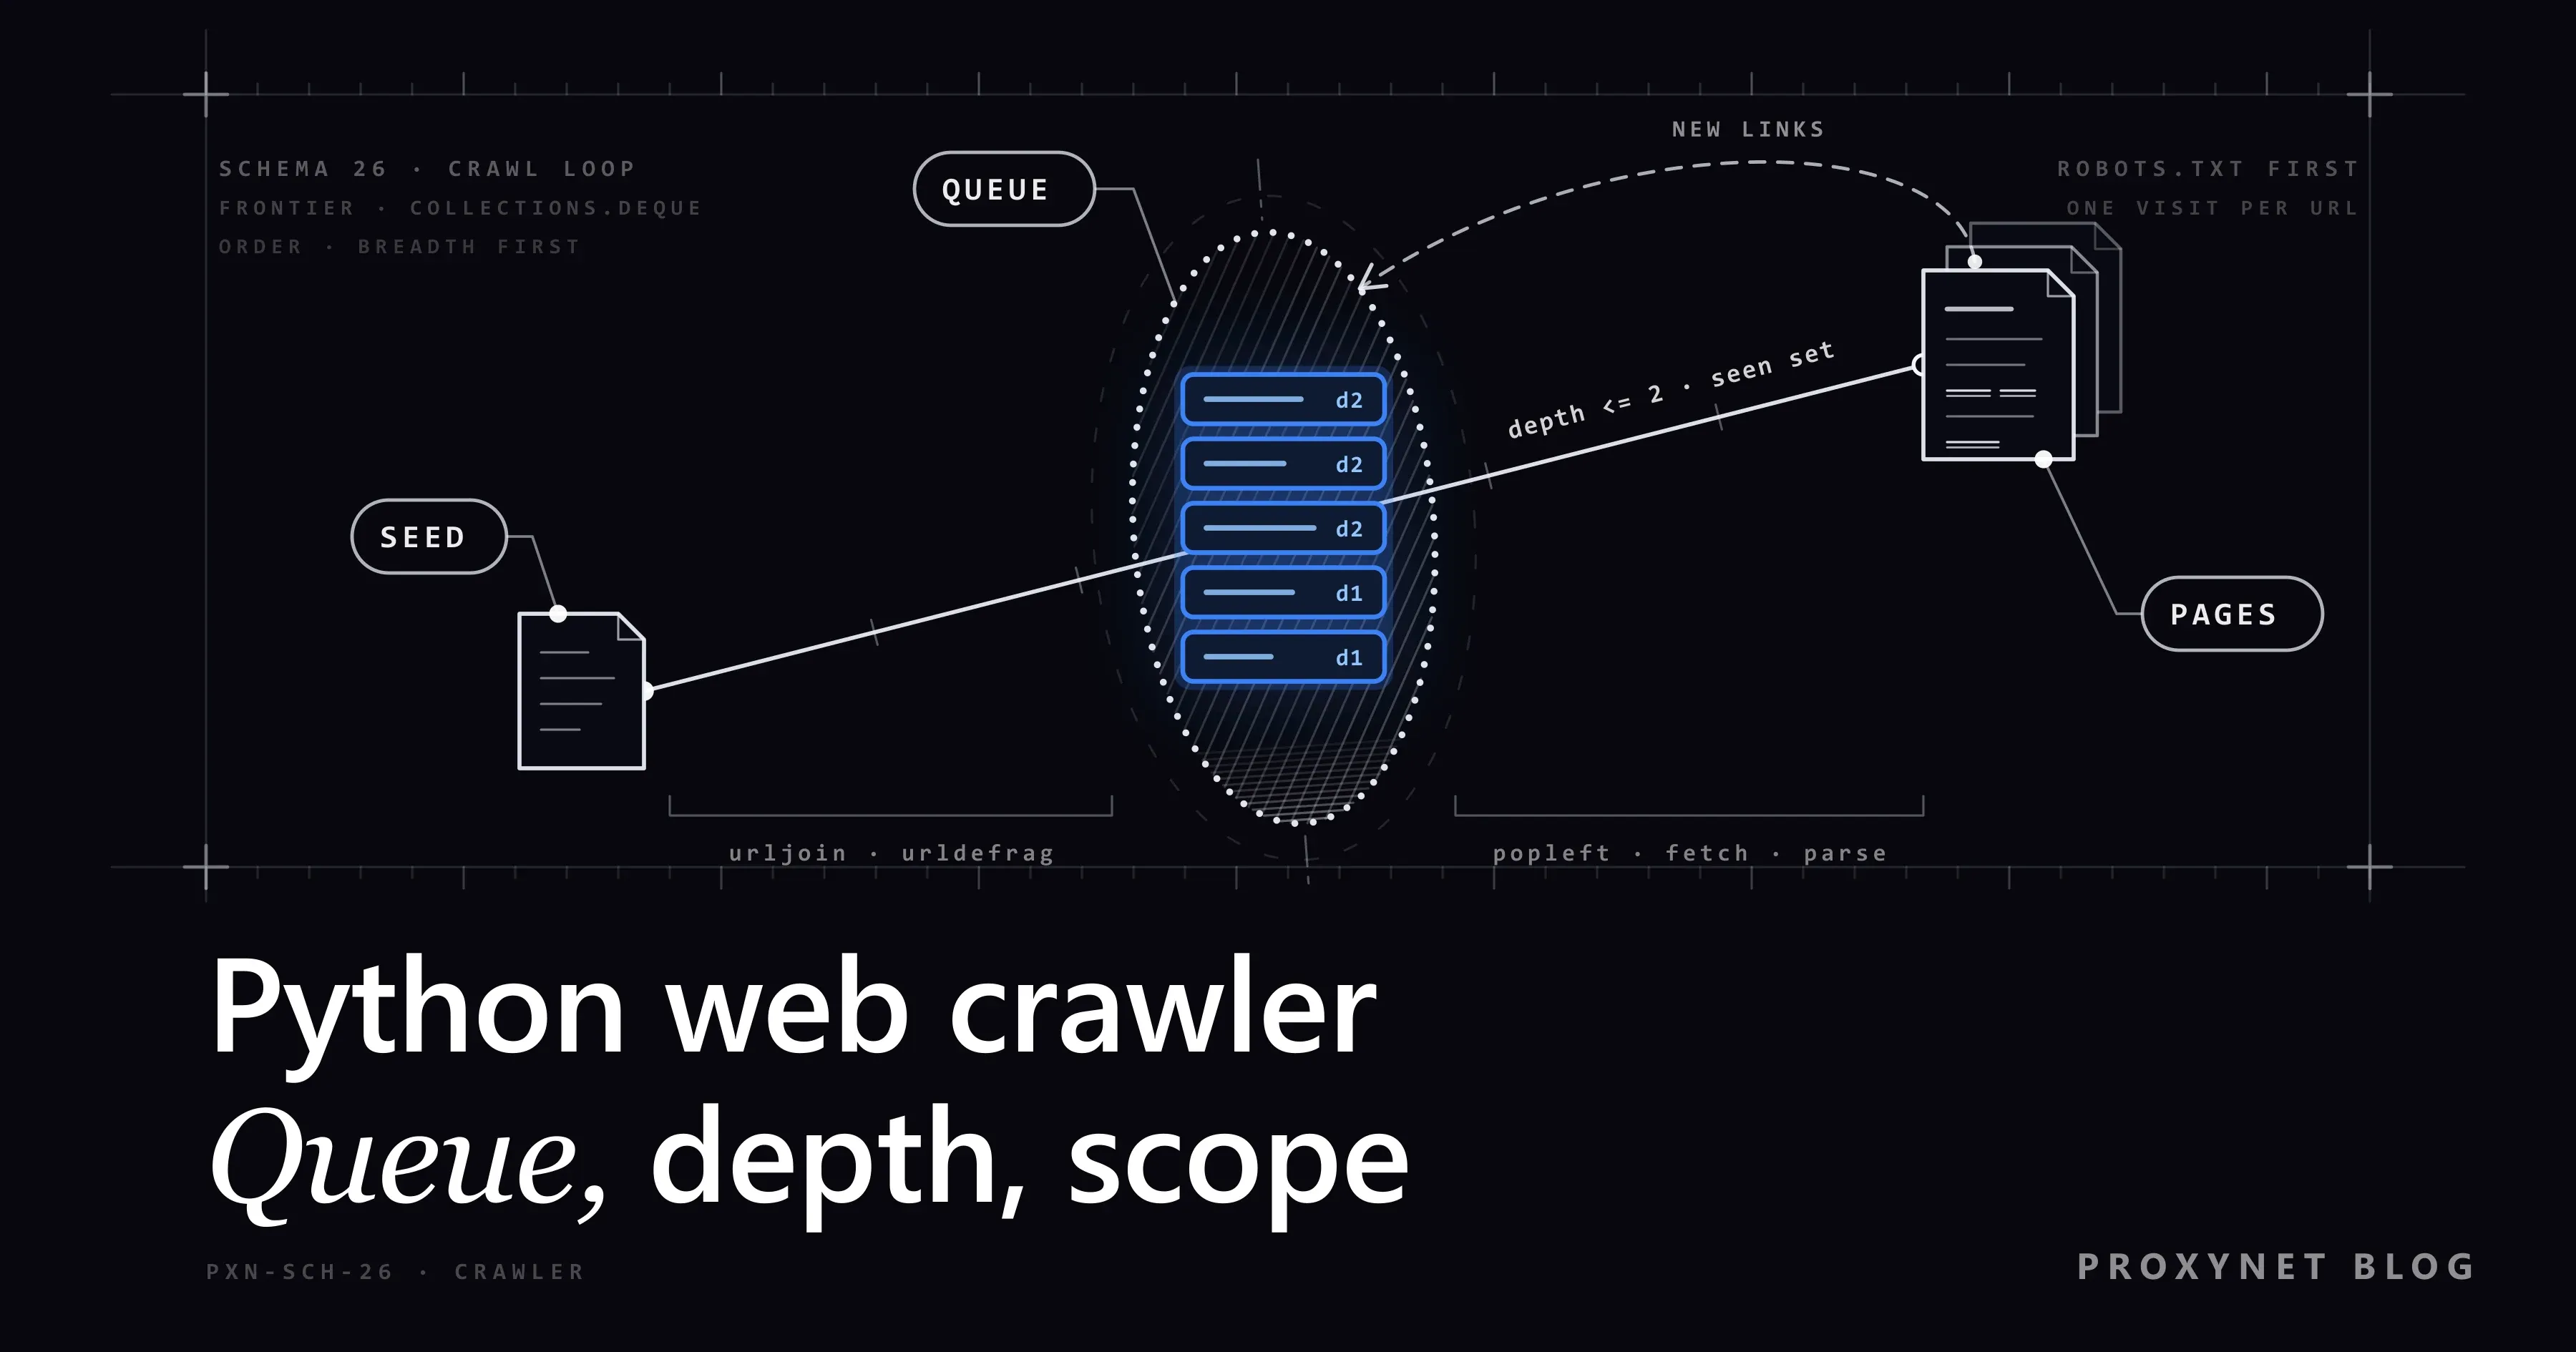
Necesitas la lista de todas las páginas de categoría y de producto de una librería online que no tiene sitemap. Nuestro objetivo de prueba es books.toscrape.com, un sitio de práctica creado para aprender scraping. Un crawler que sigue cada enlace sin recordar por dónde ha pasado nunca termina aquí: la mayoría de los enlaces apuntan a páginas que ya ha visto. En nuestra medición, 3.515 de los 4.098 enlaces de las primeras 60 páginas apuntaban a direcciones que el crawler ya conocía, y 524 direcciones nuevas seguían esperando en la cola.
A continuación construimos un crawler con Requests y BeautifulSoup, sin framework: cola, conjunto de URL vistas, normalización de URL, alcance, límite de profundidad, robots.txt, pausas y salida en JSON Lines. Qué es un crawler y en qué se diferencia de un scraper lo explicamos en nuestra página de web crawler y en Web scraping y web crawling. Todas las cifras salen de ejecuciones del script final el 25 de septiembre de 2026.
¿Qué partes necesita un web crawler en Python?
Seis partes, cada una de unas pocas líneas de Python:
- Frontera (frontier): la cola de direcciones que quedan por visitar, un
collections.deque. - Conjunto de URL vistas (
seen): todas las direcciones que el crawler ha encontrado hasta ahora. - Descargador (fetcher): una
requests.Sessioncon timeout y unUser-Agenthonesto que da el nombre del bot y un contacto (¿Qué es el User-Agent?). - Extractor de enlaces:
select("a[href]"). Leer el resto de la página es trabajo de un scraper (Qué es BeautifulSoup). - Filtro de alcance: el host, el esquema y el tipo de contenido deciden qué cuenta.
- Salida: un objeto JSON por página en un archivo
.jsonl.
Usamos Requests 2.34.2 y Beautiful Soup 4.15.0, las versiones vigentes en PyPI el 25 de septiembre de 2026; Requests necesita Python 3.10 o posterior. Scrapy trae las seis partes ya hechas.
¿Cómo funciona el bucle de rastreo paso a paso?
- Semilla. Normaliza la dirección inicial, pon
(url, 0)en la cola y la dirección en el conjuntoseen. - Tomar. Saca con
popleft()la entrada más antigua. - Consultar robots.txt. Lee las reglas del host desde una caché; se descargan una sola vez.
- Esperar y luego descargar. Controla el intervalo por host y después envía una petición GET.
- Revisar la respuesta. Lee la dirección final tras las redirecciones y la cabecera
Content-Type. - Extraer y filtrar. Resuelve cada
hrefconurljoin, normalízalo y descarta lo ya visto, lo que está fuera del sitio y lo que queda demasiado profundo. - Registrar y encolar. Escribe una línea JSON y añade las direcciones nuevas con
depth + 1.
El bucle termina cuando la cola se vacía o se alcanza el tope de páginas.
¿Qué parte evita qué problema?
| Parte | Qué evita | En Python | Sin ella |
|---|---|---|---|
Conjunto seen, rellenado al encolar | Descargar la misma página dos veces | set, se añade al encolar | En nuestra prueba con books, 3.515 enlaces conocidos se descargarían otra vez |
| Límite de profundidad y tope de páginas | Cadenas sin fin, como calendarios y filtros | (url, depth), --depth, --max-pages | Una cola que no deja de crecer (524 en espera tras 60 páginas) |
| Normalización de URL | Una misma página escrita de varias formas | urldefrag, urlsplit, parse_qsl | La misma página se descarga y se guarda más de una vez |
| Comprobación de redirección y tipo de contenido | Irse a otro sitio, analizar un PDF como HTML | r.url, Content-Type, stream=True | Los enlaces de páginas ajenas entran en la cola |
| Caché de robots.txt y pausa por host | Rutas prohibidas, ráfagas de peticiones | RobotFileParser.parse(), time.monotonic() | El sitio responde 429 |
¿Por qué la cola debe ser un deque y no una lista?
deque.popleft() saca la dirección más antigua, así que el rastreo es en anchura (BFS): primero la página inicial, luego las páginas que están a un clic, luego las que están a dos. Las páginas cercanas a la portada llegan antes, y un límite de profundidad tiene sentido porque la profundidad crece en orden. Con pop() desde el mismo extremo en el que añades, el rastreo es en profundidad (DFS): una rama hasta el fondo antes de pasar a la siguiente.
Una lista puede hacer de cola, pero pop(0) desplaza todos los elementos restantes (O(n)), mientras que un deque saca elementos por ambos extremos en un tiempo aproximadamente constante (documentación de collections). Los crawlers recursivos son DFS disfrazados, y pueden detenerse en el límite por defecto de Python de 1.000 llamadas anidadas con un RecursionError.
Además, BFS encuentra cada dirección por primera vez en su menor profundidad, así que un enlace que es demasiado profundo la primera vez que aparece puede marcarse como visto y olvidarse.
¿Cómo se escribe la normalización de URL en código?
El conjunto seen compara cadenas, así que normalize() da a cada página una sola forma escrita:
urldefrag()elimina#reviews. Según la sección 3.5 de RFC 3986, el fragmento nunca llega al servidor.- El esquema y el host pasan a minúsculas;
urlsplit().hostnameya lo está. - Se eliminan los puertos por defecto (
:80para http,:443para https), y una ruta vacía pasa a ser/, algo que la sección 6.2.3 del mismo RFC considera equivalente. - Se quitan los parámetros de seguimiento (
utm_*,gclid,fbclid) y el resto se ordena, de modo que?b=2&a=1y?a=1&b=2coinciden. - Los enlaces
mailto:,tel:yjavascript:y los puertos rotos devuelvenNone.
No borres nunca la cadena de consulta entera: ?page=2 es otra página. Las barras finales también se quedan, porque /a y /a/ pueden ser distintas; una redirección te indica cuándo no lo son. En books.toscrape.com, / y /index.html servían la misma página, algo que solo una regla propia de ese sitio podría unificar.
El conjunto seen además ignora el esquema. En quotes.toscrape.com, las páginas de autor redirigen de https a http, y sus enlaces relativos apuntan entonces a http://quotes.toscrape.com/, así que nuestra primera prueba descargó dos veces la portada y la página de login. page_key() elimina el esquema, de modo que las dos formas cuentan como una sola página.
Los sitios de práctica no tienen fragmentos ni parámetros de seguimiento, así que estas comprobaciones usan entradas inventadas:
from crawler import normalize

assert normalize("https://Example.COM:443/a#reviews") == "https://example.com/a"
assert normalize("http://example.com") == "http://example.com/"
assert normalize("https://example.com:8443/a") == "https://example.com:8443/a"
assert normalize("https://example.com/list?b=2&a=1") == "https://example.com/list?a=1&b=2"
assert normalize("https://example.com/list?utm_source=mail&page=2") == "https://example.com/list?page=2"
assert normalize("mailto:shop@example.com") is None
assert normalize("javascript:void(0)") is None
assert normalize("https://example.com:abc/") is None
assert normalize("https://example.com/a/") != normalize("https://example.com/a")
print("all normalize checks passed")
Alcance: mismo host, redirecciones y tipo de contenido
self.hosts contiene solo el host inicial. Si un sitio usa a la vez www.example.com y example.com, añade los dos a mano; una comprobación como endswith("example.com") dejaría pasar también notexample.com.
Requests sigue las redirecciones en todos los métodos salvo HEAD y guarda la dirección final en r.url (guía rápida de Requests), así que comprueba el alcance sobre r.url y resuelve los enlaces relativos contra esa dirección. En quotes.toscrape.com, /author/Jane-Austen redirige a http://quotes.toscrape.com/author/Jane-Austen/; en nuestra ejecución con profundidad 2, 40 de las 149 páginas llegaron así. Una redirección fuera del sitio se descarta, pero Requests ya ha descargado el destino. Para evitar incluso esa petición, pasa allow_redirects=False y pon tú mismo en la cola la dirección de la cabecera Location.
Con stream=True, Requests devuelve el control en cuanto llegan las cabeceras. Si Content-Type no es text/html, la conexión se cierra sin leer el cuerpo.
¿Cómo se fija un límite de profundidad y un tope de páginas?
Las entradas de la cola son (url, depth, attempts). Un enlace cuyo depth + 1 superaría --depth cuenta como too_deep y se queda fuera; --max-pages termina la ejecución tenga lo que tenga la cola. En los sitios de práctica:
- quotes.toscrape.com, profundidad 2, tope 500: la cola se vació sola tras 149 páginas (1, 46 y 102 por profundidad); 30 direcciones eran demasiado profundas.
- El mismo sitio, tope 60: la ejecución se detuvo en 60 páginas con 89 todavía en la cola.
- books.toscrape.com, profundidad 2, tope 60: las 60 páginas vinieron de las profundidades 0 y 1, con 524 en espera. Aquí la ejecución la terminó el tope, no la profundidad.
Elige la profundidad según la estructura del sitio (portada, categoría y artículo son profundidad 2; cada página de listado adicional suma uno) y el tope según tu presupuesto. Los enlaces colocados para atrapar bots los tratamos en Trampas honeypot.
robots.txt y pausas: la versión corta
El crawler guarda un RobotFileParser por esquema y host, descarga robots.txt con su propia sesión (timeout, User-Agent del bot, proxy) y pasa las líneas a parse(). Evitamos read(): en Python 3.13.9 usa urllib sin timeout y con el User-Agent propio de urllib, y lanza una excepción ante errores de red. Un 5xx o un archivo inaccesible significa no rastrear nada, como exige RFC 9309; un 4xx significa que no hay reglas (los dos sitios de práctica devolvieron 404). La sintaxis está en Qué es robots.txt.
Antes de cada petición, el crawler se asegura de que haya pasado --delay (1 segundo por defecto) o el Crawl-delay del sitio, el que sea mayor, desde su última petición a ese host. Con Crawl-delay: 2 en un sitio de prueba local y --delay 0.2, el servidor registró intervalos de 2 segundos. Ante un 429, el crawler detiene ese host e imprime Retry-After. Cómo reintentar bien lo explicamos en Códigos de estado HTTP en web scraping, y estas mismas comprobaciones con una cola en SQLite, en Paginación en web scraping.
Código completo: un web crawler en Python sin framework
Instala las dos bibliotecas en un entorno virtual, guarda el script como crawler.py y pásale una dirección inicial:
pip install requests==2.34.2 beautifulsoup4==4.15.0
python crawler.py https://books.toscrape.com/ --depth 2 --max-pages 60"""Crawler en anchura para un solo sitio: Requests + BeautifulSoup, sin framework."""
import argparse
import json
import time
from collections import Counter, deque
from urllib.parse import parse_qsl, urldefrag, urlencode, urljoin, urlsplit, urlunsplit
from urllib.robotparser import RobotFileParser
import requests
from bs4 import BeautifulSoup
BOT_NAME = "ExampleSiteMapper"
USER_AGENT = f"{BOT_NAME}/1.0 (+https://example.com/bot; bot@example.com)"
TIMEOUT = 15 # segundos; sin timeout, Requests puede esperar para siempre
MAX_RETRIES = 2 # una URL vuelve al final de la cola como máximo dos veces
TRACKING = {"utm_source", "utm_medium", "utm_campaign", "utm_term", "utm_content", "gclid", "fbclid"}
DEFAULT_PORTS = {"http": 80, "https": 443}
def normalize(url):
"""Una sola forma escrita por página, o None para los enlaces que un crawler no debe seguir."""
url, _fragment = urldefrag(url.strip())
parts = urlsplit(url)
scheme = parts.scheme.lower()
try:
port = parts.port
except ValueError: # un puerto roto, como ":abc"
return None
if scheme not in DEFAULT_PORTS or not parts.hostname:
return None # mailto:, tel:, javascript:, ftp:, ...
host = parts.hostname # ya viene en minúsculas
if port and port != DEFAULT_PORTS[scheme]:
host = f"{host}:{port}"
query = sorted((k, v) for k, v in parse_qsl(parts.query, keep_blank_values=True)
if k not in TRACKING)
return urlunsplit((scheme, host, parts.path or "/", urlencode(query), ""))
def page_key(url):
"""La clave del conjunto seen: http:// y https:// de una dirección cuentan como una sola página."""
return url.split("://", 1)[1]
class Crawler:
def __init__(self, start, max_depth, max_pages, delay, out, proxy=None):
self.start = normalize(start)
self.hosts = {urlsplit(self.start).hostname} # añade aquí, a propósito, un gemelo "www."
self.max_depth, self.max_pages, self.delay, self.out = max_depth, max_pages, delay, out
self.queue = deque([(self.start, 0, 0)]) # (url, depth, attempts)
self.seen = {page_key(self.start)} # se marca cuando una URL aparece por primera vez, no al descargarla
self.robots, self.last, self.stopped = {}, {}, {}
self.stats, self.depths = Counter(), Counter()
self.session = requests.Session()
self.session.headers["User-Agent"] = USER_AGENT
# por petición: session.proxies perdería frente a las variables de entorno HTTP(S)_PROXY
self.proxies = {"http": proxy, "https": proxy} if proxy else None
def in_scope(self, url):
return urlsplit(url).hostname in self.hosts
def fetch(self, url):
"""GET con pausa por host. stream=True lee las cabeceras antes que el cuerpo."""
parts = urlsplit(url)
rules = self.robots.get(f"{parts.scheme}://{parts.netloc}")
gap = max(self.delay, (rules.crawl_delay(BOT_NAME) if rules else None) or 0)
pause = self.last.get(parts.netloc, float("-inf")) + gap - time.monotonic()
if pause > 0:
time.sleep(pause)
try:
return self.session.get(url, timeout=TIMEOUT, stream=True, proxies=self.proxies)
finally:
self.last[parts.netloc] = time.monotonic() # por host: http y https lo comparten
def robots_ok(self, url):
root = "{0.scheme}://{0.netloc}".format(urlsplit(url))
if root not in self.robots:
rules = RobotFileParser()
try:
with self.fetch(root + "/robots.txt") as r:
status = r.status_code
rules.parse(r.text.splitlines() if status == 200 else [])
except requests.RequestException:
status = None
rules.parse([])
if status is None or status >= 500:
rules.disallow_all = True # robots.txt inaccesible: no rastrear nada en este host
self.robots[root] = rules
return self.robots[root].can_fetch(BOT_NAME, url)
def extract_links(self, html, base):
soup = BeautifulSoup(html, "html.parser")
title = " ".join(soup.title.get_text().split()) if soup.title else ""
return title, [urljoin(base, a["href"]) for a in soup.select("a[href]")]
def enqueue(self, links, depth):
for link in links:
self.stats["raw_links"] += 1
url = normalize(link)
if url is None:
self.stats["not_http"] += 1
continue
if page_key(url) in self.seen:
self.stats["duplicate"] += 1
continue
self.seen.add(page_key(url)) # BFS encuentra cada URL primero en su menor profundidad
if not self.in_scope(url):
self.stats["offsite"] += 1
elif depth + 1 > self.max_depth:
self.stats["too_deep"] += 1
else:
self.queue.append((url, depth + 1, 0))
self.stats["queued"] += 1
def retry(self, url, depth, attempts, why):
if attempts < MAX_RETRIES:
self.queue.append((url, depth, attempts + 1))
self.stats["retried"] += 1
else:
self.stats["failed"] += 1
print(f"giving up on {url}: {why}")
def run(self):
started = time.monotonic()
with open(self.out, "w", encoding="utf-8", newline="\n") as out: # JSON Lines: \n, sin BOM
while self.queue and self.stats["fetched"] < self.max_pages:
url, depth, attempts = self.queue.popleft()
host = urlsplit(url).netloc
if host in self.stopped:
self.stats["skipped_stopped_host"] += 1
continue
if not self.robots_ok(url):
self.stats["robots_disallowed"] += 1
continue
try:
r = self.fetch(url)
except requests.RequestException as exc:
self.retry(url, depth, attempts, type(exc).__name__)
continue
with r:
if r.status_code == 429:
self.stopped[host] = r.headers.get("Retry-After", "not sent")
print(f"429 from {host}, host stopped (Retry-After: {self.stopped[host]})")
continue
if r.status_code >= 500:
self.retry(url, depth, attempts, f"HTTP {r.status_code}")
continue
final = normalize(r.url)
moved = page_key(final) != page_key(url) # no solo http -> https
if not self.in_scope(final) or (moved and page_key(final) in self.seen):
self.stats["redirect_skipped"] += 1 # salió del sitio, o es una página conocida
continue
is_html = "text/html" in r.headers.get("Content-Type", "")
try: # el cuerpo se descarga aquí, y solo si es HTML
html = r.content if r.status_code == 200 and is_html else b""
except requests.RequestException as exc: # la conexión se cortó a mitad del cuerpo
self.retry(url, depth, attempts, type(exc).__name__)
continue
if final != url:
self.stats["redirected"] += 1
self.seen.add(page_key(final))
self.stats["fetched"] += 1
self.depths[depth] += 1
title, links = "", []
if html:
self.stats["html_bytes"] += len(html) # para estimar el tráfico
title, links = self.extract_links(html, r.url)
elif not is_html:
self.stats["not_html"] += 1 # el cuerpo nunca se descargó
record = {"url": url, "final_url": final, "depth": depth,
"status": r.status_code, "title": title, "links_found": len(links)}
out.write(json.dumps(record, ensure_ascii=False) + "\n")
print(f"{r.status_code} d{depth} {url}")
self.enqueue(links, depth)
print(f"\n{self.stats['fetched']} pages in {time.monotonic() - started:.1f} s,"
f" by depth {dict(sorted(self.depths.items()))}, left in queue {len(self.queue)}")
for key, value in sorted(self.stats.items()):
print(f" {key:<21}{value}")
if __name__ == "__main__":
ap = argparse.ArgumentParser(description=__doc__)
ap.add_argument("start", help="start URL, e.g. https://books.toscrape.com/")
ap.add_argument("--depth", type=int, default=2, help="link hops from the start URL")
ap.add_argument("--max-pages", type=int, default=100, help="hard ceiling on fetched pages")
ap.add_argument("--delay", type=float, default=1.0, help="minimum seconds between requests to one host")
ap.add_argument("--out", default="pages.jsonl")
ap.add_argument("--proxy", help="e.g. http://user:pass@pr.proxynet.io:8000")
args = ap.parse_args()
Crawler(args.start, args.depth, args.max_pages, args.delay, args.out, args.proxy).run()Hay tres detalles que importan cuando cambies el código:
- Los reintentos van al final de la cola, como máximo dos veces, tras un error de conexión o un
5xx. Una página de prueba local que respondió500dos veces devolvió200al tercer intento. Los reintentos dentro de Requests están en Max Retries Exceeded With URL. - El archivo es JSON Lines sin más.
encoding="utf-8"no escribe marca de orden de bytes (BOM) ynewline="\n"mantiene los finales de línea\nque pide JSON Lines; si no, Windows escribe\r\n.ensure_ascii=Falsemantiene legible el texto que no es ASCII. Un título con letras turcas hizo el viaje de ida y vuelta intacto (Codificación en Python). - Solo GET. El crawler abre
/logincomo cualquier otra página y nunca envía un formulario.
Lo que vimos al ejecutarlo
Usamos Python 3.13.9, la pausa por defecto de un segundo y profundidad 2. En quotes.toscrape.com, con un tope de 500:
149 pages in 179.1 s, by depth {0: 1, 1: 46, 2: 102}, left in queue 0
  duplicate            2916
  fetched              149
  html_bytes           722227
  offsite              2
  queued               148
  raw_links            3096
  redirected           40
  too_deep             30
En books.toscrape.com, con un tope de 60:
60 pages in 69.8 s, by depth {0: 1, 1: 59}, left in queue 524
  duplicate            3515
  fetched              60
  html_bytes           2047561
  queued               583
  raw_links            4098
En quotes, el 94 % de los enlaces apuntaba a direcciones conocidas, y solo 2 direcciones distintas quedaban fuera del sitio. Dos líneas de la salida, una normal y otra redirigida:
{"url": "https://books.toscrape.com/", "final_url": "https://books.toscrape.com/", "depth": 0, "status": 200, "title": "All products | Books to Scrape - Sandbox", "links_found": 94}
{"url": "https://quotes.toscrape.com/author/Jane-Austen", "final_url": "http://quotes.toscrape.com/author/Jane-Austen/", "depth": 1, "status": 200, "title": "Quotes to Scrape", "links_found": 4}
Un pequeño sitio local cubrió las ramas de error. El crawler se saltó una ruta prohibida, tres enlaces que no eran web y una redirección a otro host, cerró un PDF sin leerlo y registró un 404. Un 429 con Retry-After: 120 detuvo el host, y un 503 en robots.txt hizo que no se descargara nada.
¿Dónde va el proxy en el crawler?
--proxy http://user:pass@pr.proxynet.io:8000 se pasa con cada petición, robots.txt incluido. El código no usa session.proxies, porque la documentación de Requests advierte que las variables de entorno de proxy tienen prioridad sobre ese ajuste (uso avanzado). A través de un proxy de prueba local con contraseña, las 10 primeras páginas de books dieron las mismas filas que sin él, incluso con un proxy caído en HTTPS_PROXY.
Un solo sitio a una petición por segundo rara vez necesita proxy. Ayuda cuando un rastreo abarca muchos hosts y el tráfico no debería salir todo desde una misma dirección: los Proxies rotativos dan a cada petición o a cada host una IP de salida distinta. Para una lista corta y fija de destinos, los Proxies de centro de datos suelen bastar; sus IP vienen por defecto con restricción de sitio de destino, y el acceso a todos los sitios web es una opción que eliges al hacer el pedido. El código de rotación está en Cómo rotar proxies en Python.
El tráfico residencial rotativo se factura por GB, así que mide primero html_bytes en una ejecución corta. Los dos sitios de práctica enviaron HTML sin comprimir, unos 34 KB por página de books y 5 KB por página de quotes: 10.000 páginas suman aproximadamente 0,34 GB o 0,05 GB, más las cabeceras. La pausa y robots.txt se aplican a cada IP de salida, y la rotación no es motivo para enviar a un sitio más peticiones de las que permite.
Casos de uso
- Enlaces internos rotos: filtra la salida por el estado
404(web crawler). - Una lista de URL antes del scraping: primero rastrea y luego extrae datos solo de las páginas de producto o de artículo (extracción de datos).
- Productos nuevos de la competencia: compara la lista de URL de esta semana con la de la semana pasada (Seguimiento de precios de la competencia).
- Huecos en el sitemap: páginas que el crawler encuentra pero que faltan en el sitemap (Cómo encontrar el sitemap de una web).
- Imágenes de páginas conocidas: primero lista las páginas y después descarga (Cómo descargar todas las imágenes de una web).
- Campos de las páginas encontradas: títulos y precios del mismo HTML (Qué es BeautifulSoup).
Errores comunes
list.pop(0)como cola. Cada llamada desplaza toda la lista.- Recursión para cada enlace. El rastreo pasa a ser en profundidad y puede acabar en
RecursionError. - Marcar las URL como vistas solo después de descargarlas. La misma dirección entra en la cola muchas veces.
- Borrar la cadena de consulta entera. Desaparecen
?page=2y todas las páginas siguientes. - Resolver los enlaces contra la URL pedida. Tras una redirección, la base es
r.url. - Sin timeout. Sin él, Requests puede quedarse colgado indefinidamente.
- Analizar archivos PDF y ZIP como HTML. Comprueba antes el
Content-Type. - Sin tope de páginas. En un sitio con filtros o un calendario, la ejecución no termina nunca.
- Rellenar formularios. Un crawler lee páginas con GET; enviar datos es otro trabajo (POST con JSON en Python Requests).
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Unos cientos de páginas de un sitio, viendo el mecanismo | El script de este artículo |
| Reanudar un rastreo largo después de que se detenga | Una cola en disco: la versión con SQLite de Paginación en web scraping |
| Muchas peticiones al mismo tiempo | Concurrencia, dimensionada como en Concurrencia y paralelismo |
| Miles de páginas, con reintentos y exportaciones integrados | Scrapy (CrawlSpider, configuración de proxy) |
| Enlaces que solo aparecen después de ejecutar JavaScript | Un crawler basado en navegador, como PlaywrightCrawler de Crawlee para Python, o Crawl4AI |
| El sitio publica un sitemap | Léelo primero y rastrea solo lo que le falte (Cómo encontrar el sitemap de una web) |
| Un rastreo repartido entre muchos hosts | Proxies rotativos al mismo ritmo respetuoso por host |
Preguntas frecuentes
¿Qué biblioteca de Python debo usar para un web crawler?
Para unos cientos de páginas bastan Requests para descargar y BeautifulSoup para leer los enlaces. Para miles de páginas con reintentos, exportaciones y programación de tareas, Scrapy te ahorra ese código. Los enlaces que genera JavaScript necesitan una herramienta basada en navegador.
¿Puedo crear un crawler con BeautifulSoup o necesito Scrapy?
Puedes. BeautifulSoup es un parser: lee los enlaces del HTML, pero no descarga páginas, no mantiene una cola ni espera entre peticiones. El script de arriba escribe esas partes en menos de 200 líneas. Scrapy las trae integradas, algo que compensa en trabajos más grandes.
¿Un crawler en Python ve los enlaces cargados con JavaScript?
No. Requests no ejecuta scripts, así que los enlaces que añade JavaScript nunca llegan a BeautifulSoup. Busca primero una petición JSON detrás de la página a la que puedas llamar directamente. Si no la hay, usa un crawler basado en navegador donde las condiciones del sitio permitan la automatización.
¿Debería hacer el crawler multihilo?
Solo cuando rastreas varios hosts. En un solo sitio, la pausa entre peticiones marca la velocidad, y los hilos adicionales solo esperarían o romperían el intervalo. Con muchos hosts, ayuda tener un worker por host que respete las pausas (Concurrencia y paralelismo).
¿Cómo encuentro todos los enlaces de un sitio web con Python?
Empieza por el sitemap, que suele indicarse en robots.txt o estar en /sitemap.xml. Si no lo hay, ejecuta un crawler como este con un límite de profundidad y un tope de páginas, y toma el resultado como lo que alcanzan los enlaces, no como una lista completa.
¿Es legal escribir y ejecutar un web crawler?
Esto no es asesoramiento jurídico. La respuesta depende de tu país, de las condiciones del sitio, de si las páginas contienen datos personales y de lo que hagas con las copias. Respeta robots.txt, mantén un ritmo bajo y no entres en zonas que requieren inicio de sesión. País por país: ¿El web scraping es legal?.
En resumen
Un crawler que termina sin repetirse necesita un deque para el orden en anchura, un conjunto seen que se rellena al encolar, una sola forma escrita por URL, una comprobación de alcance tras las redirecciones y un límite de profundidad con un tope de páginas. robots.txt, una pausa por host y la parada ante un 429 forman parte ya de la primera versión. Cuando el trabajo crezca, pasa a una cola en disco, a la concurrencia entre hosts o a Scrapy. Para rastreos que abarcan muchos sitios o países, compara las opciones en nuestra página de servicios de proxy.