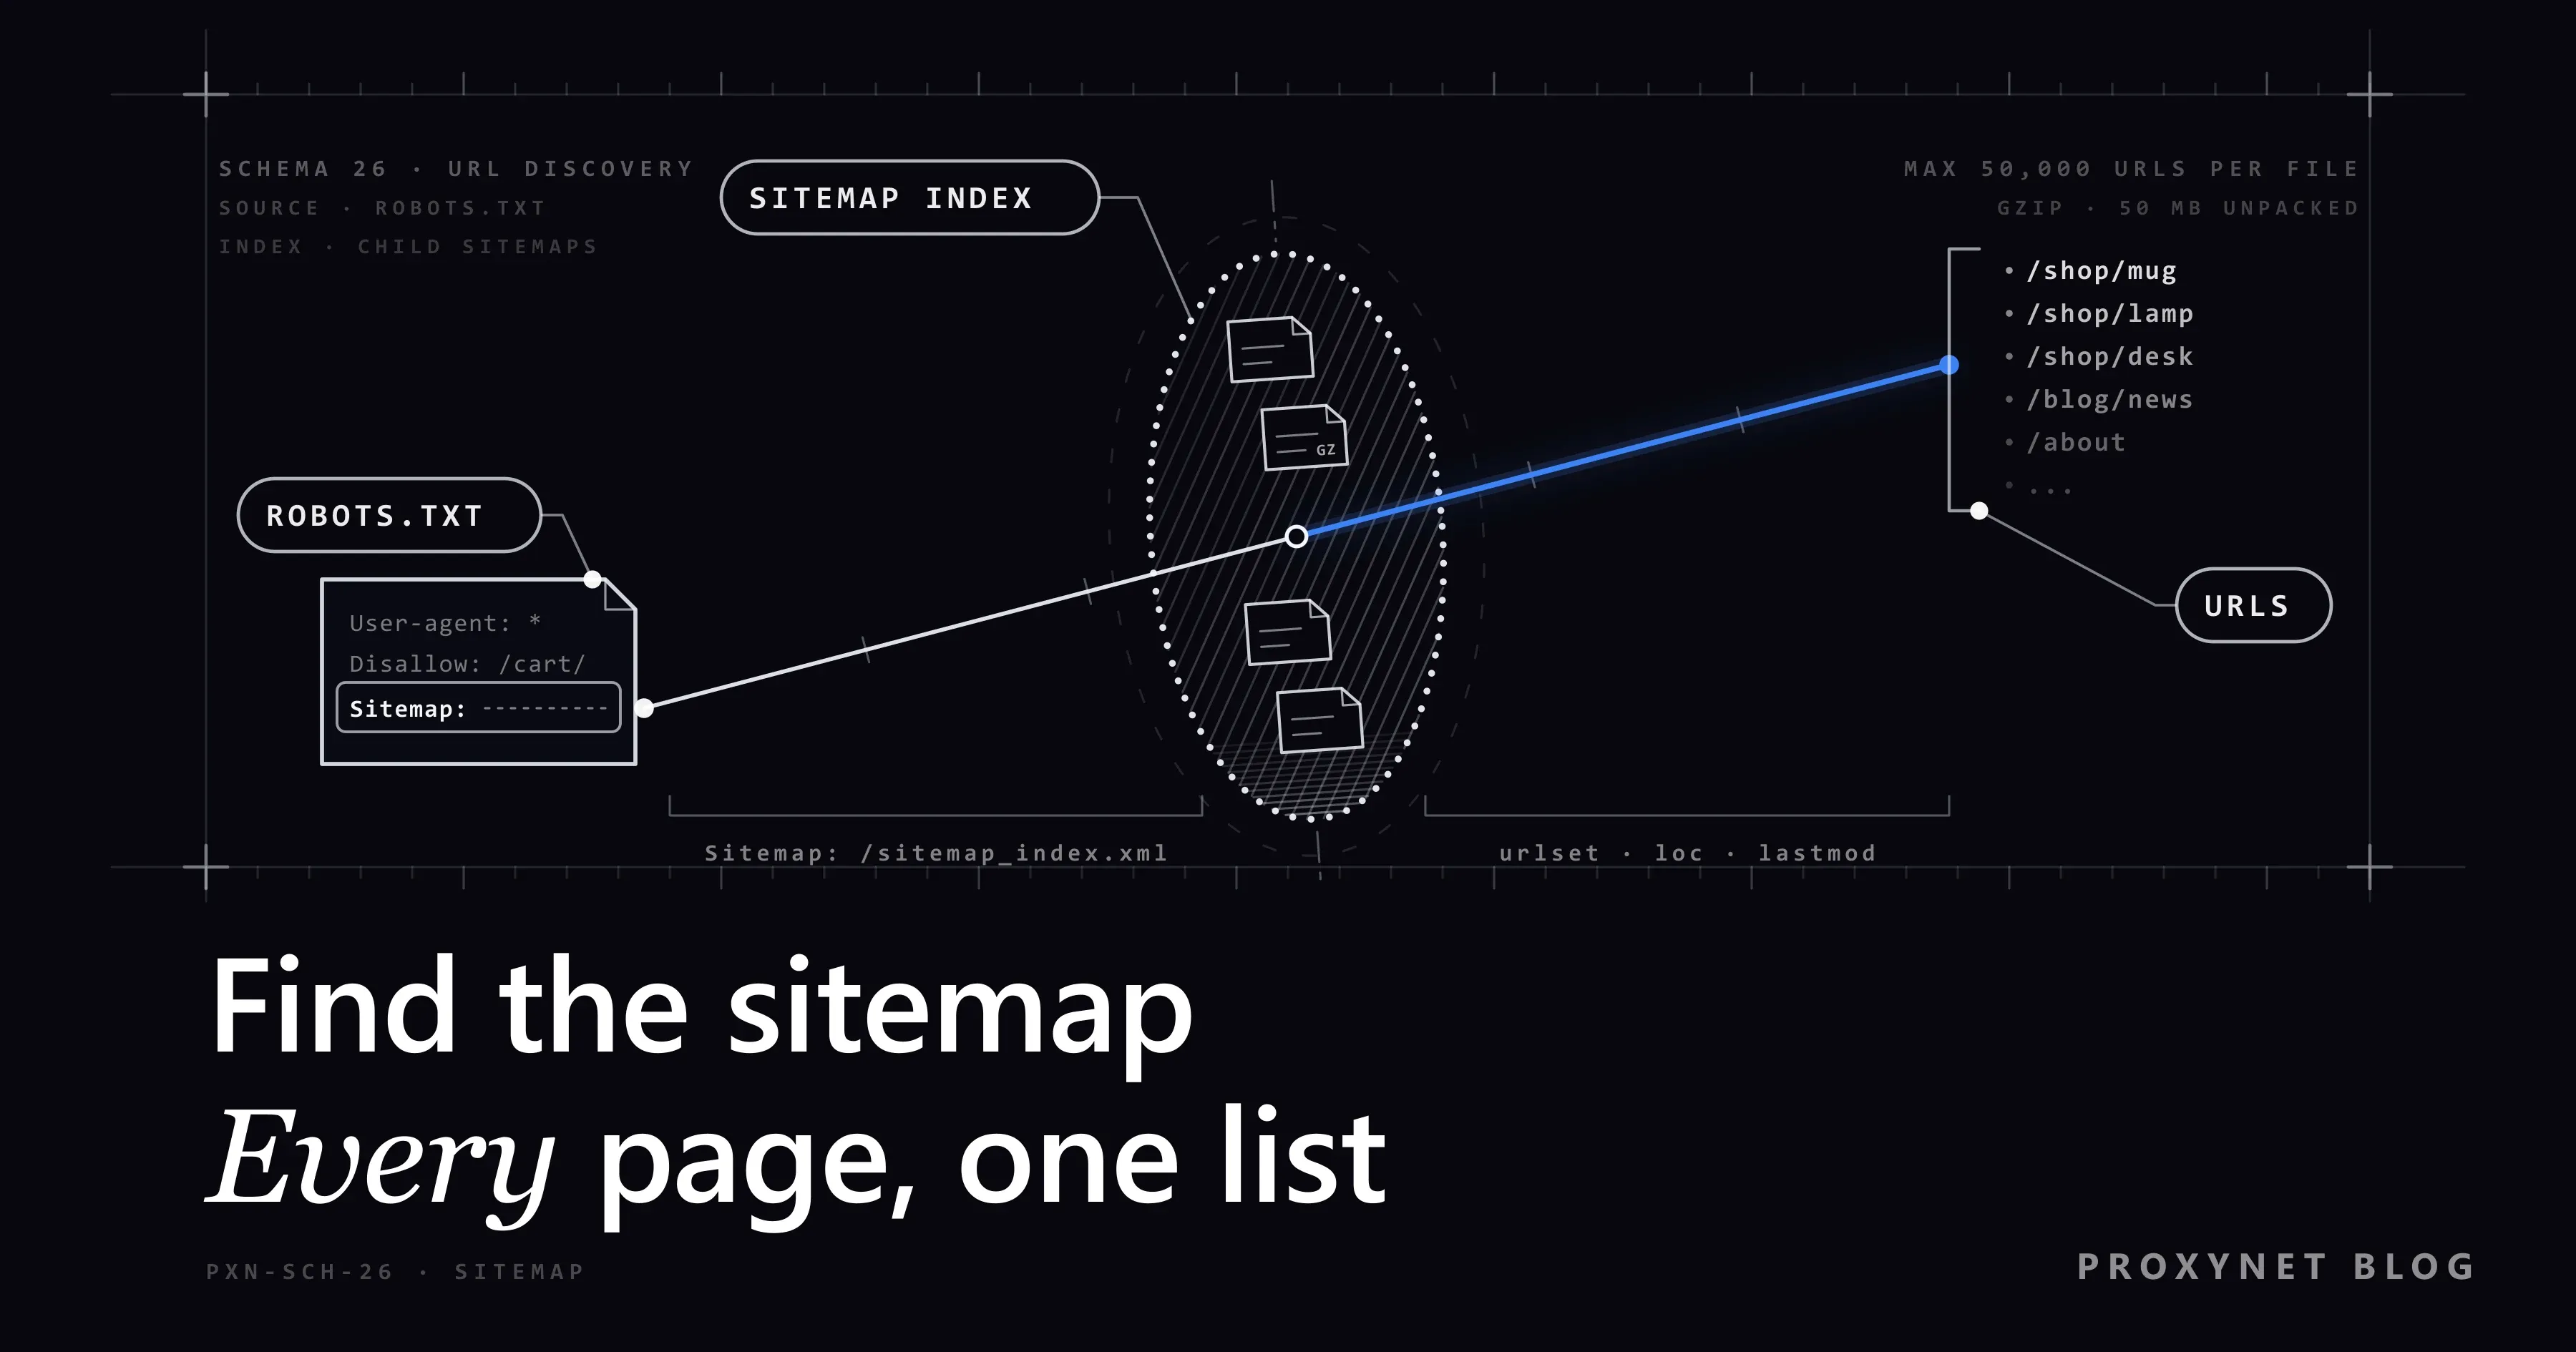
Necesitas la lista de todas las páginas de producto de la tienda online de un competidor. Recorrer cada categoría a mano llevaría horas y miles de peticiones. Puede que el propietario ya publique esa lista para los buscadores en un único archivo XML: el sitemap, un archivo que enumera las direcciones que el sitio quiere que se rastreen. Si lo encuentras, puedes ver todas las páginas de un sitio web con unas pocas peticiones.
Esta guía explica dónde buscar un sitemap y en qué orden, cómo leer el archivo, cómo abrir índices y archivos .gz, y cómo usar lastmod para quedarte solo con las páginas que cambiaron. Termina con un script de Python probado, con el motivo por el que un sitemap nunca muestra el sitio entero y con qué hacer si no hay ninguno. Para ver el diseño de un crawler en conjunto, consulta nuestra página de rastreador web.
¿Cómo se encuentra el sitemap de un sitio web?
Prueba estos lugares en orden. Cada paso cuesta una petición.
- Las líneas
Sitemap:de robots.txt. Abrehttps://example.com/robots.txt. Los propietarios indican ahí la dirección completa de cada sitemap. RFC 9309 permite a los crawlers leer estas líneas como un registro ajeno al protocolo robots.txt (sección 2.2.4); el resto de la sintaxis está en Qué es robots.txt y cómo leerlo. - Las rutas raíz. Prueba
/sitemap.xmly después/sitemap_index.xml. La mayoría de los generadores usan una de las dos. - La ruta de la plataforma. Desde la versión 5.5, el núcleo de WordPress publica un índice en
/wp-sitemap.xmly lo añade a robots.txt (anuncio de WordPress 5.5). Los plugins de SEO como Yoast lo sustituyen por su propio índice, normalmente/sitemap_index.xml. Shopify sirve/sitemap.xml, que enlaza a sitemaps separados para productos, colecciones, blogs y páginas. - El mapa del sitio en HTML. Una página «Mapa del sitio» en el pie de página está escrita para personas, pero muestra las secciones principales.
- Search Console, para tu propio sitio. El informe Sitemaps enumera lo que enviaste y cuántas URL descubrió Google en cada archivo.
Una búsqueda site:example.com filetype:xml escrita a mano una vez en Google también puede ayudar. No la automatices: Google trata las consultas automatizadas como tráfico inusual (Tráfico inusual en Google: qué significa y cómo solucionarlo).
Cómo leer un archivo sitemap: urlset, sitemapindex y lastmod
Un sitemap con dos páginas tiene este aspecto:
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
<url>
<loc>https://example.com/product/1</loc>
<lastmod>2026-09-21T12:00:00+00:00</lastmod>
</url>
<url>
<loc>https://example.com/product/2?colour=red&size=m</loc>
</url>
</urlset>El protocolo sitemap solo exige <loc>; <lastmod>, <changefreq> y <priority> son opcionales. Google ignora los dos últimos y usa lastmod solo cuando su exactitud es constante y verificable (Google Search Central). Hay cuatro reglas más que importan cuando lees el archivo de otra persona:
- Un archivo contiene como máximo 50.000 URL y 50 MB (52.428.800 bytes) sin comprimir.
- El archivo está en UTF-8, y
&se escribe&. Un parser XML lo convierte de nuevo; una expresión regular no. - Un sitemap en
/catalog/sitemap.xmlsolo puede enumerar direcciones bajo/catalog/. - Las líneas
<xhtml:link hreflang="…">apuntan a las versiones de una página en otros idiomas; no son entradas<loc>.
¿Cómo se pasa de un sitemap a todas las URL?
Un script que convierte un dominio en una lista de URL funciona así:
- Descarga robots.txt una vez; guarda sus reglas y sus líneas
Sitemap:. - Si no hay línea
Sitemap:, prueba las rutas habituales y detente en el primer200. - Descarga el archivo. Si sus dos primeros bytes son
1f 8b, descomprímelo con gzip. - Comprueba el elemento raíz. Si es
sitemapindex, repite el paso 3 para cada<loc>hijo; si esurlset, recoge las entradas. - Con una fecha de corte, descarta las entradas más antiguas y omite los archivos hijos cuyo
lastmoden el índice sea anterior. - Compara cada dirección con robots.txt y omite las cerradas.
- Elimina los duplicados y pon el resto en cola. Cómo guardar la cola en disco para que una ejecución detenida pueda reanudarse se explica en ¿Qué es la paginación y cómo rastrear todas las páginas?.
Un crawler construye el mismo tipo de lista siguiendo enlaces, una petición por página, con reglas de profundidad y de duplicados. La diferencia se explica en Web scraping y web crawling: ¿en qué se diferencian?.
Métodos para descubrir URL comparados
| Método | Carga para el sitio | Qué muestra | Información de cambios | Cuándo usarlo |
|---|---|---|---|---|
| Sitemap XML | Muy baja: unos pocos archivos | Direcciones que el propietario quiere que se rastreen; puede estar incompleto | lastmod, si es exacto | Siempre primero |
| Feed RSS o Atom | Muy baja | Solo contenido reciente | Fechas de publicación | Blogs, noticias, anuncios nuevos |
| API oficial o exportación | Baja, límites documentados | Lo que ofrece la API | Normalmente | Cuando se ofrece; antes que el HTML |
| Seguir enlaces | Alta: una petición por página | Todo lo enlazado, trampas y duplicados incluidos | Ninguna | Sin sitemap o con huecos; con límite de profundidad |
| API CDX de Wayback | Ninguna (las peticiones van al archivo) | Direcciones archivadas; algunas ya no existen | Fecha de captura | Sin sitemap; lista de candidatas |
| Google Search Console | Ninguna | Páginas que Google conoce | Estado de rastreo e indexación | Solo tu propio sitio |
El sitemap va primero: unas pocas peticiones devuelven la mayoría de las direcciones.
¿Cómo se abren los índices de sitemaps y los archivos .gz?
Los sitios grandes dividen su lista por tipo. El índice tiene <sitemapindex> como raíz y un elemento <sitemap> por cada archivo hijo, cada uno con un <loc> y un <lastmod> opcional. La guía de Google sobre sitemaps grandes exige que los archivos hijos estén en el mismo sitio, en el directorio del índice o por debajo. Aun así, un script debe recordar los archivos que ya abrió, para que un índice que se referencia a sí mismo no lo atrape en un bucle.
Los archivos comprimidos suelen terminar en .xml.gz, y los servidores tienden a enviarlos como application/gzip sin cabecera Content-Encoding. En ese caso Requests te entrega los bytes comprimidos sin cambios; en nuestra prueba local el cuerpo empezaba por 1f 8b, la firma de gzip. Comprobar esos dos bytes funciona se llame como se llame el archivo.
El límite de 50 MB se aplica al archivo sin comprimir, así que deja de leer ahí. Esto también te protege de una bomba de descompresión, un archivo pequeño que se expande hasta ocupar gigabytes; las notas de seguridad de XML de Python la mencionan junto a los ataques de expansión de entidades.
Usar lastmod para descargar solo las páginas que cambiaron
lastmod usa el formato W3C Datetime: una fecha (2026-09-20) o una fecha con hora y zona (2026-09-20T10:00:00+03:00). Desde Python 3.11, datetime.fromisoformat() lee ambos, incluida una Z final. Trata los valores sin zona como UTC para que todas las fechas se puedan comparar.
Conserva las entradas que cambiaron desde tu última ejecución, además de las que tienen un lastmod ausente o roto: nada demuestra que siguieran igual. En un índice, lastmod indica cuándo cambió cada archivo hijo, así que un archivo hijo más antiguo se puede omitir sin descargarlo. En nuestra prueba con un corte de 30 días, el script omitió un archivo cuyo último cambio fue en enero de 2025 e hizo tres peticiones en lugar de cuatro.
Que las fechas signifiquen algo depende del sitio:
- La misma fecha y hora en todas partes: el sitemap se regenera en cada despliegue, y la fecha no dice nada de las páginas.
- Sin fechas: el 24 de septiembre de 2026, ninguna de las entradas del sitemap de docs.python.org tenía
lastmod. - Algunas fechas: el núcleo de WordPress no escribe
lastmodpara los archivos de su índice, así que hay que abrir cada archivo hijo. Desde WordPress 6.5, las URL de las entradas llevan uno; los sitemaps de categorías, etiquetas y autores no.
Donde lastmod falla, usa peticiones condicionales y 304 Not Modified, que se describen en Cómo hacer web scraping sin que te bloqueen.
¿Por qué un sitemap difiere de lo que el sitio sirve realmente?
Google describe un sitemap enviado como «una simple sugerencia». Espera cinco tipos de diferencias:
- Páginas que faltan. El 24 de septiembre de 2026,
docs.python.org/sitemap.xmlenumeraba 8 URL, una página de inicio por versión de Python, mientras que el sitio sirve miles de páginas. - Entradas obsoletas. Los productos eliminados siguen apareciendo y devuelven
404o410. Quítalos de tu lista. - Conflictos con robots.txt. Una dirección puede estar en el sitemap y cerrada en robots.txt. robots.txt es la regla explícita del propietario, así que omite la dirección; en nuestra prueba, una página de búsqueda listada se omitió de esta forma.
- Alcance. Un sitemap en un subdirectorio solo cubre ese directorio, y cada subdominio tiene su propio robots.txt y su propio sitemap.
- Variantes. Aparecen parámetros de seguimiento, alternativas de idioma y páginas con una etiqueta canonical que apunta a otra parte. Decide qué versión necesitas.
Un sitemap enumera páginas publicadas a propósito, no páginas ocultas; las páginas que requieren inicio de sesión y las páginas noindex quedan fuera de este método. El aspecto legal está en ¿El web scraping es legal? Una visión general.
¿Qué hacer si un sitio no tiene sitemap?
Los sitemaps son opcionales. Estas son las siguientes opciones legítimas, en orden:
- Un feed. WordPress sirve uno en
/feed/, y muchos sitios anuncian el suyo con<link rel="alternate">en el<head>de la página. Para el contenido nuevo funciona tan bien como un sitemap. - Una API oficial o una exportación, con formato y límite documentados. Consulta la vía 1 en Cloudflare y scraping: por qué te bloquean y qué funciona.
- Seguir enlaces desde las páginas de categoría, con un límite de profundidad y un tope de páginas, como se explica en la guía de rastreo enlazada más arriba.
- La API CDX de Wayback Machine. Una consulta como
https://web.archive.org/cdx/search/cdx?url=example.com/blog/&matchType=prefix&collapse=urlkey&fl=original&limit=500enumera las direcciones archivadas bajo una ruta (documentación del servidor CDX). Paradocs.python.org/3/library/, nuestro resultado incluía2to3.html, que ahora redirige porque Python eliminó 2to3. Comprueba cada dirección y manténlimitpara no sobrecargar tampoco el archivo. - El informe Páginas de Search Console, para tu propio sitio.
No recomendamos adivinar rutas con listas de palabras, extraer resultados de Google de forma automática ni entrar en áreas con inicio de sesión. Mantén una velocidad baja por sitio.
Leer un sitemap con Python: un ejemplo que funciona
El script necesita Python 3.11 o posterior, Requests y lxml (pip install requests lxml).
"""Encuentra el sitemap de un sitio, abre índices y archivos .gz y lista las URL.

Uso: python read_sitemap.py https://example.com [DIAS]
Con DIAS, solo se listan las URL que cambiaron en los últimos DIAS días (o sin una fecha utilizable).
"""
import gzip
import io
import os
import sys
import time
from datetime import datetime, timedelta, timezone
from functools import lru_cache
from urllib.parse import urljoin
from urllib.robotparser import RobotFileParser

import requests
from lxml import etree

BOT_NAME = "ExampleSitemapReader"
USER_AGENT = f"{BOT_NAME}/1.0 (+mailto:bots@example.com)"
DELAY = 1.0                        # segundos de espera antes de cada petición
LIMIT = 50 * 1024 * 1024           # sitemaps.org: como máximo 50 MB sin comprimir
CANDIDATES = ["/sitemap.xml", "/sitemap_index.xml", "/wp-sitemap.xml"]

session = requests.Session()
session.headers["User-Agent"] = USER_AGENT
if os.environ.get("PROXY_URL"):    # p. ej. http://user:pass@pr.proxynet.io:8000
    session.proxies = {"http": os.environ["PROXY_URL"], "https": os.environ["PROXY_URL"]}

xml_parser = etree.XMLParser(resolve_entities=False, no_network=True)


@lru_cache(maxsize=16)             # nunca descarga el mismo archivo dos veces en una ejecución
def fetch(url):
    time.sleep(DELAY)
    resp = session.get(url, timeout=(5, 30))
    resp.raise_for_status()
    data = resp.content
    if data[:2] == b"\x1f\x8b":    # gzip: confía en los dos primeros bytes, no en el nombre
        with gzip.GzipFile(fileobj=io.BytesIO(data)) as gz:
            data = gz.read(LIMIT + 1)
    if len(data) > LIMIT:
        raise ValueError(f"{url} is larger than 50 MB uncompressed")
    return data


def read_robots(site):
    robots = RobotFileParser()
    try:
        lines = fetch(urljoin(site, "/robots.txt")).decode("utf-8", "replace").splitlines()
    except requests.HTTPError as err:
        if err.response.status_code >= 500:
            lines = ["User-agent: *", "Disallow: /"]  # RFC 9309: error del servidor, no entrar
        else:
            lines = []                                # 4xx: sin robots.txt, sin reglas
    robots.parse(lines)
    return robots


def find_sitemaps(site, robots):
    if robots.site_maps():
        return robots.site_maps()
    for path in CANDIDATES:
        url = urljoin(site, path)
        if not robots.can_fetch(BOT_NAME, url):
            continue
        try:
            fetch(url)
        except requests.HTTPError:
            continue
        return [url]
    return []


def parse_date(text):
    if not text:
        return None
    try:
        when = datetime.fromisoformat(text)  # 2026-09-20, 2026-09-20T10:00:00+03:00 o ...Z
    except ValueError:
        return None                          # fecha rota: se trata como desconocida
    return when if when.tzinfo else when.replace(tzinfo=timezone.utc)


def name(el):
    return etree.QName(el).localname         # nombre de la etiqueta sin el espacio de nombres


def read_sitemap(url, since, seen):
    if url in seen:
        return
    seen.add(url)
    try:
        root = etree.fromstring(fetch(url), xml_parser)
    except (requests.RequestException, etree.XMLSyntaxError, ValueError) as err:
        print(f"skipped {url}: {err}", file=sys.stderr)
        return
    is_index = name(root) == "sitemapindex"
    for entry in root.iterchildren(etree.Element):          # solo elementos, sin comentarios
        fields = {name(f): (f.text or "").strip() for f in entry.iterchildren(etree.Element)}
        loc, lastmod = fields.get("loc"), parse_date(fields.get("lastmod"))
        if not loc:
            continue
        if is_index:
            if since and lastmod and lastmod < since:
                continue                     # nada de este archivo cambió después del corte
            yield from read_sitemap(loc, since, seen)
        elif since is None or lastmod is None or lastmod >= since:
            yield loc, lastmod


if __name__ == "__main__":
    site = sys.argv[1]
    days = int(sys.argv[2]) if len(sys.argv) > 2 else None
    since = datetime.now(timezone.utc) - timedelta(days=days) if days else None
    robots = read_robots(site)
    seen, listed = set(), set()
    for sitemap in find_sitemaps(site, robots):
        for loc, lastmod in read_sitemap(sitemap, since, seen):
            if loc in listed:
                continue
            listed.add(loc)
            if robots.can_fetch(BOT_NAME, loc):
                print(lastmod.date() if lastmod else "-", loc)
            else:
                print("disallowed by robots.txt, skipped:", loc, file=sys.stderr)
Qué hace el script y qué deja fuera
- Un cliente educado. Una sola sesión espera un segundo antes de cada petición y envía un
User-Agenthonesto con un nombre de bot y una dirección de contacto (¿Qué es el User-Agent? Cómo verlo y cambiarlo). - robots.txt a través de tu propio cliente. El archivo va a
RobotFileParser.parse(), porqueread()lo descargaría con la identidad predeterminada de urllib. Un4xxsignifica que no hay reglas y un5xxsignifica no entrar, como exige RFC 9309.site_maps()devuelve las líneasSitemap:oNone(documentación de Python), ycan_fetch()recibe el nombre del bot, no elUser-Agentcompleto. - Análisis seguro.
resolve_entities=Falseyno_network=Trueimpiden que lxml expanda entidades o cargue nada remoto; en nuestra prueba, un<loc>construido con entidades anidadas volvió vacío.localnameignora las diferencias de espacio de nombres. - Sin reintentos ni peticiones en paralelo, a propósito. Para
429yRetry-After, consulta Códigos de estado HTTP en web scraping: 403, 407, 429, 503; para las peticiones en paralelo, Concurrencia y paralelismo en web scraping.
Lo ejecutamos con Python 3.13.9, Requests 2.34.2 y lxml 6.1.3 contra un sitio local: un robots.txt que cierra /search/, un índice, un sitemap de productos en gzip enviado sin Content-Encoding y un sitemap de páginas con fecha de enero de 2025. Con un corte de 30 días:
$ python read_sitemap.py http://127.0.0.1:18766 30
disallowed by robots.txt, skipped: http://127.0.0.1:18766/search/?q=x
2026-09-21 http://127.0.0.1:18766/product/1
- http://127.0.0.1:18766/product/3
- http://127.0.0.1:18766/product/4?colour=red&size=mproduct/2, modificado en marzo, quedó fuera del corte; product/3 (sin fecha) y product/4 (fecha rota) se mantienen, y & salió como &. El sitemap de páginas nunca se solicitó. Sin robots.txt, el script encontró el índice en su segunda ruta candidata. Contra docs.python.org hizo dos peticiones e imprimió 8 URL, y la misma ejecución a través de un proxy HTTP local con PROXY_URL definido dio la misma lista.
Leer un sitemap no requiere proxy. La línea del proxy es para la etapa siguiente, comprobar las páginas listadas tal como las ven los visitantes de otro país, donde un Proxies residenciales te da direcciones locales al mismo ritmo educado.
Si prefieres una biblioteca, ultimate-sitemap-parser (1.8.1 en PyPI) encuentra sitemaps a través de robots.txt y de nombres habituales y recorre el árbol con sitemap_tree_for_homepage(). SitemapSpider de Scrapy sigue sitemaps anidados y puede empezar desde robots.txt (Qué es Scrapy y cómo usarlo con un proxy).
Casos de uso
- Seguimiento de precios: toma las URL de producto del sitemap y vuelve a descargar solo las que cambiaron (Cómo hacer seguimiento de precios de la competencia).
- Auditorías SEO de tu propio sitio: confirma que cada URL del sitemap devuelve
200y que ninguna está cerrada en robots.txt; después comprueba cómo se ven las páginas desde otros países (proxy para SEO). - Rastreos grandes: empieza desde el sitemap y evita los enlaces trampa (Qué son las trampas honeypot y cómo afectan al scraping).
- Extracción puntual: prepara la lista de URL antes de extraer los campos (Cómo extraer datos de una web: Excel, Python y herramientas).
- Seguimiento de cambios: una ejecución diaria con un corte de un día muestra los anuncios o artículos nuevos (rastreador web).
Errores comunes
- Probar solo
/sitemap.xml. robots.txt suele indicar otro archivo. - Leer solo la primera línea
Sitemap:. Cuentan todas. - Tratar un índice como una lista de páginas. Sus valores
<loc>son sitemaps. - Detectar gzip por el nombre del archivo. Comprueba los dos primeros bytes.
- Descartar las entradas sin
lastmod. Pueden ser justo las que cambiaron. - Fiarte de un
lastmodidéntico en todas partes. Solo registra la compilación. - Descargar una URL porque el sitemap la enumera. robots.txt sigue aplicándose.
- Analizar XML con expresiones regulares.
&sigue escapado. - Descargar todos los archivos hijos en cada ejecución. Usa el
lastmoddel índice. Para conexiones que fallan, consulta Max retries exceeded with url: qué es y cómo solucionarlo.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| La dirección del sitemap de un sitio, rápido | /robots.txt, luego /sitemap.xml y /sitemap_index.xml |
| El sitemap de un sitio WordPress | /wp-sitemap.xml; /sitemap_index.xml con un plugin de SEO |
| Miles de direcciones en una lista | Un script que abra índices y gzip, o ultimate-sitemap-parser |
| Solo las páginas que cambiaron desde la última ejecución | Un corte por lastmod; peticiones condicionales donde las fechas fallan |
| Una URL del sitemap cerrada en robots.txt | Omitirla |
| Sin sitemap | Feed y API; después seguimiento de enlaces limitado o Wayback CDX |
| Todas las páginas de tu propio sitio | Los informes Páginas y Sitemaps de Search Console |
| Rastreos periódicos de URL de sitemaps a gran escala | Una configuración de crawler con un pool de proxies (rastreador web, Proxies rotativos) |
Preguntas frecuentes
¿Cómo veo el sitemap de un sitio web?
Escribe el dominio seguido de /robots.txt en tu navegador y abre la dirección de la línea Sitemap:. Si no hay ninguna, prueba /sitemap.xml y /sitemap_index.xml. Un archivo .gz se descarga y hay que descomprimirlo primero.
¿Todos los sitios web tienen sitemap?
No. Los sitemaps son opcionales, y los sitios pequeños con buenos enlaces internos a menudo prescinden de él. Sin sitemap, usa un feed, una API, un seguimiento de enlaces limitado o la API CDX de Wayback.
¿Qué diferencia hay entre sitemap.xml y sitemap_index.xml?
sitemap_index.xml suele ser un índice que enumera otros sitemaps. Pero el nombre no lo decide: abre el archivo y comprueba el elemento raíz. <urlset> contiene páginas; <sitemapindex>, sitemaps.
¿Cómo encuentro páginas que no están en el sitemap?
Sigue enlaces desde páginas conocidas, lee el feed, usa la API o consulta la API CDX de Wayback, y después comprueba las direcciones archivadas. No recomendamos adivinar rutas con listas de palabras. El seguimiento de enlaces se explica en Web scraping y web crawling: ¿en qué se diferencian?.
¿Puedo fiarme de lastmod?
Depende del sitio. Fechas idénticas en todas las entradas significan que el sitemap se regenera en cada compilación. El núcleo de WordPress no incluye lastmod en su índice ni en sus sitemaps de categorías y autores. Donde las fechas fallan, las peticiones condicionales permiten al servidor responder 304 para las páginas sin cambios.
¿Qué hago si robots.txt bloquea una URL del sitemap?
Omítela. robots.txt es la regla explícita del propietario para los crawlers, mientras que un sitemap es solo una lista. El script de arriba comprueba cada dirección con can_fetch() antes de imprimirla; los detalles están en Qué es robots.txt y cómo leerlo.
En resumen
Busca el sitemap primero en robots.txt, luego en /sitemap.xml, /sitemap_index.xml y la ruta de la plataforma. Abre los índices y los archivos gzip, usa lastmod para quedarte solo con lo que cambió y deja que robots.txt mande siempre sobre el sitemap. Sin sitemap, pasa a los feeds, las API, el seguimiento de enlaces limitado y la API CDX de Wayback. Cuando la lista crezca hasta miles de páginas al día, nuestra página de rastreador web muestra cómo hacer ese rastreo a escala.