


































Un script recoge anuncios de licitaciones de la web antigua de un ayuntamiento de Türkiye. En el navegador un encabezado dice Çankırı İhale İlanı, pero el script imprime Çankýrý Ýhale Ýlaný. Después, la lista que guardó en un equipo con Windows no se abre en un servidor Linux: 'utf-8' codec can't decode byte 0xc7 in position 0: invalid continuation byte. Los dos problemas tienen una sola causa: los bytes se escribieron con una tabla de códigos y se leyeron con otra.
Esta guía corrige esa causa allí donde aparezca: archivos de código fuente, open(), la consola de Windows, páginas descargadas con Requests y Beautiful Soup, y archivos CSV para Excel. También muestra cómo leer y reparar texto corrupto. Todos los valores de bytes y mensajes de error de este artículo salen de nuestras propias pruebas con Python 3.13.
¿Qué diferencia hay entre str y bytes en Python?
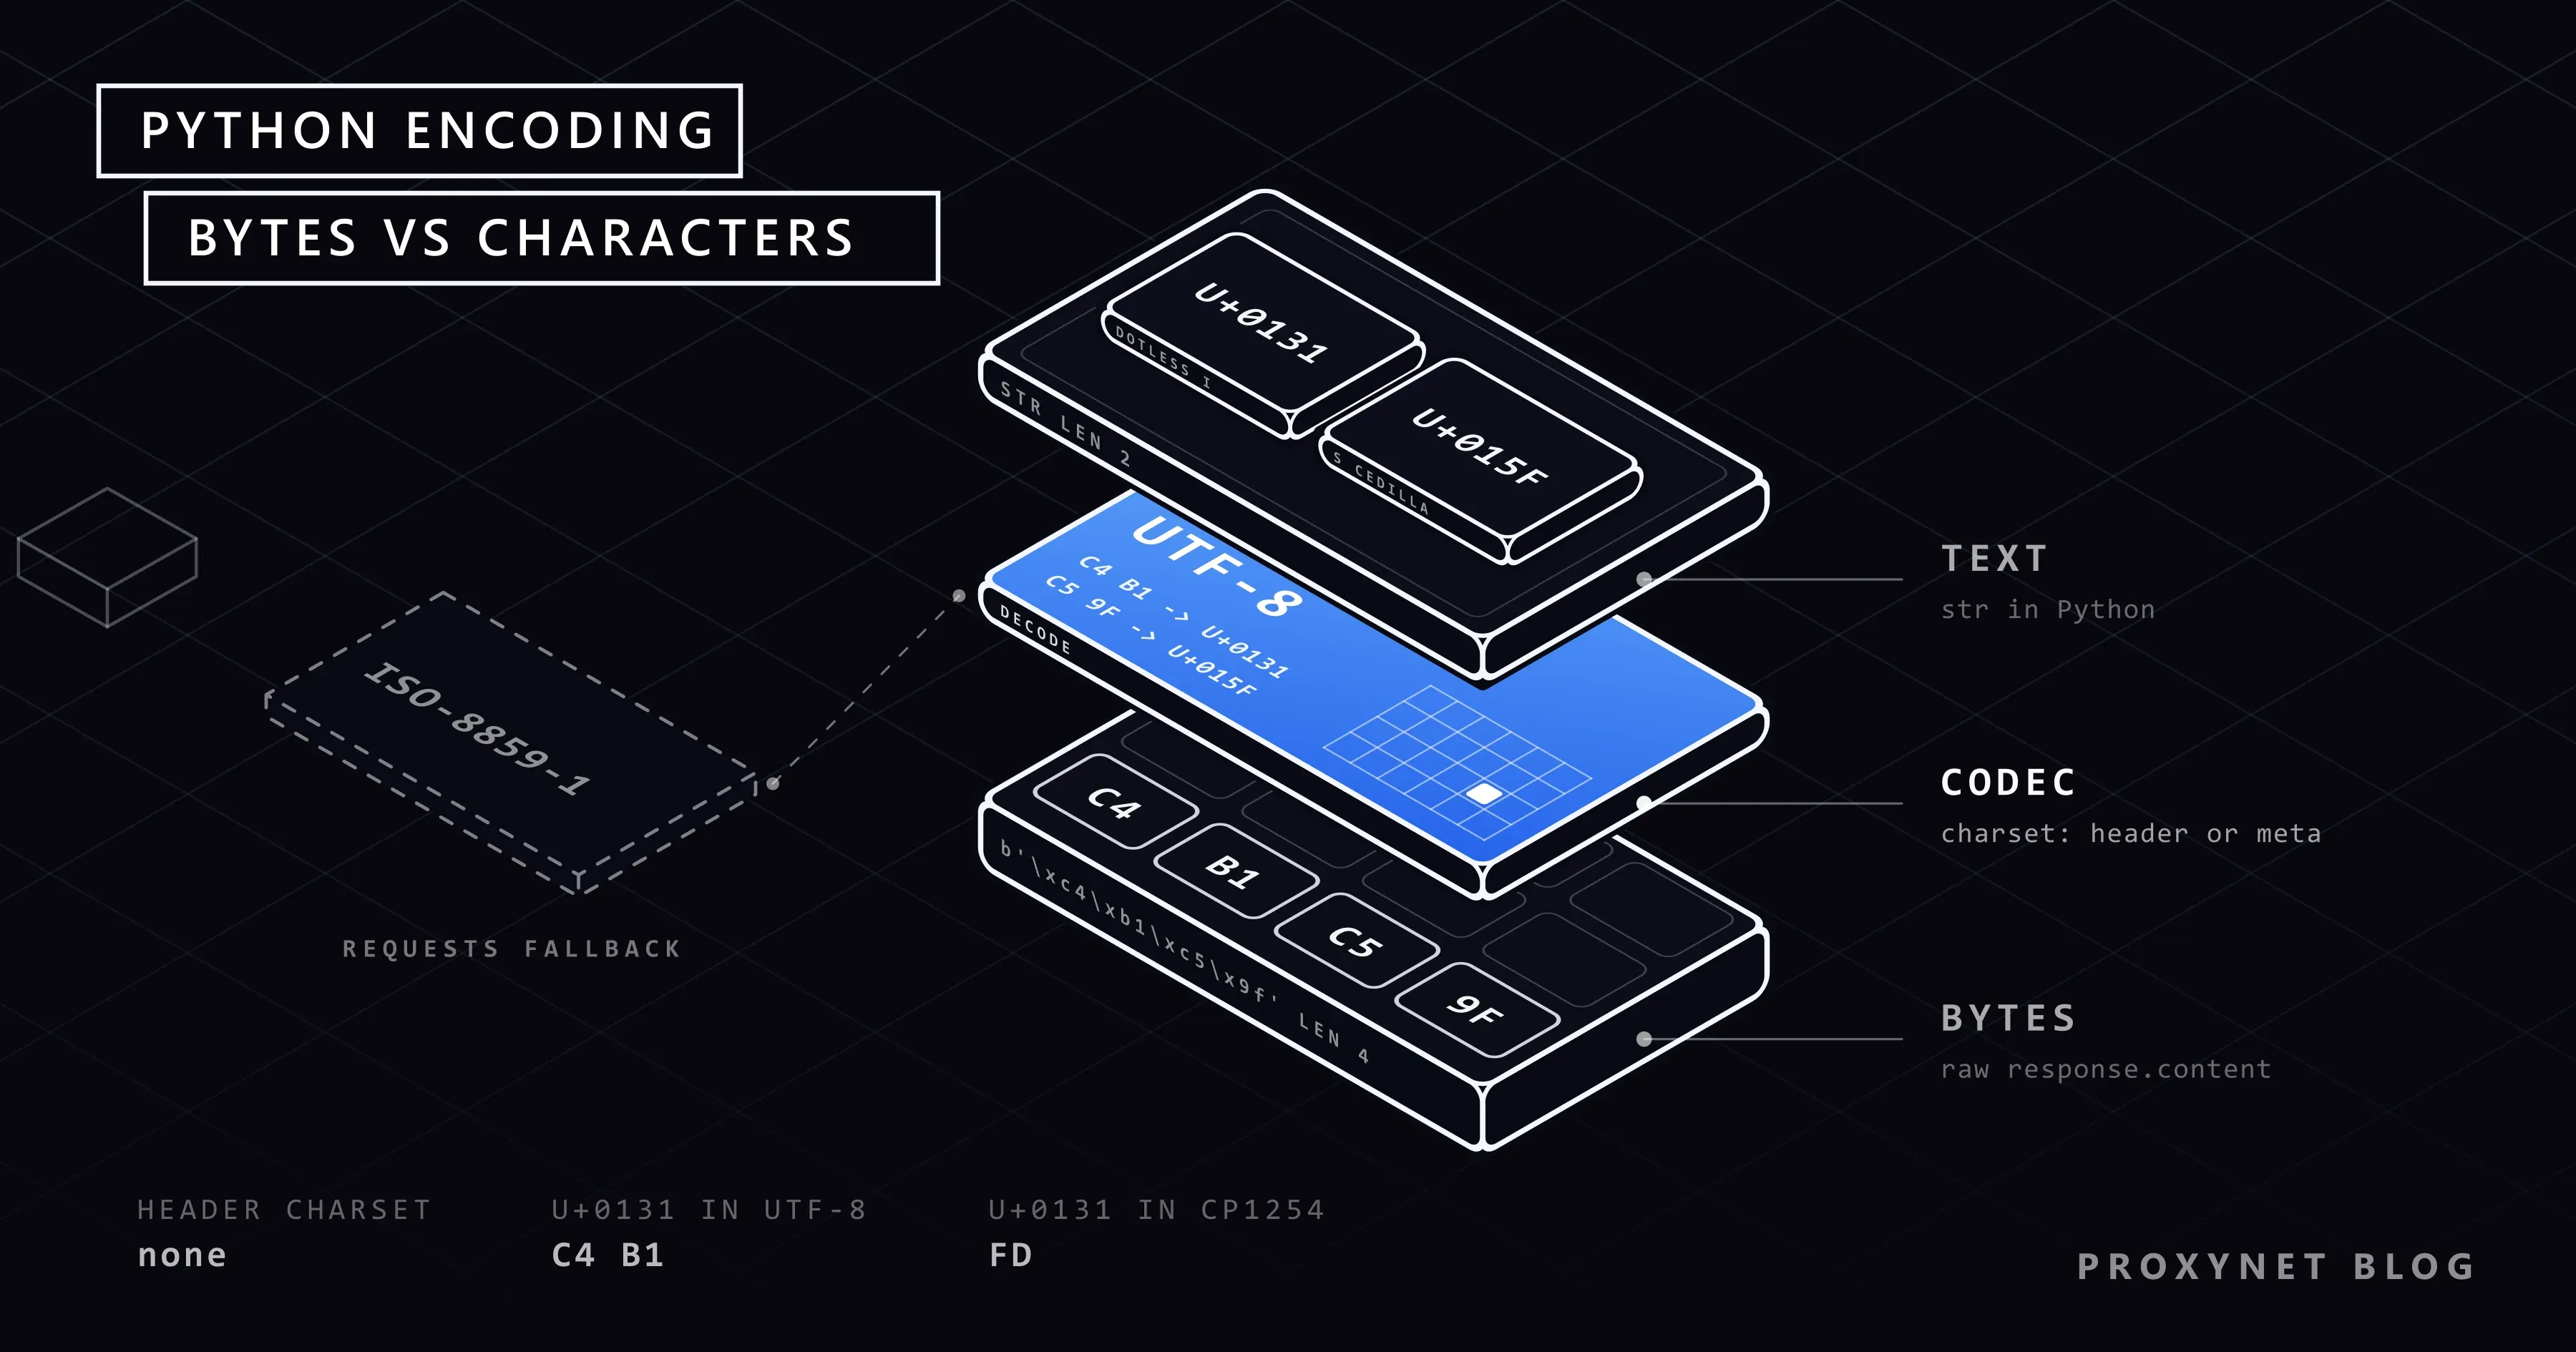
Un str contiene caracteres, cada uno con un punto de código Unicode: la ı turca sin punto es U+0131, é es U+00E9 y ñ es U+00F1. Los discos y las redes solo guardan bytes, así que el texto se codifica al salir y se decodifica al entrar. El códec decide qué bytes representan cada carácter. En UTF-8, ı ocupa dos bytes, C4 B1. En windows-1254, la antigua página de códigos turca de Windows, ocupa un byte, FD. Las páginas cp1252 e ISO-8859-1 de Europa occidental no tienen ı en absoluto.
Cuando quien escribe y quien lee usan códecs distintos, los bytes sobreviven pero las letras cambian. Esto se llama mojibake y a menudo se puede deshacer.
¿Cómo acaba un carácter convertido en otro?
Todo error de codificación sigue los mismos pasos:
- Tu texto es Unicode.
"Çankırı"en Python son siete puntos de código. - Se codifica con el códec A. Un Windows en turco escribe
C7 61 6E 6B FD 72 FDen cp1254. - Solo viajan los bytes. Un archivo, un cuerpo HTTP o una tubería no dicen nada del códec A, salvo que lo añada una cabecera, un BOM o una etiqueta
<meta>. - Alguien decodifica con el códec B. ISO-8859-1 asigna
FDaý, lo que daÇankýrý. UTF-8 no puede leerC7 61como un carácter, así que lanzaUnicodeDecodeError. - La salida se codifica otra vez.
print()ywrite()usan el códec de la consola o del archivo, y un carácter que ese códec no tiene lanzaUnicodeEncodeError.
El traceback te dice en qué dirección falló.
¿Qué te dice el texto corrupto?
La forma del daño señala la pareja de códecs.
| Lo que ves | Texto real | Qué pasó | Qué hacer |
|---|---|---|---|
café, año, ü, ı, ÅŸ | café, año, ü, ı, ş | Bytes UTF-8 (C3 A9, C3 B1, C4 B1) decodificados como cp1252 o ISO-8859-1 | Decodifica los bytes como UTF-8 o repara el texto (ver más abajo) |
ý, þ, ð, Ý | ı, ş, ğ, İ | Bytes windows-1254 (FD, FE, F0, DD) decodificados como ISO-8859-1, el valor por defecto de Requests | Fija r.encoding = "cp1254" o pasa r.content a Beautiful Soup |
ţ en lugar de ş | ş | Una estimación eligió windows-1250 para una página turca | Fija el códec para ese sitio |
� | Cualquier letra no ASCII | Bytes decodificados como UTF-8 con errors="replace" | Perdida en el texto; vuelve a decodificar los bytes originales |
? | Cualquier letra | Texto codificado con errors="replace" en un códec que no la tiene | Perdida; escribe en UTF-8 |
| Un recuadro vacío | La letra correcta | La fuente no tiene el glifo (PDF, terminal antigua) | Cambia la fuente, no la codificación |
¿Sigue haciendo falta # -*- coding: utf-8 -*- en Python 3?
No. PEP 3120 convirtió UTF-8 en la codificación por defecto de los archivos de código fuente en Python 3.0, así que esa línea es un resto de Python 2. Si las cadenas literales de tu archivo .py siguen rompiéndose, tu editor lo guardó en una página de códigos antigua («ANSI» en Windows); guárdalo como UTF-8. Otros consejos de la época de Python 2, como los prefijos u"" y codecs.open(), tampoco hacen falta.
¿Cómo se indica la codificación al leer y escribir archivos?
Indícala siempre: open("cities.txt", "w", encoding="utf-8"). Sin ella, Python 3.13 en Windows usa la página de códigos ANSI. En nuestro equipo con Windows en turco, locale.getpreferredencoding(False) devolvió cp1254, y un simple open("cities.txt", "w") escribió Çankırı como C7 61 6E 6B FD 72 FD. Windows en inglés o en español usa cp1252, que no tiene ı, así que la misma escritura falla con 'charmap' codec can't encode character '\u0131'.
Para los archivos que recibes, usa el códec con el que se escribieron: cp1254 para exportaciones antiguas de Windows y Excel en turco, cp1252 para las de Europa occidental (español incluido), cp1256 para árabe y persa. El argumento errors decide qué pasa con los bytes que no encajan:
strict, el valor por defecto, lanza un error, que es lo que quieres mientras buscas el códec correcto.replacepone�en lugar de cada byte erróneo, así ves dónde está el daño.backslashreplacemantiene visibles los bytes erróneos como\xfd.ignorelos borra sin avisar:Iğdırescrito en cp1254 y leído como UTF-8 se convirtió enIdr.
«Prueba con latin-1 y listo» falla de la misma manera. ISO-8859-1 asigna un carácter a cada uno de los 256 valores de byte, así que nunca lanza un error, y el texto turco se convierte en Çankýrý sin que nada avise.
UnicodeDecodeError: 'utf-8' codec can't decode byte
El archivo no es UTF-8, y el byte del mensaje es una pista: 0xfd, 0xfe o 0xf0 en datos turcos apuntan a cp1254, mientras que 0xe9 (é), 0xf1 (ñ) o 0xfc (ü) sugieren cp1252. En pandas, pasa el códec: pd.read_csv("export.csv", sep=";", encoding="cp1254").
UnicodeEncodeError: 'charmap' codec can't encode character en Windows
La consola interactiva de Windows escribe en UTF-8 desde Python 3.6 (PEP 528), pero la salida redirigida a un archivo o a una tubería usa la página de códigos ANSI. Las letras turcas caben en cp1254, una flecha no: python script.py > out.txt con print("Istanbul → Ankara") falló con 'charmap' codec can't encode character '\u2192'. Funcionaron tres soluciones:
set PYTHONUTF8=1($env:PYTHONUTF8=1en PowerShell) activa el modo UTF-8 para los archivos y los flujos estándar.python -X utf8 script.pyhace lo mismo para una sola ejecución.PYTHONIOENCODING=utf-8cambia solo los flujos estándar, noopen().
La guía de Python en Windows documenta el modo UTF-8. PEP 686 convierte el modo UTF-8 en el comportamiento por defecto desde Python 3.15, cuya versión final está prevista para el 1 de octubre de 2026. Mantén encoding="utf-8" en tu código hasta que todas las máquinas usen esa versión.
La variante 'latin-1' codec can't encode character suele venir de una cabecera HTTP. http.client, que Requests usa por debajo, codifica los valores de cabecera como Latin-1, así que un valor de cabecera Iğdır falló de esa forma. Aplica percent-encoding a esos valores o envíalos en el cuerpo.
¿De dónde sale la codificación de una página web?
Un navegador decide la codificación de una página en este orden:
- Una marca de orden de bytes (BOM) al principio del cuerpo.
- El parámetro
charsetde la cabeceraContent-Type. - Una etiqueta
<meta charset>, que según MDN debe estar en los primeros 1024 bytes. - Una estimación a partir de los bytes.
Requests solo lee la cabecera. Para un tipo text/* sin charset, la documentación de Requests dice que sigue RFC 2616 y usa ISO-8859-1, aunque RFC 7231 eliminó ese valor por defecto en 2014. Una respuesta JSON sin charset se lee como UTF-8, y en los demás tipos se hace una estimación. En nuestras páginas de prueba servidas como text/html sin más, r.encoding fue ISO-8859-1 todas las veces. Por eso una página puede verse bien en el navegador y mal en tu script.
¿Son iguales windows-1254 e ISO-8859-9?
Casi. Las dos colocan las letras turcas en los mismos bytes, de 0xA0 a 0xFF. De 0x80 a 0x9F, windows-1254 tiene €, “, ” y …, mientras que ISO-8859-9 tiene códigos de control invisibles. El WHATWG Encoding Standard indica a los navegadores que lean iso-8859-9 como windows-1254 e iso-8859-1 como windows-1252; Python los trata como códecs separados. En nuestra página etiquetada como iso-8859-9, Beautiful Soup produjo \x93Kampanya\x94 10\x80, y con from_encoding="cp1254" los mismos bytes se convirtieron en “Kampanya” 10€. Decodifica esas páginas como cp1254 o cp1252.
¿Cómo debe declarar el charset tu propia página HTML?
Guarda el archivo como UTF-8, pon <meta charset="utf-8"> al principio de <head> y asegúrate de que la cabecera Content-Type del servidor no indique otro charset, porque la cabecera tiene prioridad.
¿response.encoding, apparent_encoding o Beautiful Soup?
Cada opción lee una señal distinta:
r.encodingsale de la cabecera. Fijarr.encoding = "cp1254"arregla un sitio concreto; fijar"utf-8"para todos los sitios rompe los que usan windows-1254 (�ank�r�en nuestra página de prueba).r.apparent_encodinges la estimación de charset-normalizer a partir del cuerpo. DijoWindows-1254para una de nuestras páginas turcas ywindows-1250para otras dos, lo que convierteşenţ.BeautifulSoup(r.content, "html.parser")lee la etiqueta<meta>por su cuenta. Pasa bytes, nor.text; el tutorial de Beautiful Soup cubre la parte del análisis del HTML.
Nuestro orden sigue al navegador: un BOM, un charset en la cabecera, la etiqueta <meta> y después la estimación, y deja en el log cuál usaste. HTTPX funciona de otra manera: la versión 0.28.1 supone UTF-8 cuando la cabecera no trae charset, y nuestra página cp1254 salió como �ank�r� (HTTPX, Requests y AIOHTTP).
Un scraper en Python que decodifica las páginas como un navegador
El script descarga cada URL una vez, elige el códec en ese orden, trata las etiquetas ISO como lo hacen los navegadores y escribe los encabezados en un CSV para Excel. Necesita pip install requests beautifulsoup4. No reintenta ni rota IP; para eso consulta Códigos de estado HTTP en web scraping y cómo rotar proxies en Python.
"""Descarga páginas, decodifica cada una como lo haría un navegador y guarda los encabezados en un CSV para Excel."""
import csv
import logging
import sys
from email.message import Message

import requests
from bs4 import BeautifulSoup
from bs4.dammit import EncodingDetector

PROXY = None  # por ejemplo "http://user:pass@pr.proxynet.io:8000"
USER_AGENT = "heading-reader/1.0 (+https://example.com/bot)"

# Los navegadores leen estas etiquetas como páginas de códigos de Windows (WHATWG Encoding Standard); Python no.
BROWSER_ALIASES = {
    "iso-8859-1": "cp1252", "iso8859-1": "cp1252", "latin1": "cp1252", "latin-1": "cp1252",
    "us-ascii": "cp1252", "ascii": "cp1252",
    "iso-8859-9": "cp1254", "iso8859-9": "cp1254", "latin5": "cp1254",
}

log = logging.getLogger("headings")


def header_charset(resp):
    """El charset de la cabecera Content-Type, o None. El r.encoding de Requests
    diría aquí ISO-8859-1 para cualquier tipo text/* sin charset."""
    msg = Message()
    msg["content-type"] = resp.headers.get("Content-Type", "")
    return msg.get_param("charset")


def pick_codec(resp):
    """Devuelve (códec, de dónde sale): un BOM, la cabecera, <meta charset> y, por último, una estimación."""
    bom = EncodingDetector.strip_byte_order_mark(resp.content)[1]
    if bom:
        return bom, "bom"
    declared = header_charset(resp)
    source = "header"
    if not declared:
        declared = EncodingDetector.find_declared_encoding(resp.content, is_html=True)
        source = "meta"
    if not declared:
        return resp.apparent_encoding or "utf-8", "guess"
    return BROWSER_ALIASES.get(declared.lower(), declared), source


def clean(text):
    """Junta los espacios seguidos en uno, incluido el espacio de no separación U+00A0."""
    return " ".join(text.split())


def read_headings(session, url):
    resp = session.get(url, timeout=20)
    resp.raise_for_status()
    codec, source = pick_codec(resp)
    soup = BeautifulSoup(resp.content, "html.parser", from_encoding=codec)
    level = logging.WARNING if source == "guess" else logging.INFO
    log.log(level, "%s: %s from %s", url, codec, source)
    if soup.contains_replacement_characters:
        log.warning("%s: some bytes did not fit %s and became U+FFFD", url, codec)
    return [(url, codec, source, clean(h.get_text())) for h in soup.select("h1, h2")]


def main(urls, out="headings.csv"):
    session = requests.Session()
    session.headers["User-Agent"] = USER_AGENT
    if PROXY:
        session.proxies = {"http": PROXY, "https": PROXY}
    rows = []
    for url in urls:
        try:
            rows += read_headings(session, url)
        except requests.RequestException as exc:
            log.error("%s: %s", url, exc)
    # utf-8-sig escribe primero un BOM, así Excel reconoce el archivo como UTF-8
    with open(out, "w", newline="", encoding="utf-8-sig") as f:
        writer = csv.writer(f)
        writer.writerow(["url", "codec", "source", "heading"])
        writer.writerows(rows)
    log.info("%d headings written to %s", len(rows), out)


if __name__ == "__main__":
    logging.basicConfig(level=logging.INFO, format="%(levelname)-7s %(message)s")
    main(sys.argv[1:] or ["https://example.com/"])
Lo ejecutamos con Python 3.13, Requests 2.34.2 y Beautiful Soup 4.15.0 a través de un proxy HTTP local. Las páginas de prueba locales se sirvieron como text/html sin charset, salvo utf8hdr, y la última URL es una página pública:
INFO    http://127.0.0.1:8057/cp1254: windows-1254 from meta
INFO    http://127.0.0.1:8057/iso9: cp1254 from meta
INFO    http://127.0.0.1:8057/utf8meta: utf-8 from meta
INFO    http://127.0.0.1:8057/utf8hdr: utf-8 from header
INFO    http://127.0.0.1:8057/latin1: cp1252 from meta
WARNING http://127.0.0.1:8057/nometa: windows-1250 from guess
WARNING https://example.com/: ascii from guess
INFO    12 headings written to headings.csv
Todas las páginas con charset en la cabecera o con etiqueta <meta> salieron bien, incluido “quoted” 5€ en la página etiquetada como ISO-8859-1. La página sin ninguna de las dos es el punto débil: la estimación dijo windows-1250 y el CSV recibió Çankýrý y ţubat.
Si lees con regularidad muchos sitios de un mismo país, un Proxies residenciales en ese país te devuelve las páginas que ven los visitantes locales; la lógica del códec no cambia.
¿Qué significan «can't decode byte 0x8b» y «0xa0»?
UnicodeDecodeError: 'utf-8' codec can't decode byte 0x8b in position 1
Un flujo gzip empieza por 1F 8B (RFC 1952), así que 0x8b en la posición 1 significa que se están decodificando datos comprimidos como texto; gzip.compress(...).decode("utf-8") nos dio exactamente este mensaje. En el scraping ocurre cuando lees r.raw directamente, o cuando envías una cabecera Accept-Encoding copiada con urllib.request, que nunca descomprime. Requests descomprime gzip por sí solo, así que quita la cabecera copiada y usa r.content. Los valores br o zstd copiados también fallan, salvo que urllib3 tenga instalado el paquete opcional Brotli o Zstandard.
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xa0
En cp1252, cp1254 e ISO-8859-1, el espacio de no separación U+00A0 es el byte único A0, y UTF-8 nunca empieza un carácter con ese byte. Lee el archivo con su códec real. Si el carácter ya está en tu texto, "10\xa0kg".split() lo elimina, .split(" ") no, y unicodedata.normalize("NFKC", s) lo convierte en un espacio normal (NFKC también cambia caracteres como ² por 2).
¿Cómo se repara un texto que ya está corrupto?
Si no se perdió ningún byte, deshaz el paso equivocado:
- Texto como
ışğcopiado de una pantalla o de una hoja de cálculo:s.encode("cp1252").decode("utf-8")daışğ. - El mismo daño en el
r.textde Requests esconde un carácter de control (\x9f) que cp1252 no puede codificar, así que usas.encode("latin-1").decode("utf-8"). Con cp1252 falló con'charmap' codec can't encode character '\x9f'. - Texto windows-1254 leído como ISO-8859-1, como
Çankýrý:s.encode("latin-1").decode("cp1254")daÇankırı.
Para datos grandes o mezclados, ftfy 6.3.1 repara el mojibake de UTF-8: ftfy.fix_text("ışğ") devolvió ışğ. Dejó Çankýrý tal cual porque parece texto latino válido, así que las confusiones entre páginas de códigos se arreglan a mano. El texto con ? o � en lugar de letras no se puede reparar; vuelve a descargar el original.
¿Por qué Excel muestra caracteres raros en un CSV UTF-8?
Excel abre bien un CSV UTF-8 con doble clic cuando el archivo empieza con una marca de orden de bytes, como indica la página de soporte de Microsoft. encoding="utf-8-sig" añade los tres bytes EF BB BF; en pandas, df.to_csv("out.csv", encoding="utf-8-sig"). Lee también esos archivos con utf-8-sig: con utf-8 a secas, el módulo csv nos dio una primera columna llamada \ufeffşehir, mientras que pandas quitó el BOM en los dos casos. Un flujo completo del scraping a Excel está en cómo extraer datos de un sitio web.
¿Por qué "I".lower() no devuelve "ı"?
str.lower() usa la correspondencia por defecto de Unicode, que no tiene en cuenta el idioma. Para el turco eso falla dos veces: "ISPARTA".lower() devuelve isparta en lugar de ısparta, y "İ".lower() devuelve i más un punto combinante (U+0307). casefold() tiene el mismo hueco. Convierte primero las dos letras especiales:
TR_LOWER = str.maketrans({"I": "ı", "İ": "i"})
TR_UPPER = str.maketrans({"i": "İ", "ı": "I"})

print("ISPARTA İZMİR".translate(TR_LOWER).lower())  # ısparta izmir
print("istanbul ışık".translate(TR_UPPER).upper())  # İSTANBUL IŞIK
Los números y las fechas también siguen reglas locales. Un precio turco o español como 1.299,90 se convierte en float tras s.replace(".", "").replace(",", "."), y pandas tiene decimal="," y thousands=".". Evita locale.setlocale() en un scraper, porque cambia todo el proceso. La limpieza completa de precios está en seguimiento de precios de la competencia.
Casos de uso
- Seguimiento de precios: tiendas que aún sirven páginas de códigos antiguas (seguimiento de precios de la competencia).
- Tablas a Excel: un CSV que se abre con las letras correctas (extraer datos de un sitio web).
- Scrapers en PHP:
DOMDocumenttiene su propia solución (web scraping con PHP). - Exportaciones de Scrapy:
FEED_EXPORT_ENCODINGfija el códec de salida (Scrapy con un proxy). - Trabajos en .NET:
HttpClientgestiona los charsets a su manera (web scraping con C#). - Rastreos de muchos sitios: registra el códec de cada página (rastreador web).
Errores comunes
- Silenciar el error con
errors="ignore"o latin-1. El script funciona y las letras desaparecen o cambian. - Fijar
r.encoding = "utf-8"para todos los sitios. Arregla algunas páginas y rompe las de windows-1254. - Decodificar dos veces. Llamar a
.encode().decode()sobre un texto que ya se decodificó bien añade un error nuevo a un texto correcto. - Usar
iso-8859-9oiso-8859-1tal como vienen declarados. Los navegadores usan windows-1254 y windows-1252, y las comillas y el signo del euro muestran la diferencia. - Leer un archivo
utf-8-sigcomoutf-8. El nombre de la primera columna empieza con un carácter invisible y las búsquedas fallan. - Confundir la codificación de caracteres con la codificación de URL.
%40en una contraseña de proxy es percent-encoding, un tema aparte (caracteres especiales en contraseñas de proxy).
Guía de decisión
| Necesidad | Recomendación |
|---|---|
Texto no ASCII en tu propio archivo .py | Guárdalo como UTF-8; sin línea de coding |
| Leer o escribir un archivo | encoding="utf-8"; una página de códigos antigua solo para archivos escritos con ella |
Error 'charmap' en la salida redirigida en Windows | PYTHONUTF8=1 o python -X utf8; por defecto desde Python 3.15 |
| HTML sin charset en la cabecera | Pasa r.content a Beautiful Soup y registra el códec |
Sin charset en la cabecera ni etiqueta <meta> | Fija el códec del sitio; apparent_encoding como último recurso |
La página dice iso-8859-9 o iso-8859-1 | Decodifica como cp1254 o cp1252, como un navegador |
El texto ya muestra é o ı | .encode("cp1252").decode("utf-8") o ftfy.fix_text |
| El resultado se abre en Excel | Escribe el CSV con utf-8-sig |
Preguntas frecuentes
¿Necesito una biblioteca para manejar tildes y ñ en Python?
No. Un str de Python 3 es Unicode, y la biblioteca estándar incluye códecs para las páginas de códigos habituales (codificaciones estándar). charset-normalizer, que se instala con Requests, estima los códecs desconocidos, y ftfy repara el mojibake.
¿Cómo convierto un archivo cp1252 o cp1254 a UTF-8?
Léelo con su códec antiguo y escríbelo con el nuevo: Path("new.txt").write_text(Path("old.txt").read_text(encoding="cp1254"), encoding="utf-8"), con Path de pathlib. Revisa algunos nombres antes de borrar el original.
¿Arregla errors="ignore" un UnicodeDecodeError?
Lo esconde. Los bytes que no encajan se borran sin aviso, así que los nombres pierden letras. Busca el códec correcto.
¿Cómo averiguo qué codificación usa un archivo?
Salvo que empiece con un BOM, un archivo de texto no registra su códec, así que toda herramienta hace una estimación. charset_normalizer.from_path("old.txt").best().encoding devolvió cp1254 para nuestro archivo de prueba en turco. Confirma la estimación decodificando el archivo y leyendo algunas palabras que contengan letras locales.
¿Qué diferencia hay entre utf-8 y utf-8-sig?
utf-8-sig escribe un BOM (EF BB BF) y lo salta al leer. Úsalo para los archivos CSV que la gente abre en Excel.
¿Cómo arreglo UnicodeDecodeError en pandas read_csv?
Pasa el códec del archivo: encoding="cp1254" para una exportación de Windows en turco, cp1252 para una de Europa occidental, utf-8-sig si tiene BOM. encoding_errors="replace" detiene el error, pero pierde letras.
En resumen
Los errores de codificación en Python se reducen a una regla: decodifica los bytes con el códec con el que se escribieron y escribe tu propia salida en UTF-8. Lee el texto corrupto para encontrar la pareja de códecs, indica encoding en cada open(), usa el modo UTF-8 en Windows hasta que Python 3.15 lo haga por ti y pasa las páginas web a Beautiful Soup como bytes. Para trabajos de scraping que necesitan texto limpio de muchos sitios locales, consulta nuestra solución de extracción de datos.


