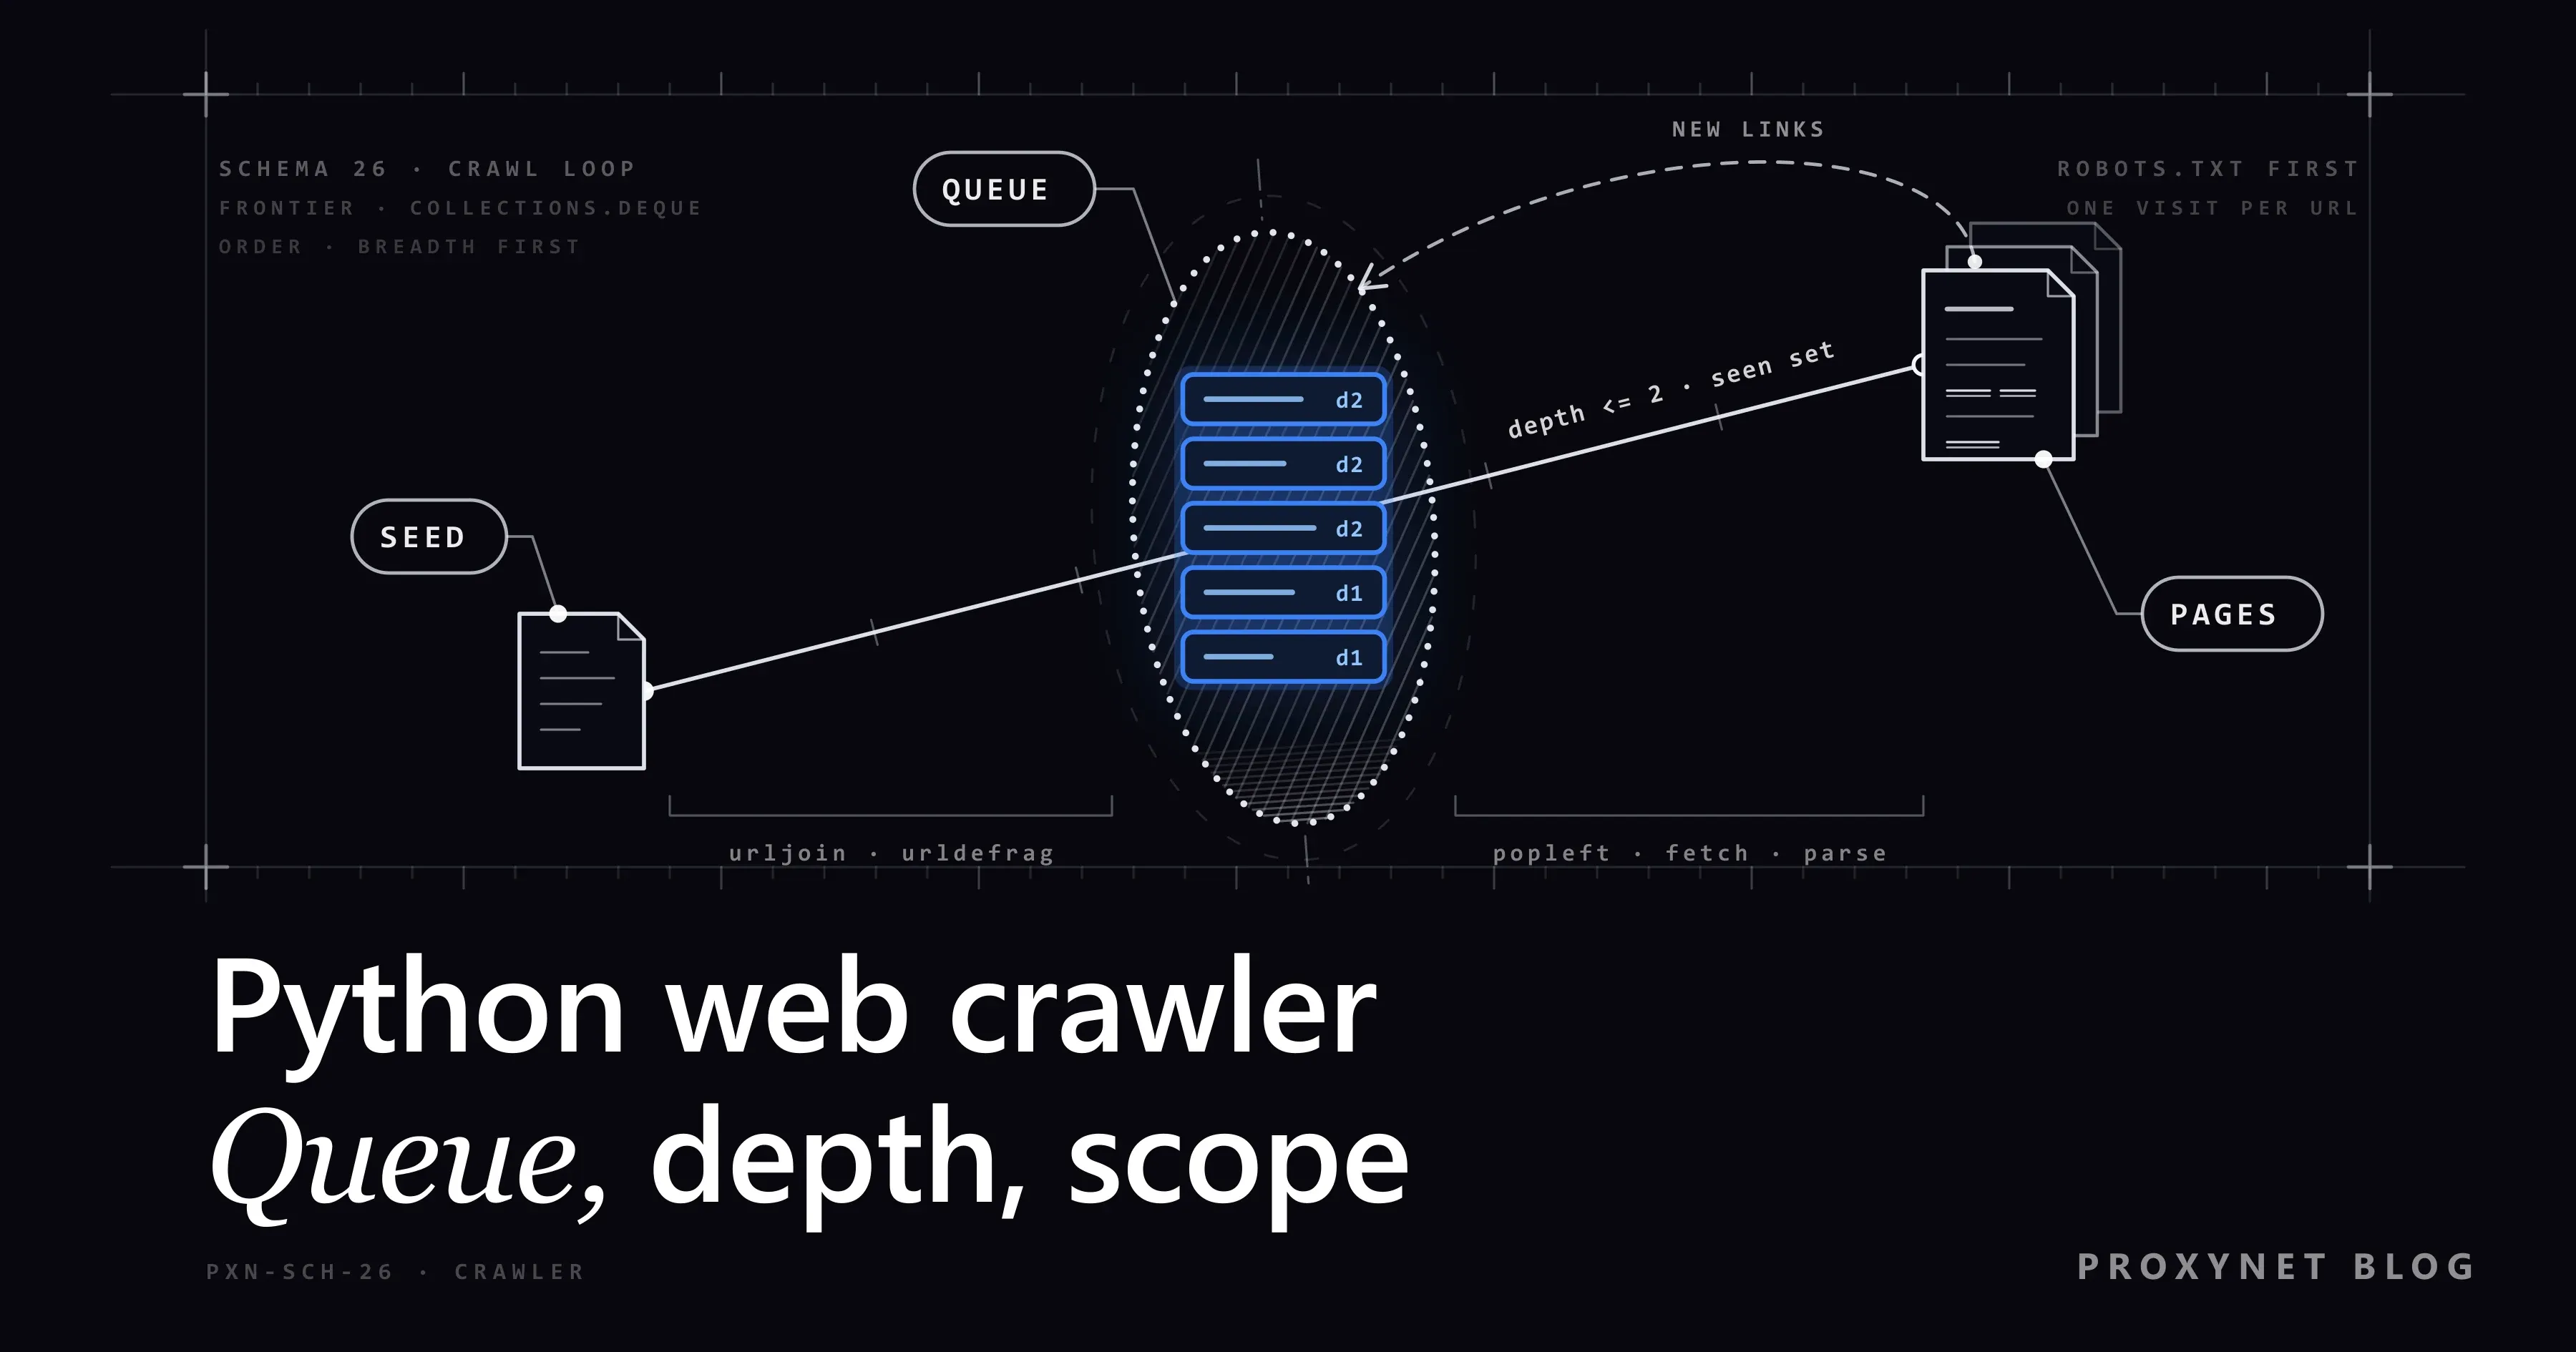
فرض کنید فهرست همه صفحههای دستهبندی و محصول یک کتابفروشی اینترنتی را لازم دارید که نقشه سایت ندارد. هدف آزمایشی ما books.toscrape.com است، سایتی که برای تمرین اسکرپینگ ساخته شده. خزندهای که هر پیوندی را دنبال کند و به خاطر نسپارد کجا بوده، اینجا هرگز به پایان نمیرسد: بیشتر پیوندها به صفحههایی برمیگردند که پیشتر دیده است. در اندازهگیری ما، از 4,098 پیوند در 60 صفحه نخست، 3,515 پیوند به نشانیهایی اشاره میکردند که خزنده از قبل میشناخت و هنوز 524 نشانی تازه در صف منتظر بودند.
در ادامه با Requests و BeautifulSoup و بدون هیچ فریمورکی یک خزنده میسازیم: صف، مجموعه دیدهشدهها، نرمالسازی نشانی، محدوده، محدودیت عمق، robots.txt، مکث میان درخواستها و خروجی JSON Lines. اینکه خزنده چیست و چه تفاوتی با اسکرپر دارد، در صفحه خزنده وب و در نوشته وب اسکرپینگ و خزش وب آمده است. همه اعداد از اجرای اسکریپت نهایی در 25 سپتامبر 2026 به دست آمدهاند.
خزنده وب پایتون به چه بخشهایی نیاز دارد؟
شش بخش، که هرکدام چند سطر پایتون است:
- صف مرزی (frontier): صف نشانیهایی که هنوز باید دیده شوند، یک
collections.deque. - مجموعه دیدهشدهها (seen set): همه نشانیهایی که خزنده تا این لحظه به آنها برخورده است.
- دریافتکننده (fetcher): یک
requests.Sessionبا مهلت زمانی (timeout) و یکUser-Agentصادق که نام ربات و راه تماس را میگوید (User-Agent چیست؟). - استخراجکننده پیوند:
select("a[href]"). خواندن بقیه صفحه کار اسکرپر است (BeautifulSoup چیست). - فیلتر محدوده: میزبان، طرح نشانی (scheme) و نوع محتوا تعیین میکنند چه چیزی به حساب بیاید.
- خروجی: برای هر صفحه یک شیء JSON در یک فایل
.jsonl.
از Requests 2.34.2 و Beautiful Soup 4.15.0 استفاده میکنیم که در 25 سپتامبر 2026 نسخههای جاری PyPI هستند؛ Requests به Python 3.10 یا جدیدتر نیاز دارد. Scrapy هر شش بخش را آماده دارد.
حلقه خزش گامبهگام چگونه کار میکند؟
- بذر (seed). نشانی آغازین را نرمالسازی کنید،
(url, 0)را در صف و خود نشانی را در مجموعه دیدهشدهها بگذارید. - برداشتن. قدیمیترین ورودی را با
popleft()بردارید. - پرسیدن از robots.txt. قواعد میزبان را از حافظه نهان (cache) بخوانید و فقط یک بار دریافتشان کنید.
- صبر، سپس دریافت. فاصله میان درخواستها را برای هر میزبان جدا نگه دارید، بعد درخواست GET بفرستید.
- بررسی پاسخ. نشانی نهایی پس از تغییر مسیرها (redirect) و هدر
Content-Typeرا بخوانید. - استخراج و فیلتر. هر
hrefرا باurljoinبه نشانی کامل برسانید، نرمالسازی کنید و هرچه دیدهشده، بیرون از سایت یا بیش از حد عمیق است را کنار بگذارید. - ثبت و افزودن به صف. یک سطر JSON بنویسید و نشانیهای تازه را با
depth + 1به صف اضافه کنید.
حلقه وقتی تمام میشود که صف خالی شود یا تعداد صفحهها به سقف برسد.
کدام بخش جلوی کدام مشکل را میگیرد؟
| بخش | جلوی چه چیزی را میگیرد | در پایتون | بدون آن |
|---|---|---|---|
| مجموعه دیدهشدهها، پرشده هنگام ورود به صف | دریافت دوباره یک صفحه | set، افزودن هنگام ورود به صف | 3,515 پیوند آشنا در اجرای books ما دوباره دریافت میشدند |
| محدودیت عمق و سقف صفحه | زنجیرههای بیپایان مثل تقویمها و فیلترها | (url, depth)، --depth، --max-pages | صفی که مدام بزرگتر میشود (524 نشانی منتظر پس از 60 صفحه) |
| نرمالسازی نشانی | یک صفحه با چند نگارش | urldefrag، urlsplit، parse_qsl | همان صفحه بیش از یک بار دریافت و ذخیره میشود |
| بررسی تغییر مسیر و نوع محتوا | لغزیدن به سایتی دیگر، تجزیه PDF بهجای HTML | r.url، Content-Type، stream=True | پیوندهای صفحههای سایتهای دیگر وارد صف میشوند |
| حافظه نهان robots.txt و مکث برای هر میزبان | مسیرهای ممنوع، رگبار درخواستها | RobotFileParser.parse()، time.monotonic() | سایت با 429 پاسخ میدهد |
چرا صف باید deque باشد و نه list؟
deque.popleft() قدیمیترین نشانی را برمیدارد، پس خزش به شیوه سطحاول (BFS) پیش میرود: اول صفحه آغازین، بعد صفحههایی که یک کلیک فاصله دارند، بعد دو کلیک. صفحههای نزدیک به صفحه اصلی زودتر میرسند و محدودیت عمق معنا پیدا میکند، چون عمق به ترتیب بالا میرود. برداشتن با pop() از همان سری که به آن اضافه میکنید، خزش را عمقاول (DFS) میکند: یک شاخه تا ته، بعد شاخه بعدی.
لیست پایتون هم میتواند نقش صف را بازی کند، اما pop(0) همه عناصر باقیمانده را جابهجا میکند (O(n))، در حالی که deque از هر دو سر تقریباً در زمان ثابت برمیدارد (مستندات collections). خزندههای بازگشتی در واقع همان DFS با ظاهری دیگرند و ممکن است با رسیدن به حد پیشفرض پایتون، یعنی 1,000 فراخوانی تودرتو، با RecursionError متوقف شوند.
BFS همچنین هر نشانی را نخستین بار در کمترین عمقش میبیند، پس پیوندی که در همان برخورد اول بیش از حد عمیق است میتواند دیدهشده علامت بخورد و کنار گذاشته شود.
نرمالسازی نشانی را چگونه در کد بنویسیم؟
مجموعه دیدهشدهها رشتهها را با هم مقایسه میکند، پس normalize() به هر صفحه یک نگارش واحد میدهد:
urldefrag()بخش#reviewsرا حذف میکند. طبق بخش 3.5 از RFC 3986، قطعه نشانی (fragment) هرگز به سرور نمیرسد.- طرح نشانی و میزبان به حروف کوچک تبدیل میشوند؛
urlsplit().hostnameاز قبل کوچک است. - پورتهای پیشفرض (
:80برای http و:443برای https) حذف میشوند و مسیر خالی به/تبدیل میشود؛ بخش 6.2.3 همان RFC این دو را همارز میداند. - پارامترهای ردیابی (
utm_*،gclid،fbclid) حذف و بقیه مرتب میشوند، تا?b=2&a=1و?a=1&b=2یکی شوند. - پیوندهای
mailto:،tel:وjavascript:و پورتهای خراب مقدارNoneبرمیگردانند.
هرگز کل رشته پرسوجو (query string) را پاک نکنید: ?page=2 صفحه دیگری است. اسلش پایانی هم میماند، چون /a و /a/ ممکن است با هم فرق کنند؛ اگر فرقی نداشته باشند، تغییر مسیر خودش این را به شما میگوید. در books.toscrape.com نشانیهای / و /index.html یک صفحه را نشان میدادند و فقط قاعدهای مخصوص همان سایت میتوانست آن دو را یکی کند.
مجموعه دیدهشدهها طرح نشانی را هم نادیده میگیرد. در quotes.toscrape.com صفحههای نویسنده از https به http تغییر مسیر میدهند و پیوندهای نسبیشان پس از آن به http://quotes.toscrape.com/ اشاره میکنند؛ به همین دلیل نخستین اجرای آزمایشی ما صفحه اصلی و صفحه ورود را دو بار دریافت کرد. page_key() طرح نشانی را کنار میگذارد، پس هر دو نگارش یک صفحه به حساب میآیند.
سایتهای تمرینی نه قطعه نشانی دارند و نه برچسب ردیابی، پس این بررسیها با ورودی ساختگی انجام میشوند:
from crawler import normalize

assert normalize("https://Example.COM:443/a#reviews") == "https://example.com/a"
assert normalize("http://example.com") == "http://example.com/"
assert normalize("https://example.com:8443/a") == "https://example.com:8443/a"
assert normalize("https://example.com/list?b=2&a=1") == "https://example.com/list?a=1&b=2"
assert normalize("https://example.com/list?utm_source=mail&page=2") == "https://example.com/list?page=2"
assert normalize("mailto:shop@example.com") is None
assert normalize("javascript:void(0)") is None
assert normalize("https://example.com:abc/") is None
assert normalize("https://example.com/a/") != normalize("https://example.com/a")
print("all normalize checks passed")
محدوده: همان میزبان، تغییر مسیرها و نوع محتوا
self.hosts فقط میزبان آغازین را نگه میدارد. اگر سایتی هم www.example.com و هم example.com را به کار میبرد، هر دو را دستی اضافه کنید؛ بررسیای مثل endswith("example.com") نشانی notexample.com را هم راه میدهد.
Requests برای همه متدها به جز HEAD تغییر مسیرها را دنبال میکند و نشانی نهایی را در r.url نگه میدارد (راهنمای شروع سریع Requests)، پس محدوده را روی r.url بررسی کنید و پیوندهای نسبی را هم نسبت به همان حل کنید. در quotes.toscrape.com نشانی /author/Jane-Austen به http://quotes.toscrape.com/author/Jane-Austen/ تغییر مسیر میدهد؛ در اجرای ما با عمق 2، از 149 صفحه 40 صفحه اینطور رسیدند. تغییر مسیری که به بیرون از سایت برود کنار گذاشته میشود، اما Requests مقصد را پیشتر دریافت کرده است. اگر نمیخواهید حتی همین درخواست فرستاده شود، allow_redirects=False بدهید و هدر Location را خودتان در صف بگذارید.
با stream=True، Requests به محض رسیدن هدرها پاسخ را برمیگرداند. اگر Content-Type از نوع text/html نباشد، اتصال بدون خواندن بدنه بسته میشود.
محدودیت عمق و سقف صفحه را چگونه تعیین کنیم؟
ورودیهای صف به شکل (url, depth, attempts) هستند. پیوندی که depth + 1 آن از --depth بگذرد، too_deep شمرده میشود و بیرون میماند؛ --max-pages اجرا را بیتوجه به آنچه در صف است تمام میکند. روی سایتهای تمرینی:
quotes.toscrape.com، عمق 2، سقف 500: صف پس از 149 صفحه خودبهخود خالی شد (به تفکیک عمق 1، 46 و 102)؛ 30 نشانی بیش از حد عمیق بودند.- همان سایت، سقف 60: اجرا در 60 صفحه متوقف شد و 89 نشانی هنوز در صف بودند.
books.toscrape.com، عمق 2، سقف 60: هر 60 صفحه از عمقهای 0 و 1 آمدند و 524 نشانی منتظر ماندند. این اجرا را سقف صفحه تمام کرد، نه عمق.
عمق را از روی ساختار سایت انتخاب کنید (صفحه اصلی، دسته، کالا یعنی عمق 2؛ هر صفحه بعدی فهرست یک سطح به عمق اضافه میکند) و سقف را از روی بودجهتان. پیوندهایی که برای به دام انداختن رباتها کاشته میشوند در نوشته تلههای هانیپات آمدهاند.
robots.txt و مکثها: نسخه کوتاه
خزنده برای هر ترکیب طرح نشانی و میزبان یک RobotFileParser نگه میدارد، robots.txt را با نشست خودش (مهلت زمانی، User-Agent ربات، پروکسی) دانلود میکند و سطرها را به parse() میدهد. از read() استفاده نمیکنیم: در Python 3.13.9 این متد از urllib بدون مهلت زمانی و با User-Agent خود urllib استفاده میکند و در خطاهای شبکه استثنا میدهد. پاسخ 5xx یا فایلی که در دسترس نیست یعنی هیچ صفحهای خزش نشود، همانطور که RFC 9309 میخواهد؛ پاسخ 4xx یعنی قاعدهای در کار نیست (هر دو سایت تمرینی 404 برگرداندند). نحو فایل: فایل robots.txt چیست.
پیش از هر درخواست، خزنده مطمئن میشود که از آخرین درخواستش به آن میزبان، --delay (بهطور پیشفرض 1 ثانیه) یا Crawl-delay سایت، هرکدام که بیشتر است، گذشته باشد. با Crawl-delay: 2 روی یک سایت آزمایشی محلی و --delay 0.2، سرور فاصلههای 2 ثانیهای ثبت کرد. با دیدن 429، خزنده آن میزبان را متوقف میکند و مقدار Retry-After را چاپ میکند. تلاش دوباره به شکل درست در نوشته کدهای وضعیت HTTP در وب اسکرپینگ آمده و همین بررسیها همراه با صف SQLite در صفحهبندی در وب اسکرپینگ.
کد کامل: خزنده وب پایتون بدون فریمورک
دو کتابخانه را در یک محیط مجازی نصب کنید، اسکریپت را با نام crawler.py ذخیره کنید و یک نشانی آغازین به آن بدهید:
pip install requests==2.34.2 beautifulsoup4==4.15.0
python crawler.py https://books.toscrape.com/ --depth 2 --max-pages 60"""A breadth-first crawler for one site: Requests + BeautifulSoup, no framework."""
import argparse
import json
import time
from collections import Counter, deque
from urllib.parse import parse_qsl, urldefrag, urlencode, urljoin, urlsplit, urlunsplit
from urllib.robotparser import RobotFileParser
import requests
from bs4 import BeautifulSoup
BOT_NAME = "ExampleSiteMapper"
USER_AGENT = f"{BOT_NAME}/1.0 (+https://example.com/bot; bot@example.com)"
TIMEOUT = 15 # seconds; without a timeout Requests can wait forever
MAX_RETRIES = 2 # a URL goes back to the end of the queue at most twice
TRACKING = {"utm_source", "utm_medium", "utm_campaign", "utm_term", "utm_content", "gclid", "fbclid"}
DEFAULT_PORTS = {"http": 80, "https": 443}
def normalize(url):
"""One spelling per page, or None for links a crawler should not follow."""
url, _fragment = urldefrag(url.strip())
parts = urlsplit(url)
scheme = parts.scheme.lower()
try:
port = parts.port
except ValueError: # a broken port such as ":abc"
return None
if scheme not in DEFAULT_PORTS or not parts.hostname:
return None # mailto:, tel:, javascript:, ftp:, ...
host = parts.hostname # already lowercase
if port and port != DEFAULT_PORTS[scheme]:
host = f"{host}:{port}"
query = sorted((k, v) for k, v in parse_qsl(parts.query, keep_blank_values=True)
if k not in TRACKING)
return urlunsplit((scheme, host, parts.path or "/", urlencode(query), ""))
def page_key(url):
"""The seen-set key: http:// and https:// of one address count as one page."""
return url.split("://", 1)[1]
class Crawler:
def __init__(self, start, max_depth, max_pages, delay, out, proxy=None):
self.start = normalize(start)
self.hosts = {urlsplit(self.start).hostname} # add a "www." twin here on purpose
self.max_depth, self.max_pages, self.delay, self.out = max_depth, max_pages, delay, out
self.queue = deque([(self.start, 0, 0)]) # (url, depth, attempts)
self.seen = {page_key(self.start)} # marked when a URL is first met, not when fetched
self.robots, self.last, self.stopped = {}, {}, {}
self.stats, self.depths = Counter(), Counter()
self.session = requests.Session()
self.session.headers["User-Agent"] = USER_AGENT
# per request: session.proxies would lose to HTTP(S)_PROXY environment variables
self.proxies = {"http": proxy, "https": proxy} if proxy else None
def in_scope(self, url):
return urlsplit(url).hostname in self.hosts
def fetch(self, url):
"""GET with a per-host pause. stream=True reads the headers before the body."""
parts = urlsplit(url)
rules = self.robots.get(f"{parts.scheme}://{parts.netloc}")
gap = max(self.delay, (rules.crawl_delay(BOT_NAME) if rules else None) or 0)
pause = self.last.get(parts.netloc, float("-inf")) + gap - time.monotonic()
if pause > 0:
time.sleep(pause)
try:
return self.session.get(url, timeout=TIMEOUT, stream=True, proxies=self.proxies)
finally:
self.last[parts.netloc] = time.monotonic() # per host: http and https share it
def robots_ok(self, url):
root = "{0.scheme}://{0.netloc}".format(urlsplit(url))
if root not in self.robots:
rules = RobotFileParser()
try:
with self.fetch(root + "/robots.txt") as r:
status = r.status_code
rules.parse(r.text.splitlines() if status == 200 else [])
except requests.RequestException:
status = None
rules.parse([])
if status is None or status >= 500:
rules.disallow_all = True # robots.txt unreachable: crawl nothing on this host
self.robots[root] = rules
return self.robots[root].can_fetch(BOT_NAME, url)
def extract_links(self, html, base):
soup = BeautifulSoup(html, "html.parser")
title = " ".join(soup.title.get_text().split()) if soup.title else ""
return title, [urljoin(base, a["href"]) for a in soup.select("a[href]")]
def enqueue(self, links, depth):
for link in links:
self.stats["raw_links"] += 1
url = normalize(link)
if url is None:
self.stats["not_http"] += 1
continue
if page_key(url) in self.seen:
self.stats["duplicate"] += 1
continue
self.seen.add(page_key(url)) # BFS meets every URL first at its lowest depth
if not self.in_scope(url):
self.stats["offsite"] += 1
elif depth + 1 > self.max_depth:
self.stats["too_deep"] += 1
else:
self.queue.append((url, depth + 1, 0))
self.stats["queued"] += 1
def retry(self, url, depth, attempts, why):
if attempts < MAX_RETRIES:
self.queue.append((url, depth, attempts + 1))
self.stats["retried"] += 1
else:
self.stats["failed"] += 1
print(f"giving up on {url}: {why}")
def run(self):
started = time.monotonic()
with open(self.out, "w", encoding="utf-8", newline="\n") as out: # JSON Lines: \n, no BOM
while self.queue and self.stats["fetched"] < self.max_pages:
url, depth, attempts = self.queue.popleft()
host = urlsplit(url).netloc
if host in self.stopped:
self.stats["skipped_stopped_host"] += 1
continue
if not self.robots_ok(url):
self.stats["robots_disallowed"] += 1
continue
try:
r = self.fetch(url)
except requests.RequestException as exc:
self.retry(url, depth, attempts, type(exc).__name__)
continue
with r:
if r.status_code == 429:
self.stopped[host] = r.headers.get("Retry-After", "not sent")
print(f"429 from {host}, host stopped (Retry-After: {self.stopped[host]})")
continue
if r.status_code >= 500:
self.retry(url, depth, attempts, f"HTTP {r.status_code}")
continue
final = normalize(r.url)
moved = page_key(final) != page_key(url) # not just http -> https
if not self.in_scope(final) or (moved and page_key(final) in self.seen):
self.stats["redirect_skipped"] += 1 # left the site, or a known page
continue
is_html = "text/html" in r.headers.get("Content-Type", "")
try: # the body is downloaded here, and only for HTML
html = r.content if r.status_code == 200 and is_html else b""
except requests.RequestException as exc: # connection broke mid-body
self.retry(url, depth, attempts, type(exc).__name__)
continue
if final != url:
self.stats["redirected"] += 1
self.seen.add(page_key(final))
self.stats["fetched"] += 1
self.depths[depth] += 1
title, links = "", []
if html:
self.stats["html_bytes"] += len(html) # for a traffic estimate
title, links = self.extract_links(html, r.url)
elif not is_html:
self.stats["not_html"] += 1 # body never downloaded
record = {"url": url, "final_url": final, "depth": depth,
"status": r.status_code, "title": title, "links_found": len(links)}
out.write(json.dumps(record, ensure_ascii=False) + "\n")
print(f"{r.status_code} d{depth} {url}")
self.enqueue(links, depth)
print(f"\n{self.stats['fetched']} pages in {time.monotonic() - started:.1f} s,"
f" by depth {dict(sorted(self.depths.items()))}, left in queue {len(self.queue)}")
for key, value in sorted(self.stats.items()):
print(f" {key:<21}{value}")
if __name__ == "__main__":
ap = argparse.ArgumentParser(description=__doc__)
ap.add_argument("start", help="start URL, e.g. https://books.toscrape.com/")
ap.add_argument("--depth", type=int, default=2, help="link hops from the start URL")
ap.add_argument("--max-pages", type=int, default=100, help="hard ceiling on fetched pages")
ap.add_argument("--delay", type=float, default=1.0, help="minimum seconds between requests to one host")
ap.add_argument("--out", default="pages.jsonl")
ap.add_argument("--proxy", help="e.g. http://user:pass@pr.proxynet.io:8000")
args = ap.parse_args()
Crawler(args.start, args.depth, args.max_pages, args.delay, args.out, args.proxy).run()هنگام تغییر کد، سه نکته مهم است:
- تلاشهای دوباره به ته صف میروند، حداکثر دو بار، پس از خطای اتصال یا
5xx. یک صفحه آزمایشی محلی که دو بار500داد، در تلاش سوم200برگرداند. تلاش دوباره درون خود Requests: خطای Max Retries Exceeded With URL. - فایل خروجی JSON Lines ساده است.
encoding="utf-8"هیچ نشانه ترتیب بایت (BOM) نمینویسد وnewline="\n"پایان سطر\nرا که JSON Lines میخواهد حفظ میکند؛ در غیر این صورت ویندوز\r\nمینویسد.ensure_ascii=Falseمتن غیر ASCII را خوانا نگه میدارد. عنوانی با حروف ترکی پس از نوشتن و خواندن دوباره سالم ماند (خطاهای کدگذاری یونیکد در پایتون). - فقط GET. خزنده
/loginرا مثل هر صفحه دیگری باز میکند و هرگز فرمی را ارسال نمیکند.
وقتی اجرایش کردیم چه دیدیم
از Python 3.13.9، مکث پیشفرض یکثانیهای و عمق 2 استفاده کردیم. روی quotes.toscrape.com با سقف 500:
149 pages in 179.1 s, by depth {0: 1, 1: 46, 2: 102}, left in queue 0
  duplicate            2916
  fetched              149
  html_bytes           722227
  offsite              2
  queued               148
  raw_links            3096
  redirected           40
  too_deep             30
روی books.toscrape.com با سقف 60:
60 pages in 69.8 s, by depth {0: 1, 1: 59}, left in queue 524
  duplicate            3515
  fetched              60
  html_bytes           2047561
  queued               583
  raw_links            4098
در اجرای quotes، 94% پیوندها به نشانیهای آشنا اشاره میکردند و فقط 2 نشانی متمایز بیرون از سایت بود. دو سطر از خروجی، یکی ساده و یکی با تغییر مسیر:
{"url": "https://books.toscrape.com/", "final_url": "https://books.toscrape.com/", "depth": 0, "status": 200, "title": "All products | Books to Scrape - Sandbox", "links_found": 94}
{"url": "https://quotes.toscrape.com/author/Jane-Austen", "final_url": "http://quotes.toscrape.com/author/Jane-Austen/", "depth": 1, "status": 200, "title": "Quotes to Scrape", "links_found": 4}
یک سایت محلی کوچک شاخههای خطا را پوشش داد. خزنده یک مسیر ممنوع، سه پیوند غیروب و یک تغییر مسیر به میزبانی دیگر را رد کرد، یک PDF را نخوانده بست و یک 404 را ثبت کرد. یک 429 با Retry-After: 120 میزبان را متوقف کرد و 503 روی robots.txt باعث شد هیچ صفحهای دریافت نشود.
پروکسی کجای خزنده قرار میگیرد؟
پروکسیای که با گزینه --proxy http://user:pass@pr.proxynet.io:8000 داده میشود، در هر درخواست، از جمله درخواست robots.txt، به کار میرود. کد session.proxies را تنظیم نمیکند، چون مستندات Requests هشدار میدهد که متغیرهای محیطی پروکسی بر آن غلبه میکنند (استفاده پیشرفته). از طریق یک پروکسی آزمایشی محلی با رمز عبور، 10 صفحه نخست books همان سطرهایی را داد که بدون پروکسی به دست آمده بود، حتی وقتی یک پروکسی از کار افتاده در HTTPS_PROXY تنظیم شده بود.
یک سایت با نرخ یک درخواست در ثانیه بهندرت به پروکسی نیاز دارد. پروکسی وقتی به کار میآید که خزش میزبانهای زیادی را پوشش دهد و نخواهید همه ترافیک از یک IP بیرون برود: پروکسی چرخشی به هر درخواست یا هر میزبان IP خروجی متفاوتی میدهد. برای فهرستی کوتاه و ثابت از هدفها، پروکسی دیتاسنتر اغلب کافی است؛ IPهای آن بهطور پیشفرض با محدودیت سایت هدف تحویل میشوند و دسترسی به همه وبسایتها گزینهای است که هنگام سفارش انتخاب میکنید. کد چرخش IP در نوشته چرخاندن پروکسی در Python آمده است.
ترافیک پروکسی مسکونی چرخشی بهازای هر گیگابایت محاسبه میشود، پس اول html_bytes را در یک اجرای کوتاه اندازه بگیرید. هر دو سایت تمرینی HTML فشردهنشده فرستادند، حدود 34 کیلوبایت برای هر صفحه books و 5 کیلوبایت برای هر صفحه quotes: 10,000 صفحه تقریباً 0.34 یا 0.05 گیگابایت میشود، بهعلاوه هدرها. مکث و robots.txt برای همه IPهای خروجی برقرارند و چرخش IP دلیلی نیست که به یک سایت بیش از آنچه اجازه میدهد درخواست بفرستید.
کاربردها
- پیوندهای داخلی شکسته: خروجی را بر اساس وضعیت
404فیلتر کنید (خزنده وب). - فهرست نشانیها پیش از اسکرپینگ: اول خزش کنید، بعد فقط صفحههای محصول یا مقاله را اسکرپ کنید (استخراج داده).
- محصولات تازه رقبا: فهرست نشانیهای این هفته را با هفته پیش مقایسه کنید (رصد قیمت رقبا در فروشگاه اینترنتی).
- کمبودهای نقشه سایت: صفحههایی که خزنده پیدا میکند ولی در نقشه سایت نیستند (چگونه نقشه سایت را پیدا کنیم).
- تصویرهای صفحههای شناختهشده: اول صفحهها را فهرست کنید، بعد دانلود کنید (دانلود همه تصویرهای یک وبسایت).
- فیلدهای صفحههای پیداشده: عنوانها و قیمتها از همان HTML (BeautifulSoup چیست).
خطاهای رایج
list.pop(0)بهعنوان صف. هر فراخوانی کل فهرست را جابهجا میکند.- فراخوانی بازگشتی برای هر پیوند. خزش عمقاول میشود و ممکن است با
RecursionErrorتمام شود. - علامتزدن نشانیها بهعنوان دیدهشده فقط پس از دریافت. یک نشانی بارها وارد صف میشود.
- پاککردن کل رشته پرسوجو.
?page=2و همه صفحههای بعدی ناپدید میشوند. - حل پیوندها نسبت به نشانی درخواستشده. پس از تغییر مسیر، پایه
r.urlاست. - نبودن مهلت زمانی. بدون آن، Requests ممکن است تا بینهایت منتظر بماند.
- تجزیه فایلهای PDF و ZIP بهجای HTML. اول
Content-Typeرا بررسی کنید. - نبودن سقف صفحه. در سایتی با فیلتر یا تقویم، اجرا هرگز تمام نمیشود.
- پرکردن فرمها. خزنده صفحهها را با GET میخواند؛ فرستادن داده کار دیگری است (ارسال JSON با POST در Python Requests).
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
| چند صد صفحه از یک سایت، با دیدن سازوکار کار | اسکریپت همین نوشته |
| ادامه یک خزش طولانی پس از توقف | صفی روی دیسک: نسخه SQLite در صفحهبندی در وب اسکرپینگ |
| درخواستهای زیاد بهطور همزمان | همروندی، با اندازهای که در همروندی و موازیسازی آمده |
| هزاران صفحه، با تلاش دوباره و خروجیگرفتن آماده | Scrapy (CrawlSpider، تنظیم پروکسی) |
| پیوندهایی که فقط پس از اجرای جاوااسکریپت ظاهر میشوند | خزندهای مبتنی بر مرورگر، مثل PlaywrightCrawler در Crawlee for Python، یا Crawl4AI |
| سایت نقشه سایت منتشر میکند | اول آن را بخوانید و فقط برای آنچه در آن نیست خزش کنید (چگونه نقشه سایت را پیدا کنیم) |
| خزشی که روی میزبانهای زیادی پخش است | پروکسی چرخشی با همان نرخ مؤدبانه برای هر میزبان |
پرسشهای متداول
برای خزنده وب از کدام کتابخانه پایتون استفاده کنم؟
برای چند صد صفحه، Requests برای دانلود و BeautifulSoup برای خواندن پیوندها کافی است. برای هزاران صفحه با تلاش دوباره، خروجیگرفتن و زمانبندی، Scrapy شما را از نوشتن این کدها بینیاز میکند. پیوندهایی که جاوااسکریپت میسازد به ابزاری مبتنی بر مرورگر نیاز دارند.
میتوانم با BeautifulSoup خزنده بسازم یا به Scrapy نیاز دارم؟
میتوانید. BeautifulSoup یک تجزیهگر (parser) است: پیوندها را از HTML میخواند، اما صفحه دانلود نمیکند، صف نگه نمیدارد و میان درخواستها صبر نمیکند. اسکریپت بالا اینها را در کمتر از 200 سطر مینویسد. Scrapy اینها را آماده دارد و در کارهای بزرگتر به صرفه است.
آیا خزنده پایتون پیوندهایی را که با جاوااسکریپت بارگذاری میشوند میبیند؟
نه. Requests اسکریپت اجرا نمیکند، پس پیوندهایی که جاوااسکریپت اضافه میکند هرگز به BeautifulSoup نمیرسند. اول دنبال درخواست JSON پشت صفحه بگردید که بتوانید آن را مستقیم فراخوانی کنید. اگر نبود، جایی که شرایط سایت خودکارسازی را مجاز میداند، از خزندهای مبتنی بر مرورگر استفاده کنید.
آیا خزنده را چندرشتهای (multithreaded) کنم؟
فقط وقتی چند میزبان را خزش میکنید. در یک سایت، مکث میان درخواستها سرعت را تعیین میکند و رشتههای اضافه فقط منتظر میمانند یا فاصله را زیر پا میگذارند. میان میزبانهای زیاد، یک کارگر مؤدب برای هر میزبان کمک میکند (همروندی و موازیسازی).
چگونه با پایتون همه پیوندهای یک وبسایت را پیدا کنم؟
از نقشه سایت شروع کنید که معمولاً نامش در robots.txt آمده یا در /sitemap.xml پیدا میشود. اگر نبود، خزندهای مثل همین را با محدودیت عمق و سقف صفحه اجرا کنید و نتیجه را فهرست صفحههایی بدانید که پیوندها به آنها میرسند، نه فهرستی کامل.
آیا نوشتن و اجرای خزنده وب قانونی است؟
این مشاوره حقوقی نیست. پاسخ به کشور شما، شرایط سایت، اینکه صفحهها داده شخصی دارند یا نه و کاری که با نسخهها میکنید بستگی دارد. از robots.txt پیروی کنید، نرخ درخواست را پایین نگه دارید و از بخشهای پشت صفحه ورود دور بمانید. وضعیت کشور به کشور: آیا اسکرپینگ وب قانونی است؟
خلاصه
خزندهای که بدون تکرار به پایان برسد به اینها نیاز دارد: یک deque برای ترتیب سطحاول، مجموعه دیدهشدههایی که هنگام ورود به صف پر میشود، یک نگارش برای هر نشانی، بررسی محدوده پس از تغییر مسیرها و محدودیت عمق همراه با سقف صفحه. robots.txt، مکث برای هر میزبان و توقف با دیدن 429 از همان نسخه اول جایشان در کد است. وقتی کار بزرگتر شد، به صفی روی دیسک، همروندی میان میزبانها یا Scrapy بروید. برای خزشهایی که به سایتها یا کشورهای زیادی میرسند، گزینهها را در صفحه خدمات پروکسی ما مقایسه کنید.