


































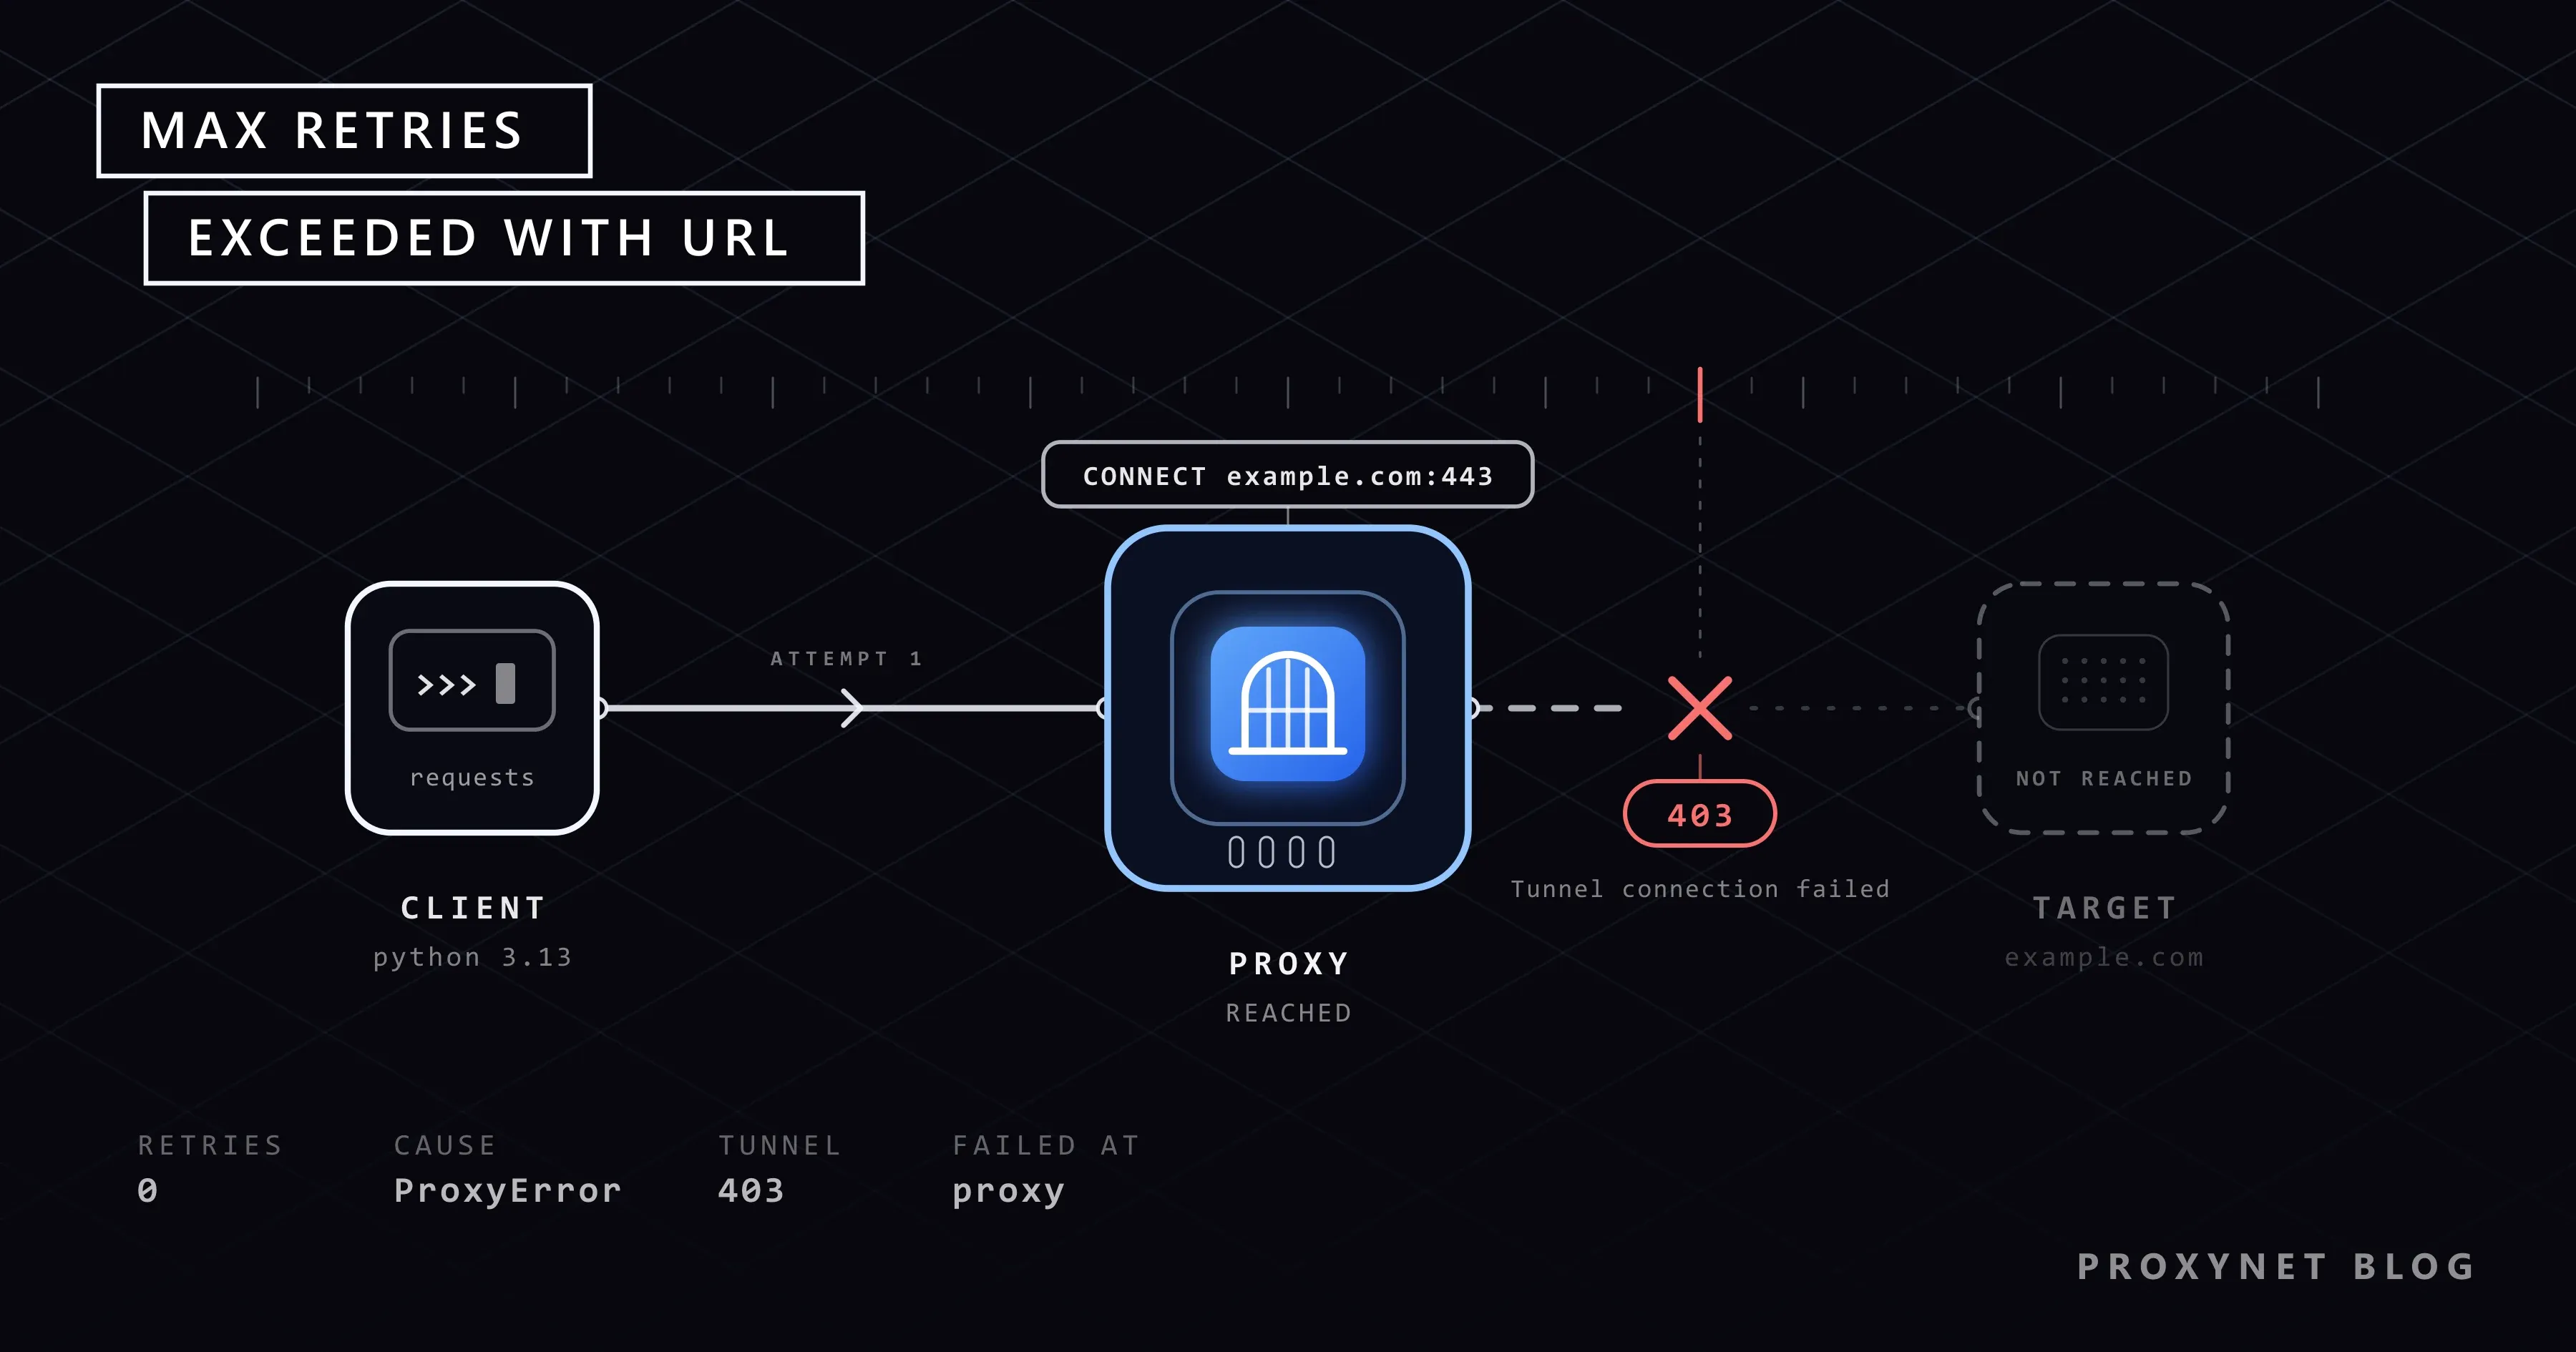
Tu script de seguimiento de precios funcionó toda la noche sin problemas. Esta mañana pegaste en él la dirección del proxy de tu nuevo plan, y ahora la terminal imprime una sola línea larga: HTTPSConnectionPool(host='example.com', port=443): Max retries exceeded with url. El script no tiene ninguna configuración de reintentos y el host del mensaje es la tienda de la que extraes los datos, así que la mirada va directa a la tienda. Al final de la línea, entre paréntesis, pone Tunnel connection failed: 403 Forbidden, y esa respuesta vino del proxy, no de la tienda.
Esta guía desmonta el mensaje: por qué dice «max retries» si no configuraste ninguno, una tabla de lectura hecha con cadenas de error que generamos nosotros mismos, las variantes con proxy, los tiempos de espera y el mismo error en pip. Termina con un script de Python probado que nombra la causa.
¿Qué significa «Max retries exceeded with url»?
El mensaje lo genera urllib3, la biblioteca que abre las conexiones de Requests. Cuando urllib3 da por perdida una petición, lanza MaxRetryError. Requests la captura y lanza su propia excepción, elegida según la causa interna: ConnectTimeout, ProxyError, SSLError, RetryError cuando se agotan los reintentos por código de estado, o un simple ConnectionError para todo lo demás. Esta es una cadena de nuestra prueba, dividida en sus cuatro partes:
requests.exceptions.ProxyError                        <- 1. la excepción de Requests
HTTPSConnectionPool(host='example.com', port=443):    <- 2. el pool: host y puerto de destino
Max retries exceeded with url: /                      <- 3. el texto envoltorio y la ruta
(Caused by ProxyError('Unable to connect to proxy',   <- 4. la causa real, la más externa primero
    OSError('Tunnel connection failed: 403 Forbidden')))
La parte 2 es donde la gente se equivoca. Con una URL https://, la línea del pool muestra el destino, aunque la petición pase por un proxy; la dirección del proxy solo aparece dentro de la parte 4, si es que aparece. Con una URL http:// normal enviada a través de un proxy ocurre lo contrario: la línea del pool muestra el proxy y la parte 3 lleva la URL de destino completa, como en HTTPConnectionPool(host='127.0.0.1', port=8083): Max retries exceeded with url: http://example.com/.
¿Por qué dice «max retries» si nunca configuraste reintentos?
Requests no reintenta las conexiones fallidas por defecto. En el código fuente de requests/adapters.py, DEFAULT_RETRIES = 0, y el adaptador lo convierte en Retry(0, read=False). La documentación de urllib3 sobre la clase Retry indica que los errores se envuelven en MaxRetryError salvo que los reintentos se desactiven con retries=False. Cero reintentos no cuenta como desactivado, así que un solo intento fallido ya sale como «Max retries exceeded».
Subir el número de reintentos no arregla la causa. Un nombre de proxy mal escrito, un puerto equivocado o un túnel rechazado fallan igual cada vez. En nuestra prueba, una dirección inalcanzable con un tiempo de espera de conexión de 2 segundos falló a los 2 segundos con la configuración por defecto y a los 7 segundos con dos reintentos y un backoff corto. Los reintentos solo ayudan con cortes breves de red.
¿Cómo se lee el mensaje de error paso a paso?
Lee el mensaje de fuera hacia dentro:
- Busca la excepción de Requests.
ProxyErrorsignifica que el fallo ocurrió de camino al proxy o en el propio proxy. - Lee la línea del pool. Con destinos
https://,hostyportson el destino. El puerto 443 a través de un proxy HTTP significa que la petición viaja por un túnel CONNECT. - Lee la primera clase después de
Caused by. Es el diagnóstico de urllib3:NameResolutionError,NewConnectionError,ConnectTimeoutError,SSLErroroProxyError. - Lee el texto más interno.
Failed to resolve 'name',[Errno 111] Connection refuseden Linux,[WinError 10061]en Windows,CERTIFICATE_VERIFY_FAILEDoTunnel connection failed: 403 Forbidden. Unhost=en esta parte puede ser el proxy. - Fíjate en cuánto tardó la llamada. Un fallo justo al cumplirse tu tiempo de espera de conexión (o un múltiplo de él) es un timeout; uno más rápido es un rechazo o un túnel denegado. En Windows, una conexión rechazada tardó unos dos segundos por dirección en nuestras pruebas, y
localhosttardó cuatro (primero IPv6, luego IPv4).
Errores de HTTPSConnectionPool: qué te dice la parte Caused by
Generamos todas las cadenas de abajo con Python 3.13, Requests 2.34.2 y urllib3 2.8.0, a través de un proxy de prueba local. Las partes largas se acortan con ...; el texto de error de Windows depende además del idioma del sistema.
| Caused by (parte más interna) | Excepción de Requests | Qué pasó | Qué revisar primero |
|---|---|---|---|
NameResolutionError(... Failed to resolve 'no-such-host.invalid' ...) | ConnectionError | El nombre del destino no se resolvió | Ortografía de la URL, DNS, VPN |
NewConnectionError(... [Errno 111] o [WinError 10061] ...) | ConnectionError | Nada escucha en ese puerto | Que el servicio esté activo, el puerto correcto |
ConnectTimeoutError(... 'Connection to 10.255.255.1 timed out. (connect timeout=2)') | ConnectTimeout | No hubo conexión TCP dentro del tiempo de espera | Dirección, firewall, valor del tiempo de espera |
SSLError(SSLCertVerificationError(... CERTIFICATE_VERIFY_FAILED ...)) | SSLError | El certificado no es de confianza | certifi, certificado raíz de la empresa |
ProxyError('Unable to connect to proxy', NewConnectionError(...)) | ProxyError | El puerto del proxy rechazó la conexión | Host y puerto del proxy, firewall local |
ProxyError('Unable to connect to proxy', NameResolutionError(... 'pr.proxynet.invalid' ...)) | ProxyError | El nombre del proxy no se resolvió | Errata en el host del proxy |
ProxyError('Unable to connect to proxy', ConnectTimeoutError(...)) | ProxyError | El proxy no respondió a tiempo | Dirección del proxy, reglas de salida para ese puerto |
ProxyError(..., OSError('Tunnel connection failed: 403 Forbidden')) | ProxyError | El proxy rechazó el túnel CONNECT | Puerto de destino, tipo y puerto del proxy, reglas de permiso |
ProxyError(..., OSError('Tunnel connection failed: 407 Proxy Authentication Required')) | ProxyError | El proxy quiere credenciales válidas | Consulta Autenticación de proxy |
ProxyError(..., OSError('Tunnel connection failed: 502 Bad Gateway')) | ProxyError | El proxy no pudo llegar al destino | Host y puerto de destino |
ProxyError('... Your proxy appears to only use HTTP and not HTTPS ...', SSLError(... WRONG_VERSION_NUMBER ...)) | ProxyError | La URL del proxy empieza por https:// | Escribe http:// |
Tres detalles quedan fuera de la tabla. Un proxy que agota el tiempo de espera lanza ProxyError, así que except ConnectTimeout nunca lo ve. Un timeout de lectura no se envuelve: llega como ReadTimeout con el texto Read timed out. (read timeout=3). Y una URL http:// normal a través de un proxy con una contraseña incorrecta no lanza nada; recibes una respuesta con estado 407.
¿Qué significa «ProxyError: Cannot connect to proxy»?
Cannot connect to proxy. (urllib3 1.26) y Unable to connect to proxy (urllib3 2.x) son el mismo error. Los dos pueden aparecer en el mismo equipo: pip 25.x incluye urllib3 1.26.20, mientras que una instalación nueva de Requests trae urllib3 2.8.0. Lee el segundo argumento, no la redacción:
NewConnectionError: nada escucha en ese puerto del proxy, o un firewall local lo bloquea. Vuelve a copiar el host y el puerto desde el panel.NameResolutionError: el nombre de host del proxy está mal escrito o tu DNS no puede resolverlo.ConnectionResetError(Errno 104en Linux,WinError 10054en Windows): el proxy o un dispositivo intermedio cerró la conexión.OSError('Tunnel connection failed: ...'): el proxy respondió pero no abrió el túnel; el código de estado es su respuesta.
Si el problema aparece en el navegador como «El servidor proxy no responde», lo explicamos en qué es un error de proxy y cómo solucionarlo.
Tunnel connection failed: 403 Forbidden: ¿por qué el proxy rechaza CONNECT?
Una petición https:// a través de un proxy HTTP empieza con CONNECT example.com:443. El proxy abre una conexión TCP con el destino y reenvía bytes cifrados; nunca ve la página. Según RFC 9110, sección 9.3.6, cualquier respuesta distinta de un 2xx significa que el túnel no se estableció. El módulo http.client de Python lee esa respuesta y escribe Tunnel connection failed.
El 403 es una decisión del proxy; el destino nunca vio tu petición. El RFC dice que los proxies deberían limitar CONNECT a puertos conocidos o a una lista de destinos seguros, porque un túnel al puerto 25 podría reenviar spam. Motivos habituales:
- El puerto de destino no está permitido.
https://example.com:8443/puede fallar mientrashttps://example.com/funciona. - Una lista de permitidos. Los proxies corporativos y algunas plataformas de hosting solo permiten dominios aprobados. Pregunta al equipo de TI o lee la documentación de la plataforma; no esquives la política.
- El tipo o el puerto de proxy equivocado, por ejemplo un puerto pensado para otro protocolo.
- Reglas del proveedor. Un proveedor puede rechazar túneles hacia ciertos destinos; su documentación indica qué códigos de estado usa.
Un 403 del sitio de destino llega como una respuesta normal con una página; ese caso está en Códigos de estado HTTP en web scraping. Un 407 en el túnel significa que el proxy pide credenciales.
¿La URL del proxy debe empezar por http:// o por https://?
En el diccionario proxies, la clave es el esquema del destino y el valor es cómo llegar al proxy. El propio ejemplo de la documentación de Requests asigna 'https' a 'http://10.10.1.10:1080'. La mayoría de los proxies hablan HTTP simple y abren un túnel CONNECT para los sitios cifrados (consulta nuestra página de proxy HTTPS), así que las dos claves llevan un valor http://:
proxies = {
    "http": "http://user:pass@pr.proxynet.io:8000",
    "https": "http://user:pass@pr.proxynet.io:8000",  # aquí también http://
}
Con https:// en el valor, urllib3 2.x abre TLS con el propio proxy, un proxy HTTP simple responde con bytes que no son TLS y recibes WRONG_VERSION_NUMBER con la pista Your proxy appears to only use HTTP and not HTTPS. La página de urllib3 sobre este error da la misma solución, también cuando el problema es una variable HTTPS_PROXY mal definida.
Dos puntos relacionados:
- SOCKS. Instala
requests[socks]. Consocks5://es tu equipo quien resuelve el nombre, así que en nuestra prueba un nombre erróneo falló antes de contactar con el proxy; consocks5h://lo resuelve el proxy (Diferencia entre SOCKS y HTTP, proxy SOCKS5). - Variables de entorno. La página de uso avanzado de Requests advierte que los proxies del entorno pueden sobrescribir
session.proxiesy recomiendaproxies=en cada petición. Las variables se explican en Proxy con wget.
¿Qué pasa sin tiempo de espera? ConnectTimeout frente a ReadTimeout
Requests no tiene tiempo de espera por defecto: sin timeout=, una llamada puede quedarse colgada durante minutos sin darte ningún error que leer. Pasa una tupla como timeout=(3.05, 20): primero el tiempo de espera de conexión y después el de lectura, en segundos. La documentación sugiere un tiempo de espera de conexión algo superior a un múltiplo de 3, la ventana de retransmisión TCP por defecto.
Los dos tiempos de espera fallan de forma distinta:
- ConnectTimeout: no hubo conexión TCP a tiempo. Llega envuelto en «Max retries exceeded», y la referencia de la API lo considera seguro de reintentar.
- ReadTimeout: hubo conexión, pero no llegaron datos dentro del tiempo de espera de lectura. No se envuelve, y puede que el servidor ya haya procesado la petición, así que reintentar un POST puede hacer el trabajo dos veces.
El tiempo de espera de conexión se aplica a cada dirección IP, así que un nombre con direcciones IPv4 e IPv6 puede duplicar la espera. El tiempo de espera de lectura es el intervalo entre bytes, no un límite para toda la descarga. Los valores por defecto de otras bibliotecas están en HTTPX, Requests y AIOHTTP: comparativa.
El mismo error en pip: «Retrying ... after connection broken by»
pip incluye sus propias copias de Requests y urllib3, así que pip install falla por las mismas razones. La documentación de pip recoge los valores por defecto: --retries 5 y --timeout 15 segundos. Ejecutamos pip 26.2.1 con --retries 2 a través de un proxy local que rechaza todos los CONNECT con 403:
WARNING: Retrying (Retry(total=1, connect=None, read=None, redirect=None, status=None)) after connection broken by 'OSError('Tunnel connection failed: 403 Forbidden')': /simple/six/
WARNING: Retrying (Retry(total=0, connect=None, read=None, redirect=None, status=None)) after connection broken by 'OSError('Tunnel connection failed: 403 Forbidden')': /simple/six/
ERROR: Could not find a version that satisfies the requirement six (from versions: none)
ERROR: No matching distribution found for six
El paquete existe; pip nunca llegó al índice. La causa está en las líneas WARNING. pip 25.2 mostraba el mismo aviso con la redacción de urllib3 1.26, ProxyError('Cannot connect to proxy.', ...).
Para CERTIFICATE_VERIFY_FAILED detrás de un proxy corporativo que inspecciona TLS, pasa el certificado raíz de la empresa con --cert; --trusted-host desactiva la verificación y es el último recurso. La configuración del proxy en pip se explica en Configurar proxy en Linux.
Un script de Python que nombra la causa
El script convierte una excepción en una sola línea: qué falló y qué revisar. En concreto:
- reintenta solo las conexiones fallidas, dos veces;
- mantiene
read=False: en nuestra prueba,read=0convertía unReadTimeouten unConnectionErrorenvuelto; - fija
other=0: sin eso, un túnel rechazado con403o407se intentaba tres veces; - pasa
proxies=ytimeout=(3.05, 20)en cada petición; - captura
ProxyError,SSLErroryConnectTimeoutantes queConnectionError, su clase padre.
Los reintentos por código de estado son otra capa (Códigos de estado HTTP en web scraping), y la rotación también (Cómo rotar proxies en Python).
"""Encuentra la causa real detrás de "Max retries exceeded with url" y dice qué revisar."""
import re
import ssl
import time

import requests
from requests.adapters import HTTPAdapter
from urllib3.exceptions import (
    ConnectTimeoutError,
    NameResolutionError,
    NewConnectionError,
    ProxyError as Urllib3ProxyError,
)
from urllib3.util import Retry

PROXY = "http://user:pass@pr.proxynet.io:8000"  # http:// incluso para destinos https://
TIMEOUT = (3.05, 20)  # segundos: (conexión, lectura)


def make_session():
    """Una sesión que reintenta las conexiones fallidas dos veces y nada más."""
    retry = Retry(
        total=2,
        connect=2,      # fallos de DNS, conexiones rechazadas y conexiones agotadas por tiempo
        read=False,     # que ReadTimeout siga siendo ReadTimeout: el servidor puede tener ya la petición
        other=0,        # un proxy que rechazó el túnel lo volverá a rechazar
        status=0,       # los reintentos por código de estado son otra capa
        backoff_factor=0.5,
    )
    adapter = HTTPAdapter(max_retries=retry)
    session = requests.Session()
    session.mount("http://", adapter)
    session.mount("https://", adapter)
    return session


def causes(exc):
    """La excepción y cada error envuelto dentro de ella, del más externo al más interno."""
    chain = []
    while exc is not None and all(exc is not seen for seen in chain):
        chain.append(exc)
        inner = None
        for candidate in (getattr(exc, "reason", None), getattr(exc, "original_error", None),
                          exc.__cause__, exc.__context__, *exc.args[:2]):
            if isinstance(candidate, BaseException):
                inner = candidate
                break
        exc = inner
    return chain


def explain(exc):
    """Una línea: qué falló, en qué lado y qué revisar primero."""
    chain = causes(exc)
    text = " | ".join(str(e) for e in chain)
    side = "proxy" if any(isinstance(e, Urllib3ProxyError) for e in chain) else "target"

    tunnel = re.search(r"Tunnel connection failed: (\d{3})", text)
    if tunnel:
        code = tunnel.group(1)
        if code == "407":
            return "proxy asked for credentials (407): check user:pass or the IP whitelist"
        if code == "403":
            return "proxy refused the CONNECT tunnel (403): check the target port and the proxy's allow rules"
        return f"proxy was reached but could not reach the target ({code}): check the target host and port"
    if "appears to only use HTTP" in text:
        return "proxy URL starts with https:// but the proxy speaks plain HTTP: write http://"
    if any(isinstance(e, NameResolutionError) for e in chain):
        host = re.search(r"Failed to resolve '([^']+)'", text)
        return f"{side} name {host.group(1) if host else ''} does not resolve: check spelling, DNS and VPN"
    if any(isinstance(e, ssl.SSLCertVerificationError) for e in chain):
        return "certificate not trusted: update certifi or set REQUESTS_CA_BUNDLE to your company root CA"
    if isinstance(exc, requests.exceptions.ReadTimeout):
        return "connected, but no answer within the read timeout: the server may have the request"
    if any(isinstance(e, NewConnectionError) for e in chain):
        return f"{side} refused the connection: wrong port, service down, or a firewall rejects it"
    if any(isinstance(e, ConnectTimeoutError) for e in chain):
        return f"no TCP connection to the {side} within the connect timeout: check address, port, firewall"
    return f"unrecognised, read the innermost error: {chain[-1]!r}"


def fetch(session, url, proxy=PROXY):
    """Hace GET a una URL e imprime el estado, o el diagnóstico si la petición falló."""
    proxies = {"http": proxy, "https": proxy} if proxy else None  # por petición: las variables de entorno no pueden sobrescribirlo
    start = time.monotonic()
    try:
        resp = session.get(url, proxies=proxies, timeout=TIMEOUT)
    except requests.exceptions.ProxyError as exc:      # antes que ConnectionError: es una subclase suya
        kind, error = "ProxyError", exc
    except requests.exceptions.SSLError as exc:        # también es un ConnectionError
        kind, error = "SSLError", exc
    except requests.exceptions.ConnectTimeout as exc:  # es ConnectionError y Timeout a la vez
        kind, error = "ConnectTimeout", exc
    except requests.exceptions.ReadTimeout as exc:     # nunca se envuelve en "Max retries exceeded"
        kind, error = "ReadTimeout", exc
    except requests.exceptions.ConnectionError as exc:
        kind, error = "ConnectionError", exc
    else:
        print(f"{'OK':<16}{time.monotonic() - start:6.2f}s  {url}  HTTP {resp.status_code}")
        return resp
    print(f"{kind:<16}{time.monotonic() - start:6.2f}s  {url}\n{'':<24}{explain(error)}")
    return None


if __name__ == "__main__":
    session = make_session()
    for url in ["https://httpbin.org/ip", "https://example.com/"]:
        fetch(session, url)
En urllib3 2.x, NameResolutionError es una subclase de NewConnectionError, que a su vez es subclase de ConnectTimeoutError, así que explain() comprueba primero la clase más específica. El script solo necesita pip install requests.
Así se ve la salida
Ejecutamos fetch() en Windows 11 una vez por caso: un proxy de prueba local (contraseña correcta e incorrecta, puerto cerrado, nombre mal escrito, esquema https://), un segundo proxy que rechaza todos los CONNECT y hosts reales para los casos de certificado y de tiempo de espera. El tiempo de espera de lectura era de 5 segundos:
OK                0.77s  https://httpbin.org/ip  HTTP 200
ProxyError        0.02s  https://httpbin.org/ip
                        proxy asked for credentials (407): check user:pass or the IP whitelist
ProxyError        0.00s  https://example.com/
                        proxy refused the CONNECT tunnel (403): check the target port and the proxy's allow rules
ProxyError        0.02s  https://no-such-host.invalid/
                        proxy was reached but could not reach the target (502): check the target host and port
ProxyError        7.10s  https://httpbin.org/ip
                        proxy refused the connection: wrong port, service down, or a firewall rejects it
ProxyError        1.02s  https://httpbin.org/ip
                        proxy name pr.proxynet.invalid does not resolve: check spelling, DNS and VPN
ProxyError        0.21s  https://httpbin.org/ip
                        proxy URL starts with https:// but the proxy speaks plain HTTP: write http://
SSLError          0.63s  https://self-signed.badssl.com/
                        certificate not trusted: update certifi or set REQUESTS_CA_BUNDLE to your company root CA
ConnectTimeout   10.16s  http://10.255.255.1/
                        no TCP connection to the target within the connect timeout: check address, port, firewall
ReadTimeout       5.02s  http://127.0.0.1:8082/
                        connected, but no answer within the read timeout: the server may have the request
ConnectionError  13.12s  http://localhost:8083/
                        target refused the connection: wrong port, service down, or a firewall rejects it
Los túneles rechazados fallaron en milisegundos porque other=0 los detuvo. El puerto cerrado del proxy necesitó tres intentos de unos dos segundos más un segundo de backoff; el tiempo de espera de conexión, tres veces 3,05 segundos más el backoff; y localhost, 13 segundos, porque cada intento probó IPv6 y luego IPv4. El 502 vino de nuestro proxy de prueba, que no pudo resolver el destino.
Dónde aparece este error
- Scraping a través de un proxy: los errores del proxy aparecen aquí antes que cualquier código de estado (extracción de datos).
- Builds de CI y Docker detrás de un proxy corporativo: los builds a menudo no reciben la configuración de proxy del host, y
localhostes el contenedor (Configurar proxy en Linux). - Integraciones de API con una IP de salida fija: un túnel rechazado parece una caída de la API (IP estática para API).
- Probar un proxy nuevo: lanza una sola petición con tiempo de espera antes de un trabajo completo (Cómo probar un proxy).
- Automatización de navegadores: el mismo fallo del túnel aparece como
ERR_TUNNEL_CONNECTION_FAILED(Playwright con un proxy). - Redes corporativas: tanto un firewall como un proxy filtran conexiones (Proxy o firewall).
Errores comunes
- Subir el número de reintentos. Una causa permanente sigue siendo permanente; solo esperas más.
- Culpar al destino porque su nombre está en la línea del pool. Con URLs
https://, el proxy solo aparece entre paréntesis. - Olvidar una variable
HTTPS_PROXYantigua. Puede sustituirsession.proxiessin avisar. - Dejar
verify=Falseen producción. La documentación de Requests advierte que te expone a ataques de intermediario (man-in-the-middle). Actualiza certifi o defineREQUESTS_CA_BUNDLE; para un proxy local de depuración, consulta Proxy MITM. - Capturar
ConnectionErrorprimero. Se tragaProxyError,SSLErroryConnectTimeout. - Confundir
403y407en el túnel. Uno es una regla; el otro, credenciales. - Leer solo la última línea de pip. La causa está en las líneas
WARNINGde encima.
Guía de decisión
| Lo que ves | Qué hacer |
|---|---|
NameResolutionError en Caused by | Corrige el nombre que falló (host del proxy o URL); sin reintentos |
ProxyError con NewConnectionError | Vuelve a copiar el host y el puerto del proxy; revisa el firewall local |
Tunnel connection failed: 403 | Revisa el puerto de destino, el tipo y el puerto del proxy y las reglas de permiso |
Tunnel connection failed: 407 | Revisa las credenciales o la lista blanca de IP |
SSLError: CERTIFICATE_VERIFY_FAILED | Actualiza certifi o define REQUESTS_CA_BUNDLE (pip: --cert) |
| Las llamadas se cuelgan o agotan el tiempo de vez en cuando | timeout=(3.05, 20) más un Retry solo para conexiones |
| pip dice «No matching distribution found» | Lee la línea WARNING: Retrying |
Preguntas frecuentes
¿Subir el número de reintentos arregla «Max retries exceeded»?
Solo cuando la red se cae un momento. Con un nombre que no se resuelve, un puerto cerrado o un túnel rechazado, cada reintento falla igual. Lee primero la parte Caused by.
¿Cuál es el tiempo de espera por defecto en Python Requests?
No hay ninguno: sin timeout=, una petición puede esperar indefinidamente. Da a cada llamada una tupla (connect, read).
¿El timeout de Requests va en segundos o en milisegundos?
En segundos. Sirve un float como 3.05; un solo número fija las dos fases, y una tupla como (3.05, 20) las fija por separado.
¿Puedo usar verify=False para CERTIFICATE_VERIFY_FAILED?
Solo para una prueba local rápida, porque permite que cualquiera en el camino lea o modifique el tráfico. La solución duradera es un certifi actualizado o, detrás de un proxy corporativo que inspecciona TLS, su certificado raíz en REQUESTS_CA_BUNDLE.
¿Por qué pip dice «No matching distribution found» si el paquete existe?
pip no pudo llegar al índice de paquetes, así que no encontró ninguna versión. Las líneas WARNING: Retrying ... after connection broken by de encima nombran la causa real, como Tunnel connection failed: 403 Forbidden.
¿Por qué recibo este error al llamar a localhost:8000?
Nada escucha en ese puerto: el servidor está caído, usa otro puerto o tu código se ejecuta en Docker, donde localhost es el contenedor. El error más interno es [Errno 111] o [WinError 10061]. Cómo averiguar qué programa ocupa un puerto lo explicamos en ¿Qué es el puerto 8080?
En resumen
«Max retries exceeded with url» es un envoltorio: la causa está después de Caused by, y aparece tras un solo intento porque Requests no reintenta por defecto. En los errores de proxy, distingue un fallo de camino al proxy de un túnel que el proxy rechazó, y mantén http:// en la URL del proxy. Da a cada petición una tupla de tiempo de espera y reintenta solo los fallos de conexión. Prueba una configuración nueva primero con una sola petición (cómo probar un proxy) y compara opciones en nuestra página de servicios de proxy.


