


































El script que escribiste con Requests y BeautifulSoup funciona sin problemas con cien páginas. Cuando pasas a diez mil, el trabajo cambia: tienes que gestionar qué dirección ya se rastreó, cuál dio error y hay que reintentar, cuántas peticiones van al mismo sitio a la vez y dónde se escriben los datos. Scrapy es un framework de Python que trae todo eso resuelto. El ajuste del proxy también vive dentro de esa estructura, en una de las capas por las que pasa cada petición.
En este artículo mostramos primero, de forma breve, qué es Scrapy y cómo se instala. Después pasamos al tema principal: las tres formas de definir un proxy, la autenticación, la diferencia entre un gateway rotativo con un único endpoint y tu propia lista de proxies, el control de velocidad con DOWNLOAD_DELAY y AutoThrottle, y el comportamiento de Scrapy ante las respuestas 429 y 503. Ejecutamos todos los ejemplos con Scrapy 2.19 y Python 3.13, sobre los sitios de práctica de toscrape.com y un proxy de prueba local.
¿Qué es Scrapy y para qué sirve?
Scrapy es un framework de Python escrito para rastrear sitios web y extraer datos estructurados de sus páginas. Se diferencia de una biblioteca en esto: Requests te da una herramienta para enviar una petición y el bucle lo montas tú. En Scrapy el bucle es el propio framework. Tú solo escribes una clase que indica desde qué dirección se empieza y qué se toma de la página recibida; esa clase se llama spider.
Todo lo que queda fuera del spider ya está hecho: un planificador que pone las peticiones en cola, un filtro de duplicados que no pide dos veces la misma dirección, un descargador asíncrono, reintentos, comprobación de robots.txt, límite de velocidad y exportación a JSON o CSV. Para los selectores se usan CSS y XPath a la vez; explicamos sus diferencias en Selector CSS o XPath. El mapa general de herramientas en Python y JavaScript está en Web scraping: ¿JavaScript o Python?.
¿Cómo se instala Scrapy?
Instala Scrapy en un entorno virtual propio del proyecto, no en el Python del sistema. En Windows los comandos son:
python -m venv venv
venv\Scripts\activate
pip install scrapy
scrapy startproject kitaplik
cd kitaplik
scrapy genspider kitaplar books.toscrape.com
En macOS y Linux la segunda línea pasa a ser source venv/bin/activate. El comando startproject genera un esqueleto con settings.py, middlewares.py y la carpeta spiders/. El archivo settings.py de la plantilla actual trae tres ajustes ya puestos: ROBOTSTXT_OBEY = True, CONCURRENT_REQUESTS_PER_DOMAIN = 1 y DOWNLOAD_DELAY = 1. Es decir, un proyecto nuevo respeta robots.txt por defecto y envía más o menos una petición por segundo al mismo sitio. No borres esas líneas; construye tus ajustes sobre ellas.
Rellena el archivo creado por genspider como se ve abajo. El spider lee las tarjetas de los libros y sigue el enlace de "página siguiente":
import scrapy


class KitaplarSpider(scrapy.Spider):
    name = "kitaplar"
    allowed_domains = ["books.toscrape.com"]
    start_urls = ["https://books.toscrape.com/"]

    def parse(self, response):
        for kart in response.css("article.product_pod"):
            yield {
                "baslik": kart.css("h3 a::attr(title)").get(),
                "fiyat": kart.css("p.price_color::text").get(),
                "adres": response.urljoin(kart.css("h3 a::attr(href)").get()),
            }

        sonraki = response.css("li.next a::attr(href)").get()
        if sonraki:
            yield response.follow(sonraki, callback=self.parse)
El comando scrapy crawl kitaplar -O kitaplar.json ejecuta el spider y escribe el resultado en un archivo. En nuestra prueba llegaron 40 registros de las dos primeras páginas. Conserva la línea FEED_EXPORT_ENCODING = "utf-8" de la plantilla para que los caracteres acentuados y los símbolos de moneda no se estropeen en el archivo.
¿Cómo procesa Scrapy una petición?
Para entender dónde se escribe el ajuste del proxy hay que conocer el camino que sigue una petición:
- El spider genera un objeto
Request(desdestart_urlsoresponse.follow). - El motor entrega la petición al planificador; el filtro de duplicados descarta las direcciones ya pedidas.
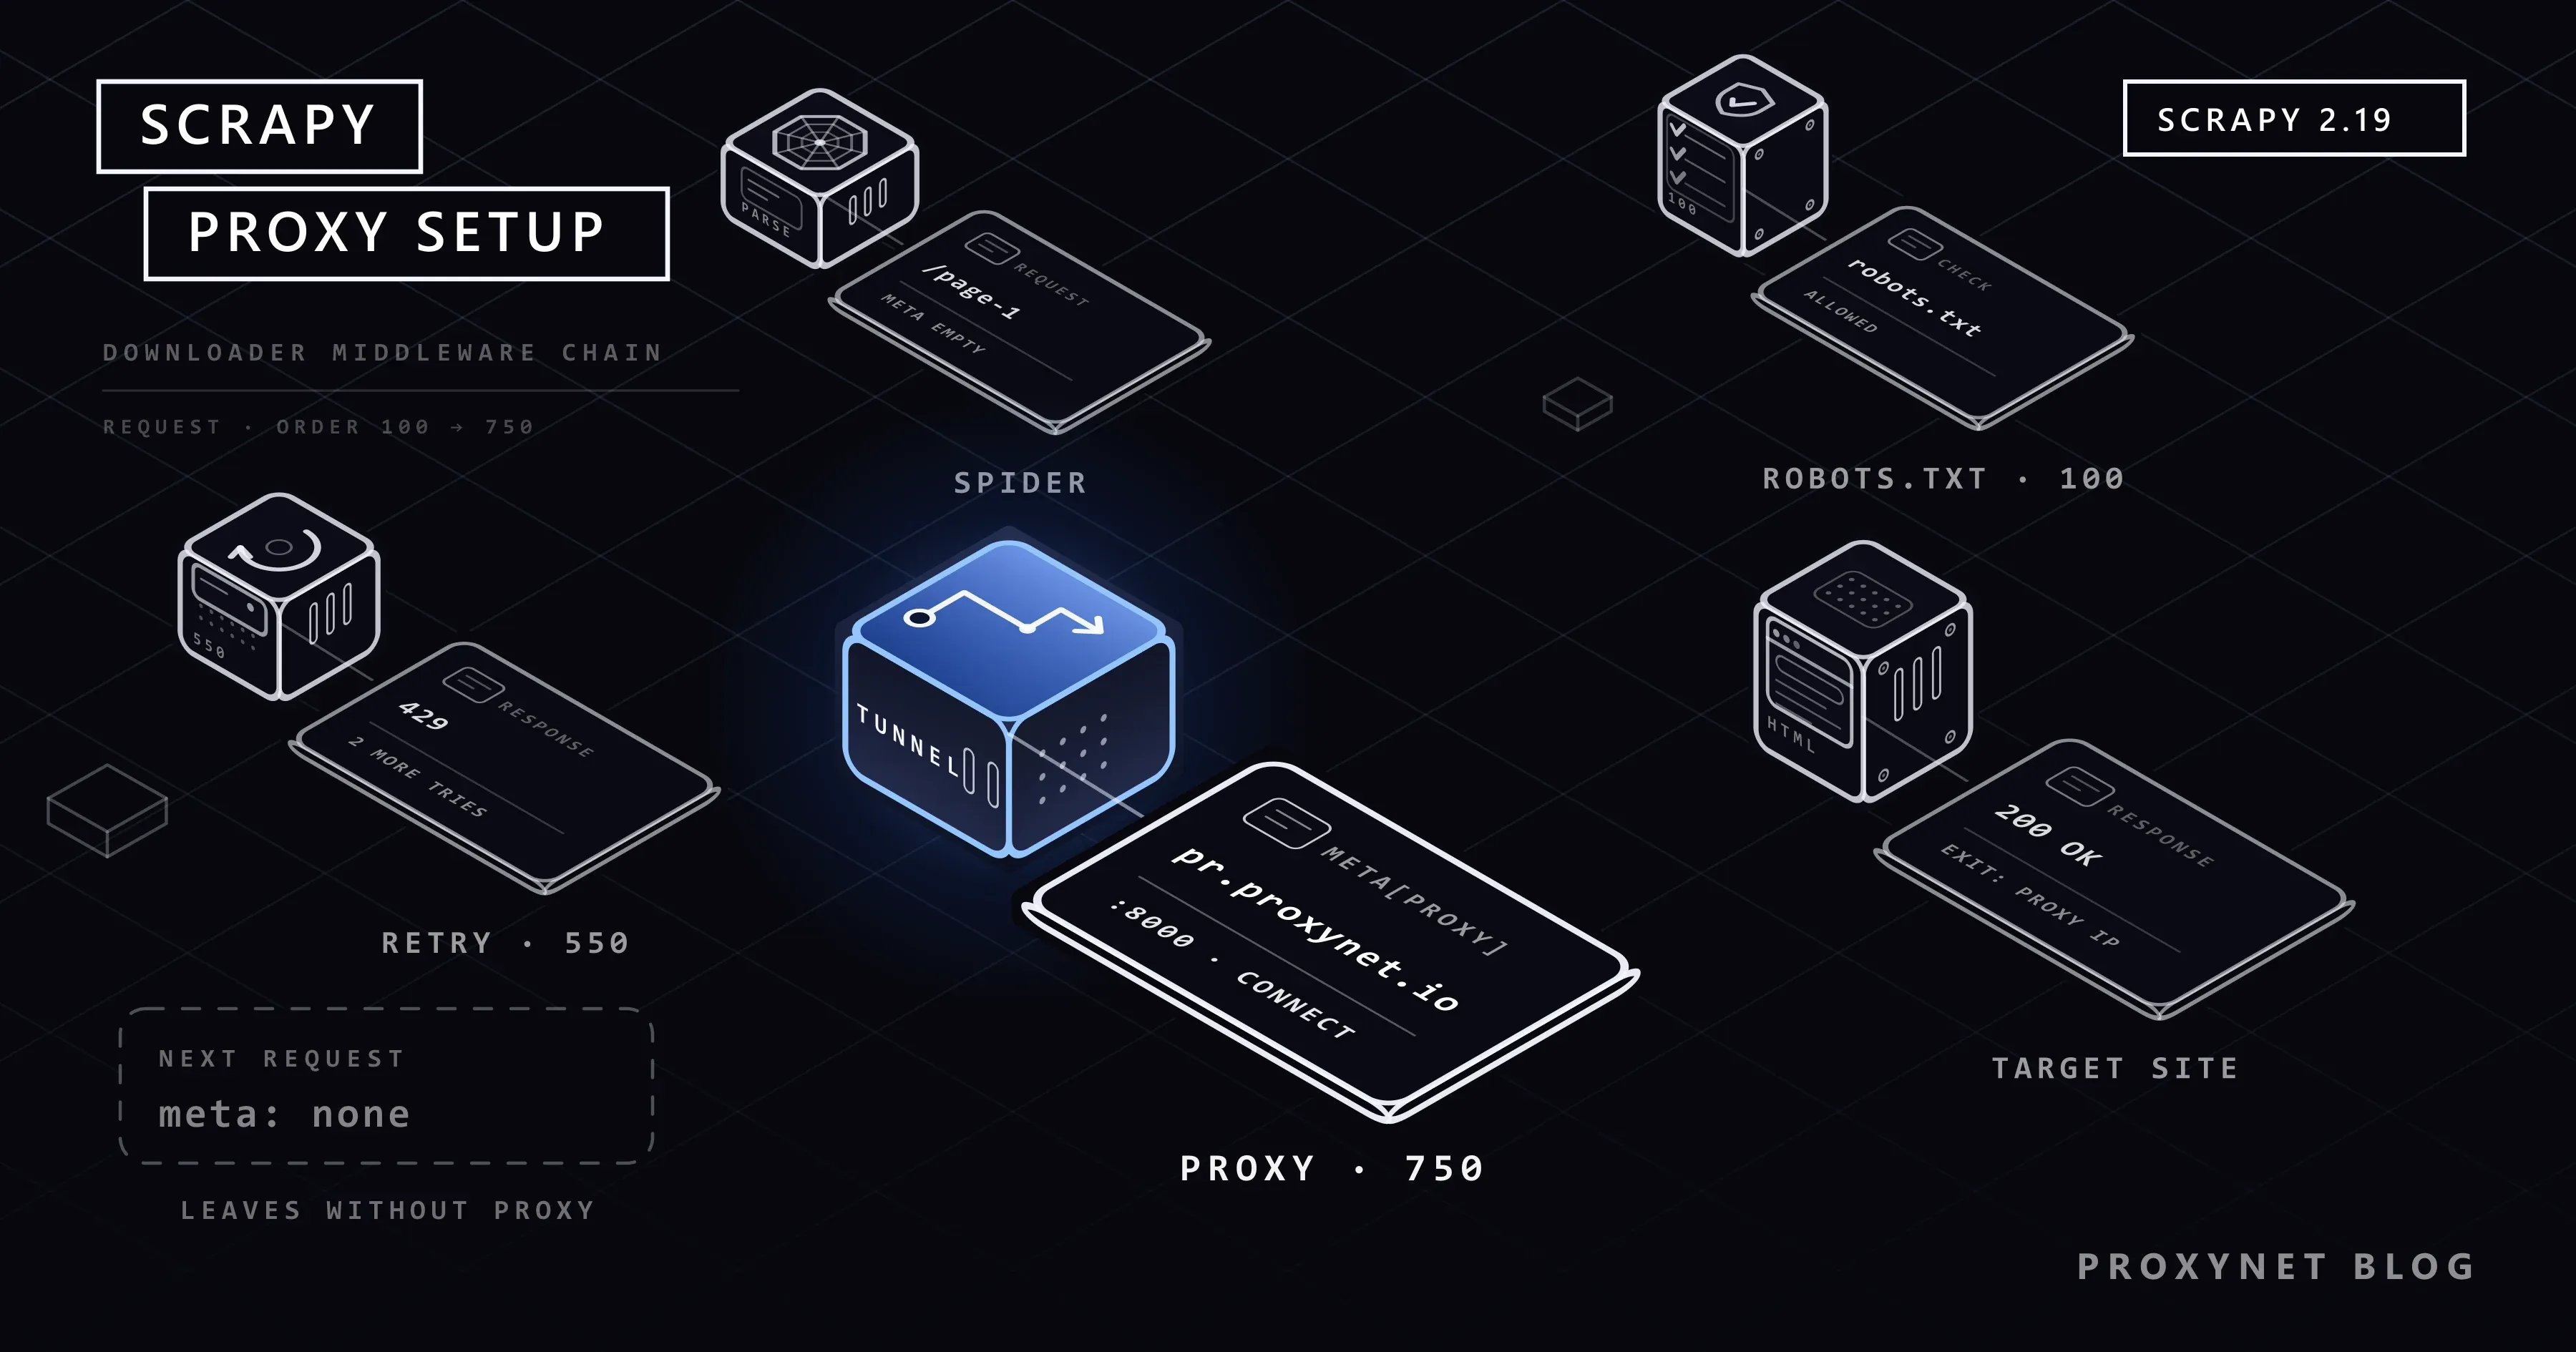
- Cuando le llega el turno, la petición atraviesa la cadena de downloader middleware. Cada middleware lleva un número de orden y la petición avanza del número menor al mayor: la comprobación de robots.txt es 100, el reintento 550,
HttpProxyMiddleware750. - El descargador envía la petición a la red. Si la petición tiene
meta["proxy"], la conexión se abre con el proxy y no con el destino; en direcciones HTTPS se establece un túnelCONNECTa través del proxy. - La respuesta vuelve por la misma cadena en orden inverso y llega a la función de callback del spider (
parse). - Los registros que produce la función van al item pipeline y las peticiones nuevas vuelven al planificador.
La conclusión: el proxy pertenece al tercer paso, no al código de análisis del spider. Rellene quien rellene meta["proxy"], quien hace el trabajo es HttpProxyMiddleware. Este middleware viene activado por defecto; la sección HttpProxyMiddleware de la documentación de Scrapy define su comportamiento.
¿Cómo se define un proxy en Scrapy?
Hay tres formas y las tres acaban rellenando el mismo campo meta["proxy"].
| Método | Dónde se escribe | Alcance | Cuándo conviene |
|---|---|---|---|
meta["proxy"] | En el spider, dentro de cada Request | Solo esa petición | Enviar unas pocas peticiones por otra salida |
| Variable de entorno | En la shell, http_proxy / https_proxy | Todas las peticiones, incluido robots.txt | Prueba rápida, ejecutar sin tocar el código |
| Downloader middleware | middlewares.py + settings.py | Todas las peticiones, incluido robots.txt | Configuración permanente del proyecto, rotación |
Por petición: el campo meta
import scrapy

PROXY = "http://user:pass@pr.proxynet.io:8000"


class KitaplarMetaSpider(scrapy.Spider):
    name = "kitaplar_meta"
    allowed_domains = ["books.toscrape.com"]

    async def start(self):
        yield scrapy.Request("https://books.toscrape.com/", meta={"proxy": PROXY})

    def parse(self, response):
        for kart in response.css("article.product_pod"):
            yield {"baslik": kart.css("h3 a::attr(title)").get()}

        sonraki = response.css("li.next a::attr(href)").get()
        if sonraki:
            # meta no pasa sola a la nueva petición, se lleva a mano
            yield response.follow(sonraki, callback=self.parse, meta={"proxy": PROXY})
Este método tiene dos consecuencias que se pasan por alto, y vimos las dos en las pruebas. La primera: meta no se transmite sola a la petición siguiente. En la prueba en la que no añadimos meta a la llamada response.follow, la primera página salió por el proxy y la segunda directamente desde nuestra propia dirección IP. La segunda: la petición de robots.txt de Scrapy no es una petición que hayas escrito tú, así que no lleva meta y también sale sin proxy. Si quieres que todo el tráfico use la misma salida, recurre a una de las dos formas siguientes.
Variable de entorno
HttpProxyMiddleware lee, igual que la biblioteca estándar de Python, las variables http_proxy, https_proxy y no_proxy. Sin cambiar nada en el código:
export https_proxy="http://user:pass@pr.proxynet.io:8000"
export http_proxy="$https_proxy"
scrapy crawl kitaplar
Si una petición tiene además meta["proxy"], ese valor se impone a la variable de entorno e ignora la lista no_proxy. Cómo se definen las variables en Windows, macOS y Linux, y la diferencia entre mayúsculas y minúsculas, está explicado en Proxy con wget; aquí no lo repetimos.
Para todo el proyecto: un middleware pequeño
En una configuración permanente basta un middleware de pocas líneas que lea la dirección del entorno en lugar de incrustarla en el código:
# kitaplik/middlewares.py
from scrapy.exceptions import NotConfigured


class TekProxyMiddleware:
    """Aplica a todas las peticiones la única dirección de proxy de los ajustes."""

    def __init__(self, adres):
        self.adres = adres

    @classmethod
    def from_crawler(cls, crawler):
        adres = crawler.settings.get("PROXY_ADRESI")
        if not adres:
            raise NotConfigured
        return cls(adres)

    def process_request(self, request):
        request.meta.setdefault("proxy", self.adres)
return None# kitaplik/settings.py
import os
PROXY_ADRESI = os.environ.get("PROXY_ADRESI")
DOWNLOADER_MIDDLEWARES = {
"kitaplik.middlewares.TekProxyMiddleware": 610,
}Gracias a setdefault, el meta["proxy"] que hayas escrito a mano en una petición se conserva. Si PROXY_ADRESI no está definida, el middleware se desactiva y el spider funciona sin proxy. El número de orden tiene que ser menor que 750; así la dirección la escribes tú primero y las credenciales las separa después HttpProxyMiddleware. En ejemplos escritos para versiones antiguas verás la firma como process_request(self, request, spider); en la documentación actual el parámetro spider no existe y el ejemplo funciona tal cual en Scrapy 2.19.
¿Cómo funciona la autenticación?
HttpProxyMiddleware separa la parte user:pass de la dirección, la codifica en Base64 y la añade a la petición como cabecera Proxy-Authorization: Basic …. En meta["proxy"] queda la dirección sin credenciales; no verás tu contraseña en el log. Si la contraseña contiene @, : o /, escríbela con codificación porcentual (%40 en lugar de @); el middleware decodifica el valor antes de enviarlo.
En la prueba con una contraseña incorrecta, Scrapy escribió esta línea:
TunnelError: Could not open CONNECT tunnel with proxy 127.0.0.1:8120 [{'status': 407, 'reason': b'Proxy Authentication Required'}]En direcciones HTTPS, 407 no llega como respuesta sino como excepción, porque el túnel no se pudo abrir. Un detalle que hay que tener presente: el middleware de reintentos trata esa excepción como un fallo temporal y prueba la misma petición dos veces más. Una contraseña incorrecta no se arregla repitiendo; si ves TunnelError y 407 en el log, detén el rastreo y corrige las credenciales. Si en lugar de usuario y contraseña usas una lista de IP autorizadas, la dirección se escribe sin credenciales, con la forma http://pr.proxynet.io:8000. La diferencia entre ambos métodos está en Autenticación de proxy: user:pass o lista blanca de IP.
¿Hace falta un middleware para la rotación?
La respuesta depende del tipo de proxy que tengas.
Con un gateway rotativo, no. En un servicio de proxies rotativos te conectas a un único endpoint y es el gateway quien cambia la IP de salida. Del lado de Scrapy basta el TekProxyMiddleware de arriba o una sola variable de entorno; mantener una lista, elegir la siguiente dirección y apartar las que fallan no es tarea tuya. Es la configuración habitual en los rastreos hechos con Proxies residenciales. Cómo funcionan los modos de rotación lo contamos en nuestro artículo sobre la rotación de IP.
Si tienes una lista de direcciones fijas (por ejemplo, unas cuantas direcciones de Proxies de centro de datos o de Proxies ISP), el reparto lo hace un middleware. El ejemplo siguiente usa las direcciones por turno, deja descansar un tiempo la que falla varias veces seguidas y escribe los recuentos en las estadísticas de Scrapy:
# kitaplik/middlewares.py
import time
from urllib.parse import urlsplit

from scrapy.exceptions import IgnoreRequest, NotConfigured


def anahtar(proxy_adresi):
    parca = urlsplit(proxy_adresi)
    return f"{parca.hostname}:{parca.port}"


class ProxyHavuzuMiddleware:
    """Asigna a cada petición el siguiente proxy de la lista y deja descansar al que falla seguido."""

    def __init__(self, adresler, hata_siniri, dinlenme, stats):
        self.adresler = adresler
        self.hata_siniri = hata_siniri
        self.dinlenme = dinlenme
        self.stats = stats
        self.sira = 0
        self.hatalar = {anahtar(a): 0 for a in adresler}
        self.kapali = {}  # clave -> momento en que vuelve a abrirse

    @classmethod
    def from_crawler(cls, crawler):
        adresler = crawler.settings.getlist("PROXY_LISTESI")
        if not adresler:
            raise NotConfigured
        return cls(
            adresler,
            crawler.settings.getint("PROXY_HATA_SINIRI", 3),
            crawler.settings.getfloat("PROXY_DINLENME", 60.0),
            crawler.stats,
        )

    def sec(self):
        simdi = time.monotonic()
        for _ in self.adresler:
            adres = self.adresler[self.sira % len(self.adresler)]
            self.sira += 1
            if self.kapali.get(anahtar(adres), 0) <= simdi:
                return adres
        return None

    def process_request(self, request):
        adres = self.sec()
        if adres is None:
            self.stats.inc_value("proxy_havuzu/hepsi_dinleniyor")
            raise IgnoreRequest("Todos los proxies de la lista están descansando")
        request.meta["proxy"] = adres
        request.meta["proxy_anahtari"] = anahtar(adres)
        return None

    def process_response(self, request, response):
        kim = request.meta.get("proxy_anahtari")
        if kim:
            self.hatalar[kim] = 0
            self.stats.inc_value(f"proxy_havuzu/yanit/{kim}")
        return response

    def process_exception(self, request, exception):
        kim = request.meta.get("proxy_anahtari")
        if not kim:
            return None
        self.hatalar[kim] += 1
        self.stats.inc_value(f"proxy_havuzu/hata/{kim}")
        if self.hatalar[kim] >= self.hata_siniri:
            self.kapali[kim] = time.monotonic() + self.dinlenme
            self.hatalar[kim] = 0
return None# kitaplik/settings.py
PROXY_LISTESI = [
"http://user:pass@203.0.113.10:8000",
"http://user:pass@203.0.113.11:8000",
"http://user:pass@203.0.113.12:8000",
]
DOWNLOADER_MIDDLEWARES = {
"kitaplik.middlewares.ProxyHavuzuMiddleware": 610,
}Probamos el ejemplo con tres proxies locales, dos en marcha y uno apagado. Los cien registros llegaron completos; las peticiones se repartieron 6 y 5 entre las dos direcciones que funcionaban, la dirección apagada quedó fuera de servicio tras tres errores de conexión y Scrapy reintentó las peticiones fallidas por las otras direcciones.
Aquí el número de orden no es arbitrario. En el primer intento pusimos el middleware en 350 y el contador de errores no llegó a funcionar: las excepciones recorren la cadena en orden inverso, y cuando el middleware de reintentos, en 550, captura la excepción y devuelve una petición nueva, los middlewares con número menor no se enteran. Un valor entre 550 y 750 (610 en el ejemplo) cumple las dos condiciones: tú ves el error antes que el reintento, y las credenciales las procesa HttpProxyMiddleware después de ti. La forma de hacer lo mismo a mano con Requests está en Cómo rotar proxies en Python.
¿Cómo se ajustan DOWNLOAD_DELAY y AutoThrottle?
El proxy cambia por dónde sale la petición; no cambia la carga que recibe el servidor de destino. Los ajustes que marcan esa carga son estos:
# kitaplik/settings.py
USER_AGENT = "kitaplik-bot/1.0 (+https://ornek.com/bot)"
ROBOTSTXT_OBEY = True

CONCURRENT_REQUESTS = 8
CONCURRENT_REQUESTS_PER_DOMAIN = 2
DOWNLOAD_DELAY = 1
DOWNLOAD_TIMEOUT = 30

AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 2
AUTOTHROTTLE_MAX_DELAY = 30
AUTOTHROTTLE_TARGET_CONCURRENCY = 1.0
AUTOTHROTTLE_DEBUG = False

RETRY_ENABLED = True
RETRY_TIMES = 2
RETRY_HTTP_CODES = [429, 500, 502, 503, 504, 408]CONCURRENT_REQUESTS_PER_DOMAINes el número de peticiones que pueden estar abiertas a la vez hacia el mismo dominio. El valor por defecto del framework es 8 y la plantilla del proyecto lo baja a 1. Qué es la concurrencia lo explicamos en Concurrencia y paralelismo.DOWNLOAD_DELAYes la espera, en segundos, entre dos peticiones al mismo dominio. Scrapy añade por defecto una variación aleatoria a este valor; las peticiones no salen a intervalos exactos como un reloj.- AutoThrottle ajusta la espera según el tiempo de respuesta del servidor. Según el algoritmo de la documentación, la espera objetivo es la latencia de la respuesta dividida entre
AUTOTHROTTLE_TARGET_CONCURRENCY, y la nueva espera es la media entre la espera anterior y ese objetivo. Las respuestas distintas de200no pueden reducir la espera. La espera nunca baja deDOWNLOAD_DELAYni sube por encima deAUTOTHROTTLE_MAX_DELAY. DOWNLOAD_TIMEOUTvale 180 segundos por defecto. Al trabajar a través de un proxy, acórtalo para que una conexión que no responde no se quede colgada tres minutos.
Con AUTOTHROTTLE_DEBUG = True ves una línea por cada respuesta. En nuestra prueba la espera empezó en 2000 ms, bajó a 1072 ms cuando el servidor respondió en 145 ms, luego a 1000 ms, el suelo que marca DOWNLOAD_DELAY, y se quedó ahí:
slot: books.toscrape.com | conc: 1 | delay: 2000 ms (+0)   | latency: 446 ms
slot: books.toscrape.com | conc: 1 | delay: 1072 ms (-927) | latency: 145 ms
slot: books.toscrape.com | conc: 1 | delay: 1000 ms (-72)  | latency: 144 ms
Con ROBOTSTXT_OBEY activado, Scrapy descarga primero el archivo /robots.txt de cada dominio y descarta las direcciones no permitidas sin pedirlas. Cómo se lee el archivo está en Qué es robots.txt y cómo leerlo, y el marco legal del rastreo en ¿El web scraping es legal?. Poner en USER_AGENT una dirección en la que se te pueda localizar permite que el administrador del sitio te escriba cuando vea un problema en lugar de bloquearte.
¿Qué hace Scrapy ante las respuestas 429 y 503?
El middleware de reintentos vuelve a intentar por defecto los códigos 500, 502, 503, 504, 522, 524, 408 y 429, además de los errores de conexión; RETRY_TIMES = 2 significa tres intentos en total contando la primera petición. La petición reintentada vuelve a la cola con menor prioridad.
Conviene conocer dos límites. El reintento de Scrapy no lee la cabecera Retry-After ni aplica una espera exponencial entre intentos; el intervalo lo siguen marcando DOWNLOAD_DELAY y AutoThrottle. Como AutoThrottle no reduce la espera con respuestas distintas de 200, la velocidad no sube sola durante una oleada de 429, pero puede que tampoco baje lo suficiente de forma automática. Si la proporción de 429 crece en el log, la reacción correcta es bajar CONCURRENT_REQUESTS_PER_DOMAIN y aumentar DOWNLOAD_DELAY. Intentar superar un límite de velocidad con más IP no resuelve el problema: aumenta la carga sobre el sitio. El significado de los códigos y la espera correcta con Retry-After están en Códigos de estado HTTP en web scraping, y la lógica del límite de velocidad del lado del sitio en nuestro artículo sobre 429 Too Many Requests.
¿Se puede usar un proxy SOCKS5 en Scrapy?
Con el descargador por defecto, no. En la prueba en la que escribimos una dirección socks5:// en meta["proxy"], la petición esperó hasta agotar el tiempo sin recibir respuesta alguna. En cambio, el segundo descargador de Scrapy, basado en httpx, HttpxDownloadHandler, admite SOCKS5 desde la versión 2.17. Para configurarlo, ejecuta pip install "scrapy[httpx]" y añade esto a los ajustes:
DOWNLOAD_HANDLERS = {
    "http": "scrapy.core.downloader.handlers._httpx.HttpxDownloadHandler",
    "https": "scrapy.core.downloader.handlers._httpx.HttpxDownloadHandler",
}
Con este ajuste, una dirección socks5://user:pass@… funcionó en nuestra prueba con autenticación incluida. La documentación de Scrapy marca este descargador como experimental y todavía no lo recomienda para producción; también señala que abre un pool de conexiones distinto para cada dirección de proxy. Si no es obligatorio, quédate con un proxy HTTP. Las diferencias entre protocolos están en Diferencia entre SOCKS y HTTP.
¿Qué se hace con las páginas cargadas con JavaScript?
Scrapy descarga el HTML de la página; no ejecuta JavaScript. Si los datos se cargan después en el navegador, mira primero el endpoint JSON al que la página llama en segundo plano; la mayoría de las veces esa dirección se puede pedir directamente con Scrapy. Si no es posible, el plugin scrapy-playwright abre en un navegador real las peticiones que elijas. Atención: en este plugin el proxy no se indica con meta["proxy"], sino con las opciones de inicio del navegador o del contexto (context). Los detalles están en Qué es Playwright y cómo usarlo con un proxy, y la forma de distinguir los tipos de página en Páginas estáticas y dinámicas.
¿Scrapy, BeautifulSoup o Selenium?
Los tres son partes distintas del mismo trabajo; por eso la comparación suele plantearse mal.
| Scrapy | Requests + BeautifulSoup | Selenium | |
|---|---|---|---|
| Qué es | Framework de rastreo | Cliente HTTP + analizador HTML | Automatización del navegador |
| Cola de peticiones y concurrencia | Incluidas | Las escribes tú | Las escribes tú |
| Reintentos, límite de velocidad, robots.txt | Se activan con un ajuste | Los escribes tú | Los escribes tú |
| Ejecución de JavaScript | No (con plugin) | No | Sí |
| Definición del proxy | meta["proxy"] o middleware | Parámetro proxies= | Opción de inicio del navegador |
| Curva de aprendizaje | Media | Baja | Media |
| Trabajo adecuado | Muchas páginas, rastreo recurrente | Puntual, unas pocas páginas | Inicio de sesión, clics, contenido dinámico |
BeautifulSoup es solo un analizador y también se puede usar dentro de Scrapy. Selenium abre un navegador completo para cada página, así que procesa muchas menos páginas con el mismo hardware; tiene sentido solo en los pasos que de verdad necesitan un navegador. La configuración del proxy en Selenium está en Selenium con proxy, y la comparación de las dos herramientas de navegador en nuestro artículo sobre Playwright y Selenium.
Casos de uso
- Seguimiento de precios y existencias: La misma lista de productos se rastrea cada día; la estructura de Scrapy, apta para ejecuciones programadas, encaja con este trabajo. El planteamiento está en nuestra página de monitorización de precios, y un ejemplo que funciona en nuestro artículo sobre el seguimiento de precios de la competencia en e-commerce.
- Rastreo interno de un sitio y creación de índices: La clase
CrawlSpider, que recorre todas las páginas siguiendo los enlaces, es un punto de partida listo para trabajos de rastreador web. - Recopilación de catálogos de varios sitios: Un spider por sitio, un pipeline común y un ajuste de proxy común. La arquitectura general está en nuestra página de extracción de datos.
- Listas paginadas: Los patrones de enlace "siguiente", número de página y cursor están en nuestro artículo sobre la paginación en web scraping.
Errores frecuentes
- Escribir el proxy solo en la primera petición.
metano pasa a las peticiones posteriores; a partir de la segunda página el rastreo sigue desde tu propia dirección IP y en el log no lo notas. - Elegir al azar el número de orden del middleware. Con un número mayor que 750 las credenciales no se separan y la petición falla con el error
invalid hostname; con uno menor que 550 no ves los errores de conexión. - Borrar de la plantilla las líneas de
ROBOTSTXT_OBEY,DOWNLOAD_DELAYy concurrencia. Los valores por defecto desnudos del framework (robots.txt desactivado, sin espera, 8 peticiones por dominio) son lo bastante rápidos como para forzar un sitio pequeño. - Seguir rastreando mientras recibes
407. Cada petición se intenta tres veces y ninguna sale bien; corrige primero las credenciales. - Montar un middleware de rotación encima de un gateway rotativo. El gateway ya hace ese trabajo; una segunda capa solo complica la depuración.
- Dejar
DOWNLOAD_TIMEOUTen su valor por defecto. Una sola conexión que no responde ocupa un hueco durante tres minutos. - Escribir la contraseña en
settings.pyy subirla al repositorio. Lee la dirección desde una variable de entorno.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Trabajo puntual de unas pocas páginas | Basta Requests + BeautifulSoup, Scrapy no es imprescindible |
| Miles de páginas, repetición periódica | Proyecto de Scrapy, conservando los ajustes de la plantilla |
| Que todo el tráfico pase por el proxy | TekProxyMiddleware o la variable de entorno https_proxy |
| Que solo ciertas peticiones salgan por otra salida | meta["proxy"] en esas peticiones |
| Repartir la carga entre muchas IP | Gateway rotativo, una sola dirección, sin middleware |
| Tienes una lista fija de proxies | ProxyHavuzuMiddleware, número de orden entre 550 y 750 |
| La misma IP durante toda la sesión | Proxies de sesión fija y una sola dirección |
Los 429 aumentan en el log | Baja la concurrencia, sube DOWNLOAD_DELAY, activa AutoThrottle |
| SOCKS5 es obligatorio | HttpxDownloadHandler (experimental) |
| Los datos llegan con JavaScript | Primero el endpoint JSON; si no, scrapy-playwright |
Preguntas frecuentes
¿Qué es un spider de Scrapy?
Un spider es una clase de Python derivada de scrapy.Spider que define dos cosas: desde qué direcciones empieza el rastreo, y qué datos y qué enlaces nuevos se extraen de la respuesta recibida. La cola, la descarga y la gestión de errores son tarea del framework, no del spider.
¿Hace falta saber Python para usar Scrapy?
Sí. Un spider es una clase de Python y vas a usar selectores, bucles y diccionarios. Alguien con Python básico puede escribir su primer spider; para la parte de middleware y pipeline conviene estar familiarizado con las clases.
¿Cómo sé que el proxy se está usando de verdad?
Envía con Scrapy una petición a un servicio que devuelva tu dirección IP en JSON y compara la dirección de la respuesta con tu propia IP. Escribir en el log el valor de response.meta.get("proxy") dentro de parse también muestra qué petición salió por qué proxy. Los métodos generales están en ¿Funciona tu proxy? Cómo probar un proxy.
¿Qué es más rápido, Scrapy o Selenium?
Con el mismo hardware Scrapy procesa claramente más páginas, porque no abre un navegador y envía las peticiones de forma asíncrona. La velocidad solo importa si la página no necesita JavaScript; si los datos se generan en el navegador, Scrapy por sí solo no puede verlos.
¿DOWNLOAD_DELAY sobra cuando AutoThrottle está activado?
No, ese valor marca el suelo. AutoThrottle nunca baja la espera por debajo de DOWNLOAD_DELAY. En un servidor que responde rápido la espera baja hasta ese suelo y se queda ahí; por eso confiar en AutoThrottle con DOWNLOAD_DELAY = 0 equivale a enviar peticiones casi sin espera a los servidores rápidos.
¿Usar una IP distinta en cada petición evita los bloqueos?
Por sí solo, no. Los sitios miden la velocidad no solo por IP, sino también por sesión, cookie y comportamiento. La rotación reparte la carga entre muchas salidas; cobra sentido junto con respetar robots.txt, una concurrencia baja y un User-Agent honesto. Reunimos los métodos legítimos en Cómo hacer web scraping sin que te bloqueen.
En resumen
En Scrapy el proxy es el campo meta["proxy"] de la petición y puedes rellenarlo de tres formas: a mano en cada petición, con una variable de entorno o con un downloader middleware. Para que todo el tráfico, incluido robots.txt, salga por la misma salida hace falta una de las dos últimas. Si usas un gateway rotativo basta una sola dirección; si tienes una lista fija, un middleware con número entre 550 y 750 se encarga del reparto y del recuento de errores. La velocidad no la marca el proxy, sino DOWNLOAD_DELAY, la concurrencia por dominio y AutoThrottle; conserva los ajustes prudentes que trae la plantilla. Encontrarás los tipos de proxy adecuados para tus rastreos entre nuestros servicios de proxy.


