Un equipo de e-commerce descarga cada mañana los precios de un competidor a partir de una lista de unos cientos de URL de producto. Un mes, el competidor abre una categoría nueva. Esos productos no están en la lista, así que nunca llegan al informe, y nadie se da cuenta durante semanas. Un scraper más rápido no habría servido de nada. Faltaba un paso que recorriera las páginas de categoría y encontrara direcciones nuevas, y ahí es donde termina el web crawling y empieza el web scraping.
En este artículo comparamos web scraping vs. web crawling en seis ejes: entrada, salida, condición de parada, deduplicación, velocidad y robots.txt. Explicamos dónde se detiene un crawler y cómo se unen los dos trabajos en un mismo pipeline, y después mostramos Spider y CrawlSpider en Scrapy con código que hemos ejecutado.
¿Qué hace el web crawling y qué hace el web scraping?
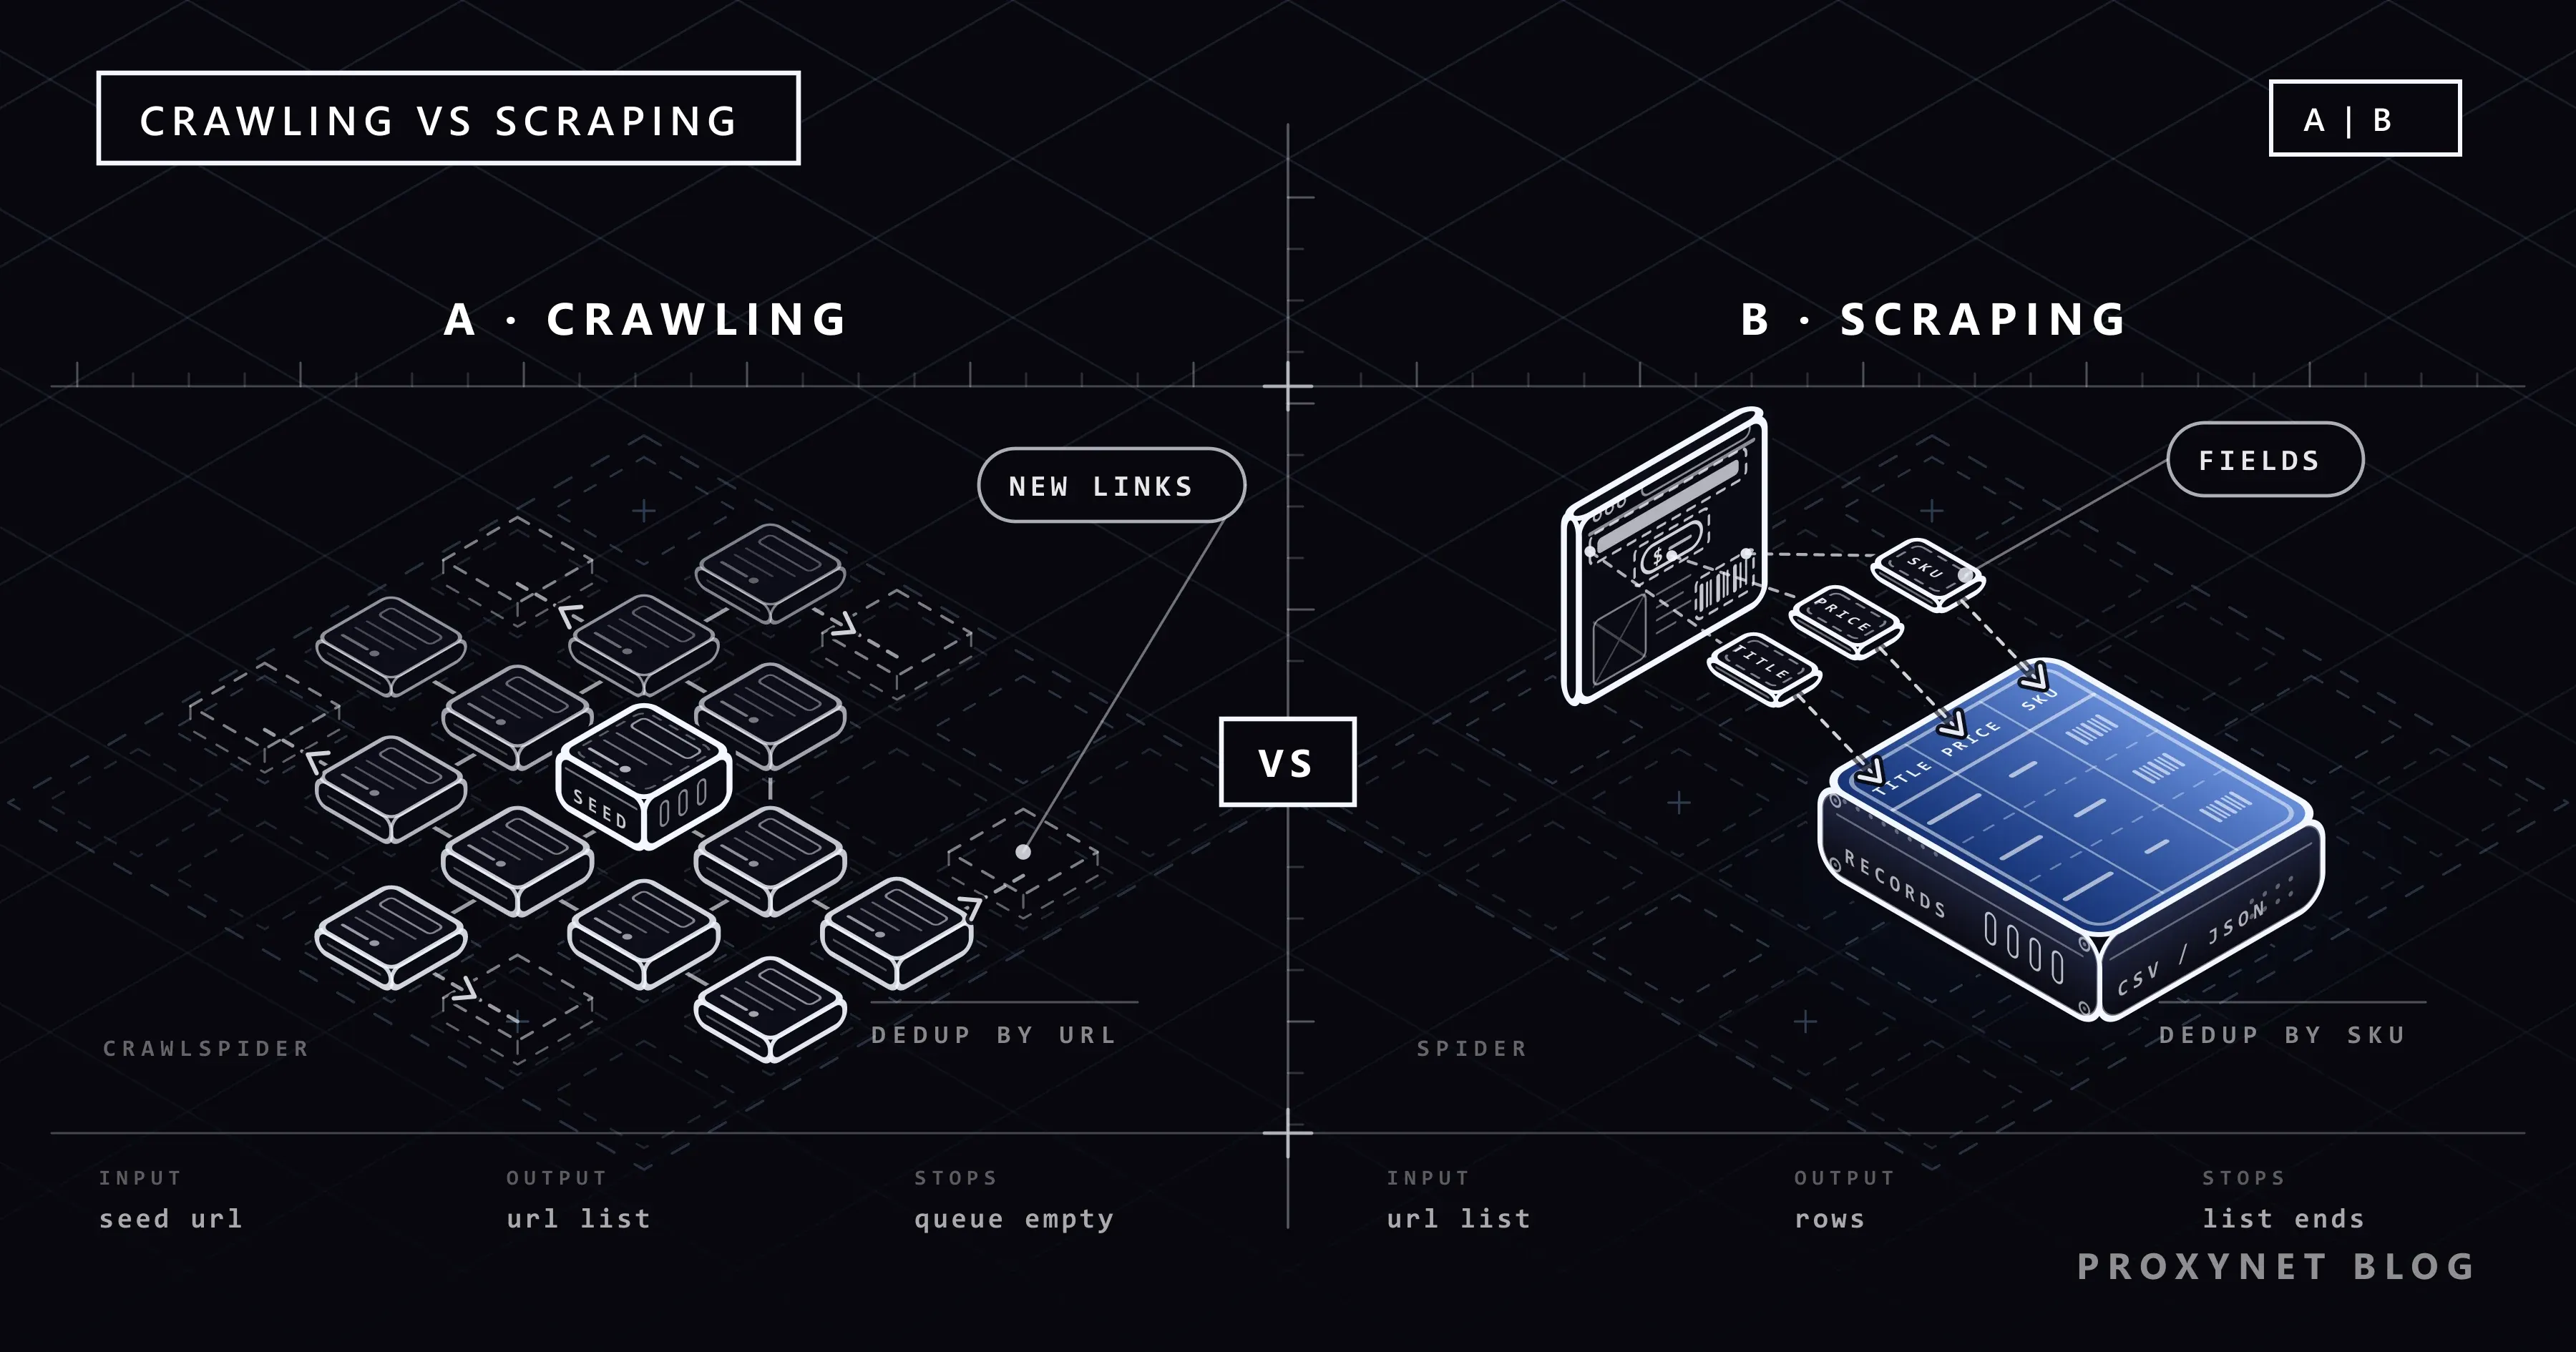
El web crawling (rastreo web) responde a la pregunta «¿adónde puedo ir?». Un crawler descarga una página, pone en cola los enlaces nuevos que encuentra y repite hasta que una regla lo detiene. El resultado es un mapa de las páginas que existen. Los trabajos de rastreo y los proxies que los sostienen están en nuestra página de rastreador web.
El web scraping responde a la pregunta «¿qué hay en esta página?». Un scraper abre una página que ya conoce y convierte las partes que leería una persona (nombre, precio, fecha, SKU) en una fila estructurada. La elección del método, de Excel a Python, está en nuestra página de extracción de datos y en Cómo extraer datos de una web. Los dos se confunden porque la mayoría de las herramientas hacen ambas cosas.
¿Qué pasa cuando la misma página llega a un crawler y a un scraper?
Dale la misma página de categoría de una librería a los dos. El crawler lee sus enlaces:
- Recoge los valores
<a href>del menú de categorías y del botón «siguiente». - Convierte las direcciones relativas en absolutas y las normaliza, de modo que dos grafías de una misma dirección queden en una sola cadena.
- Compara cada dirección con el conjunto de URL que ya ha visto.
- Añade las nuevas que cumplen sus reglas de dominio y profundidad a la frontera (frontier), la cola de URL que esperan su descarga.
El scraper lee su contenido:
- Encuentra los campos con selectores (Selector CSS o XPath).
- Comprueba los tipos: un precio es un número, un SKU no está vacío.
- Fusiona la fila con las anteriores mediante una clave de registro.
- Escribe la fila en un archivo o en una base de datos.
Web crawling vs. web scraping: tabla comparativa
| Eje | Web crawling | Web scraping |
|---|---|---|
| Entrada | Unas pocas URL semilla y reglas para seguir enlaces | Una lista de URL de páginas conocidas |
| Salida | Una lista de URL o un conjunto de páginas descargadas | Filas estructuradas (CSV, JSON, una tabla de base de datos) |
| Condición de parada | La frontera se vacía o se alcanza un límite de profundidad, de dominio o de páginas | Se acaba la lista |
| Unidad de deduplicación | La URL o la huella de la solicitud | La clave del registro (SKU, ID de anuncio) |
| Qué limita la velocidad | Las solicitudes simultáneas por host y las reglas de robots.txt | El límite de velocidad del sitio de destino y el tiempo de análisis |
| Relación con robots.txt | Se encuentra con líneas Disallow en rutas que descubre por su cuenta | Toda la lista se puede comprobar antes de la ejecución |
| Fallo típico | Variantes de URL sin fin, deriva hacia otros dominios | Una plantilla que cambia y devuelve campos vacíos |
La diferencia viene de la pregunta que plantea el trabajo, no de la herramienta: adónde ir después o qué tomar de aquí.
Bot de buscador frente a bot de precios: los dos extremos de la escala
Googlebot está en el extremo del rastreo. La guía de Google sobre cómo funciona la Búsqueda dice que algunas páginas se conocen por visitas anteriores, otras se encuentran a través de enlaces en páginas conocidas y los sitemaps añaden más. Un algoritmo decide qué sitios rastrear, con qué frecuencia y cuántas páginas descargar, y el crawler va más despacio cuando un servidor devuelve errores. Los duplicados se agrupan más tarde, en la indexación, bajo una página canónica. La guía del presupuesto de rastreo de Google está pensada sobre todo para sitios con más de un millón de páginas únicas que cambian más o menos cada semana, o con más de 10.000 páginas que cambian a diario.
Un bot de precios está en el extremo del scraping. Tiene una lista fija de URL de producto, no sigue enlaces y devuelve el mismo conjunto de filas cada día.
La mayoría de los trabajos comerciales quedan en medio: un rastreo semanal de categorías encuentra productos nuevos, y un scraper diario lee los precios de la lista que el rastreo mantiene al día, como en Cómo hacer seguimiento de precios de la competencia. Cómo distinguen los sitios a los bots de búsqueda verificados del resto del tráfico se explica en Cómo funciona la detección de bots y en Cloudflare y scraping.
¿Dónde se detiene un crawler en un sitio?
Un crawler no tiene una lista que terminar, así que son las reglas las que deciden hasta dónde llega:
- La frontera se vacía. Se han descargado todas las URL descubiertas y no ha aparecido ninguna nueva.
- Límite de profundidad. La profundidad cuenta los saltos de enlace desde la semilla. En Scrapy,
DEPTH_LIMITvale0por defecto, lo que significa sin límite. - Límite de dominio.
allowed_domainsmantiene al crawler en el sitio de destino y sus subdominios. Desde Scrapy 2.18, los cambios que se le hacen durante un rastreo surten efecto. - Tope de páginas. Un límite estricto como
CLOSESPIDER_PAGECOUNTtermina la ejecución pase lo que pase.
La normalización de URL decide si la frontera llega a vaciarse alguna vez. La sección 6 de RFC 3986 describe los pasos: pasar a minúsculas el esquema y el host, decodificar los caracteres no reservados codificados con porcentaje, eliminar los segmentos . y .. y quitar el puerto por defecto, de modo que http://example.com y http://example.com:80/ son el mismo recurso. A partir de ahí, decides tú qué parámetros de consulta importan: un criterio de ordenación o un ID de sesión crea una dirección nueva para el mismo contenido.
Algunos sitios generan direcciones sin fin, como un calendario con un enlace «mes siguiente» o combinaciones de filtros que se multiplican con cada clic. Sin un límite de profundidad y un tope de páginas, un crawler nunca sale de ellas. Los enlaces trampa colocados a propósito funcionan igual (Trampas honeypot). Un sitemap publicado suele ser una lista de partida mejor que seguir enlaces (Cómo encontrar el sitemap de un sitio web).
¿En qué capa eliminas los duplicados: URL o registro?
Un crawler elimina las solicitudes duplicadas. El DUPEFILTER_CLASS por defecto de Scrapy es RFPDupeFilter, que compara huellas de solicitud, así que una página no se descarga dos veces en la misma ejecución.
Un scraper elimina los registros duplicados. Un producto puede llegar desde dos URL, a través de su categoría y a través de una página de ofertas, y el filtro de URL deja pasar las dos. La clave tiene que salir de los datos: un SKU, un código de producto o un ID de anuncio. Por eso es falsa la idea de que el scraping no necesita deduplicación. Cómo guardar filas por clave en SQLite se muestra en Paginación en web scraping.
¿Cómo afectan robots.txt y las reglas de velocidad a un crawler?
RFC 9309 llama a los crawlers clientes automatizados, pone como ejemplo los crawlers de buscadores que «recorren enlaces de forma recursiva» y dice que las reglas de robots.txt «no son una forma de autorización de acceso». Un crawler legítimo las sigue de todos modos, y no debería usar una copia en caché durante más de 24 horas salvo que no se pueda acceder al archivo. Un crawler se encuentra con líneas Disallow más a menudo, porque entra continuamente en rutas nuevas. La sintaxis y Crawl-delay están en Qué es robots.txt y cómo leerlo.
La velocidad se limita por host con CONCURRENT_REQUESTS_PER_DOMAIN y DOWNLOAD_DELAY. Los valores por defecto del código de Scrapy son 8 y 0; el settings.py que genera scrapy startproject fija 1 y 1 y activa ROBOTSTXT_OBEY, que en los valores por defecto del código es False. Cómo elegir la cifra está en Concurrencia y paralelismo, cómo reintentar un 429 en Códigos de estado HTTP en web scraping y cómo repartir las solicitudes entre direcciones en Cómo rotar proxies en Python. Un rastreo amplio sobre muchos hosts encaja con un Proxies rotativos; una lista fija y corta suele funcionar bien con un Proxies de centro de datos.
¿Cómo se unen el rastreo y el scraping en un mismo pipeline?
En un proyecto real, los dos trabajos son etapas de un mismo ciclo:
- Descubrimiento. Las URL semilla y las entradas del sitemap entran en el sistema.
- Frontera. Una cola guarda las URL con una prioridad y una etiqueta de profundidad.
- Descarga. Las solicitudes salen bajo un límite de velocidad por host, con reintentos ante errores temporales.
- Análisis. Cada página produce registros para la salida y enlaces nuevos para la frontera.
Guarda la cola en disco para que un rastreo interrumpido pueda reanudarse: Scrapy usa JOBDIR, y una versión con SQLite está en Paginación en web scraping. Por defecto, Scrapy rastrea en profundidad (depth-first), porque sus colas por defecto son LIFO; un DEPTH_PRIORITY positivo con colas FIFO lo acerca a un rastreo en anchura (breadth-first).
¿Qué diferencia hay entre Spider y CrawlSpider en Scrapy?
scrapy.Spider parte de start_urls y llama a parse para cada respuesta. Solo sigue un enlace cuando tu código emite (yield) una solicitud nueva, así que con una lista fija es un scraper puro.
CrawlSpider traslada el seguimiento de enlaces a rules. Cada Rule combina un LinkExtractor con un callback opcional y un indicador follow. La documentación de spiders de Scrapy fija el valor por defecto: si callback es None, follow vale True por defecto; si no, False. Una regla sin callback recorre páginas; una regla con callback analiza páginas y se detiene ahí. La misma página advierte de que una solicitud que creas tú dentro de un CrawlSpider necesita un callback explícito; una solicitud sin él vuelve a pasar por las reglas.
El archivo de abajo ejecuta los dos en un sitio de práctica hecho para ejercicios de scraping. Necesita Scrapy 2.19 (publicado el 10 de septiembre de 2026, con Python 3.10 o posterior). La instalación y el middleware de proxy están en Qué es Scrapy y cómo usarlo con un proxy.
"""Un sitio de práctica, dos trabajos: un scraper de lista y un crawler basado en reglas."""
import sys

import scrapy
from scrapy.crawler import CrawlerProcess
from scrapy.linkextractors import LinkExtractor
from scrapy.spiders import CrawlSpider, Rule

POLITE = {
    "ROBOTSTXT_OBEY": True,  # un script suelto no tiene settings.py de proyecto, así que se fija aquí
    "CONCURRENT_REQUESTS_PER_DOMAIN": 2,
    "DOWNLOAD_DELAY": 1,
    "RETRY_TIMES": 2,  # RetryMiddleware: hasta 2 reintentos ante 429, 500/502/503/504 y timeouts
    "USER_AGENT": "ExampleCatalogBot/1.0 (+https://example.com/bot)",
}


def product(response):
    """El registro: el UPC es su clave, así que dos URL de un mismo libro dan una sola fila."""
    return {
        "upc": response.xpath("//th[text()='UPC']/following-sibling::td/text()").get(),
        "title": response.css("div.product_main h1::text").get(),
        "price": response.css("div.product_main p.price_color::text").get(),
        "url": response.url,
    }


class ListSpider(scrapy.Spider):
    """Scraping: una lista conocida de URL de producto, sin seguir enlaces."""

    name = "list"
    custom_settings = POLITE
    start_urls = [
        "https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html",
        "https://books.toscrape.com/catalogue/tipping-the-velvet_999/index.html",
        "https://books.toscrape.com/catalogue/soumission_998/index.html",
    ]

    def parse(self, response):
        yield product(response)


class CatalogSpider(CrawlSpider):
    """Crawling: encuentra páginas de producto siguiendo enlaces de categoría y de página siguiente."""

    name = "catalog"
    allowed_domains = ["books.toscrape.com"]
    start_urls = ["https://books.toscrape.com/catalogue/category/books/poetry_23/index.html"]
    custom_settings = {**POLITE, "DEPTH_LIMIT": 3, "CLOSESPIDER_PAGECOUNT": 60}
    rules = (
        # Sin callback, así que follow vale True por defecto: se siguen los enlaces de estas páginas.
        Rule(LinkExtractor(restrict_css=("ul.nav-list", "li.next"))),
        # Con callback, así que follow vale False por defecto: las páginas de producto se analizan, no se rastrean.
        Rule(LinkExtractor(restrict_css="article.product_pod h3"), callback="parse_item"),
    )

    def parse_item(self, response):
        yield product(response)


if __name__ == "__main__":
    spider = CatalogSpider if sys.argv[1:] == ["catalog"] else ListSpider
    feed = {f"{spider.name}.jsonl": {"format": "jsonlines", "encoding": "utf-8"}}
    process = CrawlerProcess(settings={"FEEDS": feed})
    process.crawl(spider)
    process.start()
python spiders.py ejecuta el scraper, y python spiders.py catalog, el crawler. Usamos un bloque __main__ porque scrapy runspider solo elige una clase de spider de un archivo que contiene dos. Para usar un proxy, define antes https_proxy=http://user:pass@pr.proxynet.io:8000 en el entorno; el HttpProxyMiddleware de Scrapy lo lee.
Qué mostraron las ejecuciones
Ejecutamos los dos con Python 3.13 y Scrapy 2.19.0, directamente y a través de un proxy de prueba local:
- El scraper envió cuatro solicitudes,
robots.txt(un404, así que sin reglas) y las tres URL, y escribió tres filas. - El crawler se cerró con
finish_reason: closespider_pagecounty 56 libros únicos tras 74 páginas, no 60: las solicitudes ya entregadas al descargador terminan igualmente, así que el tope es aproximado. - El filtro de duplicados descartó 867 solicitudes, porque cada página de categoría enlaza las 50 categorías en su menú.
- Con
DEPTH_LIMITen 1, el crawler ignoró 3.151 enlaces más profundos, recogió solo los 19 libros de poesía enlazados desde la semilla y terminó confinish_reason: finishedcuando se vació su frontera. - A través del proxy, el scraper devolvió las mismas filas. Con una contraseña incorrecta, cada
407se reintentó dos veces antes de que Scrapy se rindiera.
Casos de uso
- Seguimiento de precios de la competencia: una lista fija que se extrae a diario más un rastreo semanal para encontrar productos nuevos (Cómo hacer seguimiento de precios de la competencia).
- Seguimiento de precios a escala: muchas tiendas, cada una leída a su propio ritmo (seguimiento de precios).
- Auditorías SEO de sitios: los enlaces rotos y las páginas huérfanas son rastreo puro, con URL y códigos de estado como salida (proxy SEO).
- Protección de marca: un rastreo del marketplace encuentra anuncios nuevos, y un scraper lee el vendedor y el precio (protección de marca).
- Catálogos con JavaScript: el rastreo encuentra las páginas, y un navegador headless renderiza solo las que lo necesitan (Páginas estáticas y dinámicas en web scraping).
Errores comunes
- Rastrear un sitio entero para un trabajo de lista fija. Carga el sitio para nada y choca con más líneas
Disallow. - Saltarse la normalización de URL. La misma página con los parámetros de consulta en otro orden se descarga una y otra vez.
follow=Trueen una regla con callback sin límite de profundidad. Cada página de producto se convierte en un nuevo punto de partida, y el rastreo se extiende por los enlaces a artículos relacionados.- Omitir
allowed_domains. Basta un enlace a una tienda asociada para que el crawler salga del sitio de destino. - Descargar robots.txt en cada solicitud, o no volver a descargarlo nunca. Una vez por host es suficiente; en ejecuciones largas, actualízalo antes de que pasen 24 horas.
- Filas sin clave de registro. Un producto encontrado por dos caminos se escribe dos veces.
- Emitir tu propia solicitud sin callback en un
CrawlSpider. Vuelve a pasar por las reglas en lugar de llegar a tu parser.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Mi lista de URL de producto es fija y leo los precios a diario | Solo un scraper (scrapy.Spider o un cliente HTTP) |
| También quiero los productos nuevos del competidor | Un rastreo semanal de categorías que añade URL, más el scraper diario |
| Necesito todas las páginas de mi sitio para encontrar enlaces rotos | Un crawler puro; la salida son URL y códigos de estado |
| Quiero que Scrapy siga enlaces según reglas | CrawlSpider con Rule y LinkExtractor, siempre con DEPTH_LIMIT y allowed_domains |
| El sitio publica un sitemap | Empieza por el sitemap; sigue enlaces solo en las secciones que no incluye |
| Un rastreo interrumpido no debe empezar de cero | Una cola persistente: el JOBDIR de Scrapy o una tabla SQLite |
Preguntas frecuentes
¿El web crawling y el web scraping son lo mismo?
No. El crawling descubre páginas siguiendo enlaces y produce una lista de URL. El scraping extrae campos de páginas conocidas y produce registros estructurados. Una herramienta que hace las dos cosas sigue haciendo dos trabajos.
¿Googlebot es un crawler o un scraper?
Un crawler. Encuentra URL a través de enlaces, sitemaps y visitas anteriores, y un algoritmo decide con qué frecuencia y a qué profundidad se rastrea cada sitio. No extrae campos en filas como hace un scraper de precios.
¿Qué diferencia hay entre Spider y CrawlSpider en Scrapy?
Un Spider solo sigue los enlaces que pide tu código, lo que encaja con una lista fija. Un CrawlSpider sigue enlaces mediante rules: una regla sin callback sigue enlaces por defecto, y una regla con callback analiza la página y por defecto no sigue. Las solicitudes que emites tú mismo necesitan un callback explícito.
¿Un crawler tiene que obedecer robots.txt?
RFC 9309 dice que las reglas no son una forma de autorización de acceso, así que el archivo no es un candado. Un crawler legítimo lo obedece de todos modos, mantiene una velocidad baja y usa un User-Agent honesto. Las consecuencias legales dependen del país y del caso (¿El web scraping es legal?).
¿Qué librerías de Python se usan para el crawling y el scraping?
Scrapy cubre las dos cosas: planificador, filtro de duplicados, comprobación de robots.txt y límites de velocidad para el rastreo, y selectores para el scraping. Para una lista corta, Requests o HTTPX con BeautifulSoup o lxml suele bastar (HTTPX, Requests y AIOHTTP).
¿Necesitas un proxy para el crawling?
Un crawler envía muchas solicitudes a un mismo host, y los sitios limitan las solicitudes por IP. Un proxy reparte un rastreo amplio entre varias direcciones, pero cada host debe seguir recibiendo una velocidad respetuosa. Para rastreos grandes sobre muchos sitios, un Proxies rotativos da a cada solicitud o sesión una salida distinta.
En resumen
El web crawling averigua qué páginas existen siguiendo enlaces, y el web scraping convierte páginas conocidas en filas de datos. En la mayoría de los proyectos los une una cola: el rastreo la llena y el scraping la vacía. Cuando tu rastreo necesite salidas en un país concreto, consulta el Proxies residenciales o compara las opciones en nuestra página de servicios de proxy.