

































Web scraping · Blog de Proxynet

Publicado
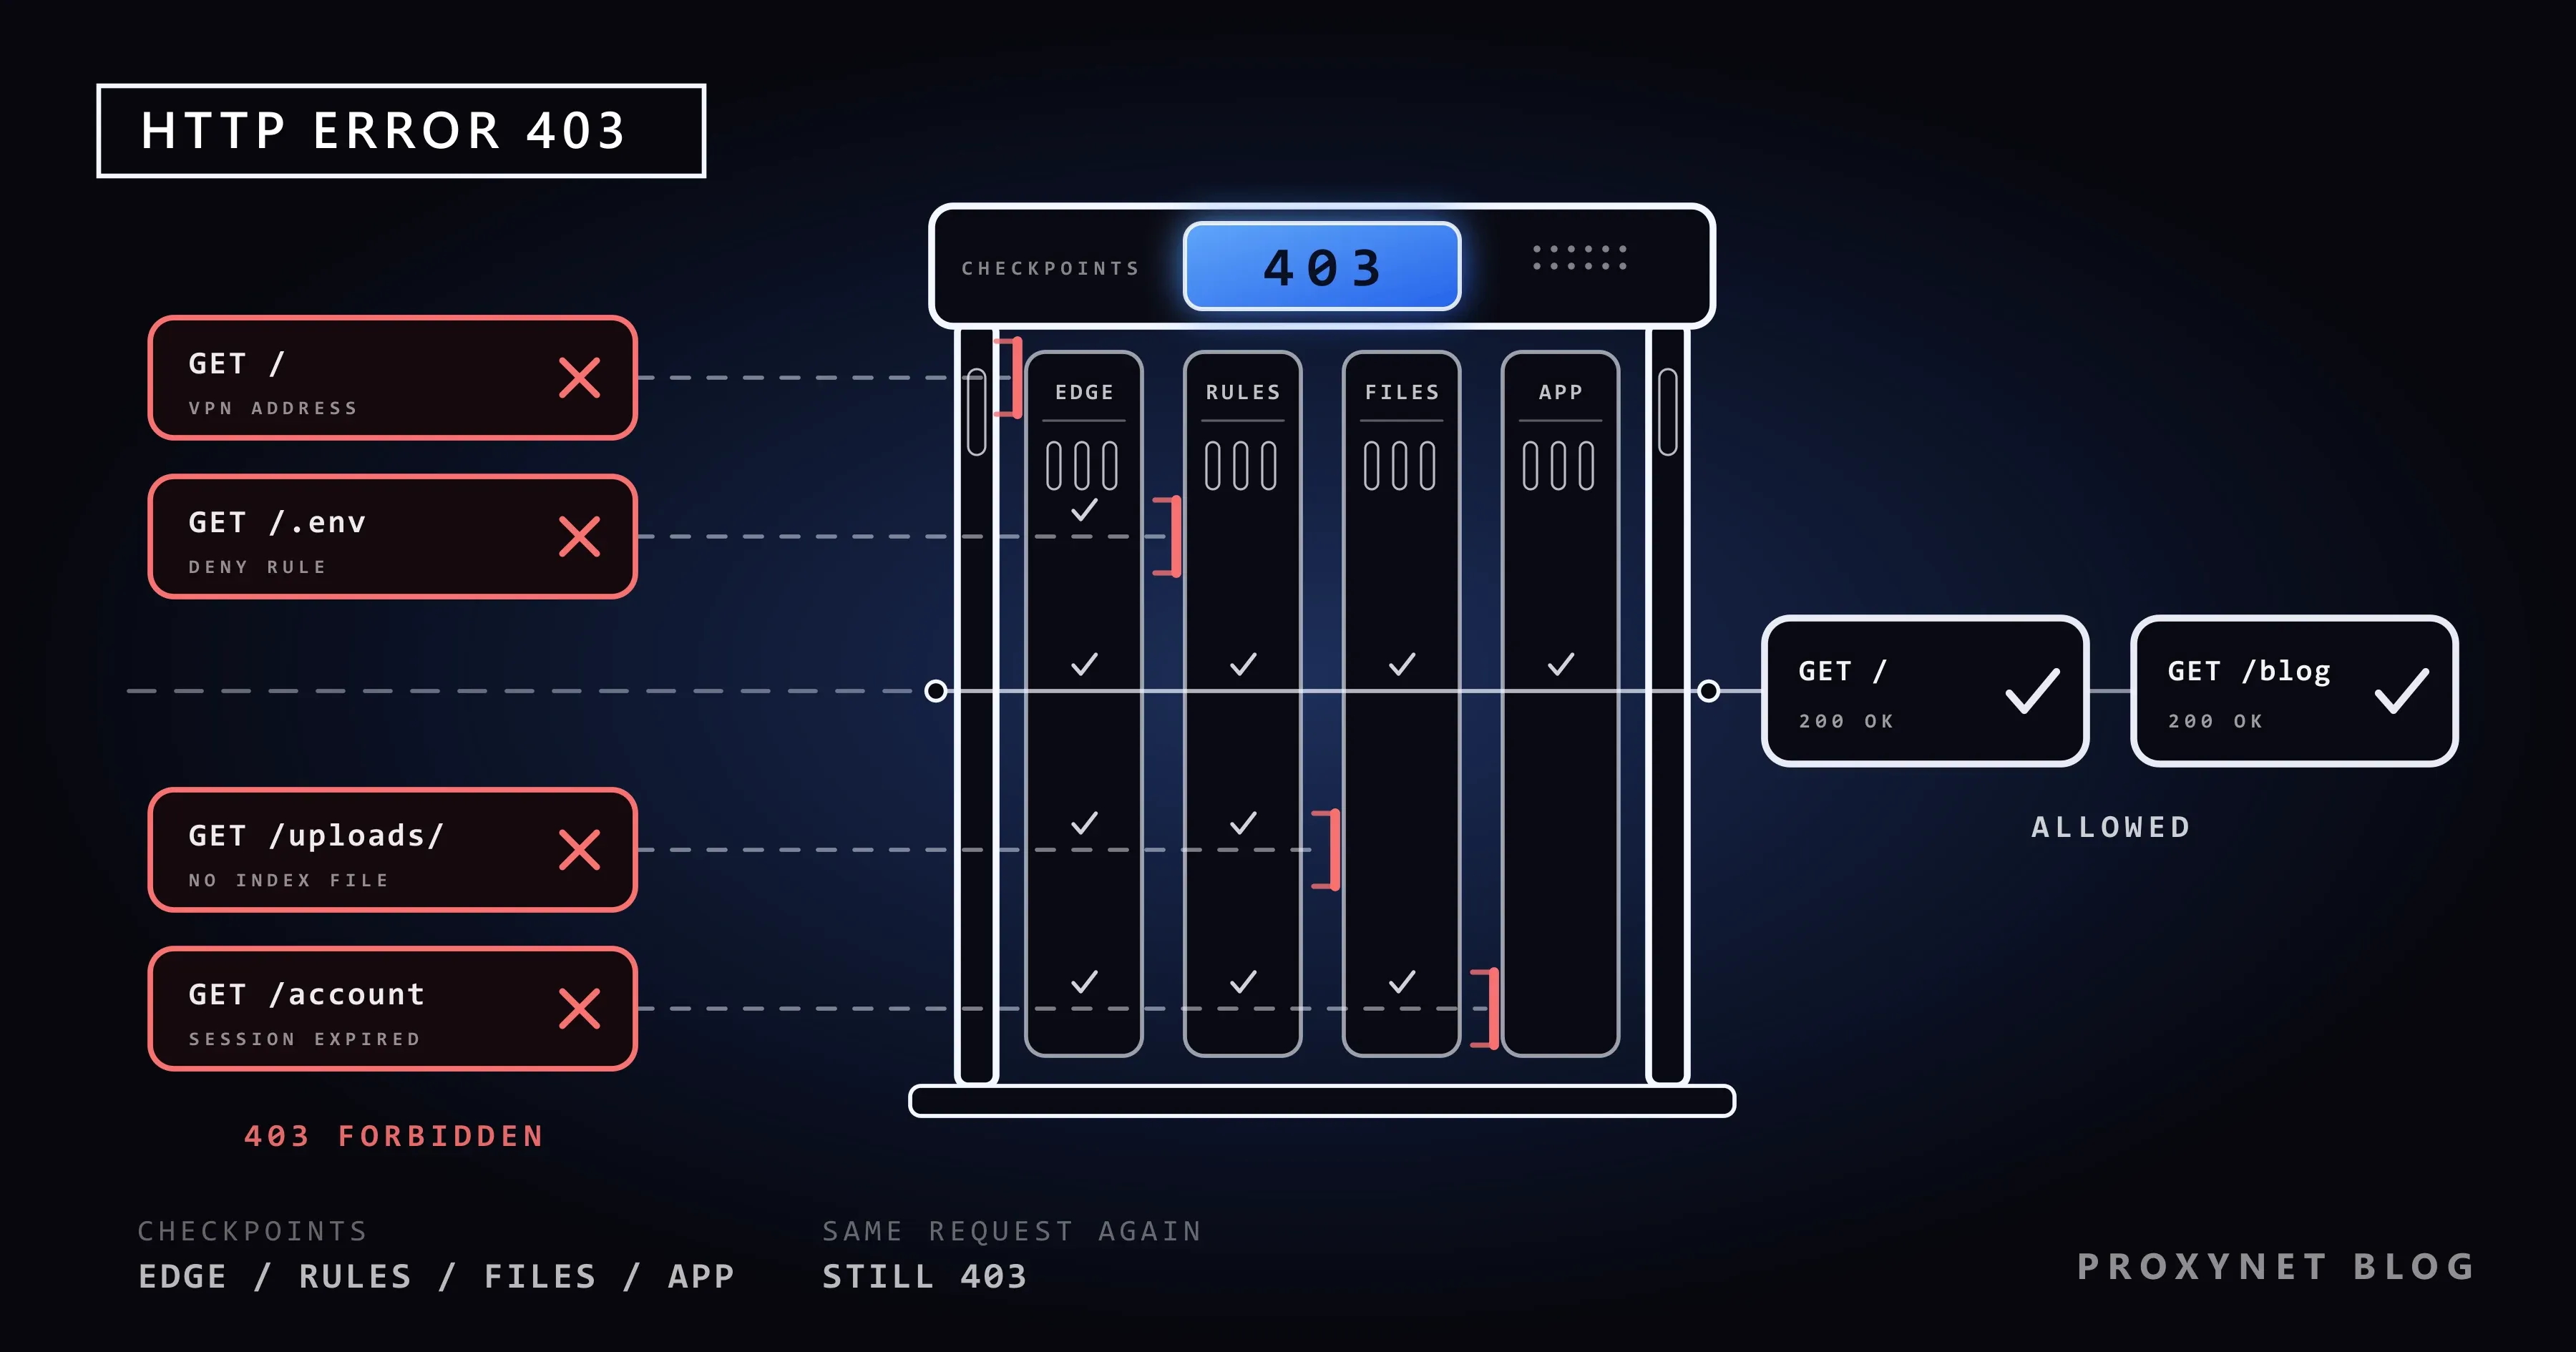
Error 403 Forbidden: qué significa y cómo resolverlo
403 forbidden significa que el servidor entendió tu solicitud y la rechaza por tu sesión, tu IP, tu país o un firewall. Cómo resolverlo en cada caso.
Autor: Acar Diveroli
Publicado
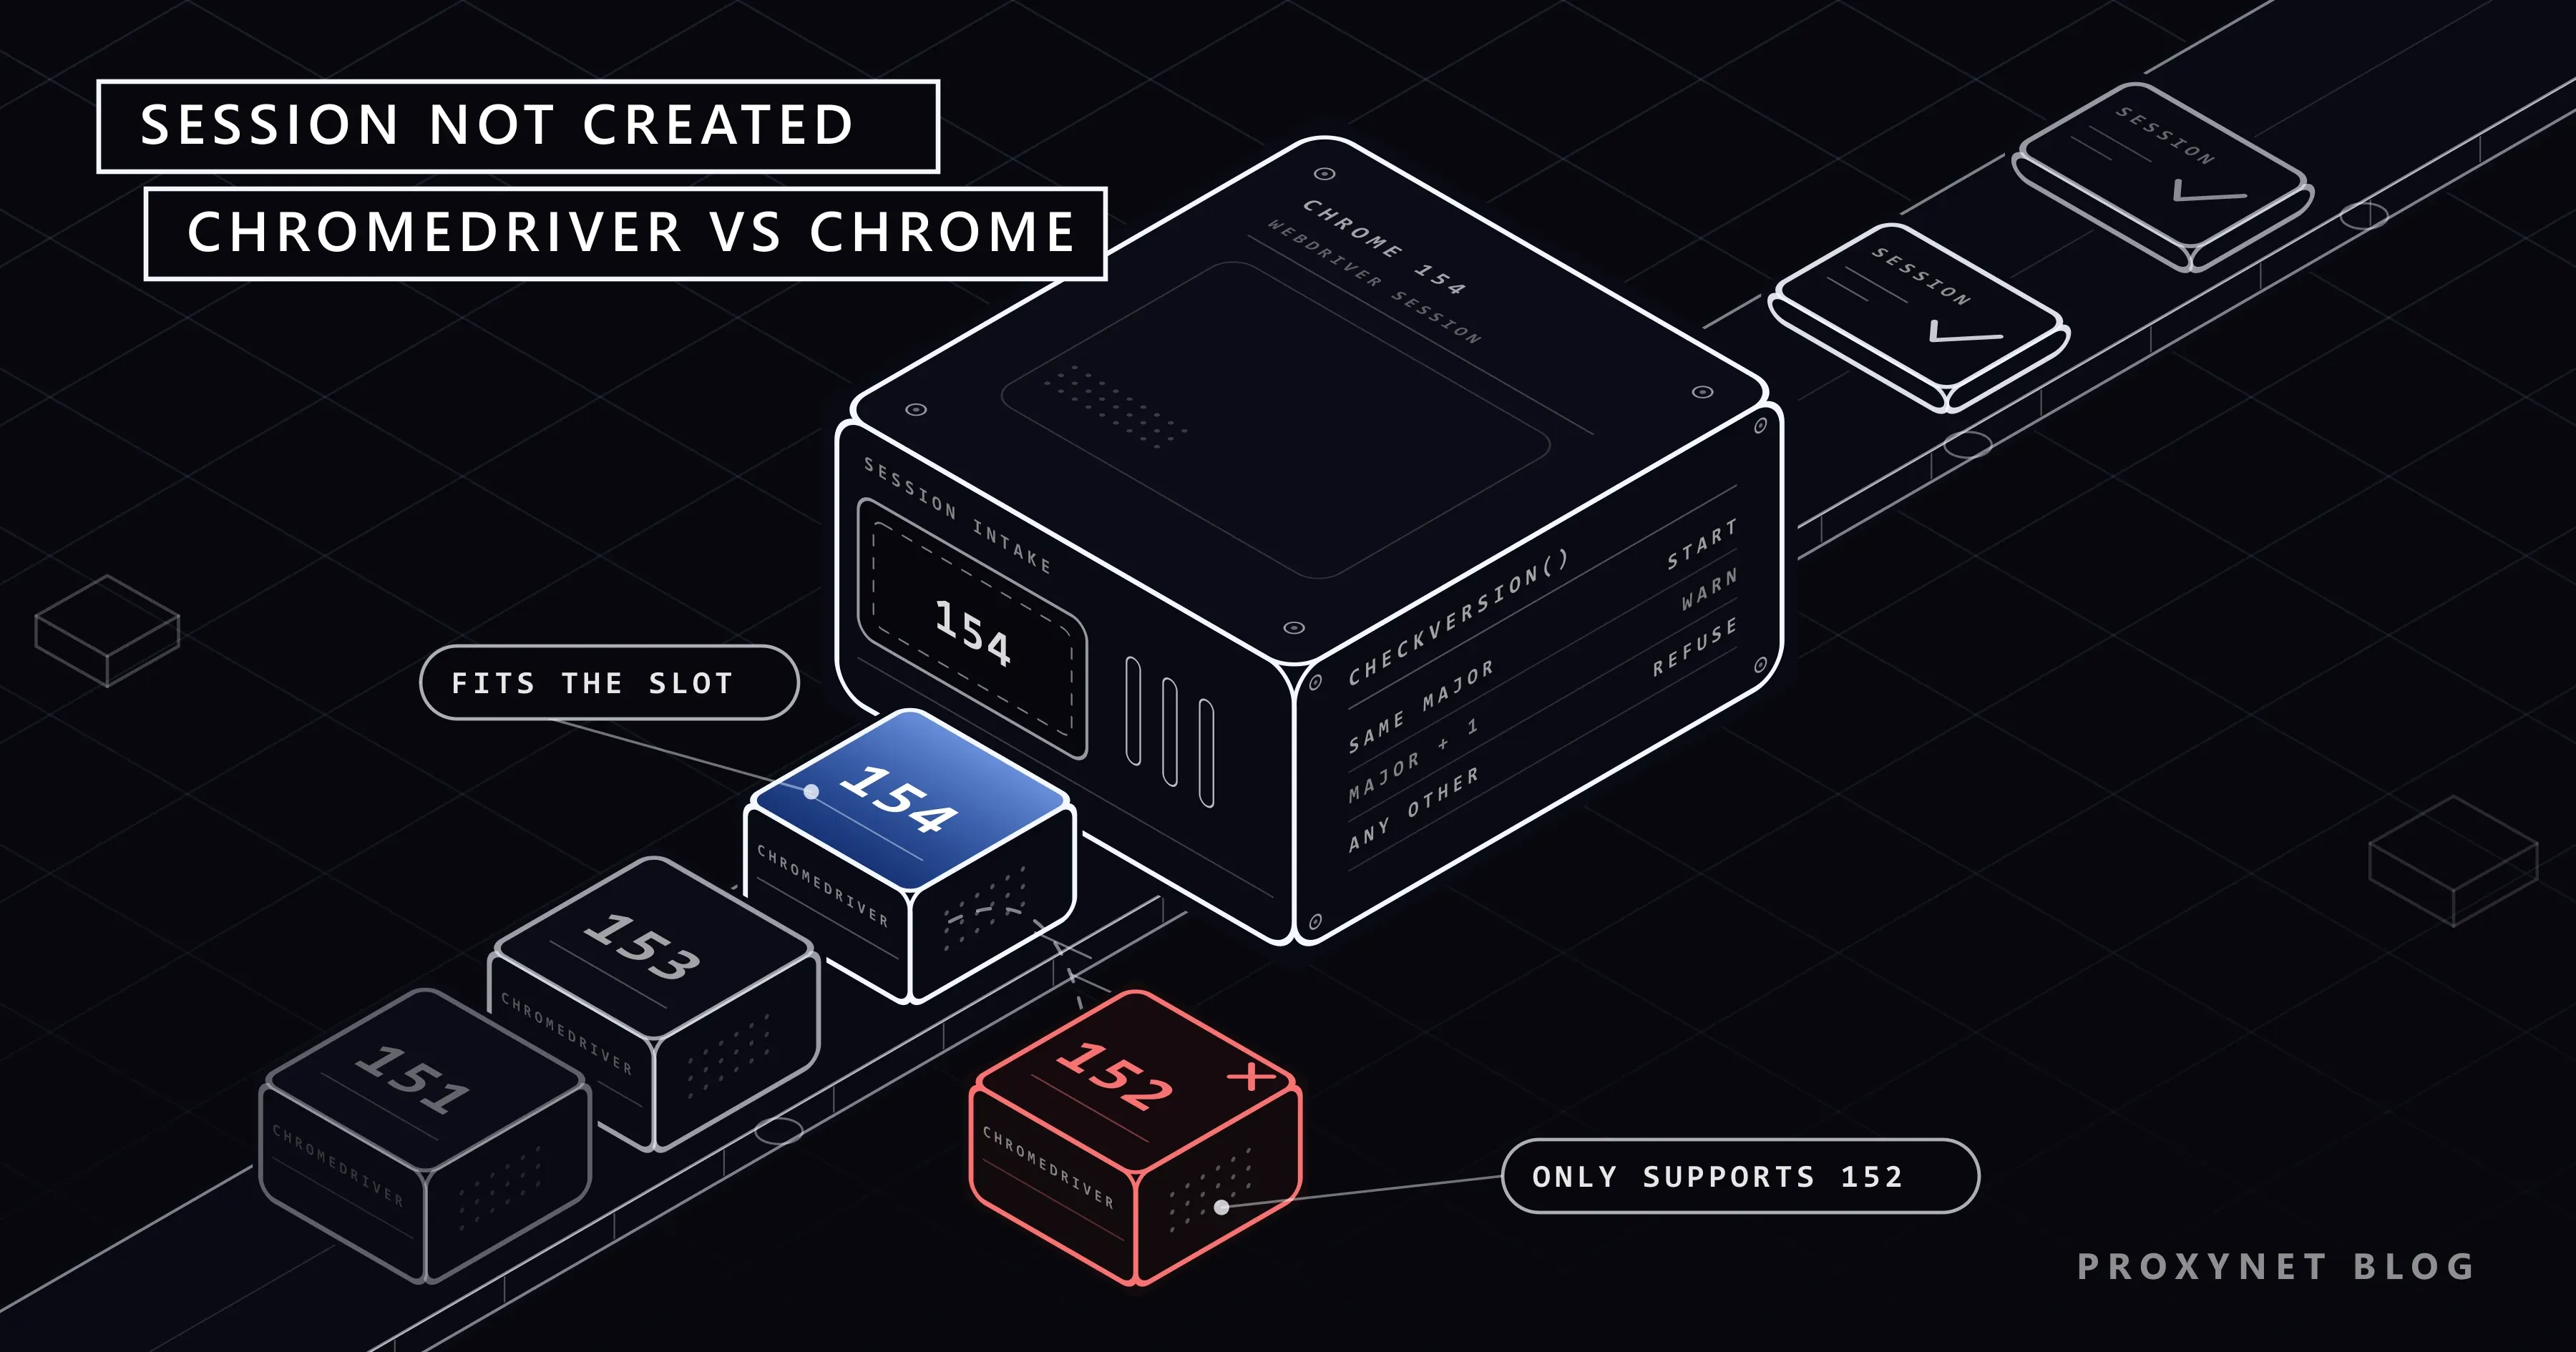
Versión de ChromeDriver incompatible: cómo solucionarlo
El error «This version of ChromeDriver only supports Chrome version N» indica que Chrome se actualizó y el driver no. Usa Selenium Manager o fija ambos.
Autor:Acar Diveroli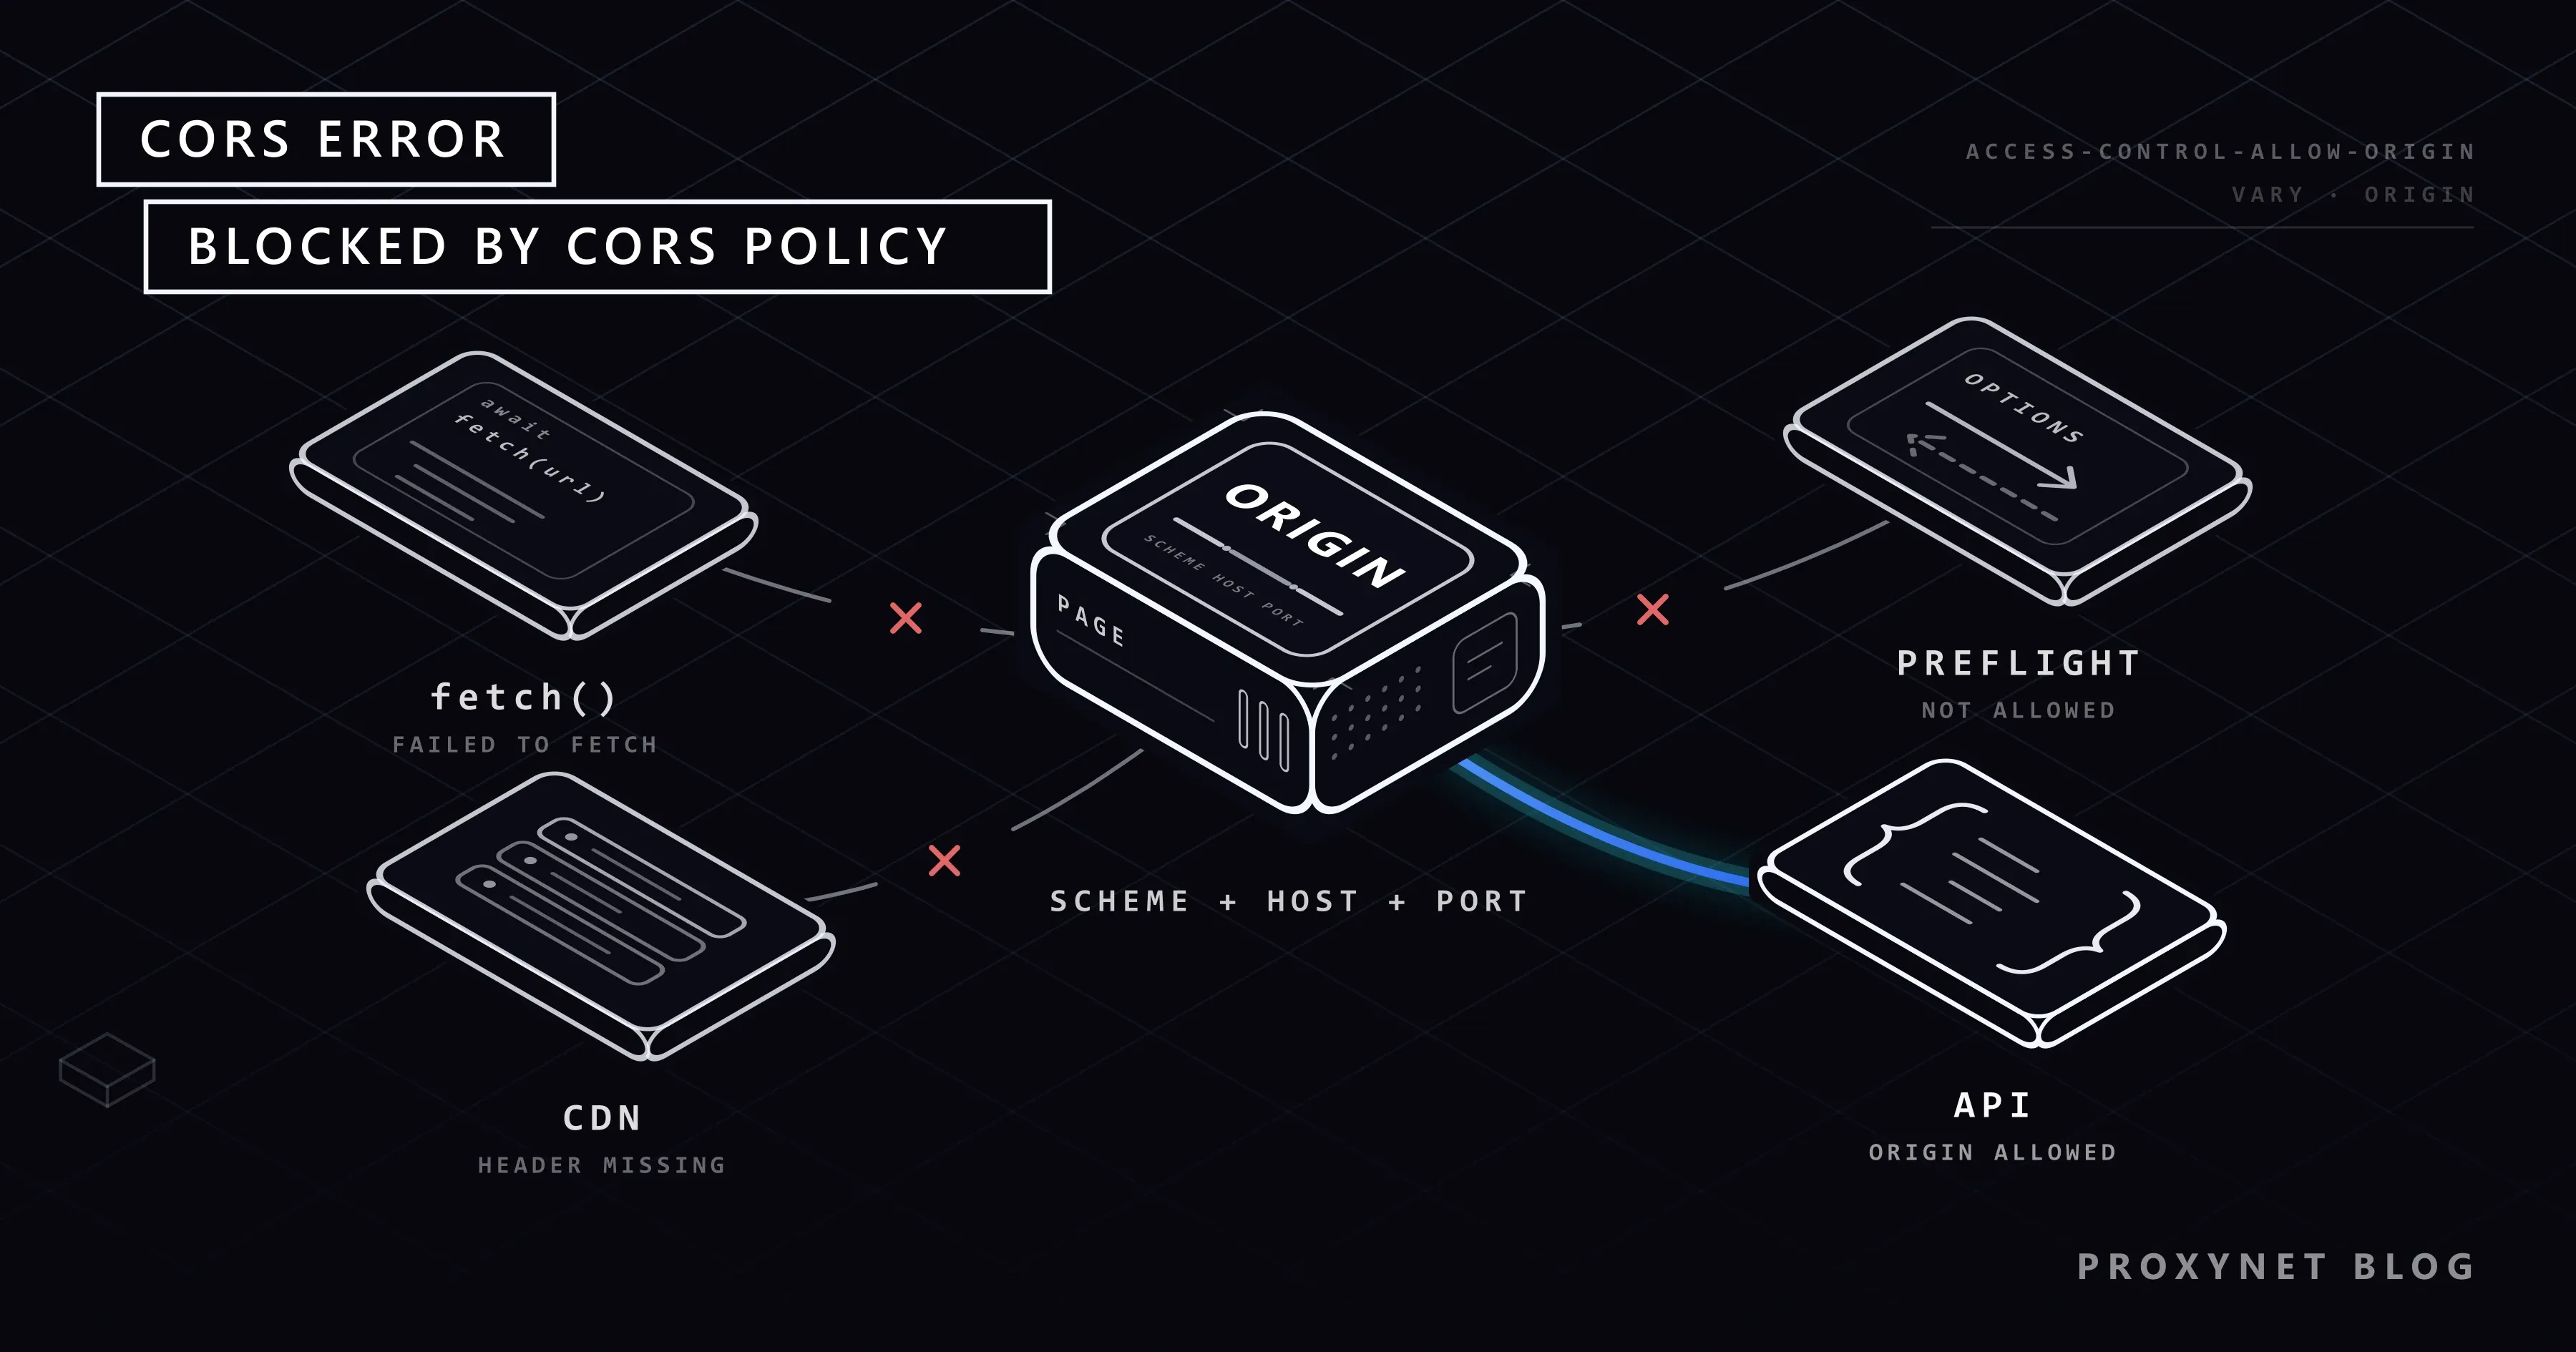
Publicado
Error CORS: qué es «blocked by CORS policy» y su solución
Un error CORS significa que el navegador no dejó a tu página leer la respuesta de otro origen. Te explicamos qué es blocked by CORS policy y cómo solucionarlo.
Autor:Acar Diveroli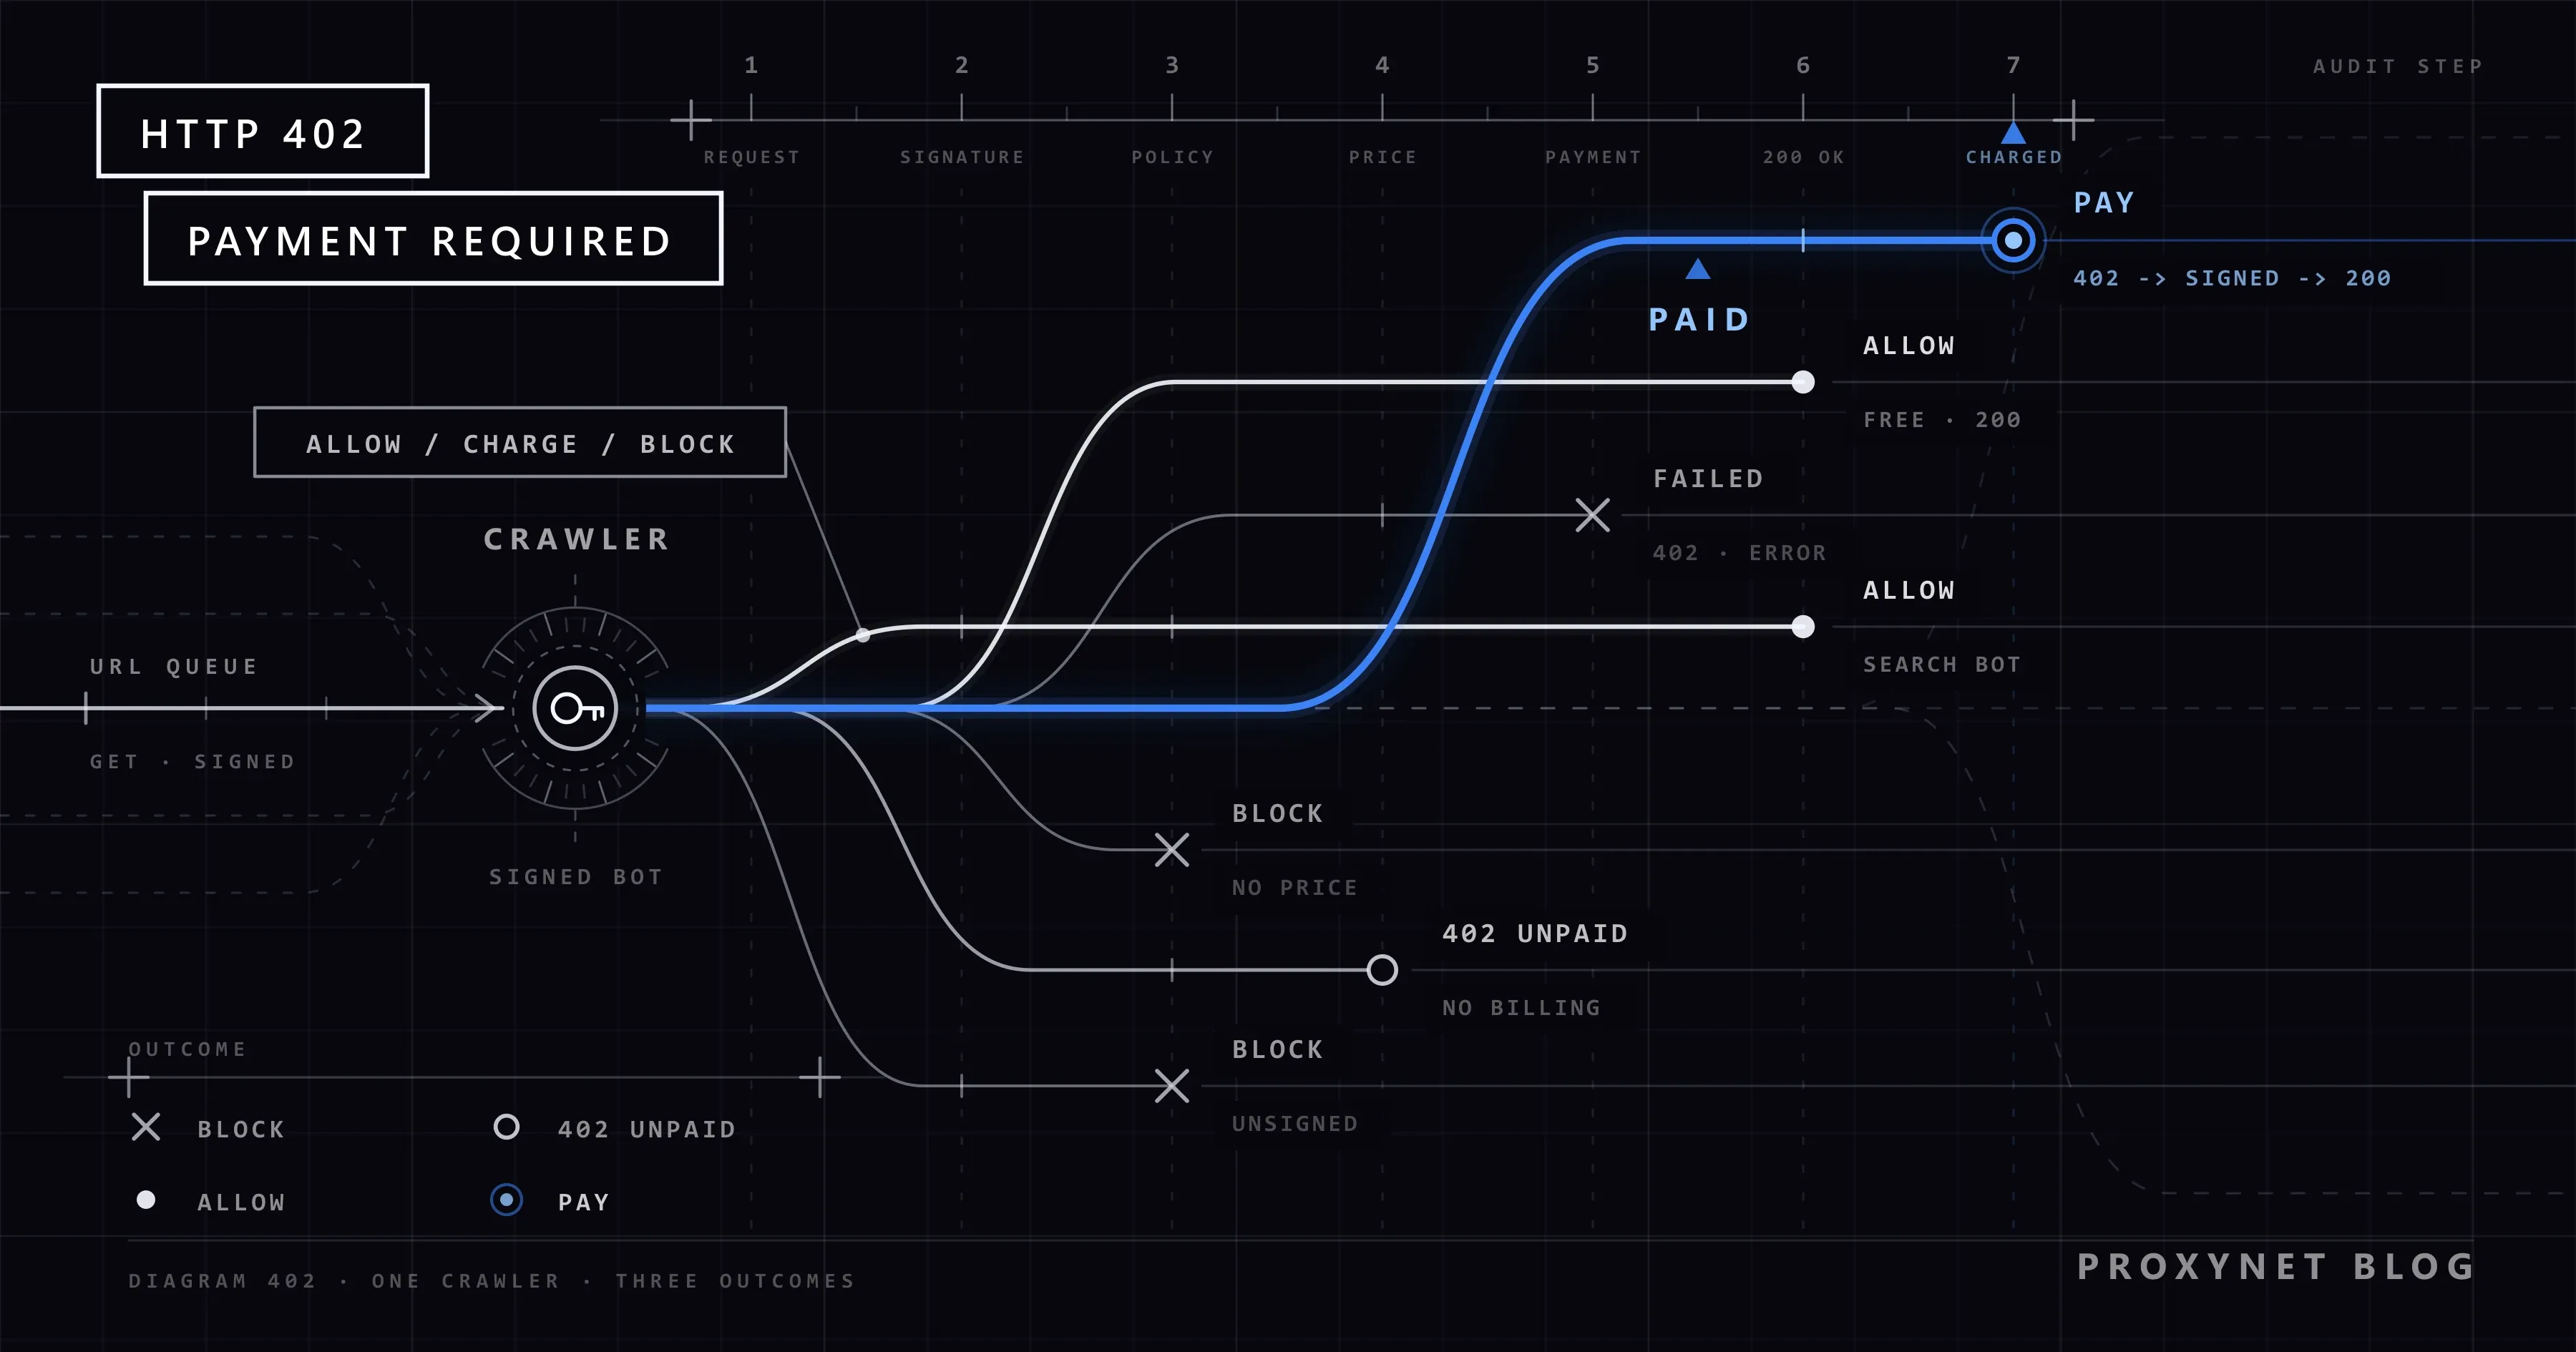
Publicado
¿Qué es HTTP 402 Payment Required? Pay per crawl y x402
HTTP 402 Payment Required significa que el servidor pide un pago antes de entregar el recurso. Por qué no se usó en décadas y cómo lo usan pay per crawl y x402.
Autor:Acar Diveroli
Publicado
Pardon Our Interruption: qué significa y cómo solucionarlo
Pardon Our Interruption es el control anti-bot de Imperva. Activa JavaScript y cookies, ve más despacio, quita bloqueadores y VPN y recarga o escribe al sitio.
Autor:Acar Diveroli
Publicado
Please Enable JS And Disable Any Ad Blocker: qué significa
Please Enable JS And Disable Any Ad Blocker es el aviso de reserva del control anti-bot de DataDome. Permite el sitio en tu bloqueador y activa JavaScript.
Autor:Acar Diveroli
Publicado
Proxy en Puppeteer: autenticación, rotación y SOCKS5
Puppeteer usa un proxy con el flag --proxy-server de Chrome o por contexto de navegador, y page.authenticate() para el login. Ejemplos probados y errores.
Autor:Acar Diveroli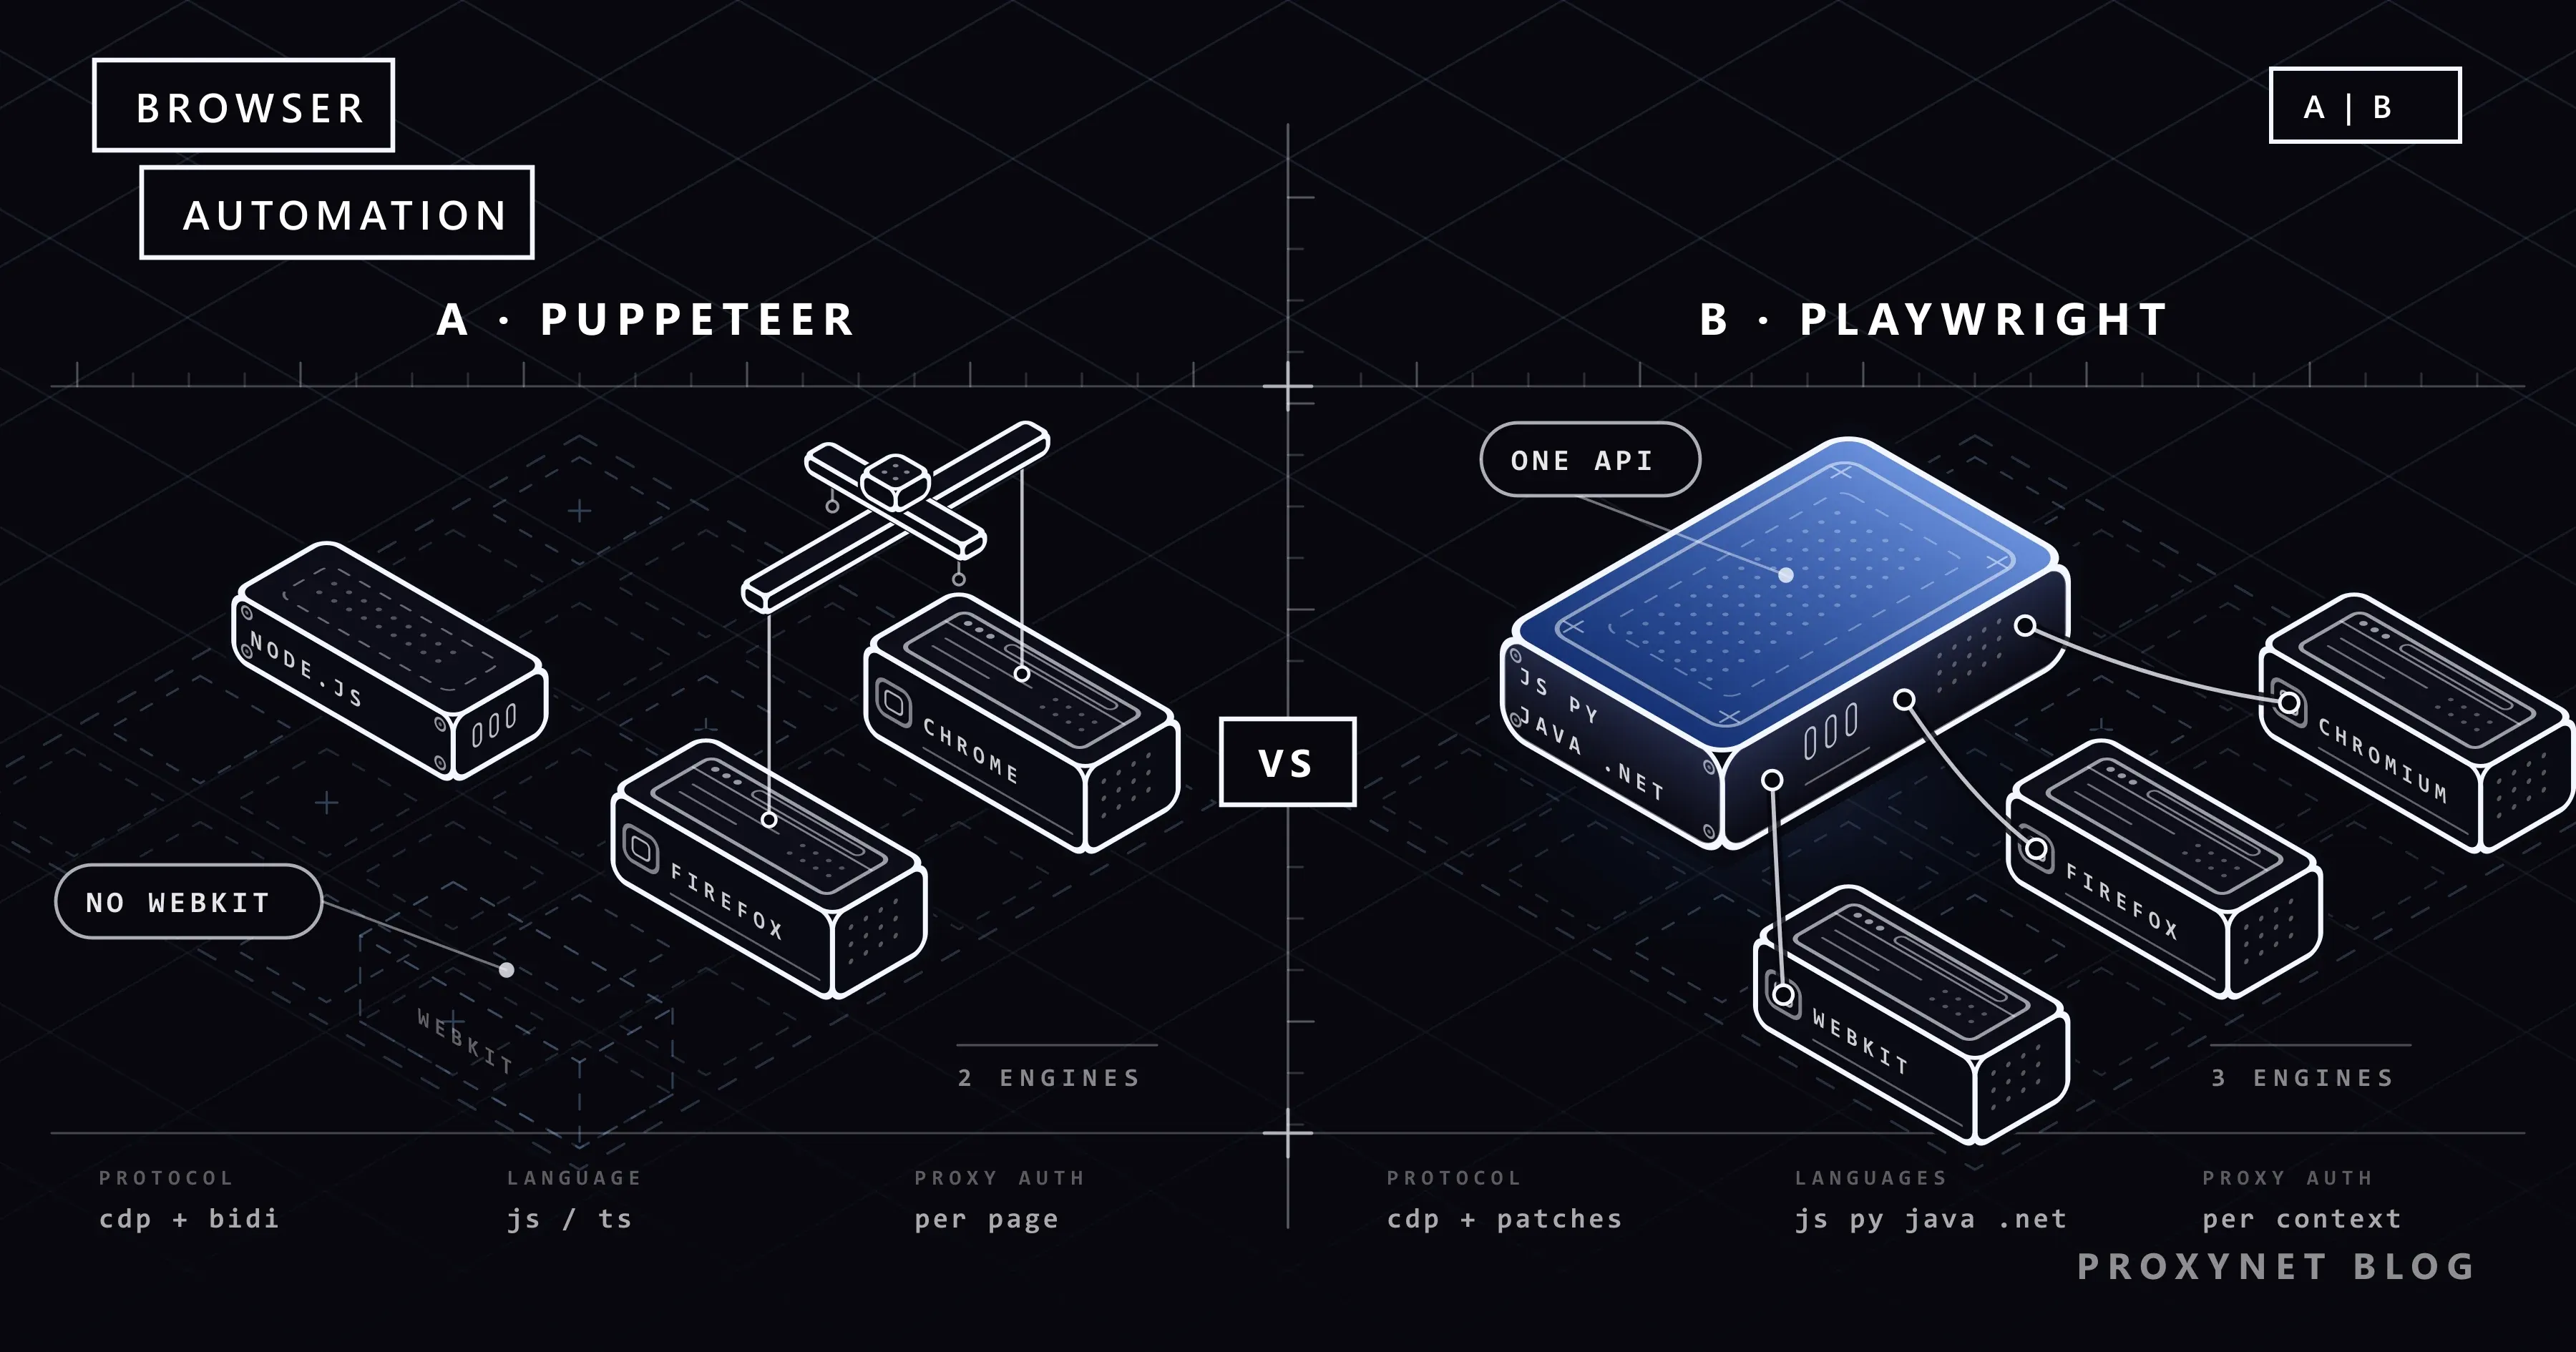
Publicado
Puppeteer vs Playwright: ¿cuál deberías elegir?
Puppeteer controla Chrome y Firefox desde Node.js; Playwright suma WebKit, cuatro lenguajes y un ejecutor de pruebas. Comparamos proxies, esperas y MCP.
Autor:Acar Diveroli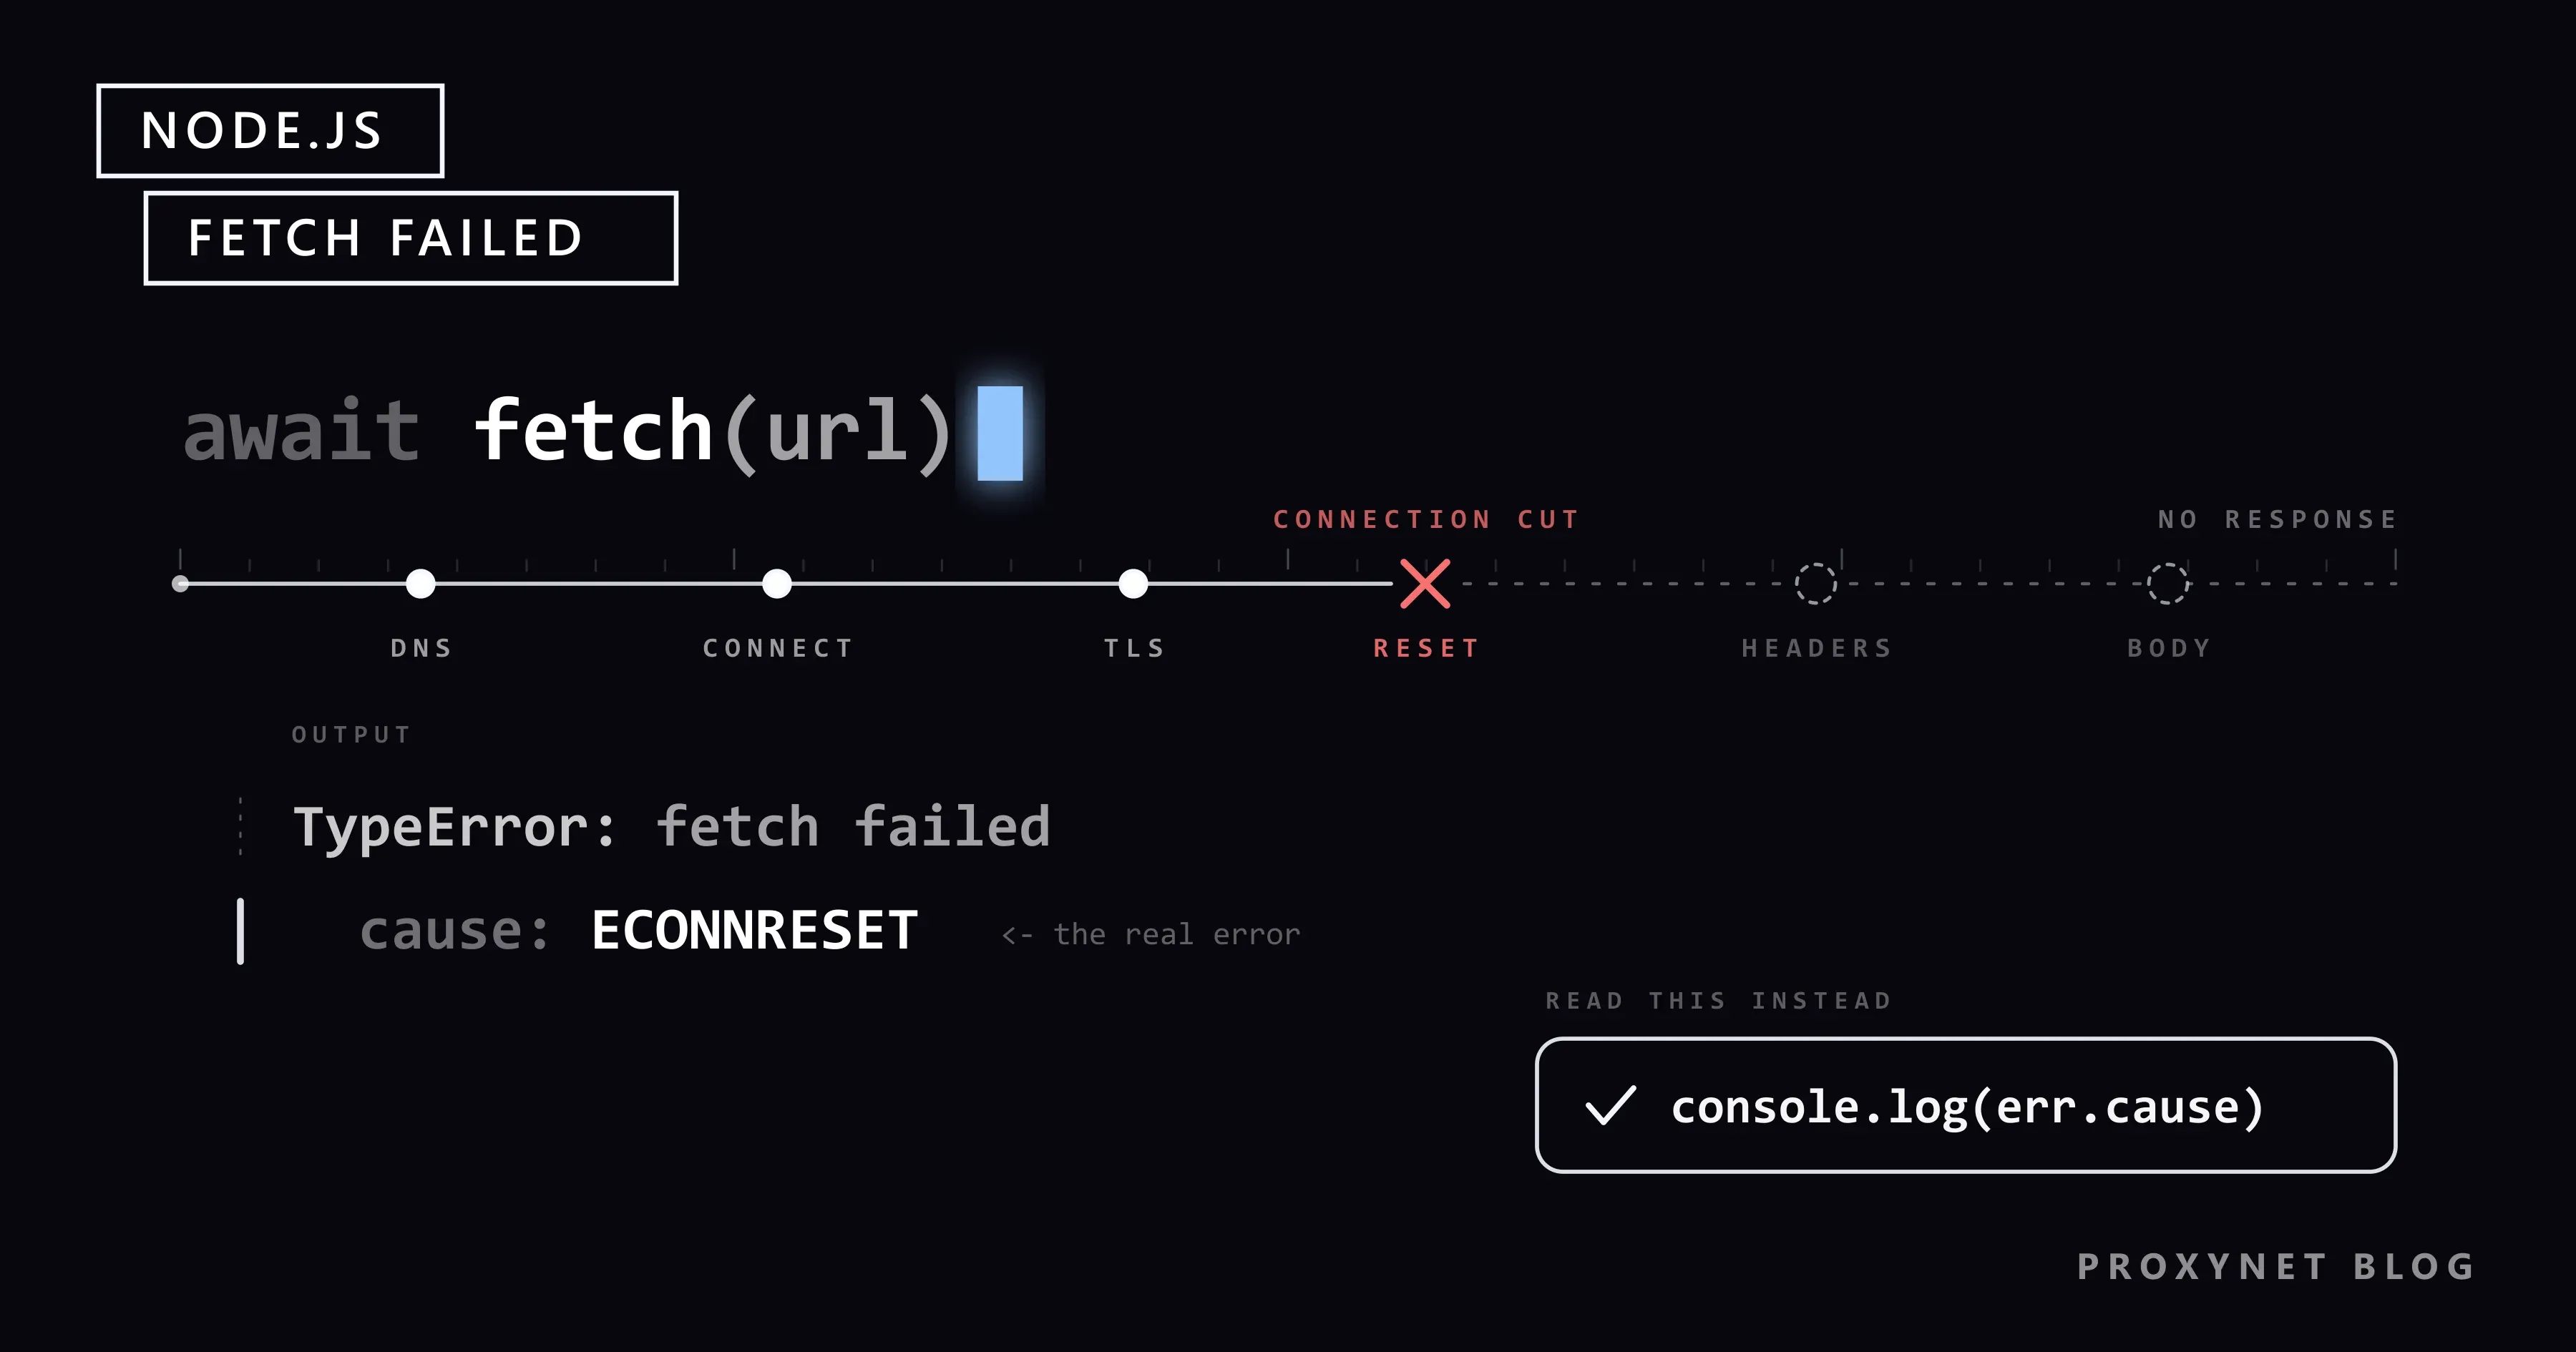
Publicado
TypeError: fetch failed en Node.js: causas y soluciones
TypeError: fetch failed en Node.js oculta el error real en err.cause. Aprende a leerlo y a corregir causas de DNS, conexión, timeout, certificado y proxy.
Autor:Acar Diveroli
Publicado
Unable to Get Local Issuer Certificate: cómo solucionarlo
Unable to get local issuer certificate: tu herramienta no encuentra la CA que firmó la cadena del servidor. Causas y soluciones en Python, npm, Git y curl.
Autor:Acar Diveroli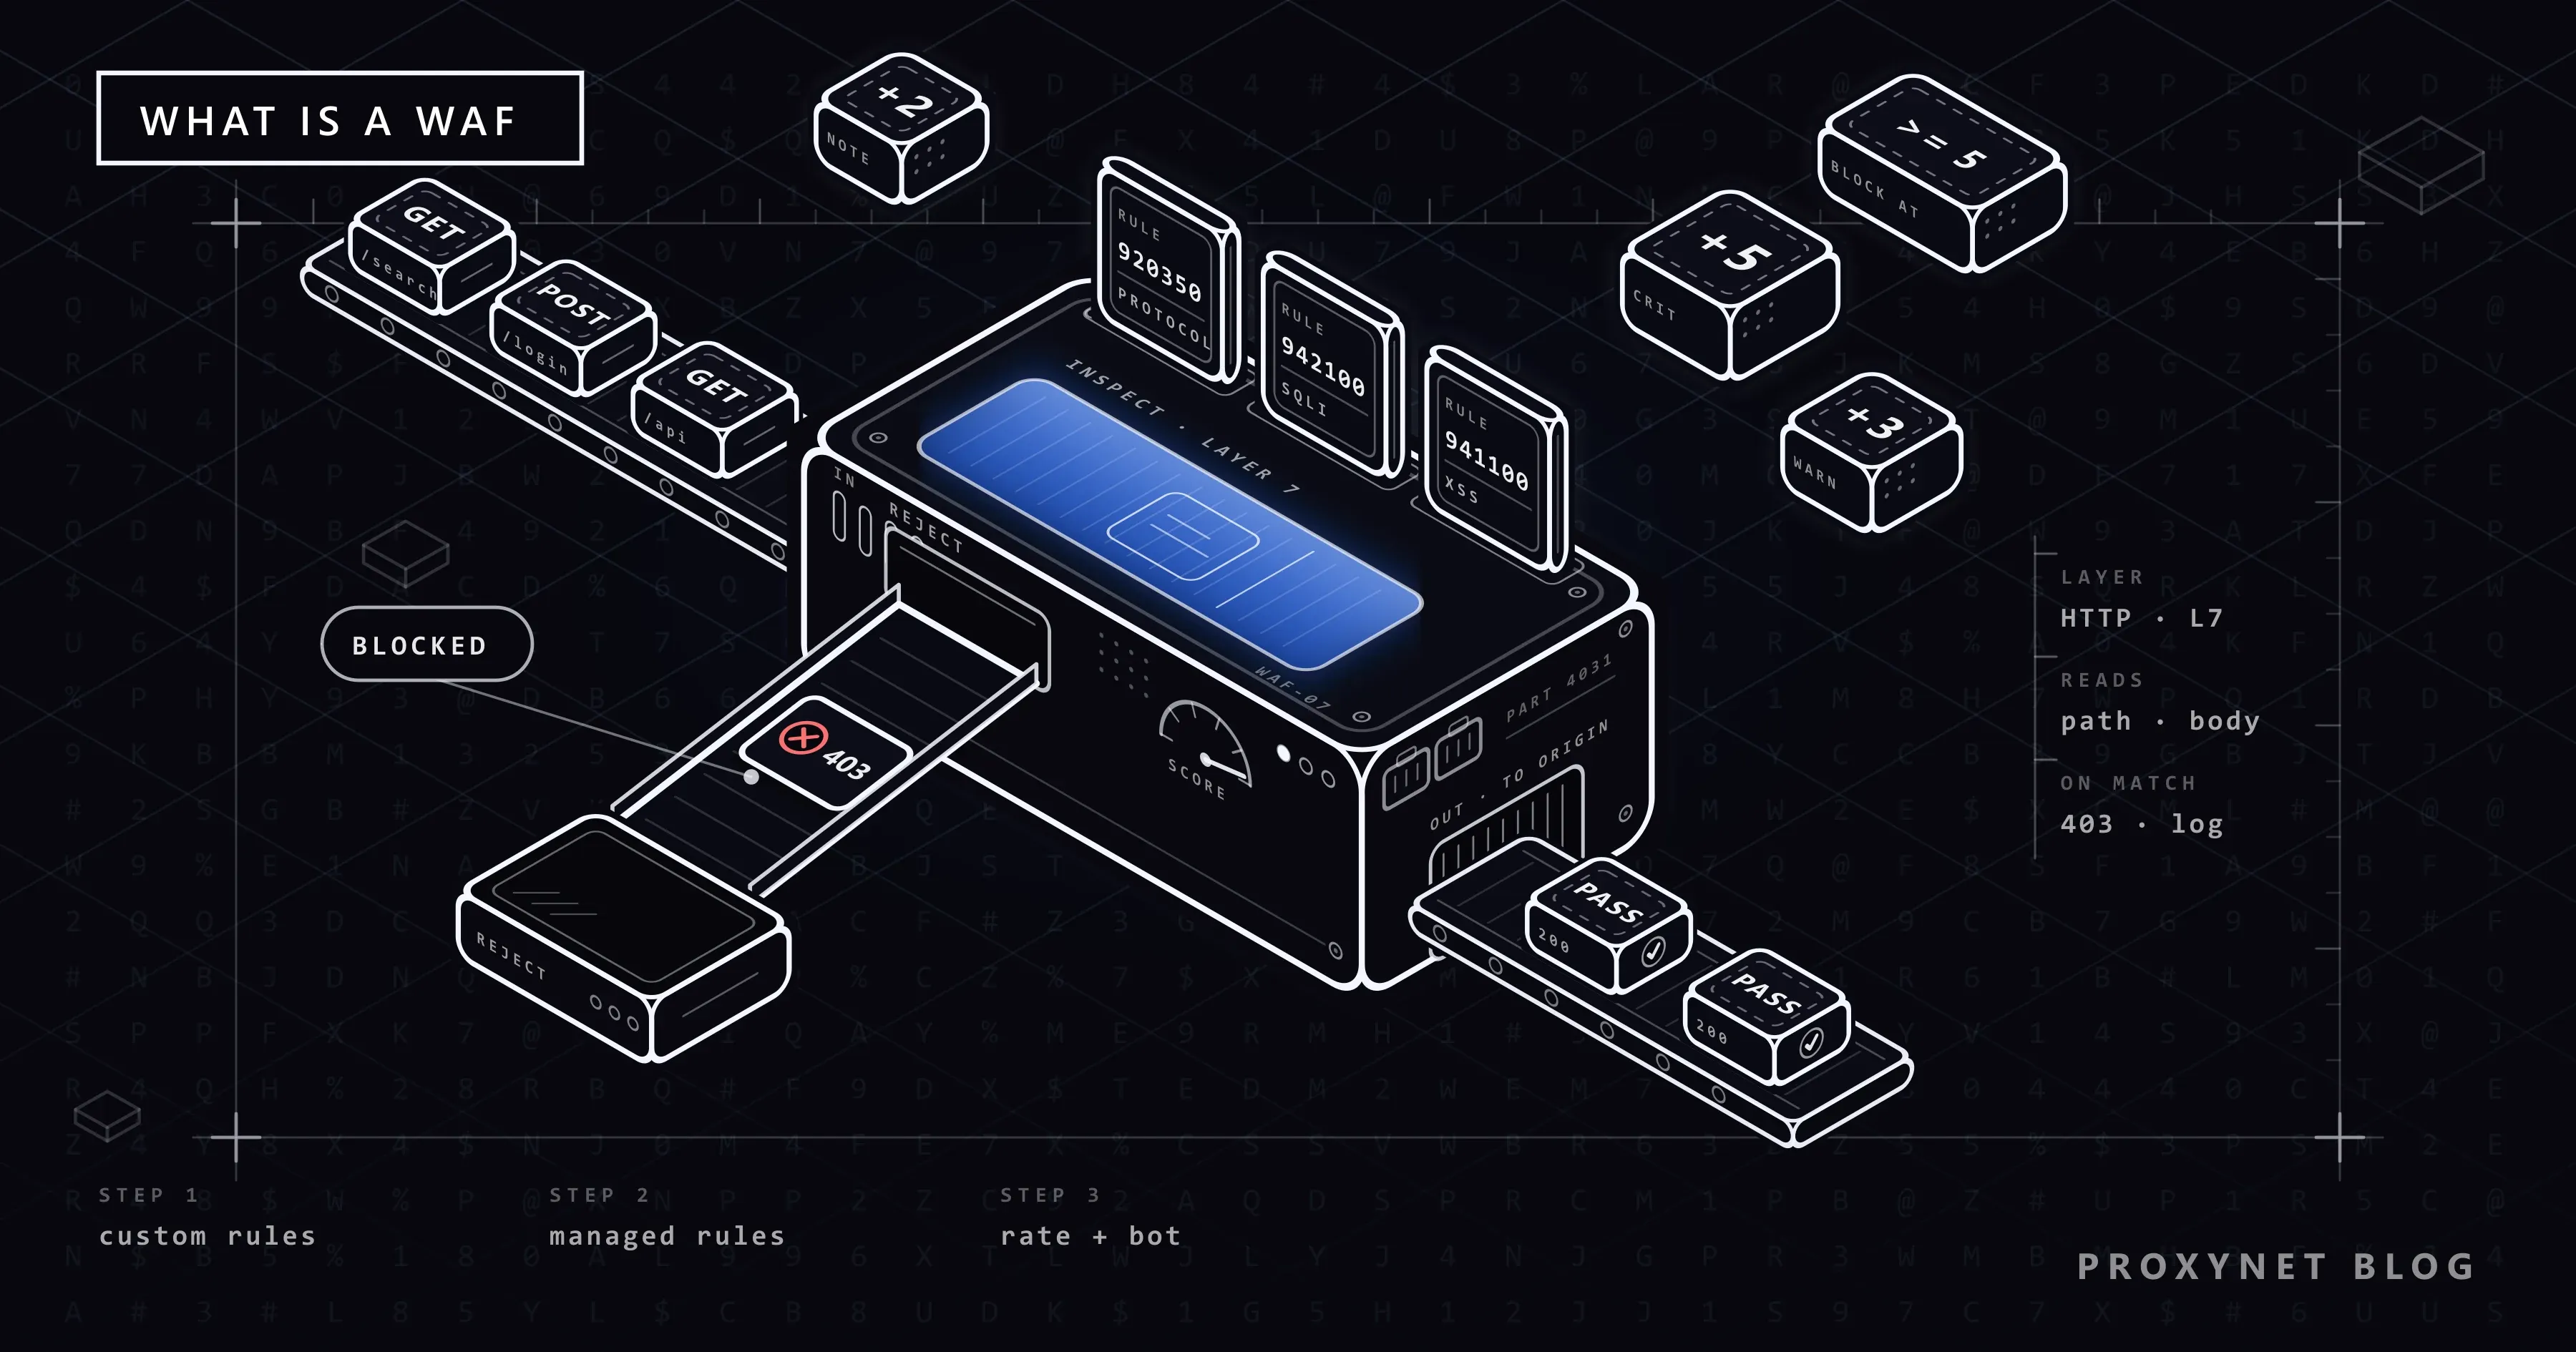
Publicado
¿Qué es un WAF (firewall de aplicaciones web)? Cómo funciona
Un WAF (firewall de aplicaciones web) revisa las solicitudes HTTP antes de que lleguen al sitio y bloquea ataques. Dónde se sitúa y cómo deciden sus reglas.
Autor:Acar Diveroli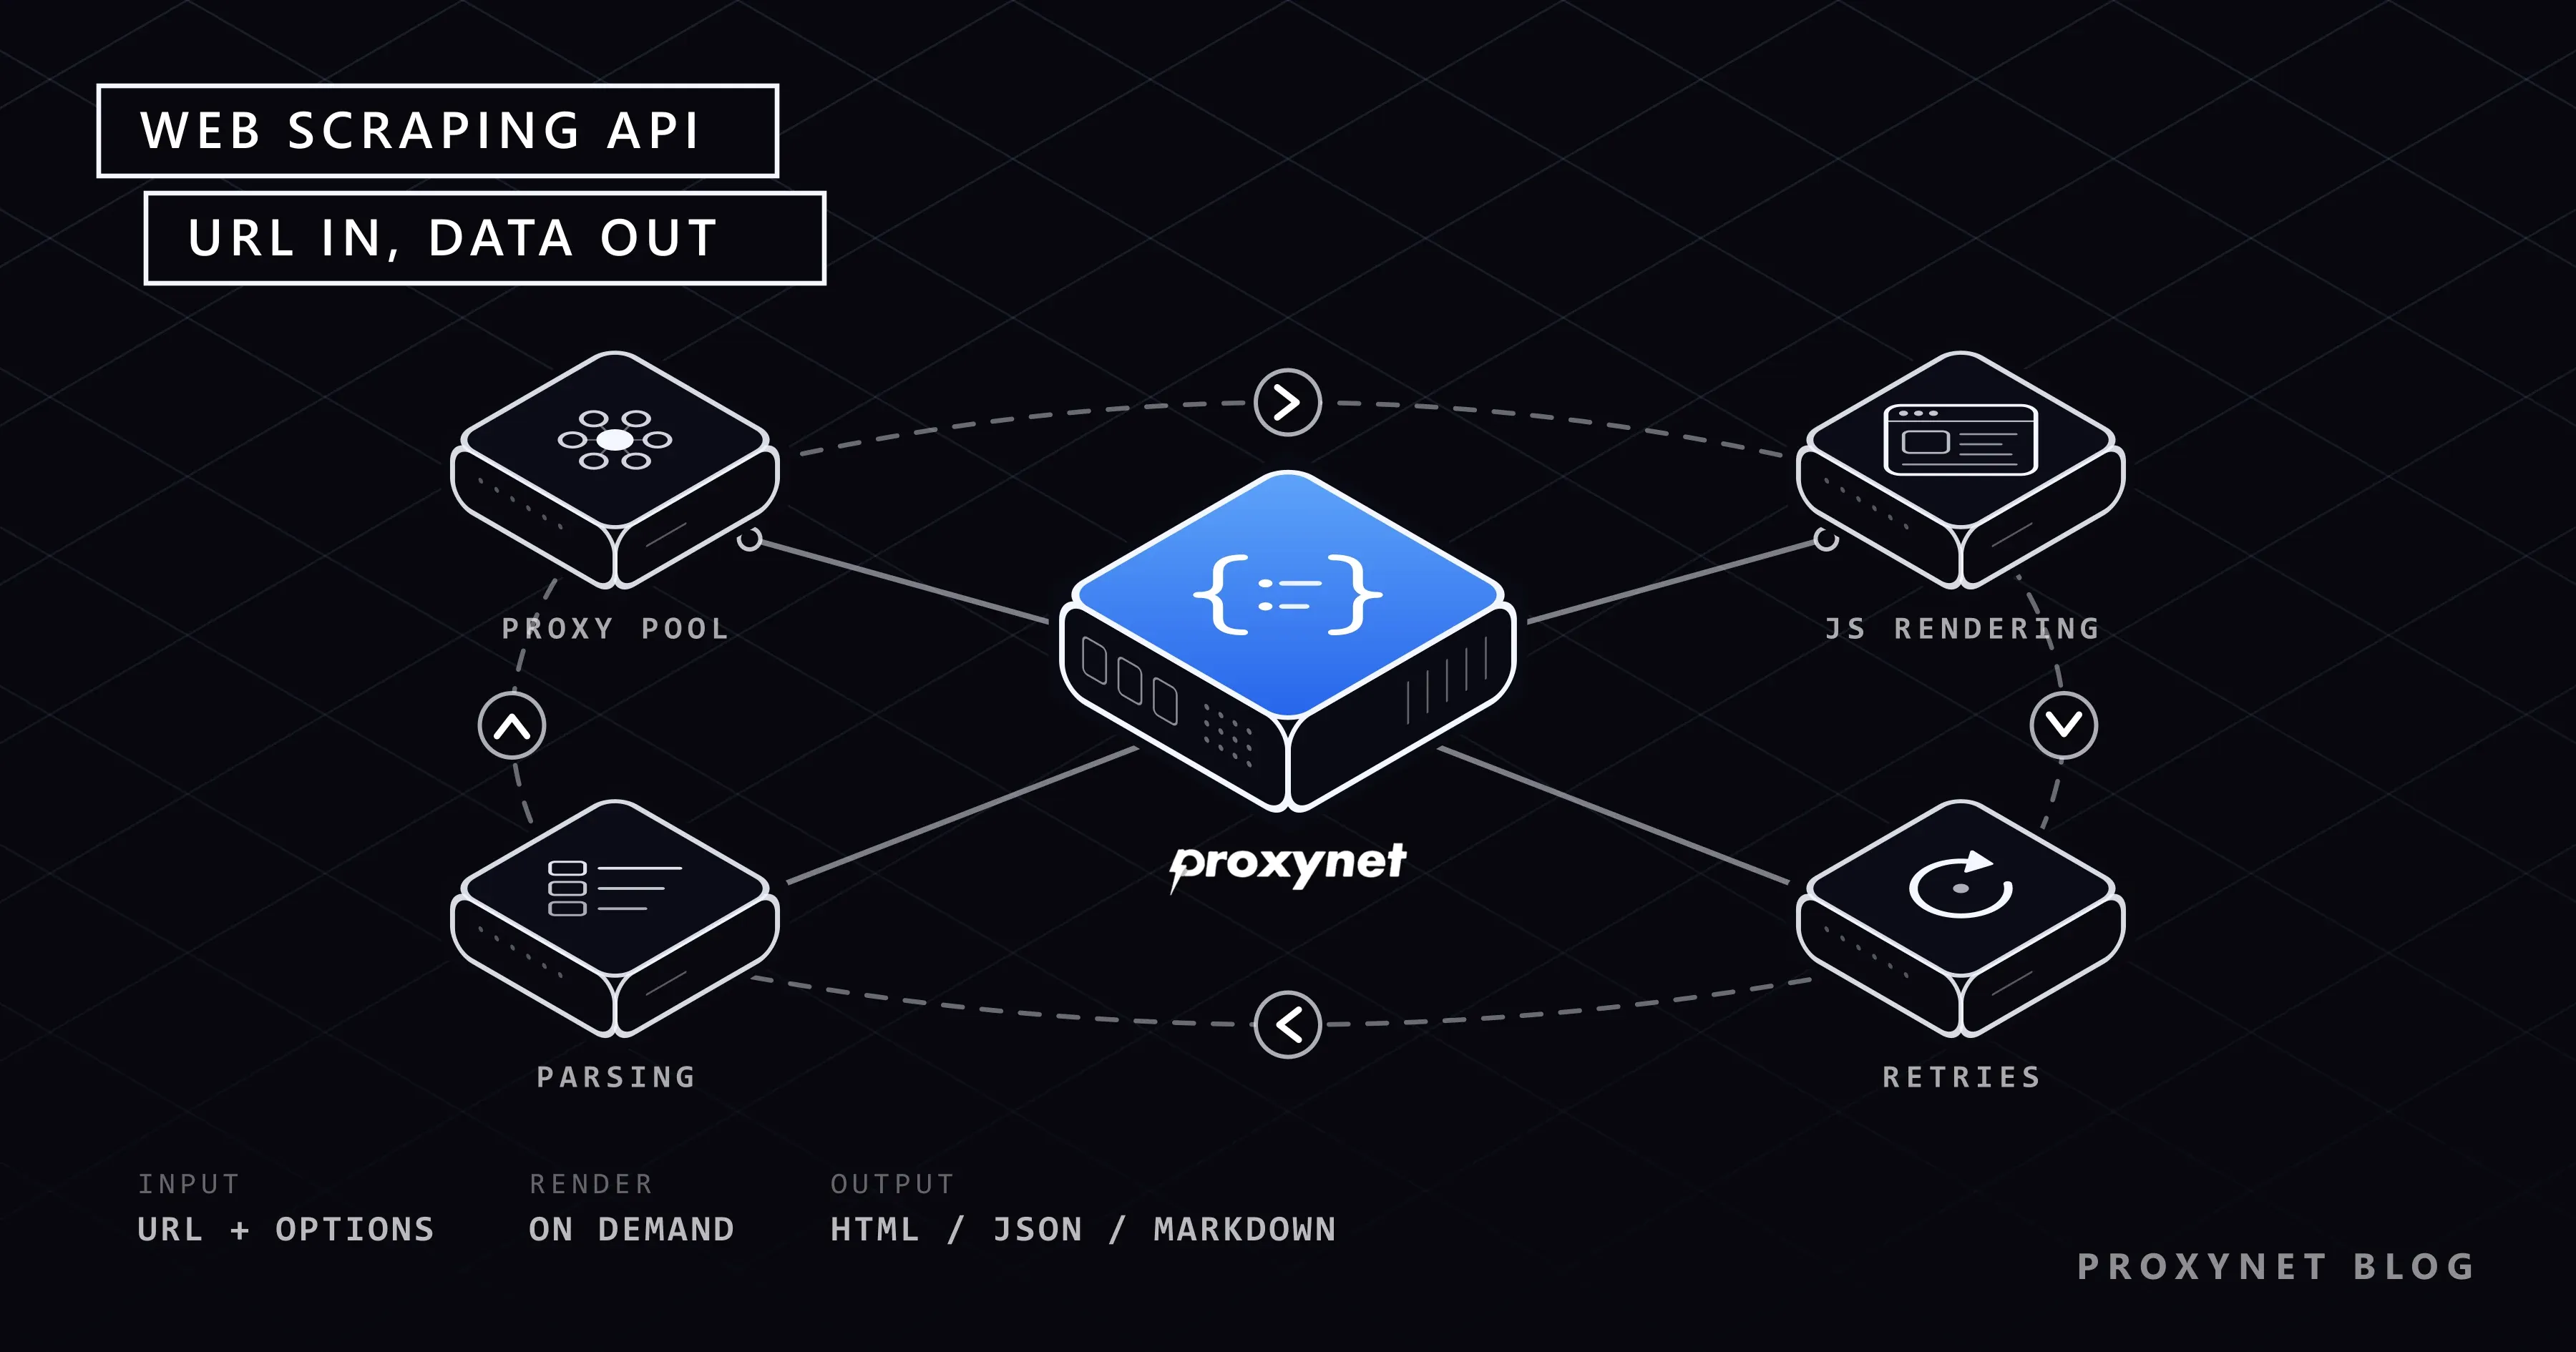
Publicado
¿Qué es una API de web scraping (scraper API)? Cómo funciona
Una API de web scraping descarga páginas por ti: envías una URL y se encarga de proxies, renderizado y reintentos; devuelve HTML, JSON o Markdown.
Autor:Acar Diveroli
Error 403 Forbidden: qué significa y cómo resolverlo
Autor: Acar DiveroliTutorialesPublicado
Versión de ChromeDriver incompatible: cómo solucionarlo
Autor: Acar DiveroliTutorialesPublicado
Error CORS: qué es «blocked by CORS policy» y su solución
Autor: Acar DiveroliTutorialesPublicado
¿Qué es HTTP 402 Payment Required? Pay per crawl y x402
Autor: Acar DiveroliWeb scrapingPublicado
Pardon Our Interruption: qué significa y cómo solucionarlo
Autor: Acar DiveroliWeb scrapingPublicado
Please Enable JS And Disable Any Ad Blocker: qué significa
Autor: Acar DiveroliWeb scrapingPublicado
Proxy en Puppeteer: autenticación, rotación y SOCKS5
Autor: Acar DiveroliIntegraciónPublicado
Puppeteer vs Playwright: ¿cuál deberías elegir?
Autor: Acar DiveroliComparativasPublicado
TypeError: fetch failed en Node.js: causas y soluciones
Autor: Acar DiveroliTutorialesPublicado
Unable to Get Local Issuer Certificate: cómo solucionarlo
Autor: Acar DiveroliTutorialesPublicado
¿Qué es un WAF (firewall de aplicaciones web)? Cómo funciona
Autor: Acar DiveroliWeb scrapingPublicado
¿Qué es una API de web scraping (scraper API)? Cómo funciona
Autor: Acar DiveroliWeb scrapingPublicado
Ningún artículo coincide
Publicado
Publicado