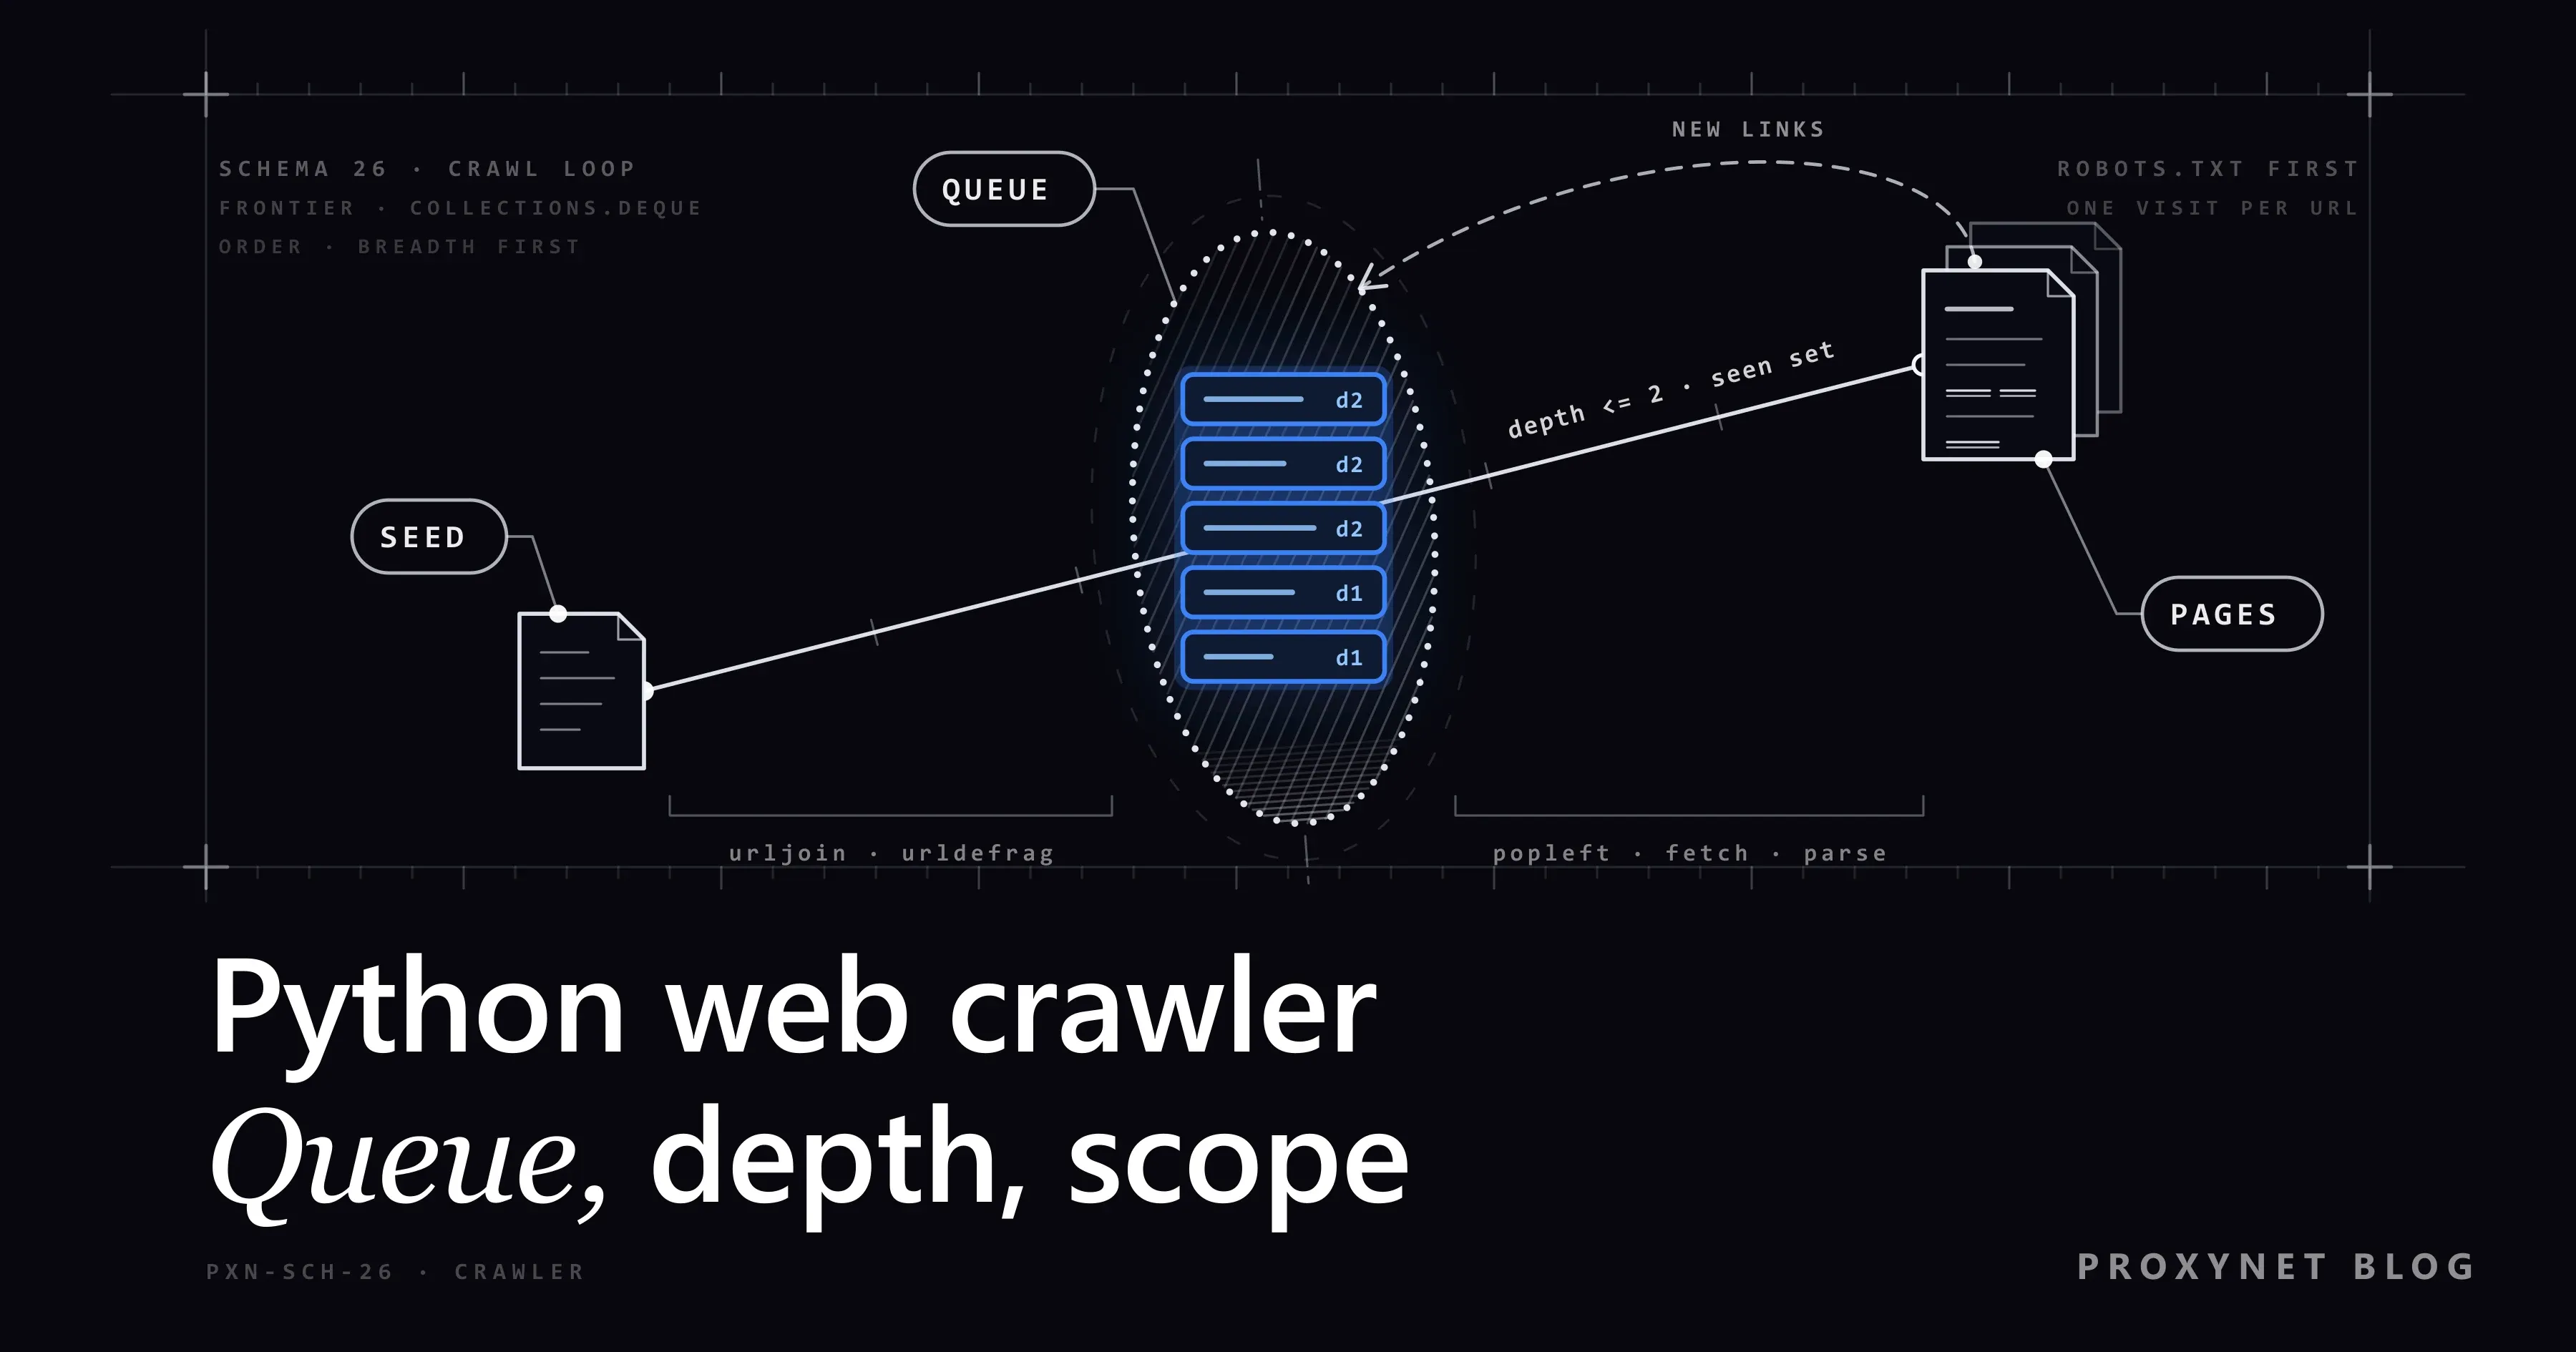
Você precisa de uma lista de todas as páginas de categoria e de produto de uma livraria on-line que não tem sitemap. Nosso alvo de teste é o books.toscrape.com, um sandbox criado para praticar scraping. Um crawler que segue todos os links sem lembrar por onde já passou nunca termina aqui: a maioria dos links aponta de volta para páginas que ele já encontrou. Na nossa medição, 3.515 dos 4.098 links das primeiras 60 páginas apontavam para endereços que o crawler já conhecia, e 524 endereços novos ainda esperavam na fila.
A seguir montamos um crawler com Requests e BeautifulSoup, sem framework: fila, conjunto de vistos, normalização de URL, escopo, limite de profundidade, robots.txt, pausas e saída em JSON Lines. O que é um crawler e como ele se diferencia de um scraper está na nossa página de web crawler e em Web scraping vs. web crawling. Todos os números vêm de execuções do script final em 25 de setembro de 2026.
Quais partes um web crawler em Python precisa ter?
Seis partes, cada uma com poucas linhas de Python:
- Fronteira (frontier): a fila de endereços que ainda serão visitados, um
collections.deque. - Conjunto de vistos (seen set): todos os endereços que o crawler encontrou até agora.
- Fetcher: uma
requests.Sessioncom timeout e umUser-Agenthonesto, que informa o nome do bot e um contato (O que é User-Agent?). - Extrator de links:
select("a[href]"). Ler o resto da página é trabalho de um scraper (O que é o BeautifulSoup). - Filtro de escopo: host, esquema e tipo de conteúdo decidem o que conta.
- Saída: um objeto JSON por página em um arquivo
.jsonl.
Usamos Requests 2.34.2 e Beautiful Soup 4.15.0, as versões atuais no PyPI em 25 de setembro de 2026; o Requests exige Python 3.10 ou mais recente. O Scrapy traz as seis partes prontas.
Como funciona o laço de rastreamento, passo a passo?
- Semente. Normalize o endereço inicial, coloque
(url, 0)na fila e o endereço no conjunto de vistos. - Retire.
popleft()pega a entrada mais antiga. - Consulte o robots.txt. Leia as regras do host a partir de um cache, baixando-as uma única vez.
- Espere e baixe. Respeite o intervalo por host e então envie uma requisição GET.
- Confira a resposta. Leia o endereço final depois dos redirecionamentos e o cabeçalho
Content-Type. - Extraia e filtre. Resolva cada
hrefcomurljoin, normalize-o e descarte o que já foi visto, o que está fora do site ou o que é profundo demais. - Registre e enfileire. Grave uma linha JSON e acrescente os endereços novos com
depth + 1.
O laço termina quando a fila esvazia ou quando o teto de páginas é atingido.
Qual parte evita qual problema?
| Parte | O que evita | Em Python | Sem ela |
|---|---|---|---|
| Conjunto de vistos, preenchido ao enfileirar | Baixar a mesma página duas vezes | set, adicionado ao enfileirar | Os 3.515 links conhecidos da nossa execução no books baixados de novo |
| Limite de profundidade e teto de páginas | Cadeias sem fim, como calendários e filtros | (url, depth), --depth, --max-pages | Uma fila que não para de crescer (524 à espera depois de 60 páginas) |
| Normalização de URL | A mesma página com várias grafias | urldefrag, urlsplit, parse_qsl | A mesma página é baixada e salva mais de uma vez |
| Verificação de redirecionamento e de tipo de conteúdo | Escapar para outro site, analisar um PDF como HTML | r.url, Content-Type, stream=True | Links de páginas de outros sites entram na fila |
| Cache do robots.txt e pausa por host | Caminhos proibidos, rajadas de requisições | RobotFileParser.parse(), time.monotonic() | O site responde 429 |
Por que a fila deve ser um deque e não uma lista?
deque.popleft() pega o endereço mais antigo, então o rastreamento é feito em largura (BFS): a página inicial, depois as páginas a um clique de distância, depois as que estão a dois. As páginas próximas da home chegam primeiro, e um limite de profundidade faz sentido porque a profundidade cresce em ordem. Usar pop() na mesma ponta em que você acrescenta dá uma busca em profundidade (DFS): um ramo até o fundo antes do próximo.
Uma lista pode servir de fila, mas pop(0) desloca todos os itens restantes (O(n)), enquanto um deque retira itens nas duas pontas em tempo praticamente constante (documentação do collections). Crawlers recursivos são DFS disfarçados e podem parar no limite padrão do Python de 1.000 chamadas aninhadas com um RecursionError.
A BFS também encontra cada endereço pela primeira vez na sua menor profundidade, então um link profundo demais já no primeiro encontro pode ser marcado como visto e esquecido.
Como escrever a normalização de URL em código?
O conjunto de vistos compara strings, então normalize() dá a cada página uma única grafia:
urldefrag()remove#reviews. Pela seção 3.5 da RFC 3986, o fragmento nunca chega ao servidor.- O esquema e o host ficam em minúsculas;
urlsplit().hostnamejá vem assim. - As portas padrão (
:80para http,:443para https) são removidas, e um caminho vazio vira/, o que a seção 6.2.3 da mesma RFC trata como equivalente. - Os parâmetros de tracking (
utm_*,gclid,fbclid) são removidos e os demais são ordenados, para que?b=2&a=1e?a=1&b=2coincidam. - Links
mailto:,tel:ejavascript:e portas quebradas retornamNone.
Nunca apague a query string inteira: ?page=2 é outra página. As barras finais também ficam, porque /a e /a/ podem ser páginas diferentes; um redirecionamento avisa quando não são. No books.toscrape.com, / e /index.html serviam a mesma página, algo que só uma regra específica para esse site conseguiria unir.
O conjunto de vistos também ignora o esquema. No quotes.toscrape.com, as páginas de autor redirecionam de https para http, e os links relativos delas passam a apontar para http://quotes.toscrape.com/; por isso, nossa primeira execução de teste baixou a home e a página de login duas vezes. page_key() descarta o esquema, então as duas grafias contam como uma página só.
Os sandboxes não têm fragmentos nem parâmetros de tracking, então estas verificações usam entradas inventadas:
from crawler import normalize

assert normalize("https://Example.COM:443/a#reviews") == "https://example.com/a"
assert normalize("http://example.com") == "http://example.com/"
assert normalize("https://example.com:8443/a") == "https://example.com:8443/a"
assert normalize("https://example.com/list?b=2&a=1") == "https://example.com/list?a=1&b=2"
assert normalize("https://example.com/list?utm_source=mail&page=2") == "https://example.com/list?page=2"
assert normalize("mailto:shop@example.com") is None
assert normalize("javascript:void(0)") is None
assert normalize("https://example.com:abc/") is None
assert normalize("https://example.com/a/") != normalize("https://example.com/a")
print("all normalize checks passed")
Escopo: mesmo host, redirecionamentos e tipo de conteúdo
self.hosts guarda só o host inicial. Se um site usa tanto www.example.com quanto example.com, adicione os dois à mão; uma verificação como endswith("example.com") deixaria entrar também notexample.com.
O Requests segue redirecionamentos em todos os métodos, exceto HEAD, e guarda o endereço final em r.url (quickstart do Requests), então verifique o escopo em r.url e resolva os links relativos a partir dele. No quotes.toscrape.com, /author/Jane-Austen redireciona para http://quotes.toscrape.com/author/Jane-Austen/; na nossa execução com profundidade 2, 40 de 149 páginas chegaram assim. Um redirecionamento para fora do site é descartado, mas o Requests já baixou o destino. Para evitar até essa requisição, passe allow_redirects=False e enfileire você mesmo o endereço do cabeçalho Location.
Com stream=True, o Requests retorna assim que os cabeçalhos chegam. Se o Content-Type não é text/html, a conexão é fechada sem que o corpo seja lido.
Como definir um limite de profundidade e um teto de páginas?
As entradas da fila são (url, depth, attempts). Um link cujo depth + 1 passaria de --depth conta como too_deep e fica de fora; --max-pages encerra a execução, não importa o que a fila contenha. Nos sandboxes:
- quotes.toscrape.com, profundidade 2, teto de 500: a fila esvaziou sozinha depois de 149 páginas (1, 46 e 102 por profundidade); 30 endereços estavam profundos demais.
- O mesmo site, teto de 60: a execução parou em 60 páginas com 89 endereços ainda na fila.
- books.toscrape.com, profundidade 2, teto de 60: as 60 páginas vieram das profundidades 0 e 1, com 524 à espera. Quem encerrou esta execução foi o teto, não a profundidade.
Escolha a profundidade pela estrutura do site (home, categoria e item dão profundidade 2; cada página de listagem a mais soma um) e o teto pelo seu orçamento. Os links plantados para pegar bots estão em O que são armadilhas honeypot.
robots.txt e pausas: a versão curta
O crawler mantém um RobotFileParser por esquema e host, baixa o robots.txt com a própria sessão (timeout, User-Agent do bot, proxy) e passa as linhas para parse(). Evitamos read(): no Python 3.13.9 ele usa o urllib sem timeout e com o User-Agent do próprio urllib, e levanta exceção em erros de rede. Um 5xx ou um arquivo inacessível significa não rastrear nada, como exige a RFC 9309; um 4xx significa que não há regras (os dois sandboxes devolveram 404). Sintaxe: O que é robots.txt.
Antes de cada requisição, o crawler confere se já passou, desde a última requisição àquele host, o --delay (1 segundo por padrão) ou o Crawl-delay do site, o que for maior. Com Crawl-delay: 2 em um site de teste local e --delay 0.2, o servidor registrou intervalos de 2 segundos. Diante de um 429, o crawler para de enviar requisições ao host e imprime o Retry-After. Como repetir as tentativas do jeito certo está em Códigos de status HTTP no web scraping, e essas verificações com uma fila em SQLite, em O que é paginação.
Código completo: um web crawler em Python sem framework
Instale as duas bibliotecas em um ambiente virtual, salve o script como crawler.py e passe um endereço inicial:
pip install requests==2.34.2 beautifulsoup4==4.15.0
python crawler.py https://books.toscrape.com/ --depth 2 --max-pages 60"""Um crawler em largura para um único site: Requests + BeautifulSoup, sem framework."""
import argparse
import json
import time
from collections import Counter, deque
from urllib.parse import parse_qsl, urldefrag, urlencode, urljoin, urlsplit, urlunsplit
from urllib.robotparser import RobotFileParser
import requests
from bs4 import BeautifulSoup
BOT_NAME = "ExampleSiteMapper"
USER_AGENT = f"{BOT_NAME}/1.0 (+https://example.com/bot; bot@example.com)"
TIMEOUT = 15 # segundos; sem timeout, o Requests pode esperar para sempre
MAX_RETRIES = 2 # uma URL volta para o fim da fila no máximo duas vezes
TRACKING = {"utm_source", "utm_medium", "utm_campaign", "utm_term", "utm_content", "gclid", "fbclid"}
DEFAULT_PORTS = {"http": 80, "https": 443}
def normalize(url):
"""Uma grafia por página, ou None para links que um crawler não deve seguir."""
url, _fragment = urldefrag(url.strip())
parts = urlsplit(url)
scheme = parts.scheme.lower()
try:
port = parts.port
except ValueError: # uma porta quebrada, como ":abc"
return None
if scheme not in DEFAULT_PORTS or not parts.hostname:
return None # mailto:, tel:, javascript:, ftp:, ...
host = parts.hostname # já vem em minúsculas
if port and port != DEFAULT_PORTS[scheme]:
host = f"{host}:{port}"
query = sorted((k, v) for k, v in parse_qsl(parts.query, keep_blank_values=True)
if k not in TRACKING)
return urlunsplit((scheme, host, parts.path or "/", urlencode(query), ""))
def page_key(url):
"""A chave do conjunto de vistos: http:// e https:// do mesmo endereço contam como uma página."""
return url.split("://", 1)[1]
class Crawler:
def __init__(self, start, max_depth, max_pages, delay, out, proxy=None):
self.start = normalize(start)
self.hosts = {urlsplit(self.start).hostname} # adicione aqui um gêmeo "www." de propósito
self.max_depth, self.max_pages, self.delay, self.out = max_depth, max_pages, delay, out
self.queue = deque([(self.start, 0, 0)]) # (url, depth, attempts)
self.seen = {page_key(self.start)} # marcada quando a URL aparece pela primeira vez, não quando é baixada
self.robots, self.last, self.stopped = {}, {}, {}
self.stats, self.depths = Counter(), Counter()
self.session = requests.Session()
self.session.headers["User-Agent"] = USER_AGENT
# por requisição: session.proxies perderia para as variáveis de ambiente HTTP(S)_PROXY
self.proxies = {"http": proxy, "https": proxy} if proxy else None
def in_scope(self, url):
return urlsplit(url).hostname in self.hosts
def fetch(self, url):
"""GET com pausa por host. stream=True lê os cabeçalhos antes do corpo."""
parts = urlsplit(url)
rules = self.robots.get(f"{parts.scheme}://{parts.netloc}")
gap = max(self.delay, (rules.crawl_delay(BOT_NAME) if rules else None) or 0)
pause = self.last.get(parts.netloc, float("-inf")) + gap - time.monotonic()
if pause > 0:
time.sleep(pause)
try:
return self.session.get(url, timeout=TIMEOUT, stream=True, proxies=self.proxies)
finally:
self.last[parts.netloc] = time.monotonic() # por host: http e https compartilham
def robots_ok(self, url):
root = "{0.scheme}://{0.netloc}".format(urlsplit(url))
if root not in self.robots:
rules = RobotFileParser()
try:
with self.fetch(root + "/robots.txt") as r:
status = r.status_code
rules.parse(r.text.splitlines() if status == 200 else [])
except requests.RequestException:
status = None
rules.parse([])
if status is None or status >= 500:
rules.disallow_all = True # robots.txt inacessível: não rastrear nada neste host
self.robots[root] = rules
return self.robots[root].can_fetch(BOT_NAME, url)
def extract_links(self, html, base):
soup = BeautifulSoup(html, "html.parser")
title = " ".join(soup.title.get_text().split()) if soup.title else ""
return title, [urljoin(base, a["href"]) for a in soup.select("a[href]")]
def enqueue(self, links, depth):
for link in links:
self.stats["raw_links"] += 1
url = normalize(link)
if url is None:
self.stats["not_http"] += 1
continue
if page_key(url) in self.seen:
self.stats["duplicate"] += 1
continue
self.seen.add(page_key(url)) # a BFS encontra cada URL primeiro na sua menor profundidade
if not self.in_scope(url):
self.stats["offsite"] += 1
elif depth + 1 > self.max_depth:
self.stats["too_deep"] += 1
else:
self.queue.append((url, depth + 1, 0))
self.stats["queued"] += 1
def retry(self, url, depth, attempts, why):
if attempts < MAX_RETRIES:
self.queue.append((url, depth, attempts + 1))
self.stats["retried"] += 1
else:
self.stats["failed"] += 1
print(f"giving up on {url}: {why}")
def run(self):
started = time.monotonic()
with open(self.out, "w", encoding="utf-8", newline="\n") as out: # JSON Lines: \n, sem BOM
while self.queue and self.stats["fetched"] < self.max_pages:
url, depth, attempts = self.queue.popleft()
host = urlsplit(url).netloc
if host in self.stopped:
self.stats["skipped_stopped_host"] += 1
continue
if not self.robots_ok(url):
self.stats["robots_disallowed"] += 1
continue
try:
r = self.fetch(url)
except requests.RequestException as exc:
self.retry(url, depth, attempts, type(exc).__name__)
continue
with r:
if r.status_code == 429:
self.stopped[host] = r.headers.get("Retry-After", "not sent")
print(f"429 from {host}, host stopped (Retry-After: {self.stopped[host]})")
continue
if r.status_code >= 500:
self.retry(url, depth, attempts, f"HTTP {r.status_code}")
continue
final = normalize(r.url)
moved = page_key(final) != page_key(url) # não é só http -> https
if not self.in_scope(final) or (moved and page_key(final) in self.seen):
self.stats["redirect_skipped"] += 1 # saiu do site, ou é uma página conhecida
continue
is_html = "text/html" in r.headers.get("Content-Type", "")
try: # o corpo é baixado aqui, e só para HTML
html = r.content if r.status_code == 200 and is_html else b""
except requests.RequestException as exc: # a conexão caiu no meio do corpo
self.retry(url, depth, attempts, type(exc).__name__)
continue
if final != url:
self.stats["redirected"] += 1
self.seen.add(page_key(final))
self.stats["fetched"] += 1
self.depths[depth] += 1
title, links = "", []
if html:
self.stats["html_bytes"] += len(html) # para estimar o tráfego
title, links = self.extract_links(html, r.url)
elif not is_html:
self.stats["not_html"] += 1 # o corpo nunca foi baixado
record = {"url": url, "final_url": final, "depth": depth,
"status": r.status_code, "title": title, "links_found": len(links)}
out.write(json.dumps(record, ensure_ascii=False) + "\n")
print(f"{r.status_code} d{depth} {url}")
self.enqueue(links, depth)
print(f"\n{self.stats['fetched']} pages in {time.monotonic() - started:.1f} s,"
f" by depth {dict(sorted(self.depths.items()))}, left in queue {len(self.queue)}")
for key, value in sorted(self.stats.items()):
print(f" {key:<21}{value}")
if __name__ == "__main__":
ap = argparse.ArgumentParser(description=__doc__)
ap.add_argument("start", help="start URL, e.g. https://books.toscrape.com/")
ap.add_argument("--depth", type=int, default=2, help="link hops from the start URL")
ap.add_argument("--max-pages", type=int, default=100, help="hard ceiling on fetched pages")
ap.add_argument("--delay", type=float, default=1.0, help="minimum seconds between requests to one host")
ap.add_argument("--out", default="pages.jsonl")
ap.add_argument("--proxy", help="e.g. http://user:pass@pr.proxynet.io:8000")
args = ap.parse_args()
Crawler(args.start, args.depth, args.max_pages, args.delay, args.out, args.proxy).run()Três detalhes importam quando você altera o código:
- As novas tentativas vão para o fim da fila, no máximo duas vezes, depois de um erro de conexão ou de um
5xx. Uma página de teste local que respondeu500duas vezes devolveu200na terceira tentativa. Novas tentativas dentro do próprio Requests: Max Retries Exceeded With URL. - O arquivo é JSON Lines puro.
encoding="utf-8"não grava a marca de ordem de bytes (BOM) enewline="\n"mantém os finais de linha\nque o JSON Lines pede; sem isso, o Windows grava\r\n.ensure_ascii=Falsemantém legível o texto fora do ASCII. Um título com letras turcas passou pela gravação e pela leitura sem perdas (Erros de codificação no Python). - Só GET. O crawler abre
/logincomo qualquer outra página e nunca envia um formulário.
O que vimos ao rodar o script
Usamos Python 3.13.9, o intervalo padrão de um segundo e profundidade 2. No quotes.toscrape.com, com teto de 500:
149 pages in 179.1 s, by depth {0: 1, 1: 46, 2: 102}, left in queue 0
  duplicate            2916
  fetched              149
  html_bytes           722227
  offsite              2
  queued               148
  raw_links            3096
  redirected           40
  too_deep             30
No books.toscrape.com, com teto de 60:
60 pages in 69.8 s, by depth {0: 1, 1: 59}, left in queue 524
  duplicate            3515
  fetched              60
  html_bytes           2047561
  queued               583
  raw_links            4098
No quotes, 94% dos links apontavam para endereços conhecidos, e só 2 endereços distintos ficavam fora do site. Duas linhas da saída, uma simples e uma redirecionada:
{"url": "https://books.toscrape.com/", "final_url": "https://books.toscrape.com/", "depth": 0, "status": 200, "title": "All products | Books to Scrape - Sandbox", "links_found": 94}
{"url": "https://quotes.toscrape.com/author/Jane-Austen", "final_url": "http://quotes.toscrape.com/author/Jane-Austen/", "depth": 1, "status": 200, "title": "Quotes to Scrape", "links_found": 4}
Um pequeno site local cobriu os ramos de erro. O crawler pulou um caminho proibido, três links que não eram web e um redirecionamento para outro host, fechou um PDF sem lê-lo e registrou um 404. Um 429 com Retry-After: 120 fez o crawler parar naquele host, e um 503 no robots.txt fez com que nada fosse baixado.
Onde entra o proxy no crawler?
--proxy http://user:pass@pr.proxynet.io:8000 é passado em cada requisição, inclusive na do robots.txt. O código não define session.proxies, porque a documentação do Requests avisa que as variáveis de ambiente de proxy se sobrepõem a ele (uso avançado). Através de um proxy de teste local com senha, as 10 primeiras páginas do books deram as mesmas linhas que sem proxy, mesmo com um proxy fora do ar em HTTPS_PROXY.
Um único site a uma requisição por segundo raramente precisa de proxy. Ele ajuda quando o rastreamento cobre muitos hosts e o tráfego não deve sair todo de um só endereço: um Proxies rotativos dá a cada requisição ou host um IP de saída diferente. Para uma lista curta e fixa de alvos, um Proxies de datacenter costuma bastar; os IPs dele vêm por padrão com restrição de site de destino, e o acesso a todos os sites é uma opção na hora do pedido. O código de rotação está em Como rotacionar proxies em Python.
O tráfego residencial rotativo é cobrado por GB, então meça html_bytes primeiro em uma execução curta. Os dois sandboxes enviaram HTML sem compressão, cerca de 34 KB por página do books e 5 KB por página do quotes: 10.000 páginas dão aproximadamente 0,34 GB ou 0,05 GB, mais os cabeçalhos. A pausa e o robots.txt valem para todos os IPs de saída, e a rotação não é motivo para mandar a um site mais requisições do que ele permite.
Casos de uso
- Links internos quebrados: filtre a saída pelo status
404(web crawler). - Uma lista de URLs antes do scraping: rastreie primeiro e depois faça scraping só das páginas de produto ou de artigo (extração de dados).
- Produtos novos na concorrência: compare a lista de URLs desta semana com a da semana passada (Como monitorar preços da concorrência no e-commerce).
- Lacunas do sitemap: páginas que o crawler encontra, mas que não estão no sitemap (Como encontrar o sitemap de um site).
- Imagens de páginas conhecidas: liste as páginas e depois baixe (Como baixar todas as imagens de um site).
- Campos das páginas encontradas: títulos e preços do mesmo HTML (O que é o BeautifulSoup).
Erros comuns
list.pop(0)como fila. Cada chamada desloca a lista inteira.- Recursão para cada link. O rastreamento vira uma busca em profundidade e pode terminar em
RecursionError. - Marcar URLs como vistas só depois de baixá-las. O mesmo endereço entra na fila muitas vezes.
- Apagar a query string inteira.
?page=2e todas as páginas seguintes desaparecem. - Resolver links a partir da URL pedida. Depois de um redirecionamento, a base é
r.url. - Sem timeout. Sem ele, o Requests pode travar indefinidamente.
- Analisar arquivos PDF e ZIP como HTML. Verifique o
Content-Typeantes. - Sem teto de páginas. Em um site com filtros ou calendário, a execução nunca termina.
- Preencher formulários. Um crawler lê páginas com GET; enviar dados é outro trabalho (POST com JSON no Python Requests).
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Algumas centenas de páginas de um site, com o mecanismo à vista | O script deste artigo |
| Retomar um rastreamento longo depois que ele para | Uma fila em disco: a versão com SQLite em O que é paginação |
| Muitas requisições ao mesmo tempo | Concorrência, dimensionada como em Concorrência e paralelismo no web scraping |
| Milhares de páginas, com novas tentativas e exportação prontas | Scrapy (CrawlSpider, configuração de proxy) |
| Links que só aparecem depois que o JavaScript roda | Um crawler baseado em navegador, como o PlaywrightCrawler do Crawlee for Python, ou o Crawl4AI |
| O site publica um sitemap | Leia o sitemap primeiro e rastreie só o que falta nele (Como encontrar o sitemap de um site) |
| Um rastreamento espalhado por muitos hosts | Um Proxies rotativos no mesmo ritmo educado por host |
Perguntas frequentes
Qual biblioteca Python devo usar para um web crawler?
Para algumas centenas de páginas, Requests para baixar e BeautifulSoup para ler os links bastam. Para milhares de páginas com novas tentativas, exportação e agendamento, o Scrapy poupa você de escrever esse código. Links montados por JavaScript exigem uma ferramenta baseada em navegador.
Dá para criar um crawler com BeautifulSoup ou preciso do Scrapy?
Dá. O BeautifulSoup é um parser: ele lê links do HTML, mas não baixa páginas, não mantém uma fila nem espera entre as requisições. O script acima escreve essas partes em menos de 200 linhas. O Scrapy já as traz prontas, o que compensa em trabalhos maiores.
Um crawler em Python vê os links carregados com JavaScript?
Não. O Requests não executa scripts, então os links adicionados por JavaScript nunca chegam ao BeautifulSoup. Primeiro procure, por trás da página, uma requisição JSON que você possa chamar diretamente. Se não houver, use um crawler baseado em navegador, desde que os termos do site permitam automação.
Devo tornar o crawler multithread?
Só quando você rastreia vários hosts. Em um único site, quem define a velocidade é a pausa entre as requisições, e threads extras só ficariam esperando ou quebrariam o intervalo. Com muitos hosts, um worker educado por host ajuda (Concorrência e paralelismo no web scraping).
Como encontrar todos os links de um site com Python?
Comece pelo sitemap, que costuma estar indicado no robots.txt ou em /sitemap.xml. Se não houver, rode um crawler como este com limite de profundidade e teto de páginas, e trate o resultado como o conjunto de páginas que os links alcançam, não como uma lista completa.
Criar e rodar um web crawler é legal?
Isto não é aconselhamento jurídico. A resposta depende do seu país, dos termos do site, de as páginas conterem ou não dados pessoais e do que você faz com as cópias. Obedeça ao robots.txt, mantenha o ritmo baixo e fique fora das áreas que exigem login. País por país: Web scraping é legal?.
Em resumo
Um crawler que termina sem se repetir precisa de um deque para a ordem em largura, de um conjunto de vistos preenchido na hora de enfileirar, de uma grafia por URL, de uma verificação de escopo depois dos redirecionamentos e de um limite de profundidade com teto de páginas. O robots.txt, uma pausa por host e a parada diante de um 429 entram já na primeira versão. Quando o trabalho crescer, passe para uma fila em disco, concorrência entre hosts ou Scrapy. Para rastreamentos que cobrem muitos sites ou países, compare as opções na nossa página de serviços de proxy.