Un equipo quiere que su asistente interno responda preguntas a partir de la documentación del producto. Descarga las páginas con Requests y le pasa el HTML al modelo, pero los menús, los avisos de cookies y los scripts ocupan la mitad del texto, y las páginas que cargan su contenido con JavaScript llegan casi vacías. Crawl4AI abre esas mismas páginas en un navegador real y devuelve el cuerpo como Markdown limpio. El segundo día cambian los problemas: a mitad de un rastreo de 300 páginas el sitio empieza a responder 429, y la instalación con Docker en el servidor de compilación solo devuelve «connection reset».
Esta guía explica cómo convierte Crawl4AI una página en Markdown, la instalación con pip y Docker, los proxies, el uso rotativo y el de sesión fija, y los ajustes de robots.txt y de ritmo que hacen que un rastreo sea respetuoso con el sitio. Ejecutamos todos los ejemplos de Python con Crawl4AI 0.9.4 y Python 3.13 a través de un proxy de prueba local con usuario y contraseña. Docker no estaba disponible en el equipo de prueba, así que los comandos de Docker siguen la guía oficial.
¿Qué es Crawl4AI y para qué se usa?
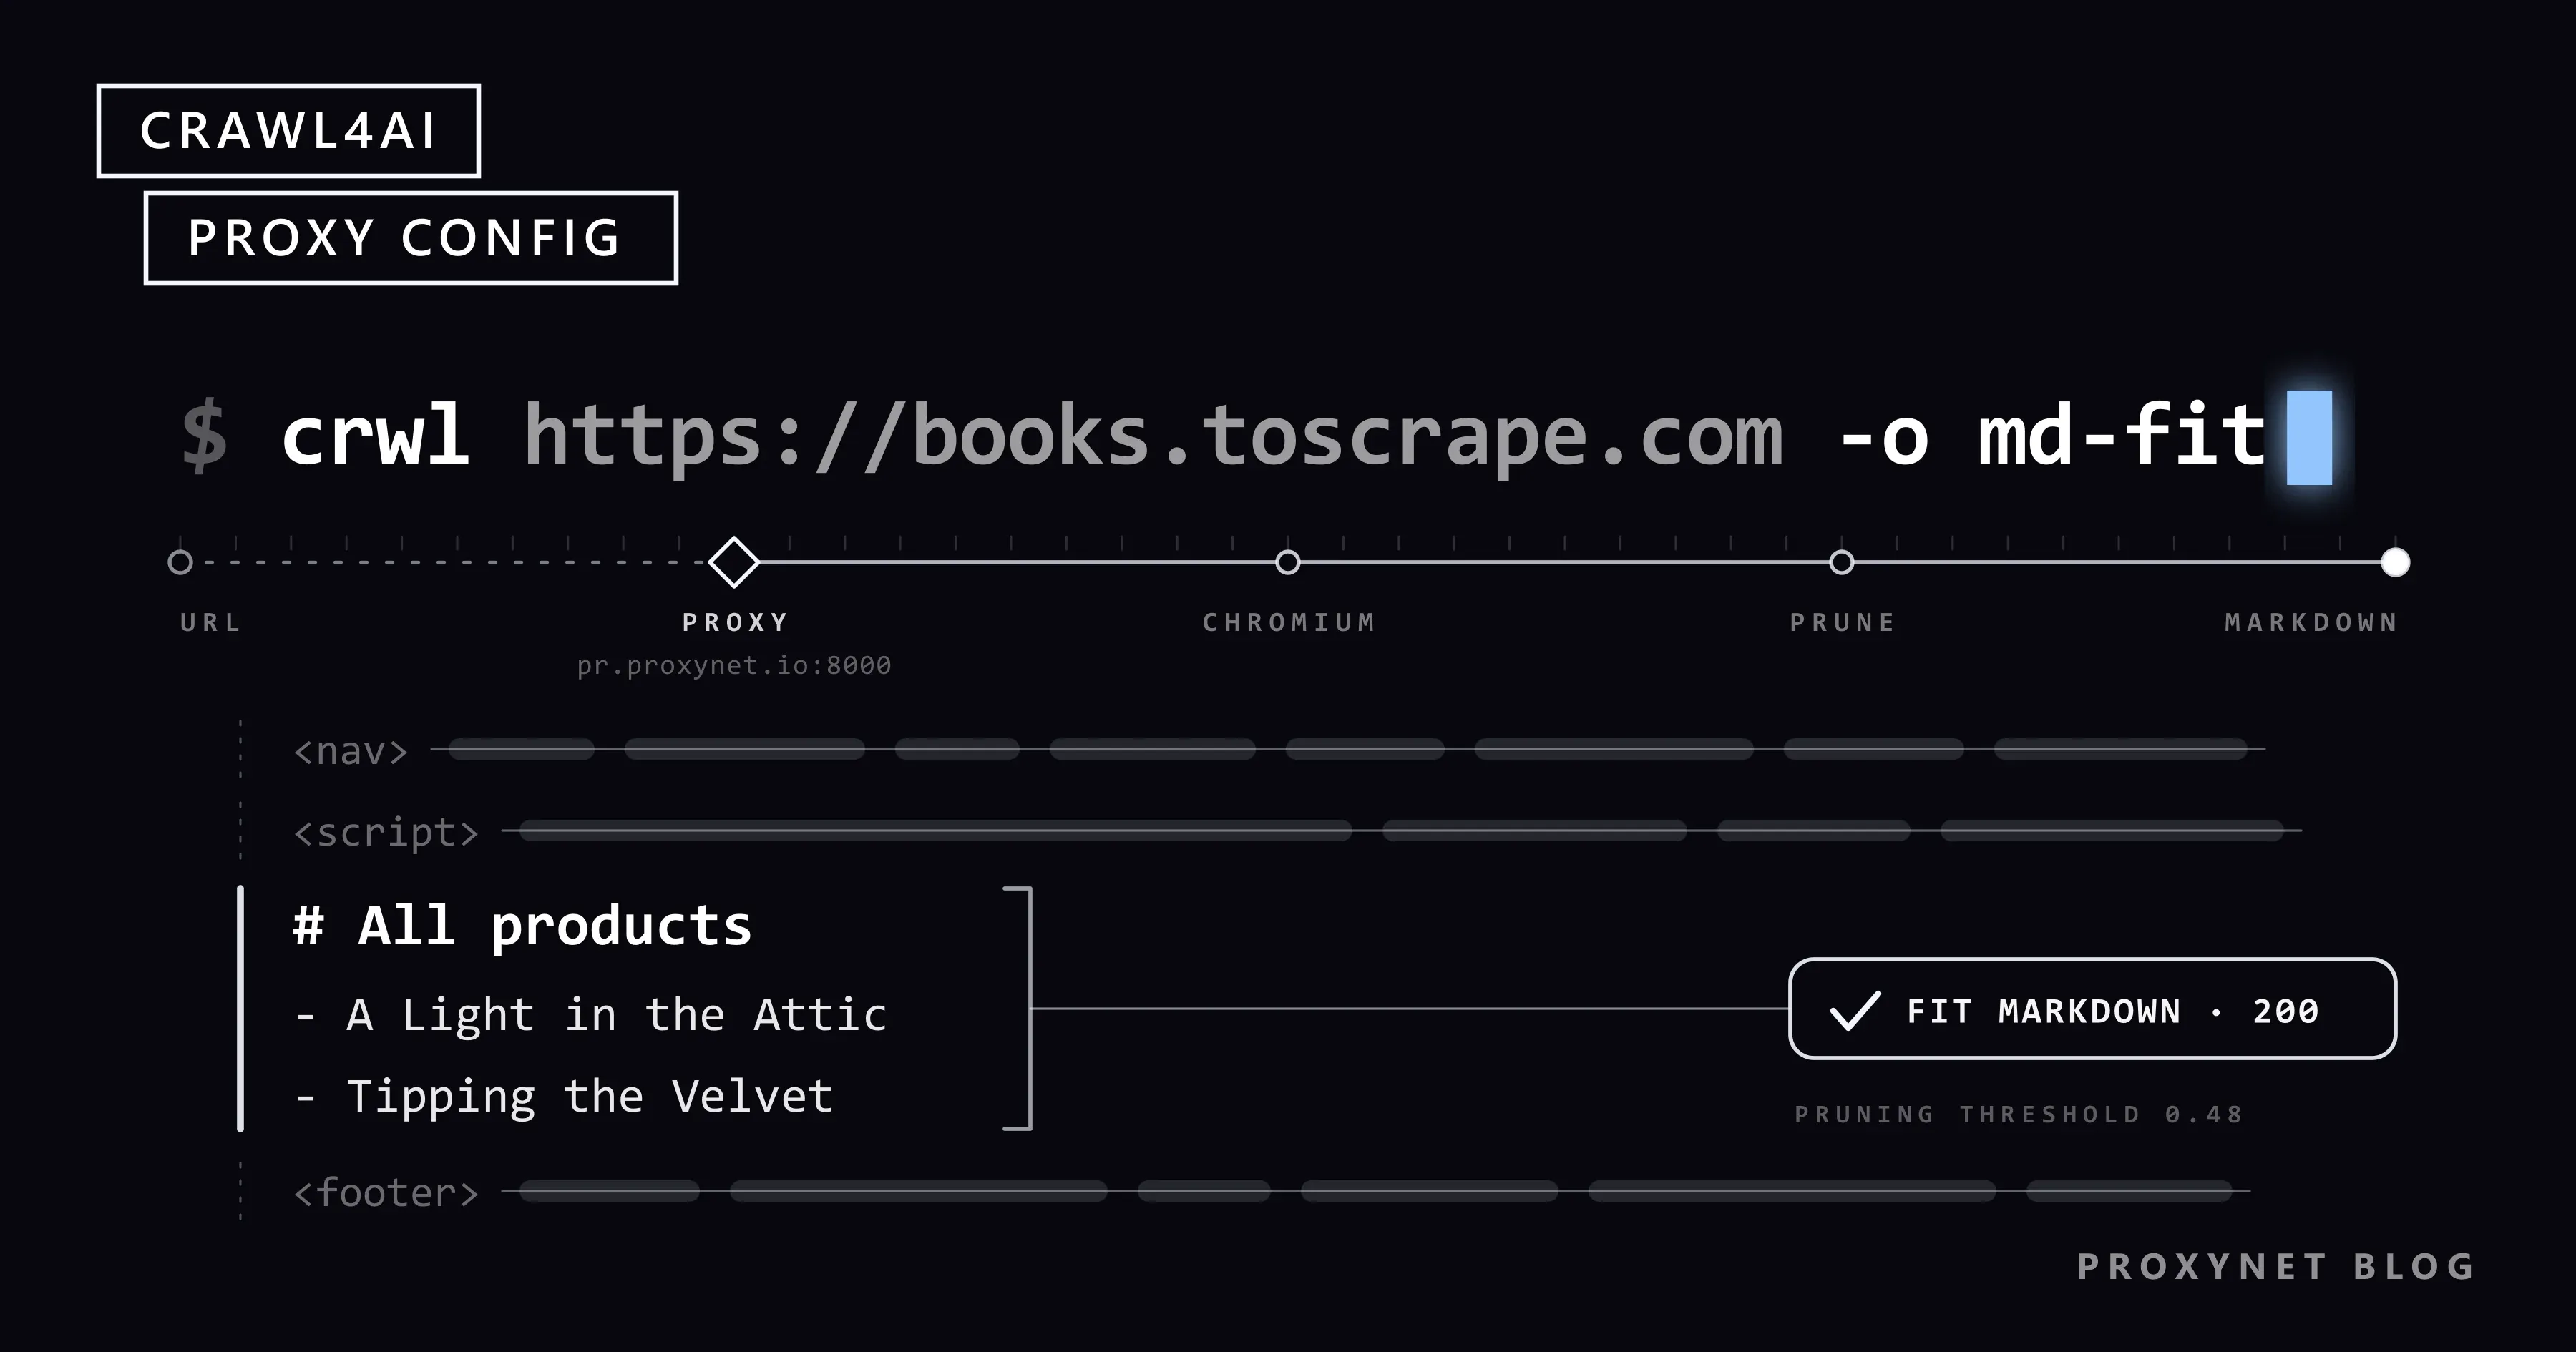
Crawl4AI es una biblioteca de Python de código abierto que descarga páginas web y devuelve su contenido en una forma que un modelo de lenguaje puede leer. Maneja Chromium mediante Playwright, así que las páginas construidas con JavaScript se renderizan antes de leerse (páginas estáticas y dinámicas). Un solo rastreo devuelve la página como Markdown, un Markdown «fit» más corto sin menús ni pies de página, los enlaces, la lista de medios y, si lo pides, una captura de pantalla o un PDF. Con una estrategia de extracción también puede rellenar un esquema JSON.
La biblioteca necesita Python 3.10 o una versión más reciente; la versión 0.9.4 apareció en PyPI el 23 de septiembre de 2026. Puedes usarla como SDK de Python, como servidor Docker con una API REST y un endpoint MCP, o mediante la herramienta de línea de comandos crwl.
Crawl4AI es ante todo un rastreador (crawler): visita páginas y sigue enlaces, y lo que extraigas de ellas depende de ti (web scraping y web crawling). La comparación con las herramientas de scraping con IA en general está en ¿Qué es un AI web scraper y cómo funciona?.
¿Cómo convierte Crawl4AI una página en Markdown?
Una llamada a arun() pasa por estos pasos:
- Arranca el navegador con los ajustes de
BrowserConfig: modo headless, elUser-Agenty, si se define ahí, un proxy para todo el navegador. - Se comprueba robots.txt si
CrawlerRunConfigtienecheck_robots_txt=True. Una URL no permitida nunca se abre; el resultado tiene el estado403y «Access denied by robots.txt». - La página se carga en Chromium, a través del proxy de la ejecución si lo hay, y se ejecuta su JavaScript.
- Se limpia el HTML: se eliminan los scripts y los estilos, y se recogen los enlaces y los medios.
DefaultMarkdownGeneratorescriberaw_markdown.- Un
content_filterescribefit_markdown:PruningContentFilterLXMLconserva los bloques con mucho texto, yBM25ContentFilter, los bloques que coinciden con una consulta. Sin filtro,fit_markdownqueda vacío. - Vuelve un
CrawlResultconsuccess,status_code,error_message,markdownylinks.
En una de nuestras páginas de prueba, el Markdown en bruto tenía 1.241 caracteres y el Markdown fit, 712: el menú y el pie de página desaparecieron y el artículo se quedó. Un aviso de cookies se mantuvo, porque el filtro puntúa la densidad de texto y de enlaces, no el significado; excluded_selector=".cookie" en CrawlerRunConfig lo eliminó.
¿Cómo se instala Crawl4AI con pip o Docker?
La vía de pip instala la biblioteca y una versión de Chromium. La vía de Docker arranca un servidor al que otros programas llaman por HTTP.
# SDK de Python
pip install -U crawl4ai
crawl4ai-setup      # instala el navegador de Playwright que usa Crawl4AI
crawl4ai-doctor     # hace un rastreo de prueba para comprobar la instalación

# Servidor Docker: 0.9.0 y versiones posteriores necesitan un token
export CRAWL4AI_API_TOKEN="$(openssl rand -hex 32)"
docker run -d -p 11235:11235 --name crawl4ai --shm-size=1g \
  -e CRAWL4AI_API_TOKEN="$CRAWL4AI_API_TOKEN" \
  unclecode/crawl4ai:0.9.4

curl http://localhost:11235/health    # responde sin token
curl -X POST http://localhost:11235/md \
  -H "Authorization: Bearer $CRAWL4AI_API_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://quotes.toscrape.com/", "f": "fit"}'
La guía de autoalojamiento usa la etiqueta latest; una etiqueta de versión evita que una actualización de la imagen cambie el comportamiento del servidor sin que te des cuenta. Las páginas /playground y /dashboard tienen arriba un campo para el token.
Las tres formas de ejecutar Crawl4AI se diferencian sobre todo en dónde puede ir el proxy:
| Forma | Instalación | Dónde va el proxy | robots.txt y ritmo | Adecuada para |
|---|---|---|---|---|
| SDK de Python | pip install, crawl4ai-setup | proxy_config en CrawlerRunConfig o BrowserConfig; proxy_rotation_strategy para una lista | check_robots_txt, SemaphoreDispatcher, RateLimiter | Cualquier trabajo que necesite tu propio proxy |
| Servidor Docker | docker run con token, puerto 11235 | No en la petición (HTTP 400) | check_robots_txt permitido en la petición | Llamadas desde otros lenguajes, n8n o agentes |
CLI crwl | Viene con pip | Archivo de configuración del navegador, -B | Archivo de configuración del crawler, -C | Una página a Markdown |
¿Cómo obtienes Markdown en tu primer rastreo con Python?
El script abre una página a través de un proxy, comprueba antes robots.txt e imprime el tamaño de las dos versiones de Markdown. La dirección del proxy sale de una variable de entorno, así que la contraseña queda fuera del código.
"""Rastrea una página a través de un proxy e imprime su Markdown."""
import asyncio
import os
import sys

from crawl4ai import (
    AsyncWebCrawler,
    BrowserConfig,
    CacheMode,
    CrawlerRunConfig,
    DefaultMarkdownGenerator,
    ProxyConfig,
    PruningContentFilterLXML,
)

URL = sys.argv[1] if len(sys.argv) > 1 else "https://quotes.toscrape.com/"


async def main():
    # PROXY_URL=http://user:pass@pr.proxynet.io:8000, fuera del código
    proxy = ProxyConfig.from_string(os.environ["PROXY_URL"])

    browser_config = BrowserConfig(
        headless=True,
        user_agent="NorthwindDocsBot/1.0 (+https://example.com/bot)",
    )
    run_config = CrawlerRunConfig(
        proxy_config=proxy,
        check_robots_txt=True,
        cache_mode=CacheMode.BYPASS,
        markdown_generator=DefaultMarkdownGenerator(
            content_filter=PruningContentFilterLXML(threshold=0.48)
        ),
    )

    async with AsyncWebCrawler(config=browser_config) as crawler:
        result = await crawler.arun(URL, config=run_config)

    if not result.success:
        print(f"failed: {result.status_code} {result.error_message}")
        return

    md = result.markdown
    print(f"status {result.status_code}")
    print(f"raw_markdown: {len(md.raw_markdown)} characters")
    print(f"fit_markdown: {len(md.fit_markdown)} characters")
    print(md.fit_markdown[:400])


asyncio.run(main())
En quotes.toscrape.com, un sitio de práctica para scraping, imprimió:
status 200
raw_markdown: 4375 characters
fit_markdown: 3663 characters
CacheMode.BYPASS descarga la página cada vez; sin él, las URL repetidas salen de la caché local. Usa PruningContentFilterLXML: en 0.9.4 el antiguo PruningContentFilter imprime un aviso de obsolescencia.
¿Cómo se configura un proxy en Crawl4AI?
Un proxy es un ProxyConfig con server, username y password, y va en uno de estos dos sitios:
from crawl4ai import BrowserConfig, CrawlerRunConfig, ProxyConfig

proxy = ProxyConfig(server="http://pr.proxynet.io:8000", username="user", password="pass")

run_config = CrawlerRunConfig(proxy_config=proxy)    # solo esta ejecución
browser_config = BrowserConfig(proxy_config=proxy)   # todas las páginas que abre este navegador
La guía oficial de proxies recomienda CrawlerRunConfig, para que cada ejecución lleve su propio proxy. Las dos formas funcionaron en nuestra prueba.
ProxyConfig.from_string() lee http://user:pass@host:port, host:port:user:pass, host:port y socks5://host:port. ProxyConfig.from_env("PROXIES") lee una lista separada por comas desde una variable de entorno. El antiguo parámetro proxy= sigue funcionando, pero imprime un aviso de obsolescencia.
SOCKS5 con contraseña no funciona. Con socks5:// y un usuario, en cualquiera de las dos formas, nuestro rastreo falló con «Browser does not support socks5 proxy authentication». El límite es de Chromium (Playwright con un proxy). Usa el endpoint HTTP del proxy, o autoriza la IP de tu servidor en el panel del proxy (lista de IP autorizadas) y conéctate sin contraseña (SOCKS y HTTP).
Para comprobar el proxy, rastrea una página que muestre la IP del visitante.
Rotativo o de sesión fija: ¿cuándo necesitas RoundRobinProxyStrategy?
Depende de a qué apunte la dirección de tu proxy.
Un gateway rotativo es una sola dirección, como pr.proxynet.io:8000, detrás de la cual el proveedor cambia la IP de salida. Con Proxies rotativos o con Proxies residenciales rotativos, Crawl4AI solo necesita un ProxyConfig. La demo de la página oficial de proxies compara la IP que vio un sitio con ProxyConfig.ip; con un gateway esa comprobación siempre indica que no coinciden, porque la IP de salida nunca es la dirección del gateway.
Una lista fija de IP, por ejemplo de un plan de Proxies de centro de datos o de Proxies ISP, es donde RoundRobinProxyStrategy ayuda: cada petición recibe el siguiente proxy de la lista. Con proxy_session_id, las peticiones con el mismo ID conservan el mismo proxy hasta que pasan proxy_session_ttl segundos:
"""Rota por una lista fija de proxies o conserva uno de ellos durante toda una sesión."""
import asyncio

from crawl4ai import (
    AsyncWebCrawler,
    BrowserConfig,
    CacheMode,
    CrawlerRunConfig,
    ProxyConfig,
    RoundRobinProxyStrategy,
)

# PROXIES="http://user:pass@203.0.113.10:8000,http://user:pass@203.0.113.11:8000"
strategy = RoundRobinProxyStrategy(ProxyConfig.from_env("PROXIES"))

rotate = CrawlerRunConfig(proxy_rotation_strategy=strategy, cache_mode=CacheMode.BYPASS)
sticky = CrawlerRunConfig(
    proxy_rotation_strategy=strategy,
    proxy_session_id="catalog-1",  # cada petición con este id recibe el mismo proxy
    proxy_session_ttl=600,         # segundos; después, la sesión elige otro
    cache_mode=CacheMode.BYPASS,
)


async def main(base):
    async with AsyncWebCrawler(config=BrowserConfig(headless=True)) as crawler:
        for label, config in (("rotate", rotate), ("sticky", sticky)):
            for page in range(1, 4):
                result = await crawler.arun(f"{base}/catalog?page={page}", config=config)
                print(label, page, result.status_code, config.proxy_config.server)


asyncio.run(main("https://shop.example.com"))
Con dos proxies locales, las peticiones rotate se alternaron y las sticky mantuvieron un solo proxy. Los parámetros de sesión están en el código fuente de 0.9.4, pero no en la página de documentación de proxies, así que vuelve a comprobarlos después de cada actualización.
Mantén separadas las dos capas. La sesión fija de Crawl4AI elige la misma entrada de tu lista; detrás de un gateway rotativo, la IP de salida solo se mantiene fija si el proveedor la retiene, como hacen los Proxies de sesión fija durante 1 a 60 minutos. Los modos se explican en rotación de IP, y la rotación para clientes HTTP sencillos, en cómo rotar proxies en Python.
¿Por qué una petición a Docker no puede llevar un proxy?
Desde 0.9.0 el servidor Docker es seguro por defecto. Un cuerpo de petición con proxy o proxy_config recibe HTTP 400, igual que js_code, headers, cookies, magic y varios campos más (notas de migración de 0.9.0). El motivo es la falsificación de peticiones del lado del servidor (SSRF): de otro modo, quien llama podría enviar el navegador del servidor a través de cualquier proxy o hacia direcciones internas.
Las notas dicen que esas opciones se configuren en el servidor, pero en el código fuente de 0.9.4 un guardián de salida (egress guard) elimina cualquier proxy_config, incluido uno en config.yml, y dirige Chromium a través del proxy de filtrado del propio servidor. El código fuente también lee un proxy HTTP upstream desde CRAWL4AI_UPSTREAM_PROXY o HTTPS_PROXY; esto no está documentado y no pudimos probarlo. Para usar tu propio proxy, ejecuta el SDK en tu propio servicio.
¿Cómo se ajustan robots.txt, el ritmo y la concurrencia?
check_robots_txt es False por defecto. Probamos el comportamiento de 0.9.4 con sitios locales:
- Una ruta no permitida devuelve el estado
403, y la página nunca se solicita. - Un robots.txt que responde
500cuenta como «todo permitido», igual que un tiempo de espera de 2 segundos y un error de red. RFC 9309 dice que, ante errores del servidor, un crawler debe asumir una prohibición completa. - Las reglas se guardan en caché durante 7 días. RFC 9309 dice que una copia en caché no debería usarse durante más de 24 horas;
crawler.robots_parser.clear_cache()vacía la caché. - robots.txt se descarga directamente desde tu equipo, no a través del proxy, con un User-Agent genérico de
aiohttp. - Las reglas se comparan con
BrowserConfig.user_agent. El valor por defecto es una cadena de Chrome, así que unDisallowpara el nombre de tu bot solo se aplica cuando tuUser-Agentlleva ese nombre. Una ruta bajo/privatese abrió con la cadena por defecto y devolvió403conNorthwindDocsBot/1.0.
Para trabajos sensibles, comprueba antes robots.txt por tu cuenta (robots.txt, ¿Qué es el User-Agent?).
El ritmo se define en el dispatcher. SemaphoreDispatcher(semaphore_count=3) mantiene como máximo tres páginas abiertas a la vez (concurrencia y paralelismo). RateLimiter espera entre peticiones a un mismo dominio, duplica más o menos la espera tras un 429 o un 503 hasta max_delay, y la acorta tras las respuestas correctas. No vuelve a descargar una página rechazada: el resultado llega con 429, y el reintento es cosa tuya. El script de abajo rastrea en lotes de tres y da a las páginas rechazadas dos rondas más:
"""Rastrea las páginas de un sitio a un ritmo prudente y guarda cada una como Markdown."""
import asyncio
import os
import re
from pathlib import Path

from crawl4ai import (
    AsyncWebCrawler,
    BrowserConfig,
    CacheMode,
    CrawlerRunConfig,
    DefaultMarkdownGenerator,
    ProxyConfig,
    PruningContentFilterLXML,
    RateLimiter,
    SemaphoreDispatcher,
)

BASE = os.environ.get("DOCS_BASE", "https://docs.example.com")
URLS = [f"{BASE}/docs/{n}" for n in range(1, 13)] + [f"{BASE}/private/report"]
OUT = Path("pages")
BATCH = 3                 # páginas abiertas a la vez
PAUSE = 5.0               # segundos entre dos lotes
RETRY_CODES = {429, 503}  # vale la pena reintentarlas más tarde
ROUNDS = 3                # primera pasada más dos rondas de reintento
ROUND_PAUSE = 60          # segundos antes de una ronda de reintento; se duplica en cada ronda


def file_name(url):
    return re.sub(r"[^a-z0-9]+", "-", url.lower()).strip("-") + ".md"


async def crawl_round(crawler, urls, run_config, dispatcher):
    """Rastrea las urls en lotes pequeños y devuelve las que hay que reintentar más tarde."""
    retry = []
    for i in range(0, len(urls), BATCH):
        results = await crawler.arun_many(
            urls[i : i + BATCH], config=run_config, dispatcher=dispatcher
        )
        for r in results:
            if r.success and r.status_code == 200:
                (OUT / file_name(r.url)).write_text(r.markdown.fit_markdown, encoding="utf-8")
                print(f"saved  {r.url}")
            elif r.status_code in RETRY_CODES:
                retry.append(r.url)
                print(f"later  {r.status_code} {r.url}")
            else:
                print(f"skip   {r.status_code} {r.url}: {r.error_message}")
        await asyncio.sleep(PAUSE)
    return retry


async def main():
    OUT.mkdir(exist_ok=True)
    browser_config = BrowserConfig(
        headless=True,
        user_agent="NorthwindDocsBot/1.0 (+https://example.com/bot)",
    )
    run_config = CrawlerRunConfig(
        proxy_config=ProxyConfig.from_string(os.environ["PROXY_URL"]),
        check_robots_txt=True,
        cache_mode=CacheMode.BYPASS,
        page_timeout=30000,
        markdown_generator=DefaultMarkdownGenerator(
            content_filter=PruningContentFilterLXML(threshold=0.48)
        ),
    )
    # Un solo dispatcher para toda la ejecución: el RateLimiter conserva el ritmo más lento que aprende de los 429
    dispatcher = SemaphoreDispatcher(
        semaphore_count=BATCH,
        rate_limiter=RateLimiter(base_delay=(1.0, 3.0), max_delay=60.0, max_retries=3),
    )

    pending = list(URLS)
    async with AsyncWebCrawler(config=browser_config) as crawler:
        for round_no in range(ROUNDS):
            if round_no:
                wait = ROUND_PAUSE * 2 ** (round_no - 1)
                print(f"round {round_no + 1}: {len(pending)} pages again in {wait} s")
                await asyncio.sleep(wait)
            pending = await crawl_round(crawler, pending, run_config, dispatcher)
            if not pending:
                break

    print(f"done, {len(pending)} pages still refused")


asyncio.run(main())
Apuntamos DOCS_BASE a un sitio local que responde con 429 a una de cada cuatro peticiones bajo /docs/ y prohíbe /private, y para la prueba pusimos ROUND_PAUSE en 5 segundos. Salida abreviada:
saved  http://192.168.1.2:28130/docs/1
saved  http://192.168.1.2:28130/docs/2
saved  http://192.168.1.2:28130/docs/3
later  429 http://192.168.1.2:28130/docs/4
...
later  429 http://192.168.1.2:28130/docs/11
saved  http://192.168.1.2:28130/docs/12
skip   403 http://192.168.1.2:28130/private/report: Access denied by robots.txt
round 2: 3 pages again in 5 s
saved  http://192.168.1.2:28130/docs/4
saved  http://192.168.1.2:28130/docs/9
saved  http://192.168.1.2:28130/docs/11
done, 0 pages still refused
El log de Crawl4AI también imprime «Blocked by anti-bot protection: HTTP 429 Too Many Requests» por cada página rechazada. Cómo tratar una cabecera Retry-After real se explica en Códigos de estado HTTP en web scraping.
¿Qué diferencia hay entre Crawl4AI y Firecrawl?
Los dos convierten páginas en Markdown para modelos de lenguaje; se diferencian en cómo los ejecutas.
| Crawl4AI | Firecrawl | |
|---|---|---|
| Licencia | Apache 2.0 más un requisito de atribución | AGPL-3.0 |
| Forma principal | Una biblioteca de Python; servidor Docker opcional | Una API alojada; también se puede autoalojar |
| Piezas si lo autoalojas | Un contenedor | API, workers, Playwright, Redis, RabbitMQ, PostgreSQL |
| Costo | Tu servidor, el proxy y el LLM que uses | Plan de la API, o tus propios servidores |
La guía de autoalojamiento de Firecrawl señala que la API autoalojada no tiene autenticación por defecto. Crawl4AI encaja con un equipo de Python que quiere ejecutar sus propios rastreos y sus propios proxies.
¿Cómo se usa Crawl4AI con MCP y n8n?
El servidor Docker expone MCP en /mcp/sse y /mcp/ws, con las herramientas md, html, screenshot, pdf, execute_js, crawl y ask. El comando para Claude Code de la guía no lleva token, pero los endpoints MCP están detrás de la misma comprobación de token que la API, así que añade la cabecera:
claude mcp add --transport sse c4ai-sse http://localhost:11235/mcp/sse \
  --header "Authorization: Bearer $CRAWL4AI_API_TOKEN"
Los clientes WebSocket que no pueden definir cabeceras pueden pasar ?token=. El protocolo se explica en Qué es MCP (Model Context Protocol), y cómo dar a un agente un navegador completo, en Playwright MCP.
En n8n, un nodo HTTP Request envía POST /md con la cabecera Bearer y un cuerpo como {"url": "https://quotes.toscrape.com/", "f": "fit"}; la página vuelve en el campo markdown (web scraping con n8n).
Casos de uso
- Documentación para RAG: la documentación del producto como Markdown para un índice de recuperación, detrás de las comprobaciones de acceso web seguro para LLM.
- Entrada limpia para agentes: Markdown fit en lugar de HTML en bruto (agentic web scraping).
- Comprobación de precios: páginas de producto convertidas en JSON con un esquema CSS (seguimiento de precios).
- Inventario de tu propio sitio: todas las páginas y los enlaces, para auditorías de contenido y enlaces rotos (rastreador web).
- Datos de catálogo: nombres, especificaciones y precios de páginas de catálogo públicas (extracción de datos).
Errores comunes
docker runsin token, o-e CRAWL4AI_API_TOKENsin valor: «connection reset» desde un contenedor que parece sano.proxy_configen una petición REST: el servidor responde400.socks5://con contraseña: Chromium lo rechaza.- Un gateway rotativo repetido varias veces en
RoundRobinProxyStrategy: el gateway ya rota. - Esperar
fit_markdownsin uncontent_filter: se queda vacío. - Dar por hecho que robots.txt se comprueba: está desactivado por defecto, y un robots.txt que no llega a cargarse cuenta como «permitido».
- Concurrencia alta sin
RateLimiter: diez páginas en paralelo sobre un sitio pequeño parecen una ráfaga, y llegan respuestas429. - Cambiar de IP para forzar a un sitio que ya respondió
429: mejor, reduce el ritmo (cómo funciona la detección de bots).
El modo stealth, el modo «magic» y las funciones de respaldo anti-bot que aparecen en la documentación quedan fuera de esta guía, y no los recomendamos.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Unas cuantas páginas de documentación como texto limpio para un LLM | pip install, arun() con PruningContentFilterLXML |
| Una IP de salida distinta en cada petición | Un solo ProxyConfig con un gateway residencial rotativo |
| La misma IP durante un flujo de varios pasos | Una sesión fija del proveedor, más proxy_session_id para una lista |
| Una lista fija de IP | ProxyConfig.from_env("PROXIES") con RoundRobinProxyStrategy |
| Rastrear desde n8n, otro lenguaje o un agente | Un servidor Docker con token; el trabajo con proxies se queda en el SDK |
| Cientos de páginas sin sobrecargar el sitio | Lotes pequeños, RateLimiter, check_robots_txt=True |
| Ninguna infraestructura que mantener | Una API alojada como Firecrawl |
Preguntas frecuentes
¿Crawl4AI es gratis?
Sí, la biblioteca es gratuita bajo la licencia Apache 2.0. Su archivo LICENSE añade el requisito de citar el proyecto en los usos públicos, por ejemplo en un README o en una página «Acerca de». Tus costos son el servidor, el proxy y cualquier modelo de lenguaje al que llames.
¿Qué versión de Python necesita Crawl4AI?
Python 3.10 o una versión más reciente, según PyPI. Probamos la versión 0.9.4 con Python 3.13.
¿Funciona Crawl4AI con un LLM local como Ollama?
La salida en Markdown no necesita ningún modelo de lenguaje. Para la extracción con LLM, la documentación muestra LLMConfig(provider="ollama/llama3.3") para un modelo local de Ollama, sin clave de API.
¿Qué diferencia hay entre Crawl4AI y Scrapy?
Scrapy envía peticiones HTTP simples y no ejecuta JavaScript por defecto; Crawl4AI renderiza cada página en Chromium y devuelve Markdown. Scrapy encaja en rastreos grandes de HTML estático (Scrapy con un proxy); Crawl4AI, en páginas que van a un modelo de lenguaje.
¿Puedo usar Crawl4AI desde Node.js u otro lenguaje?
La biblioteca en sí es de Python. Desde otros lenguajes, llama a la API REST del servidor Docker, por ejemplo POST /md con el token en la cabecera.
¿Qué hago cuando un sitio bloquea Crawl4AI?
Primero, reduce el ritmo: menos páginas en paralelo, esperas más largas y una pausa después de cada 429. Revisa robots.txt y las condiciones del sitio, y busca una API o un feed oficial. Si el sitio sigue rechazándote, detente; el aspecto legal está en ¿El web scraping es legal?.
En resumen
Crawl4AI convierte páginas en Markdown que un modelo de lenguaje puede leer. Para el trabajo con proxies, usa el SDK: un solo ProxyConfig para un gateway rotativo, RoundRobinProxyStrategy para una lista fija y nada de contraseña en SOCKS5. El servidor Docker necesita un token y no acepta ningún proxy en la petición. Activa check_robots_txt, envía un User-Agent honesto y deja que un RateLimiter marque el ritmo. Para salidas en muchos países o una dirección fija, consulta nuestros servicios de proxy.