Un compañero de equipo te pide que pases a Python una tabla de estadísticas de una página web. Descargaste el HTML con Requests y soup.find("td").text te dio la primera celda. Ahora necesitas todas las filas, la clase que pinta unas celdas de verde y otras de rojo, y los enlaces de página que hay debajo de la tabla. El selector table > tbody > tr que copiaste de las herramientas de desarrollo del navegador no devuelve nada. El camino general de una página a un archivo está en Cómo extraer datos de una web; esta guía trata la biblioteca que lee el HTML.
Vemos los tres parsers, find, find_all y select, la selección por clase, cómo moverse por el árbol, cómo leer texto y enlaces, un ejemplo completo sobre una tabla de práctica y pandas.read_html con sus errores habituales. Todos los ejemplos se ejecutaron el 24 de septiembre de 2026 con beautifulsoup4 4.15.0 y Python 3.13.
¿Qué es BeautifulSoup?
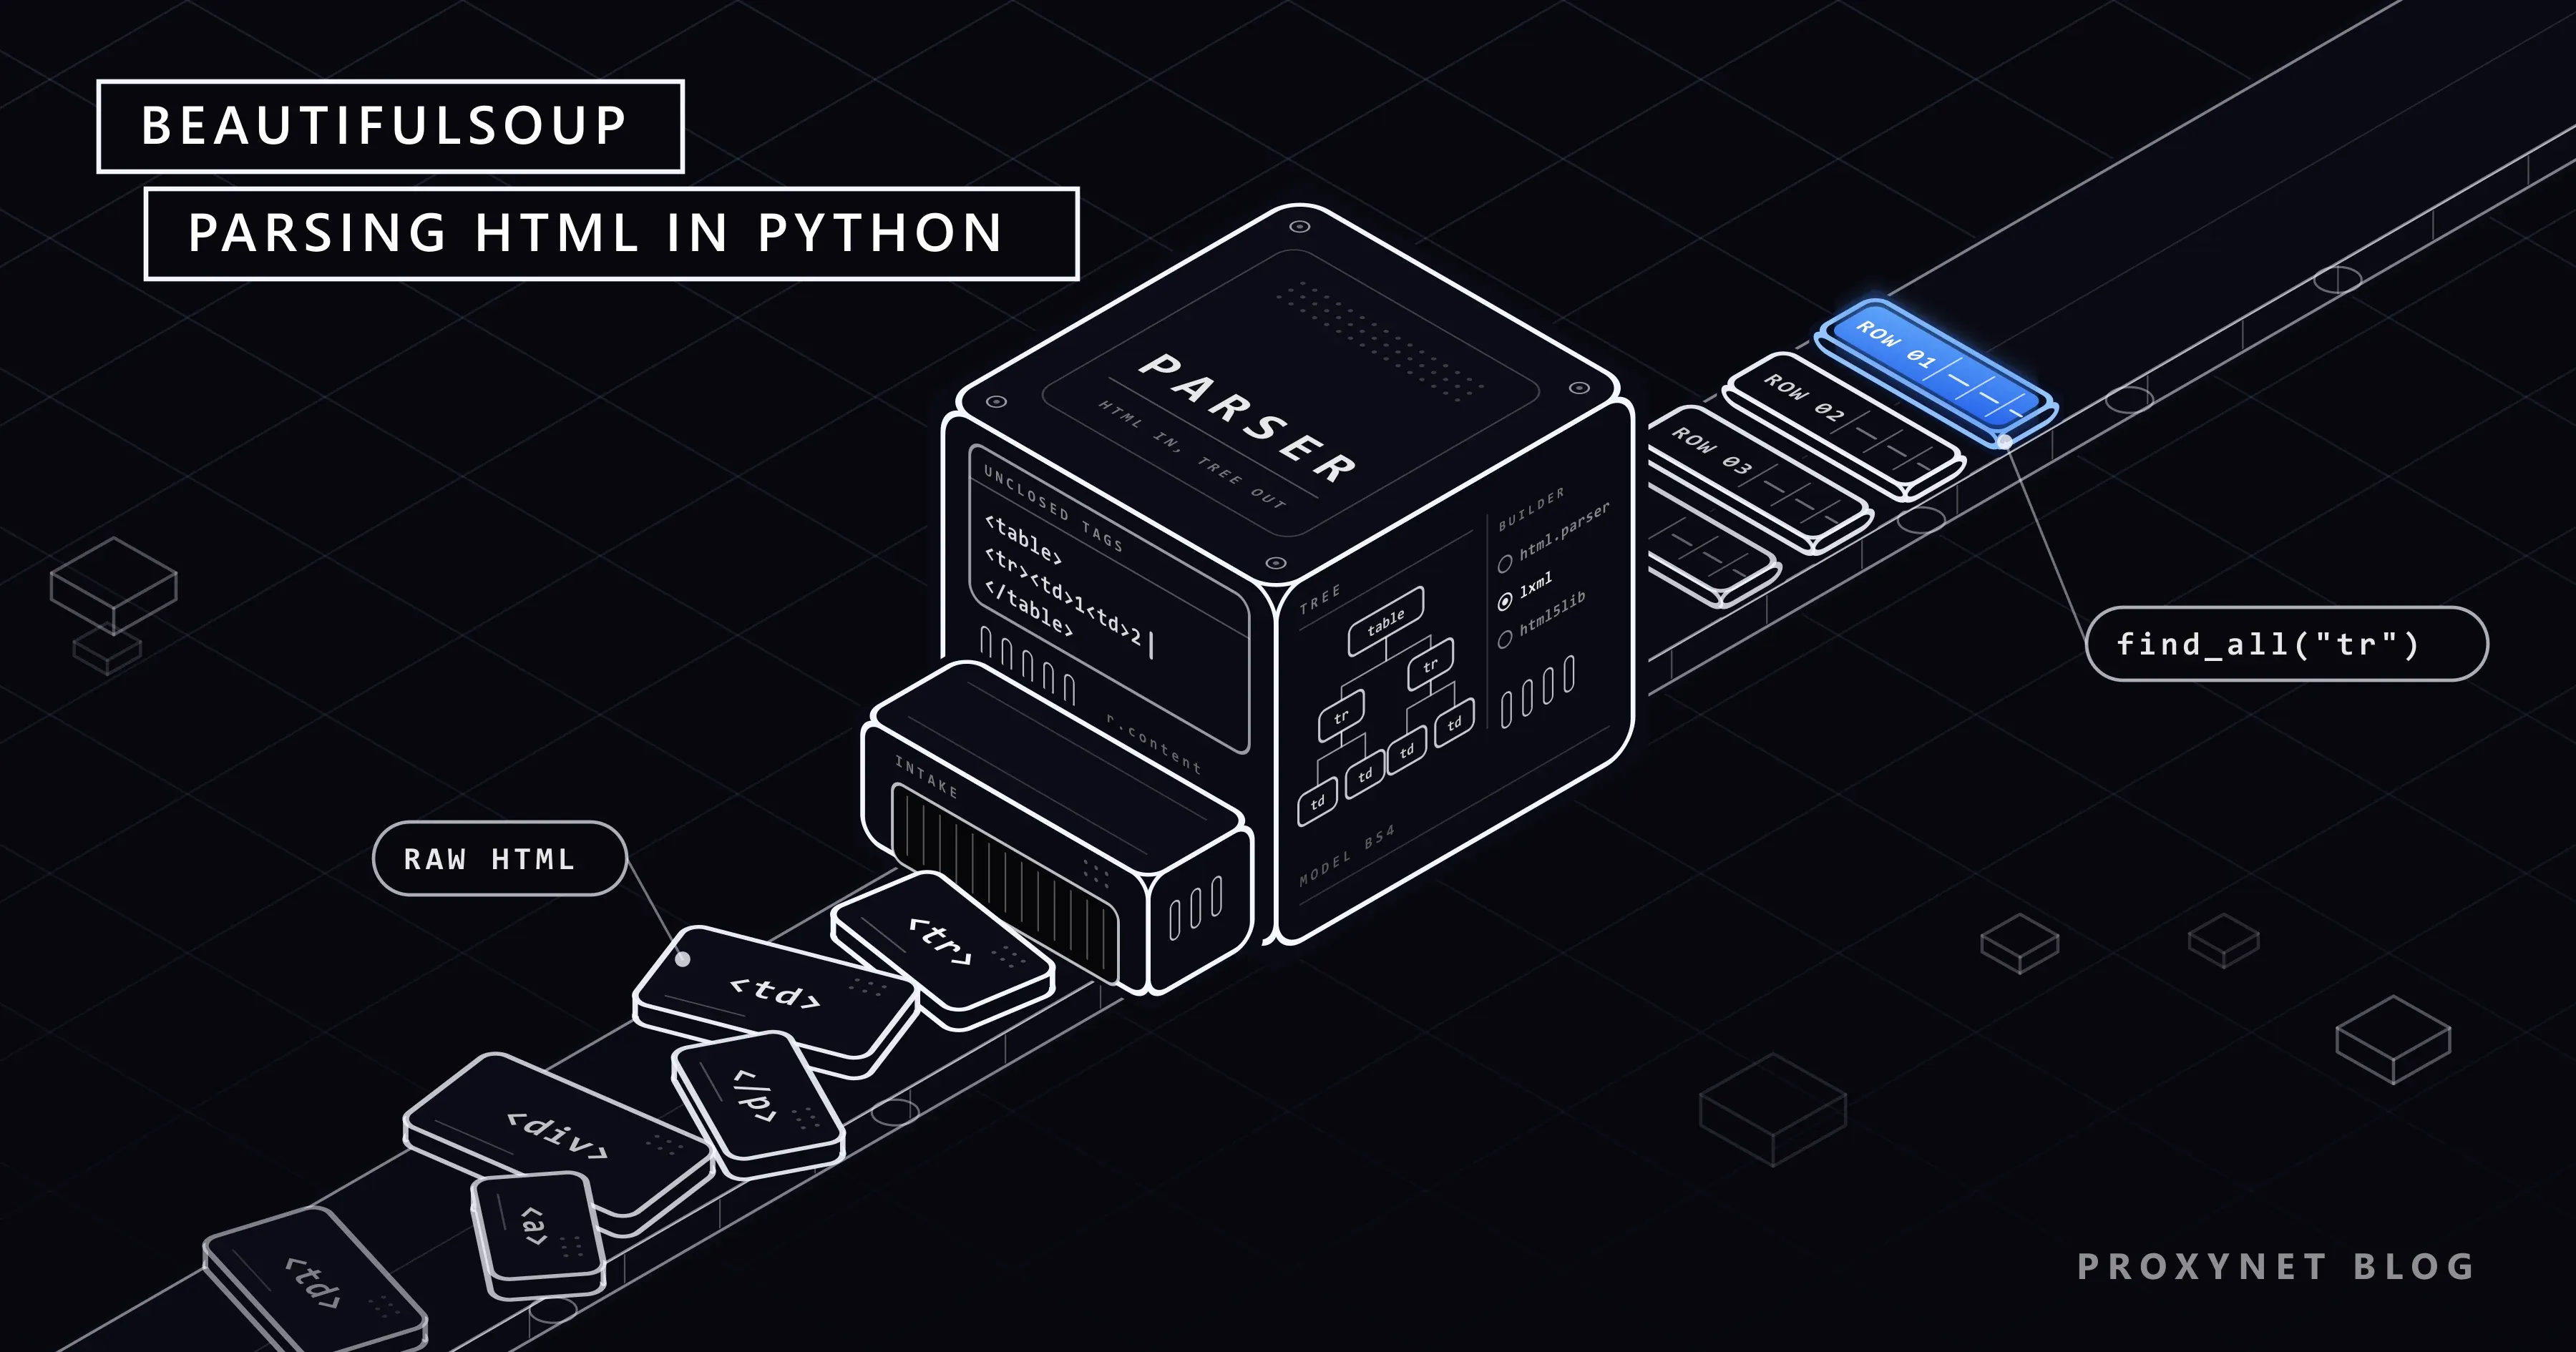
BeautifulSoup es una biblioteca de Python que analiza HTML y XML y los convierte en un árbol de objetos en el que puedes buscar, aunque el marcado esté roto. No envía peticiones. Un cliente HTTP como Requests o HTTPX descarga la página (HTTPX, Requests y AIOHTTP), y BeautifulSoup trabaja con lo que ese cliente devuelve.
El nombre del paquete y el nombre de importación no coinciden. Instalas beautifulsoup4 e importas bs4:
pip install beautifulsoup4 lxmlEl paquete bs4 de PyPI es un paquete de relleno (versión 0.0.2) que reserva el nombre y solo instala beautifulsoup4. Los tutoriales que empiezan con from BeautifulSoup import BeautifulSoup se escribieron para BeautifulSoup 3 y Python 2, y no funcionan en Python 3. La versión actual es la 4.15.0 (beautifulsoup4 en PyPI), y la documentación oficial cubre esa versión. Cómo se compara con Scrapy y Selenium lo explicamos en ¿Scrapy, BeautifulSoup o Selenium?.
¿Cómo convierte BeautifulSoup una página en un árbol?
Entre la descarga y tu primera búsqueda hay cinco pasos:
- El cliente descarga bytes. Requests los guarda en
response.contenty ofrece enresponse.textuna versión decodificada según su propia suposición. - BeautifulSoup detecta la codificación. Una subbiblioteca llamada Unicode, Dammit lee
<meta charset>y otras pistas, y después convierte los bytes a Unicode. Pasaresponse.content, noresponse.text: cuando un servidor envíatext/htmlsin charset, Requests supone ISO-8859-1 yése convierte ené. Los detalles están en errores de codificación Unicode en Python. - El parser lee las etiquetas. Convierte el texto en elementos y repara las etiquetas sin cerrar según sus propias reglas.
- El resultado es un árbol. Cada elemento se convierte en un
Tagcon nombre y atributos, y cada fragmento de texto en unNavigableString. - Los métodos de búsqueda recorren el árbol.
find,find_allyselectleen este árbol en memoria y nunca tocan la red.
¿Qué parser elegir: html.parser, lxml o html5lib?
Cada parser repara el marcado roto a su manera. Dimos a los tres el mismo fragmento con celdas sin cerrar:
from bs4 import BeautifulSoup

broken = "<table><tr><td>1<td>2</table>"
for parser in ("html.parser", "lxml", "html5lib"):
print(parser, BeautifulSoup(broken, parser))html.parser <table><tr><td>1<td>2</td></td></tr></table>
lxml <html><body><table><tr><td>1</td><td>2</td></tr></table></body></html>
html5lib <html><head></head><body><table><tbody><tr><td>1</td><td>2</td></tr></tbody></table></body></html>html.parser metió la segunda celda dentro de la primera, así que row.find_all("td", recursive=False) encuentra una celda en lugar de dos. lxml cerró las dos celdas y envolvió el fragmento en <html><body>. html5lib construyó el árbol que construiría un navegador, <tbody> incluido.
| Parser | Cómo llamarlo | Instalación | Etiquetas sin cerrar | Cuándo elegirlo |
|---|---|---|---|---|
| html.parser | BeautifulSoup(html, "html.parser") | Viene con Python | Puede anidar una celda dentro de otra | Scripts pequeños en los que no puedes instalar paquetes |
| lxml | BeautifulSoup(html, "lxml") | pip install lxml (extensión en C) | Cierra las celdas, añade <html><body> | La mayoría de los trabajos de scraping; la documentación lo describe como muy rápido |
| html5lib | BeautifulSoup(html, "html5lib") | pip install html5lib (Python puro) | Construye el árbol del navegador, añade <tbody> | Páginas muy rotas, o cuando necesitas el árbol que muestra el navegador; muy lento |
Un parser que no está instalado lanza bs4.FeatureNotFound: Couldn't find a tree builder with the features you requested: html5lib. Si no indicas ningún parser, BeautifulSoup elige el mejor que encuentra y emite un GuessedAtParserWarning, así que el mismo script puede construir un árbol distinto en un equipo sin lxml.
¿Qué diferencia hay entre find, find_all y select?
Cuatro métodos cubren casi todas las búsquedas:
find(name, attrs)devuelve la primera etiqueta que coincide, oNone.find_all(name, attrs)devuelve una lista con todas las coincidencias, o una lista vacía.select(css)recibe un selector CSS y devuelve una lista.select_one(css)devuelve la primera coincidencia de un selector CSS, oNone.
Los métodos CSS funcionan sobre Soup Sieve, que se instala junto con beautifulsoup4. Cuando nada coincide:
soup.find("td", class_="rank")        # None
soup.find_all("td", class_="rank")    # []
soup.select_one("td.rank")            # None
soup.select("td.rank")                # []

soup.find("td", class_="rank").get_text()
# AttributeError: 'NoneType' object has no attribute 'get_text'
Es un primer error habitual: find devolvió None y la llamada siguiente falló. Comprueba antes de encadenar:
cell = soup.find("td", class_="name")
name = cell.get_text(strip=True) if cell else None
limit=3 detiene find_all tras tres coincidencias, y recursive=False busca solo en los hijos directos. select es más corto cuando la ruta atraviesa varios niveles, como en table.table tr.team td.name. La sintaxis de los selectores, y por qué BeautifulSoup no tiene XPath, están en Selector CSS o XPath.
¿Cómo seleccionar por clase, id y atributo?
class es una palabra reservada en Python, así que BeautifulSoup usa class_. La trampa es que class contiene varios valores: td["class"] devuelve una lista como ['pct', 'text-success']. En la página de práctica que usamos más abajo, las celdas de Win % llevan pct y las de + / - llevan diff, cada una junto con text-success o text-danger. En una página de 25 filas contamos:
soup.find_all("td", class_="text-danger")       # 31 celdas, de las dos columnas
soup.find_all("td", class_="pct text-danger")   # 19 celdas: coincide con la cadena exacta
soup.find_all("td", class_="text-danger pct")   # 0 celdas: mismas clases, otro orden
soup.select("td.pct.text-danger")               # 19 celdas, en cualquier orden
Una sola clase en class_ coincide con cualquier etiqueta que la tenga, aunque tenga otras. Una cadena con un espacio coincide solo con ese valor exacto del atributo, y se rompe cuando la página cambia el orden de las clases. Para dos o más clases, usa select con puntos. Los demás atributos funcionan como argumentos con nombre o a través de attrs:
import re

soup.find("div", id="results")                     # por id
soup.find_all("a", href=True)                      # solo enlaces que tienen href
soup.find("a", attrs={"aria-label": "Next"})       # los nombres con guion van en attrs
soup.find("th", string=re.compile("Wins"))         # por texto
Aquí string="Wins" devuelve None porque string compara el texto completo, y la celda tiene saltos de línea y espacios alrededor de la palabra. Una expresión regular coincide en cualquier punto del texto.
¿Cómo moverse por el árbol: padre, hijos y hermanos?
.parentsube un nivel, yfind_parent("table")sube hasta encontrar una tabla..childrenda los hijos directos,.descendantstodos los nodos que hay debajo. Una fila de la tabla de práctica tiene 9 celdas, pero.childrendevolvió 19 elementos: los otros 10 son cadenas de espacios en blanco..next_siblingdevuelve el nodo siguiente, que en un HTML indentado suele ser un espacio en blanco.
name = soup.find("td", class_="name")
name.next_sibling                                   # '\n'
name.find_next_sibling("td").get_text(strip=True)   # '1990'
find_next_sibling("td") y find_previous_sibling("td") saltan a la etiqueta siguiente o anterior. El mismo método sirve para las tablas de campo y valor: th.find_next_sibling("td") da el valor que hay junto al nombre del campo.
¿Cómo leer texto y atributos: get_text, href y src?
.text conserva los espacios en blanco, así que la celda del equipo devuelve el nombre rodeado de saltos de línea y sangría. get_text(strip=True) lo recorta a 'Boston Bruins'. Cuando una etiqueta contiene otras etiquetas, añade un separador: con <td>12<small>pts</small></td>, get_text(strip=True) devuelve '12pts' y get_text(" ", strip=True) devuelve '12 pts'. .stripped_strings entrega los fragmentos uno a uno.
Los atributos se leen como un diccionario. a["href"] lanza un KeyError cuando la etiqueta no tiene href; a.get("href") devuelve None, lo que es más seguro dentro de un bucle. Los enlaces relativos como /pages/forms/?page_num=2 se convierten en direcciones completas con urllib.parse.urljoin(page_url, href), y una imagen funciona igual con img.get("src"). Las imágenes con carga diferida y srcset las tratamos en Cómo descargar todas las imágenes de una web.
Ejemplo completo: leer una tabla HTML fila a fila
El objetivo es la tabla de hockey de scrapethissite.com/pages/forms, cuyo título de página presenta el sitio como un entorno de práctica público para aprender web scraping. Su robots.txt solo prohíbe /lessons/ y /faq/, y el script lo comprueba primero (cómo leer robots.txt). Lee las 25 filas de una página, convierte la clase de la celda de Win % en un campo verdadero o falso y recoge los enlaces de página.
"""Lee una página de una tabla de práctica con Requests y BeautifulSoup."""
import json
import os
import sys
from urllib.parse import urljoin
from urllib.robotparser import RobotFileParser

import requests
from bs4 import BeautifulSoup

URL = "https://www.scrapethissite.com/pages/forms/"
USER_AGENT = "hockey-table-demo/1.0 (contact: you@example.com)"

# Opcional: PROXY_URL=http://user:pass@pr.proxynet.io:8000
proxy = os.environ.get("PROXY_URL")

session = requests.Session()
session.headers["User-Agent"] = USER_AGENT
if proxy:
    session.proxies = {"http": proxy, "https": proxy}

# Comprueba robots.txt una vez, antes de la primera petición
robots = RobotFileParser()
robots.parse(session.get(urljoin(URL, "/robots.txt"), timeout=(5, 20)).text.splitlines())
if not robots.can_fetch(USER_AGENT, URL):
    sys.exit("robots.txt does not allow this page")

response = session.get(URL, timeout=(5, 20))
response.raise_for_status()

# Pasa los bytes a BeautifulSoup e indica el parser
soup = BeautifulSoup(response.content, "lxml")

table = soup.select_one("table.table")
if table is None:
    sys.exit("No table.table on the page: the layout changed or the data comes from JavaScript")

headers = [th.get_text(" ", strip=True) for th in table.find("tr").find_all("th")]

teams = []
for row in table.find_all("tr", class_="team"):
    record = {}
    for td in row.find_all("td"):
        key = td["class"][0]              # "name", "year", "wins", "pct", "diff" ...
        record[key] = td.get_text(strip=True)
    # El sitio pinta Win % de verde o de rojo; el color solo está en la clase
    pct_classes = row.find("td", class_="pct").get("class", [])
    record["above_500"] = "text-success" in pct_classes
    teams.append(record)

# Enlaces de página: los href relativos pasan a URL completas, sin duplicados y en el mismo orden
page_links = list(dict.fromkeys(
    urljoin(URL, a["href"]) for a in soup.select("ul.pagination a[href]")
))

print("columns:", headers)
print("rows:", len(teams), "| page links:", len(page_links))
for team in teams[:3]:
    print(json.dumps(team, ensure_ascii=False))
print("last page:", page_links[-1])
Lo ejecutamos con beautifulsoup4 4.15.0, lxml 6.1.3 y Requests 2.34.2, una vez directamente y otra a través de un proxy de prueba local configurado en PROXY_URL. Las dos ejecuciones imprimieron las mismas líneas:
columns: ['Team Name', 'Year', 'Wins', 'Losses', 'OT Losses', 'Win %', 'Goals For (GF)', 'Goals Against (GA)', '+ / -']
rows: 25 | page links: 24
{"name": "Boston Bruins", "year": "1990", "wins": "44", "losses": "24", "ot-losses": "", "pct": "0.55", "gf": "299", "ga": "264", "diff": "35", "above_500": true}
{"name": "Buffalo Sabres", "year": "1990", "wins": "31", "losses": "30", "ot-losses": "", "pct": "0.388", "gf": "292", "ga": "278", "diff": "14", "above_500": false}
{"name": "Calgary Flames", "year": "1990", "wins": "46", "losses": "26", "ot-losses": "", "pct": "0.575", "gf": "344", "ga": "263", "diff": "81", "above_500": true}
last page: https://www.scrapethissite.com/pages/forms/?page_num=24
La fila de cabecera no tiene clase, así que el script toma el primer <tr> para los nombres de las columnas y tr.team para los datos. La primera clase de cada celda (name, wins, ot-losses) se convierte en la clave del diccionario, lo que hace que el código no dependa del orden de las columnas. La celda vacía de OT Losses vuelve como una cadena vacía, no como None. Aquí el color solo repite el número, pero en algunos sitios, como las tiendas que marcan con una clase un artículo agotado, la clase es el único lugar donde aparece ese dato. El bloque de paginación tiene 25 enlaces porque la flecha «Next» repite la dirección de la página 1; dict.fromkeys elimina el duplicado y conserva el orden.
El User-Agent da el nombre del script y una dirección de contacto en lugar de hacerse pasar por un navegador (¿Qué es el User-Agent?). timeout=(5, 20) abandona tras 5 segundos sin conexión o 20 segundos sin datos, y raise_for_status() se detiene ante una página de error antes de que llegue a analizarse. Una contraseña de proxy incorrecta lanza un ProxyError con «Max retries exceeded» y «407 Proxy Authentication Required» en el mensaje (Max Retries Exceeded With URL). Solo necesitas un proxy cuando el volumen crece o cuando quieres ver las páginas como las ven los visitantes de otro país; en ese caso, un Proxies residenciales encaja en la misma línea PROXY_URL.
El script se detiene a propósito en una sola página. Recorrer las 24 páginas con una pausa entre peticiones se explica en Cómo extraer listas paginadas; reintentar tras un 429 o un 503, en Códigos de estado HTTP en web scraping; lanzar peticiones en paralelo, en Concurrencia y paralelismo, y cambiar de salida entre peticiones, en Cómo rotar proxies en Python.
¿Cómo leer una tabla con pandas read_html?
Cuando la página tiene una <table> bien construida y solo necesitas los valores, pandas la lee con una sola llamada. pandas.read_html solo mira los elementos <table>, <tr>, <th> y <td>, y siempre devuelve una lista de DataFrames, uno por cada tabla que encuentra. Usamos pandas 3.0.6:
import io
import os

import pandas as pd
import requests

URL = "https://www.scrapethissite.com/pages/forms/"

session = requests.Session()
session.headers["User-Agent"] = "hockey-table-demo/1.0 (contact: you@example.com)"
if os.environ.get("PROXY_URL"):
    session.proxies = {"http": os.environ["PROXY_URL"], "https": os.environ["PROXY_URL"]}

response = session.get(URL, timeout=(5, 20))
response.raise_for_status()

# pandas 3: envuelve el HTML en StringIO; una cadena simple se lee como ruta de archivo
tables = pd.read_html(io.StringIO(response.text), attrs={"class": "table"})
df = tables[0]
print(len(tables), df.shape)
print(df[["Team Name", "Year", "Wins", "OT Losses", "Win %"]].head(3))1 (25, 9)
Team Name Year Wins OT Losses Win %
0 Boston Bruins 1990 44 NaN 0.550
1 Buffalo Sabres 1990 31 NaN 0.388
2 Calgary Flames 1990 46 NaN 0.575El servidor declara UTF-8 en su cabecera Content-Type, así que aquí response.text decodifica bien. pandas también convirtió los números: Year y Wins pasaron a enteros, Win % a número decimal y la columna vacía OT Losses a NaN. attrs elige una tabla por sus atributos, y match, por una cadena o una expresión regular presente en su texto. Por defecto, pandas analiza con lxml y, si falla, recurre a BeautifulSoup con html5lib.
Hay tres errores que aparecen una y otra vez:
- Un error de archivo al pasar texto HTML. Desde pandas 3.0,
read_htmlya no acepta cadenas HTML literales; envuelve el texto enio.StringIO(notas de la versión pandas 3.0.0). Una cadena simple se trata como ruta de archivo, y nosotros obtuvimos unFileNotFoundErrorque citaba el comienzo de la página. ValueError: No tables found. La tabla llega después mediante JavaScript, la página dibuja su cuadrícula con elementos<div>, o el texto dematchno está en ninguna tabla (No tables found matching pattern 'Points'). Si html5lib no está instalado, el parser de respaldo falla primero y recibes unImportErrorque te pide instalar html5lib.HTTP Error 403: Forbiddenal pasar la URL. En ese caso pandas descarga con urllib, cuyo User-Agent por defecto esPython-urllib/3.13, y algunos sitios lo rechazan; nuestro servidor de prueba local registró exactamente esa cadena. Descarga tú la página como arriba, o pasa un nombre de bot honesto constorage_options={"User-Agent": "..."}. No copies el User-Agent de un navegador: el RFC 9110 advierte que a un cliente que se hace pasar por otro se le pueden servir las respuestas pensadas para ese otro cliente.
pandas devuelve solo valores. extract_links="body" añade el enlace de cada celda, pero no las clases, así que para el color de Win % de antes vuelves a BeautifulSoup.
Casos de uso
- Precios de la competencia: muchas páginas de producto llevan su precio en una etiqueta
<script>JSON-LD que se lee confind_all("script", type="application/ld+json")(seguimiento de precios de la competencia). - Iniciar sesión con tu propia cuenta: un formulario de inicio de sesión suele tener un campo CSRF oculto que lees con
find("input", attrs={"name": "csrf_token"})antes de enviar el formulario (sesiones y cookies en Python). - Seguir los enlaces de página:
select_one("a[rel=next]")o un bloque de paginación le dice al rastreador dónde está la página siguiente (extraer listas paginadas). - Scraping frente a crawling: BeautifulSoup es el paso de extracción; un rastreador (crawler) añade la parte que descubre páginas (web scraping y web crawling).
- Recogida grande y programada: miles de páginas al día necesitan colas, control de velocidad y salidas en varios países (extracción de datos).
Errores comunes
- Omitir el parser. El resultado depende de lo que esté instalado en cada equipo, y recibes un
GuessedAtParserWarning. - Encadenar sobre
findsin comprobar. Un elemento que falta se convierte tres líneas después en'NoneType' object has no attribute .... - Copiar de las herramientas de desarrollo un selector con
tbody. Los navegadores añaden<tbody>porque el HTML permite a los autores omitir sus etiquetas (WHATWG HTML, el elemento tbody). En la página de práctica,table > tbody > trencontró 0 filas con html.parser y lxml, y 26 con html5lib, mientras quetable tr.teamencontró 25 con los tres. - Buscar varias clases como una sola cadena.
class_="pct text-danger"falla cuando la página escribe las clases en otro orden; usaselect("td.pct.text-danger"). - Esperar que
.next_siblingsea una etiqueta. En un HTML indentado suele ser una cadena de espacios en blanco; usafind_next_sibling("td"). - Pasar
response.text. Sin charset en la cabecera, Requests supone ISO-8859-1; pasaresponse.content. - Empezar un bucle antes de leer
robots.txt. Comprueba lo que permite el sitio y fija una pausa antes de pedir más de una página.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
La página tiene una <table> limpia y quieres un DataFrame | pandas.read_html con io.StringIO, y attrs o match para elegir la tabla |
| También necesitas la clase, el color o el enlace de una celda | BeautifulSoup: filas con find_all("tr"), atributos con td.get("class") y a.get("href") |
| No puedes instalar paquetes adicionales | html.parser, y revisa el resultado en páginas con etiquetas sin cerrar |
| Velocidad y tolerancia a tablas rotas | lxml, la opción por defecto para la mayoría de los trabajos |
| El árbol no coincide con lo que muestra el navegador | Prueba html5lib y quita tbody de tu selector |
| Los datos llegan mediante JavaScript | Busca primero la petición JSON y después un navegador headless (Páginas estáticas y dinámicas) |
| Miles de páginas con colas, reintentos y proxies | Scrapy (Scrapy con un proxy) y un Proxies rotativos |
Preguntas frecuentes
¿BeautifulSoup descarga páginas web?
No. BeautifulSoup solo analiza el HTML que le das. Un cliente HTTP como Requests o HTTPX descarga la página, y tú pasas response.content a BeautifulSoup junto con el nombre de un parser. Tampoco ejecuta JavaScript.
¿Qué diferencia hay entre find y find_all?
find devuelve la primera etiqueta que coincide o None; find_all devuelve una lista con todas las coincidencias, vacía cuando nada coincide. select_one y select hacen lo mismo con un selector CSS. Comprueba el resultado de find antes de llamar a un método sobre él.
¿Qué parser es mejor para BeautifulSoup?
lxml sirve para la mayoría de los trabajos: es rápido y cierra las etiquetas sin cerrar de forma sensata. Usa html.parser cuando no puedas instalar paquetes, y html5lib cuando necesites el árbol del navegador y puedas aceptar que es lento. Escribe siempre el nombre del parser en la llamada.
¿Puede BeautifulSoup leer contenido cargado con JavaScript?
No. Solo ve el HTML que devolvió el servidor, y los datos que un script añade después no están en él. Busca en la pestaña de red del navegador la petición JSON que entrega los datos, o usa un navegador headless donde el sitio lo permita (Páginas estáticas y dinámicas).
¿Por qué pandas read_html dice «No tables found»?
La tabla la construye JavaScript, la página dibuja su cuadrícula con elementos <div> en lugar de una <table>, o tu valor de match o attrs no encaja con ninguna tabla. Desde pandas 3.0, asegúrate también de pasar el HTML envuelto en io.StringIO; una cadena simple se trata como ruta de archivo.
¿pip install bs4 es lo mismo que pip install beautifulsoup4?
En la práctica sí, pero usa el nombre real. bs4 en PyPI es un paquete de relleno que solo instala beautifulsoup4. Instala beautifulsoup4 e importa bs4 en tu código: from bs4 import BeautifulSoup.
En resumen
BeautifulSoup convierte el HTML en un árbol; no descarga páginas ni ejecuta JavaScript. Indica el parser en cada llamada y ten presente que find devuelve None donde find_all devuelve una lista vacía. Usa select cuando busques varias clases a la vez, y prueba primero pandas.read_html cuando la página tenga una tabla limpia. Cuando una página se convierta en miles de páginas al día, mira cómo nuestros proxies para extracción de datos soportan el volumen adicional.