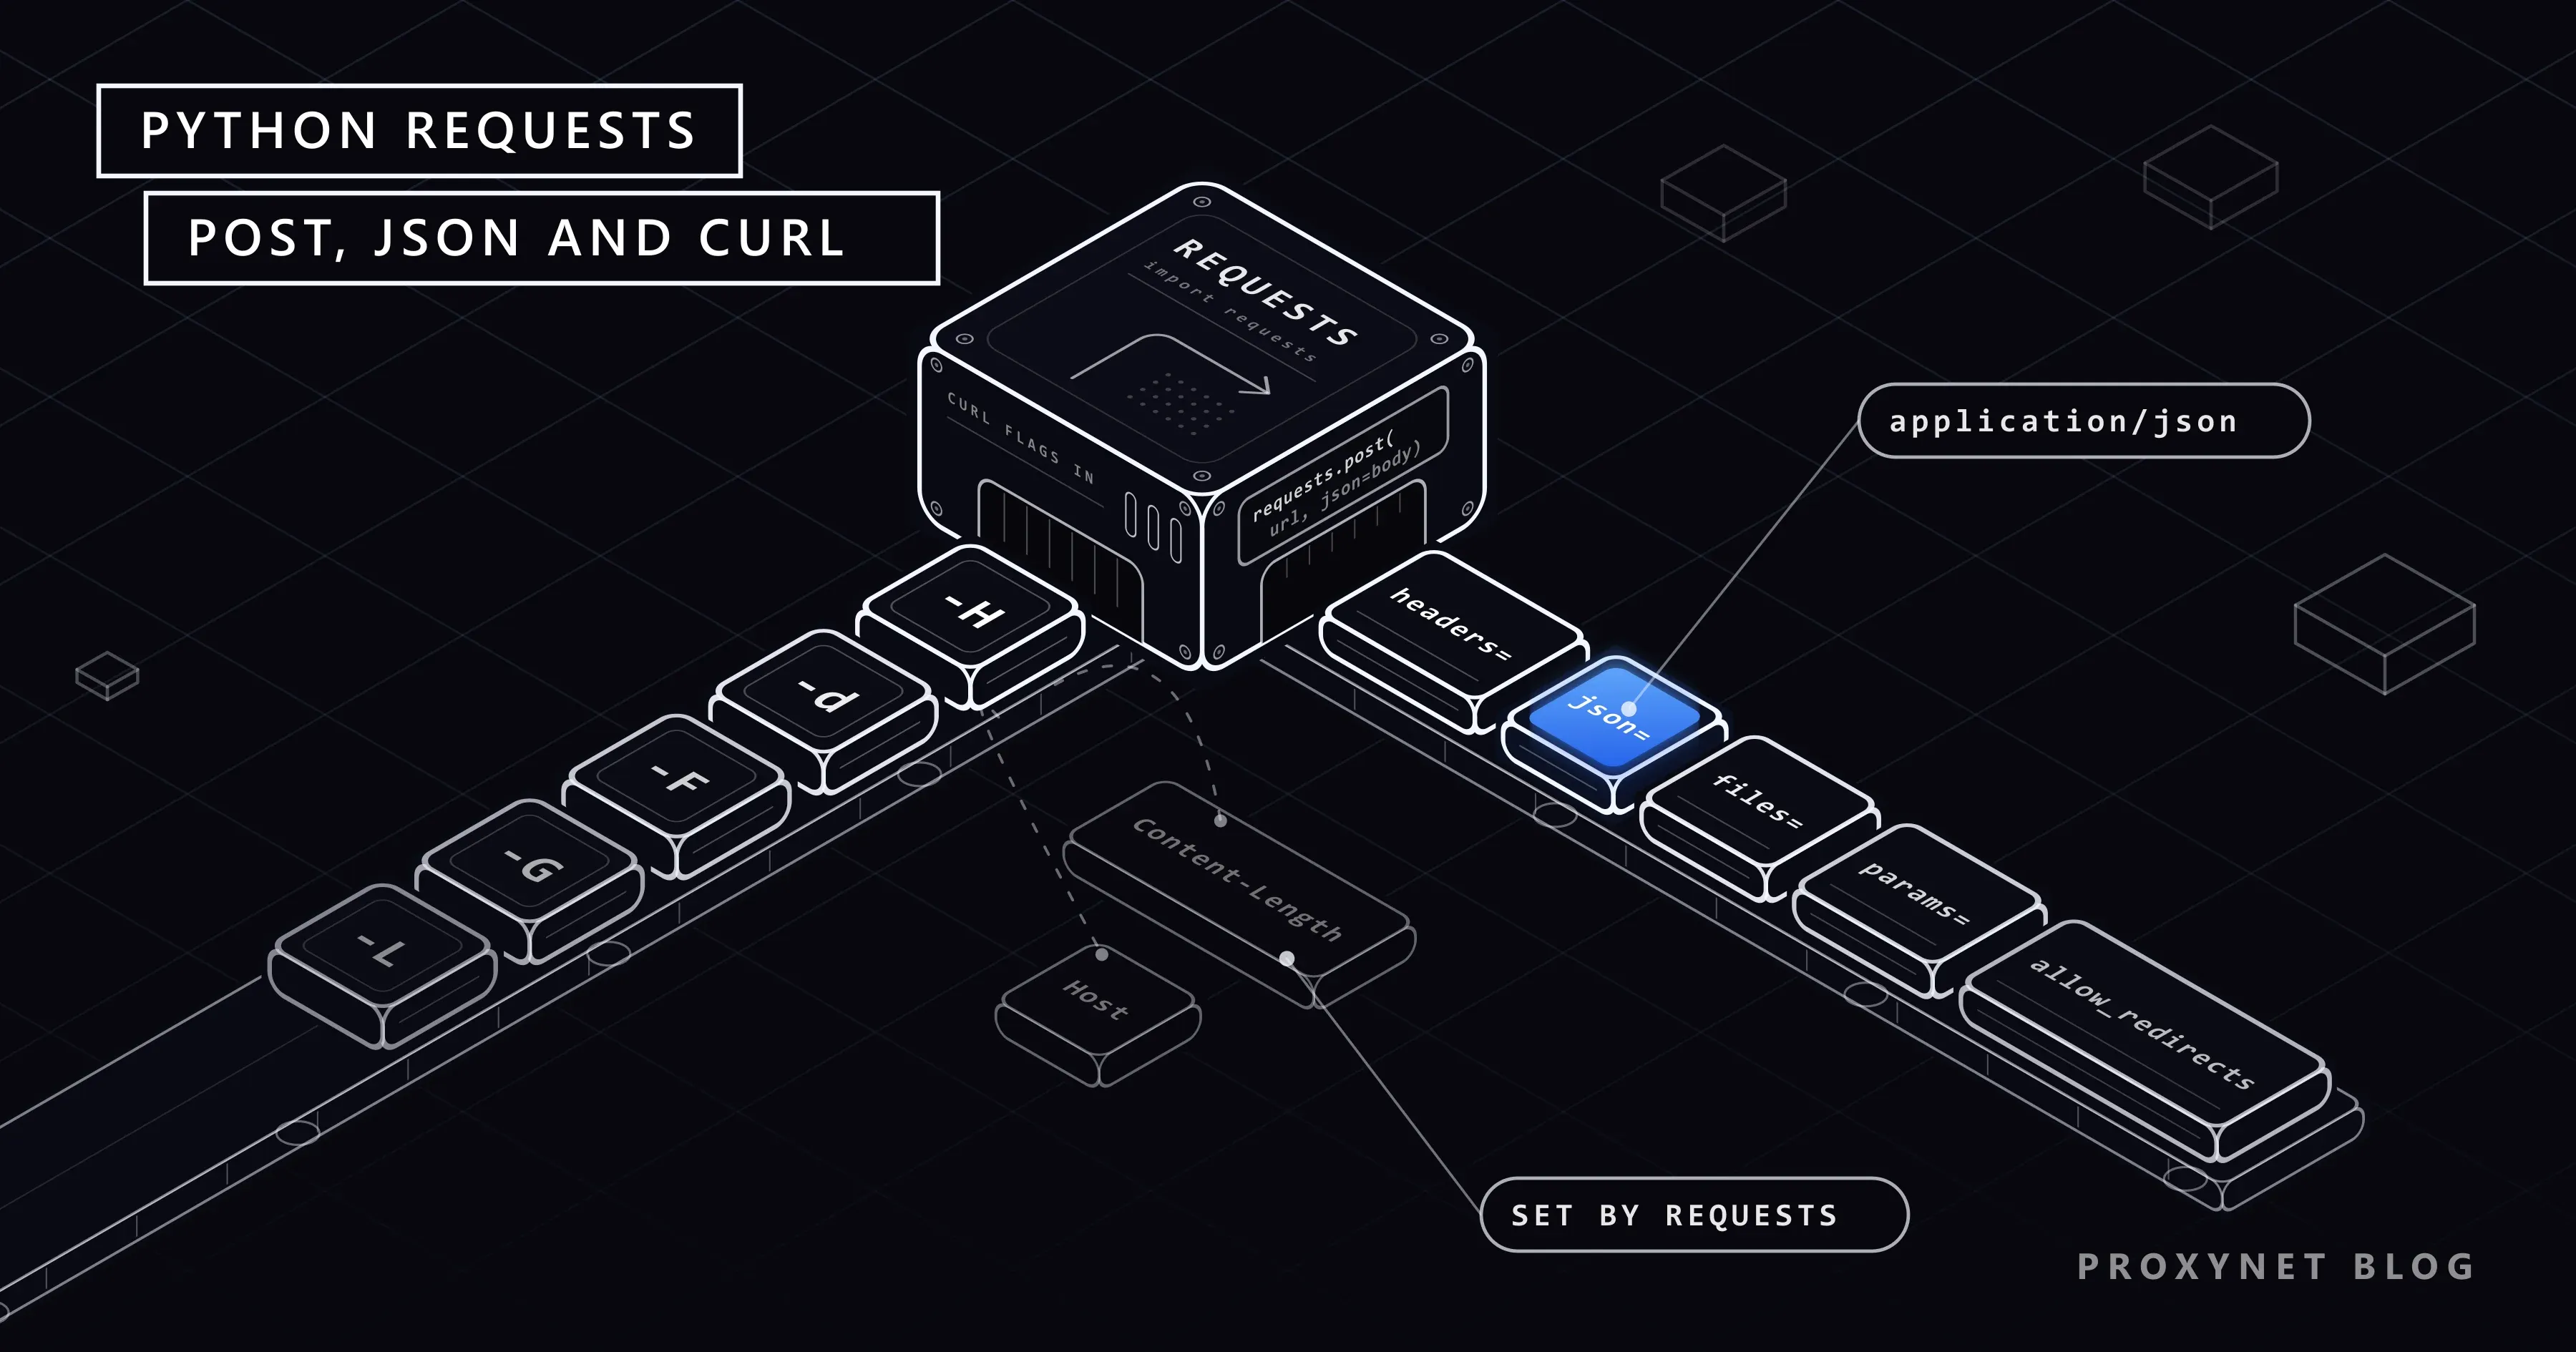
La documentación de la API de una empresa de mensajería muestra cómo crear un envío con un comando cURL: curl -X POST https://api.example.com/v1/shipments -H "Authorization: Bearer TOKEN" -H "Content-Type: application/json" -d '{"recipient": "Ayse Demir", "weight_kg": 3}'. En la terminal devuelve 201 Created. Lo pasas a Python como requests.post(url, data=json.dumps(body), headers={"Authorization": ...}) y el servidor responde 415 Unsupported Media Type: con una cadena en data=, Requests no envía Content-Type, y la línea que lo definía se quedó en el comando cURL.
Esta guía explica json=, data= y files=, los parámetros de consulta, las cabeceras y los tokens Bearer, cómo leer la respuesta y qué argumento de Requests corresponde a cada opción habitual de cURL. Termina con una lista de comprobación para las peticiones que funcionan en cURL pero no en Python y con un pequeño cliente de API que reintenta de forma segura. Todos los ejemplos se ejecutaron con Python 3.13.9, Requests 2.34.2 y curl 8.21.0 (Windows 11), contra httpbin.org y un servidor local que devuelve los bytes que recibe.
¿Cómo se envía una petición POST con Python Requests?
Instala el paquete con pip install requests. PyPI indica como versión actual la 2.34.2, publicada el 14 de mayo de 2026; requiere Python 3.10 o posterior. Cómo elegir entre librerías se explica en HTTPX, Requests y AIOHTTP: comparativa.
Un POST con cuerpo JSON es una sola llamada. httpbin.org/post devuelve lo que recibió:
import requests

payload = {"recipient": "Ayse Demir", "weight_kg": 3}
r = requests.post("https://httpbin.org/post", json=payload, timeout=20)

print(r.status_code)                         # 200
print(r.json()["headers"]["Content-Type"])   # application/json
print(r.json()["data"])                      # {"recipient": "Ayse Demir", "weight_kg": 3}
print(r.json()["json"])                      # el mismo cuerpo, convertido de nuevo en dict
El campo data es el cuerpo tal como se envió, con un espacio después de cada dos puntos y de cada coma. requests.put(), requests.patch() y requests.delete() aceptan los mismos argumentos. Pasa siempre timeout: Requests no tiene valor por defecto, así que un servidor que no responde deja tu script esperando (Max Retries Exceeded With URL trata los errores de tiempo de espera).
¿Qué diferencia hay entre json=, data= y files=?
Cada argumento construye el cuerpo de otra forma y pone un Content-Type distinto. Enviamos el mismo dict de cuatro maneras:
import json
import requests

url = "https://httpbin.org/post"
body = {"recipient": "Ayse Demir", "weight_kg": 3}

for label, kwargs in [
    ("json=body", {"json": body}),
    ("data=body", {"data": body}),
    ("data=json.dumps(body)", {"data": json.dumps(body)}),
    ("json= and data=", {"json": body, "data": {"note": "x"}}),
]:
    echo = requests.post(url, timeout=20, **kwargs).json()
print(f"{label:22} {echo['headers'].get('Content-Type')!s:34} form={echo['form']} json={echo['json']}")json=body application/json form={} json={'recipient': 'Ayse Demir', 'weight_kg': 3}
data=body application/x-www-form-urlencoded form={'recipient': 'Ayse Demir', 'weight_kg': '3'} json=None
data=json.dumps(body) None form={} json={'recipient': 'Ayse Demir', 'weight_kg': 3}
json= and data= application/x-www-form-urlencoded form={'note': 'x'} json=NoneLo que muestran las cuatro líneas:
json=serializa el dict y poneContent-Type: application/json. Úsalo con las API JSON.data=con un dict envía un formulario, y todos los valores se convierten en texto:weight_kgllegó como'3'.data=con una cadena no envíaContent-Type. httpbin lo interpretó igualmente; una API estricta responde415o400. Pon tú la cabecera.json=junto condata=ofiles=pierde el JSON sin dar ningún error. La guía rápida de Requests indica que el parámetrojsonse ignora si se pasadataofiles.
Envía texto JSON por data= solo cuando importan los bytes exactos. Una API que firma el cuerpo con un HMAC comprueba los bytes que recibe, y json= añade espacios y escapa los caracteres no ASCII ("İzmir" sale como "\u0130zmir"). Construye tú los bytes:
import json
import requests

body = {"recipient": "Ayse Demir", "city": "İzmir", "weight_kg": 3}
raw = json.dumps(body, separators=(",", ":"), ensure_ascii=False).encode("utf-8")

r = requests.post("https://httpbin.org/post", data=raw,
                  headers={"Content-Type": "application/json"}, timeout=20)
print(r.json()["data"])  # {"recipient":"Ayse Demir","city":"İzmir","weight_kg":3}
Estos bytes dieron el mismo hash SHA-256 que el cuerpo que envió curl --data-binary @body.json a partir del mismo archivo UTF-8. Los inicios de sesión con formulario y token CSRF se tratan en Sesiones y cookies en Python, y files=, más abajo.
¿Cómo se traduce un comando cURL a Requests, paso a paso?
La misma petición, copiada desde la pestaña Red del navegador en el panel web de la empresa de mensajería, trae algunas líneas más. Cómo encontrar una petición así se explica en Páginas estáticas y dinámicas en web scraping.
curl -X POST "https://api.example.com/v1/shipments?notify=false" \
  -H "Authorization: Bearer TOKEN" \
  -H "Content-Type: application/json" \
  -H "Accept-Encoding: gzip, deflate, br" \
  -H "Cookie: session=abc123" \
--data-raw '{"recipient": "Ayse Demir", "weight_kg": 3}'- Deshaz la sintaxis del shell. Quita los saltos de línea con
\(^en una copia hecha paracmdde Windows) y las comillas. - Pasa la cadena de consulta a
params=.?notify=falsese convierte enparams={"notify": "false"}. - Filtra las cabeceras. Conserva lo que necesita la API:
Authorization,Accept, claves de API. QuitaAccept-Encoding, que ya gestiona Requests, yContent-Typecuando usasjson=. No copies nuncaHostniContent-Length; Requests los calcula. Las líneas propias del navegador, comosec-fetch-*, rara vez hacen falta, y una líneaCookieva encookies=o en unaSession. - Elige el argumento del cuerpo. El JSON va a
json=(o adata=con bytes exactos si el cuerpo va firmado),-d "a=1&b=2"pasa adata={"a": "1", "b": "2"}y-Fpasa afiles=. - Elige el método.
-d,--data-raw,--jsony-Fsignifican POST salvo que-Xindique otra cosa;-Gconvierte los datos en una consulta GET. - Añade un
timeout=y llama ar.raise_for_status(). - Compara. Envía el comando cURL y tu llamada de Python a
https://httpbin.org/anythingy compara el método, la URL, las cabeceras y el cuerpo que te devuelve.
El resultado, con el token leído de una variable de entorno:
import os
import requests

r = requests.post(
    "https://api.example.com/v1/shipments",
    params={"notify": "false"},
    headers={"Authorization": f"Bearer {os.environ['API_TOKEN']}"},
    json={"recipient": "Ayse Demir", "weight_kg": 3},
    timeout=20,
)
r.raise_for_status()
print(r.status_code, r.headers.get("Location"))
curlconverter hace los pasos 1 a 5 y genera Python Requests como salida por defecto. Instálalo con npm y sustituye curl por curlconverter en el comando. Con el comando anterior, la versión 4.12.0 pasó notify a params, la cookie a cookies= y el cuerpo a json=, y dejó comentadas Content-Type y Accept-Encoding. No añadió ningún timeout, y su README advierte de que el código generado sigue las redirecciones salvo que el comando defina una política de redirección. Un comando copiado del navegador contiene tu cookie de sesión activa y tu token, así que conviértelo en tu propio equipo, no en un sitio web.
¿Qué argumento de Requests corresponde a cada opción de cURL?
| Opción de cURL | Requests | Qué cambia |
|---|---|---|
-d '{"a":1}' con Content-Type: application/json | json={"a": 1} | Requests añade espacios; usa data= para bytes exactos |
--json '{"a":1}' | json={"a": 1}, headers={"Accept": "application/json"} | --json (curl 7.82.0+) también pone Accept |
-d "a=1&b=2" | data={"a": "1", "b": "2"} | Mismos bytes |
--data-binary @body.json | data=open("body.json", "rb") | -d @file quitaría los saltos de línea; estas dos formas los conservan |
-F "file=@report.csv" | files={"file": open("report.csv", "rb")} | curl marca la parte como application/octet-stream; Requests solo añade un tipo si usas una tupla de 3 |
-G --data-urlencode "q=kargo takip" | params={"q": "kargo takip"} | Misma consulta: ?q=kargo+takip |
-X PUT | requests.put(url, ...) | Igual con PATCH y DELETE |
-H "Name: value" | headers={"Name": "value"} | Los valores deben ser cadenas; un int lanza InvalidHeader |
-A "ShipmentSync/1.0" | headers={"User-Agent": "ShipmentSync/1.0"} | Si no, cada herramienta envía su propio nombre |
-b "session=abc123" | cookies={"session": "abc123"} | Misma cabecera Cookie |
-u user:pass | auth=("user", "pass") | Misma cabecera Basic |
-L | Por defecto | cURL necesita -L; en Requests, allow_redirects=False lo desactiva |
--max-redirs 5 | session.max_redirects = 5 | Valor por defecto en Requests: 30 |
--connect-timeout 3 -m 20 | timeout=(3.05, 20) | -m limita toda la transferencia; el timeout de lectura es la pausa máxima entre bytes |
-k / --cacert ca.pem | verify=False / verify="ca.pem" | verify=False solo en pruebas locales |
-x http://user:pass@pr.proxynet.io:8000 | proxies={"http": url, "https": url} | Ver cURL con proxy |
--compressed | Nada | Requests gestiona la compresión por sí mismo |
-I | requests.head(url) | Con HEAD no se siguen redirecciones |
-i / -v | r.headers / r.request.headers | Lo que se recibió y lo que se envió |
Cada opción se describe en el manual de curl. Usar un proxy distinto en cada petición es otro trabajo (Cómo rotar proxies en Python).
¿Cómo se pasan los parámetros de consulta y las cabeceras?
Pasa los valores de consulta a params= como dict:
import requests

params = {"q": "kargo takip", "status": ["pending", "shipped"], "sort": None}
r = requests.get("https://httpbin.org/get", params=params, timeout=20)
print(r.url)  # https://httpbin.org/get?q=kargo+takip&status=pending&status=shipped
Una lista repite la clave, None se omite, y los espacios y los caracteres no ASCII se codifican solos. Si la URL ya trae una cadena de consulta, se conserva y params= se añade detrás. Cómo recorrer páginas de resultados se explica en la guía de paginación en web scraping.
Las cabeceras van en un dict de cadenas, con el token leído del entorno:
import os
import requests

headers = {
    "Authorization": f"Bearer {os.environ['API_TOKEN']}",
    "Accept": "application/json",
}
r = requests.get("https://httpbin.org/headers", headers=headers, timeout=20)
print(r.json()["headers"]["Authorization"])  # Bearer <tu token>

r = requests.get("https://httpbin.org/basic-auth/user/pass", auth=("user", "pass"), timeout=20)
print(r.status_code)  # 200
Las cabeceras que necesita cada llamada se ponen una sola vez en una requests.Session, mediante session.headers. Tres reglas de la documentación de Requests, todas confirmadas en nuestras pruebas:
.netrcgana aheaders=. Una entrada de.netrcpara el host sustituyó nuestra cabeceraBearerpor unaBasic;auth=gana a las dos.- Authorization se queda en el host original. Tras una redirección de
127.0.0.1alocalhost, la cabecera había desaparecido. - Los valores son cadenas.
headers={"X-Page": 2}lanzóInvalidHeader.
Si no defines tu propio User-Agent, Requests envía python-requests/2.34.2. Qué poner ahí se explica en ¿Qué es el User-Agent?, y por qué las cabeceras de un mismo cliente deben ser coherentes, en Cómo hacer web scraping sin que te bloqueen.
¿Cómo se lee la respuesta y se capturan los errores HTTP?
Un Response te da r.status_code, r.headers (un dict que no distingue entre mayúsculas y minúsculas), r.content (los bytes en bruto), r.text (los bytes decodificados con r.encoding) y r.json(). Si ves caracteres rotos en r.text, la codificación se adivinó mal (Codificación en Python).
La documentación de Requests advierte de que un r.json() que funciona no significa que la petición haya ido bien: un servidor puede enviar un cuerpo de error en JSON junto con un 500. Comprueba primero el estado:
import requests

r = requests.get("https://httpbin.org/status/404", timeout=20)
try:
    r.raise_for_status()
except requests.HTTPError as exc:
    print(exc)  # 404 Client Error: NOT FOUND for url: https://httpbin.org/status/404
raise_for_status() lanza HTTPError con cualquier 4xx o 5xx. Cuando el cuerpo está vacío o es HTML, r.json() falla con JSONDecodeError (Cómo solucionar JSONDecodeError: Expecting Value reúne las causas). Qué códigos conviene reintentar se explica en Códigos de estado HTTP en web scraping.
¿Cómo se suben y descargan archivos con Requests?
files= construye un cuerpo multipart/form-data. Una tupla de 3 fija el nombre del archivo y el tipo de la parte, y los campos de data= viajan como partes adicionales. Como json= se ignora junto a files=, envía el JSON como una parte propia:
import json
import requests

with open("report.csv", "rb") as f:
    files = {
        "file": ("report.csv", f, "text/csv"),
        "meta": (None, json.dumps({"source": "warehouse"}), "application/json"),
    }
    r = requests.post("https://httpbin.org/post", files=files, data={"note": "daily"}, timeout=20)

print(r.json()["files"])  # {'file': 'sku,price\n1001,19.90\n'}
print(r.json()["form"])   # {'meta': '{"source": "warehouse"}', 'note': 'daily'}
Abre el archivo en modo binario ("rb"): la documentación explica que Requests puede poner en Content-Length el número de bytes del archivo, y el modo texto puede hacer que ese valor sea incorrecto. Para subidas muy grandes, la misma página remite al paquete requests-toolbelt, que envía el cuerpo en streaming.
Para las descargas, stream=True evita cargar en memoria un cuerpo grande:
import requests

url = "https://example.com/export.csv"  # sustitúyela por la URL de tu archivo
with requests.get(url, stream=True, timeout=(3.05, 60)) as r:
    r.raise_for_status()
    with open("export.csv", "wb") as f:
        for chunk in r.iter_content(chunk_size=64 * 1024):
            f.write(chunk)
Descargar muchos archivos de una misma página se explica en Cómo descargar todas las imágenes de una web.
¿Por qué una petición que funciona en cURL recibe otra respuesta en Requests?
Normalmente, porque las dos peticiones no son iguales. Revisa en este orden:
- Redirecciones. Sin
-L, cURL se detiene en un3xx; Requests lo sigue con todos los métodos salvoHEAD. Cuando cualquiera de las dos herramientas sigue la redirección, un POST que recibe301,302o303se convierte en un GET sin cuerpo, y con307o308sigue siendo POST, de acuerdo con RFC 9110. Hay una excepción: con-X POSTy-L, cURL envió un POST sin el cuerpo tras un302;--follow(curl 8.16.0+) cambia a GET. Mirar.history, o pasaallow_redirects=Falsey leeLocation. - Cabeceras por defecto. curl 8.21.0 envió
User-Agent: curl/8.21.0,Accept: */*y ningúnAccept-Encoding. Requests enviópython-requests/2.34.2,Accept: */*,Connection: keep-aliveyAccept-Encoding: gzip, deflate(másbrcon brotli instalado yzstden Python 3.14). Compara conr.request.headers. - Versión de HTTP. Requests solo habla HTTP/1.1:
r.raw.versiondevolvió11en un sitio HTTPS. curl negocia HTTP/2 por defecto con HTTPS cuando su compilación lo admite (curl -VmuestraHTTP2), y-w "%{http_version}"imprime la versión usada. Nuestra compilación de Windows no lo incluye y usó1.1. - Entorno. Con
Session.trust_enven su valor por defecto,True, Requests leeHTTP_PROXY,HTTPS_PROXYyNO_PROXY, la configuración de proxy del sistema en Windows y macOS cuando no hay ninguna variable, y.netrc. cURL lee las variables (http_proxysolo en minúsculas), pero no la configuración del sistema, y.netrcsolo con--netrc.requests.utils.get_environ_proxies(url)muestra qué eligió Requests; las variables se explican en Proxy con wget. - Certificados. Requests usa el paquete
certifi; curl en Windows con Schannel usa el almacén de Windows. Detrás de un proxy corporativo que inspecciona TLS, cURL puede pasar mientras Requests lanzaSSLError(la solución está en Max Retries Exceeded With URL). - Bytes del cuerpo.
json=vuelve a serializar el cuerpo, y-d @filequita los saltos de línea. Calcula el hash de los dos cuerpos si la API los firma. - Lo que pasa por la red. Un proxy MITM local muestra las dos peticiones una al lado de la otra.
Si todo coincide y la respuesta sigue siendo distinta, el sitio está juzgando al propio cliente, por ejemplo su handshake TLS, que las cabeceras no cambian. Cloudflare y scraping explica cómo leer una respuesta así, y Huella TLS y JA3, qué revela el handshake. El camino es la API oficial del sitio o el permiso de su propietario; no tratamos herramientas que hacen pasar un script por un navegador.
Ejemplo completo: un pequeño cliente de API con reintentos seguros
El script guarda el token Bearer y las cabeceras comunes en una sola Session, envía params= con un GET y json= con un POST, y comprueba cada estado. Solo reintenta el GET: MDN describe POST como no idempotente, así que repetirlo puede crear un segundo envío. La clase Retry de urllib3 ya deja fuera POST por defecto; el script lo indica de forma explícita.
"""Un pequeño cliente de API: GET con params, POST con json=, reintentos solo para GET."""
import os

import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

API = os.environ.get("API_BASE", "https://api.example.com/v1")
TIMEOUT = (3.05, 20)  # timeout de conexión, timeout de lectura (segundos)


def make_session():
    session = requests.Session()
    session.headers.update({
        "Authorization": f"Bearer {os.environ['API_TOKEN']}",  # nunca escribas el token en el código
        "Accept": "application/json",
        "User-Agent": "ShipmentSync/1.0 (+https://example.com/contact)",
    })
    retry = Retry(
        total=3,
        backoff_factor=0.5,
        status_forcelist=[502, 503, 504],
        allowed_methods=["GET"],  # un POST repetido podría crear el mismo envío dos veces
        raise_on_status=False,    # devuelve la última respuesta; raise_for_status() la notifica
    )
    adapter = HTTPAdapter(max_retries=retry)
    session.mount("https://", adapter)
    session.mount("http://", adapter)
    proxy = os.environ.get("PROXY_URL")  # opcional, p. ej. http://user:pass@pr.proxynet.io:8000
    if proxy:
        session.proxies = {"http": proxy, "https": proxy}
        session.trust_env = False  # si no, HTTPS_PROXY o el proxy del sistema ganan a session.proxies
    return session


def list_shipments(session, status="pending", page=1):
    r = session.get(f"{API}/shipments", params={"status": status, "page": page}, timeout=TIMEOUT)
    r.raise_for_status()
    return r.json()


def create_shipment(session, recipient, weight_kg):
    body = {"recipient": recipient, "weight_kg": weight_kg}
    r = session.post(f"{API}/shipments", json=body, timeout=TIMEOUT)
    r.raise_for_status()
    return r.status_code, r.headers.get("Location"), r.json()


if __name__ == "__main__":
    with make_session() as s:
        try:
            print(list_shipments(s))
            print(create_shipment(s, "Ayse Demir", 3))
        except requests.HTTPError as exc:
            print("API error:", exc)
Contra un servidor local que imita la API, el GET devolvió la lista y el POST devolvió 201 con una cabecera Location. Cuando el servidor respondió 503, el GET salió cuatro veces (con esperas de 0, 1 y 2 segundos entre intentos) antes de que raise_for_status() lo notificara; un POST a la misma dirección salió una sola vez. A través de un proxy de prueba local definido en PROXY_URL, las dos llamadas funcionaron, y una contraseña incorrecta dio 407 Proxy Authentication Required.
urllib3 también respeta Retry-After en un 503 por defecto; cómo tratar un 429 se explica en Códigos de estado HTTP en web scraping, y cómo lanzar muchas llamadas en paralelo, en Concurrencia y paralelismo en web scraping.
Casos de uso
- Datos de productos o precios desde una API que ofrece el propio sitio (extracción de datos).
- Un endpoint JSON encontrado en la pestaña Red, llamado en lugar de renderizar la página (Páginas estáticas y dinámicas).
- Rastrear las páginas que hay detrás de los resultados de una API a un ritmo moderado (rastreador web en Python).
- Probar tu propio webhook o servicio interno desde un script en lugar de una herramienta gráfica (Postman con proxy).
- Comprobar la respuesta de una API para otro país con los Proxies residenciales de ese país.
- Una API que solo acepta direcciones IP registradas, llamada desde una salida fija (IP estática para API).
- La misma petición en Node.js con fetch o Axios (cURL en JavaScript).
Errores comunes
data=json.dumps(body)sinContent-Type. El servidor no sabe que es JSON; usajson=body.json=ydata=en la misma llamada. El JSON se descarta sin avisar.- Sin
timeout. Un solo servidor que no responde detiene el script. - Montar la cadena de consulta a mano. Los espacios y los caracteres no ASCII rompen la URL.
r.json()antes de comprobar el estado. Un500con un cuerpo de error en JSON se interpreta sin problema.- Subidas abiertas en modo texto. Usa
"rb". - Copiar
HostyContent-Length. Requests envió sin cambios unHostcopiado, así que una prueba contra otro servidor seguía nombrando el anterior. UnContent-Lengthcopiado en un GET sin cuerpo hizo que nuestro servidor esperara hasta el timeout de lectura. - Comandos del navegador pegados en conversores en línea. Contienen tu cookie de sesión y tu token.
verify=Falseen producción. Desactiva la comprobación de certificados.- Reintentar POST a ciegas. Un reintento tras un timeout puede crear un segundo registro.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Cuerpo JSON para una API | requests.post(url, json=data, timeout=20), sin Content-Type manual |
| Cuerpo firmado, byte a byte | data= con bytes que serializaste tú, más Content-Type |
| Formulario simple (no un inicio de sesión) | data= con un dict; inicios de sesión y CSRF en la guía de sesiones |
| Archivo con campos adicionales | files= más data=; el JSON como parte propia application/json |
| Traducción rápida de cURL | La tabla anterior, o curlconverter en tu equipo |
| Funciona en cURL, no en Python | Revisa r.history, r.request.headers, trust_env y la versión de HTTP |
| HTTP/2 o llamadas asíncronas | HTTPX; AIOHTTP solo para código asíncrono |
Preguntas frecuentes
¿Hay que definir la cabecera Content-Type al enviar JSON por POST con Requests?
Con json=, no: Requests pone él mismo Content-Type: application/json. La necesitas cuando pasas texto JSON por data=, porque una cadena en data= sale sin ella, y entonces una API estricta responde 415 Unsupported Media Type o 400.
¿Qué diferencia hay entre json= y data=json.dumps() en Requests?
Los dos envían texto JSON, pero solo json= añade la cabecera Content-Type. Los bytes también pueden ser distintos: json= escribe espacios después de los dos puntos y las comas y escapa los caracteres no ASCII. Usa json= por defecto, y data= con tus propios bytes cuando una API firma el cuerpo.
¿Cómo se envía un token Bearer con Python Requests?
Usa headers={"Authorization": f"Bearer {token}"}, o defínelo una sola vez en session.headers. Lee el token de una variable de entorno. Si un archivo .netrc tiene credenciales para el mismo host, Requests usa esas en su lugar; Session.trust_env = False lo desactiva.
¿Se puede convertir un comando cURL a Python automáticamente?
Sí. curlconverter convierte un comando cURL en código de Requests y se ejecuta en tu propio equipo. Revisa lo que genera: no añade timeout, y Requests sigue redirecciones que el comando cURL no seguía. No pegues comandos con cookies o tokens en conversores en línea.
¿Requests sigue las redirecciones? ¿Por qué mi POST se convierte en GET?
Requests sigue las redirecciones con todos los métodos salvo HEAD. Tras un 301, 302 o 303, un POST pasa a ser un GET y pierde su cuerpo, igual que en los navegadores; tras un 307 o 308, sigue siendo POST. allow_redirects=False se detiene en la primera respuesta.
¿Python Requests admite HTTP/2?
No. Requests solo habla HTTP/1.1; en nuestra prueba, r.raw.version devolvió 11 en un sitio HTTPS. HTTPX admite HTTP/2 si instalas httpx[http2] y creas el cliente con http2=True; viene desactivado por defecto.
En resumen
Para una API JSON, requests.post(url, json=data, timeout=20) es todo el trabajo: Requests serializa el cuerpo y pone la cabecera. data= envía formularios o bytes exactos, files= cuerpos multipart y params= la cadena de consulta. Un comando cURL se traduce a estos argumentos opción por opción; si las respuestas siguen siendo distintas, revisa las redirecciones, las cabeceras por defecto, la versión de HTTP y el entorno, en ese orden. Si tienes que llamar a una API desde un país concreto o desde una dirección fija, compara las opciones en nuestra página de servicios de proxy.