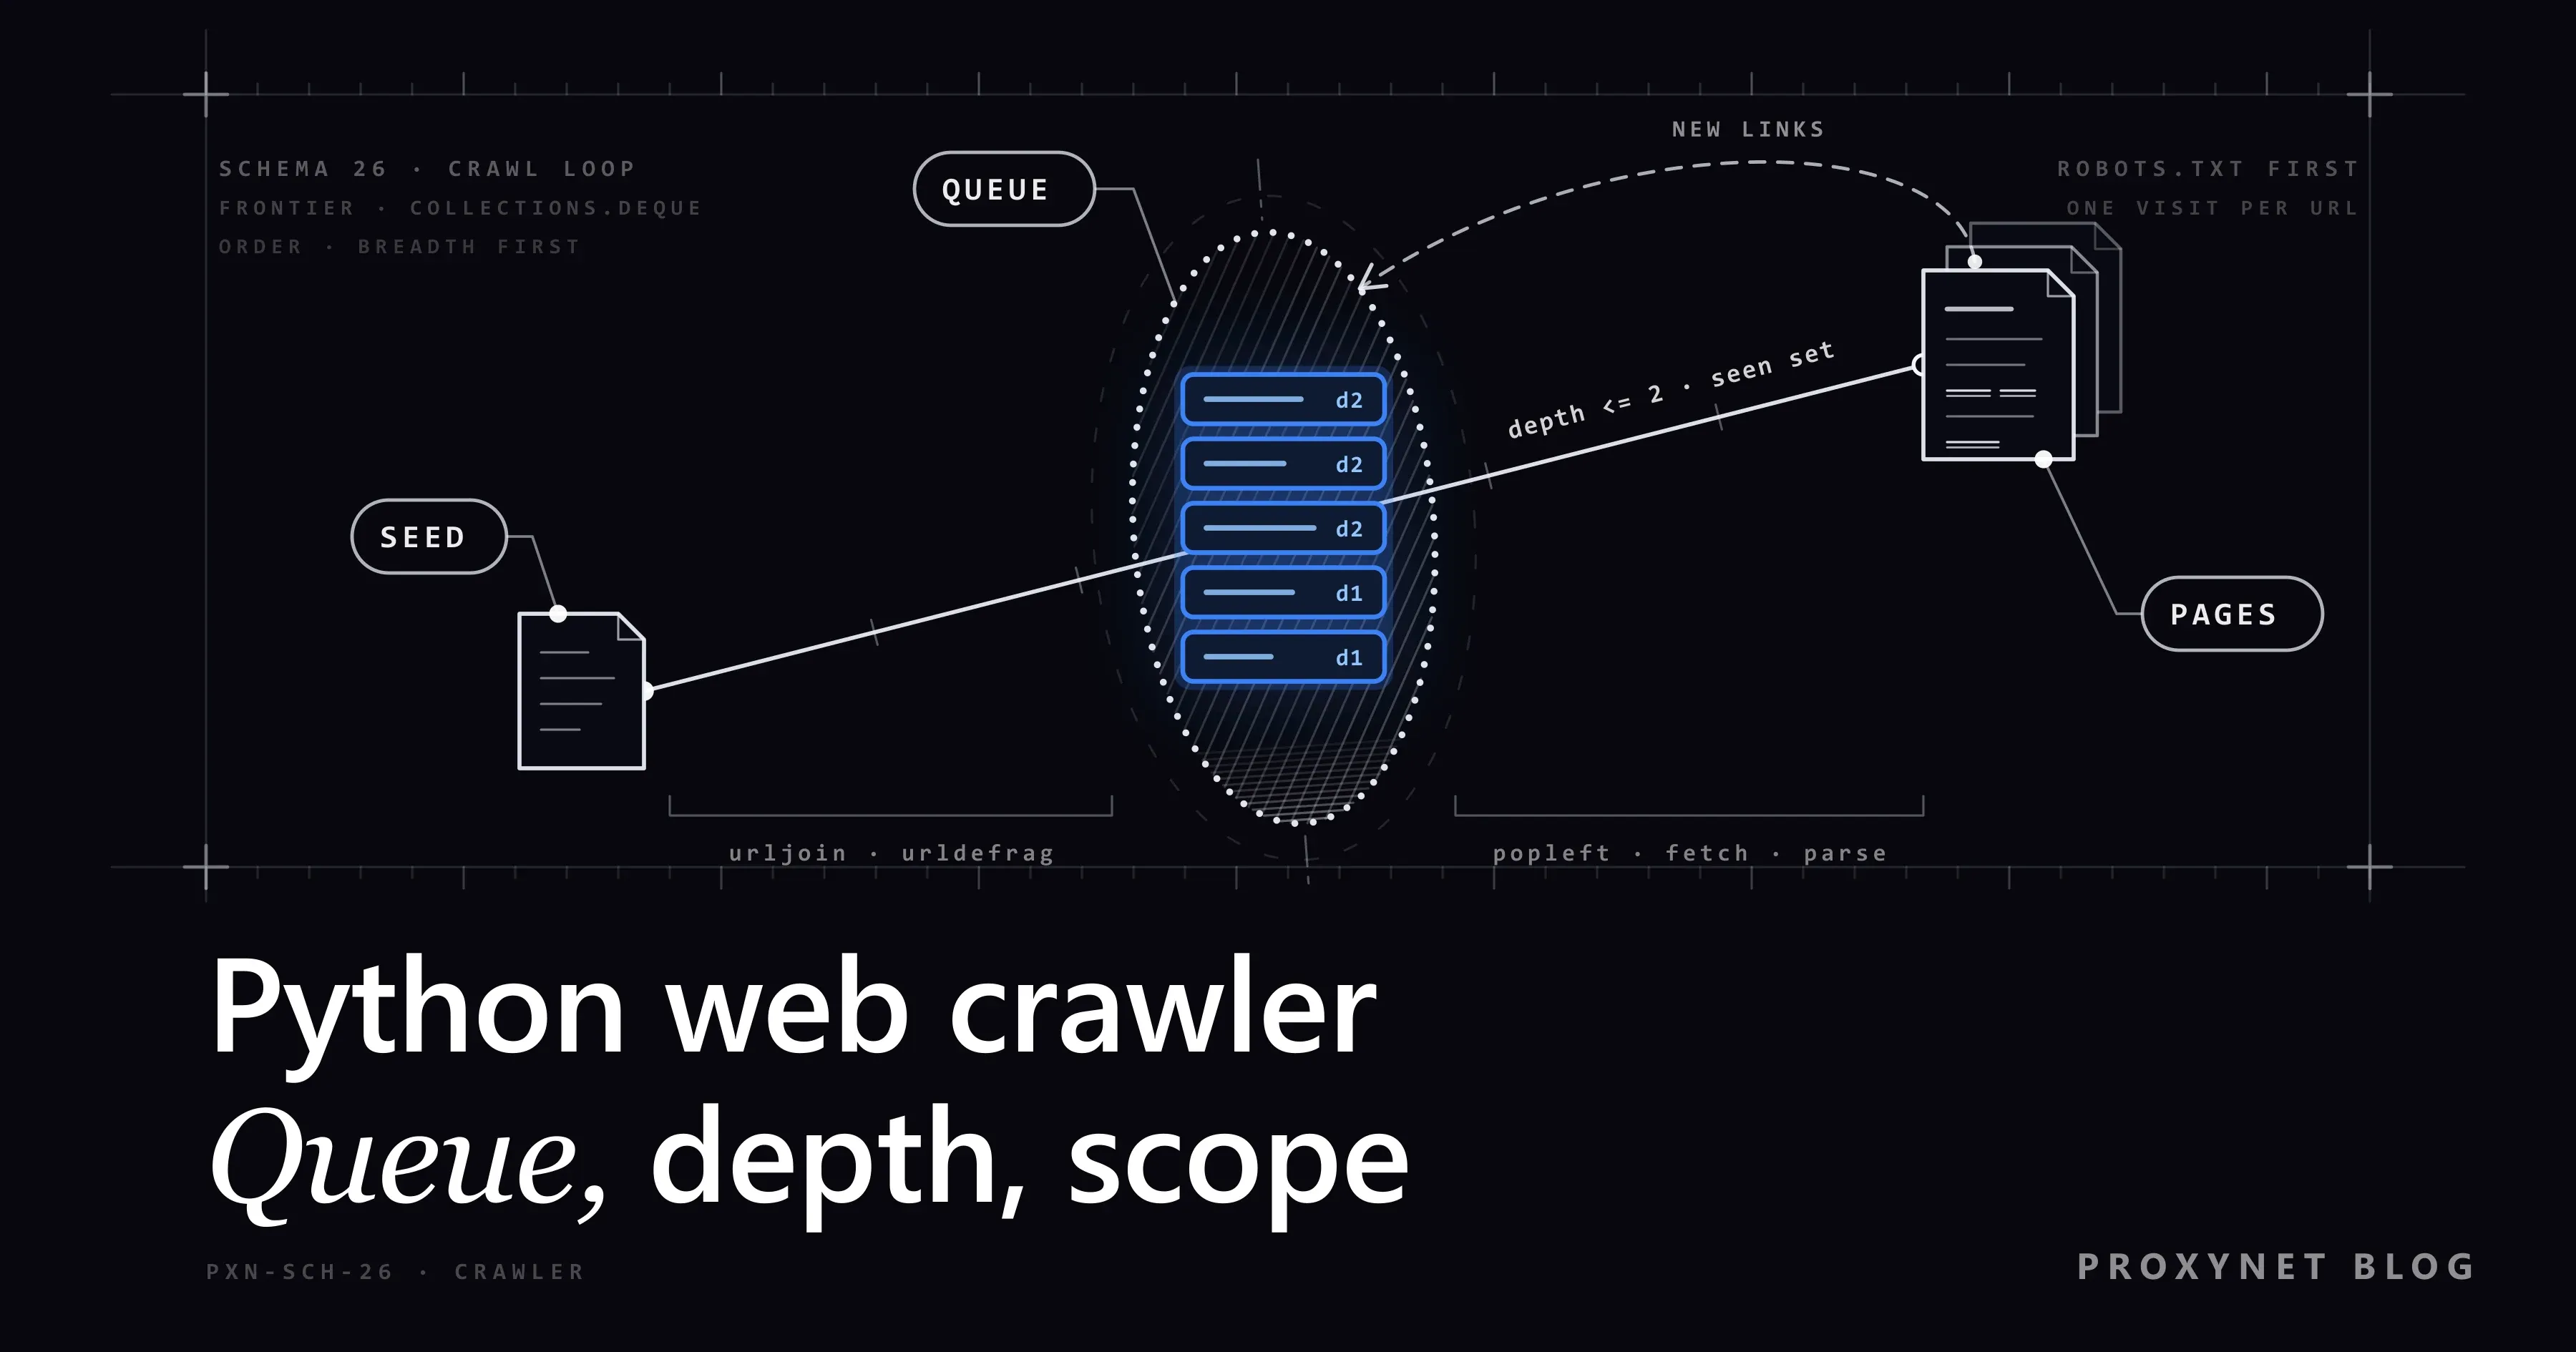
Sie brauchen eine Liste aller Kategorie- und Produktseiten einer Buchhandlungs-Website, die keine Sitemap hat. Unser Testziel ist books.toscrape.com, eine Sandbox, die zum Üben von Scraping gebaut wurde. Ein Crawler, der jedem Link folgt, ohne sich zu merken, wo er schon war, wird hier nie fertig: Die meisten Links führen zu Seiten zurück, die er bereits kennt. In unserer Messung zeigten 3.515 der 4.098 Links auf den ersten 60 Seiten auf Adressen, die der Crawler schon kannte, und 524 neue Adressen warteten noch in der Warteschlange.
Im Folgenden bauen wir einen Crawler mit Requests und BeautifulSoup, ohne Framework: Warteschlange, Seen-Set, URL-Normalisierung, Scope, Tiefenlimit, robots.txt, Pausen und Ausgabe als JSON Lines. Was ein Crawler ist und wie er sich von einem Scraper unterscheidet, erklären unsere Seite zum Web-Crawler und der Beitrag Web Scraping vs. Web Crawling. Alle Zahlen stammen aus Läufen des fertigen Skripts am 25. September 2026.
Welche Bausteine braucht ein Web-Crawler in Python?
Sechs Bausteine, jeder davon ein paar Zeilen Python:
- Frontier: die Warteschlange der Adressen, die noch besucht werden müssen, eine
collections.deque. - Seen-Set: jede Adresse, auf die der Crawler bisher gestoßen ist.
- Fetcher: eine
requests.Sessionmit Timeout und einem ehrlichenUser-Agent, der den Bot und einen Kontakt nennt (Was ist ein User-Agent?). - Link-Extraktor:
select("a[href]"). Den Rest der Seite zu lesen ist die Aufgabe eines Scrapers (Was ist BeautifulSoup). - Scope-Filter: Host, Schema und Content-Type entscheiden, was dazugehört.
- Ausgabe: ein JSON-Objekt pro Seite in einer
.jsonl-Datei.
Wir verwenden Requests 2.34.2 und Beautiful Soup 4.15.0, die am 25. September 2026 aktuellen Versionen auf PyPI; Requests braucht Python 3.10 oder neuer. Scrapy bringt alle sechs Bausteine fertig mit.
Wie läuft die Crawl-Schleife Schritt für Schritt ab?
- Seed. Normalisieren Sie die Startadresse, legen Sie
(url, 0)in die Warteschlange und die Adresse ins Seen-Set. - Entnehmen.
popleft()holt den ältesten Eintrag. - robots.txt fragen. Die Regeln des Hosts kommen aus einem Cache und werden nur einmal abgerufen.
- Warten, dann abrufen. Halten Sie die Pause pro Host ein und senden Sie dann eine GET-Anfrage.
- Antwort prüfen. Lesen Sie die endgültige Adresse nach Weiterleitungen und den Header
Content-Type. - Extrahieren und filtern. Lösen Sie jedes
hrefmiturljoinauf, normalisieren Sie es und verwerfen Sie, was schon gesehen wurde, außerhalb der Website liegt oder zu tief ist. - Speichern und einreihen. Schreiben Sie eine JSON-Zeile und hängen Sie die neuen Adressen mit
depth + 1an.
Die Schleife endet, wenn die Warteschlange leer ist oder die Seitenobergrenze erreicht ist.
Welcher Baustein verhindert welches Problem?
| Baustein | Was er verhindert | In Python | Ohne ihn |
|---|---|---|---|
| Seen-Set, beim Einreihen gefüllt | Dieselbe Seite zweimal abrufen | set, beim Einreihen ergänzt | 3.515 bekannte Links in unserem books-Lauf erneut abgerufen |
| Tiefenlimit und Seitenobergrenze | Endlose Ketten wie Kalender und Filter | (url, depth), --depth, --max-pages | Eine Warteschlange, die immer weiter wächst (524 wartend nach 60 Seiten) |
| URL-Normalisierung | Eine Seite unter mehreren Schreibweisen | urldefrag, urlsplit, parse_qsl | Dieselbe Seite wird mehr als einmal abgerufen und gespeichert |
| Prüfung von Weiterleitung und Content-Type | Abdriften auf eine andere Website, PDF als HTML parsen | r.url, Content-Type, stream=True | Links von fremden Seiten gelangen in die Warteschlange |
| robots.txt-Cache und Pause pro Host | Verbotene Pfade, Anfragespitzen | RobotFileParser.parse(), time.monotonic() | Die Website antwortet mit 429 |
Warum sollte die Warteschlange eine deque sein und keine Liste?
deque.popleft() nimmt die älteste Adresse, der Crawl läuft also in die Breite (Breitensuche, BFS): erst die Startseite, dann die Seiten einen Klick entfernt, dann die zwei Klicks entfernten. Seiten nahe der Startseite kommen zuerst, und ein Tiefenlimit ergibt Sinn, weil die Tiefe der Reihe nach wächst. pop() an dem Ende, an das Sie anhängen, ergibt eine Tiefensuche (DFS): ein Zweig bis ganz nach unten, bevor der nächste drankommt.
Eine Liste kann als Warteschlange dienen, aber pop(0) verschiebt alle übrigen Elemente (O(n)), während eine deque an beiden Enden in annähernd konstanter Zeit entnimmt (Dokumentation zu collections). Rekursive Crawler sind verkappte Tiefensuchen, und sie können an Pythons Standardgrenze von 1.000 verschachtelten Aufrufen mit einem RecursionError abbrechen.
Bei der Breitensuche trifft der Crawler außerdem jede Adresse zuerst auf ihrer geringsten Tiefe. Ein Link, der schon beim ersten Auftauchen zu tief liegt, kann daher als gesehen markiert und vergessen werden.
Wie schreiben Sie die URL-Normalisierung im Code?
Das Seen-Set vergleicht Zeichenketten, deshalb gibt normalize() jeder Seite genau eine Schreibweise:
urldefrag()entfernt#reviews. Nach RFC 3986, Abschnitt 3.5, erreicht das Fragment den Server nie.- Schema und Host werden kleingeschrieben;
urlsplit().hostnameliefert den Host bereits in Kleinbuchstaben. - Standardports (
:80für http,:443für https) fallen weg, und ein leerer Pfad wird zu/, was Abschnitt 6.2.3 desselben RFC als gleichwertig behandelt. - Tracking-Parameter (
utm_*,gclid,fbclid) werden entfernt und die übrigen sortiert, sodass?b=2&a=1und?a=1&b=2übereinstimmen. - Links mit
mailto:,tel:undjavascript:sowie kaputte Ports ergebenNone.
Löschen Sie nie den ganzen Query-String: ?page=2 ist eine andere Seite. Auch der Schrägstrich am Ende bleibt stehen, denn /a und /a/ können sich unterscheiden; ob sie es tun, verrät Ihnen eine Weiterleitung. Auf books.toscrape.com lieferten / und /index.html dieselbe Seite, was nur eine websitespezifische Regel zusammenführen könnte.
Das Seen-Set ignoriert außerdem das Schema. Auf quotes.toscrape.com leiten Autorenseiten von https auf http um, und ihre relativen Links zeigen danach auf http://quotes.toscrape.com/; unser erster Testlauf hat deshalb Startseite und Login-Seite zweimal abgerufen. page_key() lässt das Schema weg, sodass beide Schreibweisen als eine Seite zählen.
Die Sandboxes haben weder Fragmente noch Tracking-Parameter, daher arbeiten diese Prüfungen mit erfundenen Eingaben:
from crawler import normalize

assert normalize("https://Example.COM:443/a#reviews") == "https://example.com/a"
assert normalize("http://example.com") == "http://example.com/"
assert normalize("https://example.com:8443/a") == "https://example.com:8443/a"
assert normalize("https://example.com/list?b=2&a=1") == "https://example.com/list?a=1&b=2"
assert normalize("https://example.com/list?utm_source=mail&page=2") == "https://example.com/list?page=2"
assert normalize("mailto:shop@example.com") is None
assert normalize("javascript:void(0)") is None
assert normalize("https://example.com:abc/") is None
assert normalize("https://example.com/a/") != normalize("https://example.com/a")
print("all normalize checks passed")
Scope: derselbe Host, Weiterleitungen und Content-Type
Der Scope ist der Bereich, den der Crawler besuchen darf. self.hosts enthält nur den Start-Host. Nutzt eine Website sowohl www.example.com als auch example.com, tragen Sie beide von Hand ein; eine Prüfung wie endswith("example.com") würde auch notexample.com durchlassen.
Requests folgt Weiterleitungen bei jeder Methode außer HEAD und hält die endgültige Adresse in r.url fest (Requests-Quickstart). Prüfen Sie den Scope daher an r.url und lösen Sie relative Links gegen diese Adresse auf. Auf quotes.toscrape.com leitet /author/Jane-Austen auf http://quotes.toscrape.com/author/Jane-Austen/ um; in unserem Lauf mit Tiefe 2 kamen 40 von 149 Seiten auf diesem Weg an. Eine Weiterleitung, die die Website verlässt, wird verworfen, doch Requests hat das Ziel da schon abgerufen. Wollen Sie auch diese Anfrage vermeiden, übergeben Sie allow_redirects=False und reihen den Header Location selbst ein.
Mit stream=True kehrt Requests zurück, sobald die Header angekommen sind. Ist der Content-Type nicht text/html, wird die Verbindung geschlossen, ohne den Body zu lesen.
Wie legen Sie Tiefenlimit und Seitenobergrenze fest?
Die Einträge der Warteschlange sind (url, depth, attempts). Ein Link, bei dem depth + 1 über --depth hinausginge, zählt als too_deep und bleibt draußen; --max-pages beendet den Lauf, egal was noch in der Warteschlange steht. Auf den Sandboxes:
- quotes.toscrape.com, Tiefe 2, Obergrenze 500: Die Warteschlange leerte sich nach 149 Seiten von selbst (1, 46 und 102 nach Tiefe); 30 Adressen lagen zu tief.
- Dieselbe Website, Obergrenze 60: Der Lauf stoppte bei 60 Seiten, 89 Adressen standen noch in der Warteschlange.
- books.toscrape.com, Tiefe 2, Obergrenze 60: Alle 60 Seiten kamen aus den Tiefen 0 und 1, 524 warteten noch. Diesen Lauf hat die Obergrenze beendet, nicht die Tiefe.
Wählen Sie die Tiefe nach dem Aufbau der Website (Startseite, Kategorie, Artikel ergibt Tiefe 2; jede weitere Listenseite fügt eine Stufe hinzu) und die Obergrenze nach Ihrem Budget. Links, die gezielt als Falle für Bots ausgelegt werden, behandelt Honeypot-Fallen beim Scraping.
robots.txt und Pausen: die Kurzfassung
Der Crawler hält einen RobotFileParser pro Schema und Host, lädt robots.txt mit seiner eigenen Session herunter (Timeout, Bot-User-Agent, Proxy) und übergibt die Zeilen an parse(). read() vermeiden wir: In Python 3.13.9 nutzt es urllib ohne Timeout und mit dem eigenen User-Agent von urllib, und bei Netzwerkfehlern wirft es eine Ausnahme. Ein 5xx oder eine nicht erreichbare Datei bedeutet, dass nichts gecrawlt wird, wie es RFC 9309 verlangt; ein 4xx bedeutet, dass es keine Regeln gibt (beide Sandboxes lieferten 404). Zur Syntax: Was ist robots.txt.
Vor jeder Anfrage stellt der Crawler sicher, dass seit seiner letzten Anfrage an diesen Host --delay (standardmäßig 1 Sekunde) oder das Crawl-delay der Website vergangen ist, je nachdem, welcher Wert größer ist. Mit Crawl-delay: 2 auf einer lokalen Testseite und --delay 0.2 protokollierte der Server Abstände von 2 Sekunden. Bei einem 429 stoppt der Crawler den Host und gibt Retry-After aus. Wie man richtig wiederholt, steht in HTTP-Statuscodes beim Web Scraping, dieselben Prüfungen mit einer SQLite-Warteschlange in Paginierung beim Web Scraping.
Der vollständige Code: ein Web-Crawler in Python ohne Framework
Installieren Sie die beiden Bibliotheken in einer virtuellen Umgebung, speichern Sie das Skript als crawler.py und übergeben Sie ihm eine Startadresse:
pip install requests==2.34.2 beautifulsoup4==4.15.0
python crawler.py https://books.toscrape.com/ --depth 2 --max-pages 60"""Ein Breitensuche-Crawler für eine Website: Requests + BeautifulSoup, ohne Framework."""
import argparse
import json
import time
from collections import Counter, deque
from urllib.parse import parse_qsl, urldefrag, urlencode, urljoin, urlsplit, urlunsplit
from urllib.robotparser import RobotFileParser
import requests
from bs4 import BeautifulSoup
BOT_NAME = "ExampleSiteMapper"
USER_AGENT = f"{BOT_NAME}/1.0 (+https://example.com/bot; bot@example.com)"
TIMEOUT = 15 # Sekunden; ohne Timeout kann Requests ewig warten
MAX_RETRIES = 2 # eine URL kommt höchstens zweimal ans Ende der Warteschlange zurück
TRACKING = {"utm_source", "utm_medium", "utm_campaign", "utm_term", "utm_content", "gclid", "fbclid"}
DEFAULT_PORTS = {"http": 80, "https": 443}
def normalize(url):
"""Eine Schreibweise pro Seite, oder None für Links, denen ein Crawler nicht folgen soll."""
url, _fragment = urldefrag(url.strip())
parts = urlsplit(url)
scheme = parts.scheme.lower()
try:
port = parts.port
except ValueError: # ein kaputter Port wie ":abc"
return None
if scheme not in DEFAULT_PORTS or not parts.hostname:
return None # mailto:, tel:, javascript:, ftp:, ...
host = parts.hostname # bereits kleingeschrieben
if port and port != DEFAULT_PORTS[scheme]:
host = f"{host}:{port}"
query = sorted((k, v) for k, v in parse_qsl(parts.query, keep_blank_values=True)
if k not in TRACKING)
return urlunsplit((scheme, host, parts.path or "/", urlencode(query), ""))
def page_key(url):
"""Schlüssel im Seen-Set: http:// und https:// derselben Adresse zählen als eine Seite."""
return url.split("://", 1)[1]
class Crawler:
def __init__(self, start, max_depth, max_pages, delay, out, proxy=None):
self.start = normalize(start)
self.hosts = {urlsplit(self.start).hostname} # einen "www."-Zwilling hier bewusst ergänzen
self.max_depth, self.max_pages, self.delay, self.out = max_depth, max_pages, delay, out
self.queue = deque([(self.start, 0, 0)]) # (url, depth, attempts)
self.seen = {page_key(self.start)} # markiert, wenn eine URL zum ersten Mal auftaucht, nicht beim Abruf
self.robots, self.last, self.stopped = {}, {}, {}
self.stats, self.depths = Counter(), Counter()
self.session = requests.Session()
self.session.headers["User-Agent"] = USER_AGENT
# pro Anfrage: session.proxies würde gegen die Umgebungsvariablen HTTP(S)_PROXY verlieren
self.proxies = {"http": proxy, "https": proxy} if proxy else None
def in_scope(self, url):
return urlsplit(url).hostname in self.hosts
def fetch(self, url):
"""GET mit Pause pro Host. stream=True liest die Header vor dem Body."""
parts = urlsplit(url)
rules = self.robots.get(f"{parts.scheme}://{parts.netloc}")
gap = max(self.delay, (rules.crawl_delay(BOT_NAME) if rules else None) or 0)
pause = self.last.get(parts.netloc, float("-inf")) + gap - time.monotonic()
if pause > 0:
time.sleep(pause)
try:
return self.session.get(url, timeout=TIMEOUT, stream=True, proxies=self.proxies)
finally:
self.last[parts.netloc] = time.monotonic() # pro Host: http und https teilen sich den Wert
def robots_ok(self, url):
root = "{0.scheme}://{0.netloc}".format(urlsplit(url))
if root not in self.robots:
rules = RobotFileParser()
try:
with self.fetch(root + "/robots.txt") as r:
status = r.status_code
rules.parse(r.text.splitlines() if status == 200 else [])
except requests.RequestException:
status = None
rules.parse([])
if status is None or status >= 500:
rules.disallow_all = True # robots.txt nicht erreichbar: auf diesem Host nichts crawlen
self.robots[root] = rules
return self.robots[root].can_fetch(BOT_NAME, url)
def extract_links(self, html, base):
soup = BeautifulSoup(html, "html.parser")
title = " ".join(soup.title.get_text().split()) if soup.title else ""
return title, [urljoin(base, a["href"]) for a in soup.select("a[href]")]
def enqueue(self, links, depth):
for link in links:
self.stats["raw_links"] += 1
url = normalize(link)
if url is None:
self.stats["not_http"] += 1
continue
if page_key(url) in self.seen:
self.stats["duplicate"] += 1
continue
self.seen.add(page_key(url)) # BFS trifft jede URL zuerst auf ihrer geringsten Tiefe
if not self.in_scope(url):
self.stats["offsite"] += 1
elif depth + 1 > self.max_depth:
self.stats["too_deep"] += 1
else:
self.queue.append((url, depth + 1, 0))
self.stats["queued"] += 1
def retry(self, url, depth, attempts, why):
if attempts < MAX_RETRIES:
self.queue.append((url, depth, attempts + 1))
self.stats["retried"] += 1
else:
self.stats["failed"] += 1
print(f"giving up on {url}: {why}")
def run(self):
started = time.monotonic()
with open(self.out, "w", encoding="utf-8", newline="\n") as out: # JSON Lines: \n, kein BOM
while self.queue and self.stats["fetched"] < self.max_pages:
url, depth, attempts = self.queue.popleft()
host = urlsplit(url).netloc
if host in self.stopped:
self.stats["skipped_stopped_host"] += 1
continue
if not self.robots_ok(url):
self.stats["robots_disallowed"] += 1
continue
try:
r = self.fetch(url)
except requests.RequestException as exc:
self.retry(url, depth, attempts, type(exc).__name__)
continue
with r:
if r.status_code == 429:
self.stopped[host] = r.headers.get("Retry-After", "not sent")
print(f"429 from {host}, host stopped (Retry-After: {self.stopped[host]})")
continue
if r.status_code >= 500:
self.retry(url, depth, attempts, f"HTTP {r.status_code}")
continue
final = normalize(r.url)
moved = page_key(final) != page_key(url) # nicht nur http -> https
if not self.in_scope(final) or (moved and page_key(final) in self.seen):
self.stats["redirect_skipped"] += 1 # Website verlassen oder bekannte Seite
continue
is_html = "text/html" in r.headers.get("Content-Type", "")
try: # erst hier wird der Body geladen, und nur bei HTML
html = r.content if r.status_code == 200 and is_html else b""
except requests.RequestException as exc: # Verbindung mitten im Body abgebrochen
self.retry(url, depth, attempts, type(exc).__name__)
continue
if final != url:
self.stats["redirected"] += 1
self.seen.add(page_key(final))
self.stats["fetched"] += 1
self.depths[depth] += 1
title, links = "", []
if html:
self.stats["html_bytes"] += len(html) # für eine Traffic-Schätzung
title, links = self.extract_links(html, r.url)
elif not is_html:
self.stats["not_html"] += 1 # Body nie heruntergeladen
record = {"url": url, "final_url": final, "depth": depth,
"status": r.status_code, "title": title, "links_found": len(links)}
out.write(json.dumps(record, ensure_ascii=False) + "\n")
print(f"{r.status_code} d{depth} {url}")
self.enqueue(links, depth)
print(f"\n{self.stats['fetched']} pages in {time.monotonic() - started:.1f} s,"
f" by depth {dict(sorted(self.depths.items()))}, left in queue {len(self.queue)}")
for key, value in sorted(self.stats.items()):
print(f" {key:<21}{value}")
if __name__ == "__main__":
ap = argparse.ArgumentParser(description=__doc__)
ap.add_argument("start", help="start URL, e.g. https://books.toscrape.com/")
ap.add_argument("--depth", type=int, default=2, help="link hops from the start URL")
ap.add_argument("--max-pages", type=int, default=100, help="hard ceiling on fetched pages")
ap.add_argument("--delay", type=float, default=1.0, help="minimum seconds between requests to one host")
ap.add_argument("--out", default="pages.jsonl")
ap.add_argument("--proxy", help="e.g. http://user:pass@pr.proxynet.io:8000")
args = ap.parse_args()
Crawler(args.start, args.depth, args.max_pages, args.delay, args.out, args.proxy).run()Drei Details sind wichtig, wenn Sie den Code ändern:
- Wiederholungen kommen ans Ende der Warteschlange, höchstens zweimal, nach einem Verbindungsfehler oder einem
5xx. Eine lokale Testseite, die zweimal mit500antwortete, lieferte beim dritten Versuch200. Wiederholungen innerhalb von Requests: Max Retries Exceeded With URL. - Die Datei ist reines JSON Lines.
encoding="utf-8"schreibt keine Byte-Order-Mark, undnewline="\n"behält die Zeilenenden\n, die JSON Lines verlangt; sonst schreibt Windows\r\n.ensure_ascii=Falsehält Text außerhalb von ASCII lesbar. Ein Titel mit türkischen Buchstaben kam unverändert zurück (Encoding-Fehler in Python). - Nur GET. Der Crawler öffnet
/loginwie jede andere Seite und sendet nie ein Formular ab.
Was wir beim Ausführen gesehen haben
Wir haben Python 3.13.9, die Standardpause von einer Sekunde und Tiefe 2 verwendet. Auf quotes.toscrape.com mit einer Obergrenze von 500:
149 pages in 179.1 s, by depth {0: 1, 1: 46, 2: 102}, left in queue 0
  duplicate            2916
  fetched              149
  html_bytes           722227
  offsite              2
  queued               148
  raw_links            3096
  redirected           40
  too_deep             30
Auf books.toscrape.com mit einer Obergrenze von 60:
60 pages in 69.8 s, by depth {0: 1, 1: 59}, left in queue 524
  duplicate            3515
  fetched              60
  html_bytes           2047561
  queued               583
  raw_links            4098
Auf quotes zeigten 94 % der Links auf bekannte Adressen, und nur 2 verschiedene Adressen lagen außerhalb der Website. Zwei Ausgabezeilen, eine normale und eine weitergeleitete:
{"url": "https://books.toscrape.com/", "final_url": "https://books.toscrape.com/", "depth": 0, "status": 200, "title": "All products | Books to Scrape - Sandbox", "links_found": 94}
{"url": "https://quotes.toscrape.com/author/Jane-Austen", "final_url": "http://quotes.toscrape.com/author/Jane-Austen/", "depth": 1, "status": 200, "title": "Quotes to Scrape", "links_found": 4}
Eine kleine lokale Website hat die Fehlerzweige abgedeckt. Der Crawler übersprang einen gesperrten Pfad, drei Links, die keine Webadressen waren, und eine Weiterleitung auf einen anderen Host, schloss ein PDF ungelesen und protokollierte ein 404. Ein 429 mit Retry-After: 120 stoppte den Host, und bei einem 503 auf robots.txt wurde nichts abgerufen.
Wo wird der Proxy im Crawler eingebunden?
--proxy http://user:pass@pr.proxynet.io:8000 wird mit jeder Anfrage übergeben, auch mit der für robots.txt. Der Code setzt session.proxies nicht, weil die Requests-Dokumentation warnt, dass Proxy-Umgebungsvariablen diesen Wert überschreiben (Advanced Usage). Über einen lokalen Test-Proxy mit Passwort lieferten die ersten 10 books-Seiten dieselben Zeilen wie ohne Proxy, selbst mit einem toten Proxy in HTTPS_PROXY.
Eine einzelne Website bei einer Anfrage pro Sekunde braucht selten einen Proxy. Er hilft, wenn ein Crawl viele Hosts abdeckt und der Verkehr nicht komplett von einer Adresse ausgehen soll: Ein Rotierender Proxy gibt jeder Anfrage oder jedem Host eine andere Ausgangs-IP. Für eine kurze, feste Liste von Zielen reicht oft ein Datacenter-Proxy; seine IPs werden standardmäßig mit einer Beschränkung auf bestimmte Zielseiten geliefert, und der Zugriff auf alle Websites ist bei der Bestellung eine eigene Option. Code für die Rotation steht in Proxys in Python rotieren.
Rotierender Residential-Traffic wird pro GB abgerechnet; messen Sie html_bytes deshalb zuerst bei einem kurzen Lauf. Beide Sandboxes lieferten unkomprimiertes HTML, etwa 34 KB pro books-Seite und 5 KB pro quotes-Seite: 10.000 Seiten ergeben grob 0,34 GB bzw. 0,05 GB, zuzüglich Header. Pause und robots.txt gelten für jede Ausgangs-IP, und Rotation ist kein Grund, einer Website mehr Anfragen zu schicken, als sie erlaubt.
Anwendungsfälle
- Defekte interne Links: die Ausgabe nach Status
404filtern (Web-Crawler). - Eine URL-Liste vor dem Scraping: erst crawlen, dann nur Produkt- oder Artikelseiten scrapen (Data Scraping).
- Neue Produkte bei Wettbewerbern: die URL-Liste dieser Woche mit der der Vorwoche vergleichen (Wettbewerberpreise im E-Commerce überwachen).
- Lücken in der Sitemap: Seiten, die der Crawler findet, die aber in der Sitemap fehlen (Die Sitemap einer Website finden).
- Bilder von bekannten Seiten: erst die Seiten auflisten, dann herunterladen (Alle Bilder von einer Website herunterladen).
- Felder aus den gefundenen Seiten: Titel und Preise aus demselben HTML (Was ist BeautifulSoup).
Häufige Fehler
list.pop(0)als Warteschlange. Jeder Aufruf verschiebt die ganze Liste.- Rekursion für jeden Link. Der Crawl wird zur Tiefensuche und kann mit
RecursionErrorenden. - URLs erst nach dem Abruf als gesehen markieren. Dieselbe Adresse landet viele Male in der Warteschlange.
- Den ganzen Query-String löschen.
?page=2und alle folgenden Seiten verschwinden. - Links gegen die angefragte URL auflösen. Nach einer Weiterleitung ist die Basis
r.url. - Kein Timeout. Ohne Timeout kann Requests unbegrenzt hängen.
- PDF- und ZIP-Dateien als HTML parsen. Prüfen Sie zuerst den
Content-Type. - Keine Seitenobergrenze. Auf einer Website mit Filtern oder Kalender endet der Lauf nie.
- Formulare ausfüllen. Ein Crawler liest Seiten per GET; Daten zu senden ist eine andere Aufgabe (JSON mit Python Requests per POST senden).
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Einige Hundert Seiten einer Website, mit dem Mechanismus im Blick | Das Skript aus diesem Beitrag |
| Einen langen Crawl nach einem Abbruch fortsetzen | Eine Warteschlange auf der Festplatte: die SQLite-Version in Paginierung beim Web Scraping |
| Viele Anfragen gleichzeitig | Nebenläufigkeit, dimensioniert wie in Concurrency und Parallelism |
| Tausende Seiten, eingebaute Wiederholungen und Exporte | Scrapy (CrawlSpider, Proxy-Einrichtung) |
| Links, die erst nach dem Ausführen von JavaScript erscheinen | Ein browserbasierter Crawler wie der PlaywrightCrawler von Crawlee for Python oder Crawl4AI |
| Die Website veröffentlicht eine Sitemap | Zuerst die Sitemap lesen, nur für ihre Lücken crawlen (Die Sitemap einer Website finden) |
| Ein Crawl über viele Hosts | Ein Rotierender Proxy bei demselben rücksichtsvollen Tempo pro Host |
Häufige Fragen
Welche Python-Bibliothek eignet sich für einen Web-Crawler?
Für einige Hundert Seiten reichen Requests zum Herunterladen und BeautifulSoup zum Lesen der Links. Für Tausende Seiten mit Wiederholungen, Exporten und Zeitplanung spart Ihnen Scrapy diesen Code. Links, die erst JavaScript erzeugt, brauchen ein browserbasiertes Werkzeug.
Reicht BeautifulSoup für einen Crawler, oder braucht man Scrapy?
BeautifulSoup reicht. Es ist ein Parser: Es liest Links aus HTML, lädt aber keine Seiten herunter, führt keine Warteschlange und wartet nicht zwischen Anfragen. Das Skript oben erledigt diese Aufgaben in weniger als 200 Zeilen. Scrapy hat sie eingebaut, was sich bei größeren Aufträgen auszahlt.
Sieht ein Python-Crawler Links, die per JavaScript geladen werden?
Nein. Requests führt keine Skripte aus, daher kommen per JavaScript hinzugefügte Links nie bei BeautifulSoup an. Suchen Sie zuerst nach einer JSON-Anfrage hinter der Seite, die Sie direkt aufrufen können. Gibt es keine, nutzen Sie einen browserbasierten Crawler, sofern die Nutzungsbedingungen der Website Automatisierung erlauben.
Sollte der Crawler mit mehreren Threads arbeiten?
Nur wenn Sie mehrere Hosts crawlen. Auf einer einzelnen Website bestimmt die Pause zwischen den Anfragen das Tempo, und zusätzliche Threads würden nur warten oder die Pause unterlaufen. Über viele Hosts hinweg hilft ein rücksichtsvoller Worker pro Host (Concurrency und Parallelism).
Wie finden Sie mit Python alle Links einer Website?
Beginnen Sie mit der Sitemap, die meist in robots.txt genannt wird oder unter /sitemap.xml liegt. Gibt es keine, lassen Sie einen Crawler wie diesen mit Tiefenlimit und Seitenobergrenze laufen und betrachten Sie das Ergebnis als das, was über Links erreichbar ist, nicht als vollständige Liste.
Ist es legal, einen Web-Crawler zu schreiben und zu betreiben?
Dies ist keine Rechtsberatung. Die Antwort hängt von Ihrem Land ab, von den Nutzungsbedingungen der Website, davon, ob die Seiten personenbezogene Daten enthalten, und davon, was Sie mit den Kopien machen. Befolgen Sie robots.txt, halten Sie das Tempo niedrig und bleiben Sie aus Bereichen hinter einem Login heraus. Land für Land: Ist Web Scraping legal?.
Fazit
Ein Crawler, der zu Ende kommt, ohne sich zu wiederholen, braucht eine deque für die Reihenfolge der Breitensuche, ein Seen-Set, das beim Einreihen gefüllt wird, eine Schreibweise pro URL, eine Scope-Prüfung nach Weiterleitungen sowie ein Tiefenlimit mit Seitenobergrenze. robots.txt, eine Pause pro Host und ein Stopp bei 429 gehören schon in die erste Version. Wächst die Aufgabe, wechseln Sie zu einer Warteschlange auf der Festplatte, zu Nebenläufigkeit über mehrere Hosts oder zu Scrapy. Für Crawls über viele Websites oder Länder vergleichen Sie die Optionen auf unserer Seite Proxy-Dienste.