Sitemap'i olmayan bir kitapçı sitesindeki bütün kategori ve ürün sayfalarının listesini çıkarmanız gerekiyor. Test hedefimiz books.toscrape.com, web scraping (veri kazıma) alıştırması için kurulmuş bir deneme sitesi. Bu işi bir crawler, yani bağlantıları izleyerek sayfaları tek tek gezen bir program yapar. Ama her bağlantıyı izleyip nerelere uğradığını hatırlamayan bir crawler bu sitede işini hiç bitiremez: bağlantıların çoğu onu zaten gördüğü sayfalara geri götürür. Ölçümümüzde ilk 60 sayfadaki 4.098 bağlantının 3.515'i crawler'ın zaten bildiği adreslere gidiyordu ve kuyrukta hâlâ 524 yeni adres bekliyordu.
Bu yazıda framework kullanmadan, Requests ve BeautifulSoup ile bir crawler yazıyoruz: kuyruk, görülenler kümesi, URL normalleştirme, kapsam, derinlik sınırı, robots.txt, istekler arası bekleme ve JSON Lines çıktısı. Crawler'ın ne olduğunu ve scraper'dan farkını web crawler sayfamızda ve Web Scraping ve Web Crawling Farkı Nedir? yazımızda anlattık. Yazıdaki bütün sayılar, betiğin son hâlini 25 Eylül 2026'da çalıştırdığımızda aldığımız çıktılardan geliyor.
Python web crawler hangi parçalardan oluşur?
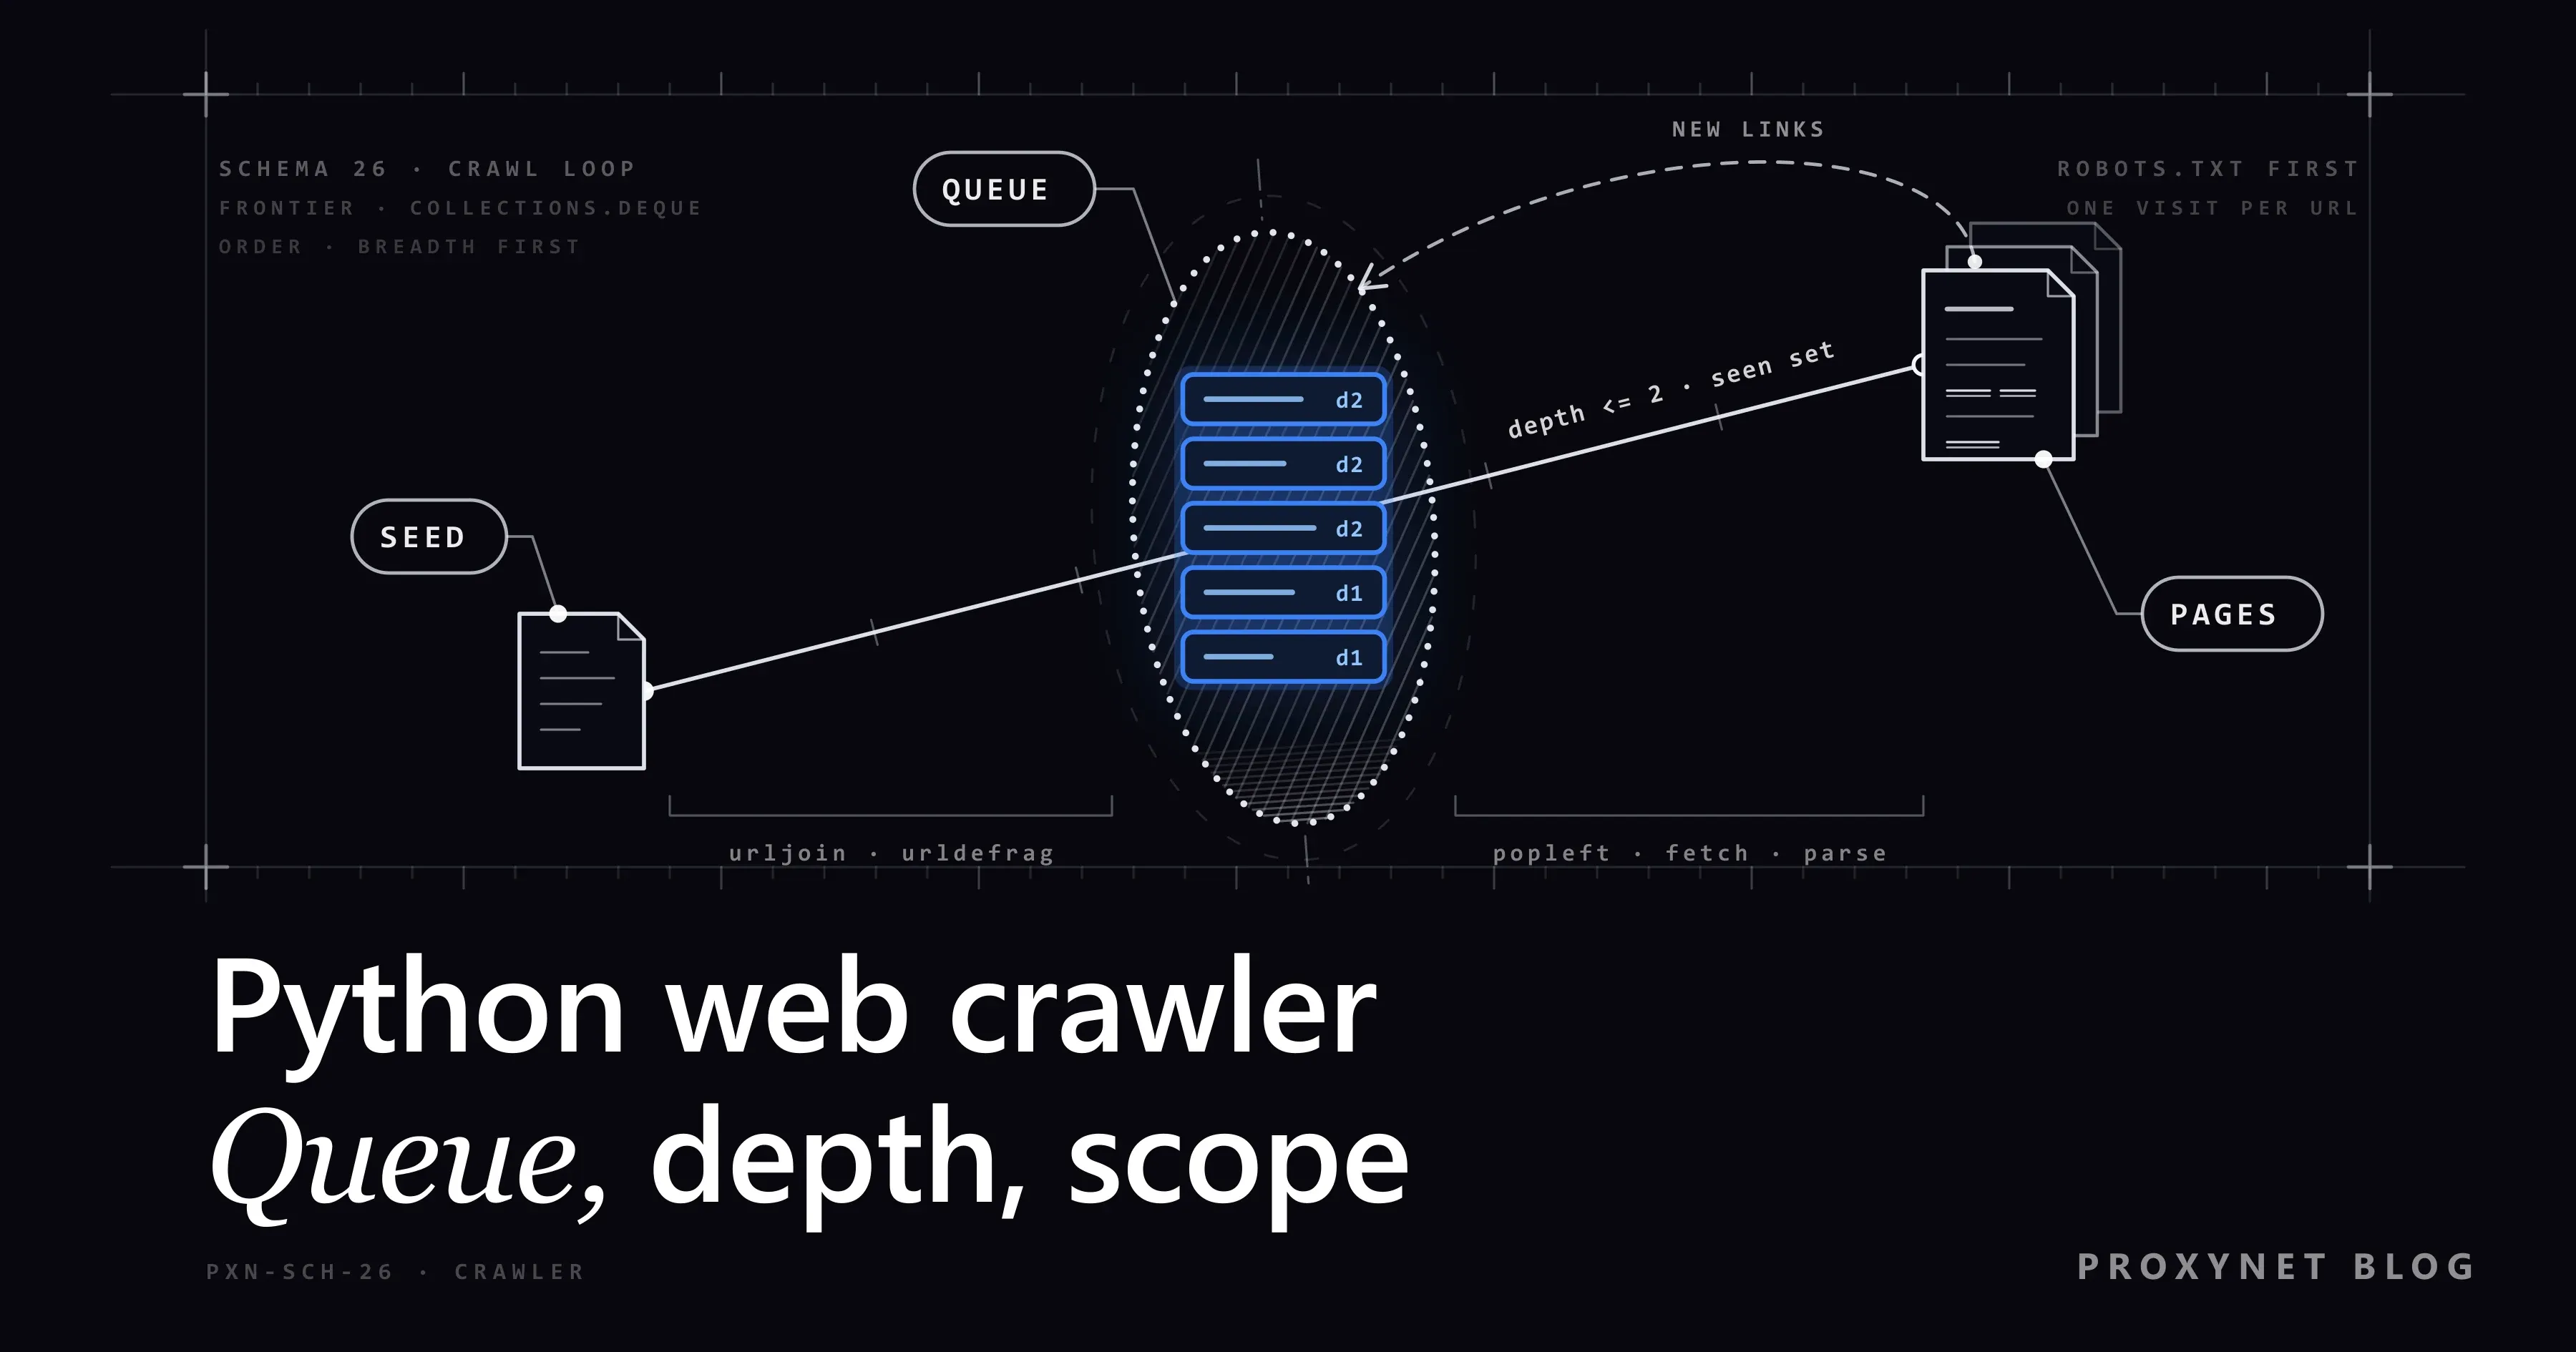
Altı parçası var ve her biri birkaç satırlık Python kodu:
- Frontier: henüz ziyaret edilmemiş adreslerin kuyruğu; kodda bir
collections.deque. - Görülenler kümesi (seen set): crawler'ın o ana kadar karşılaştığı bütün adresler.
- İndirici (fetcher): zaman aşımı (timeout) tanımlı bir
requests.Session. İsteğinUser-Agentheader'ı (her istekle sunucuya giden tanıtım satırı) botun adını ve bir iletişim adresini açıkça söyler (User-Agent Nedir, Nasıl Öğrenilir ve Değiştirilir?). - Bağlantı çıkarıcı:
select("a[href]"). Sayfanın geri kalanını okumak scraper'ın işi (BeautifulSoup Nedir ve Python'da Nasıl Kullanılır?). - Kapsam filtresi: hangi adresin hesaba katılacağına host, şema ve içerik türü karar verir.
- Çıktı:
.jsonldosyasında her sayfa için tek bir JSON nesnesi.
Requests 2.34.2 ve Beautiful Soup 4.15.0 kullanıyoruz; ikisi de 25 Eylül 2026'da PyPI'daki güncel sürüm. Requests, Python 3.10 ya da daha yeni bir sürüm istiyor. Scrapy'de bu altı parçanın hepsi hazır gelir.
Tarama döngüsü adım adım nasıl işler?
- Başlangıç. Başlangıç adresini normalleştirin,
(url, 0)çiftini kuyruğa, adresi de görülenler kümesine ekleyin. - Sıradaki adres.
popleft()ile kuyruktaki en eski girdiyi alın. - robots.txt kontrolü. Host'un kurallarını önbellekten okuyun; dosyayı yalnız bir kez indirin.
- Bekleme ve indirme. Aynı host'a yapılan son istekten bu yana yeterli süre geçmesini bekleyin, ardından GET isteği gönderin.
- Yanıt kontrolü. Yönlendirmelerden sonra varılan son adresi ve
Content-Typeheader'ını okuyun. - Çıkarma ve filtreleme. Her
hrefdeğeriniurljoinile mutlak adrese çevirip normalleştirin; görülmüş, site dışında kalan ya da fazla derindeki adresleri atın. - Kayıt ve kuyruğa ekleme. Tek bir JSON satırı yazın, yeni adresleri
depth + 1ile kuyruğun sonuna ekleyin.
Döngü, kuyruk boşaldığında ya da sayfa tavanına ulaşıldığında biter.
Hangi parça hangi sorunu önler?
| Parça | Önlediği sorun | Python'da | Olmazsa |
|---|---|---|---|
| Kuyruğa eklerken doldurulan görülenler kümesi | Aynı sayfayı iki kez indirmek | set, kuyruğa ekleme anında doldurulur | books denemesindeki 3.515 bilinen bağlantı yeniden indirilir |
| Derinlik sınırı ve sayfa tavanı | Takvim ve filtre gibi sonu gelmeyen zincirler | (url, depth), --depth, --max-pages | Durmadan büyüyen bir kuyruk (60 sayfadan sonra 524 adres bekliyordu) |
| URL normalleştirme | Aynı sayfanın birkaç farklı yazımı | urldefrag, urlsplit, parse_qsl | Aynı sayfa birden fazla kez indirilir ve kaydedilir |
| Yönlendirme ve içerik türü kontrolü | Başka bir siteye kaymak, PDF'i HTML diye ayrıştırmak | r.url, Content-Type, stream=True | Başka sitelerin sayfalarındaki bağlantılar kuyruğa girer |
| robots.txt önbelleği ve host başına bekleme | Yasaklı yollar, art arda yığılan istekler | RobotFileParser.parse(), time.monotonic() | Site 429 döner |
Kuyruk neden liste değil de deque olmalı?
deque.popleft() en eski adresi alır, bu yüzden tarama genişlik öncelikli (BFS, breadth-first search) ilerler: önce başlangıç sayfası, sonra bir tık uzaktaki sayfalar, sonra iki tık uzaktakiler. Ana sayfaya yakın sayfalar önce gelir ve derinlik sırayla arttığı için derinlik sınırı anlamlı olur. Ekleme yaptığınız uçtan pop() ile almak ise derinlik öncelikli (DFS, depth-first search) taramadır: bir dalın sonuna kadar inilir, sonra öbürüne geçilir.
Liste de kuyruk olarak kullanılabilir, ama pop(0) kalan her öğeyi bir sıra kaydırır (O(n)). Deque ise iki uçtan da yaklaşık sabit sürede eleman çıkarır (collections belgeleri). Özyinelemeli (recursive) crawler'lar da aslında DFS yapar ve Python'un varsayılan 1.000 iç içe çağrı sınırına gelince RecursionError ile durabilir.
BFS ayrıca her adrese ilk kez en düşük derinliğinde rastlar. Bu yüzden ilk görüldüğünde fazla derin olan bir bağlantı, görüldü diye işaretlenip unutulabilir.
URL normalleştirme kodda nasıl yazılır?
Görülenler kümesi adresleri karakter karakter karşılaştırır, bu yüzden normalize() her sayfanın adresini tek bir yazıma getirir:
urldefrag(),#reviewsgibi fragment kısmını (adreste#işaretinden sonra gelen bölümü) atar. RFC 3986 standardının 3.5. bölümüne göre fragment sunucuya hiç gitmez.- Şema ve host küçük harfe çevrilir;
urlsplit().hostnamezaten küçük harf döndürür. - Varsayılan portlar (http için
:80, https için:443) atılır ve boş yol/olur; aynı RFC'nin 6.2.3. bölümü bu yazımları eşdeğer sayar. - İzleme parametreleri (
utm_*,gclid,fbclid) silinir, kalanlar sıralanır. Böylece?b=2&a=1ile?a=1&b=2eşleşir. mailto:,tel:vejavascript:bağlantıları ile portu bozuk adresler içinNonedöner.
Sorgu dizesini (query string) asla tamamen silmeyin: ?page=2 başka bir sayfadır. Sondaki eğik çizgi de kalır, çünkü /a ile /a/ farklı olabilir; ikisi aynı sayfaysa site bunu bir yönlendirmeyle belli eder. books.toscrape.com'da / ve /index.html aynı sayfayı döndürdü. Bu ikisini ancak siteye özel bir kural birleştirebilir.
Görülenler kümesi şemayı da hesaba katmaz. quotes.toscrape.com'da yazar sayfaları https'ten http'ye yönlendiriliyor ve bu sayfalardaki göreli bağlantılar http://quotes.toscrape.com/ adresine çıkıyor. Bu yüzden ilk deneme çalıştırmamız ana sayfayı ve giriş sayfasını iki kez indirdi. page_key() şemayı attığı için iki yazım artık tek sayfa sayılıyor.
Deneme sitelerinde fragment ya da izleme parametresi olmadığı için bu kontrolleri örnek adreslerle yazdık:
from crawler import normalize

assert normalize("https://Example.COM:443/a#reviews") == "https://example.com/a"
assert normalize("http://example.com") == "http://example.com/"
assert normalize("https://example.com:8443/a") == "https://example.com:8443/a"
assert normalize("https://example.com/list?b=2&a=1") == "https://example.com/list?a=1&b=2"
assert normalize("https://example.com/list?utm_source=mail&page=2") == "https://example.com/list?page=2"
assert normalize("mailto:shop@example.com") is None
assert normalize("javascript:void(0)") is None
assert normalize("https://example.com:abc/") is None
assert normalize("https://example.com/a/") != normalize("https://example.com/a")
print("all normalize checks passed")
Kapsam: aynı host, yönlendirmeler ve içerik türü
self.hosts yalnız başlangıç host'unu tutar. Bir site hem www.example.com hem example.com kullanıyorsa ikisini de elle ekleyin. Kısayol olarak endswith("example.com") kullanmayın: bu kontrol notexample.com adresini de içeri alır.
Requests, HEAD dışındaki bütün yöntemlerde yönlendirmeleri izler ve son adresi r.url içinde tutar (Requests quickstart). Bu yüzden kapsamı r.url üzerinden kontrol edin ve göreli bağlantıları da bu adres üzerinden tamamlayın. quotes.toscrape.com'da /author/Jane-Austen adresi http://quotes.toscrape.com/author/Jane-Austen/ adresine yönlendiriliyor; derinlik 2 ile yaptığımız çalıştırmada 149 sayfanın 40'ı bu yolla geldi. Site dışına çıkan bir yönlendirme atılır, ama Requests hedefi o sırada indirmiş olur. Bu isteği de önlemek istiyorsanız allow_redirects=False verin ve Location header'ındaki adresi kendiniz kuyruğa ekleyin.
stream=True verildiğinde Requests, header'lar gelir gelmez döner. Content-Type değeri text/html değilse crawler bağlantıyı gövdeyi okumadan kapatır.
Derinlik sınırı ve sayfa tavanı nasıl belirlenir?
Kuyruk girdileri (url, depth, attempts) biçimindedir. depth + 1 değeri --depth sınırını aşacak bir bağlantı too_deep sayılır ve dışarıda kalır. --max-pages ise kuyrukta ne kalmış olursa olsun çalışmayı bitirir. Deneme sitelerinde sonuçlar şöyleydi:
- quotes.toscrape.com, derinlik 2, tavan 500: kuyruk 149 sayfadan sonra kendiliğinden boşaldı (derinliğe göre 1, 46 ve 102 sayfa); 30 adres fazla derindi.
- Aynı site, tavan 60: çalışma 60 sayfada durdu, kuyrukta hâlâ 89 adres vardı.
- books.toscrape.com, derinlik 2, tavan 60: 60 sayfanın hepsi 0 ve 1. derinlikten geldi, kuyrukta 524 adres bekliyordu. Bu çalışmayı derinlik değil, tavan bitirdi.
Derinliği sitenin yapısına göre seçin: ana sayfadan kategoriye, oradan ürüne inen yol derinlik 2'dir ve araya giren her liste sayfası bir ekler. Tavanı ise bütçenize göre belirleyin. Botları yakalamak için sayfaya yerleştirilen bağlantıları Honeypot Tuzakları Nedir, Web Scraping'i Nasıl Etkiler? yazımızda anlattık.
Crawler robots.txt'ye ve bekleme süresine nasıl uyar?
Crawler her şema ve host için bir RobotFileParser tutar. robots.txt dosyasını kendi oturumuyla (zaman aşımı, bot User-Agent değeri, proxy) indirir ve satırları parse() yöntemine verir. read() kullanmıyoruz: Python 3.13.9'da bu yöntem isteği zaman aşımı olmadan, urllib ile ve urllib'in kendi User-Agent değeriyle atar, ağ hatasında da exception fırlatır. 5xx yanıtı ya da ulaşılamayan dosya, RFC 9309 gereği o host'ta hiçbir şeyin taranmaması demektir; 4xx ise kural yok demektir (iki deneme sitesi de 404 döndü). Dosyanın söz dizimini robots.txt Dosyası Nedir, Nasıl Okunur? yazımızda anlattık.
Crawler her istekten önce, o host'a yaptığı son istekten bu yana --delay (varsayılan 1 saniye) ile sitenin Crawl-delay değerinden uzun olanı kadar süre geçmesini bekler. Yerel bir test sitesinde Crawl-delay: 2 ve --delay 0.2 ile denedik; sunucu kaydında istekler arasında 2 saniyelik aralıklar göründü. 429 gelince crawler o host'taki taramayı durdurur ve Retry-After değerini yazdırır. Yeniden denemenin doğru yolunu Scraping'de HTTP Hata Kodları: 403, 407, 429 ve 503 yazımızda, bu kontrollerin SQLite kuyruklu hâlini de Sayfalama (Pagination) Nedir, Scraping'de Nasıl Taranır? yazımızda anlattık.
Tam kod: framework kullanmadan Python web crawler
İki kütüphaneyi bir sanal ortama (virtual environment) kurun, betiği crawler.py adıyla kaydedin ve bir başlangıç adresi verin:
pip install requests==2.34.2 beautifulsoup4==4.15.0
python crawler.py https://books.toscrape.com/ --depth 2 --max-pages 60"""Tek bir site için genişlik öncelikli crawler: Requests + BeautifulSoup, framework yok."""
import argparse
import json
import time
from collections import Counter, deque
from urllib.parse import parse_qsl, urldefrag, urlencode, urljoin, urlsplit, urlunsplit
from urllib.robotparser import RobotFileParser
import requests
from bs4 import BeautifulSoup
BOT_NAME = "ExampleSiteMapper"
USER_AGENT = f"{BOT_NAME}/1.0 (+https://example.com/bot; bot@example.com)"
TIMEOUT = 15 # saniye; zaman aşımı olmadan Requests sonsuza kadar bekleyebilir
MAX_RETRIES = 2 # bir URL kuyruğun sonuna en fazla iki kez geri döner
TRACKING = {"utm_source", "utm_medium", "utm_campaign", "utm_term", "utm_content", "gclid", "fbclid"}
DEFAULT_PORTS = {"http": 80, "https": 443}
def normalize(url):
"""Her sayfaya tek yazım; crawler'ın izlememesi gereken bağlantılar için None."""
url, _fragment = urldefrag(url.strip())
parts = urlsplit(url)
scheme = parts.scheme.lower()
try:
port = parts.port
except ValueError: # ":abc" gibi bozuk bir port
return None
if scheme not in DEFAULT_PORTS or not parts.hostname:
return None # mailto:, tel:, javascript:, ftp:, ...
host = parts.hostname # zaten küçük harf
if port and port != DEFAULT_PORTS[scheme]:
host = f"{host}:{port}"
query = sorted((k, v) for k, v in parse_qsl(parts.query, keep_blank_values=True)
if k not in TRACKING)
return urlunsplit((scheme, host, parts.path or "/", urlencode(query), ""))
def page_key(url):
"""Görülenler kümesinin anahtarı: bir adresin http:// ve https:// hâli tek sayfa sayılır."""
return url.split("://", 1)[1]
class Crawler:
def __init__(self, start, max_depth, max_pages, delay, out, proxy=None):
self.start = normalize(start)
self.hosts = {urlsplit(self.start).hostname} # "www." ikizi gerekiyorsa buraya bilerek ekleyin
self.max_depth, self.max_pages, self.delay, self.out = max_depth, max_pages, delay, out
self.queue = deque([(self.start, 0, 0)]) # (url, depth, attempts)
self.seen = {page_key(self.start)} # URL indirildiğinde değil, ilk görüldüğünde işaretlenir
self.robots, self.last, self.stopped = {}, {}, {}
self.stats, self.depths = Counter(), Counter()
self.session = requests.Session()
self.session.headers["User-Agent"] = USER_AGENT
# istek başına veriliyor: session.proxies, HTTP(S)_PROXY ortam değişkenlerine yenilirdi
self.proxies = {"http": proxy, "https": proxy} if proxy else None
def in_scope(self, url):
return urlsplit(url).hostname in self.hosts
def fetch(self, url):
"""Host başına beklemeli GET. stream=True ile önce header'lar, sonra gövde okunur."""
parts = urlsplit(url)
rules = self.robots.get(f"{parts.scheme}://{parts.netloc}")
gap = max(self.delay, (rules.crawl_delay(BOT_NAME) if rules else None) or 0)
pause = self.last.get(parts.netloc, float("-inf")) + gap - time.monotonic()
if pause > 0:
time.sleep(pause)
try:
return self.session.get(url, timeout=TIMEOUT, stream=True, proxies=self.proxies)
finally:
self.last[parts.netloc] = time.monotonic() # host başına: http ve https aynı sayacı kullanır
def robots_ok(self, url):
root = "{0.scheme}://{0.netloc}".format(urlsplit(url))
if root not in self.robots:
rules = RobotFileParser()
try:
with self.fetch(root + "/robots.txt") as r:
status = r.status_code
rules.parse(r.text.splitlines() if status == 200 else [])
except requests.RequestException:
status = None
rules.parse([])
if status is None or status >= 500:
rules.disallow_all = True # robots.txt'ye ulaşılamıyor: bu host'ta hiçbir şey taranmaz
self.robots[root] = rules
return self.robots[root].can_fetch(BOT_NAME, url)
def extract_links(self, html, base):
soup = BeautifulSoup(html, "html.parser")
title = " ".join(soup.title.get_text().split()) if soup.title else ""
return title, [urljoin(base, a["href"]) for a in soup.select("a[href]")]
def enqueue(self, links, depth):
for link in links:
self.stats["raw_links"] += 1
url = normalize(link)
if url is None:
self.stats["not_http"] += 1
continue
if page_key(url) in self.seen:
self.stats["duplicate"] += 1
continue
self.seen.add(page_key(url)) # BFS her URL'ye ilk kez en düşük derinliğinde rastlar
if not self.in_scope(url):
self.stats["offsite"] += 1
elif depth + 1 > self.max_depth:
self.stats["too_deep"] += 1
else:
self.queue.append((url, depth + 1, 0))
self.stats["queued"] += 1
def retry(self, url, depth, attempts, why):
if attempts < MAX_RETRIES:
self.queue.append((url, depth, attempts + 1))
self.stats["retried"] += 1
else:
self.stats["failed"] += 1
print(f"giving up on {url}: {why}")
def run(self):
started = time.monotonic()
with open(self.out, "w", encoding="utf-8", newline="\n") as out: # JSON Lines: \n, BOM yok
while self.queue and self.stats["fetched"] < self.max_pages:
url, depth, attempts = self.queue.popleft()
host = urlsplit(url).netloc
if host in self.stopped:
self.stats["skipped_stopped_host"] += 1
continue
if not self.robots_ok(url):
self.stats["robots_disallowed"] += 1
continue
try:
r = self.fetch(url)
except requests.RequestException as exc:
self.retry(url, depth, attempts, type(exc).__name__)
continue
with r:
if r.status_code == 429:
self.stopped[host] = r.headers.get("Retry-After", "not sent")
print(f"429 from {host}, host stopped (Retry-After: {self.stopped[host]})")
continue
if r.status_code >= 500:
self.retry(url, depth, attempts, f"HTTP {r.status_code}")
continue
final = normalize(r.url)
moved = page_key(final) != page_key(url) # yalnız http -> https değişimi sayılmaz
if not self.in_scope(final) or (moved and page_key(final) in self.seen):
self.stats["redirect_skipped"] += 1 # siteden çıktı ya da bilinen bir sayfaya gitti
continue
is_html = "text/html" in r.headers.get("Content-Type", "")
try: # gövde burada ve yalnız HTML ise indirilir
html = r.content if r.status_code == 200 and is_html else b""
except requests.RequestException as exc: # gövde inerken bağlantı koptu
self.retry(url, depth, attempts, type(exc).__name__)
continue
if final != url:
self.stats["redirected"] += 1
self.seen.add(page_key(final))
self.stats["fetched"] += 1
self.depths[depth] += 1
title, links = "", []
if html:
self.stats["html_bytes"] += len(html) # trafik tahmini için
title, links = self.extract_links(html, r.url)
elif not is_html:
self.stats["not_html"] += 1 # gövde hiç indirilmedi
record = {"url": url, "final_url": final, "depth": depth,
"status": r.status_code, "title": title, "links_found": len(links)}
out.write(json.dumps(record, ensure_ascii=False) + "\n")
print(f"{r.status_code} d{depth} {url}")
self.enqueue(links, depth)
print(f"\n{self.stats['fetched']} pages in {time.monotonic() - started:.1f} s,"
f" by depth {dict(sorted(self.depths.items()))}, left in queue {len(self.queue)}")
for key, value in sorted(self.stats.items()):
print(f" {key:<21}{value}")
if __name__ == "__main__":
ap = argparse.ArgumentParser(description=__doc__)
ap.add_argument("start", help="start URL, e.g. https://books.toscrape.com/")
ap.add_argument("--depth", type=int, default=2, help="link hops from the start URL")
ap.add_argument("--max-pages", type=int, default=100, help="hard ceiling on fetched pages")
ap.add_argument("--delay", type=float, default=1.0, help="minimum seconds between requests to one host")
ap.add_argument("--out", default="pages.jsonl")
ap.add_argument("--proxy", help="e.g. http://user:pass@pr.proxynet.io:8000")
args = ap.parse_args()
Crawler(args.start, args.depth, args.max_pages, args.delay, args.out, args.proxy).run()Kodu değiştirirken üç ayrıntıya dikkat edin:
- Yeniden denemeler kuyruğun sonuna gider. Bağlantı hatası ya da
5xxsonrasında bir adres en fazla iki kez yeniden denenir. İki kez500dönen yerel bir test sayfası üçüncü denemede200döndü. Requests'in kendi içindeki yeniden deneme ayarını Max Retries Exceeded With URL Hatası Nedir, Nasıl Çözülür? yazımızda anlattık. - Dosya düz JSON Lines biçimindedir.
encoding="utf-8"bayt sırası işareti (BOM) yazmaz.newline="\n"ise JSON Lines biçiminin istediği\nsatır sonlarını korur; bu olmazsa Windows\r\nyazar.ensure_ascii=False, ASCII dışındaki karakterleri okunur bırakır. Denemede Türkçe harfli bir başlığı dosyaya yazıp geri okuduk; harfler bozulmadı (Python Türkçe Karakter Sorunu: Encoding Nasıl Düzeltilir?). - Yalnız GET. Crawler
/loginsayfasını diğer sayfalar gibi açar ve hiçbir formu göndermez.
Çalıştırınca ne gördük?
Python 3.13.9, varsayılan bir saniyelik bekleme ve derinlik 2 kullandık. quotes.toscrape.com'da tavan 500 iken:
149 pages in 179.1 s, by depth {0: 1, 1: 46, 2: 102}, left in queue 0
  duplicate            2916
  fetched              149
  html_bytes           722227
  offsite              2
  queued               148
  raw_links            3096
  redirected           40
  too_deep             30
books.toscrape.com'da tavan 60 iken:
60 pages in 69.8 s, by depth {0: 1, 1: 59}, left in queue 524
  duplicate            3515
  fetched              60
  html_bytes           2047561
  queued               583
  raw_links            4098
quotes sitesinde bağlantıların %94'ü bilinen adreslere gidiyordu ve site dışında yalnız 2 farklı adres vardı. Çıktıdan iki satır; biri doğrudan açılan, öbürü yönlendirilen bir sayfa:
{"url": "https://books.toscrape.com/", "final_url": "https://books.toscrape.com/", "depth": 0, "status": 200, "title": "All products | Books to Scrape - Sandbox", "links_found": 94}
{"url": "https://quotes.toscrape.com/author/Jane-Austen", "final_url": "http://quotes.toscrape.com/author/Jane-Austen/", "depth": 1, "status": 200, "title": "Quotes to Scrape", "links_found": 4}
Kodun hata durumlarını ele alan kısmını küçük bir yerel siteyle denedik. Crawler yasaklı bir yolu, web dışı üç bağlantıyı ve başka bir host'a giden bir yönlendirmeyi atladı, bir PDF'i okumadan kapattı ve bir 404 yanıtını kaydetti. Retry-After: 120 taşıyan bir 429 o host'taki taramayı durdurdu; robots.txt için 503 gelince de hiçbir sayfa indirilmedi.
Proxy crawler'ın neresine girer?
--proxy http://user:pass@pr.proxynet.io:8000 ile verilen proxy, robots.txt dahil her istekte kullanılır. Kod session.proxies ayarını kullanmaz, çünkü Requests belgeleri proxy ortam değişkenlerinin bu ayarı ezdiği konusunda uyarıyor (advanced usage). Kullanıcı adı ve şifre isteyen yerel bir test proxy'si üzerinden ilk 10 books sayfası, proxy'siz çalıştırmayla aynı satırları verdi; HTTPS_PROXY içinde çalışmayan bir proxy tanımlıyken de sonuç değişmedi.
Tek bir siteyi saniyede bir istekle taramak için nadiren proxy gerekir. Proxy, tarama çok sayıda host'a yayıldığında ve trafiğin tamamının tek bir IP'den çıkmaması gerektiğinde işe yarar: Rotating Proxy her isteğe ya da her host'a farklı bir çıkış IP'si verir. Kısa ve sabit bir hedef listesi için çoğu zaman Datacenter Proxy yeterlidir. Datacenter IP'leri varsayılan olarak hedef site kısıtlamasıyla teslim edilir; bütün sitelere erişimi sipariş sırasında ayrıca seçmeniz gerekir. Döndürme kodunu Python'da Proxy'ler Nasıl Döndürülür? yazımızda bulabilirsiniz.
Rotating residential proxy trafiği GB başına ücretlendirilir, bu yüzden önce kısa bir çalıştırmada html_bytes değerini ölçün. İki deneme sitesi de HTML'i sıkıştırmadan gönderdi: books sayfası başına yaklaşık 34 KB, quotes sayfası başına 5 KB. 10.000 sayfa kabaca 0,34 GB ya da 0,05 GB eder, buna header'lar da eklenir. Bekleme süresi ve robots.txt kuralları, çıkış IP'si hangisi olursa olsun geçerlidir. IP döndürmek, bir siteye izin verdiğinden fazla istek göndermenin gerekçesi olamaz.
Kullanım alanları
- Kırık iç bağlantılar: çıktıyı
404durum koduna göre süzün (web crawler). - Scraping öncesi URL listesi: önce tarayın, sonra yalnız ürün ya da makale sayfalarından veri çekin (veri kazıma).
- Rakiplerdeki yeni ürünler: bu haftanın URL listesini geçen haftanınkiyle karşılaştırın (E-Ticarette Rakip Fiyat Takibi Nasıl Yapılır?).
- Sitemap'teki eksikler: crawler'ın bulduğu ama sitemap'te olmayan sayfalar (Sitemap Nasıl Bulunur?).
- Bilinen sayfalardaki görseller: önce sayfaları listeleyin, sonra görselleri indirin (Sayfadaki Tüm Resimleri İndirme).
- Bulunan sayfalardan veri çekme: başlık ve fiyat gibi alanları aynı HTML'den okuyun (BeautifulSoup Nedir ve Python'da Nasıl Kullanılır?).
Sık yapılan hatalar
- Kuyruk olarak
list.pop(0)kullanmak. Her çağrı bütün listeyi kaydırır. - Her bağlantı için özyineleme. Tarama derinlik öncelikli hâle gelir ve
RecursionErrorile bitebilir. - URL'leri ancak indirdikten sonra görüldü diye işaretlemek. Aynı adres kuyruğa defalarca girer.
- Sorgu dizesini tamamen silmek.
?page=2ve sonraki bütün sayfalar kaybolur. - Göreli bağlantıları ilk istenen URL'ye göre tamamlamak. Yönlendirmeden sonra temel adres
r.urlolur. - Zaman aşımı koymamak. Bu durumda Requests süresiz bekleyebilir.
- PDF ve ZIP dosyalarını HTML diye ayrıştırmak. Önce
Content-Typeheader'ına bakın. - Sayfa tavanı koymamak. Filtreli ya da takvimli bir sitede çalışma hiç bitmez.
- Form doldurmak. Crawler sayfaları GET ile okur; veri göndermek başka bir iştir (Python Requests ile POST ve JSON).
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
| Tek bir sitede birkaç yüz sayfa ve işleyişi adım adım görmek | Bu yazıdaki betik |
| Uzun bir taramayı durduğu yerden sürdürmek | Diskte tutulan bir kuyruk: Sayfalama (Pagination) Nedir, Scraping'de Nasıl Taranır? yazısındaki SQLite sürümü |
| Aynı anda çok sayıda istek | Eşzamanlılık; ölçüsü Concurrency ve Parallelism yazısındaki gibi ayarlanır |
| Binlerce sayfa, hazır yeniden deneme ve dışa aktarma | Scrapy (CrawlSpider, proxy kurulumu) |
| Yalnız JavaScript çalıştıktan sonra görünen bağlantılar | Crawlee for Python'daki PlaywrightCrawler gibi tarayıcı tabanlı bir crawler ya da Crawl4AI |
| Site bir sitemap yayımlıyor | Önce onu okuyun, yalnız eksik kalanlar için tarayın (Sitemap Nasıl Bulunur?) |
| Çok sayıda host'a yayılan tarama | Host başına aynı ölçülü hızla Rotating Proxy |
Sıkça sorulan sorular
Web crawler için hangi Python kütüphanesini kullanmalıyım?
Birkaç yüz sayfa için indirmede Requests, bağlantıları okumada BeautifulSoup yeterli. Yeniden deneme, dışa aktarma ve zamanlama gereken binlerce sayfalık işlerde Scrapy sizi bu kodu yazmaktan kurtarır. JavaScript ile oluşturulan bağlantılar için tarayıcı tabanlı bir araç gerekir.
BeautifulSoup ile crawler yazılır mı, yoksa Scrapy mi gerekir?
Yazılır. BeautifulSoup bir ayrıştırıcıdır (parser): HTML'den bağlantıları okur, ama sayfa indirmez, kuyruk tutmaz ve istekler arasında beklemez. Yukarıdaki betik bu eksikleri 200 satırdan kısa bir kodla tamamlıyor. Scrapy'de bunlar hazır gelir; iş büyüdükçe bu avantaj ağır basar.
Python crawler JavaScript ile yüklenen bağlantıları görür mü?
Hayır. Requests betik çalıştırmaz, bu yüzden JavaScript'in eklediği bağlantılar BeautifulSoup'a hiç ulaşmaz. Önce sayfanın arkasında doğrudan çağırabileceğiniz bir JSON isteği arayın. Yoksa, sitenin kullanım şartları otomasyona izin veriyorsa tarayıcı tabanlı bir crawler kullanın.
Crawler'ı çok iş parçacıklı (multithreaded) yapmalı mıyım?
Yalnız birden fazla host tarıyorsanız işe yarar. Tek bir sitede hızı istekler arasındaki bekleme belirler; fazladan iş parçacıkları ya boşta bekler ya da bekleme kuralını bozar. Çok sayıda host'ta, her host için ölçülü hızda çalışan bir işçi (worker) işe yarar (Concurrency ve Parallelism).
Bir sitedeki bütün bağlantıları Python ile nasıl bulurum?
İşe sitemap ile başlayın; adresi çoğunlukla robots.txt'de yazar ya da /sitemap.xml altında bulunur. Sitemap yoksa derinlik sınırı ve sayfa tavanıyla buradaki gibi bir crawler çalıştırın. Sonucu tam liste olarak değil, bağlantılarla ulaşılabilen sayfaların listesi olarak değerlendirin.
Web crawler yazmak ve çalıştırmak yasal mı?
Bu bir hukuki tavsiye değildir. Cevap ülkenize, sitenin kullanım şartlarına, sayfaların kişisel veri içerip içermediğine ve kopyalarla ne yaptığınıza bağlı. robots.txt'ye uyun, hızı düşük tutun ve giriş gerektiren alanlardan uzak durun. Ülkelere göre durumu Web Scraping (Web Kazıma) Yasal mı? yazımızda anlattık.
Özet
Aynı sayfayı tekrar tekrar açmadan işini bitiren bir crawler için şunlar gerekir: genişlik öncelikli sıra için bir deque, kuyruğa eklerken doldurulan bir görülenler kümesi, her URL için tek yazım, yönlendirmelerden sonra kapsam kontrolü ve sayfa tavanıyla birlikte bir derinlik sınırı. robots.txt, host başına bekleme ve 429 gelince durma ilk sürümde olmalı. İş büyüdüğünde diskte tutulan bir kuyruğa, host'lar arası eşzamanlılığa ya da Scrapy'ye geçin. Çok sayıda siteye ya da ülkeye yayılan taramalarda seçenekleri proxy hizmetleri sayfamızda karşılaştırabilirsiniz.