Si tienes un sitio web, lo más probable es que llms.txt te haya llegado por una de dos vías. Un plugin de SEO se ofrece a generarlo «para que la IA te encuentre», o un informe de Lighthouse muestra «llms.txt no sigue las recomendaciones» bajo un apartado nuevo, Navegación agéntica. Luego lees que la Búsqueda de Google ignora el archivo. Las dos cosas son ciertas, y dejan de parecer contradictorias en cuanto ves para qué sirve el archivo.
Este artículo explica el formato, llms-full.txt y las versiones Markdown de las páginas, y en qué se diferencia el archivo de robots.txt y sitemap.xml. Mostramos parte de nuestro propio /llms.txt, revisamos lo que Google, Chrome, OpenAI y Anthropic han dicho a fecha de 5 de octubre de 2026 y terminamos con cómo crear uno.
¿Qué es llms.txt?
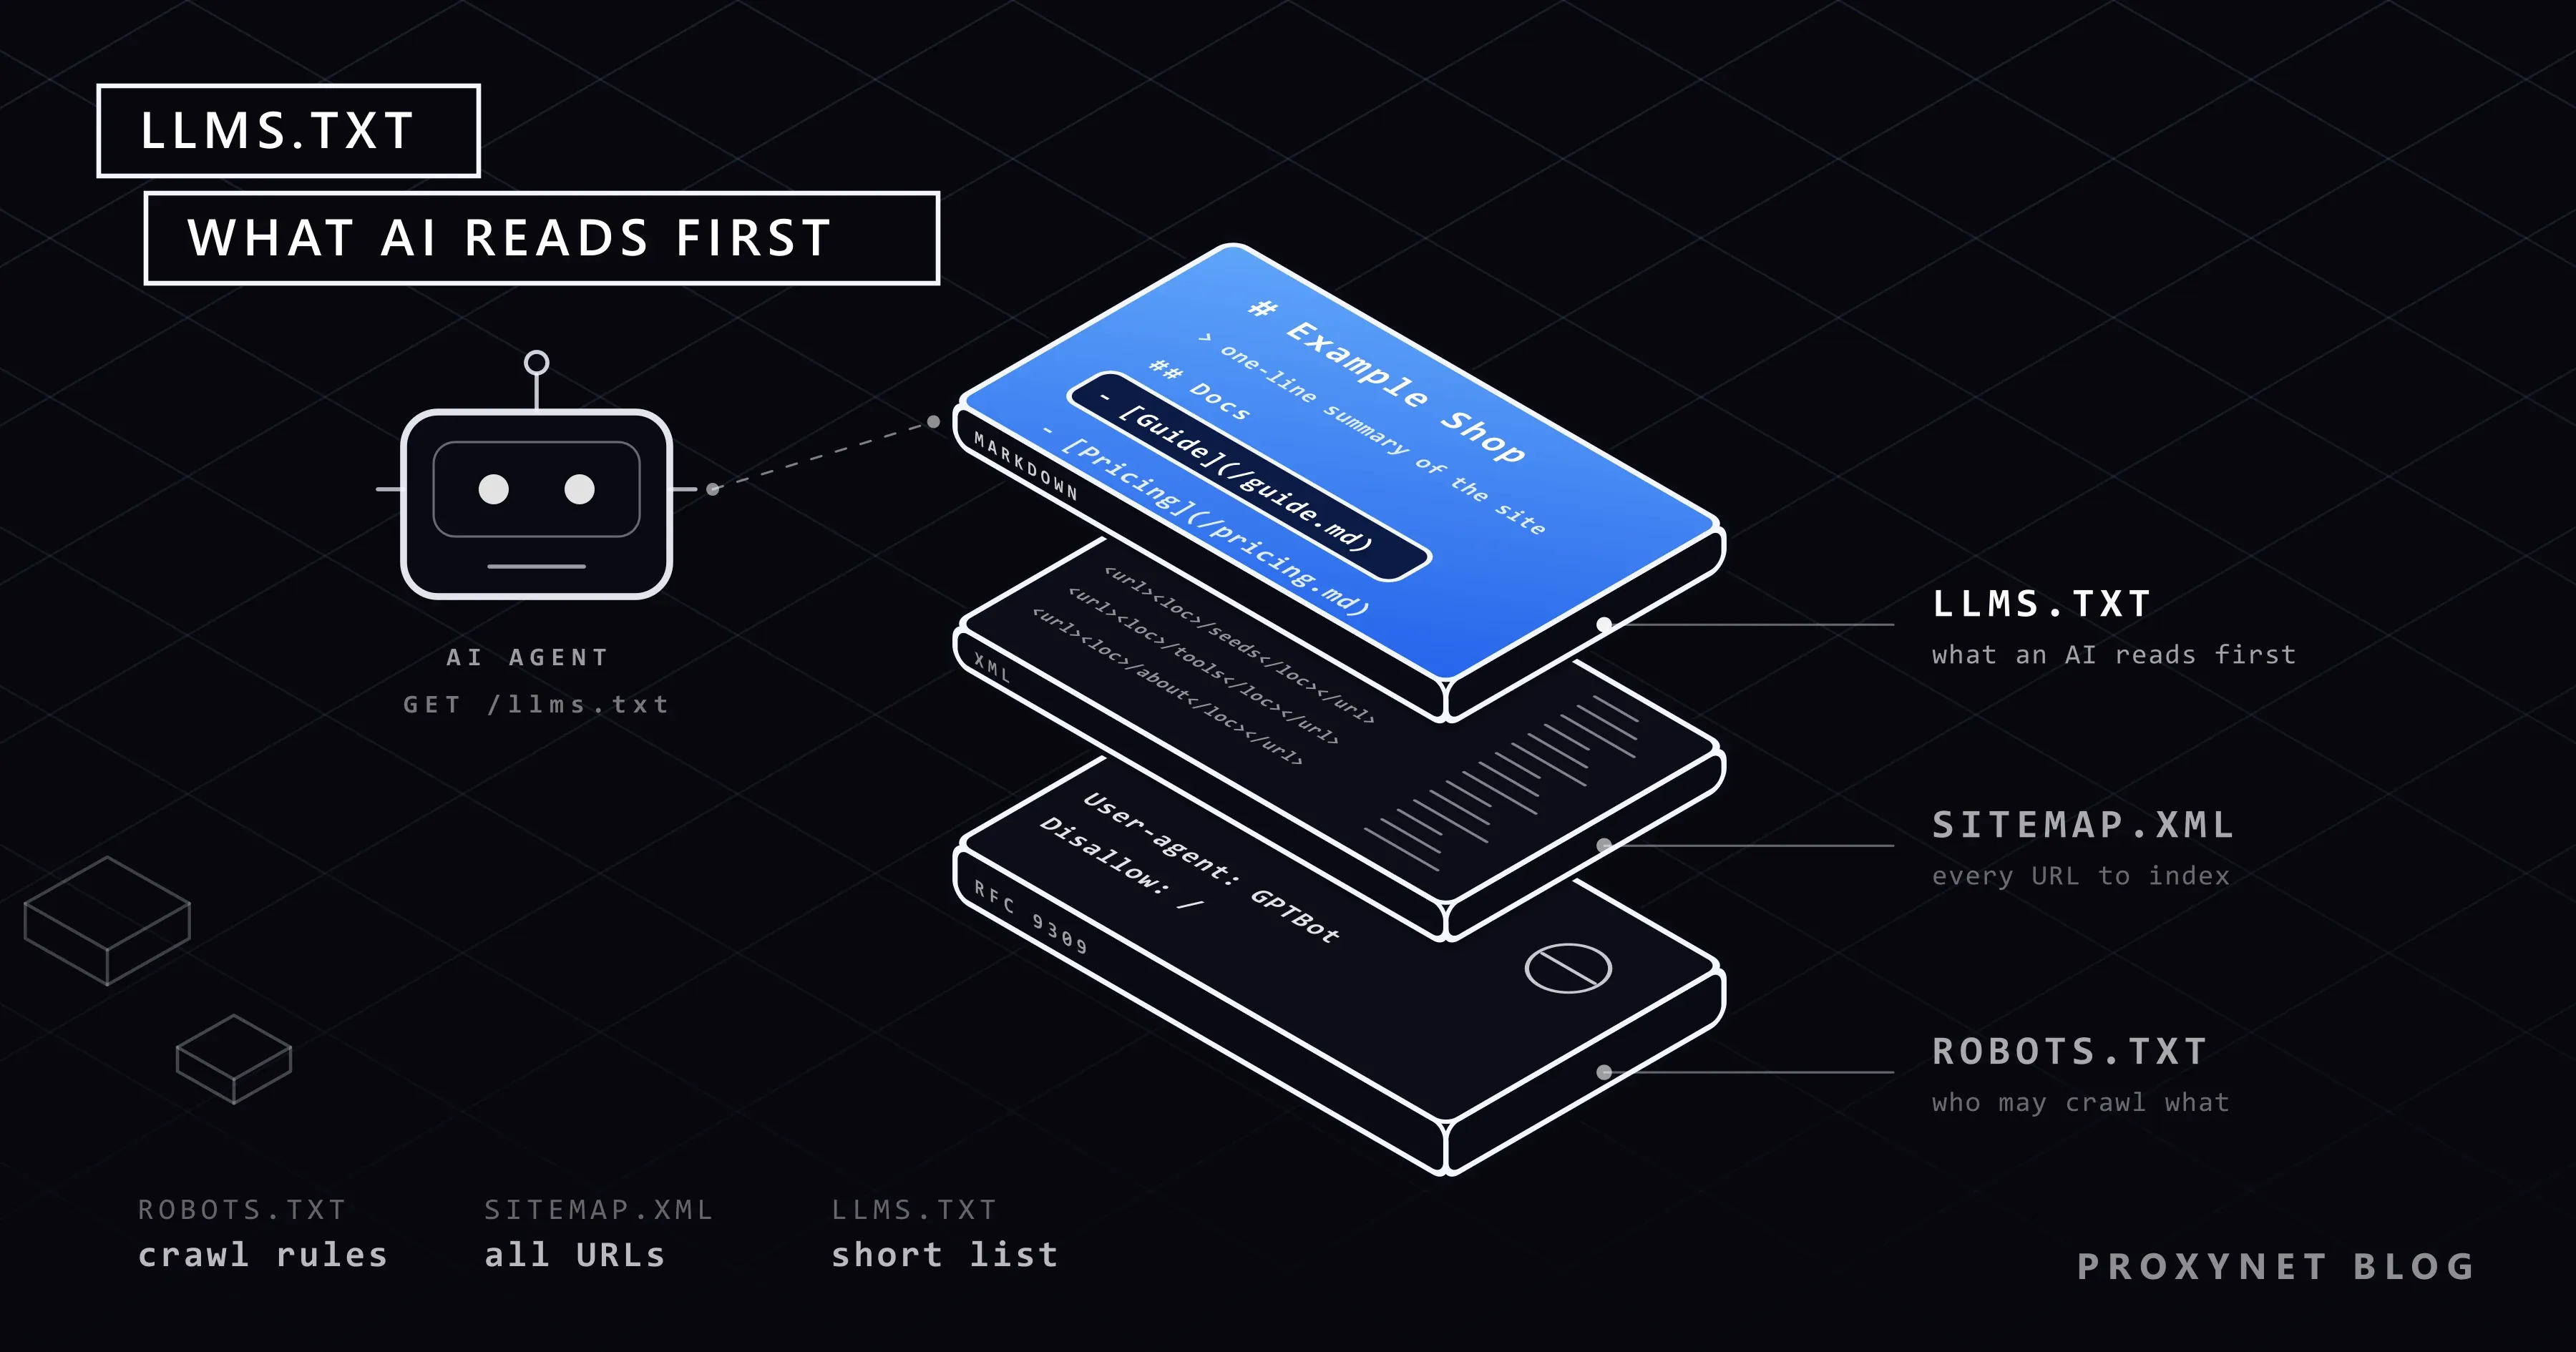
llms.txt es un archivo de texto escrito en Markdown que un sitio coloca en /llms.txt. Le dice a un modelo de lenguaje grande (LLM), el tipo de IA que hay detrás de ChatGPT, Claude y Gemini, qué es el sitio y qué páginas vale la pena leer. El problema que resuelve es el tamaño: un modelo solo puede tener en cuenta una cantidad limitada de texto a la vez, su ventana de contexto, y un sitio web entero, con sus menús y scripts, rara vez cabe en ella.
Jeremy Howard publicó la propuesta en llmstxt.org el 3 de septiembre de 2024; una segunda versión, con fecha del 10 de agosto de 2026, recoge dos años de adopción. El archivo está pensado para la inferencia, es decir, el momento en que un modelo genera una respuesta, y no para el entrenamiento: lo lee un asistente cuando un usuario pregunta algo, no un crawler que reúne material para el próximo modelo.
Es una convención, sin ningún RFC ni especificación del W3C detrás. Tampoco es un reglamento: nada en el archivo permite ni prohíbe el acceso a una página.
¿Cómo es un archivo llms.txt?
La propuesta fija el orden de las partes. Solo la primera es obligatoria:
- Un H1 con el nombre del sitio o del proyecto.
- Una cita en bloque (blockquote) con un breve resumen de los datos clave.
- Párrafos o listas sin encabezado para detalles como la organización del sitio.
- Secciones H2 con listas de enlaces, cada elemento un enlace Markdown con una nota opcional:
- [Nombre](url): nota. - Una sección llamada
Optional, por convención, para los enlaces que un agente puede saltarse si le falta espacio.
Así podría ser el archivo de una pequeña tienda online. La tienda y sus URL son inventadas:
# Jardinería Ejemplo

> Jardinería Ejemplo vende online semillas, herramientas de jardín y piezas de riego, y hace envíos a todos los países de la UE.

Cada página de producto muestra el stock por almacén. Las guías de cuidado las escribe nuestro propio equipo.

## Tienda

- [Semillas](https://example.com/semillas.md): semillas de hortalizas y flores, ordenadas por mes de siembra
- [Riego](https://example.com/riego.md): kits de goteo, programadores y recambios, con tablas de compatibilidad

## Ayuda

- [Envíos y devoluciones](https://example.com/envios.md): plazos de entrega por país, plazo de devolución y costos
- [Contacto](https://example.com/contacto): horario de atención por correo electrónico y teléfono

## Optional

- [Historia de la empresa](https://example.com/sobre-nosotros.md)
Las notas importan: un agente elige un enlace solo por su nombre y su nota, así que «plazos de entrega por país, plazo de devolución y costos» funciona mucho mejor que un simple «Envíos».
Un ejemplo real: nuestro propio /llms.txt
Nuestro llms.txt, en proxynet.io/llms.txt, nunca se edita a mano: un script lo genera en cada build a partir de los mismos datos con los que se crean las páginas, así que no puede faltar ningún artículo nuevo del blog. Empieza con # Proxynet y un blockquote de cuatro líneas sobre quiénes somos, qué vendemos y cómo funciona la facturación. La primera sección, en inglés, empieza así:
## Company

- [Homepage](https://proxynet.io): overview of all proxy types, the network and the panel
La última sección usa la convención Optional:
## Optional

- [Proxynet (Deutsch)](https://proxynet.io/de): site home in Deutsch
- [Blog (Deutsch)](https://proxynet.io/de/blog): blog index in Deutsch; every post is also available as plain Markdown by adding .md to its URL
Las páginas en inglés y en turco se enumeran una a una; los otros cuatro idiomas siguen la estructura inglesa, así que van en Optional. Los artículos del blog aparecen con su dirección .md, una copia en Markdown plano que se sirve con la cabecera X-Robots-Tag: noindex para que nunca compita en los buscadores con la página real. Como cada artículo figura en dos idiomas, el archivo contiene varios cientos de enlaces; a la mayoría de los sitios les va mejor con una o dos páginas.
Nuestra primera versión, escrita a mano, recibió en PageSpeed Insights el aviso «llms.txt no sigue las recomendaciones». Todos los enlaces eran URL sueltas, así que la comprobación de enlaces Markdown no encontró ninguno; además, anidaba listas bajo encabezados H3 y tenía dos URL de marcador de posición que devolvían 404. Generar el archivo automáticamente resolvió los tres problemas.
llms-full.txt y versiones Markdown de las páginas
llms.txt es un índice que apunta a páginas. A su lado suelen aparecer dos acompañantes.
Versiones Markdown. La propuesta pide a los sitios que ofrezcan una copia limpia en Markdown de las páginas útiles en la misma dirección con .md añadido (/guide.html.md, o /guide/index.html.md cuando la dirección no tiene nombre de archivo). Markdown conserva encabezados, listas, tablas y enlaces, pero descarta la navegación y los scripts, así que el contenido ocupa mucho menos espacio en la ventana de contexto. La versión 2 añade una forma de encontrar las copias: un enlace rel="alternate" de tipo text/markdown, en el HTML de la página o en una cabecera HTTP Link. Nuestros artículos del blog llevan esa etiqueta.
Si tu sitio está detrás de Cloudflare, Markdown for Agents hace algo parecido sin archivos aparte: cuando un cliente envía Accept: text/markdown, Cloudflare convierte la página HTML a Markdown. Es un interruptor en AI Crawl Control (control del rastreo por IA), disponible en los planes Pro, Business y Enterprise.
llms-full.txt. No forma parte de la propuesta; es una convención de las plataformas de documentación: el texto completo de la documentación en un solo archivo. La documentación para desarrolladores de Anthropic publica ambos, y su llms.txt termina con un enlace a llms-full.txt. Encaja con una referencia de API que un asistente de programación lee de principio a fin; para una tienda basta con el índice.
llms.txt vs. robots.txt vs. sitemap.xml
Los tres archivos están uno junto a otro en la raíz del sitio, pero responden a preguntas distintas:
| robots.txt | sitemap.xml | llms.txt | |
|---|---|---|---|
| Pregunta | ¿Qué rutas pueden rastrear los bots? | ¿Qué URL existen? | ¿Qué debe leer primero una IA? |
| Lector principal | Crawlers de buscadores y de IA | Motores de búsqueda | Asistentes y agentes de IA |
| Formato | Reglas en texto plano | XML | Markdown |
| Estado | Estándar (RFC 9309) | Protocolo Sitemaps | Propuesta de la comunidad |
| ¿Controla el acceso? | Pide a los crawlers que no entren | No | No |
| Alcance | Solo reglas | Todas las páginas que se deben indexar | Una selección breve |
robots.txt está definido en el RFC 9309, que deja claro que sus reglas no son una forma de autorización de acceso: los crawlers bien hechos las respetan, pero nada obliga a cumplirlas. Nuestra guía de robots.txt explica cada regla.
Un sitemap enumera todas las URL que quieres que encuentren los buscadores, hasta 50.000 por archivo según el protocolo Sitemaps; cómo encontrar el sitemap de una web muestra dónde buscarlo. El sitemap aspira a ser completo y no lleva notas, mientras que llms.txt es selectivo a propósito.
¿Funciona llms.txt?
Depende de quién esperes que lo lea. Esto es lo que ha dicho o lanzado cada empresa, comprobado el 5 de octubre de 2026.
Búsqueda de Google: ningún efecto. La guía de optimización para IA de Google, publicada el 15 de mayo de 2026, dice que no necesitas archivos nuevos legibles por máquina ni Markdown para aparecer en la Búsqueda, tampoco en sus funciones de IA generativa. Una nota añadida el 15 de junio de 2026 aclara que llms.txt no ayudará ni perjudicará la visibilidad ni el posicionamiento, porque la Búsqueda de Google ignora estos archivos.
Lighthouse de Chrome: una comprobación de formato. Lighthouse, la herramienta de auditoría de Chrome DevTools y PageSpeed Insights, tiene una categoría nueva, Navegación agéntica (Agentic Browsing), que la página de puntuación de Chrome califica de experimental (Chrome 150 o posterior, sin puntuación de 0 a 100). La página de la auditoría de llms.txt tiene fecha del 5 de mayo de 2026, y el código fuente muestra la prueba completa: una línea que empiece por # , al menos un enlace Markdown y al menos 50 caracteres. Un 404 la deja como no aplicable; un error del servidor la hace fallar. Comprueba el formato, no si alguna IA usa el archivo.
OpenAI: robots.txt para los crawlers. La documentación de crawlers de OpenAI describe OAI-SearchBot (búsqueda de ChatGPT), GPTBot (entrenamiento), OAI-AdsBot y ChatGPT-User (acciones que inicia un usuario) y cómo gestionarlos en robots.txt. OpenAI publica un llms.txt para su propia documentación para desarrolladores, pero no ha dicho que sus crawlers lean los archivos de otros sitios.
Anthropic: robots.txt para los crawlers. El artículo de ayuda de Anthropic sobre el rastreo, actualizado el 7 de abril de 2026, enumera ClaudeBot (entrenamiento), Claude-User (páginas que se obtienen cuando un usuario lo pide) y Claude-SearchBot (calidad de búsqueda), todos controlados mediante robots.txt. No menciona llms.txt, aunque la documentación para desarrolladores de Anthropic publica uno.
Así que ninguna de estas empresas usa llms.txt como señal para rastrear, posicionar o citar, mientras que los laboratorios de IA lo publican para su propia documentación. El uso que se sostiene es la lectura bajo demanda: un asistente de programación abre el llms.txt de una biblioteca para encontrar la página correcta, o un agente enviado a tu sitio lo lee en lugar de adivinar a partir del menú. Un archivo de texto no ejecuta ningún script de seguimiento, así que busca las peticiones a /llms.txt en los registros del servidor, no en tu herramienta de analítica.
robots.txt controla los crawlers de IA, no llms.txt
llms.txt no puede decir a las empresas de IA qué pueden usar. Dejar fuera una página no la oculta, y enumerarla no concede ningún permiso. Los crawlers consultan robots.txt, con un grupo por User-Agent:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Los dos primeros grupos piden a los crawlers de entrenamiento de OpenAI y Anthropic que no entren. Google-Extended controla si Google puede usar tu contenido para entrenar los modelos Gemini y para el grounding, es decir, para basar sus respuestas en fuentes; la documentación de crawlers de Google dice que no afecta a la inclusión ni al posicionamiento en la Búsqueda. Los crawlers de búsqueda como OAI-SearchBot y Claude-SearchBot tienen sus propios tokens, así que un sitio puede seguir apareciendo en la búsqueda con IA y, a la vez, excluirse del entrenamiento. Nuestro propio robots.txt permite de forma explícita GPTBot, ClaudeBot y Google-Extended; decidas lo que decidas, la decisión va en robots.txt.
Cómo crear un archivo llms.txt
- Elige las páginas que responden a lo que un cliente le preguntaría a un asistente sobre ti: productos o servicios, precios, documentación, políticas, contacto.
- Escribe el H1 y el blockquote con los datos que un modelo tendría que adivinar: qué ofreces, a quién y dónde.
- Agrupa los enlaces bajo encabezados H2 con el formato
- [Nombre](url): nota, con URL completas, y pasa las páginas secundarias a## Optional. - Enlaza versiones Markdown de las páginas si puedes ofrecerlas.
- Sube el archivo a la raíz para que
https://tudominio.com/llms.txtresponda con un estado 200 como texto plano; después ejecuta Lighthouse en Chrome DevTools o en PageSpeed Insights y busca la línea de llms.txt en Navegación agéntica. - Mantenlo al día, o genéralo automáticamente. Un enlace obsoleto lleva a un agente a un 404.
Generadores, plugins y plataformas
- WordPress. Algunos plugins de SEO crean y actualizan el archivo. En Yoast SEO es un interruptor en Yoast SEO › Settings (Ajustes) › Características del sitio, dentro del grupo AI tools (herramientas de IA; el plugin en español también lo muestra en inglés), según la página de ayuda de Yoast, y no está disponible en multisitio. llmstxt.org también menciona AIOSEO.
- Shopify. Desde una entrada del registro de cambios del 28 de mayo de 2026, todas las tiendas sirven un
/agents.mdpredeterminado, y/llms.txty/llms-full.txtapuntan al mismo contenido. Para cambiarlo, se añade en el editor de código del tema una plantillatemplates/agents.md.liquido unllms.txt.liquidaparte. - Plataformas de documentación y creadores de sitios. llmstxt.org menciona Mintlify, GitBook y Wix entre las plataformas que generan el archivo, además de plugins para VitePress, Docusaurus y Drupal.
- Los generadores online rastrean tu sitio y preparan un borrador. Tómalo como punto de partida: un crawler no puede saber qué páginas importan a tus clientes.
- Tu propio build. Si el sitio se genera a partir de datos estructurados, como el nuestro, genera el archivo en el build para que no se desfase.
Quién lee llms.txt y cómo deberían leerlo los agentes
- Documentación de API y de software. Los asistentes de programación leen la documentación bajo demanda, a menudo mediante herramientas conectadas por MCP (Model Context Protocol). Aquí es donde nació llms.txt.
- Tiendas y sitios de reservas. Los agentes que comparan productos necesitan los datos de tus páginas; por qué los sitios bloquean a los agentes de compra con IA explica cómo los tratan los sitios.
- Sitios que la gente visita con navegadores con IA, que leen las páginas de forma muy parecida a los agentes; consulta ¿Qué es un navegador con IA?.
- Equipos que crean agentes. El llms.txt de un sitio es una primera petición barata que indica adónde ir después; cómo funcionan los agentes de IA explica el ciclo.
Si eres tú quien crea el agente, lee primero robots.txt: un enlace en llms.txt no anula un Disallow para tu User-Agent. Trata el archivo como una entrada no confiable que puede traer inyección de prompts, es decir, instrucciones ocultas en el contenido; acceso web seguro para LLM trata las listas de permitidos y los límites de solicitudes. Identifica tu bot con un User-Agent claro. Para recopilar páginas públicas a gran escala, nuestras páginas de rastreador web y extracción de datos muestran el lugar de los proxies en un crawler que sigue estas reglas.
Errores comunes
- URL sueltas en lugar de enlaces Markdown. Lighthouse informa «Parece que el archivo no contiene ningún enlace.», como le pasó a nuestra primera versión.
- Usarlo para bloquear el entrenamiento de IA. Solo los grupos de robots.txt transmiten esa petición.
- Pegar el sitemap dentro. Miles de URL sin notas no le dan a un agente ningún motivo para preferir una página.
- Enlaces de marcador de posición o rotos, como variables de plantilla tipo
{slug}o páginas que ahora devuelven 404. - Un servidor que responde con HTML. Algunas configuraciones devuelven la página de inicio para cualquier ruta desconocida; la respuesta no tiene encabezado Markdown y Lighthouse avisa de que falta el H1.
- Escribirlo una vez y olvidarlo. Un resumen desactualizado es justo lo que un asistente va a repetir.
Guía de decisión
| Tu situación | Qué hacer |
|---|---|
| Quieres más tráfico de Google, incluidos los AI Overviews | Para este objetivo, prescinde de llms.txt; trabaja el contenido, el rastreo y la indexación |
| Tienes documentación de API o de producto | Publica llms.txt con versiones Markdown; valora llms-full.txt |
| Tienes un sitio WordPress | Actívalo en tu plugin de SEO y luego recorta a mano la lista de enlaces |
| Tienes una tienda Shopify | Edita el agents.md predeterminado con una plantilla del tema |
| Quieres mantener fuera a los crawlers de entrenamiento de IA | Añade a robots.txt grupos para GPTBot, ClaudeBot y Google-Extended |
| Lighthouse dice «llms.txt no sigue las recomendaciones» | Añade un H1, usa enlaces Markdown y sirve el archivo como texto con estado 200 |
Preguntas frecuentes
¿llms.txt ayuda al SEO?
En la Búsqueda de Google, no. La guía de optimización para IA de Google dice que la Búsqueda ignora los archivos llms.txt, así que no ayudan ni perjudican al posicionamiento ni a las funciones de IA. Cualquier beneficio viene de las herramientas de IA que leen el archivo bajo demanda.
¿ChatGPT y Claude leen llms.txt?
Ni OpenAI ni Anthropic han dicho que sus crawlers usen llms.txt; ambas documentan robots.txt como mecanismo de control. Aun así, un asistente puede abrir el archivo cuando un usuario o una herramienta le piden que consulte esa dirección.
¿Puede llms.txt bloquear los crawlers de IA o el entrenamiento?
No, el archivo no contiene reglas. Para pedir a un crawler que no entre, añade a robots.txt un grupo para el token de su User-Agent.
¿Dónde se pone llms.txt?
En la raíz del dominio, para que se abra en https://example.com/llms.txt. La propuesta también admite una subcarpeta como /docs/llms.txt que cubra solo las páginas que hay por debajo, algo útil cuando solo controlas una parte de un dominio.
¿Qué diferencia hay entre llms.txt y llms-full.txt?
llms.txt es un índice breve de enlaces. llms-full.txt reúne el texto completo de las páginas en un solo archivo; es una convención de las plataformas de documentación, no parte de la propuesta.
¿Existe un validador o comprobador de llms.txt?
Lo más parecido a una comprobación oficial es la auditoría de llms.txt de Lighthouse. Solo comprueba un H1, al menos un enlace Markdown, una longitud mínima y una respuesta correcta del servidor, no si tus enlaces son los adecuados.
En resumen
llms.txt es un índice en Markdown para herramientas de IA: un nombre, un resumen y enlaces seleccionados. Es una propuesta, no un estándar, y no controla nada; quien sigue diciendo a los crawlers de IA qué pueden obtener es robots.txt. La Búsqueda de Google lo ignora y Lighthouse solo comprueba su formato, así que su valor está en la documentación, las tiendas y los servicios que los agentes leen en nombre de un usuario. Mantén el tuyo breve y genéralo a partir de los datos de tu sitio. Si creas agentes o crawlers que leen páginas públicas, consulta nuestros servicios de proxy.