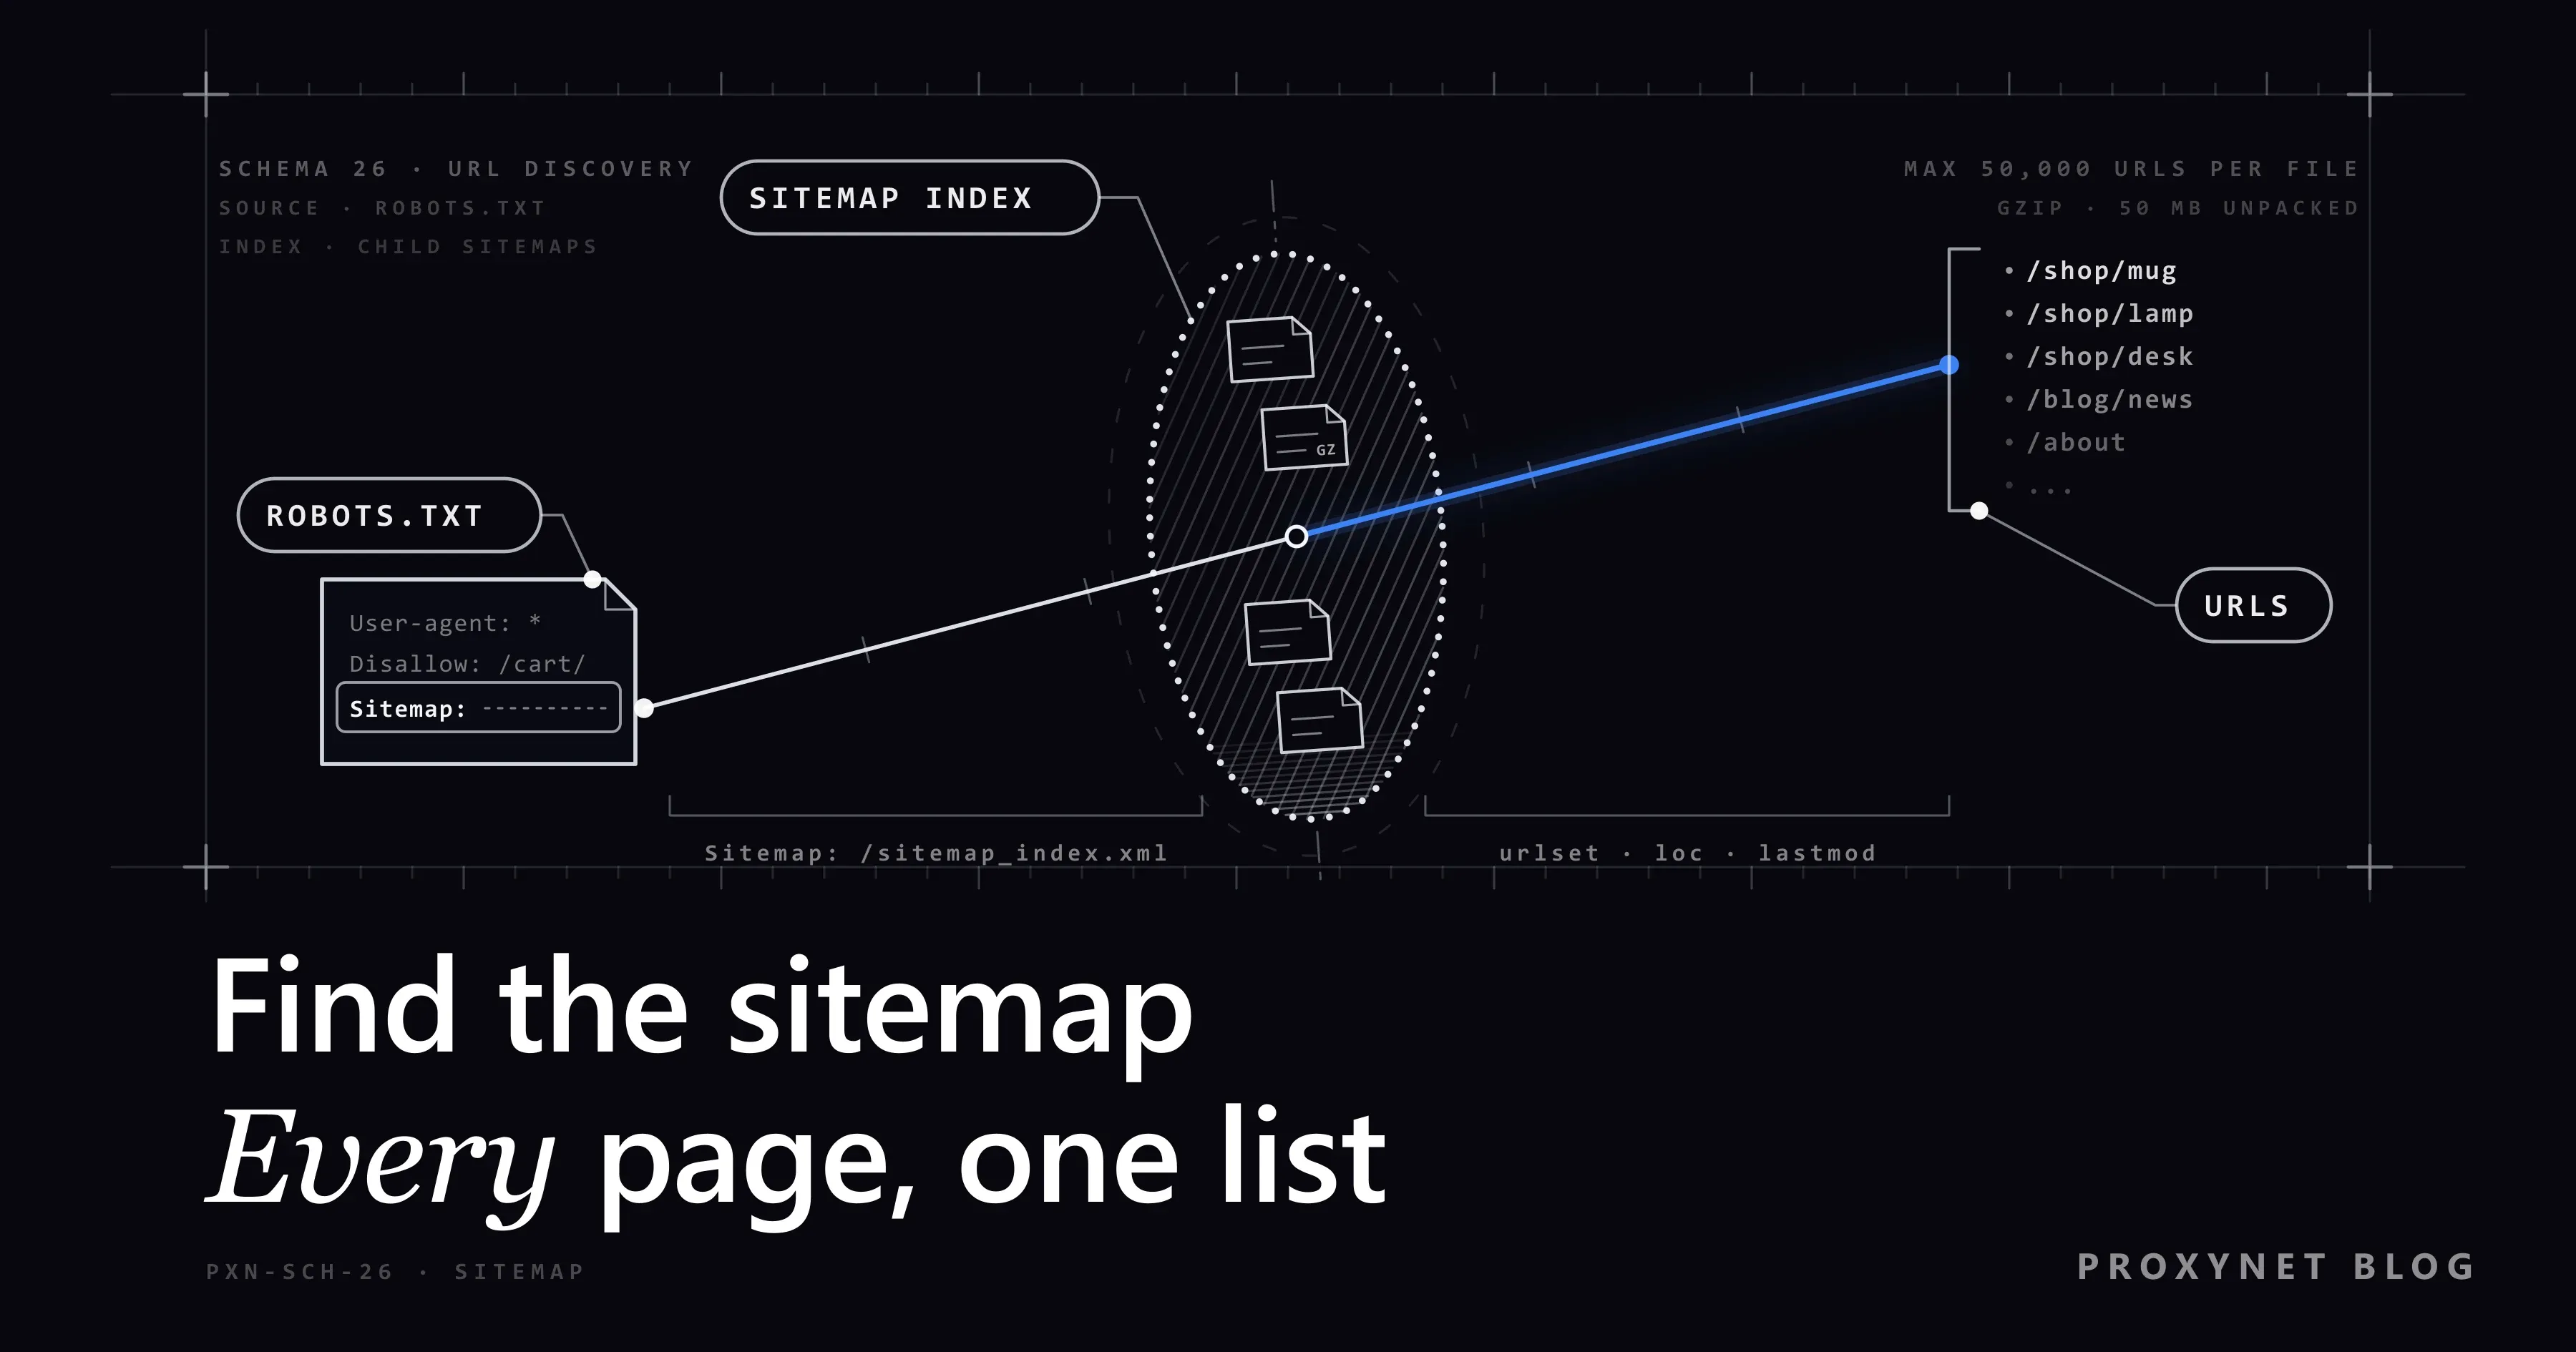
Sie brauchen eine Liste aller Produktseiten im Onlineshop eines Wettbewerbers. Sich durch jede Kategorie zu klicken, würde Stunden und Tausende Anfragen kosten. Vielleicht veröffentlicht der Betreiber diese Liste für Suchmaschinen aber bereits in einer einzigen XML-Datei: der Sitemap, einer Datei mit den Adressen, die die Website gecrawlt haben möchte. Wenn Sie sie finden, sehen Sie mit wenigen Anfragen alle Seiten einer Website.
Dieser Leitfaden zeigt, wo und in welcher Reihenfolge Sie nach einer Sitemap suchen, wie Sie die Datei lesen, wie Sie Indizes und .gz-Dateien öffnen und wie Sie mit lastmod nur die geänderten Seiten auswählen. Am Ende stehen ein getestetes Python-Skript, die Gründe, warum eine Sitemap nie die ganze Website zeigt, und die Wege, wenn es keine gibt. Den größeren Rahmen für den Aufbau eines Crawlers zeigt unsere Seite zum Web-Crawler.
Wie finden Sie die Sitemap einer Website?
Probieren Sie diese Stellen der Reihe nach aus. Jeder Schritt kostet eine Anfrage.
- Die
Sitemap:-Zeilen in robots.txt. Öffnen Siehttps://example.com/robots.txt. Betreiber tragen dort die vollständige Adresse jeder Sitemap ein. RFC 9309 erlaubt Crawlern, diese Zeilen als Eintrag außerhalb des robots.txt-Protokolls auszuwerten (Abschnitt 2.2.4); die übrige Syntax erklärt Was ist robots.txt und wie liest man die Datei?. - Die Pfade im Stammverzeichnis. Probieren Sie
/sitemap.xml, dann/sitemap_index.xml. Die meisten Generatoren verwenden einen der beiden. - Der Pfad der Plattform. Seit Version 5.5 veröffentlicht der WordPress-Kern einen Index unter
/wp-sitemap.xmlund trägt ihn in robots.txt ein (Ankündigung zu WordPress 5.5). SEO-Plugins wie Yoast ersetzen ihn durch einen eigenen Index, meist/sitemap_index.xml. Shopify liefert unter/sitemap.xmleine Datei aus, die auf getrennte Sitemaps für Produkte, Kollektionen, Blogs und Seiten verweist. - Die HTML-Sitemap. Eine Seite „Sitemap“ im Footer ist für Menschen geschrieben, zeigt aber die Hauptbereiche.
- Search Console, für Ihre eigene Website. Der Bericht „Sitemaps“ listet, was Sie eingereicht haben und wie viele URLs Google in jeder Datei gefunden hat.
Auch eine einmal von Hand in Google eingegebene Suche nach site:example.com filetype:xml kann helfen. Automatisieren Sie sie nicht: Google wertet per Skript gesendete Suchanfragen als ungewöhnlichen Datenverkehr (Google meldet ungewöhnlichen Datenverkehr).
Wie lesen Sie eine Sitemap-Datei: urlset, sitemapindex und lastmod
Eine Sitemap mit zwei Seiten sieht so aus:
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
<url>
<loc>https://example.com/product/1</loc>
<lastmod>2026-09-21T12:00:00+00:00</lastmod>
</url>
<url>
<loc>https://example.com/product/2?colour=red&size=m</loc>
</url>
</urlset>Das Sitemap-Protokoll verlangt nur <loc>; <lastmod>, <changefreq> und <priority> sind optional. Google ignoriert die letzten beiden und nutzt lastmod nur, wenn der Wert durchgängig und nachprüfbar stimmt (Google Search Central). Vier weitere Regeln zählen, wenn Sie die Datei einer fremden Website lesen:
- Eine Datei enthält höchstens 50.000 URLs und unkomprimiert 50 MB (52.428.800 Byte).
- Die Datei ist UTF-8-kodiert, und
&wird als&geschrieben. Ein XML-Parser wandelt es zurück, ein regulärer Ausdruck nicht. - Eine Sitemap unter
/catalog/sitemap.xmldarf nur Adressen unterhalb von/catalog/auflisten. - Zeilen mit
<xhtml:link hreflang="…">verweisen auf Sprachversionen einer Seite; sie sind keine<loc>-Einträge.
Wie kommen Sie von einer Sitemap zu allen URLs?
Ein Skript, das aus einer Domain eine URL-Liste macht, arbeitet so:
- Laden Sie robots.txt einmal herunter; behalten Sie die Regeln und die
Sitemap:-Zeilen. - Ohne
Sitemap:-Zeile probieren Sie die üblichen Pfade und hören beim ersten200auf. - Laden Sie die Datei herunter. Sind ihre ersten zwei Bytes
1f 8b, entpacken Sie sie mit gzip. - Prüfen Sie das Wurzelelement. Bei
sitemapindexwiederholen Sie Schritt 3 für jedes untergeordnete<loc>; beiurlsetsammeln Sie die Einträge. - Mit einer Datumsgrenze verwerfen Sie ältere Einträge und überspringen Teil-Sitemaps, deren
lastmodim Index älter ist. - Prüfen Sie jede Adresse gegen robots.txt und überspringen Sie gesperrte.
- Entfernen Sie Duplikate und stellen Sie den Rest in die Warteschlange. Wie Sie die Warteschlange auf der Festplatte halten, damit ein abgebrochener Lauf weitermachen kann, zeigt Was ist Paginierung und wie scrapen Sie alle Seiten?.
Ein Crawler baut dieselbe Art von Liste auf, indem er Links folgt, mit einer Anfrage pro Seite und Regeln für Tiefe und Duplikate. Den Unterschied erklärt Web Scraping vs. Web Crawling.
Methoden zur URL-Ermittlung im Vergleich
| Methode | Last für die Website | Was sie zeigt | Angaben zu Änderungen | Wann einsetzen |
|---|---|---|---|---|
| XML-Sitemap | Sehr gering: wenige Dateien | Adressen, die der Betreiber gecrawlt haben möchte; unter Umständen unvollständig | lastmod, falls korrekt | Immer zuerst |
| RSS- oder Atom-Feed | Sehr gering | Nur neue Inhalte | Veröffentlichungsdaten | Blogs, Nachrichten, neue Angebote |
| Offizielle API oder Export | Gering, dokumentierte Limits | Was die API anbietet | Meist | Wenn angeboten; vor HTML |
| Links folgen | Hoch: eine Anfrage pro Seite | Alles Verlinkte, einschließlich Fallen und Duplikaten | Keine | Keine Sitemap oder Lücken; mit Tiefenlimit |
| Wayback CDX API | Keine (Anfragen gehen an das Archiv) | Archivierte Adressen; manche gibt es nicht mehr | Erfassungsdatum | Keine Sitemap; Kandidatenliste |
| Google Search Console | Keine | Seiten, die Google kennt | Crawling- und Indexierungsstatus | Nur die eigene Website |
Die Sitemap kommt zuerst: Wenige Anfragen liefern die meisten Adressen.
Wie öffnen Sie Sitemap-Indizes und .gz-Dateien?
Große Websites teilen ihre Liste nach Typ auf. Der Index hat <sitemapindex> als Wurzelelement und ein <sitemap>-Element pro Teil-Sitemap, jeweils mit einem <loc> und einem optionalen <lastmod>. Googles Leitfaden zu großen Sitemaps verlangt, dass die Teil-Sitemaps auf derselben Website liegen, im Verzeichnis des Index oder darunter. Ein Skript sollte sich trotzdem merken, welche Dateien es schon geöffnet hat, damit ein Index, der auf sich selbst verweist, es nicht in einer Schleife festhält.
Komprimierte Dateien enden meist auf .xml.gz, und Server senden sie oft als application/gzip ohne Content-Encoding-Header. Requests gibt Ihnen dann die komprimierten Bytes unverändert zurück; in unserem lokalen Test begann der Body mit 1f 8b, der gzip-Signatur. Die Prüfung dieser zwei Bytes funktioniert unabhängig vom Dateinamen.
Die 50-MB-Grenze gilt für die unkomprimierte Datei, hören Sie also dort mit dem Lesen auf. Das schützt Sie auch vor einer Dekompressionsbombe, einer kleinen Datei, die sich auf mehrere Gigabyte ausdehnt; Pythons Sicherheitshinweise zu XML führen sie neben Angriffen durch Entity-Expansion auf.
Mit lastmod nur geänderte Seiten abrufen
lastmod verwendet das Format W3C Datetime: ein Datum (2026-09-20) oder ein Datum mit Uhrzeit und Zeitzone (2026-09-20T10:00:00+03:00). Ab Python 3.11 liest datetime.fromisoformat() beides, auch mit einem abschließenden Z. Behandeln Sie Werte ohne Zeitzone als UTC, damit sich alle Daten miteinander vergleichen lassen.
Behalten Sie die Einträge, die sich seit Ihrem letzten Lauf geändert haben, und dazu die Einträge mit fehlendem oder fehlerhaftem lastmod: Nichts zeigt, dass sie gleich geblieben sind. In einem Index gibt lastmod an, wann sich die jeweilige Teil-Sitemap geändert hat. Eine ältere Teil-Sitemap lässt sich also überspringen, ohne sie herunterzuladen. In unserem Test mit einer Grenze von 30 Tagen übersprang das Skript eine Datei, die zuletzt im Januar 2025 geändert worden war, und kam mit drei statt vier Anfragen aus.
Ob die Daten etwas aussagen, hängt von der Website ab:
- Überall dasselbe Datum und dieselbe Uhrzeit: Die Sitemap wird bei jedem Deployment neu erzeugt, und das Datum sagt nichts über die Seiten.
- Keine Daten: Am 24. September 2026 hatte keiner der Einträge in der Sitemap von docs.python.org ein
lastmod. - Einige Daten: Der WordPress-Kern schreibt für die Dateien in seinem Index kein
lastmod, also muss jede Teil-Sitemap geöffnet werden. Seit WordPress 6.5 haben Beitragseinträge eines; die Sitemaps für Kategorien, Schlagwörter und Autoren nicht.
Wo lastmod versagt, helfen bedingte Anfragen und 304 Not Modified, beschrieben in Web Scraping ohne Sperren: Daten regelkonform erfassen.
Warum unterscheidet sich eine Sitemap von dem, was die Website tatsächlich ausliefert?
Für Google ist eine eingereichte Sitemap nur ein Hinweis. Rechnen Sie mit fünf Arten von Abweichungen:
- Fehlende Seiten. Am 24. September 2026 listete
docs.python.org/sitemap.xml8 URLs auf, eine Startseite pro Python-Version, während die Website Tausende Seiten ausliefert. - Veraltete Einträge. Gelöschte Produkte bleiben stehen und liefern
404oder410. Streichen Sie sie aus Ihrer Liste. - Konflikte mit robots.txt. Eine Adresse kann in der Sitemap stehen und in robots.txt gesperrt sein. robots.txt ist die ausdrückliche Regel des Betreibers, überspringen Sie die Adresse also; in unserem Test wurde eine aufgeführte Suchseite auf diese Weise übersprungen.
- Geltungsbereich. Eine Sitemap in einem Unterverzeichnis deckt nur dieses Verzeichnis ab, und jede Subdomain hat ihre eigene robots.txt und Sitemap.
- Varianten. Tracking-Parameter, Sprachversionen und Seiten, deren Canonical-Tag auf eine andere Adresse zeigt, tauchen alle auf. Entscheiden Sie, welche Version Sie brauchen.
Eine Sitemap listet absichtlich veröffentlichte Seiten auf, keine versteckten; Seiten hinter einem Login und noindex-Seiten bleiben bei dieser Methode außen vor. Die rechtliche Seite behandelt Ist Web Scraping legal? Ein Überblick.
Was tun, wenn eine Website keine Sitemap hat?
Sitemaps sind optional. Danach kommen diese legitimen Wege, in dieser Reihenfolge:
- Ein Feed. WordPress liefert einen unter
/feed/aus, und viele Websites kündigen ihren mit<link rel="alternate">im Seitenkopf an. Für neue Inhalte funktioniert er so gut wie eine Sitemap. - Eine offizielle API oder ein Export mit dokumentiertem Format und Limit. Siehe Weg 1 in Cloudflare Scraper: Warum er blockiert wird und was hilft.
- Links folgen, ausgehend von Kategorieseiten, mit Tiefenlimit und Seitenobergrenze, wie im oben verlinkten Crawling-Leitfaden beschrieben.
- Die CDX API der Wayback Machine. Eine Abfrage wie
https://web.archive.org/cdx/search/cdx?url=example.com/blog/&matchType=prefix&collapse=urlkey&fl=original&limit=500listet archivierte Adressen unter einem Pfad auf (Dokumentation des CDX-Servers). Fürdocs.python.org/3/library/enthielt unser Ergebnis2to3.html, das heute weiterleitet, weil Python 2to3 entfernt hat. Prüfen Sie jede Adresse und behalten Sielimitbei, damit auch das Archiv nicht belastet wird. - Der Bericht „Seiten“ in der Search Console, für Ihre eigene Website.
Wir raten davon ab, Pfade mit Wortlisten zu erraten, Google-Ergebnisse automatisch zu scrapen oder in Login-Bereiche einzudringen. Halten Sie die Rate pro Website niedrig.
Eine Sitemap mit Python lesen: ein funktionierendes Beispiel
Das Skript braucht Python 3.11 oder neuer, Requests und lxml (pip install requests lxml).
"""Die Sitemap einer Website finden, Indizes und .gz-Dateien öffnen und die URLs auflisten.

Aufruf: python read_sitemap.py https://example.com [TAGE]
Mit TAGE werden nur URLs aufgelistet, die sich in den letzten TAGE Tagen geändert haben (oder kein brauchbares Datum haben).
"""
import gzip
import io
import os
import sys
import time
from datetime import datetime, timedelta, timezone
from functools import lru_cache
from urllib.parse import urljoin
from urllib.robotparser import RobotFileParser

import requests
from lxml import etree

BOT_NAME = "ExampleSitemapReader"
USER_AGENT = f"{BOT_NAME}/1.0 (+mailto:bots@example.com)"
DELAY = 1.0                        # Sekunden Wartezeit vor jeder Anfrage
LIMIT = 50 * 1024 * 1024           # sitemaps.org: höchstens 50 MB unkomprimiert
CANDIDATES = ["/sitemap.xml", "/sitemap_index.xml", "/wp-sitemap.xml"]

session = requests.Session()
session.headers["User-Agent"] = USER_AGENT
if os.environ.get("PROXY_URL"):    # z. B. http://user:pass@pr.proxynet.io:8000
    session.proxies = {"http": os.environ["PROXY_URL"], "https": os.environ["PROXY_URL"]}

xml_parser = etree.XMLParser(resolve_entities=False, no_network=True)


@lru_cache(maxsize=16)             # dieselbe Datei nie zweimal pro Lauf herunterladen
def fetch(url):
    time.sleep(DELAY)
    resp = session.get(url, timeout=(5, 30))
    resp.raise_for_status()
    data = resp.content
    if data[:2] == b"\x1f\x8b":    # gzip: den ersten zwei Bytes trauen, nicht dem Dateinamen
        with gzip.GzipFile(fileobj=io.BytesIO(data)) as gz:
            data = gz.read(LIMIT + 1)
    if len(data) > LIMIT:
        raise ValueError(f"{url} is larger than 50 MB uncompressed")
    return data


def read_robots(site):
    robots = RobotFileParser()
    try:
        lines = fetch(urljoin(site, "/robots.txt")).decode("utf-8", "replace").splitlines()
    except requests.HTTPError as err:
        if err.response.status_code >= 500:
            lines = ["User-agent: *", "Disallow: /"]  # RFC 9309: Serverfehler, draußen bleiben
        else:
            lines = []                                # 4xx: keine robots.txt, keine Regeln
    robots.parse(lines)
    return robots


def find_sitemaps(site, robots):
    if robots.site_maps():
        return robots.site_maps()
    for path in CANDIDATES:
        url = urljoin(site, path)
        if not robots.can_fetch(BOT_NAME, url):
            continue
        try:
            fetch(url)
        except requests.HTTPError:
            continue
        return [url]
    return []


def parse_date(text):
    if not text:
        return None
    try:
        when = datetime.fromisoformat(text)  # 2026-09-20, 2026-09-20T10:00:00+03:00 oder ...Z
    except ValueError:
        return None                          # fehlerhaftes Datum: als unbekannt behandeln
    return when if when.tzinfo else when.replace(tzinfo=timezone.utc)


def name(el):
    return etree.QName(el).localname         # Tag-Name ohne Namespace


def read_sitemap(url, since, seen):
    if url in seen:
        return
    seen.add(url)
    try:
        root = etree.fromstring(fetch(url), xml_parser)
    except (requests.RequestException, etree.XMLSyntaxError, ValueError) as err:
        print(f"skipped {url}: {err}", file=sys.stderr)
        return
    is_index = name(root) == "sitemapindex"
    for entry in root.iterchildren(etree.Element):          # nur Elemente, keine Kommentare
        fields = {name(f): (f.text or "").strip() for f in entry.iterchildren(etree.Element)}
        loc, lastmod = fields.get("loc"), parse_date(fields.get("lastmod"))
        if not loc:
            continue
        if is_index:
            if since and lastmod and lastmod < since:
                continue                     # in dieser Datei hat sich nach der Grenze nichts geändert
            yield from read_sitemap(loc, since, seen)
        elif since is None or lastmod is None or lastmod >= since:
            yield loc, lastmod


if __name__ == "__main__":
    site = sys.argv[1]
    days = int(sys.argv[2]) if len(sys.argv) > 2 else None
    since = datetime.now(timezone.utc) - timedelta(days=days) if days else None
    robots = read_robots(site)
    seen, listed = set(), set()
    for sitemap in find_sitemaps(site, robots):
        for loc, lastmod in read_sitemap(sitemap, since, seen):
            if loc in listed:
                continue
            listed.add(loc)
            if robots.can_fetch(BOT_NAME, loc):
                print(lastmod.date() if lastmod else "-", loc)
            else:
                print("disallowed by robots.txt, skipped:", loc, file=sys.stderr)
Was das Skript tut und was es auslässt
- Ein höflicher Client. Eine einzige Session wartet vor jeder Anfrage eine Sekunde und sendet einen ehrlichen
User-Agentmit Bot-Namen und Kontaktadresse (Was ist ein User-Agent?). - robots.txt über Ihren eigenen Client. Die Datei geht an
RobotFileParser.parse(), weilread()sie mit der Standardkennung von urllib abrufen würde. Ein4xxbedeutet keine Regeln und ein5xxbedeutet draußen bleiben, wie RFC 9309 es verlangt.site_maps()gibt dieSitemap:-Zeilen oderNonezurück (Python-Dokumentation), undcan_fetch()erhält den Bot-Namen, nicht den vollständigenUser-Agent. - Sicheres Parsen.
resolve_entities=Falseundno_network=Truehindern lxml daran, Entities zu expandieren oder etwas aus dem Netz zu laden; in unserem Test kam ein<loc>aus verschachtelten Entities leer zurück.localnameignoriert Unterschiede bei den Namespaces. - Absichtlich keine Wiederholungen und keine parallelen Anfragen. Zu
429undRetry-Aftersiehe HTTP-Statuscodes beim Web Scraping, zu parallelen Anfragen Concurrency und Parallelism.
Wir haben es mit Python 3.13.9, Requests 2.34.2 und lxml 6.1.3 gegen eine lokale Website ausgeführt: eine robots.txt, die /search/ sperrt, ein Index, eine gzip-Produkt-Sitemap, die ohne Content-Encoding gesendet wird, und eine Seiten-Sitemap mit Datum Januar 2025. Mit einer Grenze von 30 Tagen:
$ python read_sitemap.py http://127.0.0.1:18766 30
disallowed by robots.txt, skipped: http://127.0.0.1:18766/search/?q=x
2026-09-21 http://127.0.0.1:18766/product/1
- http://127.0.0.1:18766/product/3
- http://127.0.0.1:18766/product/4?colour=red&size=mproduct/2, im März geändert, fiel aus der Grenze heraus; product/3 (kein Datum) und product/4 (fehlerhaftes Datum) bleiben, und aus & wurde &. Die Seiten-Sitemap wurde nie angefragt. Ohne robots.txt fand das Skript den Index über seinen zweiten Kandidatenpfad. Gegen docs.python.org stellte es zwei Anfragen und gab 8 URLs aus, und derselbe Lauf über einen lokalen HTTP-Proxy mit gesetztem PROXY_URL lieferte dieselbe Liste.
Zum Lesen einer Sitemap brauchen Sie keinen Proxy. Die Proxy-Zeile ist für die nächste Stufe gedacht: aufgeführte Seiten so zu prüfen, wie Besucher in einem anderen Land sie sehen. Dort liefert Ihnen ein Residential-Proxy lokale Adressen bei derselben höflichen Rate.
Wenn Sie eine Bibliothek bevorzugen: ultimate-sitemap-parser (1.8.1 auf PyPI) findet Sitemaps über robots.txt und übliche Namen und durchläuft den Baum mit sitemap_tree_for_homepage(). Der SitemapSpider von Scrapy folgt verschachtelten Sitemaps und kann bei robots.txt beginnen (Was ist Scrapy und wie nutzt man es mit Proxy?).
Anwendungsfälle
- Preisbeobachtung: Produkt-URLs aus der Sitemap nehmen und nur die geänderten erneut abrufen (Wettbewerberpreise im E-Commerce überwachen).
- SEO-Audits der eigenen Website: prüfen, dass jede Sitemap-URL
200liefert und keine in robots.txt gesperrt ist, dann ansehen, wie die Seiten aus anderen Ländern aussehen (SEO-Proxy). - Große Crawls: bei der Sitemap beginnen und Fallen-Links meiden (Honeypot-Fallen).
- Einmalige Extraktion: die URL-Liste vorbereiten, bevor Sie Felder auslesen (Daten von Websites extrahieren).
- Änderungsüberwachung: Ein täglicher Lauf mit einer Grenze von einem Tag zeigt neue Angebote oder Artikel (Web-Crawler).
Häufige Fehler
- Nur
/sitemap.xmlprobieren. robots.txt nennt oft eine andere Datei. - Nur die erste
Sitemap:-Zeile lesen. Jede Zeile zählt. - Einen Index als Seitenliste behandeln. Seine
<loc>-Werte sind Sitemaps. - gzip am Dateinamen erkennen. Prüfen Sie die ersten zwei Bytes.
- Einträge ohne
lastmodverwerfen. Vielleicht sind gerade sie die geänderten. - Einem überall identischen
lastmodtrauen. Es hält den Build fest. - Eine URL abrufen, weil die Sitemap sie listet. robots.txt gilt trotzdem.
- XML mit regulären Ausdrücken parsen.
&bleibt maskiert. - Bei jedem Lauf jede Teil-Sitemap herunterladen. Nutzen Sie das
lastmodim Index. Bei fehlschlagenden Verbindungen siehe Max Retries Exceeded With URL.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Schnell die Sitemap-Adresse einer Website | /robots.txt, dann /sitemap.xml und /sitemap_index.xml |
| Die Sitemap einer WordPress-Website | /wp-sitemap.xml; /sitemap_index.xml mit SEO-Plugin |
| Tausende Adressen als Liste | Ein Skript, das Indizes und gzip öffnet, oder ultimate-sitemap-parser |
| Nur seit dem letzten Lauf geänderte Seiten | Eine lastmod-Grenze; bedingte Anfragen, wo die Daten versagen |
| Eine in robots.txt gesperrte Sitemap-URL | Überspringen |
| Keine Sitemap | Feed und API, dann begrenztes Folgen von Links oder Wayback CDX |
| Alle Seiten der eigenen Website | Die Berichte „Seiten“ und „Sitemaps“ in der Search Console |
| Regelmäßige Crawls von Sitemap-URLs in großem Umfang | Ein Crawler-Setup mit Proxy-Pool (Web-Crawler, Rotierender Proxy) |
Häufige Fragen
Wie sehe ich mir die Sitemap einer Website an?
Geben Sie die Domain gefolgt von /robots.txt in Ihren Browser ein und öffnen Sie die Adresse in der Sitemap:-Zeile. Gibt es keine, probieren Sie /sitemap.xml und /sitemap_index.xml. Eine .gz-Datei wird heruntergeladen und muss zuerst entpackt werden.
Hat jede Website eine Sitemap?
Nein. Sitemaps sind optional, und kleine Websites mit guter interner Verlinkung verzichten oft darauf. Ohne Sitemap nutzen Sie einen Feed, eine API, begrenztes Folgen von Links oder die Wayback CDX API.
Was ist der Unterschied zwischen sitemap.xml und sitemap_index.xml?
sitemap_index.xml ist meist ein Index, der andere Sitemaps auflistet. Der Name entscheidet das aber nicht: Öffnen Sie die Datei und prüfen Sie das Wurzelelement. <urlset> enthält Seiten, <sitemapindex> enthält Sitemaps.
Wie finde ich Seiten, die nicht in der Sitemap stehen?
Folgen Sie Links von bekannten Seiten, lesen Sie den Feed, nutzen Sie die API oder fragen Sie die Wayback CDX API ab und prüfen Sie dann die archivierten Adressen. Vom Erraten von Pfaden mit Wortlisten raten wir ab. Das Folgen von Links behandelt Web Scraping vs. Web Crawling.
Kann ich lastmod vertrauen?
Das hängt von der Website ab. Identische Daten bei allen Einträgen bedeuten, dass die Sitemap bei jedem Build neu erzeugt wird. Der WordPress-Kern lässt lastmod in seinem Index und in seinen Kategorie- und Autoren-Sitemaps weg. Wo die Daten versagen, lassen bedingte Anfragen den Server für unveränderte Seiten mit 304 antworten.
Was tun, wenn eine Sitemap-URL durch robots.txt gesperrt ist?
Überspringen Sie sie. robots.txt ist die ausdrückliche Regel des Betreibers für Crawler, eine Sitemap dagegen nur eine Liste. Das Skript oben prüft jede Adresse mit can_fetch(), bevor es sie ausgibt; die Details stehen in Was ist robots.txt und wie liest man die Datei?.
Fazit
Suchen Sie die Sitemap zuerst in robots.txt, dann unter /sitemap.xml, /sitemap_index.xml und dem Pfad der Plattform. Öffnen Sie Indizes und gzip-Dateien, behalten Sie mit lastmod nur das Geänderte und geben Sie robots.txt jedes Mal Vorrang vor der Sitemap. Ohne Sitemap gehen Sie zu Feeds, APIs, begrenztem Folgen von Links und der Wayback CDX API über. Wächst die Liste auf Tausende Seiten pro Tag, zeigt unsere Seite zum Web-Crawler, wie Sie diesen Crawl in großem Umfang betreiben.