Quieres llevar a tu propio archivo la lista de precios de un proveedor, el nombre y el precio de doscientos productos de una librería en línea o la tabla que un organismo actualiza cada semana. Lo primero que se te ocurre es copiar y pegar. Con diez filas funciona, con mil te lleva una tarde entera. Quien busca "extraer datos de una página web" busca siempre lo mismo: la manera de no hacer este trabajo a mano.
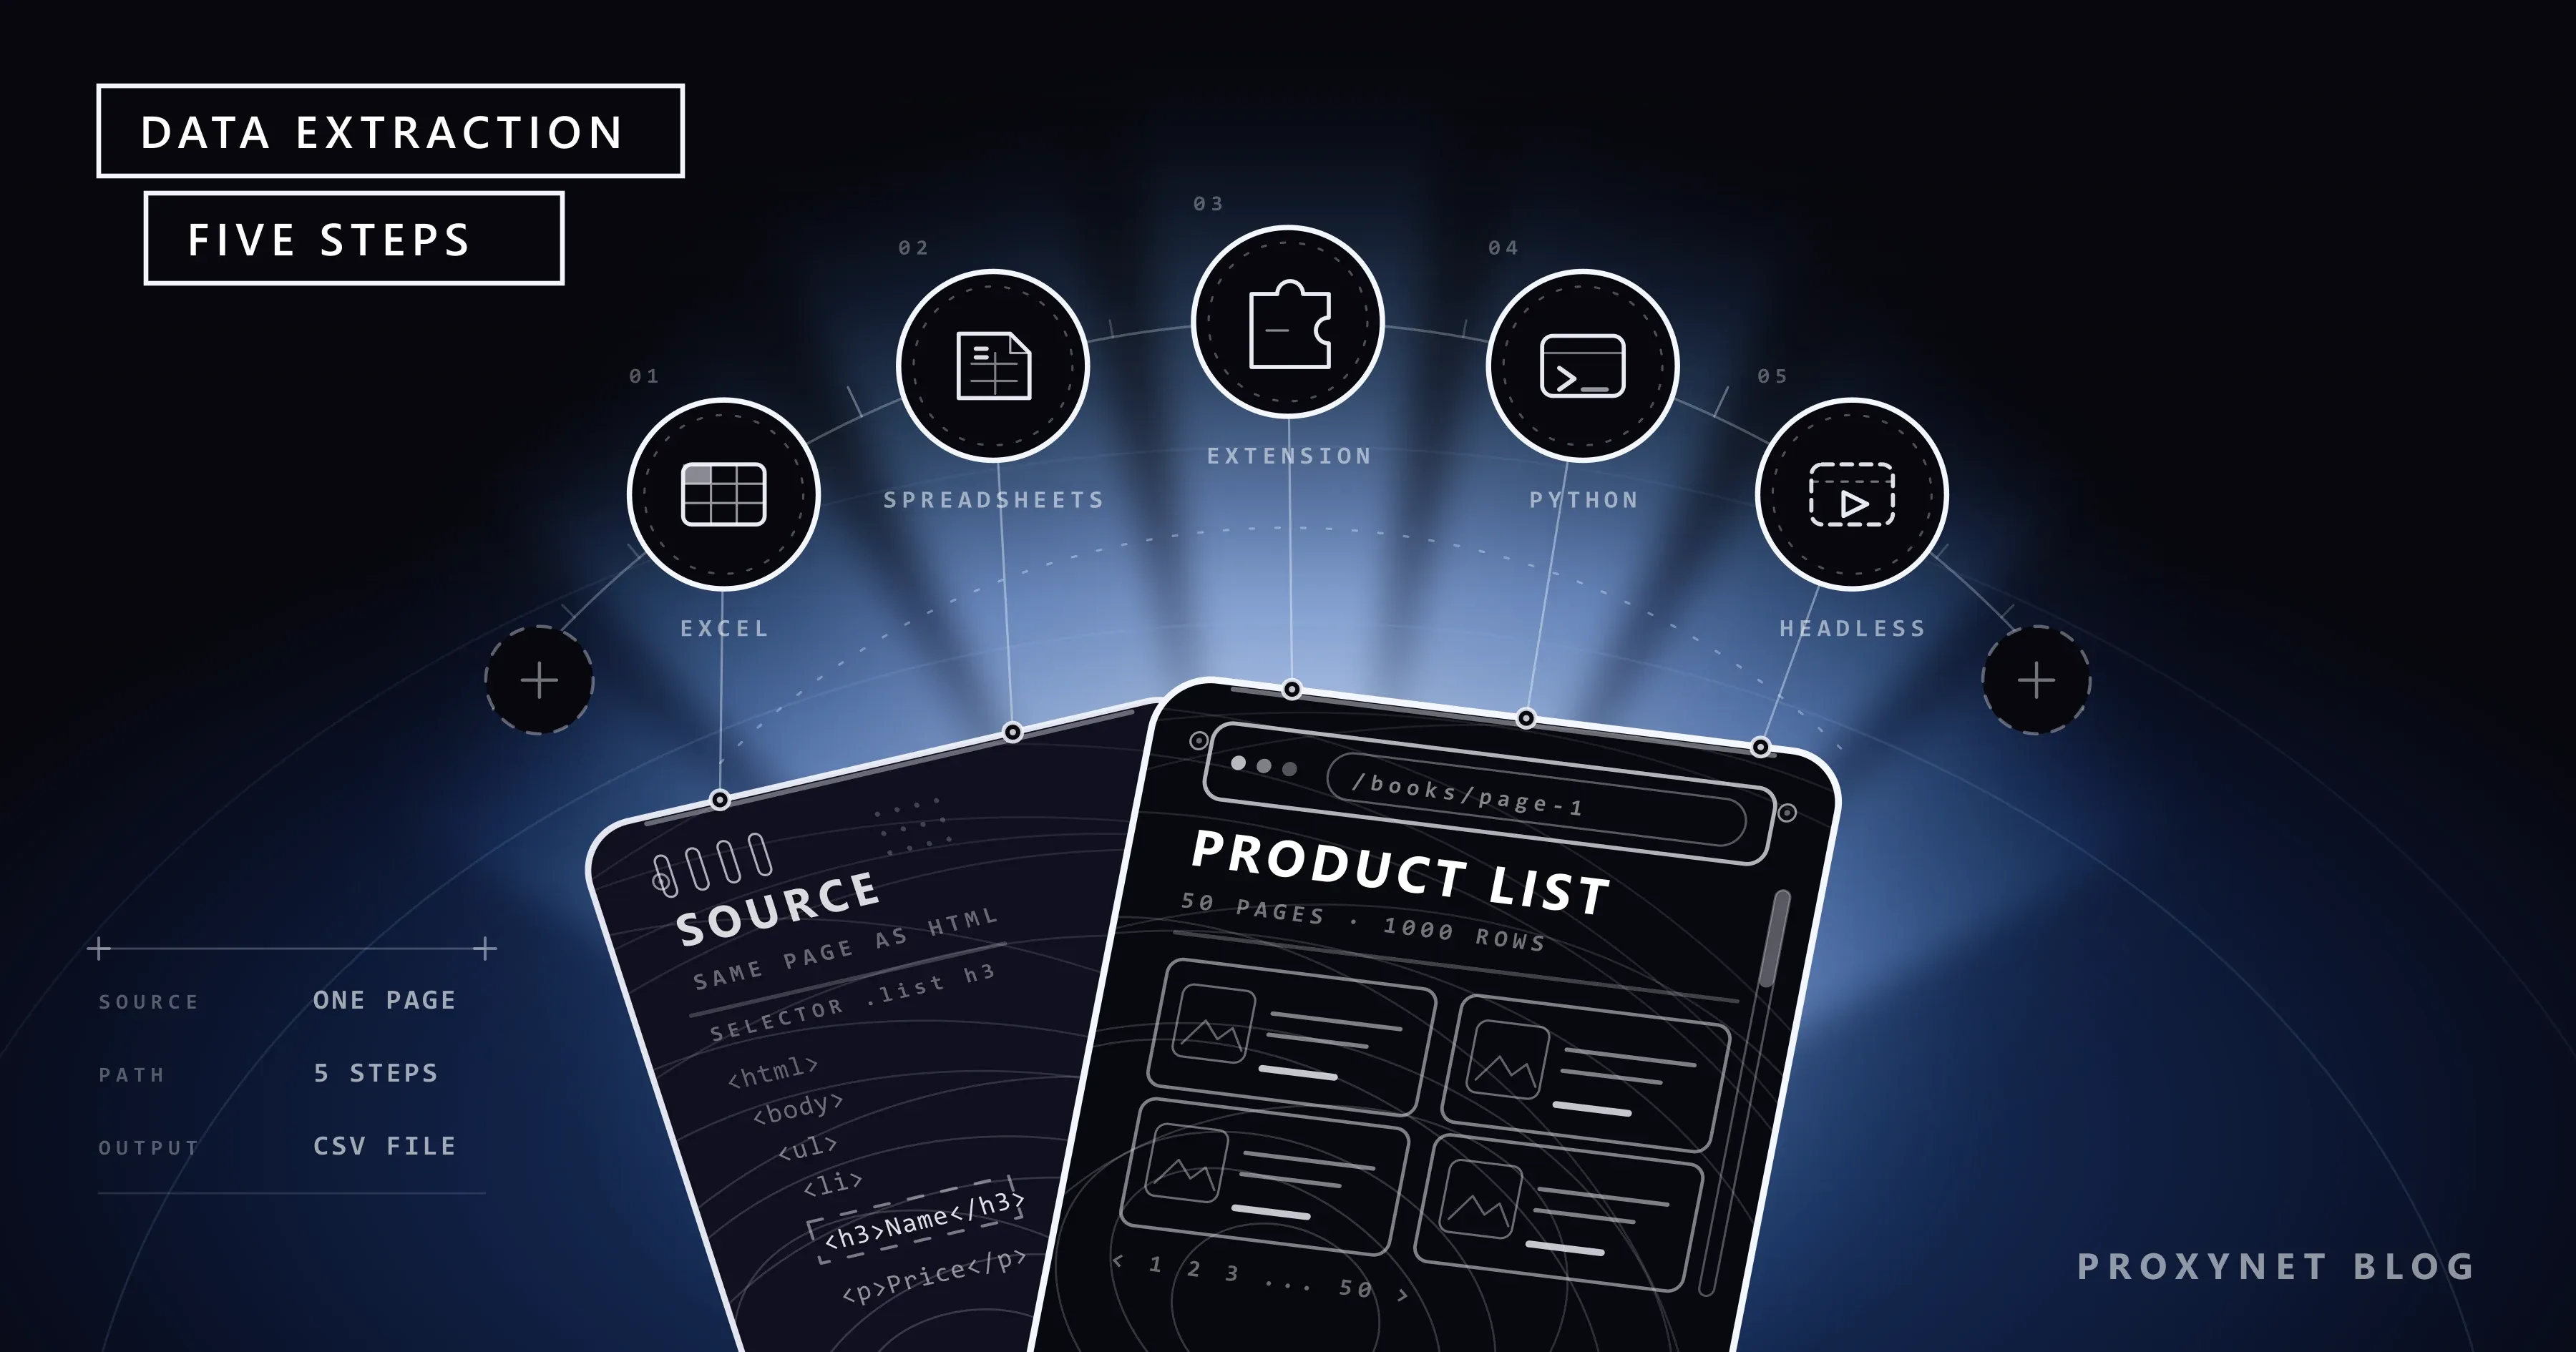
No hay un único camino, porque el método correcto depende de cuántas páginas necesitas, de cómo está construida la página y de cada cuánto vas a repetir la tarea. En este artículo ordenamos los métodos como una escalera: la función Desde la Web de Excel, las fórmulas de Hojas de cálculo de Google, las extensiones de navegador y las herramientas sin código, Python con Requests y BeautifulSoup y, arriba del todo, el navegador headless. En cada peldaño explicamos para qué alcanza, dónde se atasca y en qué peldaño entra en juego un proxy. Los ejemplos de Python de este artículo los ejecutamos contra un sitio de práctica.
¿Qué significa extraer datos de una web?
Extraer datos de una web es convertir la información que está dispuesta para el ojo humano (nombre del producto, precio, fecha, dirección) en un archivo hecho de filas y columnas. El nombre técnico es web scraping; en el resto del artículo diremos "scraping" o "extracción de datos". La definición en detalle, y qué proxy se usa en cada tipo de trabajo, están en nuestra página de la solución de extracción de datos. Este artículo no trata de la definición, sino de cómo elegir el método.
Conviene separar desde el principio tres conceptos que se confunden a menudo:
- Rastreo (crawling): Averiguar qué páginas hay en un sitio, es decir, armar la lista de direcciones. Es lo que hacen los buscadores. Los detalles están en nuestra página de web crawler.
- Extracción (scraping): Sacar campos concretos de una página cuya dirección ya conoces. El rastreo da las direcciones, la extracción da la información que hay dentro.
- API: La puerta oficial por la que el sitio ya entrega los datos de forma estructurada, casi siempre en JSON. Si hay API, no hace falta analizar la página.
Antes de extraer: ¿hay una API o un botón de descarga?
La extracción de datos más barata es la que no llega a hacerse. Antes de decidirte por un método, mira en estos tres lugares:
- API oficial. Los marketplaces ofrecen API a sus vendedores y los organismos públicos a los investigadores. El Banco Central Europeo, por ejemplo, publica los tipos de cambio de referencia del euro y el resto de sus series en el ECB Data Portal, tanto con una interfaz como con un servicio web. Para una tabla de tipos de cambio, ve a la fuente en lugar de analizar un sitio de noticias.
- Botón de descarga. Hay más páginas de las que parece con un enlace "Exportar a Excel" o "Descargar CSV" debajo de la tabla. Los portales de datos de los institutos de estadística funcionan así.
- La petición de datos de la propia página. Algunas páginas obtienen su contenido en segundo plano desde una dirección JSON. Cómo encontrar esa dirección lo mostramos paso a paso en Páginas estáticas y dinámicas.
Si no hay nada de esto se pasa a la extracción, pero con cuatro reglas. Solo se recogen datos públicos que no exigen iniciar sesión. Se leen el archivo robots.txt del sitio y sus condiciones de uso; los sitios de anuncios clasificados, de resultados deportivos y las redes sociales cuyas condiciones prohíben de forma expresa la recogida automatizada no son objetivo de los métodos de este artículo. Nombres, teléfonos y correos electrónicos son datos personales amparados por normas como el RGPD, y el argumento "estaba a la vista en la página" no lo cambia; el marco legal lo reunimos en ¿El web scraping es legal?. La última regla es la velocidad: el sitio no debe ir más lento por tu culpa.
Por eso todos los ejemplos del artículo corren sobre books.toscrape.com, un sitio montado para practicar scraping. El sitio se presenta como "sitio de demostración con fines de web scraping"; los precios y las valoraciones están asignados al azar.
¿Cómo se convierte una petición en datos?
Uses Excel o escribas Python, por debajo se ejecutan los mismos seis pasos. La diferencia entre los métodos es cuántos de esos pasos hacen por ti.
- Se envía la petición. La herramienta manda una petición HTTP a la dirección de la página, igual que un navegador.
- Llega la respuesta. El servidor devuelve un código de estado y el HTML de la página. Qué significan los códigos distintos de
200está en nuestro artículo sobre los códigos de estado HTTP. - Se analiza el HTML. El texto plano se convierte en un árbol de etiquetas anidadas.
- Se seleccionan los campos. Se escribe una regla del tipo "el título y el precio dentro de cada tarjeta de producto". El lenguaje de esa regla es un selector CSS o XPath; las diferencias las comparamos en Selector CSS o XPath.
- Se guardan las filas. Los campos seleccionados se escriben en una tabla, un archivo CSV o una base de datos.
- Se pasa a la página siguiente. Si la lista ocupa varias páginas, los pasos 1 a 5 se repiten en cada una.
Excel y Hojas de cálculo hacen todos estos pasos con un clic, pero en el cuarto tienen opciones limitadas. Las herramientas sin código te dejan describir ese paso con el ratón. En Python los seis pasos están en tus manos.
Métodos de extracción de datos, lado a lado
| Peldaño | Método | ¿Hace falta código? | ¿Cuándo basta? | ¿Dónde se atasca? |
|---|---|---|---|---|
| 1 | Excel, Datos > Desde la Web | No | La página tiene una tabla HTML y los datos se van a trabajar en Excel | Páginas con diseño de tarjetas, inicio de sesión con formulario, listas de muchas páginas |
| 2 | Hojas de cálculo de Google, IMPORTHTML e IMPORTXML | Una fórmula | Una sola página que debe mantenerse al día en una hoja compartida | Contenido que se rellena con JavaScript, páginas con inicio de sesión, muchas fórmulas |
| 3 | Extensión de navegador o herramienta sin código | No | Diseño de tarjetas, unos cientos de filas, trabajo puntual | Repetición periódica, gran volumen, recetas que se rompen cuando cambia el diseño del sitio |
| 4 | Python, Requests y BeautifulSoup | Sí | Decenas o miles de páginas, ejecución programada, tu propio formato | Contenido que se rellena después con JavaScript |
| 5 | Navegador headless (Playwright) | Sí | El contenido solo existe cuando lo genera el navegador | Velocidad y recursos: por cada página corre un navegador real |
Sube la escalera de abajo arriba. Si un peldaño inferior resuelve tu trabajo, subir al siguiente solo añade mantenimiento.
Peldaño 1: obtener datos de una web con Excel
Excel trae una función integrada para esto y muchos usuarios no la conocen. Los pasos de la página de soporte de Microsoft son estos: en la pestaña Datos, en la sección "Obtener y transformar", se selecciona Desde la Web, se pega la dirección de la página y se pulsa Aceptar. Excel encuentra las tablas de la página y las lista en el panel Navegador. Cuando eliges la tabla que quieres y seleccionas Cargar, los datos llegan a la hoja. La conexión se queda en el archivo; la semana siguiente no repites los pasos, actualizas la consulta. La pestaña "Vista web" del Navegador muestra la página en sí y resalta las tablas detectadas.
También está claro dónde se atasca. La función trabaja mejor con tablas construidas de verdad con la etiqueta <table> en el HTML. La página de inicio de nuestro sitio de práctica no tiene ni una sola etiqueta de tabla, los libros están dispuestos en tarjetas; en páginas así el Navegador puede no proponerte la tabla que buscas y queda el botón "Agregar tabla usando ejemplos", con el que describes las columnas escribiendo valores de muestra. Según la documentación del conector en Microsoft Learn, los tipos de autenticación admitidos son anónima, Windows, básica (nombre de usuario y contraseña), clave de API web y cuenta de organización. Rellenar un formulario de acceso e iniciar sesión no está en esa lista. Recorrer página a página una lista de cincuenta páginas es posible en Excel, pero no es práctico; en ese punto se pasa al cuarto peldaño.
Peldaño 2: IMPORTHTML e IMPORTXML en Hojas de cálculo de Google
Hojas de cálculo de Google hace el mismo trabajo con una fórmula. IMPORTHTML vuelca en las celdas una tabla o una lista de una página, e IMPORTXML cualquier elemento que describas con XPath. En una hoja con la configuración regional de España, los argumentos se separan con punto y coma; con la de México o Estados Unidos, con coma:
=IMPORTHTML("https://en.wikipedia.org/wiki/Demographics_of_India"; "table"; 4)
=IMPORTXML("https://books.toscrape.com/"; "//article[@class='product_pod']/h3/a/@title")
La primera fórmula es el ejemplo de la propia documentación de Google: trae la cuarta tabla de la página y la cuenta empieza en 1. En la documentación en inglés, los valores que admite el segundo argumento son "table" y "list"; en el ejemplo de la página de ayuda en español esa palabra aparece traducida, así que si la fórmula da error, este es el primer sitio donde mirar. La expresión XPath de la segunda fórmula la probamos sobre el HTML del sitio de práctica; devuelve los títulos de los veinte libros de la página de inicio. Por eso, en una página con diseño de tarjetas, funciona describir el elemento con XPath en vez de buscar una tabla.
Este peldaño tiene tres límites. La fórmula se ejecuta en los servidores de Google, la petición no la envía tu equipo. Por eso no puede ver una página en la que has iniciado sesión, un panel de la red de tu empresa ni la sesión de tu navegador. La fórmula lee el HTML en bruto de la página; si el contenido se rellena después con JavaScript, a la celda llega un resultado vacío o un error. El tercero es la escala: no decides tú cuándo se actualizan las fórmulas, y meter cientos de fórmulas de importación en un archivo vuelve pesada la hoja. Encaja con una tabla de una sola página que consulta todo un equipo, no con un catálogo de mil productos.
Peldaño 3: programas de extracción de datos y extensiones de navegador
Las herramientas que aparecen al buscar "programa para extraer datos" o "web scraping sin programar" se reparten en tres grupos:
- Extensiones de navegador. En la página abierta haces clic en una tarjeta de producto, luego en el título y en el precio; la extensión encuentra todas las tarjetas con el mismo patrón y las descarga como archivo CSV o Excel. Como la petición sale de tu navegador, la extensión ve la página igual que la ves tú.
- Herramientas sin código, de escritorio y en la nube. A esa misma lógica de describir con clics le añaden paginación, programación y ejecución en la nube. La mayoría tiene un nivel gratuito; comprueba sus límites en la página de precios de la propia herramienta.
- Herramientas de flujos de trabajo. Convierten la extracción en un eslabón de una cadena: obtén la página, separa el campo, escríbelo en la tabla, avisa si hay un cambio. Un ejemplo de este grupo lo montamos en nuestro artículo sobre web scraping con n8n.
En trabajos puntuales de unos cientos de filas, estas herramientas dan resultado más rápido que Python. Donde se atascan es en la continuidad. La receta se graba según el diseño que tenía la página ese día; cuando el sitio cambia el nombre de una clase, la herramienta produce en silencio una columna vacía y darte cuenta te toca a ti. En las herramientas que corren en la nube, los datos que recoges y los datos de cuenta que hayas introducido pasan por los servidores de una tercera empresa; tenlo en cuenta al elegir.
Peldaño 4: extraer datos de un sitio con Python
La pareja más habitual en Python son las bibliotecas Requests y BeautifulSoup. Requests descarga la página, BeautifulSoup analiza el HTML y te deja seleccionar campos con selectores CSS. La instalación es una línea:
pip install requests beautifulsoup4El script siguiente recorre las tres primeras páginas del sitio de práctica, recoge el título, el precio, la disponibilidad y la dirección de cada libro y escribe el resultado en un archivo CSV que Excel abre directamente. Al ejecutarlo con Python 3.13 generó sin problemas el archivo de 60 libros.
import csv
import os
import time
from urllib.parse import urljoin

import requests
from bs4 import BeautifulSoup

START_URL = "https://books.toscrape.com/"
MAX_PAGES = 3          # para practicar bastan tres páginas
DELAY = 2              # segundos entre dos peticiones

# Si necesitas un proxy: PROXY_URL=http://user:pass@pr.proxynet.io:8000
proxy = os.environ.get("PROXY_URL")

session = requests.Session()
session.headers["User-Agent"] = "prueba-precios-libros/1.0 (contacto: tu@example.com)"
if proxy:
    session.proxies = {"http": proxy, "https": proxy}

rows = []
url = START_URL
for page in range(MAX_PAGES):
    response = session.get(url, timeout=20)
    response.raise_for_status()
    response.encoding = "utf-8"
    soup = BeautifulSoup(response.text, "html.parser")

    for card in soup.select("article.product_pod"):
        rows.append({
            "titulo": card.select_one("h3 a")["title"],
            "precio": card.select_one("p.price_color").get_text(strip=True),
            "stock": card.select_one("p.instock").get_text(strip=True),
            "direccion": urljoin(url, card.select_one("h3 a")["href"]),
        })

    next_link = soup.select_one("li.next a")
    if next_link is None:
        break
    url = urljoin(url, next_link["href"])
    time.sleep(DELAY)

if not rows:
    raise SystemExit("No se encontró ningún producto: los selectores cambiaron o la página se rellena con JavaScript.")

# utf-8-sig: Excel muestra bien los acentos y la ñ al abrir el archivo
with open("libros.csv", "w", newline="", encoding="utf-8-sig") as f:
    writer = csv.DictWriter(f, fieldnames=rows[0].keys())
    writer.writeheader()
    writer.writerows(rows)

print(f"{len(rows)} filas escritas en libros.csv")
En el script hay cuatro decisiones que las herramientas sin código no te dejan tomar. La línea User-Agent dice quién eres y cómo contactarte; usa un nombre de bot honesto en lugar de una identidad de navegador falsa. DELAY pone una espera entre dos peticiones. raise_for_status() detiene el script ante un código de error, así el contenido de una página bloqueada no acaba en tu archivo como si fueran datos. La comprobación if not rows del final es el remedio para el problema de la columna vacía y silenciosa del tercer peldaño: si el selector no encaja, el script lo dice en voz alta.
A partir de aquí el camino se ramifica según el tamaño del trabajo. Para una cola de rastreo capaz de retomar cincuenta páginas donde se quedó, mira nuestro artículo sobre cómo recorrer listas paginadas; para páginas que exigen iniciar sesión con tu propia cuenta, sesiones y cookies en Python; para trabajos periódicos de cientos de páginas, Scrapy. Si tu equipo no escribe Python, puedes montar la misma lógica con PHP, con C# o con JavaScript; el método no depende del lenguaje.
En cuanto al almacenamiento, para un trabajo puntual basta un CSV. Si el trabajo se repite, un archivo que se sobrescribe pierde el historial de cambios; el montaje que añade la fecha a cada fila y escribe en SQLite está en nuestro artículo sobre seguimiento de precios de la competencia, y el análisis de los datos recogidos, en Minería de datos.
Peldaño 5: navegador headless cuando la página se rellena con JavaScript
Los autores del mismo sitio ofrecen también una página de práctica que se rellena con JavaScript. Cuando descargamos esa página con Requests y buscamos dentro los recuadros de citas, el resultado fue cero: los recuadros no están en el HTML, aparecen después de que el navegador ejecuta el script. Aquí es exactamente donde se atascan el segundo y el cuarto peldaño.
Un navegador headless es un navegador real sin ventana. Abre la página, ejecuta el JavaScript y tú lees los datos de la página ya generada. Con Playwright la misma página se lee así (después de pip install playwright y playwright install chromium):
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch()
    page = browser.new_page()
    page.goto("https://quotes.toscrape.com/js/")
    page.wait_for_selector("div.quote")          # espera a que aparezca el elemento
    for quote in page.locator("div.quote").all():
        text = quote.locator("span.text").inner_text()
        author = quote.locator("small.author").inner_text()
        print(author, "-", text[:60])
    browser.close()
El precio de este peldaño son los recursos: por cada página se abre una pestaña de navegador y se descargan imágenes y scripts. Por eso el navegador headless es el último peldaño. En la mayoría de las páginas dinámicas sale más barato encontrar la dirección JSON de la que vienen los datos; la decisión entre ambas vías y las estrategias de espera están en Páginas estáticas y dinámicas, y cómo configurar un proxy en el navegador, en nuestro artículo sobre Playwright y proxy.
¿En qué peldaño entra el proxy?
En los tres primeros peldaños el proxy casi nunca viene al caso. La fórmula de Hojas de cálculo sale del servidor de Google y no puedes poner nada en medio. Excel y la extensión de navegador usan la conexión de tu equipo; para un trabajo de unas pocas páginas tampoco hace falta otra cosa.
El proxy aparece en el cuarto y el quinto peldaño, en tres situaciones concretas:
- El contenido cambia según el país. Si una tienda muestra un precio a quien mira desde Alemania y otro a quien mira desde Türkiye, los datos correctos solo los ve una conexión que sale de ese país. Para eso están los Proxies residenciales con segmentación por ubicación; se facturan por GB y el precio base actual es 1,4 €.
- El trabajo ha crecido. Obtener miles de páginas en un tiempo razonable y sin cargar el sitio de destino implica que las peticiones no se amontonen en una sola dirección. Los Proxies rotativos reparten la carga en un pool. El mecanismo lo explicamos en nuestro artículo sobre la rotación de IP.
- Hace falta una sesión. Si vas a iniciar sesión con tu propia cuenta y recorrer varias páginas, necesitas mantener la misma IP durante toda la sesión; para eso se usan los Proxies de sesión fija.
También hay que decir lo que un proxy no hace. El límite de velocidad es la forma que tiene un sitio de decir "hasta aquí", y no es un obstáculo que se supera cambiando de IP, sino una señal que se respeta; el significado de la respuesta 429 lo desarrollamos en 429 Too Many Requests. La lista de diagnóstico de las causas de bloqueo está en Cómo hacer web scraping sin que te bloqueen.
Para usar un proxy en el script no tienes que cambiar el código. Cuando le das a la variable PROXY_URL una dirección con la forma http://user:pass@pr.proxynet.io:8000, todas las peticiones pasan por ahí. Probamos el ejemplo con un proxy de prueba local: con las credenciales correctas llegaron las páginas, con una contraseña incorrecta Requests lanzó un ProxyError con 407 Proxy Authentication Required. Requests lee además por su cuenta la variable de entorno HTTPS_PROXY; los detalles de estas variables están en Proxy con wget.
Casos de uso
- Seguimiento de precios y stock: Recoger de forma periódica los precios públicos de las páginas de la competencia para seguir la posición de tus propios productos en el mercado. El planteamiento está en nuestra página de monitorización de precios.
- Investigación de mercado: Indicadores agregados como el número de productos de una categoría, el rango de precios y el reparto por marcas. Los detalles están en nuestra página de investigación de mercado.
- Auditoría de catálogo y contenido: Buscar descripciones que faltan, enlaces rotos o precios erróneos en las miles de páginas de tu propio sitio. En tu sitio no hay problema de permisos y es, además, el objetivo más seguro para las primeras pruebas.
Errores frecuentes
- Analizar la página sin mirar si hay API. Pelearse con el HTML cuando existe una fuente oficial produce un trabajo que se rompe cada vez que cambia el diseño.
- Empezar la escalera por arriba. Montar un navegador headless para una tabla HTML sencilla hace el trabajo más lento y más difícil de mantener.
- Tomar un resultado vacío por datos. Cuando el selector no encaja, la mayoría de las herramientas no da error, da una columna vacía. Comprueba el número de filas en cada ejecución.
- Escribir un bucle sin esperas. Un script que envía decenas de peticiones por segundo recibe primero un
429, después un bloqueo duradero, y puede ralentizar de verdad un sitio pequeño. - Recoger datos personales porque "están a la vista". Los nombres de quienes escriben reseñas y los teléfonos de los anunciantes son datos personales. Quédate con la información de precios y productos.
Guía de decisión
| Necesidad | Método |
|---|---|
| El sitio tiene una API o un botón "Descargar CSV" | Úsalo, no extraigas |
| Una tabla bien hecha en una sola página, los datos se trabajan en Excel | Excel, Datos > Desde la Web |
| Unos cientos de filas en diseño de tarjetas, una sola vez | Extensión de navegador o IMPORTXML |
| Decenas de páginas, ejecución programada, tu propio formato de archivo | Python, Requests y BeautifulSoup |
| Cientos o miles de páginas, rastreo periódico | Scrapy y proxies rotativos que reparten la carga |
| El contenido solo se genera en el navegador y no se encuentra la dirección JSON | Navegador headless (Playwright) |
| Los datos cambian según el país | Python o Playwright con proxies residenciales segmentados por ubicación |
| Los datos están tras un inicio de sesión y la cuenta no es tuya | No los extraigas; pide permiso o una API al dueño del sitio |
Preguntas frecuentes
¿Se pueden extraer datos de una web sin programar?
Sí. Si la página tiene una tabla HTML, lo hacen la función Desde la Web de Excel y la fórmula IMPORTHTML de Hojas de cálculo; en páginas con diseño de tarjetas, las extensiones de navegador y las herramientas sin código. Cuando hacen falta cientos de páginas, repetición diaria y control de errores, escribir código pasa a ser lo menos trabajoso.
¿Hay algún programa gratuito para extraer datos?
Si tienes Excel o una cuenta de Google, los dos primeros peldaños no tienen costo adicional. Python y las bibliotecas citadas en el artículo son de código abierto. La mayoría de las herramientas sin código ofrece un nivel gratuito; comprueba sus límites en la página de la propia herramienta. Mantente lejos de los enlaces de "descargar programa" de origen dudoso; instala la extensión desde la tienda oficial de tu navegador.
¿Es legal extraer datos de una web?
Recoger datos públicos y no personales a una velocidad razonable no está prohibido por sí solo en la mayoría de los ordenamientos; pero las condiciones de uso del sitio, los derechos de autor y, en los datos personales, normas como el RGPD cambian el resultado. Este artículo no es asesoramiento legal. El marco lo explicamos en ¿El web scraping es legal?; en un proyecto comercial, consulta a un abogado.
¿Por qué Excel no ve los datos de la página?
La causa más frecuente es que los datos no están construidos como tabla HTML, sino como tarjetas o como lista; el Navegador puede no proponerte la tabla que buscas. La segunda causa es que la página pide iniciar sesión, y la tercera, que el contenido se carga después con JavaScript. En el primer caso la solución es IMPORTXML o una extensión de navegador; en los otros, los peldaños de Python.
¿Hay que aprender Python para extraer datos?
No. El método no depende del lenguaje: envía la petición, analiza el HTML, selecciona el campo, guarda. Empieza con el lenguaje que tu equipo ya conozca. La comparación de dos lenguajes populares está en Web scraping: ¿JavaScript o Python?.
¿Cuándo hace falta un proxy para extraer datos?
En un trabajo lento, de unos cientos de páginas y desde un solo país, no hace falta. Hace falta si el contenido cambia según el país, si el trabajo ha crecido a miles de páginas y hay que repartir la carga, o si la IP debe mantenerse fija durante una sesión iniciada. El proxy no es una herramienta para ignorar el límite de velocidad que pone el sitio.
En resumen
Extraer datos de una web tiene cinco peldaños, y el correcto es el más bajo que resuelve tu trabajo. Busca primero una API o un botón de descarga. Para una tabla bien hecha se usan Excel u Hojas de cálculo; para trabajos puntuales en diseño de tarjetas, extensiones y herramientas sin código; para trabajos que se repiten y crecen, Python; y solo para el contenido que se genera en el navegador, el navegador headless. Estés en el peldaño que estés, recoge solo datos públicos, a baja velocidad y respetando las reglas del sitio. Cuando el trabajo crezca hasta necesitar segmentación por país o reparto de carga, encontrarás los tipos de proxy adecuados en nuestros servicios de proxy.