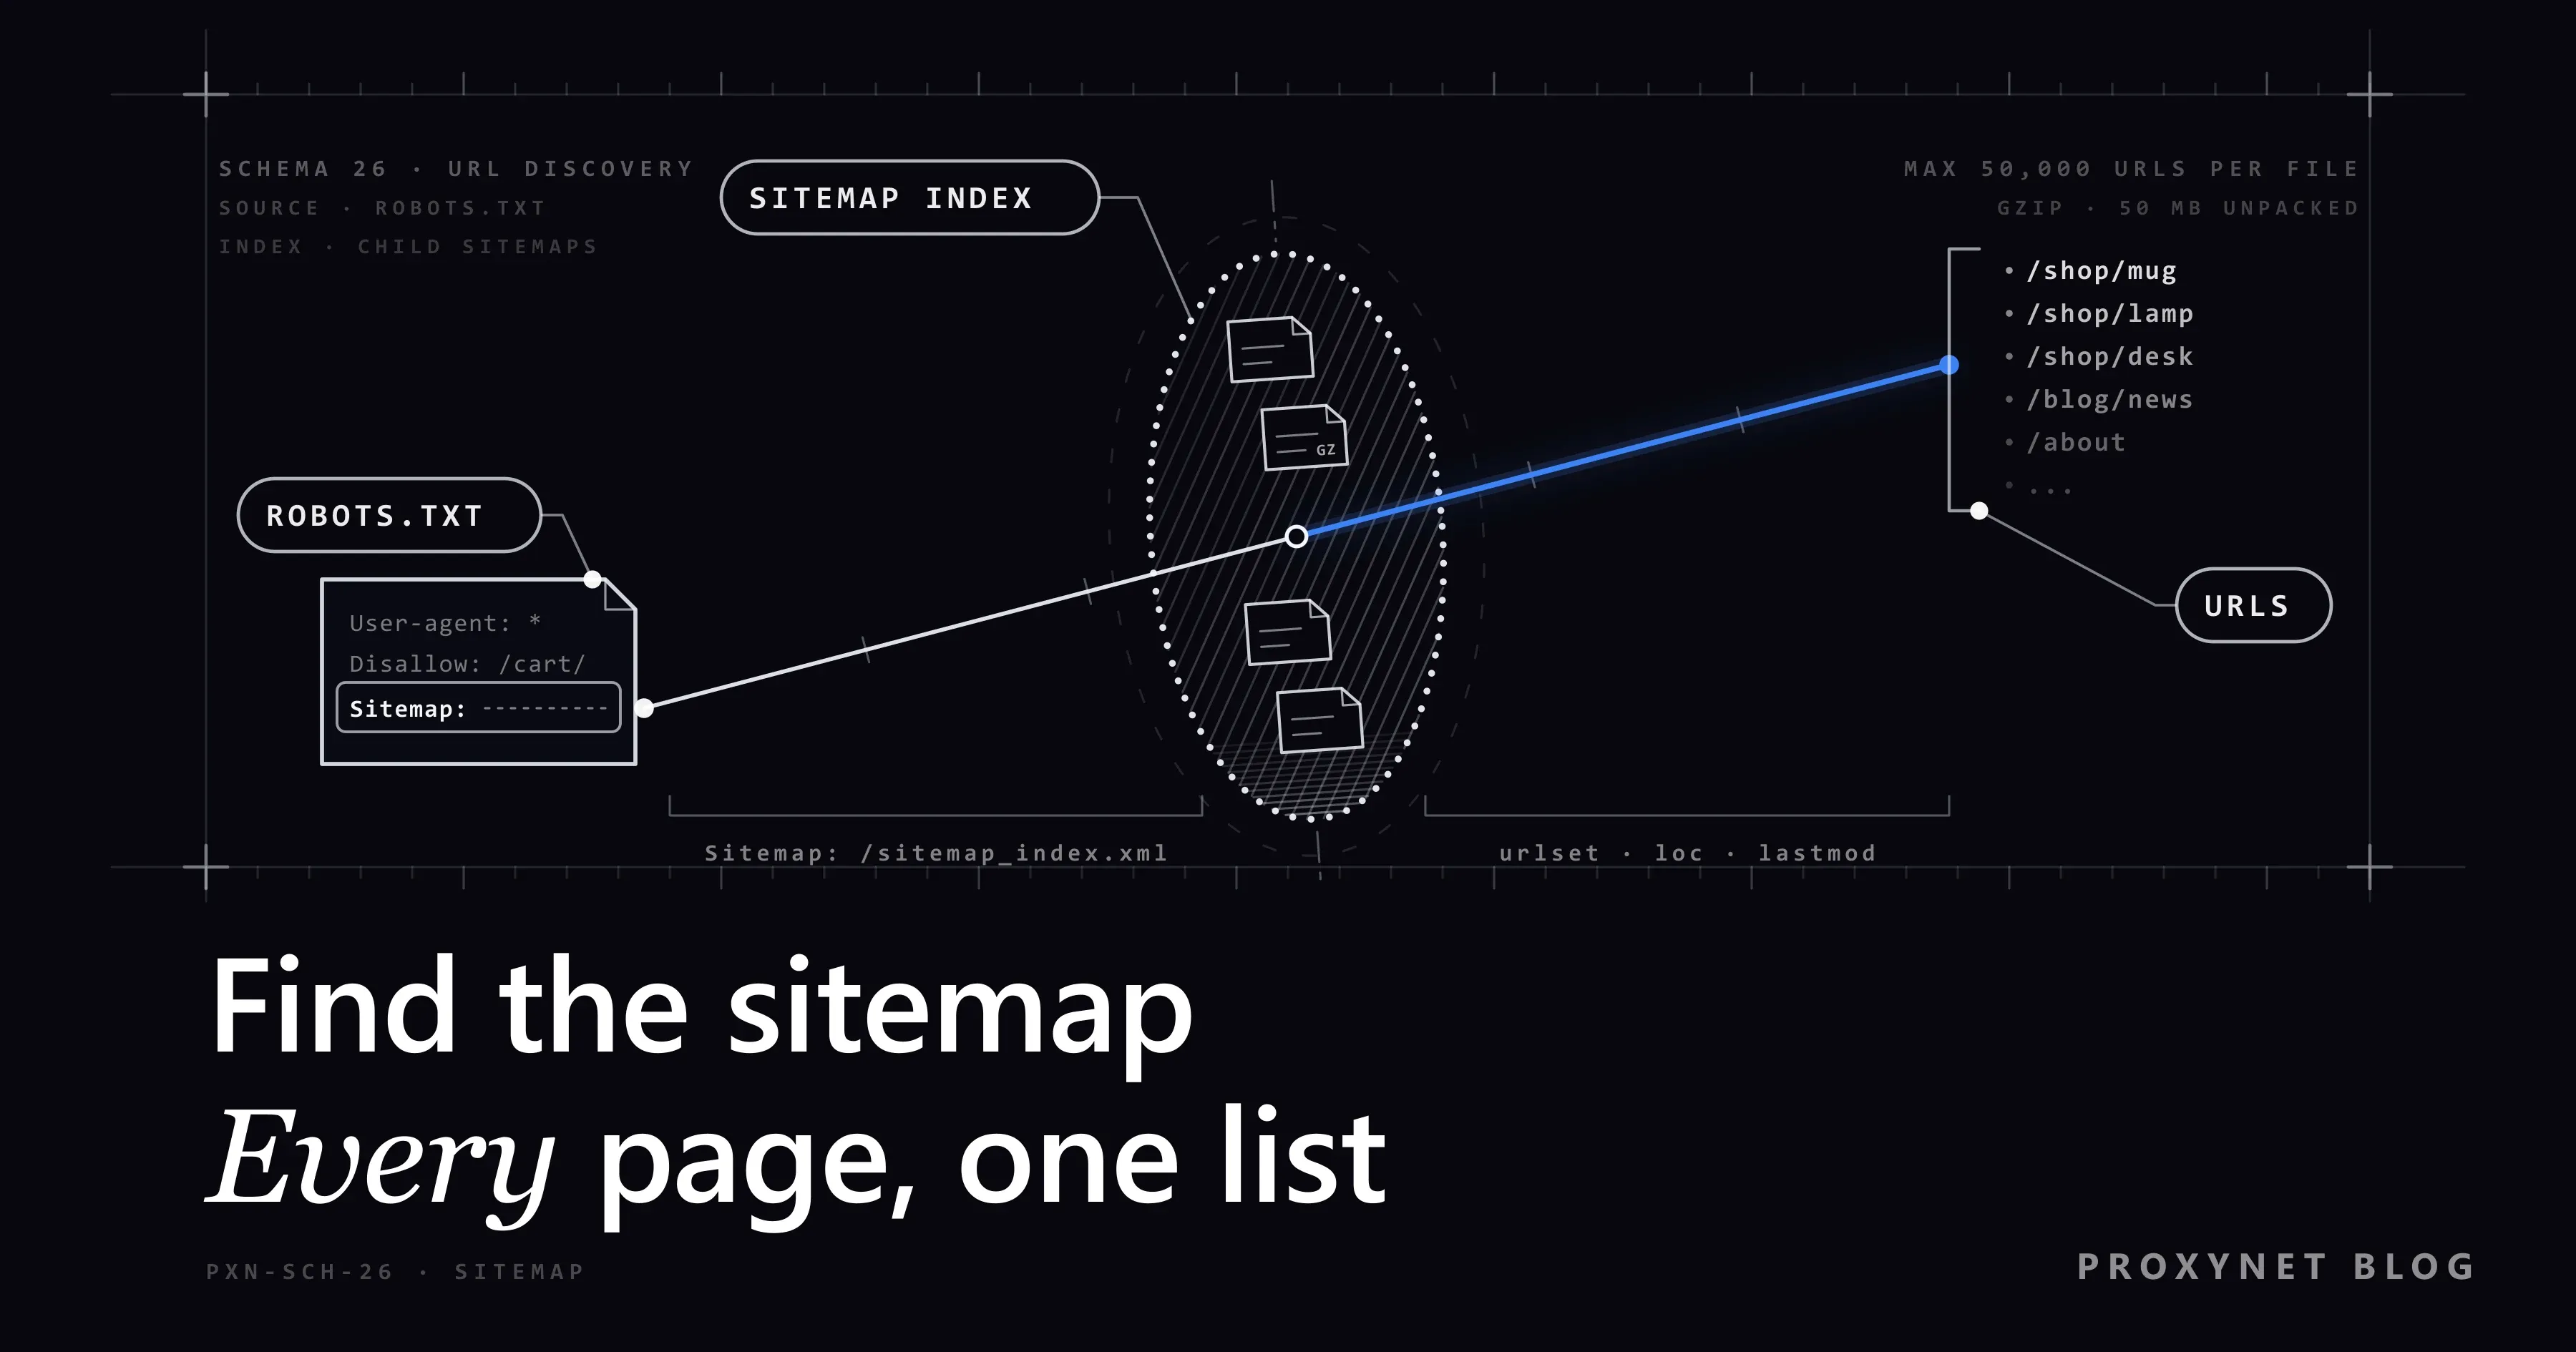
Bir rakibin online mağazasındaki bütün ürün sayfalarının listesine ihtiyacınız var. Kategorileri tek tek tıklayarak gezmek saatler ve binlerce istek demek. Oysa site sahibi bu listeyi arama motorları için tek bir XML dosyasında zaten yayımlıyor olabilir: sitemap (site haritası), yani sitenin taranmasını istediği adresleri sıralayan dosya. Bu dosyayı bulursanız bir sitenin tüm sayfalarını birkaç istekle görebilirsiniz.
Bu yazıda sitemap'i nerede ve hangi sırayla arayacağınızı, dosyanın nasıl okunduğunu, index ve .gz dosyalarının nasıl açıldığını ve lastmod ile yalnız değişen sayfaları nasıl seçeceğinizi anlatıyoruz. Sonda test ettiğimiz bir Python betiği var; sitemap'in neden hiçbir zaman sitenin tamamını göstermediğini ve sitemap yoksa ne yapılacağını da ele alıyoruz. Crawler tasarımının genel resmi için web crawler sayfamıza bakabilirsiniz.
Bir sitenin sitemap'i nasıl bulunur?
Şu yerlere sırayla bakın. Her adım yalnız bir istek harcar.
- robots.txt'deki
Sitemap:satırları.https://example.com/robots.txtadresini açın. Site sahipleri her sitemap'in tam adresini buraya yazar. RFC 9309, crawler'ların bu satırları robots.txt protokolünün dışında kalan ayrı bir kayıt olarak okumasına izin verir (bölüm 2.2.4); söz diziminin geri kalanını robots.txt Dosyası Nedir, Nasıl Okunur? yazımızda bulabilirsiniz. - Kök dizindeki yollar. Önce
/sitemap.xml, sonra/sitemap_index.xmladresini deneyin. Sitemap üreten araçların çoğu bu ikisinden birini kullanır. - Platformun yolu. WordPress çekirdeği 5.5 sürümünden beri
/wp-sitemap.xmladresinde bir index yayımlar ve bunu robots.txt'ye ekler (WordPress 5.5 duyurusu). Yoast gibi SEO eklentileri bunun yerine kendi index'lerini koyar, genellikle/sitemap_index.xml. Shopify/sitemap.xmlsunar; bu dosya ürünler, koleksiyonlar, bloglar ve sayfalar için ayrı sitemap'lere bağlanır. - HTML site haritası. Alt bilgideki "Site haritası" sayfası insanlar için yazılır ama sitenin ana bölümlerini gösterir.
- Kendi siteniz için Search Console. Site haritaları raporu gönderdiğiniz dosyaları ve Google'ın her dosyada kaç URL keşfettiğini listeler.
Google'a elle bir kez yazılan site:example.com filetype:xml araması da işe yarayabilir. Bunu otomatikleştirmeyin: Google betikle gönderilen sorguları olağandışı trafik sayar (Google Olağandışı Trafik Hatası).
Sitemap dosyası nasıl okunur: urlset, sitemapindex ve lastmod
İki sayfalık bir sitemap şöyle görünür:
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
<url>
<loc>https://example.com/product/1</loc>
<lastmod>2026-09-21T12:00:00+00:00</lastmod>
</url>
<url>
<loc>https://example.com/product/2?colour=red&size=m</loc>
</url>
</urlset>Sitemap protokolü yalnız <loc> etiketini zorunlu tutar; <lastmod>, <changefreq> ve <priority> isteğe bağlıdır. Google son ikisini yok sayar ve lastmod değerini yalnız "tutarlı ve doğrulanabilir biçimde" doğru olduğunda kullanır (Google Search Central). Başkasının dosyasını okurken dört kural daha işinize yarar:
- Bir dosya en fazla 50.000 URL ve sıkıştırılmamış hâlde 50 MB (52.428.800 bayt) tutar.
- Dosya UTF-8'dir ve
&karakteri&diye yazılır. XML ayrıştırıcı (parser) bunu geri çevirir, düzenli ifade (regex) çevirmez. /catalog/sitemap.xmladresindeki bir sitemap yalnız/catalog/altındaki adresleri listeleyebilir.<xhtml:link hreflang="…">satırları bir sayfanın dil sürümlerini gösterir; bunlar<loc>kaydı değildir.
Sitemap'ten her URL'ye nasıl ulaşılır?
Bir alan adını URL listesine çeviren betik şöyle çalışır:
- robots.txt'yi bir kez indirin; kurallarını ve
Sitemap:satırlarını saklayın. Sitemap:satırı yoksa yaygın yolları deneyin ve ilk200yanıtında durun.- Dosyayı indirin. İlk iki baytı
1f 8bise gzip ile açın. - Kök elemana bakın.
sitemapindexise her alt<loc>için 3. adımı tekrarlayın;urlsetise kayıtları toplayın. - Bir tarih sınırı varsa eski kayıtları atın ve index'teki
lastmoddeğeri sınırdan eski olan alt dosyaları hiç açmayın. - Her adresi robots.txt'ye göre kontrol edin ve kapalı olanları atlayın.
- Tekrarları temizleyin ve kalanları kuyruğa ekleyin. Yarıda kalan bir çalışmanın kaldığı yerden sürmesi için kuyruğu diskte tutmayı Sayfalama (Pagination) Nedir, Scraping'de Nasıl Taranır? yazımızda anlattık.
Crawler da aynı türden bir listeyi bağlantıları izleyerek çıkarır: her sayfa için bir istek atar, derinlik ve tekrar kurallarına uyar. İki yaklaşımın farkını Web Scraping ve Web Crawling Farkı Nedir? yazısında açıkladık.
URL keşif yöntemleri yan yana
| Yöntem | Siteye yük | Ne gösterir | Değişiklik bilgisi | Ne zaman kullanılır |
|---|---|---|---|---|
| XML sitemap | Çok düşük: birkaç dosya | Sahibinin taranmasını istediği adresler; eksik olabilir | Doğruysa lastmod | Her zaman ilk sırada |
| RSS ya da Atom feed | Çok düşük | Yalnız yeni içerik | Yayın tarihleri | Blog, haber, yeni ilanlar |
| Resmi API ya da dışa aktarma | Düşük, sınırları belgelenmiş | API'nin sunduğu kadarı | Çoğunlukla var | Sunuluyorsa; HTML'den önce |
| Bağlantı izleme | Yüksek: sayfa başına bir istek | Bağlantı verilen her şey, tuzaklar ve tekrarlar dahil | Yok | Sitemap yoksa ya da eksikse; derinlik sınırıyla |
| Wayback CDX API | Yok (istekler arşive gider) | Arşivlenmiş adresler; bazıları artık yok | Arşive alınma tarihi | Sitemap yoksa; aday liste için |
| Google Search Console | Yok | Google'ın bildiği sayfalar | Tarama ve dizine ekleme durumu | Yalnız kendi siteniz |
Sitemap bu yüzden ilk sırada: birkaç istekle adreslerin çoğu elinizde olur.
Sitemap index'i ve .gz dosyaları nasıl açılır?
Büyük siteler listelerini türe göre böler. Index'in kök elemanı <sitemapindex> olur ve her alt dosya için bir <sitemap> elemanı içerir; her birinde bir <loc> ve isteğe bağlı bir <lastmod> bulunur. Google'ın büyük sitemap'ler rehberi alt dosyaların aynı sitede, index'in bulunduğu dizinde ya da onun altında durmasını şart koşar. Betik yine de açtığı dosyaları hatırlamalı; böylece kendine bağlanan bir index onu döngüye sokamaz.
Sıkıştırılmış dosyalar genellikle .xml.gz ile biter ve sunucular bunları çoğunlukla Content-Encoding header'ı olmadan application/gzip türüyle gönderir. Bu header, yanıt gövdesinin nasıl sıkıştırıldığını istemciye bildirir. Header olmayınca Requests size sıkıştırılmış baytları olduğu gibi verir; yerel testimizde gövde, gzip imzası olan 1f 8b ile başladı. Bu iki baytı kontrol etmek, dosyanın adı ne olursa olsun işe yarar.
50 MB sınırı sıkıştırılmamış dosya için geçerlidir, bu yüzden okumayı orada kesin. Böylece sıkıştırma bombasına (decompression bomb), yani açıldığında gigabaytlara büyüyen küçük bir dosyaya karşı da korunursunuz. Python'ın XML güvenlik notları bu saldırıyı entity genişletme saldırılarının yanında sayar.
lastmod ile yalnız değişen sayfaları çekmek
lastmod W3C Datetime biçimini kullanır: yalnız tarih (2026-09-20) ya da saat ve saat dilimiyle birlikte tarih (2026-09-20T10:00:00+03:00). Python 3.11'den itibaren datetime.fromisoformat() ikisini de, sondaki Z dahil okur. Saat dilimi olmayan değerleri UTC sayın; böylece bütün tarihler birbiriyle karşılaştırılabilir.
Son çalışmanızdan beri değişen kayıtları ve lastmod değeri eksik ya da bozuk olan kayıtları tutun, çünkü bunların aynı kaldığını gösteren bir şey yok. Index'te lastmod her alt dosyanın ne zaman değiştiğini söyler, bu yüzden eski bir alt dosya indirilmeden atlanabilir. 30 günlük sınırla yaptığımız testte betik, en son Ocak 2025'te değişen bir dosyayı atladı ve dört yerine üç istek yaptı.
Tarihlerin bir anlam taşıyıp taşımadığı siteye bağlıdır:
- Her yerde aynı tarih ve saat: sitemap her derlemede yeniden üretiliyordur ve tarih sayfalar hakkında bir şey söylemez.
- Hiç tarih yok: 24 Eylül 2026'da docs.python.org sitemap'indeki kayıtların hiçbirinde
lastmodyoktu. - Yalnız bazı kayıtlarda tarih: WordPress çekirdeği index'indeki dosyalar için
lastmodyazmaz, bu yüzden her alt dosyayı açmanız gerekir. WordPress 6.5'ten beri yazı kayıtlarında bu alan var; kategori, etiket ve yazar sitemap'lerinde yok.
lastmod işe yaramadığında koşullu istekleri ve 304 Not Modified yanıtını kullanın; bunları Web Scraping'de Engellenmeden Veri Toplama Yöntemleri yazısında anlattık.
Sitemap neden sitenin gerçekte sunduğundan farklıdır?
Google, gönderilen bir sitemap'i "yalnızca bir ipucu" olarak görür. Beş tür fark bekleyin:
- Eksik sayfalar. 24 Eylül 2026'da
docs.python.org/sitemap.xml8 URL listeliyordu, her Python sürümü için bir başlangıç sayfası. Oysa site binlerce sayfa sunuyor. - Eskimiş kayıtlar. Silinen ürünler listede kalır ve
404ya da410döner. Bunları listenizden çıkarın. - robots.txt çelişkileri. Bir adres sitemap'te bulunup robots.txt'de kapalı olabilir. robots.txt site sahibinin açık kuralıdır, o yüzden adresi atlayın; testimizde listedeki bir arama sayfası bu şekilde atlandı.
- Kapsam. Alt dizindeki bir sitemap yalnız o dizini kapsar ve her alt alan adının kendi robots.txt'si ve sitemap'i vardır.
- Varyantlar. Takip parametreleri, dil alternatifleri ve canonical etiketi başka bir adresi gösteren sayfalar da listede çıkar. Hangi sürüme ihtiyacınız olduğuna karar verin.
Sitemap gizli sayfaları değil, bilerek yayımlanan sayfaları listeler; yalnız giriş yapılarak açılan sayfalar ve noindex sayfalar bu yöntemin dışında kalır. İşin hukuki tarafını Web Scraping (Web Kazıma) Yasal mı? yazısında ele aldık.
Sitenin sitemap'i yoksa ne yapılır?
Sitemap zorunlu değildir. Bu durumda sırasıyla şu meşru seçeneklere bakın:
- Feed. WordPress
/feed/adresinde bir feed sunar, birçok site de kendi feed'ini sayfanın<head>bölümündeki<link rel="alternate">etiketiyle duyurur. Yeni içerik için sitemap kadar iş görür. - Resmi API ya da dışa aktarma. Biçimi ve sınırları belgelidir. Cloudflare Scraper: Neden Engellenir, Veriye Nasıl Ulaşılır? yazısındaki birinci yola bakın.
- Kategori sayfalarından bağlantı izleme. Derinlik sınırı ve sayfa tavanı koyun; yöntemi yukarıda linkini verdiğimiz crawling yazısında anlattık.
- Wayback Machine CDX API.
https://web.archive.org/cdx/search/cdx?url=example.com/blog/&matchType=prefix&collapse=urlkey&fl=original&limit=500gibi bir sorgu, bir yolun altındaki arşivlenmiş adresleri listeler (CDX sunucu dokümantasyonu).docs.python.org/3/library/için aldığımız sonuçta2to3.htmlda vardı; Python 2to3'ü kaldırdığı için bu adres artık yönlendiriyor. Her adresi kontrol edin ve arşive de yük bindirmemek içinlimitparametresini kaldırmayın. - Search Console'daki Sayfalar raporu. Yalnız kendi siteniz için.
Kelime listeleriyle yol tahmin etmeyi, Google sonuçlarını otomatik kazımayı ya da giriş gerektiren alanlara girmeyi önermiyoruz. Site başına istek hızını düşük tutun.
Python ile sitemap okuma: çalışan bir örnek
Betik Python 3.11 veya üstü, Requests ve lxml ister (pip install requests lxml).
"""Bir sitenin sitemap'ini bulur, index ve .gz dosyalarını açar, URL'leri listeler.

Kullanım: python read_sitemap.py https://example.com [GÜN]
GÜN verilirse yalnız son GÜN günde değişen (ya da kullanılabilir tarihi olmayan) URL'ler listelenir.
"""
import gzip
import io
import os
import sys
import time
from datetime import datetime, timedelta, timezone
from functools import lru_cache
from urllib.parse import urljoin
from urllib.robotparser import RobotFileParser

import requests
from lxml import etree

BOT_NAME = "ExampleSitemapReader"
USER_AGENT = f"{BOT_NAME}/1.0 (+mailto:bots@example.com)"
DELAY = 1.0                        # her istekten önce beklenecek saniye
LIMIT = 50 * 1024 * 1024           # sitemaps.org: sıkıştırılmamış hâlde en fazla 50 MB
CANDIDATES = ["/sitemap.xml", "/sitemap_index.xml", "/wp-sitemap.xml"]

session = requests.Session()
session.headers["User-Agent"] = USER_AGENT
if os.environ.get("PROXY_URL"):    # ör. http://user:pass@pr.proxynet.io:8000
    session.proxies = {"http": os.environ["PROXY_URL"], "https": os.environ["PROXY_URL"]}

xml_parser = etree.XMLParser(resolve_entities=False, no_network=True)


@lru_cache(maxsize=16)             # bir çalışmada aynı dosyayı iki kez indirme
def fetch(url):
    time.sleep(DELAY)
    resp = session.get(url, timeout=(5, 30))
    resp.raise_for_status()
    data = resp.content
    if data[:2] == b"\x1f\x8b":    # gzip: dosya adına değil, ilk iki bayta güven
        with gzip.GzipFile(fileobj=io.BytesIO(data)) as gz:
            data = gz.read(LIMIT + 1)
    if len(data) > LIMIT:
        raise ValueError(f"{url} is larger than 50 MB uncompressed")
    return data


def read_robots(site):
    robots = RobotFileParser()
    try:
        lines = fetch(urljoin(site, "/robots.txt")).decode("utf-8", "replace").splitlines()
    except requests.HTTPError as err:
        if err.response.status_code >= 500:
            lines = ["User-agent: *", "Disallow: /"]  # RFC 9309: sunucu hatası, siteye girme
        else:
            lines = []                                # 4xx: robots.txt yok, kural da yok
    robots.parse(lines)
    return robots


def find_sitemaps(site, robots):
    if robots.site_maps():
        return robots.site_maps()
    for path in CANDIDATES:
        url = urljoin(site, path)
        if not robots.can_fetch(BOT_NAME, url):
            continue
        try:
            fetch(url)
        except requests.HTTPError:
            continue
        return [url]
    return []


def parse_date(text):
    if not text:
        return None
    try:
        when = datetime.fromisoformat(text)  # 2026-09-20, 2026-09-20T10:00:00+03:00 ya da ...Z
    except ValueError:
        return None                          # bozuk tarih: bilinmiyor say
    return when if when.tzinfo else when.replace(tzinfo=timezone.utc)


def name(el):
    return etree.QName(el).localname         # namespace olmadan etiket adı


def read_sitemap(url, since, seen):
    if url in seen:
        return
    seen.add(url)
    try:
        root = etree.fromstring(fetch(url), xml_parser)
    except (requests.RequestException, etree.XMLSyntaxError, ValueError) as err:
        print(f"skipped {url}: {err}", file=sys.stderr)
        return
    is_index = name(root) == "sitemapindex"
    for entry in root.iterchildren(etree.Element):          # yalnız elemanlar, yorumlar hariç
        fields = {name(f): (f.text or "").strip() for f in entry.iterchildren(etree.Element)}
        loc, lastmod = fields.get("loc"), parse_date(fields.get("lastmod"))
        if not loc:
            continue
        if is_index:
            if since and lastmod and lastmod < since:
                continue                     # bu dosyada sınırdan sonra değişen bir şey yok
            yield from read_sitemap(loc, since, seen)
        elif since is None or lastmod is None or lastmod >= since:
            yield loc, lastmod


if __name__ == "__main__":
    site = sys.argv[1]
    days = int(sys.argv[2]) if len(sys.argv) > 2 else None
    since = datetime.now(timezone.utc) - timedelta(days=days) if days else None
    robots = read_robots(site)
    seen, listed = set(), set()
    for sitemap in find_sitemaps(site, robots):
        for loc, lastmod in read_sitemap(sitemap, since, seen):
            if loc in listed:
                continue
            listed.add(loc)
            if robots.can_fetch(BOT_NAME, loc):
                print(lastmod.date() if lastmod else "-", loc)
            else:
                print("disallowed by robots.txt, skipped:", loc, file=sys.stderr)
Betiğin yaptıkları ve dışarıda bıraktıkları
- Tek istemci, düşük hız. Tek bir oturum (session) her istekten önce bir saniye bekler ve bot adı ile iletişim adresi taşıyan dürüst bir
User-Agentgönderir (User-Agent Nedir, Nasıl Öğrenilir ve Değiştirilir?). - robots.txt kendi istemcinizle indirilir. Dosya
RobotFileParser.parse()metoduna verilir, çünküread()onu urllib'in varsayılan kimliğiyle indirirdi. RFC 9309'un istediği gibi4xx"kural yok",5xx"siteye girme" anlamına gelir.site_maps(),Sitemap:satırlarını ya daNonedöndürür (Python dokümantasyonu);can_fetch()ise tamUser-Agentmetnini değil, bot adını alır. - Güvenli ayrıştırma.
resolve_entities=Falseveno_network=True, lxml'in entity'leri genişletmesini ya da uzaktan bir şey yüklemesini engeller; testimizde iç içe entity'lerden kurulmuş bir<loc>boş döndü.localnamenamespace farklarını yok sayar. - Yeniden deneme ve paralel istek bilerek yok.
429veRetry-Afteriçin Scraping'de HTTP Hata Kodları: 403, 407, 429 ve 503, paralel istekler için Concurrency ve Parallelism yazısına bakın.
Betiği Python 3.13.9, Requests 2.34.2 ve lxml 6.1.3 ile yerel bir siteye karşı çalıştırdık. Sitede /search/ yolunu kapatan bir robots.txt, bir index, Content-Encoding olmadan gönderilen gzip'li bir ürün sitemap'i ve Ocak 2025 tarihli bir sayfa sitemap'i vardı. 30 günlük sınırla çıktı şöyle:
$ python read_sitemap.py http://127.0.0.1:18766 30
disallowed by robots.txt, skipped: http://127.0.0.1:18766/search/?q=x
2026-09-21 http://127.0.0.1:18766/product/1
- http://127.0.0.1:18766/product/3
- http://127.0.0.1:18766/product/4?colour=red&size=m
Mart ayında değişen product/2 sınırın dışında kaldı; product/3 (tarihsiz) ve product/4 (bozuk tarih) listede kaldı, & da & olarak çıktı. Sayfa sitemap'i hiç istenmedi. robots.txt olmadığında betik index'i ikinci aday yolda buldu. docs.python.org'a karşı iki istek yaptı ve 8 URL yazdırdı; aynı çalışma PROXY_URL tanımlıyken yerel bir HTTP proxy üzerinden de aynı listeyi verdi.
Sitemap okumak için proxy gerekmez. Koddaki proxy satırı bir sonraki aşama için: listedeki sayfaları başka bir ülkedeki ziyaretçilerin gördüğü gibi kontrol etmek. O aşamada bir Residential Proxy size aynı düşük hızda yerel adresler verir.
Hazır bir kütüphane tercih ederseniz ultimate-sitemap-parser (PyPI'da 1.8.1) sitemap'leri robots.txt ve yaygın dosya adları üzerinden bulur ve sitemap_tree_for_homepage() ile ağacı dolaşır. Scrapy'nin SitemapSpider sınıfı iç içe sitemap'leri izler ve robots.txt'den başlayabilir (Scrapy Nedir ve Proxy ile Nasıl Kullanılır?).
Kullanım alanları
- Fiyat takibi: ürün URL'lerini sitemap'ten alın ve yalnız değişenleri yeniden çekin (E-Ticarette Rakip Fiyat Takibi Nasıl Yapılır?).
- Kendi sitenizin SEO denetimi: her sitemap URL'sinin
200döndüğünü ve hiçbirinin robots.txt'de kapalı olmadığını doğrulayın, sonra sayfaların başka ülkelerden nasıl göründüğüne bakın (SEO proxy). - Büyük taramalar: sitemap'ten başlayın ve tuzak bağlantılardan uzak durun (Honeypot Tuzakları).
- Tek seferlik veri çekme: alanları çekmeden önce URL listesini hazırlayın (Web Sitesinden Veri Çekme).
- Değişiklik izleme: bir günlük sınırla her gün çalışan betik yeni ilanları ya da yazıları gösterir (web crawler).
Sık yapılan hatalar
- Yalnız
/sitemap.xmldenemek. robots.txt çoğu zaman başka bir dosyayı gösterir. - Yalnız ilk
Sitemap:satırını okumak. Her satır ayrı bir sitemap gösterir. - Index'i sayfa listesi sanmak. Onun
<loc>değerleri sayfa değil, sitemap adresidir. - gzip'i dosya adından anlamaya çalışmak. İlk iki bayta bakın.
lastmoddeğeri olmayan kayıtları atmak. Değişenler tam da onlar olabilir.- Her kayıtta aynı olan
lastmoddeğerine güvenmek. Bu tarih sayfanın değil, derlemenin zamanıdır. - Sitemap'te var diye bir URL'yi çekmek. robots.txt yine geçerlidir.
- XML'i düzenli ifadelerle ayrıştırmak.
&kaçışlı hâlde kalır. - Her çalışmada bütün alt dosyaları indirmek. Index'teki
lastmoddeğerini kullanın. Bağlantılar hata veriyorsa Max Retries Exceeded With URL Hatası yazısına bakın.
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
| Bir sitenin sitemap adresini hızlıca bulmak | /robots.txt, sonra /sitemap.xml ve /sitemap_index.xml |
| WordPress sitesinin sitemap'i | /wp-sitemap.xml; SEO eklentisi varsa /sitemap_index.xml |
| Binlerce adresi liste hâlinde almak | Index ve gzip açan bir betik ya da ultimate-sitemap-parser |
| Yalnız son çalışmadan beri değişen sayfalar | lastmod sınırı; tarihlerin işe yaramadığı yerde koşullu istek |
| robots.txt'de kapalı bir sitemap URL'si | Atlayın |
| Sitemap yok | Feed ve API, sonra sınırlı bağlantı izleme ya da Wayback CDX |
| Kendi sitenizin bütün sayfaları | Search Console'daki Sayfalar ve Site haritaları raporları |
| Sitemap URL'lerini büyük ölçekte düzenli taramak | Proxy havuzuyla çalışan bir crawler kurulumu (web crawler, Rotating Proxy) |
Sıkça sorulan sorular
Bir sitenin sitemap'i nasıl görüntülenir?
Tarayıcıya alan adını ve ardından /robots.txt yazın, Sitemap: satırındaki adresi açın. Böyle bir satır yoksa /sitemap.xml ve /sitemap_index.xml adreslerini deneyin. .gz uzantılı dosya indirilir ve önce açılması gerekir.
Her sitenin sitemap'i var mı?
Hayır. Sitemap isteğe bağlıdır ve iç bağlantıları iyi kurulmuş küçük siteler çoğu zaman sitemap yayımlamaz. Sitemap yoksa feed, API, sınırlı bağlantı izleme ya da Wayback CDX API kullanın.
sitemap.xml ile sitemap_index.xml arasındaki fark nedir?
sitemap_index.xml genellikle başka sitemap'leri listeleyen bir index'tir. Yine de bunu dosya adı belirlemez: dosyayı açın ve kök elemana bakın. <urlset> sayfaları, <sitemapindex> ise sitemap'leri tutar.
Sitemap'te olmayan sayfalar nasıl bulunur?
Bilinen sayfalardan bağlantı izleyin, feed'i okuyun, API'yi kullanın ya da Wayback CDX API'yi sorgulayın, ardından arşivlenmiş adresleri tek tek kontrol edin. Kelime listeleriyle yol tahmin etmeyi önermiyoruz. Bağlantı izlemeyi Web Scraping ve Web Crawling Farkı Nedir? yazısında anlattık.
lastmod'a güvenilir mi?
Siteye göre değişir. Her kayıtta aynı tarih varsa sitemap her derlemede yeniden üretiliyordur. WordPress çekirdeği index'inde ve kategori ile yazar sitemap'lerinde lastmod yazmaz. Tarihlerin işe yaramadığı yerde koşullu istek gönderin; sunucu değişmeyen sayfalar için 304 döner.
Sitemap'teki bir URL robots.txt'de engelliyse ne yapmalı?
Atlayın. robots.txt site sahibinin crawler'lara verdiği açık kuraldır, sitemap ise yalnız bir listedir. Yukarıdaki betik her adresi yazdırmadan önce can_fetch() ile kontrol eder; ayrıntılar robots.txt Dosyası Nedir, Nasıl Okunur? yazısında.
Özet
Sitemap'i önce robots.txt'de, sonra /sitemap.xml, /sitemap_index.xml ve platformun kendi yolunda arayın. Index ve gzip dosyalarını açın, yalnız değişenleri tutmak için lastmod değerini kullanın ve robots.txt ile sitemap çeliştiğinde her seferinde robots.txt'ye uyun. Sitemap yoksa feed, API, sınırlı bağlantı izleme ve Wayback CDX API'ye geçin. Liste günde binlerce sayfaya çıktığında bu taramayı büyük ölçekte nasıl yürüteceğinizi web crawler sayfamızda bulabilirsiniz.