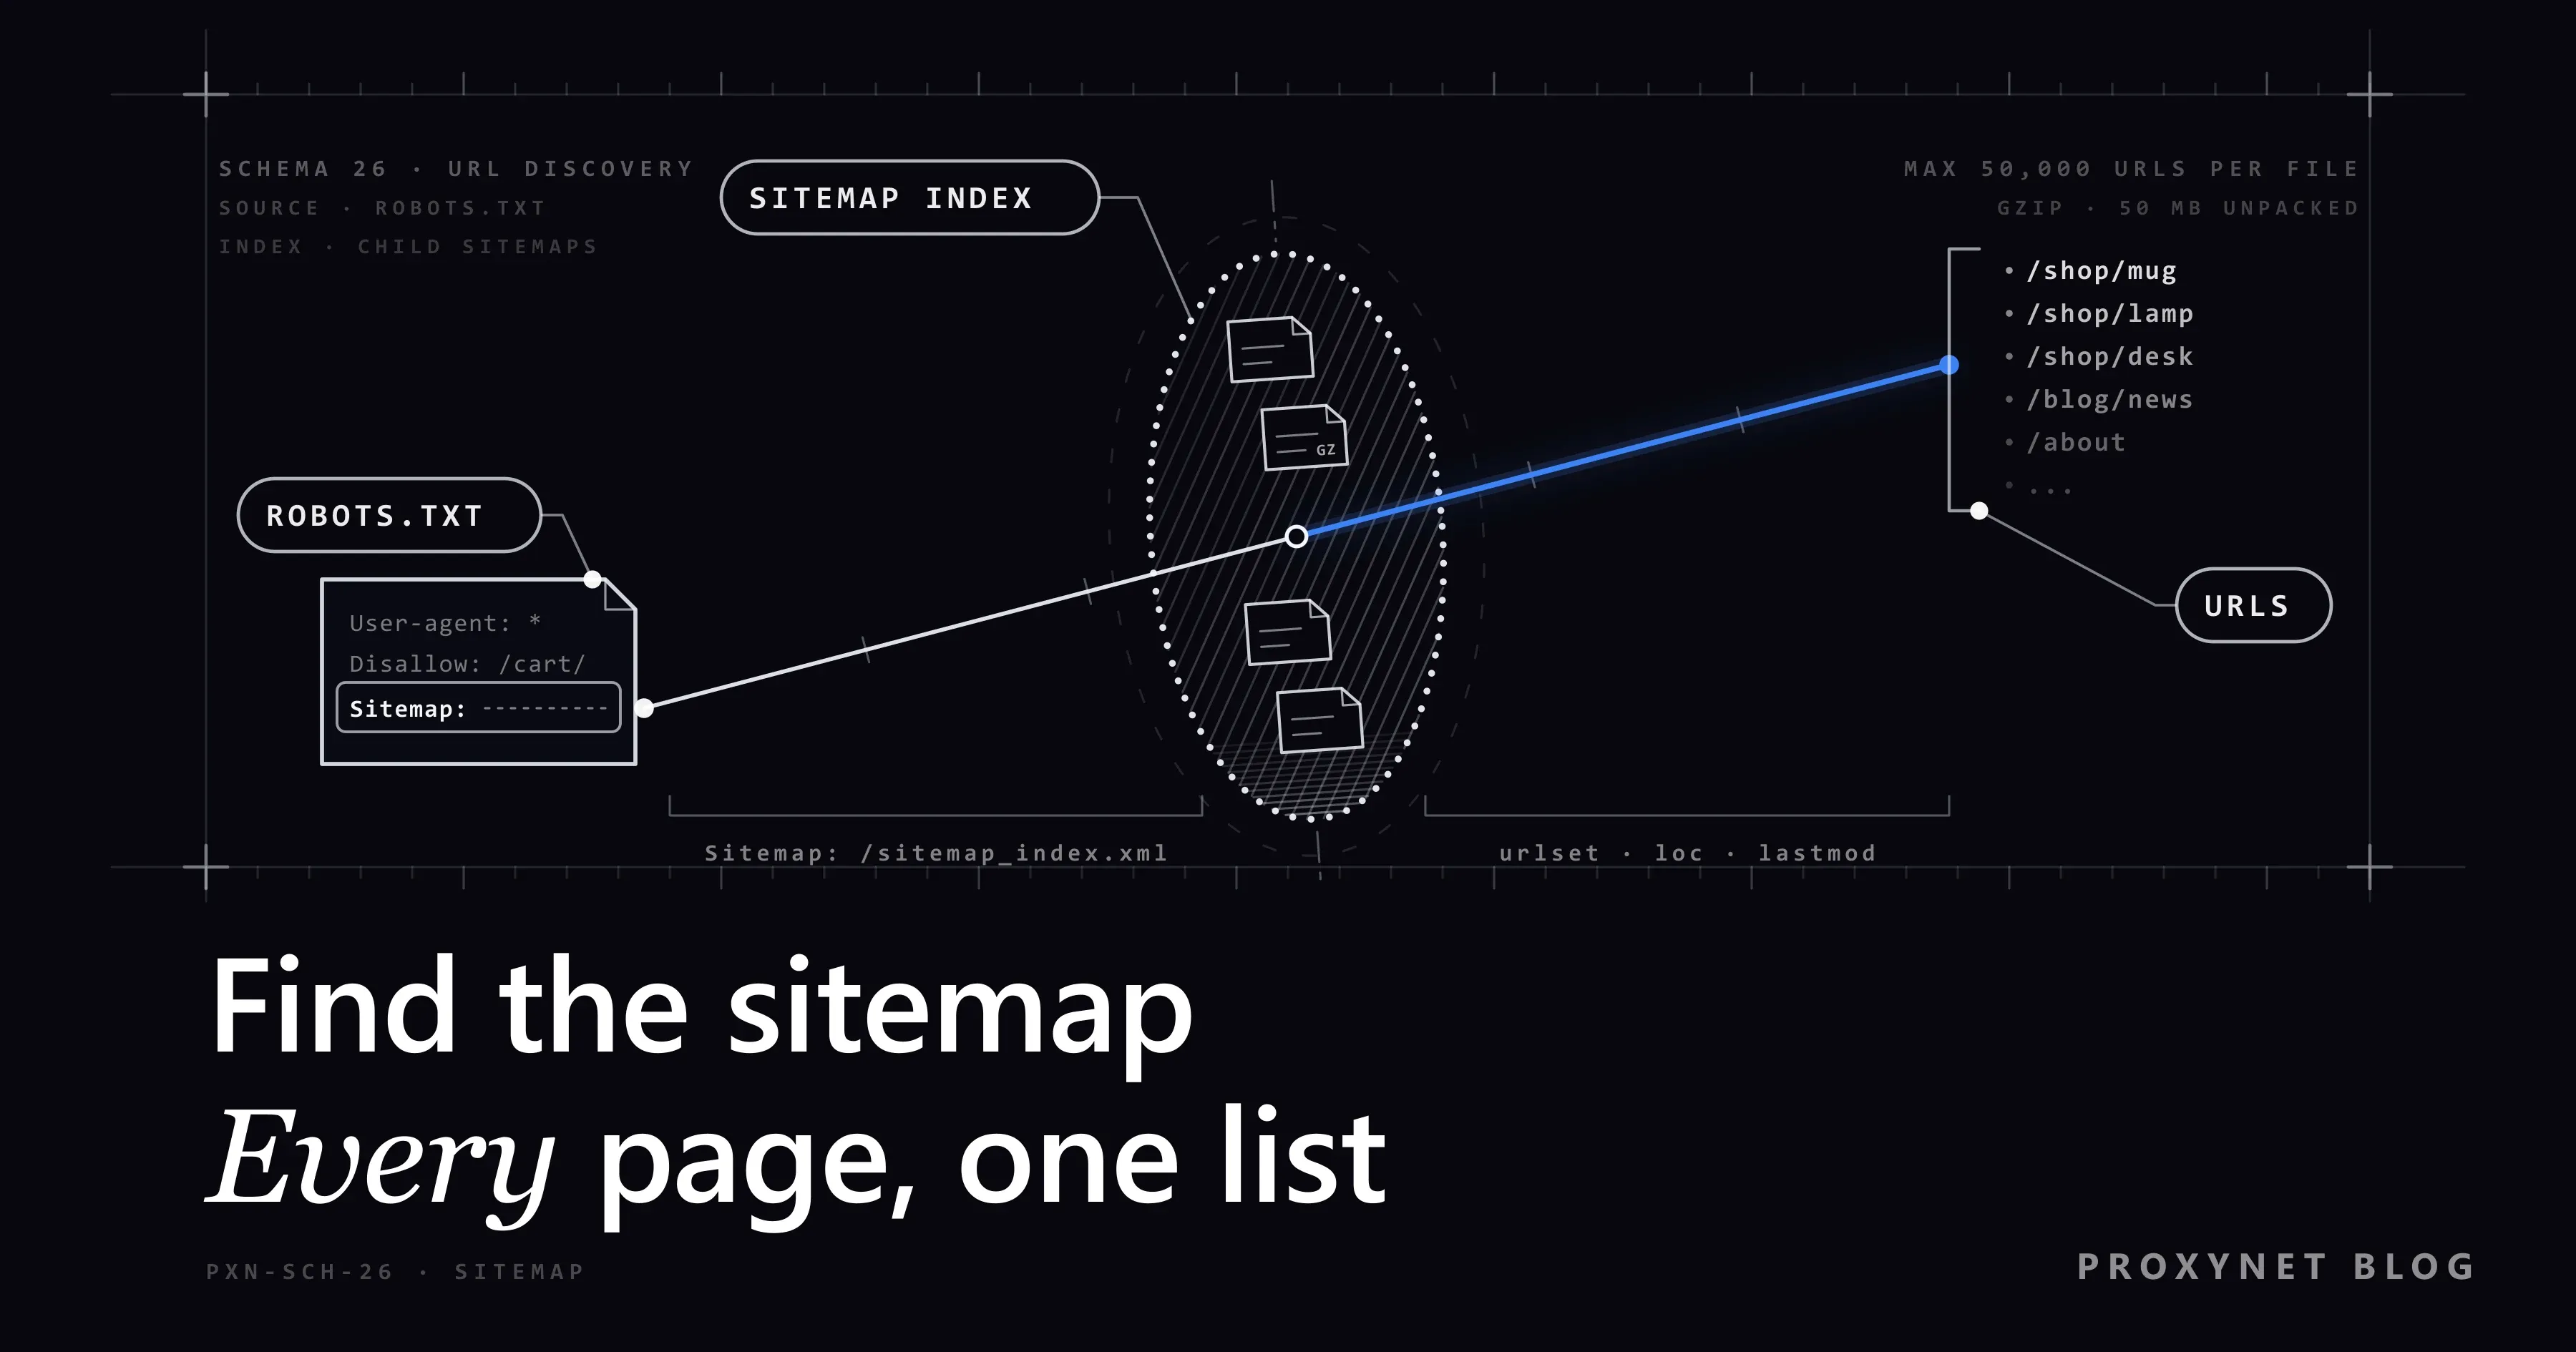
به فهرست همه صفحههای محصول در فروشگاه اینترنتی یک رقیب نیاز دارید. کلیک کردن روی تکتک دستهها ساعتها وقت و هزاران درخواست میگیرد. شاید صاحب سایت همین فهرست را از پیش برای موتورهای جستوجو در یک فایل XML منتشر کرده باشد: نقشه سایت (sitemap)، فایلی که آدرسهایی را که سایت میخواهد خزیده شوند فهرست میکند. اگر آن را پیدا کنید، با چند درخواست همه صفحههای یک وبسایت را میبینید.
این راهنما نشان میدهد نقشه سایت را کجا و به چه ترتیبی جستوجو کنید، فایل را چگونه بخوانید، فایلهای فهرست (sitemap index) و فایلهای .gz را چگونه باز کنید و چگونه با lastmod فقط صفحههای تغییرکرده را برگزینید. در پایان یک اسکریپت آزموده پایتون آمده است؛ همچنین توضیح میدهیم چرا نقشه سایت هرگز کل سایت را نشان نمیدهد و بدون آن چه باید کرد. برای تصویر کلیتر طراحی خزنده، صفحه خزنده وب ما را ببینید.
نقشه سایت یک وبسایت را چگونه پیدا کنیم؟
این جاها را به ترتیب امتحان کنید. هزینه هر گام فقط یک درخواست است.
- سطرهای
Sitemap:در robots.txt. نشانیhttps://example.com/robots.txtرا باز کنید. صاحبان سایت آدرس کامل هر نقشه سایت را آنجا مینویسند. RFC 9309 به خزندهها اجازه میدهد این سطرها را همچون رکوردی بیرون از پروتکل robots.txt بخوانند (بخش 2.2.4)؛ بقیه نحو فایل در فایل robots.txt چیست و چگونه آن را بخوانیم؟ آمده است. - مسیرهای ریشه.
/sitemap.xmlو سپس/sitemap_index.xmlرا امتحان کنید. بیشتر ابزارهای سازنده نقشه سایت یکی از این دو را به کار میبرند. - مسیر ویژه پلتفرم. هسته وردپرس از نسخه 5.5 یک فایل فهرست در
/wp-sitemap.xmlمنتشر میکند و آن را به robots.txt میافزاید (اطلاعیه وردپرس 5.5). افزونههای سئو مانند Yoast فهرست خودشان را جایگزین آن میکنند که معمولاً/sitemap_index.xmlاست. Shopify فایل/sitemap.xmlرا ارائه میدهد که به نقشههای جداگانه برای محصولات، مجموعهها، بلاگها و صفحهها پیوند میدهد. - نقشه سایت HTML. صفحه «نقشه سایت» در پاورقی سایت برای انسان نوشته شده، اما بخشهای اصلی را نشان میدهد.
- Search Console، برای سایت خودتان. گزارش Sitemaps آنچه را ارسال کردهاید فهرست میکند و نشان میدهد Google در هر فایل چند URL یافته است.
جستوجوی site:example.com filetype:xml که یک بار دستی در Google تایپ شود هم میتواند کمک کند. آن را خودکار نکنید: Google پرسوجوهای اسکریپتی را ترافیک غیرعادی میداند (خطای ترافیک غیرعادی Google چیست و چگونه رفع میشود؟).
فایل نقشه سایت را چگونه بخوانیم: urlset، sitemapindex و lastmod
نقشه سایتی با دو صفحه این شکل است:
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
<url>
<loc>https://example.com/product/1</loc>
<lastmod>2026-09-21T12:00:00+00:00</lastmod>
</url>
<url>
<loc>https://example.com/product/2?colour=red&size=m</loc>
</url>
</urlset>پروتکل sitemap فقط <loc> را الزامی میداند؛ <lastmod>، <changefreq> و <priority> اختیاریاند. Google دو مورد آخر را نادیده میگیرد و lastmod را فقط وقتی به کار میبرد که «بهطور پیوسته و قابل راستیآزمایی» دقیق باشد (Google Search Central). وقتی فایل شخص دیگری را میخوانید، چهار قاعده دیگر هم مهم است:
- هر فایل حداکثر 50,000 URL و 50 مگابایت (52,428,800 بایت) در حالت فشردهنشده دارد.
- فایل UTF-8 است و
&به شکل&نوشته میشود. تجزیهگر XML آن را به حالت اول برمیگرداند؛ عبارت باقاعده نه. - نقشه سایتی که در
/catalog/sitemap.xmlقرار دارد فقط میتواند آدرسهای زیر/catalog/را فهرست کند. - سطرهای
<xhtml:link hreflang="…">به نسخههای زبانی یک صفحه اشاره میکنند؛ مدخل<loc>نیستند.
چگونه از نقشه سایت به همه URLها برسیم؟
اسکریپتی که یک دامنه را به فهرست URL تبدیل میکند اینگونه کار میکند:
- robots.txt را یک بار دانلود کنید؛ قواعد و سطرهای
Sitemap:آن را نگه دارید. - اگر سطر
Sitemap:نبود، مسیرهای رایج را امتحان کنید و با نخستین پاسخ200متوقف شوید. - فایل را دانلود کنید. اگر دو بایت نخستش
1f 8bبود، آن را با gzip از حالت فشرده خارج کنید. - عنصر ریشه را بررسی کنید. اگر
sitemapindexبود، گام 3 را برای هر<loc>فرزند تکرار کنید؛ اگرurlsetبود، مدخلها را جمع کنید. - اگر مرز تاریخی دارید، مدخلهای قدیمیتر را کنار بگذارید و از فایلهای فرعی که
lastmodآنها در فایل فهرست قدیمیتر است بگذرید. - هر آدرس را با robots.txt بسنجید و از آدرسهای بسته بگذرید.
- تکراریها را حذف کنید و بقیه را در صف بگذارید. نگه داشتن صف روی دیسک، تا اجرای متوقفشده بتواند از همانجا ادامه یابد، در صفحهبندی چیست و چگونه همه صفحهها را اسکرپ کنیم؟ آمده است.
خزنده همین نوع فهرست را با دنبال کردن پیوندها میسازد: یک درخواست برای هر صفحه، با قواعدی برای عمق و تکراریها. تفاوت این دو در وب اسکرپینگ در برابر خزش وب توضیح داده شده است.
روشهای کشف URL در کنار هم
| روش | بار روی سایت | آنچه نشان میدهد | اطلاعات تغییر | چه زمانی به کار ببریم |
|---|---|---|---|---|
| نقشه سایت XML | بسیار کم: چند فایل | آدرسهایی که صاحب سایت میخواهد خزیده شوند؛ ممکن است ناقص باشد | lastmod، اگر دقیق باشد | همیشه اول |
| خوراک RSS یا Atom | بسیار کم | فقط محتوای تازه | تاریخ انتشار | بلاگها، اخبار، آگهیهای تازه |
| API رسمی یا خروجی داده | کم، با محدودیتهای مستند | آنچه API ارائه میدهد | معمولاً | وقتی ارائه شود؛ پیش از HTML |
| دنبال کردن پیوندها | زیاد: یک درخواست برای هر صفحه | هر چیزی که پیوند دارد، از جمله تلهها و تکراریها | ندارد | نبود نقشه سایت یا وجود شکاف؛ با سقف عمق |
| Wayback CDX API | ندارد (درخواستها به آرشیو میروند) | آدرسهای آرشیوشده؛ برخی دیگر وجود ندارند | تاریخ ثبت | نبود نقشه سایت؛ فهرست نامزدها |
| Google Search Console | ندارد | صفحههایی که Google میشناسد | وضعیت خزش و ایندکس | فقط سایت خودتان |
نقشه سایت اول میآید: چند درخواست بیشتر آدرسها را برمیگرداند.
فایلهای فهرست نقشه سایت و فایلهای .gz را چگونه باز کنیم؟
سایتهای بزرگ فهرست خود را بر اساس نوع تقسیم میکنند. ریشه فایل فهرست <sitemapindex> است و برای هر فایل فرعی یک عنصر <sitemap> دارد که یک <loc> و یک <lastmod> اختیاری در خود دارد. راهنمای Google درباره نقشههای سایت بزرگ الزام میکند فایلهای فرعی در همان سایت و در پوشه فایل فهرست یا زیر آن باشند. با این حال اسکریپت باید فایلهایی را که باز کرده به خاطر بسپارد تا فایل فهرستی که به خودش ارجاع میدهد آن را در حلقه گرفتار نکند.
فایلهای فشرده معمولاً به .xml.gz ختم میشوند و سرورها اغلب آنها را با نوع application/gzip و بدون هدر Content-Encoding میفرستند. در این حالت Requests بایتهای فشرده را بیتغییر به شما تحویل میدهد؛ در آزمون محلی ما بدنه پاسخ با 1f 8b، یعنی امضای gzip، آغاز شد. بررسی این دو بایت، نام فایل هرچه باشد، جواب میدهد.
سقف 50 مگابایت بر فایل فشردهنشده اعمال میشود، پس خواندن را همانجا متوقف کنید. این کار شما را از بمب فشردهسازی (decompression bomb) هم در امان نگه میدارد، یعنی فایل کوچکی که هنگام باز شدن به چند گیگابایت میرسد؛ یادداشتهای امنیتی XML پایتون آن را در کنار حملههای گسترش entity فهرست کرده است.
استفاده از lastmod برای دریافت فقط صفحههای تغییرکرده
lastmod قالب W3C Datetime را به کار میبرد: یک تاریخ (2026-09-20) یا تاریخ همراه با زمان و منطقه زمانی (2026-09-20T10:00:00+03:00). از پایتون 3.11 به بعد، datetime.fromisoformat() هر دو را میخواند، از جمله Z پایانی. مقدارهای بدون منطقه زمانی را UTC در نظر بگیرید تا همه تاریخها با هم قابل مقایسه باشند.
مدخلهایی را که از اجرای قبلی شما تغییر کردهاند نگه دارید، بهعلاوه مدخلهایی که lastmod ندارند یا lastmod خراب دارند: چیزی نشان نمیدهد که بیتغییر ماندهاند. در فایل فهرست، lastmod میگوید هر فایل فرعی کی تغییر کرده است، پس میتوان از فایل فرعی قدیمیتر بدون دانلود آن گذشت. در آزمون ما با مرز 30 روزه، اسکریپت از فایلی که آخرین بار در ژانویه 2025 تغییر کرده بود گذشت و بهجای چهار درخواست سه درخواست فرستاد.
اینکه تاریخها معنایی دارند یا نه به سایت بستگی دارد:
- تاریخ و زمان یکسان در همه جا: نقشه سایت در هر استقرار (deploy) از نو ساخته میشود و تاریخ چیزی درباره صفحهها نمیگوید.
- بدون تاریخ: در 24 سپتامبر 2026 هیچیک از مدخلهای نقشه سایت docs.python.org مقدار
lastmodنداشت. - برخی تاریخها: هسته وردپرس برای فایلهای درون فهرستش
lastmodنمینویسد، پس باید همه فایلهای فرعی را باز کرد. از وردپرس 6.5 به بعد مدخلهای نوشتههاlastmodدارند؛ نقشههای دسته، برچسب و نویسنده ندارند.
جایی که lastmod به کار نمیآید، از درخواستهای شرطی و 304 Not Modified استفاده کنید که در وب اسکرپینگ بدون مسدود شدن: راهنمای عملی توضیح داده شدهاند.
چرا نقشه سایت با آنچه سایت واقعاً ارائه میدهد فرق دارد؟
Google نقشه سایت ارسالشده را «فقط یک اشاره» مینامد. منتظر پنج نوع تفاوت باشید:
- صفحههای جاافتاده. در 24 سپتامبر 2026،
docs.python.org/sitemap.xmlفقط 8 URL را فهرست میکرد، یعنی یک صفحه آغاز برای هر نسخه پایتون، در حالی که سایت هزاران صفحه ارائه میدهد. - مدخلهای کهنه. محصولات حذفشده در فهرست میمانند و
404یا410برمیگردانند. آنها را از فهرست خود حذف کنید. - تعارض با robots.txt. آدرسی ممکن است در نقشه سایت باشد و در robots.txt بسته باشد. robots.txt قاعده صریح صاحب سایت است، پس از آن آدرس بگذرید؛ در آزمون ما یک صفحه جستوجوی فهرستشده به همین شکل کنار گذاشته شد.
- دامنه پوشش. نقشه سایت یک زیرپوشه فقط همان پوشه را پوشش میدهد و هر زیردامنه robots.txt و نقشه سایت خودش را دارد.
- گونهها. پارامترهای ردیابی، نسخههای زبانی دیگر و صفحههایی که تگ canonical آنها به جای دیگری اشاره میکند همه دیده میشوند. تصمیم بگیرید کدام نسخه را لازم دارید.
نقشه سایت صفحههایی را فهرست میکند که عمداً منتشر شدهاند، نه صفحههای پنهان را؛ صفحههایی که ورود لازم دارند و صفحههای noindex بیرون از این روش میمانند. جنبه حقوقی در آیا اسکرپینگ وب قانونی است؟ یک نمای کلی آمده است.
اگر سایتی نقشه سایت نداشت چه کنیم؟
نقشه سایت اختیاری است. گزینههای مشروع بعدی به ترتیب اینها هستند:
- خوراک. وردپرس یک خوراک در
/feed/ارائه میدهد و بسیاری از سایتها خوراک خود را با<link rel="alternate">در بخش head صفحه اعلام میکنند. برای محتوای تازه به خوبی نقشه سایت کار میکند. - API رسمی یا خروجی داده، با قالب و محدودیت مستند. راه 1 را در اسکرپر Cloudflare: چرا مسدود میشود و چه راهی جواب میدهد؟ ببینید.
- دنبال کردن پیوندها از صفحههای دسته، با سقف عمق و سقف تعداد صفحه، همانطور که در راهنمای خزشی که بالاتر پیوندش آمد توضیح داده شده است.
- Wayback Machine CDX API. پرسوجویی مانند
https://web.archive.org/cdx/search/cdx?url=example.com/blog/&matchType=prefix&collapse=urlkey&fl=original&limit=500آدرسهای آرشیوشده زیر یک مسیر را فهرست میکند (مستندات سرور CDX). برایdocs.python.org/3/library/نتیجه ما شامل2to3.htmlبود که اکنون هدایت میشود، چون پایتون2to3را حذف کرده است. هر آدرس را بررسی کنید وlimitرا نگه دارید تا بار آرشیو هم زیاد نشود. - گزارش Pages در Search Console، برای سایت خودتان.
حدس زدن مسیرها با فهرست کلمات (wordlist)، اسکرپ خودکار نتایج Google یا ورود به بخشهایی که ورود لازم دارند را توصیه نمیکنیم. نرخ درخواست به هر سایت را پایین نگه دارید.
خواندن نقشه سایت با پایتون: یک نمونه کارا
اسکریپت به پایتون 3.11 یا بالاتر، Requests و lxml نیاز دارد (pip install requests lxml).
"""Find a site's sitemap, open indexes and .gz files, and list the URLs.

Usage: python read_sitemap.py https://example.com [DAYS]
With DAYS, only URLs changed in the last DAYS days (or with no usable date) are listed.
"""
import gzip
import io
import os
import sys
import time
from datetime import datetime, timedelta, timezone
from functools import lru_cache
from urllib.parse import urljoin
from urllib.robotparser import RobotFileParser

import requests
from lxml import etree

BOT_NAME = "ExampleSitemapReader"
USER_AGENT = f"{BOT_NAME}/1.0 (+mailto:bots@example.com)"
DELAY = 1.0                        # seconds to wait before every request
LIMIT = 50 * 1024 * 1024           # sitemaps.org: at most 50 MB uncompressed
CANDIDATES = ["/sitemap.xml", "/sitemap_index.xml", "/wp-sitemap.xml"]

session = requests.Session()
session.headers["User-Agent"] = USER_AGENT
if os.environ.get("PROXY_URL"):    # e.g. http://user:pass@pr.proxynet.io:8000
    session.proxies = {"http": os.environ["PROXY_URL"], "https": os.environ["PROXY_URL"]}

xml_parser = etree.XMLParser(resolve_entities=False, no_network=True)


@lru_cache(maxsize=16)             # never download the same file twice in one run
def fetch(url):
    time.sleep(DELAY)
    resp = session.get(url, timeout=(5, 30))
    resp.raise_for_status()
    data = resp.content
    if data[:2] == b"\x1f\x8b":    # gzip: trust the first two bytes, not the file name
        with gzip.GzipFile(fileobj=io.BytesIO(data)) as gz:
            data = gz.read(LIMIT + 1)
    if len(data) > LIMIT:
        raise ValueError(f"{url} is larger than 50 MB uncompressed")
    return data


def read_robots(site):
    robots = RobotFileParser()
    try:
        lines = fetch(urljoin(site, "/robots.txt")).decode("utf-8", "replace").splitlines()
    except requests.HTTPError as err:
        if err.response.status_code >= 500:
            lines = ["User-agent: *", "Disallow: /"]  # RFC 9309: server error, stay out
        else:
            lines = []                                # 4xx: no robots.txt, no rules
    robots.parse(lines)
    return robots


def find_sitemaps(site, robots):
    if robots.site_maps():
        return robots.site_maps()
    for path in CANDIDATES:
        url = urljoin(site, path)
        if not robots.can_fetch(BOT_NAME, url):
            continue
        try:
            fetch(url)
        except requests.HTTPError:
            continue
        return [url]
    return []


def parse_date(text):
    if not text:
        return None
    try:
        when = datetime.fromisoformat(text)  # 2026-09-20, 2026-09-20T10:00:00+03:00 or ...Z
    except ValueError:
        return None                          # broken date: treat as unknown
    return when if when.tzinfo else when.replace(tzinfo=timezone.utc)


def name(el):
    return etree.QName(el).localname         # tag name without the namespace


def read_sitemap(url, since, seen):
    if url in seen:
        return
    seen.add(url)
    try:
        root = etree.fromstring(fetch(url), xml_parser)
    except (requests.RequestException, etree.XMLSyntaxError, ValueError) as err:
        print(f"skipped {url}: {err}", file=sys.stderr)
        return
    is_index = name(root) == "sitemapindex"
    for entry in root.iterchildren(etree.Element):          # elements only, no comments
        fields = {name(f): (f.text or "").strip() for f in entry.iterchildren(etree.Element)}
        loc, lastmod = fields.get("loc"), parse_date(fields.get("lastmod"))
        if not loc:
            continue
        if is_index:
            if since and lastmod and lastmod < since:
                continue                     # nothing in this file changed after the cutoff
            yield from read_sitemap(loc, since, seen)
        elif since is None or lastmod is None or lastmod >= since:
            yield loc, lastmod


if __name__ == "__main__":
    site = sys.argv[1]
    days = int(sys.argv[2]) if len(sys.argv) > 2 else None
    since = datetime.now(timezone.utc) - timedelta(days=days) if days else None
    robots = read_robots(site)
    seen, listed = set(), set()
    for sitemap in find_sitemaps(site, robots):
        for loc, lastmod in read_sitemap(sitemap, since, seen):
            if loc in listed:
                continue
            listed.add(loc)
            if robots.can_fetch(BOT_NAME, loc):
                print(lastmod.date() if lastmod else "-", loc)
            else:
                print("disallowed by robots.txt, skipped:", loc, file=sys.stderr)
اسکریپت چه میکند و چه چیزی را کنار میگذارد
- یک کلاینت مؤدب. یک نشست پیش از هر درخواست یک ثانیه صبر میکند و یک
User-Agentصادقانه با نام ربات و نشانی تماس میفرستد (User-Agent چیست و چگونه آن را ببینیم و تغییر دهیم؟). - robots.txt از طریق کلاینت خودتان. فایل به
RobotFileParser.parse()داده میشود، چونread()آن را با هویت پیشفرض urllib دریافت میکرد. پاسخ4xxیعنی قاعدهای در کار نیست و5xxیعنی دور بمانید، همانطور که RFC 9309 الزام میکند.site_maps()سطرهایSitemap:یاNoneرا برمیگرداند (مستندات پایتون) وcan_fetch()نام ربات را میگیرد، نه کلUser-Agentرا. - تجزیه امن.
resolve_entities=Falseوno_network=Trueنمیگذارند lxml entityها را گسترش دهد یا چیزی را از راه دور بارگذاری کند؛ در آزمون ما یک<loc>که از entityهای تودرتو ساخته شده بود خالی برگشت.localnameتفاوتهای namespace را نادیده میگیرد. - بدون تلاش دوباره و درخواست موازی، عمداً. برای
429وRetry-After، کدهای وضعیت HTTP در وب اسکرپینگ را ببینید؛ برای درخواستهای موازی، همروندی و موازیسازی در وب اسکرپینگ را.
آن را با پایتون 3.13.9، Requests 2.34.2 و lxml 6.1.3 روی یک سایت محلی اجرا کردیم: یک robots.txt که /search/ را میبندد، یک فایل فهرست، یک نقشه محصولات gzip که بدون Content-Encoding فرستاده میشود و یک نقشه صفحهها با تاریخ ژانویه 2025. با مرز 30 روزه:
$ python read_sitemap.py http://127.0.0.1:18766 30
disallowed by robots.txt, skipped: http://127.0.0.1:18766/search/?q=x
2026-09-21 http://127.0.0.1:18766/product/1
- http://127.0.0.1:18766/product/3
- http://127.0.0.1:18766/product/4?colour=red&size=m
product/2 که در مارس تغییر کرده بود بیرون از مرز افتاد؛ product/3 (بدون تاریخ) و product/4 (تاریخ خراب) ماندند و & به شکل & بیرون آمد. نقشه صفحهها هرگز درخواست نشد. بدون robots.txt، اسکریپت فایل فهرست را در دومین مسیر نامزد یافت. روی docs.python.org دو درخواست فرستاد و 8 URL چاپ کرد و همان اجرا از طریق یک پروکسی HTTP محلی با تنظیم PROXY_URL همان فهرست را داد.
خواندن نقشه سایت پروکسی لازم ندارد. سطر پروکسی برای مرحله بعد است، یعنی بررسی صفحههای فهرستشده آنگونه که بازدیدکنندگان کشوری دیگر میبینند؛ آنجا پروکسی مسکونی با همان نرخ مؤدبانه آدرسهای محلی در اختیارتان میگذارد.
اگر کتابخانه را ترجیح میدهید، ultimate-sitemap-parser (نسخه 1.8.1 در PyPI) نقشههای سایت را از طریق robots.txt و نامهای رایج پیدا میکند و با sitemap_tree_for_homepage() درخت را پیمایش میکند. SitemapSpider در Scrapy نقشههای تودرتو را دنبال میکند و میتواند از robots.txt شروع کند (Scrapy چیست و چگونه با پروکسی استفاده میشود؟).
کاربردها
- رصد قیمت: URLهای محصول را از نقشه سایت بردارید و فقط موارد تغییرکرده را دوباره دریافت کنید (رصد قیمت رقبا در فروشگاه اینترنتی چگونه انجام میشود؟).
- ممیزی سئوی سایت خودتان: مطمئن شوید هر URL نقشه سایت
200برمیگرداند و هیچکدام در robots.txt بسته نیست، سپس بررسی کنید صفحهها از کشورهای دیگر چگونه دیده میشوند (پروکسی سئو). - خزشهای بزرگ: از نقشه سایت شروع کنید و از پیوندهای تله دوری کنید (تلههای هانیپات چیست و چه اثری بر اسکرپینگ دارد؟).
- استخراج یکباره: پیش از بیرون کشیدن فیلدها، فهرست URL را آماده کنید (استخراج داده از وبسایت: Excel، پایتون و ابزارهای آماده).
- پایش تغییرات: اجرای روزانه با مرز یکروزه آگهیها یا مقالههای تازه را نشان میدهد (خزنده وب).
اشتباهات رایج
- امتحان کردن فقط
/sitemap.xml. robots.txt اغلب فایل دیگری را نام میبرد. - خواندن فقط نخستین سطر
Sitemap:. هر سطر به حساب میآید. - فهرست صفحه دانستن فایل فهرست. مقدارهای
<loc>آن خودشان نقشه سایتاند. - تشخیص gzip از روی نام فایل. دو بایت نخست را بررسی کنید.
- کنار گذاشتن مدخلهای بدون
lastmod. ممکن است همانها تغییر کرده باشند. - اعتماد به
lastmodکه همه جا یکسان است. این تاریخ زمان ساخت را ثبت میکند. - دریافت یک URL فقط چون نقشه سایت آن را فهرست کرده است. robots.txt همچنان معتبر است.
- تجزیه XML با عبارت باقاعده.
&به همان شکل رمزشده میماند. - دانلود همه فایلهای فرعی در هر اجرا. از
lastmodفایل فهرست استفاده کنید. برای اتصالهای ناموفق، خطای Max Retries Exceeded With URL چیست و چگونه رفع میشود؟ را ببینید.
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
| نشانی نقشه سایت یک سایت، بهسرعت | /robots.txt، سپس /sitemap.xml و /sitemap_index.xml |
| نقشه سایت یک سایت وردپرسی | /wp-sitemap.xml؛ با افزونه سئو /sitemap_index.xml |
| هزاران آدرس به شکل فهرست | اسکریپتی که فایل فهرست و gzip را باز کند، یا ultimate-sitemap-parser |
| فقط صفحههایی که از اجرای قبلی تغییر کردهاند | مرز lastmod؛ جایی که تاریخها به کار نمیآیند، درخواستهای شرطی |
| URL نقشه سایت که در robots.txt بسته است | از آن بگذرید |
| نبود نقشه سایت | خوراک و API، سپس دنبال کردن محدود پیوندها یا Wayback CDX |
| همه صفحههای سایت خودتان | گزارشهای Pages و Sitemaps در Search Console |
| خزش منظم URLهای نقشه سایت در مقیاس بزرگ | خزندهای با استخر پروکسی (خزنده وب، پروکسی چرخشی) |
پرسشهای متداول
نقشه سایت یک وبسایت را چگونه ببینم؟
دامنه را همراه با /robots.txt در مرورگر تایپ کنید و آدرسی را که در سطر Sitemap: آمده باز کنید. اگر چنین سطری نبود، /sitemap.xml و /sitemap_index.xml را امتحان کنید. فایل .gz دانلود میشود و باید نخست از حالت فشرده خارج شود.
آیا هر وبسایتی نقشه سایت دارد؟
نه. نقشه سایت اختیاری است و سایتهای کوچک با پیوندهای داخلی خوب اغلب آن را ندارند. بدون نقشه سایت، از خوراک، API، دنبال کردن محدود پیوندها یا Wayback CDX API استفاده کنید.
تفاوت sitemap.xml و sitemap_index.xml چیست؟
sitemap_index.xml معمولاً فایل فهرستی است که نقشههای دیگر را فهرست میکند. با این حال نام فایل تعیینکننده نیست: فایل را باز کنید و عنصر ریشه را بررسی کنید. <urlset> صفحهها را در خود دارد و <sitemapindex> نقشههای سایت را.
صفحههایی را که در نقشه سایت نیستند چگونه پیدا کنم؟
از صفحههای شناختهشده پیوندها را دنبال کنید، خوراک را بخوانید، از API استفاده کنید یا از Wayback CDX API پرسوجو کنید و سپس آدرسهای آرشیوشده را بررسی کنید. حدس زدن مسیرها با فهرست کلمات را توصیه نمیکنیم. دنبال کردن پیوندها در وب اسکرپینگ در برابر خزش وب آمده است.
آیا میتوانم به lastmod اعتماد کنم؟
به سایت بستگی دارد. تاریخهای یکسان در همه مدخلها یعنی نقشه سایت در هر ساخت از نو تولید میشود. هسته وردپرس lastmod را در فایل فهرست و در نقشههای دسته و نویسنده نمینویسد. جایی که تاریخها به کار نمیآیند، درخواستهای شرطی به سرور اجازه میدهند برای صفحههای بیتغییر پاسخ 304 بدهد.
اگر URL نقشه سایت در robots.txt مسدود بود چه کنم؟
از آن بگذرید. robots.txt قاعده صریح صاحب سایت برای خزندههاست، در حالی که نقشه سایت فقط یک فهرست است. اسکریپت بالا هر آدرس را پیش از چاپ با can_fetch() بررسی میکند؛ جزئیات در فایل robots.txt چیست و چگونه آن را بخوانیم؟ آمده است.
خلاصه
نقشه سایت را نخست در robots.txt جستوجو کنید، سپس در /sitemap.xml، /sitemap_index.xml و مسیر ویژه پلتفرم. فایلهای فهرست و gzip را باز کنید، با lastmod فقط آنچه را تغییر کرده نگه دارید و بگذارید robots.txt همیشه بر نقشه سایت مقدم باشد. بدون نقشه سایت، سراغ خوراکها، APIها، دنبال کردن محدود پیوندها و Wayback CDX API بروید. وقتی فهرست به هزاران صفحه در روز میرسد، صفحه خزنده وب ما نشان میدهد این خزش را چگونه در مقیاس بزرگ اجرا کنید.