Tu script de Python recoge cada mañana páginas de producto de unas cuantas decenas de tiendas. Funciona en todas menos en una. Esa tienda responde con un 403 y una página HTML corta que pide JavaScript y cookies. Si vuelves a ejecutar el script, recibes la misma página. La tienda está detrás de Cloudflare, y Cloudflare respondió antes de que el servidor de la propia tienda viera tu solicitud.
Tarde o temprano, todo scraper que visita sitios con Cloudflare recibe una respuesta así. En esta guía verás cómo leerla, qué vías legítimas llevan a los datos y qué puede cambiar un proxy y qué no. Al final hay un scraper en Python probado que clasifica cada respuesta de Cloudflare y se detiene cuando el sitio se niega, sin intentar esquivar ninguna verificación.
¿Qué significa «Cloudflare scraper»?
Un Cloudflare scraper no es una herramienta especial: es cualquier scraper cuyo sitio de destino pasa su tráfico por Cloudflare. (Algunos paquetes de Python usan el mismo nombre para herramientas que resuelven verificaciones; más abajo explicamos por qué no las tratamos.) En un sitio así, el DNS devuelve direcciones de Cloudflare, de modo que tu solicitud llega primero a un servidor de Cloudflare. Ahí Cloudflare aplica la configuración de seguridad del propietario y solo reenvía al servidor de origen (el servidor propio del sitio) las solicitudes que pasan. Este esquema es un reverse proxy: trabaja para el sitio, mientras que el forward proxy que configuras en tu scraper trabaja para ti (Forward proxy y reverse proxy).
¿Cómo decide Cloudflare que una solicitud es un bot?
Cloudflare aplica los ajustes del propietario uno tras otro, y el primero que bloquea la solicitud o le muestra una verificación pone fin a la comprobación. De forma simplificada:
- Comprobaciones de IP y de cabeceras. Las reglas IP Access se fijan en la dirección IP, en su red (ASN) o en su país. Browser Integrity Check, activado por defecto, muestra una verificación a las solicitudes sin
User-Agento con uno no estándar. - Reglas personalizadas. Las reglas que escribe el propietario pueden fijarse en la ruta, el país, el
User-Agent, la puntuación de bot y más. - Reglas de limitación de velocidad. La mayoría de los planes cuentan las solicitudes por IP. Advanced Rate Limiting, del plan Enterprise, también puede contar por cookie, cabecera, ASN o, con Bot Management, por huella TLS (JA3/JA4).
- Reglas gestionadas y productos contra bots. Se comprueban patrones de ataque conocidos y después actúa Bot Fight Mode, Super Bot Fight Mode o Bot Management, según el plan.
- La respuesta. La solicitud llega al origen, recibe una página de error o recibe una verificación que ejecuta comprobaciones en el navegador y, si se superan, guarda una cookie
cf_clearance.
Las señales que hay detrás de cada paso están en Cómo funciona la detección de bots, y la capa de sesión en Cloudflare Precursor.
¿Qué bloqueo de Cloudflare ha recibido tu scraper?
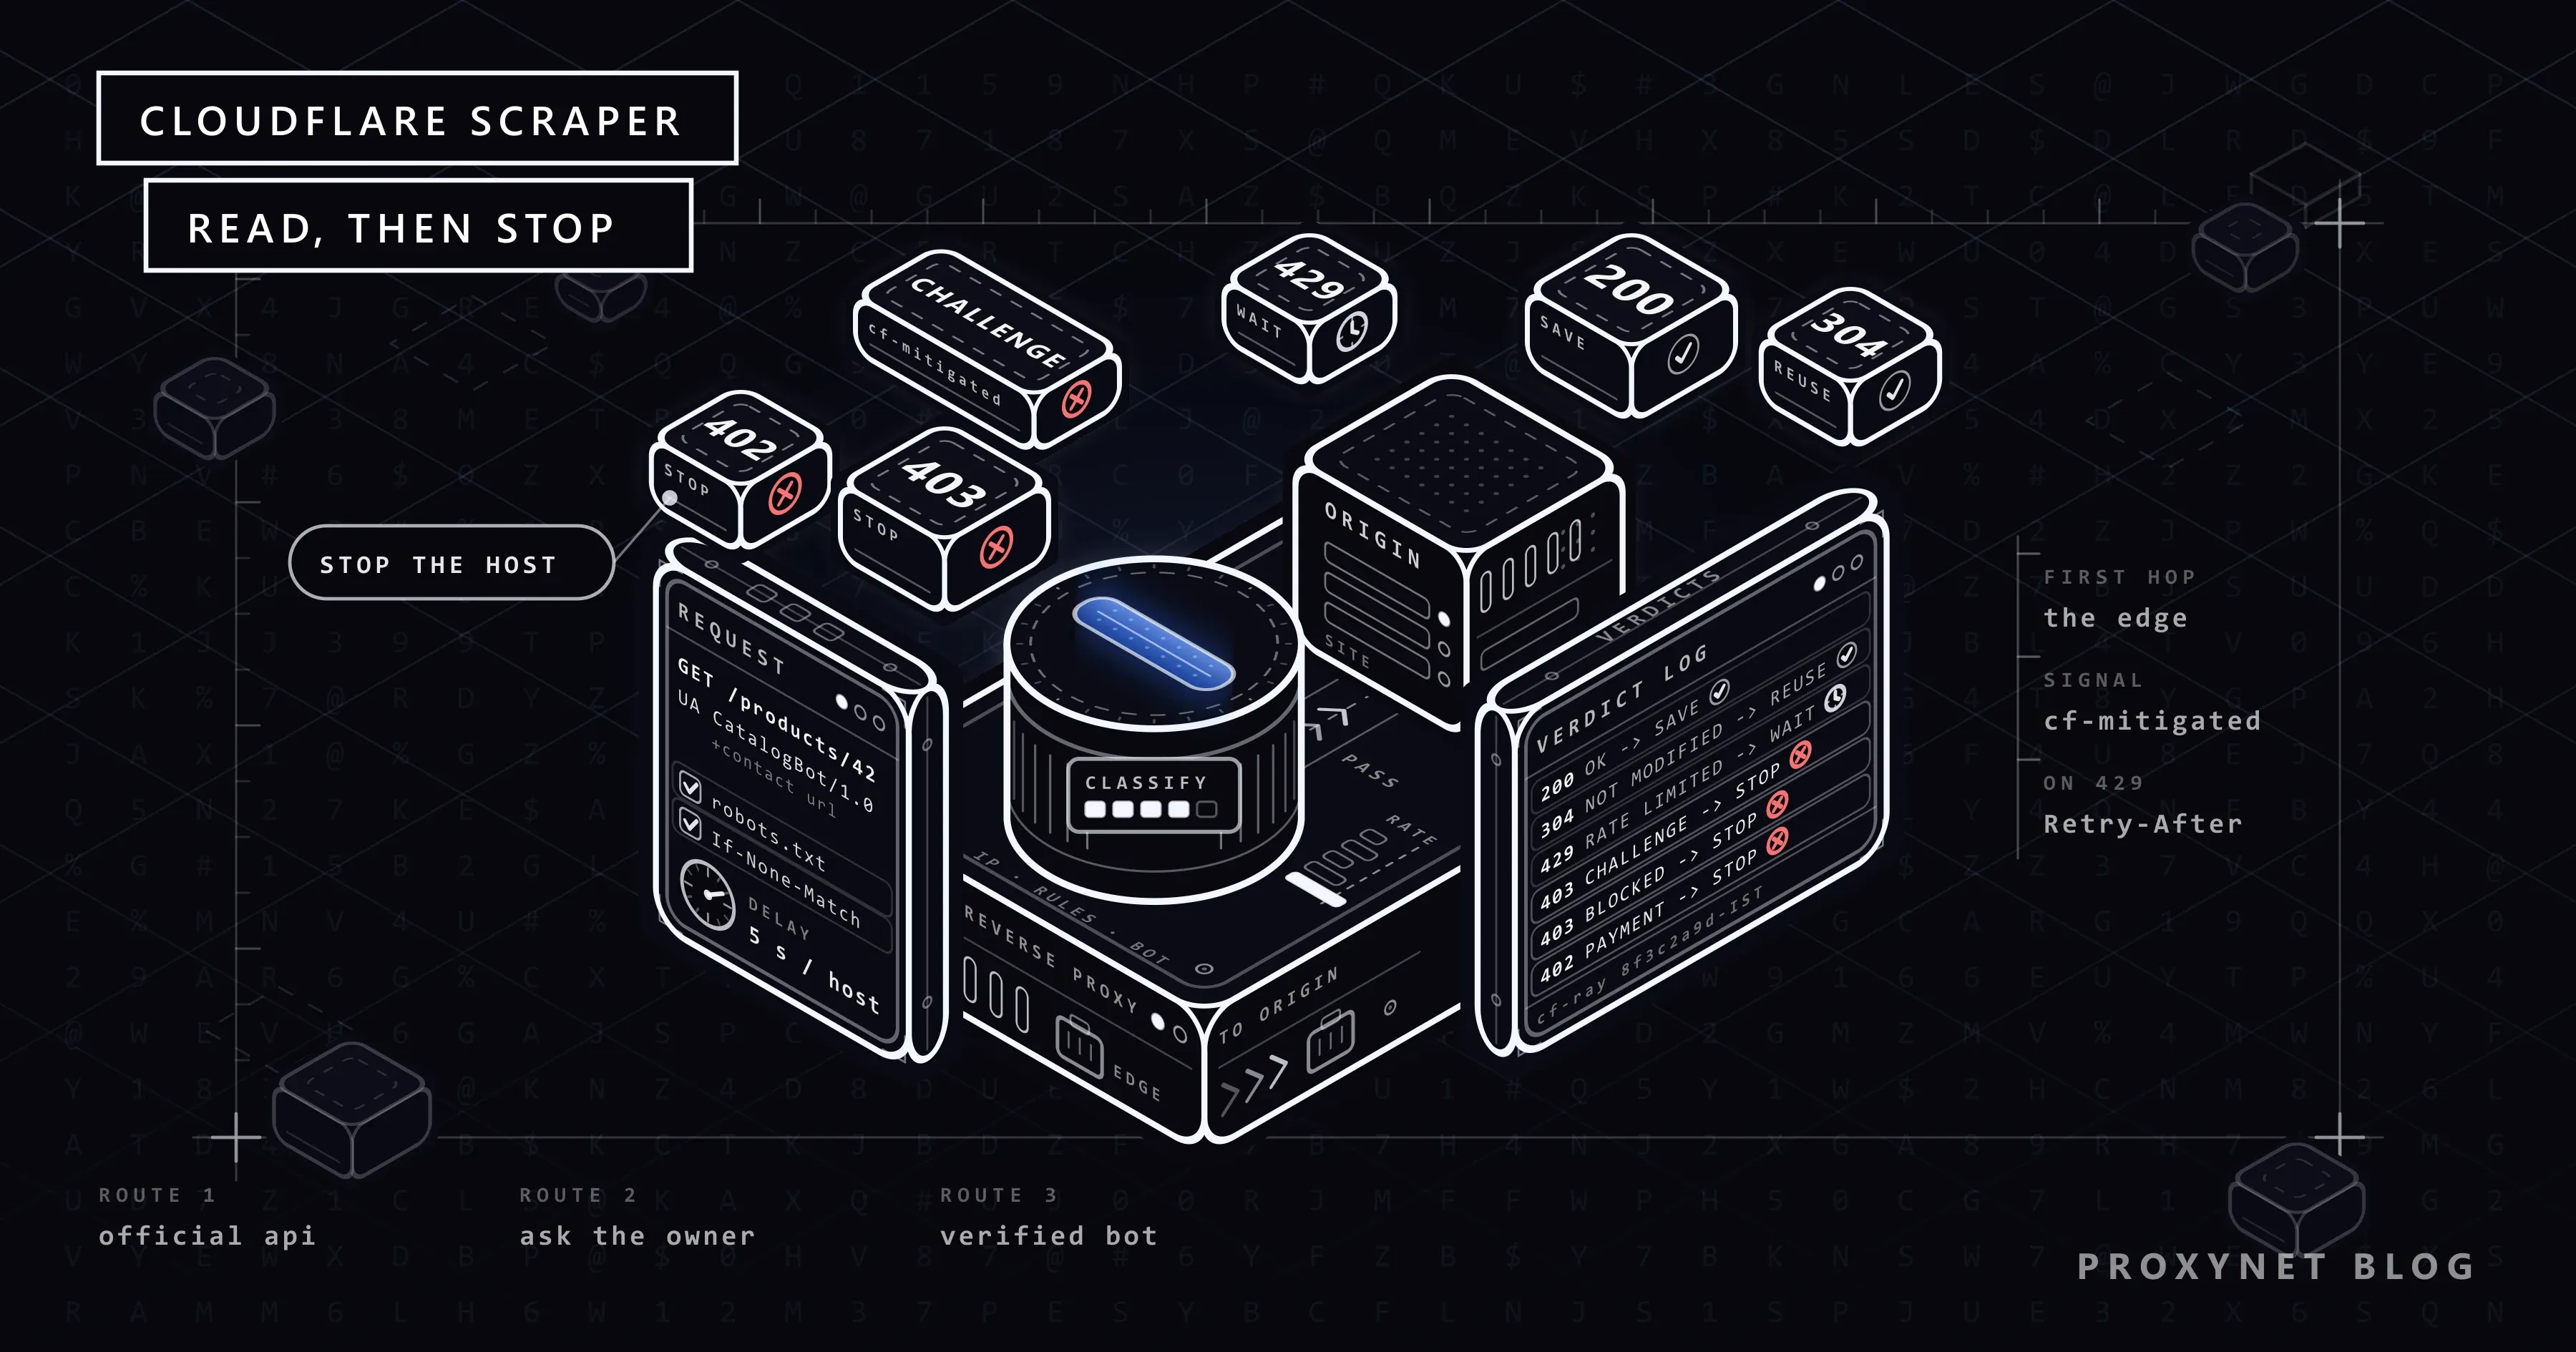
Un 403 de un sitio con Cloudflare puede ser una verificación, una regla de firewall, una red vetada o el rechazo del propio servidor de origen. Mira primero las cabeceras, después el código de estado, después el cuerpo y por último tu propia comprobación de contenido. Las cabeceras cf-ray y server: cloudflare no significan nada por sí solas, porque las lleva toda respuesta que pasa por Cloudflare.
| Lo que ves | Estado | Señal | Significado | Siguiente paso |
|---|---|---|---|---|
| Una página corta que pide JavaScript | A menudo 403 | cf-mitigated: challenge | Una página de verificación | Detente; no intentes resolverla |
| Una página normal con un formulario Turnstile | 200 | Un elemento cf-turnstile | Turnstile protege ese formulario | No envíes el formulario |
| "Sorry, you have been blocked" | 403 por defecto | Una página de Cloudflare, un Ray ID, ningún código 1xxx | Una regla WAF del propietario | Detente; envía el Ray ID al propietario |
| Error 1020, "Access denied" | 403 | Un código 1xxx de Cloudflare | Una regla de firewall antigua (legacy) | Detente; envía el Ray ID al propietario |
| Error 1010 | 403 | Igual | Browser Integrity Check te bloqueó | Pregunta al propietario |
| Error 1005, 1006-1008, 1106 o 1009 | 403 | Igual | Se ha vetado tu red (ASN), tu IP o tu país | Detente; no cambies de red |
| Error 1015 | 429 por defecto, o un 4xx que elige el propietario | 1015 en el cuerpo, o el 429 | Un límite de velocidad, de 10 segundos a un día según el plan | Espera, respeta Retry-After, baja el ritmo |
| Un aviso de pago | 402 | Cabecera crawler-price | Pay per crawl para crawlers de IA | Detente, salvo que participes |
| Una página de error simple | 403 | Ni código de error de Cloudflare ni Ray ID | El servidor de origen se negó | Detente; pregunta al propietario |
| Una página sin tus datos | 200 | Tu comprobación de contenido falla | Una página construida con JavaScript o una página trampa | No la guardes; consulta Páginas estáticas y dinámicas y Trampas honeypot |
| Un error del servidor | 5xx, incluidos 520-526 | Código de estado | Un problema en el origen, no un bloqueo | Espera y reintenta unas pocas veces |
Aquí importan cuatro detalles:
- Fíate de la cabecera, no del texto. Cloudflare documenta
cf-mitigated: challengecomo la forma de detectar la respuesta de una página de verificación: todos los tipos de verificación la envían, ychallengees su único valor. El texto de la verificación cambia con el idioma del navegador, y/cdn-cgi/challenge-platform/también aparece en páginas normales. Esa misma página, vista desde el lado del visitante, la tratamos en Cloudflare «Verifying you are human». - Los códigos de error llegan de dos formas. Cloudflare envía o bien una página HTML con su marca ("Error 1020") o bien un cuerpo de texto corto como
error code: 1003. Nosotros recibimos la forma corta al pedir directamente una dirección IP de Cloudflare, incluso con unUser-Agentde navegador. - No todo código 1xxx es un bloqueo. Error 1016, por ejemplo, es un error de DNS del origen, en el lado del sitio.
- Los bloqueos no llevan la cabecera
cf-mitigated. Solo el cuerpo distingue un bloqueo de Cloudflare del403propio del origen: un código de error, o una página de Cloudflare con un Ray ID. Los códigos uno por uno están en "Sorry, you have been blocked", y los límites de velocidad en Error 1015.
¿Por qué Cloudflare bloquea Python Requests si el navegador sí pasa?
Chrome carga la página tras una breve espera, mientras que Python Requests recibe la verificación. Hay tres diferencias.
Sin JavaScript. Cloudflare indica que un visitante necesita JavaScript y cookies para superar cualquier tipo de verificación. Requests, httpx y curl descargan el HTML, pero nunca lo ejecutan.
Sin cookie de permiso. Un navegador que supera la verificación guarda una cookie cf_clearance y la envía en cada solicitud posterior. Un cliente HTTP simple nunca la recibe.
Una identidad de cliente que no encaja. Las bibliotecas de Python abren la conexión TLS de forma distinta a Chrome, así que una solicitud que dice "Chrome" en su User-Agent pero trae el handshake TLS de Python es fácil de detectar (¿Qué es la huella TLS y cómo funciona JA3?). Un nombre de bot honesto también puede activar Browser Integrity Check, que muestra una verificación ante valores de User-Agent no estándar; solo el propietario puede hacer una excepción.
Algunas herramientas hacen que un script se haga pasar por un navegador: plugins stealth, bibliotecas que imitan el TLS de un navegador, drivers parcheados y servicios que resuelven verificaciones. No las tratamos. Falsean tu cliente, suelen incumplir las condiciones del sitio y dejan de funcionar cada vez que cambia la detección.
¿Qué vías legítimas llevan a los datos de un sitio protegido por Cloudflare?
Estas son las vías, en el orden en que las probaríamos.
1. Una API oficial, un feed o un sitemap
Muchos sitios publican datos pensados para máquinas: una API, un feed RSS o de productos, o un sitemap indicado en robots.txt. Una API te da una clave, un límite documentado y un formato estable, y nada se rompe cuando cambia el HTML. Antes de escribir un scraper, revisa el pie de página, las páginas para desarrolladores y las líneas Sitemap: de robots.txt.
2. Pregunta al propietario del sitio
Solo el propietario puede retirar una verificación o un bloqueo; el personal de Cloudflare no puede. Escribe un mensaje breve con el nombre de tu bot, una dirección de contacto, las rutas que necesitas, con qué frecuencia visitas el sitio y tu dirección IP. Así el propietario puede permitir tu IP con una regla IP Access, que se salta las reglas personalizadas, la limitación de velocidad y las reglas gestionadas; Bot Fight Mode tampoco actúa sobre ella. En los planes de pago, una regla Skip también puede eximirte de Super Bot Fight Mode; normalmente también se basa en una IP fija o en un token de cabecera que acuerdas con el propietario. Para una dirección fija, consulta IP estática para API o usa Proxies ISP.
3. Únete al programa de bots verificados de Cloudflare
Para un crawler que presta un servicio público, el programa de bots verificados de Cloudflare es la vía formal. Un bot verificado demuestra quién es con una firma Web Bot Auth, con una lista pública de IP y un User-Agent estable, o con DNS inverso. Debe respetar robots.txt y mantener un ritmo razonable. La solicitud se hace con un formulario del panel de Cloudflare; los nombres genéricos como python-requests no se aceptan para la validación por IP. Desde el 1 de julio de 2026, el programa también cubre a los agentes firmados que actúan en nombre de usuarios, y entre sus categorías están SEO, seguimiento y scraping de precios.
Con Web Bot Auth, el bot firma cada solicitud con su clave privada según RFC 9421 HTTP Message Signatures, estándar desde febrero de 2024, y publica la clave pública en su propio dominio. El grupo de trabajo del IETF adoptó las reglas para bots como borrador, draft-ietf-webbotauth-httpsig-protocol, el 1 de septiembre de 2026; el flujo completo está en por qué los sitios bloquean a los agentes de compra con IA. La verificación demuestra quién eres, pero el propietario sigue decidiendo si los bots verificados pueden entrar.
4. Para crawlers de IA: ajustes por defecto y pay per crawl
Desde julio de 2025, los dominios nuevos de Cloudflare bloquean por defecto los crawlers de IA. Desde el 15 de septiembre de 2026, los dominios nuevos también bloquean los bots de las categorías Training y Agent en las páginas con anuncios, mientras que la categoría Search sigue permitida. Algunos sitios añaden a robots.txt líneas Content-Signal como ai-train=no; urllib.robotparser las ignora (lo comprobamos), así que léelas tú. Pay per crawl empezó como beta privada en julio de 2025, y en septiembre de 2026 la documentación de Cloudflare todavía lo llama beta cerrada. Un crawler sin cabeceras de pago recibe un 402 con una cabecera crawler-price.
5. Un navegador real, solo donde haga falta
Si una página construye sus datos con JavaScript y el sitio permite la automatización, Playwright obtiene la página renderizada (Playwright con un proxy). Mira antes la pestaña de red: a menudo los datos vienen de una solicitud JSON a la que puede llamar un cliente simple. Cloudflare indica que no admite frameworks de automatización como Playwright para resolver sus verificaciones, así que, si aparece una, detente y vuelve a la vía 2.
¿Dónde ayudan los proxies y dónde no?
Un proxy solo cambia la dirección IP y la red de tu solicitud. No cambia el handshake TLS, no ejecuta JavaScript y no lleva cf_clearance. Rotar en cada solicitud hace que un solo cliente parezca muchos visitantes desconocidos sin historial (cómo funciona la rotación de IP).
Es la herramienta adecuada en tres casos:
- Contenido de un país. Con Proxies residenciales de ese país ves la página que ven los visitantes locales.
- Una IP fija que el propietario autorizó. Con Proxies ISP esa dirección se mantiene estable.
- Muchos sitios, un ritmo prudente para cada uno. Con Proxies rotativos cada sitio puede recibir una salida distinta, y con Proxies de sesión fija mantienes una salida por sitio. Nunca uses la rotación para enviar a un sitio más solicitudes de las que se permitirían a una sola IP.
Saltarse un veto no es uno de esos casos: cambiar de red después de Error 1005 o 1006 es justo lo que esas reglas quieren impedir.
Un scraper en Python para Cloudflare que sabe cuándo parar
El script es para trabajos que tienes permiso para ejecutar, como catálogos públicos en sitios que permiten el rastreo, o un sitio cuyo propietario añadió tu IP a su lista de IP autorizadas. Sin intentar superar ninguna comprobación, el script:
- envía un
User-Agenthonesto con el nombre del bot y una URL de contacto; - lee
robots.txtuna vez por host con el mismo clasificador y deja de rastrear ese host si ahí encuentra una verificación o un bloqueo (una regla prudente nuestra, ya que RFC 9309 trata un4xxcomo "sin reglas"); - registra el error real cuando no puede descargar
robots.txt, por ejemplo tras un407por una contraseña de proxy incorrecta, para que un error de configuración no parezca un rechazo; - espera
MIN_DELAYsegundos, o unCrawl-delaymás largo, entre dos solicitudes al mismo host (solo segundos enteros:urllib.robotparserignora1.5); - envía
If-None-MatcheIf-Modified-Since, de modo que una página sin cambios solo cuesta un304; - ante un
429o un5xx, respetaRetry-Afteren las dos formas que permite RFC 9110 o, si no lo hay, duplica la espera; nunca espera más deMAX_WAITy abandona el host trasMAX_RETRIESreintentos (Códigos de estado HTTP en web scraping); - ante una verificación, un bloqueo o un
402, registra la URL y el valor decf-rayy deja ese host.
Usa Requests en modo síncrono (pip install requests), porque la idea es enviar a cada host una sola solicitud cada vez, a un ritmo prudente (HTTPX, Requests y AIOHTTP).
"""Un scraper pequeño para sitios detrás de Cloudflare que lee cada respuesta y se detiene cuando le dicen que no."""
import email.utils
import logging
import math
import re
import time
from datetime import datetime, timezone
from enum import Enum
from urllib.parse import urlsplit
from urllib.robotparser import RobotFileParser

import requests

BOT_NAME = "NorthwindCatalogBot"
USER_AGENT = f"{BOT_NAME}/1.0 (+https://example.com/bot)"
PROXY = "http://user:pass@pr.proxynet.io:8000"  # una IP de salida fija que el propietario autorizó, o None
EXPECT = 'data-sku="'  # un marcador que contiene toda página de producto real
MIN_DELAY = 5.0        # segundos entre dos solicitudes al mismo host
MAX_WAIT = 300         # no esperar nunca más de esto antes de un reintento
MAX_RETRIES = 3        # reintentos tras un 429 o un 5xx antes de abandonar el host
BLOCK_CODES = {"1005", "1006", "1007", "1008", "1009", "1010", "1020", "1106"}

log = logging.getLogger(BOT_NAME)


class Verdict(Enum):
    OK = "ok"
    NOT_MODIFIED = "not_modified"
    CHALLENGE = "challenge"
    BLOCKED = "blocked"
    RATE_LIMITED = "rate_limited"
    PAYMENT_REQUIRED = "payment_required"
    SUSPICIOUS_200 = "suspicious_200"
    SERVER_ERROR = "server_error"
    OTHER = "other"


STOP = {Verdict.CHALLENGE, Verdict.BLOCKED, Verdict.PAYMENT_REQUIRED}
RETRY = {Verdict.RATE_LIMITED, Verdict.SERVER_ERROR}


class StopHost(Exception):
    """El sitio dijo que no. Dejamos este host en paz durante el resto de la ejecución."""


def page_text(resp):
    """El inicio del cuerpo, sin las etiquetas HTML."""
    return re.sub(r"<[^>]+>", " ", resp.text[:20000])


def cloudflare_code(resp):
    """El código 1xxx de una respuesta de error de Cloudflare, o None.

    Cloudflare lo envía como una página HTML con su marca ("Error 1020") o como un
    cuerpo de texto corto ("error code: 1020") junto con una cabecera "Server: cloudflare".
    """
    text = page_text(resp)
    from_cloudflare = resp.headers.get("Server", "").lower() == "cloudflare"
    short_form = from_cloudflare and text.lstrip().lower().startswith("error code:")
    if not short_form and "cloudflare" not in text.lower():
        return None
    match = re.search(r"(?i)\berror(?:\s+code)?:?\s+(1\d{3})\b", text)
    return match.group(1) if match else None


def classify(resp, expect=EXPECT):
    if resp.headers.get("cf-mitigated") == "challenge":
        return Verdict.CHALLENGE, "Cloudflare challenge page"
    status = resp.status_code
    if status == 304:
        return Verdict.NOT_MODIFIED, "unchanged since the last visit"
    if status == 402:
        return Verdict.PAYMENT_REQUIRED, "402 with crawler-price" if "crawler-price" in resp.headers else "402"
    code = cloudflare_code(resp) if status >= 400 else None
    if status == 429 or code == "1015":
        return Verdict.RATE_LIMITED, f"HTTP {status}, error {code}" if code else f"HTTP {status}"
    if code in BLOCK_CODES or status == 403:
        text = page_text(resp).lower()
        if code:
            why = f"Cloudflare error {code}"
        elif "cloudflare" in text and "ray id" in text:
            why = "Cloudflare block page without a code"  # una regla WAF
        else:
            why = "403 from the origin server"
        return Verdict.BLOCKED, why
    if status >= 500:
        return Verdict.SERVER_ERROR, f"HTTP {status}"
    if status == 200 and expect and expect not in resp.text:
        why = "Turnstile form, no data" if "cf-turnstile" in resp.text else "expected content missing"
        return Verdict.SUSPICIOUS_200, why
    if status == 200:
        return Verdict.OK, "expected content found" if expect else "HTTP 200"
    return Verdict.OTHER, f"HTTP {status}"


def wait_seconds(resp, attempt):
    """Retry-After en cualquiera de las dos formas de RFC 9110; si no, una espera que se duplica. Segundos enteros, con tope."""
    value = resp.headers.get("Retry-After", "").strip()
    wait = 30 * 2**attempt
    if value.isdigit():
        wait = int(value)
    elif value:
        try:
            when = email.utils.parsedate_to_datetime(value)
            if when.tzinfo is None:
                when = when.replace(tzinfo=timezone.utc)
            wait = (when - datetime.now(timezone.utc)).total_seconds()
        except (TypeError, ValueError):
            pass
    return min(max(math.ceil(wait), 1), MAX_WAIT)


class PoliteFetcher:
    def __init__(self, proxy=PROXY):
        self.session = requests.Session()
        self.session.headers["User-Agent"] = USER_AGENT
        if proxy:
            self.session.proxies = {"http": proxy, "https": proxy}
        self.robots, self.delay, self.last, self.cache = {}, {}, {}, {}

    def get(self, url, headers=None, expect=EXPECT):
        host = urlsplit(url).netloc
        for attempt in range(MAX_RETRIES + 1):
            pause = self.delay.get(host, MIN_DELAY) - (time.monotonic() - self.last.get(host, -1e9))
            if pause > 0:
                time.sleep(pause)
            resp = self.session.get(url, headers=headers, timeout=20)
            self.last[host] = time.monotonic()
            if resp.status_code == 407:
                raise requests.exceptions.ProxyError("the proxy rejected the credentials (407)")
            verdict, why = classify(resp, expect)
            if verdict in STOP:
                ray = resp.headers.get("cf-ray", "none")
                log.error("STOP %s: %s, %s (cf-ray %s)", url, verdict.value, why, ray)
                raise StopHost(host)
            if verdict not in RETRY:
                return resp, verdict, why
            if attempt < MAX_RETRIES:
                wait = wait_seconds(resp, attempt)
                log.warning("%s %s: %s, waiting at least %d s", verdict.value, url, why, wait)
                time.sleep(wait)
        log.error("STOP %s: still %s after %d retries", url, verdict.value, MAX_RETRIES)
        raise StopHost(host)

    def allowed(self, url):
        parts = urlsplit(url)
        host = parts.netloc
        if host not in self.robots:
            try:
                resp, _, _ = self.get(f"{parts.scheme}://{host}/robots.txt", expect=None)
            except requests.RequestException as exc:
                log.error("STOP %s: robots.txt unreachable (%s)", host, exc)
                raise StopHost(host) from exc
            parser = RobotFileParser()
            parser.parse(resp.text.splitlines() if resp.status_code == 200 else [])
            self.robots[host] = parser
            # urllib.robotparser solo lee segundos enteros: "Crawl-delay: 1.5" se ignora
            self.delay[host] = max(MIN_DELAY, parser.crawl_delay(BOT_NAME) or 0)
        return self.robots[host].can_fetch(BOT_NAME, url)

    def fetch(self, url):
        """El HTML de la página, o None cuando hay que saltarse la página."""
        if not self.allowed(url):
            log.info("skip %s: disallowed by robots.txt", url)
            return None
        validators, body = self.cache.get(url, ({}, None))
        resp, verdict, why = self.get(url, headers=validators)
        log.log(logging.INFO if verdict in (Verdict.OK, Verdict.NOT_MODIFIED) else logging.WARNING,
                "%s %s: %s", verdict.value, url, why)
        if verdict is Verdict.NOT_MODIFIED:
            return body
        if verdict is not Verdict.OK:
            return None
        saved = {}
        if "ETag" in resp.headers:
            saved["If-None-Match"] = resp.headers["ETag"]
        if "Last-Modified" in resp.headers:
            saved["If-Modified-Since"] = resp.headers["Last-Modified"]
        self.cache[url] = (saved, resp.text)
        return resp.text


def crawl(urls, proxy=PROXY):
    fetcher, stopped, pages = PoliteFetcher(proxy), set(), {}
    for url in urls:
        host = urlsplit(url).netloc
        if host in stopped:
            log.info("skip %s: host stopped earlier", url)
            continue
        try:
            html = fetcher.fetch(url)
        except StopHost:
            stopped.add(host)
            continue
        except requests.RequestException as exc:
            log.warning("network error %s: %s", url, exc)
            continue
        if html is not None:
            pages[url] = html
    return pages


if __name__ == "__main__":
    logging.basicConfig(level=logging.INFO, format="%(levelname)-7s %(message)s")
    found = crawl([
        "https://www.example.com/products/1001",
        "https://www.example.com/products/1002",
    ])
    print(f"{len(found)} pages saved")
classify() comprueba primero cf-mitigated, después 402 y 429, y luego busca un código 1xxx en cualquiera de sus dos formas. Un 403 sin código cuenta como página de bloqueo de Cloudflare cuando el cuerpo nombra a Cloudflare y muestra un Ray ID. En un 200, el veredicto solo es ok si el marcador EXPECT está en la página, así que elige un marcador que no aparezca en una página de verificación, en una página vacía que se rellena con JavaScript ni en una página trampa, por ejemplo un atributo con el ID del producto.
Así se ve la salida
Ejecutamos el script con Python 3.13 y Requests 2.34.2 a través de un proxy HTTP local, contra ocho sitios de prueba locales, uno por cada tipo de respuesta. Para la prueba sustituimos las dos URL de ejemplo de __main__ por páginas de esos sitios. Los sitios de prueba solo reproducen las señales documentadas, y los Ray ID son suyos.
INFO    ok http://127.0.0.1:28150/products/1001: expected content found
INFO    not_modified http://127.0.0.1:28150/products/1001: unchanged since the last visit
INFO    skip http://127.0.0.1:28150/cart: disallowed by robots.txt
WARNING rate_limited http://127.0.0.1:28150/products/1002: HTTP 429, waiting at least 2 s
INFO    ok http://127.0.0.1:28150/products/1002: expected content found
WARNING rate_limited http://127.0.0.1:28150/products/1003: HTTP 429, waiting at least 3 s
INFO    ok http://127.0.0.1:28150/products/1003: expected content found
WARNING suspicious_200 http://127.0.0.1:28150/products/1004: expected content missing
WARNING suspicious_200 http://127.0.0.1:28150/products/1005: Turnstile form, no data
ERROR   STOP http://127.0.0.1:28151/products/1: challenge, Cloudflare challenge page (cf-ray 8f3c2a9d1b7e28151-IST)
INFO    skip http://127.0.0.1:28151/products/2: host stopped earlier
ERROR   STOP http://127.0.0.1:28152/products/1: blocked, Cloudflare error 1020 (cf-ray 8f3c2a9d1b7e28152-IST)
ERROR   STOP http://127.0.0.1:28153/products/1: blocked, Cloudflare block page without a code (cf-ray 8f3c2a9d1b7e28153-IST)
ERROR   STOP http://127.0.0.1:28154/products/1: blocked, Cloudflare error 1006 (cf-ray 8f3c2a9d1b7e28154-IST)
ERROR   STOP http://127.0.0.1:28155/products/1: payment_required, 402 with crawler-price (cf-ray 8f3c2a9d1b7e28155-IST)
ERROR   STOP http://127.0.0.1:28156/robots.txt: challenge, Cloudflare challenge page (cf-ray 8f3c2a9d1b7e28156-IST)
INFO    skip http://127.0.0.1:28156/products/2: host stopped earlier
WARNING rate_limited http://127.0.0.1:28157/products/1: HTTP 429, waiting at least 1 s
WARNING rate_limited http://127.0.0.1:28157/products/1: HTTP 429, waiting at least 1 s
WARNING rate_limited http://127.0.0.1:28157/products/1: HTTP 429, waiting at least 1 s
ERROR   STOP http://127.0.0.1:28157/products/1: still rate_limited after 3 retries
3 pages saved
La primera página es ok, aunque carga un script de /cdn-cgi/challenge-platform/. En la segunda visita el servidor responde 304, y robots.txt mantiene el script lejos de /cart. Las dos respuestas 429 traían Retry-After, una vez en segundos y otra como fecha; el registro dice "at least" porque la espera por host puede alargar el intervalo real. Dos páginas 200 no se guardaron, los seis hosts siguientes se detuvieron en su primera página o en robots.txt, y el último host se abandonó tras tres reintentos.
Una salvedad: un propietario puede configurar un límite de velocidad con un estado y un cuerpo propios, sin el 1015. En ese caso el script registra blocked u other, así que vigila los dos veredictos.
Casos de uso
- Seguimiento de precios: las solicitudes condicionales mantienen baratas las comprobaciones diarias, y
suspicious_200avisa de un cambio de plantilla (seguimiento de precios). - Investigación de mercado: datos de surtido y de stock de muchas tiendas, cada una visitada a su propio ritmo (investigación de mercado).
- Comprobaciones SEO: averigua si tu propia configuración de Cloudflare muestra verificaciones a los crawlers que sí quieres recibir (proxy para SEO).
- Protección de marca: búsquedas de anuncios falsos en marketplaces, hechas por un trabajo que se detiene ante cada verificación (protección de marca).
- Crawlers públicos: un índice o un archivo que solicita entrar en el programa de bots verificados antes de su primer rastreo (rastreador web).
- Extracción de datos en general: datos limpios y, además, un registro de lo que el trabajo no pudo alcanzar (extracción de datos).
Errores comunes
- Reintentar un
403en bucle. La respuesta no cambia, y la propia ráfaga parece cosa de un bot. - Reintentar Error 1015 enseguida o ignorar
Retry-After. Cloudflare advierte de que los intentos repetidos en poco tiempo pueden alargar el bloqueo (429 Too Many Requests). - Rotar la IP en cada solicitud a un mismo sitio. Direcciones nuevas a la misma velocidad ignoran el límite que fijó el propietario, y los límites por cookie o por huella no se reinician (Cómo hacer web scraping sin que te bloqueen).
- Hacerse pasar por Googlebot. Google indica a los propietarios de sitios que verifiquen Googlebot con búsquedas DNS inversas y directas o con sus rangos de IP publicados, y una cadena Googlebot enviada desde otra IP no supera ninguna de las dos.
- Fiarse de cualquier
200. Las páginas vacías que se rellenan con JavaScript, los formularios Turnstile y las páginas trampa devuelven200. AI Labyrinth, de Cloudflare, lleva a los crawlers que siguen sus enlaces ocultos a un laberinto de páginas sin bloquearlos. - Copiar
cf_clearanceen un script. La cookie está ligada al dispositivo para el que se emitió. - Hacer scraping detrás de un inicio de sesión que no es tuyo. Tu propia cuenta y tus propios datos son una cosa (Sesiones y cookies en Python); las páginas que el sitio no te abrió son otra.
- Pagar un servicio que resuelve CAPTCHA. Las verificaciones de Cloudflare no son rompecabezas de imágenes; las comprobaciones se ejecutan dentro del navegador, y un servicio así esquiva la decisión del propietario.
Guía de decisión
| Tu situación | Qué hacer |
|---|---|
| El sitio tiene una API o un feed | Úsalo, aunque hacer scraping del HTML parezca más fácil |
| Necesitas unas pocas páginas de un sitio | Escribe al propietario: nombre del bot, rutas, ritmo |
| El propietario aceptó darte acceso | Envía todo el tráfico desde una sola IP fija |
| Operas un crawler público | Solicita entrar en el programa de bots verificados |
| Construyes un crawler o un agente de IA | Lee las líneas Content-Signal; trata un 402 como un precio |
| Los datos se construyen con JavaScript | Busca la solicitud JSON; usa Playwright solo donde esté permitido |
| Necesitas los precios de un país | Usa un proxy de ese país, con el mismo ritmo |
Tu trabajo recibe un 429 cada día | Baja el ritmo; no añadas IP |
| Tu trabajo choca con una verificación o una página de bloqueo | Deja ese host; elige una de las vías anteriores |
| Vigilas tu propio sitio con Cloudflare | Permite la IP de tu herramienta de seguimiento con una regla IP Access |
Preguntas frecuentes
¿Puede Python Requests hacer scraping de un sitio detrás de Cloudflare?
Sí, siempre que la configuración del propietario deje pasar la solicitud. Cuando el sitio responde con una verificación, Requests no puede superarla, porque toda verificación de Cloudflare necesita JavaScript y cookies. En ese caso usa la API del sitio, pide acceso al propietario o detente.
¿Es legal hacer scraping de un sitio protegido por Cloudflare?
Esto no es asesoramiento legal. La respuesta depende del país, de las condiciones del sitio, de si los datos son personales y de cómo los uses. Una verificación es una señal clara de lo que quiere el propietario; esquivarla es ignorar esa señal y suele incumplir las condiciones del sitio. El panorama por países está en ¿El web scraping es legal?.
¿Qué es la cookie cf_clearance?
cf_clearance es la cookie que recibe un navegador tras superar una verificación de Cloudflare, para que las solicitudes siguientes lleguen al origen sin una verificación nueva. Dura lo que indique el ajuste Challenge Passage del propietario (30 minutos por defecto) y está ligada al visitante y al dispositivo. Precursor puede anularla antes de tiempo si la sesión empieza a parecer sospechosa.
¿Un proxy residencial sirve para pasar Cloudflare?
No, y esa no es su función. Un proxy cambia tu dirección IP y tu red, pero una verificación sigue necesitando JavaScript, tu handshake TLS sigue siendo el mismo y un veto a tu cliente se sigue aplicando. Usa un proxy residencial para ver una página como la ven los visitantes de un país, a un ritmo que el sitio acepte.
¿Cómo consigo que Cloudflare verifique mi crawler?
Dale al crawler un nombre propio y una de las pruebas de la vía 3: firmas Web Bot Auth, o una lista publicada de direcciones IP que solo use el crawler. Haz que respete robots.txt y crawl-delay, y después solicita la verificación con el formulario de bots verificados del panel de Cloudflare.
¿Por qué mi scraper funciona en mi portátil pero falla en un servidor?
Tu portátil usa una línea de casa o de oficina; el servidor usa la red de un proveedor de hosting. Los propietarios pueden vetar una red entera por su ASN (Error 1005), y la reputación de la dirección entra en la puntuación de bots, así que el mismo script puede pasar desde una red y recibir una verificación desde la otra. Pide al propietario que permita la IP fija del servidor, o usa la API oficial.
En resumen
Cloudflare bloquea un scraper cuando la configuración del propietario detiene una solicitud antes de que llegue al origen. Lee la respuesta antes de cambiar nada. Una cabecera cf-mitigated: challenge es una verificación, la mayoría de los códigos de error de Cloudflare y la página de bloqueo son reglas del propietario, un 429 o Error 1015 es un límite de velocidad, un 402 es un precio y un 200 solo cuenta si tu contenido está en él. Después elige una vía que dure: una API oficial, el permiso del propietario para una IP fija, la condición de bot verificado o un navegador real solo donde haga falta renderizar. Para trabajos en los que importan el país o una dirección fija, compara las opciones en la página de nuestros servicios de proxy.