یک تیم فروشگاه اینترنتی هر صبح قیمتهای یک رقیب را از فهرستی شامل چند صد URL محصول جمعآوری میکند. یک ماه، رقیب دسته تازهای باز میکند. محصولات این دسته در فهرست نیستند، پس هرگز به گزارش نمیرسند و تا چند هفته کسی متوجه نمیشود. اسکرپر سریعتر هم کمکی نمیکرد. آنچه کم بود گامی بود که صفحههای دسته را بپیماید و آدرسهای تازه را پیدا کند و درست همینجاست که خزش وب (web crawling) تمام میشود و وب اسکرپینگ (web scraping) آغاز میشود.
این نوشته وب اسکرپینگ و خزش وب را در شش محور مقایسه میکند: ورودی، خروجی، شرط توقف، حذف موارد تکراری، سرعت و robots.txt. توضیح میدهد خزنده کجا متوقف میشود و این دو کار چگونه در یک خط لوله به هم میپیوندند و سپس Spider و CrawlSpider را در Scrapy با کدی که خودمان اجرا کردهایم نشان میدهد.
خزش وب چه میکند و وب اسکرپینگ چه میکند؟
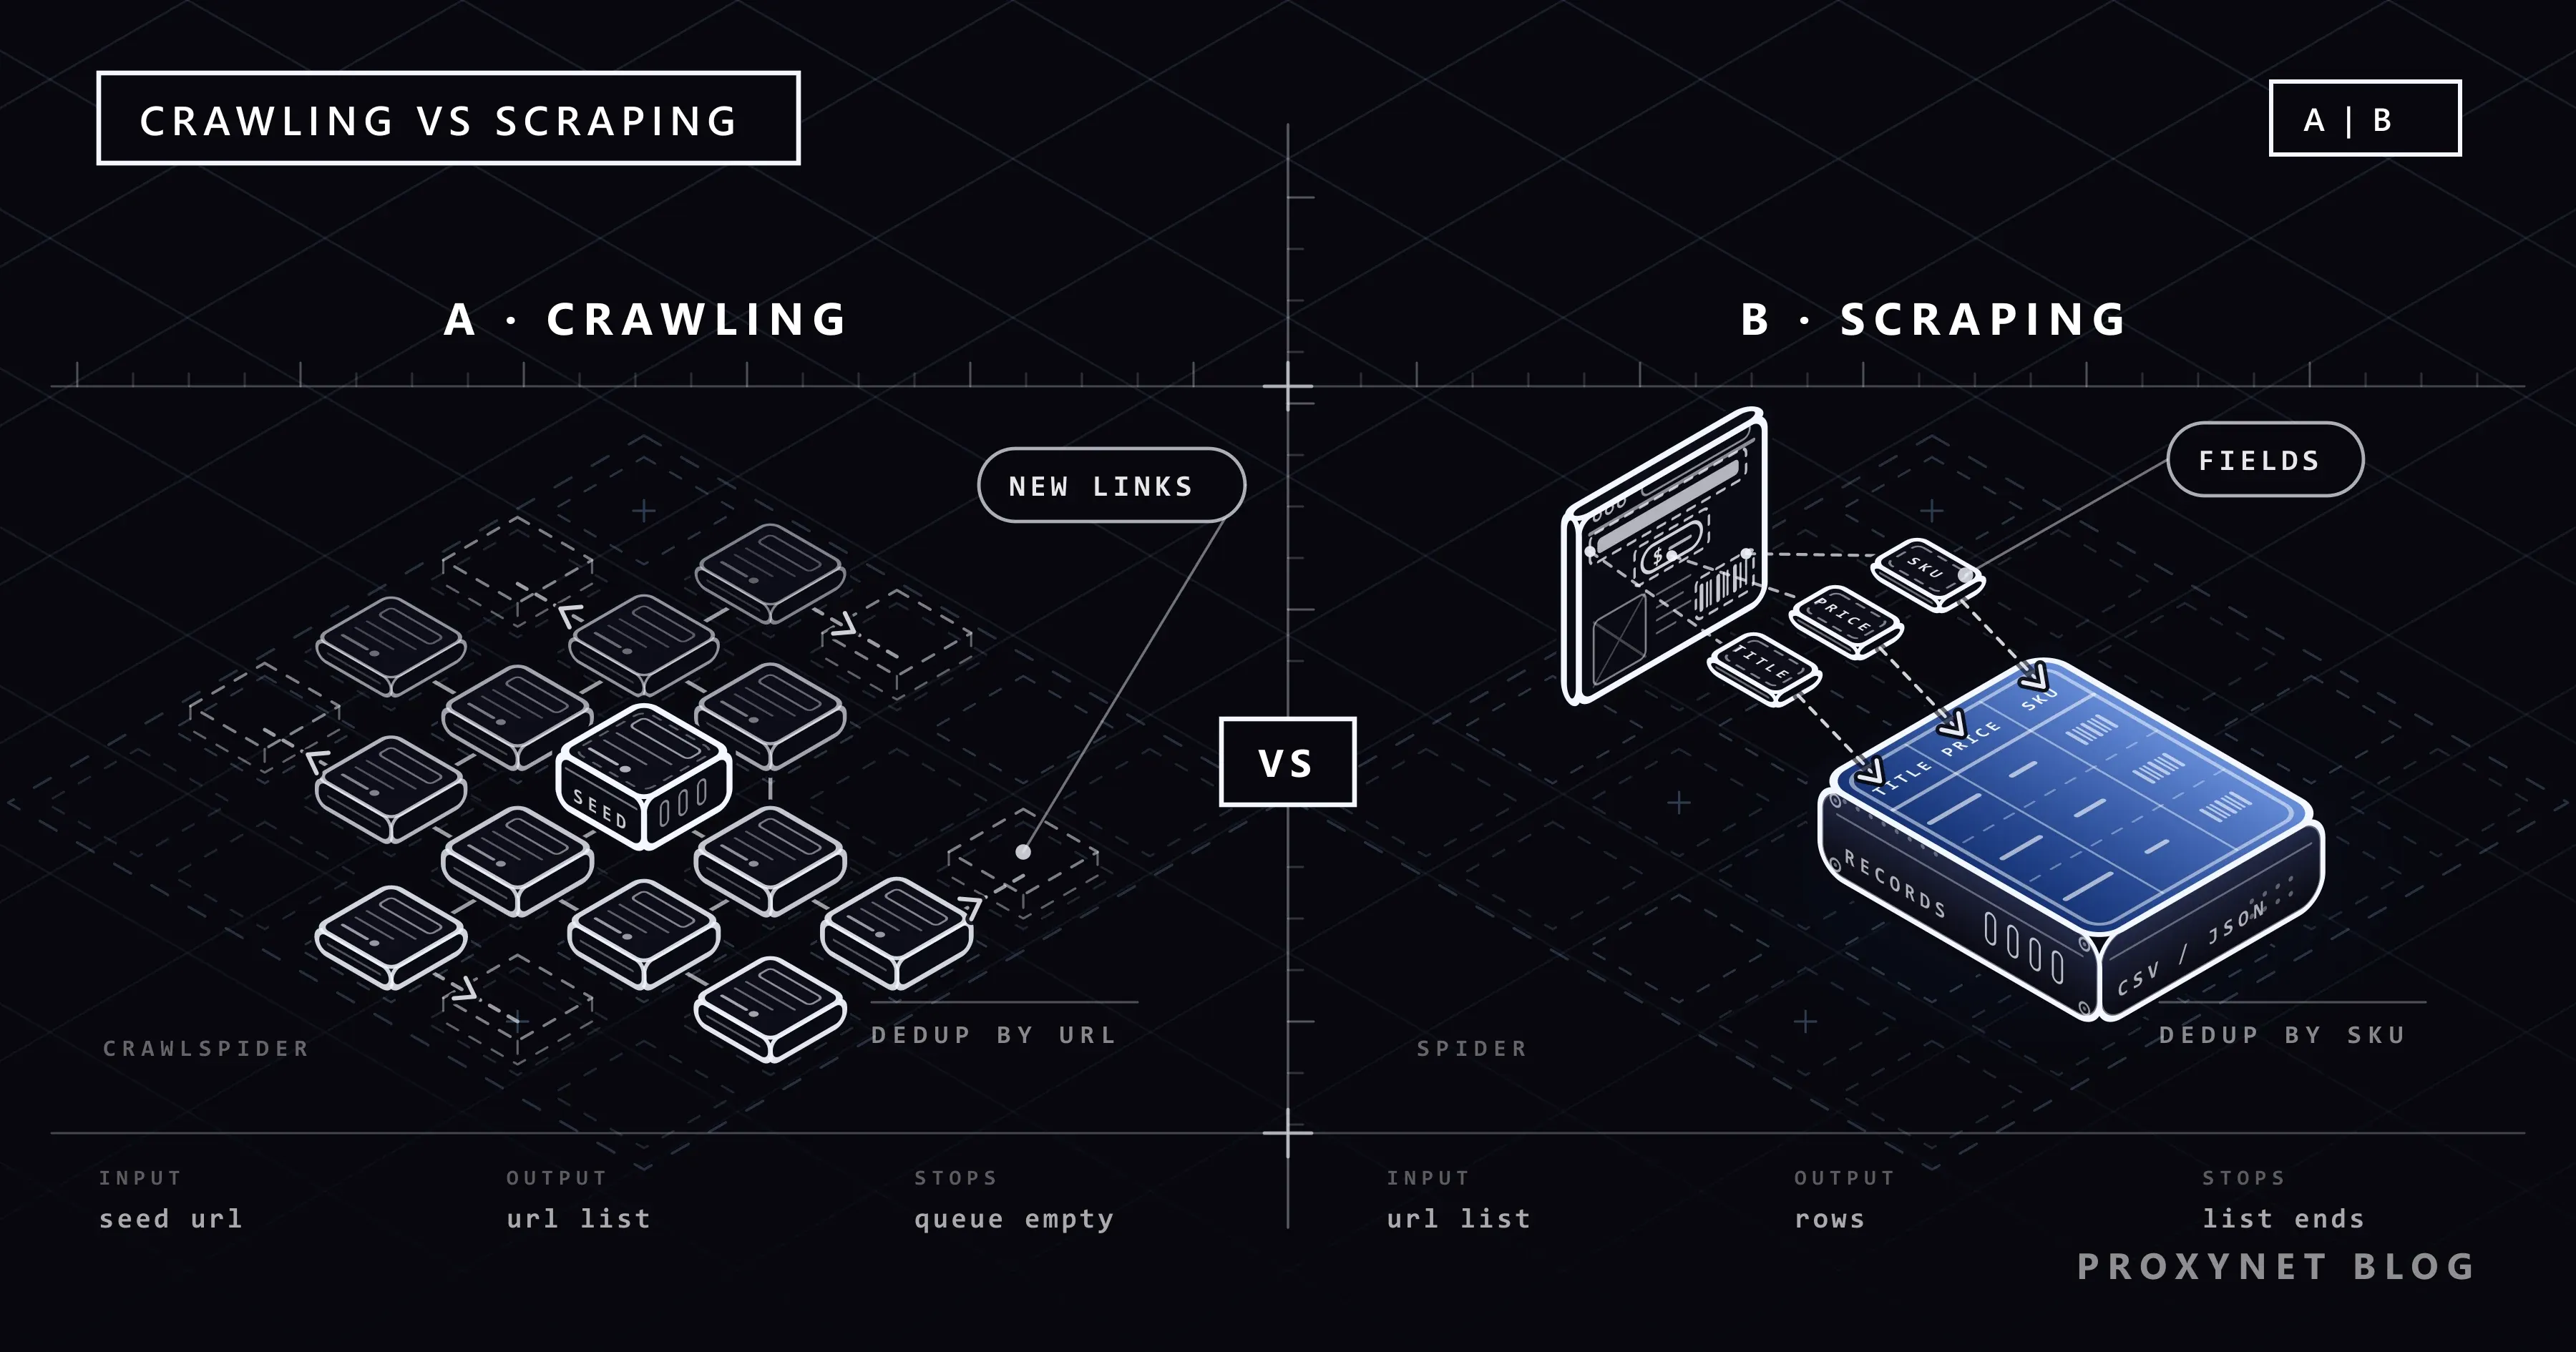
خزش وب به این پرسش پاسخ میدهد: «به کجا میتوانم بروم؟». خزنده یک صفحه را دریافت میکند، پیوندهای تازهای را که در آن مییابد در صف میگذارد و این کار را تکرار میکند تا قاعدهای متوقفش کند. نتیجه، نقشهای از صفحههای موجود است. کارهای خزنده و پروکسیهایی که پشت آنها کار میکنند در صفحه خزنده وب ما آمده است.
وب اسکرپینگ به این پرسش پاسخ میدهد: «در این صفحه چه هست؟». اسکرپر صفحهای را که از قبل میشناسد باز میکند و بخشهایی را که یک انسان میخواند (نام، قیمت، تاریخ، SKU) به یک ردیف ساختاریافته تبدیل میکند. انتخاب روش، از Excel تا Python، در صفحه استخراج داده ما و در نوشته استخراج داده از وبسایت آمده است. این دو با هم اشتباه گرفته میشوند، چون بیشتر ابزارها هر دو کار را انجام میدهند.
وقتی یک صفحه به خزنده و اسکرپر میرسد چه اتفاقی میافتد؟
یک صفحه دسته از یک کتابفروشی را به هر دو بدهید. خزنده پیوندهای آن را میخواند:
- مقدارهای
<a href>را در منوی دستهها و دکمه «بعدی» (next) جمع میکند. - آدرسهای نسبی را مطلق و نرمالسازی میکند تا دو شکل نوشتاری از یک آدرس به یک رشته تبدیل شوند.
- هر آدرس را با مجموعه آدرسهایی که پیشتر دیده است مقایسه میکند.
- آدرسهای تازهای را که از قاعدههای دامنه و عمقش میگذرند به صف خزش (frontier) اضافه میکند؛ یعنی صف آدرسهایی که منتظر دریافتاند.
اسکرپر محتوای آن را میخواند:
- فیلدها را با انتخابگرها پیدا میکند (انتخابگر CSS یا XPath).
- نوعها را بررسی میکند: قیمت عدد است و SKU خالی نیست.
- ردیف را با کمک یک کلید رکورد با ردیفهای قبلی ادغام میکند.
- ردیف را در یک فایل یا پایگاه داده مینویسد.
خزش وب و وب اسکرپینگ: جدول مقایسه
| محور | خزش وب | وب اسکرپینگ |
|---|---|---|
| ورودی | چند URL آغازین و قاعدههای دنبال کردن پیوند | فهرستی از آدرسهای صفحههای شناختهشده |
| خروجی | فهرستی از آدرسها یا مجموعهای از صفحههای دانلودشده | ردیفهای ساختاریافته (CSV، JSON، جدول پایگاه داده) |
| شرط توقف | صف خزش خالی میشود یا به محدودیت عمق، دامنه یا تعداد صفحه میرسد | فهرست تمام میشود |
| واحد حذف تکرار | URL یا اثر انگشت درخواست (request fingerprint) | کلید رکورد (SKU، شناسه آگهی) |
| چه چیزی سرعت را محدود میکند | تعداد درخواستهای همزمان به هر میزبان و قاعدههای robots.txt | محدودیت نرخ مقصد و زمان تجزیه صفحه |
| رابطه با robots.txt | به خطهای Disallow در مسیرهایی برمیخورد که خودش کشف میکند | کل فهرست را میتوان پیش از اجرا بررسی کرد |
| خطای رایج | گونههای بیپایان URL، کشیده شدن به دامنههای دیگر | قالب تغییریافتهای که فیلدهای خالی برمیگرداند |
تفاوت از پرسشی میآید که کار مطرح میکند، نه از ابزار: بعد به کجا بروم، یا از اینجا چه بردارم.
ربات موتور جستوجو و ربات قیمت: دو سر یک طیف
Googlebot در سر خزش ایستاده است. راهنمای How Search Works گوگل میگوید برخی صفحهها از بازدیدهای قبلی شناخته شدهاند، برخی دیگر از راه پیوندهای صفحههای شناختهشده پیدا میشوند و نقشههای سایت (sitemap) صفحههای بیشتری اضافه میکنند. یک الگوریتم تصمیم میگیرد کدام سایتها خزش شوند، هر چند وقت یک بار و چند صفحه از هرکدام دریافت شود و خزنده وقتی سرور خطا برمیگرداند سرعتش را کم میکند. صفحههای تکراری بعداً، در مرحله ایندکس، زیر یک صفحه canonical گروهبندی میشوند. راهنمای بودجه خزش (crawl budget) گوگل بیشتر برای سایتهایی نوشته شده است که بیش از یک میلیون صفحه یکتا دارند و این صفحهها تقریباً هر هفته تغییر میکنند، یا بیش از 10,000 صفحه دارند که هر روز تغییر میکنند.
ربات قیمت در سر اسکرپینگ ایستاده است. فهرست ثابتی از آدرسهای محصول دارد، هیچ پیوندی را دنبال نمیکند و هر روز همان مجموعه ردیفها را برمیگرداند.
بیشتر کارهای تجاری در میانه قرار میگیرند: یک خزش هفتگی در دستهها محصولات تازه را پیدا میکند و یک اسکرپر روزانه قیمتها را از فهرستی میخواند که خزش بهروز نگه میدارد، همانطور که در رصد قیمت رقبا آمده است. اینکه سایتها رباتهای جستوجوی تأییدشده را چگونه از بقیه ترافیک جدا میکنند در تشخیص بات چگونه کار میکند و اسکرپر Cloudflare توضیح داده شده است.
خزنده در یک سایت کجا متوقف میشود؟
خزنده فهرستی ندارد که به پایانش برسد، پس قاعدهها تعیین میکنند تا کجا پیش برود:
- صف خزش خالی است. همه آدرسهای کشفشده دریافت شدهاند و آدرس تازهای پیدا نشده است.
- محدودیت عمق. عمق تعداد پرشهای پیوندی از URL آغازین را میشمارد. مقدار پیشفرض
DEPTH_LIMITدر Scrapy برابر0است، یعنی بدون محدودیت. - محدودیت دامنه.
allowed_domainsخزنده را روی سایت مقصد و زیردامنههایش نگه میدارد. از Scrapy 2.18 به بعد، تغییر آن در میانه خزش اعمال میشود. - سقف صفحه. سقفی قطعی مانند
CLOSESPIDER_PAGECOUNTاجرا را تمام میکند، هر اتفاق دیگری هم که بیفتد.
نرمالسازی URL تعیین میکند که صف خزش اصلاً روزی خالی شود یا نه. بخش 6 از RFC 3986 گامها را شرح میدهد: scheme و host را با حروف کوچک بنویسید، کاراکترهای رزرونشدهای (unreserved) را که بهصورت percent-encoded آمدهاند رمزگشایی کنید، بخشهای . و .. را حذف کنید و پورت پیشفرض را کنار بگذارید؛ به این ترتیب http://example.com و http://example.com:80/ یک منبعاند. فراتر از این، خودتان تصمیم میگیرید کدام پارامترهای query اهمیت دارند: ترتیب مرتبسازی یا شناسه نشست (session ID) برای همان محتوا آدرس تازهای میسازد.
برخی سایتها بیپایان آدرس میسازند؛ مثلاً تقویمی با پیوند «ماه بعد» یا ترکیبهای فیلتری که با هر کلیک چند برابر میشوند. بدون محدودیت عمق و سقف صفحه، خزنده هرگز از آنها بیرون نمیآید. پیوندهای تلهای که عمداً گذاشته میشوند هم همینطور عمل میکنند (تلههای هانیپات). نقشه سایتی که منتشر شده است اغلب فهرست آغازین بهتری از دنبال کردن پیوندهاست (چگونه نقشه سایت یک وبسایت را پیدا کنیم).
موارد تکراری را در کدام لایه حذف کنیم: URL یا رکورد؟
خزنده درخواستهای تکراری را حذف میکند. DUPEFILTER_CLASS پیشفرض در Scrapy همان RFPDupeFilter است که اثر انگشت درخواستها را مقایسه میکند تا یک صفحه در یک اجرا دو بار دانلود نشود.
اسکرپر رکوردهای تکراری را حذف میکند. یک محصول میتواند از دو آدرس برسد، از راه دستهاش و از راه صفحه حراج، و فیلتر URL هر دو را عبور میدهد. کلید باید از خود داده بیاید: SKU، کد محصول یا شناسه آگهی. به همین دلیل این ادعا که اسکرپینگ به حذف موارد تکراری نیازی ندارد نادرست است. ذخیره ردیفها بر اساس کلید در SQLite را در صفحهبندی در وب اسکرپینگ نشان دادهایم.
اثر robots.txt و قاعدههای نرخ درخواست بر خزنده چیست؟
RFC 9309 خزندهها را کلاینتهای خودکار مینامد و خزندههای موتور جستوجو را مثال میزند که پیوندها را بهصورت بازگشتی میپیمایند (recursively traverse links)؛ همچنین میگوید قاعدههای robots.txt نوعی مجوز دسترسی نیستند (not a form of access authorization). خزنده مشروع با این حال از آنها پیروی میکند و نباید نسخه ذخیرهشده (cache) فایل را بیش از 24 ساعت به کار ببرد، مگر اینکه فایل در دسترس نباشد. خزنده بیشتر به خطهای Disallow برمیخورد، چون مدام وارد مسیرهای تازه میشود. نحو فایل و Crawl-delay در فایل robots.txt چیست آمده است.
سرعت بهازای هر میزبان با CONCURRENT_REQUESTS_PER_DOMAIN و DOWNLOAD_DELAY محدود میشود. مقدارهای پیشفرض این دو در کد Scrapy به ترتیب 8 و 0 هستند؛ فایل settings.py که scrapy startproject میسازد هر دو را روی 1 میگذارد و ROBOTSTXT_OBEY را روشن میکند که در پیشفرضهای کد False است. انتخاب عدد مناسب در همروندی و موازیسازی در وب اسکرپینگ، تلاش دوباره پس از 429 در کدهای وضعیت HTTP در وب اسکرپینگ و پخش کردن درخواستها میان چند آدرس IP در چرخاندن پروکسی در Python آمده است. خزش گسترده روی میزبانهای زیاد با پروکسی چرخشی جور درمیآید؛ فهرست ثابت و کوتاه اغلب با پروکسی دیتاسنتر بهخوبی اجرا میشود.
خزش و اسکرپینگ چگونه در یک خط لوله به هم میپیوندند؟
در یک پروژه واقعی، این دو کار مرحلههای یک چرخهاند:
- کشف. آدرسهای آغازین و مدخلهای نقشه سایت وارد سیستم میشوند.
- صف خزش. یک صف آدرسها را همراه با اولویت و برچسب عمق نگه میدارد.
- دانلود. درخواستها با محدودیت نرخ برای هر میزبان فرستاده میشوند و در خطاهای موقت دوباره تلاش میشوند.
- تجزیه (parsing). هر صفحه رکوردهایی برای خروجی و پیوندهای تازهای برای صف خزش تولید میکند.
صف را روی دیسک نگه دارید تا خزشی که قطع شده بتواند ادامه پیدا کند: Scrapy برای این کار از JOBDIR استفاده میکند و نسخهای با SQLite در صفحهبندی در وب اسکرپینگ آمده است. Scrapy بهطور پیشفرض به شیوه عمقاول (depth-first) خزش میکند، چون صفهای پیشفرضش LIFO هستند؛ مقدار مثبت DEPTH_PRIORITY همراه با صفهای FIFO آن را به سمت سطحاول (breadth-first) میبرد.
تفاوت Spider و CrawlSpider در Scrapy چیست؟
scrapy.Spider از start_urls شروع میکند و برای هر پاسخ parse را فرا میخواند. فقط وقتی پیوندی را دنبال میکند که کد شما درخواست تازهای yield کند؛ پس با یک فهرست ثابت، یک اسکرپر خالص است.
CrawlSpider دنبال کردن پیوندها را به rules منتقل میکند. هر Rule یک LinkExtractor را با یک callback اختیاری و یک پرچم follow جفت میکند. بخش Spiders در مستندات Scrapy مقدار پیشفرض را تعیین میکند: اگر callback برابر None باشد، follow بهطور پیشفرض True است و در غیر این صورت False. قاعدهای که callback ندارد از میان صفحهها عبور میکند؛ قاعدهای که callback دارد صفحهها را تجزیه میکند و همانجا میایستد. همان صفحه هشدار میدهد که درخواستی که خودتان درون یک CrawlSpider میسازید به callback صریح نیاز دارد؛ درخواست بدون callback دوباره از مسیر قاعدهها فرستاده میشود.
فایل زیر هر دو را روی سایتی اجرا میکند که برای تمرین اسکرپینگ ساخته شده است. به Scrapy 2.19 نیاز دارد (منتشرشده در 10 سپتامبر 2026، با Python 3.10 یا جدیدتر). نصب و middleware پروکسی در Scrapy چیست و چگونه با پروکسی استفاده میشود آمده است.
"""One practice site, two jobs: a list scraper and a rule-based crawler."""
import sys

import scrapy
from scrapy.crawler import CrawlerProcess
from scrapy.linkextractors import LinkExtractor
from scrapy.spiders import CrawlSpider, Rule

POLITE = {
    "ROBOTSTXT_OBEY": True,  # a script run has no project settings.py, so set it here
    "CONCURRENT_REQUESTS_PER_DOMAIN": 2,
    "DOWNLOAD_DELAY": 1,
    "RETRY_TIMES": 2,  # RetryMiddleware: up to 2 retries on 429, 500/502/503/504 and timeouts
    "USER_AGENT": "ExampleCatalogBot/1.0 (+https://example.com/bot)",
}


def product(response):
    """The record: the UPC is its key, so two URLs for one book give one row."""
    return {
        "upc": response.xpath("//th[text()='UPC']/following-sibling::td/text()").get(),
        "title": response.css("div.product_main h1::text").get(),
        "price": response.css("div.product_main p.price_color::text").get(),
        "url": response.url,
    }


class ListSpider(scrapy.Spider):
    """Scraping: a known list of product URLs, no link following."""

    name = "list"
    custom_settings = POLITE
    start_urls = [
        "https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html",
        "https://books.toscrape.com/catalogue/tipping-the-velvet_999/index.html",
        "https://books.toscrape.com/catalogue/soumission_998/index.html",
    ]

    def parse(self, response):
        yield product(response)


class CatalogSpider(CrawlSpider):
    """Crawling: find product pages by following category and next-page links."""

    name = "catalog"
    allowed_domains = ["books.toscrape.com"]
    start_urls = ["https://books.toscrape.com/catalogue/category/books/poetry_23/index.html"]
    custom_settings = {**POLITE, "DEPTH_LIMIT": 3, "CLOSESPIDER_PAGECOUNT": 60}
    rules = (
        # No callback, so follow defaults to True: links on these pages are followed.
        Rule(LinkExtractor(restrict_css=("ul.nav-list", "li.next"))),
        # A callback, so follow defaults to False: product pages are parsed, not crawled.
        Rule(LinkExtractor(restrict_css="article.product_pod h3"), callback="parse_item"),
    )

    def parse_item(self, response):
        yield product(response)


if __name__ == "__main__":
    spider = CatalogSpider if sys.argv[1:] == ["catalog"] else ListSpider
    feed = {f"{spider.name}.jsonl": {"format": "jsonlines", "encoding": "utf-8"}}
    process = CrawlerProcess(settings={"FEEDS": feed})
    process.crawl(spider)
    process.start()
python spiders.py اسکرپر را اجرا میکند و python spiders.py catalog خزنده را. از بلوک __main__ استفاده میکنیم، چون scrapy runspider از فایلی که دو کلاس spider دارد فقط یکی را برمیدارد. برای پروکسی، نخست https_proxy=http://user:pass@pr.proxynet.io:8000 را در متغیرهای محیطی تنظیم کنید؛ HttpProxyMiddleware در Scrapy آن را میخواند.
نتیجه اجراها
هر دو را با Python 3.13 و Scrapy 2.19.0 اجرا کردیم، یک بار مستقیم و یک بار از طریق یک پروکسی آزمایشی محلی:
- اسکرپر چهار درخواست فرستاد، یکی برای
robots.txt(که404برگرداند، پس قاعدهای در کار نبود) و سه تا برای سه آدرس، و سه ردیف نوشت. - خزنده پس از 74 صفحه، نه 60، با
finish_reason: closespider_pagecountو 56 کتاب یکتا بسته شد: درخواستهایی که پیشتر به downloader سپرده شدهاند باز هم کامل میشوند، پس این سقف تقریبی است. - فیلتر موارد تکراری 867 درخواست را کنار گذاشت، چون هر صفحه دسته در منوی خود به هر 50 دسته پیوند میدهد.
- با
DEPTH_LIMITبرابر 1، خزنده 3,151 پیوند عمیقتر را نادیده گرفت، فقط 19 کتاب شعری را که صفحه آغازین به آنها پیوند داده بود جمع کرد و وقتی صف خزشش خالی شد باfinish_reason: finishedبه پایان رسید. - از طریق پروکسی، اسکرپر همان ردیفها را برگرداند. با رمز عبور نادرست، پس از هر
407دو بار دیگر تلاش شد و سپس Scrapy دست کشید.
کاربردها
- رصد قیمت رقبا: فهرستی ثابت که هر روز اسکرپ میشود، بهعلاوه یک خزش هفتگی برای محصولات تازه (رصد قیمت رقبا).
- پایش قیمت در مقیاس بزرگ: فروشگاههای زیاد که هرکدام با سرعت خودش خوانده میشود (پایش قیمت).
- ممیزی سئوی سایت: پیدا کردن پیوندهای شکسته و صفحههای یتیم (orphan pages) خزش خالص است و خروجی آن آدرسها و کدهای وضعیت است (پروکسی سئو).
- حفاظت از برند: خزش یک مارکتپلیس آگهیهای تازه را پیدا میکند و اسکرپر فروشنده و قیمت را میخواند (حفاظت از برند).
- کاتالوگهای مبتنی بر JavaScript: خزش صفحهها را پیدا میکند و مرورگر headless فقط صفحههایی را رندر میکند که به آن نیاز دارند (صفحههای ایستا و پویا در وب اسکرپینگ).
اشتباههای رایج
- خزش کل سایت برای کاری که فهرست ثابتی دارد. بیدلیل بار روی سایت میگذارد و به خطهای
Disallowبیشتری برمیخورد. - نادیده گرفتن نرمالسازی URL. همان صفحه با ترتیب متفاوت پارامترهای query بارها و بارها دانلود میشود.
follow=Trueروی قاعدهای که callback دارد، بدون محدودیت عمق. هر صفحه محصول به نقطه شروع تازهای تبدیل میشود و خزش از راه پیوندهای محصولات مرتبط پخش میشود.- جا انداختن
allowed_domains. یک پیوند به فروشگاه یک شریک تجاری کافی است تا خزنده از سایت مقصد بیرون برود. - دریافت robots.txt در هر درخواست، یا دیگر هرگز. یک بار برای هر میزبان کافی است؛ در اجراهای طولانیتر آن را پیش از گذشت 24 ساعت تازه کنید.
- ردیفهای بدون کلید رکورد. محصولی که از دو مسیر پیدا شده دو بار نوشته میشود.
- فرستادن درخواست دستساز با yield و بدون callback در یک
CrawlSpider. این درخواست بهجای رسیدن به parser شما دوباره از مسیر قاعدهها میگذرد.
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
| فهرست آدرسهای محصولم ثابت است و هر روز قیمتها را میخوانم | فقط یک اسکرپر (scrapy.Spider یا یک کلاینت HTTP) |
| محصولات تازه رقیب را هم میخواهم | یک خزش هفتگی در دستهها که آدرس اضافه میکند، بهعلاوه اسکرپر روزانه |
| برای پیدا کردن پیوندهای شکسته به همه صفحههای سایتم نیاز دارم | یک خزنده خالص؛ خروجی آدرسها و کدهای وضعیت است |
| میخواهم Scrapy پیوندها را بر اساس قاعده دنبال کند | CrawlSpider با Rule و LinkExtractor، همیشه همراه با DEPTH_LIMIT و allowed_domains |
| سایت نقشه سایت منتشر میکند | از نقشه سایت شروع کنید؛ پیوندها را فقط برای بخشهایی دنبال کنید که در آن نیامدهاند |
| خزشی که قطع میشود نباید از اول شروع شود | صف ماندگار: JOBDIR در Scrapy یا یک جدول SQLite |
پرسشهای متداول
آیا خزش وب و وب اسکرپینگ یک چیزند؟
نه. خزش با دنبال کردن پیوندها صفحهها را کشف میکند و خروجی آن فهرستی از آدرسهاست. اسکرپینگ فیلدها را از صفحههای شناختهشده بیرون میکشد و خروجی آن رکوردهای ساختاریافته است. ابزاری که هر دو را انجام میدهد همچنان دو کار جداگانه انجام میدهد.
Googlebot خزنده است یا اسکرپر؟
خزنده است. آدرسها را از راه پیوندها، نقشههای سایت و بازدیدهای قبلی پیدا میکند و یک الگوریتم تصمیم میگیرد هر سایت هر چند وقت یک بار و تا چه عمقی خزش شود. فیلدها را آنطور که یک اسکرپر قیمت انجام میدهد در ردیفها جمع نمیکند.
تفاوت Spider و CrawlSpider در Scrapy چیست؟
Spider فقط پیوندهایی را دنبال میکند که کد شما درخواست میدهد و برای فهرست ثابت مناسب است. CrawlSpider پیوندها را از راه rules دنبال میکند: قاعده بدون callback بهطور پیشفرض دنبال میکند و قاعده دارای callback بهطور پیشفرض تجزیه میکند و دنبال نمیکند. درخواستهایی که خودتان yield میکنید به callback صریح نیاز دارند.
آیا خزنده باید از robots.txt پیروی کند؟
RFC 9309 میگوید این قاعدهها نوعی مجوز دسترسی نیستند، پس این فایل قفل نیست. خزنده مشروع با این حال از آن پیروی میکند، نرخ درخواست را پایین نگه میدارد و User-Agent صادقانهای به کار میبرد. پیامدهای حقوقی به کشور و شرایط هر مورد بستگی دارد (آیا اسکرپینگ وب قانونی است؟).
برای خزش و اسکرپینگ از کدام کتابخانههای Python استفاده میشود؟
Scrapy هر دو را پوشش میدهد: برای خزش، زمانبند (scheduler)، فیلتر موارد تکراری، بررسی robots.txt و محدودیت نرخ دارد و برای اسکرپینگ، انتخابگرها. برای یک فهرست کوتاه، Requests یا HTTPX همراه با BeautifulSoup یا lxml اغلب کافی است (مقایسه HTTPX، Requests و AIOHTTP).
آیا برای خزش به پروکسی نیاز دارید؟
خزنده درخواستهای زیادی به یک میزبان میفرستد و سایتها تعداد درخواستها را بهازای هر IP محدود میکنند. پروکسی یک خزش گسترده را میان چند آدرس IP پخش میکند، اما هر میزبان همچنان باید درخواستها را با نرخی مؤدبانه دریافت کند. برای خزشهای بزرگ روی سایتهای زیاد، پروکسی چرخشی به هر درخواست یا نشست یک خروجی متفاوت میدهد.
خلاصه
خزش وب با دنبال کردن پیوندها میفهمد چه صفحههایی وجود دارند و وب اسکرپینگ صفحههای شناختهشده را به ردیفهایی از داده تبدیل میکند. در بیشتر پروژهها یک صف این دو را به هم وصل میکند: خزش آن را پر میکند و اسکرپینگ خالیاش میکند. اگر خزش شما به خروجیهایی در یک کشور مشخص نیاز دارد، پروکسی مسکونی را ببینید یا گزینهها را در صفحه خدمات پروکسی ما مقایسه کنید.