Ein E-Commerce-Team ruft jeden Morgen die Preise eines Wettbewerbers ab, anhand einer Liste mit einigen Hundert Produkt-URLs. In einem Monat eröffnet der Wettbewerber eine neue Kategorie. Diese Produkte stehen nicht auf der Liste, landen also nie im Bericht, und wochenlang fällt das niemandem auf. Ein schnellerer Scraper hätte nicht geholfen. Es fehlte ein Schritt, der die Kategorieseiten durchläuft und neue Adressen findet, und genau an dieser Stelle endet Web Crawling und beginnt Web Scraping.
Dieser Beitrag stellt Web Scraping vs. Web Crawling auf sechs Achsen gegenüber: Eingabe, Ausgabe, Abbruchbedingung, Deduplizierung, Geschwindigkeit und robots.txt. Er erklärt, wo ein Crawler aufhört und wie beide Aufgaben in einer Pipeline zusammenkommen, und zeigt dann Spider und CrawlSpider in Scrapy mit Code, den wir ausgeführt haben.
Was macht Web Crawling, und was macht Web Scraping?
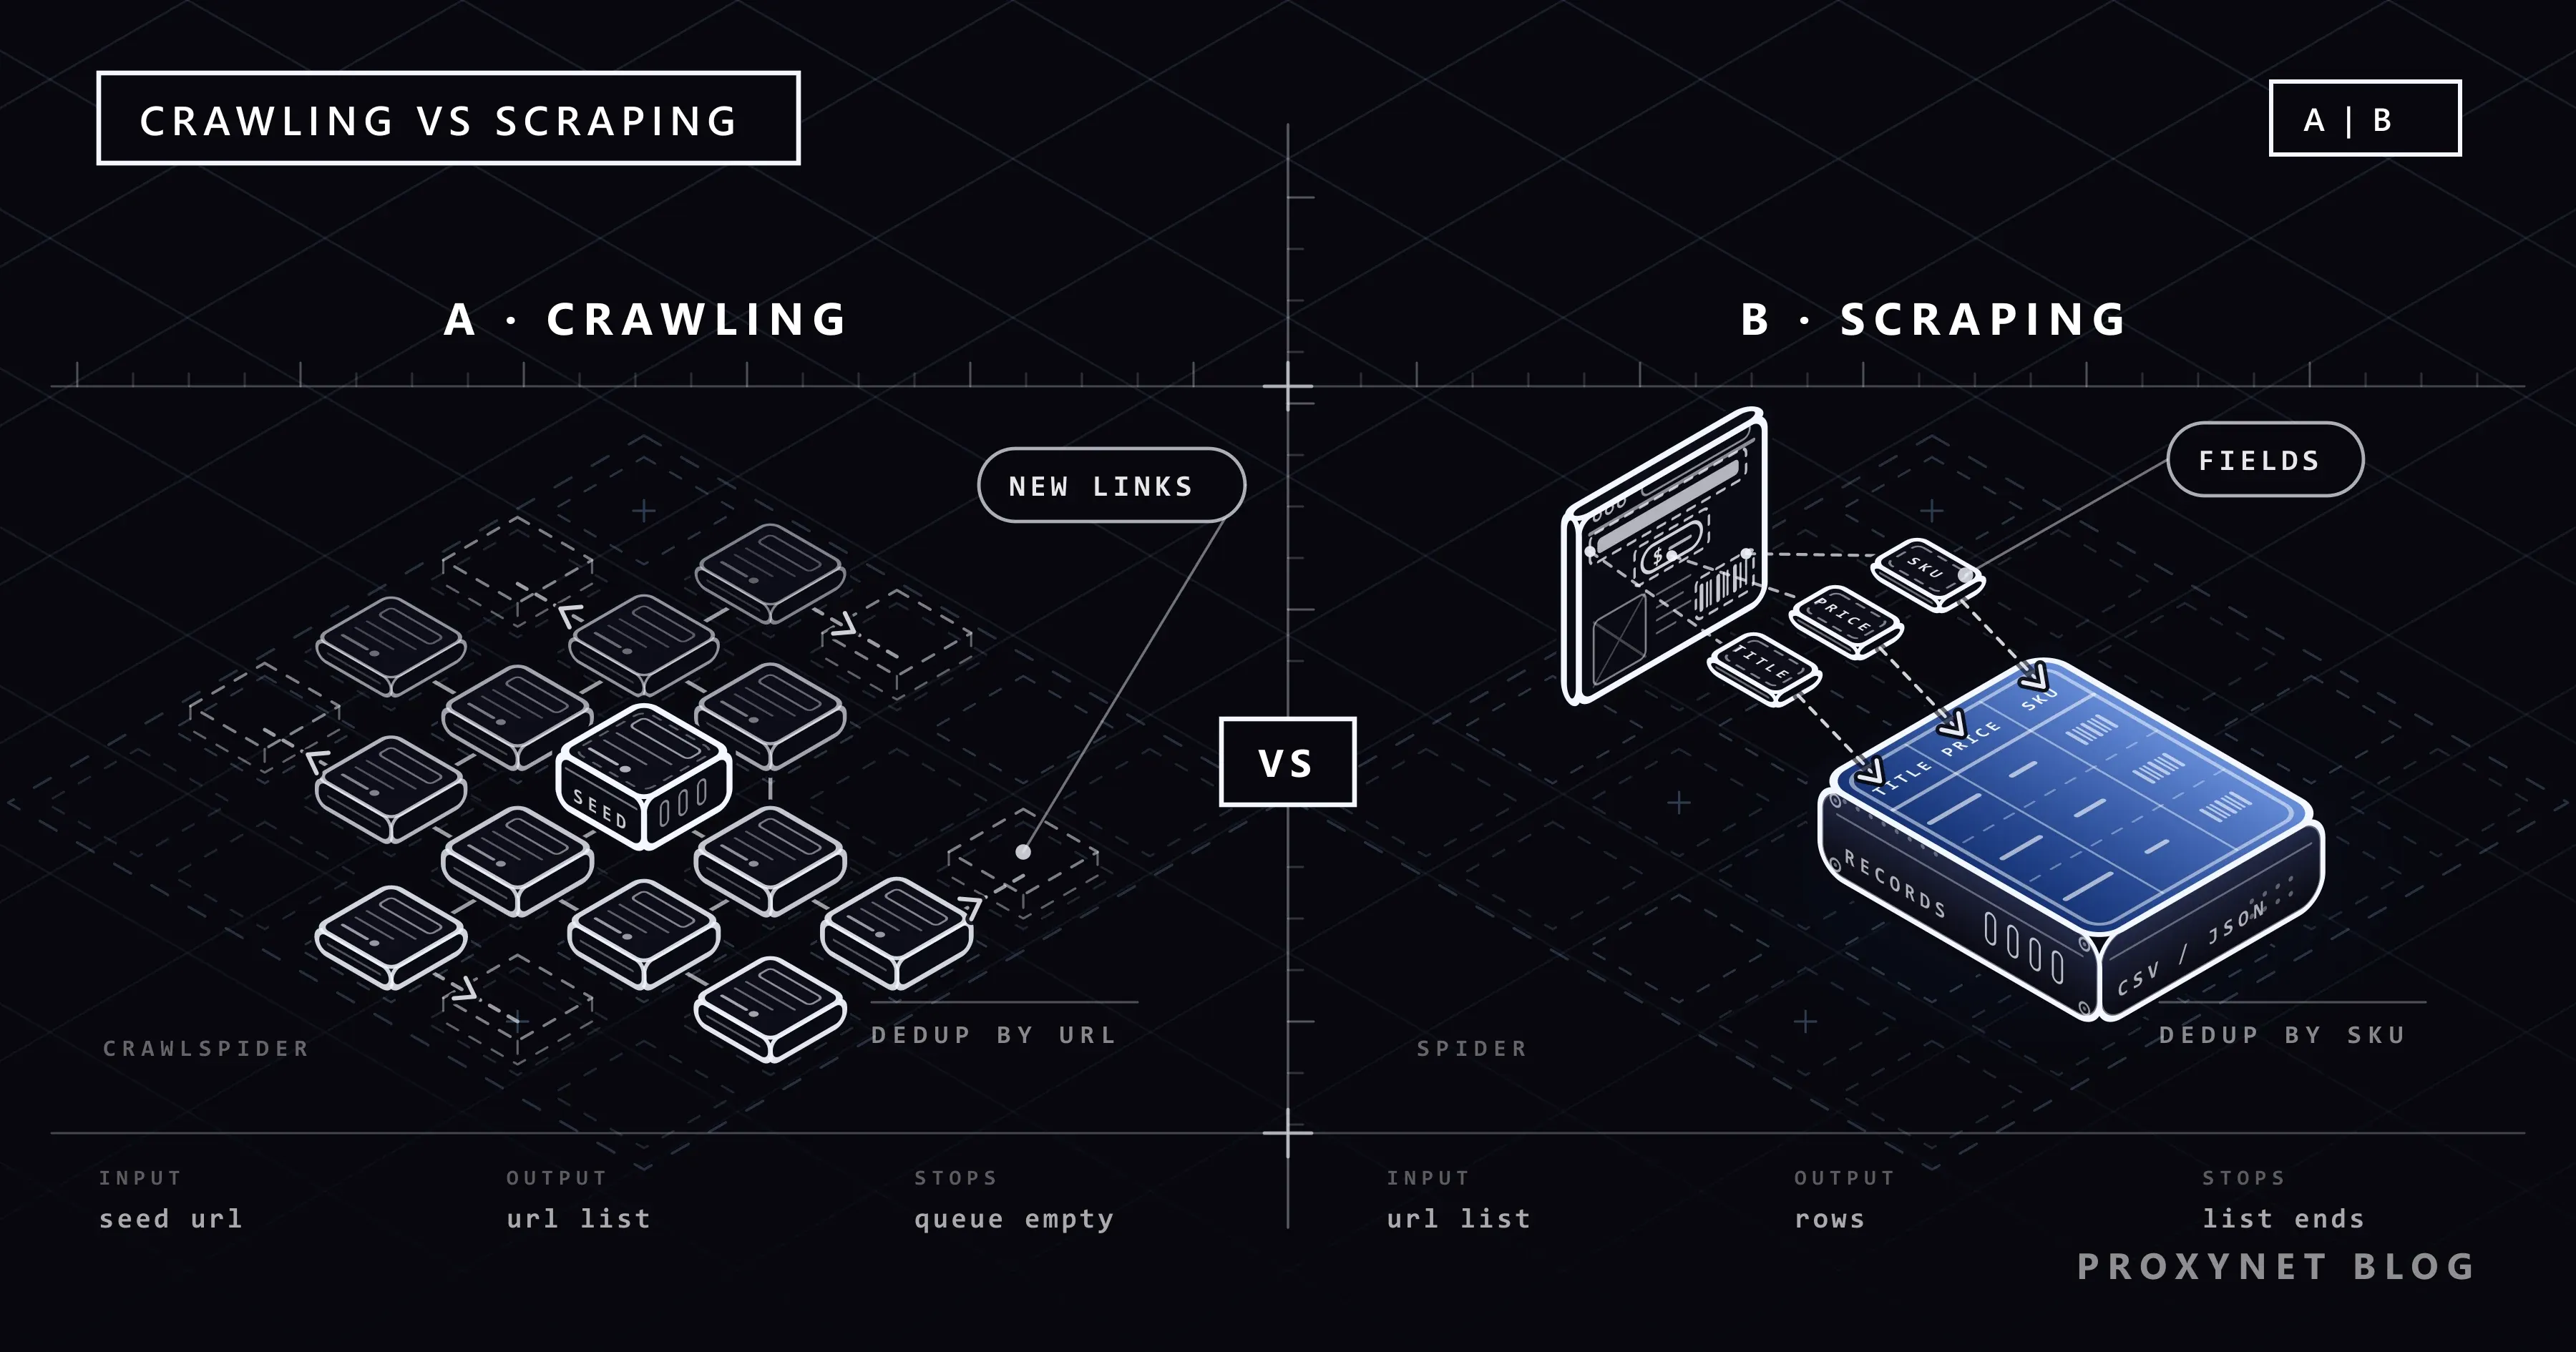
Web Crawling beantwortet die Frage „Wohin kann ich gehen?“. Ein Crawler ruft eine Seite ab, stellt die neu gefundenen Links in die Warteschlange und wiederholt das, bis eine Regel ihn stoppt. Das Ergebnis ist eine Karte der vorhandenen Seiten. Crawler-Aufgaben und die Proxys dahinter finden Sie auf unserer Seite Web Crawler.
Web Scraping beantwortet die Frage „Was steht auf dieser Seite?“. Ein Scraper öffnet eine Seite, die er bereits kennt, und macht aus den Teilen, die ein Mensch lesen würde (Name, Preis, Datum, SKU), eine strukturierte Zeile. Die Wahl der Methode, von Excel bis Python, behandeln unsere Seite Data Scraping und der Beitrag Daten von Websites extrahieren. Die beiden werden verwechselt, weil die meisten Werkzeuge beides können.
Was passiert, wenn dieselbe Seite bei einem Crawler und einem Scraper landet?
Geben Sie beiden dieselbe Kategorieseite einer Buchhandlung. Der Crawler liest ihre Links:
- Er sammelt die
<a href>-Werte im Kategoriemenü und in der Schaltfläche „Weiter“. - Er macht relative Adressen absolut und normalisiert sie, sodass zwei Schreibweisen einer Adresse zu einer einzigen Zeichenkette werden.
- Er gleicht jede Adresse mit der Menge der URLs ab, die er schon gesehen hat.
- Die neuen Adressen, die seine Domain- und Tiefenregeln erfüllen, fügt er der Frontier hinzu, also der Warteschlange der URLs, die auf ihren Abruf warten.
Der Scraper liest ihren Inhalt:
- Er findet die Felder mit Selektoren (CSS-Selektor oder XPath).
- Er prüft die Typen: Ein Preis ist eine Zahl, eine SKU ist nicht leer.
- Er führt die Zeile über einen Datensatzschlüssel mit früheren Zeilen zusammen.
- Er schreibt die Zeile in eine Datei oder Datenbank.
Web Crawling vs. Web Scraping: Vergleichstabelle
| Achse | Web Crawling | Web Scraping |
|---|---|---|
| Eingabe | Einige Start-URLs und Regeln zum Folgen von Links | Eine Liste bekannter Seiten-URLs |
| Ausgabe | Eine Liste von URLs oder eine Sammlung heruntergeladener Seiten | Strukturierte Zeilen (CSV, JSON, eine Datenbanktabelle) |
| Abbruchbedingung | Die Frontier ist leer, oder ein Tiefen-, Domain- oder Seitenlimit ist erreicht | Die Liste ist zu Ende |
| Einheit der Deduplizierung | Die URL oder der Fingerprint der Anfrage | Der Datensatzschlüssel (SKU, Inserats-ID) |
| Was das Tempo begrenzt | Gleichzeitige Anfragen pro Host und robots.txt-Regeln | Das Rate-Limit des Ziels und die Parsing-Zeit |
| Verhältnis zu robots.txt | Stößt auf Disallow-Zeilen bei selbst entdeckten Pfaden | Die ganze Liste lässt sich vor dem Lauf prüfen |
| Typischer Fehler | Endlose URL-Varianten, Abdriften auf andere Domains | Ein geändertes Template, das leere Felder liefert |
Der Unterschied ergibt sich aus der Frage, die eine Aufgabe stellt, nicht aus dem Werkzeug: Wohin geht es als Nächstes, oder was wird von hier mitgenommen?
Suchmaschinen-Bot vs. Preis-Bot: zwei Enden der Skala
Der Googlebot steht am Crawling-Ende. Googles Leitfaden How Search Works beschreibt den Ablauf so: Einige Seiten sind von früheren Besuchen bekannt, andere werden über Links auf bekannten Seiten gefunden, und Sitemaps fügen weitere hinzu. Ein Algorithmus entscheidet, welche Websites gecrawlt werden, wie oft und wie viele Seiten abgerufen werden, und der Crawler wird langsamer, wenn ein Server Fehler zurückgibt. Duplikate werden erst später, bei der Indexierung, unter einer kanonischen Seite gruppiert. Googles Leitfaden zum Crawling-Budget richtet sich vor allem an Websites mit mehr als einer Million eindeutiger Seiten, die sich etwa wöchentlich ändern, oder mit mehr als 10.000 Seiten, die sich täglich ändern.
Ein Preis-Bot steht am Scraping-Ende. Er hat eine feste Liste von Produkt-URLs, folgt keinen Links und liefert jeden Tag dieselbe Menge an Zeilen.
Die meisten kommerziellen Aufgaben liegen dazwischen: Ein wöchentlicher Kategorie-Crawl findet neue Produkte, und ein täglicher Scraper liest die Preise von der Liste, die der Crawl aktuell hält, wie in Wettbewerberpreise im E-Commerce überwachen. Wie Websites verifizierte Suchmaschinen-Bots von anderem Datenverkehr unterscheiden, erklären Bot-Erkennung: So funktionieren Anti-Bot-Systeme und Cloudflare Scraper.
Wo hört ein Crawler auf einer Website auf?
Ein Crawler hat keine Liste, die er abarbeiten könnte, also entscheiden Regeln, wie weit er geht:
- Die Frontier ist leer. Jede entdeckte URL wurde abgerufen, und es sind keine neuen hinzugekommen.
- Tiefenlimit. Die Tiefe zählt die Link-Sprünge ab dem Seed. Scrapys
DEPTH_LIMITsteht standardmäßig auf0, also ohne Limit. - Domain-Grenze.
allowed_domainshält den Crawler auf der Ziel-Website und ihren Subdomains. Seit Scrapy 2.18 greifen Änderungen daran auch während eines Crawls. - Seitenobergrenze. Eine harte Grenze wie
CLOSESPIDER_PAGECOUNTbeendet den Lauf, unabhängig von allem anderen.
Ob die Frontier jemals leer wird, hängt von der URL-Normalisierung ab. RFC 3986 beschreibt in Abschnitt 6 die Schritte: Schema und Host in Kleinbuchstaben schreiben, prozentkodierte nicht reservierte Zeichen dekodieren, .- und ..-Segmente entfernen und einen Standardport weglassen, sodass http://example.com und http://example.com:80/ dieselbe Ressource sind. Darüber hinaus entscheiden Sie, welche Query-Parameter zählen: Eine Sortierreihenfolge oder eine Session-ID erzeugt eine neue Adresse für denselben Inhalt.
Manche Websites erzeugen Adressen ohne Ende, etwa ein Kalender mit einem Link „Nächster Monat“ oder Filterkombinationen, die sich mit jedem Klick vervielfachen. Ohne Tiefenlimit und Seitenobergrenze kommt ein Crawler dort nie wieder heraus. Absichtlich gestellte Fallen-Links funktionieren genauso (Honeypot-Fallen). Eine veröffentlichte Sitemap ist oft eine bessere Startliste als das Folgen von Links (Die Sitemap einer Website finden).
Auf welcher Ebene entfernen Sie Duplikate: URL oder Datensatz?
Ein Crawler entfernt doppelte Anfragen. Scrapys Standard-DUPEFILTER_CLASS ist RFPDupeFilter, der die Fingerprints von Anfragen vergleicht, sodass eine Seite in einem Lauf nicht zweimal heruntergeladen wird.
Ein Scraper entfernt doppelte Datensätze. Ein Produkt kann über zwei URLs ankommen, über seine Kategorie und über eine Sale-Seite, und der URL-Filter lässt beide durch. Der Schlüssel muss aus den Daten kommen: eine SKU, ein Produktcode oder eine Inserats-ID. Deshalb ist die Behauptung falsch, Scraping brauche keine Deduplizierung. Wie Sie Zeilen nach Schlüssel in SQLite speichern, zeigt der Beitrag zur Paginierung beim Web Scraping.
Wie wirken sich robots.txt und Tempo-Regeln auf einen Crawler aus?
RFC 9309 bezeichnet Crawler als automatisierte Clients, nennt als Beispiel Suchmaschinen-Crawler, die Links „rekursiv durchlaufen“, und hält fest, dass robots.txt-Regeln „keine Form der Zugriffsautorisierung“ sind. Ein legitimer Crawler befolgt sie trotzdem und sollte eine zwischengespeicherte Kopie nicht länger als 24 Stunden nutzen, es sei denn, die Datei ist nicht erreichbar. Ein Crawler trifft häufiger auf Disallow-Zeilen, weil er ständig neue Pfade betritt. Syntax und Crawl-delay erklärt der Beitrag Was ist robots.txt und wie liest man die Datei?.
Das Tempo wird pro Host mit CONCURRENT_REQUESTS_PER_DOMAIN und DOWNLOAD_DELAY begrenzt. Scrapys Standardwerte im Code sind 8 und 0; die settings.py aus scrapy startproject setzt 1 und 1 und schaltet ROBOTSTXT_OBEY ein, das in den Standardwerten des Codes False ist. Wie Sie die Zahl wählen, steht in Concurrency und Parallelism, wie Sie ein 429 wiederholen, in HTTP-Statuscodes beim Web Scraping, und wie Sie Anfragen auf mehrere Adressen verteilen, in Proxys in Python rotieren. Für einen breiten Crawl über viele Hosts eignet sich ein Rotierender Proxy; eine kurze feste Liste läuft oft problemlos über einen Datacenter-Proxy.
Wie verbinden sich Crawling und Scraping in einer Pipeline?
In einem echten Projekt sind die beiden Aufgaben Stufen einer einzigen Schleife:
- Entdeckung. Start-URLs und Sitemap-Einträge gelangen ins System.
- Frontier. Eine Warteschlange hält URLs mit einer Priorität und einer Tiefenangabe.
- Download. Anfragen gehen unter einem Rate-Limit pro Host hinaus, mit Wiederholungen bei vorübergehenden Fehlern.
- Parsing. Jede Seite liefert Datensätze für die Ausgabe und neue Links für die Frontier.
Halten Sie die Warteschlange auf der Festplatte, damit ein unterbrochener Crawl fortgesetzt werden kann: Scrapy nutzt dafür JOBDIR, eine Variante mit SQLite zeigt der Beitrag zur Paginierung beim Web Scraping. Scrapy crawlt standardmäßig zuerst in die Tiefe (depth-first), weil seine Standard-Warteschlangen LIFO sind; ein positiver Wert für DEPTH_PRIORITY mit FIFO-Warteschlangen verschiebt es in Richtung Breitensuche (breadth-first).
Was ist der Unterschied zwischen Spider und CrawlSpider in Scrapy?
scrapy.Spider beginnt bei start_urls und ruft für jede Antwort parse auf. Einem Link folgt er nur, wenn Ihr Code eine neue Anfrage liefert (yield); mit einer festen Liste ist er also ein reiner Scraper.
CrawlSpider verlagert das Folgen von Links in rules. Jede Rule verbindet einen LinkExtractor mit einem optionalen callback und einem follow-Flag. Die Scrapy-Dokumentation zu Spiders legt den Standard fest: Ist callback gleich None, ist follow standardmäßig True, andernfalls False. Eine Regel ohne Callback läuft durch Seiten hindurch; eine Regel mit Callback parst Seiten und hört dort auf. Dieselbe Seite warnt, dass eine Anfrage, die Sie in einem CrawlSpider selbst erzeugen, einen expliziten Callback braucht; eine Anfrage ohne Callback wird wieder durch die Regeln geschickt.
Die folgende Datei führt beides auf einer Übungs-Website aus, die für Scraping-Übungen gebaut wurde. Sie braucht Scrapy 2.19 (erschienen am 10. September 2026, Python 3.10 oder neuer). Installation und Proxy-Middleware behandelt der Beitrag Was ist Scrapy und wie nutzt man es mit Proxy?.
"""Eine Übungs-Website, zwei Aufgaben: ein Listen-Scraper und ein regelbasierter Crawler."""
import sys

import scrapy
from scrapy.crawler import CrawlerProcess
from scrapy.linkextractors import LinkExtractor
from scrapy.spiders import CrawlSpider, Rule

POLITE = {
    "ROBOTSTXT_OBEY": True,  # ein Skriptlauf hat keine settings.py eines Projekts, also hier setzen
    "CONCURRENT_REQUESTS_PER_DOMAIN": 2,
    "DOWNLOAD_DELAY": 1,
    "RETRY_TIMES": 2,  # RetryMiddleware: bis zu 2 Wiederholungen bei 429, 500/502/503/504 und Timeouts
    "USER_AGENT": "ExampleCatalogBot/1.0 (+https://example.com/bot)",
}


def product(response):
    """Der Datensatz: Die UPC ist sein Schlüssel, zwei URLs für ein Buch ergeben also eine Zeile."""
    return {
        "upc": response.xpath("//th[text()='UPC']/following-sibling::td/text()").get(),
        "title": response.css("div.product_main h1::text").get(),
        "price": response.css("div.product_main p.price_color::text").get(),
        "url": response.url,
    }


class ListSpider(scrapy.Spider):
    """Scraping: eine bekannte Liste von Produkt-URLs, kein Folgen von Links."""

    name = "list"
    custom_settings = POLITE
    start_urls = [
        "https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html",
        "https://books.toscrape.com/catalogue/tipping-the-velvet_999/index.html",
        "https://books.toscrape.com/catalogue/soumission_998/index.html",
    ]

    def parse(self, response):
        yield product(response)


class CatalogSpider(CrawlSpider):
    """Crawling: Produktseiten über Kategorie- und Weiter-Links finden."""

    name = "catalog"
    allowed_domains = ["books.toscrape.com"]
    start_urls = ["https://books.toscrape.com/catalogue/category/books/poetry_23/index.html"]
    custom_settings = {**POLITE, "DEPTH_LIMIT": 3, "CLOSESPIDER_PAGECOUNT": 60}
    rules = (
        # Kein Callback, also ist follow standardmäßig True: Links auf diesen Seiten werden verfolgt.
        Rule(LinkExtractor(restrict_css=("ul.nav-list", "li.next"))),
        # Ein Callback, also ist follow standardmäßig False: Produktseiten werden geparst, nicht gecrawlt.
        Rule(LinkExtractor(restrict_css="article.product_pod h3"), callback="parse_item"),
    )

    def parse_item(self, response):
        yield product(response)


if __name__ == "__main__":
    spider = CatalogSpider if sys.argv[1:] == ["catalog"] else ListSpider
    feed = {f"{spider.name}.jsonl": {"format": "jsonlines", "encoding": "utf-8"}}
    process = CrawlerProcess(settings={"FEEDS": feed})
    process.crawl(spider)
    process.start()
python spiders.py startet den Scraper, python spiders.py catalog den Crawler. Wir nutzen einen __main__-Block, weil scrapy runspider aus einer Datei mit zwei Spider-Klassen nur eine auswählt. Für einen Proxy setzen Sie vorher in der Umgebung https_proxy=http://user:pass@pr.proxynet.io:8000; Scrapys HttpProxyMiddleware liest diese Variable.
Was die Testläufe gezeigt haben
Wir haben beide mit Python 3.13 und Scrapy 2.19.0 ausgeführt, direkt und über einen lokalen Test-Proxy:
- Der Scraper sendete vier Anfragen:
robots.txt(ein404, also keine Regeln) und die drei URLs. Er schrieb drei Zeilen. - Der Crawler endete mit
finish_reason: closespider_pagecountund 56 eindeutigen Büchern nach 74 Seiten, nicht 60: Anfragen, die schon an den Downloader übergeben wurden, laufen noch zu Ende, die Obergrenze ist also nur ungefähr. - Der Duplikatfilter verwarf 867 Anfragen, weil jede Kategorieseite in ihrem Menü auf alle 50 Kategorien verlinkt.
- Mit
DEPTH_LIMITauf 1 ignorierte der Crawler 3.151 tiefere Links, sammelte nur die 19 Lyrikbücher, die vom Seed aus verlinkt sind, und endete mitfinish_reason: finished, als seine Frontier leer war. - Über den Proxy lieferte der Scraper dieselben Zeilen. Mit einem falschen Passwort wurde jedes
407zweimal wiederholt, bevor Scrapy aufgab.
Anwendungsfälle
- Wettbewerberpreise verfolgen: eine feste Liste, täglich gescrapt, plus ein wöchentlicher Crawl nach neuen Produkten (Wettbewerberpreise im E-Commerce überwachen).
- Preisüberwachung im großen Maßstab: viele Shops, jeder in seinem eigenen Tempo gelesen (Preisüberwachung).
- SEO-Audits einer Website: Defekte Links und verwaiste Seiten sind reines Crawling, mit URLs und Statuscodes als Ausgabe (SEO-Proxy).
- Markenschutz: Ein Crawl über einen Marktplatz findet neue Inserate, ein Scraper liest Verkäufer und Preis (Markenschutz).
- JavaScript-Kataloge: Der Crawl findet die Seiten, und ein Headless-Browser rendert nur die, bei denen es nötig ist (Statische und dynamische Seiten beim Web Scraping).
Häufige Fehler
- Eine ganze Website crawlen, obwohl die Aufgabe eine feste Liste hat. Das belastet die Website ohne Grund und stößt auf mehr
Disallow-Zeilen. - URL-Normalisierung auslassen. Dieselbe Seite mit umsortierten Query-Parametern wird immer wieder heruntergeladen.
follow=Truebei einer Regel mit Callback, ohne Tiefenlimit. Jede Produktseite wird zu einem neuen Startpunkt, und der Crawl breitet sich über Links zu ähnlichen Artikeln aus.allowed_domainsweglassen. Ein Link zu einem Partner-Shop genügt, und der Crawler verlässt die Ziel-Website.- robots.txt bei jeder Anfrage abrufen oder nie wieder. Einmal pro Host genügt; bei längeren Läufen erneuern Sie die Datei innerhalb von 24 Stunden.
- Zeilen ohne Datensatzschlüssel. Ein Produkt, das über zwei Wege gefunden wird, wird zweimal geschrieben.
- In einem
CrawlSpidereine eigene Anfrage ohne Callback liefern. Sie läuft wieder durch die Regeln statt zu Ihrem Parser.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Meine Liste von Produkt-URLs ist fest, und ich lese täglich Preise | Nur ein Scraper (scrapy.Spider oder ein HTTP-Client) |
| Ich will auch die neuen Produkte des Wettbewerbers | Ein wöchentlicher Kategorie-Crawl, der URLs ergänzt, plus der tägliche Scraper |
| Ich brauche jede Seite meiner Website, um defekte Links zu finden | Ein reiner Crawler; die Ausgabe sind URLs und Statuscodes |
| Scrapy soll Links nach Regeln folgen | CrawlSpider mit Rule und LinkExtractor, immer mit DEPTH_LIMIT und allowed_domains |
| Die Website veröffentlicht eine Sitemap | Mit der Sitemap beginnen; Links nur für Bereiche folgen, die sie auslässt |
| Ein unterbrochener Crawl darf nicht von vorn beginnen | Eine persistente Warteschlange: Scrapys JOBDIR oder eine SQLite-Tabelle |
Häufige Fragen
Sind Web Crawling und Web Scraping dasselbe?
Nein. Crawling entdeckt Seiten, indem es Links folgt, und gibt eine Liste von URLs aus. Scraping extrahiert Felder aus bekannten Seiten und gibt strukturierte Datensätze aus. Ein Werkzeug, das beides kann, erledigt trotzdem zwei Aufgaben.
Ist der Googlebot ein Crawler oder ein Scraper?
Ein Crawler. Er findet URLs über Links, Sitemaps und frühere Besuche, und ein Algorithmus entscheidet, wie oft und wie tief jede Website gecrawlt wird. Er zieht keine Felder in Zeilen, wie es ein Preis-Scraper tut.
Was ist der Unterschied zwischen Spider und CrawlSpider in Scrapy?
Ein Spider folgt nur den Links, die Ihr Code anfordert, was zu einer festen Liste passt. Ein CrawlSpider folgt Links über rules: Eine Regel ohne Callback folgt standardmäßig, eine Regel mit Callback parst und folgt standardmäßig nicht. Anfragen, die Sie selbst liefern, brauchen einen expliziten Callback.
Muss ein Crawler die robots.txt befolgen?
Laut RFC 9309 sind die Regeln keine Form der Zugriffsautorisierung, die Datei ist also kein Schloss. Ein legitimer Crawler befolgt sie trotzdem, hält ein niedriges Tempo und nutzt einen ehrlichen User-Agent. Rechtliche Folgen hängen vom Land und vom Einzelfall ab (Ist Web Scraping legal?).
Welche Python-Bibliotheken werden für Crawling und Scraping genutzt?
Scrapy deckt beides ab: mit Scheduler, Duplikatfilter, robots.txt-Prüfung und Rate-Limits für das Crawling und mit Selektoren für das Scraping. Für eine kurze Liste reichen oft Requests oder HTTPX mit BeautifulSoup oder lxml (HTTPX, Requests und AIOHTTP im Vergleich).
Brauchen Sie für Crawling einen Proxy?
Ein Crawler sendet viele Anfragen an einen Host, und Websites begrenzen die Anfragen pro IP. Ein Proxy verteilt einen breiten Crawl auf mehrere Adressen, aber jeder Host sollte trotzdem ein rücksichtsvolles Tempo bekommen. Bei großen Crawls über viele Websites gibt ein Rotierender Proxy jeder Anfrage oder Sitzung eine andere Ausgangs-IP.
Fazit
Web Crawling findet über Links heraus, welche Seiten es gibt, und Web Scraping macht aus bekannten Seiten Datenzeilen. In den meisten Projekten verbindet eine Warteschlange die beiden: Der Crawl füllt sie, das Scraping leert sie. Braucht Ihr Crawl Ausgangs-IPs in einem bestimmten Land, sehen Sie sich den Residential-Proxy an oder vergleichen Sie die Optionen auf der Seite unserer Proxy-Dienste.