Uma equipe de e-commerce coleta os preços de um concorrente toda manhã a partir de uma lista com algumas centenas de URLs de produtos. Num certo mês, o concorrente abre uma categoria nova. Esses produtos não estão na lista, então nunca chegam ao relatório, e ninguém percebe durante semanas. Um scraper mais rápido não teria ajudado. Faltava uma etapa que percorresse as páginas de categoria e encontrasse endereços novos, e é justamente aí que termina o web crawling e começa o web scraping.
Neste artigo, comparamos web scraping vs web crawling em seis eixos: entrada, saída, condição de parada, deduplicação, velocidade e robots.txt. Explicamos onde um crawler para e como os dois trabalhos se juntam em um único pipeline e, depois, mostramos Spider e CrawlSpider no Scrapy com um código que executamos.
O que faz o web crawling e o que faz o web scraping?
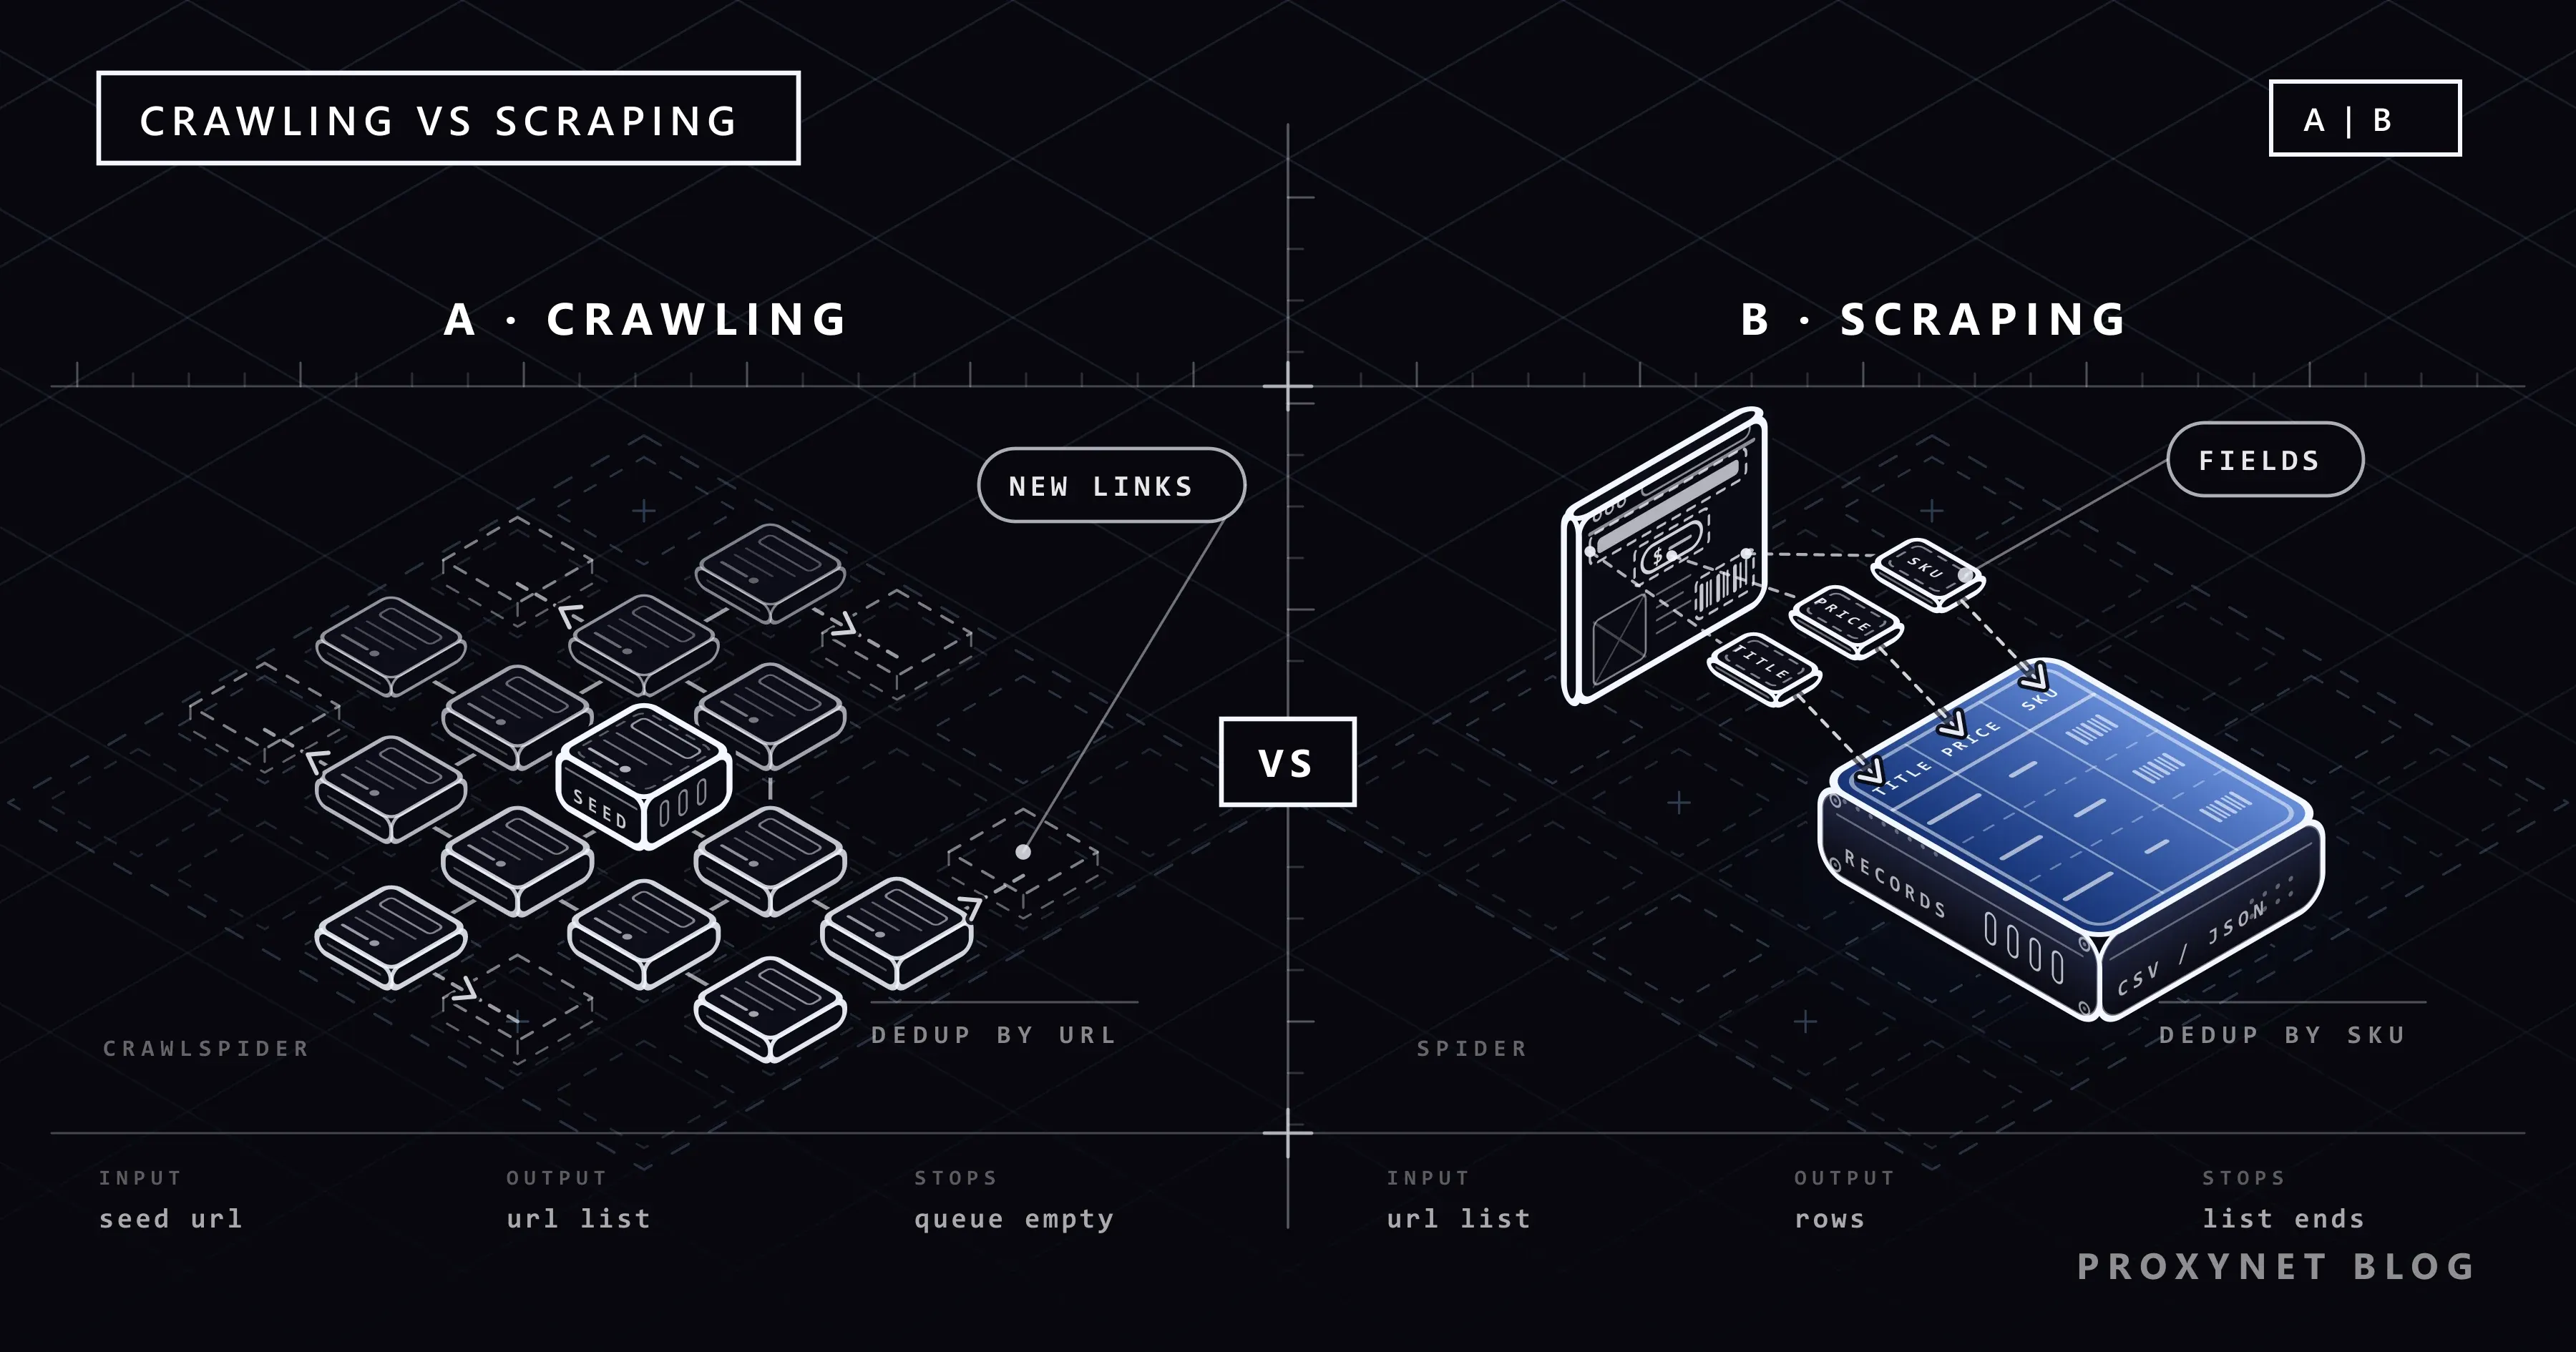
O web crawling responde à pergunta "para onde posso ir?". Um crawler baixa uma página, coloca na fila os links novos que encontra e repete o processo até que uma regra o faça parar. O resultado é um mapa das páginas que existem. Os trabalhos de crawler e os proxies por trás deles estão na nossa página de web crawler.
O web scraping responde à pergunta "o que há nesta página?". Um scraper abre uma página que já conhece e transforma as partes que uma pessoa leria (nome, preço, data, SKU) em uma linha estruturada. A escolha do método, do Excel ao Python, está na nossa página de extração de dados e em Como extrair dados de um site. Os dois se confundem porque a maioria das ferramentas faz as duas coisas.
O que acontece quando a mesma página chega a um crawler e a um scraper?
Entregue a mesma página de categoria de uma livraria aos dois. O crawler lê os links dela:
- Ele coleta os valores de
<a href>do menu de categorias e do botão "próxima". - Ele torna absolutos os endereços relativos e os normaliza, para que duas grafias do mesmo endereço virem uma única string.
- Ele compara cada endereço com o conjunto de URLs que já viu.
- Ele adiciona à fronteira (frontier), a fila de URLs à espera de download, os endereços novos que passam pelas suas regras de domínio e profundidade.
O scraper lê o conteúdo dela:
- Ele encontra os campos com seletores (Seletor CSS ou XPath).
- Ele confere os tipos: um preço é um número, um SKU não está vazio.
- Ele combina a linha com as anteriores por uma chave de registro.
- Ele grava a linha em um arquivo ou banco de dados.
Web crawling vs web scraping: tabela comparativa
| Eixo | Web crawling | Web scraping |
|---|---|---|
| Entrada | Algumas URLs iniciais e regras para seguir links | Uma lista de URLs de páginas conhecidas |
| Saída | Uma lista de URLs ou um conjunto de páginas baixadas | Linhas estruturadas (CSV, JSON, uma tabela de banco de dados) |
| Condição de parada | A fronteira esvazia ou um limite de profundidade, domínio ou páginas é atingido | A lista acaba |
| Unidade de deduplicação | A URL ou o fingerprint da requisição | A chave do registro (SKU, ID do anúncio) |
| O que limita a velocidade | Requisições simultâneas por host e regras do robots.txt | O limite de taxa do alvo e o tempo de parsing |
| Relação com o robots.txt | Encontra linhas Disallow em caminhos que descobre sozinho | A lista inteira pode ser conferida antes da execução |
| Falha típica | Variantes de URL sem fim, desvio para outros domínios | Um template alterado que devolve campos vazios |
A diferença vem da pergunta que o trabalho faz, não da ferramenta: para onde ir em seguida ou o que levar daqui.
Bot de buscador vs bot de preços: as duas pontas da escala
O Googlebot fica na ponta do crawling. O guia do Google sobre como a Pesquisa funciona diz que algumas páginas são conhecidas de visitas anteriores, outras são encontradas por links em páginas já conhecidas, e os sitemaps acrescentam mais. Um algoritmo decide quais sites rastrear, com que frequência e quantas páginas baixar, e o crawler desacelera quando um servidor devolve erros. As duplicatas são agrupadas depois, na indexação, sob uma única página canônica. O guia de orçamento de rastreamento do Google é voltado principalmente para sites com mais de um milhão de páginas únicas que mudam mais ou menos toda semana, ou com mais de 10.000 páginas que mudam todos os dias.
Um bot de preços fica na ponta do scraping. Ele tem uma lista fixa de URLs de produtos, não segue links e devolve o mesmo conjunto de linhas todos os dias.
A maioria dos trabalhos comerciais fica no meio: um rastreamento semanal das categorias encontra produtos novos, e um scraper diário lê os preços da lista que esse rastreamento mantém atualizada, como em Como monitorar preços da concorrência. Como os sites distinguem bots de busca verificados do resto do tráfego está em Como funciona a detecção de bots e em Cloudflare scraper.
Onde um crawler para em um site?
Um crawler não tem uma lista para terminar, então são regras que decidem até onde ele vai:
- A fronteira esvaziou. Todas as URLs descobertas foram baixadas e nenhuma nova apareceu.
- Limite de profundidade. A profundidade conta os saltos de link a partir da URL inicial. O
DEPTH_LIMITdo Scrapy tem0como padrão, o que significa sem limite. - Limite de domínio.
allowed_domainsmantém o crawler no site-alvo e nos seus subdomínios. Desde o Scrapy 2.18, as alterações feitas nele durante um crawling passam a valer. - Teto de páginas. Um limite rígido como
CLOSESPIDER_PAGECOUNTencerra a execução, aconteça o que acontecer.
A normalização de URLs decide se a fronteira algum dia vai esvaziar. A seção 6 da RFC 3986 descreve os passos: colocar o esquema e o host em minúsculas, decodificar caracteres não reservados com codificação percentual, remover os segmentos . e .. e descartar a porta padrão, de modo que http://example.com e http://example.com:80/ sejam o mesmo recurso. Além disso, cabe a você decidir quais parâmetros de consulta importam: uma ordem de classificação ou um ID de sessão cria um endereço novo para o mesmo conteúdo.
Alguns sites geram endereços sem fim, como um calendário com um link "próximo mês" ou combinações de filtros que se multiplicam a cada clique. Sem limite de profundidade e teto de páginas, um crawler nunca sai deles. Links-armadilha deliberados funcionam do mesmo jeito (armadilhas honeypot). Um sitemap publicado costuma ser uma lista inicial melhor do que seguir links (Como encontrar o sitemap de um site).
Em qual camada você remove duplicatas: URL ou registro?
Um crawler remove requisições duplicadas. O DUPEFILTER_CLASS padrão do Scrapy é o RFPDupeFilter, que compara os fingerprints das requisições, para que a mesma página não seja baixada duas vezes na mesma execução.
Um scraper remove registros duplicados. Um produto pode chegar por duas URLs, pela categoria e por uma página de promoções, e o filtro de URLs deixa passar as duas. A chave tem de vir dos dados: um SKU, um código de produto ou um ID de anúncio. Por isso é errada a ideia de que o scraping não precisa de deduplicação. Como guardar linhas por chave no SQLite está em Paginação em web scraping.
Como o robots.txt e as regras de velocidade afetam um crawler?
A RFC 9309 chama os crawlers de clientes automatizados, cita como exemplo os crawlers de buscadores que "percorrem links de forma recursiva" e diz que as regras do robots.txt "não são uma forma de autorização de acesso". Mesmo assim, um crawler legítimo as segue e não deve usar uma cópia em cache por mais de 24 horas, a não ser que o arquivo esteja inacessível. Um crawler encontra linhas Disallow com mais frequência porque entra o tempo todo em caminhos novos. A sintaxe e o Crawl-delay estão em O que é robots.txt.
A velocidade é limitada por host com CONCURRENT_REQUESTS_PER_DOMAIN e DOWNLOAD_DELAY. Os padrões no código do Scrapy são 8 e 0; o settings.py gerado por scrapy startproject define 1 e 1 e ativa o ROBOTSTXT_OBEY, que é False nos padrões do código. Como escolher o número está em Concorrência e paralelismo, como tentar de novo um 429 em Códigos de status HTTP no web scraping, e como distribuir as requisições por vários endereços em Como rotacionar proxies em Python. Um crawling amplo por muitos hosts combina com um Proxies rotativos; uma lista curta e fixa muitas vezes roda bem com um Proxies de datacenter.
Como crawling e scraping se juntam em um único pipeline?
Em um projeto real, os dois trabalhos são etapas de um mesmo ciclo:
- Descoberta. URLs iniciais e entradas do sitemap entram no sistema.
- Fronteira. Uma fila guarda as URLs com uma prioridade e um rótulo de profundidade.
- Download. As requisições saem sob um limite de taxa por host, com novas tentativas em erros temporários.
- Parsing. Cada página gera registros para a saída e links novos para a fronteira.
Mantenha a fila em disco para que um crawling interrompido possa continuar de onde parou: o Scrapy usa JOBDIR, e uma versão com SQLite está em Paginação em web scraping. Por padrão, o Scrapy rastreia em profundidade (depth-first), porque as filas padrão dele são LIFO; um DEPTH_PRIORITY positivo com filas FIFO o aproxima de um rastreamento em largura (breadth-first).
Qual é a diferença entre Spider e CrawlSpider no Scrapy?
O scrapy.Spider parte de start_urls e chama parse para cada resposta. Ele só segue um link quando o seu código gera uma nova requisição, então, com uma lista fixa, é um scraper puro.
O CrawlSpider leva o seguimento de links para as rules. Cada Rule combina um LinkExtractor com um callback opcional e uma flag follow. A documentação de spiders do Scrapy define o padrão: se callback for None, follow tem True como padrão; caso contrário, False. Uma regra sem callback atravessa as páginas; uma regra com callback faz o parsing das páginas e para ali. A mesma página avisa que uma requisição que você mesmo cria dentro de um CrawlSpider precisa de um callback explícito; uma requisição sem callback é mandada de volta pelas regras.
O arquivo abaixo roda os dois em um site de treino feito para exercícios de scraping. Ele precisa do Scrapy 2.19 (lançado em 10 de setembro de 2026, Python 3.10 ou superior). A instalação e o middleware de proxy estão em O que é Scrapy e como usar com proxy.
"""Um site de treino, dois trabalhos: um scraper de lista e um crawler baseado em regras."""
import sys

import scrapy
from scrapy.crawler import CrawlerProcess
from scrapy.linkextractors import LinkExtractor
from scrapy.spiders import CrawlSpider, Rule

POLITE = {
    "ROBOTSTXT_OBEY": True,  # um script avulso não tem o settings.py do projeto, então defina aqui
    "CONCURRENT_REQUESTS_PER_DOMAIN": 2,
    "DOWNLOAD_DELAY": 1,
    "RETRY_TIMES": 2,  # RetryMiddleware: até 2 novas tentativas em 429, 500/502/503/504 e timeouts
    "USER_AGENT": "ExampleCatalogBot/1.0 (+https://example.com/bot)",
}


def product(response):
    """O registro: o UPC é a chave, então duas URLs do mesmo livro geram uma única linha."""
    return {
        "upc": response.xpath("//th[text()='UPC']/following-sibling::td/text()").get(),
        "title": response.css("div.product_main h1::text").get(),
        "price": response.css("div.product_main p.price_color::text").get(),
        "url": response.url,
    }


class ListSpider(scrapy.Spider):
    """Scraping: uma lista conhecida de URLs de produtos, sem seguir links."""

    name = "list"
    custom_settings = POLITE
    start_urls = [
        "https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html",
        "https://books.toscrape.com/catalogue/tipping-the-velvet_999/index.html",
        "https://books.toscrape.com/catalogue/soumission_998/index.html",
    ]

    def parse(self, response):
        yield product(response)


class CatalogSpider(CrawlSpider):
    """Crawling: encontra páginas de produto seguindo links de categoria e de próxima página."""

    name = "catalog"
    allowed_domains = ["books.toscrape.com"]
    start_urls = ["https://books.toscrape.com/catalogue/category/books/poetry_23/index.html"]
    custom_settings = {**POLITE, "DEPTH_LIMIT": 3, "CLOSESPIDER_PAGECOUNT": 60}
    rules = (
        # Sem callback, então follow tem True como padrão: os links destas páginas são seguidos.
        Rule(LinkExtractor(restrict_css=("ul.nav-list", "li.next"))),
        # Com callback, então follow tem False como padrão: as páginas de produto são lidas, não percorridas.
        Rule(LinkExtractor(restrict_css="article.product_pod h3"), callback="parse_item"),
    )

    def parse_item(self, response):
        yield product(response)


if __name__ == "__main__":
    spider = CatalogSpider if sys.argv[1:] == ["catalog"] else ListSpider
    feed = {f"{spider.name}.jsonl": {"format": "jsonlines", "encoding": "utf-8"}}
    process = CrawlerProcess(settings={"FEEDS": feed})
    process.crawl(spider)
    process.start()
python spiders.py roda o scraper, e python spiders.py catalog, o crawler. Usamos um bloco __main__ porque o scrapy runspider pega só uma classe de spider de um arquivo que tem duas. Para usar proxy, defina antes https_proxy=http://user:pass@pr.proxynet.io:8000 no ambiente; o HttpProxyMiddleware do Scrapy lê essa variável.
O que as execuções mostraram
Rodamos os dois com Python 3.13 e Scrapy 2.19.0, diretamente e por um proxy de teste local:
- O scraper enviou quatro requisições,
robots.txt(um404, portanto sem regras) e as três URLs, e gravou três linhas. - O crawler fechou com
finish_reason: closespider_pagecounte 56 livros únicos depois de 74 páginas, não 60: as requisições já entregues ao downloader ainda terminam, então o teto é aproximado. - O filtro de duplicatas descartou 867 requisições, porque cada página de categoria tem links para todas as 50 categorias no menu.
- Com
DEPTH_LIMITigual a 1, o crawler ignorou 3.151 links mais profundos, coletou só os 19 livros de poesia linkados a partir da URL inicial e terminou comfinish_reason: finishedquando a fronteira esvaziou. - Pelo proxy, o scraper devolveu as mesmas linhas. Com uma senha errada, cada
407foi tentado de novo duas vezes antes de o Scrapy desistir.
Casos de uso
- Monitoramento de preços da concorrência: uma lista fixa lida todo dia, mais um rastreamento semanal em busca de produtos novos (Como monitorar preços da concorrência).
- Monitoramento de preços em escala: muitas lojas, cada uma lida no seu próprio ritmo (monitoramento de preços).
- Auditorias de SEO: links quebrados e páginas órfãs são crawling puro, com URLs e códigos de status como saída (proxy para SEO).
- Proteção de marca: um rastreamento do marketplace encontra anúncios novos, e um scraper lê vendedor e preço (proteção de marca).
- Catálogos em JavaScript: o crawling encontra as páginas, e um navegador headless renderiza só as que precisam disso (Páginas estáticas e dinâmicas).
Erros comuns
- Rastrear um site inteiro para um trabalho de lista fixa. Isso sobrecarrega o site à toa e esbarra em mais linhas
Disallow. - Pular a normalização de URLs. A mesma página com os parâmetros de consulta em outra ordem é baixada várias e várias vezes.
follow=Trueem uma regra com callback, sem limite de profundidade. Cada página de produto vira um novo ponto de partida, e o crawling se espalha pelos links de itens relacionados.- Deixar de fora o
allowed_domains. Basta um link para uma loja parceira para o crawler sair do site-alvo. - Buscar o robots.txt a cada requisição, ou nunca mais. Uma vez por host é suficiente; em execuções mais longas, atualize-o em até 24 horas.
- Linhas sem chave de registro. Um produto encontrado por dois caminhos é gravado duas vezes.
- Gerar a sua própria requisição sem callback em um
CrawlSpider. Ela volta pelas regras em vez de ir para o seu parser.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| A minha lista de URLs de produtos é fixa e leio os preços todo dia | Só um scraper (scrapy.Spider ou um cliente HTTP) |
| Também quero os produtos novos do concorrente | Um rastreamento semanal das categorias que adiciona URLs, mais o scraper diário |
| Preciso de todas as páginas do meu site para encontrar links quebrados | Um crawler puro; a saída são URLs e códigos de status |
| Quero que o Scrapy siga links por regras | CrawlSpider com Rule e LinkExtractor, sempre com DEPTH_LIMIT e allowed_domains |
| O site publica um sitemap | Comece pelo sitemap; siga links só nas seções que ele deixa de fora |
| Um crawling interrompido não pode recomeçar do zero | Uma fila persistente: o JOBDIR do Scrapy ou uma tabela SQLite |
Perguntas frequentes
Web crawling e web scraping são a mesma coisa?
Não. O crawling descobre páginas seguindo links e tem como saída uma lista de URLs. O scraping extrai campos de páginas conhecidas e tem como saída registros estruturados. Uma ferramenta que faz os dois continua fazendo dois trabalhos.
O Googlebot é um crawler ou um scraper?
Um crawler. Ele encontra URLs por links, sitemaps e visitas anteriores, e um algoritmo decide com que frequência e com que profundidade cada site é rastreado. Ele não extrai campos para linhas como faz um scraper de preços.
Qual é a diferença entre Spider e CrawlSpider no Scrapy?
Um Spider segue só os links que o seu código pede, o que serve para uma lista fixa. Um CrawlSpider segue links por meio das rules: por padrão, uma regra sem callback segue os links, e uma regra com callback faz o parsing e não segue. As requisições que você mesmo gera precisam de um callback explícito.
Um crawler é obrigado a obedecer ao robots.txt?
A RFC 9309 diz que as regras não são uma forma de autorização de acesso, então o arquivo não é uma tranca. Mesmo assim, um crawler legítimo o obedece, mantém uma velocidade baixa e usa um User-Agent honesto. As consequências jurídicas dependem do país e do caso (Web scraping é legal?).
Quais bibliotecas Python são usadas para crawling e scraping?
O Scrapy cobre os dois, com agendador, filtro de duplicatas, verificação do robots.txt e limites de velocidade para o crawling, e seletores para o scraping. Para uma lista curta, Requests ou HTTPX com BeautifulSoup ou lxml muitas vezes basta (HTTPX, Requests ou AIOHTTP).
Preciso de proxy para fazer crawling?
Um crawler envia muitas requisições para o mesmo host, e os sites limitam as requisições por IP. Um proxy distribui um crawling amplo por vários endereços, mas cada host ainda deve receber uma velocidade educada. Para crawlings grandes em muitos sites, um Proxies rotativos dá a cada requisição ou sessão uma saída diferente.
Em resumo
O web crawling descobre quais páginas existem seguindo links, e o web scraping transforma páginas conhecidas em linhas de dados. Na maioria dos projetos, uma fila liga os dois: o crawling a enche, o scraping a esvazia. Quando o seu crawling precisar de saídas em um país específico, veja o Proxies residenciais ou compare as opções na nossa página de serviços de proxy.