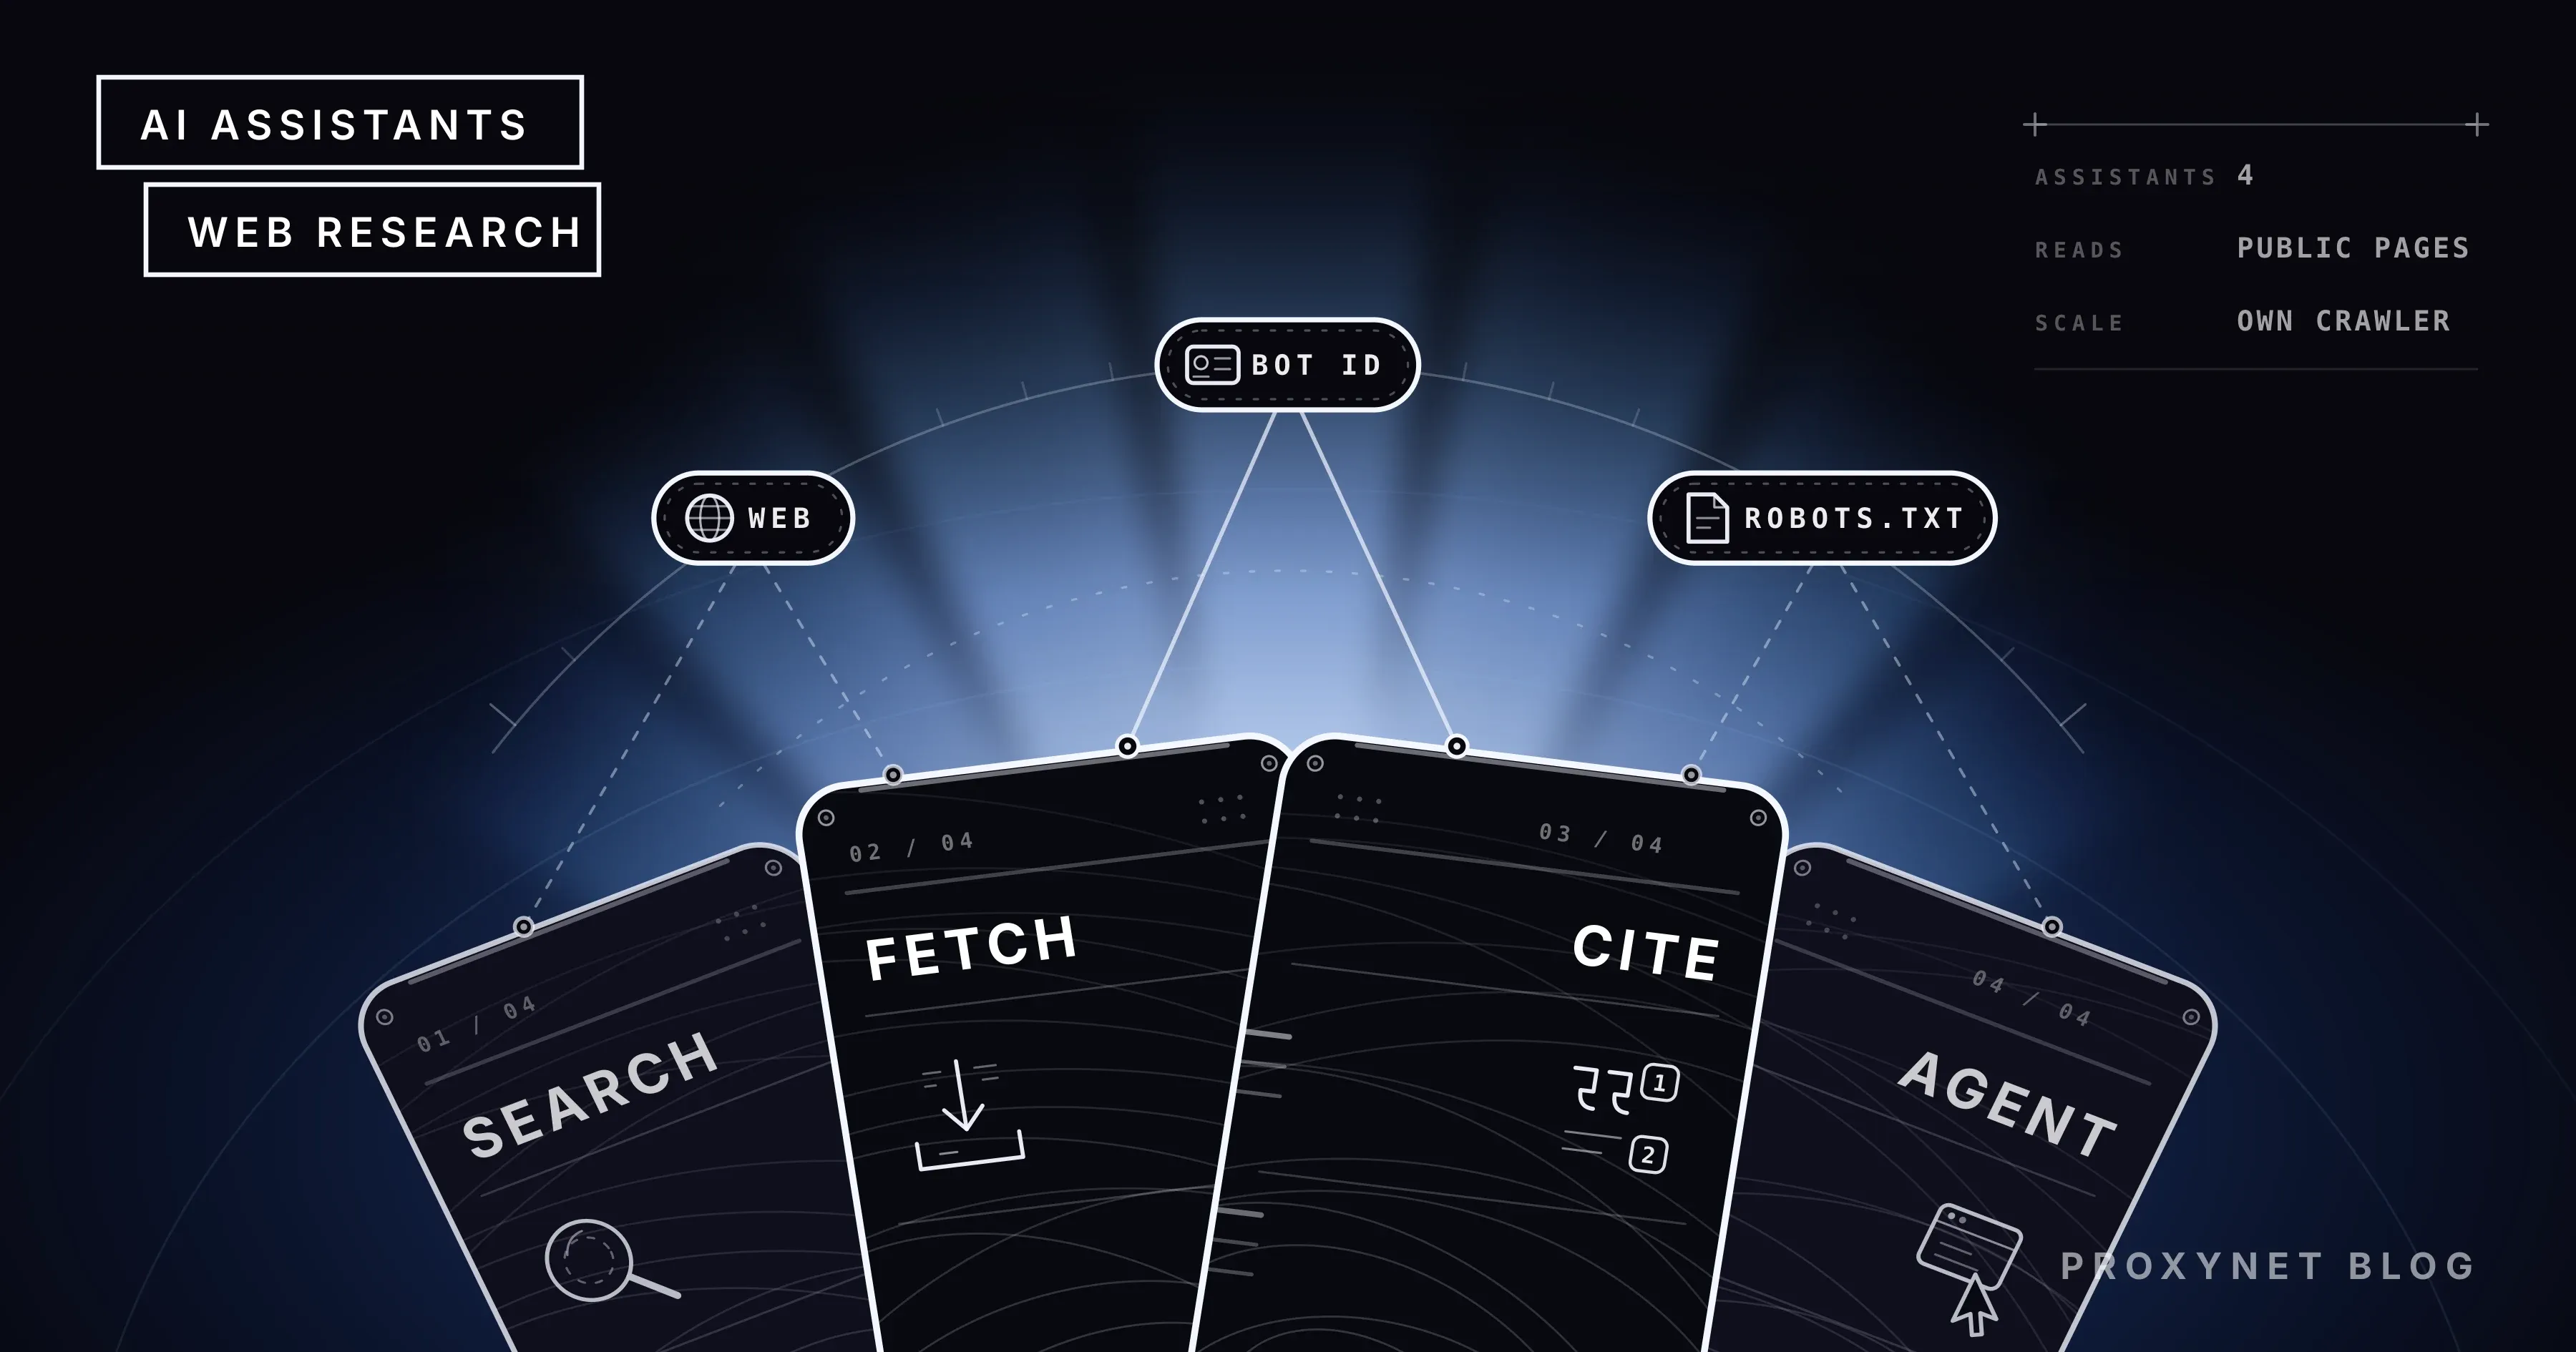
Un equipo de estudios de mercado hace la misma pregunta a cuatro asistentes: «¿Cuánto cuesta hoy este producto en esta tienda de Türkiye?». Uno devuelve un precio con fuentes numeradas, otro lee la página pero no dice de cuándo es, otro da un rango basado en resultados de Google y el último dice que no puede acceder a la página. Los cuatro se venden como «conectados a la web»; lo que los separa no es la inteligencia del modelo, sino la relación que cada producto tiene con la web.
Este artículo compara ChatGPT, Claude, Gemini y Perplexity desde ese único ángulo: cómo funciona la búsqueda en vivo, cómo se muestran las fuentes, si pueden leer una URL que les das y dónde se detienen, qué hacen los modos de «deep research» y de agente, y cómo son las herramientas web del lado de la API. Después pasamos al propietario del sitio: identidades de bot, comportamiento ante robots.txt y la disputa de agosto de 2025 entre Cloudflare y Perplexity. La última sección es para equipos de datos: por qué estos asistentes no son herramientas de scraping y dónde encaja un proxy. Comprobamos los datos de cada proveedor en sus propias páginas el 7 de octubre de 2026; no incluimos nombres de versiones de modelos.
¿Cómo llegan a la web los cuatro asistentes?
Los cuatro tienen búsqueda en vivo; la diferencia está en cuándo se ejecuta y sobre qué infraestructura. El modelo en sí no está conectado a la web: en cada producto hay una capa de búsqueda delante que convierte la pregunta en consultas, trae los resultados y se los entrega al modelo. Todo lo que hay de actual en la respuesta viene de esa capa.
ChatGPT, según la página de ayuda de OpenAI, busca en la web cuando hace falta, a veces trabaja con otros proveedores de búsqueda para hacerlo y reescribe tu pregunta en consultas dirigidas. La búsqueda está disponible en todos los planes; las fuentes llegan como citas en las que puedes hacer clic dentro del texto, y una vista «Fuentes» enumera los enlaces relacionados.
Claude incorporó la búsqueda web en marzo de 2025 y la ofrece en todo el mundo y en todos los planes desde mayo de 2025. Activas «Web search» desde el menú «+» de un chat, y Claude busca cuando la pregunta depende de información actual: hechos recientes, precios, datos sobre organizaciones y productos que pueden haber cambiado o una petición explícita de consultar algo. No busca para conocimiento asentado, matemáticas ni escritura creativa.
Gemini apoya sus respuestas en la Búsqueda de Google. Según la página de ayuda de Google, cuando hay fuentes disponibles aparece un botón «Fuentes» debajo o dentro de la respuesta que abre los enlaces en un panel lateral; si no hay botón, no se proporcionaron enlaces para esa respuesta. No toda respuesta se apoya en una búsqueda.
Perplexity parte de otro lugar. El producto es un motor de respuestas: cada pregunta va primero a la búsqueda y el modelo escribe después una respuesta con fuentes numeradas a partir de las páginas que encontró. No existe la opción de «apagar la web»; la web es la condición previa de la respuesta.
¿En qué se diferencian sus formatos de citas?
Los cuatro citan fuentes, pero la relación entre fuente y respuesta es distinta. Perplexity pone un número junto a cada frase y trata la lista de fuentes como parte de la respuesta. Claude cita a nivel de frase: qué fragmento vino de qué URL, con un extracto de 150 caracteres, viaja dentro de la respuesta. ChatGPT coloca las citas como enlaces dentro del texto y añade una lista de fuentes. Gemini reúne las fuentes en un panel aparte y trata como normal una respuesta sin fuentes.
| Asistente | Cuándo busca | Cómo aparecen las fuentes | Efecto de la ubicación |
|---|---|---|---|
| ChatGPT | Cuando la pregunta necesita datos actuales | Enlaces en el texto + lista de Fuentes | La ubicación aproximada derivada de la IP se pasa al socio de búsqueda |
| Claude | Cuando está activada y la pregunta lo necesita | Cita a nivel de frase con URL y extracto | No documentado en la app; un parámetro en la API |
| Gemini | Cuando la Búsqueda de Google mejoraría la respuesta | Botón Fuentes, panel lateral | No documentado |
| Perplexity | En cada pregunta | Fuentes numeradas como parte de la respuesta | Un parámetro en la API |
La columna de ubicación importa. La página de ayuda de OpenAI dice que ChatGPT pasa a sus socios de búsqueda una ubicación aproximada derivada de tu dirección IP, sin la IP en sí. Una pregunta de precio hecha desde Estambul puede no devolver los mismos resultados que una hecha desde Berlín. No encontramos ninguna página que documente esto en los otros tres productos, así que no afirmamos nada sobre ellos.
¿Qué pasa cuando pegas una URL?
Leer una página (fetch) es una capacidad distinta de la búsqueda: la búsqueda devuelve resúmenes de un índice, el fetch va a una dirección concreta y trae la página en sí. Los cuatro productos usan una identidad de bot aparte para esto cuando actúan en nombre de un usuario; el mecanismo es el mismo en todos:
- La dirección tiene que aparecer en la conversación. La herramienta de la API de Claude lo convierte en regla: solo pueden leerse las URL que aparecieron en un mensaje del usuario, en resultados de búsqueda o en resultados de herramientas; una dirección que el modelo escribió por su cuenta, no. La razón que da es el riesgo de exfiltración de datos.
- Se comprueban el dominio y robots.txt. La herramienta de Claude devuelve
url_not_allowedpara una ruta cerrada por robots.txt, una dirección de red privada o una URL que lleva credenciales. La herramienta URL context de Gemini excluye las direcciones de red local y los servicios de túnel. - Se recupera la página. Se leen texto, HTML y PDF. La documentación de Claude indica que las páginas renderizadas con JavaScript no están soportadas; la de Gemini dice que no se lee el contenido detrás de un inicio de sesión o de un muro de pago.
- Se recorta el contenido. Claude tiene un límite
max_content_tokens; Gemini permite 34 MB por URL y 20 URL por solicitud. El modelo lee la parte que cabe, no la página completa. - Se escribe la respuesta y se cita. En el fetch de Claude las citas son opcionales; Gemini devuelve junto a la respuesta qué URL se leyeron con éxito.
Luego está la caché. La documentación de Claude dice que el contenido leído se guarda en caché y puede no reflejar la última versión de la URL; use_cache se puede desactivar para obtener contenido fresco. Gemini mira primero en la caché de su propio índice y solo lee en vivo si la página no está ahí. Para datos que cambian cada hora, como un precio, esto decide la antigüedad de la respuesta.
| Asistente | Cómo lee una URL | Límites documentados | Postura ante robots.txt del bot activado por el usuario |
|---|---|---|---|
| ChatGPT | Visita de página por ChatGPT-User | Sin rastreo automático | «Pueden no aplicarse» |
| Claude | Claude-User; herramienta web fetch en la API | Sin JavaScript; la URL debe aparecer en el chat; caché | Obedece |
| Gemini | Fetchers activados por el usuario de Google; URL context en la API | 20 URL, 34 MB; sin inicio de sesión ni muro de pago | En general lo ignora |
| Perplexity | Perplexity-User | La página se usa de inmediato para responder la pregunta | En general lo ignora |
¿Qué hacen los modos de deep research y de agente?
Los cuatro productos tienen un modo de investigación larga, y todos ejecutan el mismo bucle: planificar, buscar, leer, volver a buscar lo que falta, escribir el informe. Gemini abrió este modo como «Deep Research» en diciembre de 2024; OpenAI lanzó «deep research» en febrero de 2025, Perplexity su «Deep Research» el mismo mes y Anthropic su función «Research» en abril de 2025. La diferencia está en cuántas páginas se leen, pero también en cómo viajan las fuentes: Perplexity y Claude atan la cita a la frase, ChatGPT y Gemini las agrupan debajo del informe. Describimos la forma de este bucle en cómo funcionan los agentes de IA.
Los modos de agente van un paso más allá: el asistente navega, rellena formularios y hace clic. Perplexity lanzó su propio navegador, Comet, para esto; Google lista una identidad de bot aparte (Google-Agent) para los agentes que navegan en nombre de un usuario; el modo agente de OpenAI vive dentro de ChatGPT. Para el propietario de un sitio, esa visita se parece a una humana, pero la solicitud sigue llegando de un programa y lleva su identidad en la cabecera user agent.
¿Cómo son las herramientas web del lado de la API?
En las cuatro API, la búsqueda web es una herramienta de servidor: la infraestructura del proveedor ejecuta la búsqueda y entrega los resultados al modelo. El desarrollador controla tres cosas: el número de búsquedas, un filtro de dominios y la ubicación.
| Asistente | Herramienta de API | Parámetro de ubicación | Filtro de dominios |
|---|---|---|---|
| OpenAI | web_search de la Responses API; anotaciones url_citation | user_location: ciudad, país, región, zona horaria | Sí |
| Anthropic | Herramientas web_search y web_fetch; citas obligatorias en la búsqueda | user_location: ciudad, región, código de país, zona horaria | allowed_domains o blocked_domains |
Grounding con google_search; url_context | No documentado | No documentado | |
| Perplexity | Modelos Sonar; search_results y citas por defecto | web_search_options.user_location: latitud y longitud más país, ciudad, región | search_domain_filter, hasta 20 dominios |
La misma solicitud con y sin country: "TR" puede devolver páginas distintas. La documentación de Claude pide al menos un campo y toma el país como código ISO de dos letras:
{
  "type": "web_search_20250305",
  "name": "web_search",
  "max_uses": 5,
  "user_location": {
    "type": "approximate",
    "city": "Istanbul",
    "country": "TR",
    "timezone": "Europe/Istanbul"
  }
}
En la herramienta de grounding de Google, el groundingMetadata que vuelve con la respuesta lleva las consultas de búsqueda, los fragmentos de fuente y un searchEntryPoint, y Google pide que estas «Search Suggestions» se muestren al usuario. La búsqueda de Perplexity no se puede desactivar, pero search_recency_filter limita la antigüedad de las fuentes.
¿Qué identidades de bot importan a los propietarios de sitios?
Cada proveedor usa tres identidades para tres trabajos: rastrear para entrenamiento, rastrear para un índice de búsqueda y abrir una página en nombre de un usuario. Cada una se gestiona por separado en robots.txt; bloquear el bot de entrenamiento no bloquea el bot de búsqueda. Nuestra guía de robots.txt explica cómo se escribe el archivo; aquí solo listamos los nombres y las posturas.
| Proveedor | Entrenamiento | Búsqueda | Activado por el usuario |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User |
| Google-Extended (solo token) | Googlebot | Fetchers activados por el usuario, Google-Agent | |
| Perplexity | Ninguno (no rastrea para entrenamiento) | PerplexityBot | Perplexity-User |
OpenAI define sus tres identidades en su documentación de bots. GPTBot rastrea para entrenamiento; OAI-SearchBot encuentra y enlaza sitios en la búsqueda de ChatGPT y no se usa para entrenamiento; ChatGPT-User visita una página cuando un usuario hace una pregunta y no rastrea de forma automática. Como un usuario inicia esas visitas, el documento dice que las reglas de robots.txt «pueden no aplicarse» a ChatGPT-User. Un sitio que bloquea OAI-SearchBot no aparece en las respuestas de búsqueda de ChatGPT; un cambio tarda unas 24 horas en recogerse. Los rangos de IP se publican en archivos JSON separados.
Anthropic define los tres bots en su página de ayuda y dice que los tres respetan robots.txt; es el único proveedor que dice «obedece» para su bot activado por el usuario. La página también dice que los bots admiten la directiva Crawl-delay y publica los rangos de IP en una sola lista JSON.
En Google, Gemini no rastrea con un crawler propio. Googlebot construye el índice; Google-Extended es un token de robots.txt sin cadena de user agent propia, y gobierna si el contenido rastreado puede usarse para entrenar modelos Gemini y para el grounding con la Búsqueda de Google en Gemini Apps y en Vertex AI. La documentación afirma dos cosas con claridad: Google-Extended no afecta a la posición de un sitio en la Búsqueda, y los fetchers activados por el usuario en general ignoran las reglas de robots.txt porque un usuario pidió la lectura. Bloquear Google-Extended no toca a Googlebot ni a las visitas hechas en nombre de un usuario.
Perplexity escribe en su documentación de crawlers que PerplexityBot rastrea para mostrar sitios en los resultados de búsqueda, no se usa para entrenamiento y respeta robots.txt. La frase para Perplexity-User es distinta: «Como un usuario pidió la lectura, este fetcher en general ignora las reglas de robots.txt». Los rangos de IP de ambos bots se publican en archivos JSON separados.
La conclusión práctica: robots.txt gobierna el rastreo automatizado, y tres de los cuatro proveedores tratan una visita única hecha en nombre de un usuario como algo fuera de ese archivo. La forma de limitar esas visitas es una regla del lado del servidor basada en el user agent y en las listas de IP publicadas. Una configuración habitual bloquea los bots de entrenamiento y deja abiertos los de búsqueda:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /
¿Qué pasó entre Cloudflare y Perplexity?
El 4 de agosto de 2025, Cloudflare publicó un artículo en el que acusaba a Perplexity de usar crawlers no declarados. Según su relato, sitios que habían bloqueado PerplexityBot informaron de que su contenido seguía apareciendo en las respuestas de Perplexity, y dominios de prueba nuevos que Cloudflare había cerrado a todos los bots seguían siendo leídos por Perplexity. El artículo decía que, una vez bloqueado el user agent declarado, las solicitudes llegaban con un user agent genérico parecido a Chrome y desde redes cambiantes (ASN), y que a veces robots.txt ni siquiera se descargaba; ese mismo día Cloudflare retiró a Perplexity de su lista de bots verificados.
Perplexity respondió al día siguiente con un artículo titulado «Agents or Bots? Making Sense of AI on the Open Web»: el tráfico en cuestión no era rastreo automatizado sino solicitudes de «agentes dirigidos por el usuario» que abrían una página para la pregunta inmediata de un usuario, no se indexó nada y Cloudflare había confundido parte del tráfico con un servicio de navegador en la nube de terceros. Los dos relatos no coinciden, y este artículo no es el árbitro. El resultado duradero es que la cuestión de la identidad avanzó hacia una respuesta técnica: ese mismo mes, Cloudflare abrió un programa de «signed agents» en el que los agentes firman sus solicitudes con Web Bot Auth, un borrador del IETF. Un bot que copia una cadena de user agent no puede producir esa firma.
¿Son estos asistentes herramientas de recopilación de datos?
No. Los límites de arriba son decisiones de diseño: el número de búsquedas por solicitud, la caché, leer solo las URL que aparecen en el chat, no ejecutar JavaScript y rechazar las rutas cerradas por robots.txt dimensionan estas herramientas para la pregunta inmediata de un usuario. Cien páginas exigen cien preguntas, y no puedes controlar qué versión de una página se leyó. Nuestro artículo sobre acceso web seguro para LLM describe a qué debe prestar atención un modelo cuando lee páginas en vivo.
Para una recopilación regular y a gran escala hay tres vías: una fuente que lo permita de forma explícita, la API oficial de la fuente o tu propio crawler. En la tercera vía, leer robots.txt, respetar los límites de solicitudes del sitio e identificarte con un user agent honesto son tu trabajo. Ejecutar el crawler a través de un Proxies de centro de datos separa tus direcciones de salida de tus servidores de aplicación y facilita identificarte con una lista fija de IP; no aumenta el número de solicitudes por minuto que un sitio permite.
El lugar real de un proxy es la geografía. Una tienda puede mostrar precios, monedas y campañas distintos según el país del visitante. Los asistentes leen una página desde donde esté su propia infraestructura; publican sus rangos de IP pero no prometen nada sobre el país. En tu propio crawler ese control es tuyo: un Proxies residenciales con salida en Türkiye devuelve la página tal como la ve un comprador de ese país y te permite guardar junto a los datos «desde qué país se vio». Que la respuesta de un asistente, en el caso de ChatGPT, pueda variar según dónde se hizo la pregunta es un asunto aparte.
Errores habituales
- Registrar el precio de un asistente sin fecha. La respuesta puede venir de una caché o de una página indexada días antes; guarda juntos la URL de la fuente y la hora de la respuesta.
- Tomar una respuesta sin fuentes por una con fuentes. En Gemini, si no hay botón «Fuentes», la respuesta no se apoyó en una búsqueda; en Claude, con la búsqueda web desactivada, la respuesta sale de los datos de entrenamiento.
- Intentar darle cientos de URL a un asistente. Las herramientas limitan las URL y los tokens por solicitud; cuando el trabajo crece, pasa a la API oficial o a tu propio crawler.
- Reportar una página renderizada con JavaScript como «el asistente no pudo leerla». La página vuelve como un cascarón vacío; el problema está en cómo está construida.
- Bloquear solo el bot de entrenamiento y dar el trabajo por hecho. Los bots de búsqueda y los activados por el usuario son identidades separadas, y la mayoría de estos últimos ni siquiera leen robots.txt.
- Confiar en la cadena de user agent. Cualquiera puede escribirla; la verificación necesita una lista de IP o una solicitud firmada.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Una respuesta rápida con fuente en cada frase | Perplexity |
| Leer un documento largo o una URL que tú aportas, con citas a nivel de frase | Claude |
| Respuestas actuales apoyadas en la Búsqueda de Google, dentro del ecosistema de Google | Gemini |
| Investigación diaria con verificación haciendo clic en las fuentes | ChatGPT |
| Añadir búsqueda web con fuentes a tu propia aplicación | Herramientas de OpenAI o Anthropic; Perplexity Sonar |
| Como propietario de un sitio, bloquear el rastreo para entrenamiento sin dejar de aparecer en la búsqueda | GPTBot, ClaudeBot y Google-Extended bloqueados; bots de búsqueda permitidos |
| Recopilación de datos regular y a gran escala | Una fuente que lo permita, una API oficial o tu propio crawler |
Preguntas frecuentes
¿ChatGPT está conectado a internet?
Sí. ChatGPT busca en la web cuando hace falta, en todos los planes, y añade a la respuesta fuentes en las que puedes hacer clic. A veces trabaja con otros proveedores de búsqueda y reescribe tu pregunta en consultas dirigidas.
¿Puede Claude buscar en la web?
Sí. La búsqueda web está en Claude desde marzo de 2025 y disponible en todos los planes y en todos los países desde mayo de 2025. La activas desde el menú «+» de un chat; Claude busca cuando una pregunta necesita información actual y ata cada cita a su fuente.
¿Cuál es la diferencia entre Perplexity y ChatGPT?
Perplexity empieza cada respuesta con una búsqueda y convierte las fuentes numeradas en parte de la respuesta; ChatGPT busca solo cuando hace falta y da las fuentes como enlaces dentro del texto. Perplexity encaja con una respuesta rápida y con fuentes; ChatGPT, con una conversación larga y un conjunto de herramientas más amplio.
¿Pueden los asistentes de IA leer páginas detrás de un muro de pago?
No. La documentación de URL context de Gemini indica que no se lee el contenido detrás de un inicio de sesión o de un muro de pago, y las demás herramientas también piden la página sin sesión. El asistente ve la versión de la página que el sitio muestra a todo el mundo.
¿Bloquear Google-Extended afecta al posicionamiento en la Búsqueda de Google?
No. La documentación de Google dice que Google-Extended no tiene una cadena de user agent propia y no afecta a la posición de un sitio en la Búsqueda de Google. El token solo gobierna si el contenido rastreado se usa para el entrenamiento y el grounding de Gemini.
¿Puedo bloquear por completo los bots de IA con robots.txt?
En parte. Los bots de entrenamiento y de búsqueda respetan robots.txt; la mayoría de los bots que abren una página en nombre de un usuario no lo hacen, con Claude-User de Anthropic como excepción. Para limitar las visitas activadas por el usuario necesitas reglas del lado del servidor basadas en el user agent y en las listas de IP publicadas.
En resumen
Los cuatro asistentes llegan a la web: Perplexity hace de la búsqueda la condición previa de cada respuesta, ChatGPT y Claude buscan cuando hace falta, y Gemini se apoya en la Búsqueda de Google y trata como normal una respuesta sin fuentes. Para leer URL comparten límites documentados: sin JavaScript, sin inicios de sesión, sin rutas cerradas por robots.txt y con una caché. Para el propietario de un sitio, la división real está en los bots activados por el usuario; todos los proveedores salvo Anthropic tratan esas visitas como algo fuera de robots.txt, así que el control pasa a los user agents y a las listas de IP. Para los equipos de datos, estas herramientas son asistentes de investigación, no recopiladores; la recopilación regular necesita una fuente que lo permita, una API oficial o tu propio crawler, y para ver una página desde el país correcto puedes consultar nuestra infraestructura de extracción de datos.