Bir e-ticaret ekibi, rakibin fiyatlarını her sabah birkaç yüz ürün URL'sinden oluşan bir listeden çekiyor. Derken rakip yeni bir kategori açıyor. Bu ürünler listede olmadığı için rapora hiç girmiyor ve haftalarca kimse fark etmiyor. Daha hızlı çalışan bir scraper bunu çözmezdi. Eksik olan, kategori sayfalarını gezip yeni adresleri bulan bir adımdı. Web crawling (tarama) ile web scraping (veri kazıma) arasındaki sınır da tam bu noktada: biri adres bulur, öbürü bulunan adresten veri çeker.
Bu yazıda web scraping vs web crawling farkını altı eksende karşılaştırıyoruz: girdi, çıktı, durma koşulu, tekilleştirme, hız ve robots.txt. Bir crawler'ın nerede durduğunu ve iki işin tek bir hatta nasıl birleştiğini anlatıyor, ardından Scrapy'deki Spider ve CrawlSpider sınıflarını çalıştırdığımız kodla gösteriyoruz.
Web crawling ne yapar, web scraping ne yapar?
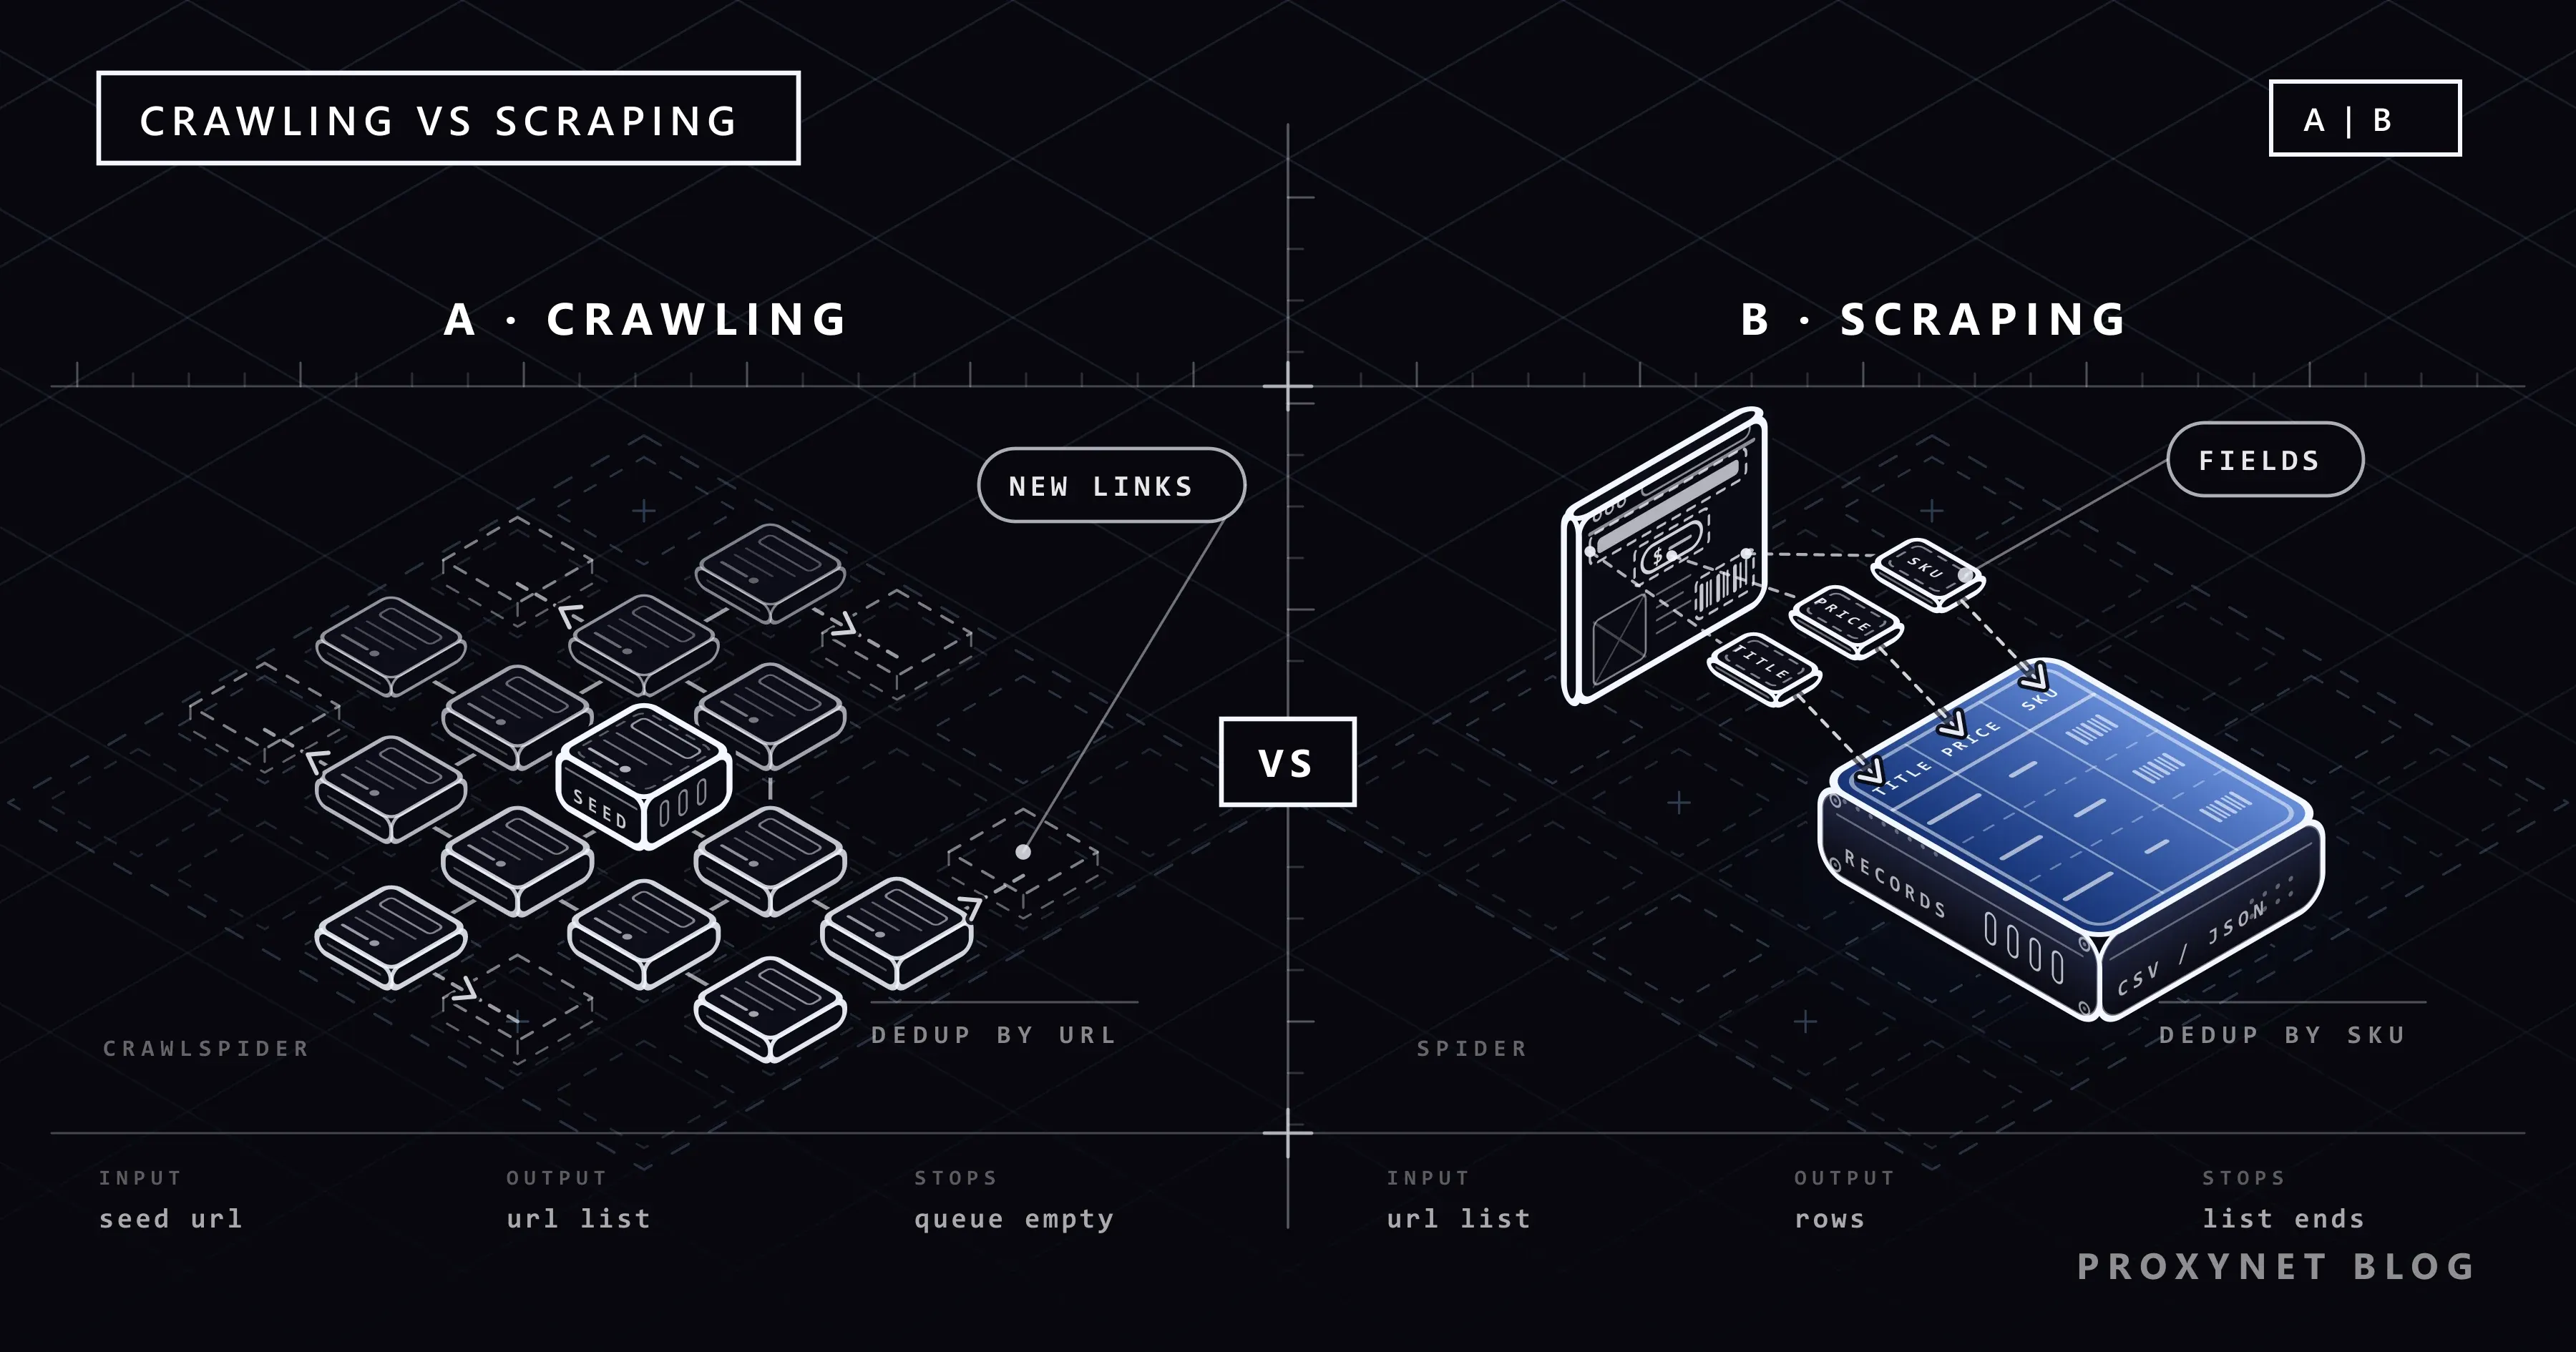
Web crawling "nereye gidebilirim?" sorusunu cevaplar. Crawler bir sayfayı indirir, bulduğu yeni bağlantıları kuyruğa ekler ve bir kural onu durdurana kadar bunu tekrarlar. Sonuç, sitede hangi sayfaların var olduğunu gösteren bir haritadır. Crawler işlerinde proxy kullanımını web crawler sayfamızda anlattık.
Web scraping "bu sayfada ne var?" sorusunu cevaplar. Scraper zaten bildiği bir sayfayı açar ve bir insanın okuyacağı kısımları (ürün adı, fiyat, tarih, SKU yani stok kodu) yapılandırılmış bir satıra çevirir. Excel'den Python'a kadar yöntem seçimini veri kazıma sayfamızda ve Web Sitesinden Veri Çekme yazımızda bulabilirsiniz. İkisinin karıştırılmasının sebebi, çoğu aracın ikisini birden yapması.
Aynı sayfa hem crawler'a hem scraper'a gelince ne olur?
Bir kitapçının kategori sayfasını ikisine birden verin. Crawler sayfanın bağlantılarını okur:
- Kategori menüsündeki ve "sonraki" düğmesindeki
<a href>değerlerini toplar. - Göreli adresleri mutlak adrese çevirir ve normalleştirir; böylece aynı adresin iki farklı yazımı tek bir biçime iner.
- Her adresi daha önce gördüğü URL'ler kümesiyle karşılaştırır.
- Alan adı ve derinlik kurallarına uyan yeni adresleri, indirilmeyi bekleyen URL kuyruğuna (frontier) ekler.
Scraper ise sayfanın içeriğini okur:
- Alanları seçicilerle bulur (CSS Selector ve XPath).
- Türleri kontrol eder: fiyat bir sayıdır, SKU boş değildir.
- Satırı bir kayıt anahtarına göre önceki satırlarla birleştirir.
- Satırı bir dosyaya ya da veritabanına yazar.
Web crawling vs web scraping: karşılaştırma tablosu
| Eksen | Web crawling | Web scraping |
|---|---|---|
| Girdi | Birkaç başlangıç adresi ve bağlantı izleme kuralları | Adresi bilinen sayfaların listesi |
| Çıktı | URL listesi ya da indirilmiş sayfa kümesi | Yapılandırılmış satırlar (CSV, JSON, veritabanı tablosu) |
| Durma koşulu | Frontier boşalır ya da derinlik, alan adı veya sayfa sınırına gelinir | Liste biter |
| Tekilleştirme birimi | URL ya da istek parmak izi | Kayıt anahtarı (SKU, ilan numarası) |
| Hızı sınırlayan | Host başına eşzamanlı istek sayısı ve robots.txt kuralları | Hedefin hız sınırı ve ayrıştırma süresi |
| robots.txt ile ilişkisi | Kendi bulduğu yollarda Disallow satırlarına rastlar | Listenin tamamı çalıştırmadan önce kontrol edilebilir |
| Tipik hata | Sonu gelmeyen URL varyantları, başka alan adlarına kayma | Şablon değişince boş dönen alanlar |
Fark araçtan değil, işin sorduğu sorudan gelir: "Sırada nereye gidilir?" ya da "Buradan ne alınır?"
Arama motoru botu ile fiyat botu: ölçeğin iki ucu
Googlebot tarama ucunda durur. Google'ın How Search Works rehberine göre bazı sayfalar önceki ziyaretlerden bilinir, bazıları bilinen sayfalardaki bağlantılarla bulunur, sitemap'ler de listeye yenilerini ekler. Hangi sitenin ne sıklıkla ve kaç sayfayla taranacağına bir algoritma karar verir; sunucu hata döndürdüğünde crawler yavaşlar. Kopyalar daha sonra, indeksleme aşamasında tek bir canonical (asıl kabul edilen) sayfa altında gruplanır. Google'ın tarama bütçesi rehberi esas olarak bir milyondan fazla tekil sayfası olan ve içeriği yaklaşık haftada bir değişen sitelere ya da 10.000'den fazla sayfası her gün değişen sitelere yöneliktir.
Fiyat botu ise scraping ucunda durur. Elinde sabit bir ürün URL listesi vardır, hiçbir bağlantıyı izlemez ve her gün aynı satır kümesini döndürür.
Ticari işlerin çoğu bu ikisinin arasında bir yerdedir: haftalık bir kategori taraması yeni ürünleri bulur, günlük bir scraper da taramanın güncel tuttuğu listeden fiyatları okur. Bu düzeni E-Ticarette Rakip Fiyat Takibi yazımızda anlattık. Sitelerin doğrulanmış arama botlarını diğer trafikten nasıl ayırdığını Bot Tespiti Nasıl Yapılır? ve Cloudflare Scraper yazılarımızda bulabilirsiniz.
Bir crawler sitenin neresinde durur?
Crawler'ın bitireceği bir liste yoktur; ne kadar ileri gideceğine kurallar karar verir:
- Frontier boşalır. Bulunan her URL indirilmiştir ve yenisi çıkmamıştır.
- Derinlik sınırı. Derinlik, başlangıç adresinden itibaren kaç bağlantı atlandığını sayar. Scrapy'de
DEPTH_LIMITvarsayılan olarak0'dır, yani sınır yoktur. - Alan adı sınırı.
allowed_domainscrawler'ı hedef sitede ve alt alan adlarında tutar. Scrapy 2.18'den beri bu listede tarama sırasında yapılan değişiklikler de geçerli olur. - Sayfa tavanı.
CLOSESPIDER_PAGECOUNTgibi kesin bir üst sınır, başka ne olursa olsun çalışmayı bitirir.
Kuyruğun bir gün boşalıp boşalmayacağını URL normalleştirme belirler. RFC 3986 6. bölümde adımları sıralar: şema ve host küçük harfe çevrilir, yüzde kodlamasıyla yazılmış, özel anlamı olmayan (unreserved) karakterler çözülür, . ve .. segmentleri kaldırılır, varsayılan port atılır. Böylece http://example.com ile http://example.com:80/ aynı kaynaktır. Bunun ötesinde hangi sorgu parametrelerinin önemli olduğuna siz karar verirsiniz: bir sıralama düzeni ya da oturum kimliği, aynı içerik için yeni bir adres üretir.
Bazı siteler sonu gelmeyen adresler üretir: "sonraki ay" bağlantısı olan bir takvim ya da her tıklamada çoğalan filtre kombinasyonları gibi. Derinlik sınırı ve sayfa tavanı olmayan bir crawler bunlardan hiç çıkamaz. Bilerek konmuş tuzak bağlantılar da aynı şekilde çalışır (Honeypot Tuzakları). Yayımlanmış bir sitemap çoğu zaman bağlantı izlemekten daha iyi bir başlangıç listesidir (Sitemap Nasıl Bulunur?).
Tekilleştirme hangi katmanda yapılır: URL mi, kayıt mı?
Crawler tekrar eden istekleri ayıklar. Scrapy'nin varsayılan DUPEFILTER_CLASS değeri RFPDupeFilter'dır. Bu sınıf isteklerin parmak izlerini (URL, metot ve gövdeden hesaplanan bir özet) karşılaştırır, böylece bir sayfa aynı çalışmada iki kez indirilmez.
Scraper ise tekrar eden kayıtları ayıklar. Bir ürün iki farklı URL'den gelebilir: kategorisinden ve bir indirim sayfasından. URL filtresi ikisini de geçirir. Anahtarın veriden gelmesi gerekir: SKU, ürün kodu ya da ilan numarası. Yani scraping de tekilleştirme ister. Satırları SQLite'ta anahtara göre saklamayı Sayfalama (Pagination) Nedir yazımızda gösterdik.
robots.txt ve hız kuralları bir crawler'ı nasıl etkiler?
RFC 9309 crawler'ları otomatik istemciler olarak tanımlar ve örnek olarak bağlantıları "özyinelemeli olarak dolaşan" arama motoru crawler'larını verir. Aynı belge robots.txt kurallarının "bir erişim yetkilendirmesi biçimi olmadığını" söyler. Meşru bir crawler yine de bu kurallara uyar ve dosyaya ulaşılamadığı durumlar dışında önbellekteki kopyayı 24 saatten uzun kullanmamalıdır. Crawler Disallow satırlarına daha sık rastlar, çünkü sürekli yeni yollara girer. Söz dizimi ve Crawl-delay için robots.txt Dosyası Nedir yazımıza bakabilirsiniz.
Hız, host başına CONCURRENT_REQUESTS_PER_DOMAIN ve DOWNLOAD_DELAY ile sınırlanır. Scrapy'nin koddaki varsayılanları 8 ve 0'dır; scrapy startproject ile gelen settings.py ise bunları 1 ve 1 yapar ve koddaki varsayılanı False olan ROBOTSTXT_OBEY ayarını açar. Sayının nasıl seçileceğini Concurrency ve Parallelism, 429 hatasında yeniden denemeyi Scraping'de HTTP Hata Kodları, istekleri farklı adreslere dağıtmayı Python'da Proxy'ler Nasıl Döndürülür? yazımızda anlattık. Çok sayıda host'a yayılan geniş bir tarama Rotating Proxy ile iyi çalışır; kısa ve sabit bir liste çoğu zaman Datacenter Proxy ile sorunsuz ilerler.
Crawling ve scraping tek bir hatta nasıl birleşir?
Gerçek bir projede iki iş, aynı döngünün aşamalarıdır:
- Keşif. Başlangıç adresleri ve sitemap kayıtları sisteme girer.
- Frontier. Bir kuyruk, URL'leri bir öncelik ve bir derinlik etiketiyle tutar.
- İndirme. İstekler host başına bir hız sınırı altında gönderilir, geçici hatalarda yeniden denenir.
- Ayrıştırma. Her sayfa çıktı için kayıtlar, frontier için yeni bağlantılar üretir.
Yarıda kesilen bir taramanın kaldığı yerden sürmesi için kuyruğu diskte tutun: Scrapy bunun için JOBDIR kullanır, SQLite ile yapılmış bir sürümü de Sayfalama (Pagination) Nedir yazımızda bulabilirsiniz. Scrapy varsayılan olarak derinlik öncelikli tarar, çünkü varsayılan kuyrukları LIFO'dur (son giren ilk çıkar). Pozitif bir DEPTH_PRIORITY değeri FIFO kuyruklarla birlikte onu genişlik öncelikli taramaya yaklaştırır.
Scrapy'de Spider ile CrawlSpider arasındaki fark nedir?
scrapy.Spider start_urls listesinden başlar ve her yanıt için parse metodunu çağırır. Bir bağlantıyı ancak kodunuz yeni bir istek ürettiğinde izler; sabit bir listeyle çalıştığında saf bir scraper'dır.
CrawlSpider bağlantı izlemeyi rules içine taşır. Her Rule bir LinkExtractor'ı isteğe bağlı bir callback ve bir follow bayrağıyla eşleştirir. Scrapy spiders dokümantasyonu varsayılanı şöyle belirler: callback None ise follow varsayılan olarak True, değilse False olur. Callback'i olmayan bir kural sayfalar arasında gezer; callback'i olan bir kural sayfaları ayrıştırır ve orada durur. Dokümantasyon bir uyarı da yapar: CrawlSpider içinde kendi oluşturduğunuz bir isteğe callback'i açıkça vermeniz gerekir, callback'siz bir istek yeniden kurallardan geçirilir.
Aşağıdaki dosya ikisini de scraping alıştırmaları için yapılmış bir deneme sitesinde çalıştırıyor. Scrapy 2.19 gerekir (10 Eylül 2026'da yayımlandı, Python 3.10 ya da üstü ister). Kurulumu ve proxy middleware'ini Scrapy Nedir ve Proxy ile Nasıl Kullanılır? yazımızda anlattık.
"""Tek deneme sitesi, iki iş: bir liste scraper'ı ve kurallarla çalışan bir crawler."""
import sys

import scrapy
from scrapy.crawler import CrawlerProcess
from scrapy.linkextractors import LinkExtractor
from scrapy.spiders import CrawlSpider, Rule

POLITE = {
    "ROBOTSTXT_OBEY": True,  # betik olarak çalışınca projenin settings.py dosyası yok, bu yüzden burada açılır
    "CONCURRENT_REQUESTS_PER_DOMAIN": 2,
    "DOWNLOAD_DELAY": 1,
    "RETRY_TIMES": 2,  # RetryMiddleware: 429, 500/502/503/504 ve zaman aşımlarında en fazla 2 yeniden deneme
    "USER_AGENT": "ExampleCatalogBot/1.0 (+https://example.com/bot)",
}


def product(response):
    """Kayıt: anahtarı UPC'dir, bu yüzden aynı kitabın iki URL'si tek satır verir."""
    return {
        "upc": response.xpath("//th[text()='UPC']/following-sibling::td/text()").get(),
        "title": response.css("div.product_main h1::text").get(),
        "price": response.css("div.product_main p.price_color::text").get(),
        "url": response.url,
    }


class ListSpider(scrapy.Spider):
    """Scraping: bilinen bir ürün URL listesi, bağlantı izleme yok."""

    name = "list"
    custom_settings = POLITE
    start_urls = [
        "https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html",
        "https://books.toscrape.com/catalogue/tipping-the-velvet_999/index.html",
        "https://books.toscrape.com/catalogue/soumission_998/index.html",
    ]

    def parse(self, response):
        yield product(response)


class CatalogSpider(CrawlSpider):
    """Crawling: kategori ve sonraki sayfa bağlantılarını izleyerek ürün sayfalarını bulur."""

    name = "catalog"
    allowed_domains = ["books.toscrape.com"]
    start_urls = ["https://books.toscrape.com/catalogue/category/books/poetry_23/index.html"]
    custom_settings = {**POLITE, "DEPTH_LIMIT": 3, "CLOSESPIDER_PAGECOUNT": 60}
    rules = (
        # Callback yok, bu yüzden follow varsayılan olarak True: bu sayfalardaki bağlantılar izlenir.
        Rule(LinkExtractor(restrict_css=("ul.nav-list", "li.next"))),
        # Callback var, bu yüzden follow varsayılan olarak False: ürün sayfaları ayrıştırılır, taranmaz.
        Rule(LinkExtractor(restrict_css="article.product_pod h3"), callback="parse_item"),
    )

    def parse_item(self, response):
        yield product(response)


if __name__ == "__main__":
    spider = CatalogSpider if sys.argv[1:] == ["catalog"] else ListSpider
    feed = {f"{spider.name}.jsonl": {"format": "jsonlines", "encoding": "utf-8"}}
    process = CrawlerProcess(settings={"FEEDS": feed})
    process.crawl(spider)
    process.start()
python spiders.py scraper'ı, python spiders.py catalog ise crawler'ı çalıştırır. __main__ bloğu kullanmamızın sebebi, scrapy runspider komutunun iki sınıf içeren bir dosyadan yalnız bir spider sınıfını seçmesi. Proxy için önce ortamda https_proxy=http://user:pass@pr.proxynet.io:8000 değişkenini tanımlayın; Scrapy'nin HttpProxyMiddleware bileşeni bu değeri okur.
Çalıştırdığımızda ne gördük
İkisini de Python 3.13 ve Scrapy 2.19.0 ile, hem doğrudan hem de yerel bir test proxy'si üzerinden çalıştırdık:
- Scraper dört istek gönderdi:
robots.txt(404döndü, yani kural yok) ve üç URL. Sonuçta üç satır yazdı. - Crawler
finish_reason: closespider_pagecountile kapandı ve 60 değil 74 sayfadan sonra 56 tekil kitap topladı. İndiriciye (downloader) verilmiş istekler yine de tamamlandığı için tavan yaklaşık bir sınırdır. - Tekrar filtresi 867 isteği eledi, çünkü her kategori sayfası menüsünde 50 kategorinin hepsine bağlantı veriyor.
DEPTH_LIMIT1 yapıldığında crawler 3.151 derin bağlantıyı yok saydı, yalnız başlangıç sayfasından bağlantı verilen 19 şiir kitabını topladı ve frontier boşalıncafinish_reason: finishedile bitti.- Proxy üzerinden scraper aynı satırları döndürdü. Yanlış parolayla her
407hatası, Scrapy vazgeçmeden önce iki kez yeniden denendi.
Kullanım alanları
- Rakip fiyat takibi: her gün verisi çekilen sabit bir liste ve yeni ürünler için haftalık bir tarama (E-Ticarette Rakip Fiyat Takibi).
- Büyük ölçekte fiyat izleme: her biri kendi hızında okunan çok sayıda mağaza (fiyat izleme).
- SEO site denetimleri: kırık bağlantılar ve yetim sayfalar (hiçbir sayfadan bağlantı almayan sayfalar) saf crawling işidir, çıktı URL'ler ve durum kodlarıdır (SEO proxy).
- Marka koruma: bir pazar yeri taraması yeni ilanları bulur, bir scraper satıcıyı ve fiyatı okur (marka koruma).
- JavaScript ile yüklenen kataloglar: tarama sayfaları bulur, headless (arayüzsüz) tarayıcı yalnız buna ihtiyaç duyan sayfaları oluşturur (Statik ve Dinamik Sayfalar).
Sık yapılan hatalar
- Sabit listeli bir iş için bütün siteyi taramak. Siteye boşuna yük bindirir ve daha çok
Disallowsatırına takılır. - URL normalleştirmeyi atlamak. Sorgu parametrelerinin sırası değişmiş aynı sayfa tekrar tekrar indirilir.
- Callback'li bir kuralda derinlik sınırı olmadan
follow=True. Her ürün sayfası yeni bir başlangıç noktasına dönüşür ve tarama benzer ürün bağlantıları üzerinden yayılır. allowed_domainsayarını unutmak. Bir iş ortağı mağazaya verilen tek bir bağlantı yeter, crawler hedef siteden çıkar.- robots.txt dosyasını her istekte indirmek ya da bir daha hiç indirmemek. Host başına bir kez yeterlidir; uzun çalışmalarda dosyayı 24 saat içinde yenileyin.
- Kayıt anahtarı olmayan satırlar. İki farklı yoldan bulunan tek bir ürün iki kez yazılır.
CrawlSpideriçinde callback'siz kendi isteğinizi üretmek. İstek ayrıştırıcınıza değil, yeniden kurallara gider.
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
| Ürün URL listem sabit, her gün fiyat çekiyorum | Yalnız scraper (scrapy.Spider ya da bir HTTP istemcisi) |
| Rakibin yeni ürünlerini de yakalamak istiyorum | URL ekleyen haftalık bir kategori taraması ve günlük scraper |
| Kırık bağlantıları bulmak için sitemin bütün sayfalarına ihtiyacım var | Saf crawler; çıktı URL'ler ve durum kodlarıdır |
| Scrapy'nin bağlantıları kurallarla izlemesini istiyorum | Rule ve LinkExtractor ile CrawlSpider, her zaman DEPTH_LIMIT ve allowed_domains ile birlikte |
| Site bir sitemap yayımlıyor | Sitemap'ten başlayın; bağlantıları yalnız sitemap'in dışarıda bıraktığı bölümler için izleyin |
| Yarıda kesilen tarama baştan başlamamalı | Kalıcı bir kuyruk: Scrapy'nin JOBDIR ayarı ya da bir SQLite tablosu |
Sıkça sorulan sorular
Web crawling ile web scraping aynı şey mi?
Hayır. Crawling bağlantıları izleyerek sayfa keşfeder ve çıktısı bir URL listesidir. Scraping bilinen sayfalardan alan çıkarır ve çıktısı yapılandırılmış kayıtlardır. İkisini birden yapan bir araç da aslında iki ayrı iş yapar.
Googlebot bir crawler mı, scraper mı?
Crawler. URL'leri bağlantılardan, sitemap'lerden ve önceki ziyaretlerden bulur; her sitenin ne sıklıkla ve ne kadar derin taranacağına bir algoritma karar verir. Bir fiyat scraper'ı gibi alanları satırlara çekmez.
Scrapy'de Spider ile CrawlSpider arasındaki fark nedir?
Spider yalnız kodunuzun istediği bağlantıları izler, bu da sabit bir listeye uyar. CrawlSpider bağlantıları rules üzerinden izler: callback'i olmayan bir kural varsayılan olarak bağlantıları izler, callback'i olan bir kural sayfayı ayrıştırır ve varsayılan olarak izlemez. Kendi ürettiğiniz isteklere callback'i açıkça vermeniz gerekir.
Crawler robots.txt'ye uymak zorunda mı?
RFC 9309'a göre bu kurallar bir erişim yetkilendirmesi biçimi değildir, yani dosya bir kilit değildir. Meşru bir crawler yine de ona uyar, hızını düşük tutar ve dürüst bir User-Agent kullanır. Hukuki sonuçlar ülkeye ve somut olaya göre değişir (Web Scraping Yasal mı?).
Crawling ve scraping için hangi Python kütüphaneleri kullanılır?
Scrapy ikisini de karşılar: crawling için zamanlayıcı (scheduler), tekrar filtresi, robots.txt kontrolü ve hız sınırları, scraping için de seçiciler sunar. Kısa bir liste için Requests ya da HTTPX ile BeautifulSoup ya da lxml çoğu zaman yeterlidir (HTTPX, Requests ve AIOHTTP Karşılaştırması).
Crawling için proxy gerekir mi?
Crawler tek bir host'a çok sayıda istek gönderir ve siteler IP başına istek sayısını sınırlar. Proxy geniş bir taramayı farklı adreslere dağıtır, ama her host yine de makul bir hızla istek almalıdır. Çok sayıda siteye yayılan büyük taramalarda Rotating Proxy her isteğe ya da oturuma farklı bir çıkış IP'si verir.
Özet
Web crawling bağlantıları izleyerek hangi sayfaların var olduğunu bulur, web scraping ise bilinen sayfaları veri satırlarına çevirir. Çoğu projede ikisini bir kuyruk bağlar: tarama kuyruğu doldurur, scraping boşaltır. Taramanız belirli bir ülkeden çıkış IP'sine ihtiyaç duyuyorsa Residential Proxy sayfasına bakın ya da seçenekleri proxy hizmetleri sayfamızda karşılaştırın.