


































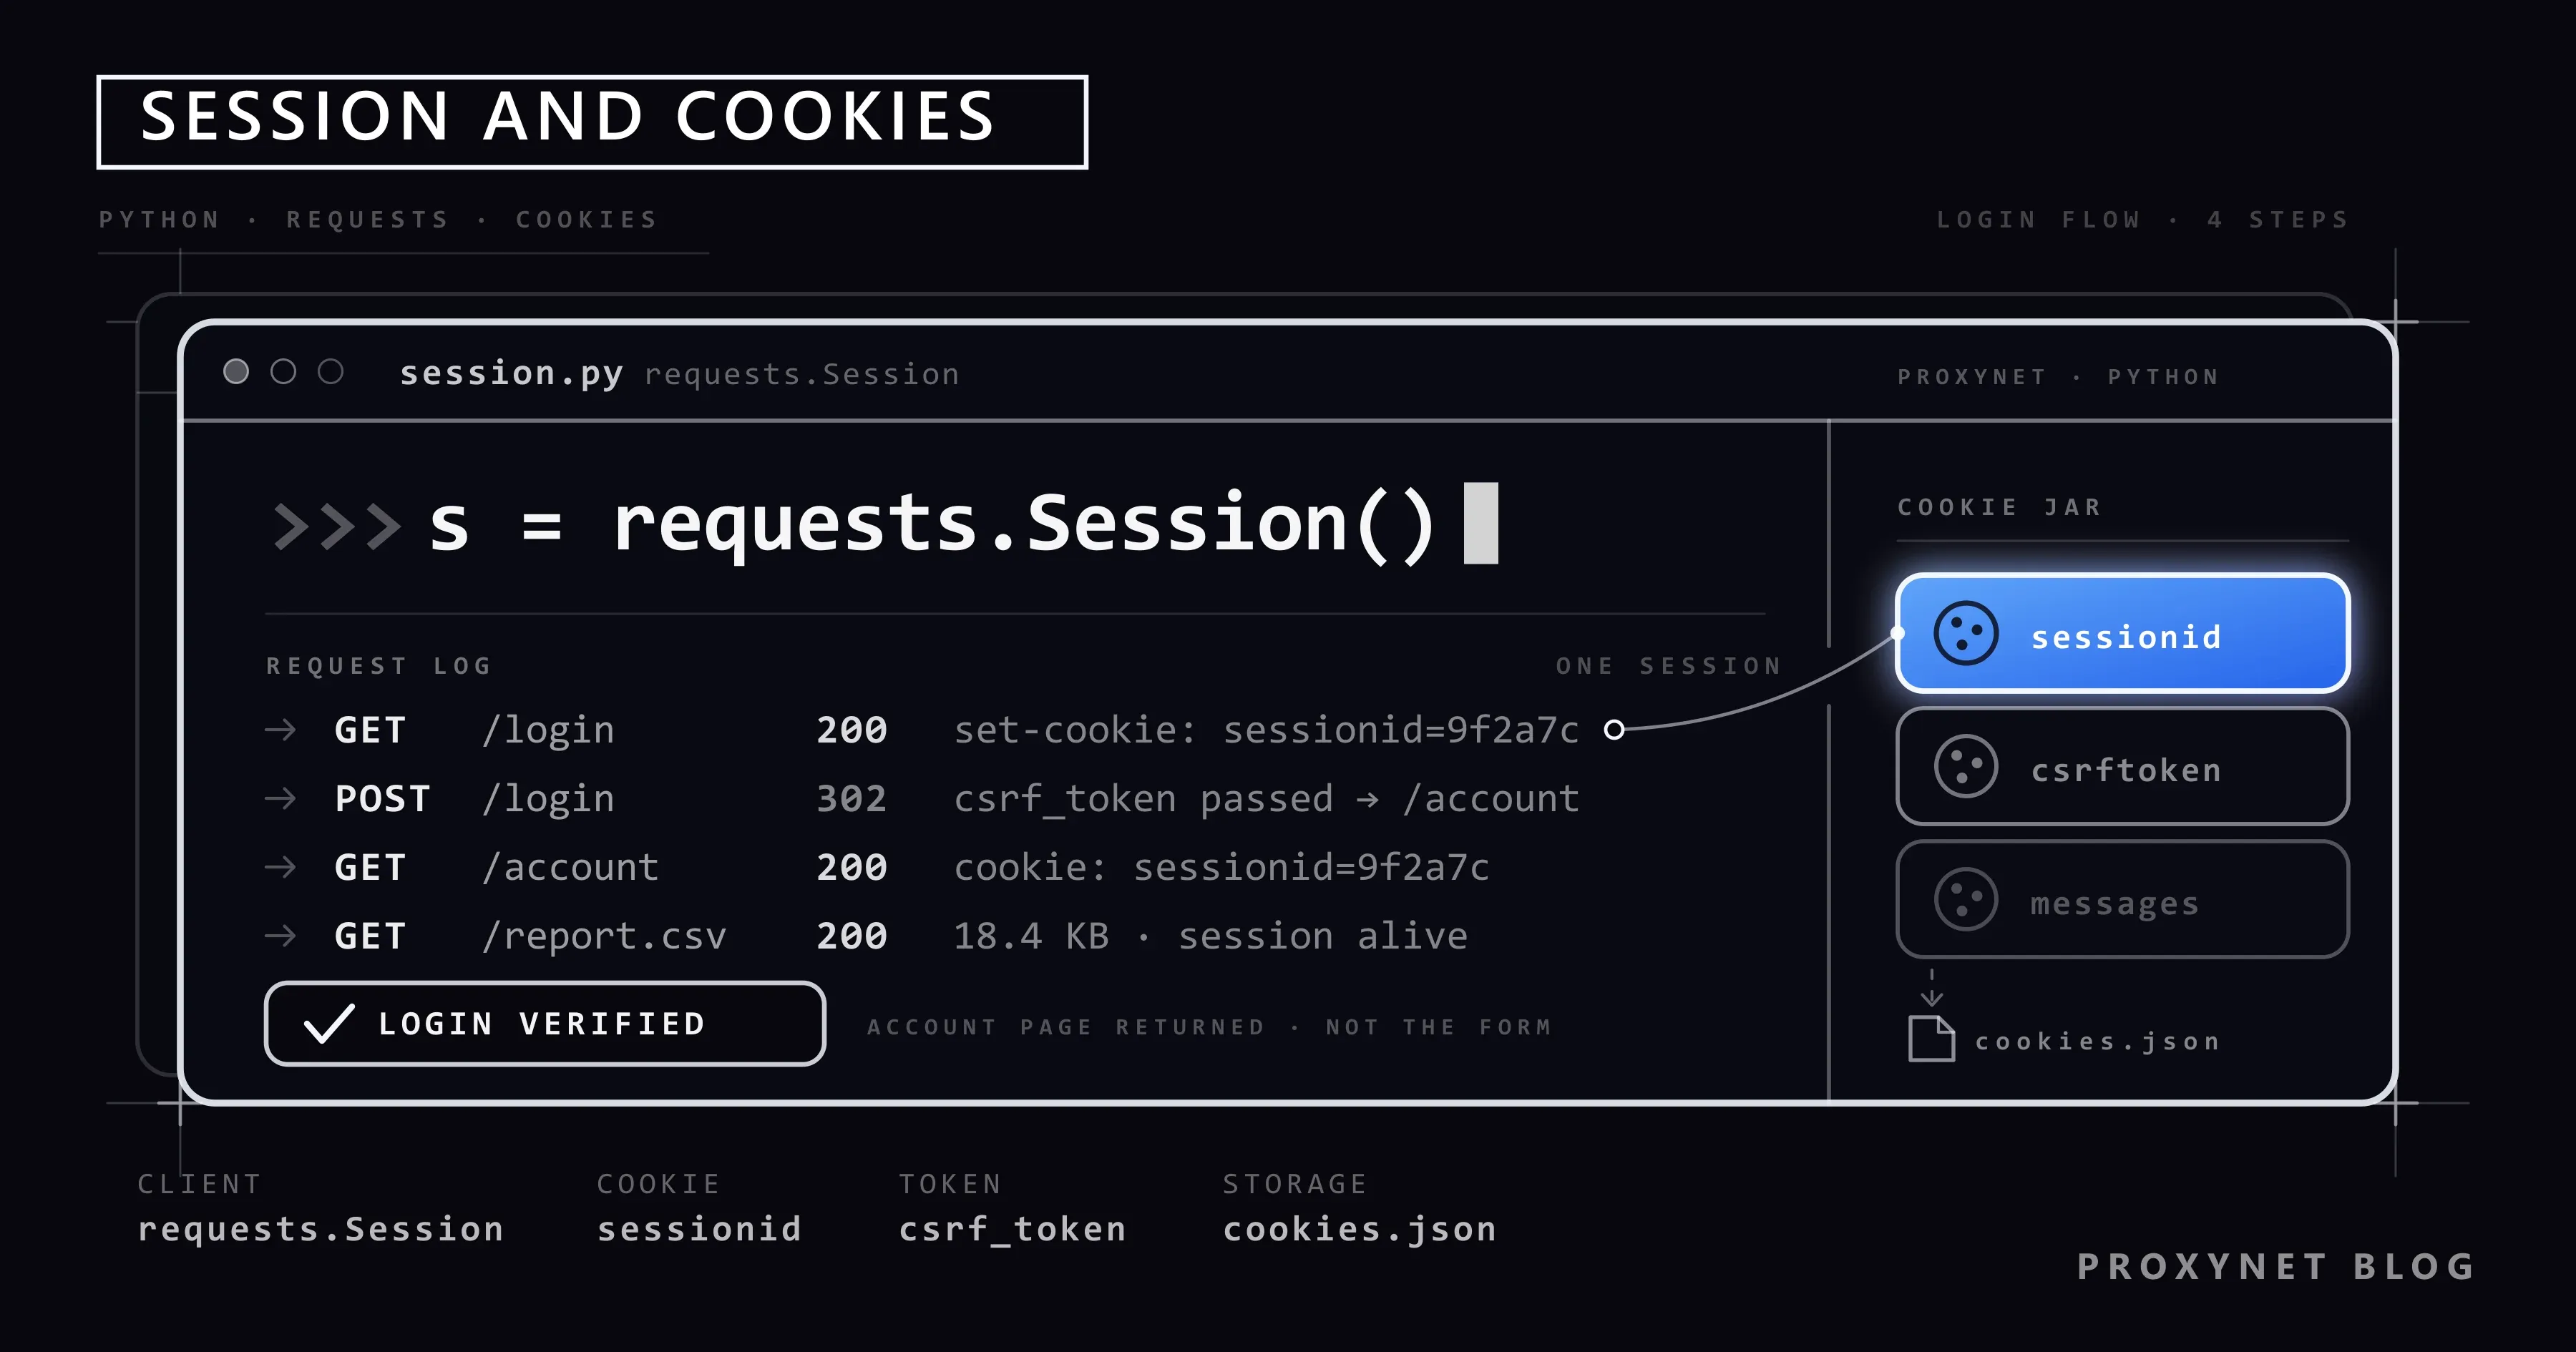
Cada mañana entras a mano en el panel de tu propia empresa y descargas un informe. El panel tiene un botón de exportación, no tiene API oficial y los mismos cinco clics se repiten todos los días. En cuanto intentas delegar eso en un script de Python, el primer muro es la página de acceso: lo que descarga requests.get() no es el informe, es el formulario de acceso. HTTP es un protocolo sin estado y el servidor solo te reconoce por una cookie que añades a cada petición.
En este artículo explicamos qué son las cookies y las sesiones, por qué el token CSRF se lee de nuevo en cada ejecución y cómo se construye un flujo de acceso con requests.Session. Después vemos cómo guardar la sesión en disco, renovarla cuando caduca, sacar las credenciales del código y mantener la misma IP de salida durante toda la sesión. Al final está el método storage_state de Playwright para los sitios que envían el formulario con JavaScript. Los ejemplos de código se probaron contra quotes.toscrape.com.
¿A qué accesos se aplica este artículo?
Todo lo que sigue se apoya en un único supuesto: la cuenta en la que entras es tuya, o su titular te dio permiso por escrito. El panel de administración de tu propia empresa, tu propia cuenta de tienda, un sistema de un cliente que pidió por escrito «descárganos este informe cada día». Lo que quede fuera de eso no es tema de este artículo.
Tres preguntas antes de escribir código:
- ¿Hay una API oficial o una exportación? Si la hay, no automatices la interfaz. Una clave de API es estable y no se rompe cuando cambia la interfaz; automatizar el acceso es el camino al que se recurre cuando no hay otra forma de llegar al dato. El marco legal lo tratamos en ¿El web scraping es legal? Una visión general.
- ¿Qué dicen los términos de uso del sitio? Si una cláusula prohíbe el acceso automatizado, tu cuenta puede quedar suspendida. Que sea técnicamente posible no significa que esté permitido.
- ¿Tienes el permiso por escrito? En trabajos para clientes, el visto bueno verbal no basta. Con qué cuenta, de qué páginas y con qué frecuencia vas a extraer datos debe quedar en un contrato o en un correo.
Hay cuatro cosas que aquí no se explican a propósito:
- Nada de probar contraseñas. El código que va escribiendo una lista en el campo del formulario (credential stuffing) o el que genera combinaciones (fuerza bruta) no aparece aquí. No lo hagas: el acceso no autorizado a una cuenta ajena es un delito en cualquier país, y que sea técnicamente posible no cambia nada.
- Nada de saltarse la verificación en dos pasos ni los CAPTCHA. Esos controles existen para proteger la cuenta; intentar superarlos con un script reduce la seguridad de la propia cuenta con la que trabajas. Si tu cuenta tiene 2FA activo, el camino correcto es la clave de API o la contraseña de aplicación del proveedor; si no existe ninguna, ese trabajo no se va a automatizar.
- Nada de cuentas ajenas. «La cuenta de un amigo», «la cuenta de alguien que dejó la empresa» y las credenciales compartidas en internet entran también aquí.
- Nada de robar ni mover cookies de sesión. Una sesión abierta con una cookie copiada del navegador de otra persona es una suplantación de identidad. Los archivos de cookies de este artículo se generan solo con tu propio acceso y se quedan en tu máquina.
Hace falta una distinción más por el parecido de los nombres: autenticarse ante un servidor proxy (user:pass o autorización por IP) e iniciar sesión en el sitio de destino son dos cosas distintas. Lo primero lo contamos en Autenticación de proxy: user:pass o lista blanca de IP; aquí hablamos de lo segundo.
¿Qué son las cookies y las sesiones?
HTTP no tiene estado: el servidor no recuerda nada que una dos peticiones. Ese hueco lo llenan las cookies. El servidor pone una cabecera Set-Cookie en su respuesta, el cliente guarda el valor y lo devuelve con una cabecera Cookie en las peticiones siguientes al mismo dominio. Todos los atributos de la cabecera están explicados uno a uno en la página Set-Cookie de MDN.
La «sesión» es lo que le da sentido a esa cookie. Hay dos diseños habituales:
- Sesión del lado del servidor. En la cookie viaja solo un identificador aleatorio (
sessionid,PHPSESSID,JSESSIONID); quién es el usuario está en un registro del servidor. Si el servidor borra ese registro, la sesión termina aunque la cookie siga en tu poder. - Cookie firmada. La información del usuario está dentro de la cookie y el servidor la firma con una clave secreta. La cookie
sessionpor defecto de Flask funciona así.
Cuánto vive una cookie lo fijan Expires y Max-Age. La sección 4.1.2.2 del RFC 6265 dice que, si una cookie no tiene ni Max-Age ni Expires, el cliente la conserva hasta que «la sesión actual termine». En un navegador eso significa «hasta que cierres el navegador»; en un script de Python, «mientras viva el proceso». Así que no te extrañe que tu script vuelva a entrar en cada ejecución: la cookie que guardó nunca fue persistente.
A qué peticiones se añade una cookie lo deciden estos atributos de la cabecera Set-Cookie:
| Atributo | Qué hace | Qué significa en un script |
|---|---|---|
Domain | A qué dominio va la cookie | Una cookie de panel.ejemplo.com no se añade a una petición a ejemplo.com |
Path | Bajo qué ruta es válida | Una cookie en /informe no se envía en una petición a / |
Secure | Solo se envía por HTTPS | Una petición que cae a HTTP no lleva la cookie |
HttpOnly | El JavaScript de la página no puede leerla | No la verás con document.cookie en la consola del navegador; un cliente HTTP sí la ve |
SameSite | Si se añade a peticiones que llegan desde otro sitio | Con Strict, la primera petición desde un enlace externo parece sin sesión |
Esta tabla no es teoría, es una lista de diagnóstico: la mayoría de los «el acceso parece correcto pero la siguiente petición vuelve a caer en la página de acceso» salen de una discrepancia de Domain o de Path.
¿Qué es el token CSRF y por qué se lee cada vez?
Mientras tienes la sesión abierta en una página de banca, un formulario oculto en otro sitio puede enviar una petición en tu nombre. Como el navegador añade la cookie automáticamente, el servidor lo toma por una petición tuya. A esto se le llama falsificación de petición en sitios cruzados (CSRF).
La defensa más extendida es el método que la página de prevención de CSRF de OWASP llama «token sincronizador»: el servidor incrusta en cada página con formulario un valor aleatorio ligado a esa sesión, como campo oculto. Al enviar el formulario, ese valor tiene que coincidir con su pareja en la cookie de sesión. Un formulario de otro sitio no puede conocer el token de tu sesión, así que la comprobación falla.
Para quien escribe el script esto tiene tres consecuencias:
- El token no es fijo. Si lo copias una vez del navegador y lo dejas escrito en el código, al día siguiente no funciona. En cada ejecución tienes que descargar la página de acceso y leer el campo de ahí.
- El token va ligado a la sesión. Enviar el token en una petición y el formulario por otra conexión no sirve de nada. Los dos tienen que pasar por el mismo objeto
Session; esa es precisamente la primera razón para usar unaSession. - El nombre del campo cambia según el sitio.
csrf_token,csrfmiddlewaretoken(Django),authenticity_token(Rails) y_token(Laravel) hacen el mismo trabajo. Mira el código fuente del formulario antes de escribir código.
En las aplicaciones que esperan el token en una cabecera (X-CSRF-Token) en vez de en un campo oculto, el valor se sigue leyendo de la página, pero lo pones en el diccionario headers y no en el cuerpo.
¿Qué camino elegir?
Para un trabajo detrás de un acceso hay tres caminos, y el formulario del sitio decide cuál te toca.
| Camino | Cuándo | Coste | Punto débil |
|---|---|---|---|
requests.Session | El formulario es HTML plano y los campos se ven en la página | El más bajo, sin navegador | No ve los campos generados con JavaScript |
storage_state de Playwright | El formulario se envía con JavaScript o el token lo genera un script | Alto, se abre un navegador real | Memoria y tiempo, carga de instalación |
| Híbrido: entrar con el navegador y seguir por HTTP | El acceso es complejo pero las páginas de datos son HTML plano | Un navegador una vez, luego barato | Las cookies pasan entre dos entornos, la IP tiene que ser la misma |
Haz la elección mirando el código fuente de la página, no adivinando: si dentro de un <form method="post"> ves campos input con name, requests basta. Si los campos están vacíos o el formulario se envía con fetch(), pasa al segundo o al tercer camino.
¿Cómo se inicia sesión con requests.Session?
Son cinco pasos y el orden importa: los cuatro primeros son el acceso en sí, el quinto es para las ejecuciones siguientes.
- Descarga la página de acceso con
GET. Esa respuesta trae dos cosas: una cookie de sesión todavía anónima y el token CSRF del formulario. LaSessionguarda la cookie en su propio almacén. - Lee de verdad los campos del formulario. Rellena el formulario en el navegador, envíalo y mira el cuerpo de la petición en la pestaña Red de las herramientas de desarrollo. Los nombres de los campos no se adivinan, se copian de ahí; si hay un campo oculto
nextoredirect, envíalo también. - Manda el
POSTcon la mismaSession. La cookie se añade sola. Si el atributoactiondel formulario apunta a otra ruta, envía la petición allí. - Verifica el acceso por el contenido. El código de estado engaña: muchas aplicaciones devuelven
200también con una contraseña incorrecta y vuelven a pintar el formulario con un mensaje de error. El criterio es un elemento que solo aparece con la sesión abierta: un enlace de salida, el nombre de usuario, un menú de cuenta. - Guarda las cookies. La siguiente ejecución se salta el paso del acceso.
Según la sección Session Objects de la documentación de Requests, además de conservar las cookies durante la vida de la instancia, una Session reutiliza también la conexión TCP para las peticiones que van al mismo host. El patrón es el mismo en las tres bibliotecas de HTTPX, Requests y AIOHTTP: comparativa, solo cambia el nombre de la clase.
Un ejemplo que funciona: quotes.toscrape.com
El código de abajo se probó contra quotes.toscrape.com/login. Es un sitio de formación abierto, montado para practicar scraping, y acepta cualquier nombre de usuario y cualquier contraseña que escribas; no comprueba ninguna identidad, solo imita el flujo. Ver el mecanismo ahí primero te evita generar una tanda de accesos fallidos en tu propia cuenta.
Primero el flujo básico, cuatro pasos:
import os

import requests
from bs4 import BeautifulSoup

BASE_URL = "https://quotes.toscrape.com"

session = requests.Session()

# 1) Pide el formulario de acceso: la cookie de sesión y el token CSRF llegan con esta respuesta
page = session.get(f"{BASE_URL}/login", timeout=20)
page.raise_for_status()
token = BeautifulSoup(page.text, "html.parser").select_one('input[name="csrf_token"]')["value"]

# 2) Las credenciales no van en el código, se leen de variables de entorno
payload = {
    "csrf_token": token,
    "username": os.environ["SITE_USERNAME"],
    "password": os.environ["SITE_PASSWORD"],
}

# 3) Envia el formulario con la misma Session; la cookie la añade la propia Session
result = session.post(f"{BASE_URL}/login", data=payload, timeout=20)
result.raise_for_status()

# 4) Verifica por el contenido de la página, no por el código de estado
if BeautifulSoup(result.text, "html.parser").select_one('a[href="/logout"]') is None:
    raise SystemExit("No se pudo verificar el acceso")

print("Acceso correcto, cookies:", list(session.cookies.keys()))
Pon las credenciales en el entorno antes de ejecutar; escribir la contraseña en el código es escribirla también en el historial de versiones:
export SITE_USERNAME="usuario"
export SITE_PASSWORD="contrasena"
python login.py
En Windows PowerShell la forma es $env:SITE_USERNAME = "usuario". Cómo dejar fijas las variables de entorno para las herramientas de línea de comandos lo contamos en Proxy con wget: comandos y ejemplos.
¿Cómo se guarda la sesión en disco y cuándo se renueva?
Entrar de nuevo en cada ejecución llena de registros innecesarios el historial de seguridad de tu cuenta; en algunas aplicaciones, además, varios accesos seguidos en poco tiempo disparan una verificación extra. La solución es escribir el almacén de cookies en un archivo y volver a cargarlo en la ejecución siguiente.
El script completo de abajo hace eso: carga las cookies guardadas si las hay, entra si no las hay, comprueba en cada petición que la sesión sigue abierta y, si se ha caído, vuelve a entrar una sola vez. Que sea una sola vez importa: un bucle sin condición se convierte en intentos de acceso infinitos cuando el problema está en las credenciales.
import json
import os
import time
from pathlib import Path

import requests
from bs4 import BeautifulSoup

BASE_URL = "https://quotes.toscrape.com"
COOKIE_FILE = Path("session_cookies.json")
DELAY_SECONDS = 2.0


class LoginError(Exception):
    """El acceso no se completó; mira la causa en vez de reintentar."""


def build_session():
    session = requests.Session()
    session.headers["User-Agent"] = "script-informe/1.0 (contacto: tu@ejemplo.com)"
    proxy_url = os.environ.get("PROXY_URL")  # p. ej. http://user:pass@pr.proxynet.io:8000
    if proxy_url:
        session.proxies = {"http": proxy_url, "https": proxy_url}
    return session


def save_cookies(session, path=COOKIE_FILE):
    cookies = [
        {"name": c.name, "value": c.value, "domain": c.domain, "path": c.path,
         "expires": c.expires, "secure": c.secure}
        for c in session.cookies
    ]
    path.write_text(json.dumps(cookies), encoding="utf-8")
    try:
        path.chmod(0o600)  # el archivo es tan sensible como una contrasena; en Windows el efecto es limitado
    except OSError:
        pass


def load_cookies(session, path=COOKIE_FILE):
    if not path.exists():
        return False
    try:
        cookies = json.loads(path.read_text(encoding="utf-8"))
    except json.JSONDecodeError:
        return False
    now = time.time()
    for c in cookies:
        if c["expires"] and c["expires"] < now:
            continue  # no cargues nunca una cookie caducada
        session.cookies.set(c["name"], c["value"], domain=c["domain"], path=c["path"],
                            expires=c["expires"], secure=c["secure"])
    return True


def is_logged_in(html):
    return BeautifulSoup(html, "html.parser").select_one('a[href="/logout"]') is not None


def login(session):
    page = session.get(f"{BASE_URL}/login", timeout=20)
    page.raise_for_status()
    field = BeautifulSoup(page.text, "html.parser").select_one('input[name="csrf_token"]')
    if field is None:
        raise LoginError("No hay campo csrf_token en el formulario; la pagina puede haber cambiado")
    payload = {
        "csrf_token": field["value"],
        "username": os.environ["SITE_USERNAME"],
        "password": os.environ["SITE_PASSWORD"],
    }
    result = session.post(f"{BASE_URL}/login", data=payload, timeout=20)
    result.raise_for_status()
    if not is_logged_in(result.text):
        raise LoginError("Acceso no verificado; revisa las credenciales y los campos del formulario")
    save_cookies(session)


def get_page(session, path):
    """Trae la pagina; si la sesion se cayo, vuelve a entrar una sola vez."""
    for attempt in range(2):
        response = session.get(f"{BASE_URL}{path}", timeout=20)
        response.raise_for_status()
        if is_logged_in(response.text):
            return response
        if attempt == 0:
            print("Sesion no valida, entrando de nuevo")
            session.cookies.clear()
            login(session)
    raise LoginError("Sigue sin haber sesion tras el segundo intento; para y mira la causa")


def main():
    session = build_session()
    if load_cookies(session):
        print("Cookies guardadas cargadas")
    else:
        print("No hay sesion guardada, entrando")
        login(session)

    for number in range(1, 4):
        response = get_page(session, f"/page/{number}/")
        quotes = BeautifulSoup(response.text, "html.parser").select("div.quote")
        print(f"Pagina {number}: {len(quotes)} registros")
        time.sleep(DELAY_SECONDS)


if __name__ == "__main__":
    main()
La primera ejecución dice «No hay sesión guardada» y entra; la segunda dice «Cookies guardadas cargadas» y pasa directa a los datos. Tres puntos a vigilar:
- El archivo de cookies es un secreto. El valor que hay dentro sustituye a la contraseña durante esa sesión. Añade el archivo a
.gitignorey déjalo fuera de las copias de seguridad y de las carpetas compartidas; la documentación de Playwright da el mismo aviso para su archivo de estado. - No cargues una cookie caducada.
load_cookieslas descarta mirando el campoexpires; sin eso, el script arranca con una sesión inválida. - Detecta por el contenido que la sesión se ha caído. Unas aplicaciones redirigen a la página de acceso con un
302, otras devuelven el formulario con un200. Un único criterio comois_logged_inatrapa los dos casos.
¿Por qué hace falta la misma IP durante toda la sesión?
Una parte de las aplicaciones ata la sesión abierta a la dirección IP desde la que se hizo el acceso, o a la red de esa dirección. Si la petición siguiente llega desde otra dirección, la sesión se cierra, al usuario se le lleva a la página de acceso o se le pide una verificación extra. Es una decisión de seguridad y su objetivo es dificultar que una cookie de sesión robada se use en otro sitio.
En un script que usa proxy, esto significa una cosa: un pool rotativo rompe la sesión en los trabajos que requieren acceso. Un proxy rotativo cambia la IP de salida en cada petición o cada poco tiempo; la dirección desde la que entraste y la dirección desde la que descargas el informe acaban siendo distintas y la aplicación no te reconoce. Cómo funciona la rotación y para qué trabajos es la opción correcta lo contamos en Qué es la rotación de IP y cómo funciona.
El montaje correcto es una de estas dos opciones:
- Con Proxies de sesión fija te quedas en la misma IP de salida durante el tiempo que fijes, entre 1 y 60 minutos. Si la sesión es corta y sueltas la conexión al terminar el trabajo, con esto basta.
- Con Proxies ISP la dirección se mantiene igual también de una ejecución a otra. En los sistemas que limitan el acceso al panel a IP concretas es el único camino, porque comunicas la dirección una vez a la otra parte y haces que la añadan a su lista.
El caso de hacer que añadan una dirección a la lista de permitidas de una API está en IP estática para API: cómo resolver el error de autorización, y el motivo general para una IP fija, en la sección «IP sticky donde hace falta sesión» de Cómo hacer web scraping sin que te bloqueen.
Salgamos al paso de una mala lectura: una IP fija no es una herramienta para saltarse un control de seguridad. Lo que hace es mantener coherente tu propio tráfico en una cuenta para la que ya tienes autorización. Si la cuenta no es tuya, una IP fija tampoco produce un acceso legítimo.
Límite de peticiones: mantener el script educado
Un script con sesión iniciada es más visible que uno anónimo: tus peticiones ya no se anotan contra una dirección IP, sino directamente contra tu cuenta. Respetar el límite de peticiones aquí no es una preferencia técnica, es parte de proteger tu cuenta.
- Empieza con un solo hilo. Para un informe al día no montes paralelismo.
- Pon una espera entre peticiones.
DELAY_SECONDSen el script de arriba es la forma más simple de hacerlo. - Para cuando veas un
429. La cabeceraRetry-Afterde la respuesta te dice cuánto esperar. El código completo está en 429 Too Many Requests: qué es el error de rate limit y en Códigos de estado HTTP en web scraping: 403, 407, 429, 503. - Preséntate. Escribir el nombre del script y una dirección de contacto en el campo
User-Agentpermite que quien administra el sitio hable contigo; para qué sirve el campo está en ¿Qué es el User-Agent? Cómo verlo y cambiarlo.
Si el acceso va con JavaScript: storage_state de Playwright
En algunas aplicaciones el formulario de acceso no envía un POST clásico: JavaScript lee los campos, el navegador genera el token y la respuesta llega por una llamada a una API. En una página así, el formulario enviado con requests falla en silencio. Ahí es donde hace falta ejecutar un navegador de verdad.
Playwright puede escribir el estado de la sesión en un único archivo JSON. Según la documentación de autenticación de Playwright, ese archivo lleva juntas las cookies y el localStorage, así que también sirve en aplicaciones que guardan la sesión en localStorage en vez de en una cookie. Si la aplicación guarda el token en IndexedDB, tienes que pedirlo aparte: context.storage_state(path=..., indexed_db=True).
import os
from pathlib import Path

from playwright.sync_api import sync_playwright

BASE_URL = "https://quotes.toscrape.com"
STATE_FILE = Path("storage_state.json")
PROXY = {"server": "http://pr.proxynet.io:8000", "username": "user", "password": "pass"}

with sync_playwright() as p:
    browser = p.chromium.launch(proxy=PROXY)
    if STATE_FILE.exists():
        context = browser.new_context(storage_state=STATE_FILE)  # abrir con la sesion guardada
    else:
        context = browser.new_context()
    page = context.new_page()
    page.goto(BASE_URL)

    if page.locator('a[href="/logout"]').count() == 0:
        page.goto(f"{BASE_URL}/login")
        page.fill("#username", os.environ["SITE_USERNAME"])
        page.fill("#password", os.environ["SITE_PASSWORD"])
        page.click('input[type="submit"]')
        page.wait_for_selector('a[href="/logout"]')  # prueba del acceso
        context.storage_state(path=STATE_FILE)  # cookies y localStorage en un solo archivo
        print("Acceso hecho, estado guardado")
    else:
        print("Sesion abierta con el estado guardado")

    browser.close()
La primera ejecución entra y escribe el archivo; la segunda ni siquiera ve el paso del acceso. La configuración de proxy de Playwright y la instalación del navegador las contamos en detalle en Qué es Playwright y cómo usarlo con un proxy; para el equivalente en Selenium, mira Selenium con proxy: configuración en Python y Java.
De aquí sale el patrón híbrido: entras una vez con el navegador y generas storage_state.json, luego pasas las cookies a una requests.Session y traes los datos por la vía barata.
import json
from pathlib import Path

import requests

state = json.loads(Path("storage_state.json").read_text(encoding="utf-8"))
session = requests.Session()
for c in state["cookies"]:
    session.cookies.set(c["name"], c["value"], domain=c["domain"], path=c["path"])
Este patrón tiene una única condición: tanto el navegador como el cliente HTTP que viene detrás tienen que salir por la misma IP. Si les das proxies distintos, la sesión se cae en la primera petición. Qué automatización de navegador encaja con cada trabajo lo comparamos en Playwright o Selenium: cuál elegir.
Casos de uso
- Descargar el informe diario de tu propio panel. La dirección que hay detrás del botón de exportación suele ser un enlace directo a un archivo; mientras la cookie de sesión aguante,
requestslo descarga. El montaje general está en nuestra página de extracción de datos. - Vigilar un flujo que está detrás del acceso. Para revisar los pasos de acceso y de carrito de tu propia aplicación después de cada despliegue; el montaje está en nuestra página de pruebas de aplicaciones.
- Transferir datos desde el sistema de un cliente. Con permiso por escrito y una IP de salida fija, para que la otra parte pueda añadir esa dirección a su propia lista.
- Recoger datos de una lista de varias páginas. Después del acceso es un trabajo de paginación corriente; el patrón lo contamos en Qué es la paginación y cómo se recorre en scraping.
Errores habituales y diagnóstico
- Redirección infinita a la página de acceso. Si la petición vuelve a
/logincon un302, la cookie o no se está enviando o es inválida en el servidor. Mira primero el contenido desession.cookiesy compara luego elDomainde la cookie con la dirección que estás llamando. - Usar
requests.geten vez de unaSession. Elrequests.get()a nivel de módulo abre una conexión nueva y un almacén de cookies vacío en cada llamada. En un flujo de acceso no funciona. - Verificar el acceso por el código de estado. Con una contraseña incorrecta también puede llegar un
200. Busca una prueba en el contenido. - Dejar el token CSRF escrito en el código. Funciona un día y al siguiente da un error de «token inválido».
- Cambiar de IP en mitad de la sesión. Entrar con un pool rotativo y luego extraer datos es la causa más frecuente de que se caiga la sesión.
- Entrar en bucle tras un acceso fallido. Si la contraseña es incorrecta, reintentar no lo arregla; en algunos sistemas bloquea la cuenta. El script debe parar en el primer fallo.
Guía de decisión
| Situación | Qué hacer |
|---|---|
| El sitio tiene API oficial | No te metas en automatizar el acceso, usa una clave de API |
| Formulario HTML plano, campos en la página | Entra con requests.Session y guarda las cookies en un archivo |
El formulario tiene un campo oculto tipo csrf_token | Léelo de la página en cada ejecución, no lo dejes en el código |
| El formulario se envía con JavaScript | Entra con Playwright y conserva el archivo storage_state |
| El acceso es complejo y las páginas de datos, simples | Híbrido: entra con el navegador y pasa las cookies a requests |
| La sesión se cierra a mitad del trabajo | Fija la IP de salida: Proxies de sesión fija |
| El panel solo está abierto a ciertas IP | Dirección fija con Proxies ISP |
| La cuenta tiene verificación en dos pasos | Pide una clave de API o una contraseña de aplicación, no intentes superar el control |
| La cuenta no es tuya | Para; consigue el permiso por escrito del titular |
Preguntas frecuentes
¿Cuál es la diferencia entre sesión y cookie?
Una cookie es un trozo pequeño de datos que el servidor guarda en tu navegador o en tu cliente y que se devuelve en cada petición. La sesión es el estado al que apunta esa cookie: quién eres, desde cuándo has entrado, qué permisos tienes. En Python, requests.Session es el objeto que une las dos cosas; guarda las cookies y las lleva entre peticiones.
He entrado, pero la siguiente petición vuelve a caer en la página de acceso, ¿por qué?
Hay tres causas habituales. La primera: mandaste la petición de acceso fuera de la Session y la cookie se perdió. La segunda: el Domain o el Path de la cookie no coincide con la dirección que llamas. La tercera: la aplicación ató la sesión a una IP y, por un proxy rotativo, la segunda petición salió de otra dirección.
¿Puedo pedir el token CSRF una vez y guardarlo?
No. El token va ligado a la sesión y cambia cuando la sesión se renueva. En cada ejecución tienes que descargar la página de acceso y leer el campo de ahí. Lo que se guarda no es el token, es la cookie de sesión que llega después del acceso.
¿Es delito extraer datos de un sitio protegido con contraseña?
Lo que decide no es que el sitio pida contraseña, sino si tienes autorización para acceder a esa cuenta. Sacar tus propios datos de tu propia cuenta es un uso corriente; entrar con las credenciales de otra persona es acceso no autorizado y es delito en cualquier país. Si los términos de uso prohíben el acceso automatizado, incumples el contrato incluso en tu propia cuenta. El detalle está en ¿El web scraping es legal? Una visión general.
¿Cuánto tiempo vale una cookie de sesión?
Depende de la aplicación. Una cookie sin Max-Age ni Expires termina cuando se cierra el cliente. Las que llevan duración pueden vivir de unas horas a unas semanas, pero cuando el servidor borra su propio registro, la sesión termina aunque la cookie siga en tu poder. Por eso en un script se comprueba «¿sigue abierta la sesión?» y no «¿ha caducado?».
¿Puedo cambiar de proxy después de entrar?
Mejor no. Si la IP que abrió la sesión y la IP desde la que salen las peticiones siguientes son distintas, la aplicación puede cerrar la sesión o pedir una verificación extra. Si en el mismo trabajo usas navegador y cliente HTTP, dales el mismo proxy a los dos.
En resumen
El núcleo técnico de un trabajo detrás de un acceso es pequeño: requests.Session lleva las cookies, el token CSRF leído de la página de acceso se añade al formulario, el resultado se verifica por el contenido de la página y no por el código de estado, y la sesión se guarda en un archivo y pasa a la ejecución siguiente. En los sitios que envían el formulario con JavaScript, el archivo storage_state de Playwright hace ese mismo trabajo. Para que la sesión no se caiga, la IP de salida no debe cambiar mientras dure; para eso están Proxies de sesión fija o una dirección fija. La condición previa no cambia: la cuenta tiene que ser tuya o hay que tener el permiso por escrito de su titular, y si existe una API oficial, se prueba primero. Los tipos de proxy que encajan los tienes en nuestros servicios de proxy.


