Ein Kollege bittet Sie, eine Statistiktabelle von einer Webseite nach Python zu holen. Das HTML haben Sie mit Requests heruntergeladen, und soup.find("td").text hat Ihnen die erste Zelle geliefert. Jetzt brauchen Sie jede Zeile, die Klasse, die manche Zellen grün und andere rot färbt, und die Seitenlinks unter der Tabelle. Der Selektor table > tbody > tr, den Sie aus den Entwicklertools des Browsers kopiert haben, liefert nichts. Den allgemeinen Weg von einer Seite zu einer Datei beschreibt Daten von Websites extrahieren; dieser Leitfaden behandelt die Bibliothek, die das HTML liest.
Wir behandeln die drei Parser, find, find_all und select, die Auswahl nach Klasse, die Bewegung im Baum, das Auslesen von Text und Links, ein vollständiges Beispiel an einer Übungstabelle sowie pandas.read_html mit seinen häufigen Fehlern. Jedes Beispiel lief am 24. September 2026 mit beautifulsoup4 4.15.0 und Python 3.13.
Was ist BeautifulSoup?
BeautifulSoup ist eine Python-Bibliothek, die HTML und XML in einen Baum aus Objekten parst, den Sie durchsuchen können, auch bei fehlerhaftem Markup. Anfragen sendet sie keine. Ein HTTP-Client wie Requests oder HTTPX lädt die Seite herunter (HTTPX, Requests und AIOHTTP im Vergleich), und BeautifulSoup arbeitet mit dem, was dieser Client zurückgibt.
Paketname und Importname unterscheiden sich. Sie installieren beautifulsoup4 und importieren bs4:
pip install beautifulsoup4 lxmlDas Paket bs4 auf PyPI ist ein Platzhalter (Version 0.0.2), der den Namen belegt und nur beautifulsoup4 nachinstalliert. Anleitungen, die mit from BeautifulSoup import BeautifulSoup beginnen, wurden für BeautifulSoup 3 und Python 2 geschrieben und laufen unter Python 3 nicht. Die aktuelle Version ist 4.15.0 (beautifulsoup4 auf PyPI), die in der offiziellen Dokumentation beschrieben ist. Wie sich die Bibliothek zu Scrapy und Selenium verhält, steht in Scrapy, BeautifulSoup oder Selenium?.
Wie verwandelt BeautifulSoup eine Seite in einen Baum?
Zwischen dem Download und Ihrer ersten Suche liegen fünf Schritte:
- Der Client lädt Bytes herunter. Requests speichert sie in
response.contentund bietet inresponse.texteine dekodierte Vermutung an. - BeautifulSoup ermittelt die Kodierung. Eine Unterbibliothek namens Unicode, Dammit liest
<meta charset>und andere Hinweise und wandelt die Bytes dann in Unicode um. Übergeben Sieresponse.content, nichtresponse.text: Sendet ein Servertext/htmlohne Charset, nimmt Requests ISO-8859-1 an, und auséwirdé. Einzelheiten stehen in Unicode-Kodierungsfehler in Python. - Der Parser liest die Tags. Er verwandelt den Text in Elemente und repariert nicht geschlossene Tags nach seinen eigenen Regeln.
- Das Ergebnis ist ein Baum. Jedes Element wird zu einem
Tagmit Namen und Attributen, jedes Textstück zu einemNavigableString. - Suchmethoden durchlaufen den Baum.
find,find_allundselectlesen diesen Baum im Arbeitsspeicher und greifen nie auf das Netzwerk zu.
Welchen Parser sollten Sie wählen: html.parser, lxml oder html5lib?
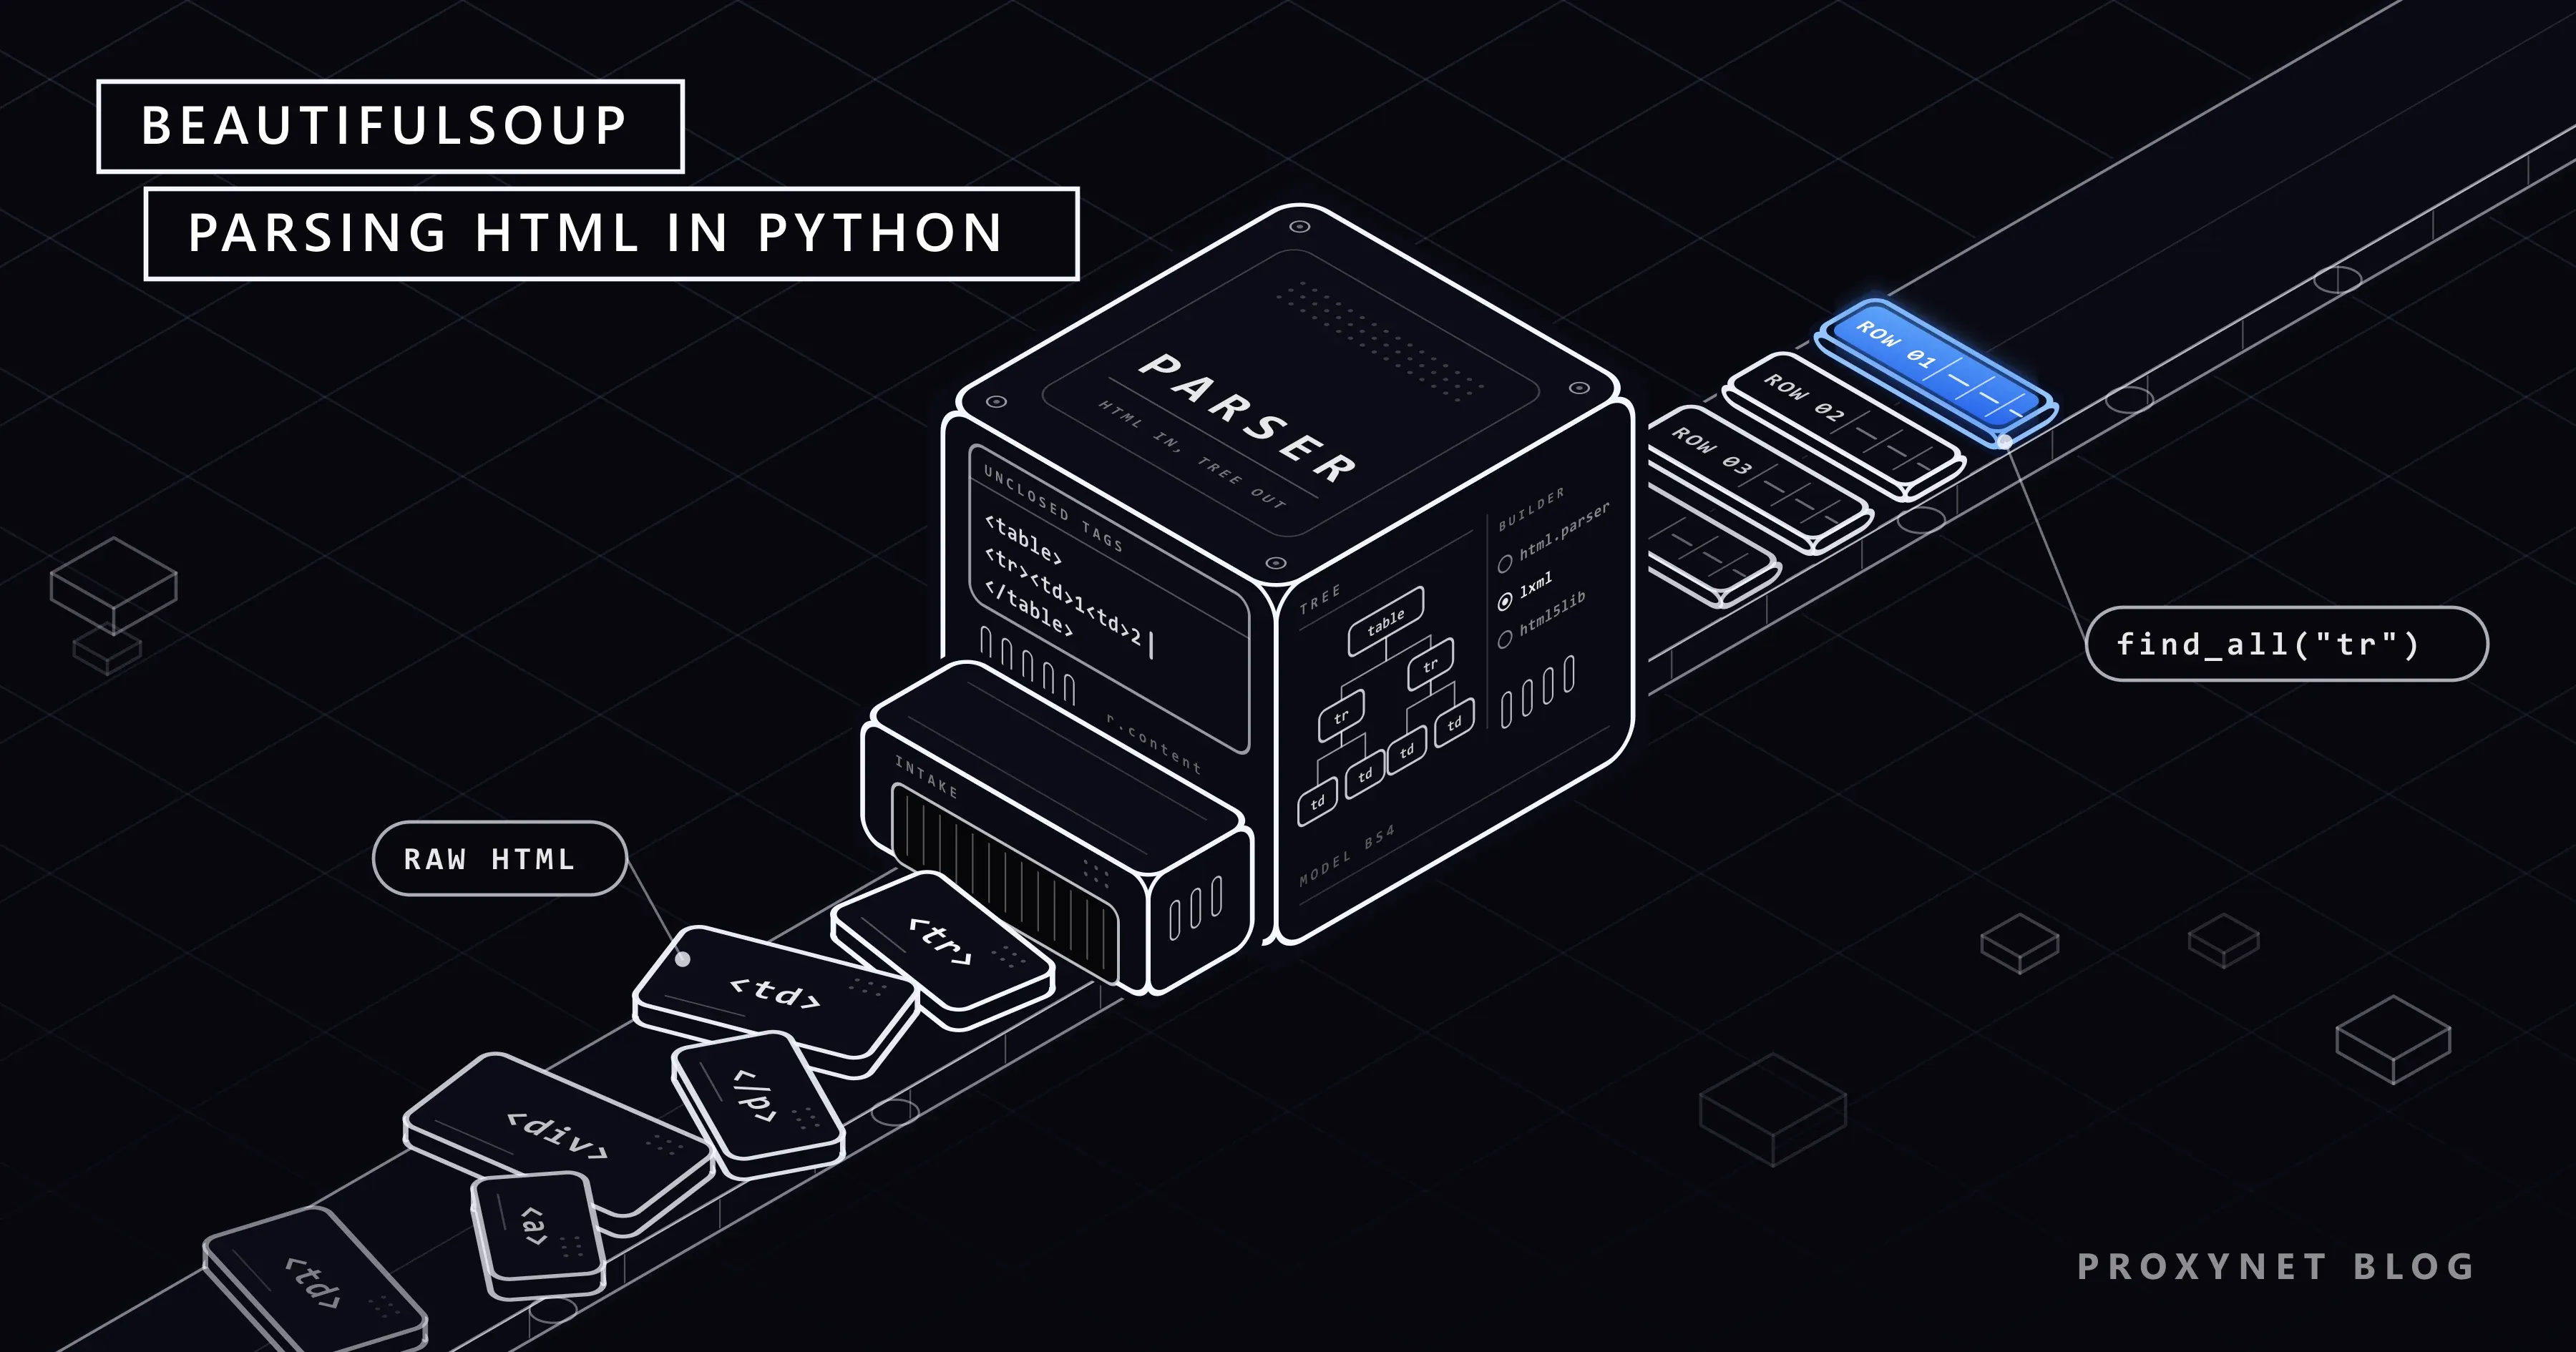
Jeder Parser repariert fehlerhaftes Markup auf seine eigene Weise. Wir haben allen dreien dasselbe Fragment mit nicht geschlossenen Zellen gegeben:
from bs4 import BeautifulSoup

broken = "<table><tr><td>1<td>2</table>"
for parser in ("html.parser", "lxml", "html5lib"):
print(parser, BeautifulSoup(broken, parser))html.parser <table><tr><td>1<td>2</td></td></tr></table>
lxml <html><body><table><tr><td>1</td><td>2</td></tr></table></body></html>
html5lib <html><head></head><body><table><tbody><tr><td>1</td><td>2</td></tr></tbody></table></body></html>html.parser hat die zweite Zelle in die erste gesetzt, deshalb findet row.find_all("td", recursive=False) eine Zelle statt zwei. lxml hat beide Zellen geschlossen und das Fragment in <html><body> eingebettet. html5lib hat den Baum gebaut, den auch ein Browser bauen würde, <tbody> eingeschlossen.
| Parser | Aufruf | Installation | Nicht geschlossene Tags | Wann wählen |
|---|---|---|---|---|
| html.parser | BeautifulSoup(html, "html.parser") | Bei Python dabei | Kann eine Zelle in eine andere verschachteln | Kleine Skripte, wenn Sie keine Pakete installieren können |
| lxml | BeautifulSoup(html, "lxml") | pip install lxml (C-Erweiterung) | Schließt die Zellen, ergänzt <html><body> | Die meisten Scraping-Aufgaben; die Dokumentation nennt ihn sehr schnell |
| html5lib | BeautifulSoup(html, "html5lib") | pip install html5lib (reines Python) | Baut den Baum des Browsers, ergänzt <tbody> | Stark fehlerhafte Seiten oder wenn Sie den Baum brauchen, den der Browser zeigt; sehr langsam |
Ein nicht installierter Parser löst bs4.FeatureNotFound: Couldn't find a tree builder with the features you requested: html5lib aus. Ist kein Parser angegeben, wählt BeautifulSoup nach einer festen Rangfolge einen der installierten Parser und gibt eine GuessedAtParserWarning aus. Dasselbe Skript kann so auf einem Rechner ohne lxml einen anderen Baum bauen.
Was ist der Unterschied zwischen find, find_all und select?
Vier Methoden decken fast jede Suche ab:
find(name, attrs)liefert das erste passende Tag oderNone.find_all(name, attrs)liefert eine Liste aller Treffer oder eine leere Liste.select(css)nimmt einen CSS-Selektor entgegen und liefert eine Liste.select_one(css)liefert den ersten Treffer eines CSS-Selektors oderNone.
Die CSS-Methoden laufen über Soup Sieve, das zusammen mit beautifulsoup4 installiert wird. Wenn nichts passt:
soup.find("td", class_="rank")        # None
soup.find_all("td", class_="rank")    # []
soup.select_one("td.rank")            # None
soup.select("td.rank")                # []

soup.find("td", class_="rank").get_text()
# AttributeError: 'NoneType' object has no attribute 'get_text'
Das ist ein häufiger erster Fehler: find hat None geliefert, und der nächste Aufruf ist gescheitert. Prüfen Sie, bevor Sie verketten:
cell = soup.find("td", class_="name")
name = cell.get_text(strip=True) if cell else None
limit=3 beendet find_all nach drei Treffern, und recursive=False durchsucht nur direkte Kinder. select ist kürzer, wenn der Pfad über mehrere Ebenen führt, etwa table.table tr.team td.name. Die Selektorsyntax und warum BeautifulSoup kein XPath kennt, erklärt CSS-Selektor oder XPath.
Wie wählen Sie nach Klasse, ID und Attribut aus?
class ist in Python ein reserviertes Wort, deshalb verwendet BeautifulSoup class_. Die Falle: class enthält mehrere Werte, und td["class"] liefert eine Liste wie ['pct', 'text-success']. Auf der Übungsseite, die wir weiter unten verwenden, tragen die Zellen von Win % die Klasse pct und die Zellen von + / - die Klasse diff, jeweils zusammen mit text-success oder text-danger. Auf einer Seite mit 25 Zeilen haben wir gezählt:
soup.find_all("td", class_="text-danger")       # 31 Zellen, aus beiden Spalten
soup.find_all("td", class_="pct text-danger")   # 19 Zellen: vergleicht den exakten String
soup.find_all("td", class_="text-danger pct")   # 0 Zellen: gleiche Klassen, andere Reihenfolge
soup.select("td.pct.text-danger")               # 19 Zellen, in beliebiger Reihenfolge
Eine einzelne Klasse in class_ trifft jedes Tag, das sie neben anderen trägt. Ein String mit Leerzeichen trifft nur genau diesen Attributwert und bricht, sobald die Seite die Klassen umstellt. Für zwei oder mehr Klassen nehmen Sie select mit Punkten. Andere Attribute funktionieren als Schlüsselwortargumente oder über attrs:
import re

soup.find("div", id="results")                     # nach ID
soup.find_all("a", href=True)                      # nur Links, die ein href haben
soup.find("a", attrs={"aria-label": "Next"})       # Namen mit Bindestrich gehören in attrs
soup.find("th", string=re.compile("Wins"))         # nach Text
string="Wins" liefert hier None, weil string den gesamten Text vergleicht und die Zelle Zeilenumbrüche und Leerzeichen um das Wort enthält. Ein regulärer Ausdruck trifft an jeder Stelle darin.
Wie bewegen Sie sich im Baum: parent, children und siblings?
.parentgeht eine Ebene nach oben, undfind_parent("table")steigt auf, bis es auf eine Tabelle trifft..childrenliefert die direkten Kinder,.descendantsjeden Knoten darunter. Eine Zeile der Übungstabelle hat 9 Zellen, doch.childrenlieferte 19 Einträge: Die übrigen 10 sind Leerraum-Strings..next_siblingliefert den nächsten Knoten, und das ist in eingerücktem HTML meist Leerraum.
name = soup.find("td", class_="name")
name.next_sibling                                   # '\n'
name.find_next_sibling("td").get_text(strip=True)   # '1990'
find_next_sibling("td") und find_previous_sibling("td") springen zum nächsten oder vorherigen Tag. Mit derselben Methode lesen Sie Tabellen aus Beschriftung und Wert: th.find_next_sibling("td") liefert den Wert neben einer Beschriftung.
Wie lesen Sie Text und Attribute: get_text, href und src?
.text behält den Leerraum, deshalb liefert die Team-Zelle den Namen umgeben von Zeilenumbrüchen und Einrückung. get_text(strip=True) kürzt ihn auf 'Boston Bruins'. Enthält ein Tag weitere Tags, geben Sie ein Trennzeichen an: Für <td>12<small>pts</small></td> liefert get_text(strip=True) den Wert '12pts' und get_text(" ", strip=True) den Wert '12 pts'. .stripped_strings gibt die Teile einzeln aus.
Attribute lesen Sie wie ein Dictionary. a["href"] löst einen KeyError aus, wenn das Tag kein href hat; a.get("href") liefert None, was in einer Schleife sicherer ist. Relative Links wie /pages/forms/?page_num=2 werden mit urllib.parse.urljoin(page_url, href) zu vollständigen Adressen, und ein Bild funktioniert genauso mit img.get("src"). Bilder mit Lazy Loading und srcset behandelt Alle Bilder einer Website herunterladen.
Vollständiges Beispiel: eine HTML-Tabelle Zeile für Zeile lesen
Ziel ist die Eishockey-Tabelle auf scrapethissite.com/pages/forms, deren Seitentitel die Website als öffentliche Sandbox zum Erlernen von Web Scraping bezeichnet. Ihre robots.txt sperrt nur /lessons/ und /faq/, und das Skript prüft sie zuerst (robots.txt lesen). Es liest die 25 Zeilen einer Seite, macht aus der Klasse der Win-%-Zelle ein Feld mit wahr oder falsch und sammelt die Seitenlinks.
"""Eine Seite einer Übungstabelle mit Requests und BeautifulSoup lesen."""
import json
import os
import sys
from urllib.parse import urljoin
from urllib.robotparser import RobotFileParser

import requests
from bs4 import BeautifulSoup

URL = "https://www.scrapethissite.com/pages/forms/"
USER_AGENT = "hockey-table-demo/1.0 (contact: you@example.com)"

# Optional: PROXY_URL=http://user:pass@pr.proxynet.io:8000
proxy = os.environ.get("PROXY_URL")

session = requests.Session()
session.headers["User-Agent"] = USER_AGENT
if proxy:
    session.proxies = {"http": proxy, "https": proxy}

# robots.txt einmal vor der ersten Anfrage prüfen
robots = RobotFileParser()
robots.parse(session.get(urljoin(URL, "/robots.txt"), timeout=(5, 20)).text.splitlines())
if not robots.can_fetch(USER_AGENT, URL):
    sys.exit("robots.txt does not allow this page")

response = session.get(URL, timeout=(5, 20))
response.raise_for_status()

# BeautifulSoup die Bytes übergeben und den Parser nennen
soup = BeautifulSoup(response.content, "lxml")

table = soup.select_one("table.table")
if table is None:
    sys.exit("No table.table on the page: the layout changed or the data comes from JavaScript")

headers = [th.get_text(" ", strip=True) for th in table.find("tr").find_all("th")]

teams = []
for row in table.find_all("tr", class_="team"):
    record = {}
    for td in row.find_all("td"):
        key = td["class"][0]              # "name", "year", "wins", "pct", "diff" ...
        record[key] = td.get_text(strip=True)
    # Die Website färbt Win % grün oder rot; die Farbe steht nur in der Klasse
    pct_classes = row.find("td", class_="pct").get("class", [])
    record["above_500"] = "text-success" in pct_classes
    teams.append(record)

# Seitenlinks: relative hrefs werden zu vollen URLs, Duplikate fallen weg, die Reihenfolge bleibt
page_links = list(dict.fromkeys(
    urljoin(URL, a["href"]) for a in soup.select("ul.pagination a[href]")
))

print("columns:", headers)
print("rows:", len(teams), "| page links:", len(page_links))
for team in teams[:3]:
    print(json.dumps(team, ensure_ascii=False))
print("last page:", page_links[-1])
Wir haben es mit beautifulsoup4 4.15.0, lxml 6.1.3 und Requests 2.34.2 ausgeführt, einmal direkt und einmal über einen lokalen Test-Proxy, der in PROXY_URL eingetragen war. Beide Läufe gaben dieselben Zeilen aus:
columns: ['Team Name', 'Year', 'Wins', 'Losses', 'OT Losses', 'Win %', 'Goals For (GF)', 'Goals Against (GA)', '+ / -']
rows: 25 | page links: 24
{"name": "Boston Bruins", "year": "1990", "wins": "44", "losses": "24", "ot-losses": "", "pct": "0.55", "gf": "299", "ga": "264", "diff": "35", "above_500": true}
{"name": "Buffalo Sabres", "year": "1990", "wins": "31", "losses": "30", "ot-losses": "", "pct": "0.388", "gf": "292", "ga": "278", "diff": "14", "above_500": false}
{"name": "Calgary Flames", "year": "1990", "wins": "46", "losses": "26", "ot-losses": "", "pct": "0.575", "gf": "344", "ga": "263", "diff": "81", "above_500": true}
last page: https://www.scrapethissite.com/pages/forms/?page_num=24
Die Kopfzeile hat keine Klasse, deshalb nimmt das Skript die erste <tr> für die Spaltennamen und tr.team für die Daten. Die erste Klasse jeder Zelle (name, wins, ot-losses) wird zum Schlüssel im Dictionary, damit bleibt der Code unabhängig von der Reihenfolge der Spalten. Die leere Zelle OT Losses kommt als leerer String zurück, nicht als None. Hier wiederholt die Farbe nur die Zahl, doch auf manchen Websites, etwa bei Shops, die einen ausverkauften Artikel mit einer Klasse markieren, steht diese Information nur in der Klasse. Der Paginierungsblock hat 25 Links, weil der Pfeil „Next“ die Adresse von Seite 1 wiederholt; dict.fromkeys entfernt das Duplikat und behält die Reihenfolge bei.
Der User-Agent nennt das Skript und gibt eine Kontaktadresse an, statt sich als Browser auszugeben (Was ist ein User-Agent?). timeout=(5, 20) gibt nach 5 Sekunden ohne Verbindung oder 20 Sekunden ohne Daten auf, und raise_for_status() stoppt bei einer Fehlerseite, bevor sie geparst wird. Ein falsches Proxy-Passwort löst einen ProxyError mit „Max retries exceeded“ und „407 Proxy Authentication Required“ in der Meldung aus (Max Retries Exceeded With URL). Einen Proxy brauchen Sie erst, wenn das Volumen wächst oder Sie Seiten so sehen müssen, wie Besucher in einem anderen Land sie sehen; ein Residential-Proxy passt dann in dieselbe Zeile PROXY_URL.
Das Skript hört absichtlich nach einer Seite auf. Wie Sie alle 24 Seiten mit einer Pause zwischen den Anfragen durchgehen, zeigt Paginierung beim Web Scraping, das Wiederholen nach einem 429 oder 503 erklärt HTTP-Statuscodes beim Web Scraping, parallele Anfragen behandelt Concurrency und Parallelism und den Wechsel des Ausgangs zwischen Anfragen Proxys in Python rotieren.
Wie lesen Sie eine Tabelle mit pandas read_html?
Hat die Seite eine richtige <table> und brauchen Sie nur die Werte, liest pandas sie mit einem einzigen Aufruf. pandas.read_html betrachtet nur die Elemente <table>, <tr>, <th> und <td> und liefert immer eine Liste von DataFrames, einen pro gefundener Tabelle. Wir haben pandas 3.0.6 verwendet:
import io
import os

import pandas as pd
import requests

URL = "https://www.scrapethissite.com/pages/forms/"

session = requests.Session()
session.headers["User-Agent"] = "hockey-table-demo/1.0 (contact: you@example.com)"
if os.environ.get("PROXY_URL"):
    session.proxies = {"http": os.environ["PROXY_URL"], "https": os.environ["PROXY_URL"]}

response = session.get(URL, timeout=(5, 20))
response.raise_for_status()

# pandas 3: das HTML in StringIO verpacken, ein einfacher String gilt als Dateipfad
tables = pd.read_html(io.StringIO(response.text), attrs={"class": "table"})
df = tables[0]
print(len(tables), df.shape)
print(df[["Team Name", "Year", "Wins", "OT Losses", "Win %"]].head(3))1 (25, 9)
Team Name Year Wins OT Losses Win %
0 Boston Bruins 1990 44 NaN 0.550
1 Buffalo Sabres 1990 31 NaN 0.388
2 Calgary Flames 1990 46 NaN 0.575Der Server gibt im Header Content-Type UTF-8 an, deshalb dekodiert response.text hier korrekt. pandas hat auch die Zahlen umgewandelt: Year und Wins wurden zu Ganzzahlen, Win % zu einer Gleitkommazahl und die leere Spalte OT Losses zu NaN. attrs wählt eine Tabelle nach ihren Attributen aus, match nach einem String oder regulären Ausdruck in ihrem Text. Standardmäßig parst pandas mit lxml und weicht auf BeautifulSoup mit html5lib aus, wenn das scheitert.
Drei Fehler tauchen immer wieder auf:
- Ein Dateifehler, wenn Sie HTML-Text übergeben. Seit pandas 3.0 akzeptiert
read_htmlkeine literalen HTML-Strings mehr; verpacken Sie den Text inio.StringIO(Versionshinweise zu pandas 3.0.0). Ein einfacher String wird als Dateipfad behandelt, und wir erhielten einenFileNotFoundError, der den Anfang der Seite zitierte. ValueError: No tables found. Die Tabelle kommt erst später per JavaScript, die Seite zeichnet ihr Raster mit<div>-Elementen, oder Ihrmatch-Text steht in keiner Tabelle (No tables found matching pattern 'Points'). Ist html5lib nicht installiert, scheitert zuerst der Ausweich-Parser, und Sie erhalten einenImportError, der Sie auffordert, html5lib zu installieren.HTTP Error 403: Forbidden, wenn Sie die URL übergeben. pandas lädt dann mit urllib herunter, dessen Standard-User-AgentPython-urllib/3.13lautet, und manche Websites lehnen ihn ab; unser lokaler Testserver hat genau diesen String protokolliert. Laden Sie die Seite wie oben selbst herunter oder übergeben Sie überstorage_options={"User-Agent": "..."}einen ehrlichen Bot-Namen. Kopieren Sie nicht den User-Agent eines Browsers: RFC 9110 weist darauf hin, dass ein Client, der sich als ein anderer ausgibt, die Antworten erhalten kann, die für diesen anderen Client gedacht sind.
pandas liefert nur Werte. extract_links="body" ergänzt den Link jeder Zelle, aber keine Klassen; für die Farbe von Win % oben kehren Sie also zu BeautifulSoup zurück.
Anwendungsfälle
- Preise von Wettbewerbern: Viele Produktseiten tragen ihren Preis in einem JSON-LD-Tag
<script>, dasfind_all("script", type="application/ld+json")ausliest (Wettbewerberpreise überwachen). - Anmeldung mit dem eigenen Konto: Ein Login-Formular hat oft ein verstecktes CSRF-Feld, das Sie mit
find("input", attrs={"name": "csrf_token"})lesen, bevor Sie das Formular absenden (Sitzungen und Cookies in Python). - Seitenlinks folgen:
select_one("a[rel=next]")oder ein Paginierungsblock zeigt dem Crawler, wo die nächste Seite liegt (paginierte Listen scrapen). - Scraping und Crawling: BeautifulSoup ist der Extraktionsschritt; ein Crawler ergänzt den Teil, der Seiten findet (Web Scraping und Web Crawling).
- Große, geplante Datenerfassung: Tausende Seiten am Tag brauchen Warteschlangen, Tempokontrolle und Ausgänge in mehreren Ländern (Data Scraping).
Häufige Fehler
- Den Parser weglassen. Das Ergebnis hängt davon ab, was auf dem jeweiligen Rechner installiert ist, und Sie erhalten eine
GuessedAtParserWarning. - Nach
findohne Prüfung verketten. Ein fehlendes Element wird drei Zeilen später zu'NoneType' object has no attribute .... - Einen Selektor mit
tbodyaus den Entwicklertools kopieren. Browser ergänzen<tbody>, weil HTML es Autoren erlaubt, die Tags dieses Elements wegzulassen (WHATWG HTML, das tbody-Element). Auf der Übungsseite fandtable > tbody > trmit html.parser und lxml 0 Zeilen, mit html5lib 26, währendtable tr.teammit allen dreien 25 fand. - Mehrere Klassen als einen String suchen.
class_="pct text-danger"scheitert, wenn die Seite die Klassen in anderer Reihenfolge schreibt; nehmen Sieselect("td.pct.text-danger"). - Erwarten, dass
.next_siblingein Tag ist. In eingerücktem HTML ist es meist ein Leerraum-String; nehmen Siefind_next_sibling("td"). response.textübergeben. Ohne Charset im Header rät Requests ISO-8859-1; übergeben Sieresponse.content.- Eine Schleife starten, bevor Sie
robots.txtgelesen haben. Prüfen Sie, was die Website erlaubt, und legen Sie eine Pause fest, bevor Sie mehr als eine Seite anfragen.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
Die Seite hat eine saubere <table>, und Sie wollen einen DataFrame | pandas.read_html mit io.StringIO, dazu attrs oder match, um die Tabelle auszuwählen |
| Sie brauchen auch Klasse, Farbe oder Link einer Zelle | BeautifulSoup: Zeilen mit find_all("tr"), Attribute mit td.get("class") und a.get("href") |
| Sie können keine zusätzlichen Pakete installieren | html.parser, und prüfen Sie das Ergebnis bei Seiten mit nicht geschlossenen Tags |
| Tempo und Toleranz gegenüber fehlerhaften Tabellen | lxml, die Standardwahl für die meisten Aufgaben |
| Der Baum weicht von dem ab, was der Browser zeigt | html5lib ausprobieren und tbody aus dem Selektor entfernen |
| Die Daten kommen per JavaScript | Zuerst die JSON-Anfrage suchen, dann einen Headless-Browser (Statische und dynamische Seiten) |
| Tausende Seiten mit Warteschlangen, Wiederholungen und Proxys | Scrapy (Scrapy mit Proxy) und Rotierender Proxy |
Häufige Fragen
Lädt BeautifulSoup Webseiten herunter?
Nein. BeautifulSoup parst nur HTML, das Sie übergeben. Ein HTTP-Client wie Requests oder HTTPX lädt die Seite herunter, und Sie reichen response.content zusammen mit einem Parsernamen an BeautifulSoup weiter. JavaScript führt BeautifulSoup ebenfalls nicht aus.
Was ist der Unterschied zwischen find und find_all?
find liefert das erste passende Tag oder None; find_all liefert eine Liste aller Treffer, die leer ist, wenn nichts passt. select_one und select tun dasselbe mit einem CSS-Selektor. Prüfen Sie ein Ergebnis von find, bevor Sie darauf eine Methode aufrufen.
Welcher Parser ist für BeautifulSoup der richtige?
lxml passt für die meisten Aufgaben: Er ist schnell und schließt offene Tags sinnvoll. Nehmen Sie html.parser, wenn Sie keine Pakete installieren können, und html5lib, wenn Sie den Baum des Browsers brauchen und in Kauf nehmen, dass er langsam ist. Schreiben Sie den Parsernamen immer in den Aufruf.
Kann BeautifulSoup per JavaScript geladene Inhalte lesen?
Nein. Die Bibliothek sieht nur das HTML, das der Server zurückgegeben hat, und Daten, die ein Skript später hinzufügt, stehen nicht darin. Suchen Sie im Netzwerk-Tab des Browsers die JSON-Anfrage, die die Daten liefert, oder nutzen Sie einen Headless-Browser, wo die Website es erlaubt (Statische und dynamische Seiten).
Warum meldet pandas read_html „No tables found“?
Die Tabelle wird per JavaScript aufgebaut, die Seite zeichnet ihr Raster mit <div>-Elementen statt mit einer <table>, oder Ihr Wert für match oder attrs passt zu keiner Tabelle. Achten Sie seit pandas 3.0 außerdem darauf, das HTML in io.StringIO verpackt zu übergeben; ein einfacher String wird als Dateipfad behandelt.
Ist pip install bs4 dasselbe wie pip install beautifulsoup4?
Im Ergebnis ja, aber verwenden Sie den echten Namen. bs4 auf PyPI ist ein Platzhalterpaket, das nur beautifulsoup4 installiert. Installieren Sie beautifulsoup4 und importieren Sie im Code bs4: from bs4 import BeautifulSoup.
Fazit
BeautifulSoup parst HTML in einen Baum, lädt aber keine Seiten herunter und führt kein JavaScript aus. Nennen Sie in jedem Aufruf den Parser, und denken Sie daran, dass find None liefert, wo find_all eine leere Liste liefert. Nehmen Sie select, wenn Sie mehrere Klassen auf einmal abgleichen, und versuchen Sie es zuerst mit pandas.read_html, wenn die Seite eine saubere Tabelle hat. Wird aus einer Seite eine Sammlung von Tausenden Seiten am Tag, sehen Sie sich an, wie unsere Proxys für Data Scraping das zusätzliche Volumen tragen.