Um colega pede que você leve para o Python uma tabela de estatísticas de uma página web. Você baixou o HTML com o Requests, e soup.find("td").text devolveu a primeira célula. Agora você precisa de todas as linhas, da classe que pinta algumas células de verde e outras de vermelho e dos links de página que ficam abaixo da tabela. O seletor table > tbody > tr que você copiou das ferramentas de desenvolvedor do navegador não retorna nada. O caminho geral de uma página até um arquivo está em Como extrair dados de um site; este guia trata da biblioteca que lê o HTML.
Vamos ver os três parsers, find, find_all e select, a seleção por classe, a navegação pela árvore, a leitura de texto e de links, um exemplo completo em uma tabela de treino e o pandas.read_html com seus erros comuns. Todos os exemplos rodaram em 24 de setembro de 2026 com beautifulsoup4 4.15.0 e Python 3.13.
O que é o BeautifulSoup?
O BeautifulSoup é uma biblioteca Python que analisa HTML e XML e os transforma em uma árvore de objetos pesquisável, mesmo quando a marcação está quebrada. Ele não envia requisições. Um cliente HTTP como o Requests ou o HTTPX baixa a página (HTTPX, Requests e AIOHTTP), e o BeautifulSoup trabalha sobre o que esse cliente devolve.
O nome do pacote e o nome do import são diferentes. Você instala beautifulsoup4 e importa bs4:
pip install beautifulsoup4 lxmlO pacote bs4 no PyPI é um pacote fictício (versão 0.0.2) que reserva o nome e só instala o beautifulsoup4. Tutoriais que começam com from BeautifulSoup import BeautifulSoup foram escritos para o BeautifulSoup 3 e o Python 2 e não rodam no Python 3. A versão atual é a 4.15.0 (beautifulsoup4 no PyPI), coberta pela documentação oficial. A comparação com o Scrapy e o Selenium está em Scrapy, BeautifulSoup ou Selenium?.
Como o BeautifulSoup transforma uma página em árvore?
Cinco etapas separam o download da sua primeira busca:
- O cliente baixa bytes. O Requests os guarda em
response.contente oferece uma decodificação estimada emresponse.text. - O BeautifulSoup descobre a codificação. Uma sub-biblioteca chamada Unicode, Dammit lê
<meta charset>e outras pistas e depois converte os bytes para Unicode. Passeresponse.content, nãoresponse.text: quando um servidor enviatext/htmlsem charset, o Requests supõe ISO-8859-1 eéviraé. Os detalhes estão em Erros de codificação Unicode no Python. - O parser lê as tags. Ele transforma o texto em elementos e corrige tags não fechadas segundo as próprias regras.
- O resultado é uma árvore. Cada elemento vira uma
Tagcom nome e atributos, e cada trecho de texto vira umaNavigableString. - Os métodos de busca percorrem a árvore.
find,find_alleselectleem essa árvore na memória e nunca tocam a rede.
Qual parser escolher: html.parser, lxml ou html5lib?
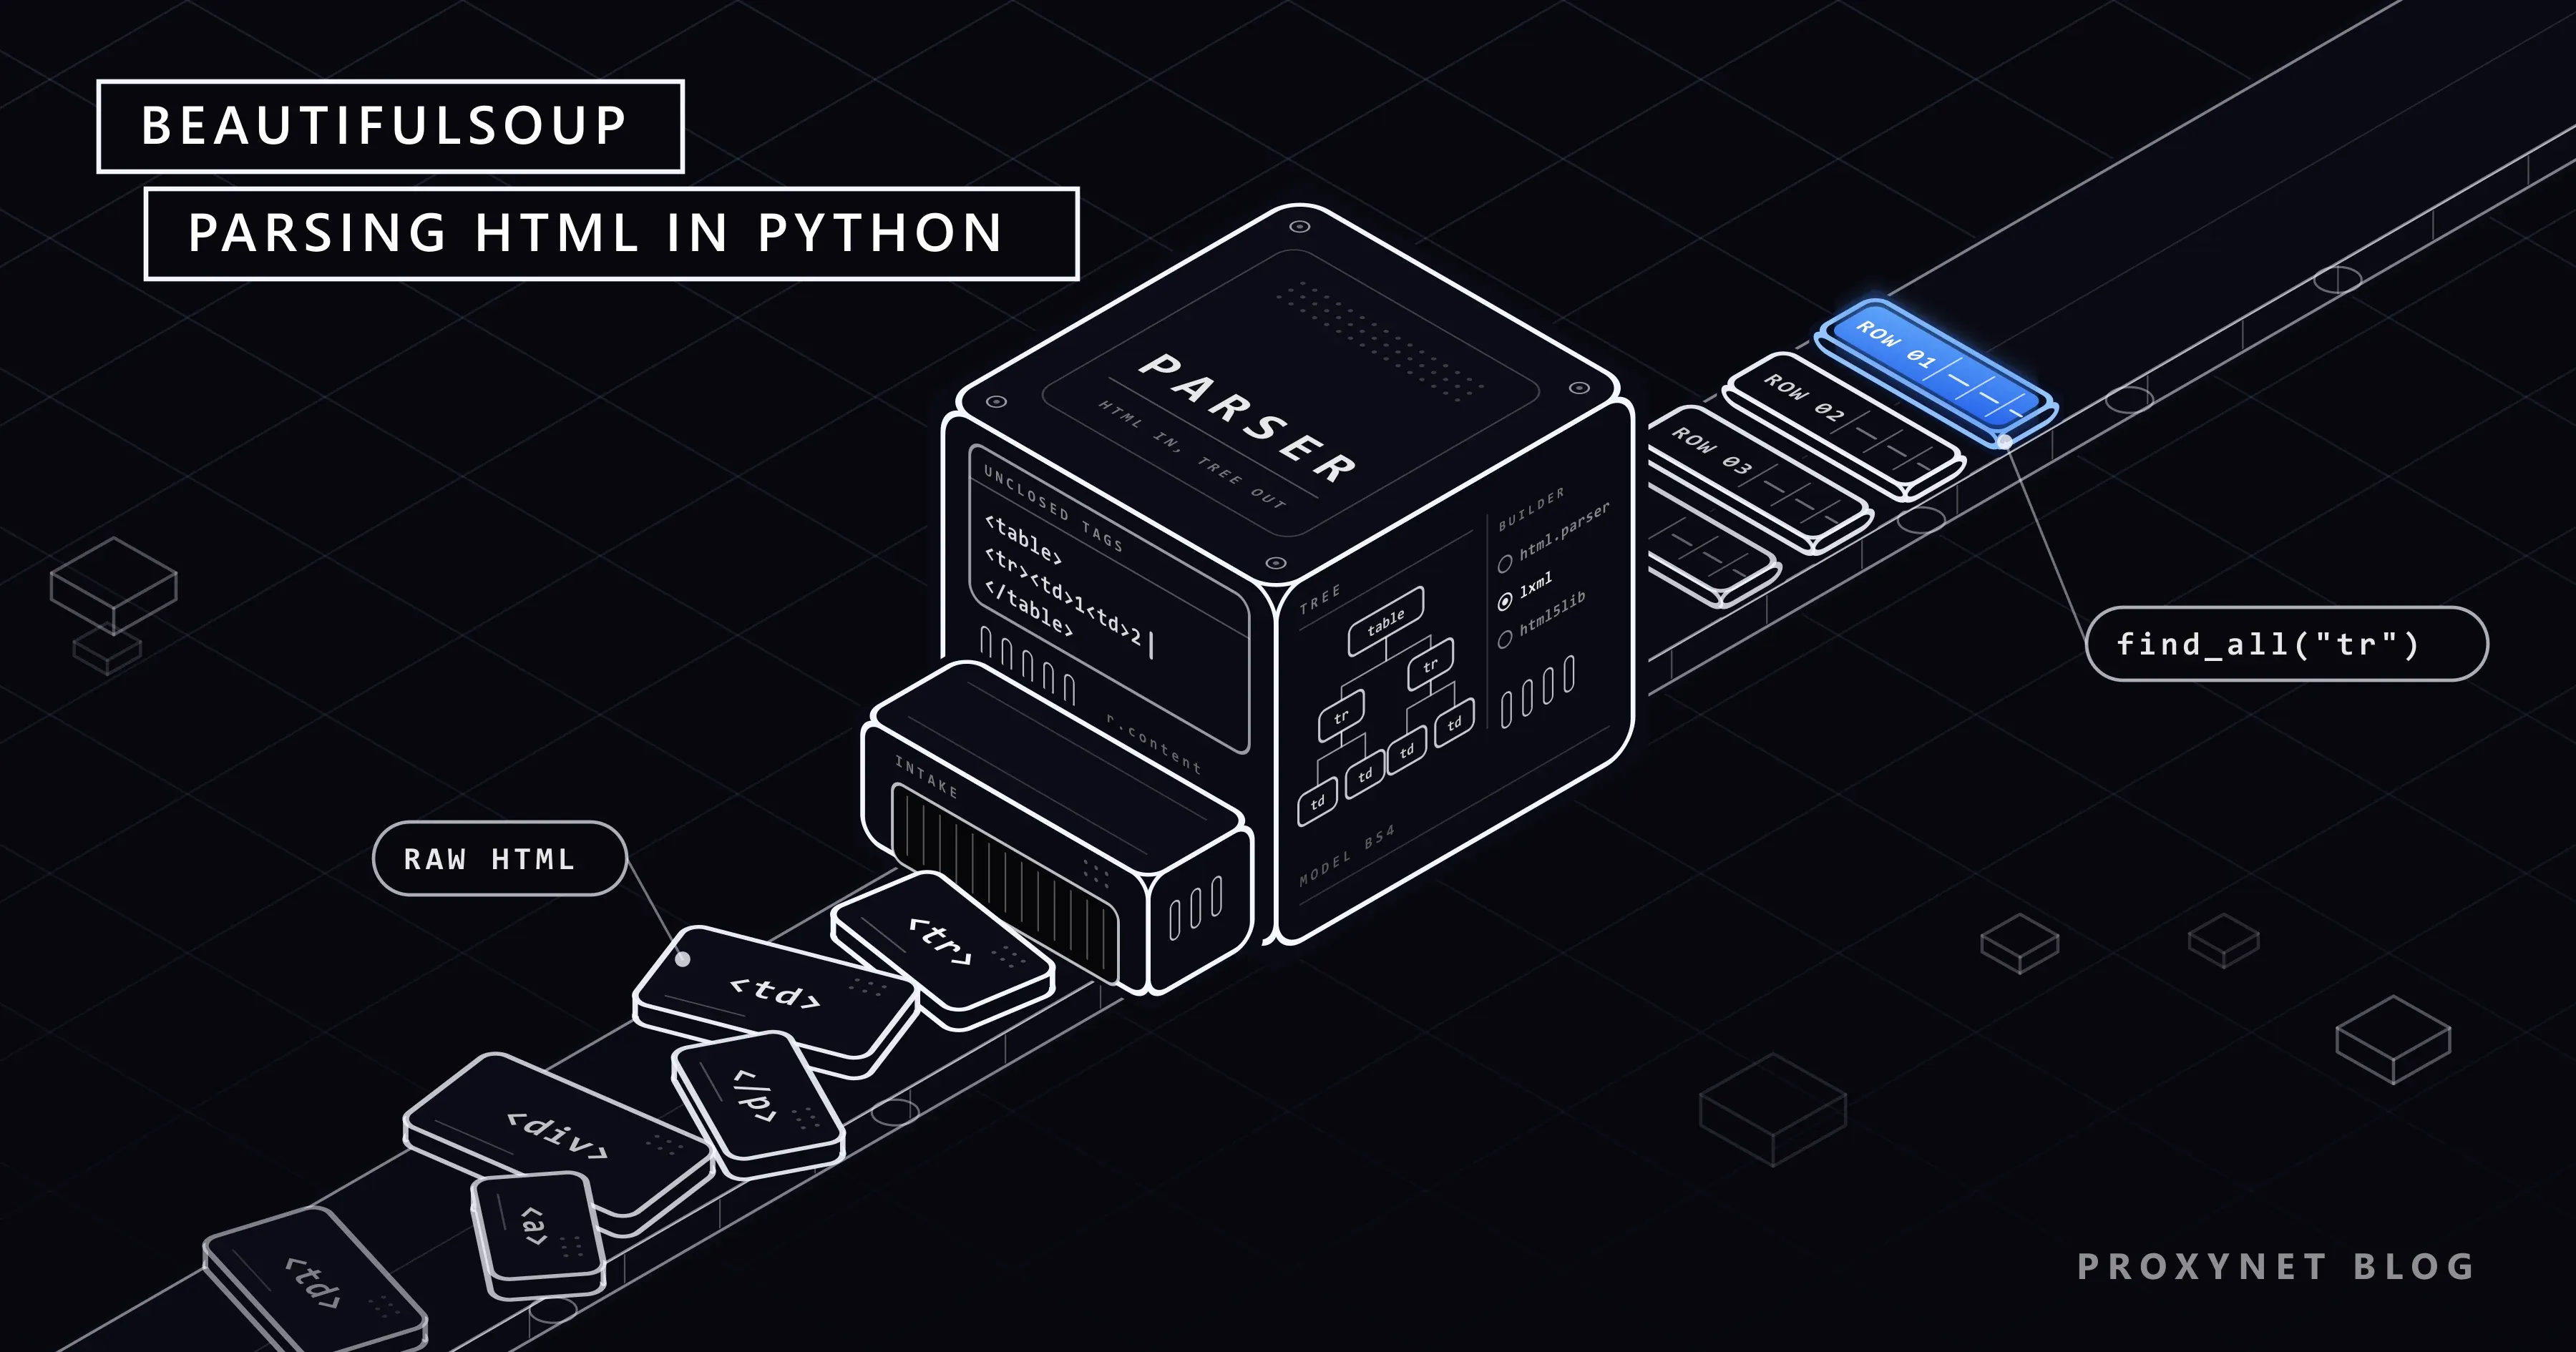
Cada parser corrige a marcação quebrada do seu jeito. Demos aos três o mesmo fragmento com células não fechadas:
from bs4 import BeautifulSoup

broken = "<table><tr><td>1<td>2</table>"
for parser in ("html.parser", "lxml", "html5lib"):
print(parser, BeautifulSoup(broken, parser))html.parser <table><tr><td>1<td>2</td></td></tr></table>
lxml <html><body><table><tr><td>1</td><td>2</td></tr></table></body></html>
html5lib <html><head></head><body><table><tbody><tr><td>1</td><td>2</td></tr></tbody></table></body></html>O html.parser colocou a segunda célula dentro da primeira, então row.find_all("td", recursive=False) encontra uma célula em vez de duas. O lxml fechou as duas células e envolveu o fragmento em <html><body>. O html5lib montou a árvore que um navegador montaria, incluindo o <tbody>.
| Parser | Como chamar | Instalação | Tags não fechadas | Quando escolher |
|---|---|---|---|---|
| html.parser | BeautifulSoup(html, "html.parser") | Vem com o Python | Pode aninhar uma célula dentro de outra | Scripts pequenos em que você não pode instalar pacotes |
| lxml | BeautifulSoup(html, "lxml") | pip install lxml (extensão em C) | Fecha as células, adiciona <html><body> | A maioria dos trabalhos de scraping; a documentação o descreve como muito rápido |
| html5lib | BeautifulSoup(html, "html5lib") | pip install html5lib (Python puro) | Monta a árvore do navegador, adiciona <tbody> | Páginas muito quebradas, ou quando você precisa da árvore que o navegador mostra; muito lento |
Um parser que não está instalado gera bs4.FeatureNotFound: Couldn't find a tree builder with the features you requested: html5lib. Se nenhum parser for informado, o BeautifulSoup escolhe sozinho entre os parsers instalados, pela ordem de preferência dele, e emite um GuessedAtParserWarning; assim, o mesmo script pode montar uma árvore diferente em uma máquina sem lxml.
Qual é a diferença entre find, find_all e select?
Quatro métodos cobrem quase todas as buscas:
find(name, attrs)retorna a primeira tag correspondente, ouNone.find_all(name, attrs)retorna uma lista com todas as correspondências, ou uma lista vazia.select(css)recebe um seletor CSS e retorna uma lista.select_one(css)retorna a primeira correspondência de um seletor CSS, ouNone.
Os métodos CSS rodam sobre o Soup Sieve, que é instalado junto com o beautifulsoup4. Quando nada corresponde:
soup.find("td", class_="rank")        # None
soup.find_all("td", class_="rank")    # []
soup.select_one("td.rank")            # None
soup.select("td.rank")                # []

soup.find("td", class_="rank").get_text()
# AttributeError: 'NoneType' object has no attribute 'get_text'
Esse é um primeiro erro comum: find retornou None e a chamada seguinte falhou. Verifique antes de encadear:
cell = soup.find("td", class_="name")
name = cell.get_text(strip=True) if cell else None
limit=3 faz o find_all parar depois de três correspondências, e recursive=False busca apenas nos filhos diretos. O select fica mais curto quando o caminho passa por vários níveis, como em table.table tr.team td.name. A sintaxe dos seletores, e por que o BeautifulSoup não tem XPath, estão em Seletor CSS ou XPath.
Como selecionar por classe, id e atributo?
class é uma palavra reservada do Python, então o BeautifulSoup usa class_. A armadilha é que class guarda vários valores: td["class"] retorna uma lista como ['pct', 'text-success']. Na página de treino usada mais abaixo, as células de Win % levam pct e as de + / - levam diff, cada uma com text-success ou text-danger. Em uma página de 25 linhas, contamos:
soup.find_all("td", class_="text-danger")       # 31 células, das duas colunas
soup.find_all("td", class_="pct text-danger")   # 19 células: corresponde à string exata
soup.find_all("td", class_="text-danger pct")   # 0 células: mesmas classes, outra ordem
soup.select("td.pct.text-danger")               # 19 células, em qualquer ordem
Uma única classe em class_ corresponde a qualquer tag que a tenha entre outras. Uma string com espaço corresponde apenas a esse valor exato do atributo e quebra quando a página reordena as classes. Para duas ou mais classes, use select com pontos. Outros atributos funcionam como argumentos nomeados ou por meio de attrs:
import re

soup.find("div", id="results")                     # por id
soup.find_all("a", href=True)                      # só links que têm href
soup.find("a", attrs={"aria-label": "Next"})       # nomes com hífen vão em attrs
soup.find("th", string=re.compile("Wins"))         # pelo texto
string="Wins" retorna None aqui porque string compara o texto inteiro, e a célula tem quebras de linha e espaços em volta da palavra. Uma expressão regular encontra a palavra em qualquer ponto do texto.
Como navegar pela árvore: parent, children e siblings?
.parentsobe um nível, efind_parent("table")vai subindo até encontrar uma tabela..childrentraz os filhos diretos, e.descendants, todos os nós abaixo. Uma linha da tabela de treino tem 9 células, mas.childrenretornou 19 itens: os outros 10 são strings de espaço em branco..next_siblingretorna o nó seguinte, que em HTML indentado geralmente é espaço em branco.
name = soup.find("td", class_="name")
name.next_sibling                                   # '\n'
name.find_next_sibling("td").get_text(strip=True)   # '1990'
find_next_sibling("td") e find_previous_sibling("td") pulam para a tag seguinte ou anterior. O mesmo método lê tabelas de rótulo e valor: th.find_next_sibling("td") dá o valor ao lado de um rótulo.
Como ler texto e atributos: get_text, href e src?
.text mantém o espaço em branco, então a célula do time retorna o nome cercado de quebras de linha e indentação. get_text(strip=True) o reduz a 'Boston Bruins'. Quando uma tag contém outras tags, adicione um separador: para <td>12<small>pts</small></td>, get_text(strip=True) retorna '12pts' e get_text(" ", strip=True) retorna '12 pts'. .stripped_strings entrega os pedaços um a um.
Os atributos são lidos como um dicionário. a["href"] gera um KeyError quando a tag não tem href; a.get("href") retorna None, o que é mais seguro em um loop. Links relativos como /pages/forms/?page_num=2 viram endereços completos com urllib.parse.urljoin(page_url, href), e uma imagem funciona do mesmo jeito com img.get("src"). Imagens com lazy loading e srcset estão em Como baixar todas as imagens de um site.
Exemplo completo: ler uma tabela HTML linha por linha
O alvo é a tabela de hóquei em scrapethissite.com/pages/forms, cujo título de página descreve o site como uma sandbox pública para aprender web scraping. O robots.txt do site bloqueia apenas /lessons/ e /faq/, e o script o verifica primeiro (como ler o robots.txt). O script lê as 25 linhas de uma página, transforma a classe da célula Win % em um campo verdadeiro ou falso e reúne os links de página.
"""Lê uma página de uma tabela de treino com Requests e BeautifulSoup."""
import json
import os
import sys
from urllib.parse import urljoin
from urllib.robotparser import RobotFileParser

import requests
from bs4 import BeautifulSoup

URL = "https://www.scrapethissite.com/pages/forms/"
USER_AGENT = "hockey-table-demo/1.0 (contact: you@example.com)"

# Opcional: PROXY_URL=http://user:pass@pr.proxynet.io:8000
proxy = os.environ.get("PROXY_URL")

session = requests.Session()
session.headers["User-Agent"] = USER_AGENT
if proxy:
    session.proxies = {"http": proxy, "https": proxy}

# Verifica o robots.txt uma vez, antes da primeira requisição
robots = RobotFileParser()
robots.parse(session.get(urljoin(URL, "/robots.txt"), timeout=(5, 20)).text.splitlines())
if not robots.can_fetch(USER_AGENT, URL):
    sys.exit("robots.txt does not allow this page")

response = session.get(URL, timeout=(5, 20))
response.raise_for_status()

# Entrega os bytes ao BeautifulSoup e informa o parser
soup = BeautifulSoup(response.content, "lxml")

table = soup.select_one("table.table")
if table is None:
    sys.exit("No table.table on the page: the layout changed or the data comes from JavaScript")

headers = [th.get_text(" ", strip=True) for th in table.find("tr").find_all("th")]

teams = []
for row in table.find_all("tr", class_="team"):
    record = {}
    for td in row.find_all("td"):
        key = td["class"][0]              # "name", "year", "wins", "pct", "diff" ...
        record[key] = td.get_text(strip=True)
    # O site pinta o Win % de verde ou vermelho; a cor existe só na classe
    pct_classes = row.find("td", class_="pct").get("class", [])
    record["above_500"] = "text-success" in pct_classes
    teams.append(record)

# Links de página: hrefs relativos viram URLs completas, sem duplicatas, na ordem original
page_links = list(dict.fromkeys(
    urljoin(URL, a["href"]) for a in soup.select("ul.pagination a[href]")
))

print("columns:", headers)
print("rows:", len(teams), "| page links:", len(page_links))
for team in teams[:3]:
    print(json.dumps(team, ensure_ascii=False))
print("last page:", page_links[-1])
Rodamos o script com beautifulsoup4 4.15.0, lxml 6.1.3 e Requests 2.34.2, uma vez direto e outra por um proxy de teste local definido em PROXY_URL. As duas execuções imprimiram as mesmas linhas:
columns: ['Team Name', 'Year', 'Wins', 'Losses', 'OT Losses', 'Win %', 'Goals For (GF)', 'Goals Against (GA)', '+ / -']
rows: 25 | page links: 24
{"name": "Boston Bruins", "year": "1990", "wins": "44", "losses": "24", "ot-losses": "", "pct": "0.55", "gf": "299", "ga": "264", "diff": "35", "above_500": true}
{"name": "Buffalo Sabres", "year": "1990", "wins": "31", "losses": "30", "ot-losses": "", "pct": "0.388", "gf": "292", "ga": "278", "diff": "14", "above_500": false}
{"name": "Calgary Flames", "year": "1990", "wins": "46", "losses": "26", "ot-losses": "", "pct": "0.575", "gf": "344", "ga": "263", "diff": "81", "above_500": true}
last page: https://www.scrapethissite.com/pages/forms/?page_num=24
A linha de cabeçalho não tem classe, então o script usa o primeiro <tr> para os nomes das colunas e tr.team para os dados. A primeira classe de cada célula (name, wins, ot-losses) vira a chave do dicionário, o que deixa o código independente da ordem das colunas. A célula vazia de OT Losses volta como string vazia, não como None. Aqui a cor só repete o número, mas em alguns sites, como lojas que marcam um item esgotado com uma classe, a classe é o único lugar onde essa informação aparece. O bloco de paginação tem 25 links porque a seta "Next" repete o endereço da página 1; dict.fromkeys remove a duplicata e mantém a ordem.
O User-Agent informa o nome do script e um endereço de contato, em vez de fingir ser um navegador (O que é User-Agent?). timeout=(5, 20) desiste depois de 5 segundos sem conexão ou de 20 segundos sem dados, e raise_for_status() interrompe o script em uma página de erro antes que ela seja analisada. Uma senha de proxy errada gera um ProxyError com "Max retries exceeded" e "407 Proxy Authentication Required" na mensagem (Max retries exceeded with URL). Você só precisa de proxy quando o volume cresce ou quando precisa ver as páginas como os visitantes de outro país as veem; nesse caso, um Proxies residenciais entra na mesma linha PROXY_URL.
O script se limita, de propósito, a uma página. Percorrer as 24 páginas com uma pausa entre as requisições está em Como percorrer listas paginadas; tentar de novo depois de um 429 ou 503, em Códigos de status HTTP no web scraping; rodar requisições em paralelo, em Concorrência e paralelismo; e trocar a saída entre as requisições, em Como rotacionar proxies em Python.
Como ler uma tabela com o read_html do pandas?
Quando a página tem uma <table> de verdade e você só precisa dos valores, o pandas a lê em uma chamada. O pandas.read_html olha apenas para os elementos <table>, <tr>, <th> e <td> e sempre retorna uma lista de DataFrames, um para cada tabela que encontra. Usamos o pandas 3.0.6:
import io
import os

import pandas as pd
import requests

URL = "https://www.scrapethissite.com/pages/forms/"

session = requests.Session()
session.headers["User-Agent"] = "hockey-table-demo/1.0 (contact: you@example.com)"
if os.environ.get("PROXY_URL"):
    session.proxies = {"http": os.environ["PROXY_URL"], "https": os.environ["PROXY_URL"]}

response = session.get(URL, timeout=(5, 20))
response.raise_for_status()

# pandas 3: envolva o HTML em StringIO; uma string simples é lida como caminho de arquivo
tables = pd.read_html(io.StringIO(response.text), attrs={"class": "table"})
df = tables[0]
print(len(tables), df.shape)
print(df[["Team Name", "Year", "Wins", "OT Losses", "Win %"]].head(3))1 (25, 9)
Team Name Year Wins OT Losses Win %
0 Boston Bruins 1990 44 NaN 0.550
1 Buffalo Sabres 1990 31 NaN 0.388
2 Calgary Flames 1990 46 NaN 0.575O servidor declara UTF-8 no cabeçalho Content-Type, então response.text decodifica corretamente aqui. O pandas também converteu os números: Year e Wins viraram inteiros, Win % virou float e a coluna vazia OT Losses virou NaN. attrs escolhe uma tabela pelos atributos, e match, por uma string ou expressão regular presente no texto dela. Por padrão, o pandas analisa com o lxml e, se isso falhar, recorre ao BeautifulSoup com o html5lib.
Três erros aparecem o tempo todo:
- Um erro de arquivo quando você passa texto HTML. Desde o pandas 3.0,
read_htmlnão aceita mais strings HTML literais; envolva o texto emio.StringIO(notas da versão 3.0.0 do pandas). Uma string simples é tratada como caminho de arquivo, e recebemos umFileNotFoundErrorque citava o começo da página. ValueError: No tables found. A tabela chega depois, via JavaScript, a página desenha a grade com elementos<div>, ou o texto do seumatchnão está em nenhuma tabela (No tables found matching pattern 'Points'). Sem o html5lib instalado, o parser de reserva falha antes e você recebe umImportErrorpedindo para instalar o html5lib.HTTP Error 403: Forbiddenquando você passa a URL. Nesse caso, o pandas baixa a página com o urllib, cujo User-Agent padrão éPython-urllib/3.13, e alguns sites o recusam; nosso servidor de teste local registrou exatamente essa string. Baixe a página você mesmo, como acima, ou passe um nome de bot honesto porstorage_options={"User-Agent": "..."}. Não copie o User-Agent de um navegador: a RFC 9110 observa que um cliente que se passa por outro pode receber as respostas destinadas a esse outro cliente.
O pandas retorna só valores. extract_links="body" acrescenta o link de cada célula, mas não as classes; para a cor do Win % acima, você volta ao BeautifulSoup.
Casos de uso
- Preços da concorrência: muitas páginas de produto trazem o preço em uma tag
<script>JSON-LD, quefind_all("script", type="application/ld+json")lê (monitoramento de preços da concorrência). - Login com a sua própria conta: um formulário de login costuma ter um campo CSRF oculto, que você lê com
find("input", attrs={"name": "csrf_token"})antes de enviar o formulário (sessões e cookies em Python). - Seguir os links de página:
select_one("a[rel=next]")ou um bloco de paginação diz ao crawler onde está a próxima página (scraping de listas paginadas). - Scraping ou crawling: o BeautifulSoup é a etapa de extração; um crawler acrescenta a parte que descobre as páginas (web scraping vs web crawling).
- Coleta grande e agendada: milhares de páginas por dia pedem filas, controle de taxa e saídas em vários países (extração de dados).
Erros comuns
- Não informar o parser. O resultado depende do que está instalado em cada máquina, e você recebe um
GuessedAtParserWarning. - Encadear chamadas sobre
findsem verificar. Um elemento ausente vira'NoneType' object has no attribute ...três linhas depois. - Copiar das ferramentas de desenvolvedor um seletor com
tbody. Os navegadores adicionam<tbody>porque o HTML permite que os autores omitam as tags desse elemento (WHATWG HTML, o elemento tbody). Na página de treino,table > tbody > trencontrou 0 linhas com html.parser e lxml e 26 com html5lib, enquantotable tr.teamencontrou 25 com os três. - Buscar várias classes como uma única string.
class_="pct text-danger"falha quando a página escreve as classes em outra ordem; useselect("td.pct.text-danger"). - Esperar que
.next_siblingseja uma tag. Em HTML indentado, geralmente é uma string de espaço em branco; usefind_next_sibling("td"). - Passar
response.text. Sem charset no cabeçalho, o Requests supõe ISO-8859-1; passeresponse.content. - Começar um loop antes de ler o
robots.txt. Confira o que o site permite e defina uma pausa antes de pedir mais de uma página.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
A página tem uma <table> limpa e você quer um DataFrame | pandas.read_html com io.StringIO, e attrs ou match para escolher a tabela |
| Você também precisa da classe, da cor ou do link de uma célula | BeautifulSoup: linhas com find_all("tr"), atributos com td.get("class") e a.get("href") |
| Você não pode instalar pacotes extras | html.parser, conferindo o resultado em páginas com tags não fechadas |
| Velocidade e tolerância a tabelas quebradas | lxml, a escolha padrão para a maioria dos trabalhos |
| A árvore difere do que o navegador mostra | Teste o html5lib e tire o tbody do seu seletor |
| Os dados chegam via JavaScript | Procure primeiro a requisição JSON e depois um navegador headless (Páginas estáticas e dinâmicas) |
| Milhares de páginas com filas, novas tentativas e proxies | Scrapy (Scrapy com proxy) e um Proxies rotativos |
Perguntas frequentes
O BeautifulSoup baixa páginas web?
Não. O BeautifulSoup apenas analisa o HTML que você entrega a ele. Um cliente HTTP como o Requests ou o HTTPX baixa a página, e você passa response.content ao BeautifulSoup junto com o nome de um parser. Ele também não executa JavaScript.
Qual é a diferença entre find e find_all?
find retorna a primeira tag correspondente ou None; find_all retorna uma lista com todas as correspondências, vazia quando nada corresponde. select_one e select fazem o mesmo com um seletor CSS. Verifique o resultado de um find antes de chamar um método sobre ele.
Qual parser usar com o BeautifulSoup?
O lxml atende à maioria dos trabalhos: é rápido e fecha as tags não fechadas de forma sensata. Use o html.parser quando não puder instalar pacotes, e o html5lib quando precisar da árvore do navegador e puder aceitar que ele é lento. Escreva sempre o nome do parser na chamada.
O BeautifulSoup consegue ler conteúdo carregado com JavaScript?
Não. Ele vê apenas o HTML que o servidor retornou, e os dados que um script adiciona depois não estão nesse HTML. Procure na aba de rede do navegador a requisição JSON que entrega os dados, ou use um navegador headless onde o site permitir (Páginas estáticas e dinâmicas).
Por que o read_html do pandas diz "No tables found"?
A tabela é montada por JavaScript, a página desenha a grade com elementos <div> em vez de uma <table>, ou o valor de match ou de attrs não se encaixa em nenhuma tabela. Desde o pandas 3.0, confira também se você passa o HTML envolto em io.StringIO; uma string simples é tratada como caminho de arquivo.
pip install bs4 é o mesmo que pip install beautifulsoup4?
Na prática, sim, mas use o nome real. bs4 no PyPI é um pacote fictício que só instala o beautifulsoup4. Instale beautifulsoup4 e importe bs4 no seu código: from bs4 import BeautifulSoup.
Em resumo
O BeautifulSoup transforma HTML em uma árvore; ele não baixa páginas nem executa JavaScript. Informe o parser em toda chamada e saiba que find retorna None onde find_all retorna uma lista vazia. Use select quando precisar combinar várias classes ao mesmo tempo, e tente primeiro o pandas.read_html quando a página tiver uma tabela limpa. Quando uma página virar milhares de páginas por dia, veja como os nossos proxies para extração de dados dão conta do volume extra.