یکی از همتیمیهایتان از شما میخواهد جدول آماری یک صفحه وب را به پایتون بیاورید. HTML را با Requests دانلود کردهاید و soup.find("td").text نخستین خانه جدول را به شما داده است. حالا همه سطرها را لازم دارید، کلاسی را که برخی خانهها را سبز و برخی را قرمز میکند و پیوندهای صفحهبندی زیر جدول را. انتخابگر table > tbody > tr که از ابزارهای توسعهدهنده مرورگر کپی کردهاید هیچ چیزی برنمیگرداند. مسیر کلی از صفحه تا فایل را در استخراج داده از وبسایت آوردهایم؛ این راهنما به کتابخانهای میپردازد که HTML را میخواند.
در این نوشته سه تجزیهگر، متدهای find، find_all و select، انتخاب بر اساس کلاس، حرکت در درخت، خواندن متن و پیوندها، یک نمونه کامل روی جدولی تمرینی و pandas.read_html را همراه با خطاهای رایجش بررسی میکنیم. همه نمونهها در 24 سپتامبر 2026 با beautifulsoup4 4.15.0 و Python 3.13 اجرا شدند.
BeautifulSoup چیست؟
BeautifulSoup کتابخانهای در پایتون است که HTML و XML را، حتی با نشانهگذاری خراب، به درختی از اشیا تجزیه میکند که میتوانید در آن جستوجو کنید. هیچ درخواستی نمیفرستد. یک کلاینت HTTP مانند Requests یا HTTPX صفحه را دانلود میکند (مقایسه HTTPX، Requests و AIOHTTP) و BeautifulSoup روی چیزی کار میکند که آن کلاینت برمیگرداند.
نام بسته و نام import با هم فرق دارند. beautifulsoup4 را نصب میکنید و bs4 را import میکنید:
pip install beautifulsoup4 lxmlبسته bs4 در PyPI بستهای ساختگی (نسخه 0.0.2) است که فقط نام را نگه میدارد و beautifulsoup4 را نصب میکند. آموزشهایی که با from BeautifulSoup import BeautifulSoup آغاز میشوند برای BeautifulSoup 3 و Python 2 نوشته شدهاند و روی Python 3 اجرا نمیشوند. نسخه فعلی 4.15.0 است (beautifulsoup4 در PyPI) و مستندات رسمی همین نسخه را پوشش میدهد. مقایسه آن با Scrapy و Selenium را در Scrapy، BeautifulSoup یا Selenium؟ آوردهایم.
BeautifulSoup چگونه صفحه را به درخت تبدیل میکند؟
میان دانلود و نخستین جستوجوی شما پنج گام وجود دارد:
- کلاینت بایتها را دانلود میکند. Requests آنها را در
response.contentنگه میدارد و حدسی رمزگشاییشده را درresponse.textارائه میدهد. - BeautifulSoup رمزگذاری را پیدا میکند. زیرکتابخانهای به نام Unicode, Dammit تگ
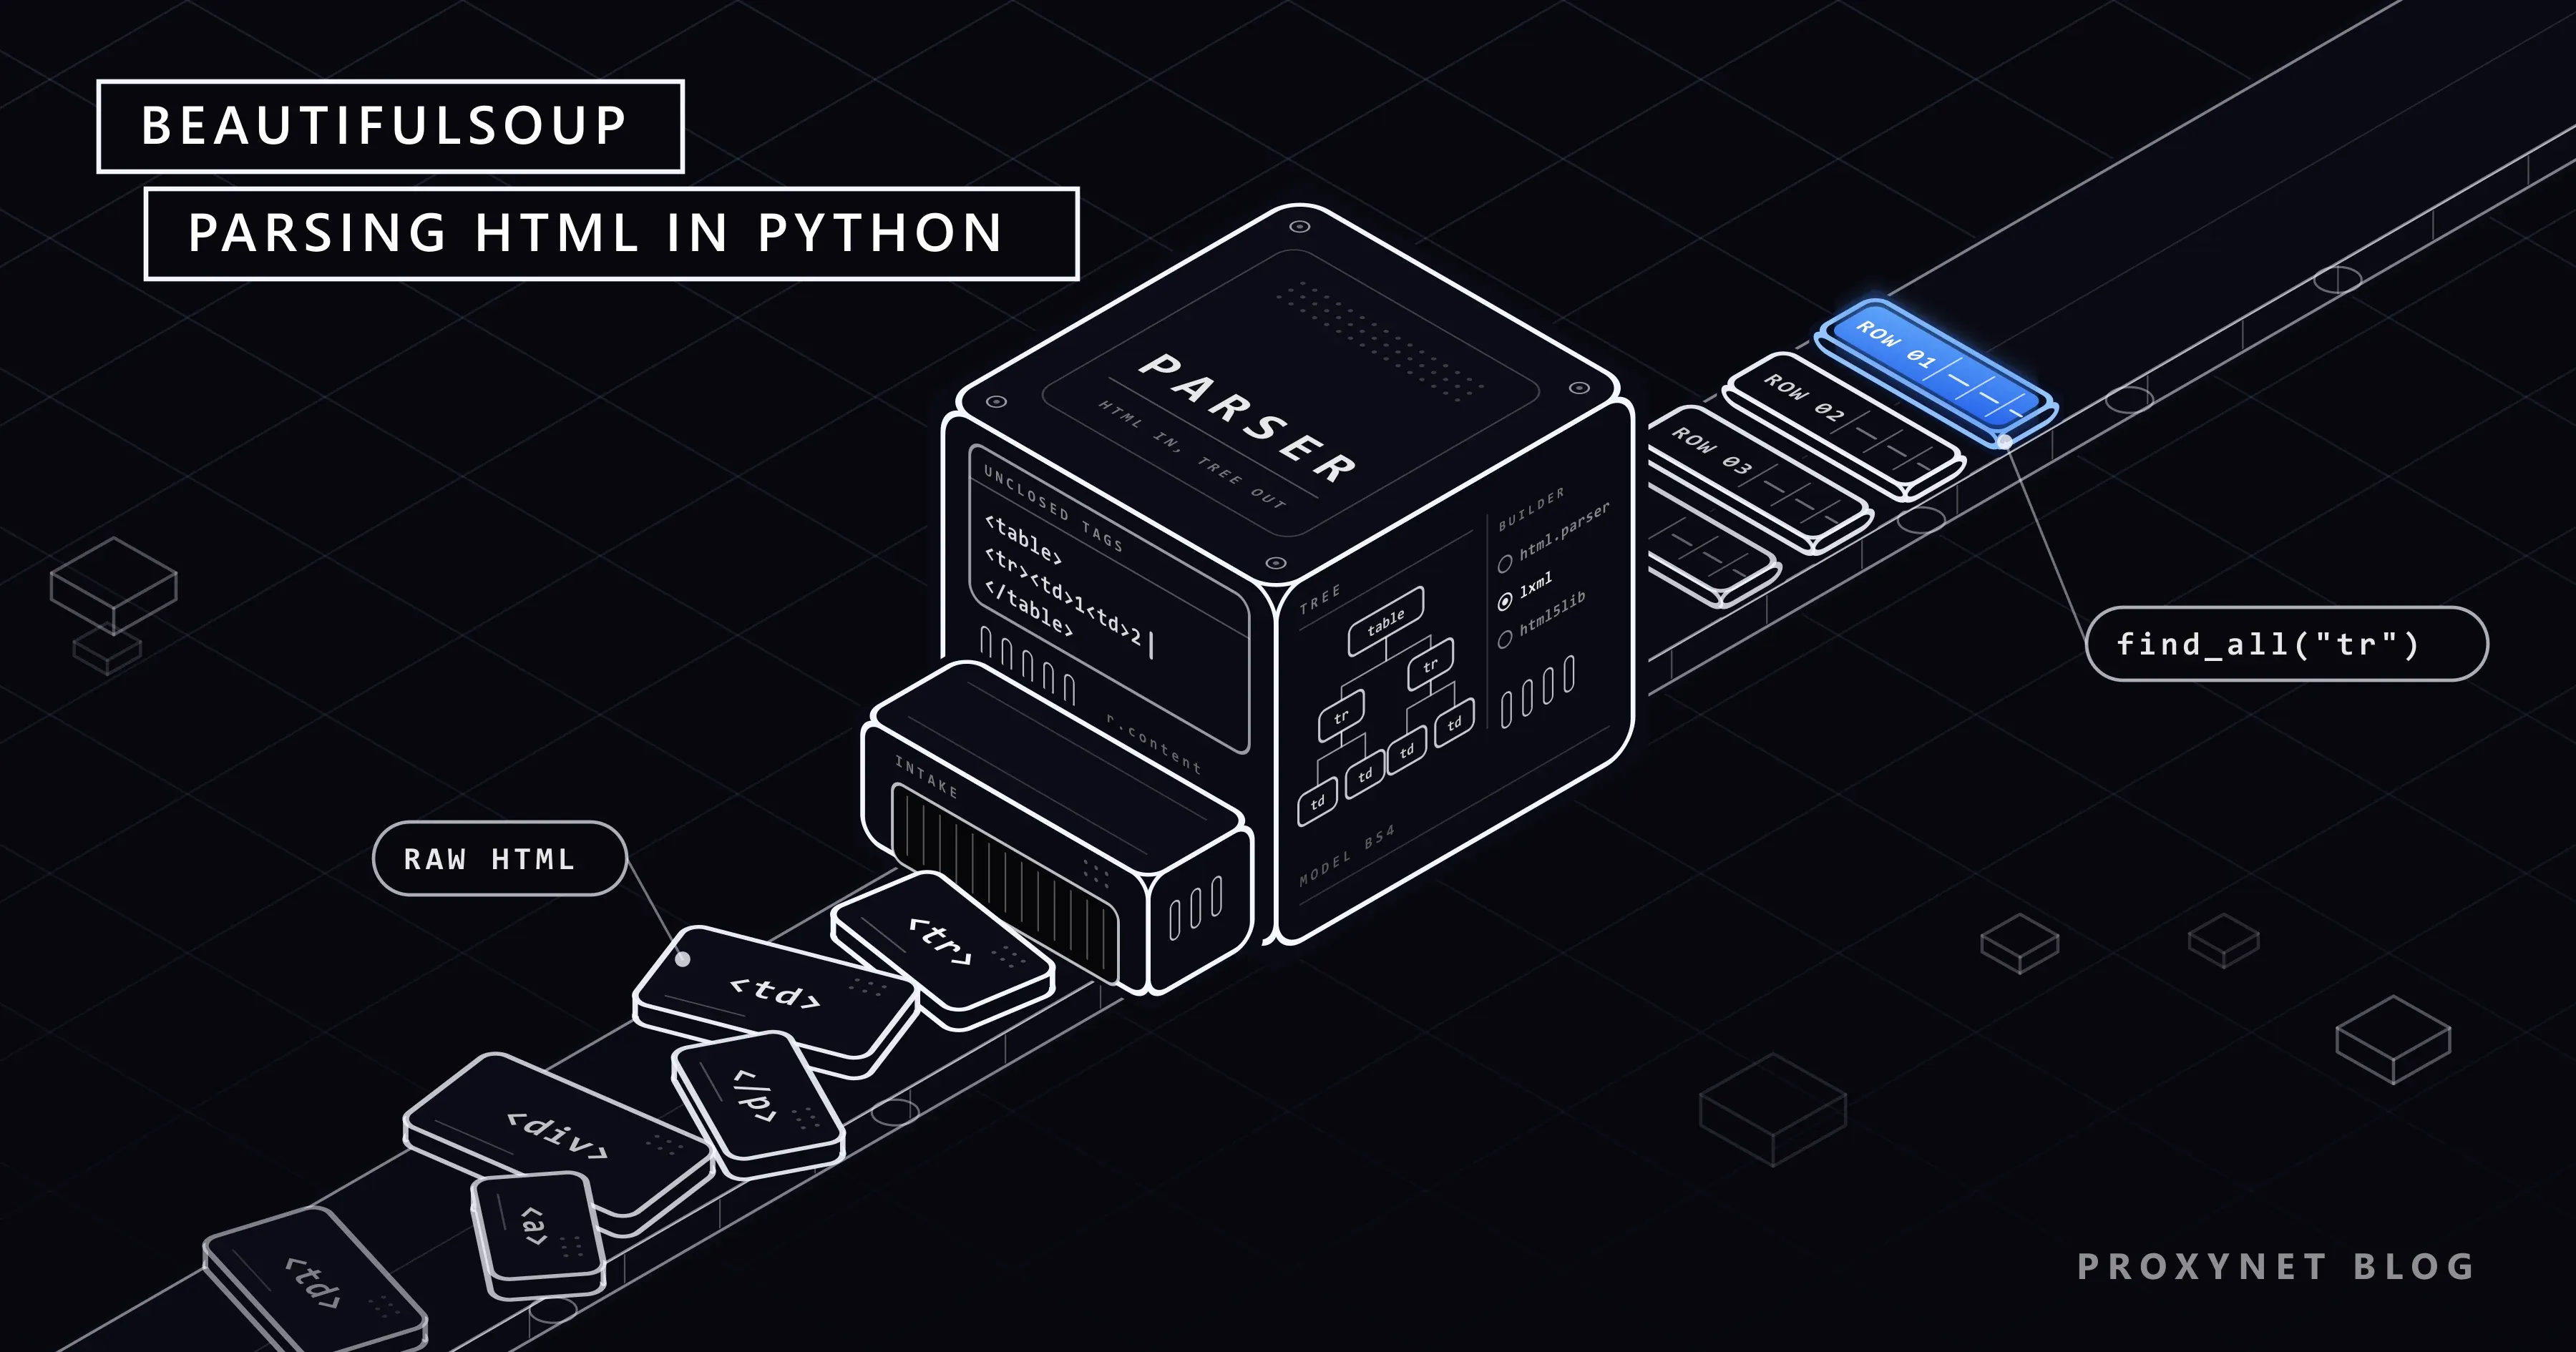
<meta charset>و نشانههای دیگر را میخواند و سپس بایتها را به یونیکد تبدیل میکند.response.contentرا بدهید، نهresponse.text: وقتی سرورtext/htmlرا بدون charset میفرستد، Requests رمزگذاری ISO-8859-1 را فرض میکند وéبهéتبدیل میشود. جزئیات را در خطاهای رمزگذاری یونیکد در پایتون آوردهایم. - تجزیهگر تگها را میخواند. متن را به عنصرها تبدیل میکند و تگهای بستهنشده را با قاعدههای خودش ترمیم میکند.
- نتیجه یک درخت است. هر عنصر به یک
Tagبا نام و ویژگیها تبدیل میشود و هر تکه متن به یکNavigableString. - متدهای جستوجو درخت را میپیمایند.
find،find_allوselectاین درخت را در حافظه میخوانند و هرگز سراغ شبکه نمیروند.
کدام تجزیهگر را انتخاب کنیم: html.parser، lxml یا html5lib؟
هر تجزیهگر نشانهگذاری خراب را به شیوه خودش ترمیم میکند. به هر سه یک تکه یکسان با خانههای بستهنشده دادیم:
from bs4 import BeautifulSoup

broken = "<table><tr><td>1<td>2</table>"
for parser in ("html.parser", "lxml", "html5lib"):
print(parser, BeautifulSoup(broken, parser))html.parser <table><tr><td>1<td>2</td></td></tr></table>
lxml <html><body><table><tr><td>1</td><td>2</td></tr></table></body></html>
html5lib <html><head></head><body><table><tbody><tr><td>1</td><td>2</td></tr></tbody></table></body></html>html.parser خانه دوم را درون خانه اول گذاشت، بنابراین row.find_all("td", recursive=False) بهجای دو خانه یک خانه پیدا میکند. lxml هر دو خانه را بست و تکه را درون <html><body> پیچید. html5lib همان درختی را ساخت که مرورگر میسازد، همراه با <tbody>.
| تجزیهگر | شیوه فراخوانی | نصب | تگهای بستهنشده | چه زمانی انتخاب کنیم |
|---|---|---|---|---|
| html.parser | BeautifulSoup(html, "html.parser") | همراه پایتون نصب است | ممکن است خانهای را درون خانه دیگر بگذارد | اسکریپتهای کوچک، وقتی نمیتوانید بسته نصب کنید |
| lxml | BeautifulSoup(html, "lxml") | pip install lxml (افزونه C) | خانهها را میبندد، <html><body> میافزاید | بیشتر کارهای اسکرپینگ؛ مستندات آن را بسیار سریع میداند |
| html5lib | BeautifulSoup(html, "html5lib") | pip install html5lib (پایتون خالص) | درخت مرورگر را میسازد، <tbody> میافزاید | صفحههای بهشدت خراب، یا وقتی درختی را میخواهید که مرورگر نشان میدهد؛ بسیار کند |
تجزیهگری که نصب نشده باشد خطای bs4.FeatureNotFound: Couldn't find a tree builder with the features you requested: html5lib میدهد. اگر نام تجزیهگر را ننویسید، BeautifulSoup از میان تجزیهگرهای نصبشده آنی را که خودش ترجیح میدهد برمیگزیند و هشدار GuessedAtParserWarning میدهد؛ به همین دلیل همان اسکریپت روی رایانهای که lxml ندارد ممکن است درخت دیگری بسازد.
تفاوت find، find_all و select چیست؟
چهار متد تقریباً همه جستوجوها را پوشش میدهند:
find(name, attrs)نخستین تگ منطبق را برمیگرداند، یاNone.find_all(name, attrs)فهرستی از همه موارد منطبق را برمیگرداند، یا فهرستی خالی.select(css)یک انتخابگر CSS میگیرد و فهرست برمیگرداند.select_one(css)نخستین مورد منطبق با انتخابگر CSS را برمیگرداند، یاNone.
متدهای CSS روی Soup Sieve کار میکنند که همراه beautifulsoup4 نصب میشود. وقتی هیچ موردی منطبق نباشد:
soup.find("td", class_="rank")        # None
soup.find_all("td", class_="rank")    # []
soup.select_one("td.rank")            # None
soup.select("td.rank")                # []

soup.find("td", class_="rank").get_text()
# AttributeError: 'NoneType' object has no attribute 'get_text'
این یکی از نخستین خطاهایی است که بیشتر افراد میبینند: find مقدار None برگرداند و فراخوانی بعدی شکست خورد. پیش از زنجیره کردن متدها، نتیجه را بررسی کنید:
cell = soup.find("td", class_="name")
name = cell.get_text(strip=True) if cell else None
limit=3 متد find_all را پس از سه مورد متوقف میکند و recursive=False فقط فرزندان مستقیم را جستوجو میکند. وقتی مسیر از چند سطح میگذرد، select کوتاهتر است، مانند table.table tr.team td.name. نحو انتخابگرها و اینکه چرا BeautifulSoup از XPath پشتیبانی نمیکند در انتخابگر CSS یا XPath: کدام برای اسکرپینگ؟ آمده است.
چگونه بر اساس کلاس، id و ویژگی انتخاب کنیم؟
class در پایتون کلمهای رزروشده است، بنابراین BeautifulSoup از class_ استفاده میکند. دام اینجاست که class چند مقدار دارد: td["class"] فهرستی مانند ['pct', 'text-success'] برمیگرداند. در صفحه تمرینی که پایینتر به کار میبریم، خانههای ستون Win % کلاس pct و خانههای ستون + / - کلاس diff دارند و هر کدام افزون بر آن text-success یا text-danger هم دارند. در یک صفحه 25 سطری این شمارشها را به دست آوردیم:
soup.find_all("td", class_="text-danger")       # 31 cells, from both columns
soup.find_all("td", class_="pct text-danger")   # 19 cells: matches the exact string
soup.find_all("td", class_="text-danger pct")   # 0 cells: same classes, other order
soup.select("td.pct.text-danger")               # 19 cells, in any order
یک کلاس در class_ با هر تگی منطبق میشود که آن کلاس را در کنار کلاسهای دیگر داشته باشد. رشتهای که فاصله دارد فقط با همان مقدار دقیق ویژگی منطبق میشود و وقتی صفحه ترتیب کلاسها را عوض کند، میشکند. برای دو کلاس یا بیشتر، select را با نقطه به کار ببرید. ویژگیهای دیگر بهصورت آرگومان کلیدی یا از راه attrs کار میکنند:
import re

soup.find("div", id="results")                     # by id
soup.find_all("a", href=True)                      # only links that have an href
soup.find("a", attrs={"aria-label": "Next"})       # names with a dash go in attrs
soup.find("th", string=re.compile("Wins"))         # by text
string="Wins" اینجا None برمیگرداند، چون string کل متن را مقایسه میکند و این خانه پیرامون کلمه شکست خط و فاصله دارد. عبارت باقاعده (regular expression) در هر جای متن منطبق میشود.
چگونه در درخت حرکت کنیم: والد، فرزندان و همنیاها؟
.parentیک سطح بالا میرود وfind_parent("table")آنقدر بالا میرود تا به یک جدول برسد..childrenفرزندان مستقیم را میدهد و.descendantsهمه گرههای زیرین را. یک سطر جدول تمرینی 9 خانه دارد، اما.childrenتعداد 19 مورد برگرداند: 10 مورد دیگر رشتههای فاصلهاند..next_siblingگره بعدی را برمیگرداند که در HTML تورفته معمولاً فاصله است.
name = soup.find("td", class_="name")
name.next_sibling                                   # '\n'
name.find_next_sibling("td").get_text(strip=True)   # '1990'
find_next_sibling("td") و find_previous_sibling("td") مستقیم به تگ بعدی یا قبلی میروند. همین متد جدولهای برچسب و مقدار را هم میخواند: th.find_next_sibling("td") مقدار کنار یک برچسب را میدهد.
چگونه متن و ویژگیها را بخوانیم: get_text، href و src؟
.text فاصلهها را نگه میدارد، بنابراین خانه نام تیم، نام را میان شکستهای خط و تورفتگی برمیگرداند. get_text(strip=True) آن را به 'Boston Bruins' کوتاه میکند. وقتی تگی تگهای دیگر را در بر دارد، جداکننده بیفزایید: برای <td>12<small>pts</small></td> فراخوانی get_text(strip=True) مقدار '12pts' و get_text(" ", strip=True) مقدار '12 pts' را برمیگرداند. .stripped_strings تکهها را یکییکی میدهد.
ویژگیها مانند دیکشنری خوانده میشوند. a["href"] وقتی تگ href نداشته باشد خطای KeyError میدهد؛ a.get("href") مقدار None برمیگرداند که در حلقه امنتر است. پیوندهای نسبی مانند /pages/forms/?page_num=2 با urllib.parse.urljoin(page_url, href) به آدرس کامل تبدیل میشوند و تصویر هم به همین شیوه با img.get("src") کار میکند. تصویرهایی که با تأخیر بارگذاری میشوند (lazy loading) و srcset را در دانلود همه تصویرهای یک وبسایت بررسی کردهایم.
نمونه کامل: خواندن سطربهسطر یک جدول HTML
هدف، جدول هاکی در scrapethissite.com/pages/forms است که عنوان صفحهاش سایت را محیطی عمومی برای یادگیری وب اسکرپینگ معرفی میکند. فایل robots.txt آن فقط /lessons/ و /faq/ را منع میکند و اسکریپت نخست همین فایل را بررسی میکند (شیوه خواندن robots.txt). اسکریپت 25 سطر یک صفحه را میخواند، کلاس خانه Win % را به فیلدی درست یا نادرست (true/false) تبدیل میکند و پیوندهای صفحهها را جمع میکند.
"""Read one page of a practice table with Requests and BeautifulSoup."""
import json
import os
import sys
from urllib.parse import urljoin
from urllib.robotparser import RobotFileParser

import requests
from bs4 import BeautifulSoup

URL = "https://www.scrapethissite.com/pages/forms/"
USER_AGENT = "hockey-table-demo/1.0 (contact: you@example.com)"

# Optional: PROXY_URL=http://user:pass@pr.proxynet.io:8000
proxy = os.environ.get("PROXY_URL")

session = requests.Session()
session.headers["User-Agent"] = USER_AGENT
if proxy:
    session.proxies = {"http": proxy, "https": proxy}

# Check robots.txt once before the first request
robots = RobotFileParser()
robots.parse(session.get(urljoin(URL, "/robots.txt"), timeout=(5, 20)).text.splitlines())
if not robots.can_fetch(USER_AGENT, URL):
    sys.exit("robots.txt does not allow this page")

response = session.get(URL, timeout=(5, 20))
response.raise_for_status()

# Give BeautifulSoup the bytes and name the parser
soup = BeautifulSoup(response.content, "lxml")

table = soup.select_one("table.table")
if table is None:
    sys.exit("No table.table on the page: the layout changed or the data comes from JavaScript")

headers = [th.get_text(" ", strip=True) for th in table.find("tr").find_all("th")]

teams = []
for row in table.find_all("tr", class_="team"):
    record = {}
    for td in row.find_all("td"):
        key = td["class"][0]              # "name", "year", "wins", "pct", "diff" ...
        record[key] = td.get_text(strip=True)
    # The site colours Win % green or red; the colour lives only in the class
    pct_classes = row.find("td", class_="pct").get("class", [])
    record["above_500"] = "text-success" in pct_classes
    teams.append(record)

# Page links: relative hrefs become full URLs, duplicates removed, order kept
page_links = list(dict.fromkeys(
    urljoin(URL, a["href"]) for a in soup.select("ul.pagination a[href]")
))

print("columns:", headers)
print("rows:", len(teams), "| page links:", len(page_links))
for team in teams[:3]:
    print(json.dumps(team, ensure_ascii=False))
print("last page:", page_links[-1])
این اسکریپت را با beautifulsoup4 4.15.0، lxml 6.1.3 و Requests 2.34.2 اجرا کردیم، یک بار مستقیم و یک بار از راه یک پروکسی آزمایشی محلی که در PROXY_URL تعریف شده بود. هر دو اجرا همین سطرها را چاپ کردند:
columns: ['Team Name', 'Year', 'Wins', 'Losses', 'OT Losses', 'Win %', 'Goals For (GF)', 'Goals Against (GA)', '+ / -']
rows: 25 | page links: 24
{"name": "Boston Bruins", "year": "1990", "wins": "44", "losses": "24", "ot-losses": "", "pct": "0.55", "gf": "299", "ga": "264", "diff": "35", "above_500": true}
{"name": "Buffalo Sabres", "year": "1990", "wins": "31", "losses": "30", "ot-losses": "", "pct": "0.388", "gf": "292", "ga": "278", "diff": "14", "above_500": false}
{"name": "Calgary Flames", "year": "1990", "wins": "46", "losses": "26", "ot-losses": "", "pct": "0.575", "gf": "344", "ga": "263", "diff": "81", "above_500": true}
last page: https://www.scrapethissite.com/pages/forms/?page_num=24
سطر سرتیتر کلاسی ندارد، بنابراین اسکریپت نخستین <tr> را برای نام ستونها و tr.team را برای داده برمیدارد. نخستین کلاس هر خانه (name، wins، ot-losses) کلید دیکشنری میشود و همین کار کد را از ترتیب ستونها مستقل نگه میدارد. خانه خالی ستون OT Losses بهصورت رشته خالی برمیگردد، نه None. اینجا رنگ فقط عدد را تکرار میکند، اما در برخی سایتها، مانند فروشگاههایی که کالای ناموجود را با یک کلاس علامت میزنند، کلاس تنها جایی است که این واقعیت در آن دیده میشود. بلوک صفحهبندی 25 پیوند دارد، چون فلش «Next» آدرس صفحه 1 را تکرار میکند؛ dict.fromkeys مورد تکراری را حذف میکند و ترتیب را نگه میدارد.
User-Agent بهجای تظاهر به مرورگر بودن، نام اسکریپت را میگوید و یک آدرس تماس میدهد (User-Agent چیست؟). timeout=(5, 20) اگر پس از 5 ثانیه اتصالی برقرار نشود یا 20 ثانیه دادهای نرسد دست میکشد و raise_for_status() پیش از آنکه صفحه خطا تجزیه شود، کار را متوقف میکند. رمز نادرست پروکسی خطای ProxyError میدهد که در پیامش «Max retries exceeded» و «407 Proxy Authentication Required» آمده است (خطای Max Retries Exceeded With URL). فقط وقتی به پروکسی نیاز دارید که حجم کار بالا برود یا صفحهها را همانطور بخواهید که بازدیدکنندگان کشوری دیگر میبینند؛ در آن صورت یک پروکسی مسکونی در همان خط PROXY_URL جا میگیرد.
اسکریپت عمداً در یک صفحه متوقف میشود. پیمودن هر 24 صفحه با مکث میان درخواستها را در اسکرپ کردن فهرستهای صفحهبندیشده آوردهایم، تلاش دوباره پس از 429 یا 503 را در کدهای وضعیت HTTP در وب اسکرپینگ، اجرای موازی درخواستها را در همروندی و موازیسازی و عوض کردن نقطه خروج میان درخواستها را در چرخاندن پروکسی در پایتون.
چگونه جدول را با read_html در pandas بخوانیم؟
وقتی صفحه یک <table> درست دارد و فقط مقدارها را لازم دارید، pandas آن را با یک فراخوانی میخواند. pandas.read_html فقط به عنصرهای <table>، <tr>، <th> و <td> نگاه میکند و همیشه فهرستی از DataFrameها برمیگرداند، یکی برای هر جدولی که پیدا کند. ما از pandas 3.0.6 استفاده کردیم:
import io
import os

import pandas as pd
import requests

URL = "https://www.scrapethissite.com/pages/forms/"

session = requests.Session()
session.headers["User-Agent"] = "hockey-table-demo/1.0 (contact: you@example.com)"
if os.environ.get("PROXY_URL"):
    session.proxies = {"http": os.environ["PROXY_URL"], "https": os.environ["PROXY_URL"]}

response = session.get(URL, timeout=(5, 20))
response.raise_for_status()

# pandas 3: wrap the HTML in StringIO, a plain string is read as a file path
tables = pd.read_html(io.StringIO(response.text), attrs={"class": "table"})
df = tables[0]
print(len(tables), df.shape)
print(df[["Team Name", "Year", "Wins", "OT Losses", "Win %"]].head(3))1 (25, 9)
Team Name Year Wins OT Losses Win %
0 Boston Bruins 1990 44 NaN 0.550
1 Buffalo Sabres 1990 31 NaN 0.388
2 Calgary Flames 1990 46 NaN 0.575سرور در هدر Content-Type خود UTF-8 را اعلام میکند، بنابراین response.text اینجا درست رمزگشایی میشود. pandas عددها را هم تبدیل کرد: Year و Wins به عدد صحیح، Win % به عدد اعشاری و ستون خالی OT Losses به NaN. پارامتر attrs جدول را بر اساس ویژگیهایش انتخاب میکند و match بر اساس رشته یا عبارت باقاعدهای که در متن جدول باشد. pandas بهطور پیشفرض با lxml تجزیه میکند و اگر این کار شکست بخورد، به BeautifulSoup همراه با html5lib برمیگردد.
سه خطا بارها و بارها پیش میآیند:
- خطای فایل وقتی متن HTML را میدهید. از pandas 3.0 به بعد
read_htmlدیگر رشته HTML را مستقیم نمیپذیرد؛ متن را درio.StringIOبپیچید (یادداشتهای انتشار pandas 3.0.0). رشته ساده مسیر فایل تلقی میشود و ما خطایFileNotFoundErrorگرفتیم که آغاز صفحه را نقل میکرد. ValueError: No tables found. جدول بعداً با جاوااسکریپت میرسد، صفحه شبکه خود را با عنصرهای<div>میکشد، یا متنmatchشما در هیچ جدولی نیست (No tables found matching pattern 'Points'). اگر html5lib نصب نباشد، تجزیهگر جایگزین زودتر شکست میخورد و خطایImportErrorمیگیرید که از شما میخواهد html5lib را نصب کنید.HTTP Error 403: Forbiddenوقتی URL را میدهید. در این حالت pandas با urllib دانلود میکند که User-Agent پیشفرضشPython-urllib/3.13است و برخی سایتها آن را رد میکنند؛ سرور آزمایشی محلی ما دقیقاً همین رشته را ثبت کرد. صفحه را مانند بالا خودتان دانلود کنید، یا نام صادقانه ربات خود را از راهstorage_options={"User-Agent": "..."}بدهید. User-Agent مرورگر را کپی نکنید: RFC 9110 یادآوری میکند کلاینتی که خود را به جای کلاینت دیگری جا بزند ممکن است پاسخهایی را دریافت کند که برای آن کلاینت دیگر در نظر گرفته شدهاند.
pandas فقط مقدارها را برمیگرداند. extract_links="body" پیوند هر خانه را میافزاید اما کلاسها را نه، بنابراین برای رنگ ستون Win % که بالاتر دیدیم باید به BeautifulSoup برگردید.
کاربردها
- قیمت رقبا: بسیاری از صفحههای محصول قیمت خود را در یک تگ
<script>از نوع JSON-LD نگه میدارند کهfind_all("script", type="application/ld+json")آن را میخواند (رصد قیمت رقبا). - ورود با حساب خودتان: فرم ورود اغلب یک فیلد پنهان CSRF دارد که پیش از ارسال فرم آن را با
find("input", attrs={"name": "csrf_token"})میخوانید (نشست و کوکی در پایتون). - دنبال کردن پیوندهای صفحهبندی:
select_one("a[rel=next]")یا یک بلوک صفحهبندی به خزنده میگوید صفحه بعد کجاست (اسکرپ کردن فهرستهای صفحهبندیشده). - اسکرپینگ در برابر خزش: BeautifulSoup گام استخراج است؛ خزنده بخشی را میافزاید که صفحهها را کشف میکند (وب اسکرپینگ و خزش وب).
- جمعآوری بزرگ و زمانبندیشده: هزاران صفحه در روز به صف، کنترل نرخ و نقطههای خروج در چند کشور نیاز دارد (استخراج داده).
اشتباهات رایج
- ننوشتن نام تجزیهگر. نتیجه به چیزی بستگی دارد که روی هر رایانه نصب است و هشدار
GuessedAtParserWarningمیگیرید. - زنجیره کردن متد روی
findبدون بررسی. عنصری که وجود ندارد سه خط بعد به خطای'NoneType' object has no attribute ...تبدیل میشود. - کپی کردن انتخابگری که
tbodyدارد از ابزارهای توسعهدهنده. مرورگرها<tbody>را میافزایند، چون HTML به نویسندگان صفحه اجازه میدهد تگهای آن را ننویسند (استاندارد WHATWG HTML، عنصر tbody). در صفحه تمرینی،table > tbody > trبا html.parser و lxml هیچ سطری پیدا نکرد و با html5lib تعداد 26 سطر، در حالی کهtable tr.teamبا هر سه تجزیهگر 25 سطر پیدا کرد. - جستوجوی چند کلاس به شکل یک رشته.
class_="pct text-danger"وقتی صفحه کلاسها را با ترتیب دیگری بنویسد شکست میخورد؛select("td.pct.text-danger")را به کار ببرید. - انتظار اینکه
.next_siblingیک تگ باشد. در HTML تورفته معمولاً یک رشته فاصله است؛find_next_sibling("td")را به کار ببرید. - دادن
response.text. اگر هدر charset نداشته باشد، Requests رمزگذاری ISO-8859-1 را حدس میزند؛response.contentرا بدهید. - آغاز حلقه پیش از خواندن
robots.txt. بررسی کنید سایت چه چیزی را مجاز میداند و پیش از درخواست بیش از یک صفحه، مکثی میان درخواستها تعیین کنید.
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
صفحه یک <table> تمیز دارد و DataFrame میخواهید | pandas.read_html با io.StringIO، و attrs یا match برای انتخاب جدول |
| کلاس، رنگ یا پیوند یک خانه را هم لازم دارید | BeautifulSoup: سطرها با find_all("tr")، ویژگیها با td.get("class") و a.get("href") |
| نمیتوانید بسته اضافه نصب کنید | html.parser، و نتیجه را در صفحههایی که تگ بستهنشده دارند بررسی کنید |
| سرعت و تحمل جدولهای خراب | lxml، انتخاب پیشفرض برای بیشتر کارها |
| درخت با آنچه مرورگر نشان میدهد فرق دارد | html5lib را بیازمایید و tbody را از انتخابگر خود حذف کنید |
| داده از راه جاوااسکریپت میرسد | نخست درخواست JSON را پیدا کنید، سپس مرورگر بدون رابط گرافیکی (صفحههای ایستا و پویا) |
| هزاران صفحه با صف، تلاش دوباره و پروکسی | Scrapy (Scrapy با پروکسی) و یک پروکسی چرخشی |
پرسشهای متداول
آیا BeautifulSoup صفحههای وب را دانلود میکند؟
نه. BeautifulSoup فقط HTML را تجزیه میکند که شما به آن میدهید. یک کلاینت HTTP مانند Requests یا HTTPX صفحه را دانلود میکند و شما response.content را همراه نام یک تجزیهگر به BeautifulSoup میدهید. جاوااسکریپت را هم اجرا نمیکند.
تفاوت find و find_all چیست؟
find نخستین تگ منطبق یا None را برمیگرداند؛ find_all فهرستی از همه موارد منطبق برمیگرداند که اگر چیزی پیدا نشود خالی است. select_one و select همین کار را با انتخابگر CSS انجام میدهند. پیش از فراخوانی متدی روی نتیجه find، آن را بررسی کنید.
کدام تجزیهگر برای BeautifulSoup مناسبتر است؟
lxml برای بیشتر کارها مناسب است: سریع است و تگهای بستهنشده را به شکلی معقول میبندد. وقتی نمیتوانید بسته نصب کنید html.parser را به کار ببرید و وقتی درخت مرورگر را لازم دارید و کندی آن را میپذیرید، html5lib را. نام تجزیهگر را همیشه در فراخوانی بنویسید.
آیا BeautifulSoup محتوایی را که با جاوااسکریپت بارگذاری میشود میخواند؟
نه. فقط HTML را میبیند که سرور برگردانده است و دادهای که اسکریپتی بعداً میافزاید در آن نیست. در زبانه Network مرورگر، درخواست JSON را که داده را میآورد پیدا کنید، یا جایی که سایت اجازه میدهد از مرورگر بدون رابط گرافیکی استفاده کنید (صفحههای ایستا و پویا در وب اسکرپینگ).
چرا read_html در pandas میگوید «No tables found»؟
جدول را جاوااسکریپت میسازد، صفحه شبکه خود را بهجای <table> با عنصرهای <div> میکشد، یا مقدار match یا attrs شما با هیچ جدولی جور نیست. از pandas 3.0 به بعد این را هم بررسی کنید که HTML را درون io.StringIO میدهید؛ رشته ساده مسیر فایل تلقی میشود.
آیا pip install bs4 همان pip install beautifulsoup4 است؟
در عمل بله، اما نام واقعی را به کار ببرید. bs4 در PyPI بستهای ساختگی است که فقط beautifulsoup4 را نصب میکند. beautifulsoup4 را نصب کنید و در کد خود bs4 را import کنید: from bs4 import BeautifulSoup.
خلاصه
BeautifulSoup متن HTML را به درخت تجزیه میکند؛ صفحه دانلود نمیکند و جاوااسکریپت اجرا نمیکند. در هر فراخوانی نام تجزیهگر را بنویسید و بدانید find در جایی که find_all فهرست خالی برمیگرداند، None برمیگرداند. وقتی چند کلاس را همزمان تطبیق میدهید select را به کار ببرید و وقتی صفحه جدولی تمیز دارد، نخست pandas.read_html را بیازمایید. وقتی یک صفحه به هزاران صفحه در روز تبدیل میشود، ببینید پروکسیهای استخراج داده ما چگونه این حجم اضافه را جابهجا میکنند.