Bir ekip arkadaşınız, bir web sayfasındaki istatistik tablosunu Python'a almanızı istiyor. HTML'i Requests ile indirdiniz ve soup.find("td").text size ilk hücreyi verdi. Şimdi bütün satırlar, bazı hücreleri yeşile, bazılarını kırmızıya boyayan sınıf ve tablonun altındaki sayfa linkleri gerekiyor. Tarayıcının geliştirici araçlarından kopyaladığınız table > tbody > tr seçicisi ise hiçbir şey döndürmüyor. Bir sayfadan dosyaya uzanan genel yolu Web Sitesinden Veri Çekme yazısında anlattık; bu rehber HTML'i okuyan kütüphaneye odaklanıyor.
Üç parser'ı (HTML metnini okuyup öğelere ayıran ayrıştırıcı), find, find_all ve select yöntemlerini, sınıfa göre seçimi, ağaçta gezinmeyi, metin ve link okumayı, bir alıştırma tablosu üzerinde tam bir örneği, son olarak da pandas.read_html fonksiyonunu ve sık görülen hatalarını ele alıyoruz. Bütün örnekleri 24 Eylül 2026'da beautifulsoup4 4.15.0 ve Python 3.13 ile çalıştırdık.
BeautifulSoup nedir?
BeautifulSoup, HTML ve XML belgelerini, bozuk yazılmış olanlar dahil, aranabilir nesnelerden oluşan bir ağaca çeviren Python kütüphanesidir. Kendisi istek göndermez. Sayfayı Requests ya da HTTPX gibi bir HTTP istemcisi indirir (HTTPX, Requests ve AIOHTTP), BeautifulSoup da bu istemcinin döndürdüğü içerikle çalışır.
Paket adı ile içe aktarılan ad farklıdır. Kurduğunuz paket beautifulsoup4, içe aktardığınız ad bs4:
pip install beautifulsoup4 lxmlPyPI'daki bs4 paketi, adı tutmak için konmuş boş bir pakettir (sürüm 0.0.2) ve yalnızca beautifulsoup4'ü kurar. from BeautifulSoup import BeautifulSoup satırıyla başlayan eski rehberler BeautifulSoup 3 ve Python 2 için yazılmıştır, Python 3'te çalışmaz. Güncel sürüm 4.15.0'dır (PyPI'da beautifulsoup4) ve resmi dokümantasyon bu sürümü anlatır. Scrapy ve Selenium ile karşılaştırması, Scrapy yazımızın Scrapy mi, BeautifulSoup mu, Selenium mu? bölümünde.
BeautifulSoup bir sayfayı nasıl ağaca çevirir?
İndirme ile ilk aramanız arasında beş adım var:
- İstemci baytları indirir. Requests bunları
response.contentiçinde tutar;response.textise kodlamayı tahmin ederek metne çevrilmiş hâlidir. - BeautifulSoup kodlamayı bulur. Unicode, Dammit adlı bir alt kütüphane
<meta charset>etiketini ve başka ipuçlarını okur, ardından baytları Unicode'a çevirir.response.textdeğilresponse.contentverin: sunucutext/htmlgönderip charset belirtmediğinde Requests ISO-8859-1 varsayar veüharfiüolarak görünür. Ayrıntılar Python Türkçe karakter sorunu yazısında. - Parser etiketleri okur. Metni öğelere çevirir ve kapanmamış etiketleri kendi kurallarına göre onarır.
- Sonuç bir ağaçtır. Her öğe, adı ve öznitelikleri olan bir
Tagolur; her metin parçası birNavigableString. - Arama yöntemleri ağacı dolaşır.
find,find_allveselectbellekteki bu ağacı okur, ağa hiç çıkmaz.
Hangi parser seçilmeli: html.parser, lxml mi, html5lib mi?
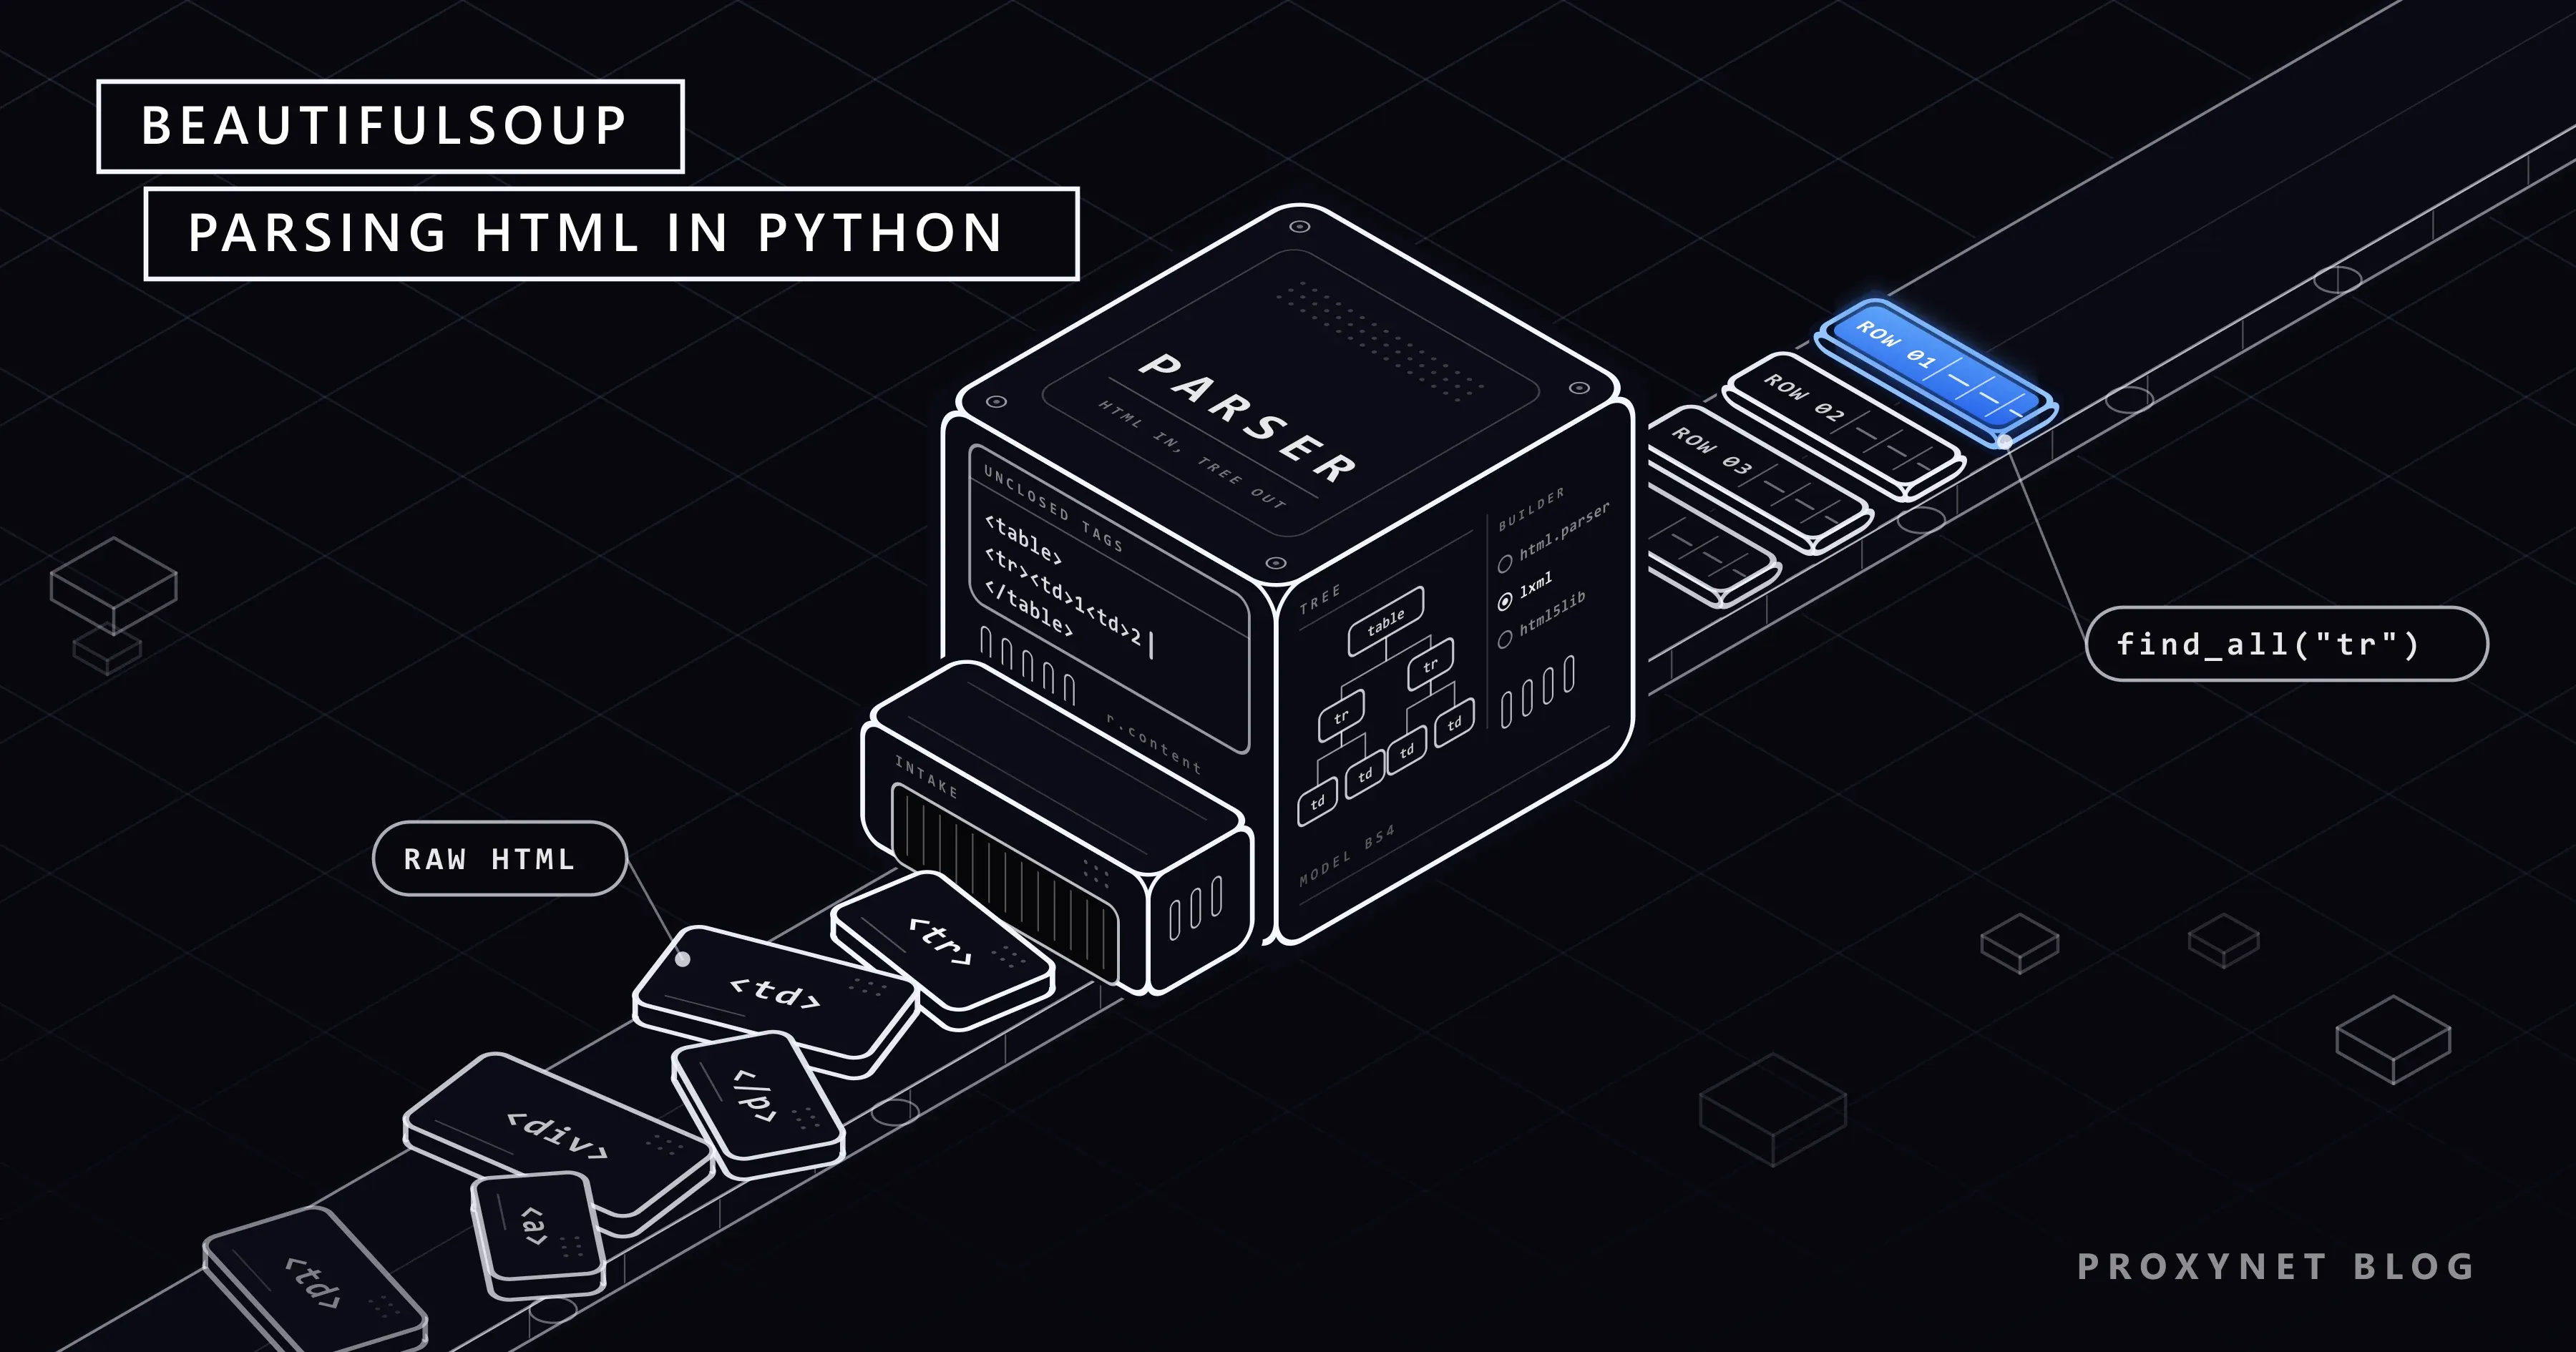
Her parser bozuk HTML'i kendi yöntemiyle onarır. Üçüne de kapanmamış hücreler içeren aynı parçayı verdik:
from bs4 import BeautifulSoup

broken = "<table><tr><td>1<td>2</table>"
for parser in ("html.parser", "lxml", "html5lib"):
print(parser, BeautifulSoup(broken, parser))html.parser <table><tr><td>1<td>2</td></td></tr></table>
lxml <html><body><table><tr><td>1</td><td>2</td></tr></table></body></html>
html5lib <html><head></head><body><table><tbody><tr><td>1</td><td>2</td></tr></tbody></table></body></html>html.parser ikinci hücreyi birincinin içine yerleştirdi; bu yüzden row.find_all("td", recursive=False) iki yerine tek hücre bulur. lxml iki hücreyi de kapattı ve parçayı <html><body> içine sardı. html5lib ise <tbody> dahil, bir tarayıcının kuracağı ağacı kurdu.
| Parser | Nasıl çağrılır | Kurulum | Kapanmamış etiketler | Ne zaman seçilir |
|---|---|---|---|---|
| html.parser | BeautifulSoup(html, "html.parser") | Python ile birlikte gelir | Bir hücreyi diğerinin içine yerleştirebilir | Paket kuramadığınız küçük betikler |
| lxml | BeautifulSoup(html, "lxml") | pip install lxml (C eklentisi) | Hücreleri kapatır, <html><body> ekler | Çoğu scraping (veri kazıma) işi; resmi dokümantasyona göre çok hızlıdır |
| html5lib | BeautifulSoup(html, "html5lib") | pip install html5lib (saf Python) | Tarayıcının ağacını kurar, <tbody> ekler | Çok bozuk sayfalar ya da tarayıcının gösterdiği ağaç gerektiğinde; çok yavaştır |
Kurulu olmayan bir parser bs4.FeatureNotFound: Couldn't find a tree builder with the features you requested: html5lib hatası verir. Parser adı yazılmazsa BeautifulSoup kurulu olanlar arasından en uygun gördüğünü seçer ve GuessedAtParserWarning uyarısı verir; bu yüzden aynı betik, lxml kurulu olmayan bir makinede farklı bir ağaç kurabilir.
find, find_all ve select arasındaki fark nedir?
Aramaların neredeyse tamamı dört yöntemle yapılır:
find(name, attrs)eşleşen ilk etiketi ya daNonedöndürür.find_all(name, attrs)bütün eşleşmelerin listesini ya da boş bir liste döndürür.select(css)bir CSS seçicisi alır ve liste döndürür.select_one(css)CSS seçicisinin ilk eşleşmesini ya daNonedöndürür.
CSS yöntemleri, beautifulsoup4 ile birlikte kurulan Soup Sieve üzerinde çalışır. Hiçbir şey eşleşmediğinde sonuç şöyledir:
soup.find("td", class_="rank")        # None
soup.find_all("td", class_="rank")    # []
soup.select_one("td.rank")            # None
soup.select("td.rank")                # []

soup.find("td", class_="rank").get_text()
# AttributeError: 'NoneType' object has no attribute 'get_text'
Yeni başlayanların sık aldığı ilk hata budur: find None döndürdü ve sonraki çağrı çöktü. Zincirlemeden önce kontrol edin:
cell = soup.find("td", class_="name")
name = cell.get_text(strip=True) if cell else Nonelimit=3, find_all'u üç eşleşmeden sonra durdurur; recursive=False yalnızca doğrudan alt öğelerde arar. Yol birkaç seviyeden geçiyorsa select daha kısa yazılır, örneğin table.table tr.team td.name. Seçici sözdizimini ve BeautifulSoup'ta neden XPath olmadığını CSS Selector ve XPath yazısında anlattık.
Sınıf, id ve özniteliğe göre nasıl seçilir?
class Python'da bir anahtar sözcük olduğu için BeautifulSoup class_ kullanır. Tuzak şurada: class birden fazla değer taşır ve td["class"], ['pct', 'text-success'] gibi bir liste döndürür. Aşağıda kullandığımız alıştırma sayfasında Win % hücreleri pct, + / - hücreleri diff sınıfını taşır; her birinin yanında ayrıca text-success ya da text-danger bulunur. 25 satırlık tek bir sayfada şunları saydık:
soup.find_all("td", class_="text-danger")       # 31 hücre, iki sütundan
soup.find_all("td", class_="pct text-danger")   # 19 hücre: dizeyle birebir eşleşir
soup.find_all("td", class_="text-danger pct")   # 0 hücre: aynı sınıflar, farklı sıra
soup.select("td.pct.text-danger")               # 19 hücre, sıra fark etmez
class_ içine tek bir sınıf yazarsanız, o sınıfı başka sınıflarla birlikte taşıyan her etiket eşleşir. Boşluk içeren bir dize ise yalnızca özniteliğin tam o değeriyle eşleşir ve sayfa sınıfların sırasını değiştirdiğinde bozulur. İki ya da daha fazla sınıf için noktalı yazımla select kullanın. Diğer öznitelikler isimli argüman olarak ya da attrs üzerinden çalışır:
import re

soup.find("div", id="results")                     # id ile
soup.find_all("a", href=True)                      # yalnızca href'i olan linkler
soup.find("a", attrs={"aria-label": "Next"})       # tire içeren adlar attrs'a yazılır
soup.find("th", string=re.compile("Wins"))         # metne göre
string="Wins" burada None döndürür, çünkü string metnin tamamını karşılaştırır ve hücrede kelimenin çevresinde satır sonları ve boşluklar vardır. Düzenli ifade (regex) ise metnin herhangi bir yerinde eşleşir.
Ağaçta nasıl gezinilir: parent, children ve sibling'ler
.parentbir seviye yukarı çıkar,find_parent("table")ise bir tabloya ulaşana kadar yukarı tırmanır..childrendoğrudan alt öğeleri,.descendantsaltındaki her düğümü verir. Alıştırma tablosundaki bir satırda 9 hücre var, ama.children19 öğe döndürdü: kalan 10 tanesi boşluk dizeleri..next_siblingbir sonraki düğümü döndürür; girintili HTML'de bu çoğunlukla boşluktur.
name = soup.find("td", class_="name")
name.next_sibling                                   # '\n'
name.find_next_sibling("td").get_text(strip=True)   # '1990'
find_next_sibling("td") ve find_previous_sibling("td") bir sonraki ya da önceki etikete atlar. Başlık ve değer çiftlerinden oluşan tablolar da aynı yöntemle okunur: th.find_next_sibling("td") bir başlık hücresinin yanındaki değeri verir.
Metin ve öznitelikler nasıl okunur: get_text, href ve src
.text boşlukları korur; bu yüzden takım hücresinde ad, satır sonları ve girintiyle sarılı olarak gelir. get_text(strip=True) bunu 'Boston Bruins' hâline getirir. Bir etiket başka etiketler içeriyorsa ayırıcı ekleyin: <td>12<small>pts</small></td> için get_text(strip=True) '12pts', get_text(" ", strip=True) ise '12 pts' döndürür. .stripped_strings parçaları tek tek verir.
Öznitelikler bir sözlük gibi okunur. Etiketin href'i yoksa a["href"] bir KeyError fırlatır; a.get("href") ise None döndürür ve döngü içinde daha güvenlidir. /pages/forms/?page_num=2 gibi göreli linkler urllib.parse.urljoin(page_url, href) ile tam adrese dönüşür; bir görsel de img.get("src") ile aynı şekilde okunur. Sonradan yüklenen (lazy loading) görselleri ve srcset özniteliğini Sayfadaki Tüm Resimleri İndirme yazısında anlattık.
Tam örnek: HTML tablosunu satır satır okumak
Hedef, scrapethissite.com/pages/forms adresindeki hokey tablosu. Sayfanın başlığı siteyi, web scraping öğrenmek için herkese açık bir deneme alanı olarak tanıtıyor. robots.txt dosyası yalnızca /lessons/ ve /faq/ yollarını yasaklıyor ve betik işe bunu kontrol ederek başlıyor (robots.txt nasıl okunur). Betik tek sayfadaki 25 satırı okuyor, Win % hücresinin sınıfını true/false değerli bir alana çeviriyor ve sayfa linklerini topluyor.
"""Bir alıştırma tablosunun tek sayfasını Requests ve BeautifulSoup ile okur."""
import json
import os
import sys
from urllib.parse import urljoin
from urllib.robotparser import RobotFileParser

import requests
from bs4 import BeautifulSoup

URL = "https://www.scrapethissite.com/pages/forms/"
USER_AGENT = "hockey-table-demo/1.0 (contact: you@example.com)"

# İsteğe bağlı: PROXY_URL=http://user:pass@pr.proxynet.io:8000
proxy = os.environ.get("PROXY_URL")

session = requests.Session()
session.headers["User-Agent"] = USER_AGENT
if proxy:
    session.proxies = {"http": proxy, "https": proxy}

# İlk istekten önce robots.txt'yi bir kez kontrol et
robots = RobotFileParser()
robots.parse(session.get(urljoin(URL, "/robots.txt"), timeout=(5, 20)).text.splitlines())
if not robots.can_fetch(USER_AGENT, URL):
    sys.exit("robots.txt does not allow this page")

response = session.get(URL, timeout=(5, 20))
response.raise_for_status()

# BeautifulSoup'a baytları ver ve parser'ı adıyla belirt
soup = BeautifulSoup(response.content, "lxml")

table = soup.select_one("table.table")
if table is None:
    sys.exit("No table.table on the page: the layout changed or the data comes from JavaScript")

headers = [th.get_text(" ", strip=True) for th in table.find("tr").find_all("th")]

teams = []
for row in table.find_all("tr", class_="team"):
    record = {}
    for td in row.find_all("td"):
        key = td["class"][0]              # "name", "year", "wins", "pct", "diff" ...
        record[key] = td.get_text(strip=True)
    # Site Win % değerini yeşil ya da kırmızı boyar; renk yalnızca sınıfta durur
    pct_classes = row.find("td", class_="pct").get("class", [])
    record["above_500"] = "text-success" in pct_classes
    teams.append(record)

# Sayfa linkleri: göreli href'ler tam URL olur, tekrarlar atılır, sıra korunur
page_links = list(dict.fromkeys(
    urljoin(URL, a["href"]) for a in soup.select("ul.pagination a[href]")
))

print("columns:", headers)
print("rows:", len(teams), "| page links:", len(page_links))
for team in teams[:3]:
    print(json.dumps(team, ensure_ascii=False))
print("last page:", page_links[-1])
Betiği beautifulsoup4 4.15.0, lxml 6.1.3 ve Requests 2.34.2 ile bir kez doğrudan, bir kez de PROXY_URL ile ayarlanan yerel bir test proxy'si üzerinden çalıştırdık. İki çalıştırma da aynı satırları yazdırdı:
columns: ['Team Name', 'Year', 'Wins', 'Losses', 'OT Losses', 'Win %', 'Goals For (GF)', 'Goals Against (GA)', '+ / -']
rows: 25 | page links: 24
{"name": "Boston Bruins", "year": "1990", "wins": "44", "losses": "24", "ot-losses": "", "pct": "0.55", "gf": "299", "ga": "264", "diff": "35", "above_500": true}
{"name": "Buffalo Sabres", "year": "1990", "wins": "31", "losses": "30", "ot-losses": "", "pct": "0.388", "gf": "292", "ga": "278", "diff": "14", "above_500": false}
{"name": "Calgary Flames", "year": "1990", "wins": "46", "losses": "26", "ot-losses": "", "pct": "0.575", "gf": "344", "ga": "263", "diff": "81", "above_500": true}
last page: https://www.scrapethissite.com/pages/forms/?page_num=24
Başlık satırının sınıfı olmadığı için betik sütun adlarını ilk <tr>'den, verileri tr.team satırlarından alıyor. Her hücrenin ilk sınıfı (name, wins, ot-losses) sözlük anahtarı oluyor; böylece kod sütun sırasına bağlı kalmıyor. Boş OT Losses hücresi None değil, boş dize olarak geliyor. Burada renk yalnızca sayıyı tekrarlıyor, ama bazı sitelerde, örneğin tükenen ürünü bir sınıfla işaretleyen mağazalarda, bu bilgi yalnızca sınıfta yer alır. Sayfalama bloğunda 25 link var, çünkü "Next" oku 1. sayfanın adresini tekrarlıyor; dict.fromkeys tekrarı atıyor ve sırayı koruyor.
User-Agent, isteği gönderen programı sunucuya tanıtan header'dır (HTTP başlığı). Bu betikte tarayıcı gibi görünmeye çalışmak yerine betiğin adını ve bir iletişim adresini veriyor (User-Agent Nedir?). timeout=(5, 20) bağlantı 5 saniyede kurulmazsa ya da 20 saniye boyunca veri gelmezse vazgeçiyor; raise_for_status() ise bir hata sayfası ayrıştırılmadan önce betiği durduruyor. Yanlış bir proxy şifresi, mesajında "Max retries exceeded" ve "407 Proxy Authentication Required" geçen bir ProxyError fırlatır (Max Retries Exceeded With URL Hatası). Proxy'ye yalnızca hacim büyüdüğünde ya da sayfaları başka bir ülkedeki ziyaretçilerin gördüğü gibi görmeniz gerektiğinde ihtiyaç duyarsınız; o zaman bir Residential Proxy aynı PROXY_URL satırına yerleşir.
Betik bilerek tek sayfada duruyor. 24 sayfanın hepsini istekler arasında bekleyerek dolaşmayı Sayfalama (Pagination) Nedir?, 429 ya da 503 aldıktan sonra yeniden denemeyi Scraping'de HTTP Hata Kodları, istekleri paralel çalıştırmayı Concurrency ve Parallelism, istekler arasında çıkış IP'sini değiştirmeyi de Python'da Proxy'ler Nasıl Döndürülür? yazısı anlatıyor.
pandas read_html ile tablo nasıl okunur?
Sayfada düzgün bir <table> varsa ve yalnızca değerlere ihtiyacınız varsa pandas tabloyu tek çağrıda okur. pandas.read_html yalnızca <table>, <tr>, <th> ve <td> öğelerine bakar ve her zaman bir DataFrame listesi döndürür: bulduğu her tablo için bir tane. pandas 3.0.6 kullandık:
import io
import os

import pandas as pd
import requests

URL = "https://www.scrapethissite.com/pages/forms/"

session = requests.Session()
session.headers["User-Agent"] = "hockey-table-demo/1.0 (contact: you@example.com)"
if os.environ.get("PROXY_URL"):
    session.proxies = {"http": os.environ["PROXY_URL"], "https": os.environ["PROXY_URL"]}

response = session.get(URL, timeout=(5, 20))
response.raise_for_status()

# pandas 3: HTML'i StringIO ile sarın, düz dize dosya yolu olarak okunur
tables = pd.read_html(io.StringIO(response.text), attrs={"class": "table"})
df = tables[0]
print(len(tables), df.shape)
print(df[["Team Name", "Year", "Wins", "OT Losses", "Win %"]].head(3))1 (25, 9)
Team Name Year Wins OT Losses Win %
0 Boston Bruins 1990 44 NaN 0.550
1 Buffalo Sabres 1990 31 NaN 0.388
2 Calgary Flames 1990 46 NaN 0.575Sunucu Content-Type header'ında UTF-8 bildirdiği için burada response.text doğru çözülüyor. pandas sayıları da dönüştürdü: Year ve Wins tam sayı, Win % ondalıklı sayı (float), boş OT Losses sütunu da NaN oldu. attrs tabloyu özniteliklerine göre, match ise metnindeki bir dizeye ya da düzenli ifadeye göre seçer. pandas varsayılan olarak lxml ile ayrıştırır, bu başarısız olursa html5lib ile BeautifulSoup'a geçer.
Üç hata sık sık karşınıza çıkar:
- HTML metni verdiğinizde dosya hatası. pandas 3.0'dan beri
read_htmldüz HTML dizelerini kabul etmiyor; metniio.StringIOile sarın (pandas 3.0.0 sürüm notları). Düz dize dosya yolu olarak ele alınıyor; biz de mesajında sayfanın ilk satırları geçen birFileNotFoundErroraldık. ValueError: No tables found. Tablo sonradan JavaScript ile geliyor, sayfa ızgarasını<div>öğeleriyle çiziyor ya damatchmetniniz hiçbir tabloda geçmiyor (No tables found matching pattern 'Points'). html5lib kurulu değilse yedek parser da çalışamaz ve html5lib'i kurmanızı isteyen birImportErroralırsınız.- URL verdiğinizde
HTTP Error 403: Forbidden. pandas bu durumda sayfayı urllib ile indirir. urllib'in varsayılan User-Agent değeriPython-urllib/3.13'tür ve bazı siteler bunu reddeder; yerel test sunucumuz da tam olarak bu dizeyi kaydetti. Sayfayı yukarıdaki gibi kendiniz indirin ya dastorage_options={"User-Agent": "..."}ile dürüst bir bot adı verin. Bir tarayıcının User-Agent'ını kopyalamayın: RFC 9110, kendini başka bir istemci gibi gösteren istemciye o istemci için hazırlanmış yanıtların gönderilebileceğini belirtir.
pandas yalnızca değerleri döndürür. extract_links="body" her hücrenin linkini ekler ama sınıfları eklemez; yukarıdaki Win % rengi için BeautifulSoup'a geri dönersiniz.
Kullanım alanları
- Rakip fiyatları: birçok ürün sayfası fiyatını bir JSON-LD
<script>etiketinde taşır ve bu etiketfind_all("script", type="application/ld+json")ile okunur (rakip fiyat takibi). - Kendi hesabınızla giriş: giriş formlarında çoğu zaman gizli bir CSRF alanı bulunur; formu göndermeden önce bu alanı
find("input", attrs={"name": "csrf_token"})ile okursunuz (Python'da oturum ve çerez yönetimi). - Sayfa linklerini izlemek:
select_one("a[rel=next]")ya da bir sayfalama bloğu, crawler'a (sayfaları linkler üzerinden gezerek bulan programa) sonraki sayfanın nerede olduğunu söyler (sayfalı listeleri tarama). - Scraping ve crawling: BeautifulSoup veri çıkarma adımıdır; crawler buna sayfaları keşfeden kısmı ekler (web scraping ve web crawling farkı).
- Büyük ve zamanlanmış veri toplama: günde binlerce sayfa toplamak kuyruk, hız kontrolü ve birkaç ülkede çıkış noktası gerektirir (veri kazıma).
Sık yapılan hatalar
- Parser'ı yazmamak. Sonuç, makinede hangi paketlerin kurulu olduğuna bağlı olur ve
GuessedAtParserWarningalırsınız. findsonucunu kontrol etmeden zincirlemek. Eksik bir öğe üç satır sonra'NoneType' object has no attribute ...hatasına dönüşür.- Geliştirici araçlarından
tbodyiçeren bir seçici kopyalamak. HTML standardı<tbody>etiketlerini yazmamaya izin verir, tarayıcılar da bu öğeyi kendileri ekler (WHATWG HTML, tbody öğesi). Alıştırma sayfasındatable > tbody > trhtml.parser ve lxml ile 0, html5lib ile 26 satır buldu;table tr.teamise üçüyle de 25 satır buldu. - Birden fazla sınıfı tek dize olarak aramak.
class_="pct text-danger", sayfa sınıfları başka sırayla yazdığında çalışmaz;select("td.pct.text-danger")kullanın. .next_sibling'in bir etiket olmasını beklemek. Girintili HTML'de bu çoğunlukla bir boşluk dizesidir;find_next_sibling("td")kullanın.response.textvermek. Header'da charset yoksa Requests ISO-8859-1 tahmin eder;response.contentverin.robots.txt'yi okumadan döngüye başlamak. Sitenin neye izin verdiğini kontrol edin ve birden fazla sayfa istemeden önce bir bekleme süresi belirleyin.
Karar rehberi
| İhtiyaç | Öneri |
|---|---|
Sayfada düzgün bir <table> var ve DataFrame istiyorsunuz | io.StringIO ile pandas.read_html; tabloyu seçmek için attrs ya da match |
| Hücrenin sınıfı, rengi ya da linki de gerekiyor | BeautifulSoup: satırlar find_all("tr") ile, öznitelikler td.get("class") ve a.get("href") ile |
| Ek paket kuramıyorsunuz | html.parser; kapanmamış etiket içeren sayfalarda sonucu kontrol edin |
| Hız ve bozuk tablolara dayanıklılık | lxml, çoğu iş için varsayılan seçim |
| Ağaç, tarayıcının gösterdiğinden farklı | html5lib'i deneyin ve seçicinizden tbody'yi çıkarın |
| Veri JavaScript ile geliyor | Önce JSON isteğini arayın, sonra headless (arayüzsüz çalışan) tarayıcıya geçin (Statik ve Dinamik Sayfalar) |
| Kuyruk, yeniden deneme ve proxy ile binlerce sayfa | Scrapy (Scrapy ile proxy kullanımı) ve bir Rotating Proxy |
Sıkça sorulan sorular
BeautifulSoup web sayfalarını indirir mi?
Hayır. BeautifulSoup yalnızca kendisine verdiğiniz HTML'i ayrıştırır. Sayfayı Requests ya da HTTPX gibi bir HTTP istemcisi indirir; siz de response.content değerini bir parser adıyla birlikte BeautifulSoup'a verirsiniz. JavaScript de çalıştırmaz.
find ile find_all arasındaki fark nedir?
find eşleşen ilk etiketi ya da None döndürür; find_all bütün eşleşmelerin listesini döndürür, eşleşme yoksa liste boş gelir. select_one ve select aynı işi bir CSS seçicisiyle yapar. find sonucunda bir yöntem çağırmadan önce sonucu kontrol edin.
BeautifulSoup için hangi parser en uygun?
Çoğu iş için lxml uygundur: hızlıdır ve kapanmamış etiketleri mantıklı biçimde kapatır. Paket kuramıyorsanız html.parser'ı, tarayıcının ağacına ihtiyacınız varsa ve yavaşlığını kabul edebiliyorsanız html5lib'i kullanın. Parser adını çağrıda her zaman yazın.
BeautifulSoup JavaScript ile yüklenen içeriği okuyabilir mi?
Hayır. Yalnızca sunucunun döndürdüğü HTML'i görür; bir betiğin sonradan eklediği veri bu HTML'de yoktur. Tarayıcının ağ (Network) sekmesinde veriyi getiren JSON isteğini arayın ya da sitenin izin verdiği durumlarda headless bir tarayıcı kullanın (Statik ve Dinamik Sayfalar).
pandas read_html neden "No tables found" diyor?
Tablo JavaScript ile oluşturuluyordur, sayfa ızgarasını <table> yerine <div> öğeleriyle çiziyordur ya da match veya attrs değeriniz hiçbir tabloya uymuyordur. pandas 3.0'dan beri HTML'i io.StringIO ile sararak verdiğinizden de emin olun; düz dize dosya yolu olarak ele alınır.
pip install bs4 ile pip install beautifulsoup4 aynı şey mi?
Pratikte aynı, ama gerçek adı kullanın. PyPI'daki bs4, yalnızca beautifulsoup4'ü kuran boş bir pakettir. beautifulsoup4'ü kurun, kodunuzda da bs4'ü içe aktarın: from bs4 import BeautifulSoup.
Özet
BeautifulSoup HTML'i bir ağaca çevirir; sayfa indirmez, JavaScript çalıştırmaz. Her çağrıda parser'ı adıyla belirtin ve find_all boş liste döndürürken find'ın None döndürdüğünü aklınızda tutun. Birden fazla sınıfı aynı anda eşleştirirken select kullanın; sayfada düzgün bir tablo varsa önce pandas.read_html'i deneyin. Tek sayfa günde binlerce sayfaya dönüştüğünde veri kazıma proxy'lerimizin artan hacmi nasıl taşıdığına göz atın.