
Blog de Proxynet – Página 18

Publicado
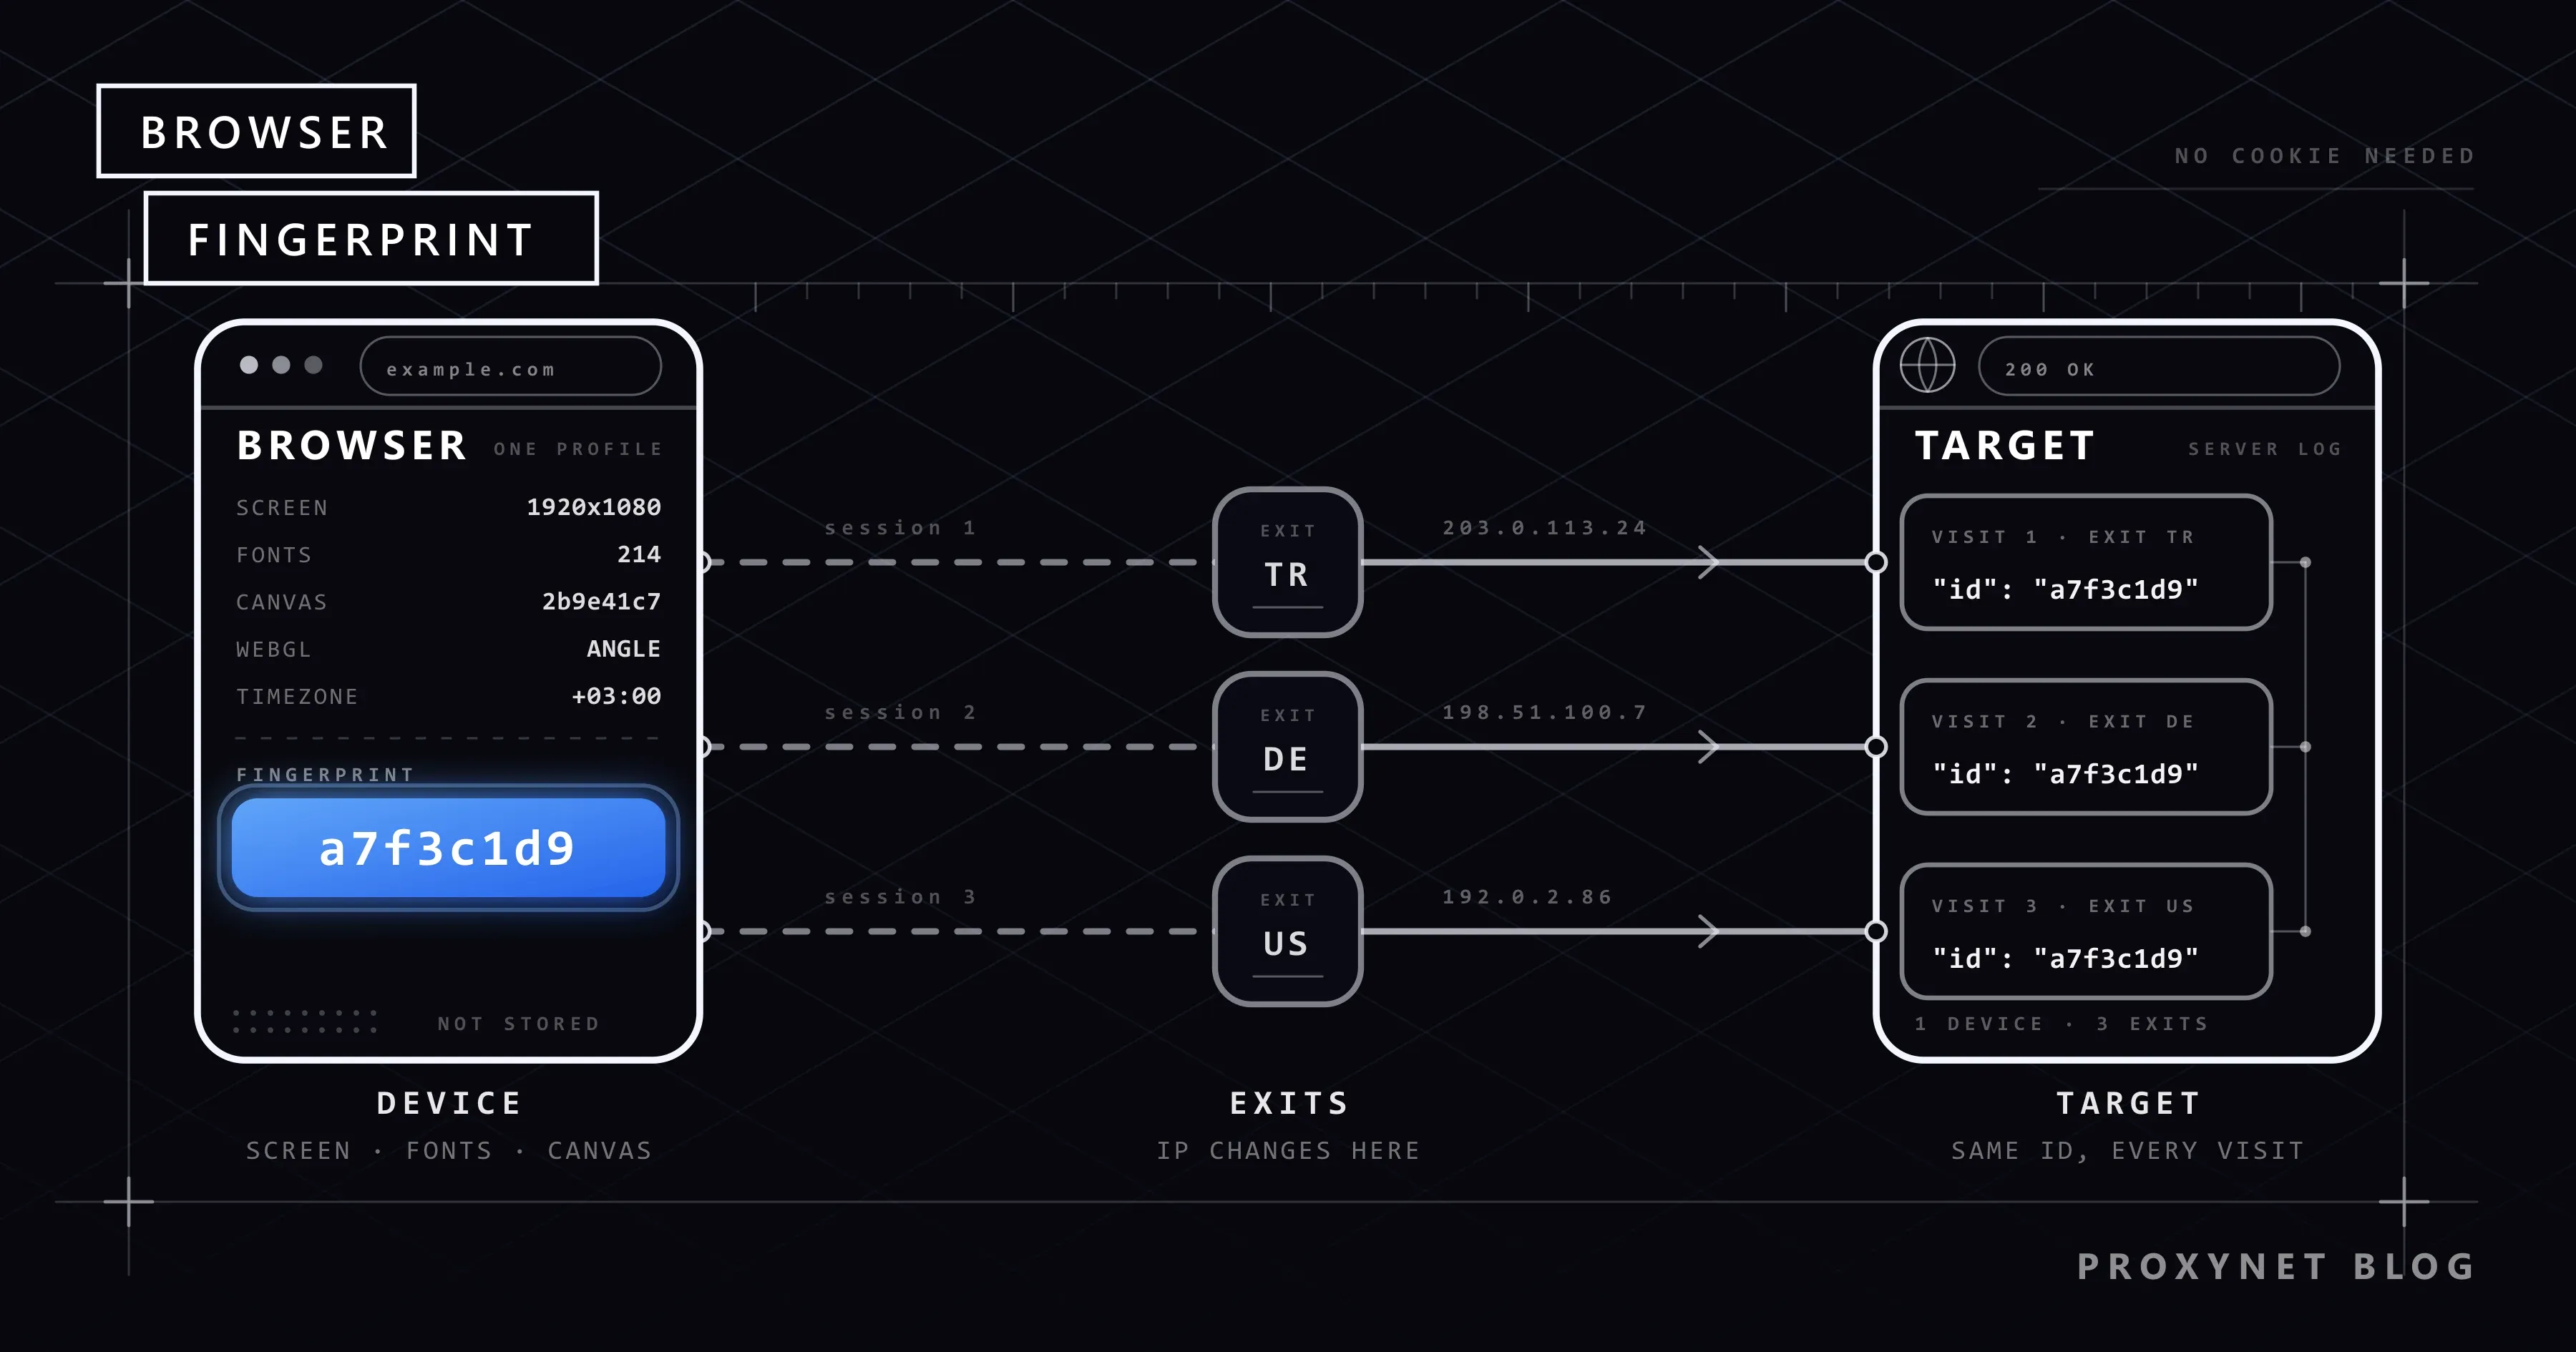
¿Qué es la huella digital del navegador?
La huella digital del navegador identifica tu dispositivo sin cookies, con señales de pantalla, fuentes y canvas. Por qué cambiar de IP no basta.
Autor: Acar Diveroli
Publicado
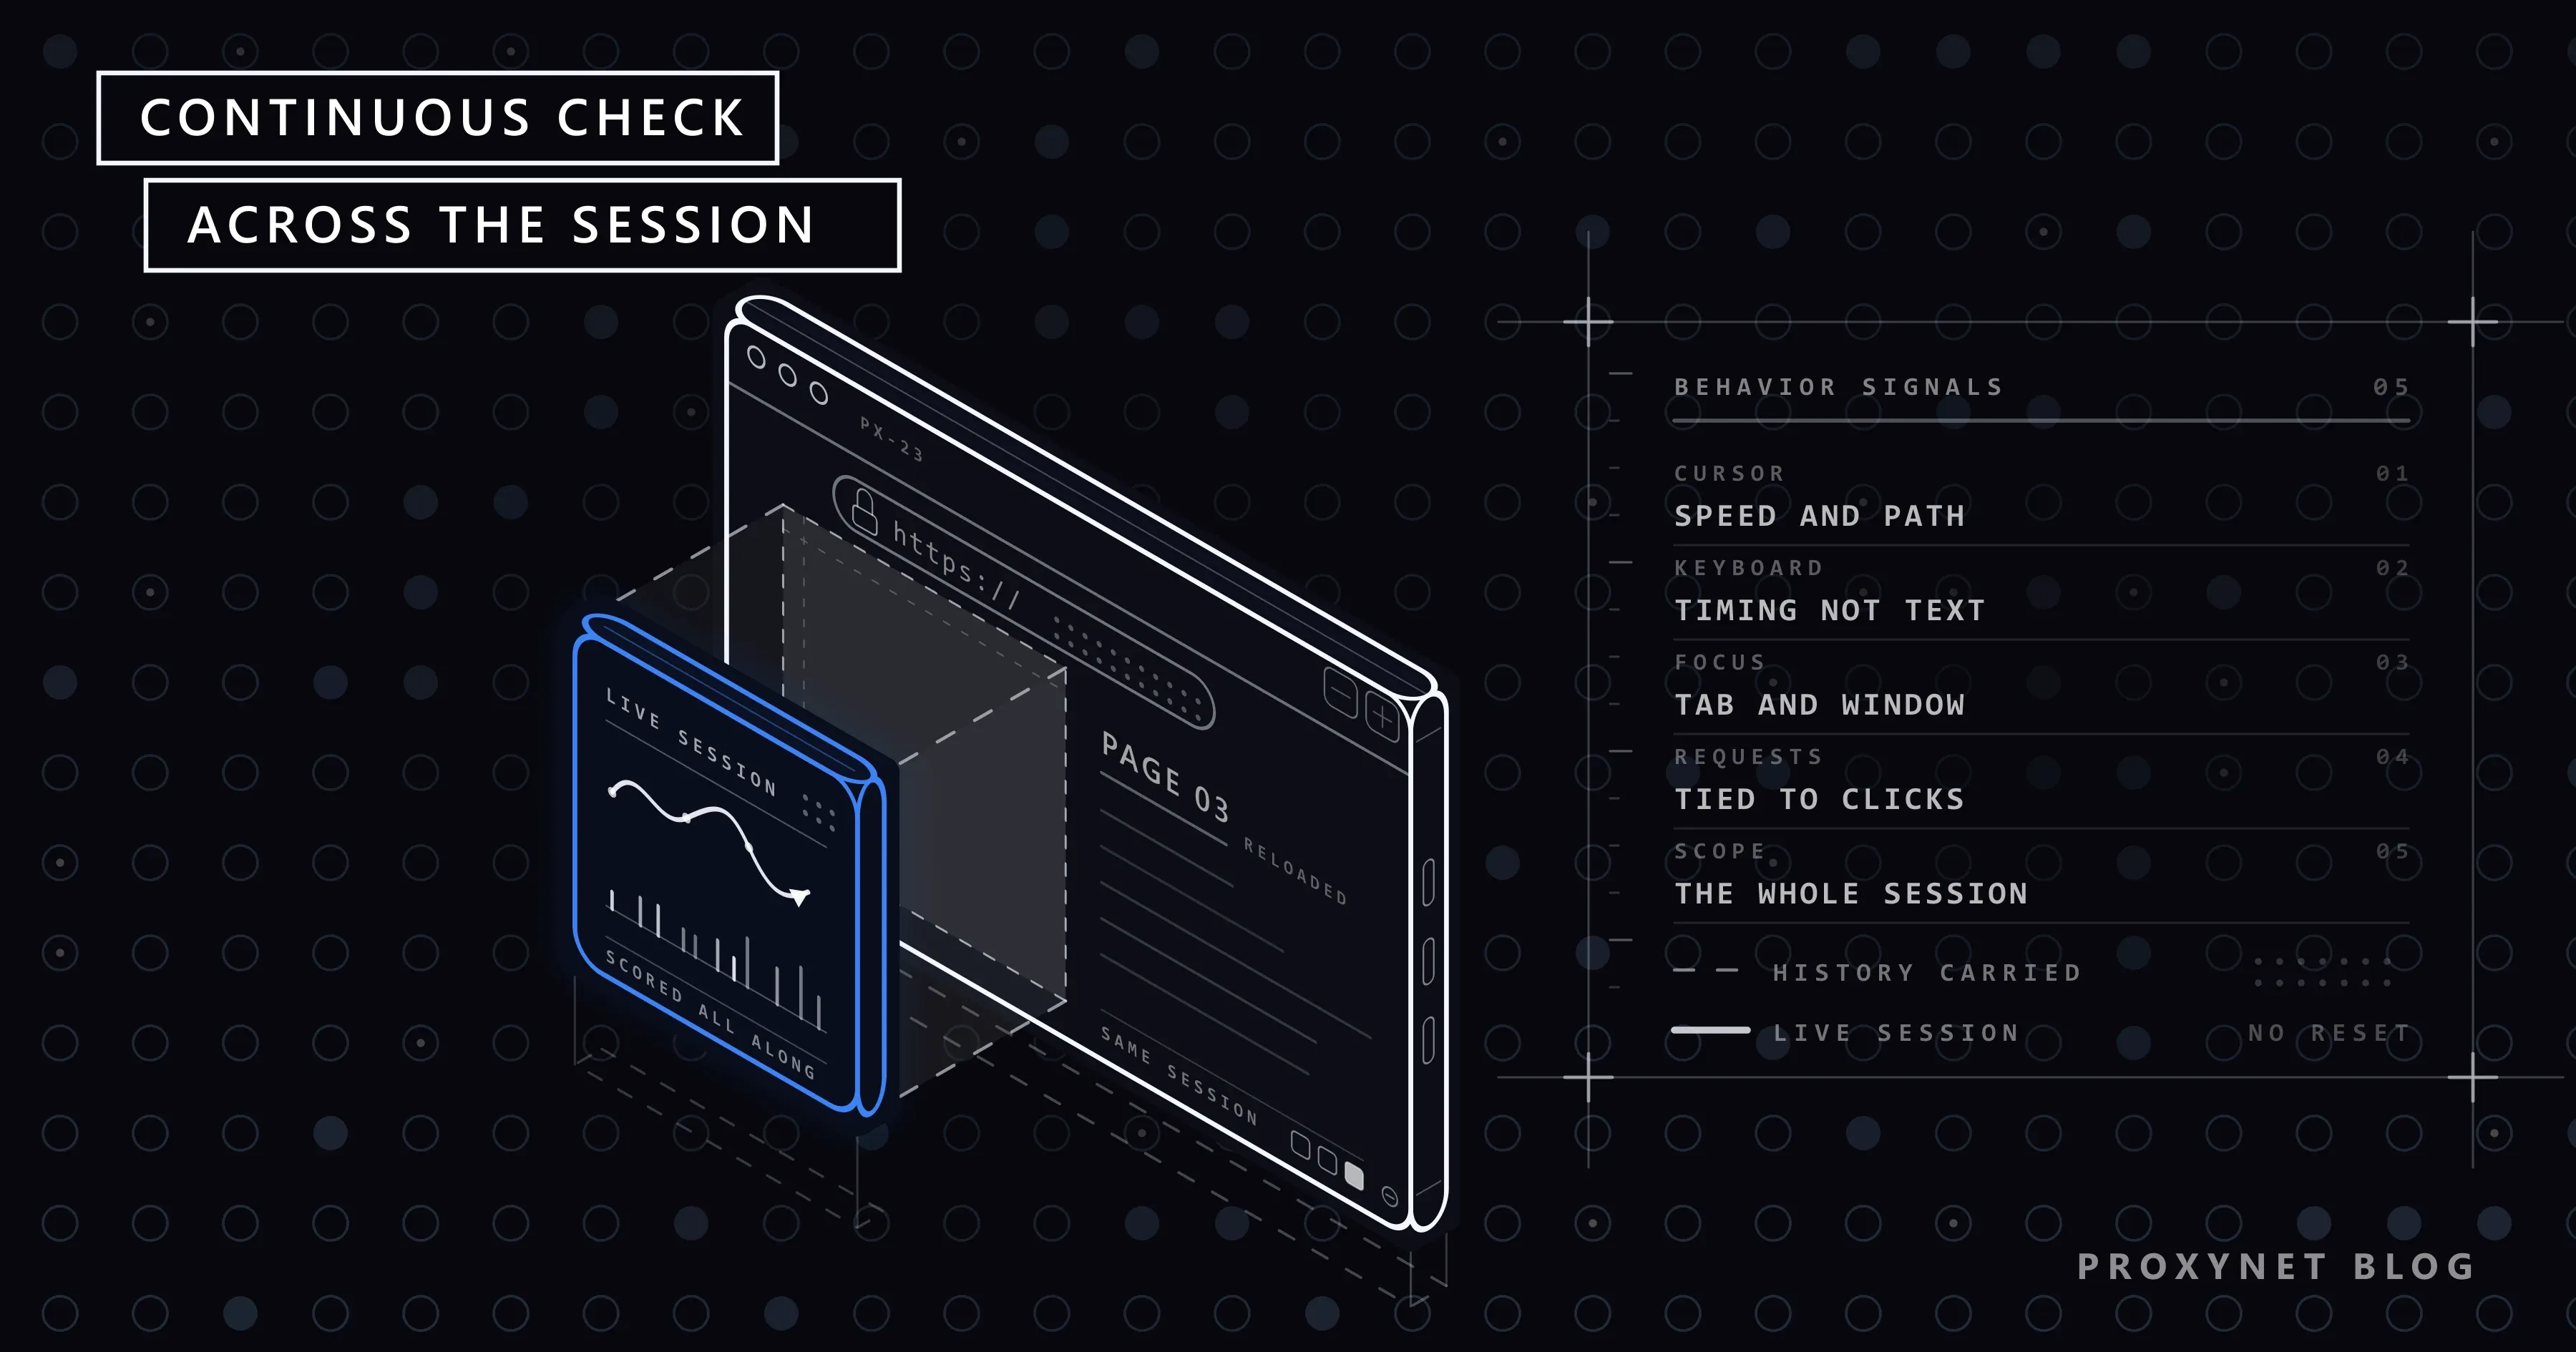
Cloudflare Precursor: qué es y cómo afecta al scraping
Cloudflare Precursor analiza el comportamiento del visitante durante toda la sesión. Qué mide esta capa de bots y qué cambia para la automatización.
Autor:Acar Diveroli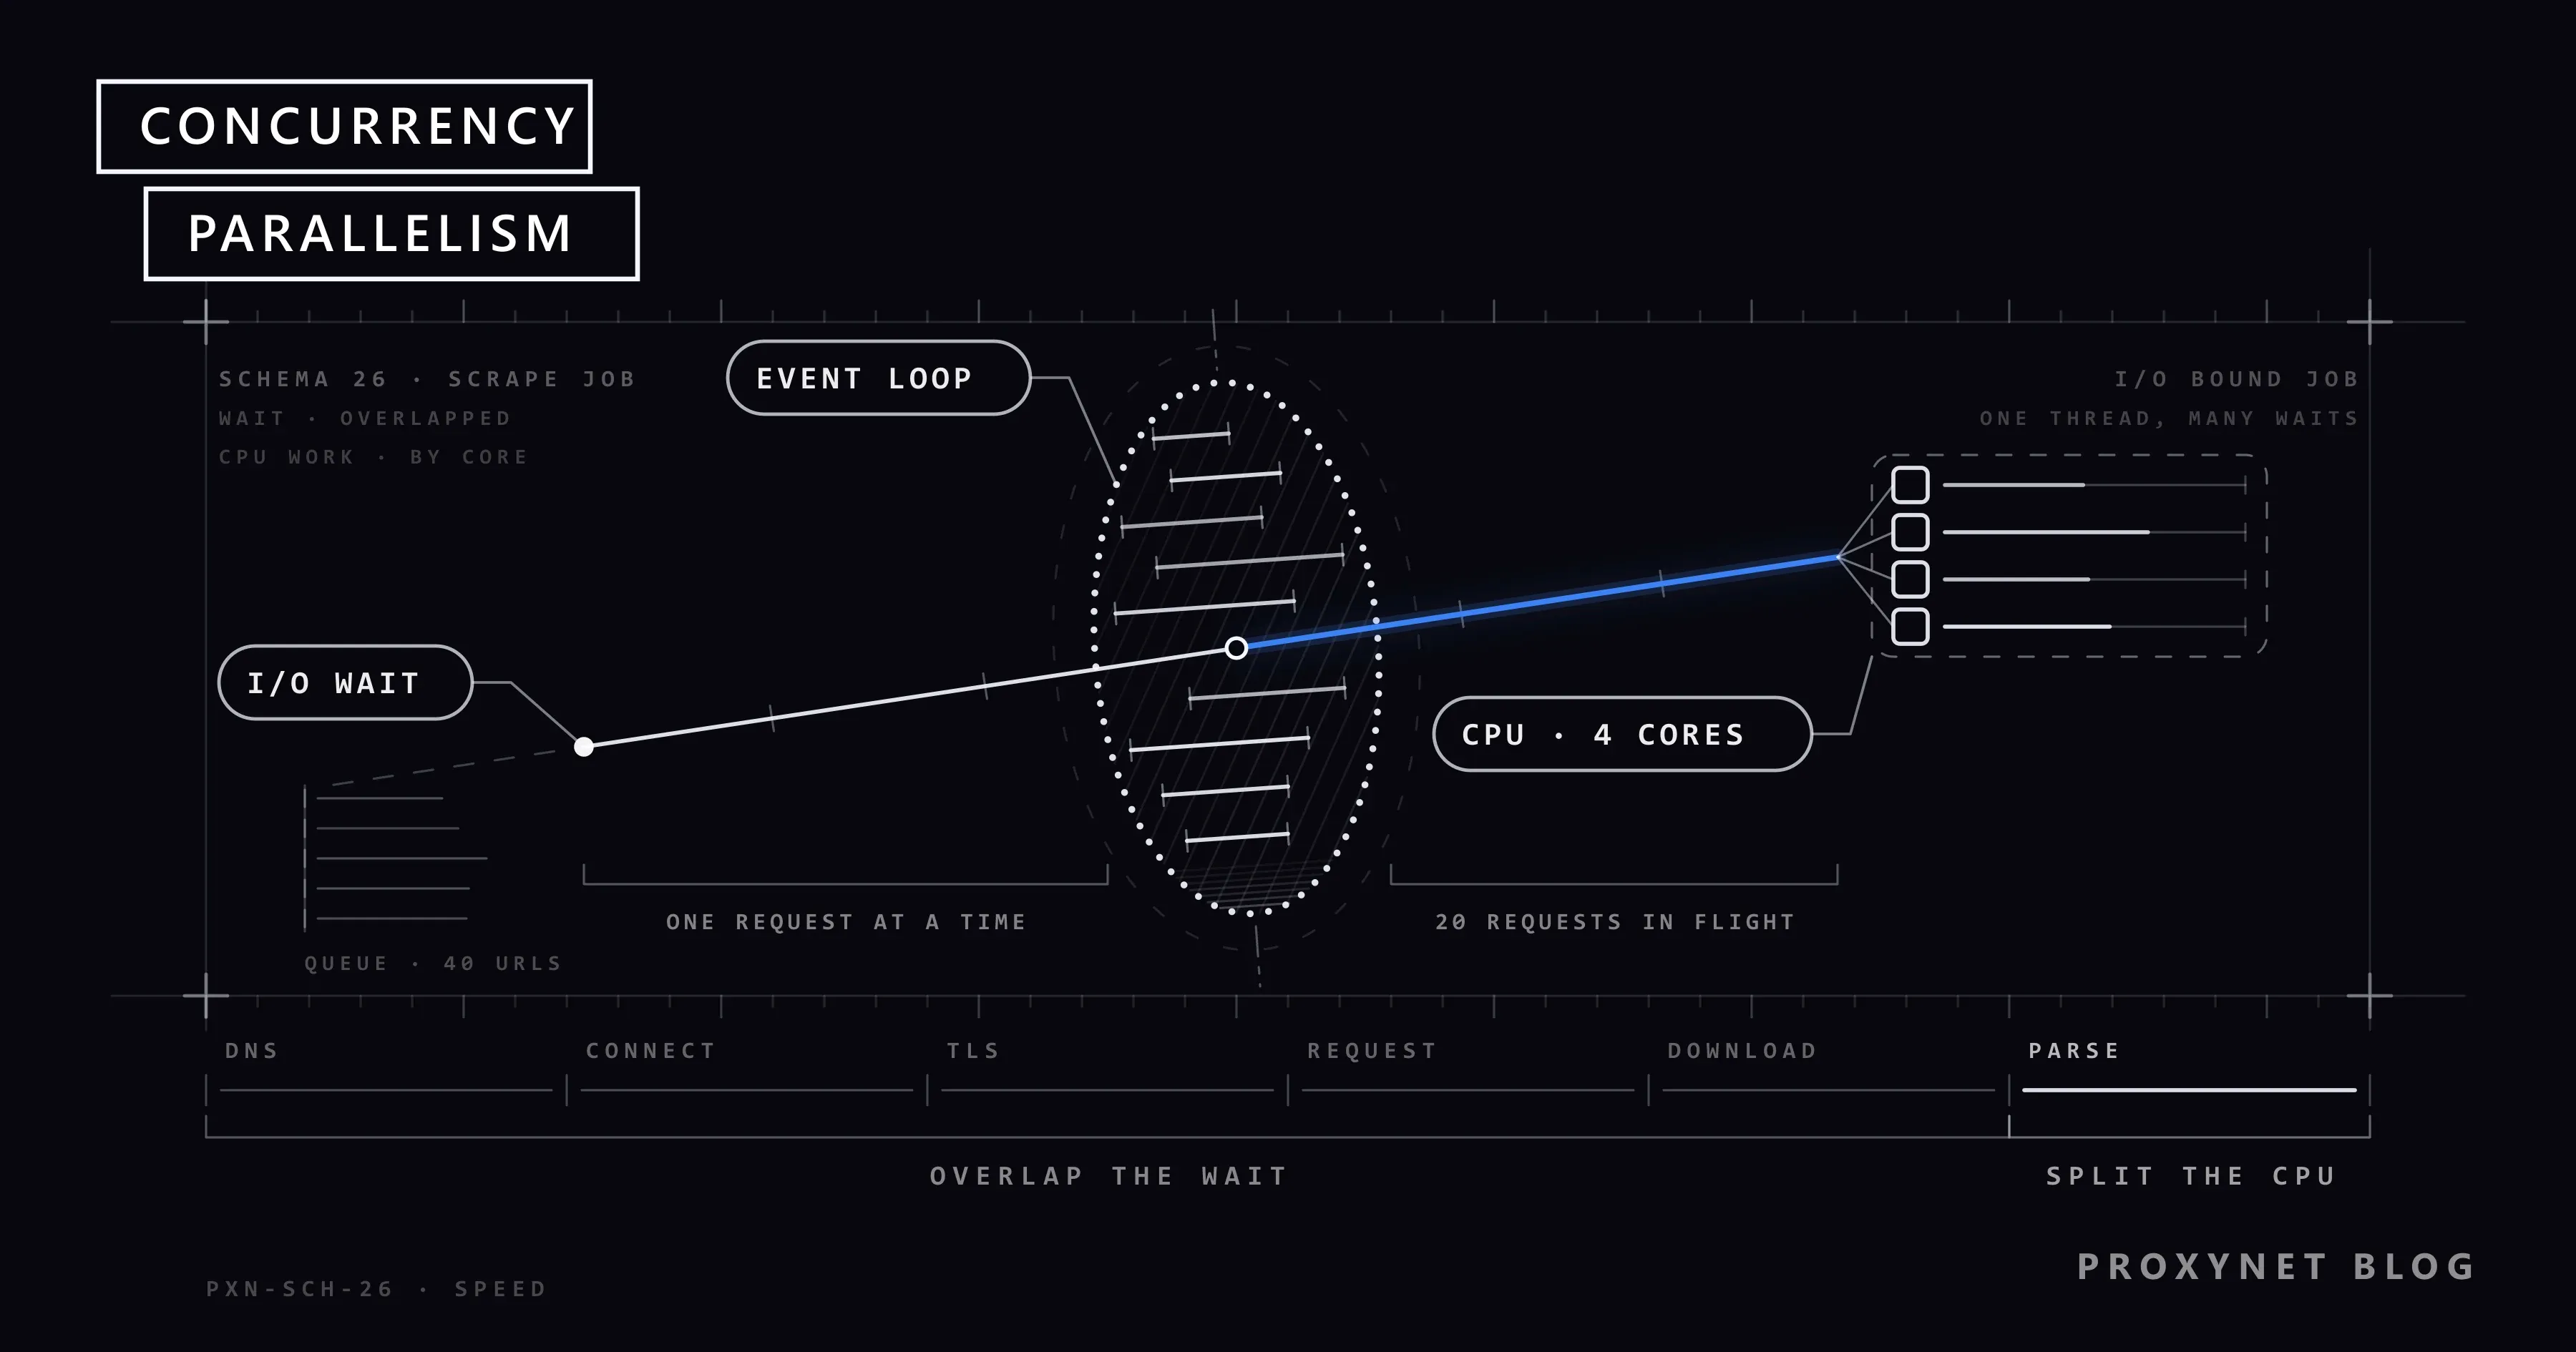
Publicado
Concurrencia y paralelismo en web scraping
La concurrencia aprovecha el tiempo de espera y el paralelismo, la potencia de CPU. Explicamos cuál acelera el scraping, con ejemplos en Python y Node.js.
Autor:Acar Diveroli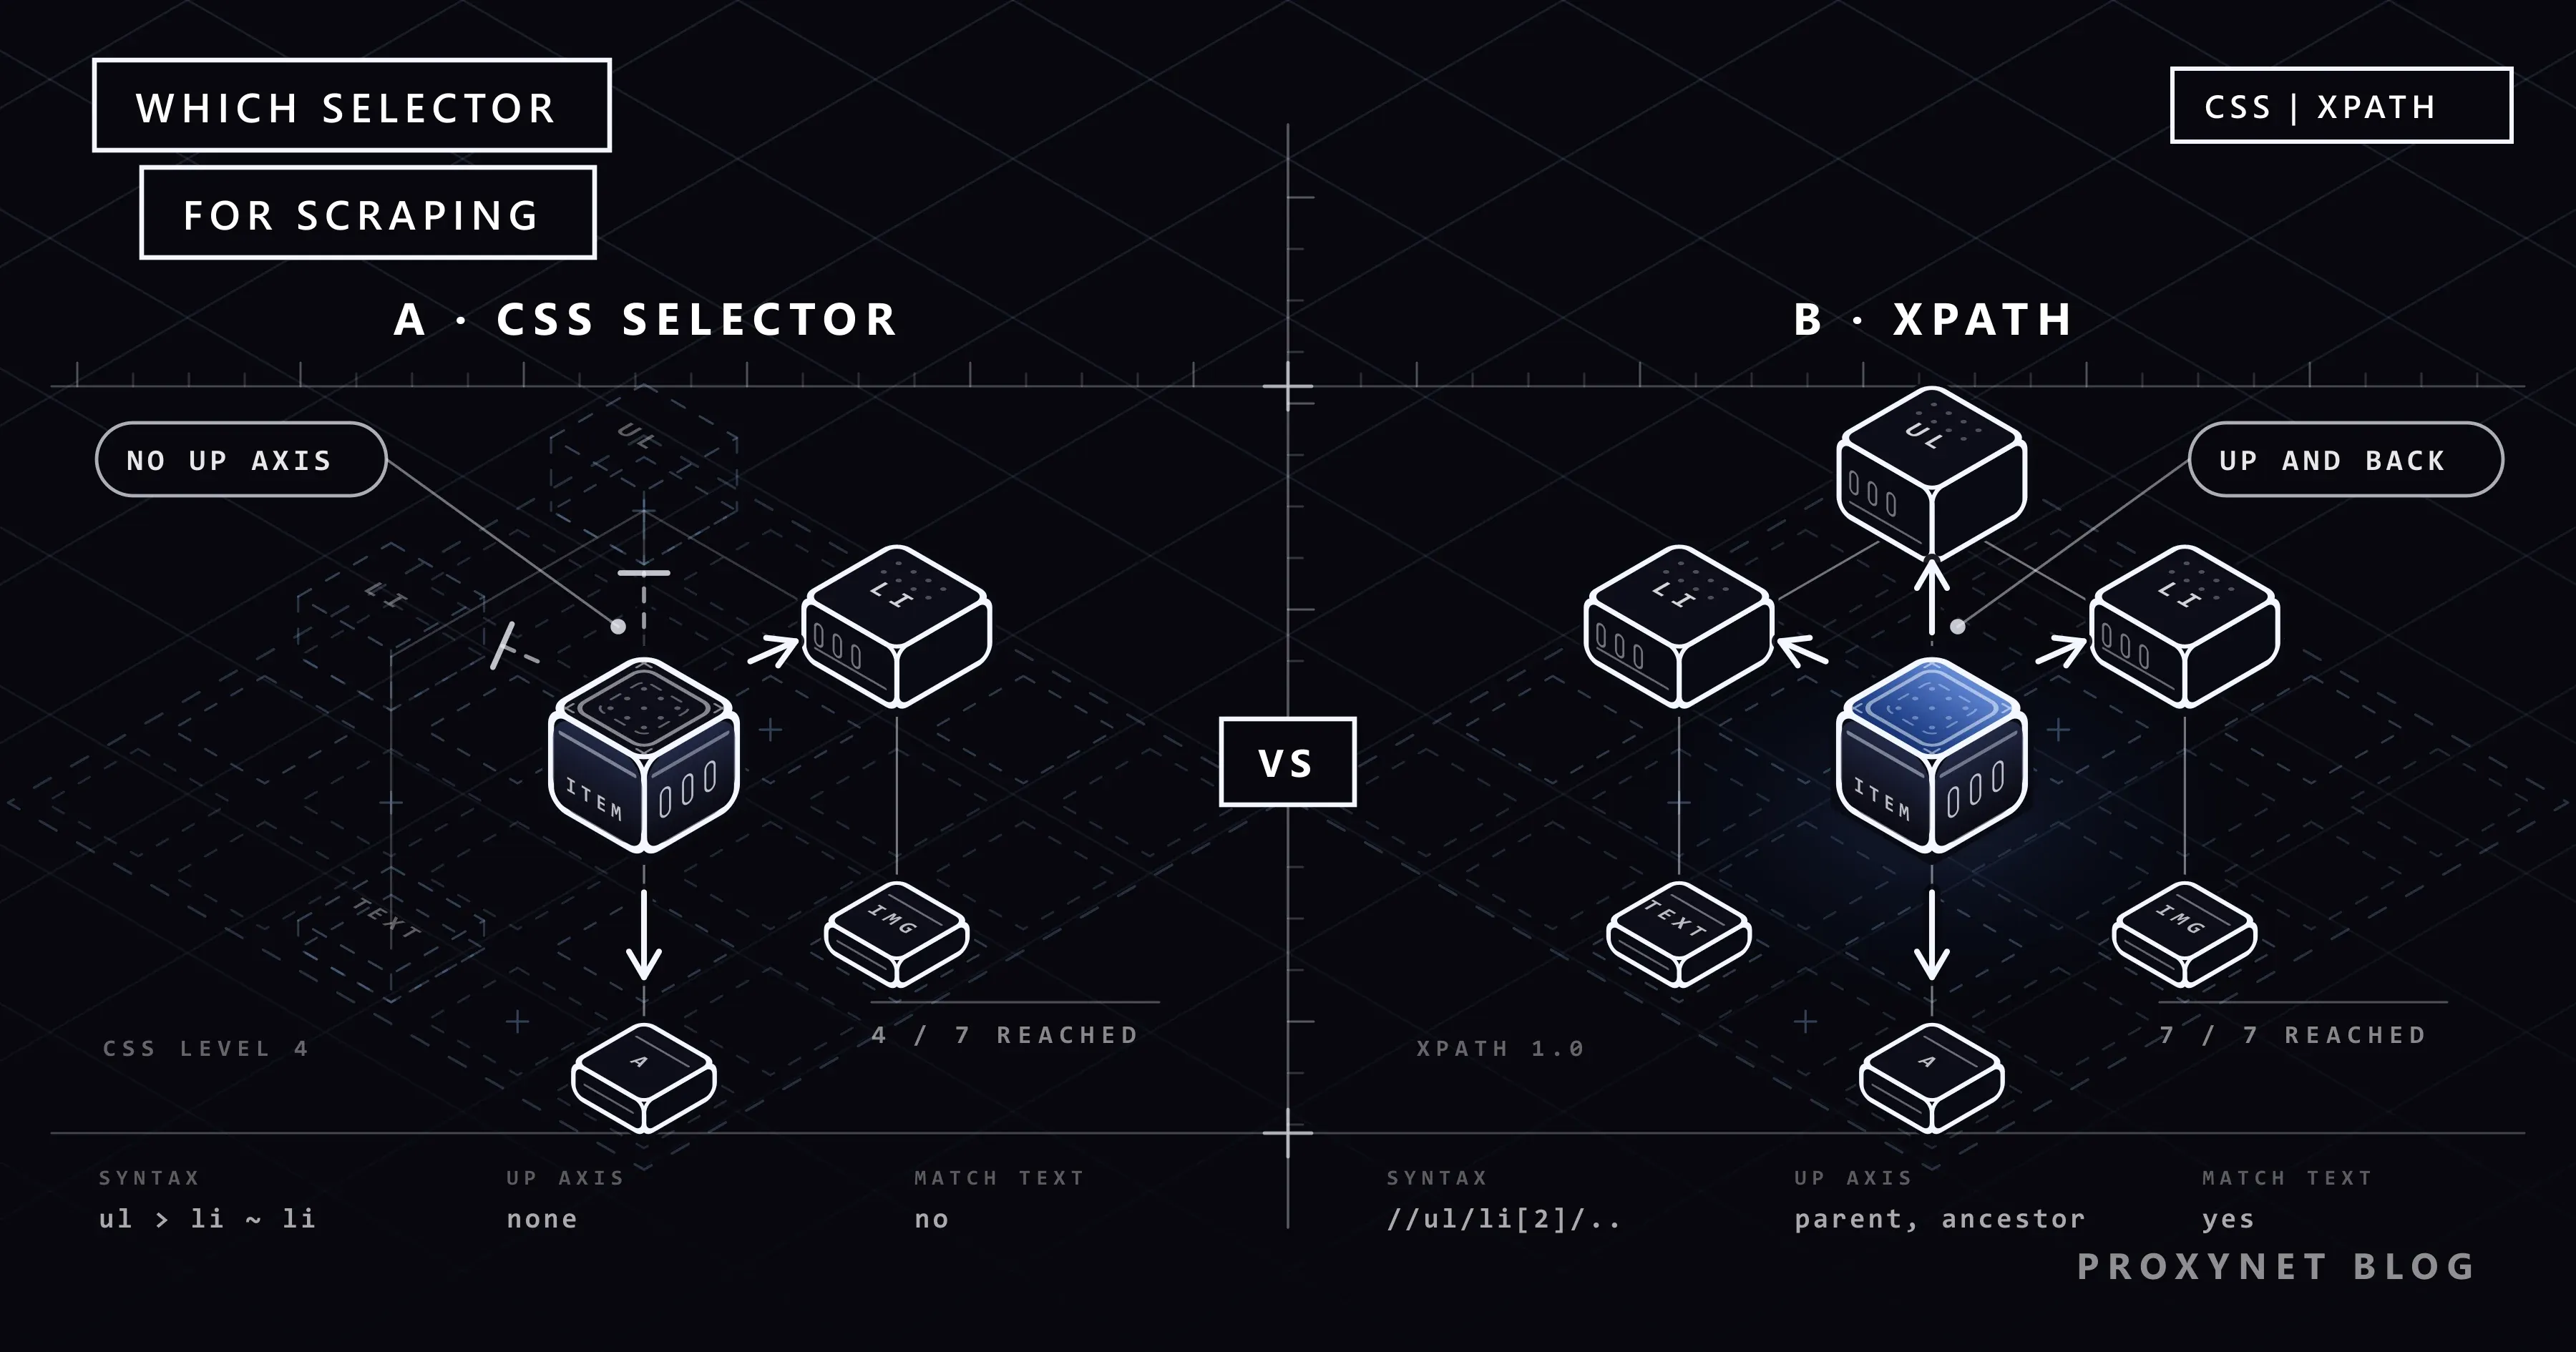
Publicado
Selector CSS o XPath: ¿cuál usar en web scraping?
Los selectores CSS son cortos y legibles; XPath también selecciona por texto y por elemento padre. Comparamos sintaxis, velocidad y ejemplos en Python.
Autor:Acar Diveroli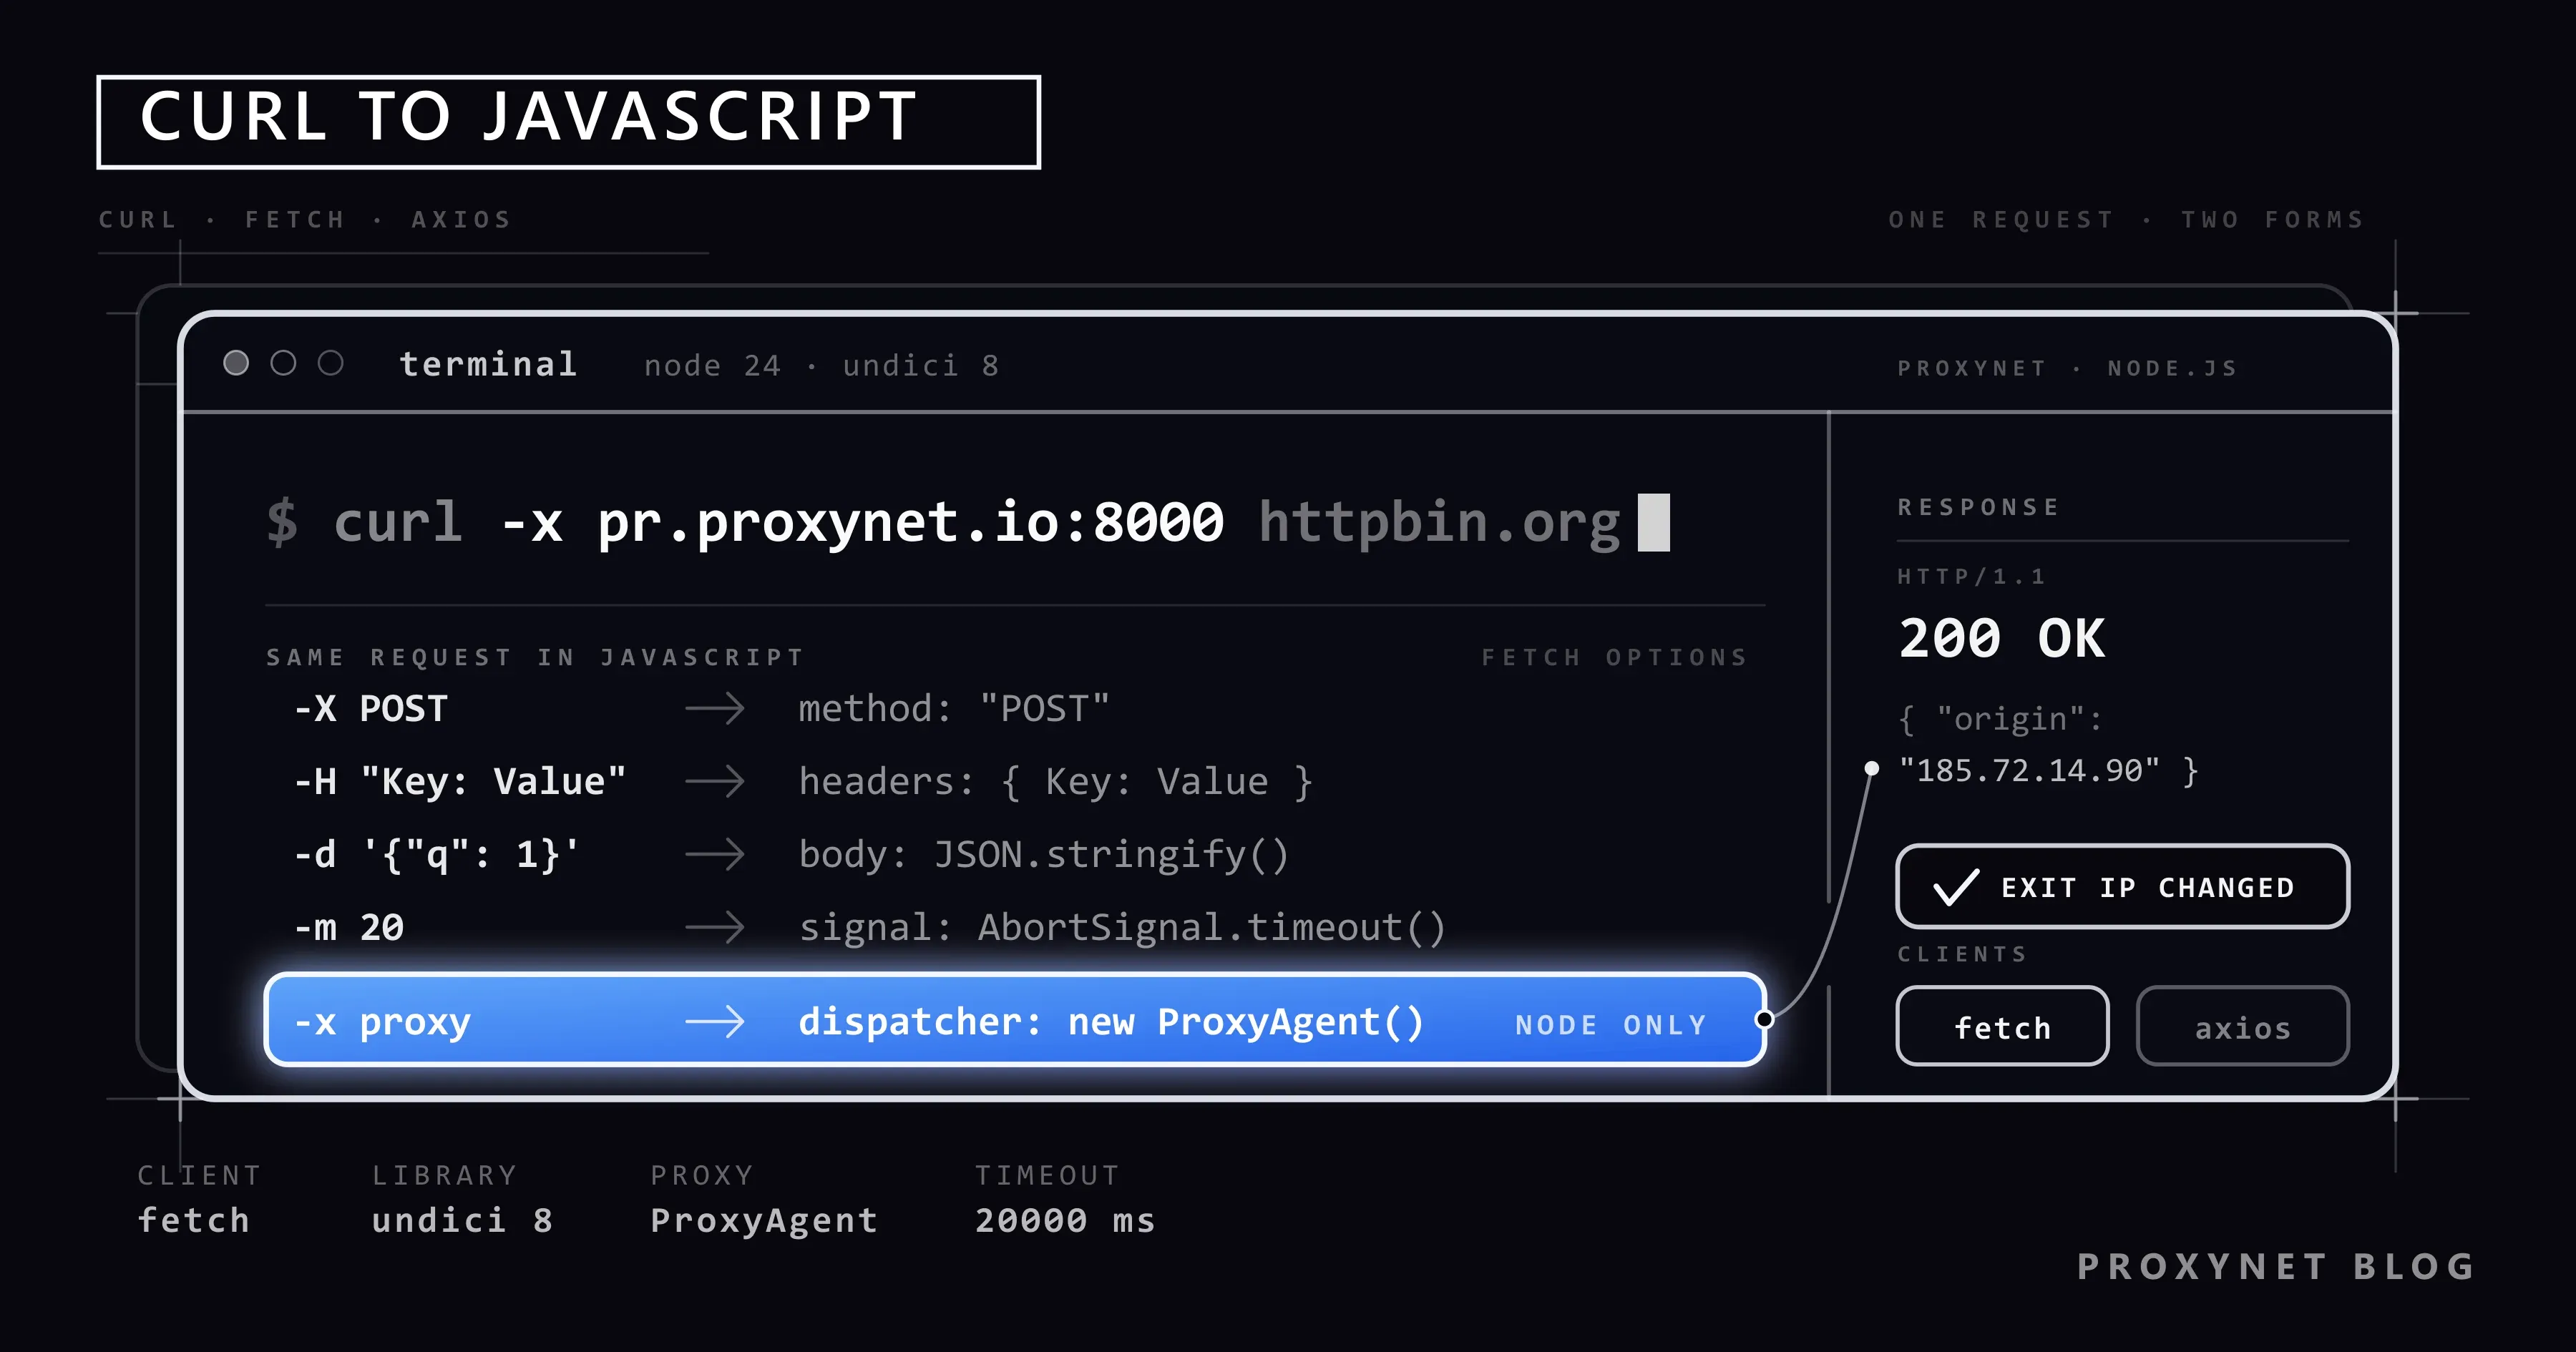
Publicado
cURL en JavaScript: fetch, Axios y proxy
El equivalente en JavaScript de cURL son fetch y Axios. Explicamos cabeceras, cuerpo, autenticación y cómo configurar un proxy en Node.js con ejemplos.
Autor:Acar Diveroli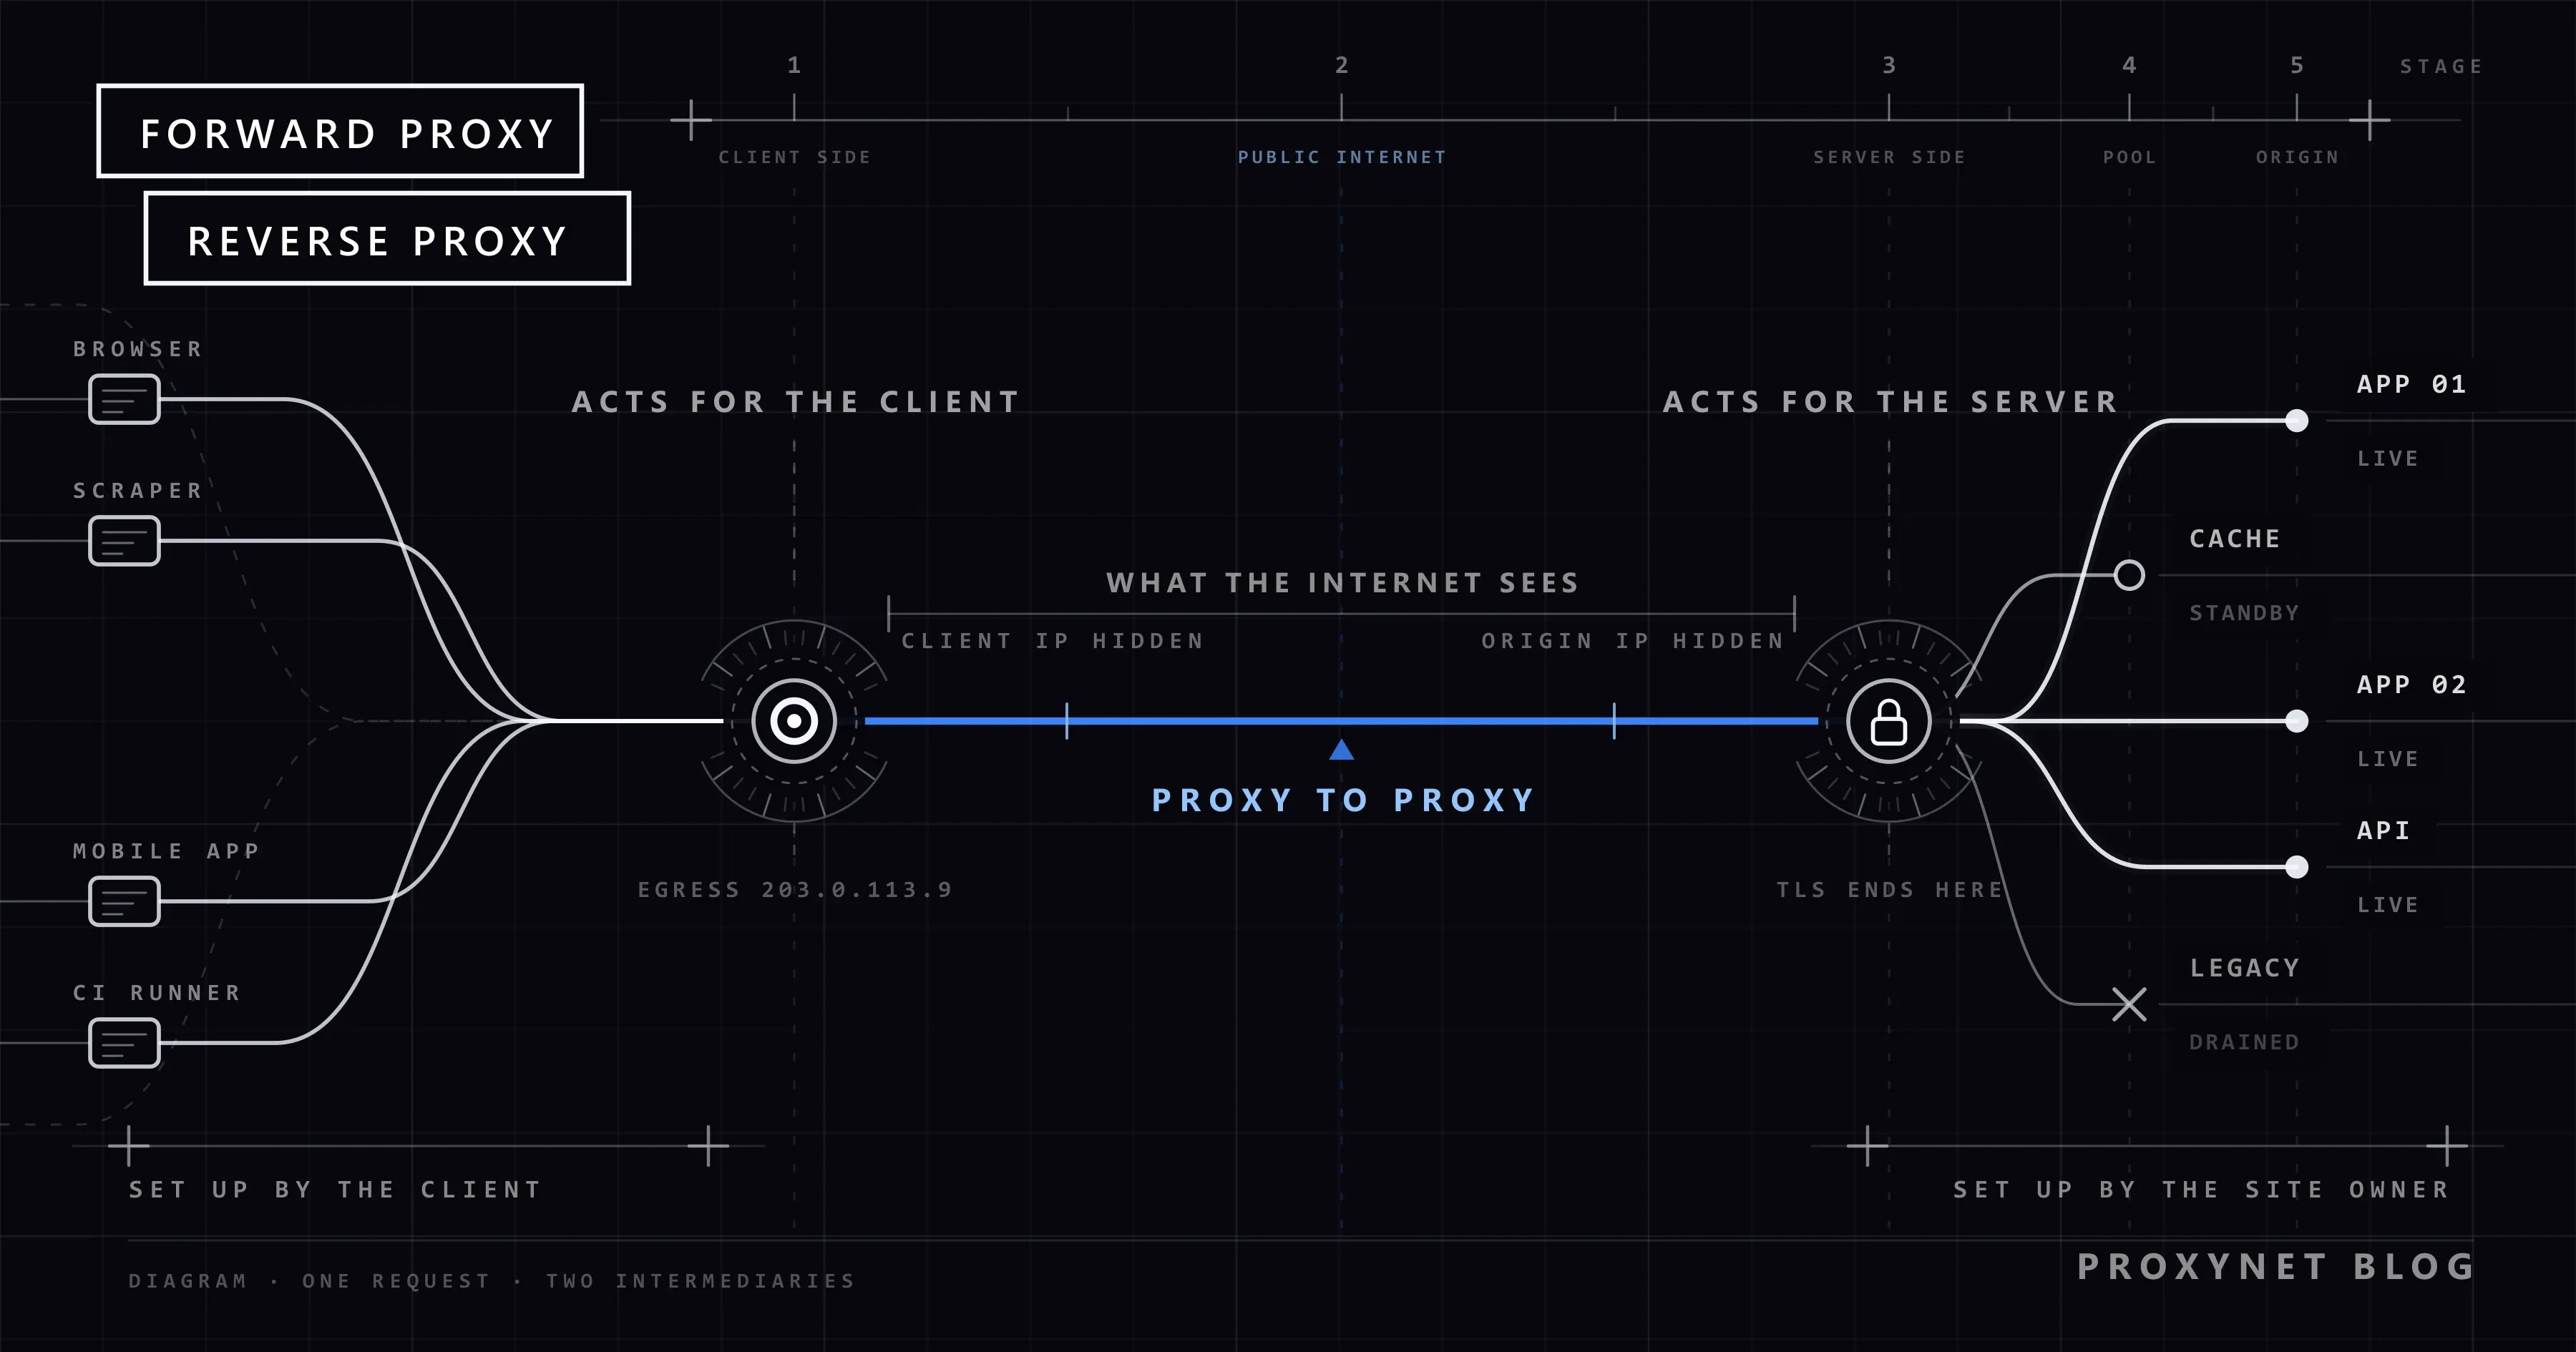
Publicado
Forward proxy y reverse proxy: ¿en qué se diferencian?
Un forward proxy representa al cliente y un reverse proxy al servidor. Comparamos cómo gestiona cada uno el tráfico, dónde se usa y un ejemplo con Nginx.
Autor:Acar Diveroli
Publicado
Web scraping con GPT-6 Astra: qué ha cambiado
GPT-6 Astra mejora la lectura de páginas y el control del navegador, pero no resuelve bloqueos, CAPTCHA ni límites de solicitud en el scraping.
Autor:Acar Diveroli
Publicado
Qué son las trampas honeypot y cómo afectan al scraping
Los honeypots son enlaces ocultos que los visitantes no ven pero en los que caen los bots. Explicamos cómo funcionan, sin enseñar a esquivarlos.
Autor:Acar Diveroli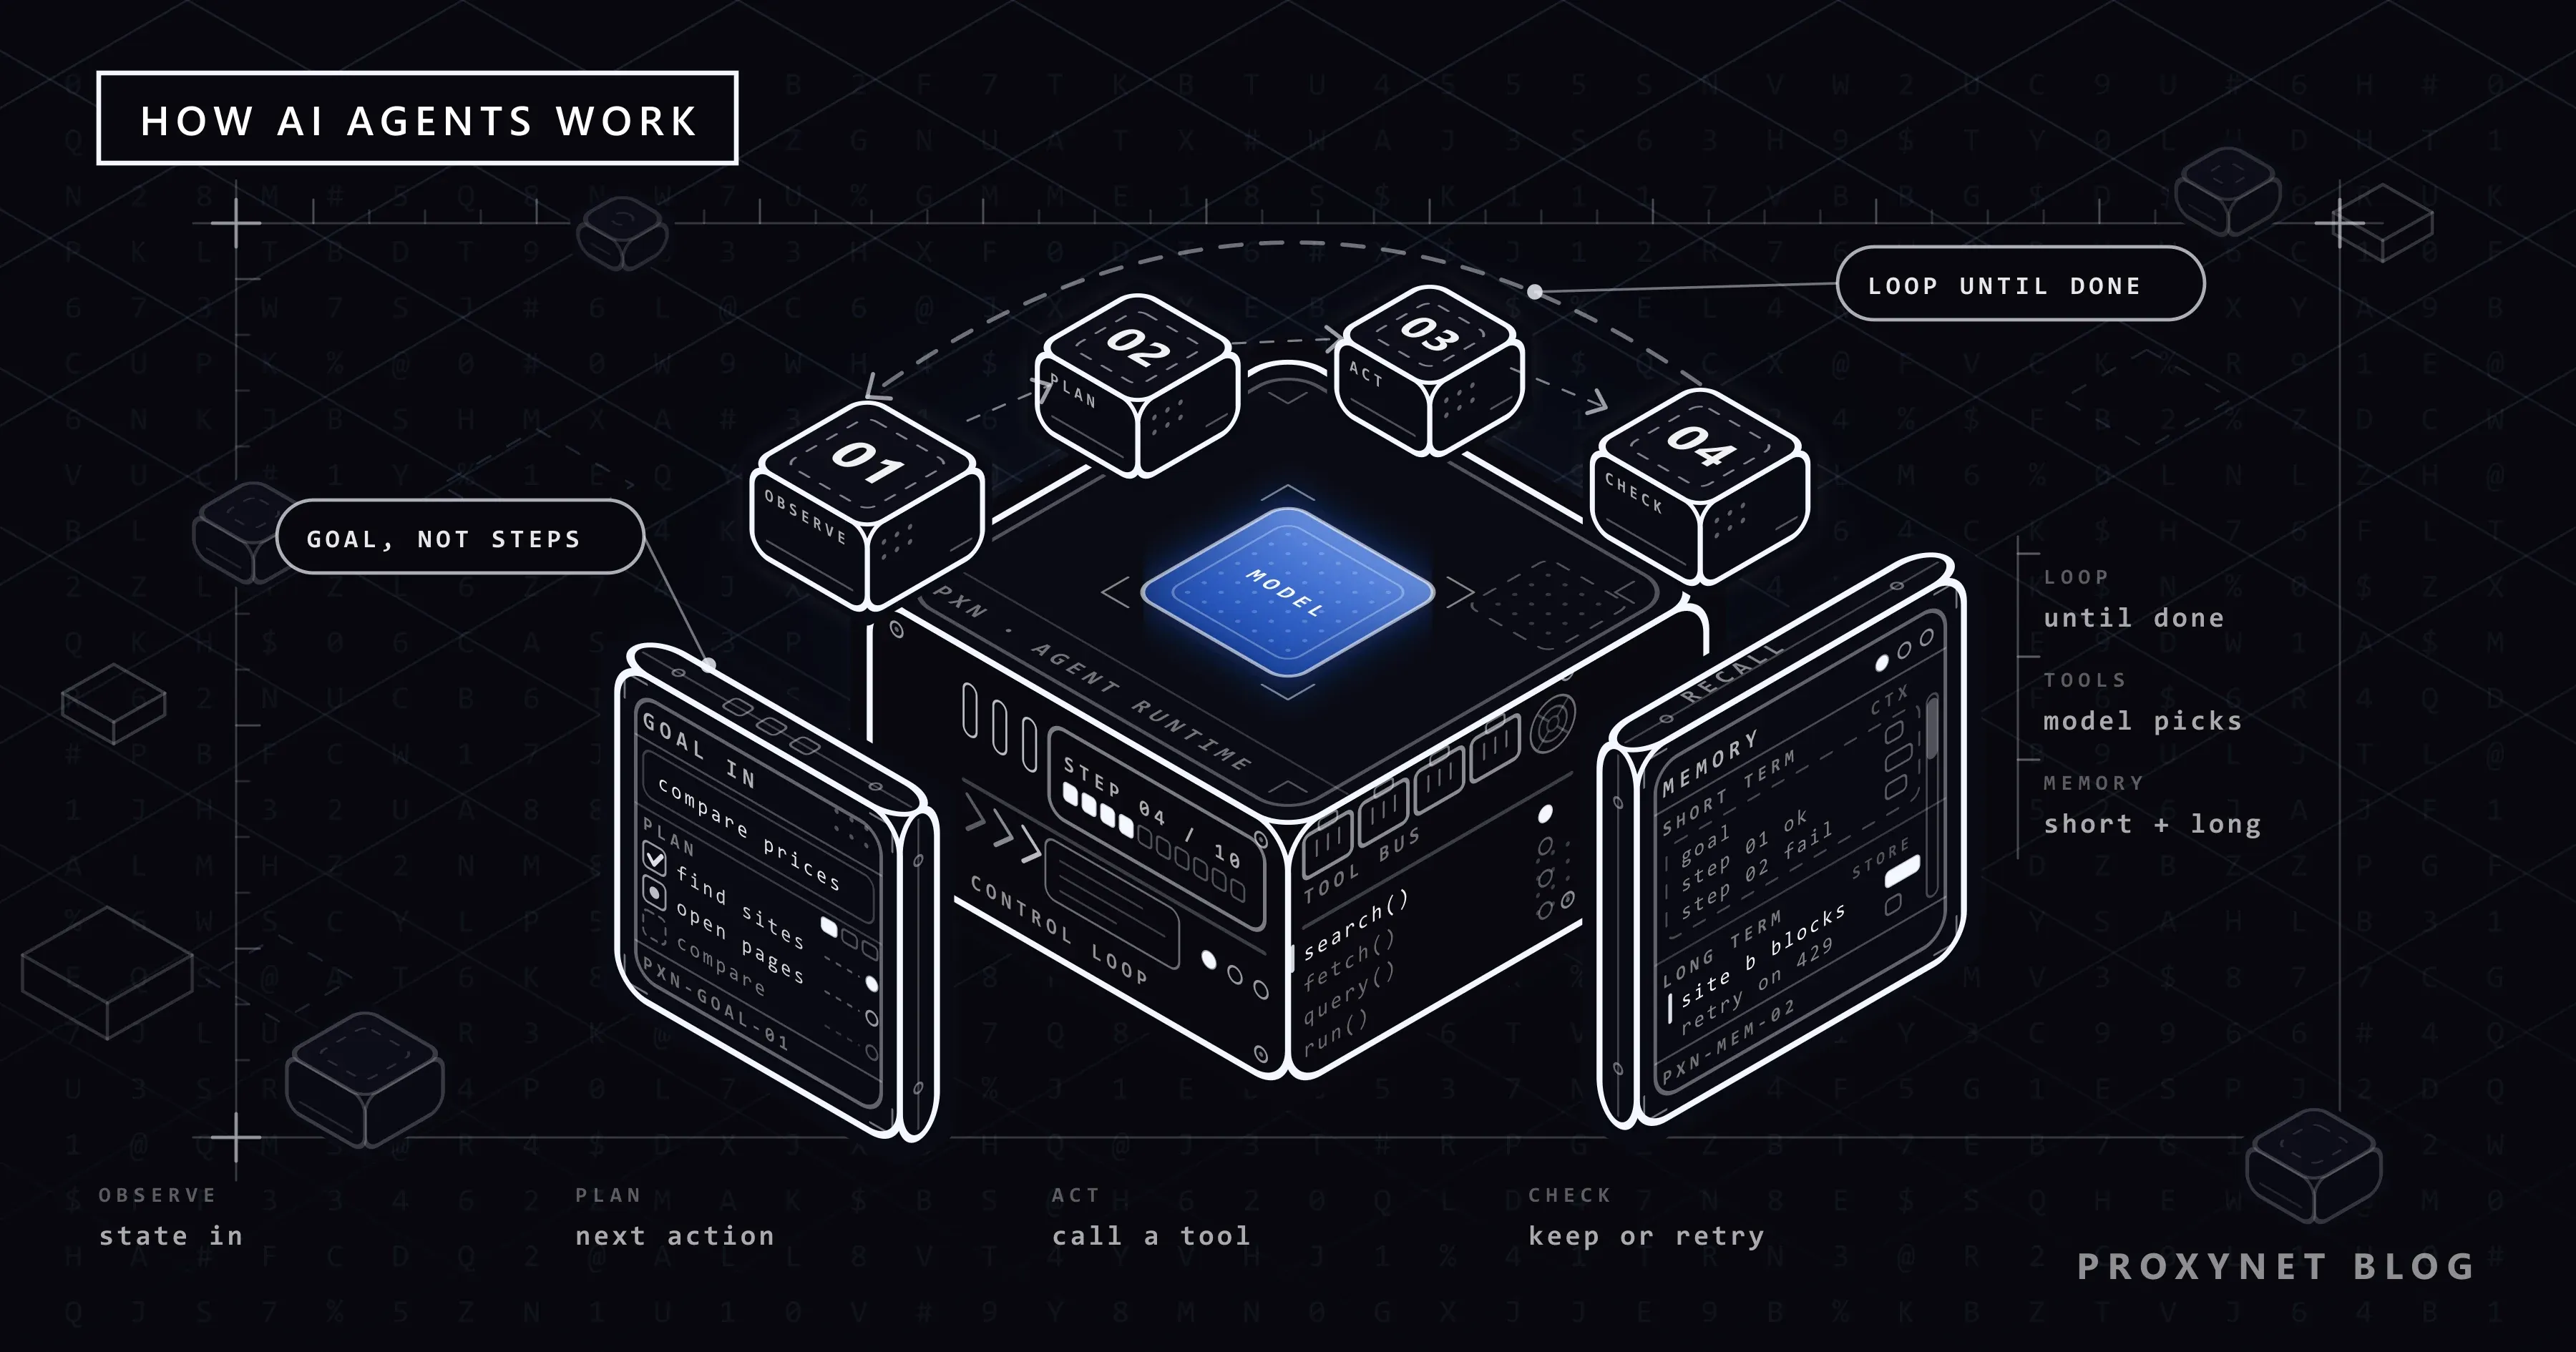
Publicado
Agentes de IA: planificación, herramientas y memoria
Un agente de IA divide un objetivo en pasos, llama a herramientas, evalúa el resultado y actualiza su memoria. Explicamos este bucle y su acceso a la web.
Autor:Acar Diveroli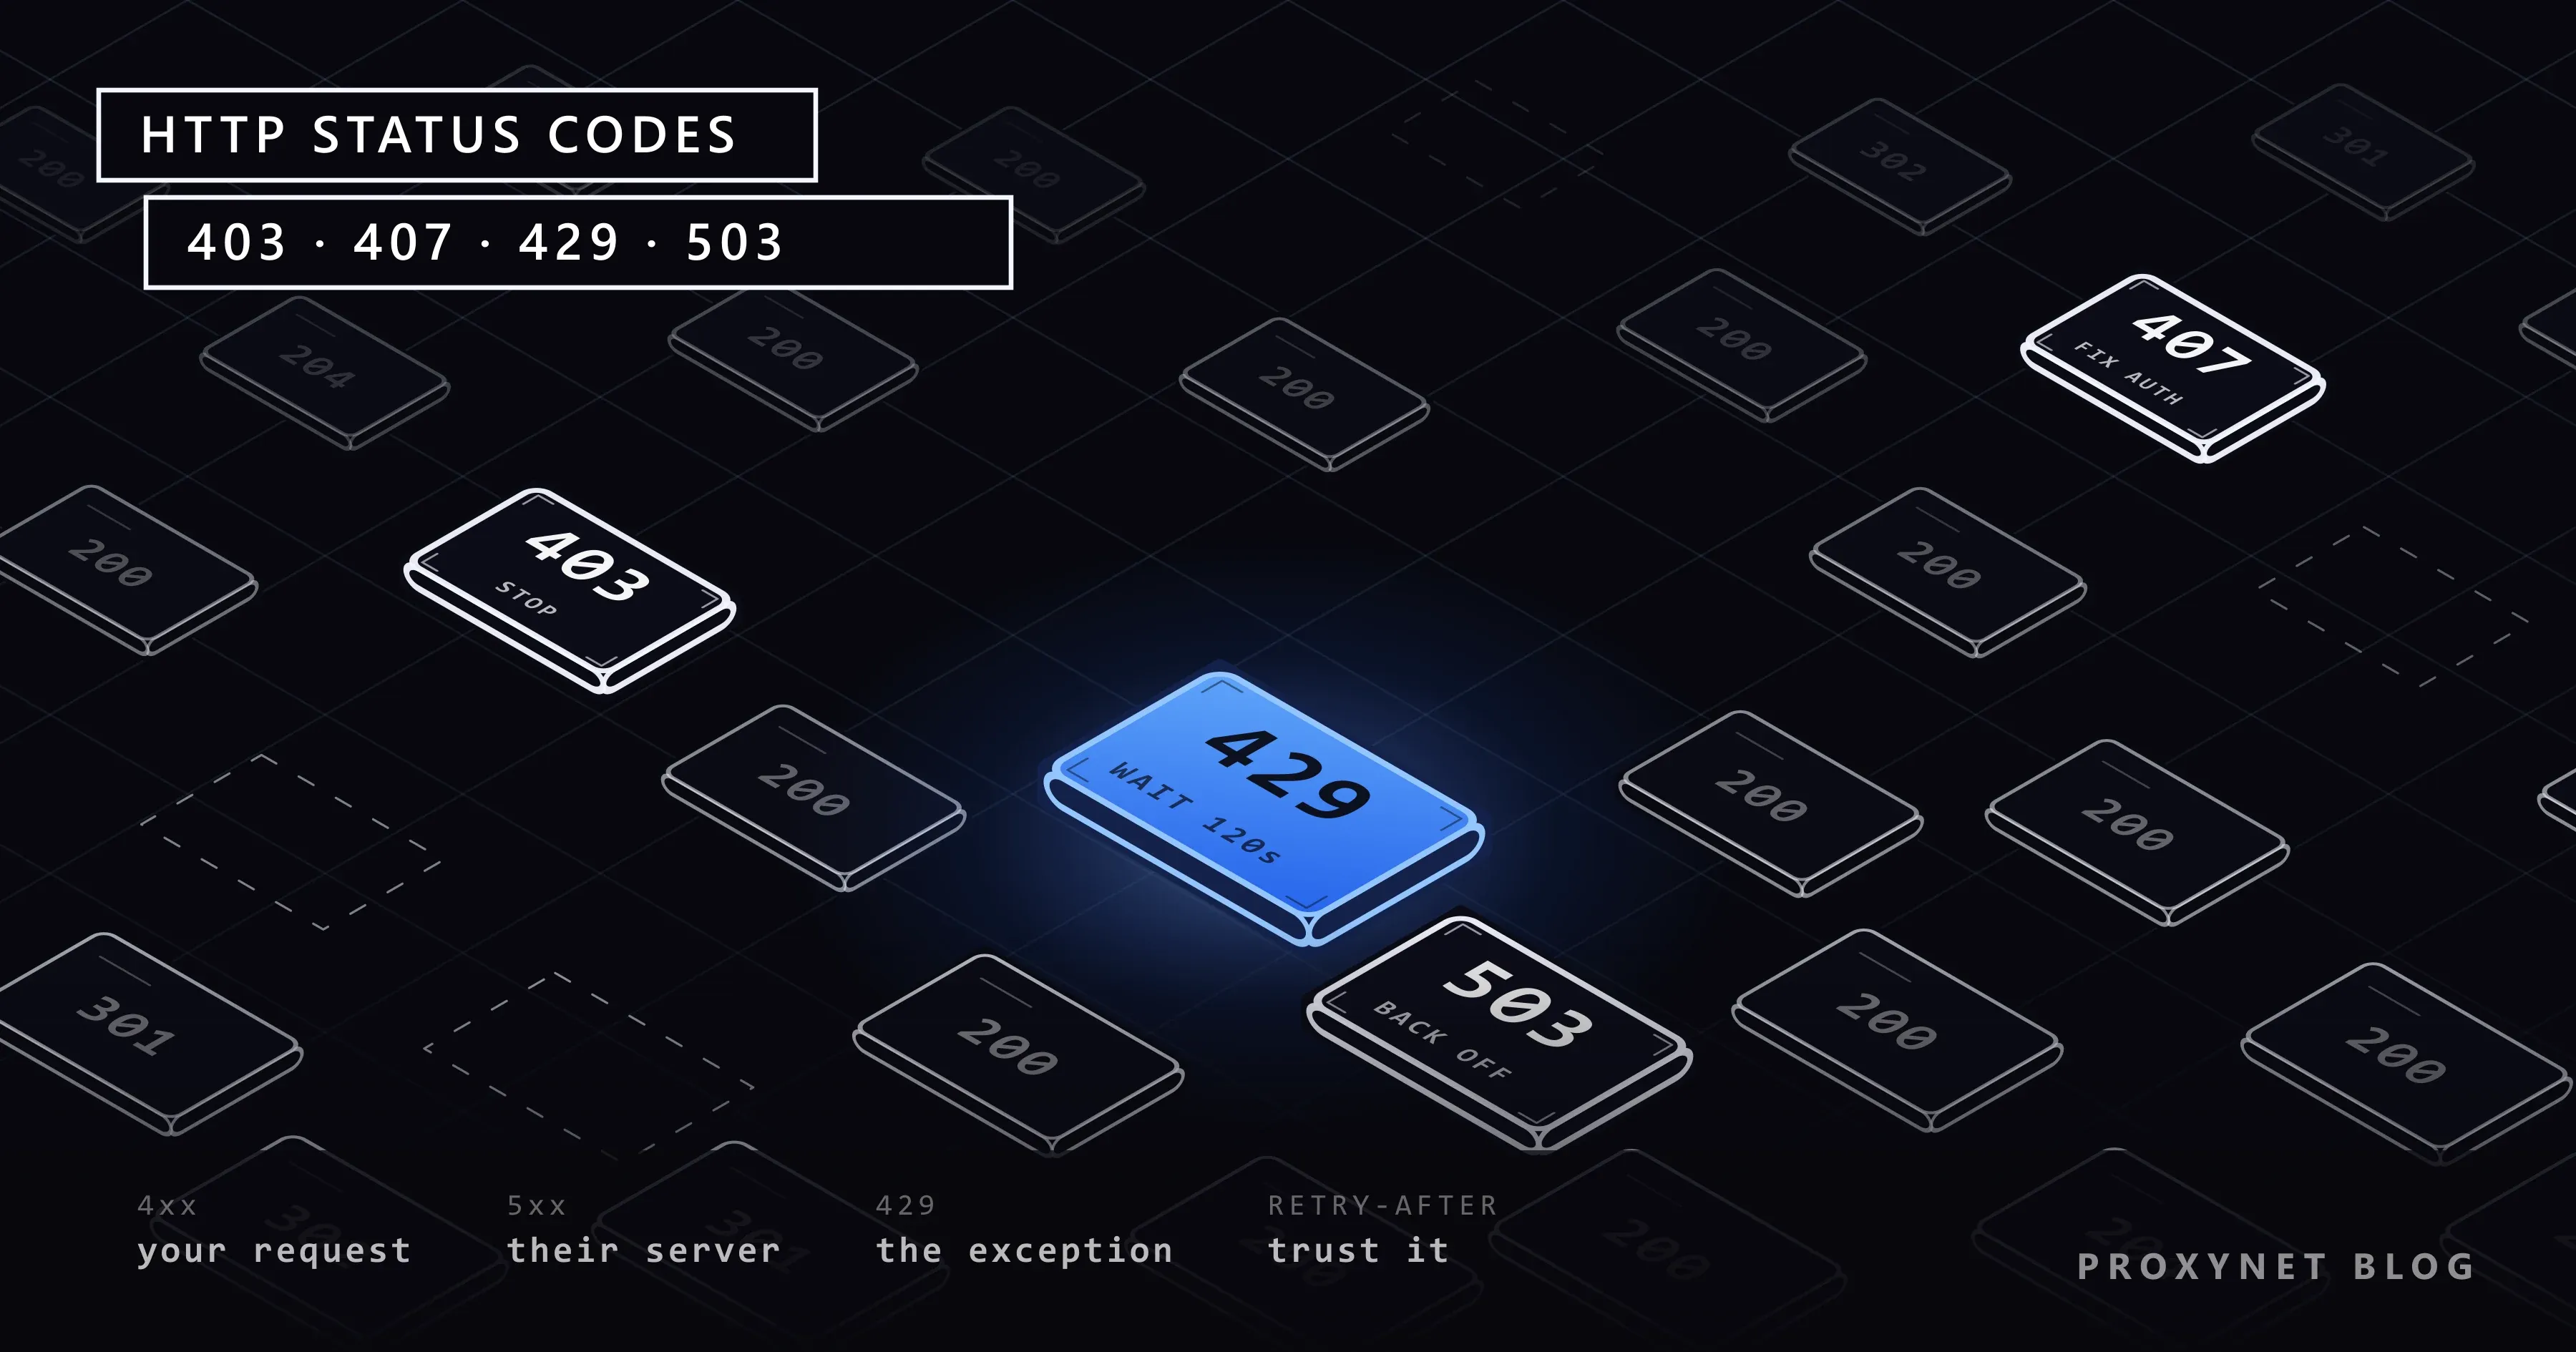
Publicado
Códigos de estado HTTP en web scraping: 403, 407, 429, 503
Las respuestas 403, 407, 429 y 503 indican problemas distintos en el scraping. Explicamos cada código, sus causas y cómo reintentar con Retry-After.
Autor:Acar Diveroli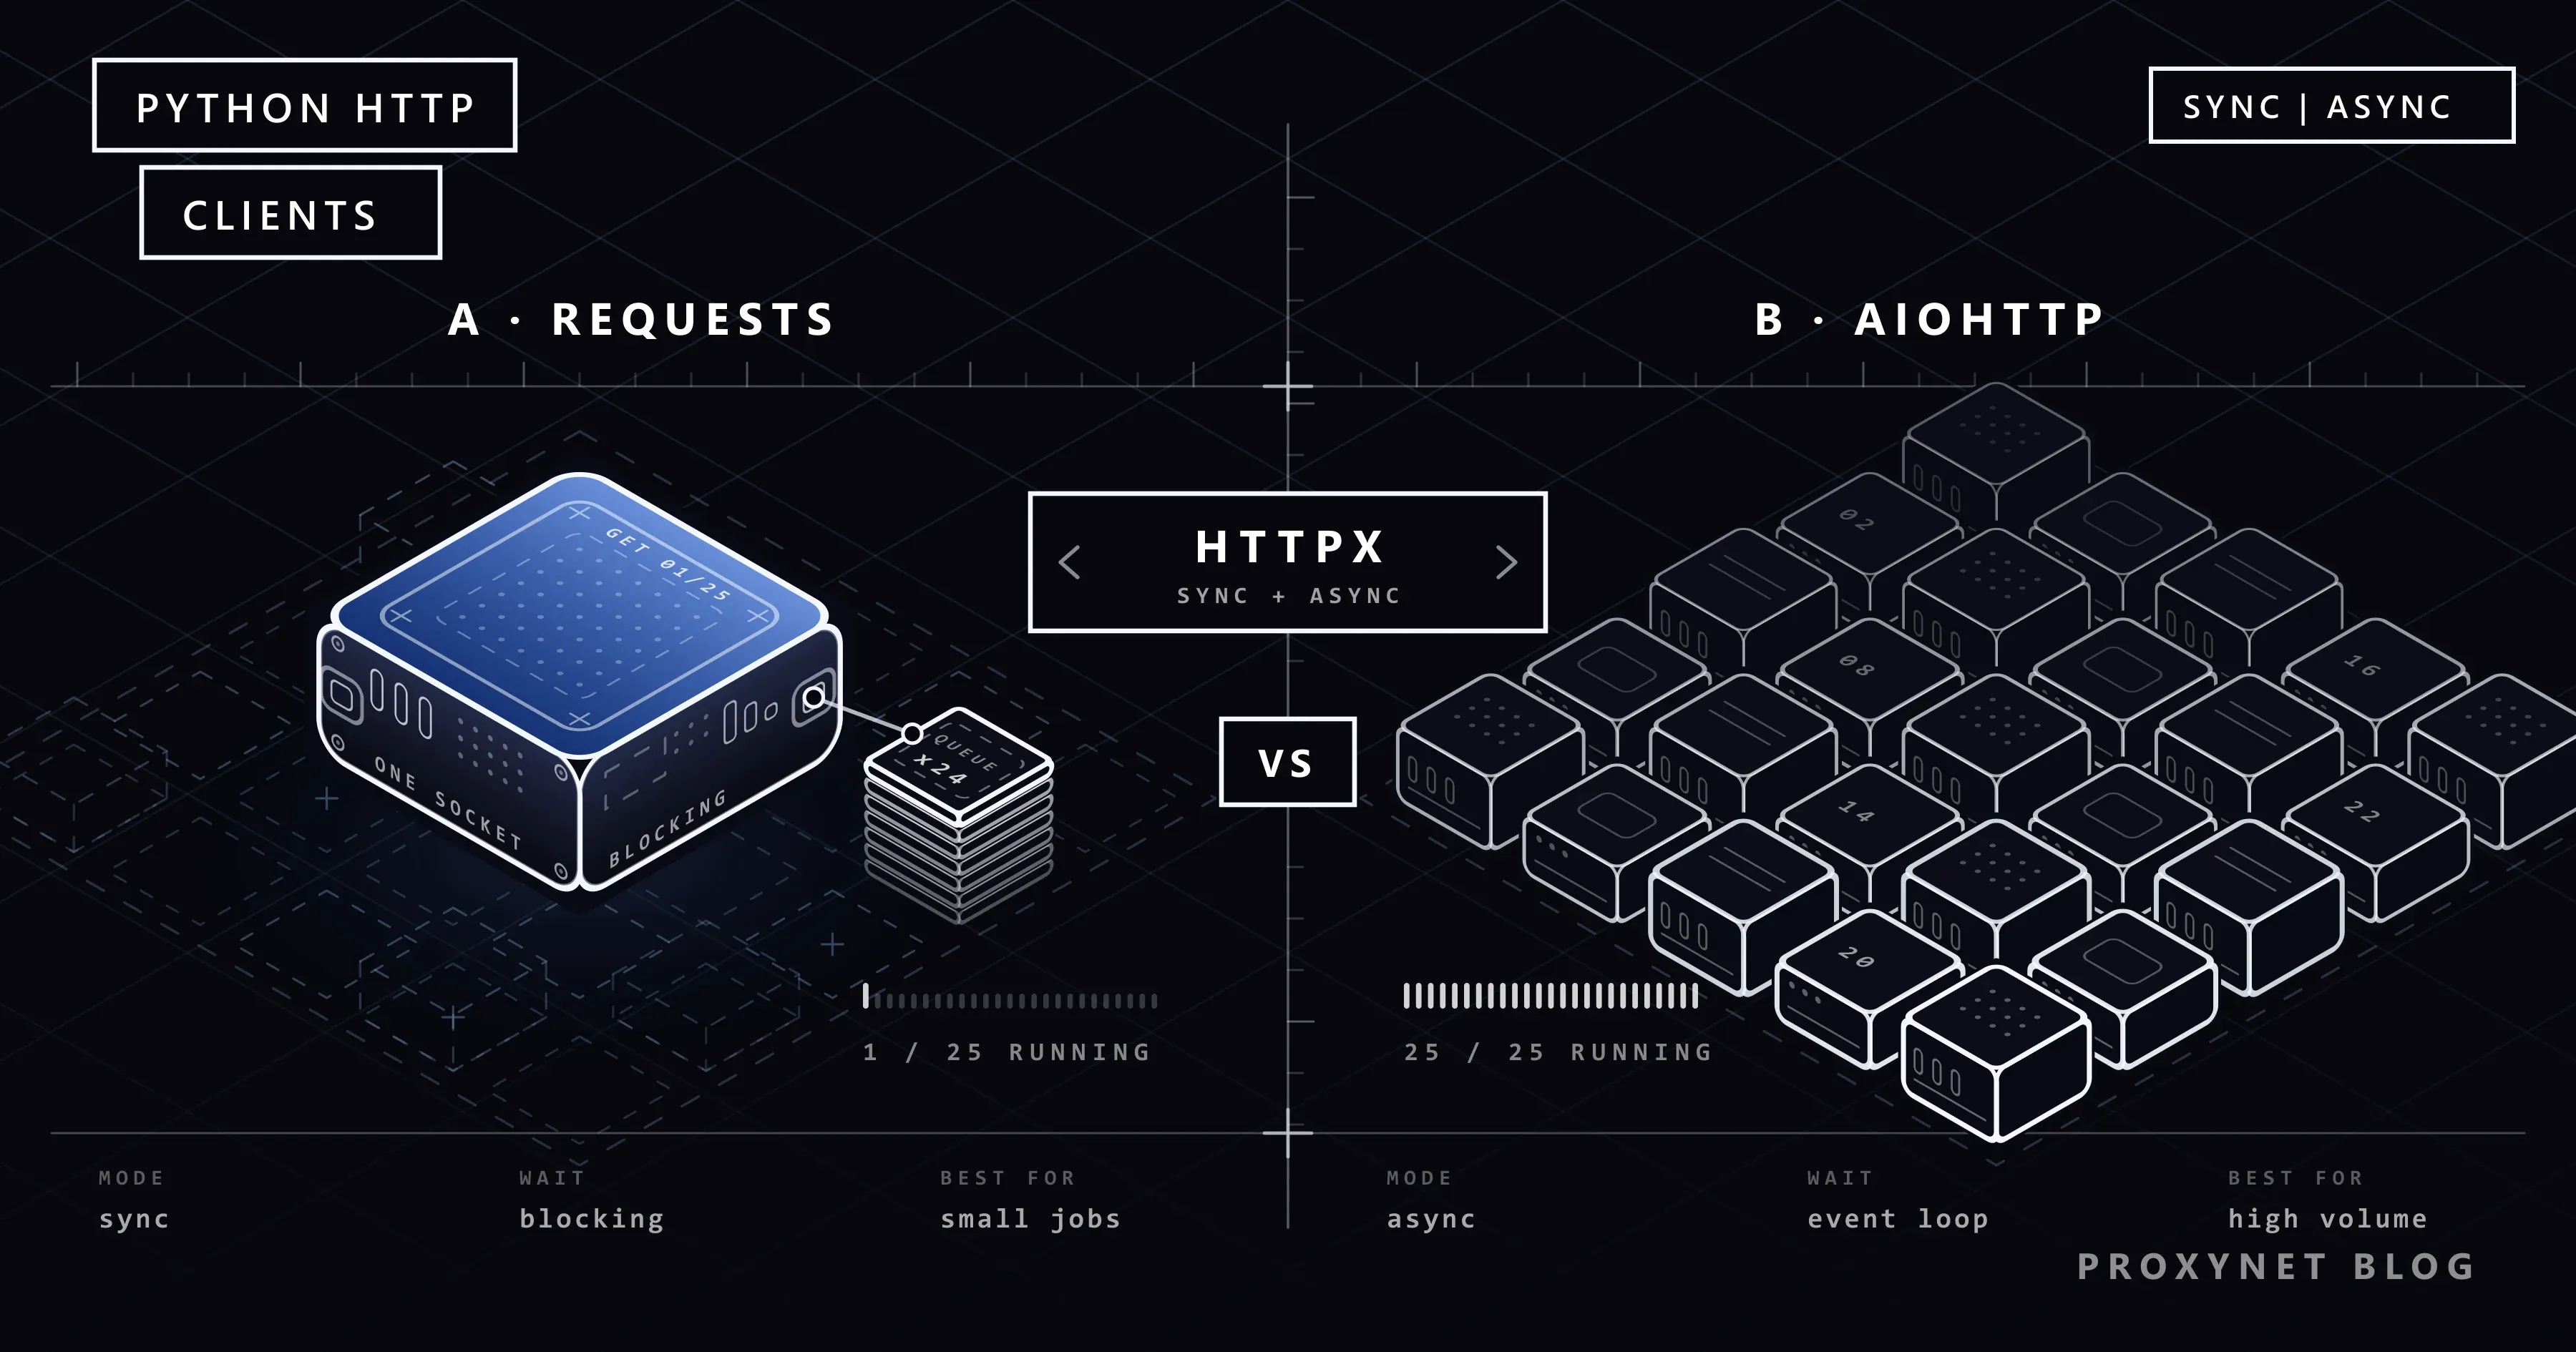
Publicado
HTTPX, Requests y AIOHTTP: comparativa
Requests es simple y síncrono, AIOHTTP es asíncrono y HTTPX ofrece los dos modos. Uso de proxy, rendimiento y cuál elegir en cada proyecto, con código.
Autor:Acar Diveroli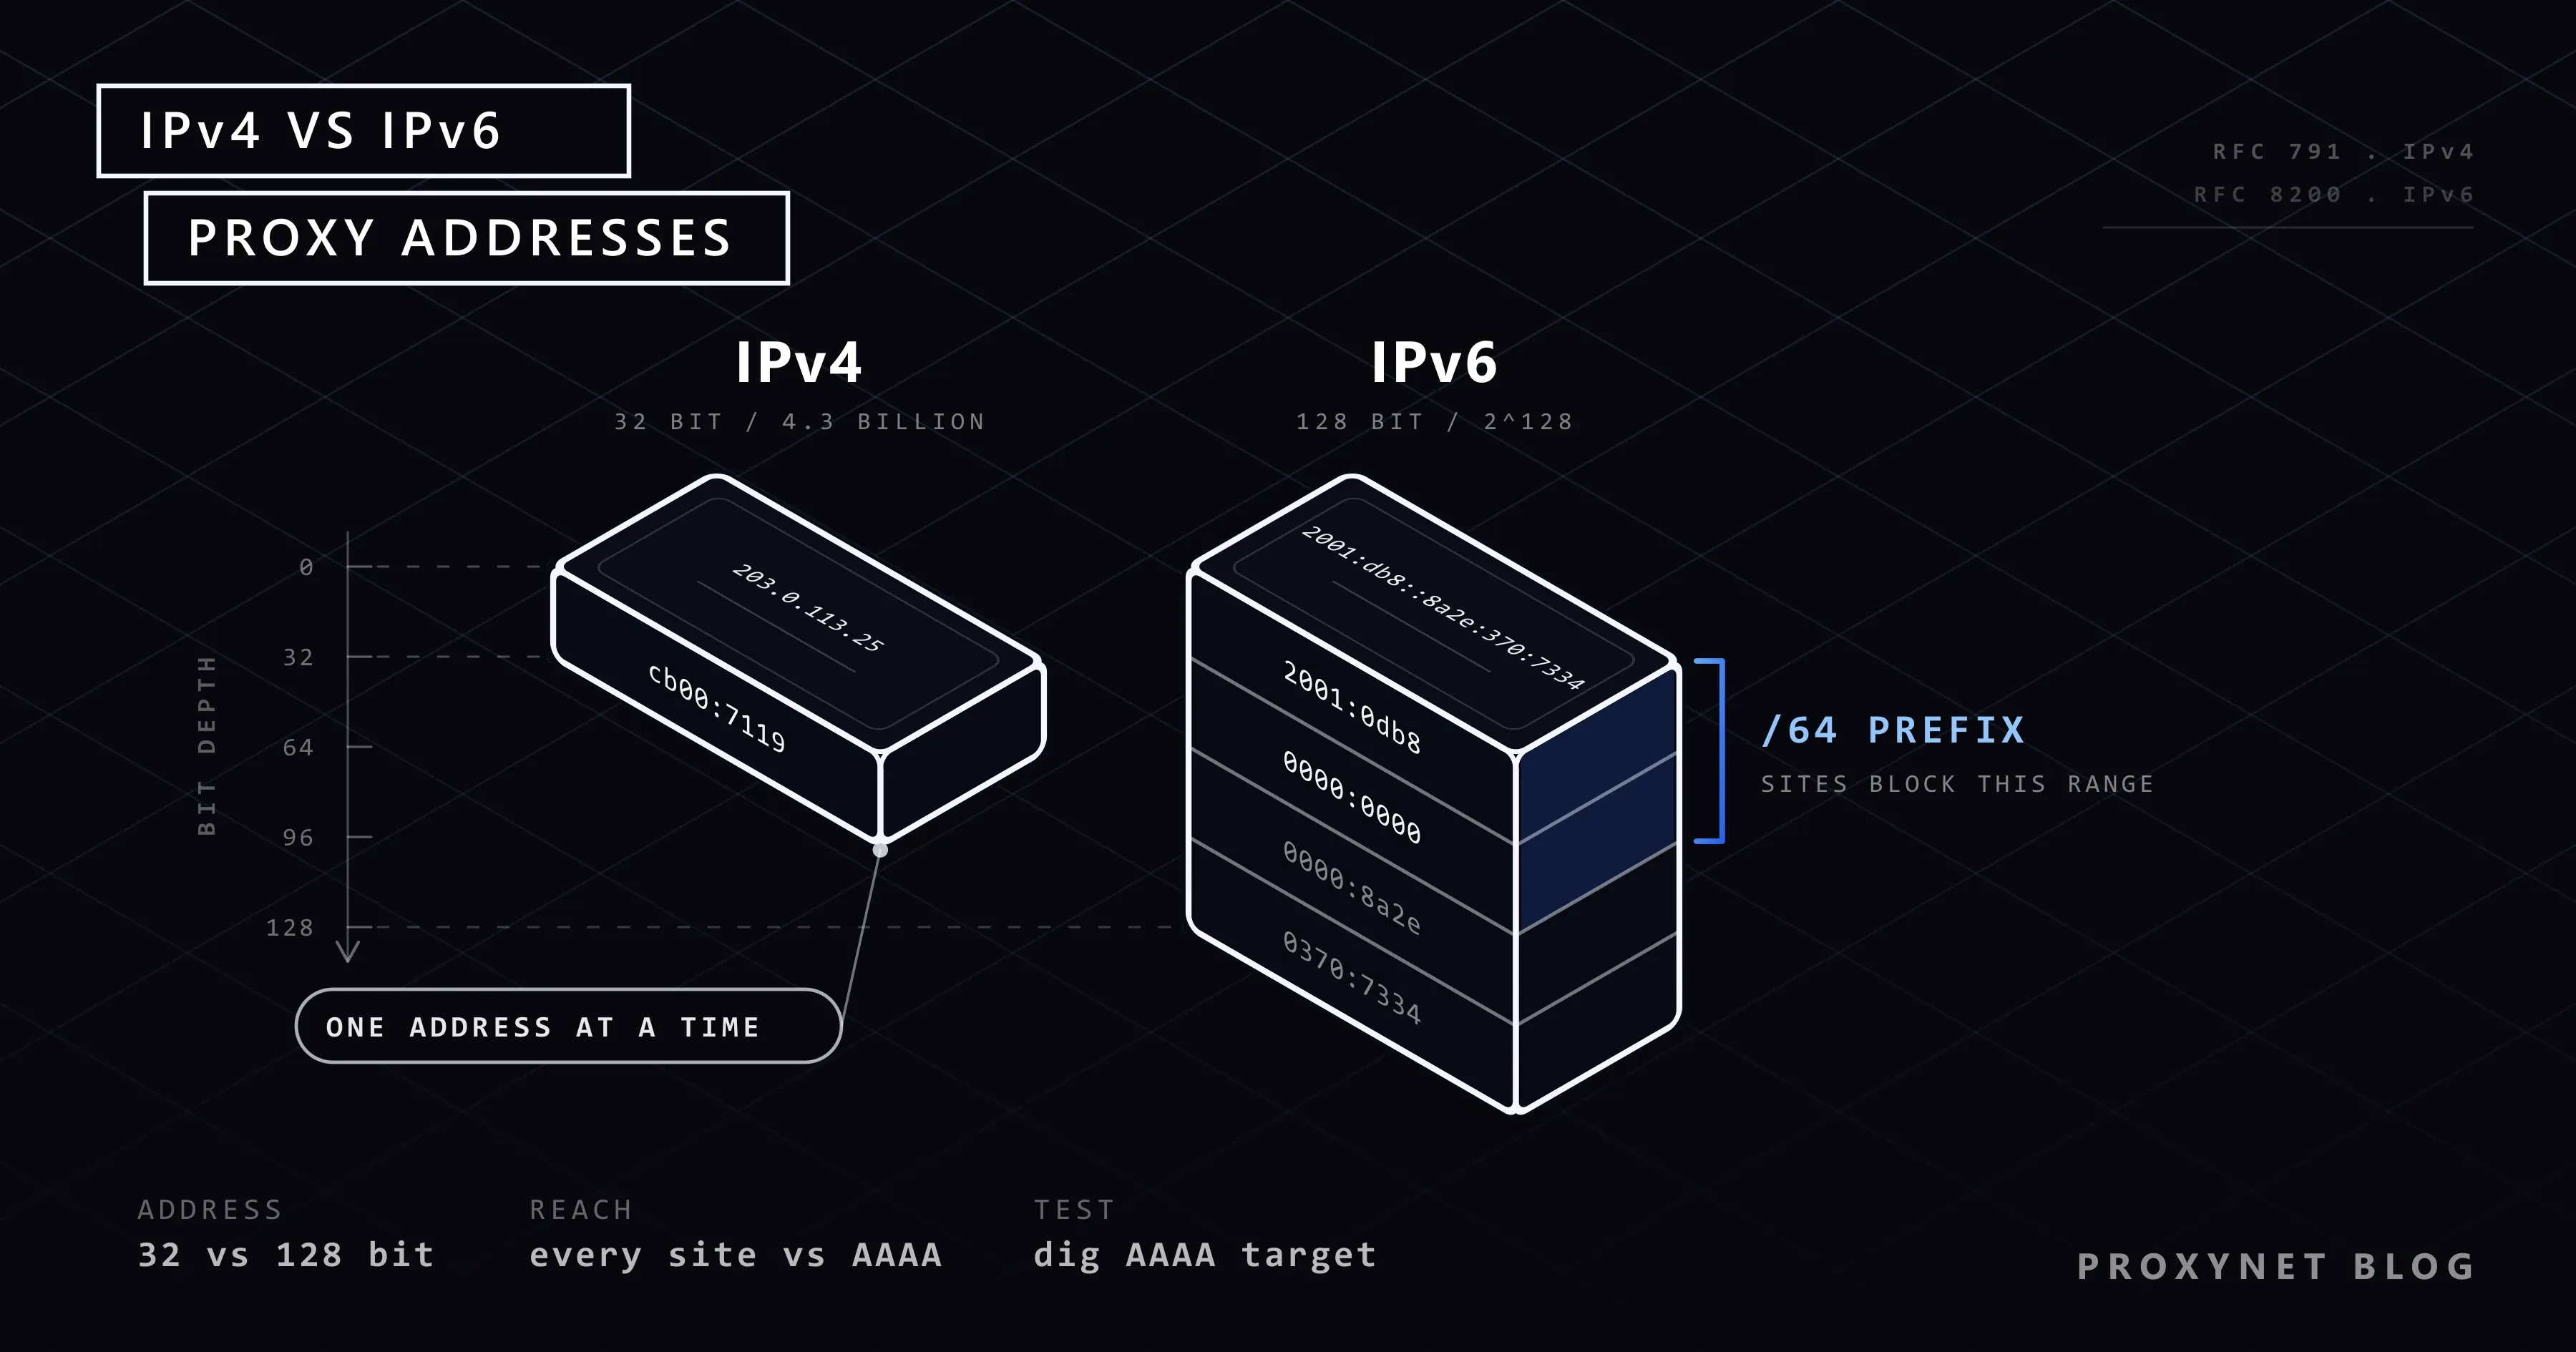
Publicado
Proxies IPv4 e IPv6: ¿cuál conviene elegir?
Los proxies IPv6 ofrecen un pool de direcciones enorme, pero no todos los sitios aceptan IPv6. Explicamos la diferencia, la compatibilidad y cómo elegir.
Autor:Acar Diveroli
¿Qué es la huella digital del navegador?
Autor: Acar DiveroliProxy 101Publicado
Cloudflare Precursor: qué es y cómo afecta al scraping
Autor: Acar DiveroliProxy 101Publicado
Concurrencia y paralelismo en web scraping
Autor: Acar DiveroliComparativasPublicado
Selector CSS o XPath: ¿cuál usar en web scraping?
Autor: Acar DiveroliComparativasPublicado
cURL en JavaScript: fetch, Axios y proxy
Autor: Acar DiveroliTutorialesPublicado
Forward proxy y reverse proxy: ¿en qué se diferencian?
Autor: Acar DiveroliComparativasPublicado
Web scraping con GPT-6 Astra: qué ha cambiado
Autor: Acar DiveroliIAPublicado
Qué son las trampas honeypot y cómo afectan al scraping
Autor: Acar DiveroliWeb scrapingPublicado
Agentes de IA: planificación, herramientas y memoria
Autor: Acar DiveroliIAPublicado
Códigos de estado HTTP en web scraping: 403, 407, 429, 503
Autor: Acar DiveroliWeb scrapingPublicado
HTTPX, Requests y AIOHTTP: comparativa
Autor: Acar DiveroliComparativasPublicado
Proxies IPv4 e IPv6: ¿cuál conviene elegir?
Autor: Acar DiveroliComparativasPublicado
Ningún artículo coincide
Publicado
Publicado