
Proxynet Blog – Seite 18

Veröffentlicht
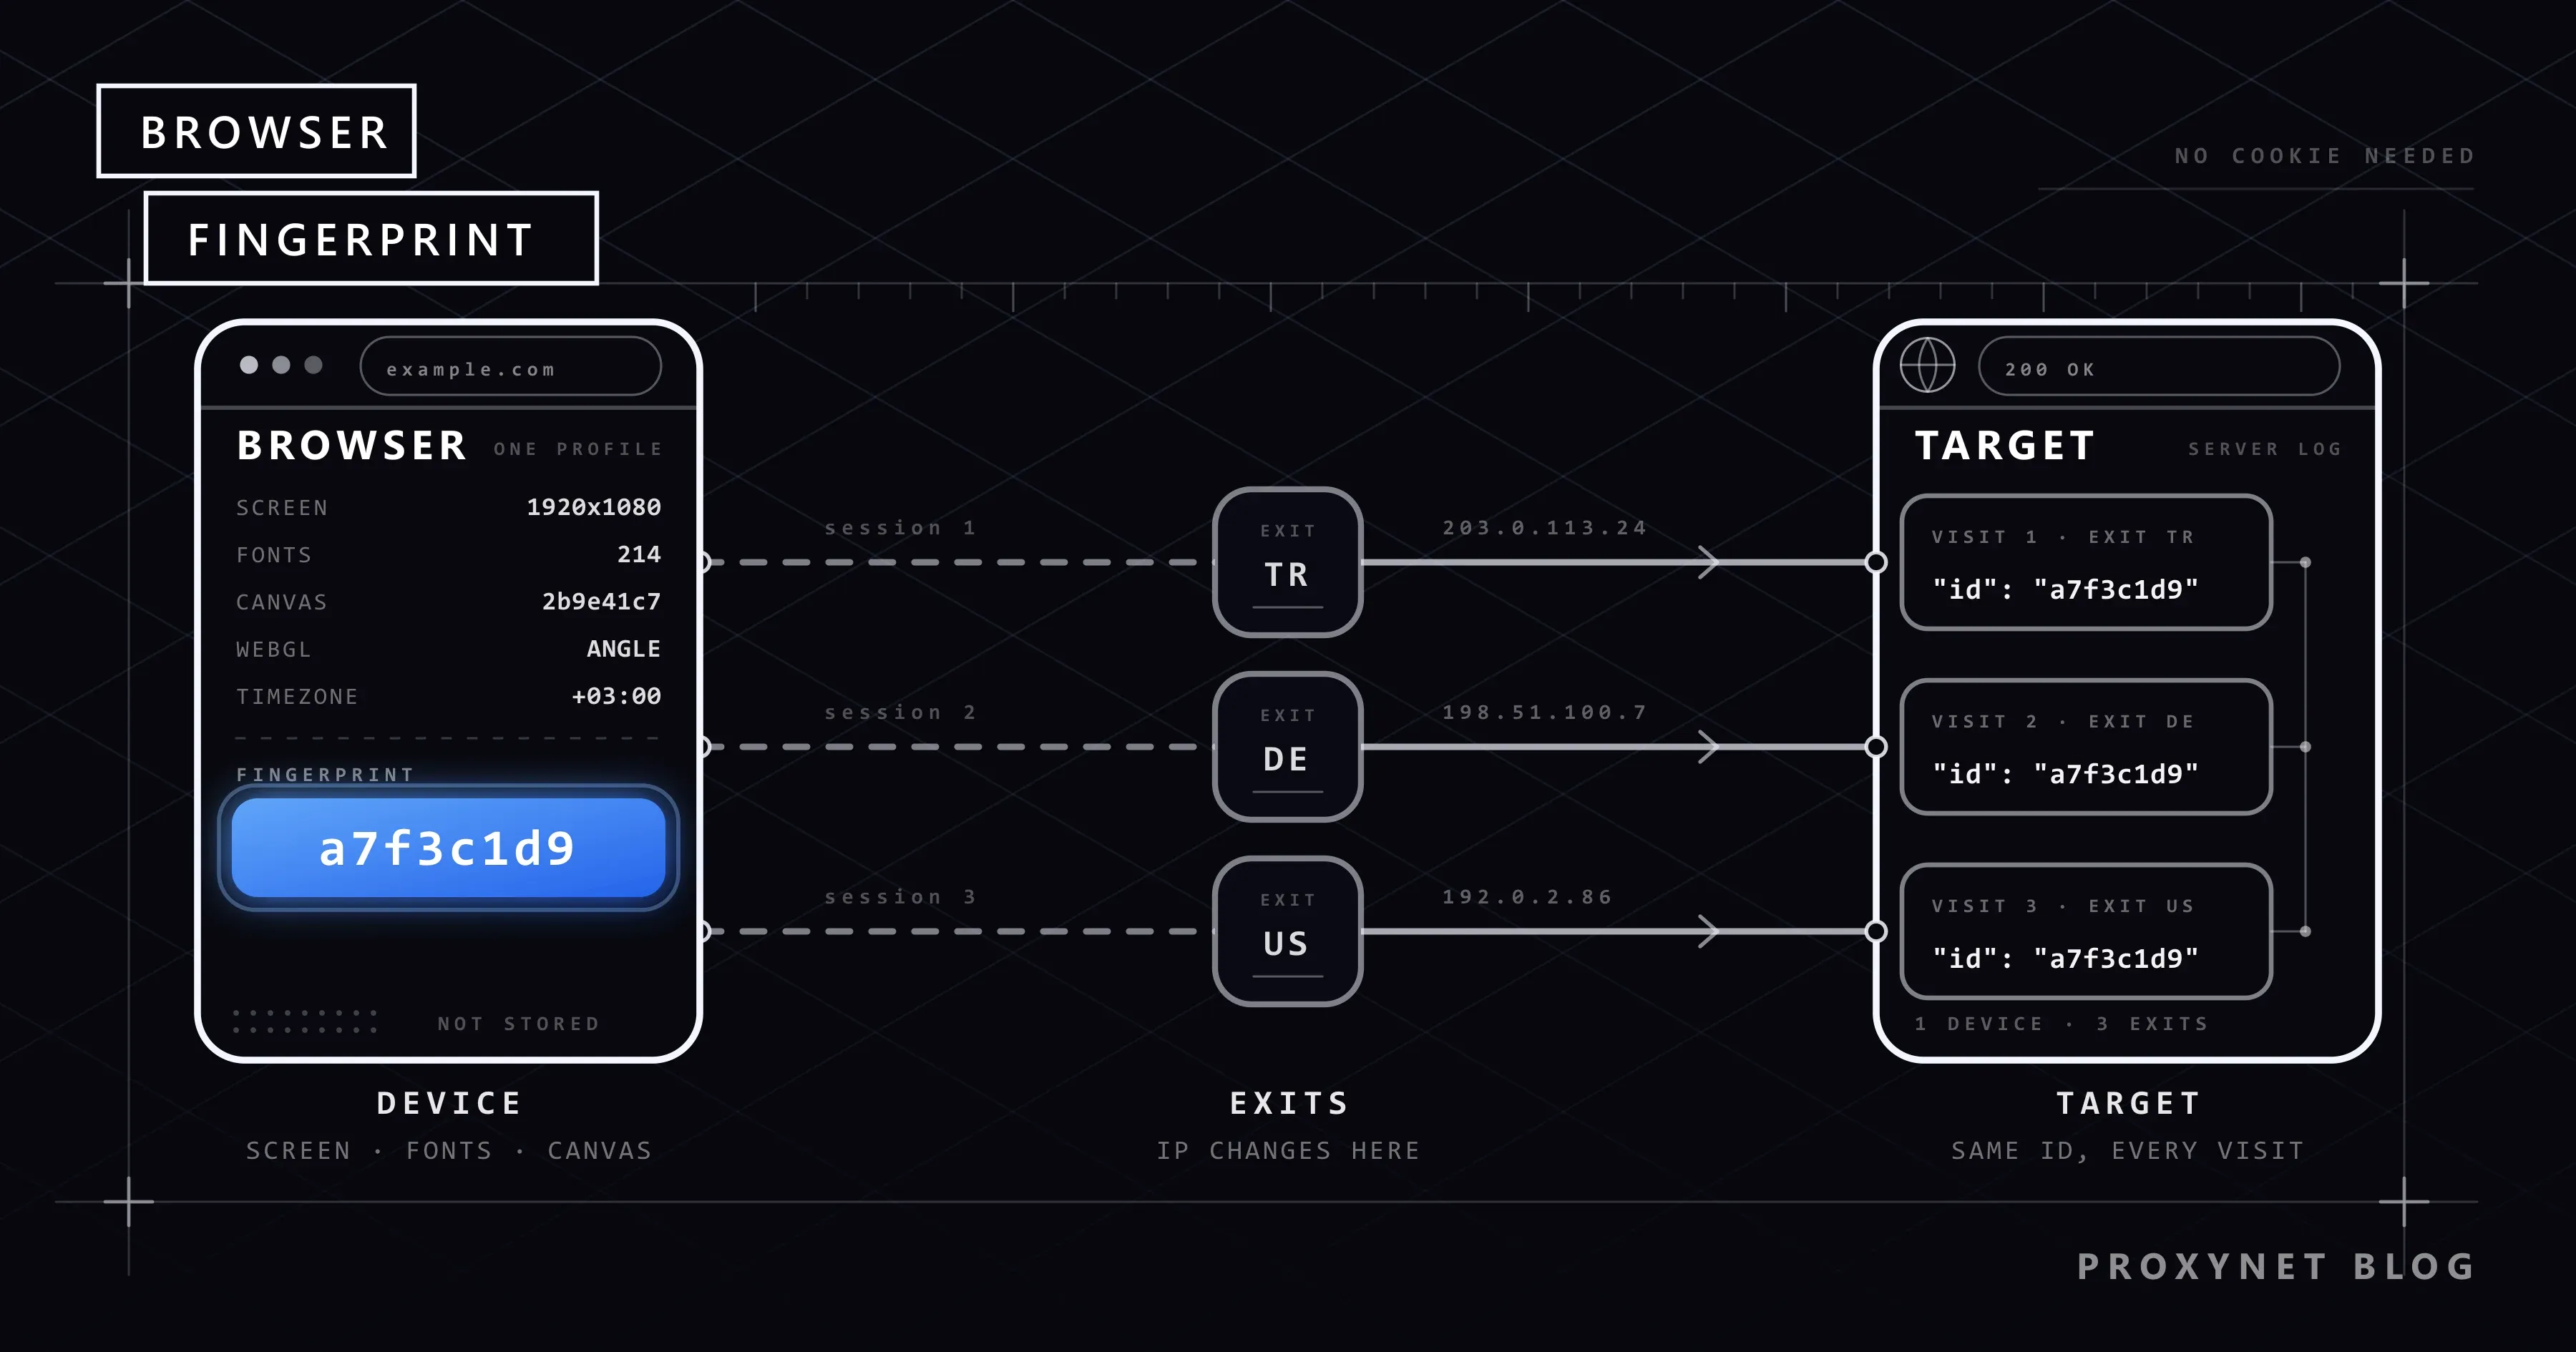
Was ist Browser-Fingerprinting?
Browser-Fingerprinting erkennt Ihr Gerät anhand von Bildschirm-, Schrift- und Canvas-Signalen ohne Cookies. Warum ein IP-Wechsel dabei allein nicht genügt.
Autor: Acar Diveroli
Veröffentlicht
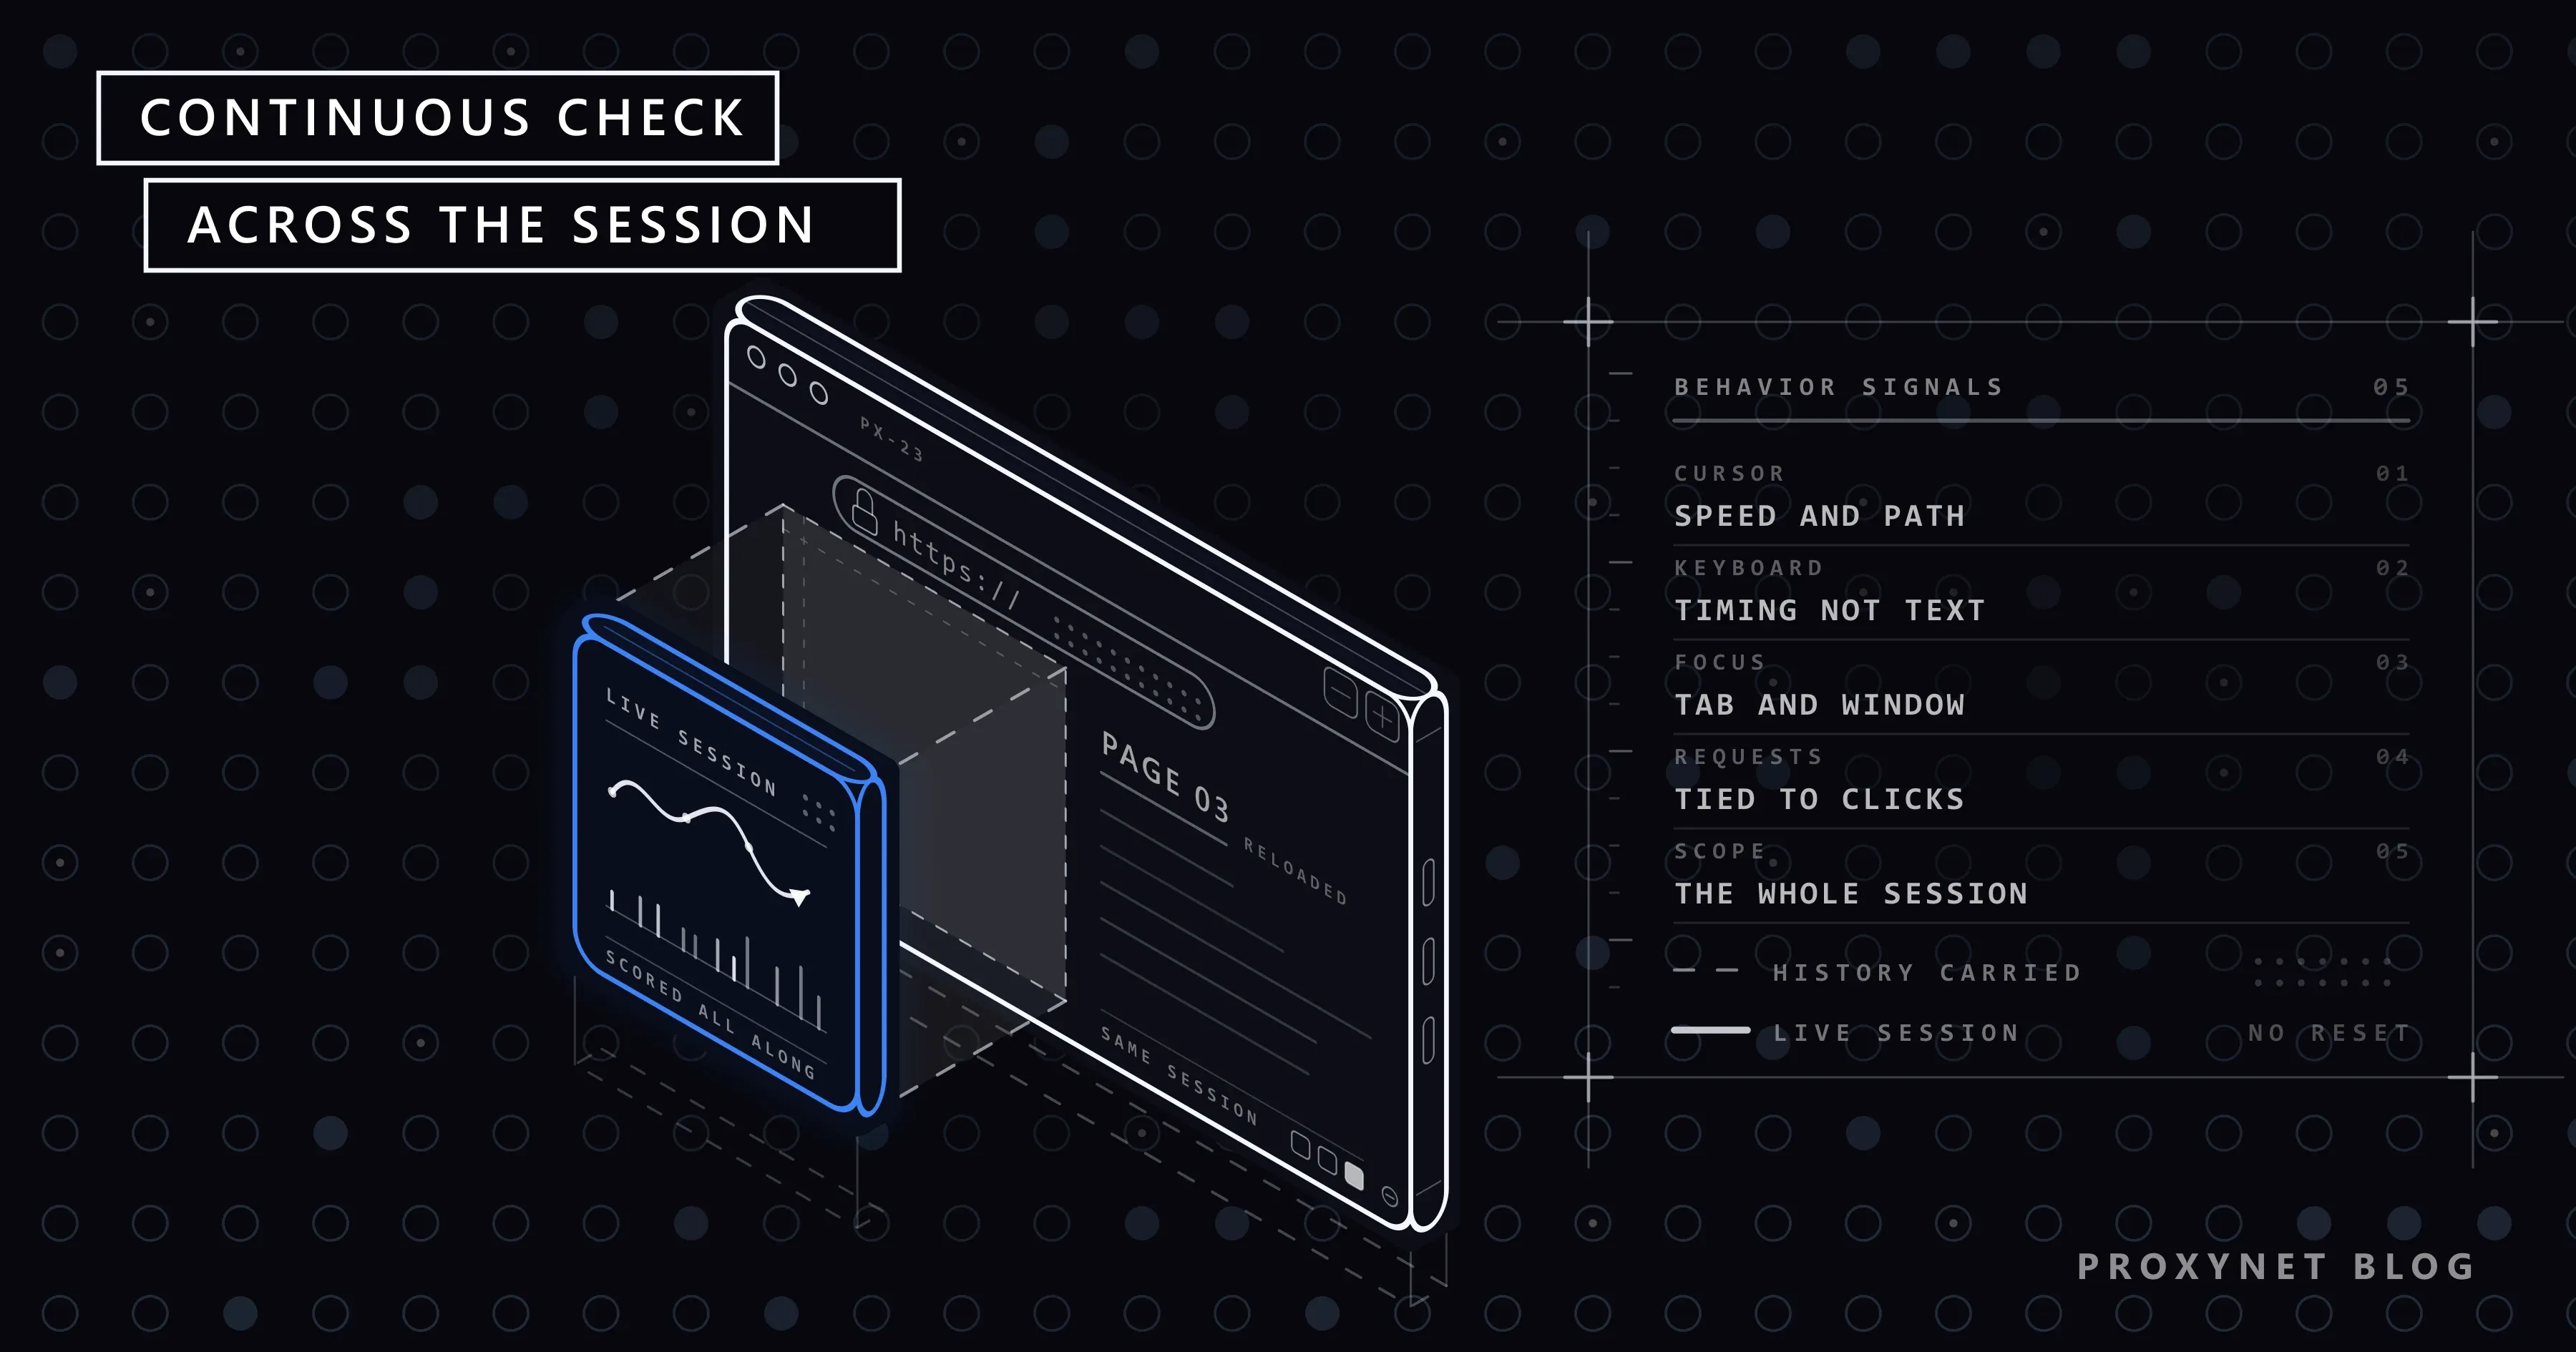
Cloudflare Precursor: was bedeutet er für Scraping?
Cloudflare Precursor bewertet Besucherverhalten über die gesamte Sitzung. Was die neue Bot-Erkennungsebene misst und was sich für Automatisierung ändert.
Autor:Acar Diveroli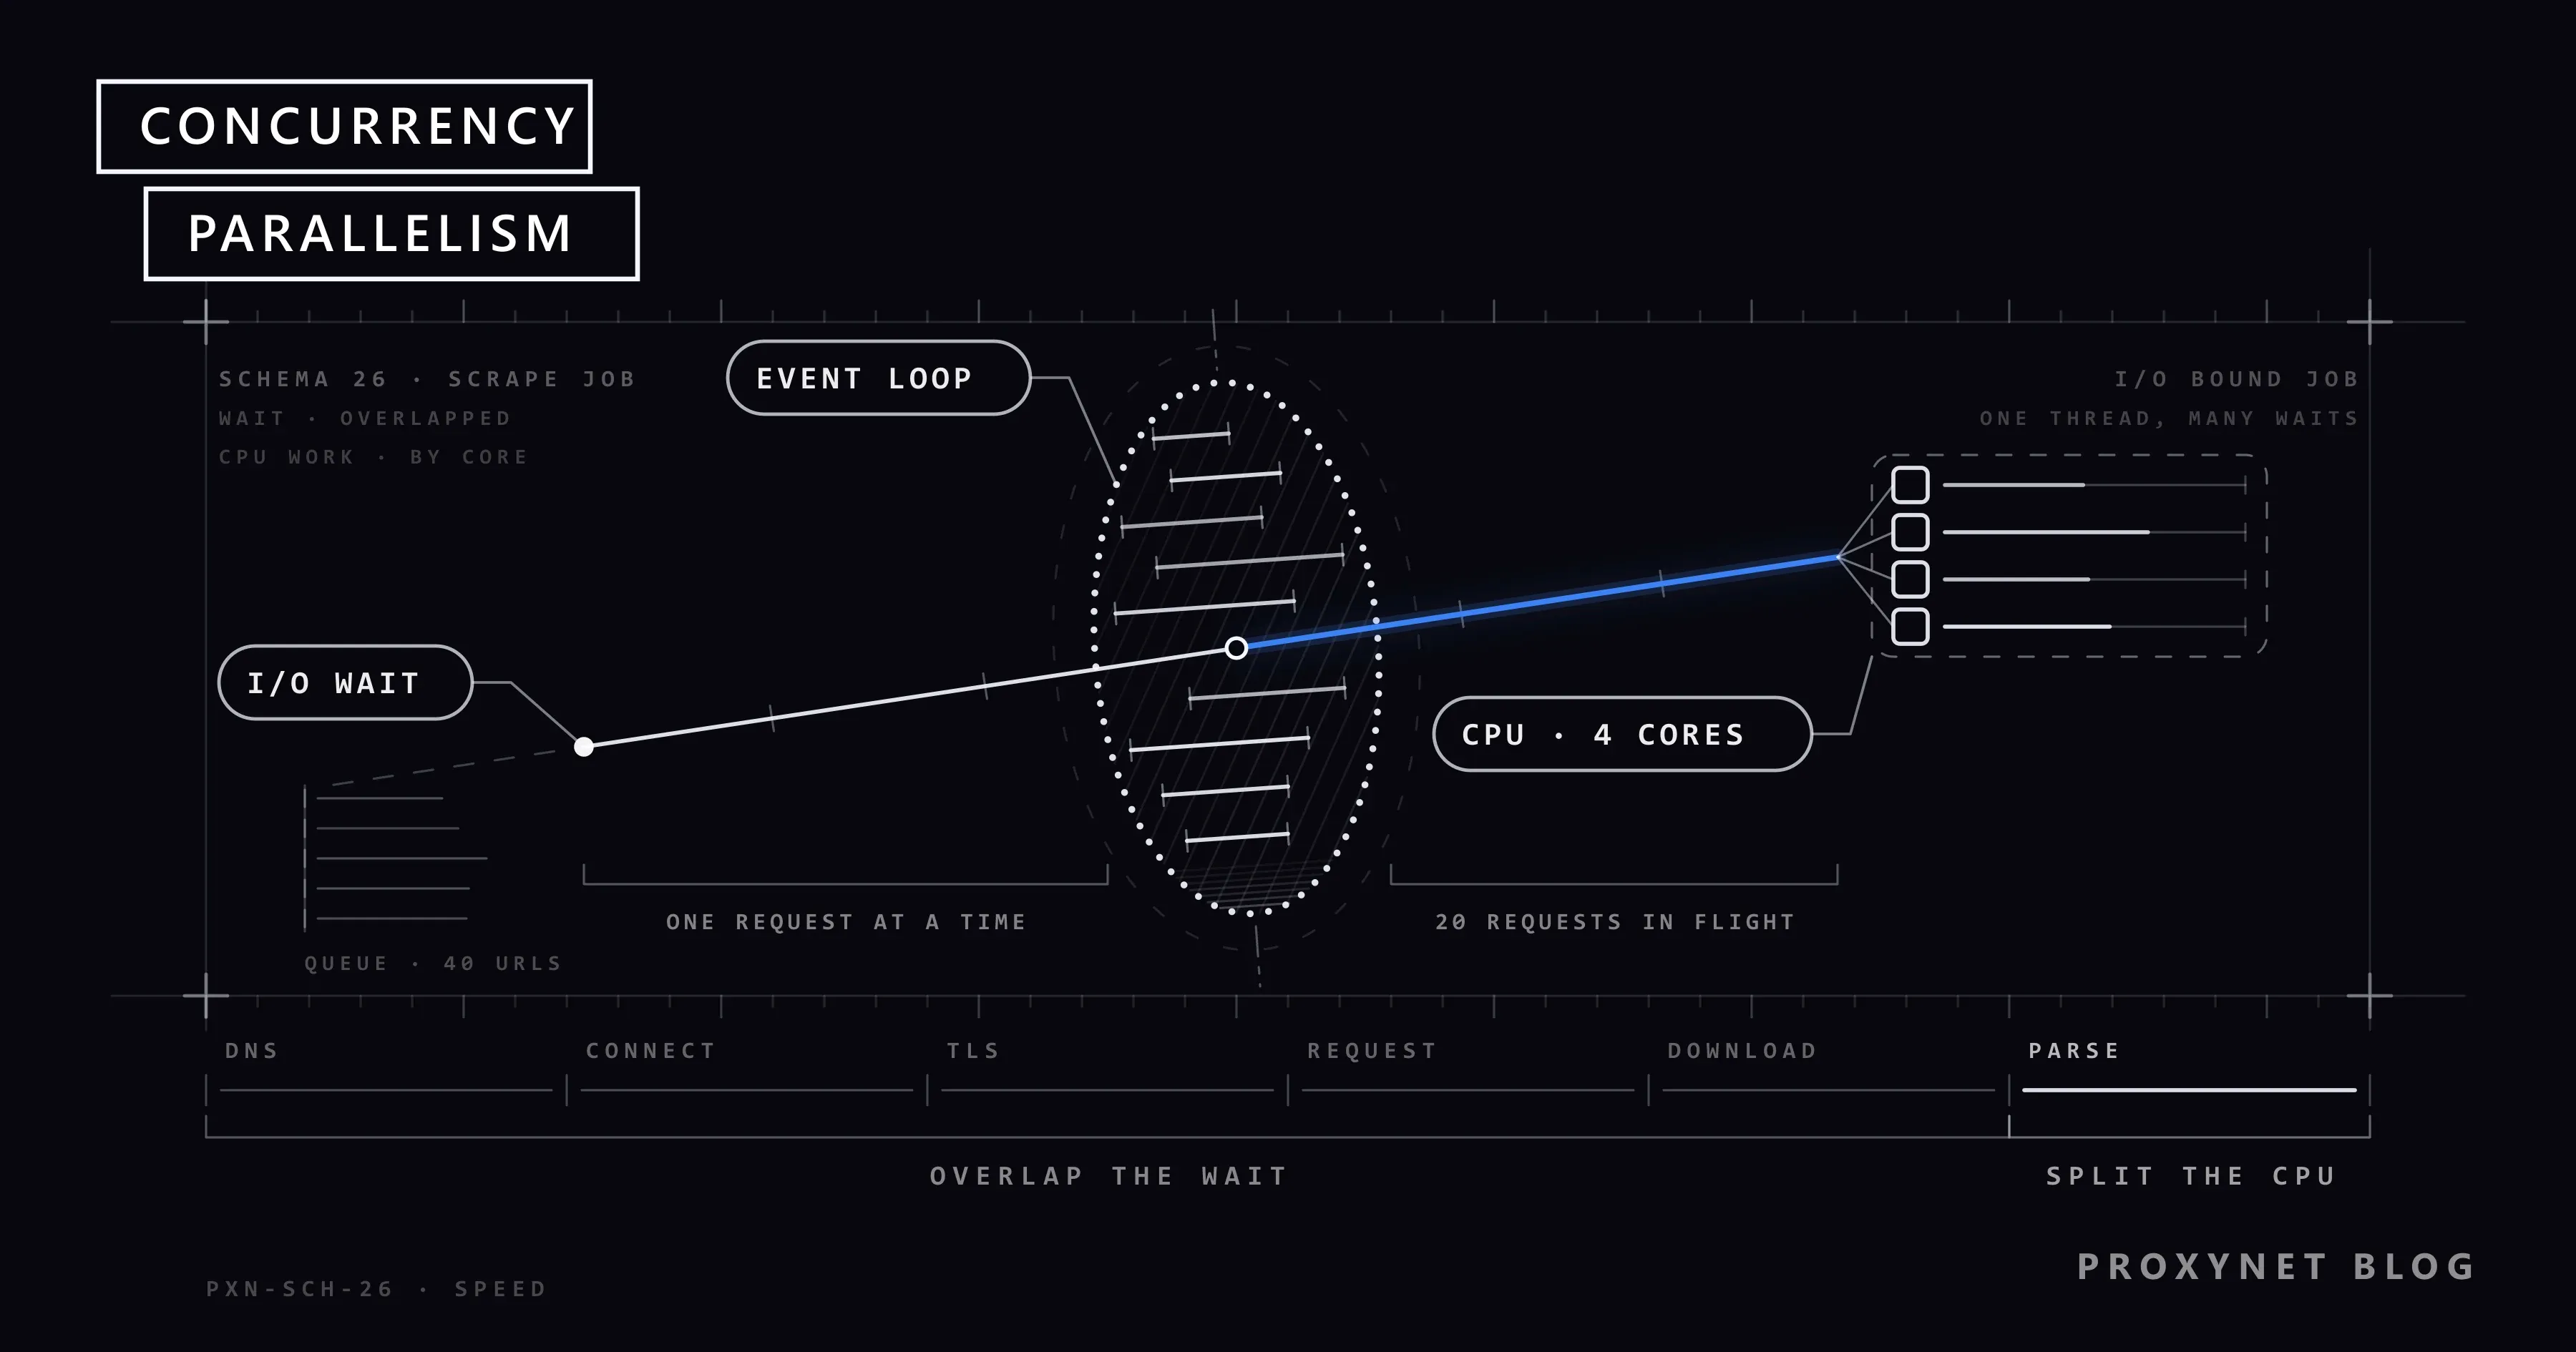
Veröffentlicht
Concurrency und Parallelism: Was bestimmt Scraping-Tempo?
Nebenläufigkeit nutzt Wartezeit, Parallelität nutzt CPU-Leistung. Wir erklären mit Python- und Node.js-Beispielen, was Scraping wirklich beschleunigt.
Autor:Acar Diveroli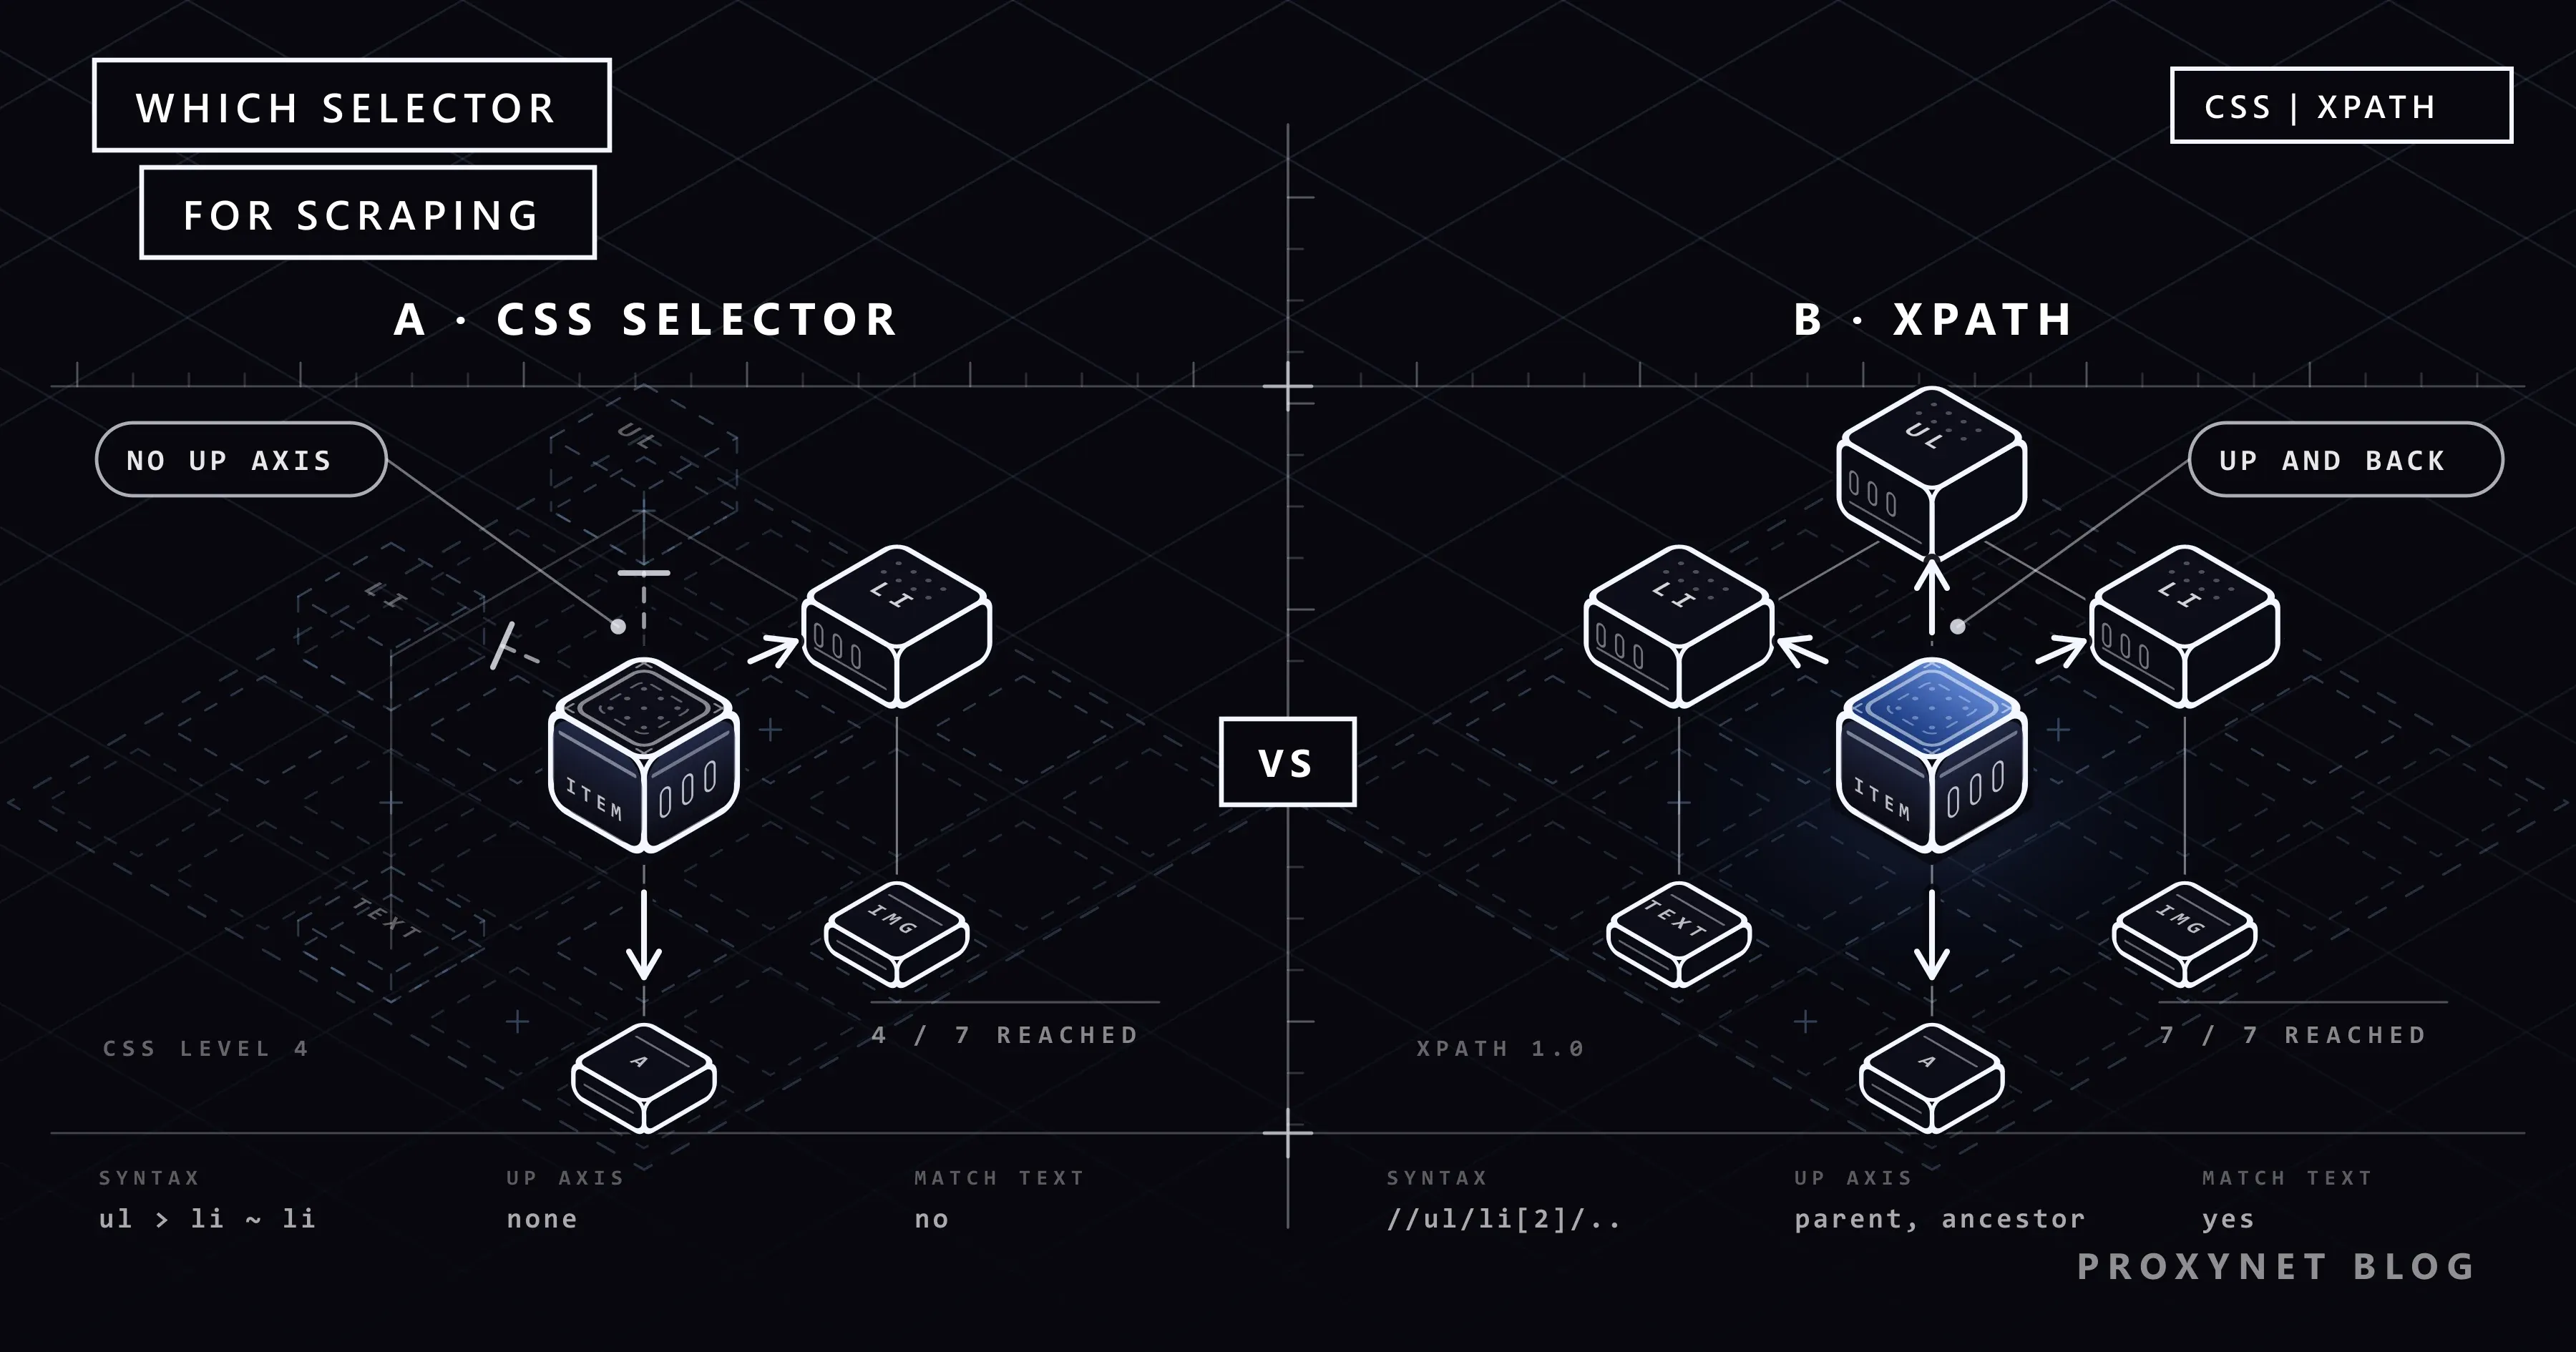
Veröffentlicht
CSS-Selektor oder XPath: Was passt zum Web Scraping?
CSS-Selektoren sind kurz und lesbar, XPath wählt auch nach Text und Elternelement. Wir vergleichen Syntax, Tempo und Python-Beispiele für beide Methoden.
Autor:Acar Diveroli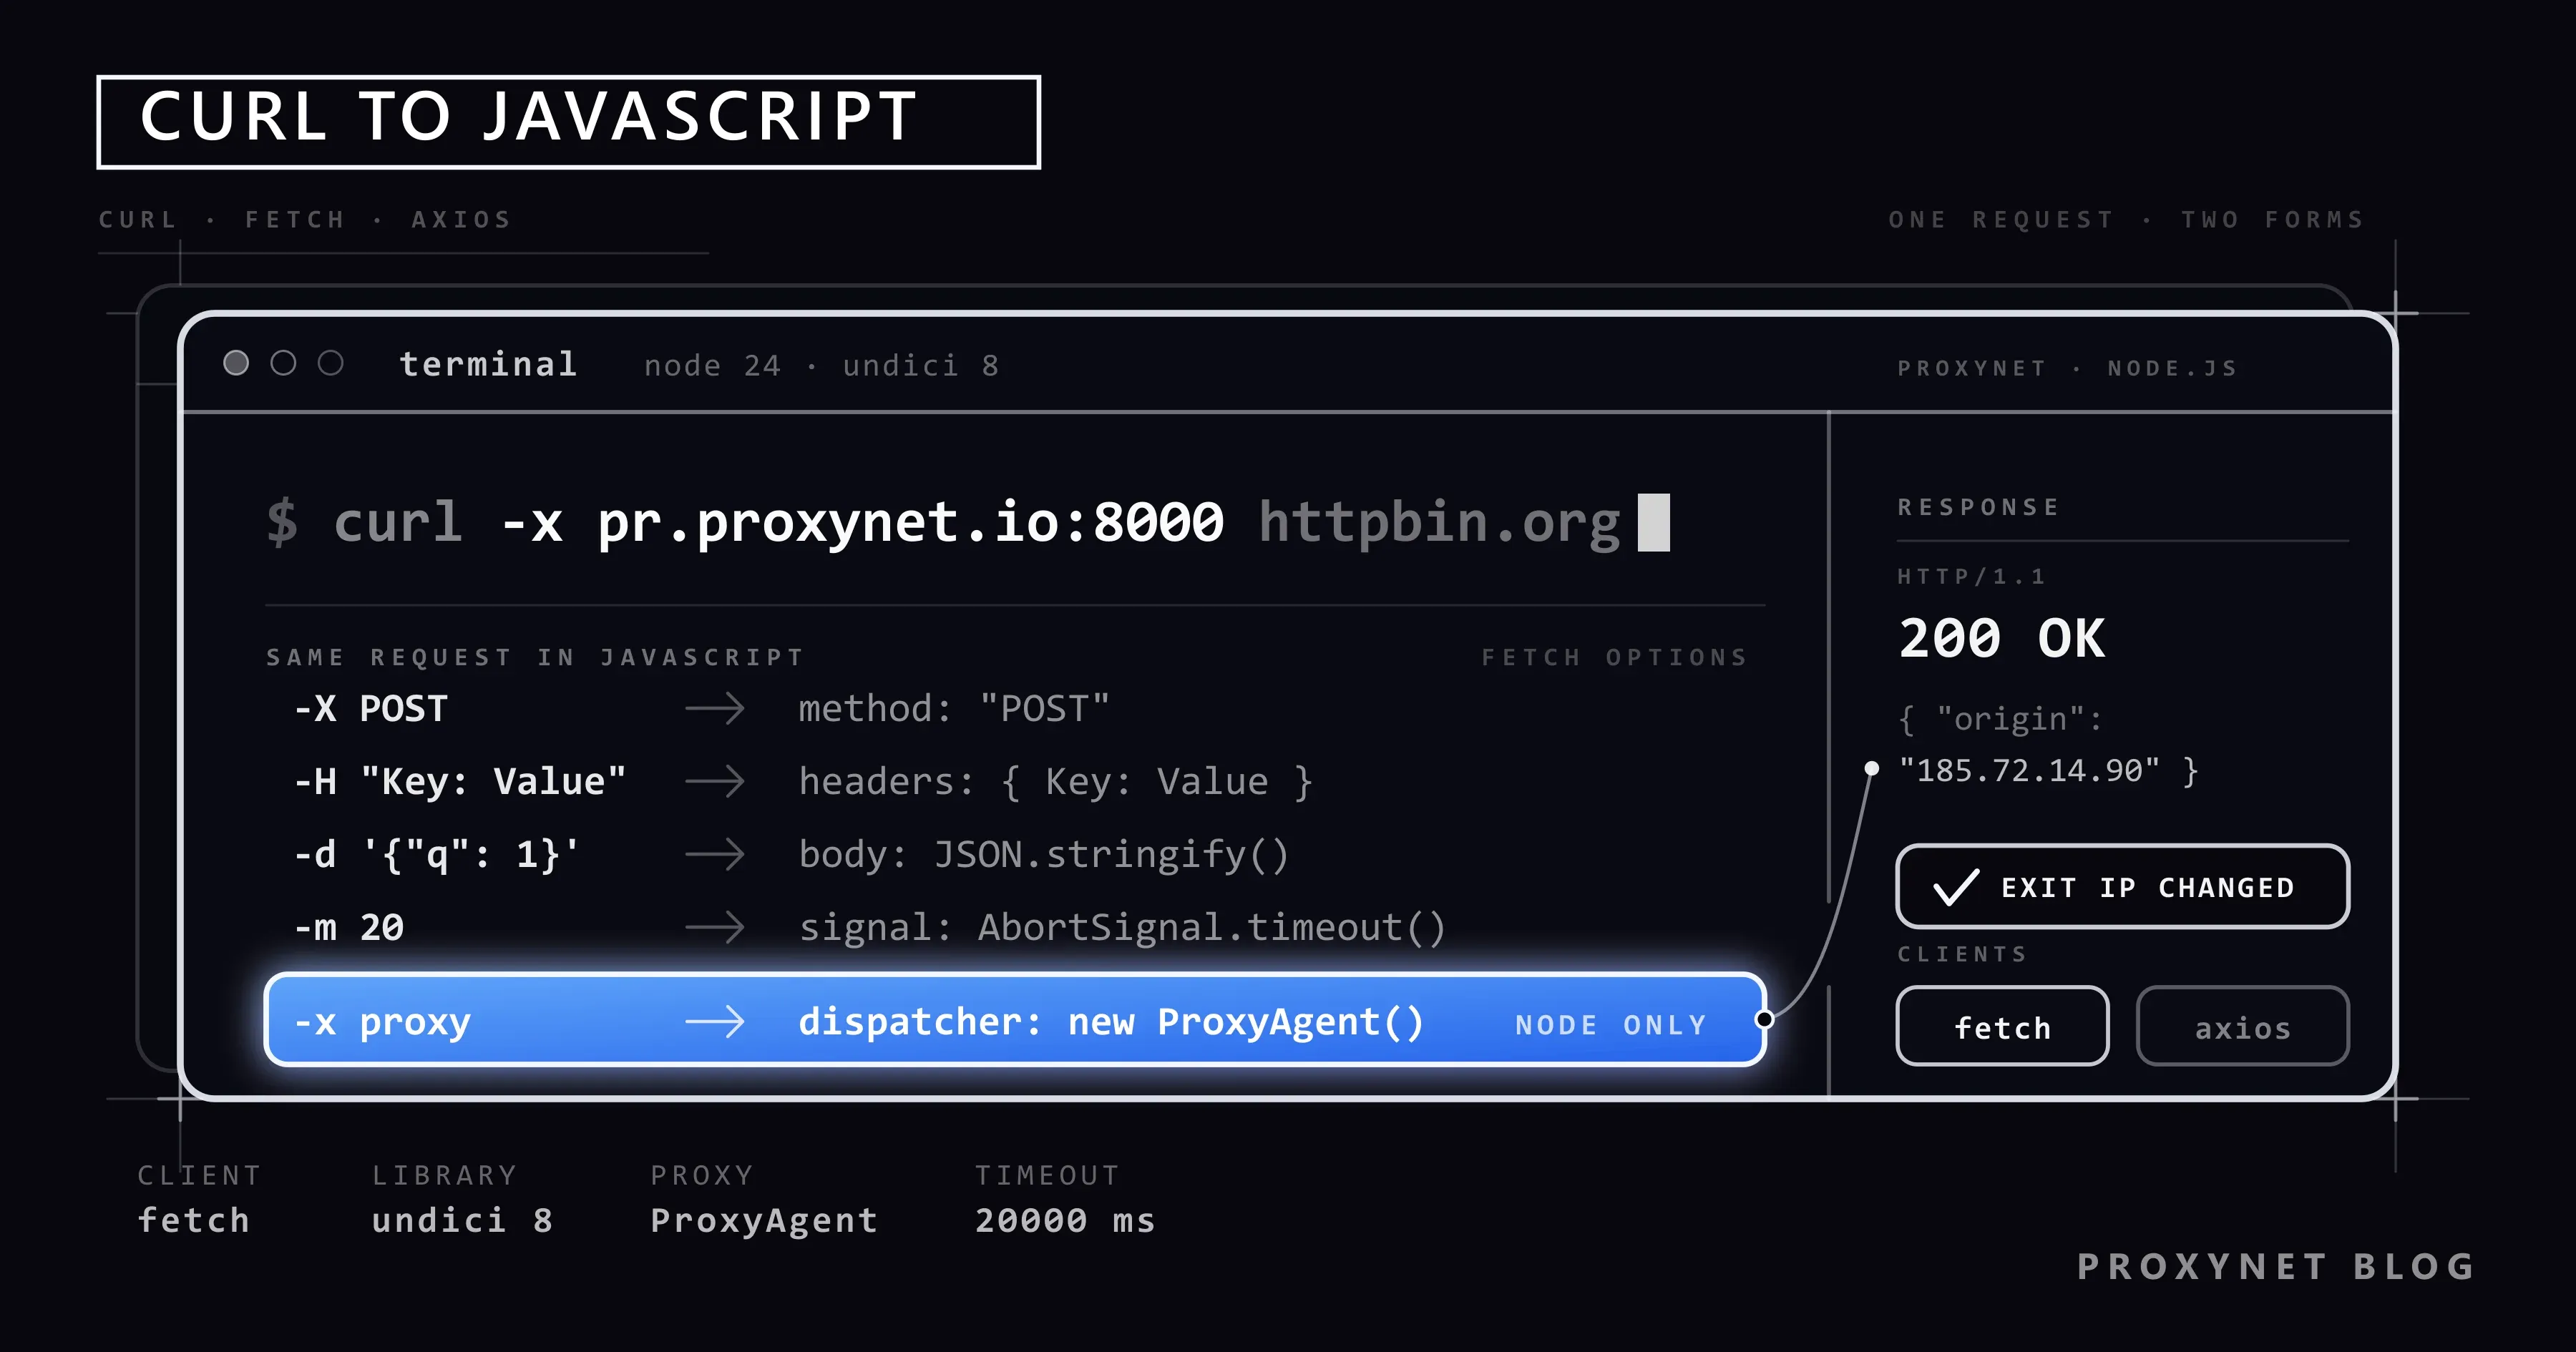
Veröffentlicht
cURL in JavaScript: fetch, Axios und Proxy
Das JavaScript-Gegenstück zu cURL sind fetch und Axios. Header, Body, Authentifizierung und Proxy-Einrichtung in Node.js mit getesteten Codebeispielen.
Autor:Acar Diveroli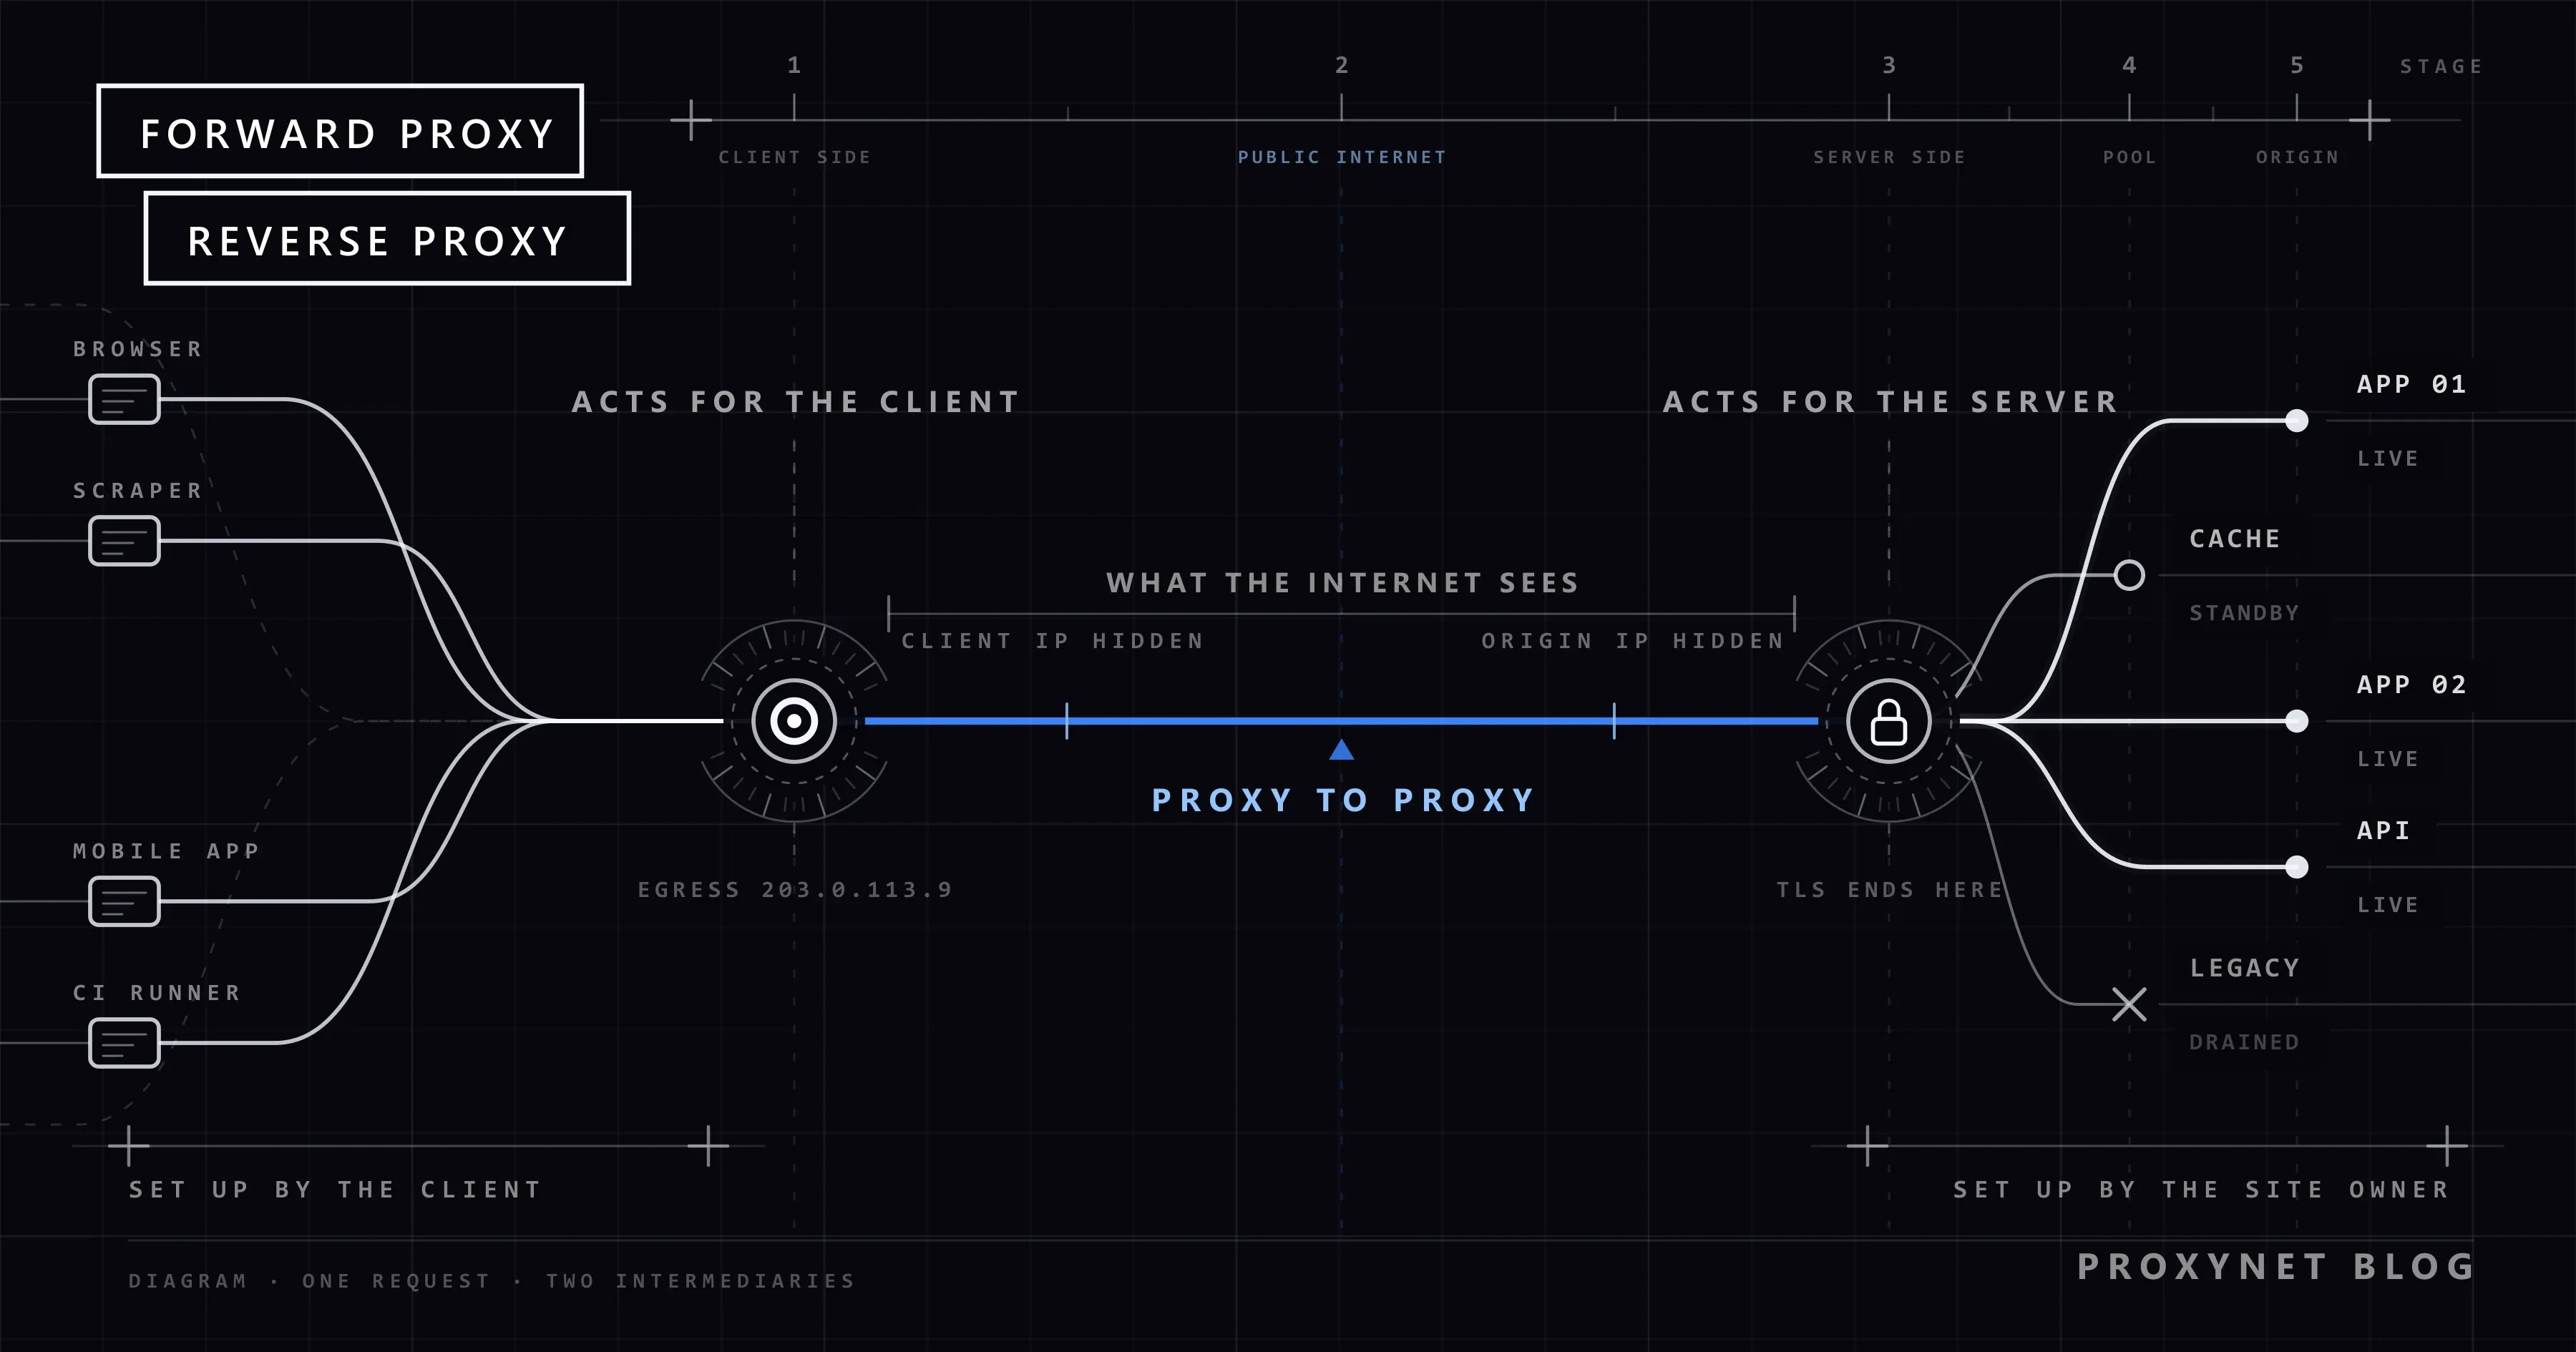
Veröffentlicht
Forward-Proxy und Reverse-Proxy: Was ist der Unterschied?
Ein Forward-Proxy vertritt den Client, ein Reverse-Proxy den Server. Wir vergleichen, wie beide Verkehr steuern und wofür sie dienen, mit Nginx-Beispiel.
Autor:Acar Diveroli
Veröffentlicht
Web Scraping mit GPT-6 Astra: was ändert sich?
GPT-6 Astra verbessert das Lesen von Seiten, löst aber keine Sperren, CAPTCHAs oder Rate-Limits. Der reale Platz des Modells im Scraping-Ablauf.
Autor:Acar Diveroli
Veröffentlicht
Was sind Honeypot-Fallen und wie wirken sie beim Scraping?
Honeypots sind versteckte Links, die Besucher nie sehen, in denen sich Bots aber verfangen. Wir erklären, wie sie funktionieren, ohne Umgehung zu lehren.
Autor:Acar Diveroli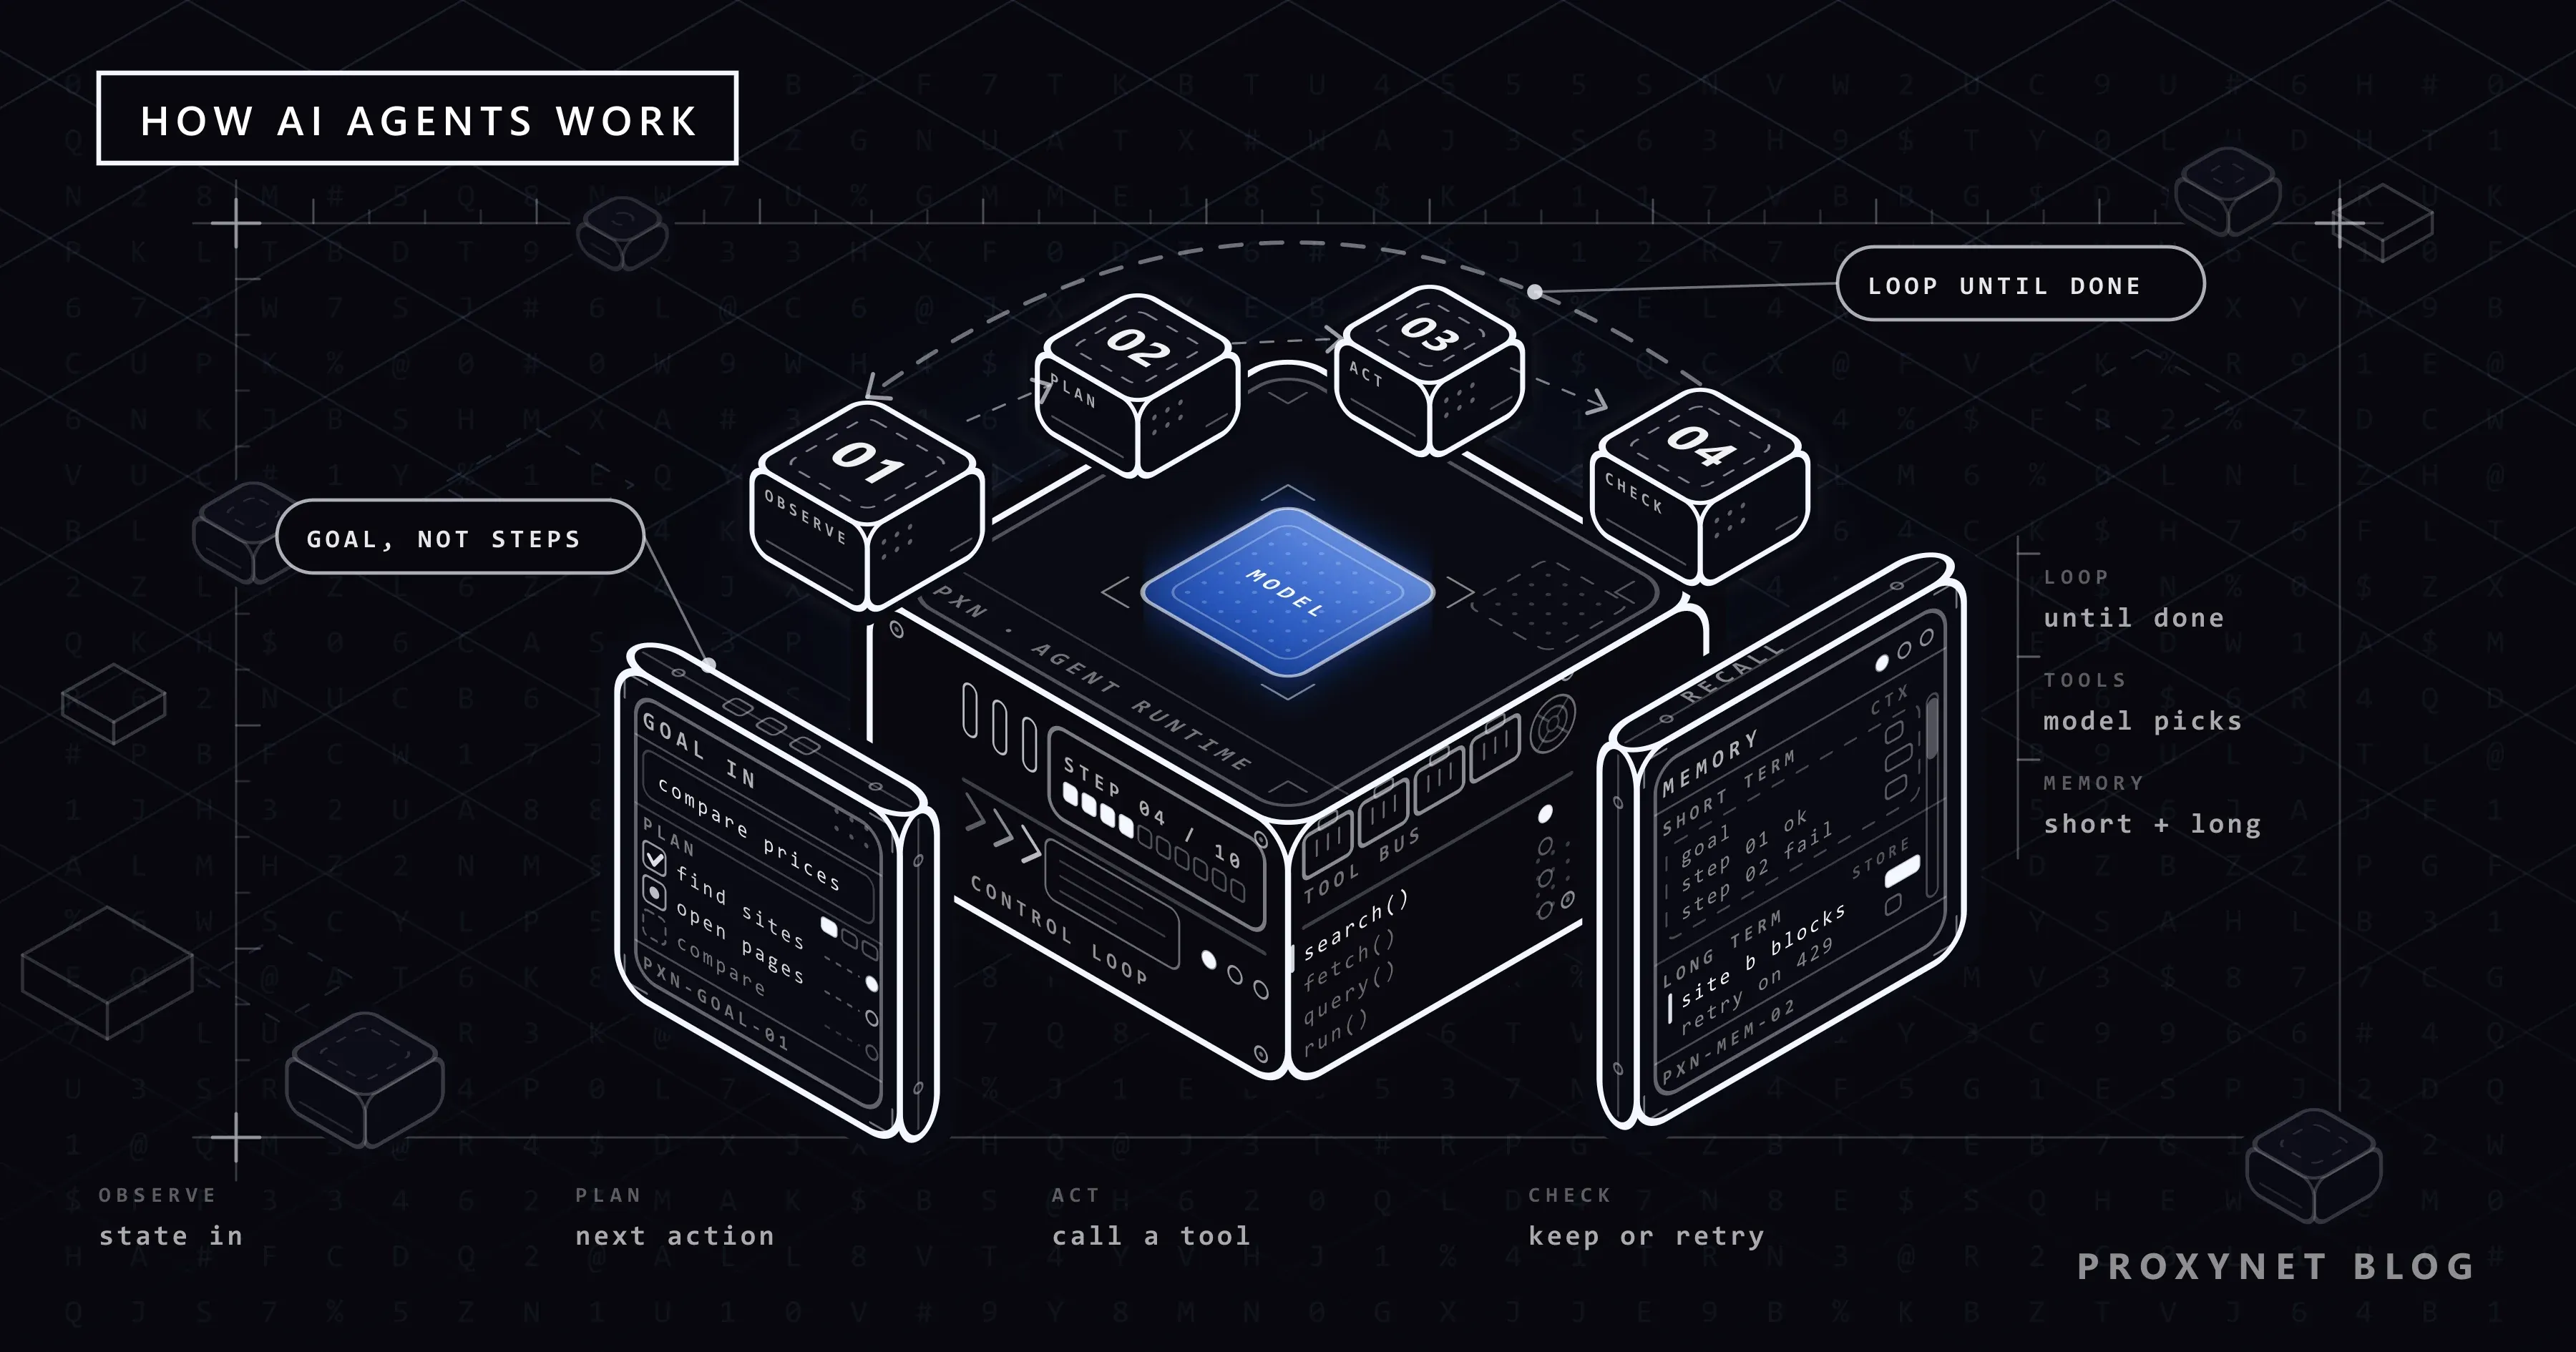
Veröffentlicht
Wie funktionieren KI-Agenten? Planung, Tools und Gedächtnis
Ein KI-Agent zerlegt ein Ziel in Schritte, ruft Tools auf, bewertet Ergebnisse und pflegt sein Gedächtnis. Wir erklären die Schleife und den Webzugriff.
Autor:Acar Diveroli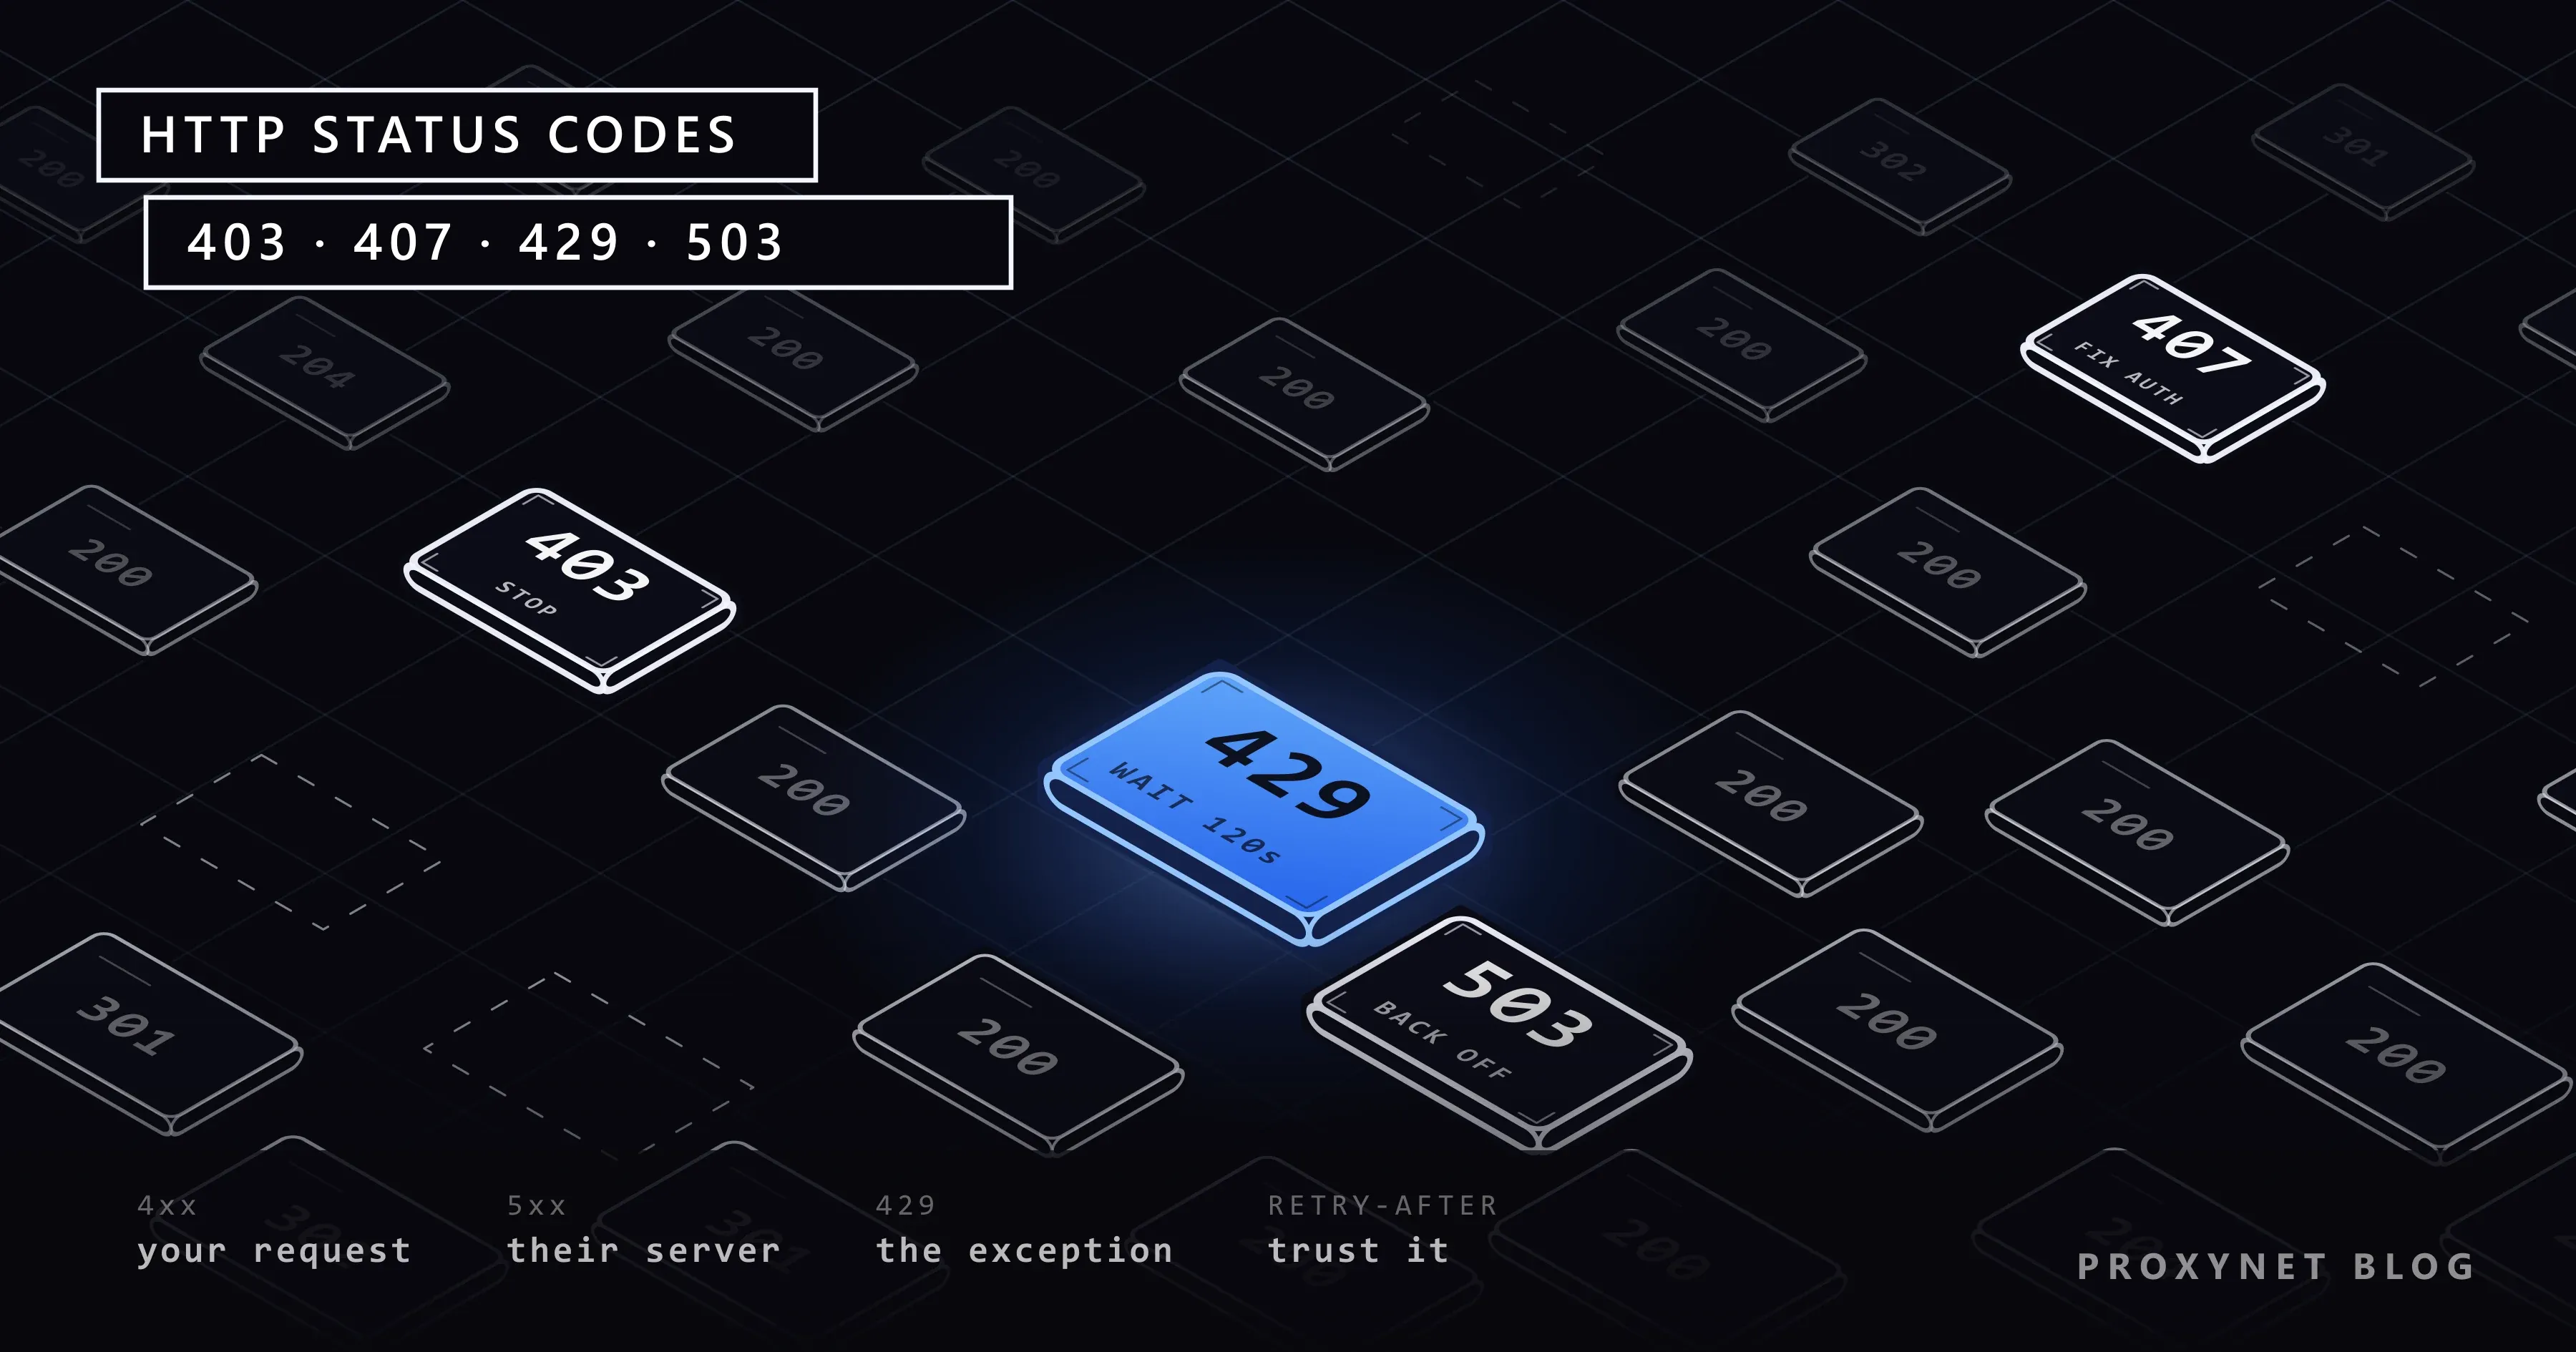
Veröffentlicht
HTTP-Statuscodes beim Web Scraping: 403, 407, 429, 503
403, 407, 429 und 503 weisen beim Scraping auf verschiedene Probleme hin. Wir erklären Bedeutung und Ursachen und korrekte Wiederholungen mit Retry-After.
Autor:Acar Diveroli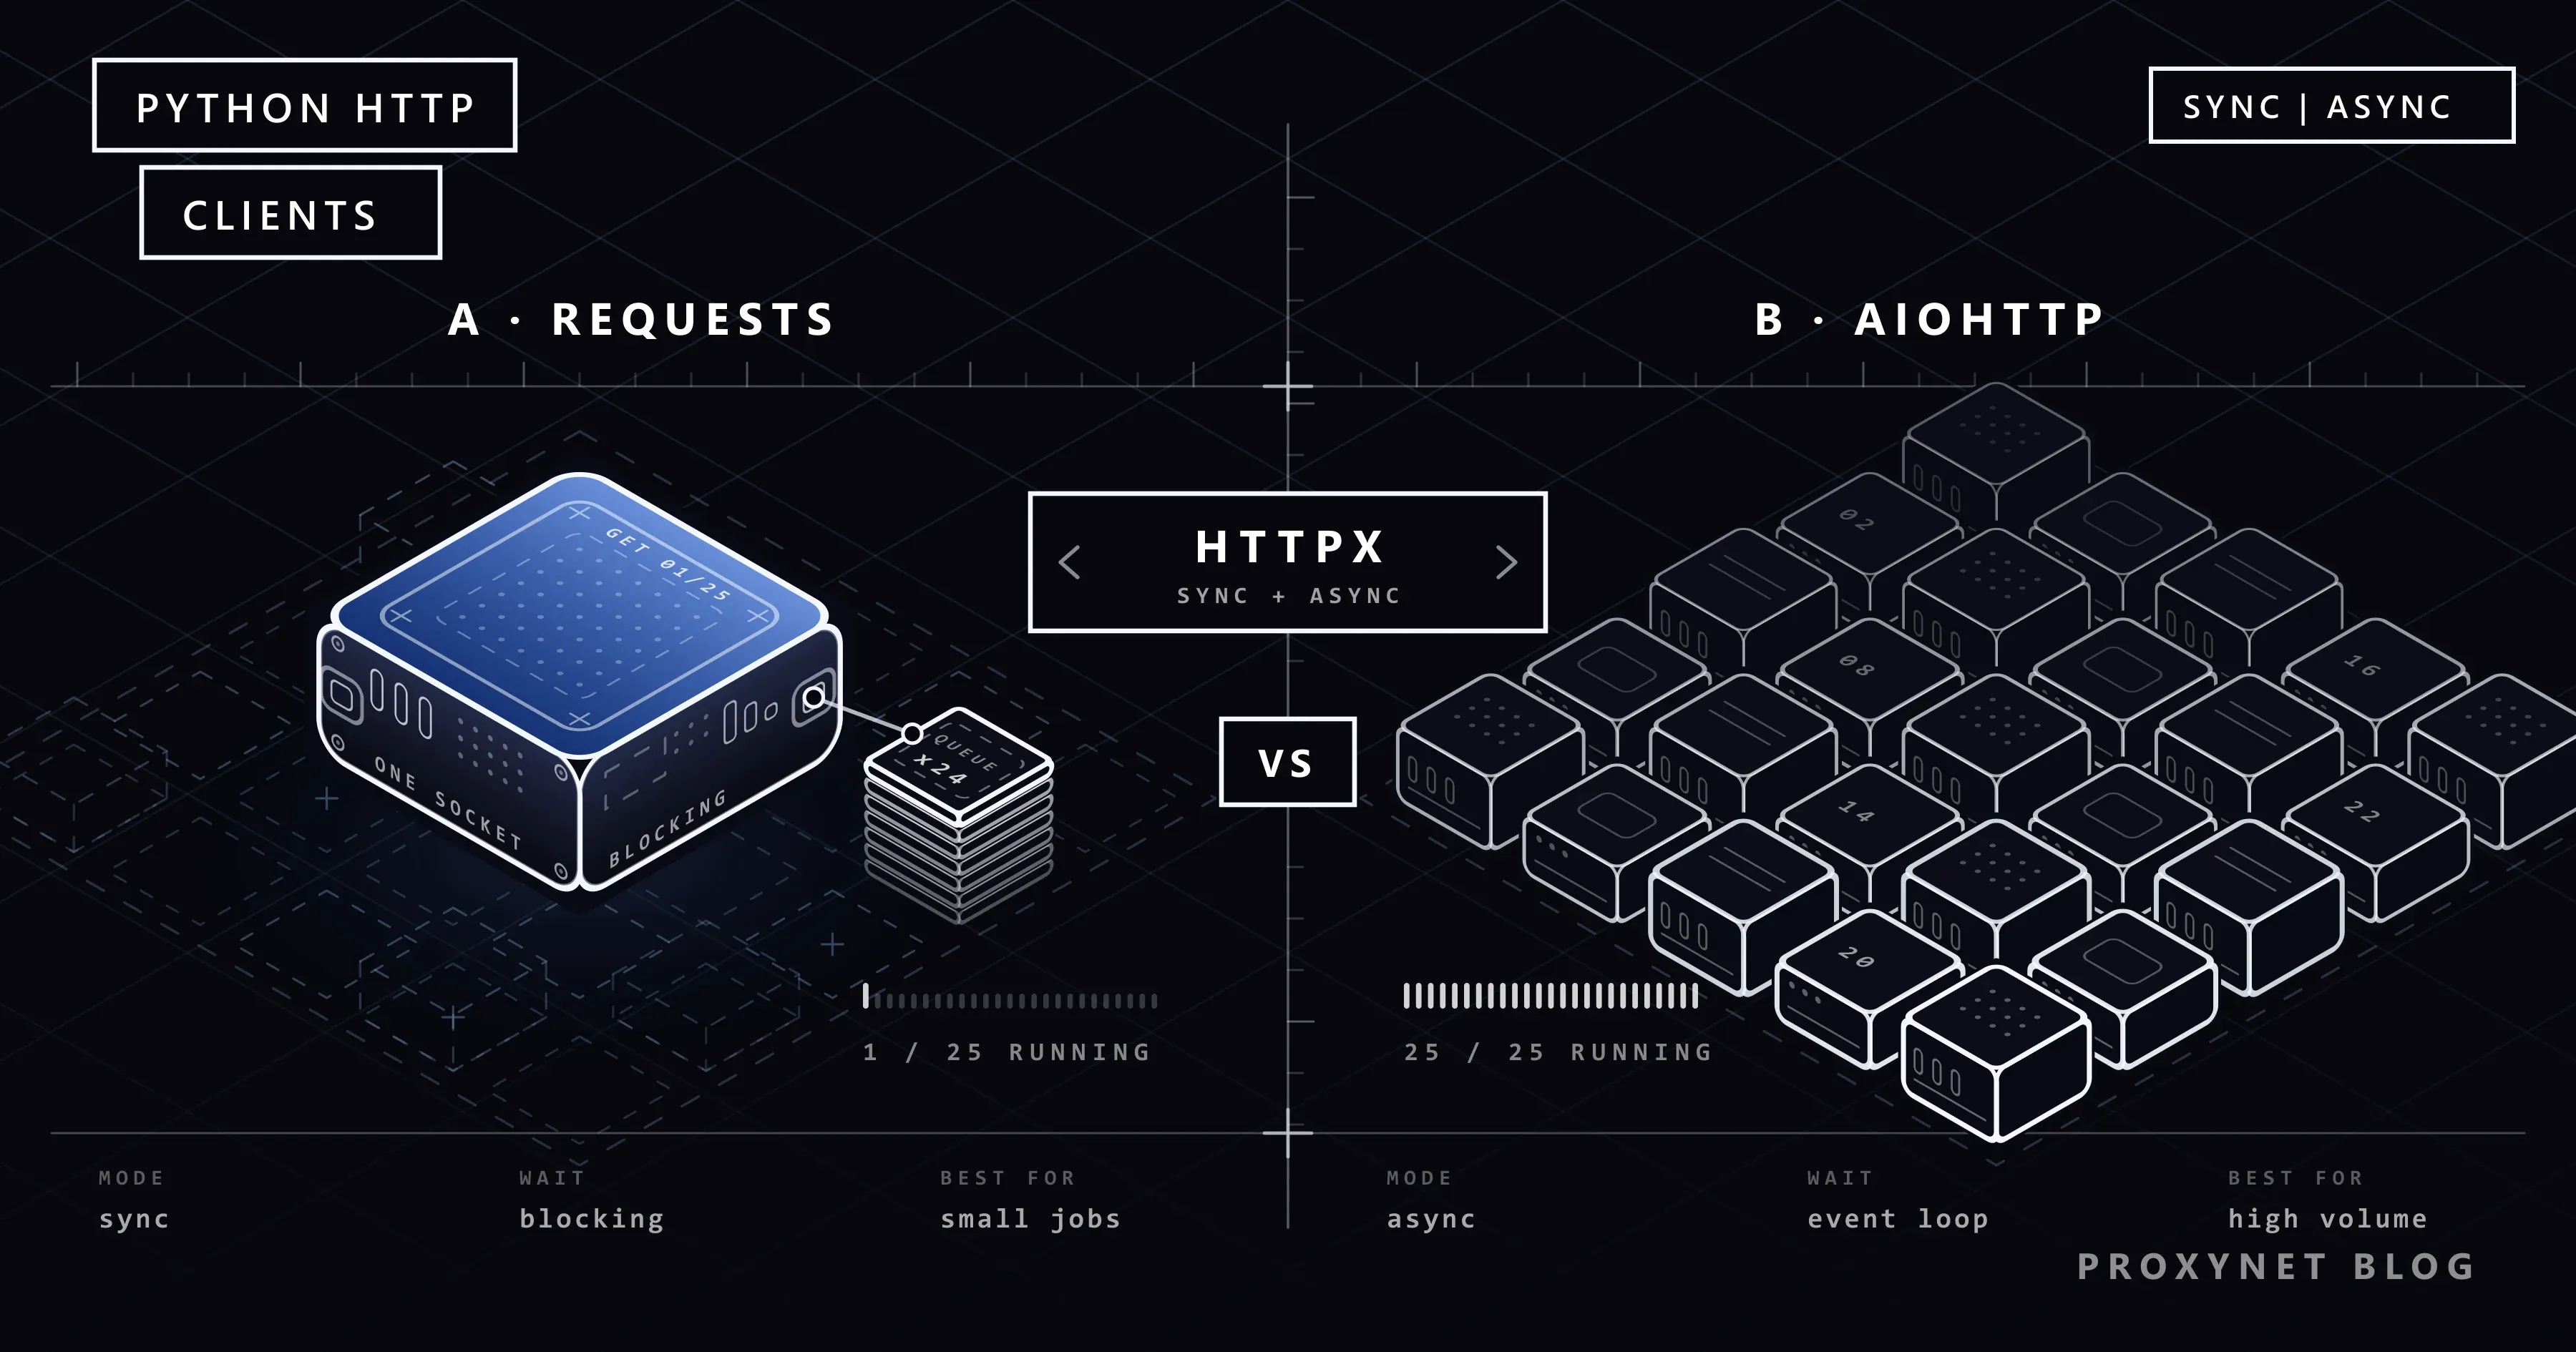
Veröffentlicht
HTTPX, Requests und AIOHTTP im Vergleich
Requests ist einfach und synchron, AIOHTTP asynchron, HTTPX bietet beides. Proxy-Nutzung und Performance je Projekt mit Codebeispielen.
Autor:Acar Diveroli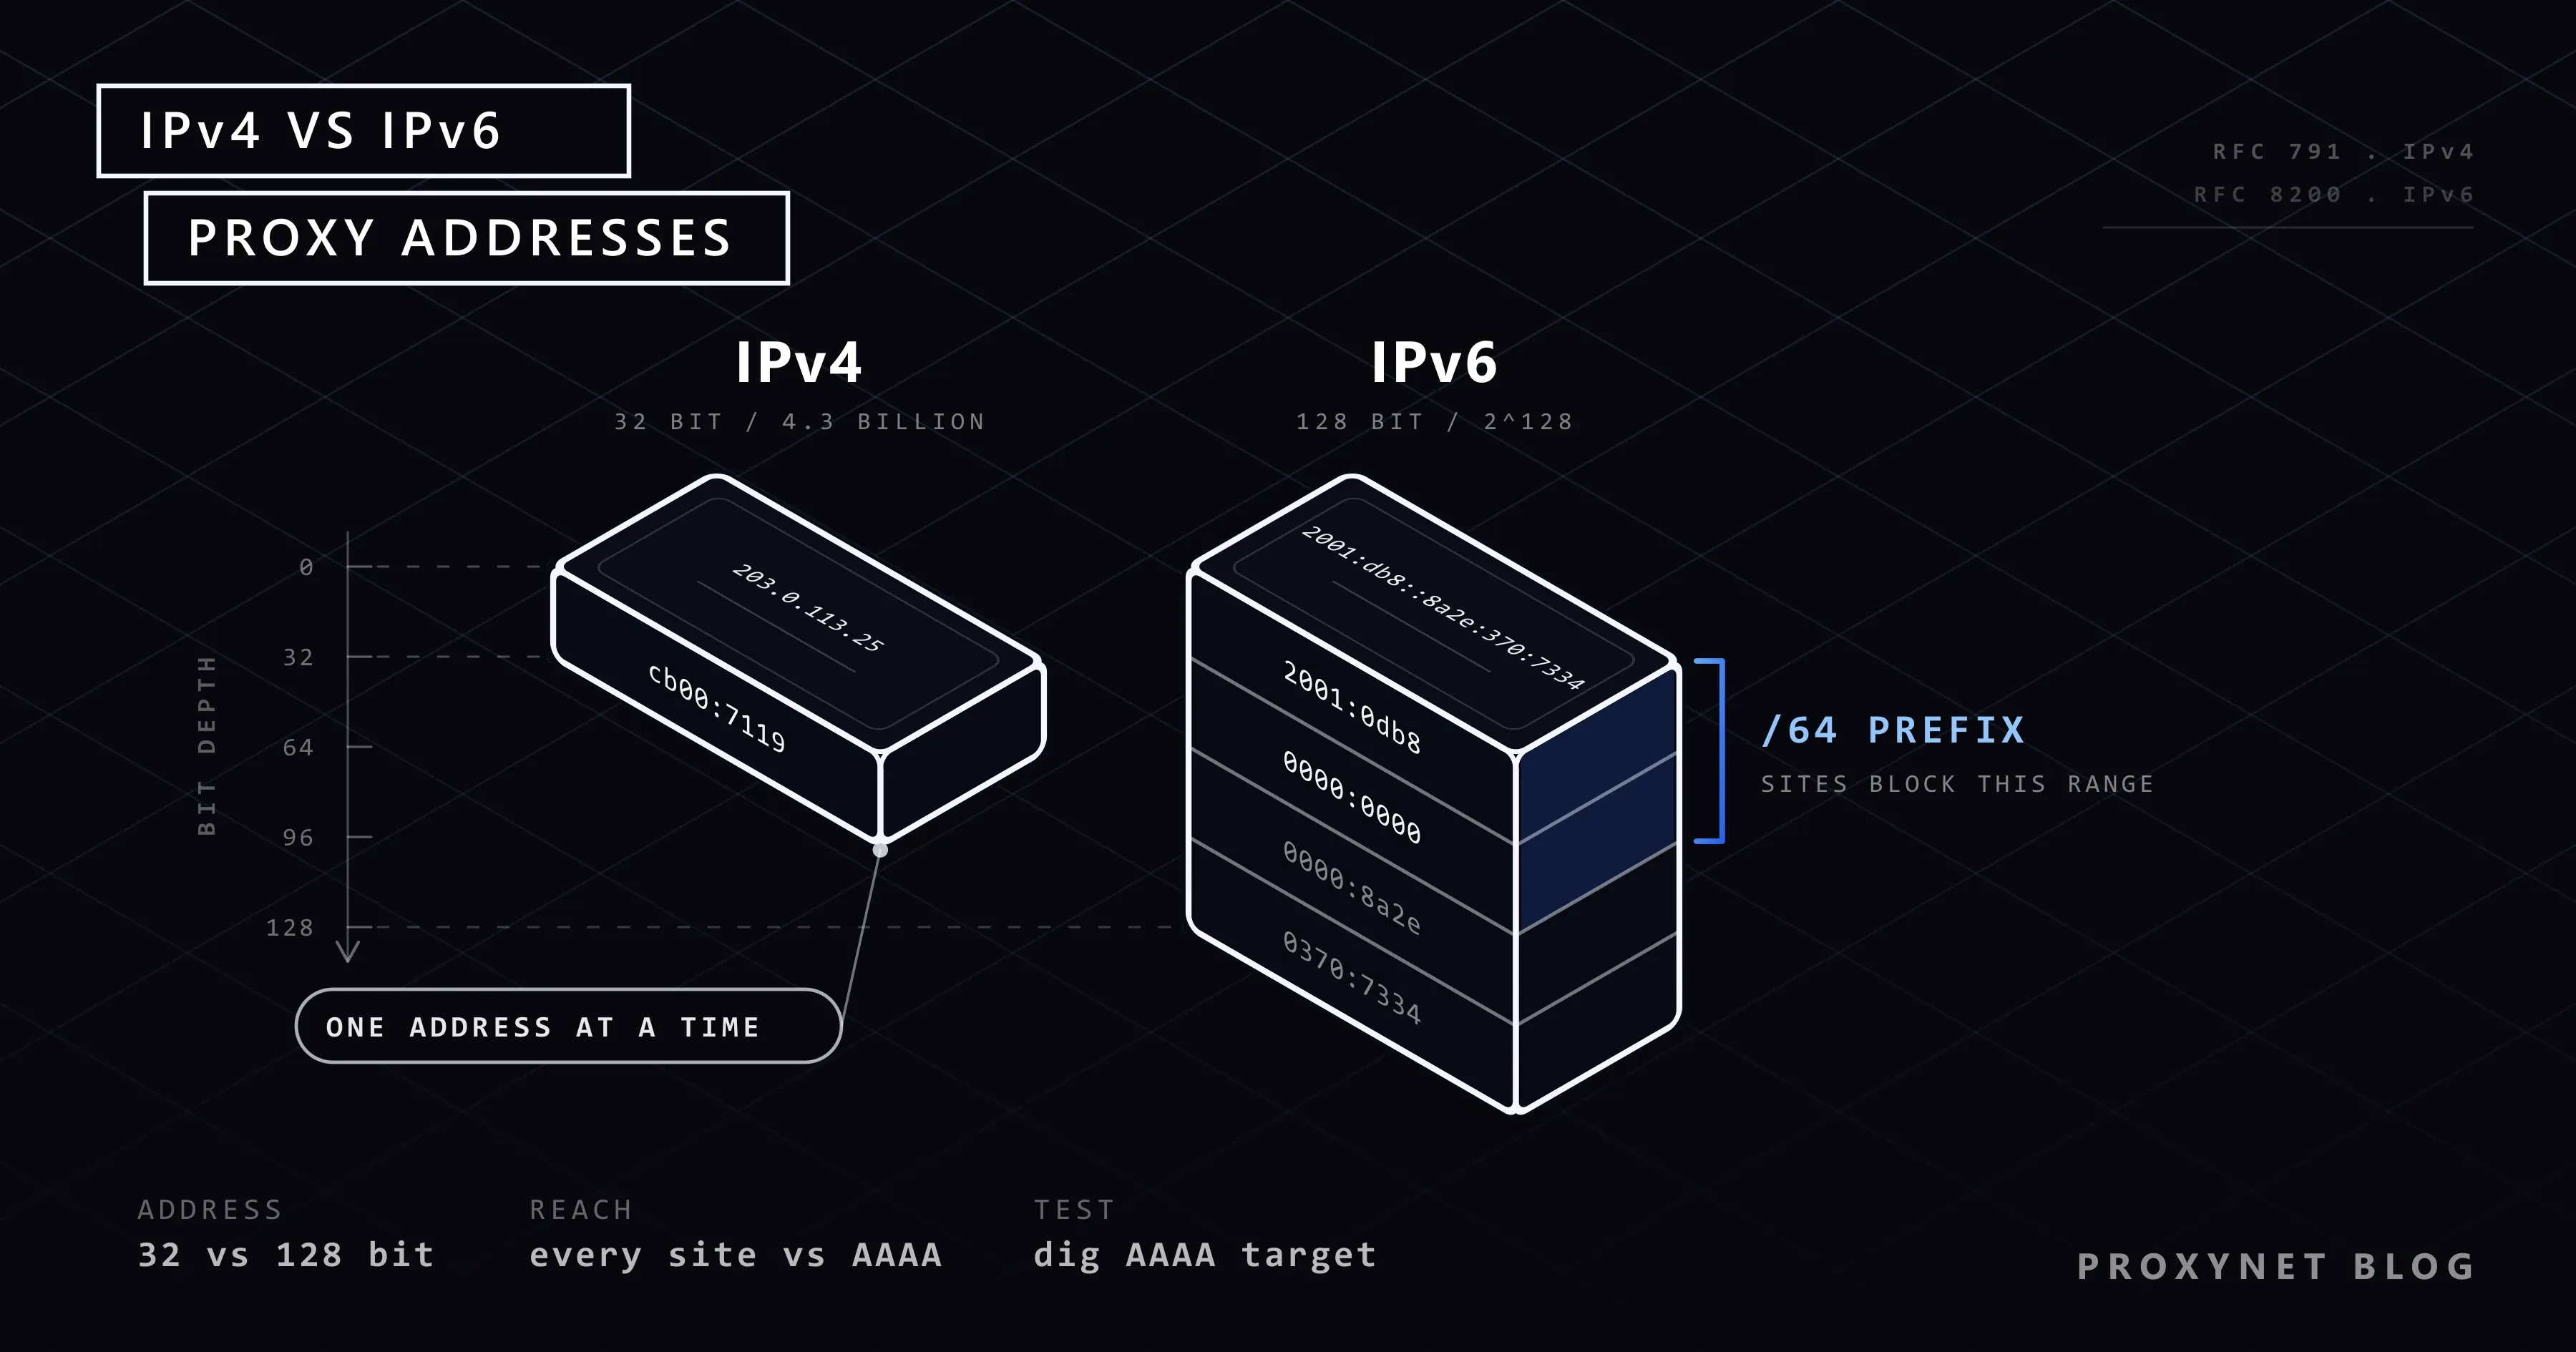
Veröffentlicht
IPv4- und IPv6-Proxys: Welche sollten Sie wählen?
IPv6-Proxys bieten viele Adressen, doch nicht jede Website akzeptiert IPv6. Wir erklären Unterschiede, Kompatibilität und die richtige Wahl.
Autor:Acar Diveroli
Was ist Browser-Fingerprinting?
Autor: Acar DiveroliProxy 101Veröffentlicht
Cloudflare Precursor: was bedeutet er für Scraping?
Autor: Acar DiveroliProxy 101Veröffentlicht
Concurrency und Parallelism: Was bestimmt Scraping-Tempo?
Autor: Acar DiveroliVergleichVeröffentlicht
CSS-Selektor oder XPath: Was passt zum Web Scraping?
Autor: Acar DiveroliVergleichVeröffentlicht
cURL in JavaScript: fetch, Axios und Proxy
Autor: Acar DiveroliAnleitungenVeröffentlicht
Forward-Proxy und Reverse-Proxy: Was ist der Unterschied?
Autor: Acar DiveroliVergleichVeröffentlicht
Web Scraping mit GPT-6 Astra: was ändert sich?
Autor: Acar DiveroliKIVeröffentlicht
Was sind Honeypot-Fallen und wie wirken sie beim Scraping?
Autor: Acar DiveroliWeb ScrapingVeröffentlicht
Wie funktionieren KI-Agenten? Planung, Tools und Gedächtnis
Autor: Acar DiveroliKIVeröffentlicht
HTTP-Statuscodes beim Web Scraping: 403, 407, 429, 503
Autor: Acar DiveroliWeb ScrapingVeröffentlicht
HTTPX, Requests und AIOHTTP im Vergleich
Autor: Acar DiveroliVergleichVeröffentlicht
IPv4- und IPv6-Proxys: Welche sollten Sie wählen?
Autor: Acar DiveroliVergleichVeröffentlicht
Keine passenden Beiträge
Veröffentlicht
Veröffentlicht