
Blog da Proxynet – Página 18

Publicado
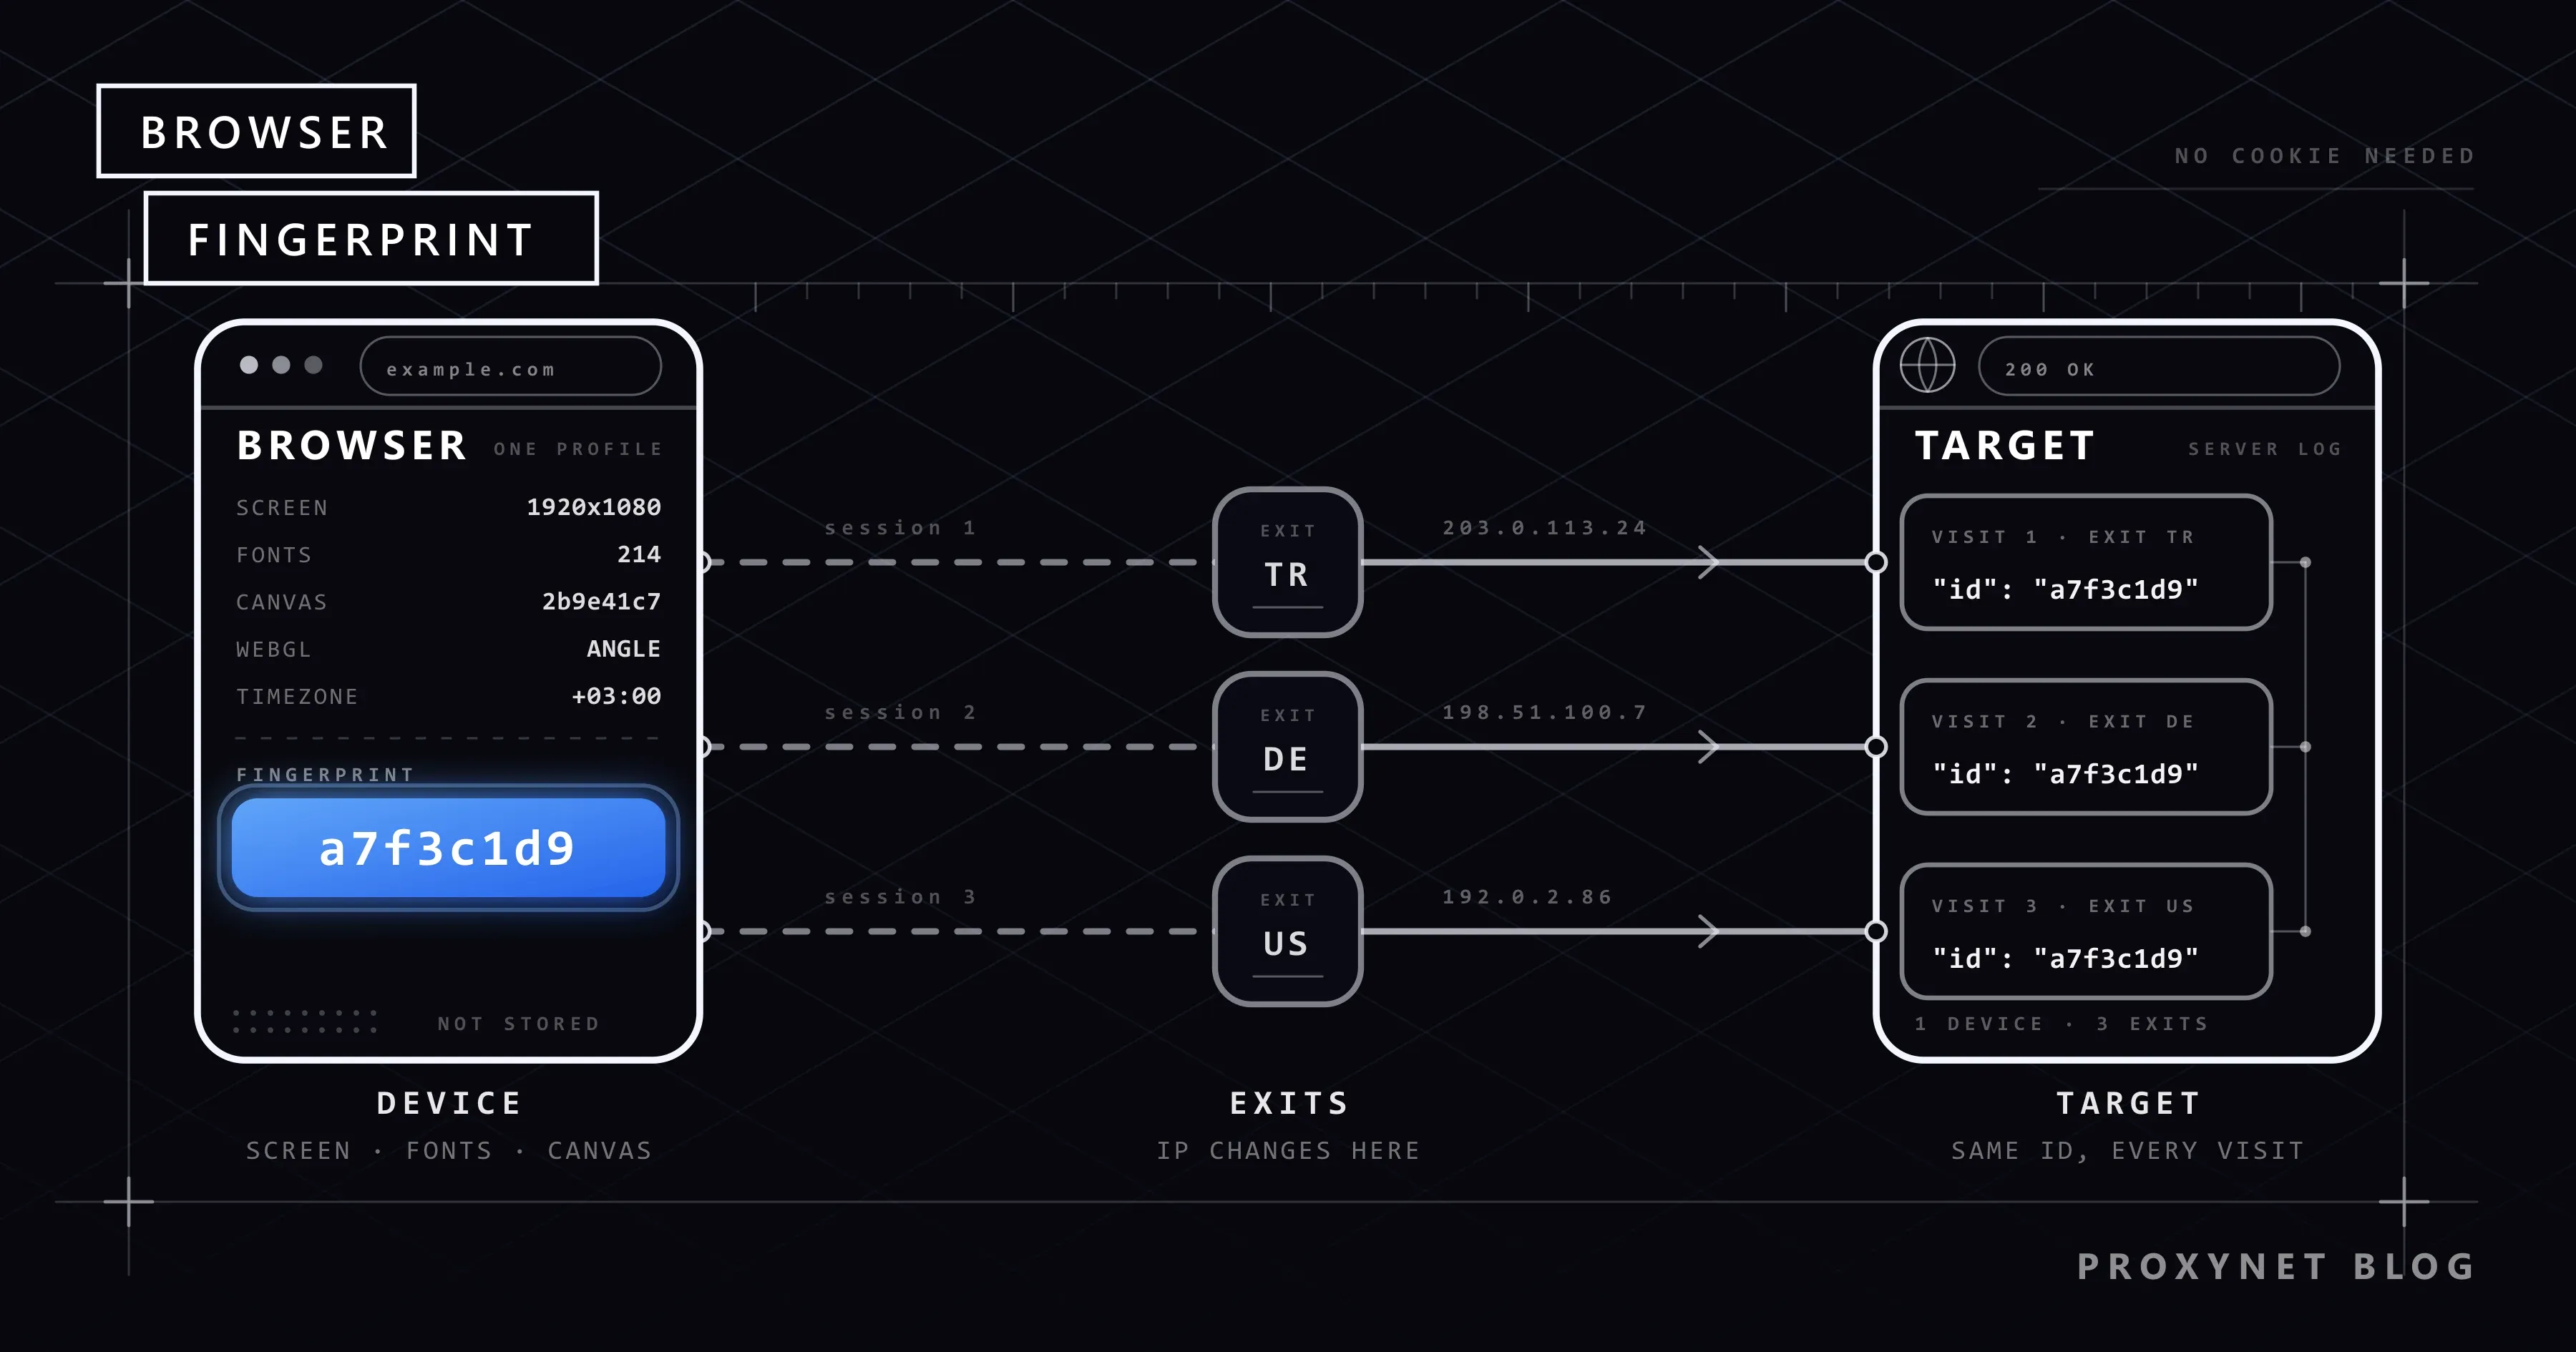
O que é fingerprint do navegador?
O fingerprint do navegador identifica o dispositivo sem cookies, com sinais de tela, fonte e canvas. Explicamos como funciona e por que trocar o IP não basta.
Autor: Acar Diveroli
Publicado
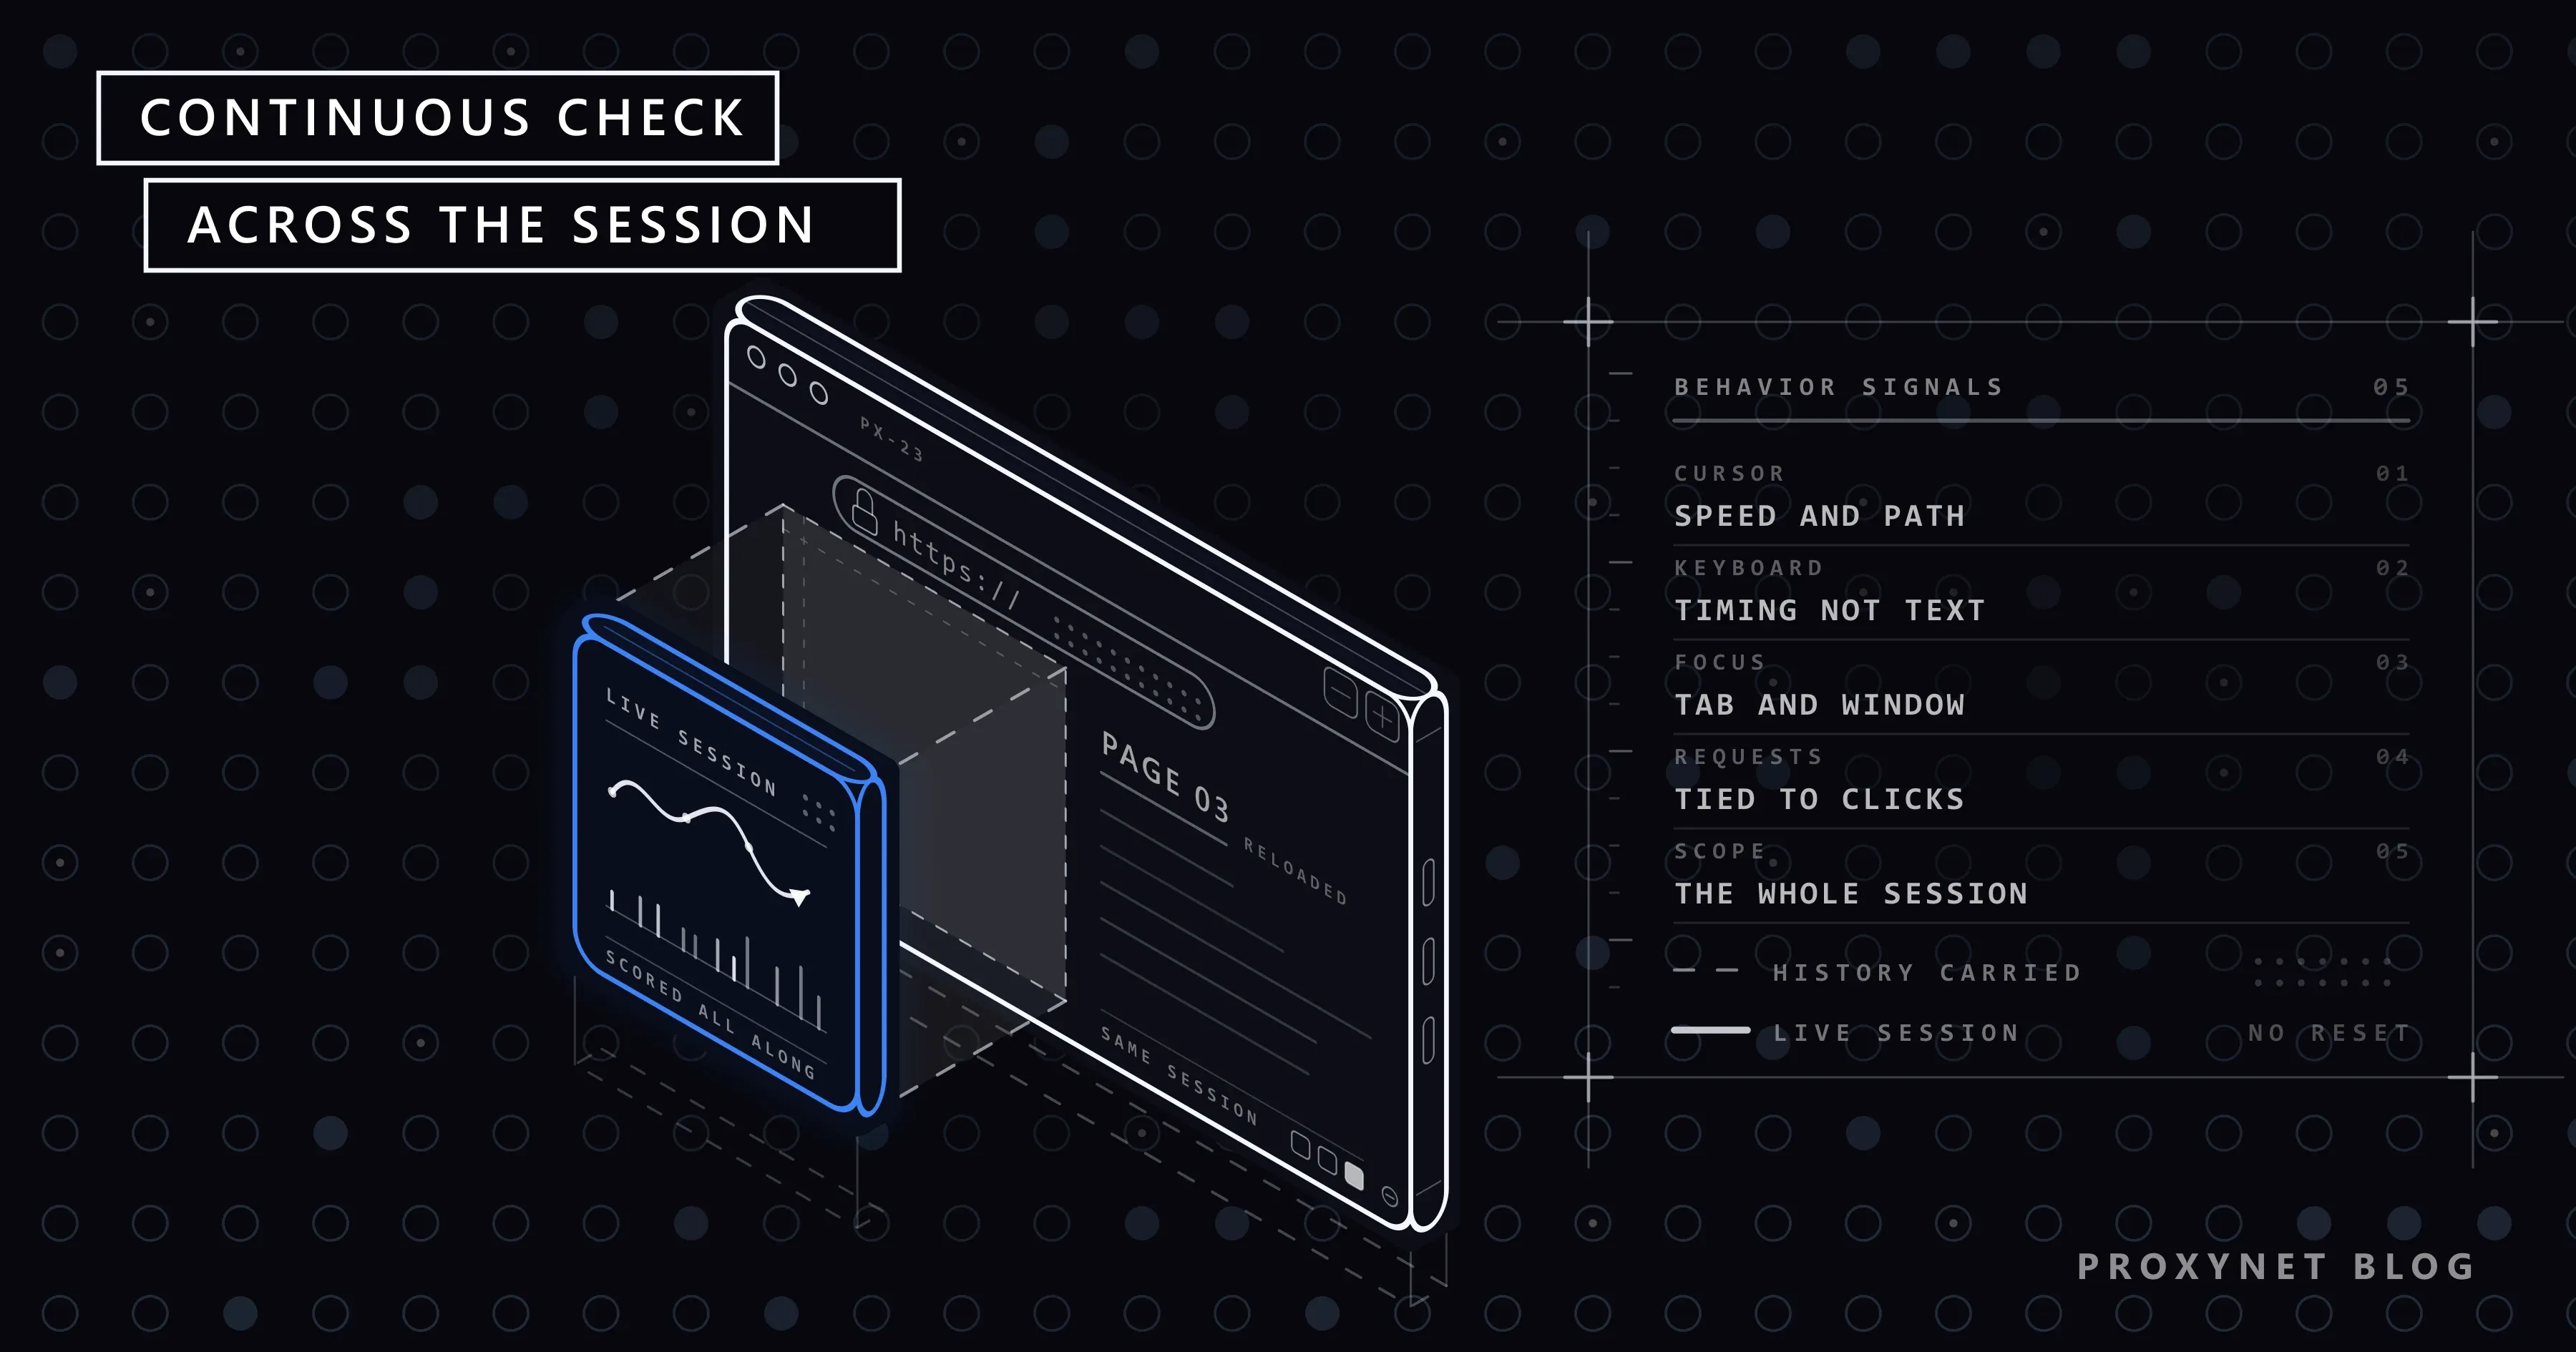
O que é o Cloudflare Precursor?
O Cloudflare Precursor é uma camada de detecção de bots que analisa o comportamento do visitante durante a sessão. Explicamos o que muda para a automação.
Autor:Acar Diveroli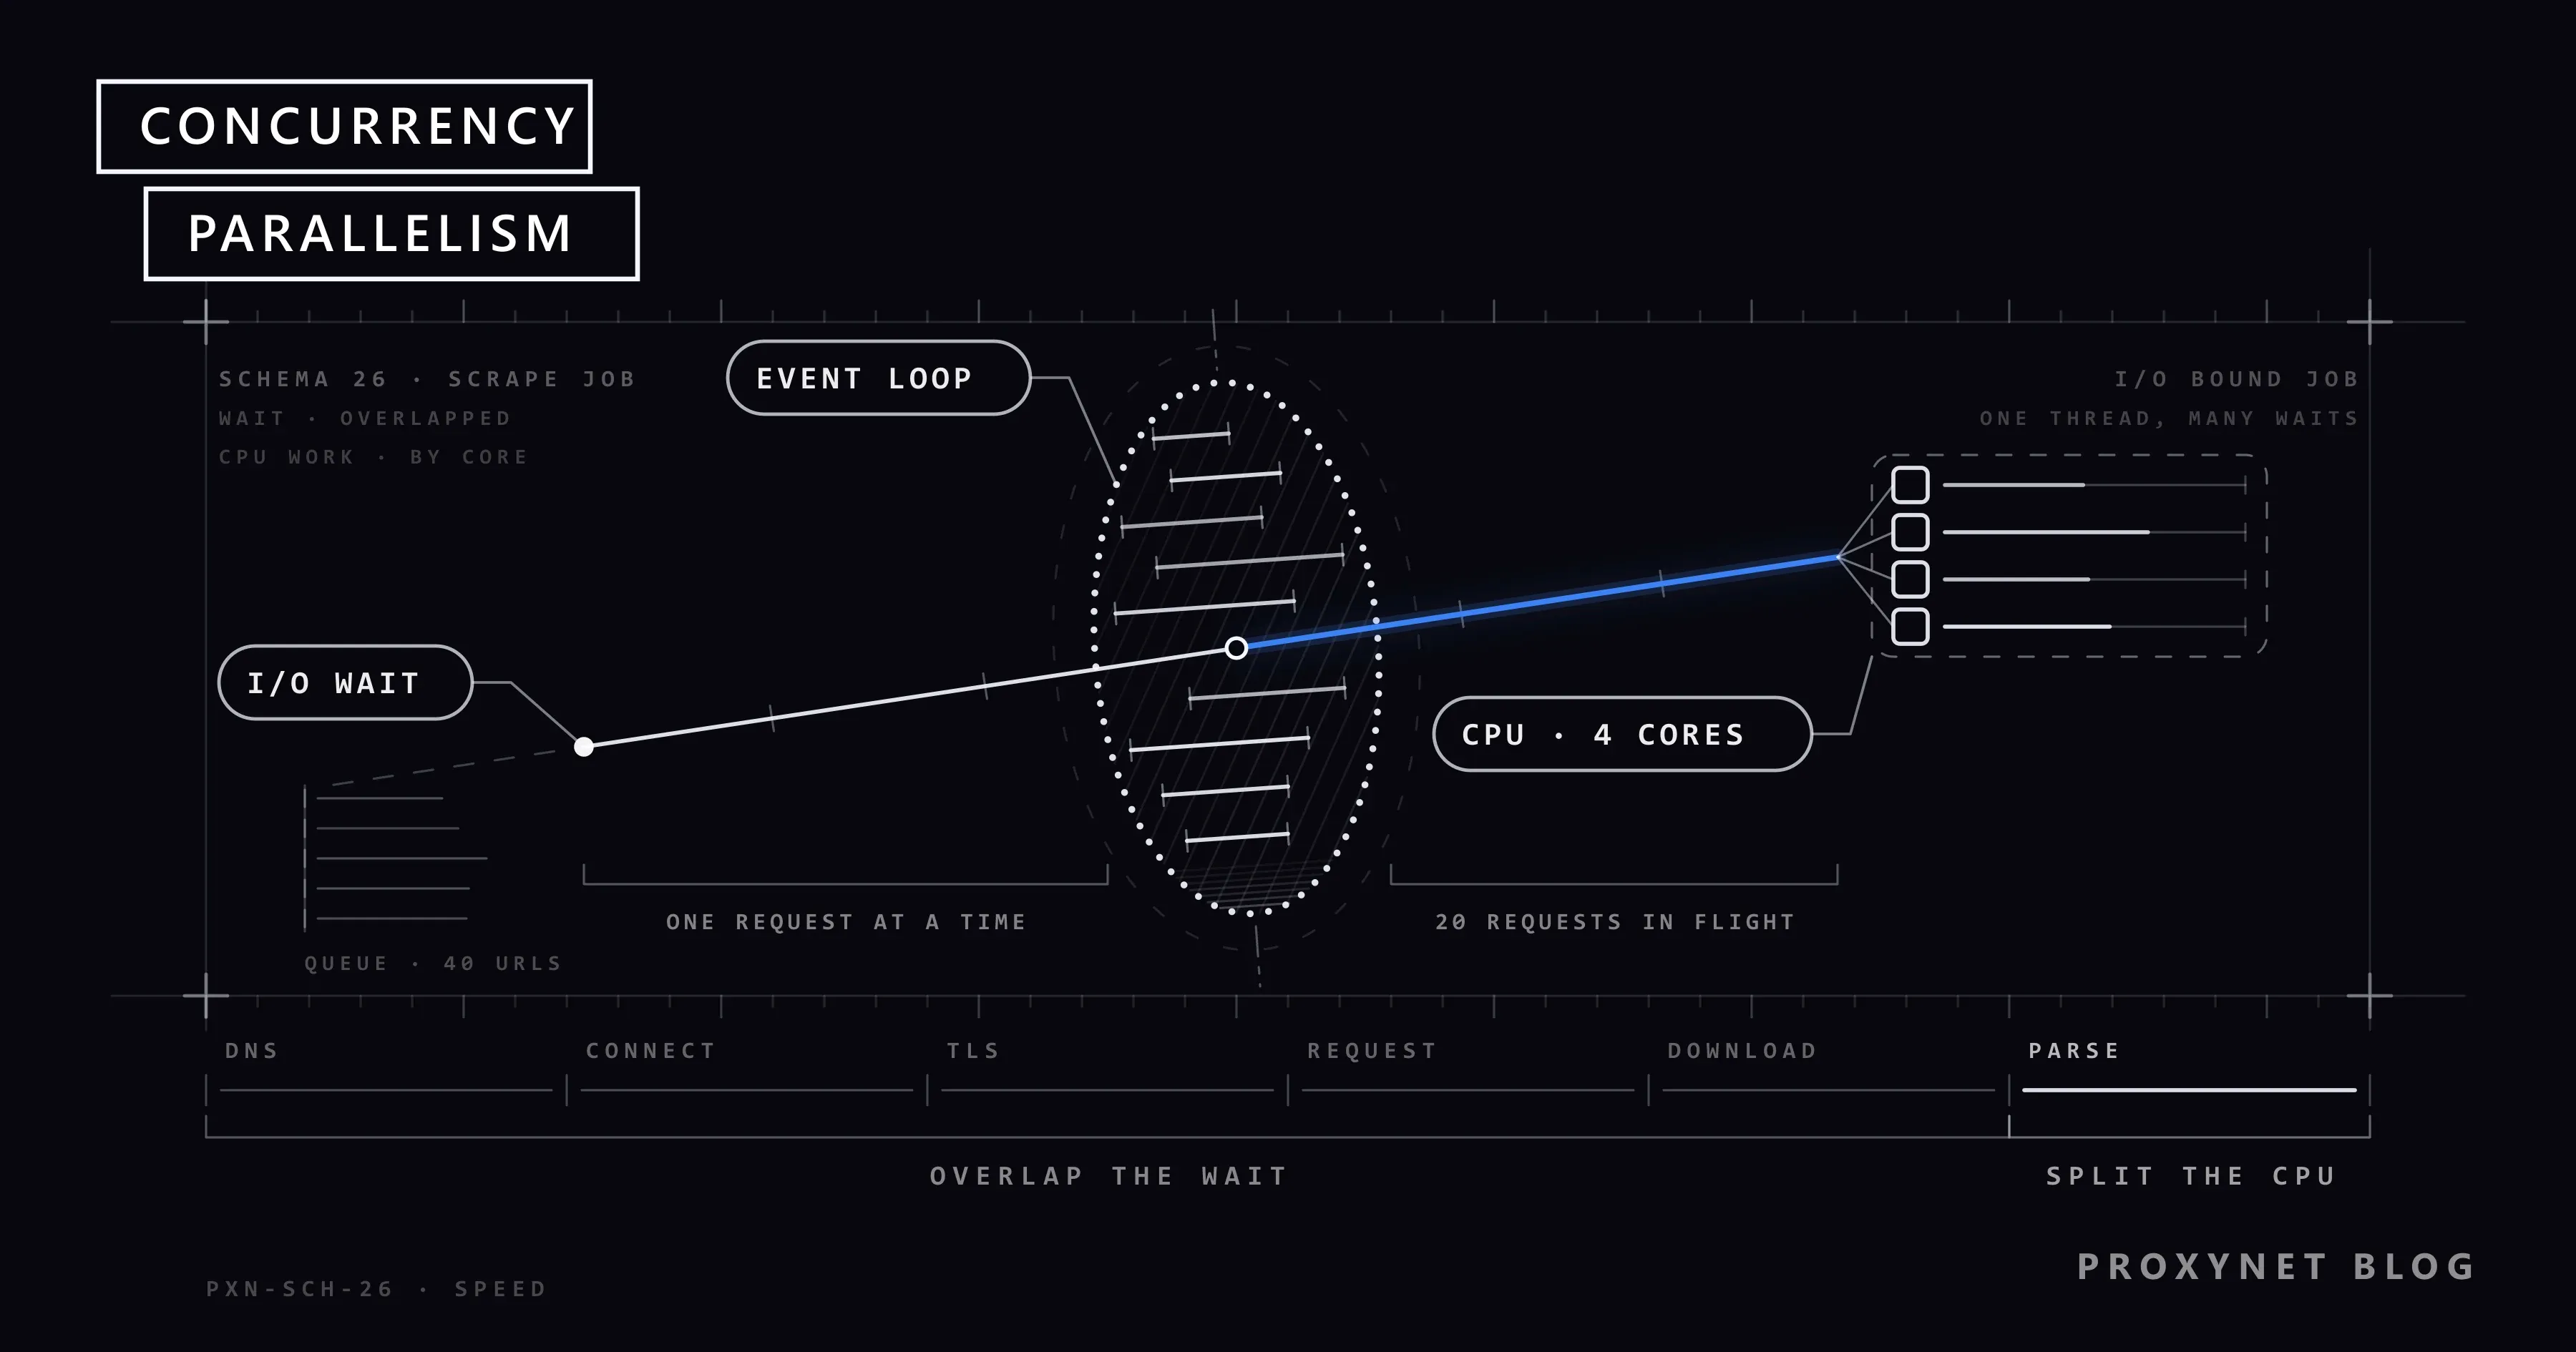
Publicado
Concorrência e paralelismo no web scraping
A concorrência aproveita o tempo de espera e o paralelismo, a potência da CPU. Explicamos qual acelera o scraping, com exemplos em Python e Node.js.
Autor:Acar Diveroli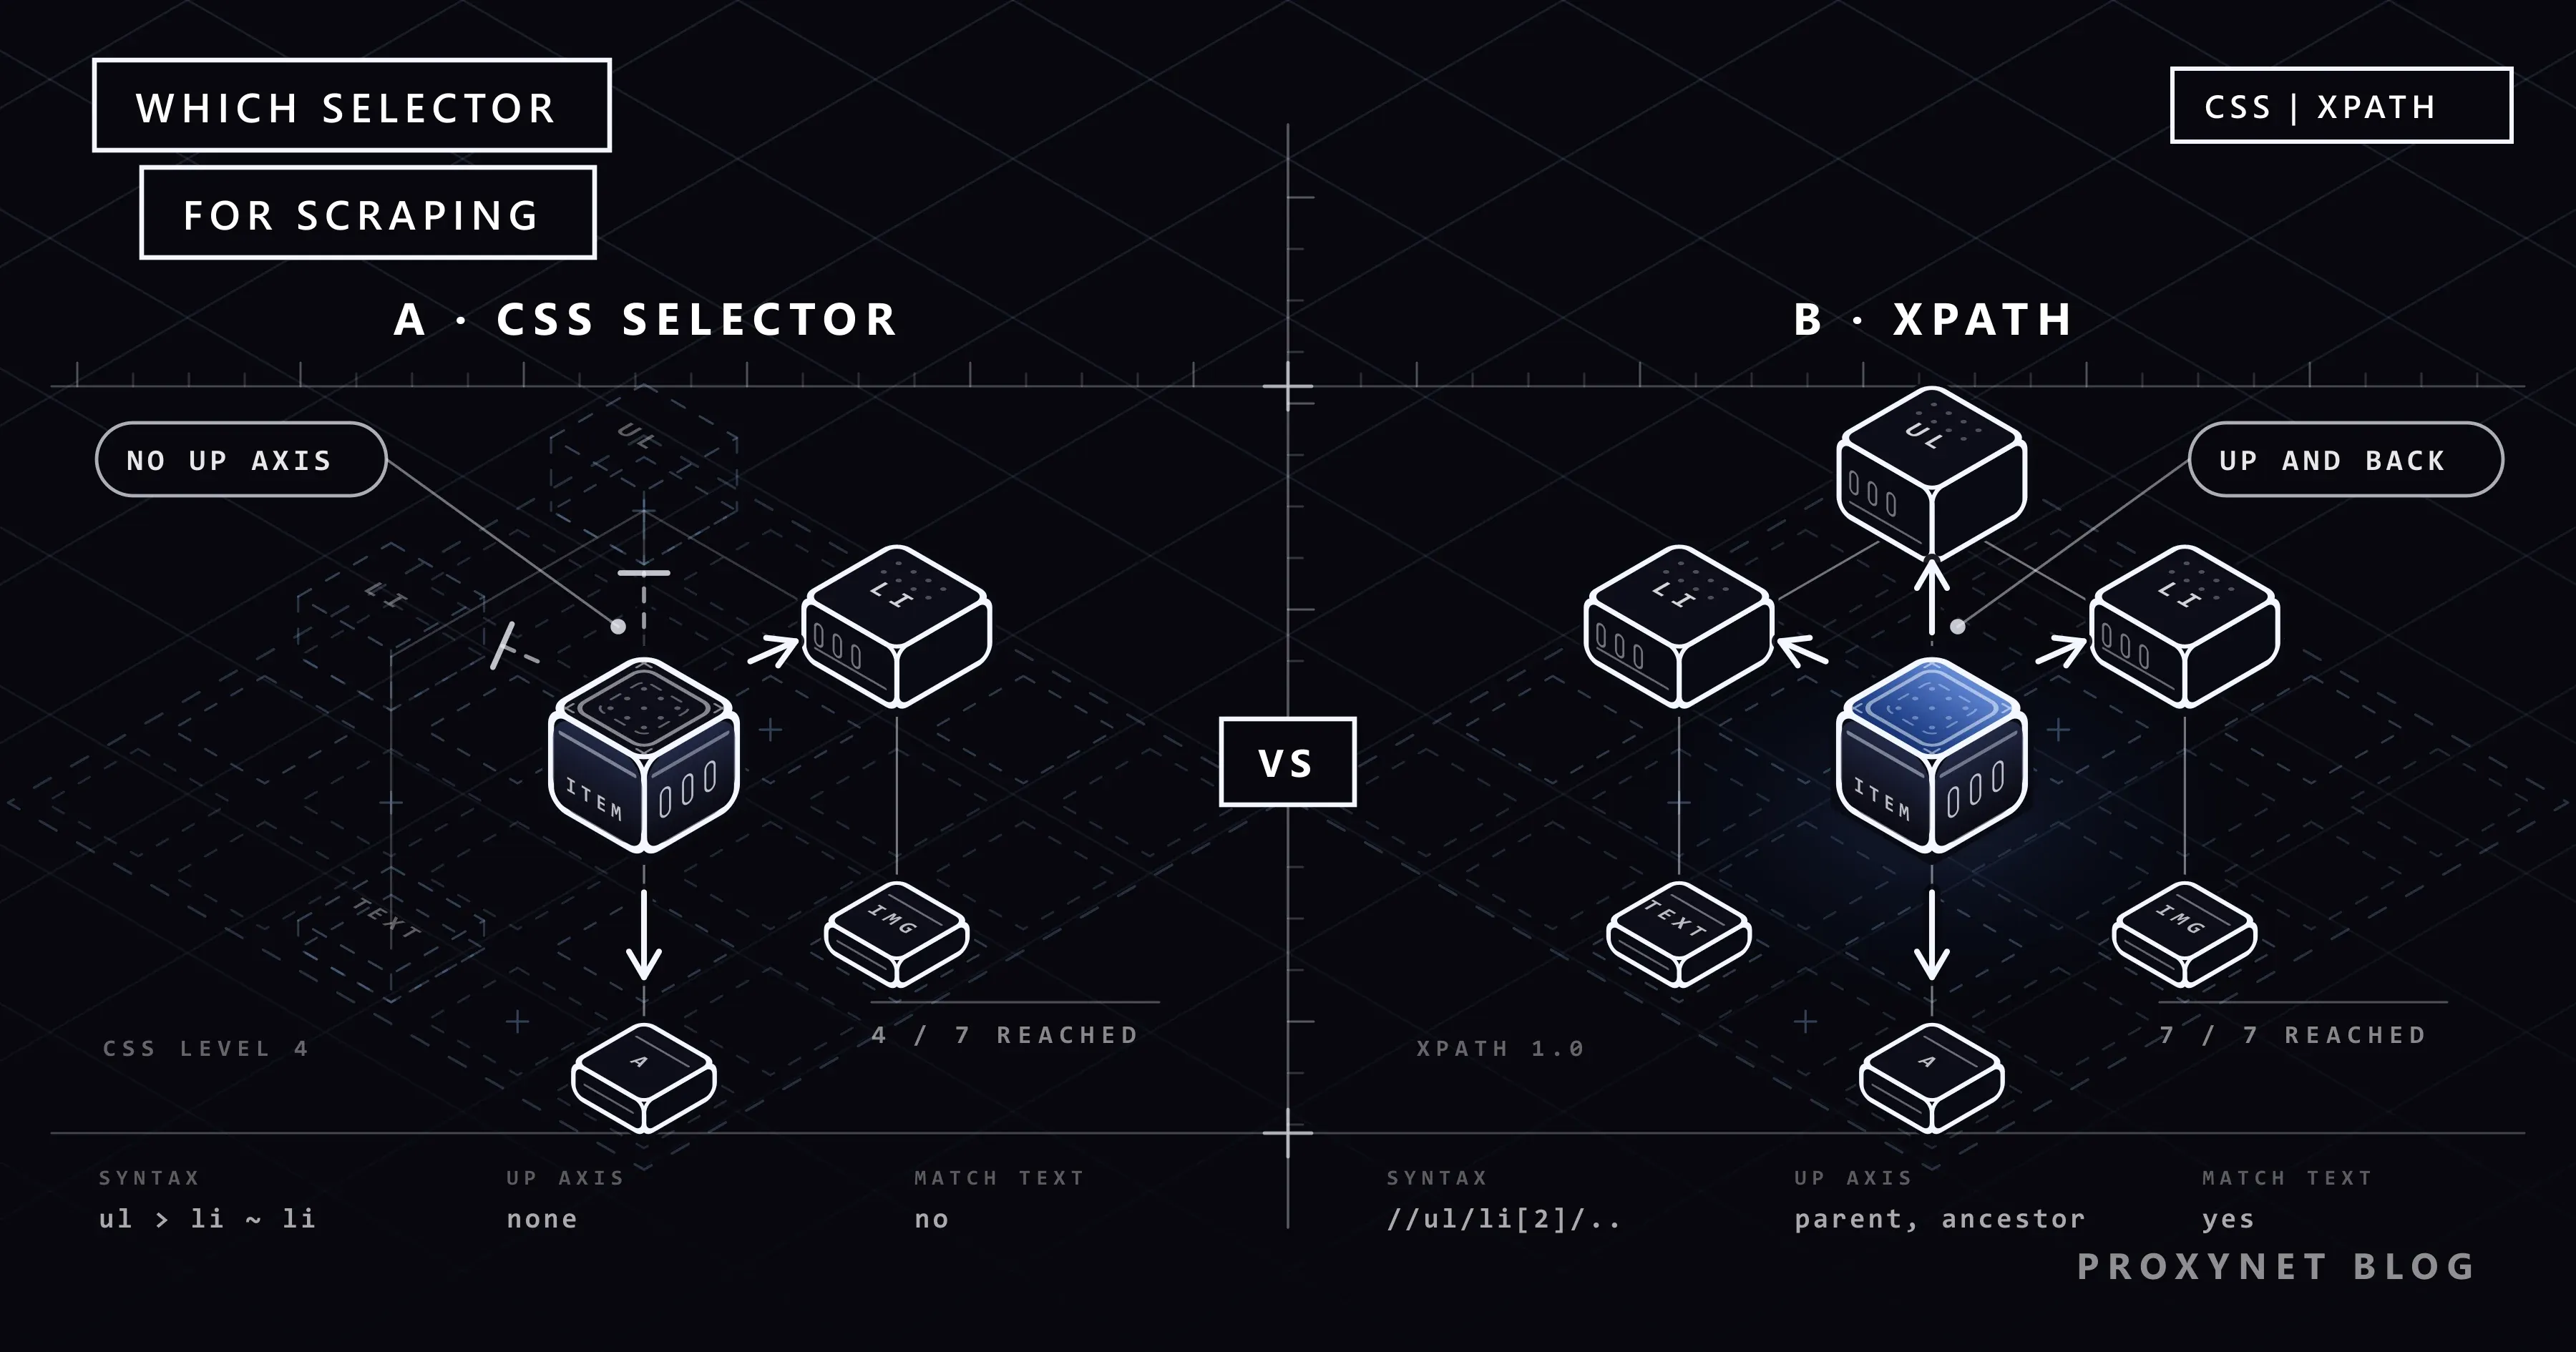
Publicado
Seletor CSS ou XPath: qual usar no web scraping?
Seletores CSS são curtos e legíveis; o XPath também seleciona por texto e por elemento pai. Comparamos sintaxe, velocidade e exemplos em Python.
Autor:Acar Diveroli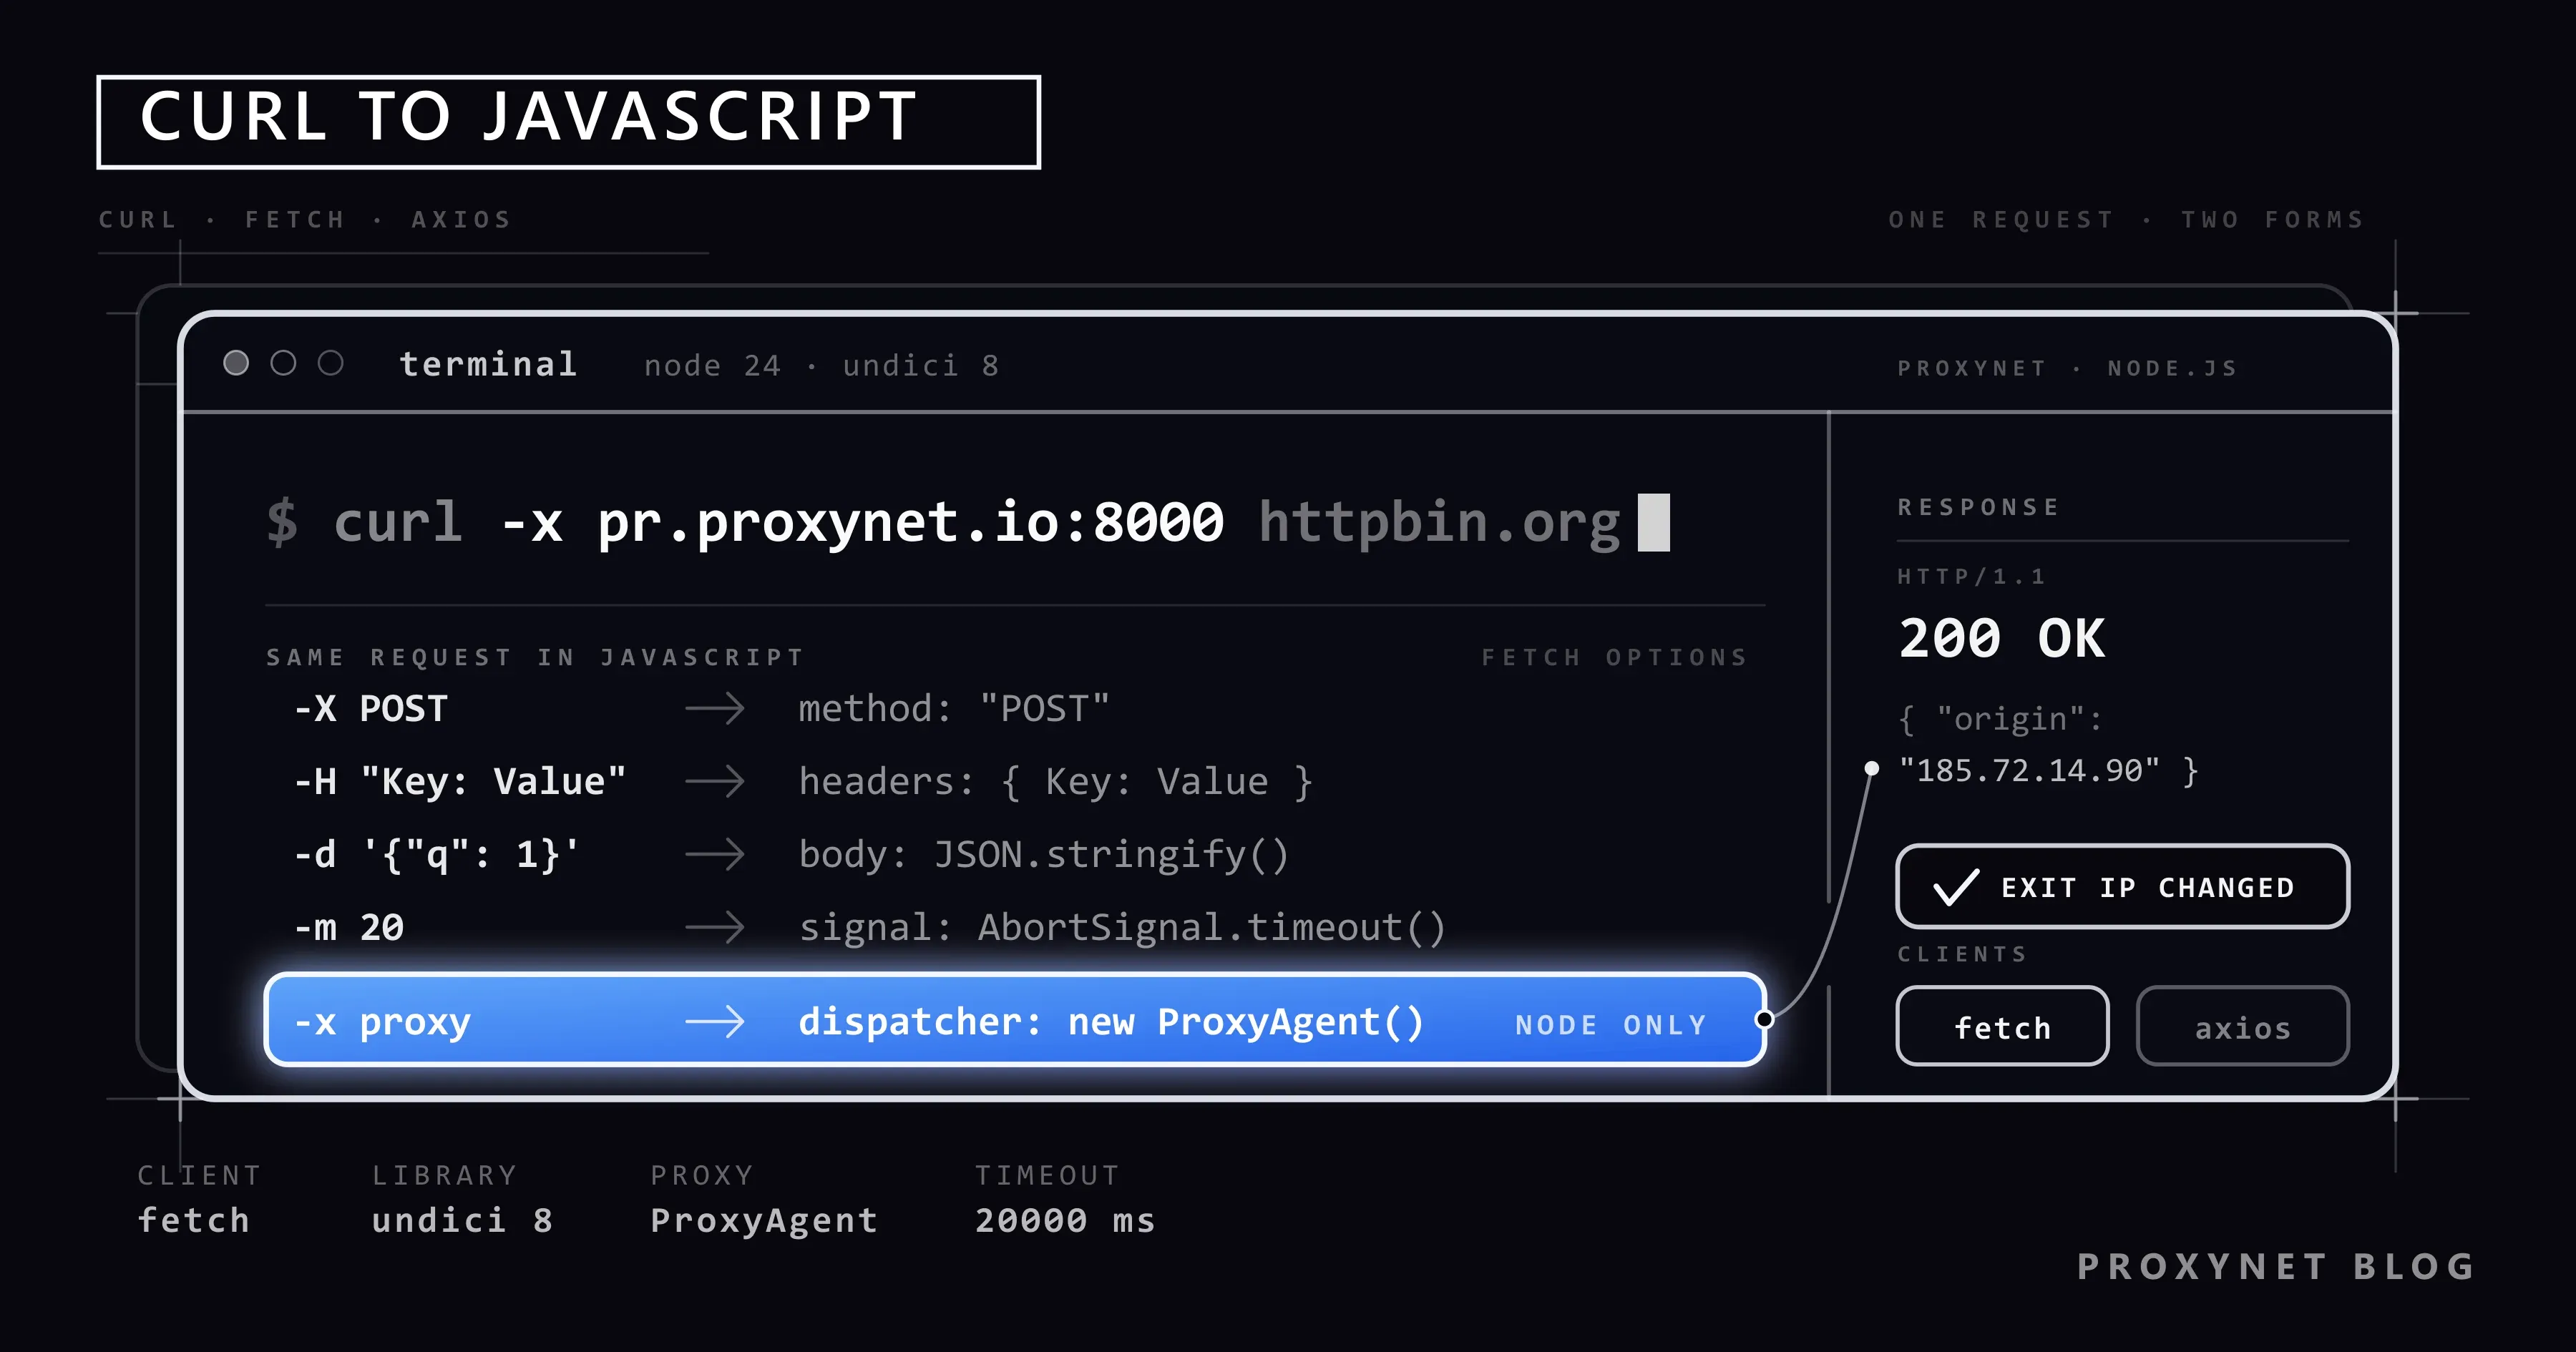
Publicado
cURL em JavaScript: fetch, Axios e proxy
O equivalente dos comandos cURL em JavaScript é fetch e Axios. Explicamos cabeçalho, corpo, autenticação e proxy no Node.js com exemplos de código testados.
Autor:Acar Diveroli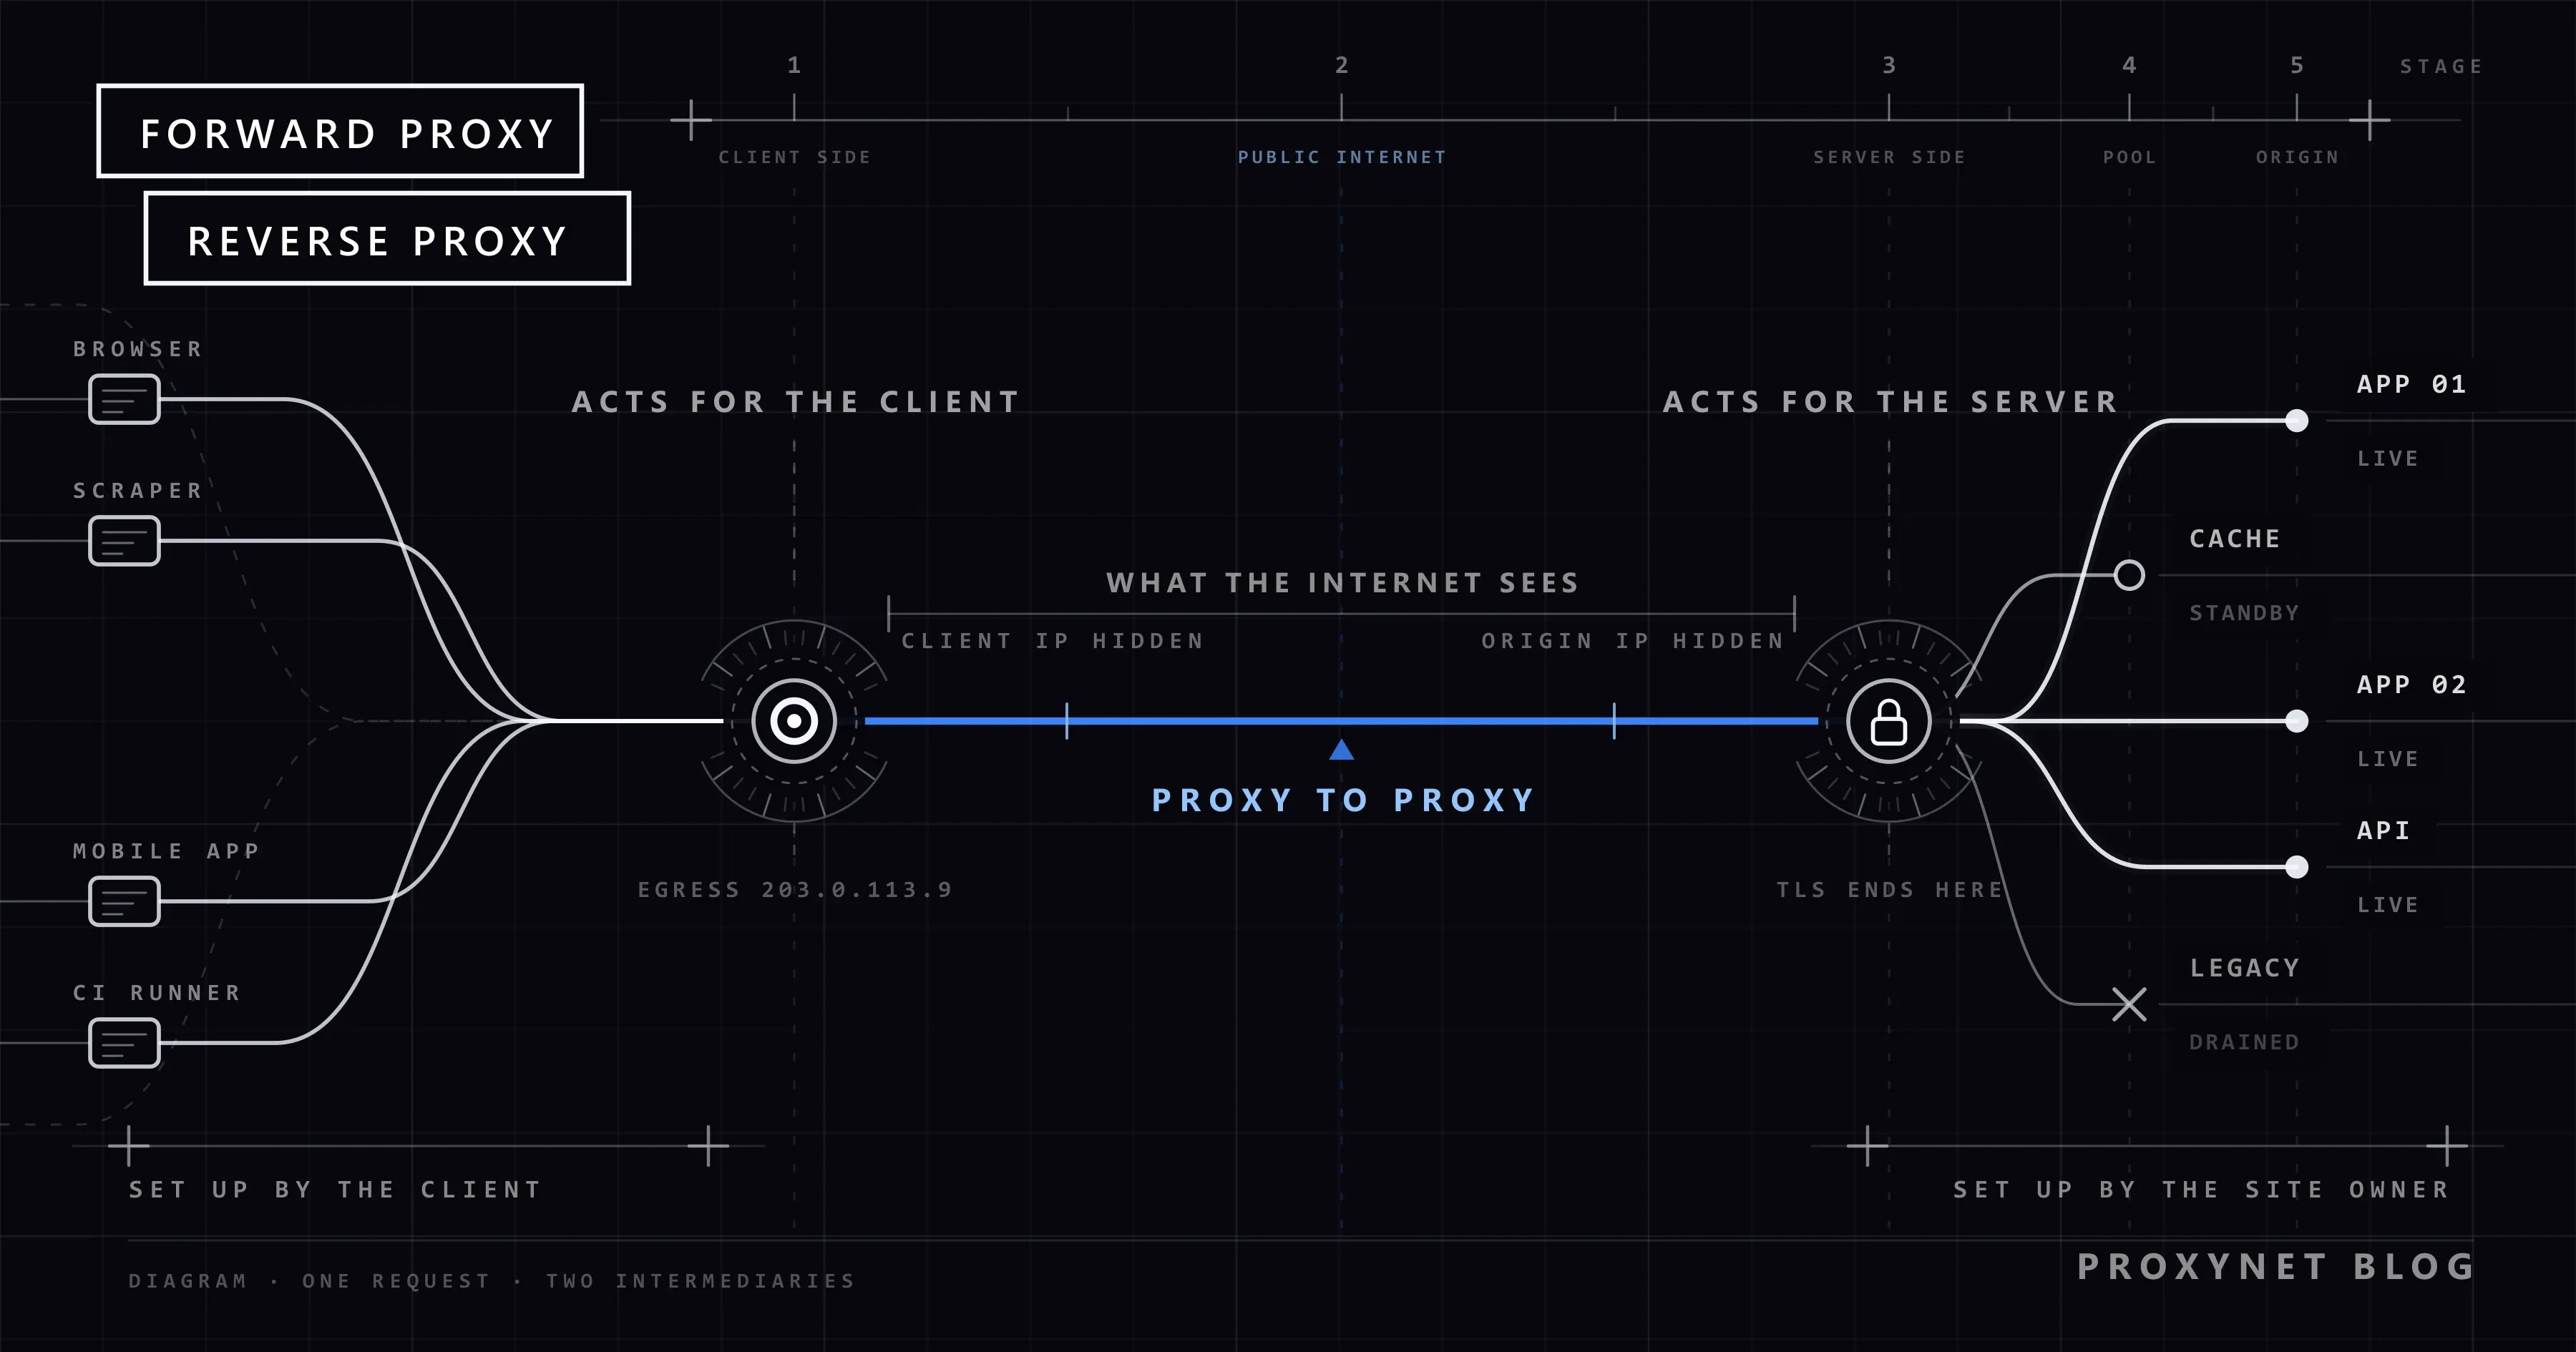
Publicado
Forward proxy e reverse proxy: qual é a diferença?
O forward proxy representa o cliente e o reverse proxy representa o servidor. Comparamos como cada um lida com o tráfego, onde é usado e um exemplo com Nginx.
Autor:Acar Diveroli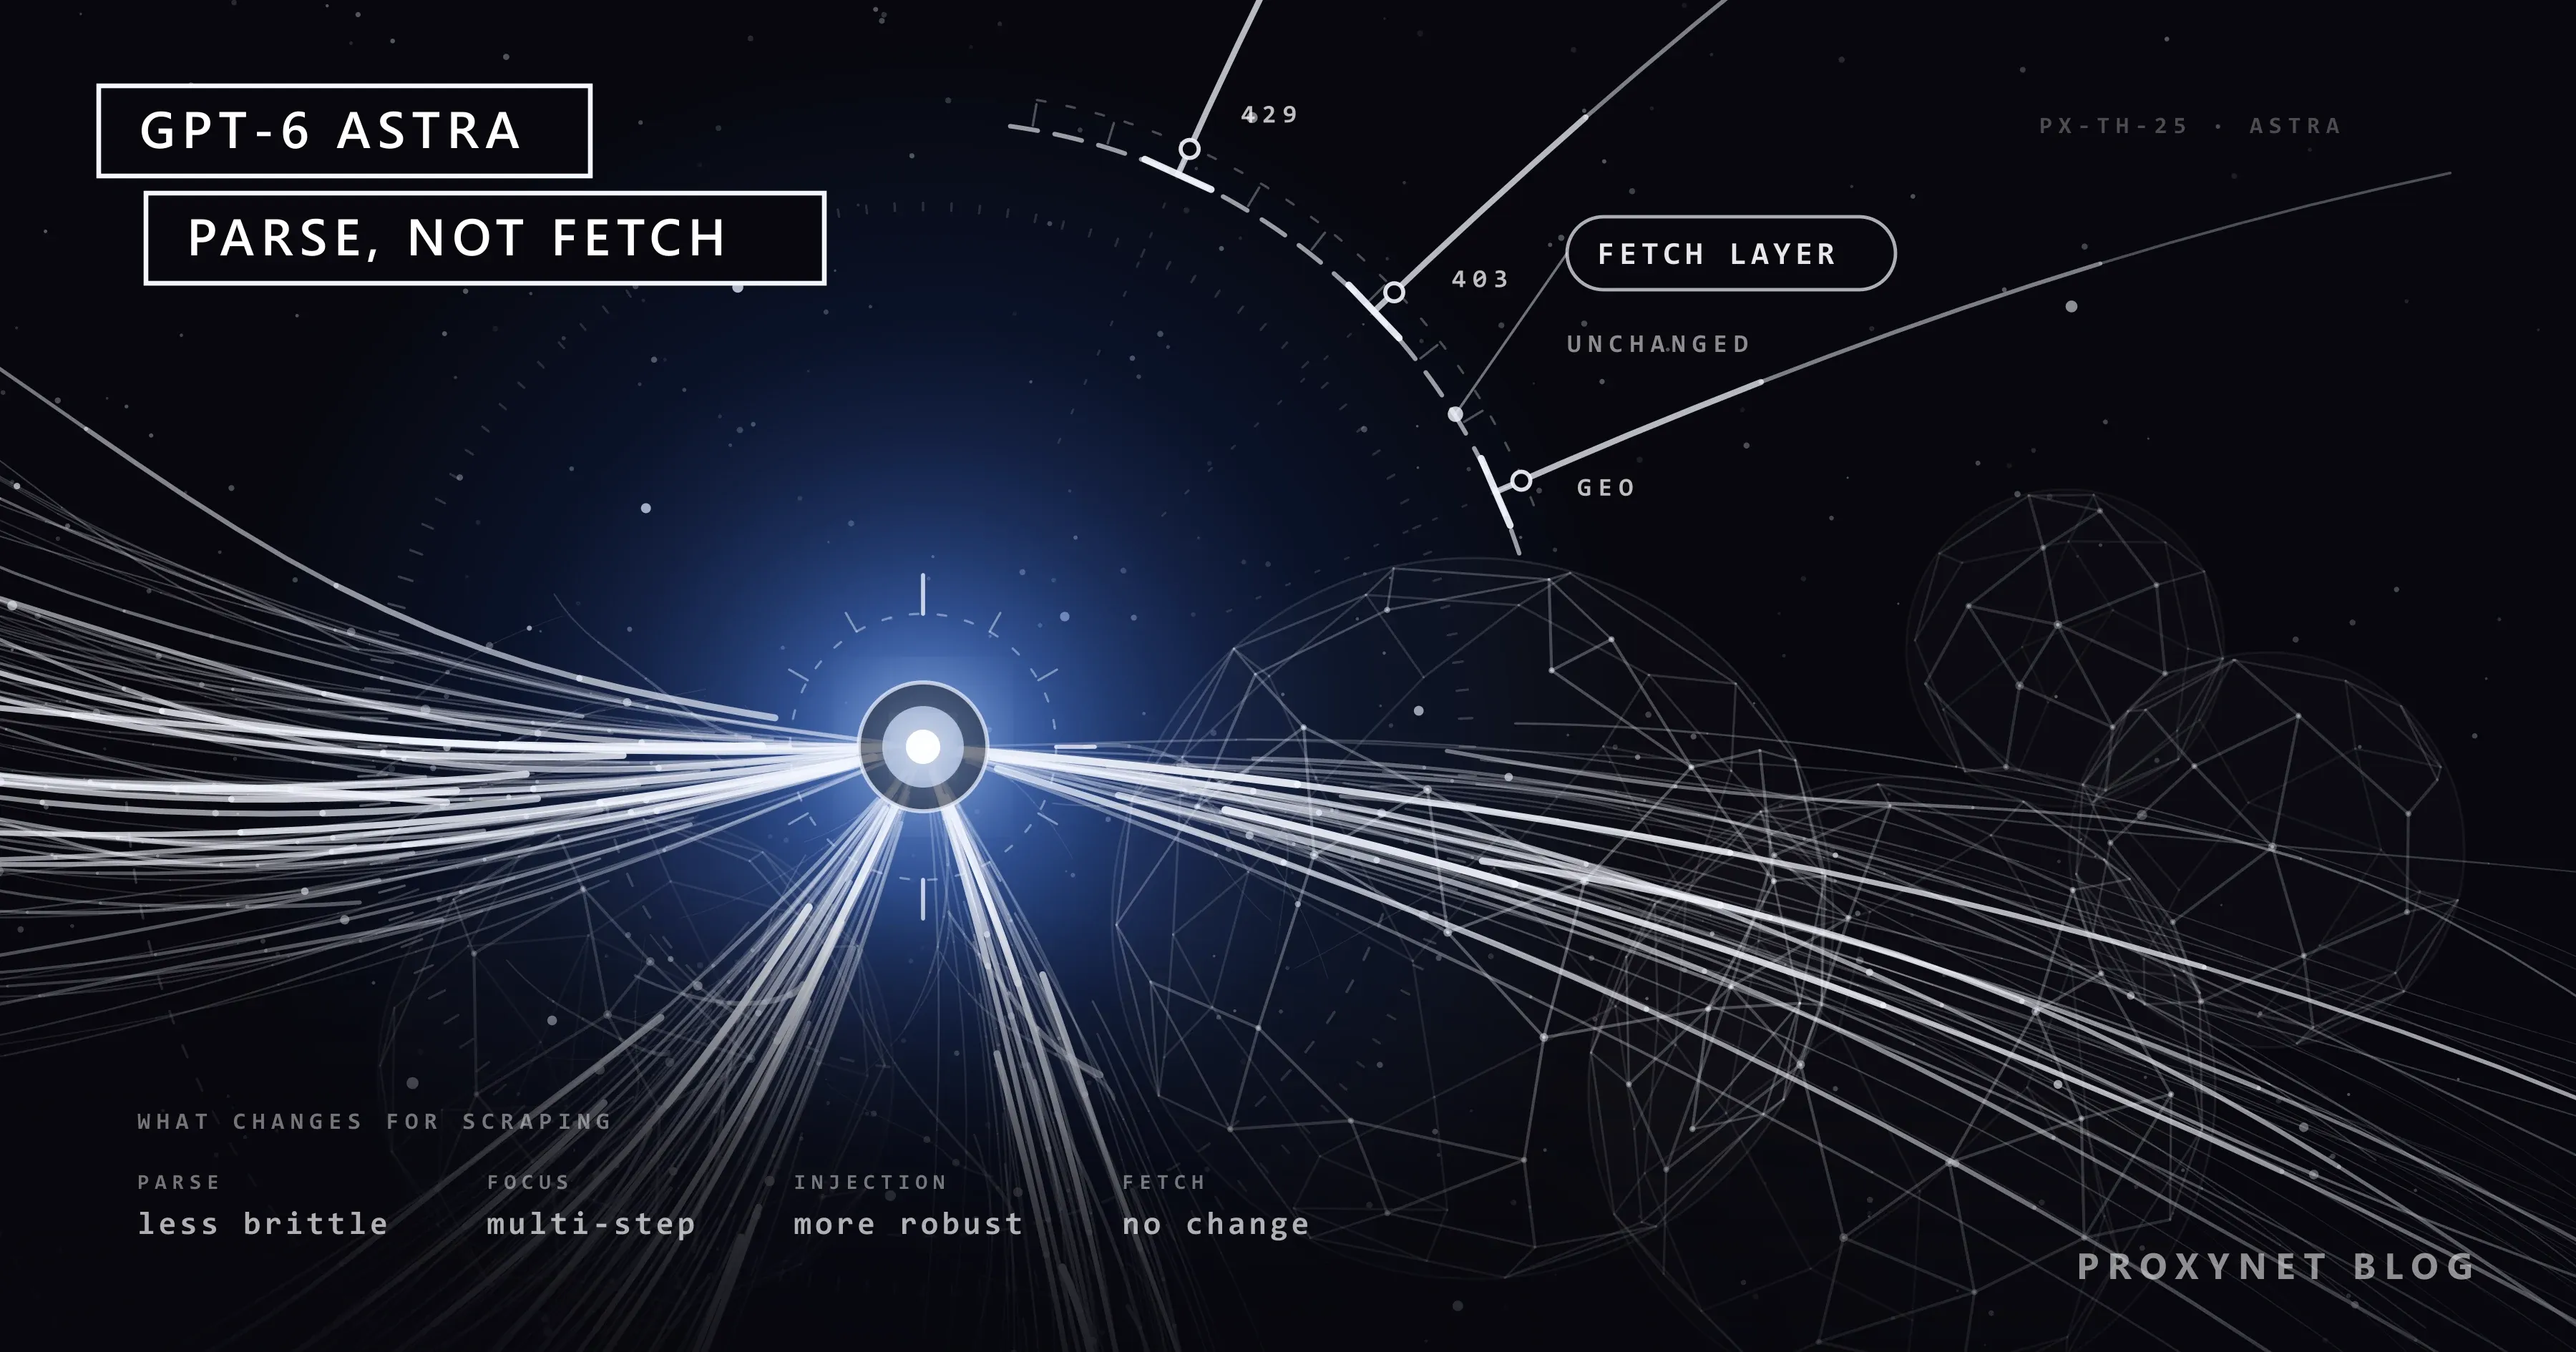
Publicado
Extração de dados com o GPT-6 Astra: o que muda?
O GPT-6 Astra melhora a leitura de páginas e o controle do navegador, mas não resolve bloqueio, CAPTCHA nem limite de requisição. O lugar real do modelo.
Autor:Acar Diveroli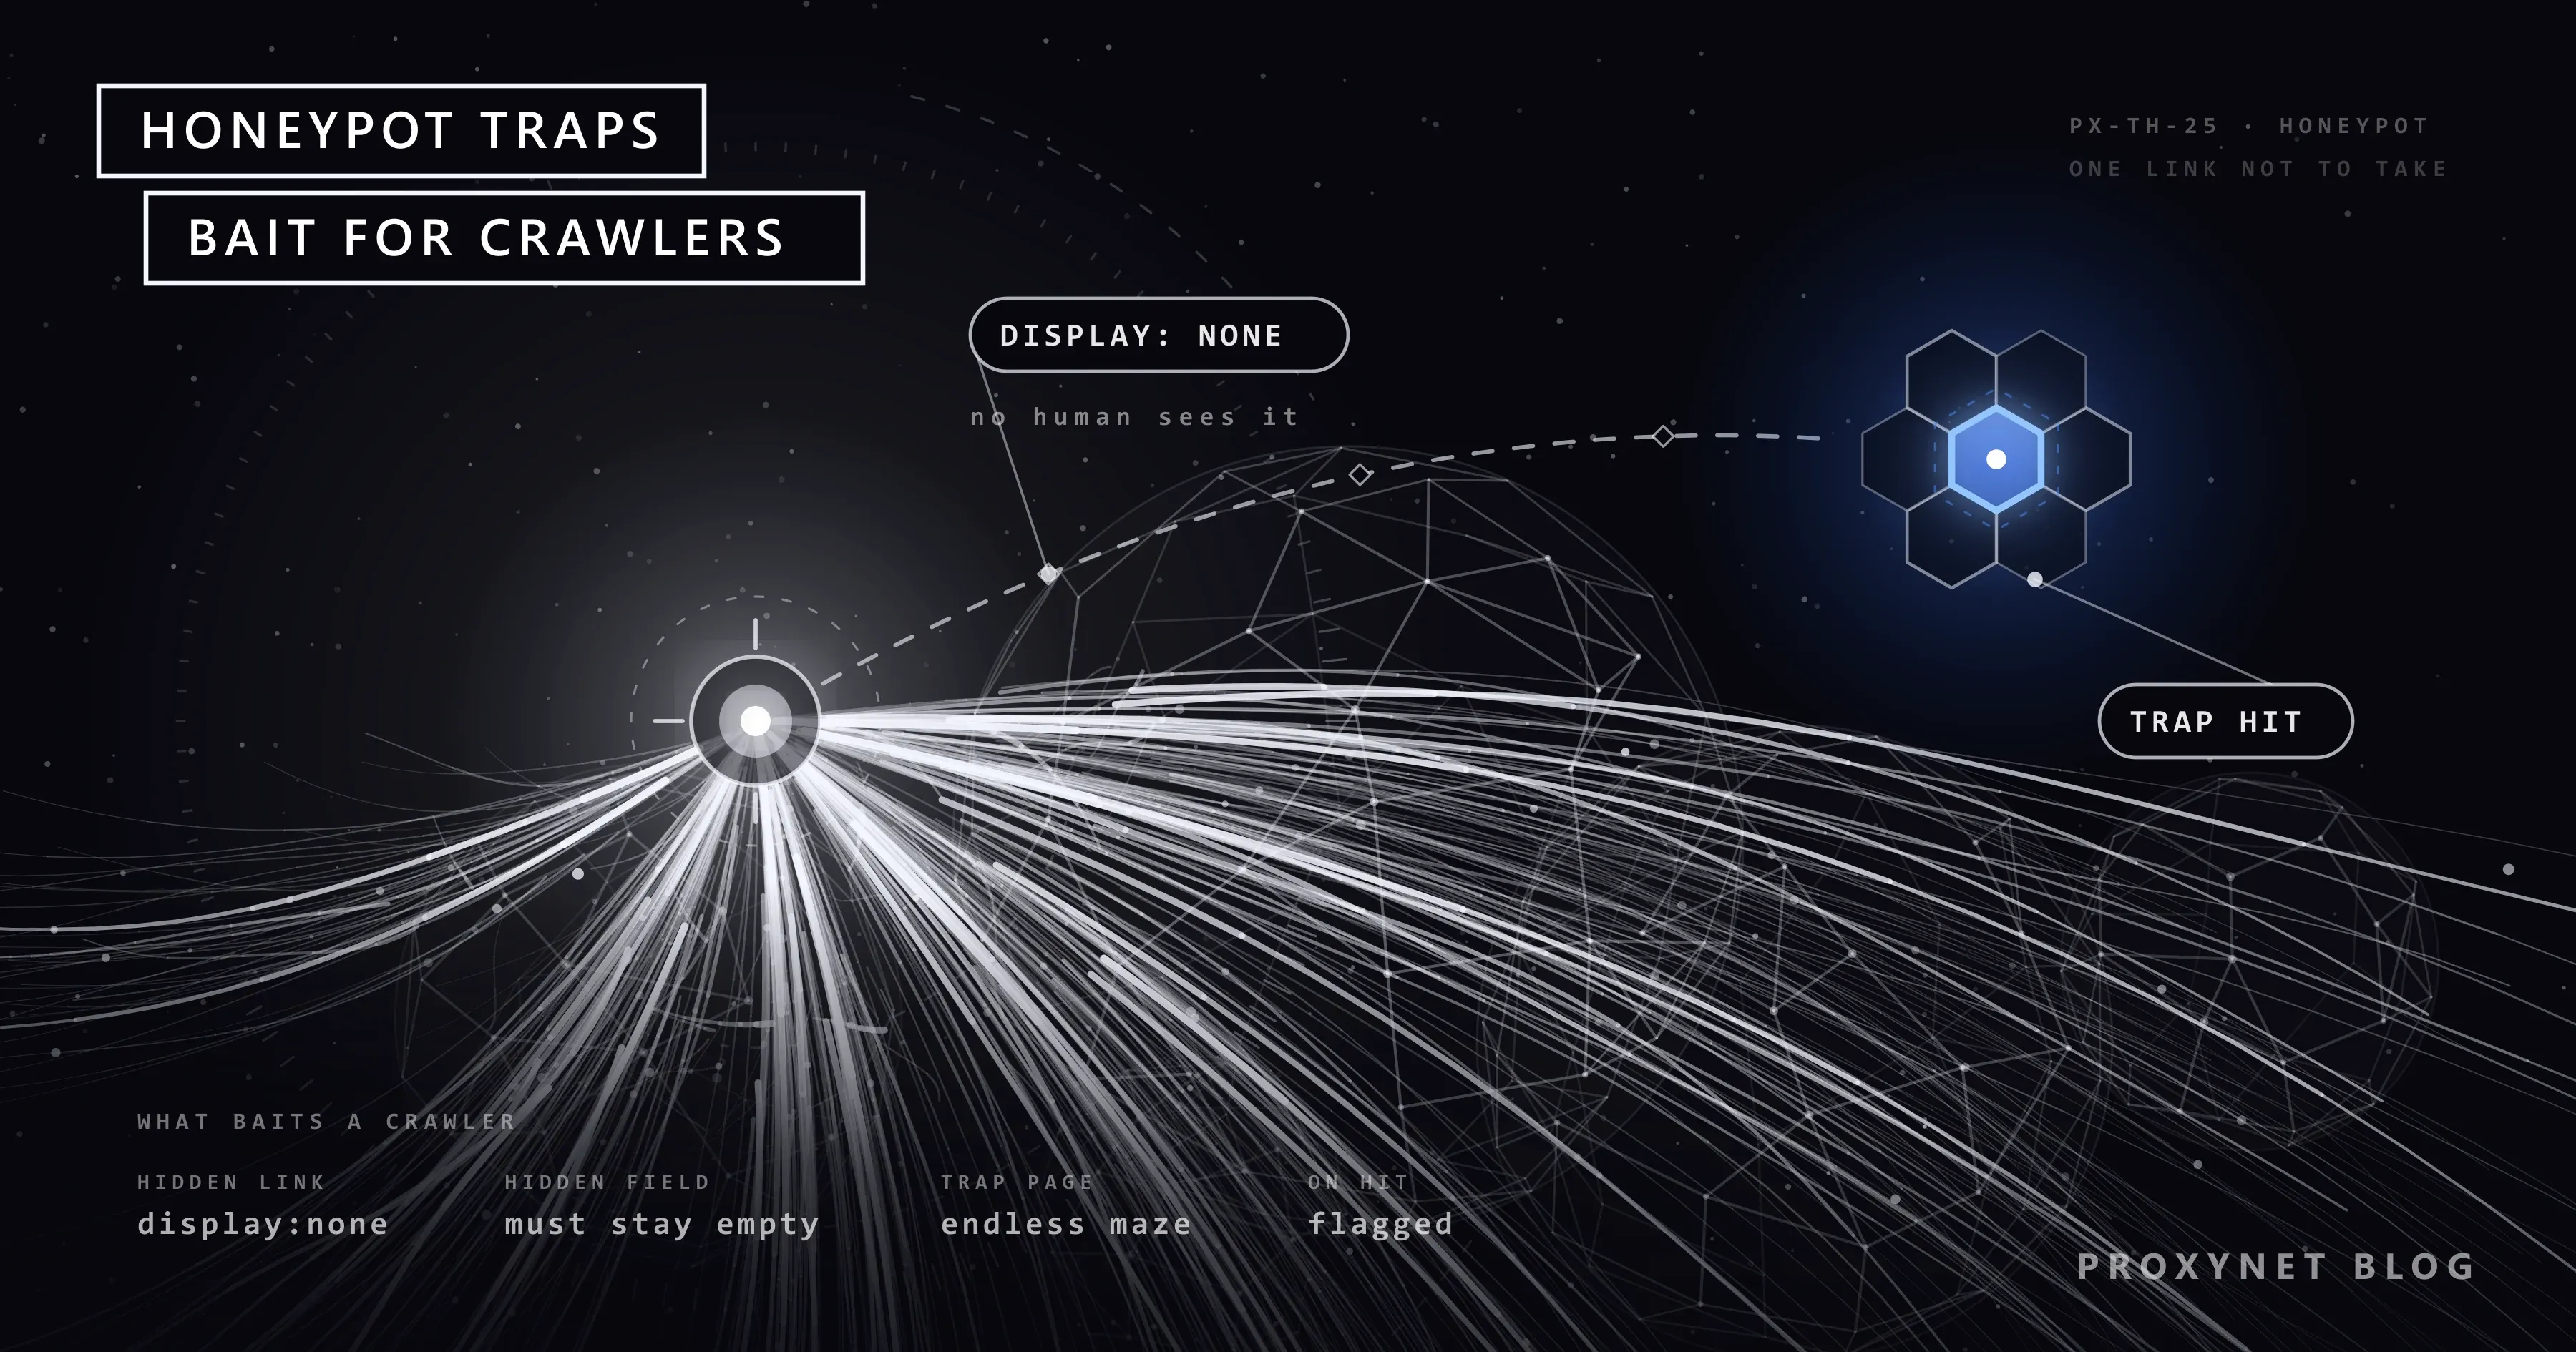
Publicado
O que são armadilhas honeypot e como afetam o scraping?
Honeypots são links escondidos que os visitantes não veem, mas nos quais os bots caem. Explicamos como funcionam, sem ensinar a burlá-los.
Autor:Acar Diveroli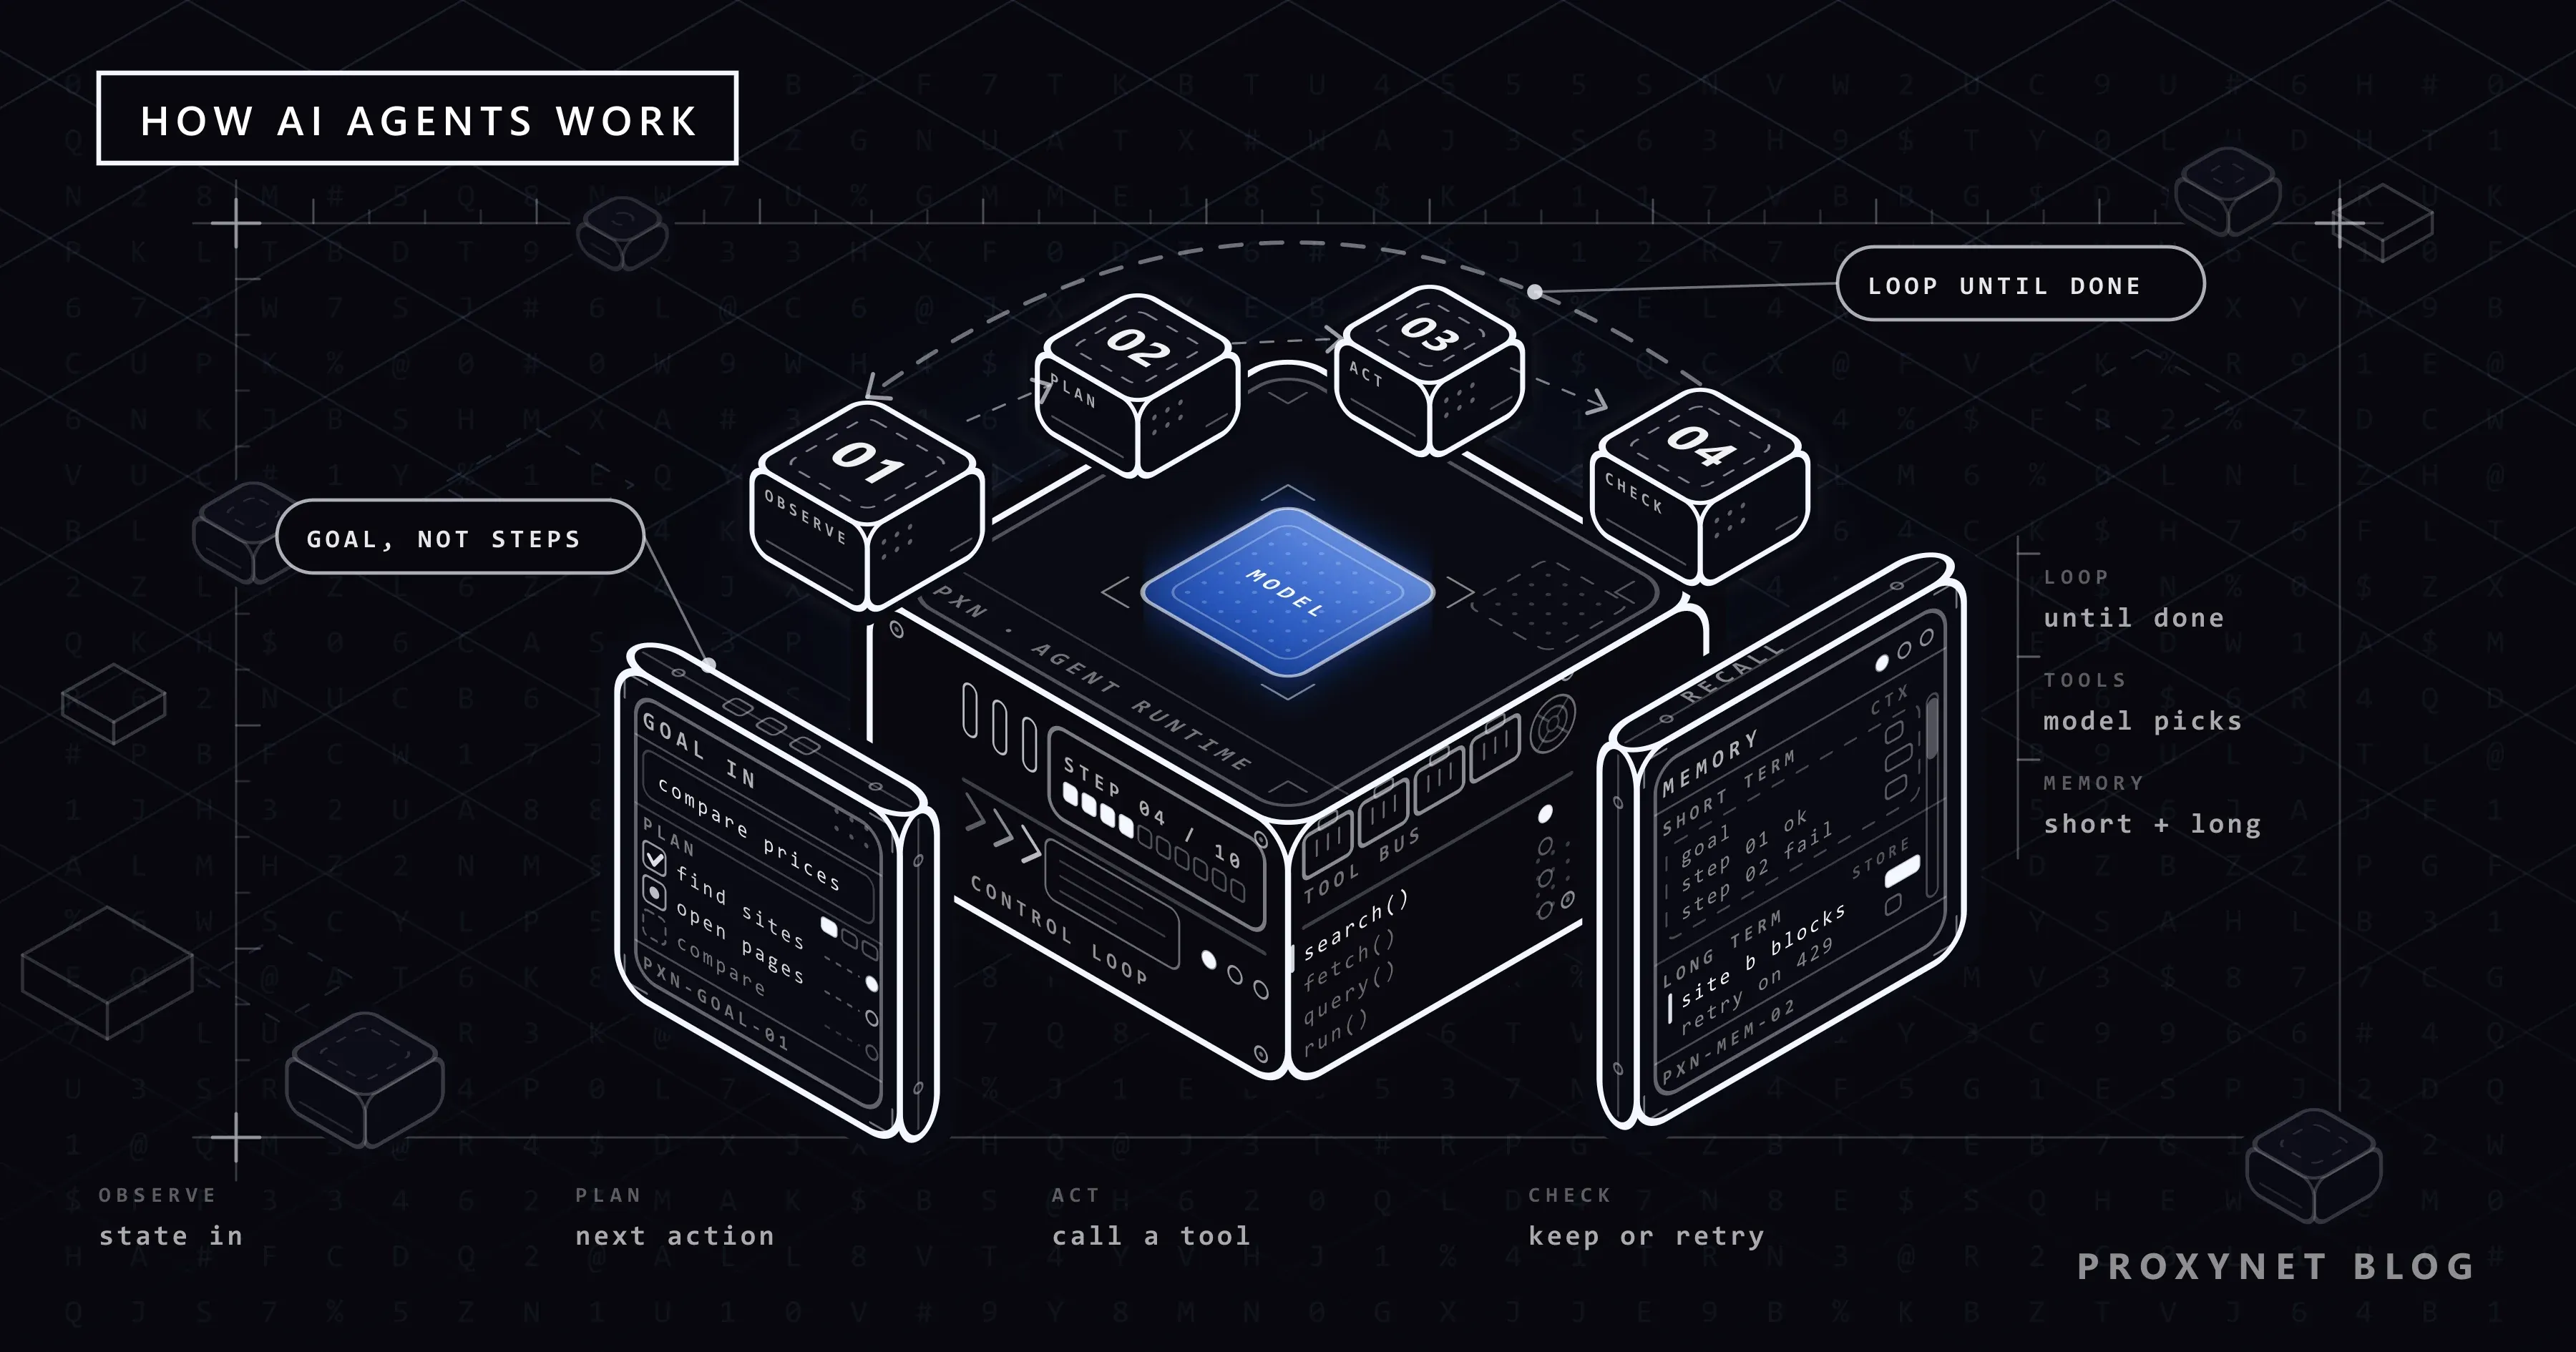
Publicado
Agentes de IA: planejamento, ferramentas e memória
Um agente de IA divide um objetivo em etapas, chama ferramentas, avalia o resultado e atualiza a memória. Explicamos esse loop e como ele acessa a web.
Autor:Acar Diveroli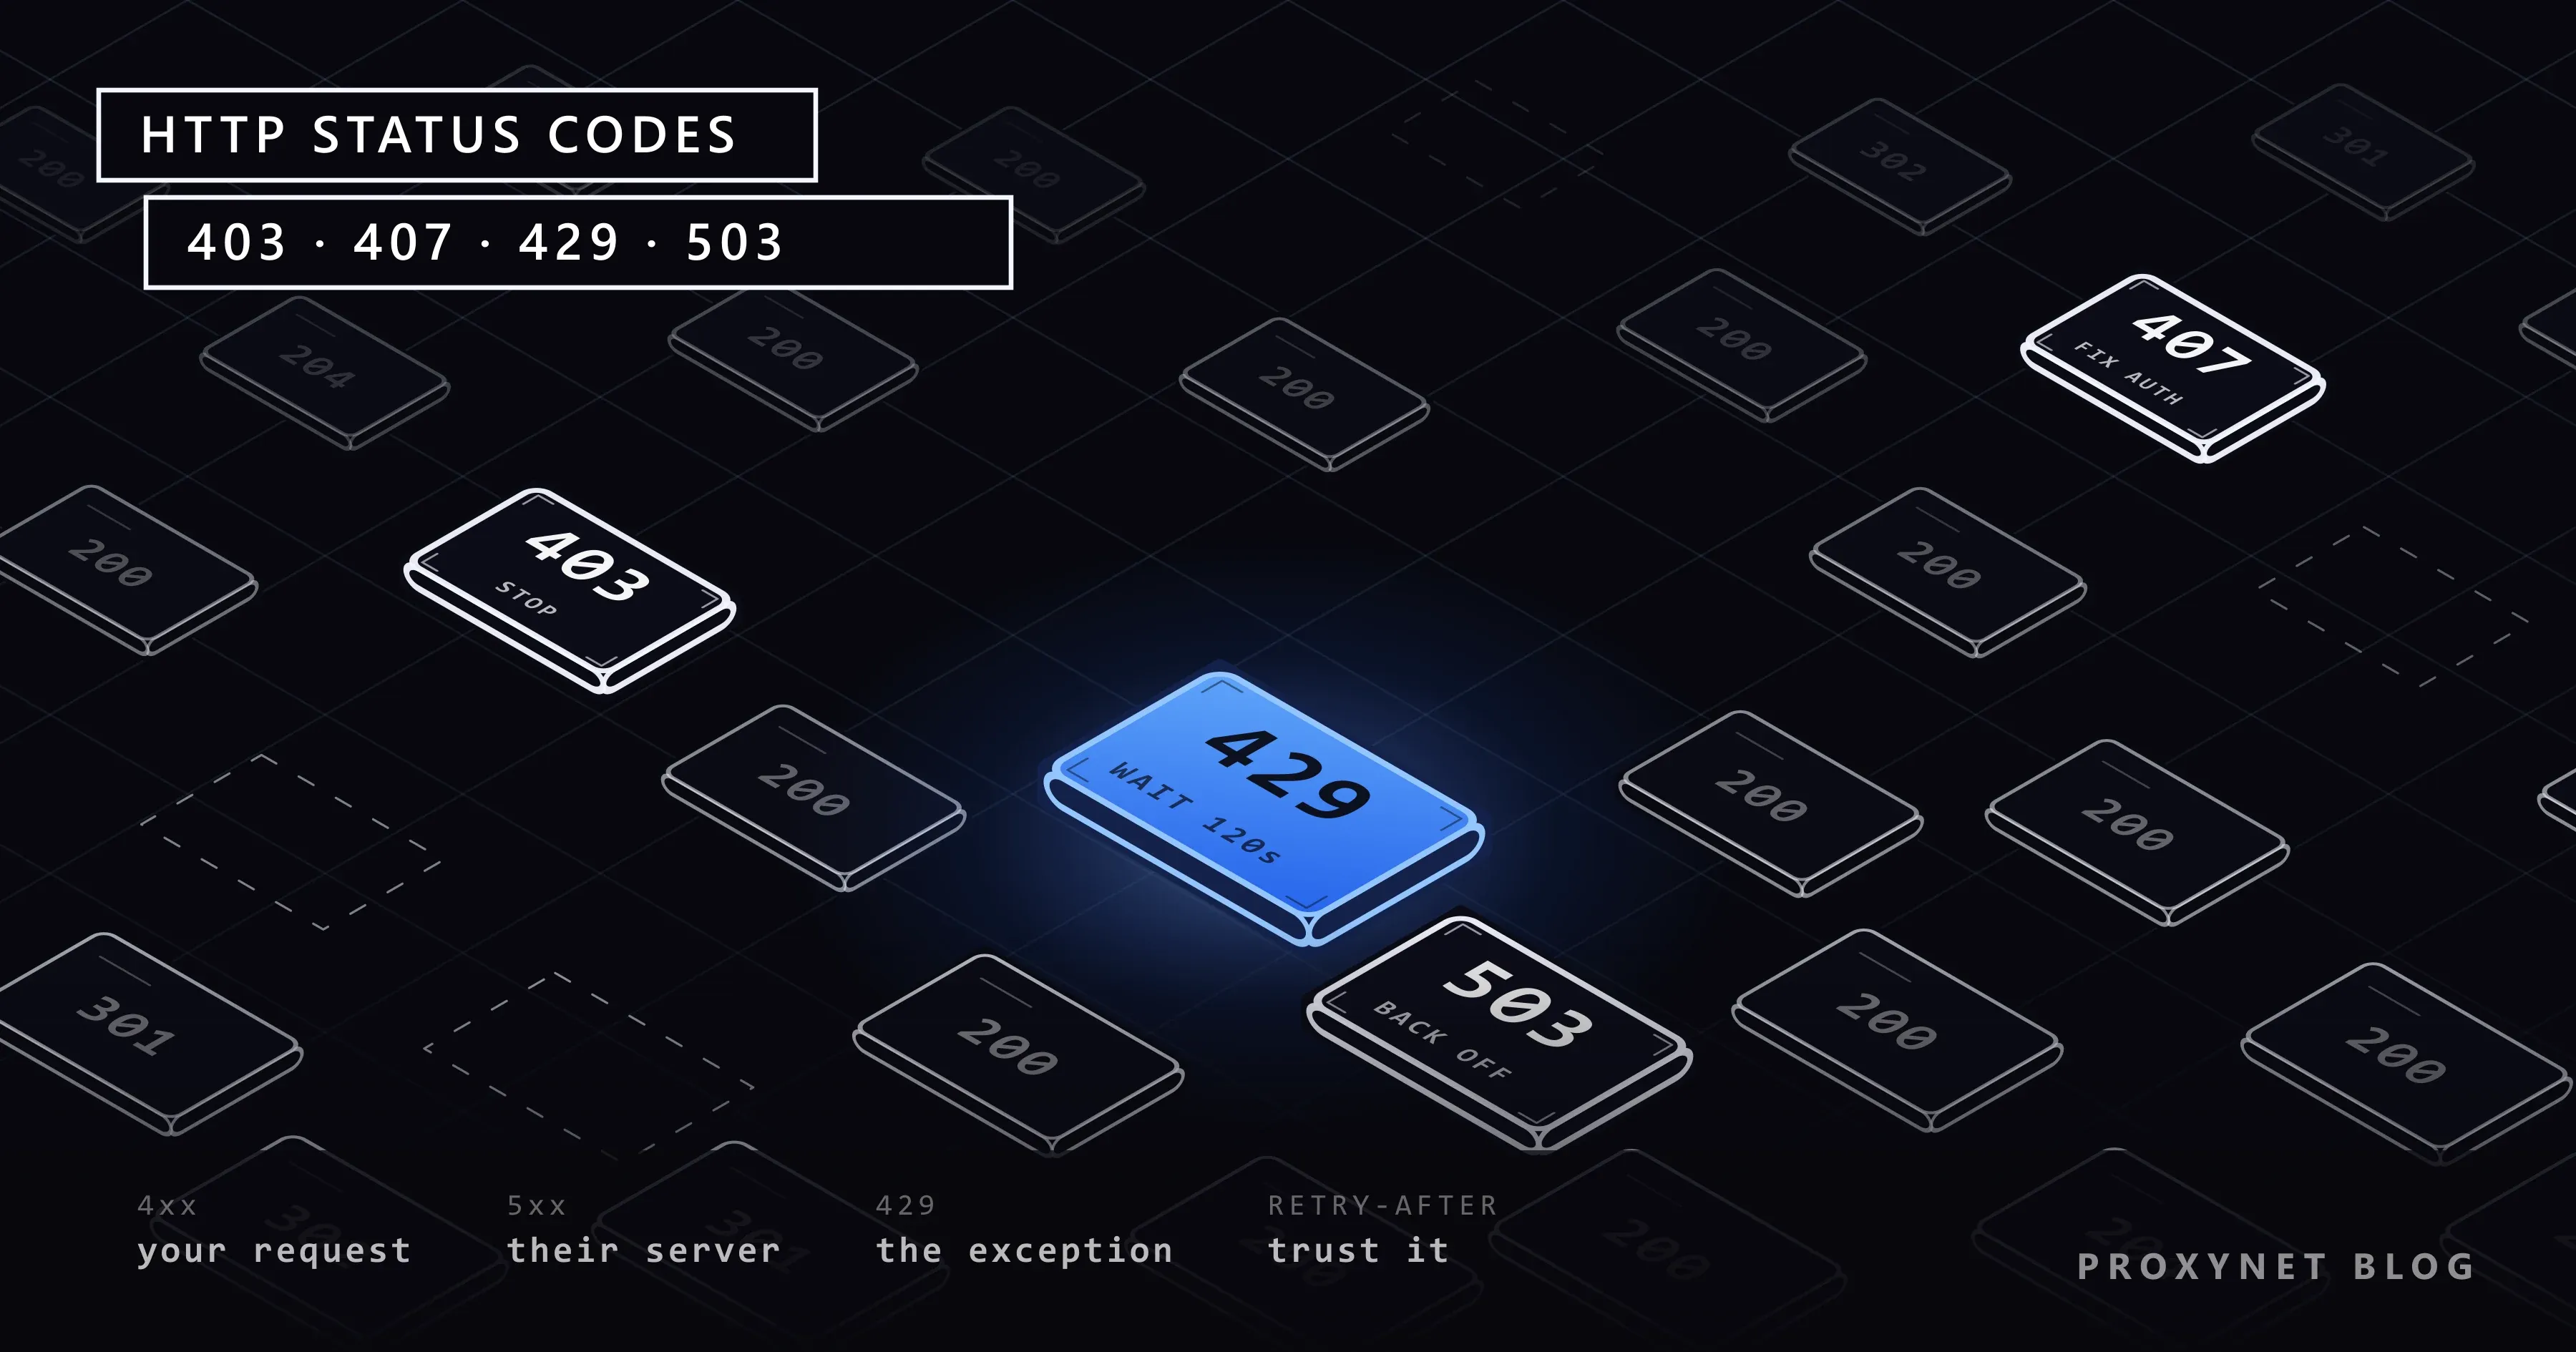
Publicado
Códigos de status HTTP no web scraping: 403, 407, 429, 503
As respostas 403, 407, 429 e 503 indicam problemas diferentes no scraping. Explicamos cada código, as causas e como tentar de novo com Retry-After.
Autor:Acar Diveroli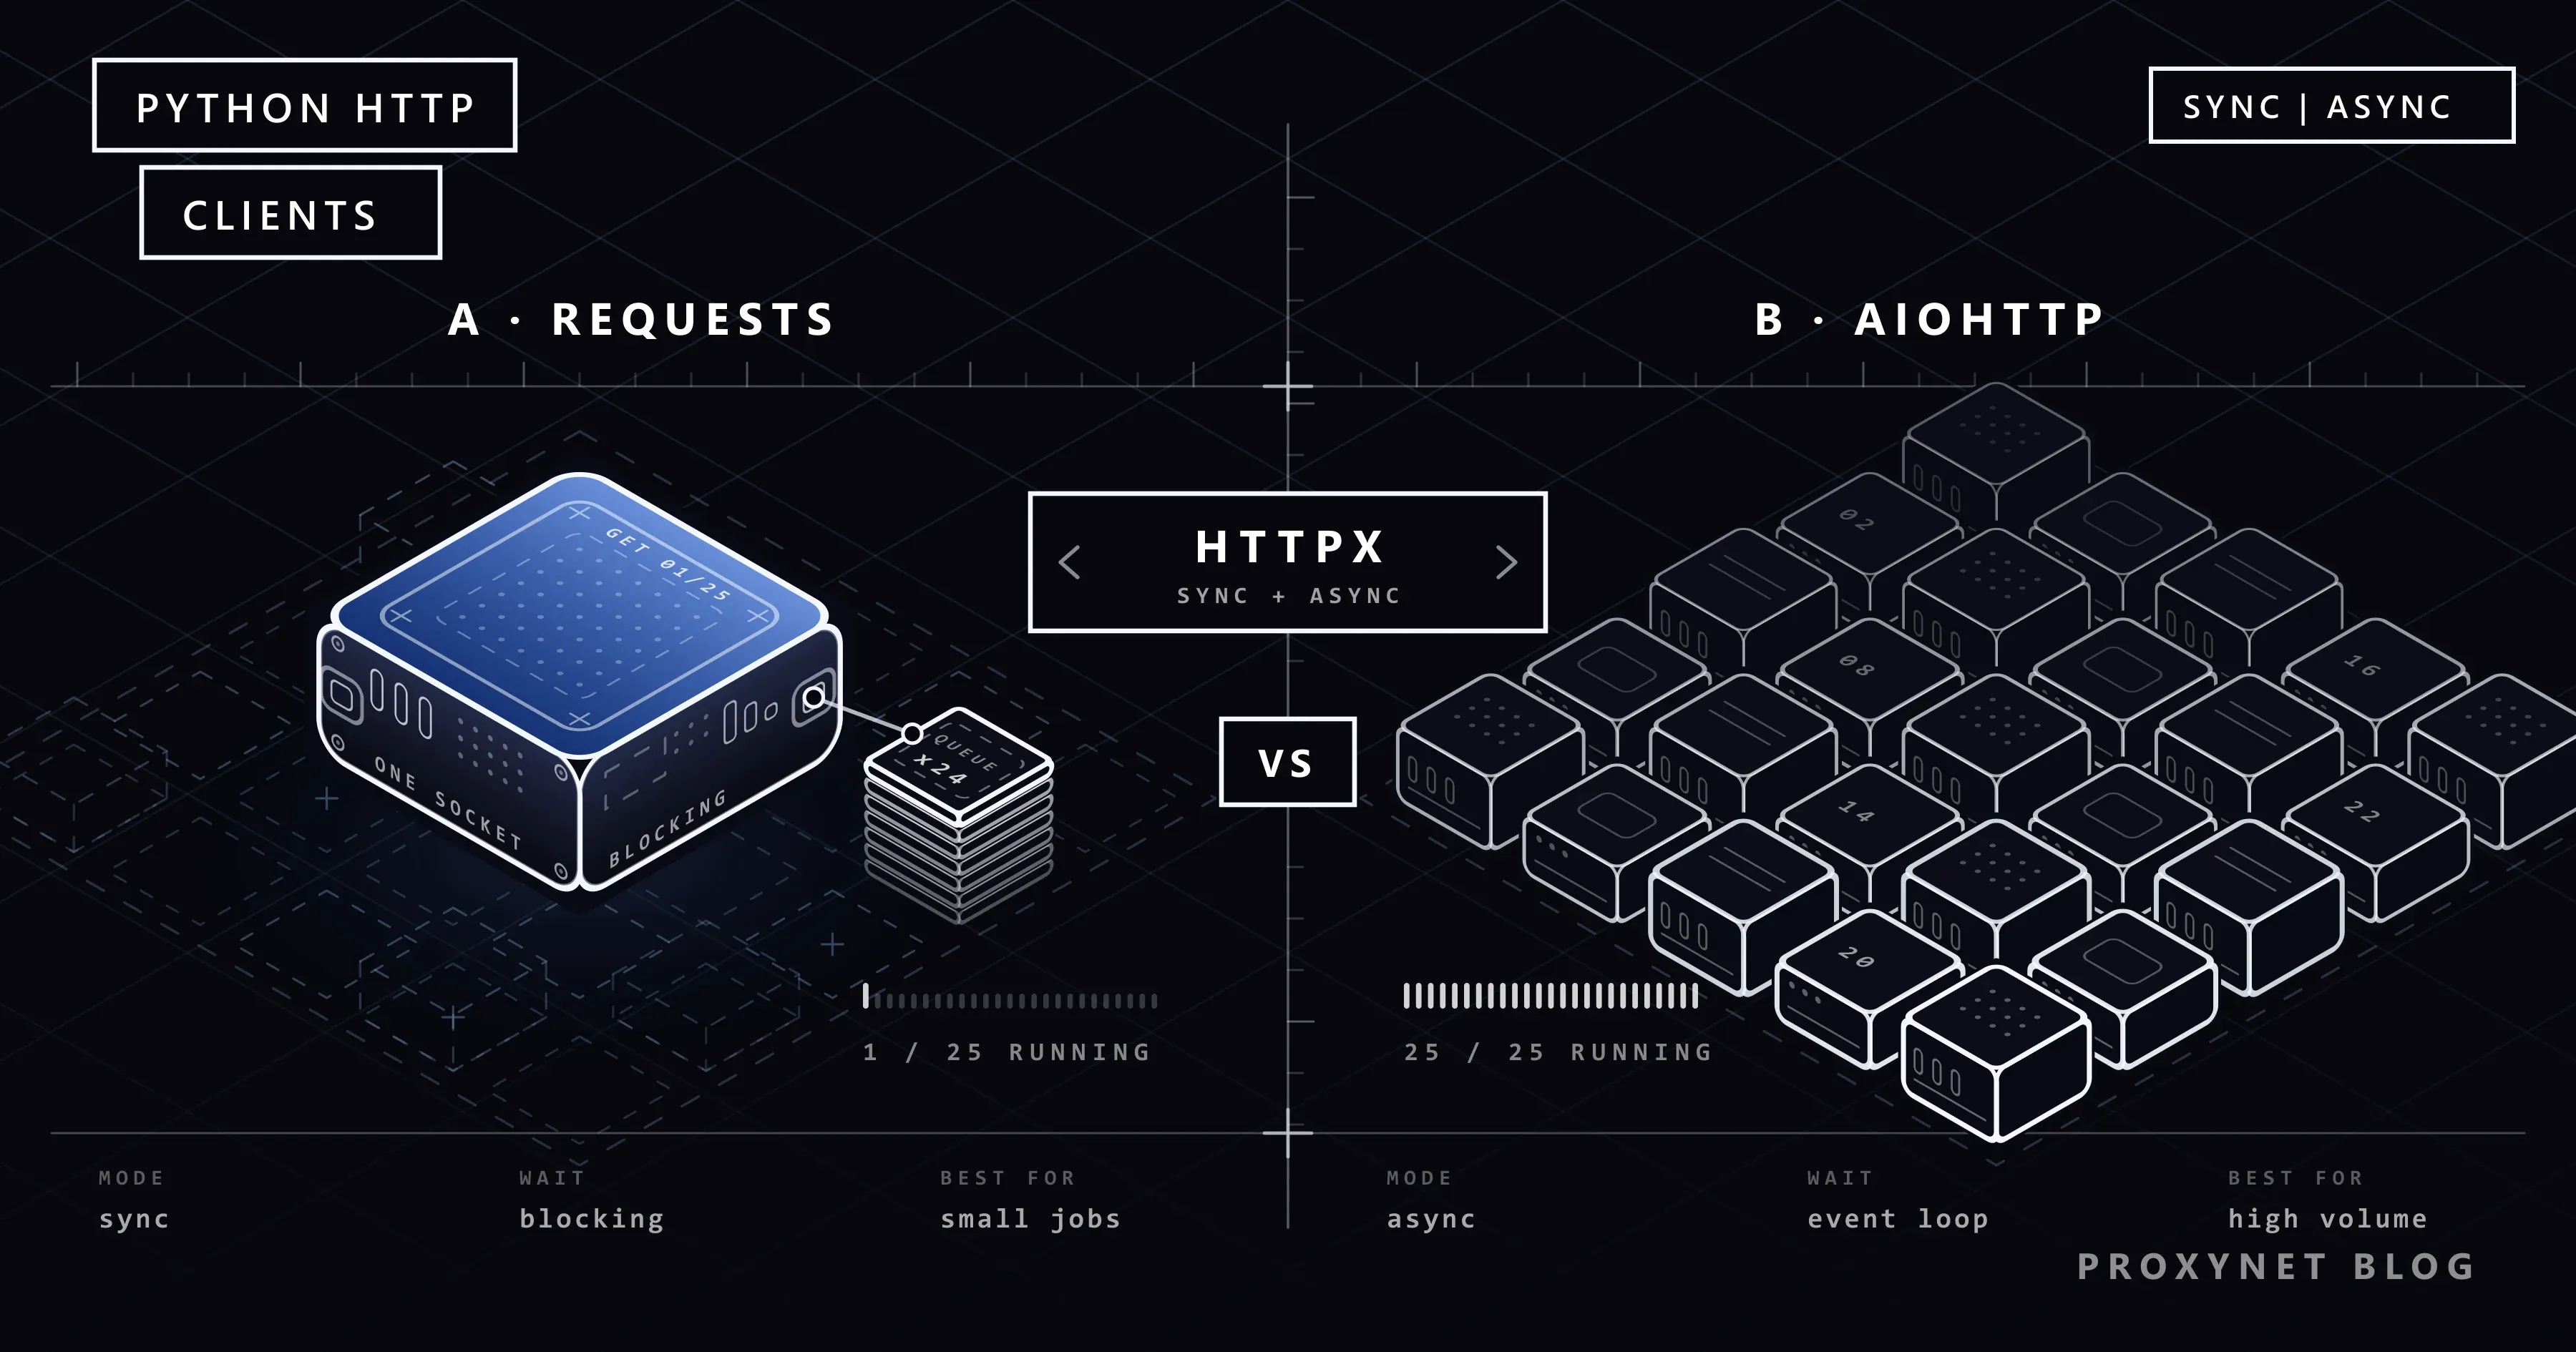
Publicado
Comparativo entre HTTPX, Requests e AIOHTTP
Requests é simples e síncrono, o AIOHTTP é assíncrono, e o HTTPX oferece os dois. Uso de proxy, desempenho e qual escolher em cada projeto, com exemplos.
Autor:Acar Diveroli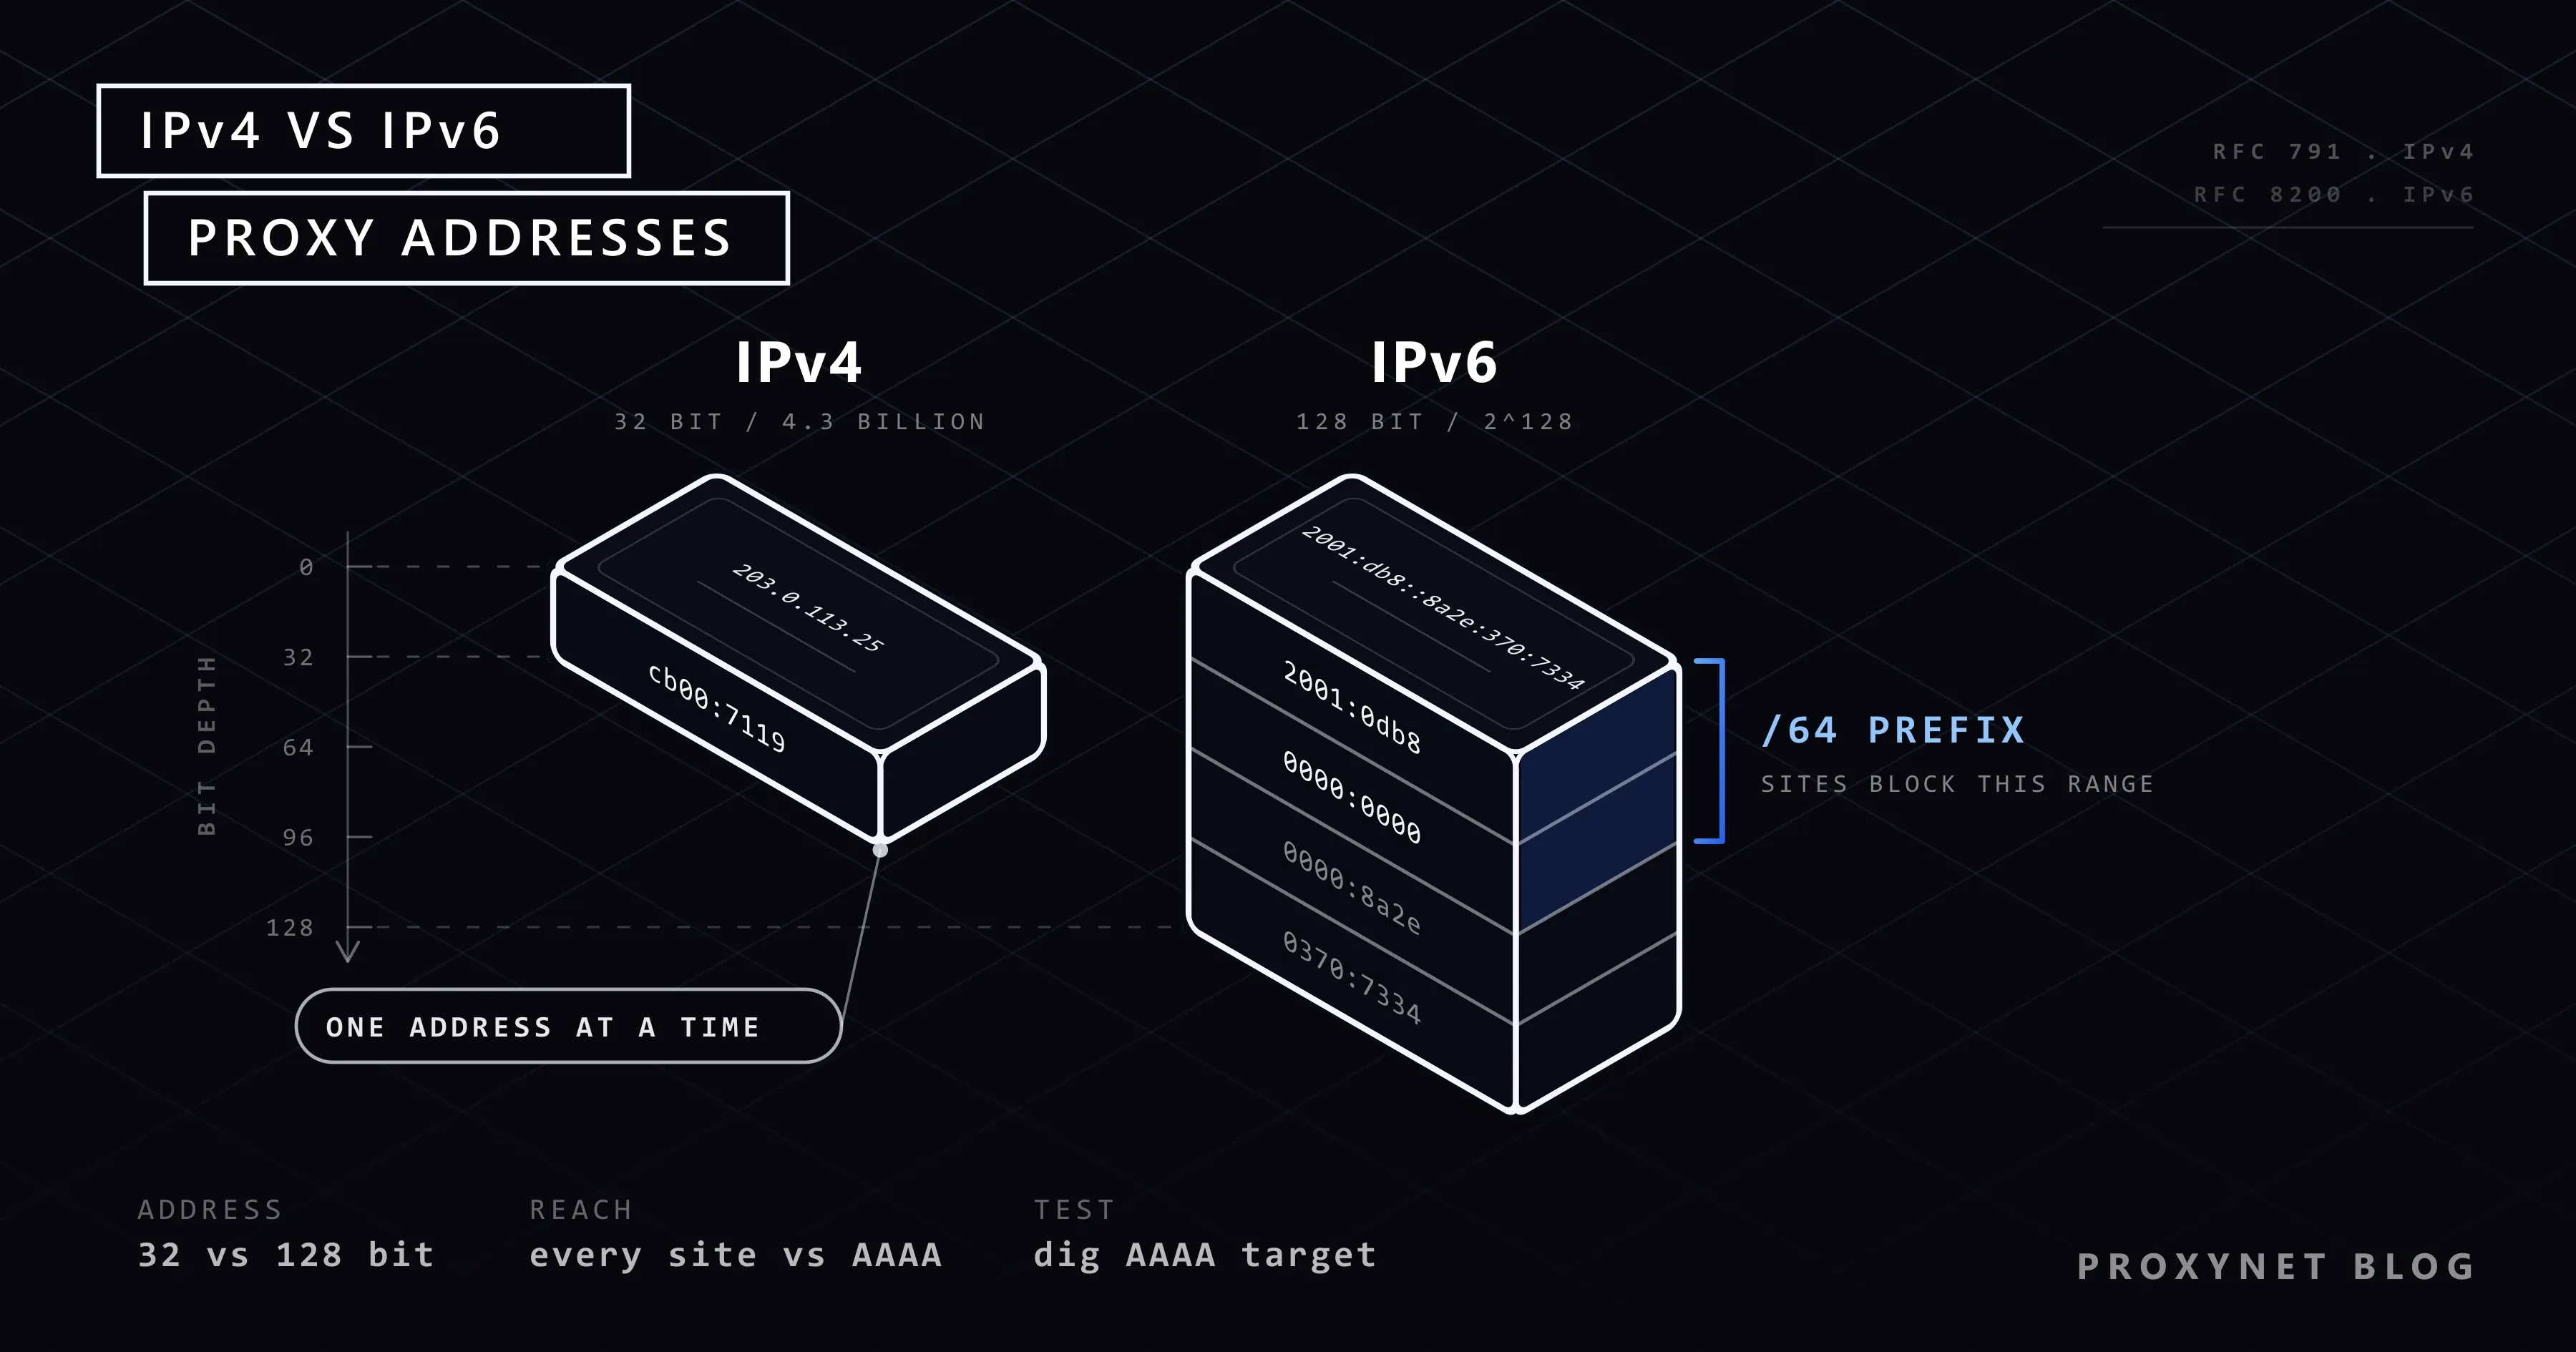
Publicado
Proxies IPv4 e IPv6: qual escolher?
Proxies IPv6 oferecem um pool de endereços enorme, mas nem todo site aceita conexões IPv6. Explicamos a diferença, a compatibilidade e como escolher.
Autor:Acar Diveroli
O que é fingerprint do navegador?
Autor: Acar DiveroliProxy 101Publicado
O que é o Cloudflare Precursor?
Autor: Acar DiveroliProxy 101Publicado
Concorrência e paralelismo no web scraping
Autor: Acar DiveroliComparativosPublicado
Seletor CSS ou XPath: qual usar no web scraping?
Autor: Acar DiveroliComparativosPublicado
cURL em JavaScript: fetch, Axios e proxy
Autor: Acar DiveroliTutoriaisPublicado
Forward proxy e reverse proxy: qual é a diferença?
Autor: Acar DiveroliComparativosPublicado
Extração de dados com o GPT-6 Astra: o que muda?
Autor: Acar DiveroliIAPublicado
O que são armadilhas honeypot e como afetam o scraping?
Autor: Acar DiveroliWeb scrapingPublicado
Agentes de IA: planejamento, ferramentas e memória
Autor: Acar DiveroliIAPublicado
Códigos de status HTTP no web scraping: 403, 407, 429, 503
Autor: Acar DiveroliWeb scrapingPublicado
Comparativo entre HTTPX, Requests e AIOHTTP
Autor: Acar DiveroliComparativosPublicado
Proxies IPv4 e IPv6: qual escolher?
Autor: Acar DiveroliComparativosPublicado
Nenhum artigo encontrado
Publicado
Publicado