
Blog de Proxynet – Página 19

Publicado
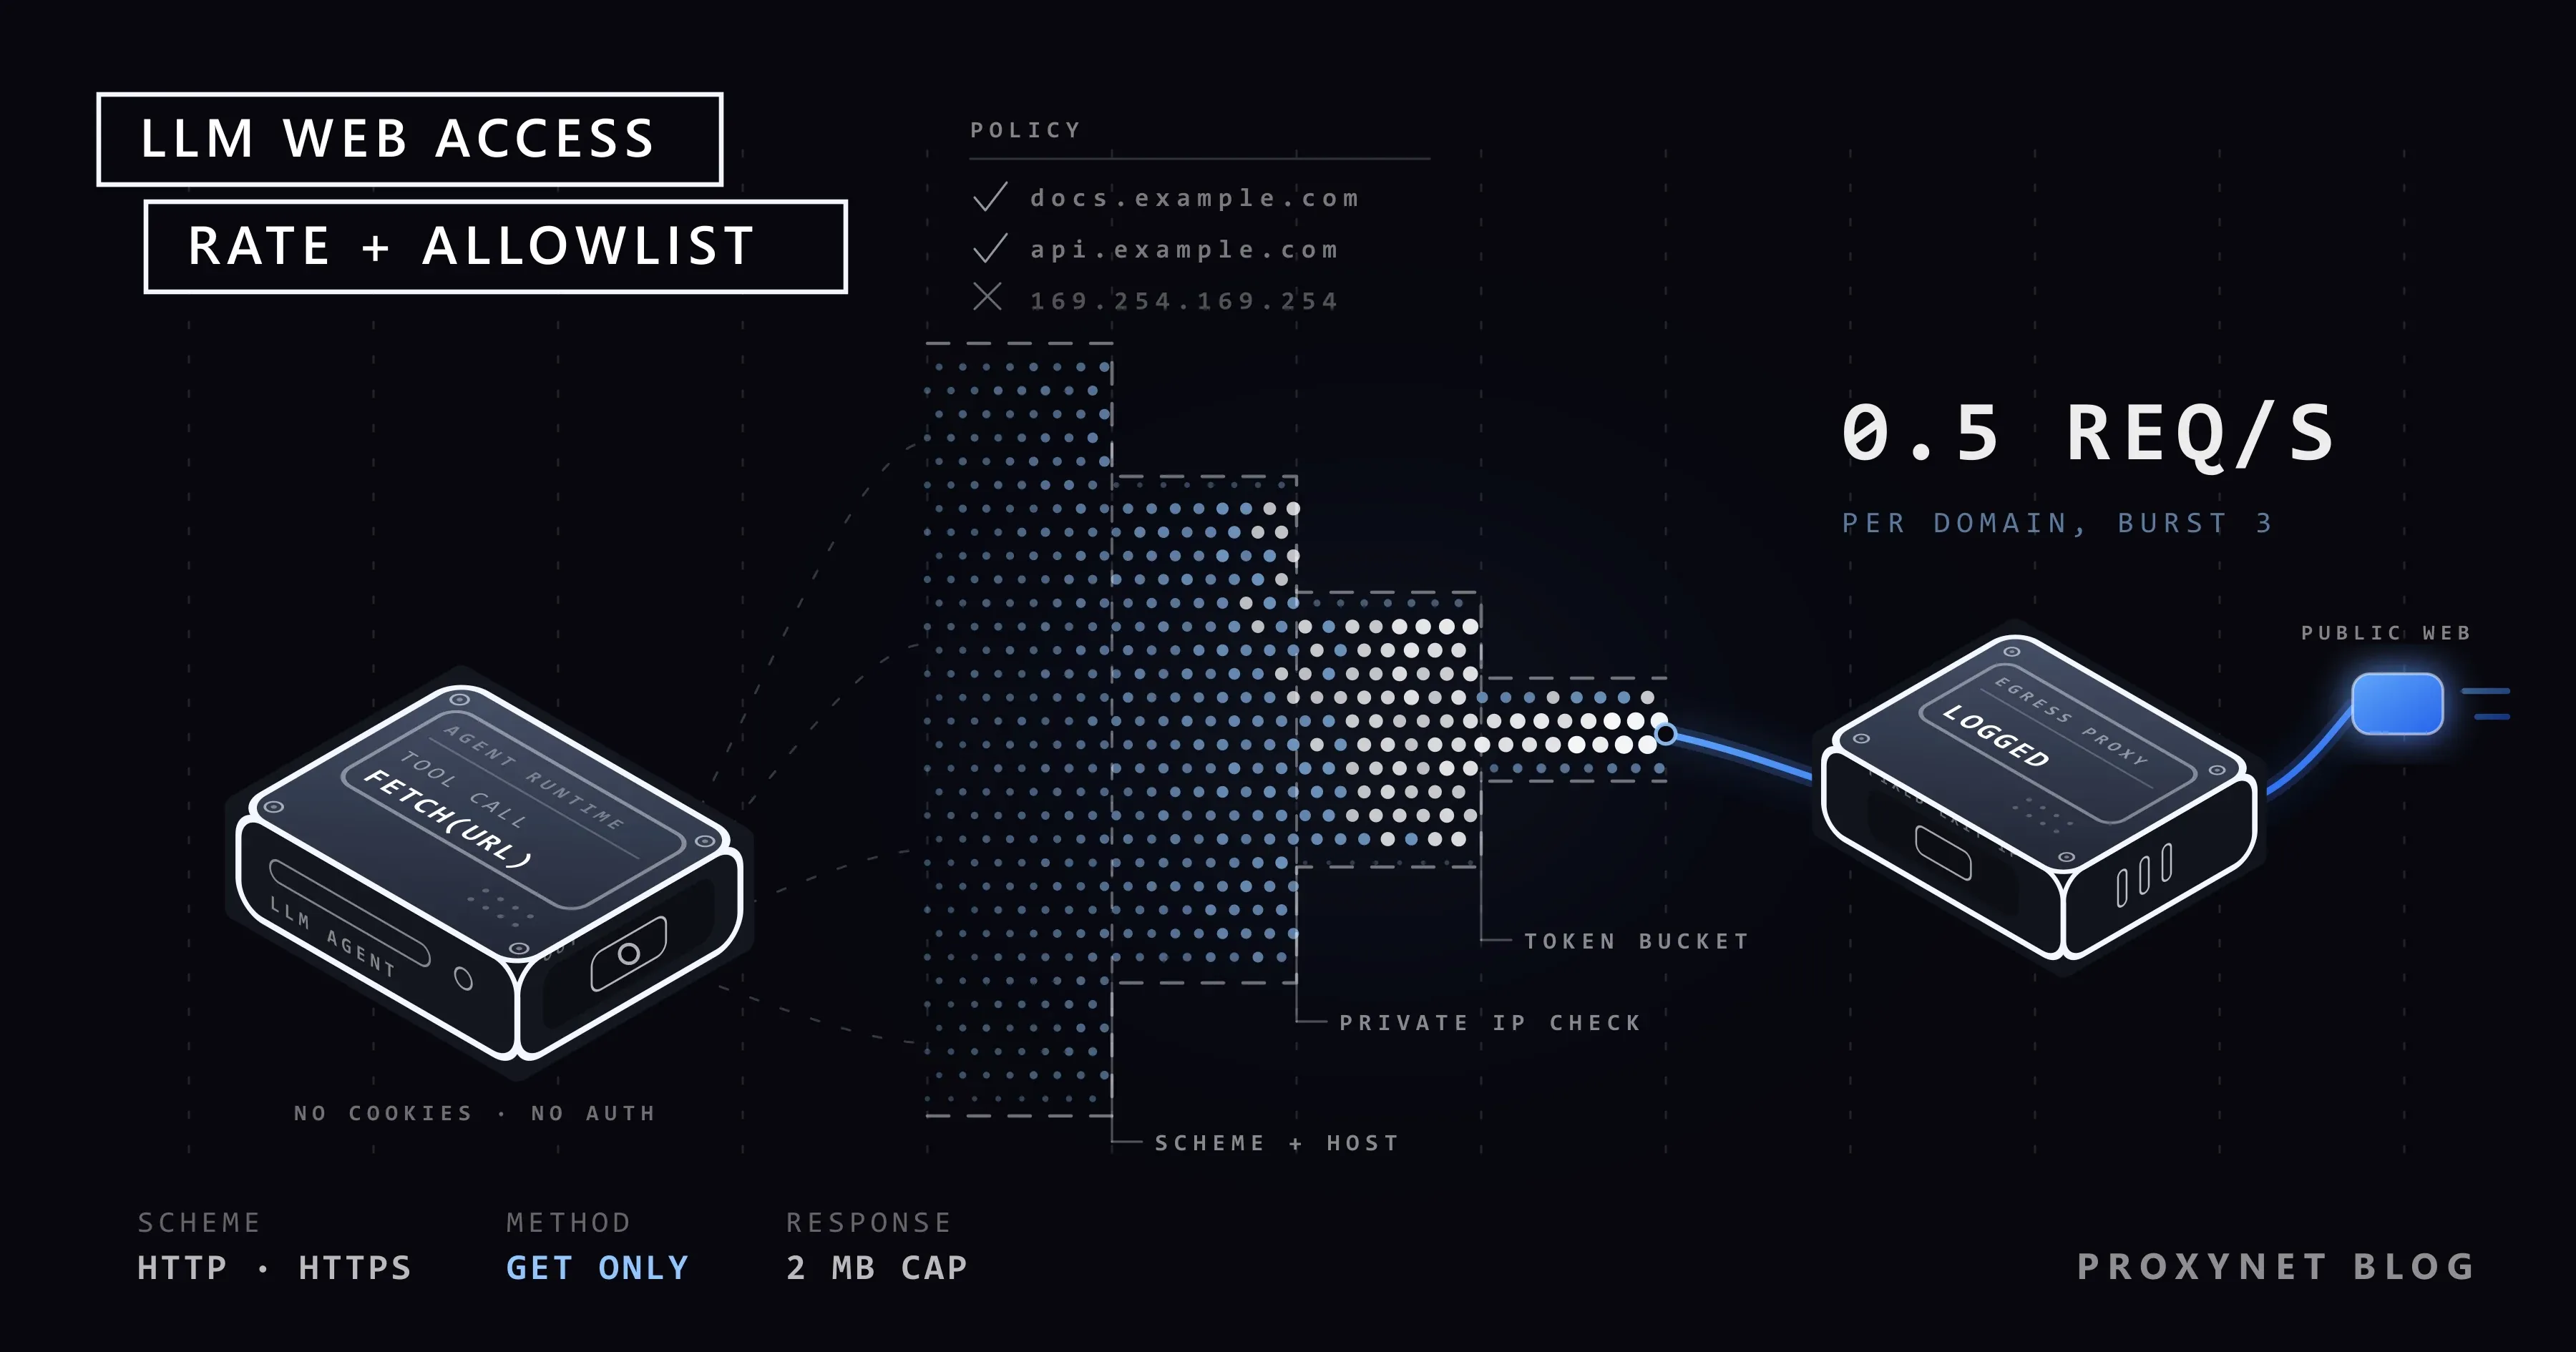
Acceso web seguro para LLM: límites y permisos
Un LLM con acceso web conlleva inyección de prompts y peticiones sin control. Montamos un esquema seguro con límites, lista de permitidos, proxy y registros.
Autor: Acar Diveroli
Publicado
Cómo usar un proxy en Node.js: Axios y node-fetch
Cómo usar un proxy en Node.js con Axios, node-fetch y fetch integrado, con código que funciona. Incluye autenticación, SOCKS5, rotación y errores.
Autor:Acar Diveroli
Publicado
Configuración de proxy en Postman paso a paso
Cómo definir un proxy propio en Postman, usar el proxy del sistema y añadir autenticación. Incluye soluciones para los errores de conexión habituales.
Autor:Acar Diveroli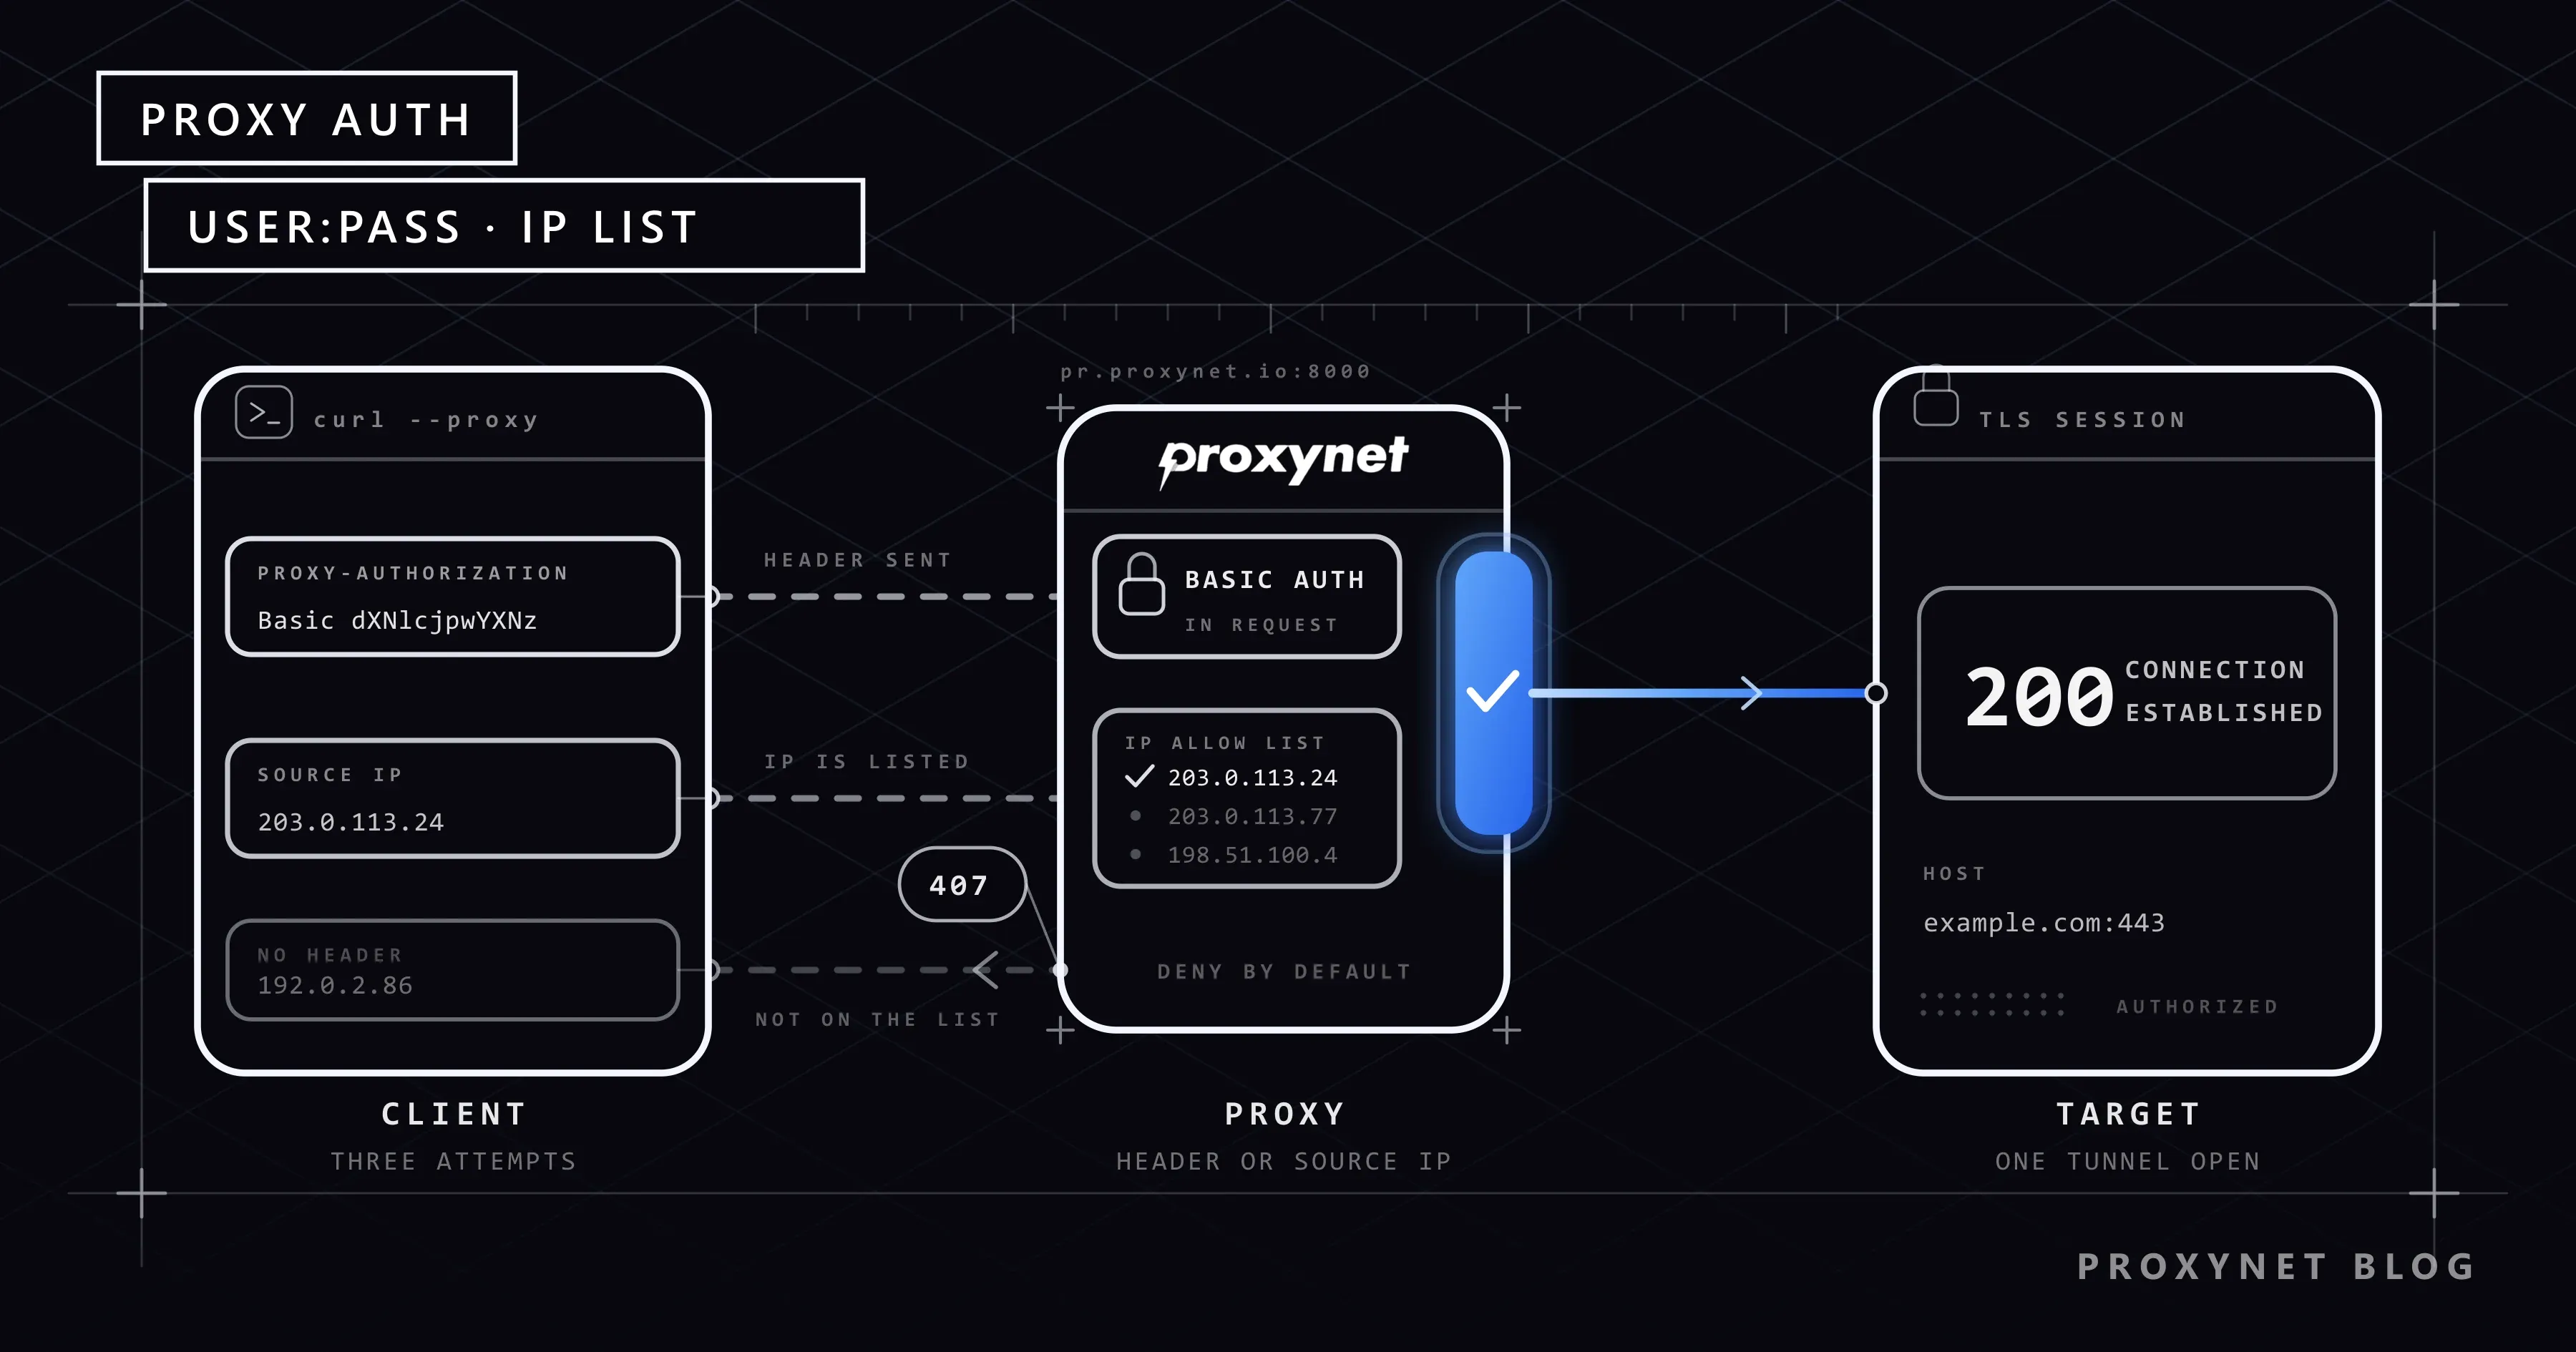
Publicado
Autenticación de proxy: user:pass o lista blanca de IP
Te conectas a un proxy con usuario y contraseña o con una lista de IP permitidas. Comparamos la seguridad de ambos métodos, el error 407 y cómo elegir.
Autor:Acar Diveroli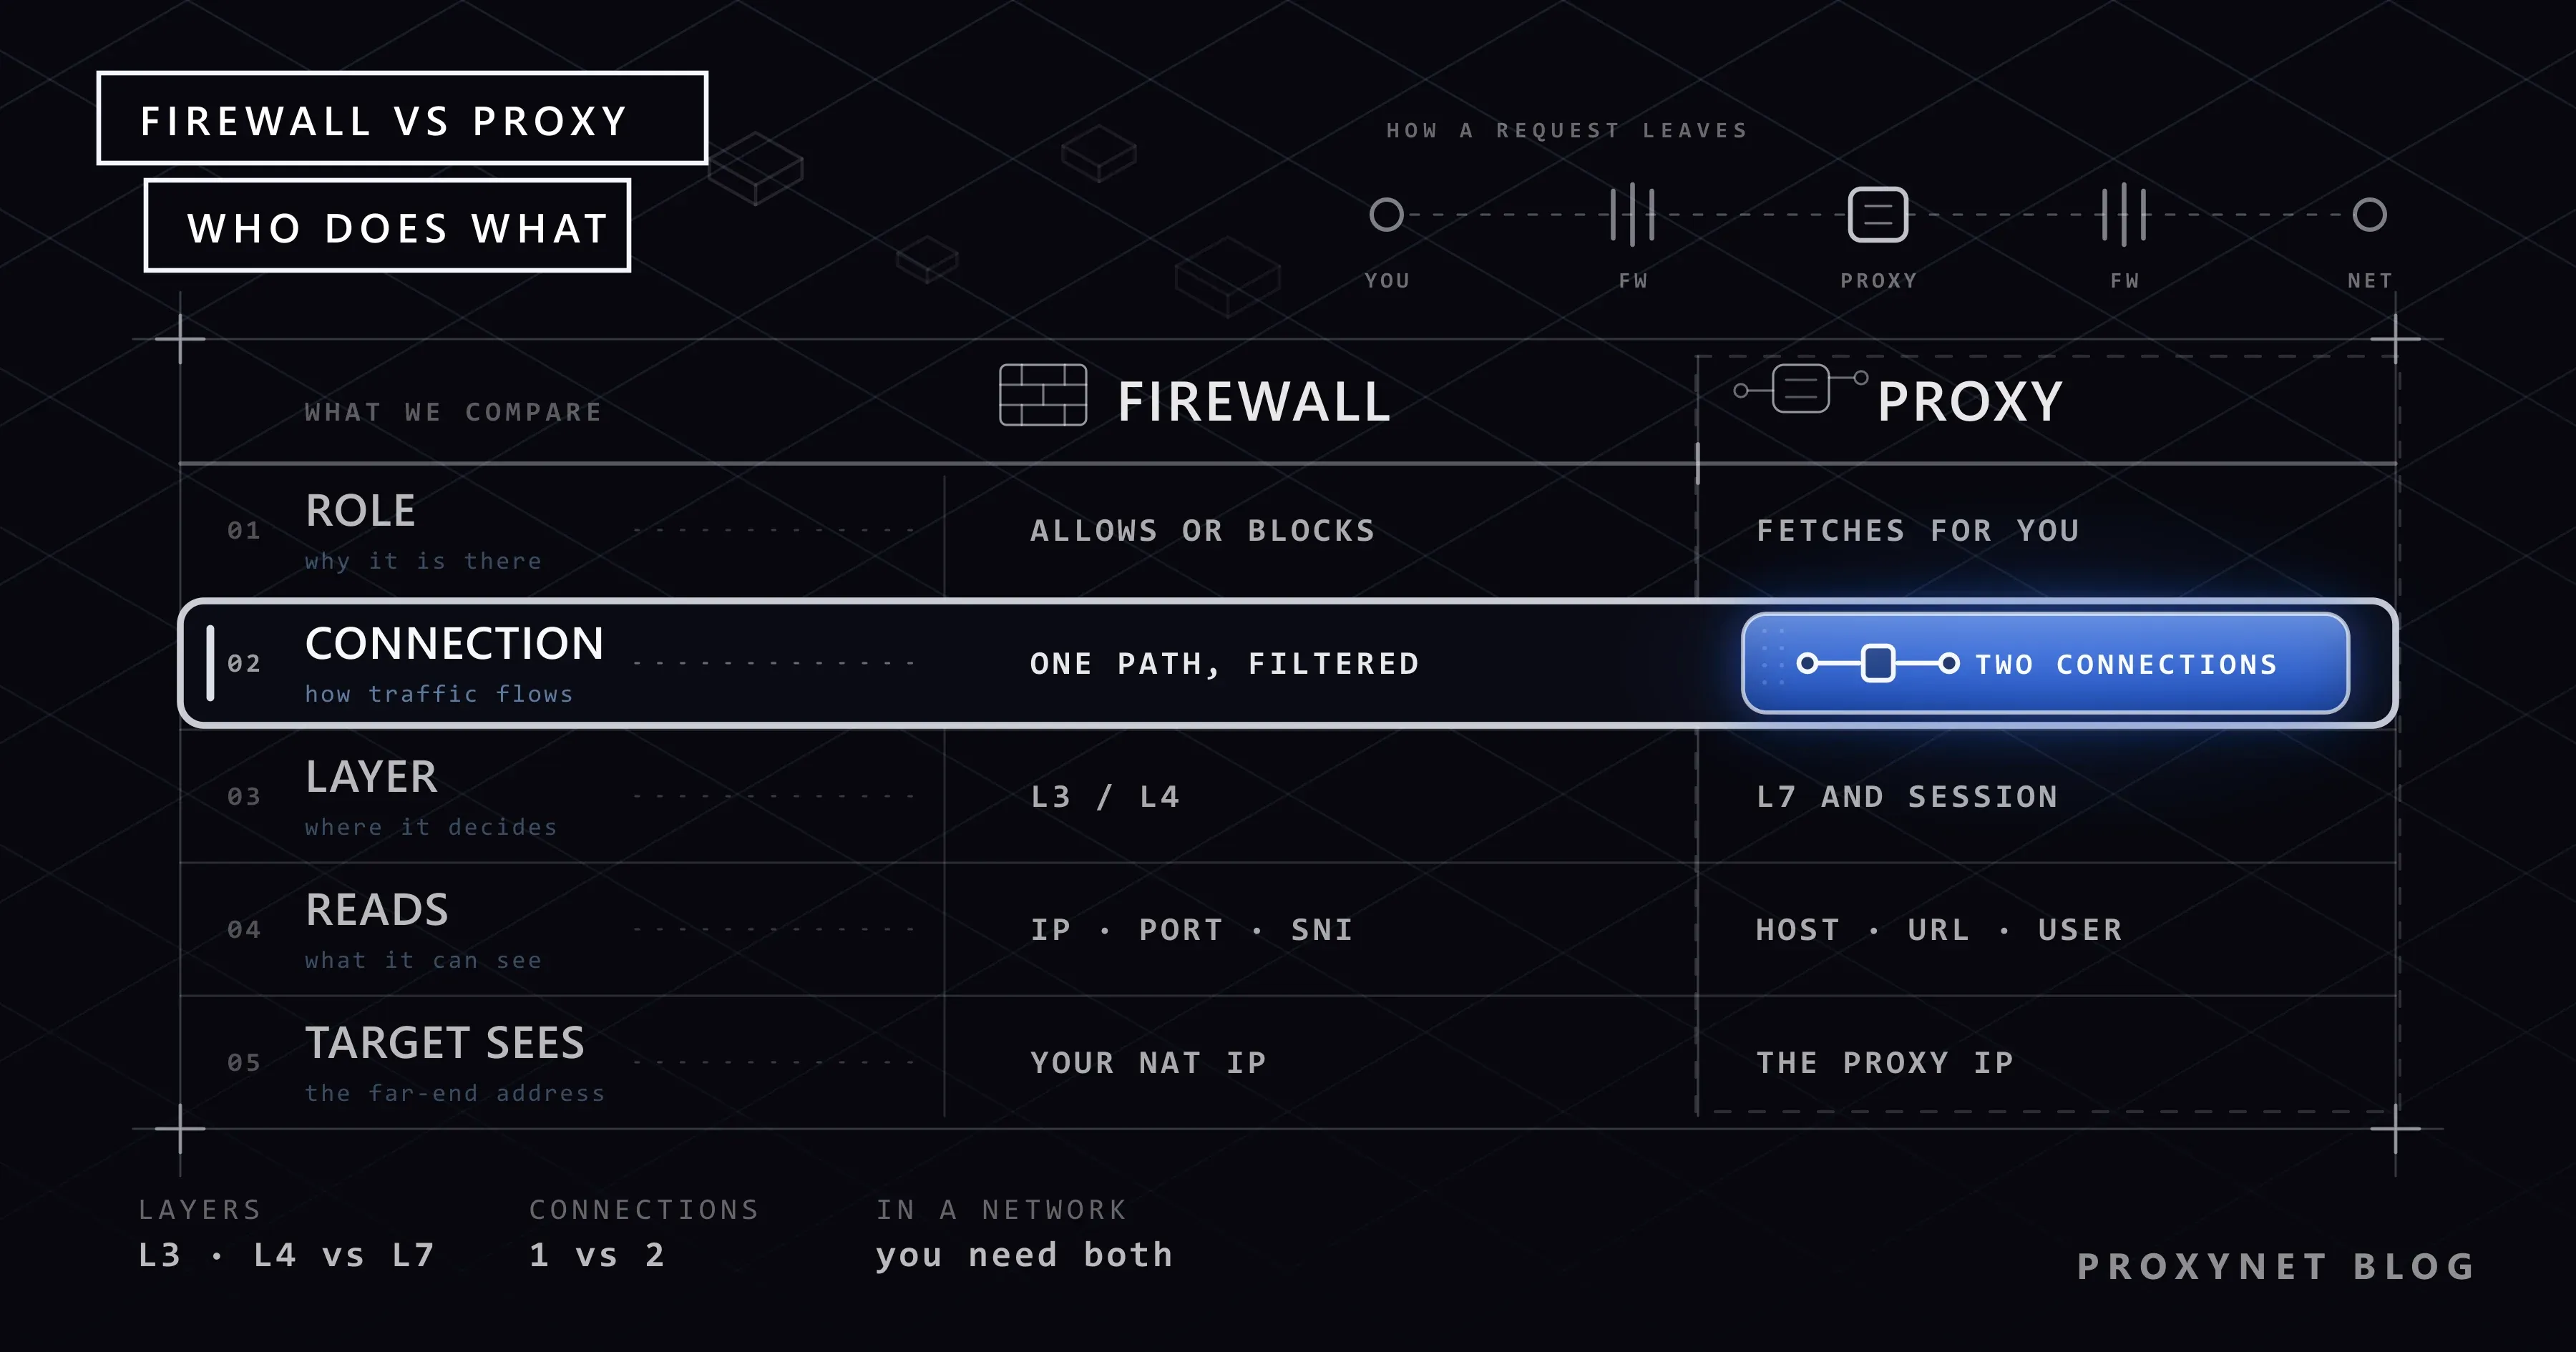
Publicado
Proxy o firewall: ¿en qué se diferencian?
Un firewall decide si el tráfico puede pasar; un proxy lo reenvía en su propio nombre. Explicamos el papel de cada capa y cómo trabajan juntas.
Autor:Acar Diveroli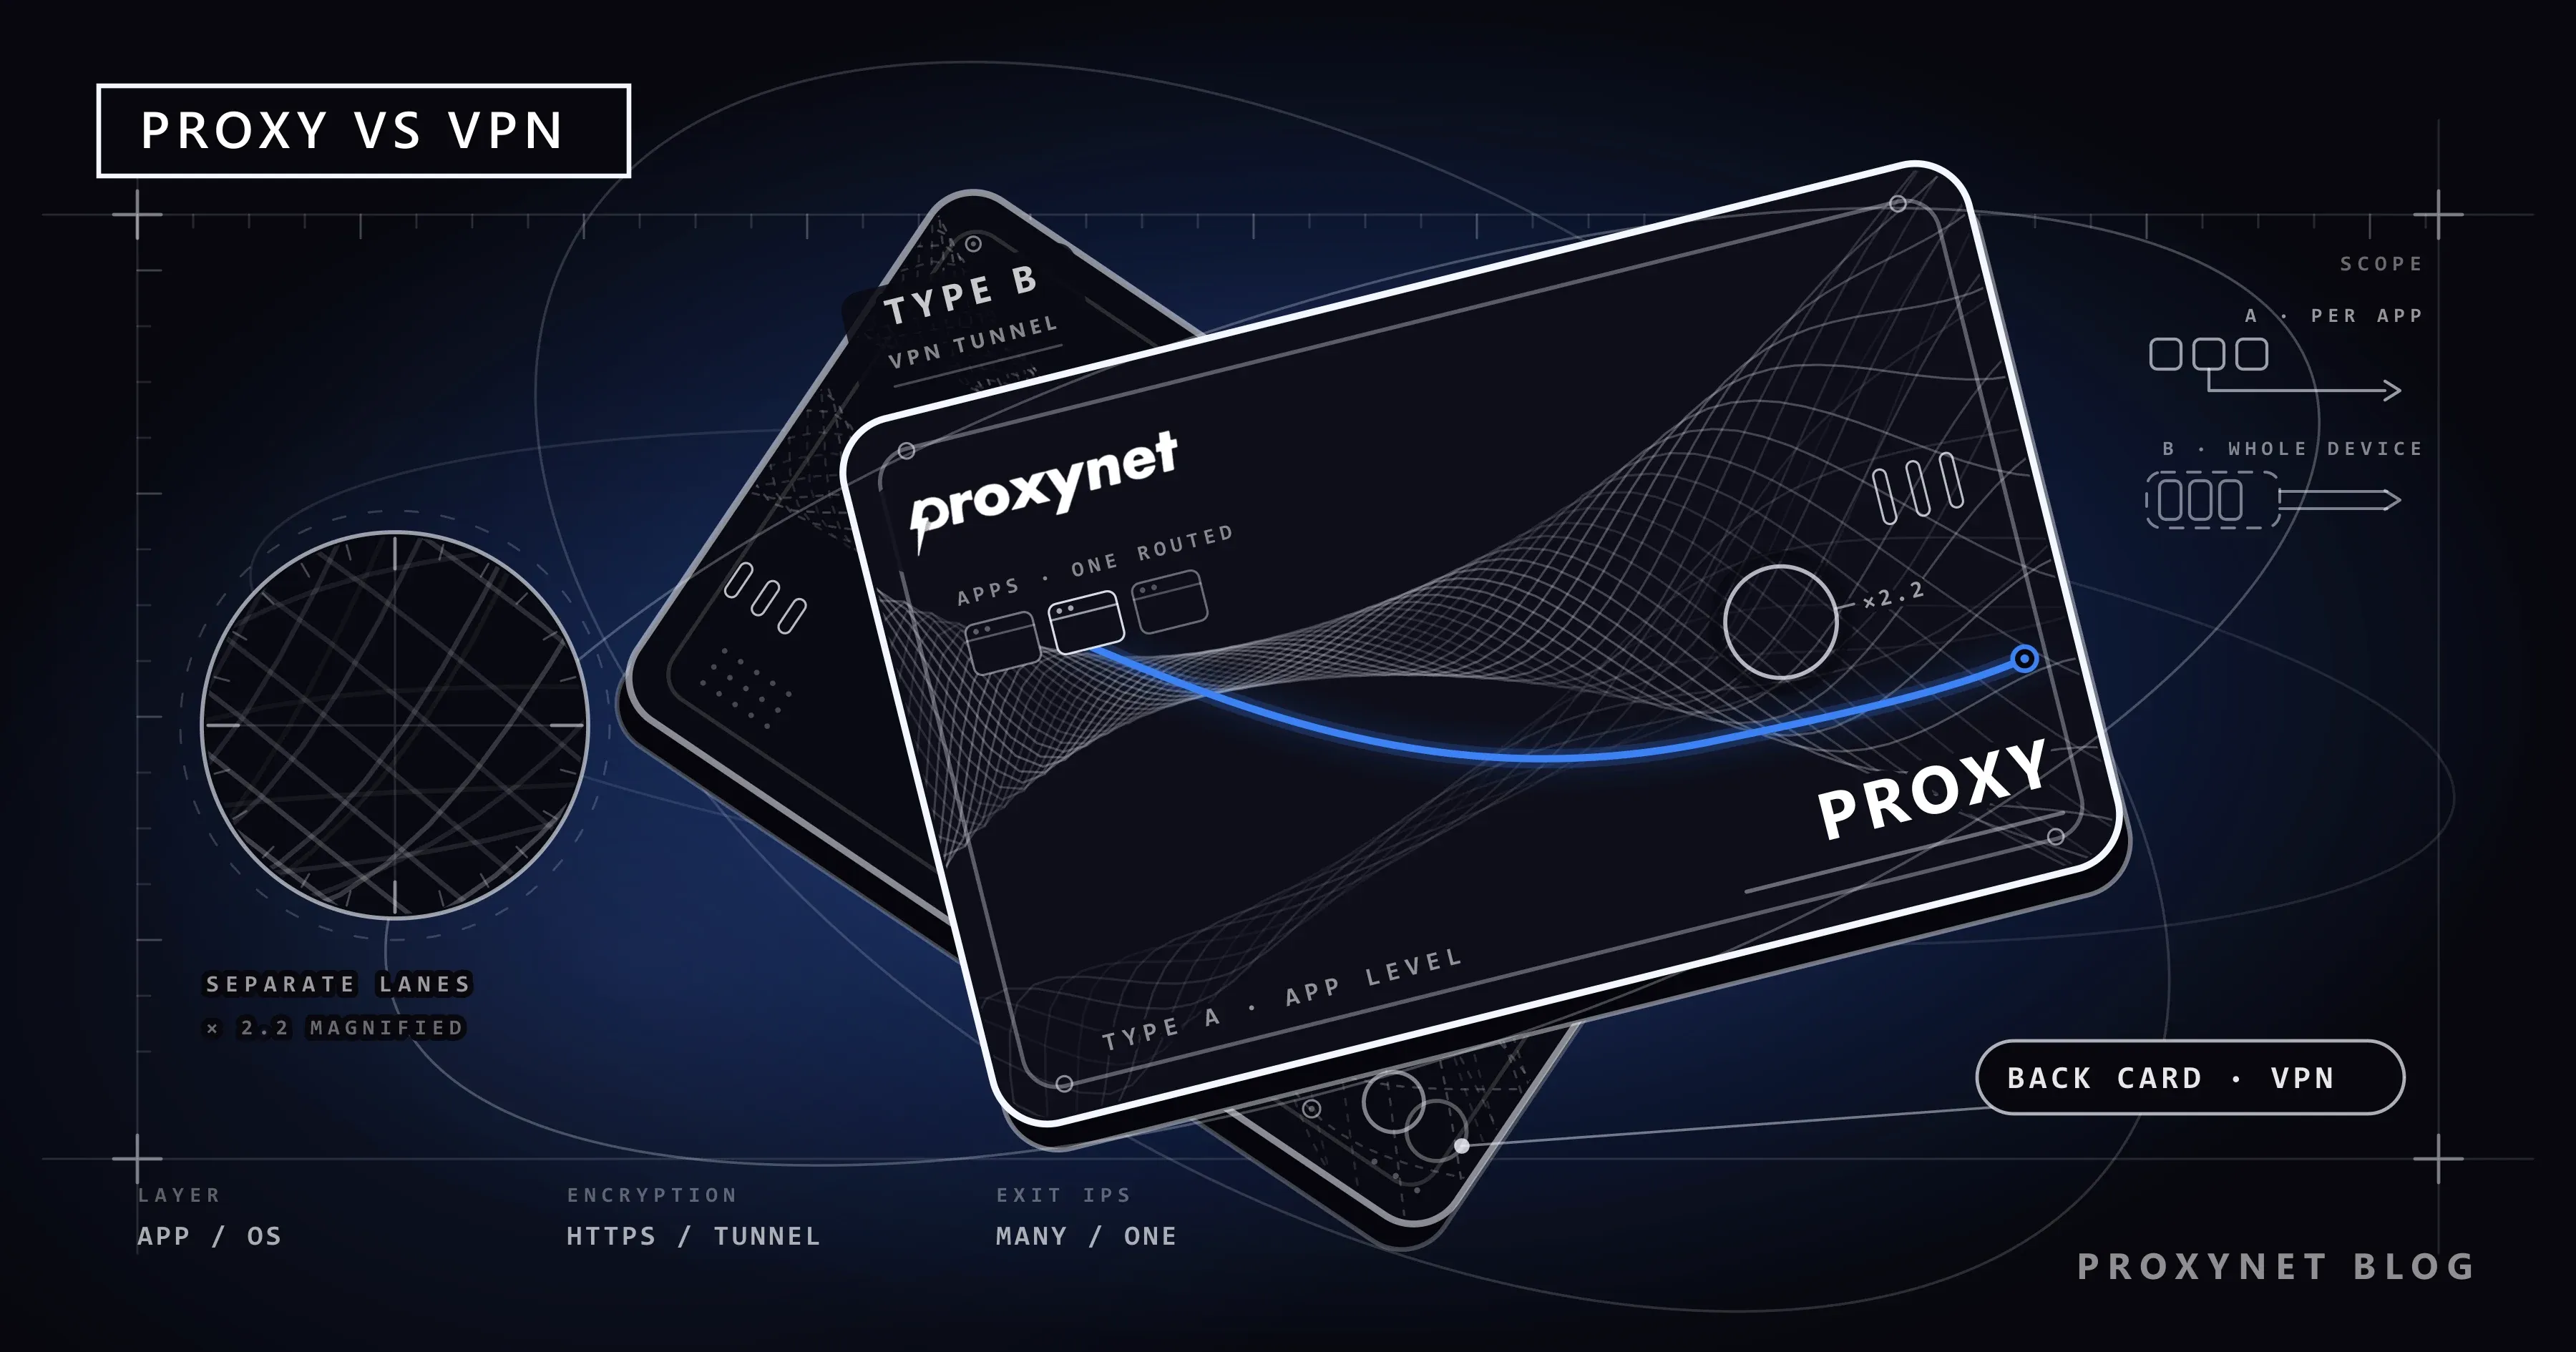
Publicado
Proxy o VPN: diferencias y cuándo usar cada uno
Un proxy envía por otra IP el tráfico de la aplicación que elijas; una VPN cifra todo el tráfico del dispositivo. Te explicamos cuál conviene en cada caso.
Autor:Acar Diveroli
Publicado
Puppeteer y CAPTCHA: por qué aparece y cómo reducirlo
En Puppeteer el CAPTCHA suele activarse por la reputación de la IP, la velocidad y las huellas del modo headless. Causas y soluciones legítimas.
Autor:Acar Diveroli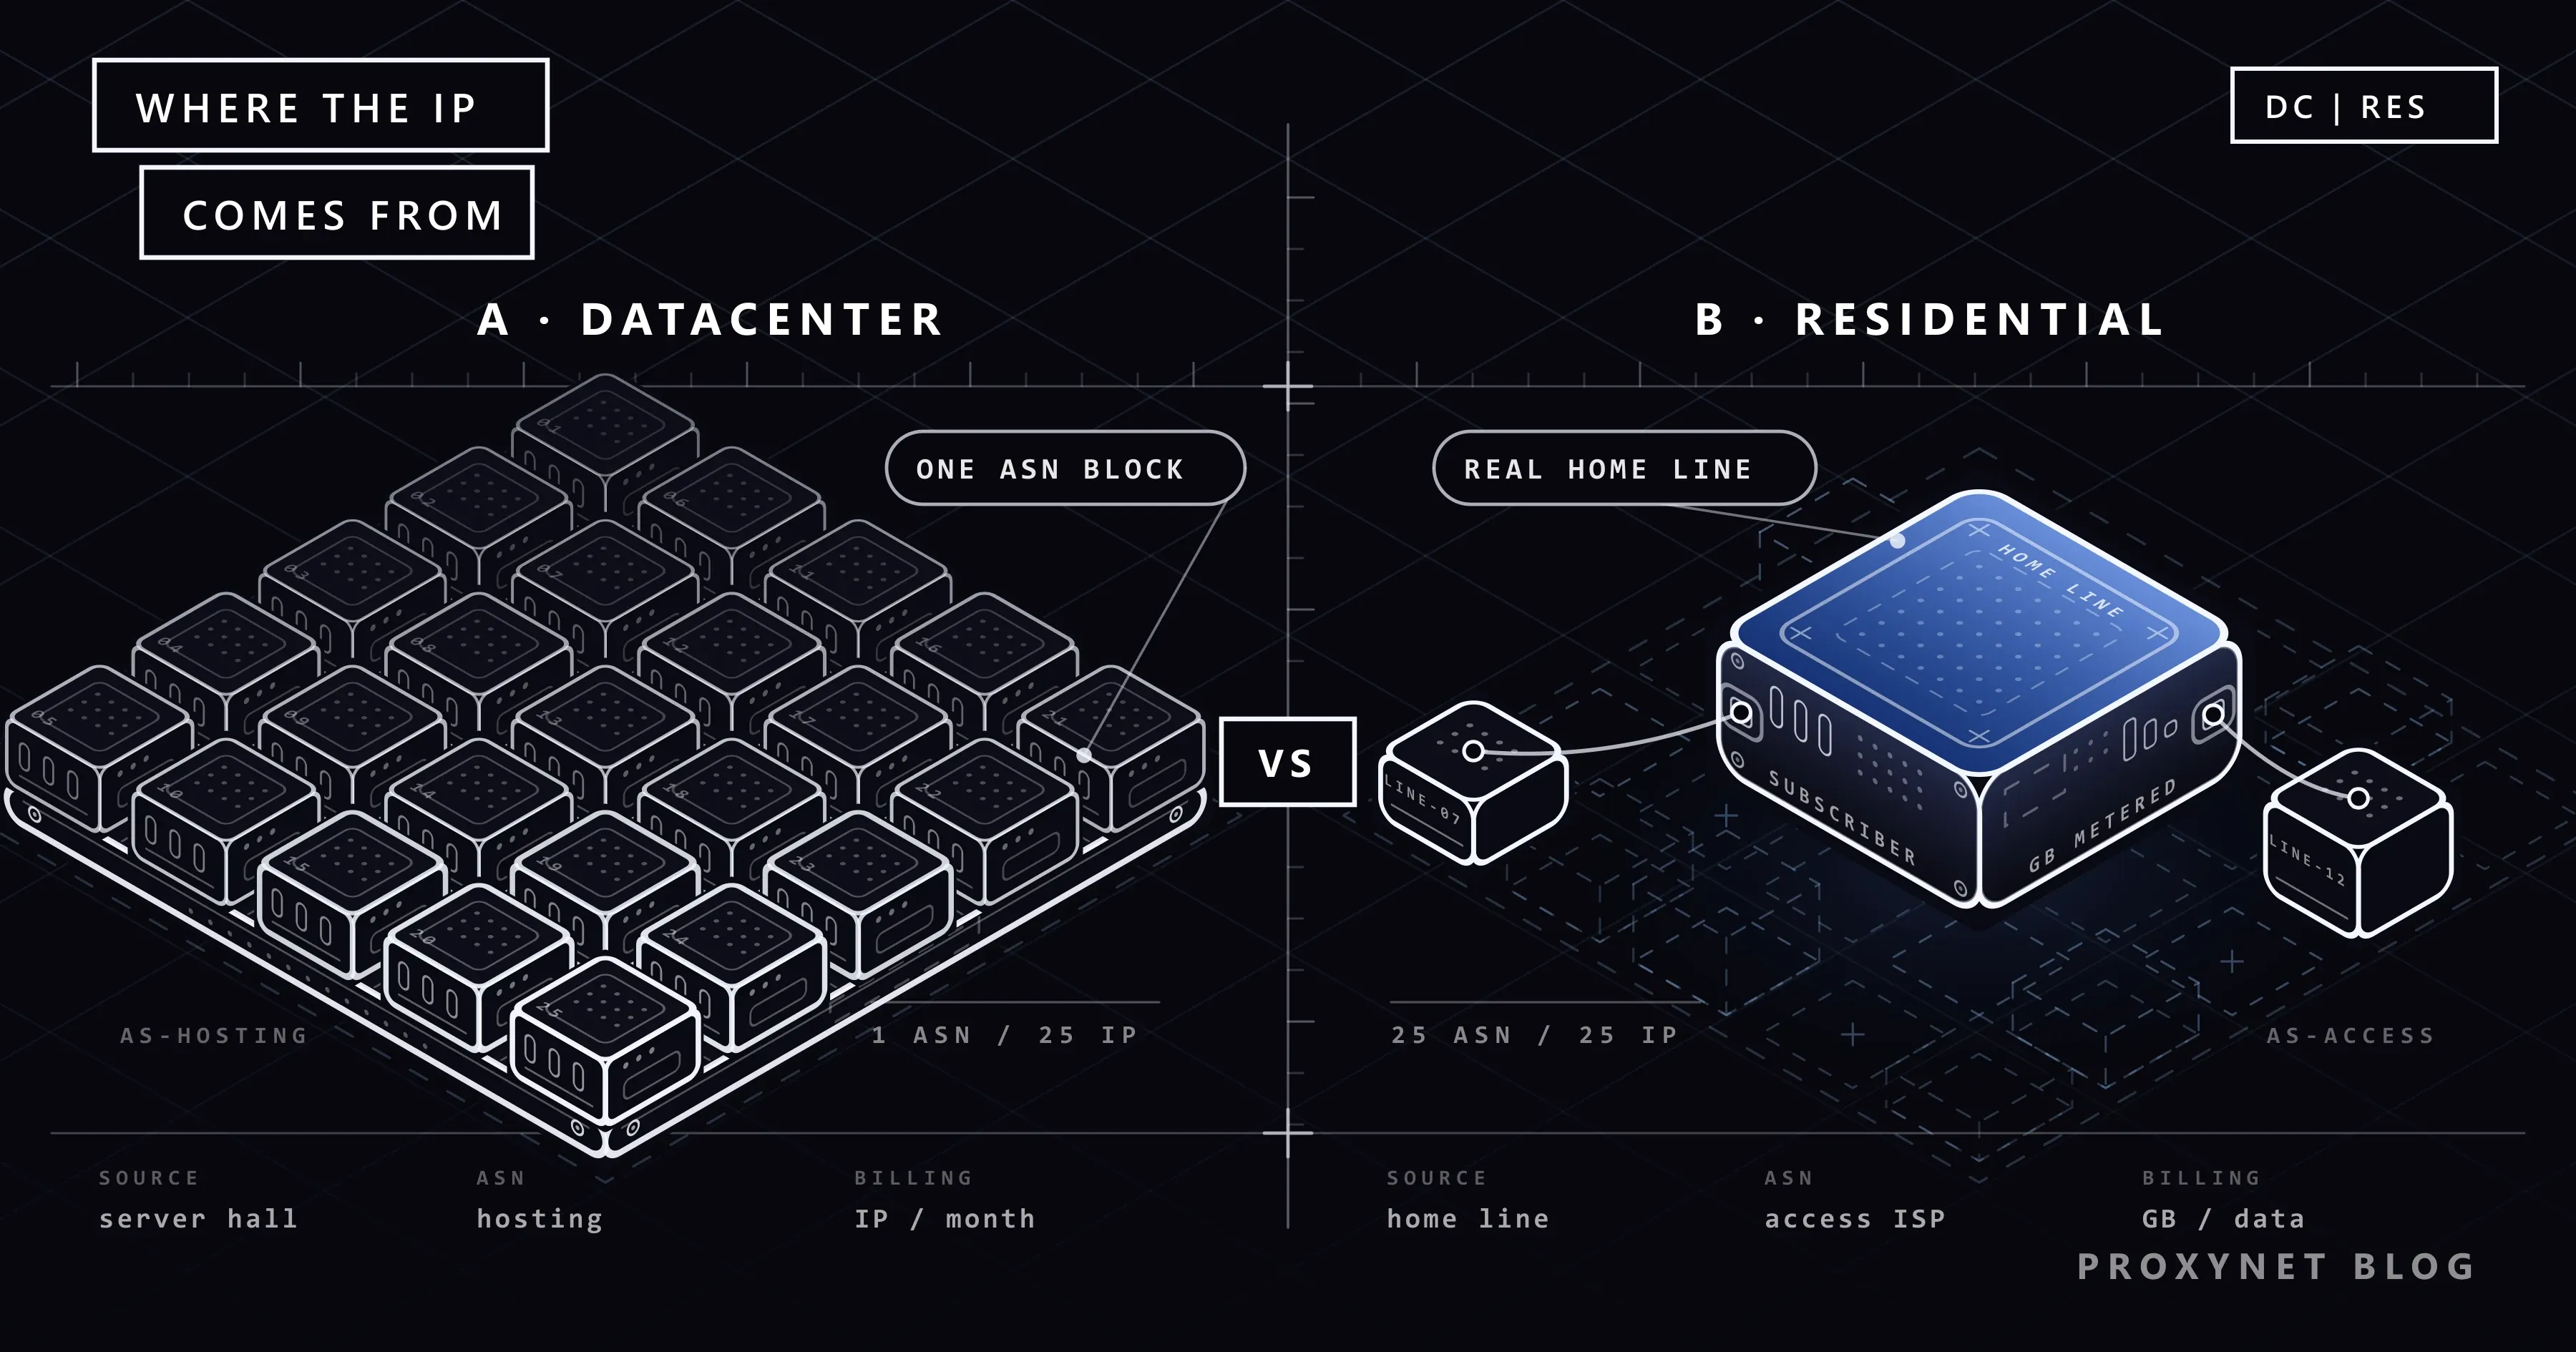
Publicado
Proxies residenciales y de centro de datos: diferencias
Un proxy residencial da IP de conexiones domésticas; uno de centro de datos, de servidores. Velocidad, riesgo de detección, costo y cuál elegir en cada caso.
Autor:Acar Diveroli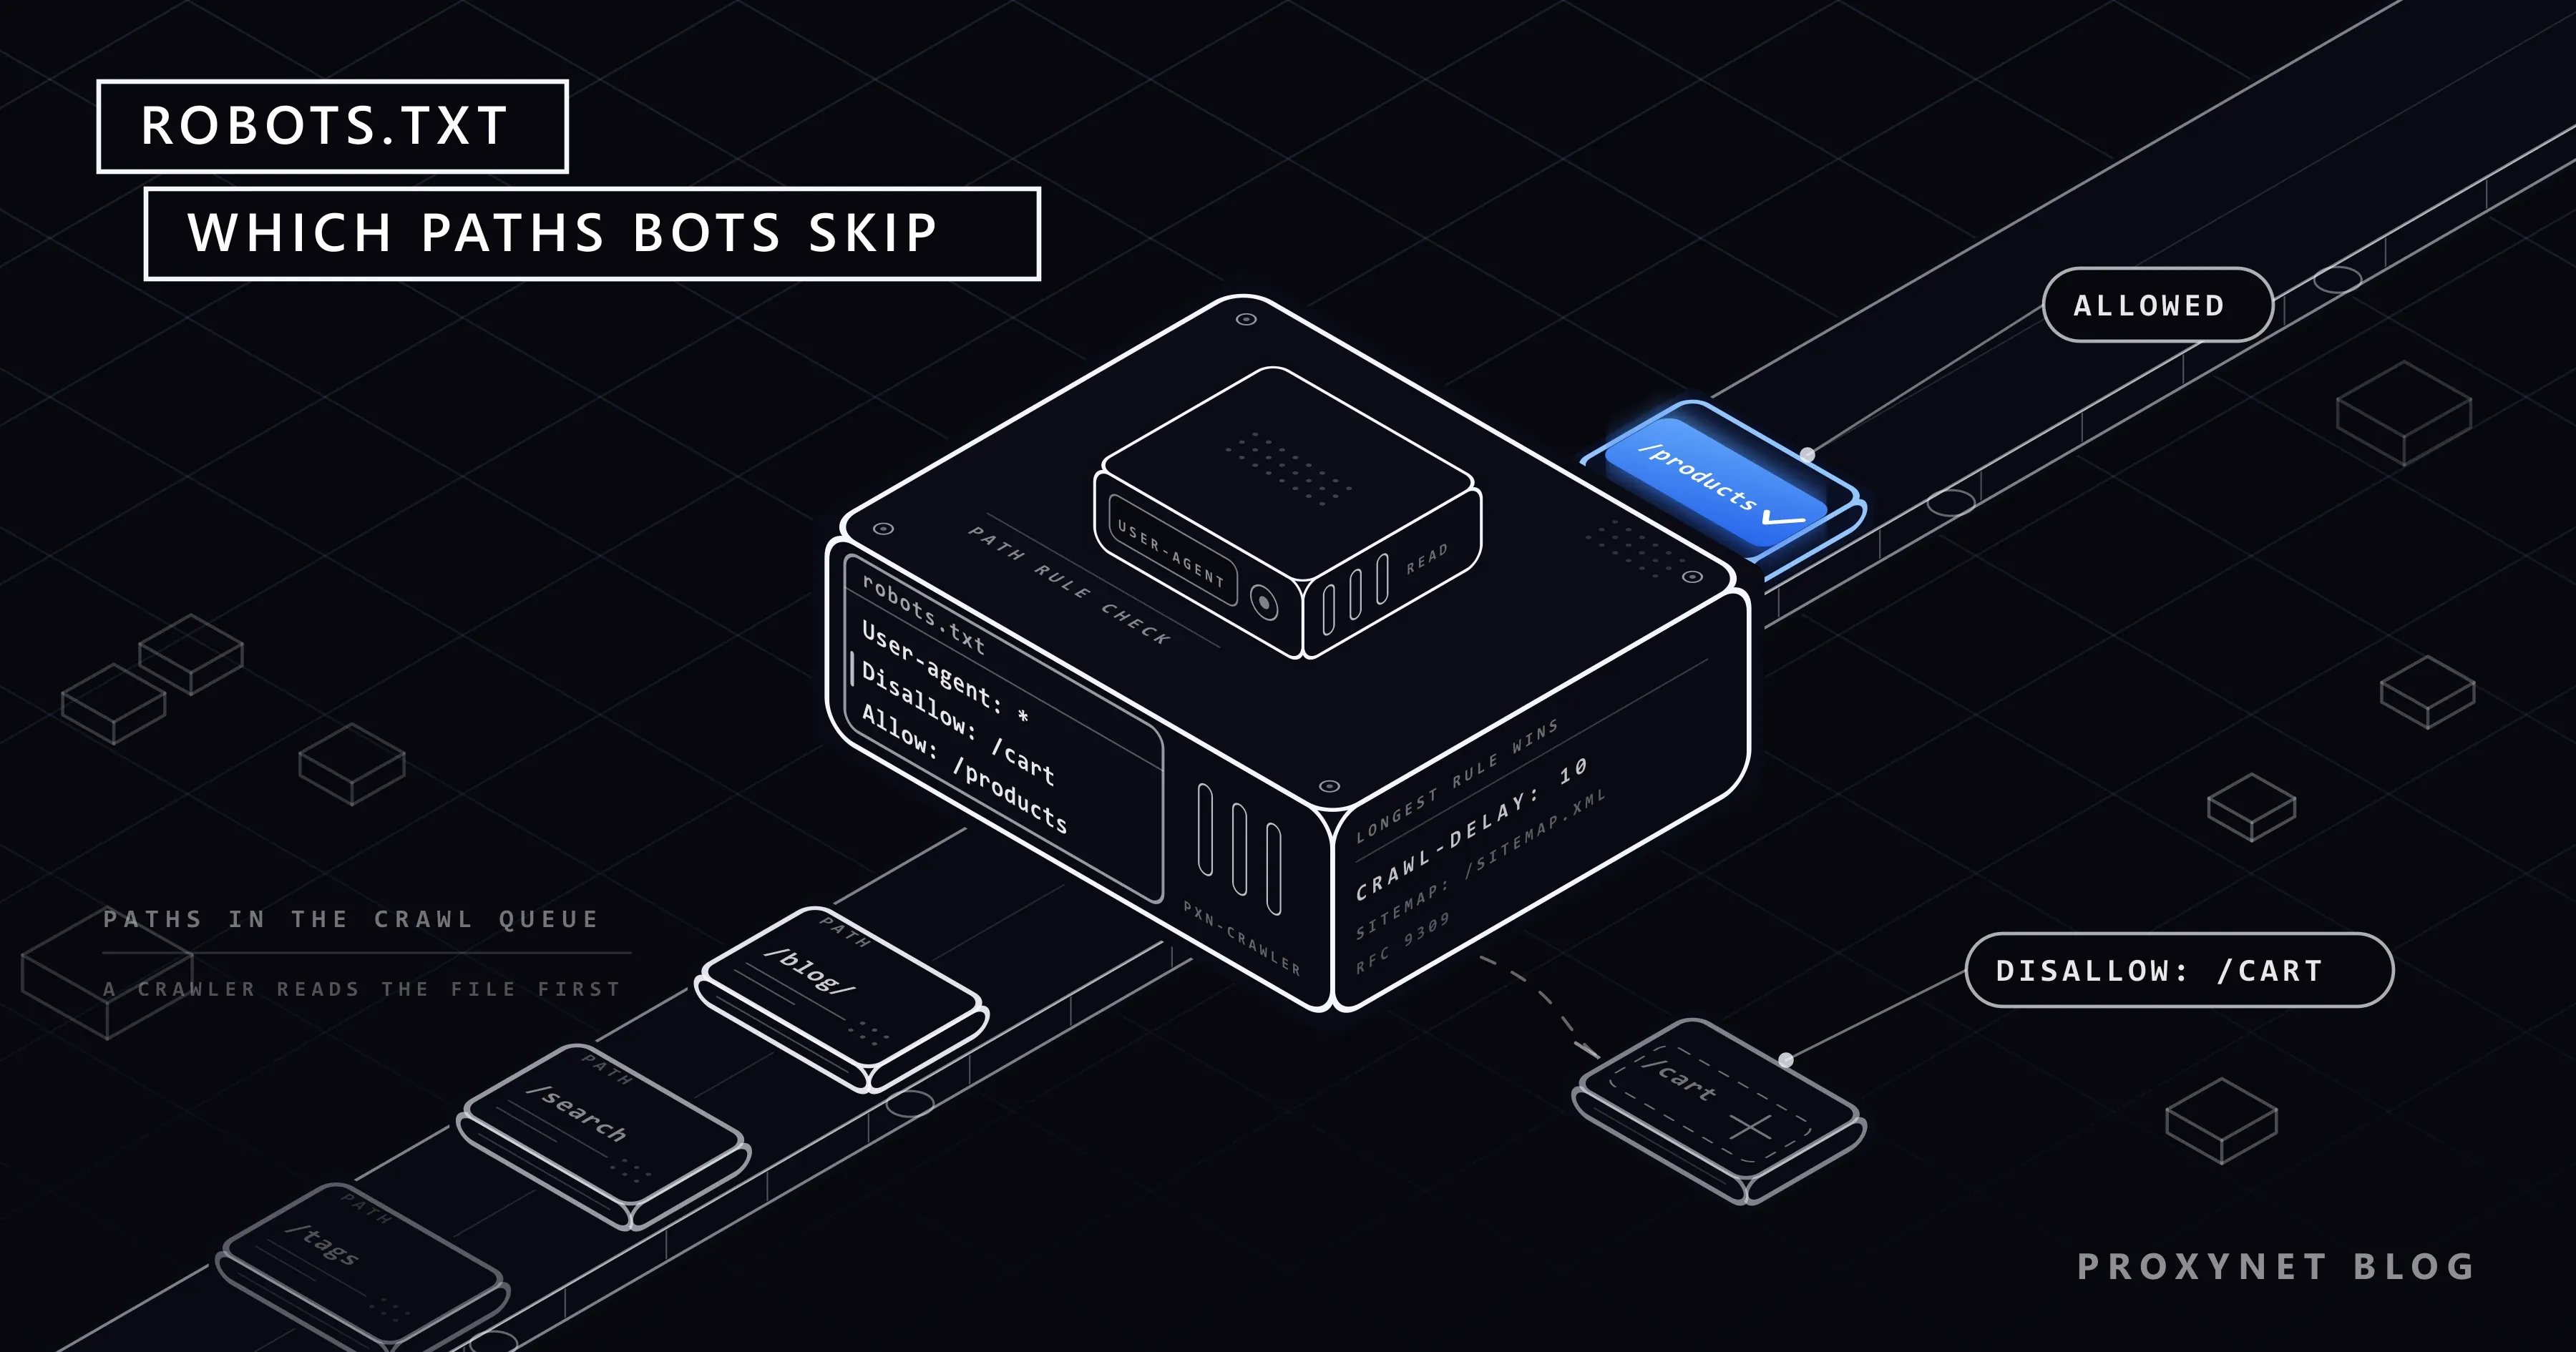
Publicado
Qué es robots.txt y cómo leerlo
robots.txt es el archivo donde un sitio indica a los bots qué rutas no rastrear. Explicamos Disallow, Allow, Crawl-delay y cómo leerlo con Python.
Autor:Acar Diveroli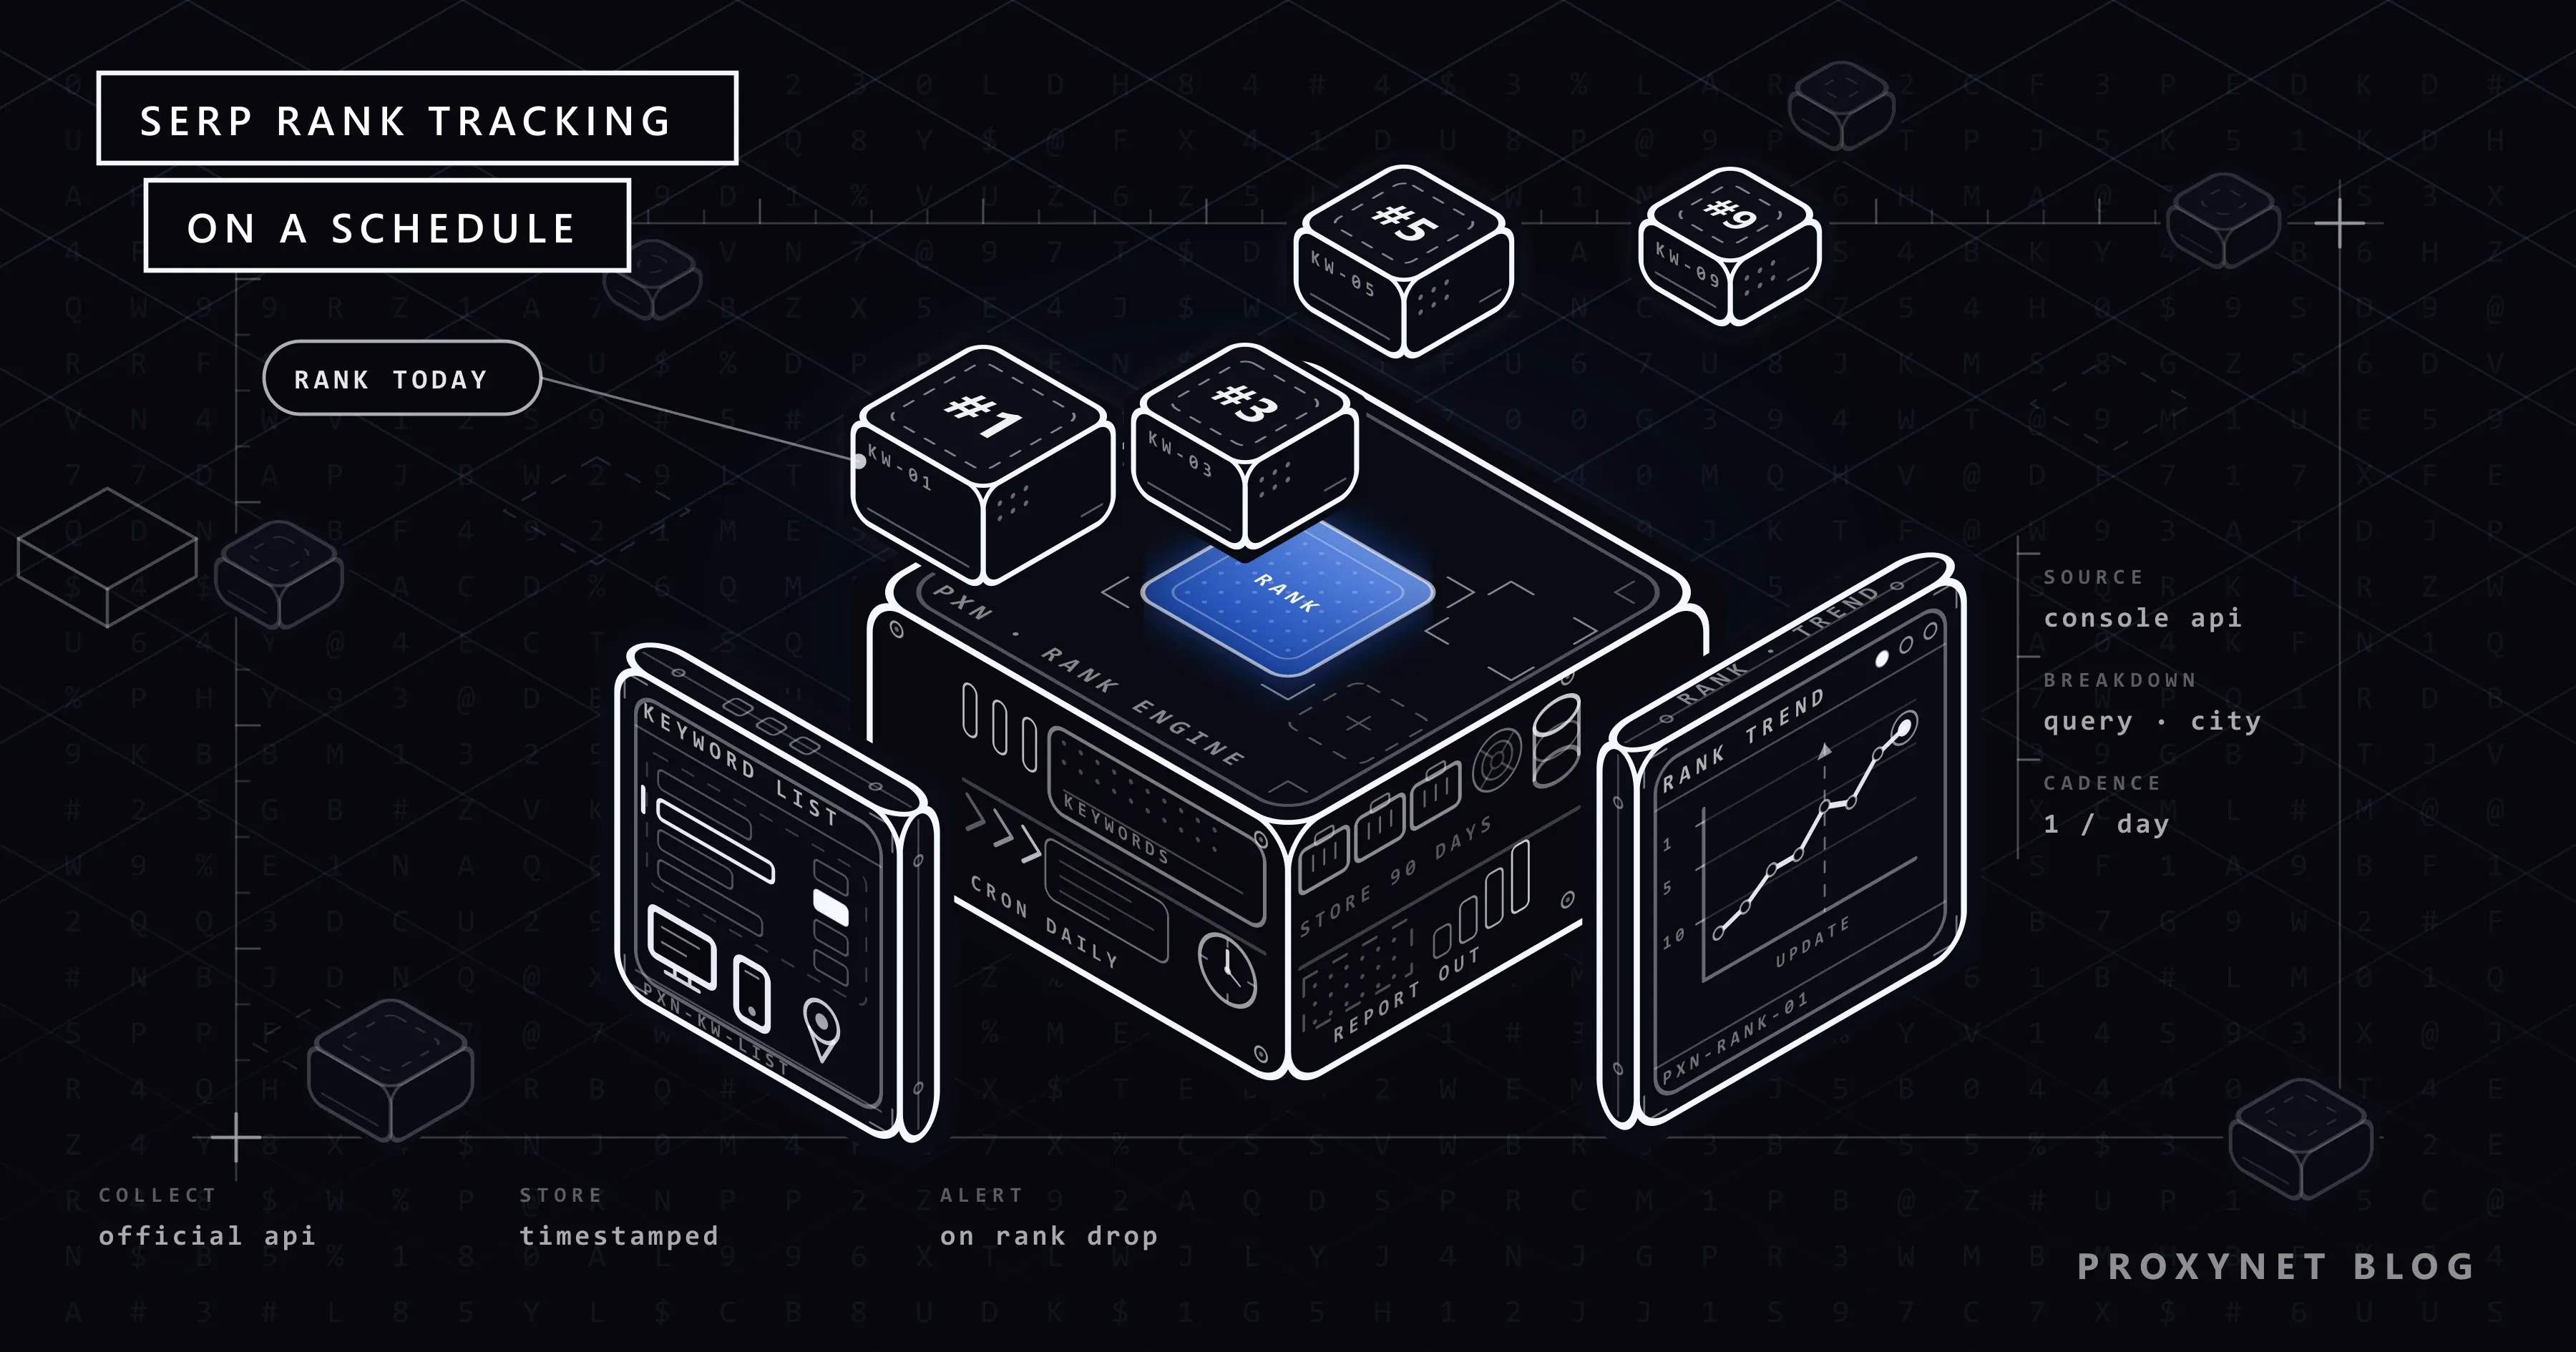
Publicado
Cómo automatizar el seguimiento de posiciones SEO
Revisar posiciones a mano no escala. Explicamos el seguimiento automático de rankings con la API de Search Console, datos SERP y consultas por ubicación.
Autor:Acar Diveroli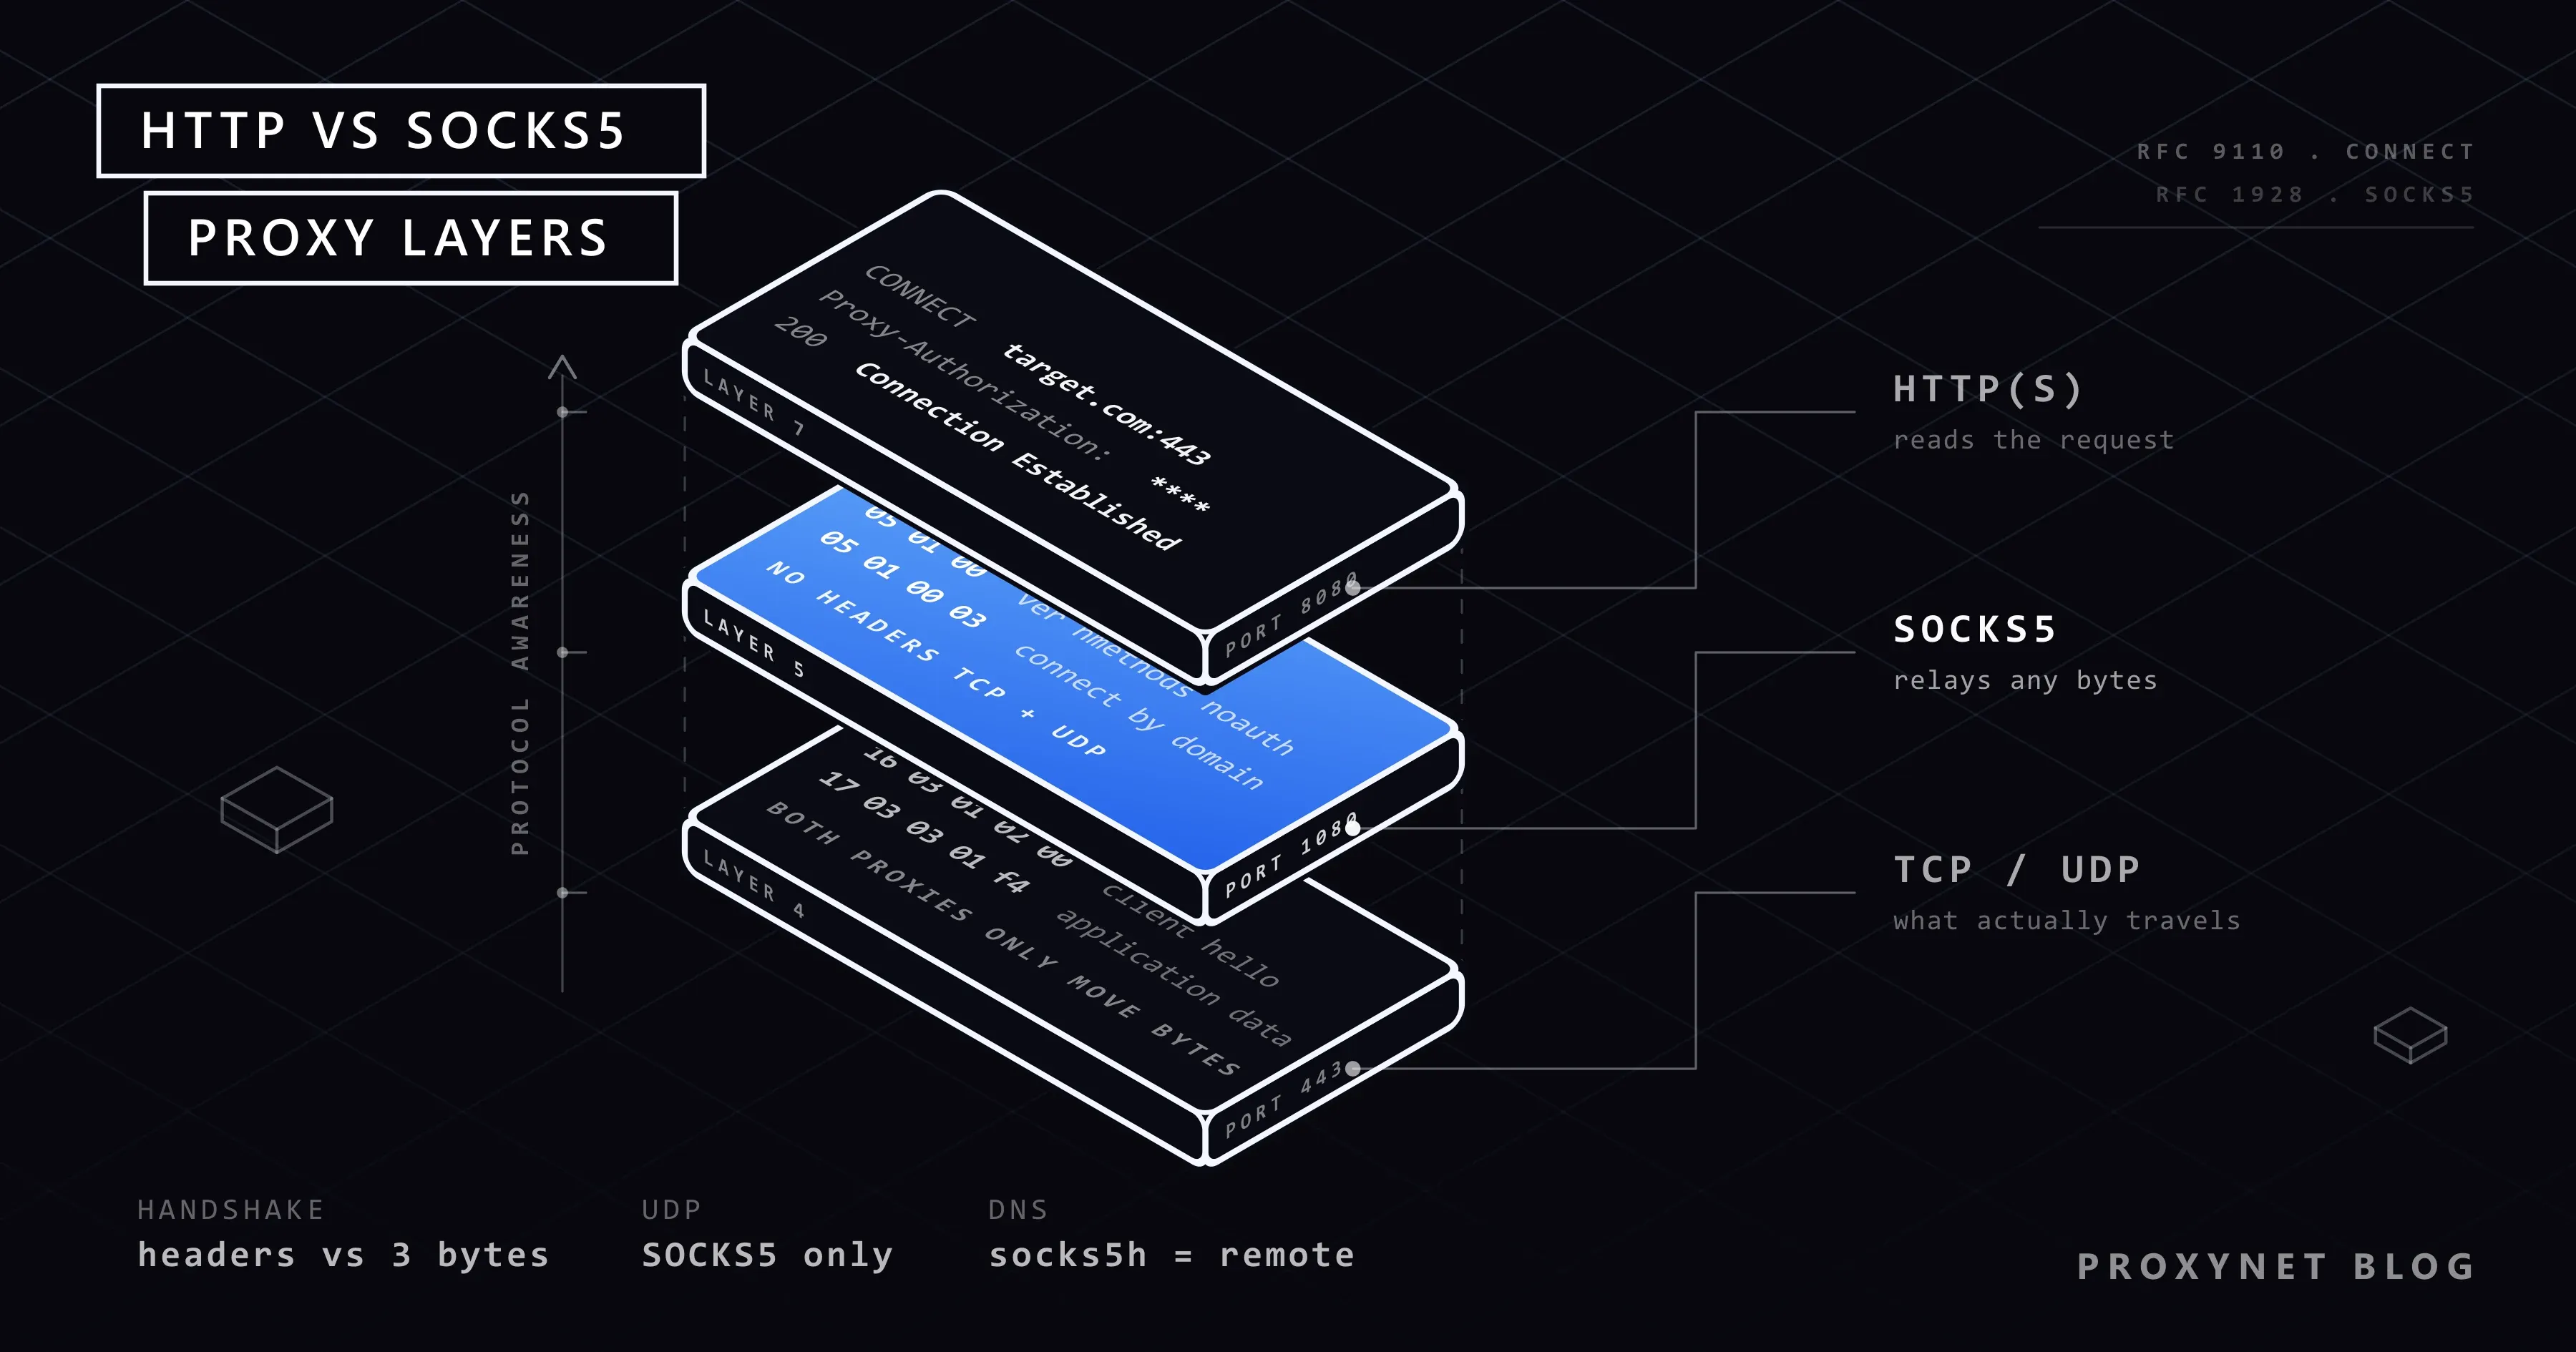
Publicado
Diferencia entre SOCKS y HTTP: ¿cuál elegir?
El proxy HTTP entiende las peticiones web; SOCKS5 mueve todo el tráfico TCP y UDP sin mirar el contenido. Según velocidad, compatibilidad y uso, ¿cuál conviene?
Autor:Acar Diveroli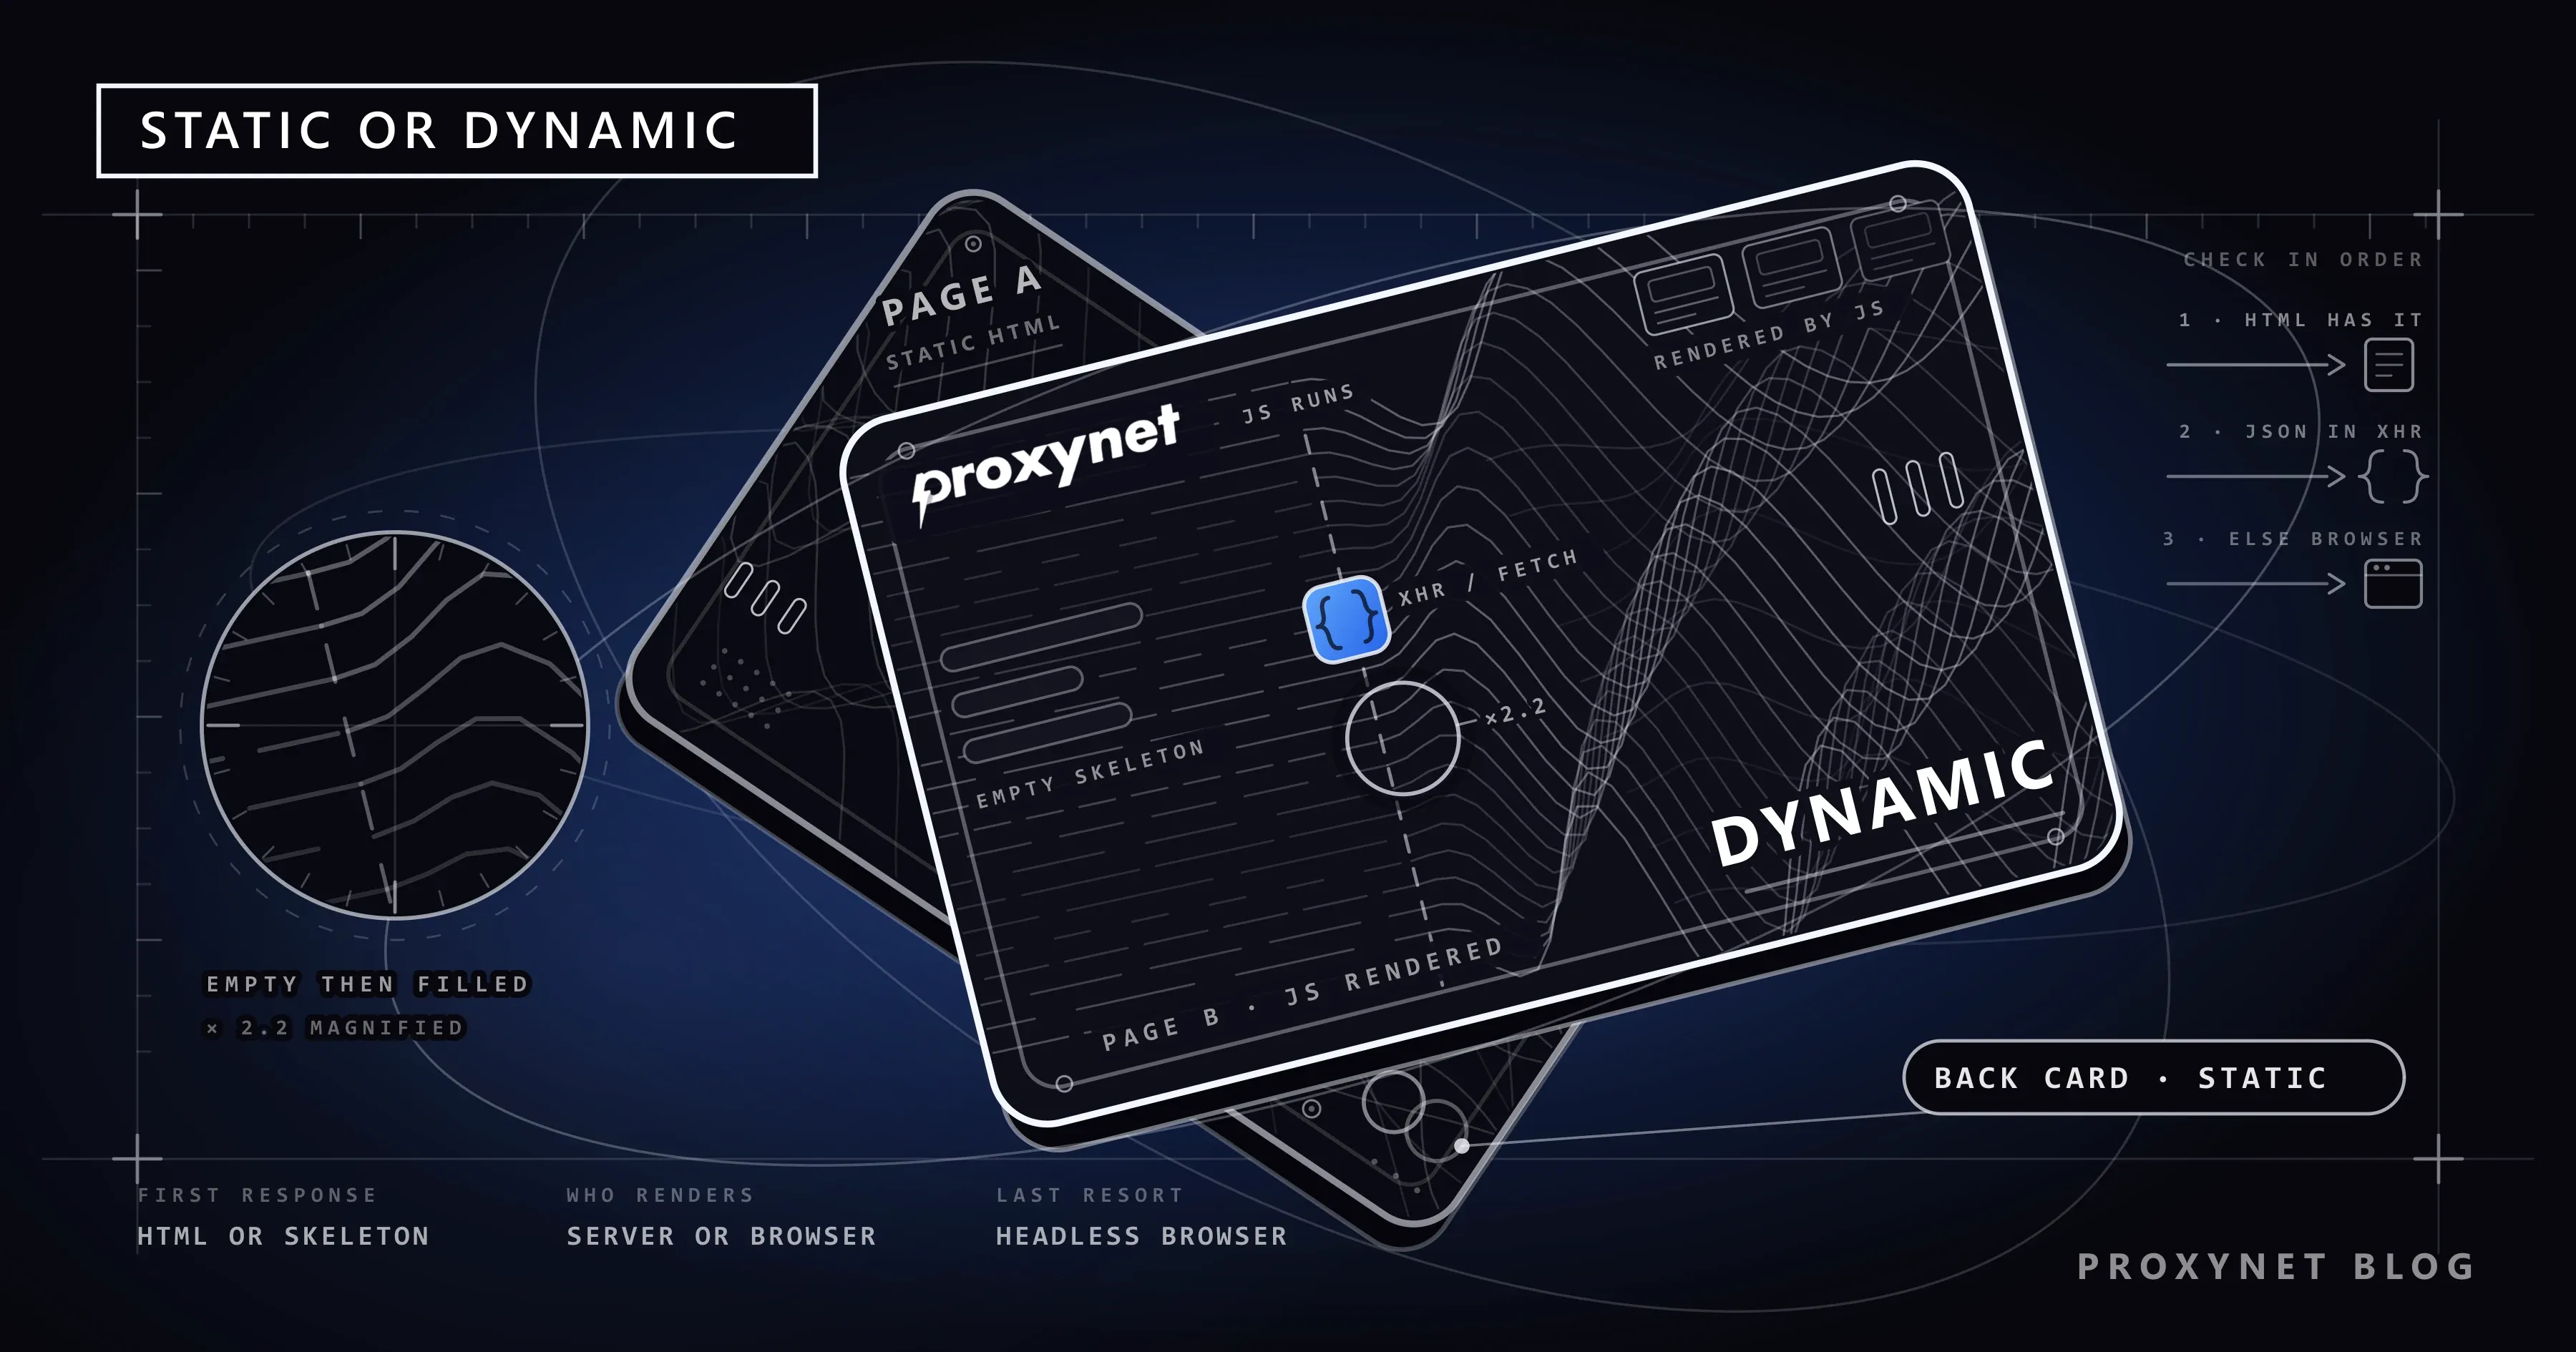
Publicado
Páginas estáticas y dinámicas en web scraping
Las páginas dinámicas cargan el contenido con JavaScript, así que una petición simple vuelve vacía. Explicamos cuándo hace falta un navegador headless.
Autor:Acar Diveroli
Acceso web seguro para LLM: límites y permisos
Autor: Acar DiveroliIAPublicado
Cómo usar un proxy en Node.js: Axios y node-fetch
Autor: Acar DiveroliTutorialesPublicado
Configuración de proxy en Postman paso a paso
Autor: Acar DiveroliIntegraciónPublicado
Autenticación de proxy: user:pass o lista blanca de IP
Autor: Acar DiveroliProxy 101Publicado
Proxy o firewall: ¿en qué se diferencian?
Autor: Acar DiveroliComparativasPublicado
Proxy o VPN: diferencias y cuándo usar cada uno
Autor: Acar DiveroliComparativasPublicado
Puppeteer y CAPTCHA: por qué aparece y cómo reducirlo
Autor: Acar DiveroliTutorialesPublicado
Proxies residenciales y de centro de datos: diferencias
Autor: Acar DiveroliComparativasPublicado
Qué es robots.txt y cómo leerlo
Autor: Acar DiveroliWeb scrapingPublicado
Cómo automatizar el seguimiento de posiciones SEO
Autor: Acar DiveroliCasos de usoPublicado
Diferencia entre SOCKS y HTTP: ¿cuál elegir?
Autor: Acar DiveroliComparativasPublicado
Páginas estáticas y dinámicas en web scraping
Autor: Acar DiveroliComparativasPublicado
Ningún artículo coincide
Publicado
Publicado