Tu registro de accesos muestra 40.000 peticiones de ayer que dicen todas ExampleBot/1.0 (+https://bot.example/about). Algunas llegan desde los rangos que publica el operador del bot, muchas desde un rango compartido de un proveedor de nube y unas pocas desde conexiones domésticas. ¿Cuáles son del crawler auténtico y cuáles de alguien que toma prestado su nombre? La línea User-Agent no puede decírtelo: cualquier cliente puede escribirla.
Web Bot Auth es la respuesta que el IETF, el organismo detrás de muchos protocolos de internet, está estandarizando ahora: el bot firma cada petición con una clave privada y tu sitio comprueba la firma con una clave pública que publica el operador. Este artículo explica qué es y en qué punto está el estándar, por qué los controles antiguos se quedan cortos, cómo es una petición firmada, quién lo admite, qué significa para los dueños de sitios y para quienes crean bots, y qué no demuestra una firma.
¿Qué es Web Bot Auth?
Web Bot Auth es un protocolo en el que un cliente automatizado firma sus peticiones HTTP para que el sitio que las recibe pueda verificar qué operador las envió. Se apoya en HTTP Message Signatures, un estándar del IETF publicado como RFC 9421 en febrero de 2024 que define cómo firmar partes seleccionadas de un mensaje HTTP. Web Bot Auth añade las reglas propias de los bots: qué partes hay que firmar, un valor fijo de tag, una cabecera que apunta a las claves del operador y un formato para publicarlas.
El nombre corresponde también a un grupo de trabajo del IETF, webbotauth. Su mandato (charter) abarca crawlers de buscadores, archivadores web, comprobadores de enlaces, crawlers de entrenamiento de IA y agentes de IA que actúan en nombre de un usuario, en sitios pensados sobre todo para personas; la autenticación de API entre servicios y el inicio de sesión de personas quedan fuera.
A 19 de noviembre de 2026, el único documento adoptado por el grupo es el Internet-Draft HTTP Message Signatures for automated traffic (draft-ietf-webbotauth-httpsig-protocol-01, 29 de octubre de 2026), escrito por autores de Cloudflare y Google y orientado al Standards Track, la vía hacia un estándar oficial. Sustituye a dos borradores anteriores, uno sobre la arquitectura y otro sobre el directorio de claves. Un Internet-Draft es un trabajo en curso, así que los nombres de campos y las reglas aún pueden cambiar.
¿Por qué no bastan el User-Agent y las listas de IP?
La cabecera User-Agent y las listas de IP permitidas identifican a un bot por datos que otros clientes pueden copiar o compartir, así que ninguna de las dos demuestra quién envió una petición. El User-Agent es una línea de texto que escribe el propio cliente; explicamos cómo se construye en ¿Qué es el User-Agent? Cómo verlo y cambiarlo. Un crawler bien educado pone ahí su nombre y una URL informativa, pero nada impide que otro cliente escriba exactamente la misma línea.
En nuestra máquina de pruebas levantamos un pequeño servidor en 127.0.0.1 que devuelve las cabeceras recibidas y le enviamos curl -A "ExampleBot/1.0 (+https://example.com/bot)". El servidor recibió esa cadena exacta como User-Agent, sin nada en la petición que la vinculara con example.com.
Las listas de IP son más sólidas, pero fallan en tres casos habituales. Los bots que corren en infraestructura de nube compartida salen desde direcciones que también usan otros clientes. Los agentes de IA que actúan por un usuario pueden ejecutarse en el navegador de esa persona, así que salen desde una conexión doméstica o de oficina. Y los operadores cambian sus rangos, de modo que la lista del mes pasado puede estar mal hoy.
La comprobación clásica para los grandes crawlers es el DNS inverso confirmado en sentido directo: el sitio busca el nombre de host asociado a la IP, comprueba que pertenece al dominio del operador y luego resuelve ese nombre para confirmar que devuelve la misma IP. Funciona con operadores que tienen su propio espacio de direcciones, pero no con un agente en una dirección de nube compartida ni en el portátil de un usuario.
¿Cómo funciona Web Bot Auth?
Web Bot Auth combina un paso de firma en el lado del bot con un paso de consulta y verificación en el lado del sitio:
- El operador crea un par de claves. La clave privada se queda con el bot. Ed25519, un algoritmo de firma moderno con claves cortas, es el que aparece en los ejemplos del borrador y el que acepta Cloudflare.
- El operador publica la clave pública. Va en un directorio de claves, un JSON Web Key Set (JWKS) servido por HTTPS; el borrador define además una ruta conocida para alojarlo,
/.well-known/http-message-signatures-directory. - El bot firma cada petición. Incluye como mínimo el host (
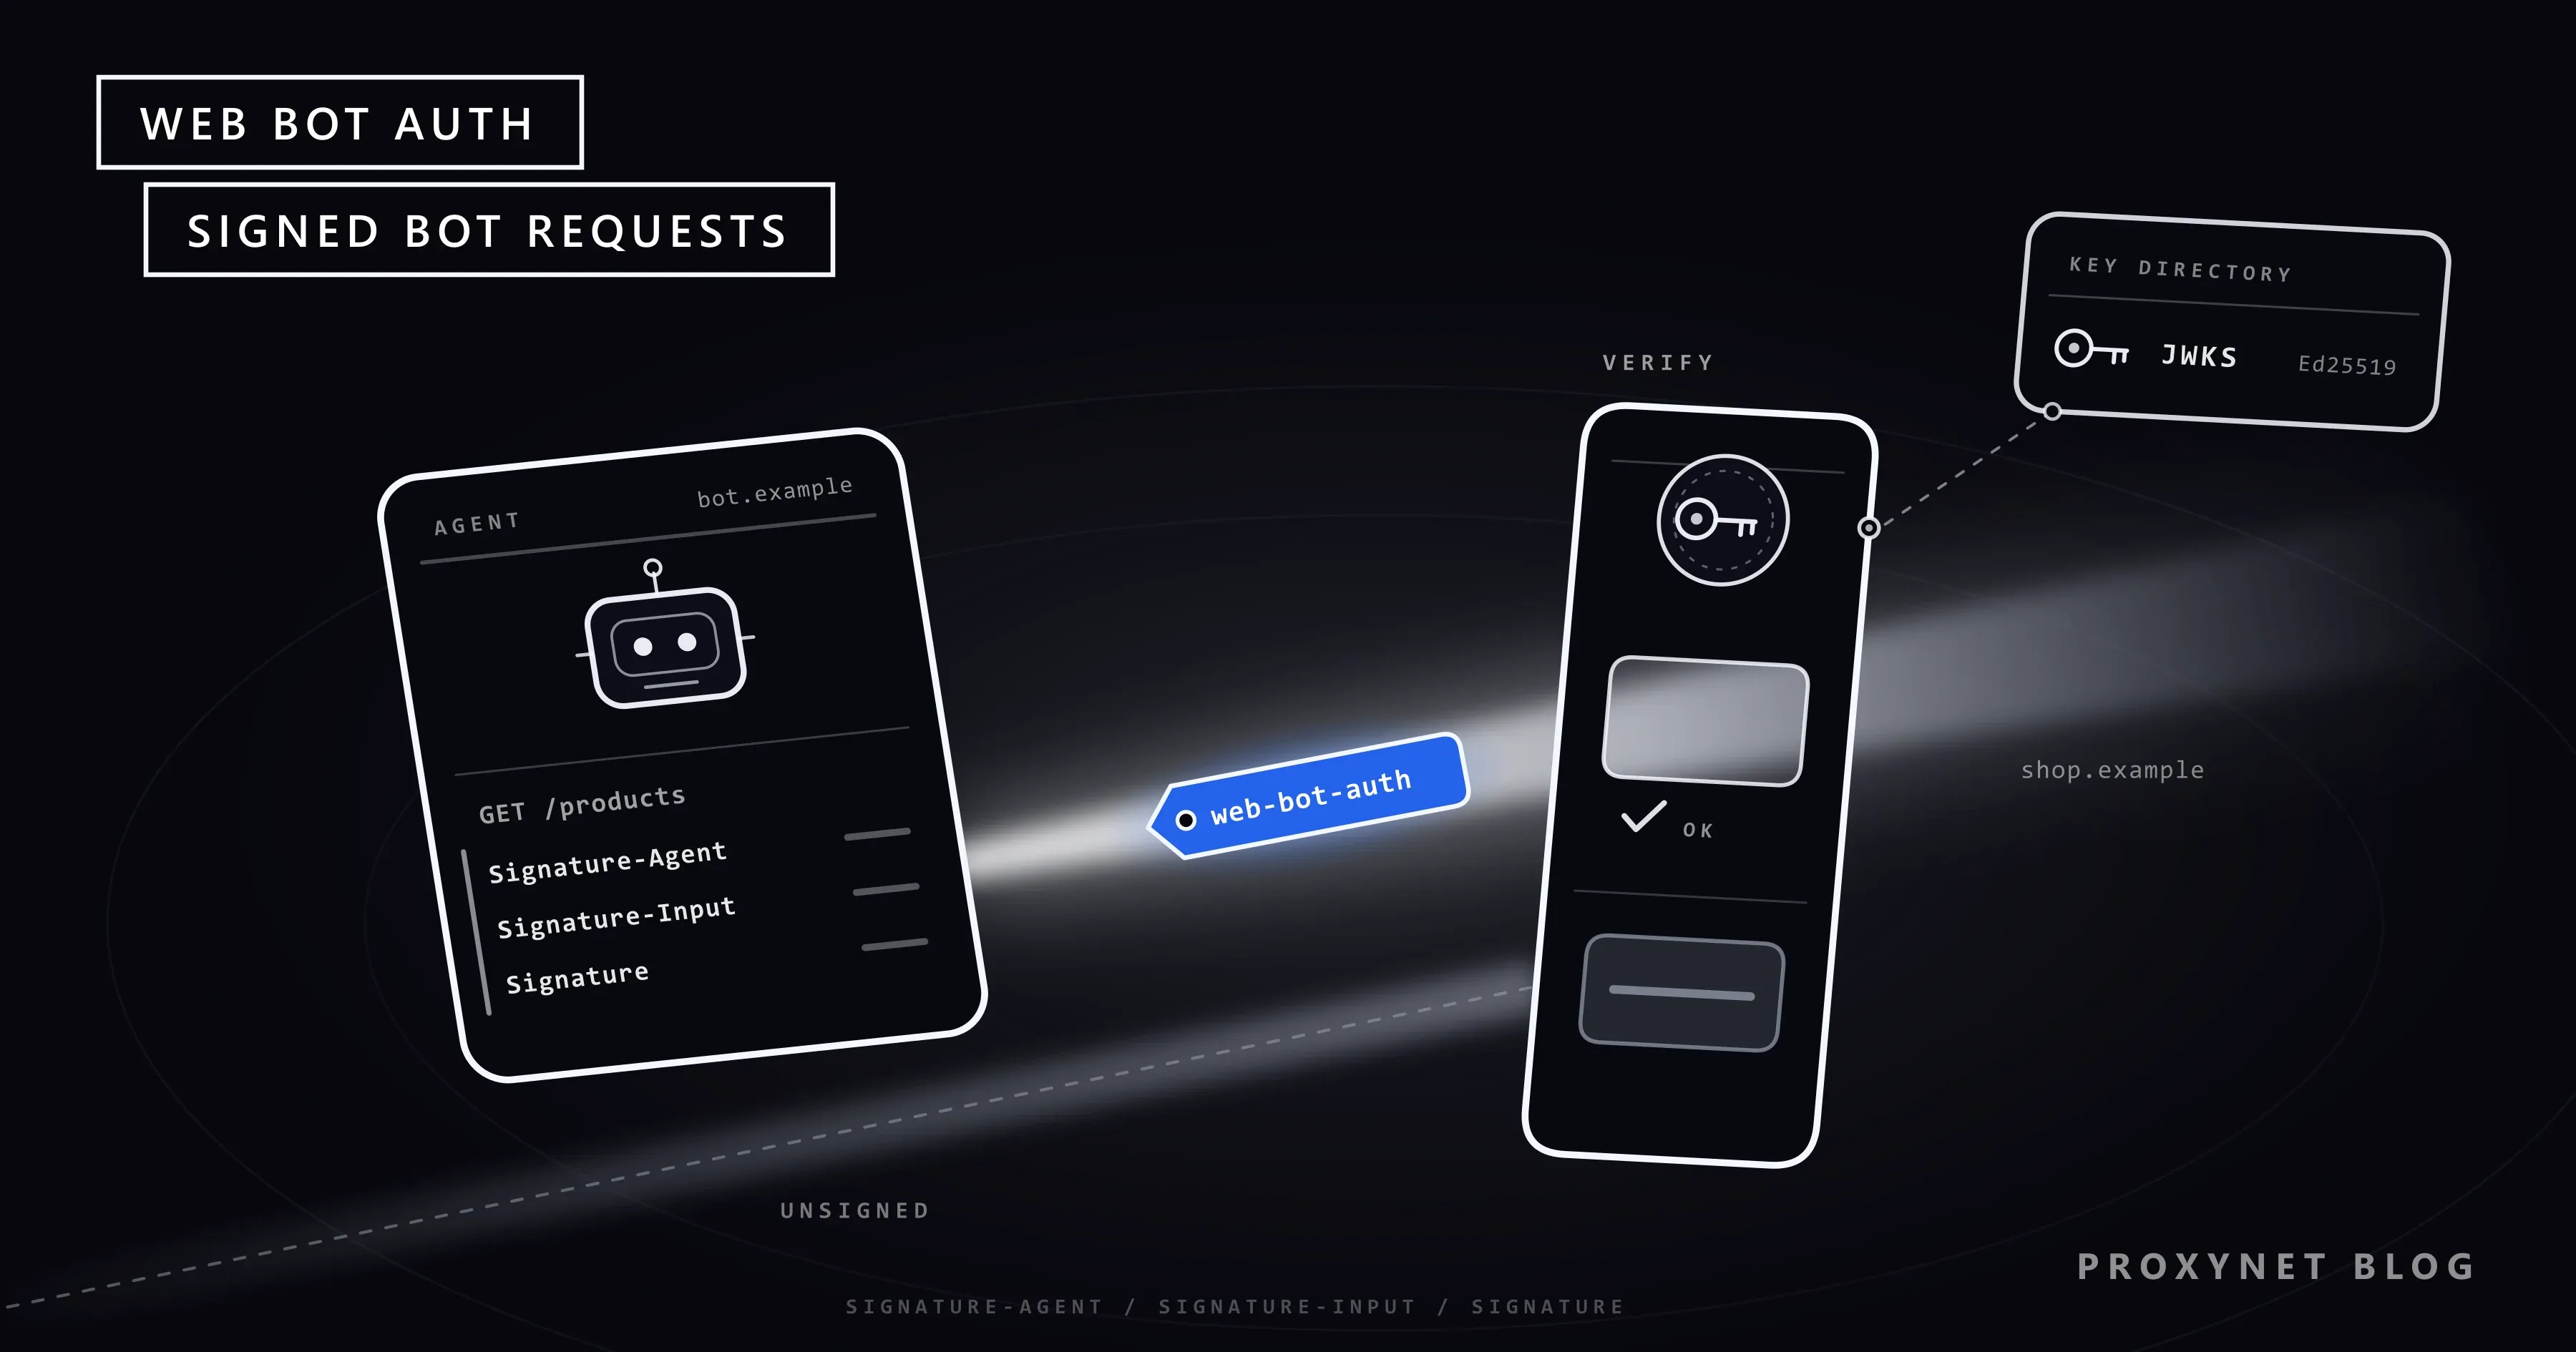
@authority) o la URI de destino completa, más la cabeceraSignature-Agent; añade una hora de creación, una hora de caducidad, un identificador de clave y la etiquetaweb-bot-auth, y firma. - El bot envía tres cabeceras más.
Signature-Inputindica qué se firmó,Signaturecontiene la firma ySignature-Agentda la dirección del directorio de claves. - El sitio descarga la clave. El verificador, a menudo una CDN o un firewall de aplicaciones web (WAF), descarga el directorio, lo guarda en caché y elige la clave que coincide con el
keyid. - El sitio verifica y decide. Reconstruye los datos firmados a partir de la petición recibida, comprueba la firma y la ventana de tiempo, y aplica su propia política: permitir, limitar la frecuencia o bloquear.
Como la firma incluye el host, una firma hecha para un sitio no se verifica en otro, y el borrador recomienda que caduque en menos de 24 horas.
¿Cómo es una petición firmada?
Una petición firmada es una petición HTTP corriente con tres cabeceras más. El ejemplo usa valores inventados y acortados para un bot ficticio en bot.example que pide una página de shop.example.
GET /products HTTP/1.1
Host: shop.example
User-Agent: ExampleBot/1.0 (+https://bot.example/about)
Signature-Agent: sig1="https://bot.example/.well-known/http-message-signatures-directory"
Signature-Input: sig1=("@authority" "signature-agent";key="sig1");created=1795046400;expires=1795050000;keyid="x7Qp…3kLa";tag="web-bot-auth"
Signature: sig1=:jR3x…Q2Bw==:
La etiqueta sig1 une las tres cabeceras, de modo que una petición puede llevar más de una firma. created y expires son marcas de tiempo Unix, aquí separadas por una hora.
| Cabecera | Qué lleva | Quién la lee |
|---|---|---|
Signature-Agent | Dirección del directorio de claves | El verificador, para descargar claves |
Signature-Input | Partes firmadas, horas, ID de clave, etiqueta | El verificador, para reconstruir los datos |
Signature | La firma en sí | El verificador, para comprobarla |
User-Agent | Nombre del bot y URL informativa | Registros y personas |
El keyid es la huella JWK (JWK thumbprint) de la clave, un hash SHA-256 de la clave pública. En nuestra máquina de pruebas, una clave Ed25519 desechable creada en Node.js dio un identificador de clave de 43 caracteres y una firma de 64 bytes, 88 caracteres en base64. Cuando cambiamos el host firmado de shop.example a shop.example.net, la verificación falló.
¿Cómo se comparan los controles antiguos y el nuevo?
Web Bot Auth traslada la prueba de identidad desde la dirección de red a una clave que controla el operador.
| Control | Qué mira el sitio | Dónde falla |
|---|---|---|
| User-Agent | Una cabecera de texto | Cualquiera puede copiarla |
| Lista de IP permitidas | La dirección de origen | Nube compartida, dispositivos de usuarios |
| DNS inverso | Nombre de host de la IP | Exige espacio de IP propio |
| Web Bot Auth | Una firma y una clave | Los sitios deben verificarla |
En la práctica estos controles se combinan, no se sustituyen: Google aconseja mantener las comprobaciones de IP, DNS inverso y user-agent junto a las firmas, porque todavía no todas las peticiones van firmadas.
¿Qué demuestra una firma válida y qué no?
Una firma válida demuestra que la petición se firmó con una clave que figura en el directorio de la dirección Signature-Agent, y nada más. El borrador lo dice con claridad: la firma no te indica quién opera el agente, si es inofensivo ni si la petición está autorizada.
- Identidad no es permiso. A un bot verificado se le puede seguir limitando la frecuencia, cerrando rutas o bloqueando; robots.txt y las condiciones del sitio siguen vigentes.
- Quien controla el directorio es la identidad. Si roban una clave, las peticiones firmadas con ella se verifican hasta que el operador la retire del directorio.
- Las peticiones firmadas se pueden vincular. Los sitios pueden relacionar peticiones que llevan el mismo identificador, así que el protocolo no sirve para agentes que necesitan mantenerse anónimos.
Tampoco cubre lo que un agente hace con el contenido que descarga: un agente verificado aún puede dejarse engañar por instrucciones ocultas en una página, un riesgo distinto llamado inyección de prompts.
¿Quién admite Web Bot Auth hoy?
A 19 de noviembre de 2026, Cloudflare y AWS WAF verifican firmas de Web Bot Auth, Google firma parte del tráfico de uno de sus agentes y Shopify pide a los bots que firmen. Los detalles cambian con el borrador, así que consulta la página actual de cada proveedor.
- Cloudflare. Según su documentación de Web Bot Auth, Cloudflare usa el método para verificar bots en su programa Verified bots: los operadores alojan un directorio de claves, lo registran y firman con Ed25519. Desde el 1 de julio de 2026, los agentes firmados también figuran dentro de Verified bots.
- AWS WAF. El grupo de reglas AWS WAF Bot Control comprueba firmas desde la versión 4.0 y etiqueta cada petición como
verified,invalid,expiredounknown_bot, para que los dueños de sitios escriban reglas sobre el resultado. - Google. La página de Google sobre Web Bot Auth califica su implementación de experimental: un subconjunto de las peticiones de
Google-Agentse firma comohttps://agent.bot.goog. - Shopify. Un registro de cambios para desarrolladores de mayo de 2026 pide a los bots y agentes que visitan tiendas de Shopify que firmen con Web Bot Auth; el tráfico sin firmar recibe los límites de solicitudes más estrictos.
¿Qué significa Web Bot Auth para los dueños de sitios?
Para quien gestiona un sitio, Web Bot Auth convierte la pregunta «¿de verdad es ese bot?» de una suposición en una comprobación, y la mayor parte del trabajo ocurre en la CDN o el firewall, no en tu aplicación.
Una política inicial sensata: deja pasar a un ritmo normal a los crawlers verificados que quieres recibir y aplica a la automatización sin firmar un límite de solicitudes más bajo en lugar de un bloqueo total, porque la mayoría de los bots aún no firma. Vigila los resultados invalid y expired, que apuntan a configuraciones rotas o cabeceras copiadas. Si verificas firmas por tu cuenta, guarda en caché los directorios de claves, no sigas redirecciones al descargarlos y responde a las peticiones sin firmar a rutas protegidas con un 403 y una cabecera Accept-Signature, como recomienda el borrador.
La identidad firmada también facilita hacer cumplir las preferencias que publicas. robots.txt indica qué rutas puede rastrear cada bot, como contamos en Qué es robots.txt y cómo leerlo, y Web Bot Auth te permite comprobar que un bot que dice seguir esas reglas es realmente quien dice ser.
¿Qué significa para quienes crean bots y agentes?
Para los operadores de crawlers y agentes, Web Bot Auth es una forma de ser reconocidos sin que cada sitio tenga que mantener una lista de IP para ellos, a cambio de gestionar claves.
- Usa identidades separadas. El borrador indica que un crawler y un agente que actúa por un usuario deben usar URL de
Signature-Agent, claves y directorios distintos. - Firmas de vida corta. Fija
expirescerca decreated. - Rota las claves. Publica la clave nueva antes de usarla y después retira la antigua.
- Protege la clave privada. Guárdala como cualquier credencial; no se permiten claves secretas compartidas (HMAC).
- Mantén los buenos modales. Un
User-Agentclaro, robots.txt y un ritmo de peticiones prudente siguen importando.
Para los agentes que compran o pagan por un usuario, la firma es solo la mitad de la historia; la parte del pago está en ¿Por qué los sitios bloquean a los agentes de compra con IA?
¿Cambia un proxy la identidad de un bot con Web Bot Auth?
No. Con Web Bot Auth, la identidad de un bot está en su clave, no en la dirección IP desde la que sale su tráfico, así que un proxy decide por dónde sale una petición, pero no quién es el bot. El borrador establece que la firma no depende de la IP y que un proxy no debería eliminar las cabeceras de firma. Con HTTPS, un proxy solo hace de túnel para la conexión cifrada, así que las cabeceras firmadas llegan tal como las envió el bot.
Esa separación resulta útil para los equipos de crawlers: la firma responde a «¿quién es?», mientras que la ubicación de salida responde a «¿qué muestra esta página a los visitantes en Alemania o Brasil?», por ejemplo al revisar precios localizados. Nuestra página de proxy para web crawler describe la segmentación geográfica y las esperas ajustables entre peticiones para este tipo de rastreo respetuoso.
Cuando un crawler necesita una dirección de salida fija y conocida, por ejemplo para que coincida con una regla de firewall en tus propios sitios, los Proxies de centro de datos ofrecen direcciones IPv4 dedicadas. En cualquier caso, una petición firmada que pasa por un proxy sigue sujeta a la política propia del sitio.
¿Dónde te encontrarás con Web Bot Auth?
- Paneles de CDN y firewall: categorías de bots verificados, resultados de firma y reglas basadas en ellos.
- Crawlers de búsqueda y de IA: operadores que publican directorios de claves junto a la documentación de su crawler.
- Agentes de IA que actúan por usuarios: agentes de navegación y de compra que firman algunas o todas sus peticiones.
- Plataformas de tiendas online: tiendas que dan límites de solicitudes más altos a los bots firmados.
- Monitorización y comprobación de enlaces: monitores de disponibilidad que quieren distinguirse de los ataques.
Errores frecuentes
- Llamarlo RFC. Web Bot Auth es un borrador de grupo de trabajo basado en RFC 9421; todavía puede cambiar.
- Tratar una firma válida como permiso. Demuestra la clave, no la buena intención ni el derecho a rastrear.
- Bloquear todos los bots sin firma. La mayor parte del tráfico automatizado aún no va firmado; los límites de solicitudes son un primer paso más suave.
- Abandonar los controles antiguos. La propia Google aconseja mantener las comprobaciones de IP, DNS inverso y user-agent durante el despliegue.
- Firmas de larga duración. Una firma válida durante días alarga la vida de las cabeceras copiadas.
- Una sola clave para todo. Un crawler y un agente dirigido por el usuario no deberían compartir identidad.
Guía de decisión
| Tu situación | Qué hacer |
|---|---|
| Tu sitio está detrás de una CDN o un WAF | Activa su verificación de firmas y crea reglas con el resultado |
| Tráfico de crawlers falsos llena tus registros | Permite bots verificados, limita la frecuencia de los no verificados |
| Operas un crawler | Publica un directorio de claves, firma cada petición |
| Operas un agente de IA para usuarios | Usa una clave y un directorio distintos de los del crawler |
| Verificas firmas por tu cuenta | Caché de directorios, sin redirecciones, ventanas de tiempo cortas |
| Necesitas una IP de salida fija o local | Usa un proxy; la firma no cambia |
Preguntas frecuentes
¿Web Bot Auth es un estándar oficial?
Todavía no. Es un Internet-Draft del grupo de trabajo Web Bot Auth del IETF, orientado al Standards Track. El método de firma en el que se basa, HTTP Message Signatures, ya es un estándar: RFC 9421.
¿Web Bot Auth es lo mismo que los bots verificados de Cloudflare?
No. Web Bot Auth es un protocolo abierto que cualquier sitio, CDN o firewall puede verificar. El programa Verified bots de Cloudflare es uno de los lugares donde se usa, junto a otros controles como las listas de IP publicadas y el DNS inverso.
¿AWS WAF es compatible con Web Bot Auth?
Sí. AWS WAF Bot Control verifica firmas a partir de la versión 4.0 del grupo de reglas y añade una etiqueta con el resultado, como verified o unknown_bot, sobre la que pueden actuar tus propias reglas.
¿Necesito Cloudflare para firmar peticiones con Web Bot Auth?
No. Necesitas un par de claves, un directorio de claves en una dirección HTTPS que controles y código de firma en tu bot. Shopify, por ejemplo, indica que los bots no tienen que inscribirse en Cloudflare para firmar peticiones dirigidas a sus tiendas.
¿Web Bot Auth sustituye a robots.txt?
No. robots.txt indica a los bots qué rutas pueden rastrear; Web Bot Auth indica al sitio qué bot pregunta. Los dos funcionan juntos.
¿Alguien puede copiar una petición firmada y reutilizarla?
Solo dentro de límites estrechos. La firma incluye el host, así que falla en otro sitio, y lleva una hora de caducidad. Los sitios que necesitan una protección más estricta pueden pedir un nonce, un valor de un solo uso, y rechazar las firmas que ya hayan visto.
En resumen
Web Bot Auth da a los bots y agentes de IA una identidad verificable: el operador publica una clave pública, el bot firma cada petición con HTTP Message Signatures y el sitio comprueba la firma en lugar de fiarse de una cadena User-Agent o de una lista de IP. Sigue siendo un borrador del IETF, pero Cloudflare y AWS WAF ya lo verifican y Google lo está probando. Una firma demuestra quién pregunta, no lo que puede hacer, así que robots.txt, los límites de solicitudes y las políticas del sitio siguen decidiendo. Por dónde salen las peticiones de tu crawler es otra cuestión, y nuestros servicios de proxy cubren esa parte.