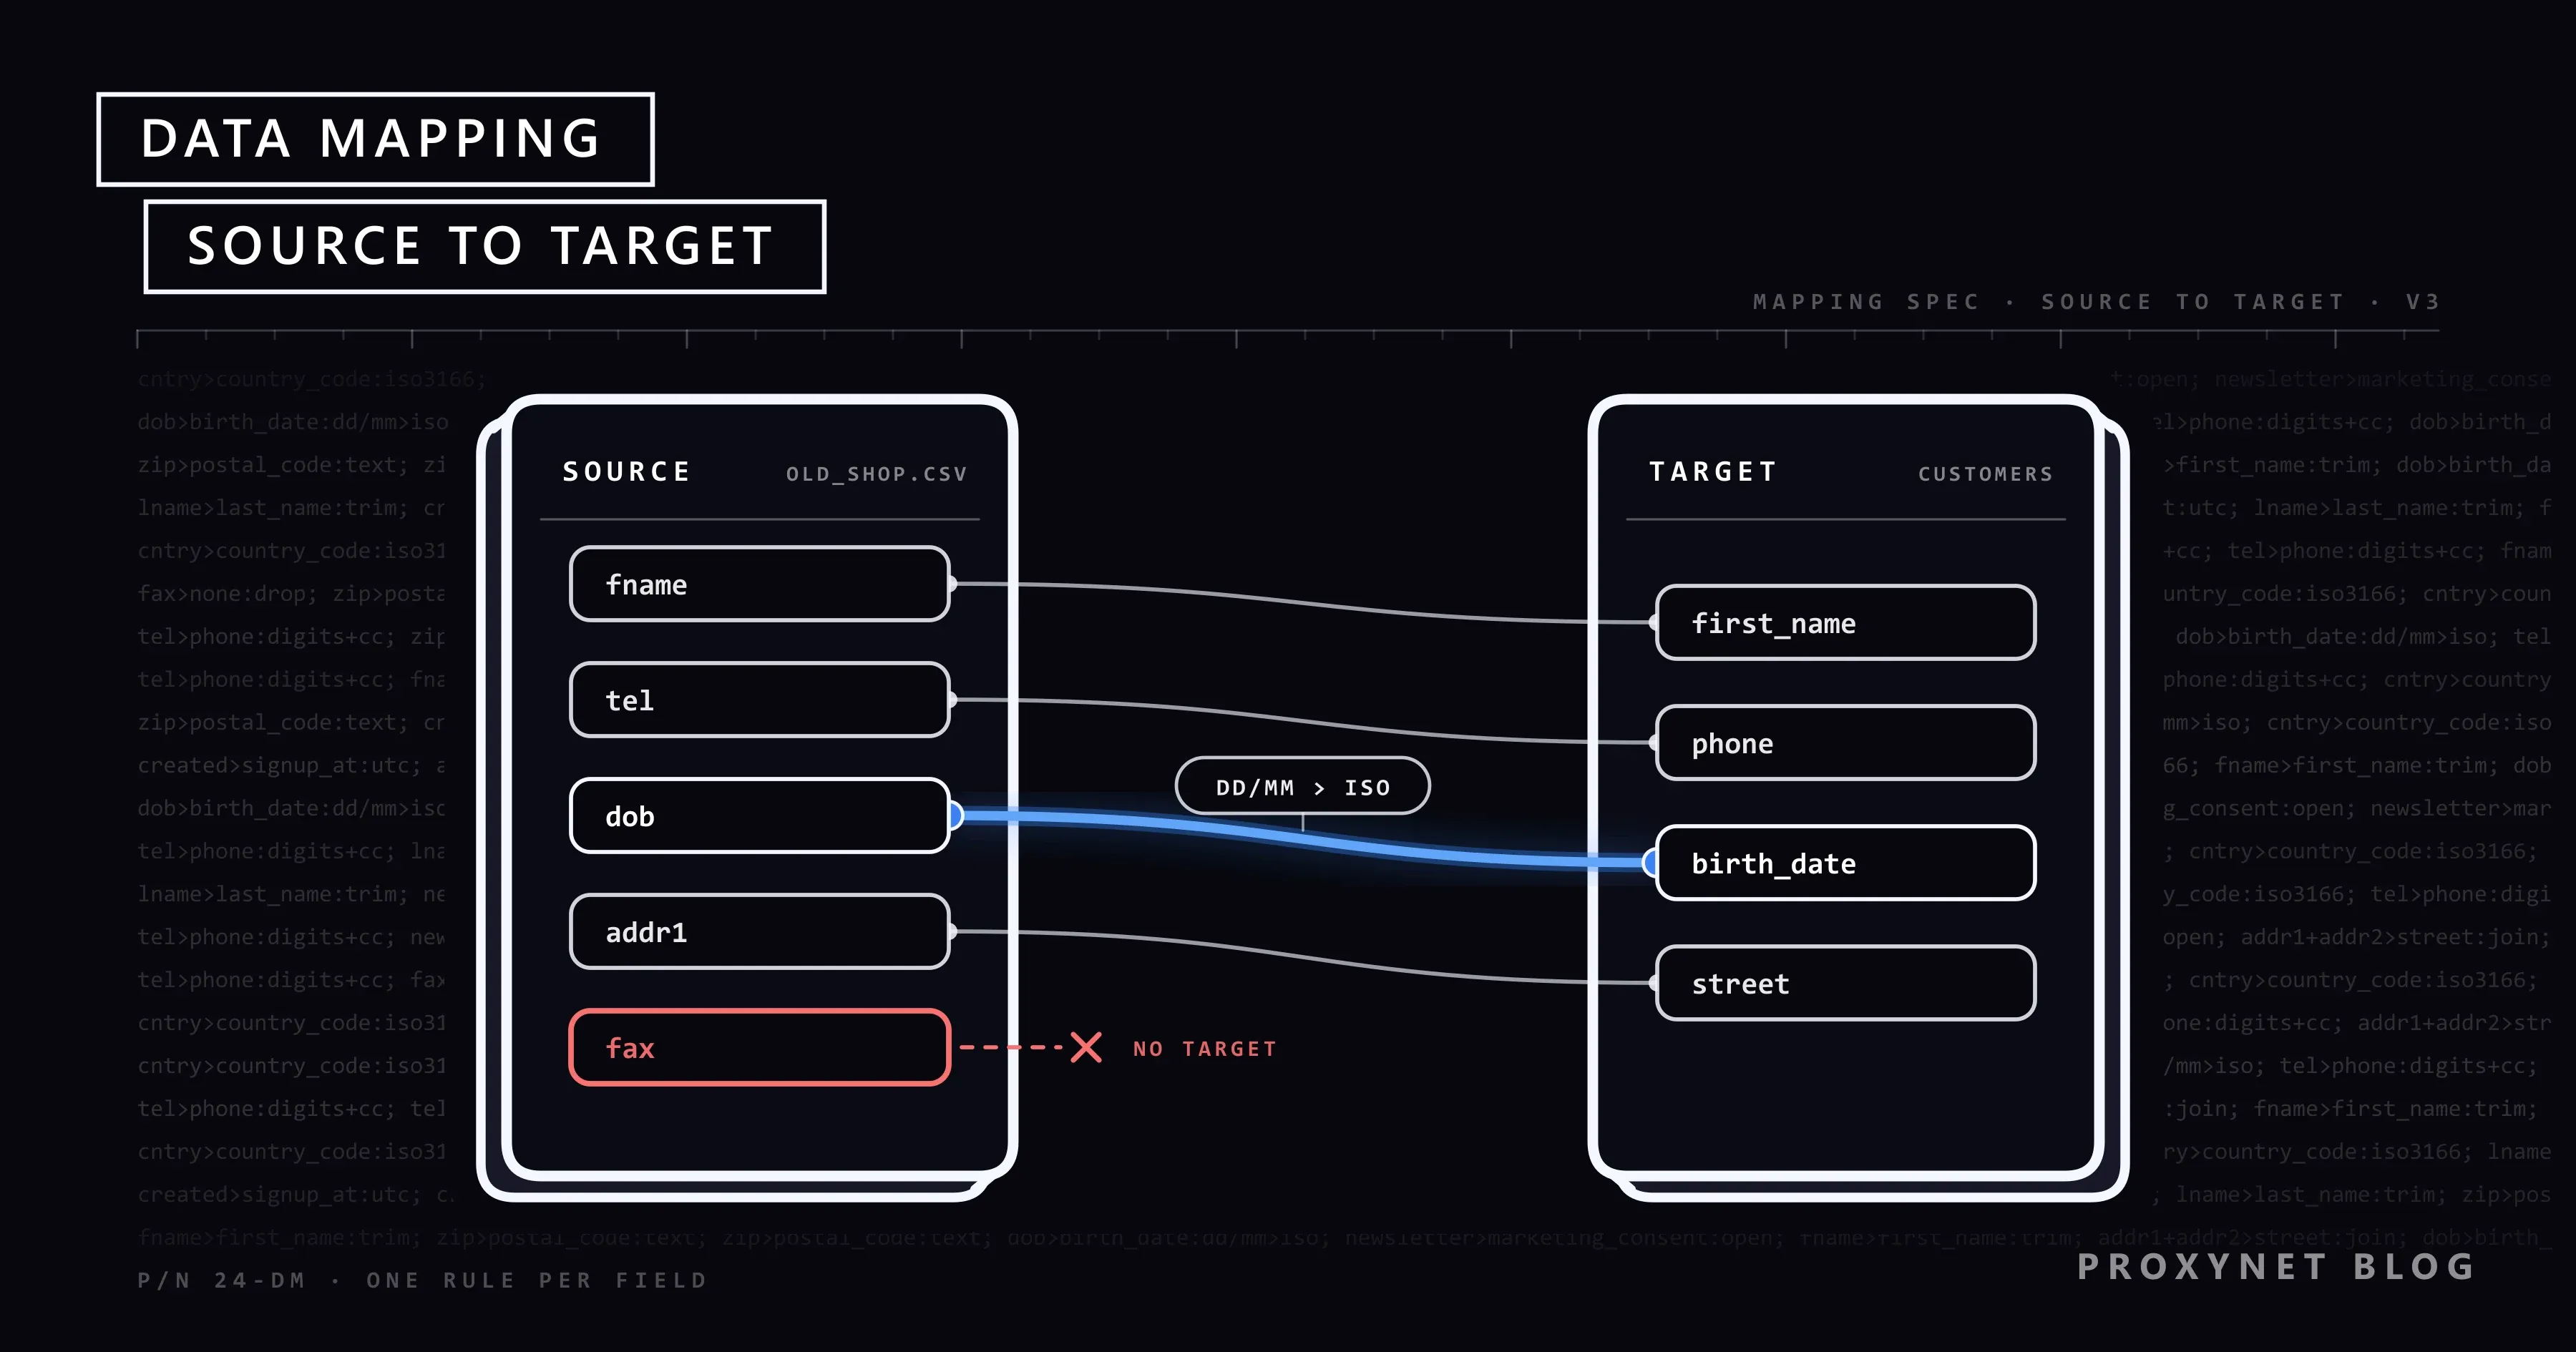
Una pequeña tienda online se muda a una nueva plataforma de comercio electrónico. El sistema antiguo exporta 38.000 clientes con columnas llamadas fname, tel y dob, y las fechas de nacimiento tienen el aspecto 03/04/1990; la nueva plataforma espera first_name, un teléfono con su prefijo de país y fechas escritas como 1990-04-03. Antes de importar nada, alguien tiene que decidir, columna por columna, adónde va cada valor y cómo cambia por el camino. Esa tabla de decisiones es un mapa de datos, y crearla es el mapeo de datos (data mapping).
Una semana después, la responsable de privacidad de la tienda plantea otra pregunta bajo el mismo nombre: qué sistemas guardan datos de clientes, para qué y quién los recibe. Este artículo cubre los dos significados: el mapeo de campos y su documento, los enfoques principales y cómo los equipos de privacidad mapean los datos personales para el RGPD y para la Ley n.º 6698 de Türkiye (KVKK).
¿Qué es el mapeo de datos?
El mapeo de datos es el trabajo de describir cómo se corresponden los datos de un lugar con los de otro. El resultado es un mapa: una lista de pares (este campo de origen se convierte en aquel campo de destino) con una regla para cada par o, en el ámbito de la privacidad, una lista de dónde están los datos personales y adónde van.
El término abarca dos tareas que comparten método pero sirven a lectores distintos:
| Significado | Pregunta que responde | Responsable habitual | Entregable |
|---|---|---|---|
| Mapeo de integración | ¿Adónde va cada campo y cómo cambia? | Ingeniero o analista de datos | Documento de mapeo de origen a destino |
| Mapeo de privacidad | ¿Qué datos personales tenemos, para qué y adónde fluyen? | Responsable de privacidad o delegado de protección de datos | Inventario de datos, mapa de flujos, registro de tratamiento |
¿Cómo funciona el mapeo campo a campo?
El mapeo campo a campo consiste en listar los campos de ambos lados, emparejarlos y escribir una regla de conversión para cada par antes de mover ningún dato. Una secuencia típica tiene siete pasos:
- Perfila el origen. Lista cada campo con su tipo, algunos valores de ejemplo, la frecuencia con la que está vacío y el formato que usa. Una columna llamada
phonepuede contener fijos, móviles y las palabras «preguntar en recepción». - Fija el esquema de destino. Un esquema es la descripción formal de una estructura de datos: qué campos existen, de qué tipo son, cuáles son obligatorios y qué valores se permiten.
- Empareja los campos. Asocia cada campo de origen a un campo de destino. Algunos pares son uno a uno; otros dividen un campo en dos o juntan varios en uno.
- Escribe las reglas de transformación. Indica cómo cambia cada valor: formatos de fecha, separadores decimales, unidades, monedas, listas de códigos (
MyFamaleyfemale), recorte de espacios y valores por defecto para los vacíos. - Decide qué no se mapea. Cada campo de origen acaba mapeado, descartado de forma deliberada o marcado como pregunta abierta. Los descartes silenciosos son la vía por la que se pierden datos.
- Prueba con muestras reales. Pasa unos cientos de registros por las reglas y compara a mano el resultado con el origen, incluidos campos vacíos, nombres con tildes y valores extremos.
- Ejecuta, supervisa y versiona. Cuenta los registros de entrada y de salida en cada ejecución, registra las filas rechazadas y versiona el mapa, para que un cambio en cualquiera de los dos sistemas obligue a cambiar el mapa.
El paso 4 es donde se esconden la mayoría de los errores. En nuestra máquina de pruebas, Node.js 24 interpretó la cadena «03/04/1990» como el 4 de marzo de 1990, no como el 3 de abril; convertida a UTC pasó a ser el 3 de marzo, porque el reloj de la máquina iba dos horas por delante de UTC en esa fecha, y rechazó «13/04/1990» como fecha no válida. Una regla que solo dice «fecha de nacimiento a fecha ISO» sin indicar el orden del origen (día primero o mes primero) deja esa decisión al analizador que toque ejecutarla.
¿Cómo es un documento de mapeo de datos?
Un documento de mapeo de datos es una tabla con una fila por campo que muestra de dónde viene cada valor, adónde va y qué regla lo cambia. Para la migración de la tienda anterior:
| Campo de origen | Campo de destino | Regla |
|---|---|---|
fname | first_name | Quitar espacios sobrantes |
tel | phone | Solo dígitos, añadir prefijo de país |
dob | birth_date | Leer DD/MM/YYYY, escribir YYYY-MM-DD |
addr1 + addr2 | street | Unir con un espacio |
cntry | country_code | Nombre a código ISO 3166 de dos letras |
fax | (ninguno) | Descartado: ya no se usa |
newsletter | marketing_consent | Abierto: revisar registros de consentimiento |
Los documentos reales añaden columnas de tipo de dato, responsable y estado de prueba; la mayoría de las «plantillas de mapeo de datos» son esta tabla con esas columnas extra. Las dos últimas filas son las que más importan. Un campo descartado es una decisión que alguien aprobó, y un indicador de consentimiento no se puede suponer: si el sistema antiguo nunca registró cómo se dio el consentimiento, el nuevo no debería mostrarlo como dado.
¿Qué tipos de mapeo de datos existen?
El mapeo de datos se hace de tres formas: manual, basado en esquemas con apoyo de herramientas y automatizado con sugerencias de emparejamiento. La mayoría de los proyectos reales combinan las tres.
| Enfoque | Cómo funciona | Encaja en | Riesgo principal |
|---|---|---|---|
| Manual | Personas emparejan campos en una hoja de cálculo | Migraciones pequeñas o puntuales | Erratas, sin pruebas |
| Basado en esquemas | Ambos esquemas cargados en una herramienta; reglas en un editor o en código | Integraciones recurrentes, ETL | Código y documento se desalinean |
| Automatizado | La herramienta propone pares por nombres, tipos y valores de ejemplo | Muchas fuentes parecidas | Coincidencias erróneas con apariencia segura |
Las sugerencias automáticas ahorran tiempo en pares obvios como email a email_address, pero un nombre dice poco sobre el significado: date es la fecha del pedido en una fuente y la fecha de entrega en otra. Trata cada par sugerido como una propuesta que confirma una persona.
Las relaciones entre campos son de varios tipos y cada una necesita su propia regla: uno a uno, varios a uno (dos líneas de dirección unidas), uno a varios (un nombre completo dividido en dos, algo que falla con muchos nombres reales), búsquedas en una tabla de referencia y constantes que el origen no tiene.
¿En qué se diferencia el mapeo de datos de la transformación, el ETL y el linaje?
El mapeo de datos es la especificación, la transformación es la ejecución de sus reglas, el ETL es el proceso que las ejecuta y el linaje de datos (data lineage) es el registro de dónde salió realmente un valor. El mapa dice «dob pasa a birth_date, leer con el día primero»; la transformación es el paso que lo hace. El ETL (extracción, transformación, carga) toma los datos del origen, aplica esas transformaciones y carga el resultado en una base de datos, como explica paso a paso ¿Qué es ETL?.
El linaje mira hacia atrás: para una cifra de un panel, muestra qué tablas, procesos y campos de origen la produjeron, y un buen documento de mapeo facilita seguir ese rastro. Un diccionario de datos describe los campos de un solo sistema sin relacionarlos con otro.
El mapeo también va antes de la limpieza. Cuando los campos ya están alineados, los valores erróneos, duplicados o incoherentes se hacen visibles y se pueden corregir; ¿Qué es la limpieza de datos? trata ese paso.
¿Qué es el mapeo de datos en privacidad?
En privacidad, el mapeo de datos consiste en averiguar qué datos personales tiene una organización, dónde se almacenan, por qué se tratan, quién los recibe y cuánto tiempo se conservan. Un dato personal es cualquier información sobre una persona identificada o identificable: un nombre, una dirección de correo electrónico, un número de cliente, una dirección IP en un registro del servidor.
Los equipos de privacidad suelen producir dos cosas. Un inventario de datos enumera las actividades de tratamiento (nóminas, selección de personal, gestión de pedidos, el boletín) con los datos y sistemas que usa cada una. Un mapa de flujos de datos muestra cómo se mueven esos datos: de un formulario web a la base de datos de la tienda, de ahí a un proveedor de pagos, cada noche a un CRM, cada mes a una gestoría en el extranjero. Las sorpresas aparecen en los flujos, por ejemplo una herramienta de soporte que copia fichas completas de clientes en un servidor de otro país.
¿Qué exige el artículo 30 del RGPD?
El artículo 30 del RGPD obliga a cada responsable del tratamiento, es decir, la organización que decide los fines y los medios del tratamiento de datos personales, a llevar un registro por escrito de sus actividades de tratamiento, que en inglés se abrevia a menudo como RoPA. El registro debe contener:
- el nombre y los datos de contacto del responsable y, en su caso, de su representante y del delegado de protección de datos;
- los fines del tratamiento;
- las categorías de interesados y de datos personales;
- las categorías de destinatarios, incluidos los destinatarios en otros países;
- las transferencias a países de fuera de la UE o a organizaciones internacionales;
- cuando sea posible, los plazos previstos para suprimir cada categoría de datos;
- cuando sea posible, una descripción general de las medidas de seguridad.
Los encargados del tratamiento, las empresas que tratan datos por cuenta de un responsable, como un proveedor de alojamiento o de nóminas, llevan un registro propio y más breve. Ambos registros pueden ser electrónicos y deben ponerse a disposición de la autoridad de control que lo solicite (texto del RGPD en EUR-Lex).
La excepción para organizaciones de menos de 250 personas es más estrecha de lo que parece. Solo se aplica si el tratamiento no puede entrañar un riesgo para los derechos de las personas, es ocasional y no incluye categorías especiales de datos personales (como los de salud) ni datos sobre condenas penales. Las nóminas y una base de datos de clientes no son ocasionales, así que la mayoría de las pequeñas empresas llevan el registro de todos modos. La Comisión Europea ha propuesto cambios en esta excepción; el 19 de noviembre de 2026, EUR-Lex todavía los recoge como propuestas, no como modificaciones en vigor.
La guía del Comité Europeo de Protección de Datos (CEPD) para pequeñas empresas ofrece un punto de partida práctico: identifica cuáles de tus actividades implican datos personales, como la selección de personal, las nóminas o las tarjetas de acceso, y describe cada una (guía del CEPD para pequeñas empresas). El mapa de datos es el material de trabajo y el registro del artículo 30 es el documento formal que se construye a partir de él; el detalle adicional del mapa (nombres de tablas, campos, servidores) es lo que mantiene exacto el registro.
El mismo mapa alimenta una evaluación de impacto relativa a la protección de datos (EIPD). El artículo 35 la exige antes de un tratamiento que probablemente entrañe un alto riesgo para las personas, como el tratamiento a gran escala de datos de salud, y nadie puede evaluar el riesgo de unos datos que no ha localizado.
En Türkiye, la Ley n.º 6698 de Protección de Datos Personales (KVKK) tiene un equivalente cercano. Según el reglamento turco sobre el registro de responsables del tratamiento, los responsables obligados a inscribirse en el registro público, VERBIS, elaboran un inventario de tratamiento de datos personales. Recoge fines y bases jurídicas, categorías de datos, grupos de destinatarios, grupos de personas, plazos máximos de conservación, transferencias previstas al extranjero y medidas de seguridad, y la inscripción en el registro se basa en él.
¿Cómo se crea un mapa de datos personales?
Un mapa de datos personales se crea empezando por las actividades del negocio en lugar de por las bases de datos, y siguiendo después cada actividad hasta sus sistemas, datos y destinatarios:
- Enumera las actividades. Pregunta a cada equipo qué hace con información sobre personas: contratación, nóminas, ventas, soporte, marketing, analítica web, registros de seguridad.
- Localiza los sistemas. Nombra las aplicaciones, bases de datos, hojas de cálculo, unidades compartidas y buzones que usa cada actividad, incluido el software que gestionan proveedores por ti.
- Anota los datos y las personas. Indica qué categorías de datos (contacto, pago, salud) se guardan sobre qué grupos (clientes, plantilla, candidatos, visitantes).
- Anota el fin y la base jurídica. Escribe para qué se tratan los datos y en qué base legal se apoya ese tratamiento.
- Sigue los flujos. Registra de dónde vienen los datos, qué proveedores los reciben y si salen del país.
- Fija conservación y seguridad. Indica cuánto tiempo se guarda cada categoría y qué la protege.
- Mantenlo al día. Vincula las actualizaciones a hechos concretos: una herramienta nueva, un proveedor nuevo, un formulario nuevo en la web.
Los equipos que recopilan datos web públicos también deberían incluir esos conjuntos de datos, porque las páginas obtenidas por scraping suelen contener nombres, enlaces a perfiles o direcciones de correo; el artículo sobre cómo tratar datos personales en datos de scraping explica cómo recortar esos campos.
¿Dónde encajan los proxies en el mapeo de datos?
Los proxies intervienen antes del mapeo, en la fase de recopilación, cuando los datos que mapeas vienen de páginas web públicas de varios países. Una página de producto en Alemania escribe el precio con coma decimal, la versión de EE. UU. usa un punto, y un sitio indica las existencias con availability mientras otro solo muestra una etiqueta. Una salida de proxy en cada país muestra la página que ve un visitante local, y mapear todas las versiones a un único esquema (producto, precio, moneda, existencias, país, momento de la recopilación) es el primer paso antes de cualquier comparación. Si prefieres recibir los datos ya estructurados, puedes usar nuestra Web Scraping API, un servicio gestionado de extracción de páginas disponible a través de nuestro equipo comercial.
Un mapa de datos también es una herramienta de seguridad: te dice qué expondría una filtración. Los equipos de seguridad que vigilan fuentes públicas en busca de datos filtrados de su empresa usan proxies para seguridad de datos para hacer esa investigación lejos de su propia red, dentro de los límites legales que se le aplican.
¿Dónde se usa el mapeo de datos?
- Migraciones de datos: el paso a un nuevo CRM, plataforma de tienda o sistema contable.
- ETL y almacenes de datos: cargar muchos sistemas en un único modelo de informes.
- Integraciones: mantener sincronizados los pedidos entre una tienda y una herramienta de facturación.
- Fusiones: combinar los datos de clientes y productos de dos empresas.
- Datos web: convertir páginas de muchos sitios y países en una sola tabla.
- Cumplimiento en privacidad: el registro del RGPD, el inventario de la KVKK, las EIPD y las solicitudes de personas que quieren una copia de sus datos.
Errores comunes
- Mapear solo por el nombre del campo.
date,statusytypesignifican cosas distintas en sistemas distintos. - No indicar los formatos de origen. Fechas, separadores decimales, unidades y codificaciones necesitan una regla explícita.
- Descartar campos en silencio. Cada campo sin mapear necesita una decisión registrada.
- Probar solo filas limpias. Los campos vacíos, los nombres largos y los caracteres extranjeros rompen reglas que funcionan con muestras ordenadas.
- Dar el documento por terminado en la puesta en marcha. Un cambio de esquema sin cambio en el mapa estropea los datos en silencio.
- Trasladar indicadores de consentimiento sin pruebas. Necesitan evidencia, no un valor por defecto.
- Construir el mapa de privacidad solo a partir de los sistemas de TI. Las hojas de cálculo, los buzones y las herramientas de los proveedores también guardan datos personales.
Guía de decisión
| Necesidad | Recomendación |
|---|---|
| Pasar datos a un sistema nuevo una sola vez | Hoja de origen a destino, probada con muestras |
| Integración recurrente | Mapeo basado en esquemas en la herramienta ETL, versionado |
| Muchas fuentes parecidas (feeds, sitios) | Un esquema de destino; sugerencias de la herramienta confirmadas por una persona |
| Registro de actividades de tratamiento del RGPD | Primero un inventario por actividades, después el registro del artículo 30 |
| Tratamiento de alto riesgo previsto | Primero el mapa de datos, después una EIPD |
| Responsable registrado en Türkiye | Inventario de tratamiento de la KVKK como base para VERBIS |
| Una persona pide sus datos | Usar el mapa para encontrar cada sistema que los guarda |
Preguntas frecuentes
¿Qué es el mapeo de datos en pocas palabras?
El mapeo de datos es decidir adónde va cada dato cuando pasa de un sistema a otro y cómo cambia por el camino. En privacidad, significa enumerar dónde se guardan los datos personales, para qué y quién los recibe.
¿Cuál es un ejemplo de mapeo de datos?
Una tienda que se muda a una plataforma nueva asocia su antigua columna fname al nuevo campo first_name y convierte las fechas de nacimiento de 03/04/1990 a 1990-04-03. Un ejemplo de privacidad es una tabla que muestra que los correos de los clientes están en la base de datos de la tienda, pasan a una herramienta de boletines y se borran dos años después del último pedido.
¿Puedo hacer el mapeo de datos en Excel?
Sí. Para migraciones puntuales, una hoja de cálculo es el formato más habitual: una fila por campo con origen, destino, regla, tipo y estado. En integraciones recurrentes, mantén la hoja como especificación y las reglas en tu herramienta ETL, y actualiza ambas a la vez.
¿Qué es el mapeo de datos según el RGPD?
Es el trabajo previo al registro del artículo 30: qué datos personales tratas, para qué, sobre quién, quién los recibe, adónde van y cuánto tiempo se conservan. El reglamento exige el registro, no un diagrama, pero pocas organizaciones pueden redactar un registro exacto sin mapear antes.
¿Un mapa de datos es lo mismo que un registro de actividades de tratamiento?
No. El mapa de datos es la vista de trabajo detallada de sistemas, campos y flujos; el registro es la lista formal que exige el RGPD, organizada por actividades. La mayoría de los equipos construyen el registro a partir del mapa.
¿Quién es responsable del mapeo de datos?
En las integraciones, el documento de mapeo es cosa de los ingenieros de datos o del equipo de migración, y el responsable de negocio de cada campo confirma su significado. En privacidad, la responsabilidad es del responsable del tratamiento, normalmente a través de una persona a cargo de la privacidad o de un delegado de protección de datos que reúne la información de cada equipo.
En resumen
El mapeo de datos consiste en emparejar campos entre sistemas con una regla escrita para cada par, y en localizar los datos personales, sus fines y sus flujos para cumplir la normativa de privacidad. El mapeo de campos falla por formatos no indicados y descartes silenciosos; el mapeo de privacidad empieza por las actividades y se convierte en el registro del artículo 30 del RGPD o, en Türkiye, en el inventario de la KVKK. Si tus fuentes son páginas web públicas de varios países, mapéalas a un único esquema desde el principio y recopila cada página desde el país que describe, por ejemplo con los Proxies residenciales con segmentación por país.