


































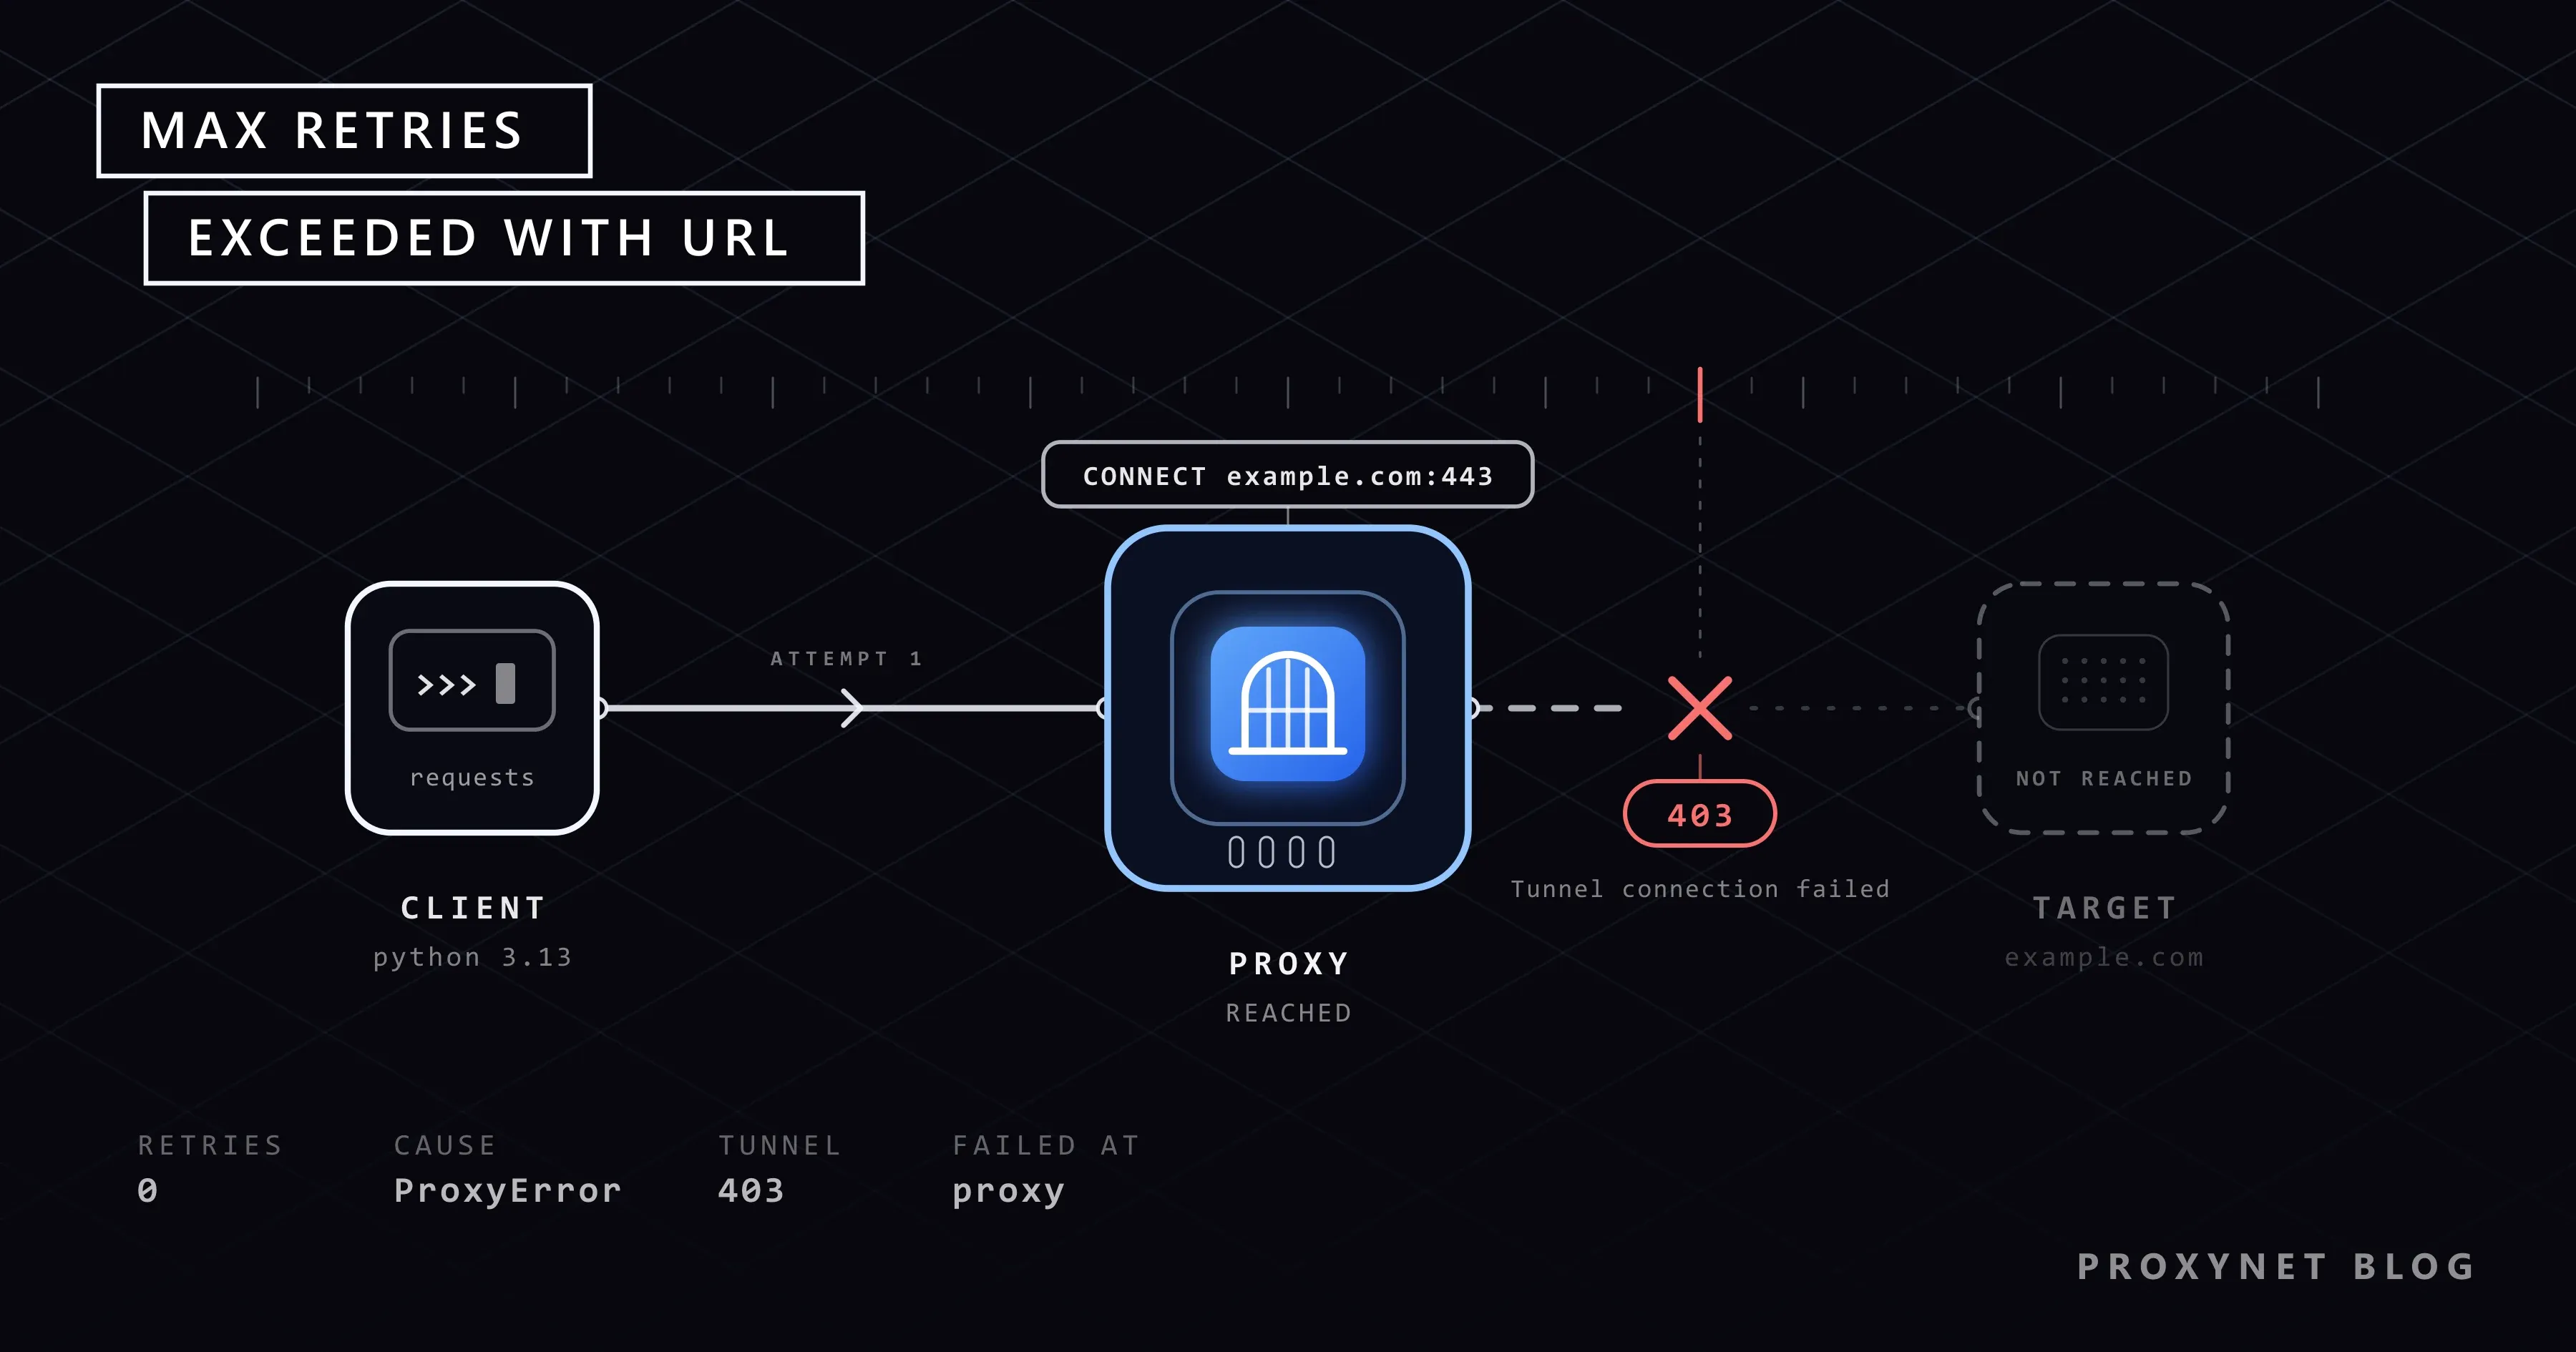
Ihr Skript zur Preisbeobachtung lief die ganze Nacht ohne Probleme. Heute Morgen haben Sie die Proxy-Adresse aus Ihrem neuen Tarif eingefügt, und jetzt gibt das Terminal eine einzige lange Zeile aus: HTTPSConnectionPool(host='example.com', port=443): Max retries exceeded with url. Das Skript hat keine Einstellung für Wiederholungen, und der Host in der Meldung ist der Shop, den Sie auslesen, also richtet sich Ihr Blick sofort auf den Shop. Ganz am Ende der Zeile steht in den Klammern aber Tunnel connection failed: 403 Forbidden, und diese Antwort kam vom Proxy, nicht vom Shop.
Dieser Leitfaden nimmt die Meldung auseinander. Er erklärt, warum sie „max retries“ sagt, obwohl Sie keine Wiederholungen eingestellt haben, bietet eine Lesetabelle aus Fehlertexten, die wir selbst erzeugt haben, und behandelt die Proxy-Varianten, Timeouts und denselben Fehler in pip. Am Ende steht ein getestetes Python-Skript, das die Ursache benennt.
Was bedeutet „Max retries exceeded with url“?
Die Meldung stammt von urllib3, der Bibliothek, die für Requests die Verbindungen öffnet. Gibt urllib3 eine Anfrage auf, wirft es MaxRetryError. Requests fängt diese Ausnahme ab und wirft eine eigene, die es nach der inneren Ursache auswählt: ConnectTimeout, ProxyError, SSLError, RetryError, wenn die Wiederholungen nach Statuscode aufgebraucht sind, oder schlicht ConnectionError für alles andere. Hier ein Fehlertext aus unserem Testlauf, in seine vier Teile zerlegt:
requests.exceptions.ProxyError                        <- 1. die Requests-Ausnahme
HTTPSConnectionPool(host='example.com', port=443):    <- 2. der Pool: Ziel-Host und Port
Max retries exceeded with url: /                      <- 3. der Text der Hülle und der Pfad
(Caused by ProxyError('Unable to connect to proxy',   <- 4. die echte Ursache, die äußerste zuerst
    OSError('Tunnel connection failed: 403 Forbidden')))
An Teil 2 scheitern die meisten. Bei einer https://-URL zeigt die Pool-Zeile das Ziel, auch wenn die Anfrage über einen Proxy läuft; die Proxy-Adresse erscheint, wenn überhaupt, nur in Teil 4. Bei einer einfachen http://-URL über einen Proxy ist es umgekehrt: Die Pool-Zeile zeigt den Proxy, und Teil 3 enthält die vollständige Ziel-URL, etwa HTTPConnectionPool(host='127.0.0.1', port=8083): Max retries exceeded with url: http://example.com/.
Warum steht dort „max retries“, obwohl Sie nie Wiederholungen eingestellt haben?
Requests wiederholt fehlgeschlagene Verbindungen standardmäßig nicht. Im Quelltext von requests/adapters.py steht DEFAULT_RETRIES = 0, und der Adapter macht daraus Retry(0, read=False). Die urllib3-Dokumentation zur Retry-Klasse hält fest, dass Fehler in MaxRetryError verpackt werden, sofern Wiederholungen nicht mit retries=False abgeschaltet sind. Null Wiederholungen gelten nicht als abgeschaltet, deshalb erscheint schon ein einziger fehlgeschlagener Versuch als „Max retries exceeded“.
Mehr Wiederholungen beheben die Ursache nicht. Ein falsch geschriebener Proxy-Name, ein falscher Port oder ein abgelehnter Tunnel scheitert jedes Mal auf dieselbe Weise. In unserem Test scheiterte eine nicht erreichbare Adresse mit 2 Sekunden Verbindungs-Timeout in der Standardeinstellung nach 2 Sekunden, mit zwei Wiederholungen und kurzem Backoff nach 7 Sekunden. Wiederholungen helfen nur bei kurzen Netzaussetzern.
Wie lesen Sie die Fehlermeldung Schritt für Schritt?
Lesen Sie die Meldung von außen nach innen:
- Suchen Sie die Requests-Ausnahme.
ProxyErrorbedeutet, dass der Fehler auf dem Weg zum Proxy oder beim Proxy selbst auftrat. - Lesen Sie die Pool-Zeile. Bei
https://-Zielen sindhostundportdas Ziel. Port 443 über einen HTTP-Proxy bedeutet, dass die Anfrage durch einen CONNECT-Tunnel läuft. - Lesen Sie die erste Klasse nach
Caused by. Das ist die Diagnose von urllib3:NameResolutionError,NewConnectionError,ConnectTimeoutError,SSLErroroderProxyError. - Lesen Sie den innersten Text.
Failed to resolve 'name',[Errno 111] Connection refusedunter Linux,[WinError 10061]unter Windows,CERTIFICATE_VERIFY_FAILEDoderTunnel connection failed: 403 Forbidden. Einhost=an dieser Stelle kann der Proxy sein. - Achten Sie darauf, wie lange der Aufruf gedauert hat. Ein Fehler nach genau Ihrem Verbindungs-Timeout (oder einem Vielfachen davon) ist ein Timeout; ein schnellerer ist eine Ablehnung oder ein zurückgewiesener Tunnel. Unter Windows dauerte eine abgelehnte Verbindung in unseren Tests etwa zwei Sekunden pro Adresse, und
localhostvier (erst IPv6, dann IPv4).
HTTPSConnectionPool-Fehler: Was der Teil „Caused by“ verrät
Alle folgenden Fehlertexte haben wir unter Python 3.13 mit Requests 2.34.2 und urllib3 2.8.0 über einen lokalen Test-Proxy erzeugt. Lange Teile sind mit ... gekürzt; der Windows-Fehlertext hängt außerdem von der Systemsprache ab.
| Caused by (innerster Teil) | Requests-Ausnahme | Was passiert ist | Zuerst prüfen |
|---|---|---|---|
NameResolutionError(... Failed to resolve 'no-such-host.invalid' ...) | ConnectionError | Der Zielname wurde nicht aufgelöst | Schreibweise der URL, DNS, VPN |
NewConnectionError(... [Errno 111] or [WinError 10061] ...) | ConnectionError | Auf diesem Port lauscht nichts | Läuft der Dienst, stimmt der Port |
ConnectTimeoutError(... 'Connection to 10.255.255.1 timed out. (connect timeout=2)') | ConnectTimeout | Keine TCP-Verbindung innerhalb des Timeouts | Adresse, Firewall, Timeout-Wert |
SSLError(SSLCertVerificationError(... CERTIFICATE_VERIFY_FAILED ...)) | SSLError | Dem Zertifikat wird nicht vertraut | certifi, Stammzertifikat der Firma |
ProxyError('Unable to connect to proxy', NewConnectionError(...)) | ProxyError | Der Proxy-Port hat die Verbindung abgelehnt | Proxy-Host und -Port, lokale Firewall |
ProxyError('Unable to connect to proxy', NameResolutionError(... 'pr.proxynet.invalid' ...)) | ProxyError | Der Proxy-Name wurde nicht aufgelöst | Tippfehler im Proxy-Host |
ProxyError('Unable to connect to proxy', ConnectTimeoutError(...)) | ProxyError | Der Proxy hat nicht rechtzeitig geantwortet | Proxy-Adresse, ausgehende Regeln für diesen Port |
ProxyError(..., OSError('Tunnel connection failed: 403 Forbidden')) | ProxyError | Der Proxy hat den CONNECT-Tunnel abgelehnt | Zielport, Proxy-Typ und -Port, Freigaberegeln |
ProxyError(..., OSError('Tunnel connection failed: 407 Proxy Authentication Required')) | ProxyError | Der Proxy verlangt gültige Zugangsdaten | Siehe Proxy-Authentifizierung |
ProxyError(..., OSError('Tunnel connection failed: 502 Bad Gateway')) | ProxyError | Der Proxy hat das Ziel nicht erreicht | Ziel-Host und -Port |
ProxyError('... Your proxy appears to only use HTTP and not HTTPS ...', SSLError(... WRONG_VERSION_NUMBER ...)) | ProxyError | Die Proxy-URL beginnt mit https:// | http:// schreiben |
Drei Details stehen nicht in der Tabelle. Ein Proxy, der in ein Timeout läuft, wirft ProxyError, except ConnectTimeout bekommt ihn also nie zu sehen. Ein Lese-Timeout wird nicht verpackt: Es kommt als ReadTimeout mit dem Text Read timed out. (read timeout=3). Und eine einfache http://-URL über einen Proxy mit falschem Passwort wirft gar nichts; Sie erhalten eine Antwort mit dem Status 407.
Was bedeutet „ProxyError: Cannot connect to proxy“?
Cannot connect to proxy. (urllib3 1.26) und Unable to connect to proxy (urllib3 2.x) sind derselbe Fehler. Beide können auf einem Rechner vorkommen: pip 25.x bringt urllib3 1.26.20 mit, während eine frische Requests-Installation urllib3 2.8.0 nachzieht. Lesen Sie das zweite Argument, nicht den Wortlaut:
NewConnectionError: Auf diesem Proxy-Port lauscht nichts, oder eine lokale Firewall blockiert ihn. Kopieren Sie Host und Port erneut aus dem Panel.NameResolutionError: Der Host-Name des Proxys ist falsch geschrieben, oder Ihr DNS kann ihn nicht auflösen.ConnectionResetError(Errno 104unter Linux,WinError 10054unter Windows): Der Proxy oder ein Gerät auf dem Weg hat die Verbindung geschlossen.OSError('Tunnel connection failed: ...'): Der Proxy hat geantwortet, aber den Tunnel nicht geöffnet; der Statuscode ist seine Antwort.
Die Browser-Variante, „Proxyserver reagiert nicht“, behandelt Proxy-Fehler: Was tun, wenn der Proxyserver nicht reagiert?
Tunnel connection failed: 403 Forbidden: Warum lehnt der Proxy CONNECT ab?
Eine https://-Anfrage über einen HTTP-Proxy beginnt mit CONNECT example.com:443. Der Proxy öffnet eine TCP-Verbindung zum Ziel und reicht verschlüsselte Bytes durch; die Seite selbst sieht er nie. Nach RFC 9110, Abschnitt 9.3.6 bedeutet jede Antwort außer 2xx, dass kein Tunnel zustande kam. Das Python-Modul http.client liest diese Antwort und schreibt Tunnel connection failed.
Das 403 ist die Entscheidung des Proxys; das Ziel hat Ihre Anfrage nie gesehen. Der RFC empfiehlt, dass Proxys CONNECT auf bekannte Ports oder eine Liste sicherer Ziele beschränken, weil ein Tunnel zu Port 25 Spam weiterleiten könnte. Häufige Gründe:
- Der Zielport ist nicht erlaubt.
https://example.com:8443/kann scheitern, währendhttps://example.com/funktioniert. - Eine Freigabeliste. Firmen-Proxys und manche Hosting-Plattformen erlauben nur freigegebene Domains. Fragen Sie das IT-Team oder lesen Sie die Dokumentation der Plattform; umgehen Sie die Richtlinie nicht.
- Falscher Proxy-Typ oder falscher Port, zum Beispiel ein Port, der für ein anderes Protokoll gedacht ist.
- Regeln des Anbieters. Ein Anbieter kann Tunnel zu bestimmten Zielen ablehnen; seine Dokumentation nennt die Statuscodes, die er dafür nutzt.
Ein 403 der Zielseite kommt als normale Antwort mit einer Seite an; diesen Fall behandelt HTTP-Statuscodes beim Web Scraping. Ein 407 beim Tunnel bedeutet, dass der Proxy Zugangsdaten verlangt.
Soll die Proxy-URL mit http:// oder https:// beginnen?
Im Dictionary proxies ist der Schlüssel das Schema des Ziels und der Wert der Weg zum Proxy. Das Beispiel in der Requests-Dokumentation ordnet 'https' den Wert 'http://10.10.1.10:1080' zu. Die meisten Proxys sprechen einfaches HTTP und öffnen für verschlüsselte Websites einen CONNECT-Tunnel (siehe unsere Seite HTTPS-Proxy), daher bekommen beide Schlüssel einen Wert mit http://:
proxies = {
    "http": "http://user:pass@pr.proxynet.io:8000",
    "https": "http://user:pass@pr.proxynet.io:8000",  # auch hier http://
}
Steht https:// im Wert, öffnet urllib3 2.x eine TLS-Verbindung zum Proxy selbst, ein einfacher HTTP-Proxy antwortet mit Bytes ohne TLS, und Sie erhalten WRONG_VERSION_NUMBER mit dem Hinweis Your proxy appears to only use HTTP and not HTTPS. Die urllib3-Seite zu diesem Fehler nennt dieselbe Lösung, auch für eine falsch gesetzte Variable HTTPS_PROXY.
Zwei verwandte Punkte:
- SOCKS. Installieren Sie
requests[socks]. Mitsocks5://löst Ihr Rechner den Namen auf; in unserem Test scheiterte ein falscher Name deshalb, bevor der Proxy überhaupt kontaktiert wurde. Mitsocks5h://löst der Proxy ihn auf (SOCKS und HTTP Proxy im Vergleich, SOCKS5-Proxy). - Umgebungsvariablen. Die Requests-Seite zur fortgeschrittenen Nutzung warnt, dass Proxys aus der Umgebung
session.proxiesüberschreiben können, und empfiehltproxies=bei jeder Anfrage. Die Variablen erklärt Proxy-Nutzung mit wget.
Was passiert ohne Timeout? ConnectTimeout und ReadTimeout
Requests hat kein Standard-Timeout: Ohne timeout= kann ein Aufruf minutenlang hängen und liefert Ihnen keinen Fehler, den Sie lesen könnten. Übergeben Sie ein Tupel wie timeout=(3.05, 20): erst das Verbindungs-Timeout, dann das Lese-Timeout, in Sekunden. Die Dokumentation empfiehlt ein Verbindungs-Timeout knapp über einem Vielfachen von 3, dem Standardfenster für TCP-Neuübertragungen.
Die beiden Timeouts scheitern unterschiedlich:
- ConnectTimeout: keine TCP-Verbindung in der vorgegebenen Zeit. Es kommt verpackt in „Max retries exceeded“, und die API-Referenz bezeichnet es als sicher wiederholbar.
- ReadTimeout: verbunden, aber innerhalb des Lese-Timeouts keine Daten. Es wird nicht verpackt, und der Server hat die Anfrage womöglich schon verarbeitet; ein wiederholter POST kann die Arbeit also doppelt ausführen.
Das Verbindungs-Timeout gilt pro IP-Adresse, ein Name mit IPv4- und IPv6-Adressen kann die Wartezeit also verdoppeln. Das Lese-Timeout ist die Pause zwischen zwei Bytes, keine Grenze für den ganzen Download. Die Standardwerte anderer Bibliotheken stehen in HTTPX, Requests und AIOHTTP im Vergleich.
Derselbe Fehler in pip: „Retrying ... after connection broken by“
pip bringt eigene Kopien von Requests und urllib3 mit, deshalb scheitert pip install aus denselben Gründen. Die pip-Dokumentation nennt die Standardwerte: --retries 5 und --timeout 15 Sekunden. Wir haben pip 26.2.1 mit --retries 2 über einen lokalen Proxy laufen lassen, der jedes CONNECT mit 403 ablehnt:
WARNING: Retrying (Retry(total=1, connect=None, read=None, redirect=None, status=None)) after connection broken by 'OSError('Tunnel connection failed: 403 Forbidden')': /simple/six/
WARNING: Retrying (Retry(total=0, connect=None, read=None, redirect=None, status=None)) after connection broken by 'OSError('Tunnel connection failed: 403 Forbidden')': /simple/six/
ERROR: Could not find a version that satisfies the requirement six (from versions: none)
ERROR: No matching distribution found for six
Das Paket existiert; pip hat den Index nie erreicht. Die Ursache steht in den WARNING-Zeilen. pip 25.2 gab dieselbe Warnung mit dem Wortlaut von urllib3 1.26 aus: ProxyError('Cannot connect to proxy.', ...).
Bei CERTIFICATE_VERIFY_FAILED hinter einem Firmen-Proxy, der TLS inspiziert, übergeben Sie das Stammzertifikat der Firma mit --cert; --trusted-host schaltet die Prüfung ab und ist nur der letzte Ausweg. Wie Sie den Proxy für pip einstellen, steht in Linux-Proxy-Einstellungen.
Ein Python-Skript, das die Ursache benennt
Das Skript macht aus einer Ausnahme eine einzige Zeile: was fehlgeschlagen ist und was Sie prüfen sollten. Es
- wiederholt nur fehlgeschlagene Verbindungen, und zwar zweimal;
- behält
read=False: In unserem Test machteread=0aus einemReadTimeouteinen verpacktenConnectionError; - setzt
other=0: Ohne diese Einstellung wurde ein mit403oder407abgelehnter Tunnel dreimal versucht; - übergibt bei jeder Anfrage
proxies=undtimeout=(3.05, 20); - fängt
ProxyError,SSLErrorundConnectTimeoutvor ihrer ElternklasseConnectionErrorab.
Wiederholungen nach Statuscode sind eine eigene Ebene (HTTP-Statuscodes beim Web Scraping), ebenso die Rotation (Proxys in Python rotieren).
"""Findet die echte Ursache hinter "Max retries exceeded with url" und sagt, was zu prüfen ist."""
import re
import ssl
import time

import requests
from requests.adapters import HTTPAdapter
from urllib3.exceptions import (
    ConnectTimeoutError,
    NameResolutionError,
    NewConnectionError,
    ProxyError as Urllib3ProxyError,
)
from urllib3.util import Retry

PROXY = "http://user:pass@pr.proxynet.io:8000"  # http:// auch für https://-Ziele
TIMEOUT = (3.05, 20)  # Sekunden: (Verbindung, Lesen)


def make_session():
    """Eine Session, die fehlgeschlagene Verbindungen zweimal wiederholt und sonst nichts."""
    retry = Retry(
        total=2,
        connect=2,      # DNS-Fehler, abgelehnte Verbindungen und Verbindungs-Timeouts
        read=False,     # ReadTimeout bleibt ReadTimeout: Der Server hat die Anfrage vielleicht schon
        other=0,        # ein Proxy, der den Tunnel abgelehnt hat, lehnt ihn wieder ab
        status=0,       # Wiederholungen nach Statuscode gehören in eine andere Ebene
        backoff_factor=0.5,
    )
    adapter = HTTPAdapter(max_retries=retry)
    session = requests.Session()
    session.mount("http://", adapter)
    session.mount("https://", adapter)
    return session


def causes(exc):
    """Die Ausnahme und jeder darin verpackte Fehler, der äußerste zuerst."""
    chain = []
    while exc is not None and all(exc is not seen for seen in chain):
        chain.append(exc)
        inner = None
        for candidate in (getattr(exc, "reason", None), getattr(exc, "original_error", None),
                          exc.__cause__, exc.__context__, *exc.args[:2]):
            if isinstance(candidate, BaseException):
                inner = candidate
                break
        exc = inner
    return chain


def explain(exc):
    """Eine Zeile: was fehlgeschlagen ist, auf welcher Seite, und was zuerst zu prüfen ist."""
    chain = causes(exc)
    text = " | ".join(str(e) for e in chain)
    side = "proxy" if any(isinstance(e, Urllib3ProxyError) for e in chain) else "target"

    tunnel = re.search(r"Tunnel connection failed: (\d{3})", text)
    if tunnel:
        code = tunnel.group(1)
        if code == "407":
            return "proxy asked for credentials (407): check user:pass or the IP whitelist"
        if code == "403":
            return "proxy refused the CONNECT tunnel (403): check the target port and the proxy's allow rules"
        return f"proxy was reached but could not reach the target ({code}): check the target host and port"
    if "appears to only use HTTP" in text:
        return "proxy URL starts with https:// but the proxy speaks plain HTTP: write http://"
    if any(isinstance(e, NameResolutionError) for e in chain):
        host = re.search(r"Failed to resolve '([^']+)'", text)
        return f"{side} name {host.group(1) if host else ''} does not resolve: check spelling, DNS and VPN"
    if any(isinstance(e, ssl.SSLCertVerificationError) for e in chain):
        return "certificate not trusted: update certifi or set REQUESTS_CA_BUNDLE to your company root CA"
    if isinstance(exc, requests.exceptions.ReadTimeout):
        return "connected, but no answer within the read timeout: the server may have the request"
    if any(isinstance(e, NewConnectionError) for e in chain):
        return f"{side} refused the connection: wrong port, service down, or a firewall rejects it"
    if any(isinstance(e, ConnectTimeoutError) for e in chain):
        return f"no TCP connection to the {side} within the connect timeout: check address, port, firewall"
    return f"unrecognised, read the innermost error: {chain[-1]!r}"


def fetch(session, url, proxy=PROXY):
    """Ruft eine URL per GET ab und gibt den Status aus, oder die Diagnose, wenn die Anfrage scheitert."""
    proxies = {"http": proxy, "https": proxy} if proxy else None  # pro Anfrage: Umgebungsvariablen überschreiben es nicht
    start = time.monotonic()
    try:
        resp = session.get(url, proxies=proxies, timeout=TIMEOUT)
    except requests.exceptions.ProxyError as exc:      # vor ConnectionError: Es ist eine Unterklasse
        kind, error = "ProxyError", exc
    except requests.exceptions.SSLError as exc:        # ebenfalls ein ConnectionError
        kind, error = "SSLError", exc
    except requests.exceptions.ConnectTimeout as exc:  # ConnectionError und Timeout zugleich
        kind, error = "ConnectTimeout", exc
    except requests.exceptions.ReadTimeout as exc:     # nie in "Max retries exceeded" verpackt
        kind, error = "ReadTimeout", exc
    except requests.exceptions.ConnectionError as exc:
        kind, error = "ConnectionError", exc
    else:
        print(f"{'OK':<16}{time.monotonic() - start:6.2f}s  {url}  HTTP {resp.status_code}")
        return resp
    print(f"{kind:<16}{time.monotonic() - start:6.2f}s  {url}\n{'':<24}{explain(error)}")
    return None


if __name__ == "__main__":
    session = make_session()
    for url in ["https://httpbin.org/ip", "https://example.com/"]:
        fetch(session, url)
In urllib3 2.x ist NameResolutionError eine Unterklasse von NewConnectionError, und diese wiederum eine Unterklasse von ConnectTimeoutError; deshalb prüft explain() die speziellste Klasse zuerst. Das Skript braucht nur pip install requests.
So sieht die Ausgabe aus
Wir haben fetch() unter Windows 11 für jeden Fall einmal ausgeführt: mit einem lokalen Test-Proxy (richtiges und falsches Passwort, geschlossener Port, falsch geschriebener Name, Schema https://), mit einem zweiten, der jedes CONNECT ablehnt, und mit echten Hosts für die Zertifikats- und Timeout-Fälle. Das Lese-Timeout lag bei 5 Sekunden:
OK                0.77s  https://httpbin.org/ip  HTTP 200
ProxyError        0.02s  https://httpbin.org/ip
                        proxy asked for credentials (407): check user:pass or the IP whitelist
ProxyError        0.00s  https://example.com/
                        proxy refused the CONNECT tunnel (403): check the target port and the proxy's allow rules
ProxyError        0.02s  https://no-such-host.invalid/
                        proxy was reached but could not reach the target (502): check the target host and port
ProxyError        7.10s  https://httpbin.org/ip
                        proxy refused the connection: wrong port, service down, or a firewall rejects it
ProxyError        1.02s  https://httpbin.org/ip
                        proxy name pr.proxynet.invalid does not resolve: check spelling, DNS and VPN
ProxyError        0.21s  https://httpbin.org/ip
                        proxy URL starts with https:// but the proxy speaks plain HTTP: write http://
SSLError          0.63s  https://self-signed.badssl.com/
                        certificate not trusted: update certifi or set REQUESTS_CA_BUNDLE to your company root CA
ConnectTimeout   10.16s  http://10.255.255.1/
                        no TCP connection to the target within the connect timeout: check address, port, firewall
ReadTimeout       5.02s  http://127.0.0.1:8082/
                        connected, but no answer within the read timeout: the server may have the request
ConnectionError  13.12s  http://localhost:8083/
                        target refused the connection: wrong port, service down, or a firewall rejects it
Die abgelehnten Tunnel scheiterten in Millisekunden, weil other=0 sie stoppte. Der geschlossene Proxy-Port brauchte drei Versuche von je etwa zwei Sekunden plus eine Sekunde Backoff, beim Verbindungs-Timeout waren es dreimal 3,05 Sekunden plus Backoff, bei localhost 13 Sekunden, weil jeder Versuch erst IPv6 und dann IPv4 probierte. Das 502 stammte von unserem Test-Proxy, der das Ziel nicht auflösen konnte.
Wo Ihnen dieser Fehler begegnet
- Scraping über einen Proxy: Proxy-Fehler zeigen sich hier noch vor jedem Statuscode (Data Scraping).
- CI- und Docker-Builds hinter einem Firmen-Proxy: Builds übernehmen die Proxy-Einstellungen des Hosts oft nicht, und
localhostist dort der Container (Linux-Proxy-Einstellungen). - API-Integrationen mit fester Ausgangs-IP: Eine Tunnel-Ablehnung sieht aus wie ein Ausfall der API (Statische IP für APIs).
- Test eines neuen Proxys: Senden Sie eine einzelne Anfrage mit Timeout, bevor Sie einen ganzen Job starten (So testen Sie einen Proxy).
- Browserautomatisierung: Derselbe Tunnelfehler erscheint als
ERR_TUNNEL_CONNECTION_FAILED(Playwright mit Proxy). - Firmennetze: Eine Firewall und ein Proxy filtern beide Verbindungen (Proxy und Firewall).
Häufige Fehler
- Die Zahl der Wiederholungen erhöhen. Eine dauerhafte Ursache bleibt dauerhaft; Sie warten nur länger.
- Dem Ziel die Schuld geben, weil sein Name in der Pool-Zeile steht. Bei
https://-URLs erscheint der Proxy nur in den Klammern. - Eine alte Variable
HTTPS_PROXYvergessen. Sie kannsession.proxiesstillschweigend ersetzen. verify=Falsein der Produktion stehen lassen. Die Requests-Dokumentation warnt, dass Sie sich damit Man-in-the-Middle-Angriffen aussetzen. Aktualisieren Sie certifi oder setzen SieREQUESTS_CA_BUNDLE; für einen lokalen Debugging-Proxy siehe MITM-Proxy.ConnectionErrorzuerst abfangen. Es verschlucktProxyError,SSLErrorundConnectTimeout.- Tunnel-
403und407verwechseln. Das eine ist eine Regel, das andere eine Frage der Zugangsdaten. - Die letzte Zeile von pip lesen. Die Ursache steht in den
WARNING-Zeilen darüber.
Entscheidungshilfe
| Was Sie sehen | Was zu tun ist |
|---|---|
NameResolutionError in Caused by | Den fehlerhaften Namen korrigieren (Proxy-Host oder URL); keine Wiederholungen |
ProxyError mit NewConnectionError | Proxy-Host und -Port neu kopieren; lokale Firewall prüfen |
Tunnel connection failed: 403 | Zielport, Proxy-Typ und -Port, Freigaberegeln prüfen |
Tunnel connection failed: 407 | Zugangsdaten oder IP-Whitelist prüfen |
SSLError: CERTIFICATE_VERIFY_FAILED | certifi aktualisieren oder REQUESTS_CA_BUNDLE setzen (pip: --cert) |
| Aufrufe hängen oder laufen ab und zu in ein Timeout | timeout=(3.05, 20) plus ein Retry nur für Verbindungen |
| pip meldet „No matching distribution found“ | Die Zeile WARNING: Retrying lesen |
Häufige Fragen
Behebt eine höhere Zahl an Wiederholungen „Max retries exceeded“?
Nur wenn das Netz kurz aussetzt. Bei einem Namen, der sich nicht auflösen lässt, einem geschlossenen Port oder einem abgelehnten Tunnel scheitert jede Wiederholung auf dieselbe Weise. Lesen Sie zuerst den Teil Caused by.
Welches Standard-Timeout hat Python Requests?
Keines: Ohne timeout= kann eine Anfrage unbegrenzt warten. Geben Sie jedem Aufruf ein Tupel (connect, read) mit.
Wird das Timeout in Requests in Sekunden oder Millisekunden angegeben?
In Sekunden. Eine Gleitkommazahl wie 3.05 funktioniert; eine einzelne Zahl setzt beide Phasen, ein Tupel wie (3.05, 20) setzt sie getrennt.
Kann ich bei CERTIFICATE_VERIFY_FAILED verify=False verwenden?
Nur für einen schnellen lokalen Test, denn damit kann jeder auf dem Weg den Verkehr mitlesen oder verändern. Die dauerhafte Lösung ist ein aktuelles certifi oder, hinter einem Firmen-Proxy, der TLS inspiziert, dessen Stammzertifikat in REQUESTS_CA_BUNDLE.
Warum meldet pip „No matching distribution found“, obwohl das Paket existiert?
pip konnte den Paketindex nicht erreichen und hat deshalb keine Versionen gefunden. Die Zeilen WARNING: Retrying ... after connection broken by darüber nennen die echte Ursache, etwa Tunnel connection failed: 403 Forbidden.
Warum erhalte ich diesen Fehler beim Aufruf von localhost:8000?
Auf diesem Port lauscht nichts: Der Server läuft nicht, nutzt einen anderen Port, oder Ihr Code läuft in Docker, wo localhost der Container ist. Der innerste Fehler lautet [Errno 111] oder [WinError 10061]. Wie Sie herausfinden, welches Programm einen Port belegt, erklärt Was ist Port 8080?
Fazit
„Max retries exceeded with url“ ist eine Hülle: Die Ursache steht nach Caused by, und die Meldung erscheint schon nach einem Versuch, weil Requests standardmäßig nicht wiederholt. Unterscheiden Sie bei Proxy-Fehlern einen Fehler auf dem Weg zum Proxy von einem Tunnel, den der Proxy abgelehnt hat, und behalten Sie http:// in der Proxy-URL. Geben Sie jeder Anfrage ein Timeout-Tupel mit und wiederholen Sie nur Verbindungsfehler. Testen Sie eine neue Einrichtung zuerst mit einer einzelnen Anfrage (so testen Sie einen Proxy), und vergleichen Sie die Optionen auf unserer Seite zu Proxy-Diensten.


