


































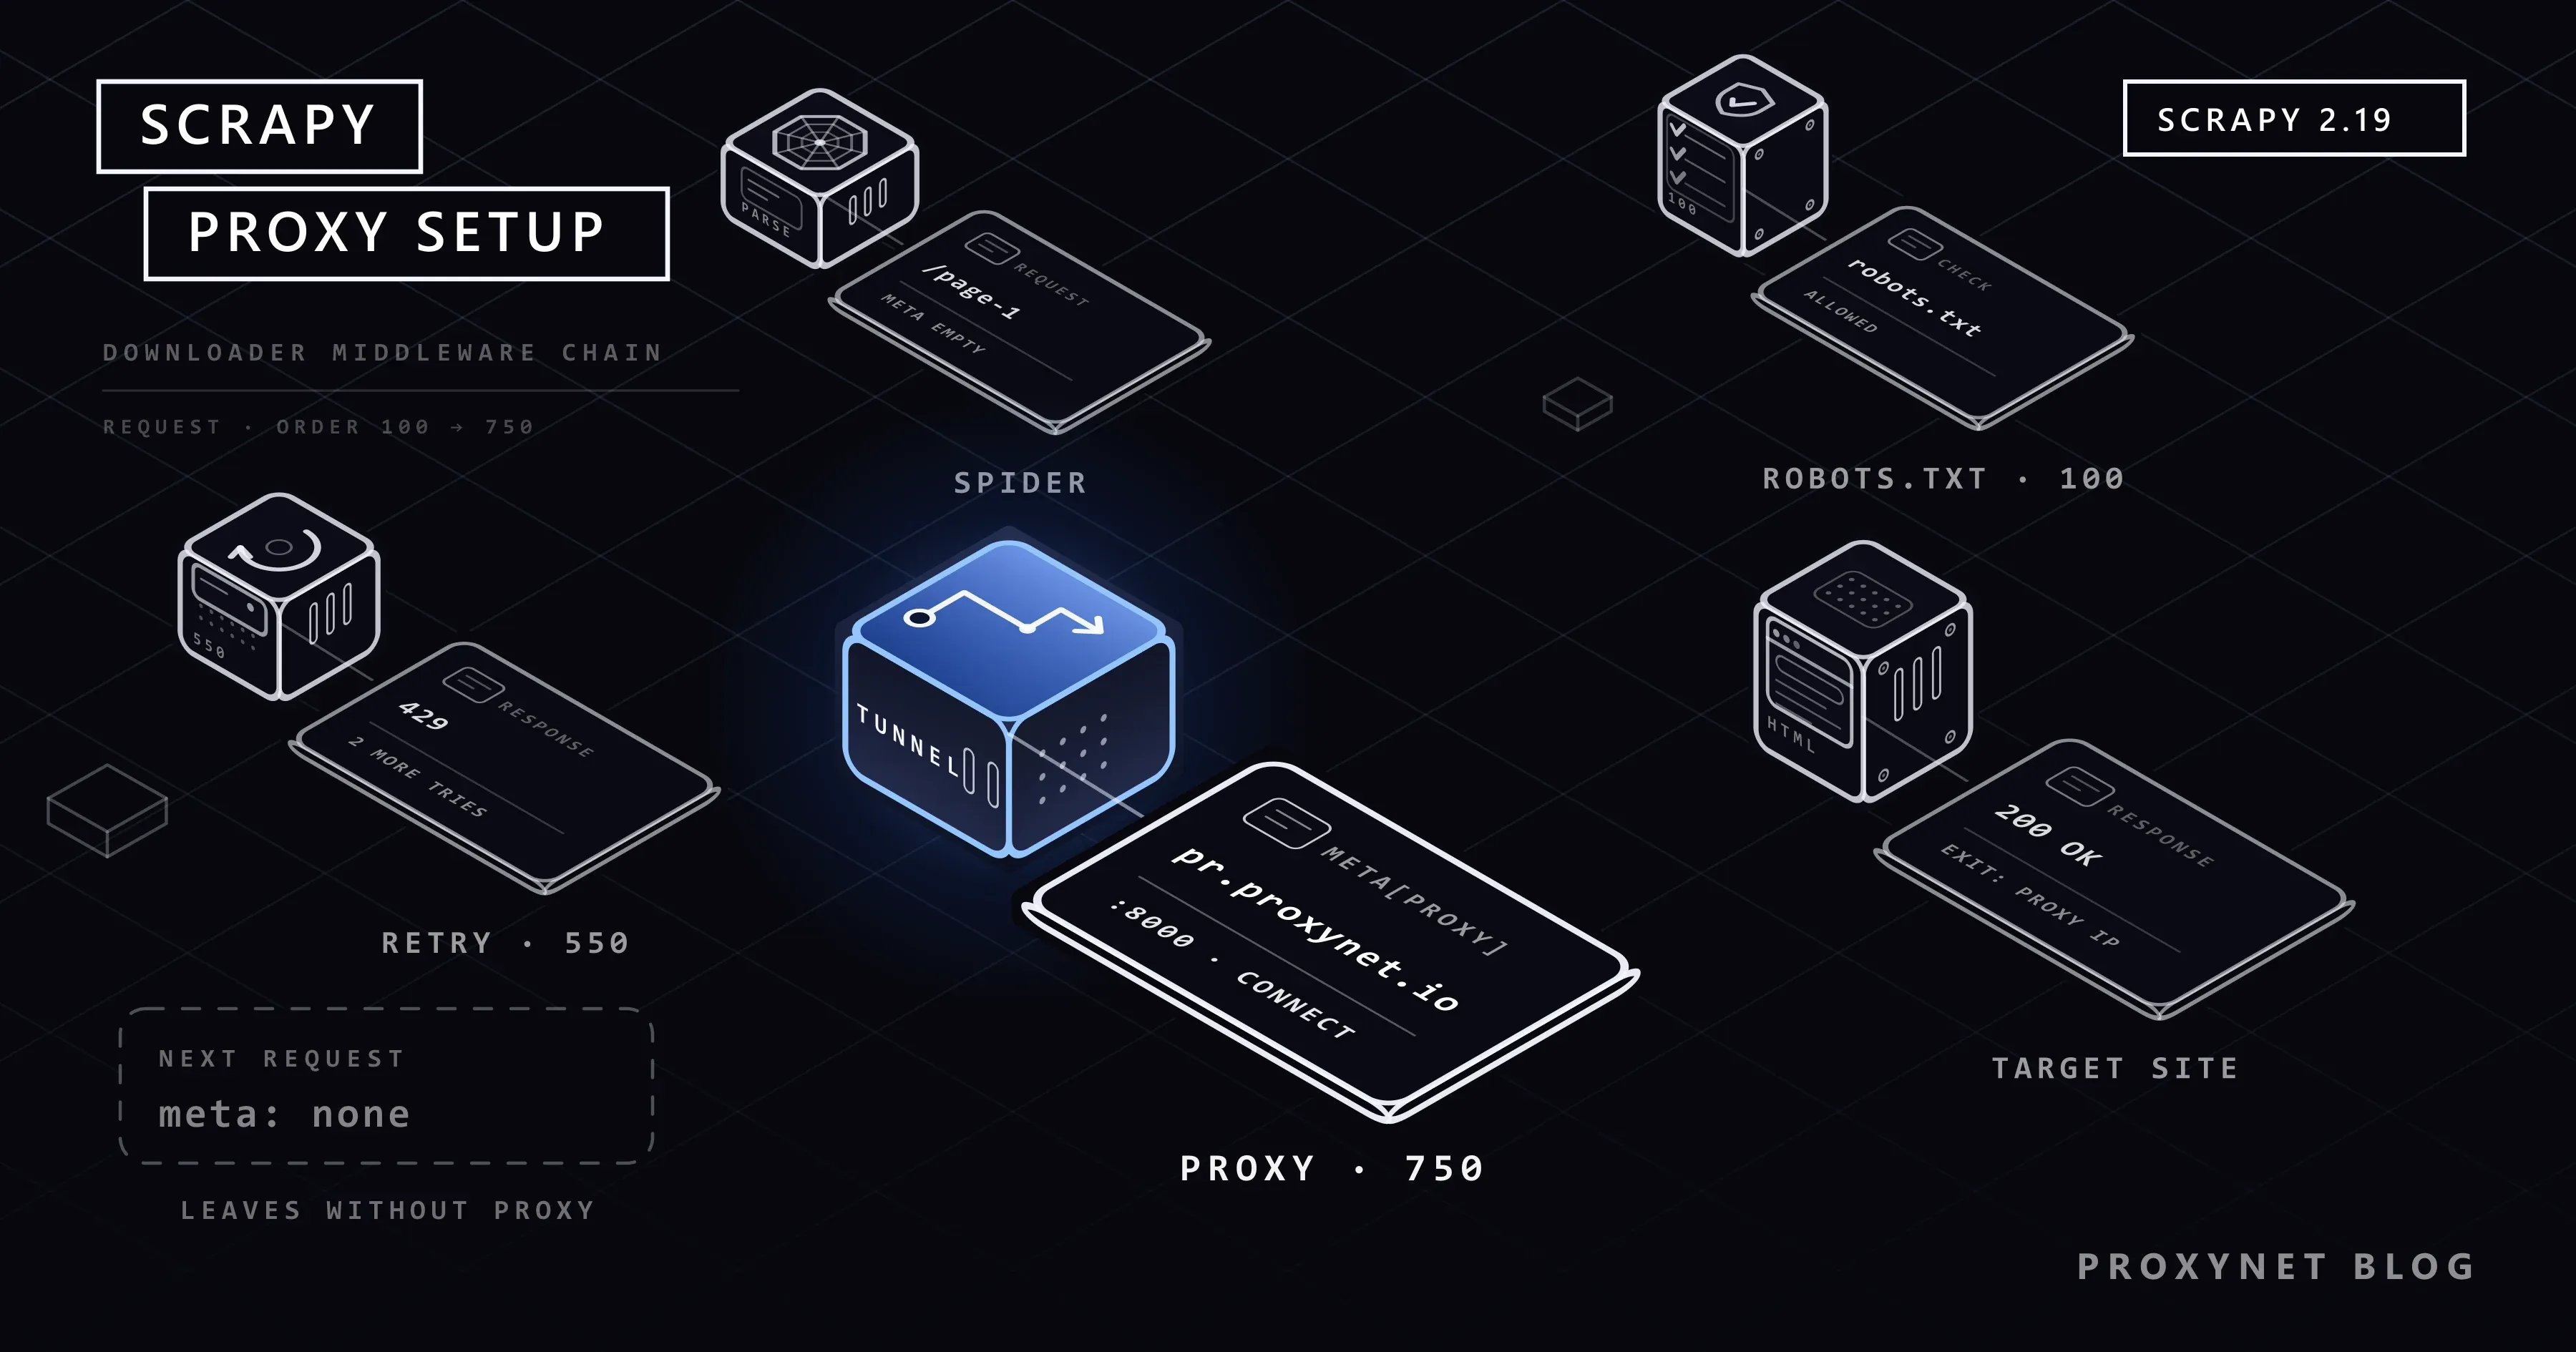
Ein Skript mit Requests und BeautifulSoup läuft bei hundert Seiten ohne Probleme. Bei zehntausend Seiten ändert sich die Aufgabe selbst: Sie müssen verwalten, welche Adresse schon gecrawlt wurde, welche einen Fehler geliefert hat und wiederholt wird, wie viele Anfragen gleichzeitig an dieselbe Website gehen und wohin die Daten geschrieben werden. Scrapy ist ein Python-Framework, das all das fertig mitbringt. Auch die Proxy-Einstellung sitzt innerhalb dieser Struktur, in einer der Schichten, die jede Anfrage durchläuft.
In diesem Beitrag zeigen wir zuerst kurz, was Scrapy ist und wie es installiert wird. Danach geht es um das eigentliche Thema: die drei Wege, einen Proxy festzulegen, die Authentifizierung, den Unterschied zwischen einem rotierenden Gateway mit einem einzigen Endpunkt und einer eigenen Proxy-Liste, die Geschwindigkeitssteuerung mit DOWNLOAD_DELAY und AutoThrottle sowie das Verhalten von Scrapy bei den Antworten 429 und 503. Alle Beispiele haben wir mit Scrapy 2.19 und Python 3.13 ausgeführt, gegen die Übungsseiten von toscrape.com und einen lokalen Test-Proxy.
Was ist Scrapy und wofür wird es genutzt?
Scrapy ist ein Python-Framework, mit dem Websites gecrawlt und strukturierte Daten aus ihren Seiten gewonnen werden. Der Unterschied zu einer Bibliothek: Requests gibt Ihnen ein Werkzeug, um eine einzelne Anfrage zu senden, die Schleife bauen Sie selbst. In Scrapy ist die Schleife das Framework. Sie schreiben nur eine Klasse, die festlegt, bei welcher Adresse begonnen wird und was aus der gelieferten Seite entnommen wird. Diese Klasse heißt Spider.
Alles außerhalb des Spiders ist vorhanden: ein Scheduler, der Anfragen einreiht, ein Duplikatfilter, der dieselbe Adresse kein zweites Mal anfordert, ein asynchroner Downloader, Wiederholungsversuche, die robots.txt-Prüfung, die Begrenzung des Tempos und der Export nach JSON oder CSV. Für Selektoren werden CSS und XPath nebeneinander verwendet; den Unterschied erklären wir in CSS-Selektor oder XPath. Den Überblick über die Werkzeuge auf der Python- und der JavaScript-Seite finden Sie in Web Scraping: JavaScript oder Python?.
Wie wird Scrapy installiert?
Installieren Sie Scrapy nicht in das System-Python, sondern in eine virtuelle Umgebung, die zum Projekt gehört. Unter Windows lauten die Befehle:
python -m venv venv
venv\Scripts\activate
pip install scrapy
scrapy startproject kitaplik
cd kitaplik
scrapy genspider kitaplar books.toscrape.com
Unter macOS und Linux lautet die zweite Zeile source venv/bin/activate. Der Befehl startproject erzeugt ein Gerüst mit settings.py, middlewares.py und dem Ordner spiders/. Die Datei settings.py der aktuellen Vorlage bringt drei Einstellungen bereits mit: ROBOTSTXT_OBEY = True, CONCURRENT_REQUESTS_PER_DOMAIN = 1 und DOWNLOAD_DELAY = 1. Ein neues Projekt hält sich also standardmäßig an die robots.txt und sendet ungefähr eine Anfrage pro Sekunde an dieselbe Website. Löschen Sie diese Zeilen nicht, sondern bauen Sie Ihre Einstellungen darauf auf.
Füllen Sie die von genspider angelegte Datei wie unten. Der Spider liest die Buchkarten und folgt dem Link „nächste Seite“:
import scrapy


class KitaplarSpider(scrapy.Spider):
    name = "kitaplar"
    allowed_domains = ["books.toscrape.com"]
    start_urls = ["https://books.toscrape.com/"]

    def parse(self, response):
        for kart in response.css("article.product_pod"):
            yield {
                "baslik": kart.css("h3 a::attr(title)").get(),
                "fiyat": kart.css("p.price_color::text").get(),
                "adres": response.urljoin(kart.css("h3 a::attr(href)").get()),
            }

        sonraki = response.css("li.next a::attr(href)").get()
        if sonraki:
            yield response.follow(sonraki, callback=self.parse)
Der Befehl scrapy crawl kitaplar -O kitaplar.json startet den Spider und schreibt das Ergebnis in eine Datei. In unserem Lauf kamen von den ersten beiden Seiten 40 Datensätze. Behalten Sie die Zeile FEED_EXPORT_ENCODING = "utf-8" aus der Vorlage bei, damit Umlaute und Währungssymbole in der Datei nicht beschädigt werden.
Wie verarbeitet Scrapy eine Anfrage?
Um zu verstehen, wohin die Proxy-Einstellung gehört, muss man den Weg einer Anfrage kennen:
- Der Spider erzeugt ein
Request-Objekt (ausstart_urlsoderresponse.follow). - Die Engine übergibt die Anfrage an den Scheduler; der Duplikatfilter sortiert bereits angeforderte Adressen aus.
- Ist die Anfrage an der Reihe, durchläuft sie die Kette der Downloader-Middlewares. Jede Middleware trägt eine Ordnungszahl, und die Anfrage wandert von der kleineren zur größeren Zahl: die robots.txt-Prüfung hat 100, der Wiederholungsversuch 550,
HttpProxyMiddleware750. - Der Downloader schickt die Anfrage ins Netz. Enthält sie
meta["proxy"], wird die Verbindung nicht zum Ziel, sondern zum Proxy geöffnet; bei HTTPS-Adressen wird über den Proxy einCONNECT-Tunnel aufgebaut. - Die Antwort läuft in umgekehrter Reihenfolge durch dieselbe Kette zurück und erreicht die Callback-Funktion des Spiders (
parse). - Die von der Funktion erzeugten Datensätze gehen an die Item-Pipeline, neue Anfragen wieder an den Scheduler.
Daraus folgt: Der Proxy gehört zum dritten Schritt, nicht zum Parsing-Code des Spiders. Wer auch immer meta["proxy"] füllt, die Arbeit erledigt HttpProxyMiddleware. Diese Middleware ist standardmäßig aktiv; der Abschnitt HttpProxyMiddleware in der Scrapy-Dokumentation beschreibt ihr Verhalten.
Wie wird in Scrapy ein Proxy festgelegt?
Es gibt drei Wege, und alle drei füllen am Ende dasselbe Feld meta["proxy"].
| Methode | Wo sie steht | Geltungsbereich | Wann sie passt |
|---|---|---|---|
meta["proxy"] | Im Spider, in jedem Request | Nur diese Anfrage | Einige Anfragen über einen anderen Ausgang senden |
| Umgebungsvariable | In der Shell, http_proxy / https_proxy | Alle Anfragen, auch robots.txt | Schneller Versuch, Ausführung ohne Codeänderung |
| Downloader-Middleware | middlewares.py + settings.py | Alle Anfragen, auch robots.txt | Dauerhafte Projekteinrichtung, Rotation |
Pro Anfrage: das meta-Feld
import scrapy

PROXY = "http://user:pass@pr.proxynet.io:8000"


class KitaplarMetaSpider(scrapy.Spider):
    name = "kitaplar_meta"
    allowed_domains = ["books.toscrape.com"]

    async def start(self):
        yield scrapy.Request("https://books.toscrape.com/", meta={"proxy": PROXY})

    def parse(self, response):
        for kart in response.css("article.product_pod"):
            yield {"baslik": kart.css("h3 a::attr(title)").get()}

        sonraki = response.css("li.next a::attr(href)").get()
        if sonraki:
            # meta geht nicht von selbst auf die neue Anfrage über, es wird von Hand mitgegeben
            yield response.follow(sonraki, callback=self.parse, meta={"proxy": PROXY})
Diese Methode hat zwei Folgen, die leicht übersehen werden, und beide haben wir im Test gesehen. Erstens wird meta nicht von selbst an die nächste Anfrage weitergegeben. In dem Lauf, in dem wir meta beim Aufruf von response.follow weggelassen hatten, ging die erste Seite über den Proxy und die zweite direkt von unserer eigenen IP-Adresse aus. Zweitens ist die robots.txt-Anfrage von Scrapy keine Anfrage, die Sie geschrieben haben; sie trägt kein meta und geht ebenfalls ohne Proxy hinaus. Soll der gesamte Verkehr denselben Ausgang nehmen, verwenden Sie einen der beiden folgenden Wege.
Umgebungsvariable
HttpProxyMiddleware liest wie die Python-Standardbibliothek die Variablen http_proxy, https_proxy und no_proxy. Ohne eine Änderung am Code:
export https_proxy="http://user:pass@pr.proxynet.io:8000"
export http_proxy="$https_proxy"
scrapy crawl kitaplar
Enthält eine Anfrage zusätzlich meta["proxy"], hat dieser Wert Vorrang vor der Umgebungsvariable und ignoriert die no_proxy-Liste. Wie die Variablen unter Windows, macOS und Linux gesetzt werden und was es mit Groß- und Kleinschreibung auf sich hat, steht in Proxy-Nutzung mit wget; hier wiederholen wir es nicht.
Für das ganze Projekt: eine kleine Middleware
Für eine dauerhafte Einrichtung genügt eine Middleware aus wenigen Zeilen, die die Adresse aus der Umgebung liest, statt sie in den Code zu schreiben:
# kitaplik/middlewares.py
from scrapy.exceptions import NotConfigured


class TekProxyMiddleware:
    """Wendet die eine Proxy-Adresse aus den Einstellungen auf alle Anfragen an."""

    def __init__(self, adres):
        self.adres = adres

    @classmethod
    def from_crawler(cls, crawler):
        adres = crawler.settings.get("PROXY_ADRESI")
        if not adres:
            raise NotConfigured
        return cls(adres)

    def process_request(self, request):
        request.meta.setdefault("proxy", self.adres)
return None# kitaplik/settings.py
import os
PROXY_ADRESI = os.environ.get("PROXY_ADRESI")
DOWNLOADER_MIDDLEWARES = {
"kitaplik.middlewares.TekProxyMiddleware": 610,
}Dank setdefault bleibt ein meta["proxy"] erhalten, das Sie von Hand in eine Anfrage geschrieben haben. Ist PROXY_ADRESI nicht gesetzt, schaltet sich die Middleware ab und der Spider läuft ohne Proxy. Die Ordnungszahl muss kleiner als 750 sein; so schreiben zuerst Sie die Adresse, und die Zugangsdaten zerlegt danach HttpProxyMiddleware. In Beispielen für ältere Versionen sehen Sie die Signatur als process_request(self, request, spider); in der aktuellen Dokumentation gibt es den Parameter spider nicht, und das Beispiel läuft in dieser Form unter Scrapy 2.19.
Wie funktioniert die Authentifizierung?
HttpProxyMiddleware trennt den Teil user:pass aus der Adresse heraus, kodiert ihn mit Base64 und fügt ihn der Anfrage als Header Proxy-Authorization: Basic … hinzu. In meta["proxy"] bleibt die Adresse ohne Zugangsdaten zurück; Ihr Passwort sehen Sie im Log nicht. Enthält das Passwort @, : oder /, schreiben Sie es prozentkodiert (%40 statt @); die Middleware dekodiert den Wert vor dem Senden.
In unserem Versuch mit falschem Passwort schrieb Scrapy diese Zeile:
TunnelError: Could not open CONNECT tunnel with proxy 127.0.0.1:8120 [{'status': 407, 'reason': b'Proxy Authentication Required'}]Bei HTTPS-Adressen kommt 407 nicht als Antwort an, sondern als Ausnahme, weil der Tunnel nicht aufgebaut werden konnte. Zu beachten ist: Die Retry-Middleware wertet diese Ausnahme als vorübergehenden Fehler und versucht dieselbe Anfrage noch zweimal. Ein falsches Passwort wird durch Wiederholung nicht richtig; sehen Sie im Log TunnelError und 407, stoppen Sie den Crawl und korrigieren Sie die Zugangsdaten. Nutzen Sie statt Benutzername und Passwort eine IP-Whitelist, wird die Adresse ohne Zugangsdaten geschrieben, in der Form http://pr.proxynet.io:8000. Den Unterschied zwischen beiden Verfahren erklärt Proxy-Authentifizierung: User:Pass oder IP-Whitelist.
Braucht man für die Rotation eine Middleware?
Die Antwort hängt von der Art des Proxys ab, den Sie haben.
Mit einem rotierenden Gateway nicht. Bei einem Rotating-Proxy-Dienst verbinden Sie sich mit einem einzigen Endpunkt, und das Gateway wechselt die Ausgangs-IP. Auf der Scrapy-Seite genügt die TekProxyMiddleware von oben oder eine einzige Umgebungsvariable; eine Liste zu führen, die nächste Adresse zu wählen und defekte Adressen auszusortieren, ist nicht Ihre Aufgabe. Bei Crawls mit Residential-Proxy ist das der typische Aufbau. Wie die Rotationsmodi arbeiten, steht in unserem Beitrag zur IP-Rotation.
Haben Sie eine Liste fester Adressen (zum Beispiel einige Adressen vom Typ Datacenter-Proxy oder ISP-Proxy), übernimmt eine Middleware die Verteilung. Das folgende Beispiel verwendet die Adressen der Reihe nach, lässt eine Adresse, die mehrmals hintereinander Fehler liefert, eine Weile ruhen und schreibt die Zähler in die Scrapy-Statistik:
# kitaplik/middlewares.py
import time
from urllib.parse import urlsplit

from scrapy.exceptions import IgnoreRequest, NotConfigured


def anahtar(proxy_adresi):
    parca = urlsplit(proxy_adresi)
    return f"{parca.hostname}:{parca.port}"


class ProxyHavuzuMiddleware:
    """Weist jeder Anfrage den nächsten Proxy der Liste zu und lässt einen wiederholt fehlerhaften ruhen."""

    def __init__(self, adresler, hata_siniri, dinlenme, stats):
        self.adresler = adresler
        self.hata_siniri = hata_siniri
        self.dinlenme = dinlenme
        self.stats = stats
        self.sira = 0
        self.hatalar = {anahtar(a): 0 for a in adresler}
        self.kapali = {}  # Schlüssel -> Zeitpunkt der Wiederfreigabe

    @classmethod
    def from_crawler(cls, crawler):
        adresler = crawler.settings.getlist("PROXY_LISTESI")
        if not adresler:
            raise NotConfigured
        return cls(
            adresler,
            crawler.settings.getint("PROXY_HATA_SINIRI", 3),
            crawler.settings.getfloat("PROXY_DINLENME", 60.0),
            crawler.stats,
        )

    def sec(self):
        simdi = time.monotonic()
        for _ in self.adresler:
            adres = self.adresler[self.sira % len(self.adresler)]
            self.sira += 1
            if self.kapali.get(anahtar(adres), 0) <= simdi:
                return adres
        return None

    def process_request(self, request):
        adres = self.sec()
        if adres is None:
            self.stats.inc_value("proxy_havuzu/hepsi_dinleniyor")
            raise IgnoreRequest("Alle Proxys der Liste ruhen gerade")
        request.meta["proxy"] = adres
        request.meta["proxy_anahtari"] = anahtar(adres)
        return None

    def process_response(self, request, response):
        kim = request.meta.get("proxy_anahtari")
        if kim:
            self.hatalar[kim] = 0
            self.stats.inc_value(f"proxy_havuzu/yanit/{kim}")
        return response

    def process_exception(self, request, exception):
        kim = request.meta.get("proxy_anahtari")
        if not kim:
            return None
        self.hatalar[kim] += 1
        self.stats.inc_value(f"proxy_havuzu/hata/{kim}")
        if self.hatalar[kim] >= self.hata_siniri:
            self.kapali[kim] = time.monotonic() + self.dinlenme
            self.hatalar[kim] = 0
return None# kitaplik/settings.py
PROXY_LISTESI = [
"http://user:pass@203.0.113.10:8000",
"http://user:pass@203.0.113.11:8000",
"http://user:pass@203.0.113.12:8000",
]
DOWNLOADER_MIDDLEWARES = {
"kitaplik.middlewares.ProxyHavuzuMiddleware": 610,
}Wir haben das Beispiel mit drei lokalen Proxys ausprobiert, zwei davon in Betrieb, einer abgeschaltet. Alle hundert Datensätze kamen vollständig an; die Anfragen verteilten sich mit 6 und 5 auf die beiden funktionierenden Adressen, die abgeschaltete Adresse wurde nach drei Verbindungsfehlern aus dem Umlauf genommen, und Scrapy wiederholte die fehlgeschlagenen Anfragen über die anderen Adressen.
Die Ordnungszahl ist hier nicht beliebig. Im ersten Versuch hatten wir die Middleware auf 350 gesetzt, und der Fehlerzähler lief nie: Ausnahmen wandern in umgekehrter Reihenfolge durch die Kette, und wenn die Retry-Middleware auf 550 die Ausnahme abfängt und eine neue Anfrage zurückgibt, erfahren Middlewares mit kleinerer Zahl nichts davon. Ein Wert zwischen 550 und 750 (im Beispiel 610) erfüllt beide Bedingungen: Sie sehen den Fehler vor dem Wiederholungsversuch, und die Zugangsdaten verarbeitet HttpProxyMiddleware nach Ihnen. Wie dieselbe Aufgabe mit Requests von Hand gelöst wird, zeigt Proxys in Python rotieren.
Wie werden DOWNLOAD_DELAY und AutoThrottle eingestellt?
Ein Proxy ändert, von wo die Anfrage ausgeht; die Last auf dem Zielserver ändert er nicht. Die Last bestimmen diese Einstellungen:
# kitaplik/settings.py
USER_AGENT = "kitaplik-bot/1.0 (+https://ornek.com/bot)"
ROBOTSTXT_OBEY = True

CONCURRENT_REQUESTS = 8
CONCURRENT_REQUESTS_PER_DOMAIN = 2
DOWNLOAD_DELAY = 1
DOWNLOAD_TIMEOUT = 30

AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 2
AUTOTHROTTLE_MAX_DELAY = 30
AUTOTHROTTLE_TARGET_CONCURRENCY = 1.0
AUTOTHROTTLE_DEBUG = False

RETRY_ENABLED = True
RETRY_TIMES = 2
RETRY_HTTP_CODES = [429, 500, 502, 503, 504, 408]CONCURRENT_REQUESTS_PER_DOMAINist die Zahl der Anfragen, die gleichzeitig an dieselbe Domain offen sein dürfen. Der Standardwert des Frameworks ist 8, die Projektvorlage senkt ihn auf 1. Was Nebenläufigkeit bedeutet, erklären wir in Concurrency und Parallelism.DOWNLOAD_DELAYist die Wartezeit zwischen zwei Anfragen an dieselbe Domain in Sekunden. Scrapy versieht diesen Wert standardmäßig mit einer zufälligen Schwankung; die Anfragen gehen nicht im Takt einer Uhr hinaus.- AutoThrottle passt die Wartezeit an die Antwortzeit des Servers an. Nach dem Algorithmus in der Dokumentation ist die Zielwartezeit die Antwortlatenz geteilt durch
AUTOTHROTTLE_TARGET_CONCURRENCY; die neue Wartezeit ist der Mittelwert aus der vorherigen Wartezeit und diesem Ziel. Antworten außer200können die Wartezeit nicht senken. Sie fällt nie unterDOWNLOAD_DELAYund steigt nie überAUTOTHROTTLE_MAX_DELAY. DOWNLOAD_TIMEOUTbeträgt standardmäßig 180 Sekunden. Verkürzen Sie den Wert bei der Arbeit über einen Proxy, damit eine Verbindung, die nicht antwortet, nicht drei Minuten lang hängt.
Mit AUTOTHROTTLE_DEBUG = True sehen Sie pro Antwort eine Zeile. In unserem Lauf begann die Wartezeit bei 2.000 ms, sank auf 1.072 ms, als der Server in 145 ms antwortete, dann auf 1.000 ms, die Untergrenze durch DOWNLOAD_DELAY, und blieb dort:
slot: books.toscrape.com | conc: 1 | delay: 2000 ms (+0)   | latency: 446 ms
slot: books.toscrape.com | conc: 1 | delay: 1072 ms (-927) | latency: 145 ms
slot: books.toscrape.com | conc: 1 | delay: 1000 ms (-72)  | latency: 144 ms
Ist ROBOTSTXT_OBEY aktiv, lädt Scrapy für jede Domain zuerst die Datei /robots.txt und sortiert nicht erlaubte Adressen aus, ohne sie anzufordern. Wie die Datei gelesen wird, steht in Was ist robots.txt und wie liest man die Datei?, der rechtliche Rahmen des Crawlings in Ist Web Scraping legal?. Eine Adresse im Feld USER_AGENT, unter der Sie erreichbar sind, sorgt dafür, dass der Betreiber der Website Ihnen schreiben kann, wenn er ein Problem sieht, statt Sie zu sperren.
Was macht Scrapy bei den Antworten 429 und 503?
Die Retry-Middleware wiederholt standardmäßig die Codes 500, 502, 503, 504, 522, 524, 408 und 429 sowie Verbindungsfehler; RETRY_TIMES = 2 bedeutet zusammen mit der ersten Anfrage insgesamt drei Versuche. Eine wiederholte Anfrage kehrt mit niedrigerer Priorität in die Warteschlange zurück.
Zwei Grenzen sollte man kennen. Der Wiederholungsversuch von Scrapy liest den Header Retry-After nicht und wendet zwischen den Versuchen keine exponentielle Wartezeit an; den Abstand bestimmen weiterhin DOWNLOAD_DELAY und AutoThrottle. Weil AutoThrottle die Wartezeit bei Antworten außer 200 nicht senkt, steigt das Tempo in einer Welle von 429 nicht von selbst, es sinkt aber unter Umständen auch nicht automatisch weit genug. Steigt der Anteil von 429 im Log, ist die richtige Reaktion, CONCURRENT_REQUESTS_PER_DOMAIN zu senken und DOWNLOAD_DELAY zu erhöhen. Der Versuch, ein Ratenlimit mit mehr IPs zu überschreiten, löst das Problem nicht, er erhöht die Last auf der Website. Die Bedeutung der Codes und das richtige Warten mit Retry-After finden Sie in HTTP-Statuscodes beim Web Scraping, die Logik des Ratenlimits auf der Seite der Website in unserem Beitrag zu 429 Too Many Requests.
Lässt sich in Scrapy ein SOCKS5 Proxy verwenden?
Mit dem Standard-Downloader nicht. In dem Versuch, in dem wir eine socks5://-Adresse in meta["proxy"] geschrieben hatten, wartete die Anfrage ohne jede Antwort bis zum Timeout. Der zweite, auf httpx basierende Downloader von Scrapy, HttpxDownloadHandler, unterstützt SOCKS5 dagegen seit Version 2.17. Führen Sie zur Einrichtung pip install "scrapy[httpx]" aus und ergänzen Sie die Einstellungen um:
DOWNLOAD_HANDLERS = {
    "http": "scrapy.core.downloader.handlers._httpx.HttpxDownloadHandler",
    "https": "scrapy.core.downloader.handlers._httpx.HttpxDownloadHandler",
}
Mit dieser Einstellung funktionierte eine Adresse der Form socks5://user:pass@… in unserem Test samt Authentifizierung. Die Scrapy-Dokumentation kennzeichnet diesen Downloader als experimentell und empfiehlt ihn noch nicht für den Produktivbetrieb; sie merkt außerdem an, dass er für jede Proxy-Adresse einen eigenen Verbindungspool öffnet. Bleiben Sie bei einem HTTP Proxy, wenn SOCKS5 nicht zwingend ist. Die Unterschiede der Protokolle stehen in SOCKS und HTTP Proxy im Vergleich.
Was tun bei Seiten, die mit JavaScript geladen werden?
Scrapy lädt das HTML der Seite und führt kein JavaScript aus. Werden die Daten erst im Browser nachgeladen, sehen Sie sich zuerst den JSON-Endpunkt an, den die Seite im Hintergrund aufruft; meist lässt sich diese Adresse direkt mit Scrapy anfordern. Ist das nicht möglich, öffnet das Plugin scrapy-playwright ausgewählte Anfragen in einem echten Browser. Achtung: In diesem Plugin wird der Proxy nicht über meta["proxy"] angegeben, sondern über die Optionen beim Browserstart oder im Kontext (context). Die Einzelheiten stehen in Was ist Playwright und wie nutzt man es mit Proxy?, wie sich Seitentypen unterscheiden lassen, in Statische und dynamische Seiten.
Scrapy, BeautifulSoup oder Selenium?
Die drei sind verschiedene Teile derselben Aufgabe; deshalb wird der Vergleich oft falsch aufgebaut.
| Scrapy | Requests + BeautifulSoup | Selenium | |
|---|---|---|---|
| Was es ist | Crawling-Framework | HTTP-Client + HTML-Parser | Browser-Automatisierung |
| Anfragewarteschlange und Nebenläufigkeit | Vorhanden | Schreiben Sie selbst | Schreiben Sie selbst |
| Wiederholungsversuch, Ratenlimit, robots.txt | Per Einstellung aktivierbar | Schreiben Sie selbst | Schreiben Sie selbst |
| JavaScript ausführen | Nein (mit Plugin) | Nein | Ja |
| Proxy-Angabe | meta["proxy"] oder Middleware | Parameter proxies= | Option beim Browserstart |
| Lernaufwand | Mittel | Niedrig | Mittel |
| Passende Aufgabe | Viele Seiten, wiederkehrendes Crawling | Einmalig, wenige Seiten | Anmeldung, Klicks, dynamische Inhalte |
BeautifulSoup ist nur ein Parser und lässt sich auch innerhalb von Scrapy verwenden. Selenium öffnet für jede Seite einen vollständigen Browser und verarbeitet deshalb auf derselben Hardware deutlich weniger Seiten; sinnvoll ist es nur für die Schritte, die wirklich einen Browser brauchen. Die Proxy-Einrichtung für Selenium steht in Selenium mit Proxy, der Vergleich der beiden Browser-Werkzeuge in unserem Beitrag Playwright oder Selenium.
Einsatzbereiche
- Preis- und Bestandsüberwachung: Dieselbe Produktliste wird jeden Tag gecrawlt; der Aufbau von Scrapy eignet sich für zeitgesteuerte Läufe und passt zu dieser Aufgabe. Den Aufbau beschreibt unsere Seite zur Preisüberwachung, ein lauffähiges Beispiel unser Beitrag zur Beobachtung von Wettbewerberpreisen im E-Commerce.
- Crawling innerhalb einer Website und Indexerstellung: Die Klasse
CrawlSpider, die Links folgt und alle Seiten durchläuft, ist ein fertiger Ausgangspunkt für Aufgaben mit einem Web Crawler. - Katalogerfassung über mehrere Websites: Ein eigener Spider pro Website, eine gemeinsame Pipeline und eine gemeinsame Proxy-Einstellung. Die allgemeine Architektur steht auf unserer Seite zum Data Scraping.
- Paginierte Listen: Die Muster „Weiter“-Link, Seitennummer und Cursor behandelt unser Beitrag zur Paginierung beim Web Scraping.
Häufige Fehler
- Den Proxy nur in die erste Anfrage schreiben.
metawird nicht an spätere Anfragen weitergegeben; ab der zweiten Seite läuft der Crawl von Ihrer eigenen IP-Adresse aus weiter, und im Log fällt das nicht auf. - Die Ordnungszahl der Middleware beliebig wählen. Bei einer Zahl über 750 werden die Zugangsdaten nicht zerlegt und die Anfrage scheitert mit dem Fehler
invalid hostname, bei einer Zahl unter 550 sehen Sie keine Verbindungsfehler. - Die Zeilen
ROBOTSTXT_OBEY,DOWNLOAD_DELAYund Nebenläufigkeit aus der Vorlage löschen. Die nackten Standardwerte des Frameworks (robots.txt aus, keine Wartezeit, 8 Anfragen pro Domain) sind schnell genug, um eine kleine Website zu belasten. - Den Crawl trotz
407weiterlaufen lassen. Jede Anfrage wird dreimal versucht, keine gelingt; korrigieren Sie zuerst die Zugangsdaten. - Auf ein rotierendes Gateway zusätzlich eine Rotations-Middleware setzen. Das Gateway erledigt diese Arbeit bereits; eine zweite Schicht erschwert nur die Fehlersuche.
DOWNLOAD_TIMEOUTauf dem Standardwert lassen. Eine einzige Verbindung, die nicht antwortet, belegt einen Slot drei Minuten lang.- Das Passwort in
settings.pyschreiben und ins Repository übertragen. Lesen Sie die Adresse aus einer Umgebungsvariable.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Einmalige Aufgabe mit wenigen Seiten | Requests + BeautifulSoup genügt, Scrapy ist nicht nötig |
| Tausende Seiten, regelmäßig wiederholt | Scrapy-Projekt, die Einstellungen der Vorlage bleiben erhalten |
| Der gesamte Verkehr soll über den Proxy laufen | TekProxyMiddleware oder die Umgebungsvariable https_proxy |
| Nur bestimmte Anfragen über einen anderen Ausgang | meta["proxy"] in diesen Anfragen |
| Last auf viele IPs verteilen | Rotierendes Gateway, eine Adresse, keine Middleware |
| Sie haben eine feste Proxy-Liste | ProxyHavuzuMiddleware, Ordnungszahl zwischen 550 und 750 |
| Dieselbe IP für die ganze Sitzung | Sticky-Proxy und eine Adresse |
429 nimmt im Log zu | Nebenläufigkeit senken, DOWNLOAD_DELAY erhöhen, AutoThrottle einschalten |
| SOCKS5 ist zwingend | HttpxDownloadHandler (experimentell) |
| Die Daten kommen per JavaScript | Zuerst der JSON-Endpunkt, sonst scrapy-playwright |
Häufige Fragen
Was ist ein Scrapy-Spider?
Ein Spider ist eine Python-Klasse, die von scrapy.Spider abgeleitet ist und zwei Dinge festlegt: von welchen Adressen der Crawl ausgeht und welche Daten und welche neuen Links aus der Antwort entnommen werden. Warteschlange, Download und Fehlerbehandlung sind Aufgabe des Frameworks, nicht des Spiders.
Muss man für Scrapy Python können?
Ja. Ein Spider ist eine Python-Klasse, und Sie arbeiten mit Selektoren, Schleifen und Dictionarys. Wer die Grundlagen von Python kennt, kann einen ersten Spider schreiben; für Middleware und Pipeline sollte man mit Klassen vertraut sein.
Wie erkenne ich, dass der Proxy wirklich verwendet wird?
Senden Sie mit Scrapy eine Anfrage an einen Dienst, der Ihre IP-Adresse als JSON zurückgibt, und vergleichen Sie die Adresse in der Antwort mit Ihrer eigenen IP. Auch der Wert response.meta.get("proxy"), in parse ins Log geschrieben, zeigt, welche Anfrage über welchen Proxy ging. Allgemeine Verfahren stehen in Funktioniert mein Proxy? So testen Sie einen Proxy.
Was ist schneller, Scrapy oder Selenium?
Auf derselben Hardware verarbeitet Scrapy deutlich mehr Seiten, weil es keinen Browser öffnet und Anfragen asynchron sendet. Das Tempo zählt nur, wenn die Seite kein JavaScript braucht; entstehen die Daten im Browser, sieht Scrapy allein sie nicht.
Wird DOWNLOAD_DELAY überflüssig, wenn AutoThrottle aktiv ist?
Nein, dieser Wert legt die Untergrenze fest. AutoThrottle senkt die Wartezeit nie unter DOWNLOAD_DELAY. Bei einem Server, der schnell antwortet, fällt die Wartezeit auf diese Untergrenze und bleibt dort; wer sich mit DOWNLOAD_DELAY = 0 auf AutoThrottle verlässt, sendet an schnelle Server deshalb Anfragen fast ohne Pause.
Verhindert eine andere IP bei jeder Anfrage eine Sperre?
Für sich genommen nicht. Websites messen das Tempo nicht nur pro IP, sondern auch pro Sitzung, Cookie und Verhalten. Rotation verteilt die Last auf viele Ausgänge; sinnvoll wird sie zusammen mit der Beachtung der robots.txt, niedriger Nebenläufigkeit und einem ehrlichen User-Agent. Die legitimen Verfahren haben wir in Web Scraping ohne Sperren zusammengestellt.
Fazit
In Scrapy ist der Proxy das Feld meta["proxy"] der Anfrage, und Sie können es auf drei Wegen füllen: von Hand pro Anfrage, mit einer Umgebungsvariable oder mit einer Downloader-Middleware. Soll der gesamte Verkehr einschließlich robots.txt denselben Ausgang nehmen, ist einer der beiden letzten Wege nötig. Mit einem rotierenden Gateway genügt eine Adresse; haben Sie eine feste Liste, übernimmt eine Middleware mit einer Ordnungszahl zwischen 550 und 750 die Verteilung und das Zählen der Fehler. Das Tempo bestimmt nicht der Proxy, sondern DOWNLOAD_DELAY, die Nebenläufigkeit pro Domain und AutoThrottle; behalten Sie die vorsichtigen Einstellungen der Vorlage bei. Die Proxy-Typen, die zu Ihren Crawling-Aufgaben passen, finden Sie bei unseren Proxy-Diensten.


