


































Ein Skript sammelt Ausschreibungen von der alten Website einer Stadtverwaltung in Türkiye. Im Browser lautet eine Überschrift Çankırı İhale İlanı, das Skript gibt aber Çankýrý Ýhale Ýlaný aus. Die Liste, die es auf einem Windows-Laptop gespeichert hat, lässt sich danach auf einem Linux-Server nicht öffnen: 'utf-8' codec can't decode byte 0xc7 in position 0: invalid continuation byte. Beide Probleme haben dieselbe Ursache: Die Bytes wurden mit einer Codetabelle geschrieben und mit einer anderen gelesen.
Dieser Leitfaden behebt die Ursache überall, wo sie auftritt: in Quelldateien, bei open(), in der Windows-Konsole, bei Seiten, die Sie mit Requests und Beautiful Soup abrufen, und in CSV-Dateien für Excel. Er zeigt außerdem, wie Sie verstümmelten Text lesen und reparieren; dieselben Schritte helfen, wenn statt ü plötzlich ü dasteht. Jeder Bytewert und jede Fehlermeldung unten stammt aus unseren eigenen Läufen mit Python 3.13.
Was ist der Unterschied zwischen str und bytes in Python?
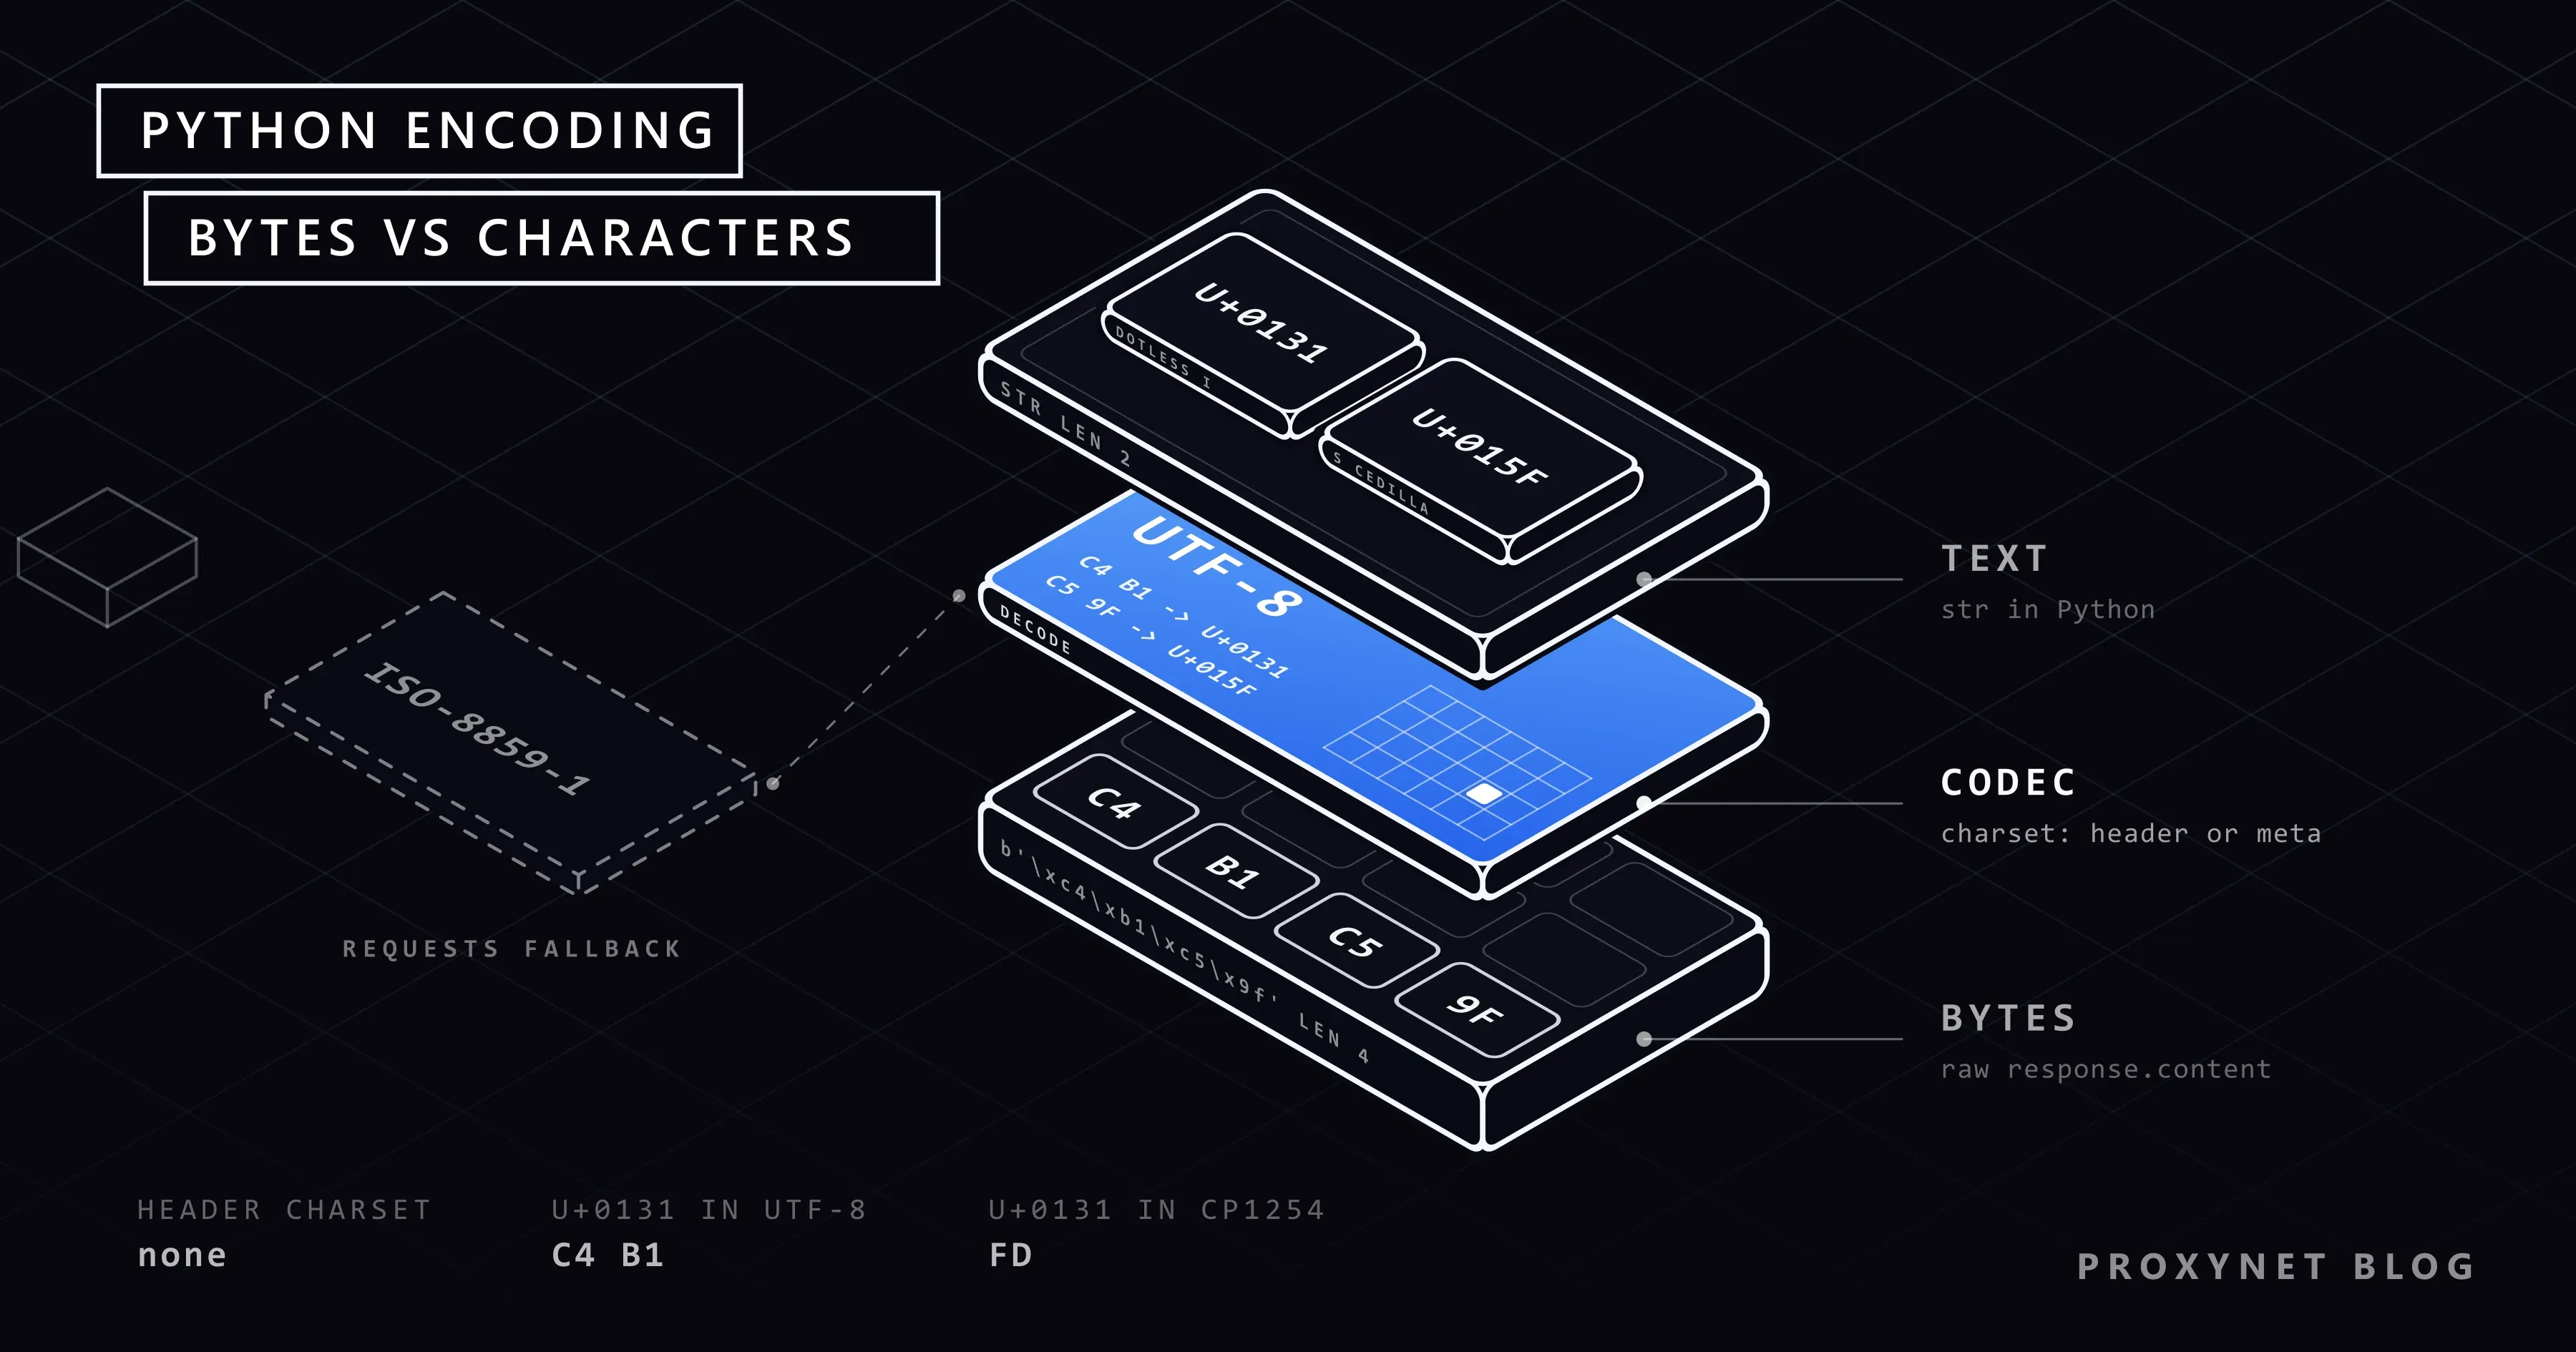
Ein str enthält Zeichen, jedes mit einem Unicode-Codepoint: Das türkische punktlose ı ist U+0131, ü ist U+00FC. Festplatten und Netzwerke speichern nur Bytes, also wird Text auf dem Weg nach draußen kodiert und auf dem Weg hinein dekodiert. Der Codec legt fest, welche Bytes für welches Zeichen stehen. In UTF-8 besteht ı aus zwei Bytes, C4 B1, und ü ebenfalls aus zwei, C3 BC. In windows-1254, der alten türkischen Windows-Codepage, ist ı ein einziges Byte, FD. Das westeuropäische cp1252 speichert ü als FC, kennt ı aber ebenso wenig wie ISO-8859-1.
Verwenden Schreiber und Leser unterschiedliche Codecs, bleiben die Bytes erhalten, aber die Buchstaben ändern sich. Das nennt man Mojibake, im Deutschen oft Zeichensalat, und es lässt sich häufig rückgängig machen.
Wie wird aus einem Zeichen ein falsches?
Jeder Kodierungsfehler folgt denselben Schritten:
- Ihr Text ist Unicode.
"Çankırı"besteht in Python aus sieben Codepoints. - Er wird mit Codec A kodiert. Ein türkisches Windows schreibt in cp1254
C7 61 6E 6B FD 72 FD. - Nur die Bytes reisen mit. Eine Datei, ein HTTP-Body oder eine Pipe sagt nichts über Codec A, außer ein Header, eine BOM oder ein
<meta>-Tag ergänzt diese Angabe. - Jemand dekodiert mit Codec B. ISO-8859-1 bildet
FDaufýab, daraus wirdÇankýrý. UTF-8 kannC7 61nicht als Zeichen lesen und löstUnicodeDecodeErroraus. - Die Ausgabe wird erneut kodiert.
print()undwrite()verwenden den Codec der Konsole oder der Datei, und ein Zeichen, das dieser Codec nicht kennt, löstUnicodeEncodeErroraus.
Am Traceback erkennen Sie, welche Richtung gescheitert ist.
Was verrät der verstümmelte Text?
Die Form des Schadens zeigt auf das Codec-Paar.
| Was Sie sehen | Richtiger Text | Was passiert ist | Was zu tun ist |
|---|---|---|---|
café, ü, ß, ı, ÅŸ | café, ü, ß, ı, ş | UTF-8-Bytes (C3 BC, C4 B1) als cp1252 oder ISO-8859-1 dekodiert | Die Bytes als UTF-8 dekodieren oder den Text reparieren (siehe unten) |
ý, þ, ð, Ý | ı, ş, ğ, İ | windows-1254-Bytes (FD, FE, F0, DD) als ISO-8859-1 dekodiert, der Standard von Requests | r.encoding = "cp1254" setzen oder r.content an Beautiful Soup übergeben |
ţ statt ş | ş | Eine Schätzung hat für eine türkische Seite windows-1250 gewählt | Den Codec für diese Website festlegen |
� | Jeder Nicht-ASCII-Buchstabe | Bytes mit errors="replace" als UTF-8 dekodiert | Im Text verloren; die Rohbytes neu dekodieren |
? | Jeder Buchstabe | Text mit errors="replace" in einen Codec kodiert, der das Zeichen nicht kennt | Verloren; mit UTF-8 schreiben |
| Ein leeres Kästchen | Der richtige Buchstabe | Der Schriftart fehlt die Glyphe (PDF, altes Terminal) | Die Schriftart wechseln, nicht die Kodierung |
Braucht man # -*- coding: utf-8 -*- in Python 3 noch?
Nein. PEP 3120 hat UTF-8 in Python 3.0 zur Standardkodierung von Quelldateien gemacht; die Zeile ist ein Überbleibsel aus Python 2. Gehen String-Literale in Ihrer .py-Datei trotzdem kaputt, hat Ihr Editor sie in einer alten Codepage gespeichert („ANSI“ unter Windows); speichern Sie sie als UTF-8. Andere Ratschläge aus Python 2, etwa u""-Präfixe und codecs.open(), brauchen Sie ebenfalls nicht.
Wie legen Sie die Kodierung beim Lesen und Schreiben von Dateien fest?
Geben Sie sie jedes Mal an: open("cities.txt", "w", encoding="utf-8"). Ohne diese Angabe verwendet Python 3.13 unter Windows die ANSI-Codepage. Auf unserem türkischen Windows-Rechner lieferte locale.getpreferredencoding(False) den Wert cp1254, und ein einfaches open("cities.txt", "w") schrieb Çankırı als C7 61 6E 6B FD 72 FD. Ein deutsches oder englisches Windows verwendet cp1252, das kein ı kennt, deshalb scheitert derselbe Schreibvorgang dort mit 'charmap' codec can't encode character 'ı'.
Für Dateien, die Sie erhalten, verwenden Sie den Codec, mit dem sie geschrieben wurden: cp1254 für ältere türkische Windows- und Excel-Exporte, cp1252 für westeuropäische, also auch deutsche, und cp1256 für Arabisch und Persisch. Das Argument errors legt fest, was mit Bytes geschieht, die nicht passen:
strict, der Standard, löst einen Fehler aus; genau das wollen Sie, solange Sie den richtigen Codec suchen.replacesetzt�an die Stelle jedes fehlerhaften Bytes, sodass Sie sehen, wo der Schaden liegt.backslashreplacelässt fehlerhafte Bytes als\xfdsichtbar.ignorelöscht sie stillschweigend:Iğdır, in cp1254 geschrieben und als UTF-8 gelesen, wurde zuIdr.
„Nimm einfach latin-1“ scheitert auf dieselbe Weise. ISO-8859-1 ordnet allen 256 Bytewerten ein Zeichen zu, löst also nie einen Fehler aus, und türkischer Text wird unbemerkt zu Çankýrý.
UnicodeDecodeError: 'utf-8' codec can't decode byte
Die Datei ist kein UTF-8, und das Byte in der Meldung ist ein Hinweis: 0xfd, 0xfe oder 0xf0 in türkischen Daten deuten auf cp1254, 0xe4 (ä), 0xfc (ü) oder 0xdf (ß) auf cp1252. So meldet b"Gr\xfc\xdfe".decode("utf-8") den Fehler can't decode byte 0xfc in position 2: invalid start byte. In pandas geben Sie den Codec an: pd.read_csv("export.csv", sep=";", encoding="cp1254"), für einen deutschen Export encoding="cp1252".
UnicodeEncodeError: 'charmap' codec can't encode character unter Windows
Die interaktive Windows-Konsole schreibt seit Python 3.6 UTF-8 (PEP 528), aber in eine Datei oder Pipe umgeleitete Ausgabe verwendet die ANSI-Codepage. Türkische Buchstaben passen in cp1254, ein Pfeil nicht: python script.py > out.txt mit print("Istanbul → Ankara") scheiterte mit 'charmap' codec can't encode character '→'. Drei Lösungen haben funktioniert:
set PYTHONUTF8=1($env:PYTHONUTF8=1in PowerShell) schaltet den UTF-8-Modus für Dateien und Standardstreams ein.python -X utf8 script.pytut dasselbe für einen einzelnen Lauf.PYTHONIOENCODING=utf-8ändert nur die Standardstreams, nichtopen().
Den UTF-8-Modus beschreibt der Windows-Leitfaden der Python-Dokumentation. PEP 686 macht den UTF-8-Modus ab Python 3.15 zum Standard; die finale Version ist für den 1. Oktober 2026 geplant. Behalten Sie encoding="utf-8" in Ihrem Code, bis jeder Rechner diese Version nutzt.
Die Variante 'latin-1' codec can't encode character stammt meist aus einem HTTP-Header. http.client, auf dem Requests aufbaut, kodiert Header-Werte als Latin-1, deshalb scheiterte ein Header-Wert Iğdır auf diese Weise. Kodieren Sie solche Werte mit Prozentkodierung oder senden Sie sie im Body.
Woher kommt die Kodierung einer Webseite?
Ein Browser bestimmt die Kodierung einer Seite in dieser Reihenfolge:
- Eine Byte Order Mark (BOM) am Anfang des Bodys.
- Der Parameter
charsetim HeaderContent-Type. - Ein
<meta charset>-Tag, das laut MDN in den ersten 1.024 Bytes stehen muss. - Eine Schätzung anhand der Bytes.
Requests liest nur den Header. Für einen text/*-Typ ohne Charset folgt es laut Requests-Dokumentation RFC 2616 und verwendet ISO-8859-1, obwohl RFC 7231 diesen Standardwert 2014 gestrichen hat. Eine JSON-Antwort ohne Charset wird als UTF-8 gelesen, andere Typen werden geschätzt. Auf unseren Testseiten, die als einfaches text/html ausgeliefert wurden, war r.encoding jedes Mal ISO-8859-1. Deshalb kann eine Seite im Browser richtig und in Ihrem Skript falsch aussehen, etwa mit ü statt ü auf einer UTF-8-Seite.
Sind windows-1254 und ISO-8859-9 dasselbe?
Fast. Beide legen die türkischen Buchstaben im Bereich 0xA0 bis 0xFF auf dieselben Bytes. Zwischen 0x80 und 0x9F hat windows-1254 Zeichen wie €, “, ” und …, ISO-8859-9 dagegen unsichtbare Steuerzeichen. Der WHATWG Encoding Standard weist Browser an, iso-8859-9 als windows-1254 und iso-8859-1 als windows-1252 zu lesen; Python behandelt sie als getrennte Codecs. Auf unserer mit iso-8859-9 ausgezeichneten Seite erzeugte Beautiful Soup \x93Kampanya\x94 10\x80, und mit from_encoding="cp1254" wurden dieselben Bytes zu “Kampanya” 10€. Für deutsche Seiten gilt dasselbe Paar: Umlaute liegen in ISO-8859-1 und windows-1252 auf denselben Bytes, der Unterschied zeigt sich bei Anführungszeichen und beim Eurozeichen. Dekodieren Sie solche Seiten als cp1254 bzw. cp1252.
Wie sollte Ihre eigene HTML-Seite ihr Charset angeben?
Speichern Sie die Datei als UTF-8, setzen Sie <meta charset="utf-8"> an den Anfang von <head> und achten Sie darauf, dass der Content-Type-Header des Servers kein anderes Charset nennt, denn der Header gewinnt.
response.encoding, apparent_encoding oder Beautiful Soup?
Jede Option liest ein anderes Signal:
r.encodingstammt aus dem Header.r.encoding = "cp1254"repariert eine bekannte Website;"utf-8"für jede Website zu setzen, macht die windows-1254-Seiten kaputt (�ank�r�auf unserer Testseite).r.apparent_encodingist die Schätzung von charset-normalizer anhand des Bodys. Sie lautete bei einer unserer türkischen SeitenWindows-1254und bei zwei anderenwindows-1250, wasşinţverwandelt.BeautifulSoup(r.content, "html.parser")liest das<meta>-Tag selbst. Übergeben Sie Bytes, nichtr.text; die Parsing-Seite behandelt unser Leitfaden zu Beautiful Soup.
Unsere Reihenfolge folgt dem Browser: eine BOM, ein Charset im Header, das <meta>-Tag, dann die Schätzung; protokollieren Sie dabei, welche Quelle Sie verwendet haben. HTTPX verhält sich anders: Version 0.28.1 nimmt UTF-8 an, wenn der Header kein Charset nennt, und unsere cp1254-Seite kam als �ank�r� heraus (HTTPX, Requests und AIOHTTP im Vergleich).
Ein Python-Scraper, der Seiten wie ein Browser dekodiert
Das Skript ruft jede URL einmal ab, wählt den Codec in dieser Reihenfolge, bildet die ISO-Bezeichnungen so ab wie Browser und schreibt die Überschriften in eine CSV-Datei für Excel. Es braucht pip install requests beautifulsoup4. Wiederholungen und IP-Rotation enthält es nicht; dazu lesen Sie HTTP-Statuscodes beim Web Scraping und Proxys in Python rotieren.
"""Seiten abrufen, jede wie ein Browser dekodieren und die Überschriften als CSV für Excel speichern."""
import csv
import logging
import sys
from email.message import Message

import requests
from bs4 import BeautifulSoup
from bs4.dammit import EncodingDetector

PROXY = None  # zum Beispiel "http://user:pass@pr.proxynet.io:8000"
USER_AGENT = "heading-reader/1.0 (+https://example.com/bot)"

# Browser lesen diese Bezeichnungen als Windows-Codepages (WHATWG Encoding Standard), Python nicht.
BROWSER_ALIASES = {
    "iso-8859-1": "cp1252", "iso8859-1": "cp1252", "latin1": "cp1252", "latin-1": "cp1252",
    "us-ascii": "cp1252", "ascii": "cp1252",
    "iso-8859-9": "cp1254", "iso8859-9": "cp1254", "latin5": "cp1254",
}

log = logging.getLogger("headings")


def header_charset(resp):
    """Das Charset aus dem Content-Type-Header oder None. Das eigene r.encoding von Requests
    würde hier bei jedem text/*-Typ ohne Charset ISO-8859-1 melden."""
    msg = Message()
    msg["content-type"] = resp.headers.get("Content-Type", "")
    return msg.get_param("charset")


def pick_codec(resp):
    """Gibt (Codec, Herkunft) zurück: eine BOM, der Header, <meta charset>, dann eine Schätzung."""
    bom = EncodingDetector.strip_byte_order_mark(resp.content)[1]
    if bom:
        return bom, "bom"
    declared = header_charset(resp)
    source = "header"
    if not declared:
        declared = EncodingDetector.find_declared_encoding(resp.content, is_html=True)
        source = "meta"
    if not declared:
        return resp.apparent_encoding or "utf-8", "guess"
    return BROWSER_ALIASES.get(declared.lower(), declared), source


def clean(text):
    """Fasst Leerraum zusammen, auch das geschützte Leerzeichen U+00A0."""
    return " ".join(text.split())


def read_headings(session, url):
    resp = session.get(url, timeout=20)
    resp.raise_for_status()
    codec, source = pick_codec(resp)
    soup = BeautifulSoup(resp.content, "html.parser", from_encoding=codec)
    level = logging.WARNING if source == "guess" else logging.INFO
    log.log(level, "%s: %s from %s", url, codec, source)
    if soup.contains_replacement_characters:
        log.warning("%s: some bytes did not fit %s and became U+FFFD", url, codec)
    return [(url, codec, source, clean(h.get_text())) for h in soup.select("h1, h2")]


def main(urls, out="headings.csv"):
    session = requests.Session()
    session.headers["User-Agent"] = USER_AGENT
    if PROXY:
        session.proxies = {"http": PROXY, "https": PROXY}
    rows = []
    for url in urls:
        try:
            rows += read_headings(session, url)
        except requests.RequestException as exc:
            log.error("%s: %s", url, exc)
    # utf-8-sig schreibt zuerst eine BOM, damit Excel die Datei als UTF-8 erkennt
    with open(out, "w", newline="", encoding="utf-8-sig") as f:
        writer = csv.writer(f)
        writer.writerow(["url", "codec", "source", "heading"])
        writer.writerows(rows)
    log.info("%d headings written to %s", len(rows), out)


if __name__ == "__main__":
    logging.basicConfig(level=logging.INFO, format="%(levelname)-7s %(message)s")
    main(sys.argv[1:] or ["https://example.com/"])
Wir haben es mit Python 3.13, Requests 2.34.2 und Beautiful Soup 4.15.0 über einen lokalen HTTP-Proxy ausgeführt. Die lokalen Testseiten wurden als text/html ohne Charset ausgeliefert, außer utf8hdr; die letzte URL ist eine öffentliche Seite:
INFO    http://127.0.0.1:8057/cp1254: windows-1254 from meta
INFO    http://127.0.0.1:8057/iso9: cp1254 from meta
INFO    http://127.0.0.1:8057/utf8meta: utf-8 from meta
INFO    http://127.0.0.1:8057/utf8hdr: utf-8 from header
INFO    http://127.0.0.1:8057/latin1: cp1252 from meta
WARNING http://127.0.0.1:8057/nometa: windows-1250 from guess
WARNING https://example.com/: ascii from guess
INFO    12 headings written to headings.csv
Jede Seite mit einem Charset im Header oder einem <meta>-Tag kam richtig heraus, auch “quoted” 5€ auf der mit ISO-8859-1 ausgezeichneten Seite. Die Seite ohne beides ist die Schwachstelle: Die Schätzung lautete windows-1250, und in der CSV landeten Çankýrý und ţubat.
Wenn Sie viele Websites in einem Land nach Zeitplan lesen, liefert ein Residential-Proxy in diesem Land die Seiten, die auch lokale Besucher sehen; die Codec-Logik bleibt dieselbe.
Was bedeuten „can't decode byte 0x8b“ und „0xa0“?
UnicodeDecodeError: 'utf-8' codec can't decode byte 0x8b in position 1
Ein gzip-Stream beginnt mit 1F 8B (RFC 1952); 0x8b an Position 1 bedeutet also, dass komprimierte Daten als Text dekodiert werden. gzip.compress(...).decode("utf-8") lieferte uns genau diese Meldung. Beim Scraping passiert das, wenn Sie r.raw direkt lesen oder mit urllib.request einen kopierten Accept-Encoding-Header senden, denn urllib.request dekomprimiert nie. Requests entpackt gzip selbst; entfernen Sie also den kopierten Header und verwenden Sie r.content. Kopierte Werte wie br oder zstd scheitern ebenfalls, sofern urllib3 nicht das optionale Brotli- bzw. Zstandard-Paket hat.
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xa0
In cp1252, cp1254 und ISO-8859-1 ist das geschützte Leerzeichen U+00A0 das einzelne Byte A0, mit dem in UTF-8 nie ein Zeichen beginnt. Lesen Sie die Datei mit ihrem echten Codec. Steht das Zeichen bereits in Ihrem Text, entfernt "10\xa0kg".split() es, .split(" ") nicht, und unicodedata.normalize("NFKC", s) macht daraus ein normales Leerzeichen (NFKC ändert auch Zeichen wie ² zu 2).
Wie reparieren Sie Text, der bereits verstümmelt ist?
Wenn kein Byte verloren gegangen ist, kehren Sie den falschen Schritt um:
- Text wie
ışğoderGrüße, kopiert von einem Bildschirm oder aus einer Tabelle:s.encode("cp1252").decode("utf-8")ergibtışğbzw.Grüße. - Derselbe Schaden aus
r.textvon Requests enthält ein verstecktes Steuerzeichen (\x9f, etwa ausşoderß), das cp1252 nicht kodieren kann; verwenden Sie deshalbs.encode("latin-1").decode("utf-8"). cp1252 scheiterte daran mit'charmap' codec can't encode character '\x9f'. - windows-1254-Text, der als ISO-8859-1 gelesen wurde, etwa
Çankýrý:s.encode("latin-1").decode("cp1254")ergibtÇankırı.
Für große oder gemischte Datenmengen repariert ftfy 6.3.1 UTF-8-Mojibake: ftfy.fix_text("ışğ") lieferte ışğ. Çankýrý ließ es unverändert, weil das wie gültiger lateinischer Text aussieht; Verwechslungen von Codepages reparieren Sie also von Hand. Text, in dem ? oder � statt Buchstaben steht, lässt sich nicht reparieren; laden Sie die Quelle erneut.
Warum zeigt Excel in einer UTF-8-CSV verstümmelte Zeichen?
Excel öffnet eine UTF-8-CSV per Doppelklick korrekt, wenn die Datei mit einer Byte Order Mark beginnt, wie Microsofts Supportseite erklärt. encoding="utf-8-sig" fügt die drei Bytes EF BB BF hinzu; in pandas schreiben Sie df.to_csv("out.csv", encoding="utf-8-sig"). Lesen Sie solche Dateien auch mit utf-8-sig zurück: Mit einfachem utf-8 lieferte uns das Modul csv eine erste Spalte namens şehir, während pandas die BOM in beiden Fällen entfernte. Einen vollständigen Ablauf vom Scraping bis Excel finden Sie in Daten von Websites extrahieren.
Warum gibt "I".lower() nicht "ı" zurück?
str.lower() verwendet die Standardzuordnung von Unicode, die die Sprache nicht berücksichtigt. Für Türkisch ist das gleich doppelt falsch: "ISPARTA".lower() gibt isparta statt ısparta zurück, und "İ".lower() gibt i plus einen kombinierenden Punkt (U+0307) zurück. casefold() hat dieselbe Lücke. Ordnen Sie die beiden Sonderbuchstaben zuerst zu:
TR_LOWER = str.maketrans({"I": "ı", "İ": "i"})
TR_UPPER = str.maketrans({"i": "İ", "ı": "I"})

print("ISPARTA İZMİR".translate(TR_LOWER).lower())  # ısparta izmir
print("istanbul ışık".translate(TR_UPPER).upper())  # İSTANBUL IŞIK
Auch im Deutschen ist die Umwandlung nicht umkehrbar: "Straße".upper() ergibt STRASSE, und .lower() macht daraus strasse. Für Vergleiche verwenden Sie casefold(), das Straße und STRASSE gleichermaßen zu strasse macht.
Auch Zahlen und Datumsangaben folgen lokalen Regeln. Ein Preis in türkischer oder deutscher Schreibweise wie 1.299,90 wird nach s.replace(".", "").replace(",", ".") zu einem Float, und pandas bietet dafür decimal="," und thousands=".". Vermeiden Sie locale.setlocale() in einem Scraper, weil es den ganzen Prozess umstellt. Die vollständige Preisbereinigung zeigt Wettbewerberpreise überwachen.
Anwendungsfälle
- Preisüberwachung: Shops, die noch alte Codepages ausliefern (Wettbewerberpreise überwachen).
- Tabellen nach Excel: eine CSV, die sich mit den richtigen Buchstaben öffnet (Daten von Websites extrahieren).
- PHP-Scraper:
DOMDocumentbraucht eine eigene Lösung (Webscraping mit PHP). - Scrapy-Exporte:
FEED_EXPORT_ENCODINGlegt den Ausgabe-Codec fest (Scrapy mit Proxy). - .NET-Jobs:
HttpClientbehandelt Charsets auf eigene Weise (Web Scraping mit C#). - Crawls über viele Websites: den Codec jeder Seite protokollieren (Web-Crawler).
Häufige Fehler
- Den Fehler mit
errors="ignore"oder latin-1 unterdrücken. Das Skript läuft, und die Buchstaben verschwinden oder ändern sich. r.encoding = "utf-8"für jede Website fest einstellen. Das repariert manche Seiten und macht windows-1254-Seiten kaputt.- Doppelt dekodieren. Wer
.encode().decode()auf bereits korrekt dekodierten Text anwendet, baut in guten Text einen neuen Fehler ein. iso-8859-9oderiso-8859-1wörtlich nehmen. Browser verwenden windows-1254 und windows-1252, und Anführungszeichen und Eurozeichen zeigen den Unterschied.- Eine
utf-8-sig-Datei alsutf-8lesen. Der erste Spaltenname beginnt mit einem unsichtbaren Zeichen, und Zugriffe über den Namen scheitern. - Zeichenkodierung mit URL-Kodierung verwechseln.
%40in einem Proxy-Passwort ist Prozentkodierung, ein eigenes Thema (Sonderzeichen in Proxy-Passwörtern).
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
Nicht-ASCII-Text in Ihrer eigenen .py-Datei | Als UTF-8 speichern; keine coding-Zeile |
| Eine Datei lesen oder schreiben | encoding="utf-8"; eine alte Codepage nur für Dateien, die damit geschrieben wurden |
'charmap'-Fehler bei umgeleiteter Ausgabe unter Windows | PYTHONUTF8=1 oder python -X utf8; ab Python 3.15 Standard |
| HTML ohne Charset im Header | r.content an Beautiful Soup übergeben, den Codec protokollieren |
Kein Charset im Header und kein <meta>-Tag | Den Codec der Website festlegen; apparent_encoding als letzter Ausweg |
Die Seite nennt iso-8859-9 oder iso-8859-1 | Als cp1254 oder cp1252 dekodieren, wie ein Browser |
Der Text zeigt bereits ü oder ı | .encode("cp1252").decode("utf-8") oder ftfy.fix_text |
| Das Ergebnis wird in Excel geöffnet | Die CSV mit utf-8-sig schreiben |
Häufige Fragen
Brauche ich eine Bibliothek, um Umlaute und andere Sonderzeichen in Python zu verarbeiten?
Nein. Ein str in Python 3 ist Unicode, und die Standardbibliothek bringt Codecs für die gängigen Codepages mit (Standard Encodings). charset-normalizer, das mit Requests installiert wird, schätzt unbekannte Codecs, und ftfy repariert Mojibake.
Wie konvertiere ich eine cp1252- oder cp1254-Datei nach UTF-8?
Lesen Sie sie mit ihrem alten Codec und schreiben Sie sie mit dem neuen: Path("new.txt").write_text(Path("old.txt").read_text(encoding="cp1254"), encoding="utf-8"), mit Path aus pathlib. Für eine deutsche Datei setzen Sie cp1252 ein. Prüfen Sie einige Namen, bevor Sie das Original löschen.
Behebt errors="ignore" einen UnicodeDecodeError?
Es verdeckt ihn. Bytes, die nicht passen, werden ohne Warnung gelöscht, sodass Namen Buchstaben verlieren: Aus Grüße in einer cp1252-Datei wird beim Lesen als UTF-8 Gre. Suchen Sie stattdessen den richtigen Codec.
Wie finde ich heraus, welche Kodierung eine Datei verwendet?
Sofern sie nicht mit einer BOM beginnt, speichert eine Textdatei ihren Codec nicht, deshalb schätzt jedes Werkzeug. charset_normalizer.from_path("old.txt").best().encoding lieferte für unsere türkische Testdatei cp1254. Bestätigen Sie die Schätzung, indem Sie dekodieren und einige Wörter mit lokalen Buchstaben lesen.
Was ist der Unterschied zwischen utf-8 und utf-8-sig?
utf-8-sig schreibt eine BOM (EF BB BF) und überspringt sie beim Lesen. Verwenden Sie es für CSV-Dateien, die in Excel geöffnet werden.
Wie behebe ich UnicodeDecodeError in pandas read_csv?
Geben Sie den Codec der Datei an: encoding="cp1254" für einen türkischen Windows-Export, cp1252 für einen westeuropäischen oder deutschen und utf-8-sig, wenn die Datei eine BOM hat. encoding_errors="replace" stoppt den Fehler, kostet aber Buchstaben.
Fazit
Encoding-Fehler in Python lassen sich auf eine Regel zurückführen: Dekodieren Sie Bytes mit dem Codec, in dem sie geschrieben wurden, und schreiben Sie Ihre eigene Ausgabe in UTF-8. Lesen Sie am verstümmelten Text das Codec-Paar ab, setzen Sie encoding bei jedem open(), nutzen Sie unter Windows den UTF-8-Modus, bis Python 3.15 das für Sie übernimmt, und übergeben Sie Webseiten als Bytes an Beautiful Soup. Für Scraping-Aufträge, die sauberen Text von vielen lokalen Websites brauchen, finden Sie mehr in unserer Lösung für Data Scraping.


