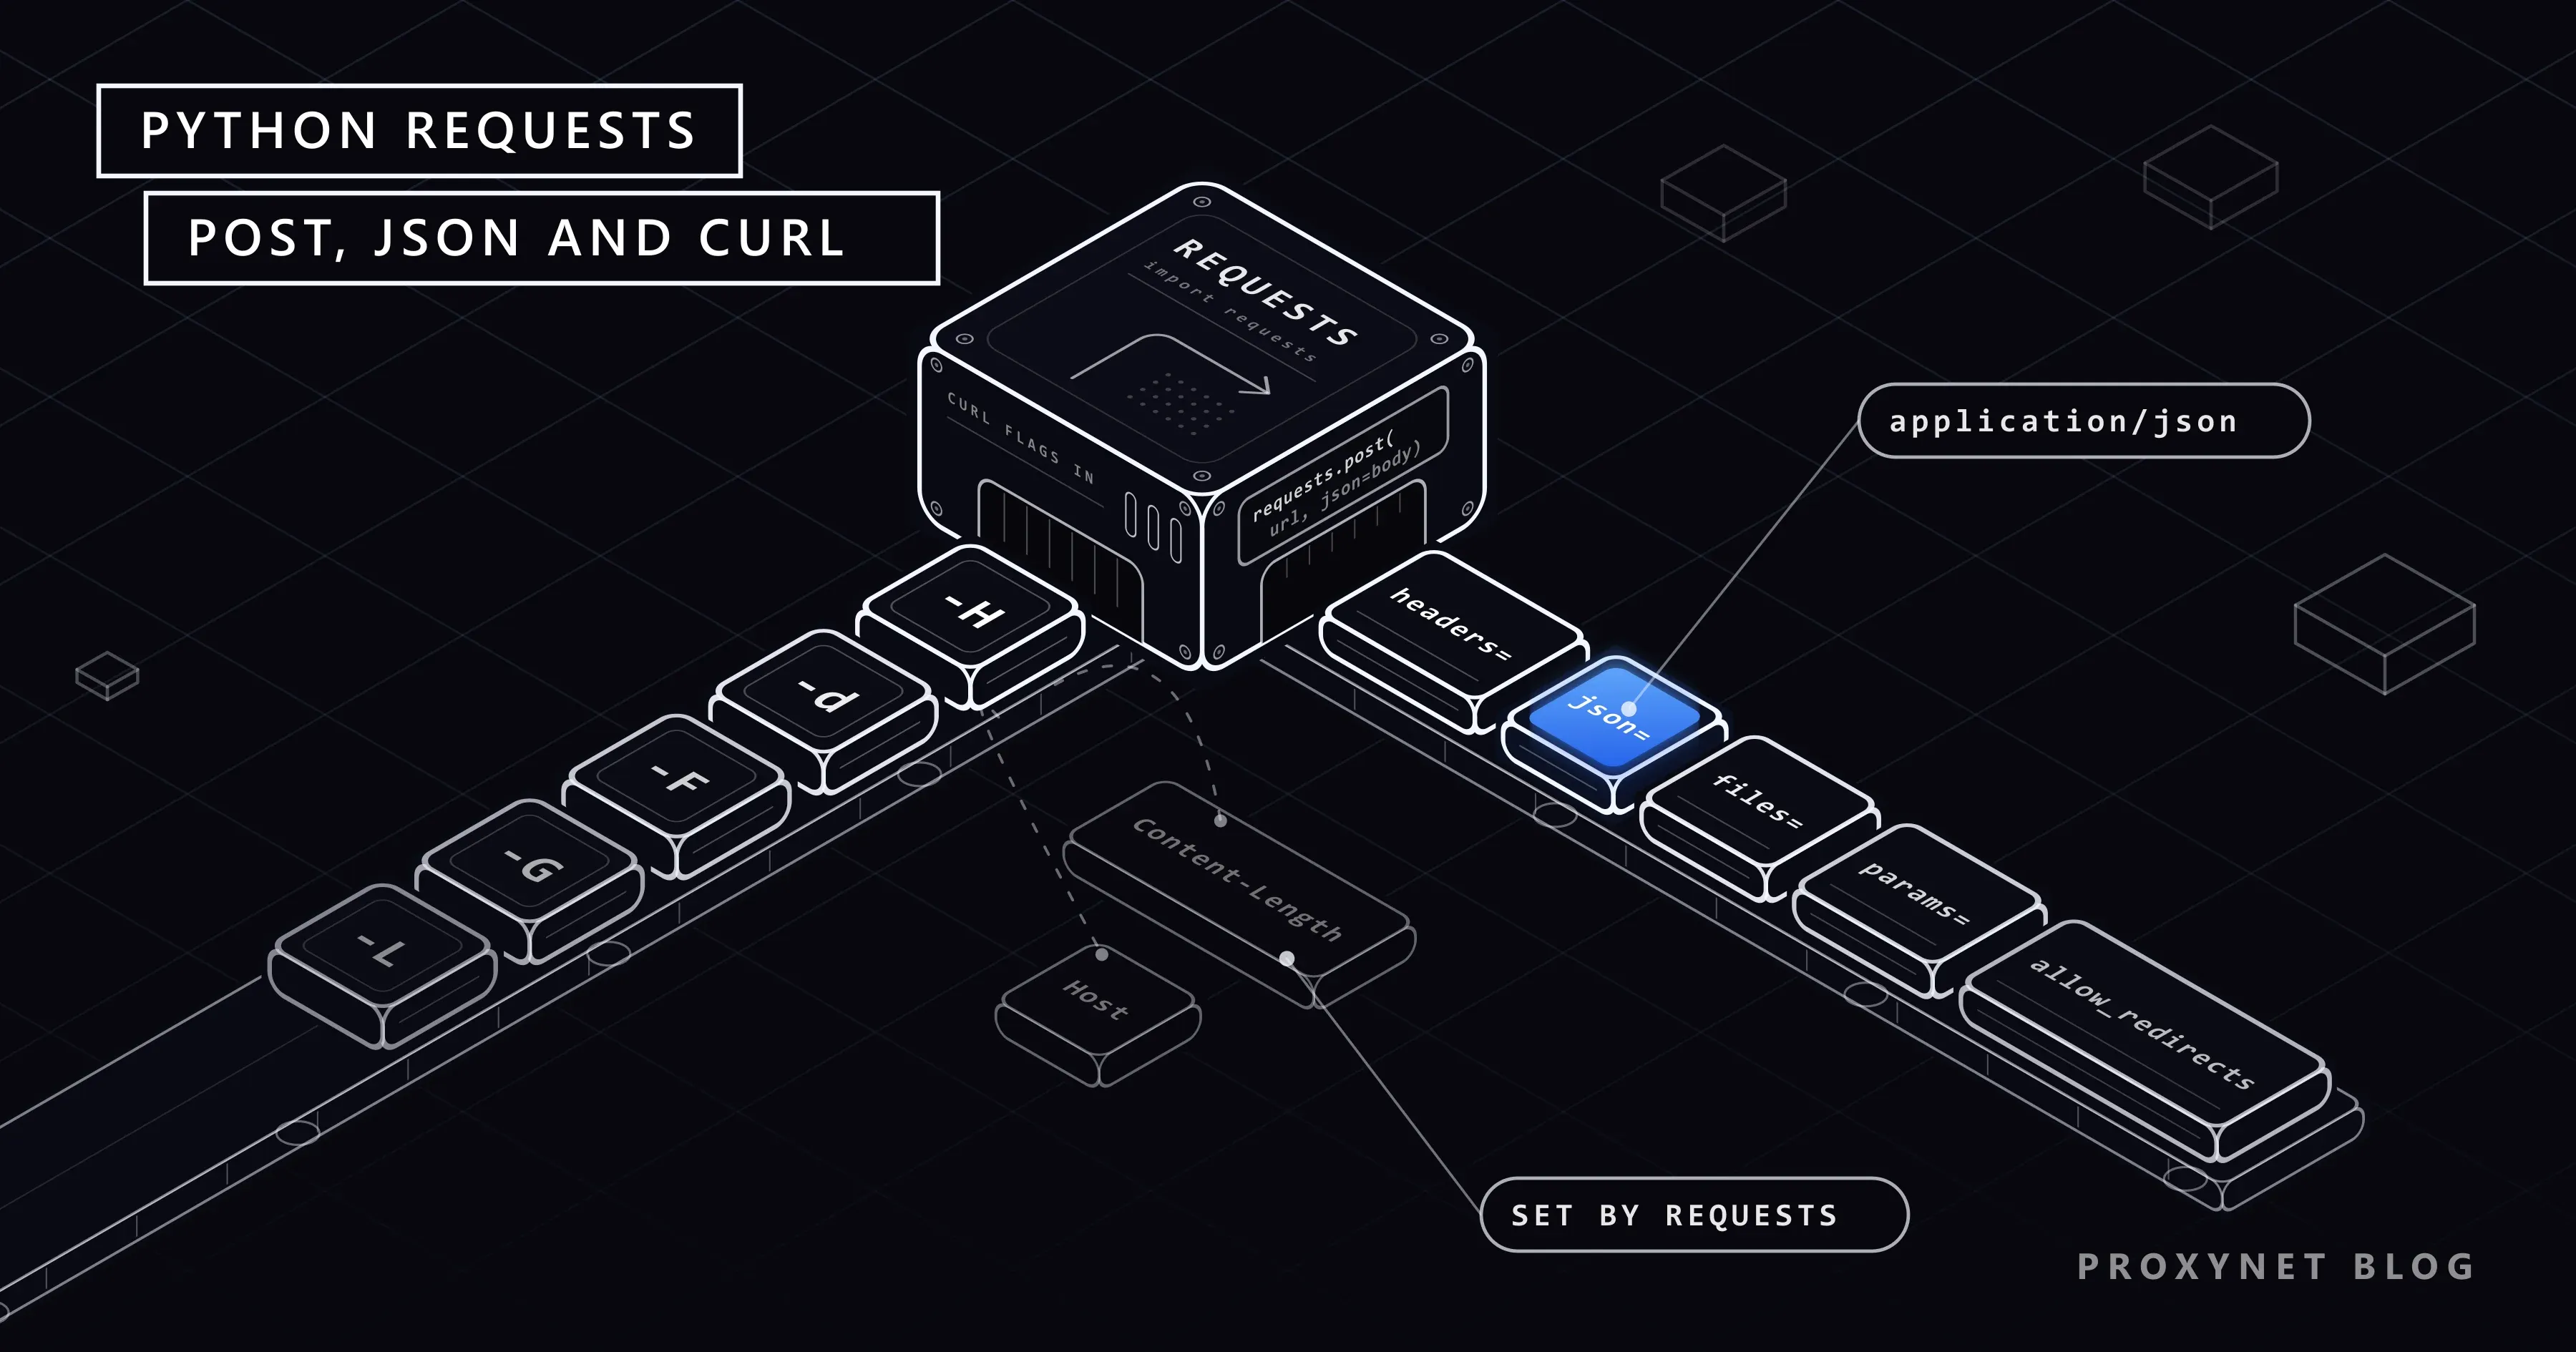
Die API-Dokumentation eines Paketdienstes zeigt als cURL-Befehl, wie man eine Sendung anlegt: curl -X POST https://api.example.com/v1/shipments -H "Authorization: Bearer TOKEN" -H "Content-Type: application/json" -d '{"recipient": "Ayse Demir", "weight_kg": 3}'. Im Terminal kommt 201 Created zurück. Sie übertragen das nach Python als requests.post(url, data=json.dumps(body), headers={"Authorization": ...}), und der Server antwortet mit 415 Unsupported Media Type: Mit einem String in data= sendet Requests keinen Content-Type, und die Zeile, die ihn gesetzt hat, ist im cURL-Befehl zurückgeblieben.
Dieser Leitfaden behandelt json=, data= und files=, Query-Parameter, Header und Bearer-Tokens, das Lesen der Antwort und das passende Requests-Argument für jede gängige cURL-Option. Am Ende stehen eine Checkliste für Anfragen, die in cURL funktionieren, in Python aber nicht, und ein kleiner API-Client, der Wiederholungen sicher handhabt. Jedes Beispiel lief unter Python 3.13.9, Requests 2.34.2 und curl 8.21.0 (Windows 11), gegen httpbin.org und einen lokalen Server, der die empfangenen Bytes zurückschickt.
Wie senden Sie eine POST-Anfrage mit Python Requests?
Installieren Sie das Paket mit pip install requests. PyPI führt 2.34.2, erschienen am 14. Mai 2026, als aktuelle Version; sie setzt Python 3.10 oder neuer voraus. Die Wahl zwischen den Bibliotheken behandelt HTTPX, Requests und AIOHTTP im Vergleich.
Ein POST mit JSON-Body ist ein einziger Aufruf. httpbin.org/post schickt zurück, was es empfangen hat:
import requests

payload = {"recipient": "Ayse Demir", "weight_kg": 3}
r = requests.post("https://httpbin.org/post", json=payload, timeout=20)

print(r.status_code)                         # 200
print(r.json()["headers"]["Content-Type"])   # application/json
print(r.json()["data"])                      # {"recipient": "Ayse Demir", "weight_kg": 3}
print(r.json()["json"])                      # derselbe Body, wieder als dict geparst
Das Feld data ist der Body, wie er gesendet wurde, mit einem Leerzeichen nach jedem Doppelpunkt und jedem Komma. requests.put(), requests.patch() und requests.delete() nehmen dieselben Argumente. Übergeben Sie immer timeout: Requests hat keinen Standardwert, ein stummer Server lässt Ihr Skript also unbegrenzt warten (Max Retries Exceeded With URL behandelt Timeout-Fehler).
Was ist der Unterschied zwischen json=, data= und files=?
Jedes Argument baut den Body anders und setzt einen anderen Content-Type. Wir haben dasselbe dict auf vier Arten gesendet:
import json
import requests

url = "https://httpbin.org/post"
body = {"recipient": "Ayse Demir", "weight_kg": 3}

for label, kwargs in [
    ("json=body", {"json": body}),
    ("data=body", {"data": body}),
    ("data=json.dumps(body)", {"data": json.dumps(body)}),
    ("json= and data=", {"json": body, "data": {"note": "x"}}),
]:
    echo = requests.post(url, timeout=20, **kwargs).json()
print(f"{label:22} {echo['headers'].get('Content-Type')!s:34} form={echo['form']} json={echo['json']}")json=body application/json form={} json={'recipient': 'Ayse Demir', 'weight_kg': 3}
data=body application/x-www-form-urlencoded form={'recipient': 'Ayse Demir', 'weight_kg': '3'} json=None
data=json.dumps(body) None form={} json={'recipient': 'Ayse Demir', 'weight_kg': 3}
json= and data= application/x-www-form-urlencoded form={'note': 'x'} json=NoneWas die vier Zeilen zeigen:
json=serialisiert das dict und setztContent-Type: application/json. Nehmen Sie es für JSON-APIs.data=mit einem dict sendet ein Formular, und jeder Wert wird zu Text:weight_kgkam als'3'an.data=mit einem String sendet keinenContent-Type. httpbin hat den Body trotzdem geparst; eine strenge API antwortet mit415oder400. Setzen Sie den Header dann selbst.json=zusammen mitdata=oderfiles=verliert das JSON ohne Fehlermeldung. Laut Quickstart von Requests wird der Parameterjsonignoriert, sobalddataoderfilesübergeben wird.
Senden Sie JSON-Text nur dann über data=, wenn es auf die exakten Bytes ankommt. Eine API, die den Body mit einem HMAC signiert, prüft genau die Bytes, die sie empfängt, und json= fügt Leerzeichen ein und maskiert Nicht-ASCII-Zeichen ("İzmir" geht als "\u0130zmir" hinaus). Bauen Sie die Bytes selbst:
import json
import requests

body = {"recipient": "Ayse Demir", "city": "İzmir", "weight_kg": 3}
raw = json.dumps(body, separators=(",", ":"), ensure_ascii=False).encode("utf-8")

r = requests.post("https://httpbin.org/post", data=raw,
                  headers={"Content-Type": "application/json"}, timeout=20)
print(r.json()["data"])  # {"recipient":"Ayse Demir","city":"İzmir","weight_kg":3}
Diese Bytes hatten denselben SHA-256-Hash wie der Body, den curl --data-binary @body.json aus derselben UTF-8-Datei gesendet hat. Formular-Logins mit CSRF-Tokens behandelt Sitzungen und Cookies in Python, files= folgt weiter unten.
Wie übersetzen Sie einen cURL-Befehl Schritt für Schritt in Requests?
Dieselbe Anfrage, im Network-Panel des Browsers aus dem Web-Dashboard des Paketdienstes kopiert, hat ein paar zusätzliche Zeilen. Wie Sie eine solche Anfrage finden, zeigt Statische und dynamische Seiten.
curl -X POST "https://api.example.com/v1/shipments?notify=false" \
  -H "Authorization: Bearer TOKEN" \
  -H "Content-Type: application/json" \
  -H "Accept-Encoding: gzip, deflate, br" \
  -H "Cookie: session=abc123" \
--data-raw '{"recipient": "Ayse Demir", "weight_kg": 3}'- Shell-Syntax auflösen. Entfernen Sie die
\-Zeilenumbrüche (^in einer Kopie für Windows-cmd) und die Anführungszeichen. - Query-String nach
params=verschieben. Aus?notify=falsewirdparams={"notify": "false"}. - Header filtern. Behalten Sie, was die API braucht:
Authorization,Accept, API-Schlüssel. Streichen SieAccept-Encoding, das Requests selbst erledigt, undContent-Type, wenn Siejson=verwenden. Kopieren Sie nieHostoderContent-Length; beide ermittelt Requests selbst. Browserzeilen wiesec-fetch-*sind selten nötig, und eineCookie-Zeile gehört incookies=oder in eineSession. - Body-Argument wählen. JSON wird zu
json=(oder zudata=mit exakten Bytes, wenn der Body signiert wird),-d "a=1&b=2"wird zudata={"a": "1", "b": "2"}, und-Fwird zufiles=. - Methode wählen.
-d,--data-raw,--jsonund-Fbedeuten POST, sofern-Xnichts anderes angibt;-Gmacht daraus eine GET-Abfrage. timeout=ergänzen undr.raise_for_status()aufrufen.- Vergleichen. Schicken Sie den cURL-Befehl und Ihren Python-Aufruf an
https://httpbin.org/anythingund vergleichen Sie die zurückgegebene Methode, URL, Header und den Body.
Das Ergebnis, mit dem Token aus einer Umgebungsvariablen:
import os
import requests

r = requests.post(
    "https://api.example.com/v1/shipments",
    params={"notify": "false"},
    headers={"Authorization": f"Bearer {os.environ['API_TOKEN']}"},
    json={"recipient": "Ayse Demir", "weight_kg": 3},
    timeout=20,
)
r.raise_for_status()
print(r.status_code, r.headers.get("Location"))
curlconverter erledigt die Schritte 1 bis 5, mit Python Requests als voreingestelltem Ausgabeformat. Installieren Sie es mit npm und ersetzen Sie im Befehl curl durch curlconverter. Für den Befehl oben hat Version 4.12.0 notify nach params verschoben, das Cookie nach cookies= und den Body nach json=, und Content-Type sowie Accept-Encoding auskommentiert. Einen Timeout hat es nicht ergänzt, und seine README warnt, dass der erzeugte Code Weiterleitungen folgt, sofern der Befehl keine Regel für Weiterleitungen setzt. Ein Befehl aus dem Browser enthält Ihr aktives Sitzungscookie und Ihr Token; konvertieren Sie ihn daher lokal, nicht auf einer Website.
Welches Requests-Argument entspricht welcher cURL-Option?
| cURL-Option | Requests | Unterschied |
|---|---|---|
-d '{"a":1}' mit Content-Type: application/json | json={"a": 1} | Requests fügt Leerzeichen ein; für exakte Bytes data= |
--json '{"a":1}' | json={"a": 1}, headers={"Accept": "application/json"} | --json (curl 7.82.0+) setzt auch Accept |
-d "a=1&b=2" | data={"a": "1", "b": "2"} | Gleiche Bytes |
--data-binary @body.json | data=open("body.json", "rb") | -d @file würde Zeilenumbrüche entfernen; diese beiden behalten sie |
-F "file=@report.csv" | files={"file": open("report.csv", "rb")} | curl kennzeichnet den Teil als application/octet-stream; Requests setzt einen Typ nur aus einem 3-Tupel |
-G --data-urlencode "q=kargo takip" | params={"q": "kargo takip"} | Gleiche Query: ?q=kargo+takip |
-X PUT | requests.put(url, ...) | Genauso bei PATCH und DELETE |
-H "Name: value" | headers={"Name": "value"} | Werte müssen Strings sein; ein int löst InvalidHeader aus |
-A "ShipmentSync/1.0" | headers={"User-Agent": "ShipmentSync/1.0"} | Sonst sendet jedes Tool seinen eigenen Namen |
-b "session=abc123" | cookies={"session": "abc123"} | Gleicher Cookie-Header |
-u user:pass | auth=("user", "pass") | Gleicher Basic-Header |
-L | Standard | cURL braucht -L; in Requests schaltet allow_redirects=False es ab |
--max-redirs 5 | session.max_redirects = 5 | Standard in Requests: 30 |
--connect-timeout 3 -m 20 | timeout=(3.05, 20) | -m begrenzt die gesamte Übertragung; der Lese-Timeout ist die Pause zwischen zwei Bytes |
-k / --cacert ca.pem | verify=False / verify="ca.pem" | verify=False nur in lokalen Tests |
-x http://user:pass@pr.proxynet.io:8000 | proxies={"http": url, "https": url} | Siehe cURL mit Proxy |
--compressed | Nichts | Requests erledigt die Komprimierung selbst |
-I | requests.head(url) | Bei HEAD folgt Requests keinen Weiterleitungen |
-i / -v | r.headers / r.request.headers | Was empfangen und was gesendet wurde |
Jede Option ist im curl-Handbuch beschrieben. Ein neuer Proxy bei jeder Anfrage ist eine eigene Aufgabe (Proxys in Python rotieren).
Wie übergeben Sie Query-Parameter und Header?
Übergeben Sie Query-Werte als dict an params=:
import requests

params = {"q": "kargo takip", "status": ["pending", "shipped"], "sort": None}
r = requests.get("https://httpbin.org/get", params=params, timeout=20)
print(r.url)  # https://httpbin.org/get?q=kargo+takip&status=pending&status=shipped
Eine Liste wiederholt den Schlüssel, None wird weggelassen, und Leerzeichen sowie Nicht-ASCII-Zeichen werden für Sie kodiert. Ein Query-String, der schon in der URL steht, bleibt erhalten, und params= wird dahinter angehängt. Das Durchblättern von Ergebnissen behandelt Paginierung beim Web Scraping.
Header kommen in ein dict aus Strings, das Token kommt aus der Umgebung:
import os
import requests

headers = {
    "Authorization": f"Bearer {os.environ['API_TOKEN']}",
    "Accept": "application/json",
}
r = requests.get("https://httpbin.org/headers", headers=headers, timeout=20)
print(r.json()["headers"]["Authorization"])  # Bearer <Ihr Token>

r = requests.get("https://httpbin.org/basic-auth/user/pass", auth=("user", "pass"), timeout=20)
print(r.status_code)  # 200
Header, die jeder Aufruf braucht, setzen Sie einmal auf einer requests.Session, über session.headers. Drei Regeln aus der Requests-Dokumentation, alle in unseren Tests bestätigt:
.netrcschlägtheaders=. Ein.netrc-Eintrag für den Host hat unserenBearer-Header durch einenBasic-Header ersetzt;auth=schlägt beide.- Authorization bleibt beim ursprünglichen Host. Nach einer Weiterleitung von
127.0.0.1auflocalhostwar der Header weg. - Werte sind Strings.
headers={"X-Page": 2}hatInvalidHeaderausgelöst.
Ohne eigenen User-Agent sendet Requests python-requests/2.34.2. Was dort stehen sollte, erklärt Was ist ein User-Agent?, und warum die Header eines Clients zueinander passen sollten, Web Scraping ohne Sperren.
Wie lesen Sie die Antwort und fangen HTTP-Fehler ab?
Ein Response-Objekt liefert r.status_code, r.headers (ein dict, das Groß- und Kleinschreibung ignoriert), r.content (rohe Bytes), r.text (die mit r.encoding dekodierten Bytes) und r.json(). Kaputte Zeichen in r.text bedeuten, dass die Kodierung falsch geraten wurde (Encoding-Fehler in Python).
Die Requests-Dokumentation warnt, dass ein erfolgreiches r.json() noch keine erfolgreiche Anfrage bedeutet: Ein Server kann mit einem 500 einen JSON-Fehlerbody senden. Prüfen Sie deshalb zuerst den Status:
import requests

r = requests.get("https://httpbin.org/status/404", timeout=20)
try:
    r.raise_for_status()
except requests.HTTPError as exc:
    print(exc)  # 404 Client Error: NOT FOUND for url: https://httpbin.org/status/404
raise_for_status() löst bei jedem 4xx oder 5xx ein HTTPError aus. Ist der Body leer oder HTML, scheitert r.json() mit JSONDecodeError (JSONDecodeError: Expecting Value listet die Ursachen auf). Welche Codes Sie wiederholen sollten, steht in HTTP-Statuscodes beim Web Scraping.
Wie laden Sie Dateien mit Requests hoch und herunter?
files= baut einen multipart/form-data-Body. Ein 3-Tupel setzt den Dateinamen und den Typ des Teils, und data=-Felder reisen als zusätzliche Teile mit. Da json= neben files= ignoriert wird, senden Sie JSON als eigenen Teil:
import json
import requests

with open("report.csv", "rb") as f:
    files = {
        "file": ("report.csv", f, "text/csv"),
        "meta": (None, json.dumps({"source": "warehouse"}), "application/json"),
    }
    r = requests.post("https://httpbin.org/post", files=files, data={"note": "daily"}, timeout=20)

print(r.json()["files"])  # {'file': 'sku,price\n1001,19.90\n'}
print(r.json()["form"])   # {'meta': '{"source": "warehouse"}', 'note': 'daily'}
Öffnen Sie die Datei im Binärmodus ("rb"): Die Dokumentation erklärt, dass Requests Content-Length womöglich auf die Byte-Zahl der Datei setzt, und im Textmodus kann dieser Wert falsch werden. Für sehr große Uploads verweist dieselbe Seite auf das Paket requests-toolbelt, das den Body streamt.
Bei Downloads hält stream=True einen großen Body aus dem Arbeitsspeicher heraus:
import requests

url = "https://example.com/export.csv"  # durch die URL Ihrer Datei ersetzen
with requests.get(url, stream=True, timeout=(3.05, 60)) as r:
    r.raise_for_status()
    with open("export.csv", "wb") as f:
        for chunk in r.iter_content(chunk_size=64 * 1024):
            f.write(chunk)
Wie Sie viele Dateien von einer Seite herunterladen, zeigt Alle Bilder von einer Website herunterladen.
Warum bekommt eine Anfrage, die in cURL funktioniert, in Requests eine andere Antwort?
Meist unterscheiden sich die beiden Anfragen. Prüfen Sie in dieser Reihenfolge:
- Weiterleitungen. cURL hält ohne
-Lbei einem3xxan; Requests folgt ihm bei jeder Methode außerHEAD. Folgt eines der beiden Tools, wird ein POST, der mit301,302oder303beantwortet wird, zu einem GET ohne Body, während307und308den POST beibehalten, im Einklang mit RFC 9110. Eine Ausnahme: Mit-X POSTund-Lhat cURL nach einem302einen POST ohne Body gesendet;--follow(curl 8.16.0+) wechselt zu GET. Sehen Sie sichr.historyan, oder übergeben Sieallow_redirects=Falseund lesen SieLocation. - Standard-Header. curl 8.21.0 hat
User-Agent: curl/8.21.0,Accept: */*und keinAccept-Encodinggesendet. Requests hatpython-requests/2.34.2,Accept: */*,Connection: keep-aliveundAccept-Encoding: gzip, deflategesendet (dazubr, wenn brotli installiert ist, undzstdunter Python 3.14). Vergleichen Sie mitr.request.headers. - HTTP-Version. Requests spricht nur HTTP/1.1:
r.raw.versionlieferte für eine HTTPS-Website11. curl handelt bei HTTPS standardmäßig HTTP/2 aus, wenn sein Build es unterstützt (curl -Vlistet dannHTTP2), und-w "%{http_version}"gibt die verwendete Version aus. Unserem Windows-Build fehlt diese Unterstützung, er nutzte1.1. - Umgebung. Mit
Session.trust_envauf dem StandardwertTrueliest RequestsHTTP_PROXY,HTTPS_PROXYundNO_PROXY, unter Windows und macOS die Proxy-Einstellungen des Systems, wenn keine Variable gesetzt ist, sowie.netrc. cURL liest die Variablen (http_proxynur in Kleinbuchstaben), aber nicht die Systemeinstellungen, und.netrcnur mit--netrc.requests.utils.get_environ_proxies(url)zeigt, was Requests übernommen hat; die Variablen erklärt Proxy-Nutzung mit wget. - Zertifikate. Requests nutzt das
certifi-Bundle; curl unter Windows mit Schannel nutzt den Zertifikatspeicher von Windows. Hinter einem Firmen-Proxy, der TLS inspiziert, kann cURL durchkommen, während RequestsSSLErrorauslöst (Lösung in Max Retries Exceeded With URL). - Body-Bytes.
json=serialisiert den Body neu, und-d @fileentfernt Zeilenumbrüche. Bilden Sie von beiden Bodys einen Hash, wenn die API sie signiert. - Die Leitung selbst. Ein lokaler MITM-Proxy zeigt beide Anfragen nebeneinander.
Stimmt alles überein und die Antwort weicht trotzdem ab, beurteilt die Website den Client selbst, zum Beispiel seinen TLS-Handshake, an dem Header nichts ändern. Cloudflare Scraper erklärt, wie Sie eine solche Antwort lesen, und TLS-Fingerprinting und JA3, was der Handshake verrät. Der richtige Weg ist dann die offizielle API der Website oder die Erlaubnis des Betreibers; Werkzeuge, die ein Skript als Browser tarnen, behandeln wir nicht.
Vollständiges Beispiel: ein kleiner API-Client mit sicheren Wiederholungen
Das Skript hält das Bearer-Token und die gemeinsamen Header auf einer Session, sendet params= mit einem GET und json= mit einem POST und prüft jeden Status. Es wiederholt nur den GET: MDN beschreibt POST als nicht idempotent, eine Wiederholung kann also eine zweite Sendung anlegen. Die Retry-Klasse von urllib3 lässt POST standardmäßig schon aus; das Skript schreibt es trotzdem ausdrücklich hin.
"""Kleiner API-Client: GET mit params, POST mit json=, Wiederholungen nur für GET."""
import os

import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

API = os.environ.get("API_BASE", "https://api.example.com/v1")
TIMEOUT = (3.05, 20)  # Verbindungs-Timeout, Lese-Timeout (Sekunden)


def make_session():
    session = requests.Session()
    session.headers.update({
        "Authorization": f"Bearer {os.environ['API_TOKEN']}",  # Token nie fest in den Code schreiben
        "Accept": "application/json",
        "User-Agent": "ShipmentSync/1.0 (+https://example.com/contact)",
    })
    retry = Retry(
        total=3,
        backoff_factor=0.5,
        status_forcelist=[502, 503, 504],
        allowed_methods=["GET"],  # ein wiederholter POST könnte dieselbe Sendung doppelt anlegen
        raise_on_status=False,    # letzte Antwort zurückgeben, raise_for_status() meldet sie
    )
    adapter = HTTPAdapter(max_retries=retry)
    session.mount("https://", adapter)
    session.mount("http://", adapter)
    proxy = os.environ.get("PROXY_URL")  # optional, z. B. http://user:pass@pr.proxynet.io:8000
    if proxy:
        session.proxies = {"http": proxy, "https": proxy}
        session.trust_env = False  # sonst gewinnt HTTPS_PROXY oder der System-Proxy gegen session.proxies
    return session


def list_shipments(session, status="pending", page=1):
    r = session.get(f"{API}/shipments", params={"status": status, "page": page}, timeout=TIMEOUT)
    r.raise_for_status()
    return r.json()


def create_shipment(session, recipient, weight_kg):
    body = {"recipient": recipient, "weight_kg": weight_kg}
    r = session.post(f"{API}/shipments", json=body, timeout=TIMEOUT)
    r.raise_for_status()
    return r.status_code, r.headers.get("Location"), r.json()


if __name__ == "__main__":
    with make_session() as s:
        try:
            print(list_shipments(s))
            print(create_shipment(s, "Ayse Demir", 3))
        except requests.HTTPError as exc:
            print("API error:", exc)
Gegen einen lokalen Server, der die API nachahmt, lieferte der GET die Liste und der POST 201 mit einem Location-Header. Als der Server mit 503 antwortete, ging der GET viermal hinaus (mit Pausen von 0, 1 und 2 Sekunden zwischen den Versuchen), bevor raise_for_status() den Fehler meldete; ein POST an dieselbe Adresse ging nur einmal hinaus. Über einen lokalen Test-Proxy in PROXY_URL funktionierten beide Aufrufe, und ein falsches Passwort ergab 407 Proxy Authentication Required.
urllib3 beachtet bei einem 503 standardmäßig auch Retry-After; den Umgang mit 429 behandelt HTTP-Statuscodes beim Web Scraping, viele parallele Aufrufe Concurrency und Parallelism.
Anwendungsfälle
- Produkt- oder Preisdaten aus einer API, die die Website selbst anbietet (Data Scraping).
- Ein JSON-Endpunkt aus dem Network-Panel, direkt aufgerufen, statt die Seite zu rendern (Statische und dynamische Seiten).
- Die Seiten hinter API-Ergebnissen crawlen, in rücksichtsvollem Tempo (Python-Webcrawler).
- Den eigenen Webhook oder internen Dienst testen, per Skript statt mit einem GUI-Tool (Postman mit Proxy).
- Die Antwort einer API für ein anderes Land prüfen, über einen Residential-Proxy in diesem Land.
- Eine API, die nur registrierte IP-Adressen annimmt, von einem festen Ausgang aus aufrufen (Statische IP für APIs).
- Dieselbe Anfrage in Node.js mit fetch oder Axios (cURL in JavaScript).
Häufige Fehler
data=json.dumps(body)ohneContent-Type. Der Server erkennt nicht, dass es JSON ist; nehmen Siejson=body.json=unddata=in einem Aufruf. Das JSON fällt stillschweigend weg.- Kein
timeout. Ein einziger stummer Server hält das Skript an. - Den Query-String von Hand zusammensetzen. Leerzeichen und Nicht-ASCII-Zeichen machen die URL kaputt.
r.json()vor der Statusprüfung. Ein500mit JSON-Fehlerbody lässt sich problemlos parsen.- Uploads im Textmodus geöffnet. Nehmen Sie
"rb". HostundContent-Lengthmitkopieren. Requests hat einen kopiertenHostunverändert gesendet, sodass ein Test gegen einen anderen Server weiterhin den alten nannte. Ein kopiertesContent-Lengthbei einem GET ohne Body ließ unseren Server bis zum Lese-Timeout warten.- Browser-Befehle in Online-Konverter einfügen. Sie enthalten Ihr Sitzungscookie und Ihr Token.
verify=Falsein Produktion. Es schaltet die Zertifikatsprüfung ab.- POST blind wiederholen. Eine Wiederholung nach einem Timeout kann einen zweiten Datensatz anlegen.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| JSON-Body für eine API | requests.post(url, json=data, timeout=20), kein manueller Content-Type |
| Signierter Body, Byte für Byte | data= mit selbst serialisierten Bytes, dazu Content-Type |
| Einfaches Formular (kein Login) | data= mit einem dict; Logins und CSRF im Leitfaden zu Sitzungen |
| Datei mit zusätzlichen Feldern | files= plus data=; JSON als eigener application/json-Teil |
| Schnelle cURL-Übersetzung | Die Tabelle oben oder curlconverter auf Ihrem Rechner |
| Funktioniert in cURL, nicht in Python | r.history, r.request.headers, trust_env und HTTP-Version prüfen |
| HTTP/2 oder asynchrone Aufrufe | HTTPX; AIOHTTP nur für async |
Häufige Fragen
Muss ich beim Senden von JSON mit Requests den Content-Type-Header setzen?
Nicht mit json=: Requests setzt Content-Type: application/json selbst. Sie brauchen ihn, wenn Sie JSON-Text über data= übergeben, denn ein String in data= geht ohne diesen Header hinaus, und eine strenge API antwortet dann mit 415 Unsupported Media Type oder 400.
Was ist der Unterschied zwischen json= und data=json.dumps() in Requests?
Beide senden JSON-Text, aber nur json= fügt den Content-Type-Header hinzu. Auch die Bytes können sich unterscheiden: json= schreibt Leerzeichen nach Doppelpunkten und Kommas und maskiert Nicht-ASCII-Zeichen. Nehmen Sie standardmäßig json=, und data= mit eigenen Bytes, wenn eine API den Body signiert.
Wie sende ich ein Bearer-Token mit Python Requests?
Nutzen Sie headers={"Authorization": f"Bearer {token}"} oder setzen Sie den Header einmal in session.headers. Lesen Sie das Token aus einer Umgebungsvariablen. Enthält eine .netrc-Datei Zugangsdaten für denselben Host, nimmt Requests stattdessen diese; Session.trust_env = False schaltet das ab.
Kann ich einen cURL-Befehl automatisch in Python umwandeln?
Ja. curlconverter wandelt einen cURL-Befehl in Requests-Code um und läuft auf Ihrem eigenen Rechner. Prüfen Sie die Ausgabe: Sie enthält keinen Timeout, und Requests folgt Weiterleitungen, denen der cURL-Befehl nicht gefolgt ist. Halten Sie Befehle mit Cookies oder Tokens von Online-Konvertern fern.
Folgt Requests Weiterleitungen, und warum wird mein POST zu einem GET?
Requests folgt Weiterleitungen bei jeder Methode außer HEAD. Nach einem 301, 302 oder 303 wird ein POST zu einem GET und verliert seinen Body, wie im Browser; nach 307 oder 308 bleibt er ein POST. allow_redirects=False hält bei der ersten Antwort an.
Unterstützt Python Requests HTTP/2?
Nein. Requests spricht nur HTTP/1.1; in unserem Test lieferte r.raw.version für eine HTTPS-Website 11. HTTPX unterstützt HTTP/2, wenn Sie httpx[http2] installieren und den Client mit http2=True erstellen; standardmäßig ist es ausgeschaltet.
Fazit
Für eine JSON-API ist requests.post(url, json=data, timeout=20) schon die ganze Arbeit: Requests serialisiert den Body und setzt den Header. data= sendet Formulare oder exakte Bytes, files= Multipart-Bodys und params= den Query-String. Ein cURL-Befehl lässt sich Option für Option auf diese Argumente abbilden; unterscheiden sich die Antworten trotzdem, prüfen Sie Weiterleitungen, Standard-Header, die HTTP-Version und die Umgebung, in dieser Reihenfolge. Muss eine API aus einem bestimmten Land oder von einer festen Adresse aus aufgerufen werden, vergleichen Sie die Optionen auf unserer Seite zu Proxy-Diensten.