

































Web Scraping · Proxynet Blog
Veröffentlicht
Warum werden KI-Shopping-Agenten auf Websites blockiert?
Shopping-Agenten scheitern am Bot-Schutz, weil Websites Menschen nicht von autorisierten Agenten unterscheiden können. Wir erklären Gründe und neue Lösungen.
Autor: Acar Diveroli
Veröffentlicht
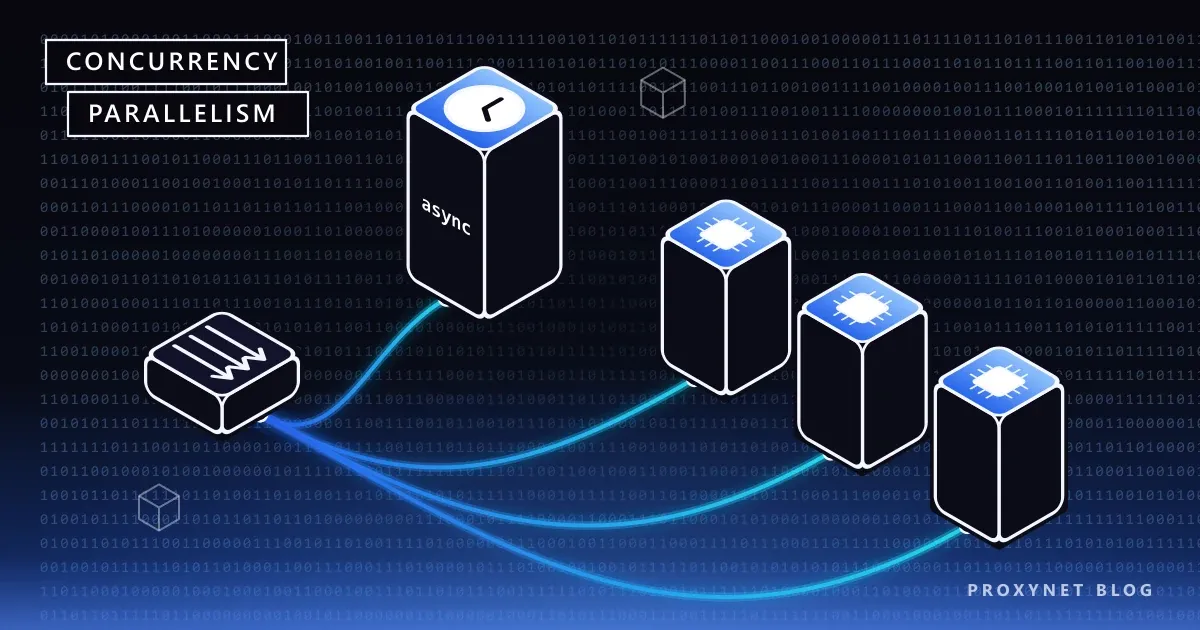
Concurrency und Parallelism: Was bestimmt Scraping-Tempo?
Nebenläufigkeit nutzt Wartezeit, Parallelität nutzt CPU-Leistung. Wir erklären mit Python- und Node.js-Beispielen, was Scraping wirklich beschleunigt.
Autor:Acar Diveroli
Veröffentlicht
CSS-Selektor oder XPath: Was passt zum Web Scraping?
CSS-Selektoren sind kurz und lesbar, XPath wählt auch nach Text und Elternelement. Wir vergleichen Syntax, Tempo und Python-Beispiele für beide Methoden.
Autor:Acar Diveroli
Veröffentlicht
Was sind Honeypot-Fallen und wie wirken sie beim Scraping?
Honeypots sind versteckte Links, die Besucher nie sehen, in denen sich Bots aber verfangen. Wir erklären, wie sie funktionieren, ohne Umgehung zu lehren.
Autor:Acar Diveroli
Veröffentlicht
HTTP-Statuscodes beim Web Scraping: 403, 407, 429, 503
403, 407, 429 und 503 weisen beim Scraping auf verschiedene Probleme hin. Wir erklären Bedeutung und Ursachen und korrekte Wiederholungen mit Retry-After.
Autor:Acar Diveroli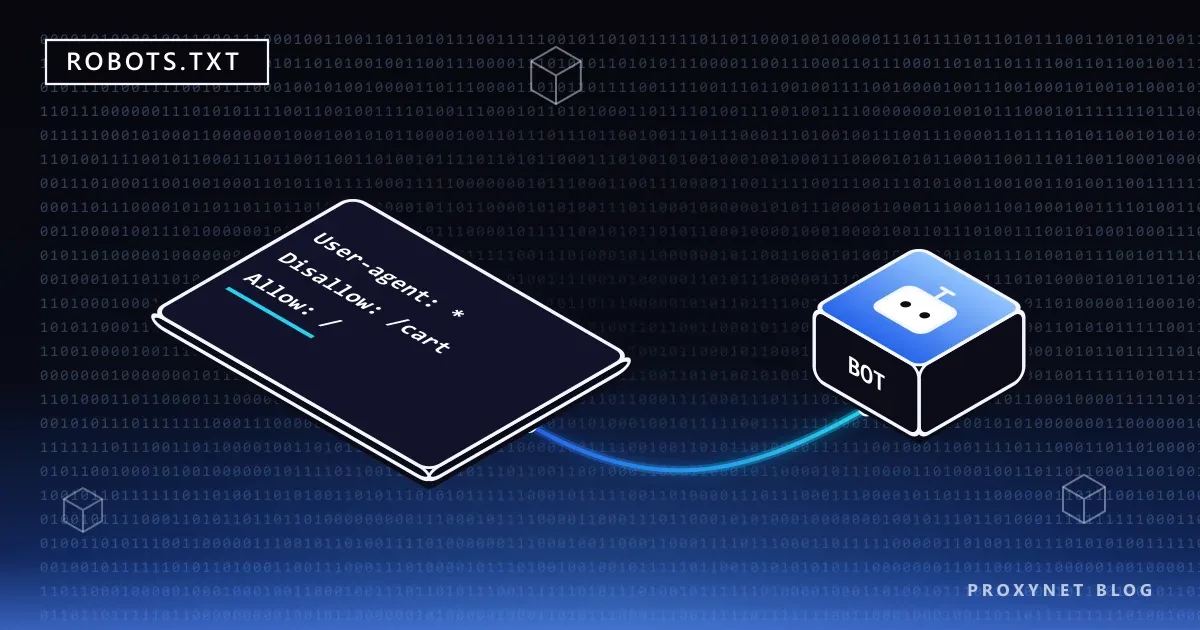
Veröffentlicht
Was ist robots.txt und wie liest man die Datei?
In robots.txt legt eine Website fest, welche Pfade Bots nicht crawlen sollen. Wir erklären Disallow, Allow, Crawl-delay und das Auslesen mit Python.
Autor:Acar Diveroli
Veröffentlicht
So automatisieren Sie das SEO-Rank-Tracking
Rankings von Hand zu prüfen, skaliert nicht. Wir zeigen automatisiertes Rank-Tracking mit der Search Console API, SERP-Daten und standortbezogenen Abfragen.
Autor:Acar Diveroli
Veröffentlicht
Statische und dynamische Seiten beim Web Scraping
Dynamische Seiten laden Inhalte später per JavaScript, daher kommt eine einfache Anfrage leer zurück. Wir zeigen, wann ein Headless-Browser wirklich nötig ist.
Autor:Acar Diveroli
Veröffentlicht
Web Scraping ohne Sperren: Daten regelkonform erfassen
Scraper werden meist wegen Rate-Limits, fehlender Header und einer einzigen IP gesperrt. So erfassen Sie Daten regelkonform, ohne die Website zu belasten.
Autor:Acar Diveroli
Warum werden KI-Shopping-Agenten auf Websites blockiert?
Autor: Acar DiveroliWeb ScrapingVeröffentlicht
Concurrency und Parallelism: Was bestimmt Scraping-Tempo?
Autor: Acar DiveroliWeb ScrapingVeröffentlicht
CSS-Selektor oder XPath: Was passt zum Web Scraping?
Autor: Acar DiveroliWeb ScrapingVeröffentlicht
Was sind Honeypot-Fallen und wie wirken sie beim Scraping?
Autor: Acar DiveroliWeb ScrapingVeröffentlicht
HTTP-Statuscodes beim Web Scraping: 403, 407, 429, 503
Autor: Acar DiveroliWeb ScrapingVeröffentlicht
Was ist robots.txt und wie liest man die Datei?
Autor: Acar DiveroliWeb ScrapingVeröffentlicht
So automatisieren Sie das SEO-Rank-Tracking
Autor: Acar DiveroliWeb ScrapingVeröffentlicht
Statische und dynamische Seiten beim Web Scraping
Autor: Acar DiveroliWeb ScrapingVeröffentlicht
Web Scraping ohne Sperren: Daten regelkonform erfassen
Autor: Acar DiveroliWeb ScrapingVeröffentlicht
Keine passenden Beiträge
Veröffentlicht
Veröffentlicht