Ein Team möchte, dass sein interner Assistent Fragen aus der Produktdokumentation beantwortet. Es lädt die Seiten mit Requests herunter und gibt das HTML an das Modell weiter, doch Menüs, Cookie-Banner und Skripte machen die Hälfte des Textes aus, und Seiten, die ihren Inhalt per JavaScript laden, kommen fast leer an. Crawl4AI öffnet dieselben Seiten in einem echten Browser und liefert den eigentlichen Inhalt als sauberes Markdown. Am zweiten Tag ändern sich die Probleme: Mitten in einem Crawl über 300 Seiten antwortet die Website mit 429, und die Docker-Installation auf dem Build-Server liefert nur „connection reset“.
Dieser Leitfaden erklärt, wie Crawl4AI eine Seite in Markdown umwandelt, und behandelt die Einrichtung mit pip und Docker, Proxys, Rotation und Sticky-Sitzungen sowie die Einstellungen für robots.txt und Tempo, mit denen ein Crawl rücksichtsvoll bleibt. Alle Python-Beispiele haben wir mit Crawl4AI 0.9.4 und Python 3.13 über einen lokalen Test-Proxy mit Benutzername und Passwort ausgeführt. Auf dem Testrechner war Docker nicht verfügbar, die Docker-Befehle folgen daher der offiziellen Anleitung.
Was ist Crawl4AI und wofür wird es verwendet?
Crawl4AI ist eine Open-Source-Bibliothek für Python, die Webseiten abruft und ihren Inhalt in einer Form zurückgibt, die ein Sprachmodell lesen kann. Sie steuert Chromium über Playwright, sodass mit JavaScript aufgebaute Seiten gerendert werden, bevor sie gelesen werden (statische und dynamische Seiten). Ein einzelner Crawl liefert die Seite als Markdown, ein kürzeres „fit“-Markdown ohne Menüs und Footer, die Links, die Medienliste und auf Wunsch einen Screenshot oder ein PDF. Mit einer Extraktionsstrategie kann Crawl4AI außerdem ein JSON-Schema befüllen.
Die Bibliothek braucht Python 3.10 oder neuer; Version 0.9.4 erschien am 23. September 2026 auf PyPI. Sie können sie als Python-SDK nutzen, als Docker-Server mit REST-API und MCP-Endpunkt oder über das Kommandozeilenwerkzeug crwl.
Crawl4AI ist in erster Linie ein Crawler: Es besucht Seiten und folgt Links, und was Sie daraus extrahieren, entscheiden Sie selbst (Web Scraping vs. Web Crawling). Wie es sich zu KI-Scraping-Werkzeugen im Allgemeinen verhält, erklärt Was ist ein AI Web Scraper und wie funktioniert er?.
Wie wandelt Crawl4AI eine Seite in Markdown um?
Ein Aufruf von arun() durchläuft diese Schritte:
- Der Browser startet mit den Einstellungen aus
BrowserConfig: Headless-Modus, derUser-Agentund, falls dort gesetzt, ein Proxy für den gesamten Browser. - Die robots.txt wird geprüft, wenn
CrawlerRunConfigden Wertcheck_robots_txt=Trueenthält. Eine gesperrte URL wird nie geöffnet; das Ergebnis hat den Status403und „Access denied by robots.txt“. - Die Seite lädt in Chromium, über den Proxy des Laufs, falls es einen gibt, und ihr JavaScript wird ausgeführt.
- Das HTML wird bereinigt: Skripte und Styles fallen weg, Links und Medien werden gesammelt.
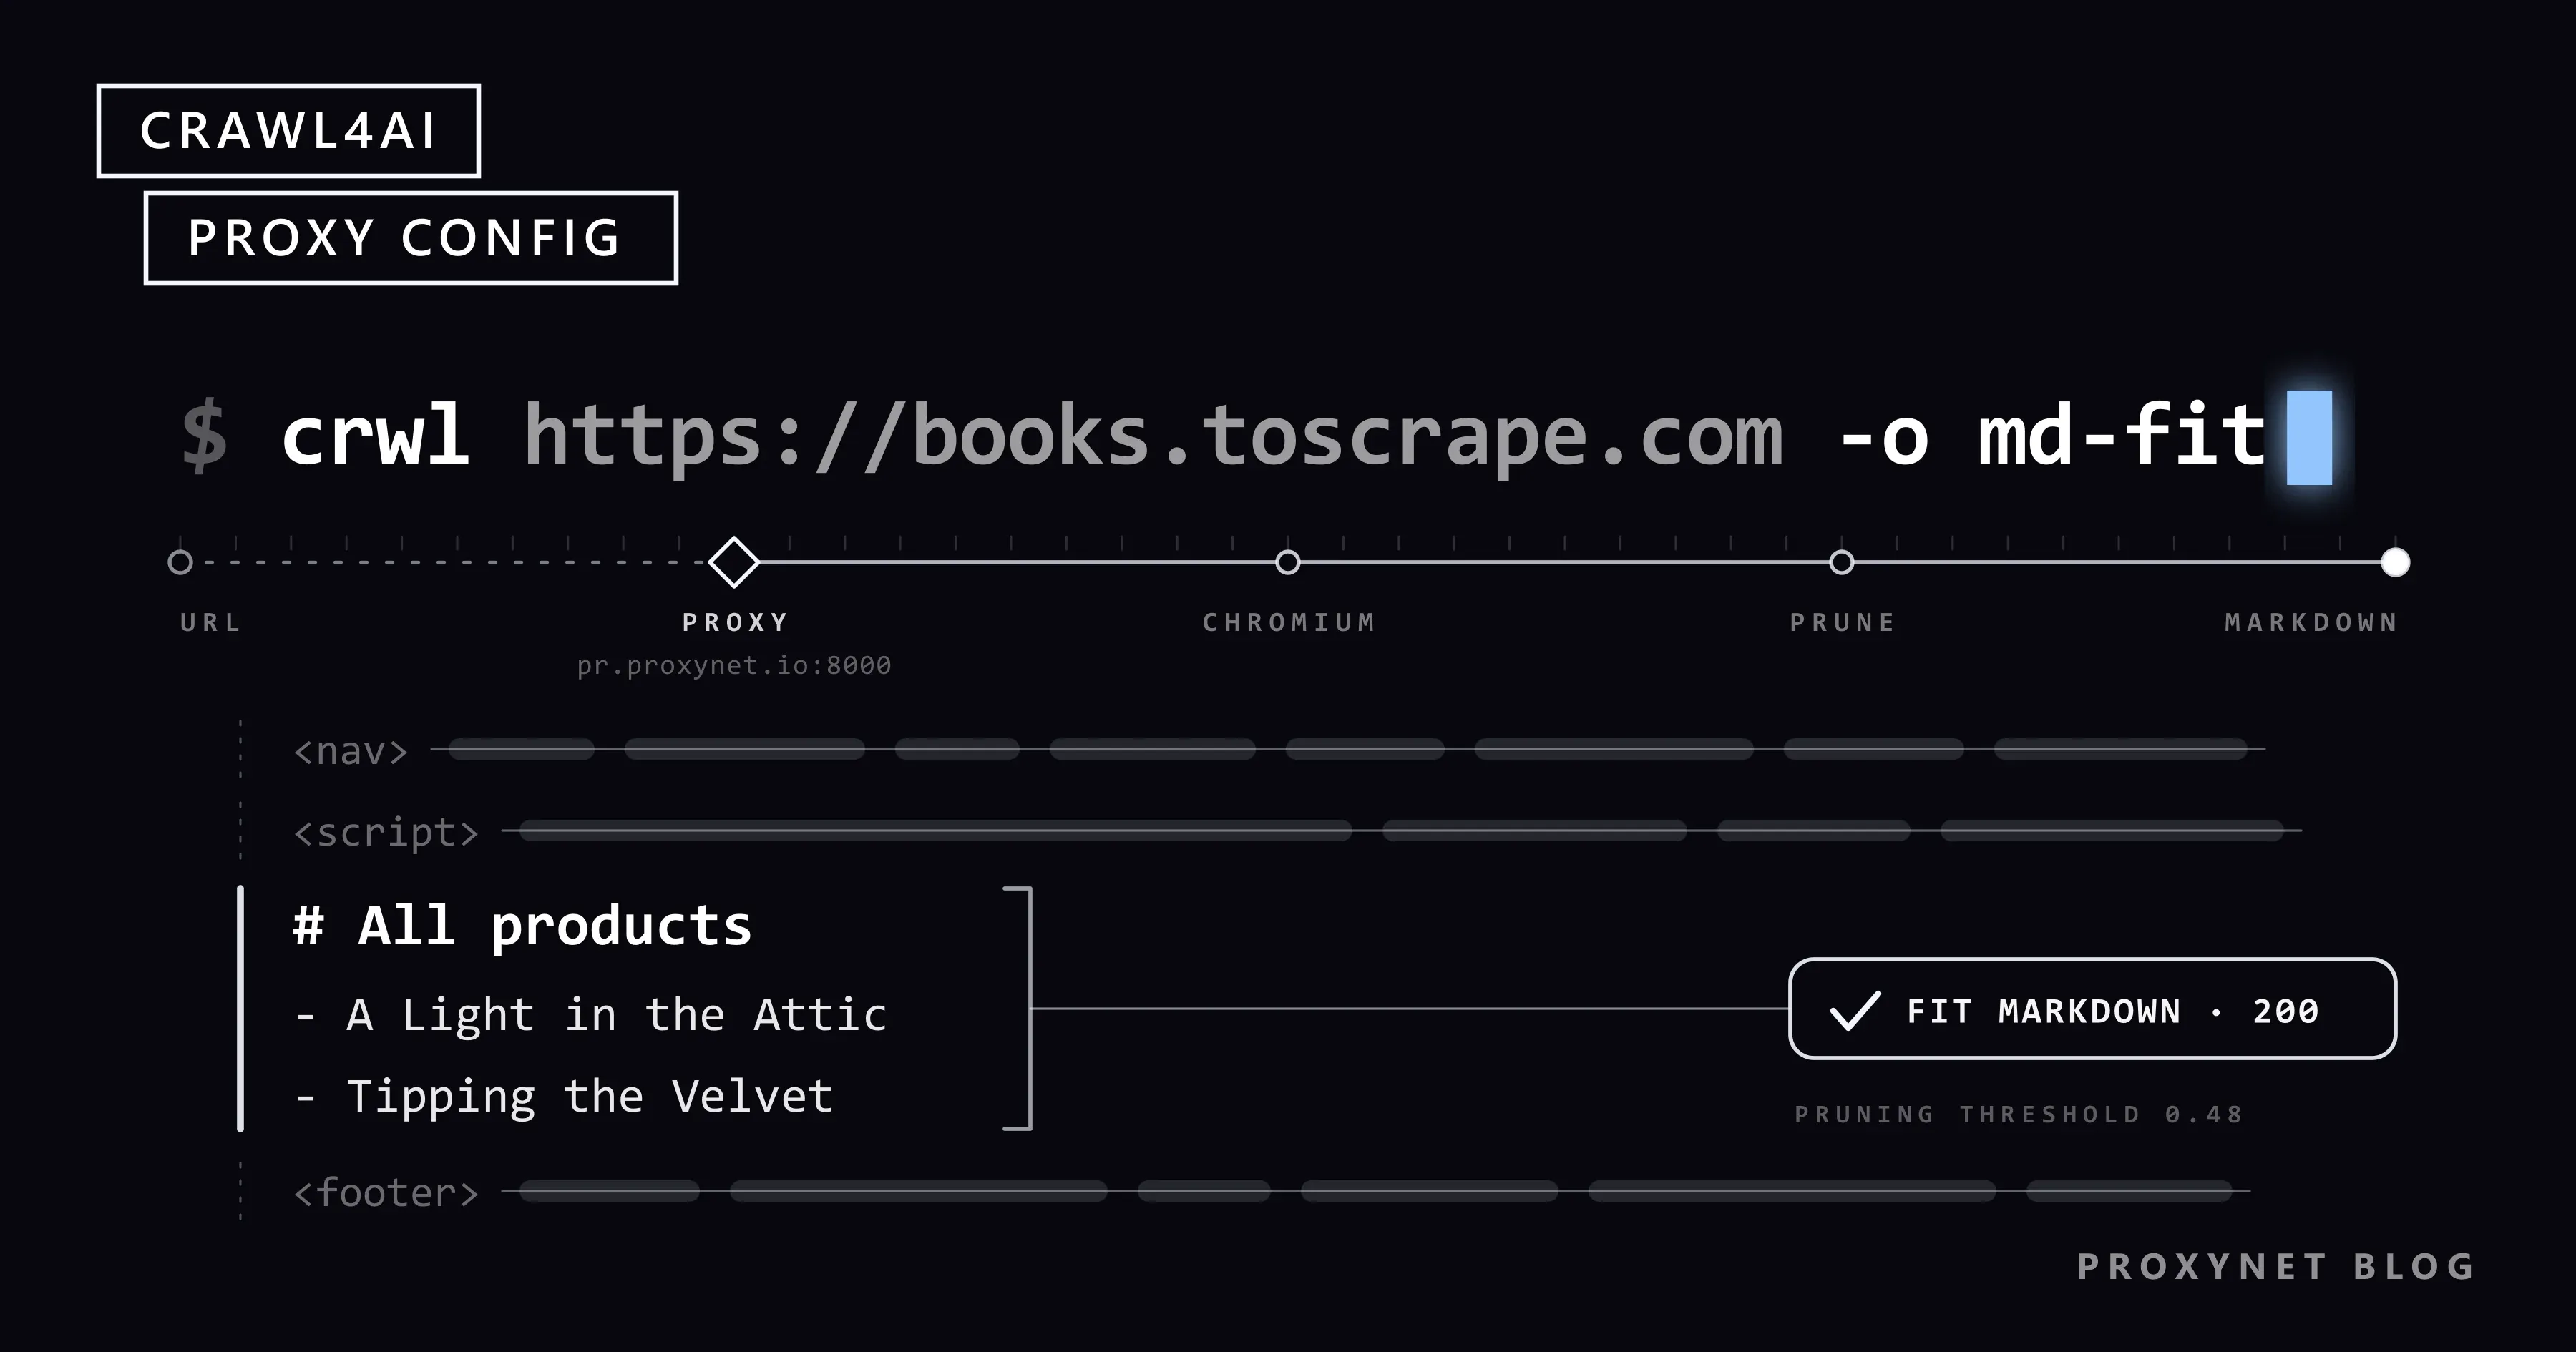
DefaultMarkdownGeneratorschreibtraw_markdown.- Ein
content_filterschreibtfit_markdown:PruningContentFilterLXMLbehält die textreichen Blöcke,BM25ContentFilterdie Blöcke, die zu einer Suchanfrage passen. Ohne Filter bleibtfit_markdownleer. - Ein
CrawlResultkommt zurück mitsuccess,status_code,error_message,markdownundlinks.
Auf einer unserer Testseiten hatte das rohe Markdown 1.241 Zeichen, das fit-Markdown 712: Menü und Footer waren weg, der Artikel blieb. Ein Cookie-Hinweis blieb ebenfalls stehen, weil der Filter Text- und Linkdichte bewertet, nicht die Bedeutung; excluded_selector=".cookie" in CrawlerRunConfig hat ihn entfernt.
Wie installieren Sie Crawl4AI mit pip oder Docker?
Der Weg über pip installiert die Bibliothek und einen Chromium-Build. Der Weg über Docker startet einen Server, den andere Programme per HTTP aufrufen.
# Python-SDK
pip install -U crawl4ai
crawl4ai-setup      # installiert den Playwright-Browser, den Crawl4AI nutzt
crawl4ai-doctor     # führt einen Test-Crawl aus und prüft so die Installation

# Docker-Server: ab 0.9.0 ist ein Token Pflicht
export CRAWL4AI_API_TOKEN="$(openssl rand -hex 32)"
docker run -d -p 11235:11235 --name crawl4ai --shm-size=1g \
  -e CRAWL4AI_API_TOKEN="$CRAWL4AI_API_TOKEN" \
  unclecode/crawl4ai:0.9.4

curl http://localhost:11235/health    # antwortet ohne Token
curl -X POST http://localhost:11235/md \
  -H "Authorization: Bearer $CRAWL4AI_API_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://quotes.toscrape.com/", "f": "fit"}'
Die Self-Hosting-Anleitung nutzt das Tag latest; ein Versions-Tag verhindert, dass ein Image-Update das Verhalten des Servers unbemerkt ändert. Die Seiten /playground und /dashboard haben oben ein Feld für das Token.
Die drei Arten, Crawl4AI zu betreiben, unterscheiden sich vor allem darin, wo der Proxy eingetragen werden kann:
| Weg | Einrichtung | Wo der Proxy steht | robots.txt und Tempo | Geeignet für |
|---|---|---|---|---|
| Python-SDK | pip install, crawl4ai-setup | proxy_config in CrawlerRunConfig oder BrowserConfig; proxy_rotation_strategy für eine Liste | check_robots_txt, SemaphoreDispatcher, RateLimiter | Jede Aufgabe, die Ihren eigenen Proxy braucht |
| Docker-Server | docker run mit Token, Port 11235 | Nicht in der Anfrage (HTTP 400) | check_robots_txt in der Anfrage erlaubt | Aufrufe aus anderen Sprachen, n8n oder Agenten |
crwl-CLI | Kommt mit pip | Browser-Konfigurationsdatei, -B | Crawler-Konfigurationsdatei, -C | Eine einzelne Seite als Markdown |
Wie bekommen Sie mit Python Markdown aus Ihrem ersten Crawl?
Das Skript öffnet eine Seite über einen Proxy, prüft vorher die robots.txt und gibt die Größe beider Markdown-Versionen aus. Die Proxy-Adresse kommt aus einer Umgebungsvariablen, damit das Passwort nicht im Code steht.
"""Eine Seite über einen Proxy crawlen und ihr Markdown ausgeben."""
import asyncio
import os
import sys

from crawl4ai import (
    AsyncWebCrawler,
    BrowserConfig,
    CacheMode,
    CrawlerRunConfig,
    DefaultMarkdownGenerator,
    ProxyConfig,
    PruningContentFilterLXML,
)

URL = sys.argv[1] if len(sys.argv) > 1 else "https://quotes.toscrape.com/"


async def main():
    # PROXY_URL=http://user:pass@pr.proxynet.io:8000, bleibt außerhalb des Codes
    proxy = ProxyConfig.from_string(os.environ["PROXY_URL"])

    browser_config = BrowserConfig(
        headless=True,
        user_agent="NorthwindDocsBot/1.0 (+https://example.com/bot)",
    )
    run_config = CrawlerRunConfig(
        proxy_config=proxy,
        check_robots_txt=True,
        cache_mode=CacheMode.BYPASS,
        markdown_generator=DefaultMarkdownGenerator(
            content_filter=PruningContentFilterLXML(threshold=0.48)
        ),
    )

    async with AsyncWebCrawler(config=browser_config) as crawler:
        result = await crawler.arun(URL, config=run_config)

    if not result.success:
        print(f"failed: {result.status_code} {result.error_message}")
        return

    md = result.markdown
    print(f"status {result.status_code}")
    print(f"raw_markdown: {len(md.raw_markdown)} characters")
    print(f"fit_markdown: {len(md.fit_markdown)} characters")
    print(md.fit_markdown[:400])


asyncio.run(main())
Auf quotes.toscrape.com, einer Übungsseite für Scraping, gab das Skript Folgendes aus:
status 200
raw_markdown: 4375 characters
fit_markdown: 3663 characters
CacheMode.BYPASS ruft die Seite jedes Mal neu ab; ohne diese Einstellung kommen wiederholte URLs aus dem lokalen Cache. Nutzen Sie PruningContentFilterLXML: In 0.9.4 gibt der ältere PruningContentFilter eine Deprecation-Warnung aus.
Wie richten Sie einen Proxy in Crawl4AI ein?
Ein Proxy ist ein ProxyConfig mit server, username und password und gehört an eine von zwei Stellen:
from crawl4ai import BrowserConfig, CrawlerRunConfig, ProxyConfig

proxy = ProxyConfig(server="http://pr.proxynet.io:8000", username="user", password="pass")

run_config = CrawlerRunConfig(proxy_config=proxy)    # nur dieser Lauf
browser_config = BrowserConfig(proxy_config=proxy)   # jede Seite, die dieser Browser öffnet
Die offizielle Proxy-Anleitung empfiehlt CrawlerRunConfig, damit jeder Lauf seinen eigenen Proxy mitbringt. In unserem Test funktionierte beides.
ProxyConfig.from_string() liest http://user:pass@host:port, host:port:user:pass, host:port und socks5://host:port. ProxyConfig.from_env("PROXIES") liest eine kommagetrennte Liste aus einer Umgebungsvariablen. Der alte Parameter proxy= funktioniert noch, gibt aber eine Deprecation-Warnung aus.
SOCKS5 mit Passwort funktioniert nicht. Mit socks5:// und Benutzername, in beiden Schreibweisen, scheiterte unser Crawl mit „Browser does not support socks5 proxy authentication“. Die Grenze liegt bei Chromium (Playwright mit Proxy). Nutzen Sie den HTTP-Endpunkt des Proxys, oder geben Sie die IP Ihres Servers im Proxy-Panel frei (IP-Whitelist) und verbinden Sie sich ohne Passwort (SOCKS und HTTP Proxy im Vergleich).
Um den Proxy zu prüfen, crawlen Sie eine Seite, die die IP des Besuchers anzeigt.
Rotation oder Sticky-Sitzung: Wann brauchen Sie RoundRobinProxyStrategy?
Das hängt davon ab, worauf Ihre Proxy-Adresse zeigt.
Ein rotierendes Gateway ist eine einzige Adresse wie pr.proxynet.io:8000, hinter der der Anbieter die Ausgangs-IP wechselt. Ist Ihr Proxy ein Rotierender Proxy oder ein rotierender Residential-Proxy, braucht Crawl4AI nur ein ProxyConfig. Die Demo auf der offiziellen Proxy-Seite vergleicht die IP, die eine Website gesehen hat, mit ProxyConfig.ip; bei einem Gateway meldet diese Prüfung immer eine Abweichung, weil die Ausgangs-IP nie die Adresse des Gateways ist.
Eine feste IP-Liste, zum Beispiel aus einem Tarif mit Datacenter-Proxy oder ISP-Proxy, ist der Fall, in dem RoundRobinProxyStrategy hilft: Jede Anfrage bekommt den nächsten Proxy der Liste. Mit proxy_session_id behalten Anfragen mit derselben ID denselben Proxy, bis proxy_session_ttl Sekunden vergangen sind:
"""Eine feste Proxy-Liste durchrotieren oder einen Proxy für eine ganze Sitzung behalten."""
import asyncio

from crawl4ai import (
    AsyncWebCrawler,
    BrowserConfig,
    CacheMode,
    CrawlerRunConfig,
    ProxyConfig,
    RoundRobinProxyStrategy,
)

# PROXIES="http://user:pass@203.0.113.10:8000,http://user:pass@203.0.113.11:8000"
strategy = RoundRobinProxyStrategy(ProxyConfig.from_env("PROXIES"))

rotate = CrawlerRunConfig(proxy_rotation_strategy=strategy, cache_mode=CacheMode.BYPASS)
sticky = CrawlerRunConfig(
    proxy_rotation_strategy=strategy,
    proxy_session_id="catalog-1",  # jede Anfrage mit dieser ID bekommt denselben Proxy
    proxy_session_ttl=600,         # Sekunden; danach wählt die Sitzung einen neuen
    cache_mode=CacheMode.BYPASS,
)


async def main(base):
    async with AsyncWebCrawler(config=BrowserConfig(headless=True)) as crawler:
        for label, config in (("rotate", rotate), ("sticky", sticky)):
            for page in range(1, 4):
                result = await crawler.arun(f"{base}/catalog?page={page}", config=config)
                print(label, page, result.status_code, config.proxy_config.server)


asyncio.run(main("https://shop.example.com"))
Mit zwei lokalen Proxys wechselten sich die rotate-Anfragen ab, und die sticky-Anfragen behielten einen Proxy. Die Sitzungsparameter stehen im Quellcode von 0.9.4, aber nicht auf der Dokumentationsseite zu Proxys; prüfen Sie sie nach Updates also erneut.
Halten Sie die beiden Ebenen auseinander. Die Sticky-Sitzung von Crawl4AI wählt denselben Eintrag aus Ihrer Liste; hinter einem rotierenden Gateway bleibt die Ausgangs-IP nur fest, wenn der Anbieter sie hält, wie es eine Sitzung mit einem Sticky-Proxy für 1 bis 60 Minuten tut. Die Modi erklärt der Beitrag zur IP-Rotation, die Rotation für einfache HTTP-Clients Proxys in Python rotieren.
Warum kann eine Docker-Anfrage keinen Proxy mitgeben?
Seit 0.9.0 ist der Docker-Server standardmäßig abgesichert. Ein Request-Body mit proxy oder proxy_config erhält HTTP 400, ebenso js_code, headers, cookies, magic und einige weitere Felder (Migrationshinweise zu 0.9.0). Der Grund ist Server-Side Request Forgery (SSRF): Ein Aufrufer könnte den Browser des Servers sonst über einen beliebigen Proxy oder an interne Adressen schicken.
Laut den Hinweisen sollen solche Optionen auf dem Server konfiguriert werden, doch im Quellcode von 0.9.4 entfernt ein Egress-Guard jedes proxy_config, auch eines in config.yml, und leitet Chromium über den eigenen filternden Proxy des Servers. Der Quellcode liest außerdem einen vorgelagerten HTTP-Proxy aus CRAWL4AI_UPSTREAM_PROXY oder HTTPS_PROXY; das ist nicht dokumentiert, und wir konnten es nicht testen. Für Ihren eigenen Proxy betreiben Sie das SDK in Ihrem eigenen Dienst.
Wie stellen Sie robots.txt, Tempo und Parallelität ein?
check_robots_txt ist standardmäßig False. Wir haben das Verhalten von 0.9.4 mit lokalen Websites getestet:
- Ein gesperrter Pfad liefert den Status
403, und die Seite wird nie angefragt. - Eine robots.txt, die mit
500antwortet, gilt als „alles erlaubt“, ebenso ein Timeout nach 2 Sekunden und ein Netzwerkfehler. Laut RFC 9309 muss ein Crawler bei Serverfehlern von einem vollständigen Verbot ausgehen. - Regeln werden 7 Tage lang gecacht. Laut RFC 9309 sollte eine gecachte Kopie nicht länger als 24 Stunden verwendet werden;
crawler.robots_parser.clear_cache()leert den Cache. - Die robots.txt wird direkt von Ihrem Rechner abgerufen, nicht über den Proxy, und zwar mit einem generischen
aiohttp-User-Agent. - Die Regeln werden mit
BrowserConfig.user_agentabgeglichen. Standard ist ein Chrome-String, einDisallowfür den Namen Ihres Bots greift also nur, wenn IhrUser-Agentdiesen Namen enthält. Ein Pfad unter/privateöffnete sich mit dem Standard-String und lieferte mitNorthwindDocsBot/1.0den Status403.
Prüfen Sie die robots.txt bei sensiblen Aufgaben vorher selbst (robots.txt, Was ist ein User-Agent?).
Das Tempo legen Sie im Dispatcher fest. SemaphoreDispatcher(semaphore_count=3) hält höchstens drei Seiten gleichzeitig offen (Concurrency und Parallelism). RateLimiter wartet zwischen Anfragen an dieselbe Domain, verdoppelt die Wartezeit nach einem 429 oder 503 ungefähr, bis max_delay erreicht ist, und verkürzt sie nach erfolgreichen Anfragen. Eine abgelehnte Seite ruft er nicht erneut ab: Das Ergebnis kommt mit 429 zurück, und die Wiederholung ist Ihre Aufgabe. Das folgende Skript crawlt in Dreiergruppen und gibt abgelehnten Seiten zwei weitere Runden:
"""Die Seiten einer Website in rücksichtsvollem Tempo crawlen und jede als Markdown speichern."""
import asyncio
import os
import re
from pathlib import Path

from crawl4ai import (
    AsyncWebCrawler,
    BrowserConfig,
    CacheMode,
    CrawlerRunConfig,
    DefaultMarkdownGenerator,
    ProxyConfig,
    PruningContentFilterLXML,
    RateLimiter,
    SemaphoreDispatcher,
)

BASE = os.environ.get("DOCS_BASE", "https://docs.example.com")
URLS = [f"{BASE}/docs/{n}" for n in range(1, 13)] + [f"{BASE}/private/report"]
OUT = Path("pages")
BATCH = 3                 # gleichzeitig geöffnete Seiten
PAUSE = 5.0               # Sekunden zwischen zwei Gruppen
RETRY_CODES = {429, 503}  # später einen neuen Versuch wert
ROUNDS = 3                # erster Durchlauf plus zwei Wiederholungsrunden
ROUND_PAUSE = 60          # Sekunden vor einer Wiederholungsrunde; verdoppelt sich pro Runde


def file_name(url):
    return re.sub(r"[^a-z0-9]+", "-", url.lower()).strip("-") + ".md"


async def crawl_round(crawler, urls, run_config, dispatcher):
    """URLs in kleinen Gruppen crawlen und die zurückgeben, die später erneut versucht werden."""
    retry = []
    for i in range(0, len(urls), BATCH):
        results = await crawler.arun_many(
            urls[i : i + BATCH], config=run_config, dispatcher=dispatcher
        )
        for r in results:
            if r.success and r.status_code == 200:
                (OUT / file_name(r.url)).write_text(r.markdown.fit_markdown, encoding="utf-8")
                print(f"saved  {r.url}")
            elif r.status_code in RETRY_CODES:
                retry.append(r.url)
                print(f"later  {r.status_code} {r.url}")
            else:
                print(f"skip   {r.status_code} {r.url}: {r.error_message}")
        await asyncio.sleep(PAUSE)
    return retry


async def main():
    OUT.mkdir(exist_ok=True)
    browser_config = BrowserConfig(
        headless=True,
        user_agent="NorthwindDocsBot/1.0 (+https://example.com/bot)",
    )
    run_config = CrawlerRunConfig(
        proxy_config=ProxyConfig.from_string(os.environ["PROXY_URL"]),
        check_robots_txt=True,
        cache_mode=CacheMode.BYPASS,
        page_timeout=30000,
        markdown_generator=DefaultMarkdownGenerator(
            content_filter=PruningContentFilterLXML(threshold=0.48)
        ),
    )
    # Ein Dispatcher für den ganzen Lauf: Der RateLimiter behält das langsamere Tempo, das er aus 429-Antworten lernt
    dispatcher = SemaphoreDispatcher(
        semaphore_count=BATCH,
        rate_limiter=RateLimiter(base_delay=(1.0, 3.0), max_delay=60.0, max_retries=3),
    )

    pending = list(URLS)
    async with AsyncWebCrawler(config=browser_config) as crawler:
        for round_no in range(ROUNDS):
            if round_no:
                wait = ROUND_PAUSE * 2 ** (round_no - 1)
                print(f"round {round_no + 1}: {len(pending)} pages again in {wait} s")
                await asyncio.sleep(wait)
            pending = await crawl_round(crawler, pending, run_config, dispatcher)
            if not pending:
                break

    print(f"done, {len(pending)} pages still refused")


asyncio.run(main())
Wir haben DOCS_BASE auf eine lokale Website gerichtet, die jede vierte Anfrage unter /docs/ mit 429 beantwortet und /private sperrt, und ROUND_PAUSE für den Test auf 5 Sekunden gesetzt. Gekürzte Ausgabe:
saved  http://192.168.1.2:28130/docs/1
saved  http://192.168.1.2:28130/docs/2
saved  http://192.168.1.2:28130/docs/3
later  429 http://192.168.1.2:28130/docs/4
...
later  429 http://192.168.1.2:28130/docs/11
saved  http://192.168.1.2:28130/docs/12
skip   403 http://192.168.1.2:28130/private/report: Access denied by robots.txt
round 2: 3 pages again in 5 s
saved  http://192.168.1.2:28130/docs/4
saved  http://192.168.1.2:28130/docs/9
saved  http://192.168.1.2:28130/docs/11
done, 0 pages still refused
Das eigene Log von Crawl4AI gibt für jede abgelehnte Seite außerdem „Blocked by anti-bot protection: HTTP 429 Too Many Requests“ aus. Wie Sie einen echten Retry-After-Header behandeln, zeigt HTTP-Statuscodes beim Web Scraping.
Was ist der Unterschied zwischen Crawl4AI und Firecrawl?
Beide wandeln Seiten in Markdown für Sprachmodelle um; sie unterscheiden sich darin, wie Sie sie betreiben.
| Crawl4AI | Firecrawl | |
|---|---|---|
| Lizenz | Apache 2.0 plus Pflicht zur Namensnennung | AGPL-3.0 |
| Hauptform | Eine Python-Bibliothek; optionaler Docker-Server | Eine gehostete API; Self-Hosting möglich |
| Selbst gehostete Teile | Ein Container | API, Worker, Playwright, Redis, RabbitMQ, PostgreSQL |
| Kosten | Ihr Server, Ihr Proxy und gegebenenfalls ein LLM | API-Tarif oder eigene Server |
Die Self-Hosting-Anleitung von Firecrawl weist darauf hin, dass die selbst gehostete API standardmäßig keine Authentifizierung hat. Crawl4AI passt zu einem Python-Team, das seine Crawls und Proxys selbst betreiben möchte.
Wie nutzen Sie Crawl4AI mit MCP und n8n?
Der Docker-Server stellt MCP unter /mcp/sse und /mcp/ws bereit, mit den Tools md, html, screenshot, pdf, execute_js, crawl und ask. Der Befehl für Claude Code in der Anleitung enthält kein Token, die MCP-Endpunkte liegen aber hinter derselben Token-Prüfung wie die API; fügen Sie also den Header hinzu:
claude mcp add --transport sse c4ai-sse http://localhost:11235/mcp/sse \
  --header "Authorization: Bearer $CRAWL4AI_API_TOKEN"
WebSocket-Clients, die keine Header setzen können, übergeben das Token mit ?token=. Das Protokoll erklärt Was ist MCP (Model Context Protocol)?, wie Sie einem Agenten einen vollständigen Browser geben, zeigt Playwright MCP.
In n8n sendet ein HTTP-Request-Node POST /md mit dem Bearer-Header und einem Body wie {"url": "https://quotes.toscrape.com/", "f": "fit"}; die Seite kommt im Feld markdown zurück (Web Scraping mit n8n).
Anwendungsfälle
- Dokumentation für RAG: Produktdokumentation als Markdown für einen Retrieval-Index, abgesichert durch die Prüfungen aus Sicherer Webzugriff für LLMs.
- Saubere Eingaben für Agenten: fit-Markdown statt rohem HTML (Agentic Web Scraping).
- Preisprüfungen: Produktseiten, die mit einem CSS-Schema in JSON umgewandelt werden (Preisüberwachung).
- Bestandsaufnahme der eigenen Website: jede Seite und jeder Link, für Content-Audits und die Suche nach defekten Links (Web-Crawler).
- Katalogdaten: Namen, technische Daten und Preise aus öffentlichen Katalogseiten (Data Scraping).
Häufige Fehler
docker runohne Token oder-e CRAWL4AI_API_TOKENohne Wert: „connection reset“ von einem scheinbar gesunden Container.proxy_configin einer REST-Anfrage: Der Server antwortet mit400.socks5://mit Passwort: Chromium lehnt es ab.- Ein rotierendes Gateway mehrfach in
RoundRobinProxyStrategy: Das Gateway rotiert bereits selbst. fit_markdownohnecontent_filtererwarten: Es bleibt leer.- Davon ausgehen, dass die robots.txt geprüft wird: Die Prüfung ist standardmäßig aus, und eine robots.txt, die nicht lädt, gilt als „erlaubt“.
- Hohe Parallelität ohne
RateLimiter: Zehn parallele Seiten auf einer kleinen Website wirken wie ein Ansturm, und429-Antworten folgen. - Die IP wechseln, um eine Website zu bedrängen, die mit
429geantwortet hat: Werden Sie stattdessen langsamer (Bot-Erkennung: So funktionieren Anti-Bot-Systeme).
Stealth-Modus, „Magic“-Modus und die Anti-Bot-Fallback-Funktionen aus der Dokumentation behandelt dieser Leitfaden nicht, und wir empfehlen sie nicht.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Einige Dokumentationsseiten als sauberer Text für ein LLM | pip install, arun() mit PruningContentFilterLXML |
| Bei jeder Anfrage eine andere Ausgangs-IP | Ein ProxyConfig mit einem rotierenden Residential-Gateway |
| Dieselbe IP über einen mehrstufigen Ablauf | Eine Sticky-Sitzung des Anbieters, bei einer Liste zusätzlich proxy_session_id |
| Eine feste IP-Liste | ProxyConfig.from_env("PROXIES") mit RoundRobinProxyStrategy |
| Crawlen aus n8n, einer anderen Sprache oder einem Agenten | Ein Docker-Server mit Token; Proxy-Aufgaben bleiben im SDK |
| Hunderte Seiten, ohne die Website zu belasten | Kleine Gruppen, RateLimiter, check_robots_txt=True |
| Keine eigene Infrastruktur | Eine gehostete API wie Firecrawl |
Häufige Fragen
Ist Crawl4AI kostenlos?
Ja, die Bibliothek ist unter der Apache-2.0-Lizenz kostenlos. Ihre LICENSE-Datei ergänzt die Pflicht, das Projekt bei öffentlicher Nutzung zu nennen, zum Beispiel in einer README oder auf einer „Über uns“-Seite. Kosten entstehen für den Server, den Proxy und jedes Sprachmodell, das Sie aufrufen.
Welche Python-Version braucht Crawl4AI?
Laut PyPI Python 3.10 oder neuer. Wir haben Version 0.9.4 mit Python 3.13 getestet.
Funktioniert Crawl4AI mit einem lokalen LLM wie Ollama?
Die Markdown-Ausgabe braucht kein Sprachmodell. Für die Extraktion mit einem LLM zeigt die Dokumentation LLMConfig(provider="ollama/llama3.3") für ein lokales Ollama-Modell, ohne API-Schlüssel.
Was ist der Unterschied zwischen Crawl4AI und Scrapy?
Scrapy sendet einfache HTTP-Anfragen und führt standardmäßig kein JavaScript aus; Crawl4AI rendert jede Seite in Chromium und liefert Markdown. Scrapy eignet sich für große Crawls über statisches HTML (Scrapy mit Proxy), Crawl4AI für Seiten, die an ein Sprachmodell gehen.
Kann ich Crawl4AI aus Node.js oder einer anderen Sprache nutzen?
Die Bibliothek selbst ist in Python geschrieben. Aus anderen Sprachen rufen Sie die REST-API des Docker-Servers auf, zum Beispiel POST /md mit dem Token im Header.
Was tun, wenn eine Website Crawl4AI blockiert?
Werden Sie zuerst langsamer: weniger parallele Seiten, längere Wartezeiten und eine Pause nach jedem 429. Prüfen Sie die robots.txt und die Nutzungsbedingungen der Website und suchen Sie nach einer offiziellen API oder einem Feed. Lehnt die Website weiterhin ab, hören Sie auf; die rechtliche Seite behandelt Ist Web Scraping legal?.
Fazit
Crawl4AI wandelt Seiten in Markdown um, das ein Sprachmodell lesen kann. Für Proxy-Aufgaben nutzen Sie das SDK: ein ProxyConfig für ein rotierendes Gateway, RoundRobinProxyStrategy für eine feste Liste, kein Passwort bei SOCKS5. Der Docker-Server braucht ein Token und akzeptiert keinen Proxy in der Anfrage. Schalten Sie check_robots_txt ein, senden Sie einen ehrlichen User-Agent und lassen Sie einen RateLimiter das Tempo bestimmen. Ausgangs-IPs in vielen Ländern oder eine feste Adresse bieten unsere Proxy-Dienste.