Montagmorgen, Sie öffnen den Verkaufsbericht: Bei Ihren drei meistverkauften Produkten haben sich die Bestellungen am Wochenende halbiert. Den Grund finden Sie am Nachmittag, als Sie von Hand auf die Seite des Wettbewerbers schauen. Er hat am Freitagabend den Preis gesenkt, und Sie waren zwei Tage lang zu teuer. Genau dieses Problem löst die Beobachtung von Wettbewerberpreisen: Sie erfahren von der Änderung durch die Änderung selbst und nicht durch den entgangenen Umsatz.
In diesem Beitrag bauen wir den Ablauf von Anfang bis Ende auf. Zuerst vergleichen wir, woher die Daten kommen können (Verkäufer-API, fertiges Tool, eigenes Skript); danach geht es um den Produktabgleich, um die Frage, welcher Preis gespeichert wird, und darum, wie Sie das Abrufintervall berechnen. Für Entwickler gibt es ein getestetes Python-Beispiel, das den Preis aus der Seite liest, den Verlauf in SQLite ablegt und bei Überschreiten eines Schwellenwerts warnt. Am Ende stehen die Grenzen: Nutzungsbedingungen, robots.txt und Kartellrecht.
Aus welchen Schritten besteht die Preisbeobachtung?
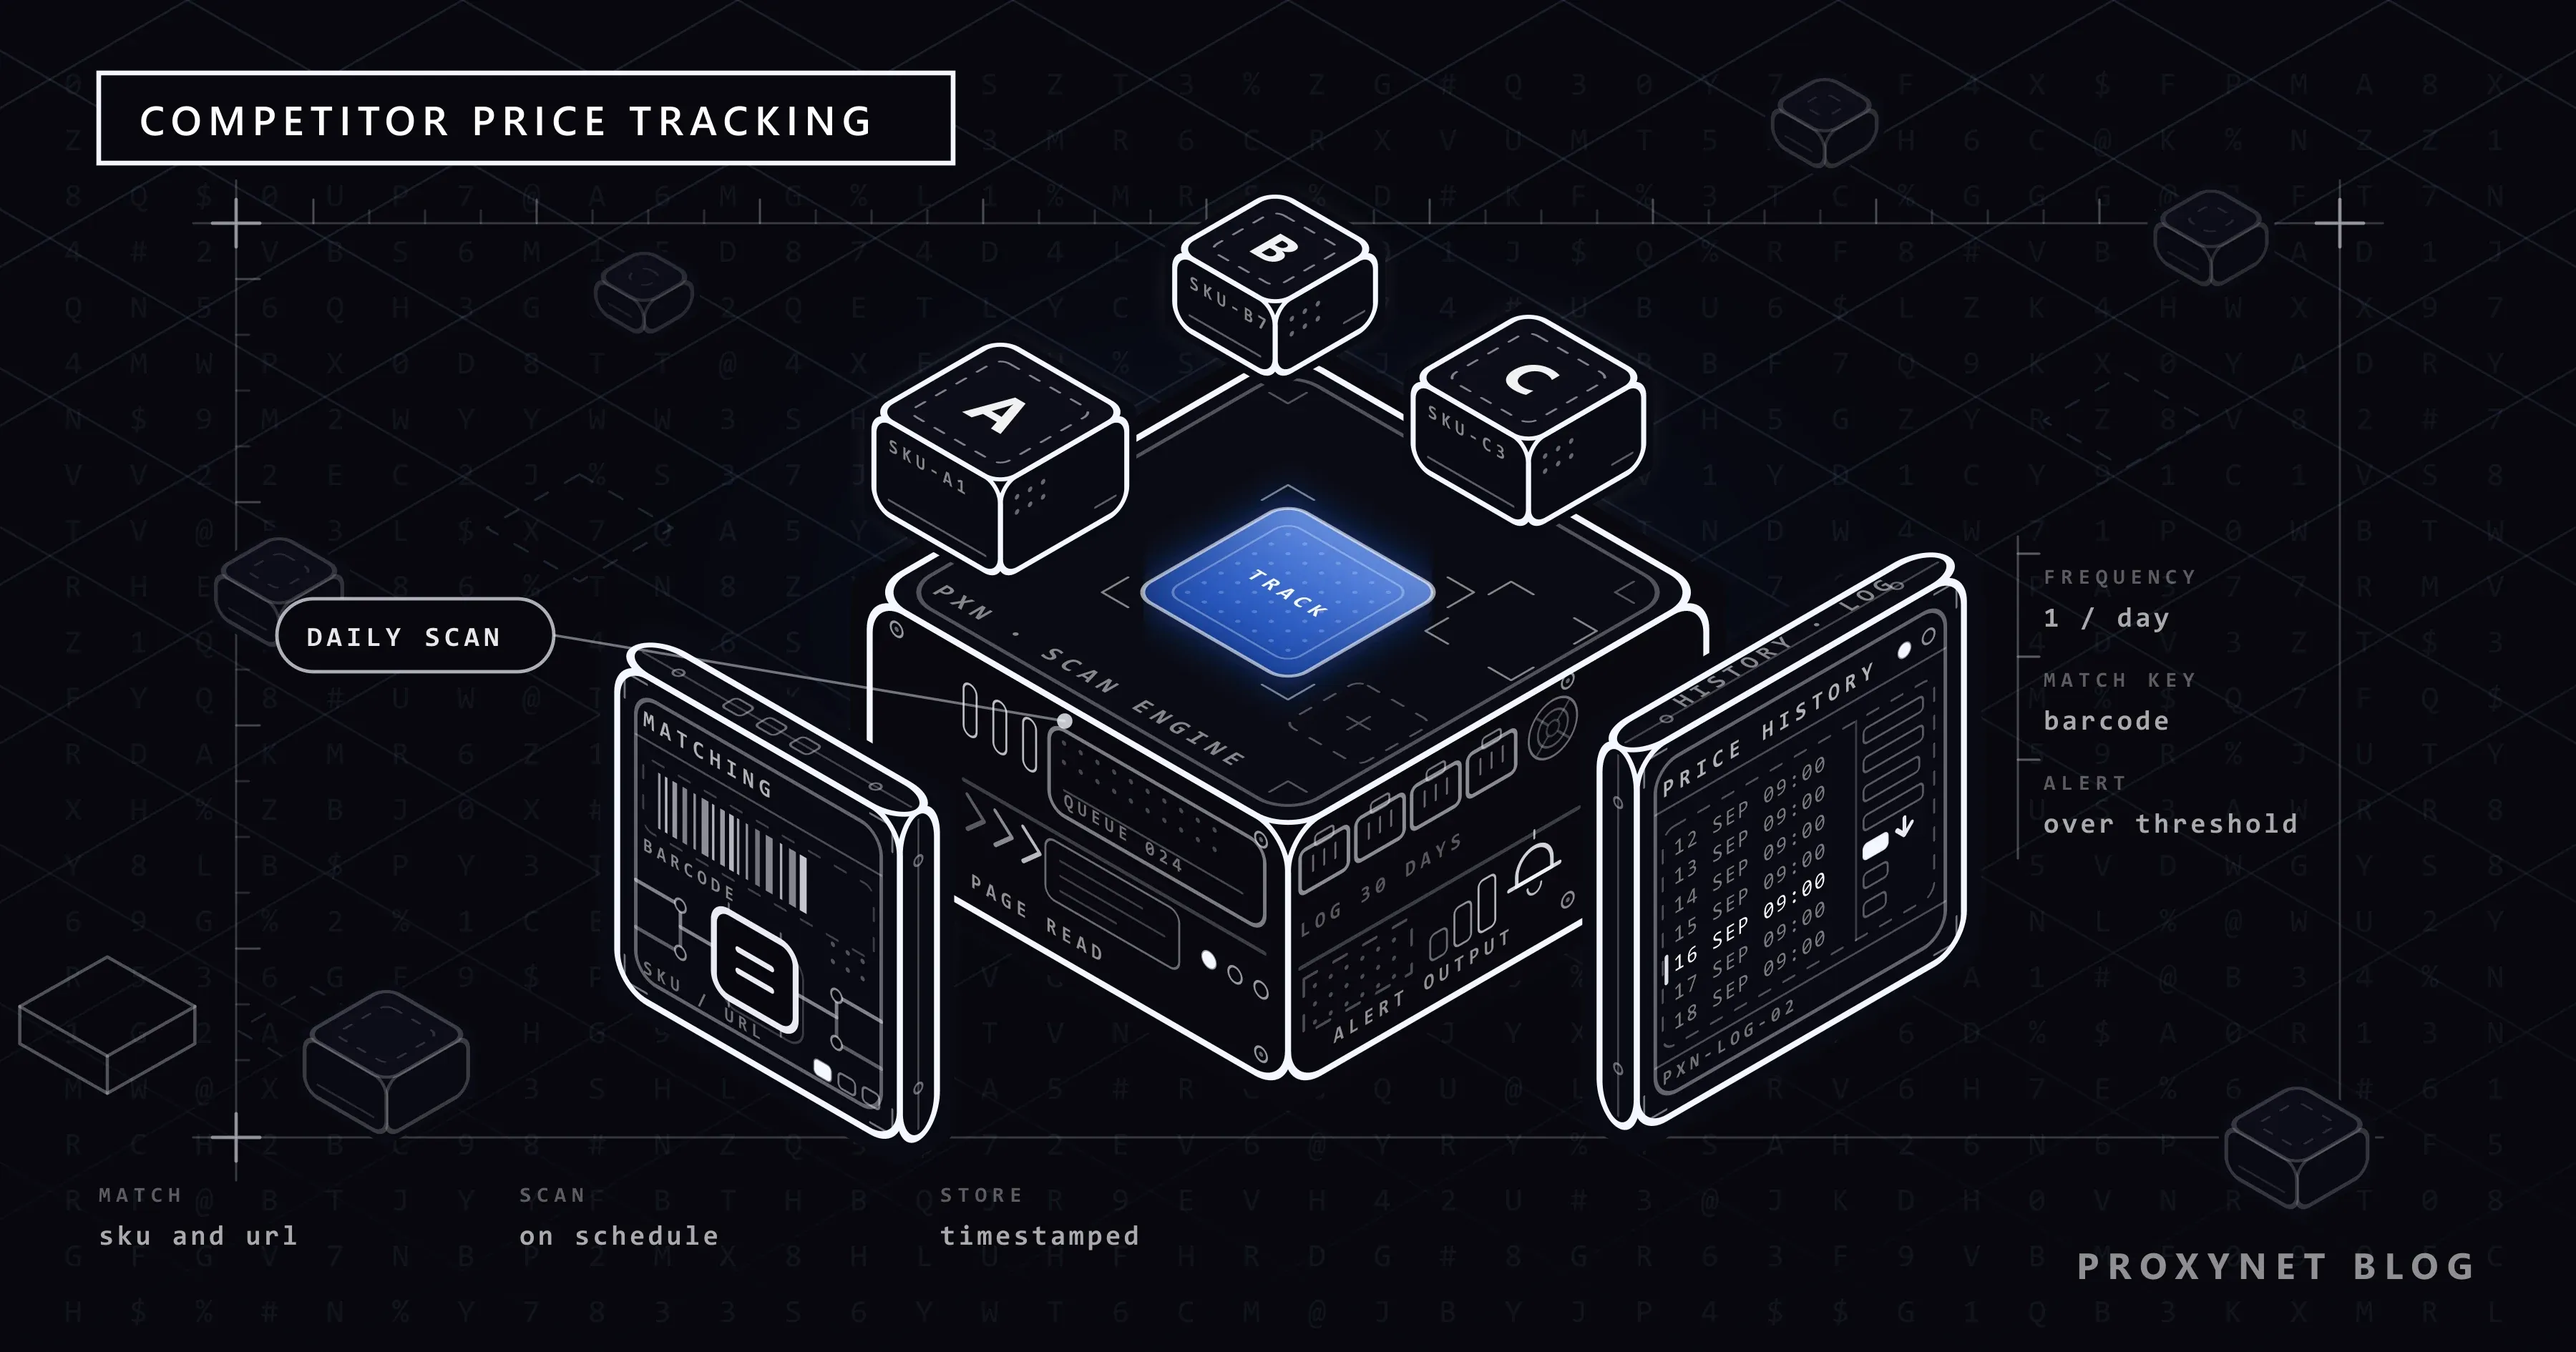
Preisbeobachtung heißt, Preis- und Bestandsangaben auf den Produktseiten von Wettbewerbern in regelmäßigen Abständen zu lesen und zu speichern. Die ausführliche Definition und die Infrastrukturseite finden Sie auf unserer Seite zur Preisüberwachung; hier geht es darum, wie man den Ablauf aufsetzt. Unabhängig vom Werkzeug ist er immer derselbe:
- Umfang festlegen. Beobachten Sie nicht den ganzen Katalog, sondern die Produkte, die den Umsatz tragen und preissensibel sind.
- Produkte abgleichen. Tragen Sie zu jeder Ihrer Artikelnummern (SKU) die Adresse desselben Produkts beim Wettbewerber ein.
- Seiten regelmäßig lesen. Erfasst werden Preis, Währung, Verfügbarkeit und, falls vorhanden, der Name des Verkäufers.
- Jeden Abruf mit Datum speichern. Eine Tabelle, die nur den letzten Preis hält, kann die Frage „Wann hat er sich geändert?" nicht beantworten.
- Änderung mit einem Schwellenwert vergleichen und melden. Kommt für jede Cent-Bewegung eine E-Mail, liest nach drei Tagen niemand mehr die Warnungen.
- Die Entscheidung einem Menschen überlassen. Eine Warnung ist ein Vorschlag. Wer den Preis nach welcher Regel ändert, ist eine eigene geschäftliche Entscheidung.
Woher kommen die Daten: Verkäufer-API, fertiges Tool oder eigenes Skript?
Schauen Sie zuerst auf den offiziellen Weg. Marktplätze stellen ihren Verkäufern APIs bereit, mit denen diese ihre eigenen Produkt-, Bestands- und Preisdaten verwalten. Amazons Selling Partner API deckt zum Beispiel Angebote, Preise, Bestellungen und Lagerbestand ab und gilt auch für Amazon.de; die OTTO Market API richtet sich an Verkäufer und deren Dienstleister und umfasst Bereiche wie Produkte und Bestellungen. Diese APIs sind für Ihren eigenen Shop gedacht, über Wettbewerber verraten sie wenig. Amazons Product Pricing API liefert Wettbewerbspreisdaten zu Produkten im Amazon-Katalog, etwa zum hervorgehobenen Angebot (Featured Offer). Über den eigenen Webshop eines Wettbewerbers, einen anderen Marktplatz oder ein Produkt, das Sie nicht führen, erfahren Sie dort nichts. Trotzdem sollte die linke Spalte des Vergleichs, also Ihr eigener aktueller Preis, von hier kommen und nicht aus einer von Hand gepflegten Tabelle.
Für die Seite des Wettbewerbers sehen die Möglichkeiten nebeneinander so aus:
| Methode | Was sie liefert | Aufwand | Wann sie passt |
|---|---|---|---|
| Verkäufer-API | Ihre eigenen Preis-, Bestands- und Bestelldaten; auf manchen Marktplätzen den Preis des hervorgehobenen Angebots für Produkte, die Sie verkaufen | Einmalige Integration | Immer, für die eigene Seite des Vergleichs |
| Manuelle Kontrolle und Tabelle | Den aktuellen Preis weniger Produkte | Täglich wiederkehrende Handarbeit | 20-30 Produkte, wöchentlicher Blick |
| Fertiges Preisbeobachtungs-Tool | Abgleich, Crawling und Berichtsoberfläche | Monatliches Abo, wenig Einrichtung | Kein Entwicklerteam, Standard-Marktplätze reichen aus |
| Eigenes Skript | Jede gewünschte Website, jedes Feld, jedes Intervall | Entwicklung und Wartung | Spezielle Websites, Datenfluss ins eigene Data Warehouse, flexible Alarmregeln |
| Ablauf in einem Automatisierungstool | Das Skript ohne Code | Mittel | Kleine Liste, fertige Anbindungen für Tabellen und Benachrichtigungen |
Ein Beispiel für die letzte Zeile haben wir im Beitrag Web Scraping mit n8n aufgebaut. Wie Sie ganz ohne Code eine Tabelle aus einer Seite holen, erklären wir Schritt für Schritt in Daten aus einer Website extrahieren.
Wie gleicht man Produkte ab?
Ein falsch zugeordnetes Produkt schadet mehr als eines, das gar nicht beobachtet wird: Eine Warnung, die den Preis des 64-GB-Modells mit dem des 128-GB-Modells vergleicht, führt Sie zu einem unnötigen Rabatt. Nach Verlässlichkeit geordnet sieht der Abgleich so aus:
- Barcode (GTIN/EAN). Steht auf zwei Seiten derselbe Barcode, ist es dasselbe Produkt. In strukturierten Daten steht er im Feld
gtin13odergtin, manchmal auch in der Tabelle mit den Produkteigenschaften. - Herstellernummer (MPN) und Marke. Bei Elektronik und Ersatzteilen taucht sie häufiger auf als der Barcode.
- Vergleich von Titel und Eigenschaften. Fehlt der Barcode, werden Marke, Modell, Kapazität, Farbe und Stückzahl einzeln verglichen.
Bei Produkten mit Varianten (Größe, Farbe, Kapazität) ist jede Variante eine eigene Zeile und hat auf den meisten Websites eine eigene Adresse oder einen eigenen Adressparameter. Bei Mehrfachpackungen (3er, 6er) vergleichen Sie erst, nachdem Sie auf den Stückpreis umgerechnet haben. Auf Marktplätzen kann dieselbe Produktseite mehrere Verkäufer haben; der „Wettbewerber" ist dann nicht die Seite, sondern ein bestimmter Verkäufer auf dieser Seite.
In der Abgleichstabelle genügen die Spalten sku, wettbewerber, url, abgleichsart und zuletzt geprüft. Sehen Sie von Hand zugeordnete Zeilen in Abständen erneut durch: Der Wettbewerber kann ein Produkt entfernen und unter derselben Adresse das neue Modell einstellen.
Welchen Preis sollten Sie speichern?
Auf einer Produktseite gibt es nicht den einen Preis. Wenn Sie nicht von Anfang an festlegen, was Sie speichern, stehen in Ihrer Verlaufstabelle Äpfel neben Birnen.
- Listenpreis und reduzierter Preis. Führen Sie beide in getrennten Spalten. Der Kunde zahlt den reduzierten.
- Preis, der erst im Warenkorb oder mit Gutschein sinkt. Er ist auf der Produktseite oft nicht zu sehen. Steht er nicht auf der öffentlich zugänglichen Seite, lassen Sie ihn außen vor; automatisiertes Surfen mit einem angemeldeten Konto ist nicht Thema dieses Beitrags.
- Versand. Die Schwelle für kostenlosen Versand bestimmt bei günstigen Produkten den tatsächlichen Unterschied.
- Währung. Bei Wettbewerbern im Ausland speichern Sie die Währung zusammen mit dem Preis und verschieben die Umrechnung in die Auswertung.
- Verfügbarkeit. Der Preis eines Wettbewerbers, der nicht liefern kann, bindet Sie nicht.
Wie legt man das Abrufintervall fest?
Das Intervall bestimmt nicht die Neugier, sondern zwei Fragen: Wie schnell ändern sich die Preise in dieser Kategorie, und wie schnell können Sie reagieren? Für ein Team, das Preise einmal pro Woche anpasst, erzeugt ein stündlicher Abruf Last auf dem Server des Wettbewerbers und bei Ihnen Daten, die niemand liest.
| Produktklasse | Sinnvoller Start | Begründung |
|---|---|---|
| Bestseller während einer Aktion | Mehrmals täglich | Der Preis kann sich im Tagesverlauf ändern, die Reaktionszeit ist kurz |
| Regelmäßig verkaufte Kernprodukte | Einmal täglich | Die meisten Preisentscheidungen fallen täglich |
| Long Tail, Langsamdreher | Einmal pro Woche | Änderungen sind selten, der Reaktionsbedarf gering |
| Produkte, die beim Wettbewerber nicht lieferbar sind | Einmal täglich, nur Verfügbarkeit | Die Rückkehr ins Sortiment ist eine ebenso wertvolle Information wie der Preis |
Die Zahl der Anfragen berechnen Sie mit einer einfachen Multiplikation: Anzahl der Produkte × Abrufe pro Tag. 500 Produkte viermal täglich zu lesen ergibt 2.000 Anfragen. Warten Sie zwischen den Anfragen zwei Sekunden, dauert ein Durchlauf etwa 17 Minuten, und das ist für eine einzelne Website ein ruhiges Tempo. Rechnen Sie dasselbe für 50.000 Produkte und stündliche Abrufe, kommen Warteschlangen, Rate Limits und die Verteilung auf mehrere IPs ins Spiel. Wie Sie Rate Limits einhalten, beschreiben wir in Web Scraping ohne Blockierung, und was es heißt, wenn der Server „langsamer" sagt, in unserem Beitrag zu 429 Too Many Requests.
Wo auf der Seite steht der Preis?
Wir wechseln auf die Entwicklerseite. Den Preis dort zu lesen, wo Sie ihn auf dem Bildschirm sehen, also aus dem Text innerhalb irgendeiner CSS-Klasse, ist der fragilste Weg: Das Design ändert sich, der Klassenname ändert sich, das Skript geht lautlos kaputt. Die meisten Shops legen dieselbe Information ein zweites Mal für Suchmaschinen auf die Seite, in strukturierter Form. Diese Daten stehen in einem <script type="application/ld+json">-Tag und tragen die Felder price, priceCurrency und availability des schema.org-Typs Offer. Googles Dokumentation zu strukturierten Daten für Händlereinträge führt price und priceCurrency als Pflichtfelder; ein Shop, der in der Suche mit seinem Preis erscheinen will, hält diese Daten aktuell.
Die Lesereihenfolge sollte deshalb so aussehen:
- Enthält die Seite JSON-LD-Daten vom Typ
Product, nehmen Sie den Preis von dort. - Wenn nicht, schreiben Sie einen Selektor passend zur HTML-Struktur der Seite.
- Steht der Preis gar nicht im HTML, lädt die Seite die Daten per JavaScript nach. Diesen Fall und weitere Formen von eingebettetem JSON behandeln wir in Statische und dynamische Seiten; zum Schreiben von Selektoren siehe CSS-Selektor und XPath.
Lauffähiges Python-Beispiel: Preisverlauf und Schwellenwert-Alarm
Das Beispiel läuft nicht gegen einen echten Shop, sondern gegen books.toscrape.com. Die Website ist eine fiktive Buchhandlung, die zum Üben von Scraping veröffentlicht wurde, und laut Hinweis auf der Startseite sind die Preise zufällig vergeben. Ihre Seiten enthalten kein JSON-LD. In echten Shops begegnen Ihnen beide Fälle; das Skript versucht es deshalb zuerst mit JSON-LD und greift, wenn es nichts findet, auf die Produktinformationstabelle der Website zurück.
Sie brauchen Python 3 und zwei Pakete (pip install requests beautifulsoup4). SQLite kommt mit dem Modul sqlite3 aus der Python-Standardbibliothek; einen eigenen Datenbankserver installieren Sie nicht.
import json
import re
import sqlite3
import time
from datetime import datetime, timezone
from decimal import Decimal

import requests
from bs4 import BeautifulSoup

DB = "prices.db"
THRESHOLD_PCT = Decimal("5")   # eine größere Änderung löst eine Warnung aus
DELAY = 2.0                    # Pause zwischen zwei Anfragen an dieselbe Website (Sekunden)
PROXY = None                   # Beispiel: "http://user:pass@pr.proxynet.io:8000"
USER_AGENT = "ExamplePriceBot/1.0 (+https://example.com/about-the-bot)"

# Ihre eigene SKU -> Seite desselben Produkts beim Wettbewerber
PRODUCTS = {
    "BK-001": "https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html",
    "BK-002": "https://books.toscrape.com/catalogue/tipping-the-velvet_999/index.html",
    "BK-003": "https://books.toscrape.com/catalogue/soumission_998/index.html",
}

CURRENCIES = {"£": "GBP", "€": "EUR", "$": "USD", "₺": "TRY", "TL": "TRY"}


def parse_price(text):
    """Wandelt einen Text wie '£51.77' oder '1.299,90' in ein Decimal um."""
    number = re.sub(r"[^\d.,]", "", text)
    if re.fullmatch(r"\d{1,3}(\.\d{3})+", number):
        number = number.replace(".", "")                     # 1.299 -> 1299 (ohne Nachkommastellen)
    elif number.rfind(",") > number.rfind("."):
        number = number.replace(".", "").replace(",", ".")   # 1.299,90 -> 1299.90
    else:
        number = number.replace(",", "")                     # 1,299.90 -> 1299.90
    return Decimal(number)


def read_jsonld(soup):
    """Liest den Preis aus den schema.org-Product-Daten, falls die Seite sie enthält."""
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except json.JSONDecodeError:
            continue
        candidates = data if isinstance(data, list) else data.get("@graph", [data])
        for candidate in candidates:
            kind = candidate.get("@type")
            if "Product" not in (kind if isinstance(kind, list) else [kind]):
                continue
            offer = candidate.get("offers") or {}
            if isinstance(offer, list):
                offer = offer[0]
            price = offer.get("price") or offer.get("lowPrice")
            if price is None:
                continue
            return {
                "price": Decimal(str(price)),
                "currency": offer.get("priceCurrency"),
                "in_stock": str(offer.get("availability", "")).endswith("InStock"),
                "source": "json-ld",
            }
    return None


def read_html(soup):
    """Ohne JSON-LD: eigene Struktur der Seite, hier die Produkttabelle von books.toscrape.com."""
    table = {
        row.th.get_text(strip=True): row.td.get_text(strip=True)
        for row in soup.select("table.table-striped tr")
    }
    raw = table.get("Price (incl. tax)") or soup.select_one("p.price_color").get_text()
    symbol = next((s for s in CURRENCIES if s in raw), None)
    return {
        "price": parse_price(raw),
        "currency": CURRENCIES.get(symbol),
        "in_stock": table.get("Availability", "").startswith("In stock"),
        "source": "html",
    }


def fetch_product(session, url):
    response = session.get(url, timeout=20)
    response.raise_for_status()
    response.encoding = "utf-8"   # der Server sendet kein charset; so bleibt das £-Zeichen intakt
    soup = BeautifulSoup(response.text, "html.parser")
    if soup.select_one("h1") is None:
        raise ValueError("200 erhalten, aber keine Produktseite")
    return read_jsonld(soup) or read_html(soup)


def database():
    db = sqlite3.connect(DB)
    db.execute(
        """CREATE TABLE IF NOT EXISTS prices (
               sku TEXT NOT NULL,
               url TEXT NOT NULL,
               price_cents INTEGER NOT NULL,
               currency TEXT,
               in_stock INTEGER NOT NULL,
               source TEXT,
               checked_at TEXT NOT NULL
           )"""
    )
    db.execute("CREATE INDEX IF NOT EXISTS idx_sku_checked ON prices (sku, checked_at)")
    return db


def previous_row(db, sku):
    return db.execute(
        "SELECT price_cents, in_stock FROM prices WHERE sku = ? ORDER BY checked_at DESC LIMIT 1",
        (sku,),
    ).fetchone()


def alert(message):
    print("WARNUNG:", message)   # hier E-Mail oder Chat-Webhook anbinden


def main():
    db = database()
    session = requests.Session()
    session.headers["User-Agent"] = USER_AGENT
    if PROXY:
        session.proxies = {"http": PROXY, "https": PROXY}

    for sku, url in PRODUCTS.items():
        try:
            product = fetch_product(session, url)
        except (requests.RequestException, ValueError, AttributeError) as error:
            print(f"{sku}: nicht lesbar ({error})")
            time.sleep(DELAY)
            continue

        cents = int(product["price"] * 100)
        previous = previous_row(db, sku)
        if previous:
            old_cents, old_stock = previous
            change = Decimal(cents - old_cents) * 100 / Decimal(old_cents)
            if abs(change) >= THRESHOLD_PCT:
                alert(f"{sku}: {old_cents / 100:.2f} -> {cents / 100:.2f} "
                      f"{product['currency']} ({change:+.1f} %)")
            if bool(old_stock) != product["in_stock"]:
                alert(f"{sku}: Verfügbarkeit geändert, jetzt {'lieferbar' if product['in_stock'] else 'nicht lieferbar'}")

        db.execute(
            "INSERT INTO prices VALUES (?, ?, ?, ?, ?, ?, ?)",
            (sku, url, cents, product["currency"], int(product["in_stock"]), product["source"],
             datetime.now(timezone.utc).isoformat(timespec="seconds")),
        )
        db.commit()
        print(f"{sku}: {product['price']} {product['currency']} "
              f"lieferbar={'ja' if product['in_stock'] else 'nein'} ({product['source']})")
        time.sleep(DELAY)

    db.close()


if __name__ == "__main__":
    main()
Beim ersten Lauf werden drei Zeilen geschrieben, und weil es noch keinen älteren Eintrag zum Vergleichen gibt, erscheint keine Warnung:
BK-001: 51.77 GBP lieferbar=ja (html)
BK-002: 53.74 GBP lieferbar=ja (html)
BK-003: 50.10 GBP lieferbar=ja (html)
Die Preise der Übungswebsite ändern sich nicht. Um die Warnung zu sehen, haben wir deshalb den letzten Eintrag in der Datenbank von Hand geändert: Den Preis von BK-001 haben wir auf 45,00 gesetzt und BK-002 als nicht lieferbar markiert. Die Ausgabe des zweiten Laufs:
WARNUNG: BK-001: 45.00 -> 51.77 GBP (+15.0 %)
BK-001: 51.77 GBP lieferbar=ja (html)
WARNUNG: BK-002: Verfügbarkeit geändert, jetzt lieferbar
BK-002: 53.74 GBP lieferbar=ja (html)
BK-003: 50.10 GBP lieferbar=ja (html)
Vier Entscheidungen im Code sind bewusst getroffen:
- Der Preis wird als ganze Zahl in Cent gespeichert. Gleitkommazahlen (
float) häufen bei Geldbeträgen Rundungsfehler an. MitDecimalzu parsen und in Cent umzurechnen hält die Prozentrechnung exakt. - Jeder Abruf ist eine neue Zeile. Eine Zeile wird auch dann geschrieben, wenn sich der Preis nicht geändert hat; so lassen sich „an dem Tag haben wir nachgesehen und er war gleich" und „an dem Tag konnten wir nicht nachsehen" unterscheiden.
- Ein nicht lesbares Produkt wird übersprungen, der Durchlauf geht weiter. Der Fehler wird ausgegeben, dann folgt das nächste Produkt. Bei welchem Statuscode ein neuer Versuch sinnvoll ist und bei welchem Schluss sein sollte, können Sie mit dem Retry-Code aus HTTP-Statuscodes beim Web Scraping kombinieren.
- Der User-Agent sagt, wer der Bot ist. Wie Sie den Wert wählen, steht in unserem Beitrag Was ist ein User-Agent?.
Mit ausgefüllter PROXY-Zeile haben wir dasselbe Skript auch über einen lokalen Test-Proxy mit Authentifizierung laufen lassen. Das Ergebnis blieb gleich; bei falschem Passwort gab es für jedes Produkt einen ProxyError (407), und der Durchlauf wurde trotzdem abgeschlossen.
Wie entsteht die Produktliste: Kategorieseiten und Paginierung
Um alle Produktadressen einer Kategorie des Wettbewerbers zu sammeln, müssen Sie die Kategorieseiten durchlaufen, und die Liste ist fast immer auf mehrere Seiten verteilt. Am robustesten ist es, keine Seitennummern zu erfinden, sondern dem „Weiter"-Link auf der Seite zu folgen:
import time
from urllib.parse import urljoin

import requests
from bs4 import BeautifulSoup


def product_urls(session, start, max_pages=3, delay=2.0):
    """Durchläuft Kategorieseiten über den 'next'-Link und sammelt Produktadressen."""
    url, found = start, []
    for _ in range(max_pages):
        response = session.get(url, timeout=20)
        response.raise_for_status()
        soup = BeautifulSoup(response.text, "html.parser")
        found += [urljoin(url, a["href"]) for a in soup.select("article.product_pod h3 a")]
        next_link = soup.select_one("li.next a")
        if next_link is None:
            break
        url = urljoin(url, next_link["href"])
        time.sleep(delay)
    return found


session = requests.Session()
session.headers["User-Agent"] = "ExamplePriceBot/1.0 (+https://example.com/about-the-bot)"
urls = product_urls(session, "https://books.toscrape.com/catalogue/category/books/mystery_3/index.html")
print(len(urls), "Produkte gefunden")
In der Kategorie „Mystery" der Übungswebsite hat diese Funktion zwei Seiten durchlaufen und 32 Produktadressen geliefert. Die Seitenobergrenze (max_pages) verhindert, dass ein fehlerhafter „Weiter"-Link das Skript in eine Endlosschleife schickt. Endloses Scrollen, „Mehr laden"-Schaltflächen, Cursor-basierte APIs und eine URL-Warteschlange, die einen abgebrochenen Crawl an derselben Stelle fortsetzt, behandeln wir in Paginierung beim Web Scraping. Wenn Sie dieselbe Aufgabe lieber mit einem fertigen Framework lösen, lesen Sie Scrapy mit Proxy verwenden.
Wie fragt man den Verlauf ab und wie plant man das Skript?
Der niedrigste und der höchste Preis der letzten 30 Tage sind eine einzige Abfrage:
SELECT sku,
       MIN(price_cents) / 100.0 AS lowest,
       MAX(price_cents) / 100.0 AS highest,
       COUNT(*)                 AS readings
FROM prices
WHERE checked_at >= date('now', '-30 days')
GROUP BY sku
ORDER BY sku;
Diese Tabelle zeigt, wie viele Tage ein Rabatt gedauert hat und ob der als „Angebot" beworbene Preis schlicht der Normalpreis des Vormonats war.
Für die Zeitplanung genügt unter Linux eine cron-Zeile (0 */6 * * * python3 /opt/prices/price_tracker.py, alle sechs Stunden), unter Windows die Aufgabenplanung. Legen Sie die Durchläufe in die Nachtstunden; die Website des Wettbewerbers bedient tagsüber Kunden, genau wie Ihre.
Warum spielt das Land eine Rolle, aus dem Sie schauen?
Preis und Verfügbarkeit, die ein Shop anzeigt, können vom Land des Besuchers abhängen: Währung, Steuern, Liefergebiet, regionale Aktionen. Läuft Ihr Skript auf einem Cloud-Server im Ausland, speichern Sie womöglich nicht die Seite, die Ihr Kunde sieht, sondern die, die an jenem Standort ausgeliefert wird.
Die Lösung ist, die Anfrage aus demselben Land zu senden, in dem Ihr Kunde sitzt. Mit Residential-Proxy wählen Sie das Ausgangsland; die verfügbaren Länder stehen auf unserer Seite Proxy-Standorte. Wie der Standort einer IP bestimmt wird und warum er manchmal falsch ist, erklären wir in Wie genau ist die IP-Geolokalisierung?. Die zweite Rolle des Proxys bei dieser Aufgabe: Wer sehr viele Produkte abruft, verteilt die Last auf mehrere Adressen. Die Logik der Rotation steht in unserem Beitrag zur IP-Rotation. Die Wahl zwischen rotierenden Proxys und Sticky Sitzungen beantwortet der Fragenbereich unserer Seite zur Preisüberwachung.
Ein Proxy ist keine Erlaubnis. Das Rate Limit der Website und die Regeln der robots.txt gelten unabhängig davon, von welcher IP die Anfrage kommt.
Lässt sich eine Bestandsbenachrichtigung mit demselben Ablauf bauen?
Ja. Das Skript oben speichert die Verfügbarkeit bereits und warnt, wenn sie sich ändert. Ist der Wettbewerber ausverkauft, brauchen Sie in diesen Tagen keinen Rabatt; ist er wieder lieferbar, ist es Zeit, den Preis zu überprüfen.
Die Grenze verläuft hier: Eine Benachrichtigung zu erhalten und automatisch zu kaufen ist nicht dasselbe. Limitierte Produkte im Moment der Verfügbarkeit per Bot aufzukaufen und weiterzuverkaufen geht zulasten der anderen Käufer, und die meisten Shops verbieten es in ihren Bedingungen. Der Ablauf in diesem Beitrag sammelt Informationen und rührt den Warenkorb nicht an. Warum Agenten, die den Kaufschritt automatisieren, blockiert werden, behandeln wir in Warum KI-Shopping-Agenten blockiert werden.
Grenzen: Nutzungsbedingungen, robots.txt und Kartellrecht
Ein Blick auf den Preis im Schaufenster des Wettbewerbers ist so alt wie der Handel selbst. Was die automatisierte Beobachtung legitim hält, ist die Methode:
- Nur öffentlich zugängliche Produktseiten. Bereiche hinter einer Anmeldung, personenbezogene Daten in Kundenbewertungen und Konto-Automatisierung gehören nicht dazu.
- robots.txt und Nutzungsbedingungen. Lesen Sie beides vor dem Crawlen. Die Nutzungsbedingungen von Marktplätzen können Klauseln enthalten, die den automatisierten Zugriff einschränken; gibt es eine solche Klausel, prüfen Sie die offizielle API, eine Datenpartnerschaft oder eine Anfrage um Erlaubnis. Wie man die Datei liest, steht in Was ist eine robots.txt-Datei?, den rechtlichen Rahmen finden Sie in Ist Web Scraping legal?.
- Niedriges Tempo und Cache. Warten Sie zwischen den Anfragen und rufen Sie dieselbe Seite nicht häufiger ab, als es das Tempo Ihrer Entscheidungen verlangt.
- Erscheint eine Schutzseite, hören Sie auf. Eine Prüfseite ist keine Störung, sondern eine Antwort der Website. Wie diese Systeme arbeiten, erklären wir in Wie funktioniert Bot-Erkennung?.
Dazu kommt das Kartellrecht. Den öffentlich sichtbaren Preis eines Wettbewerbers zu beobachten und den eigenen Preis allein festzulegen ist übliches kaufmännisches Verhalten. Sich mit Wettbewerbern über Preise abzusprechen oder durch gegenseitigen Austausch von Preisinformationen gemeinsam vorzugehen ist etwas anderes. In der EU verbietet Artikel 101 des Vertrags über die Arbeitsweise der Europäischen Union Vereinbarungen und abgestimmte Verhaltensweisen, die den Wettbewerb beschränken, und nennt als erstes Beispiel die Festsetzung der An- oder Verkaufspreise; in Deutschland zieht § 1 GWB dieselbe Linie. In Türkiye regelt dies Artikel 4 des Gesetzes Nr. 4054 zum Schutz des Wettbewerbs. Wenn Sie Regeln für automatische Preisanpassung aufsetzen, besprechen Sie diese Grenze mit einer Juristin oder einem Juristen.
Einsatzbereiche
- Marktplatz-Verkäufer: Preis und Verfügbarkeit anderer Verkäufer desselben Produkts. Plattformspezifische Hinweise zur Infrastruktur stehen auf unseren Seiten Amazon Proxy, Walmart Proxy und Alibaba Proxy.
- Marken mit eigenem Onlineshop: Prüfen, ob autorisierte Händler die unverbindliche Preisempfehlung einhalten. Den allgemeinen Aufbau zeigt unsere Seite zur E-Commerce-Lösung.
- Datenteams: Den Preisverlauf als Eingangsgröße für Nachfrageprognosen und Aktionsanalysen nutzen. Wie die Erfassung skaliert, steht auf unserer Seite zur Data-Scraping-Lösung.
Häufige Fehler
- Nur den letzten Preis speichern. Ohne Verlauf sehen Sie nicht, wann ein Rabatt begonnen hat, wie viele Tage er lief und ob er sich wiederholt.
- Den Abgleich einmal machen und vergessen. Der Wettbewerber erneuert das Produkt, die Adresse bleibt, und Sie vergleichen das alte Modell mit dem neuen.
- Eine
200-Antwort für einen Preis halten. Auch eine Prüfseite oder eine Seite „Produkt nicht gefunden" kann200liefern. Eine Kontrolle wie derh1-Test im Skript ist Pflicht; ist das Preisfeld leer, schreiben Sie keine Zeile. - Komma und Punkt verwechseln.
1.299,90und1,299.90sind dieselbe Zahl. Testen Sie die Parsing-Funktion mit echten Beispielen der Zielwebsite. - Dem Preis des Wettbewerbers automatisch und unbegrenzt folgen. Arbeiten zwei automatische Regeln gegeneinander, fällt der Preis auf den Boden. Die Untergrenze legen Sie anhand Ihrer Kosten selbst fest.
Entscheidungshilfe
| Bedarf | Empfehlung |
|---|---|
| Eigenen Preis und Bestand aktuell halten | Verkäufer-API des Marktplatzes |
| 20-30 Produkte, wöchentlicher Blick | Manuelle Kontrolle und Tabelle |
| Hunderte Produkte, kein Entwicklerteam | Fertiges Preisbeobachtungs-Tool oder Automatisierungsablauf |
| Spezielle Websites, eigenes Data Warehouse, flexible Alarme | Eigenes Python-Skript und SQLite |
| Zehntausende Produkte, stündliche Abrufe | Crawler mit Warteschlange (Scrapy), Server-Datenbank, Verteilung auf mehrere IPs |
| Der Preis hängt vom Land ab | Eine IP aus dem Land Ihres Kunden |
| Die Website zeigt eine Prüfseite | Aufhören; Tempo, Bedingungen und die offizielle API prüfen |
Häufige Fragen
Ist die Beobachtung von Wettbewerberpreisen legal?
Den Preis auf einer öffentlich zugänglichen Produktseite anzusehen und zu notieren ist übliche kaufmännische Tätigkeit. Probleme entstehen bei der Methode: Zugriff auf Daten hinter einer Anmeldung, Missachtung der Nutzungsbedingungen oder der robots.txt, Crawlen in einem Tempo, das den Server belastet. Außerdem verstößt es gegen das Kartellrecht, die gesammelten Informationen für Preisabsprachen mit Wettbewerbern zu nutzen.
Kann man Preise mit Excel beobachten?
Für wenige Produkte ja. Eine von Hand gepflegte Tabelle oder die Excel-Funktion zum Abrufen von Daten aus dem Web reicht für den Anfang. Die Grenze zeigt sich beim Verlauf und beim Alarm: Die Tabelle zeigt den aktuellen Stand und meldet keine Änderung. Ab einigen Dutzend Produkten macht eine kleine Datenbank wie SQLite weniger Mühe.
Liefert die Verkäufer-API von Amazon oder Otto Wettbewerberpreise?
Teilweise. Verkäufer-APIs sind zuerst dafür da, die Produkt-, Bestands-, Preis- und Bestelldaten Ihres eigenen Shops zu verwalten. Amazons Product Pricing API liefert Wettbewerbspreisdaten wie das hervorgehobene Angebot für Produkte im Amazon-Katalog; einen Endpunkt für den Preisverlauf eines Wettbewerbers, seinen Bestand oder seine Preise auf anderen Websites gibt es nicht. Was welcher Marktplatz anbietet, prüfen Sie in der jeweils aktuellen Integrationsdokumentation. Die eigentliche Aufgabe dieser APIs ist es, Ihren aktuellen Preis zu lesen und die Preisentscheidung in Ihren Shop zurückzuschreiben.
Wie oft am Tag sollte ich abrufen?
So oft, wie Sie Preisentscheidungen treffen. Für die meisten Kataloge genügt ein Abruf pro Tag; bei Bestsellern während einer Aktion sind es mehrere Durchläufe täglich, Langsamdreher laufen wöchentlich.
Braucht man für die Preisbeobachtung einen Proxy?
Für eine kleine Liste und ein niedriges Intervall nicht. Nötig wird er in zwei Fällen: wenn der Preis vom Land abhängt und Ihr Skript in einem anderen Land läuft als Ihr Kunde, oder wenn die Zahl der Produkte so groß ist, dass Anfragen von einer einzigen Adresse zum Problem werden. Welcher IP-Typ zu welcher Aufgabe passt, vergleichen wir auf unserer Seite zur Preisüberwachung.
Wo lese ich den Preis, wenn die Seite kein JSON-LD hat?
Prüfen Sie zuerst im Seitenquelltext, ob der Preis im reinen HTML steht; wenn ja, schreiben Sie einen Selektor wie im Beispiel und halten Sie sich möglichst an eine dauerhaftere Struktur wie die Produktinformationstabelle statt an einen Klassennamen. Steht der Preis gar nicht im Quelltext, lädt die Seite die Daten nachträglich. Dann ist es leichter, im Netzwerk-Tab des Browsers die Anfrage zu finden, aus der die Daten kommen, als einen Headless-Browser zu starten.
Fazit
Die Beobachtung von Wettbewerberpreisen ist keine Software, sondern ein Ablauf: eine korrekt abgeglichene Produktliste, ein Abrufintervall, das zum Tempo Ihrer Entscheidungen passt, eine Verlaufstabelle mit Datumsstempel und wenige, aber aussagekräftige Warnungen. Die Daten Ihrer eigenen Seite holen Sie aus der Verkäufer-API; auf der Seite des Wettbewerbers bleiben Sie bei öffentlich zugänglichen Seiten, bei der robots.txt und bei niedrigem Tempo. Ein Python-Skript von rund 150 Zeilen und eine SQLite-Datenbank in einer einzigen Datei erledigen das für die meisten Kataloge. Wenn der Umfang wächst und Sie den Preis aus dem Land Ihres Kunden sehen müssen, finden Sie die Infrastrukturoptionen auf unserer Seite zur Preisüberwachung.