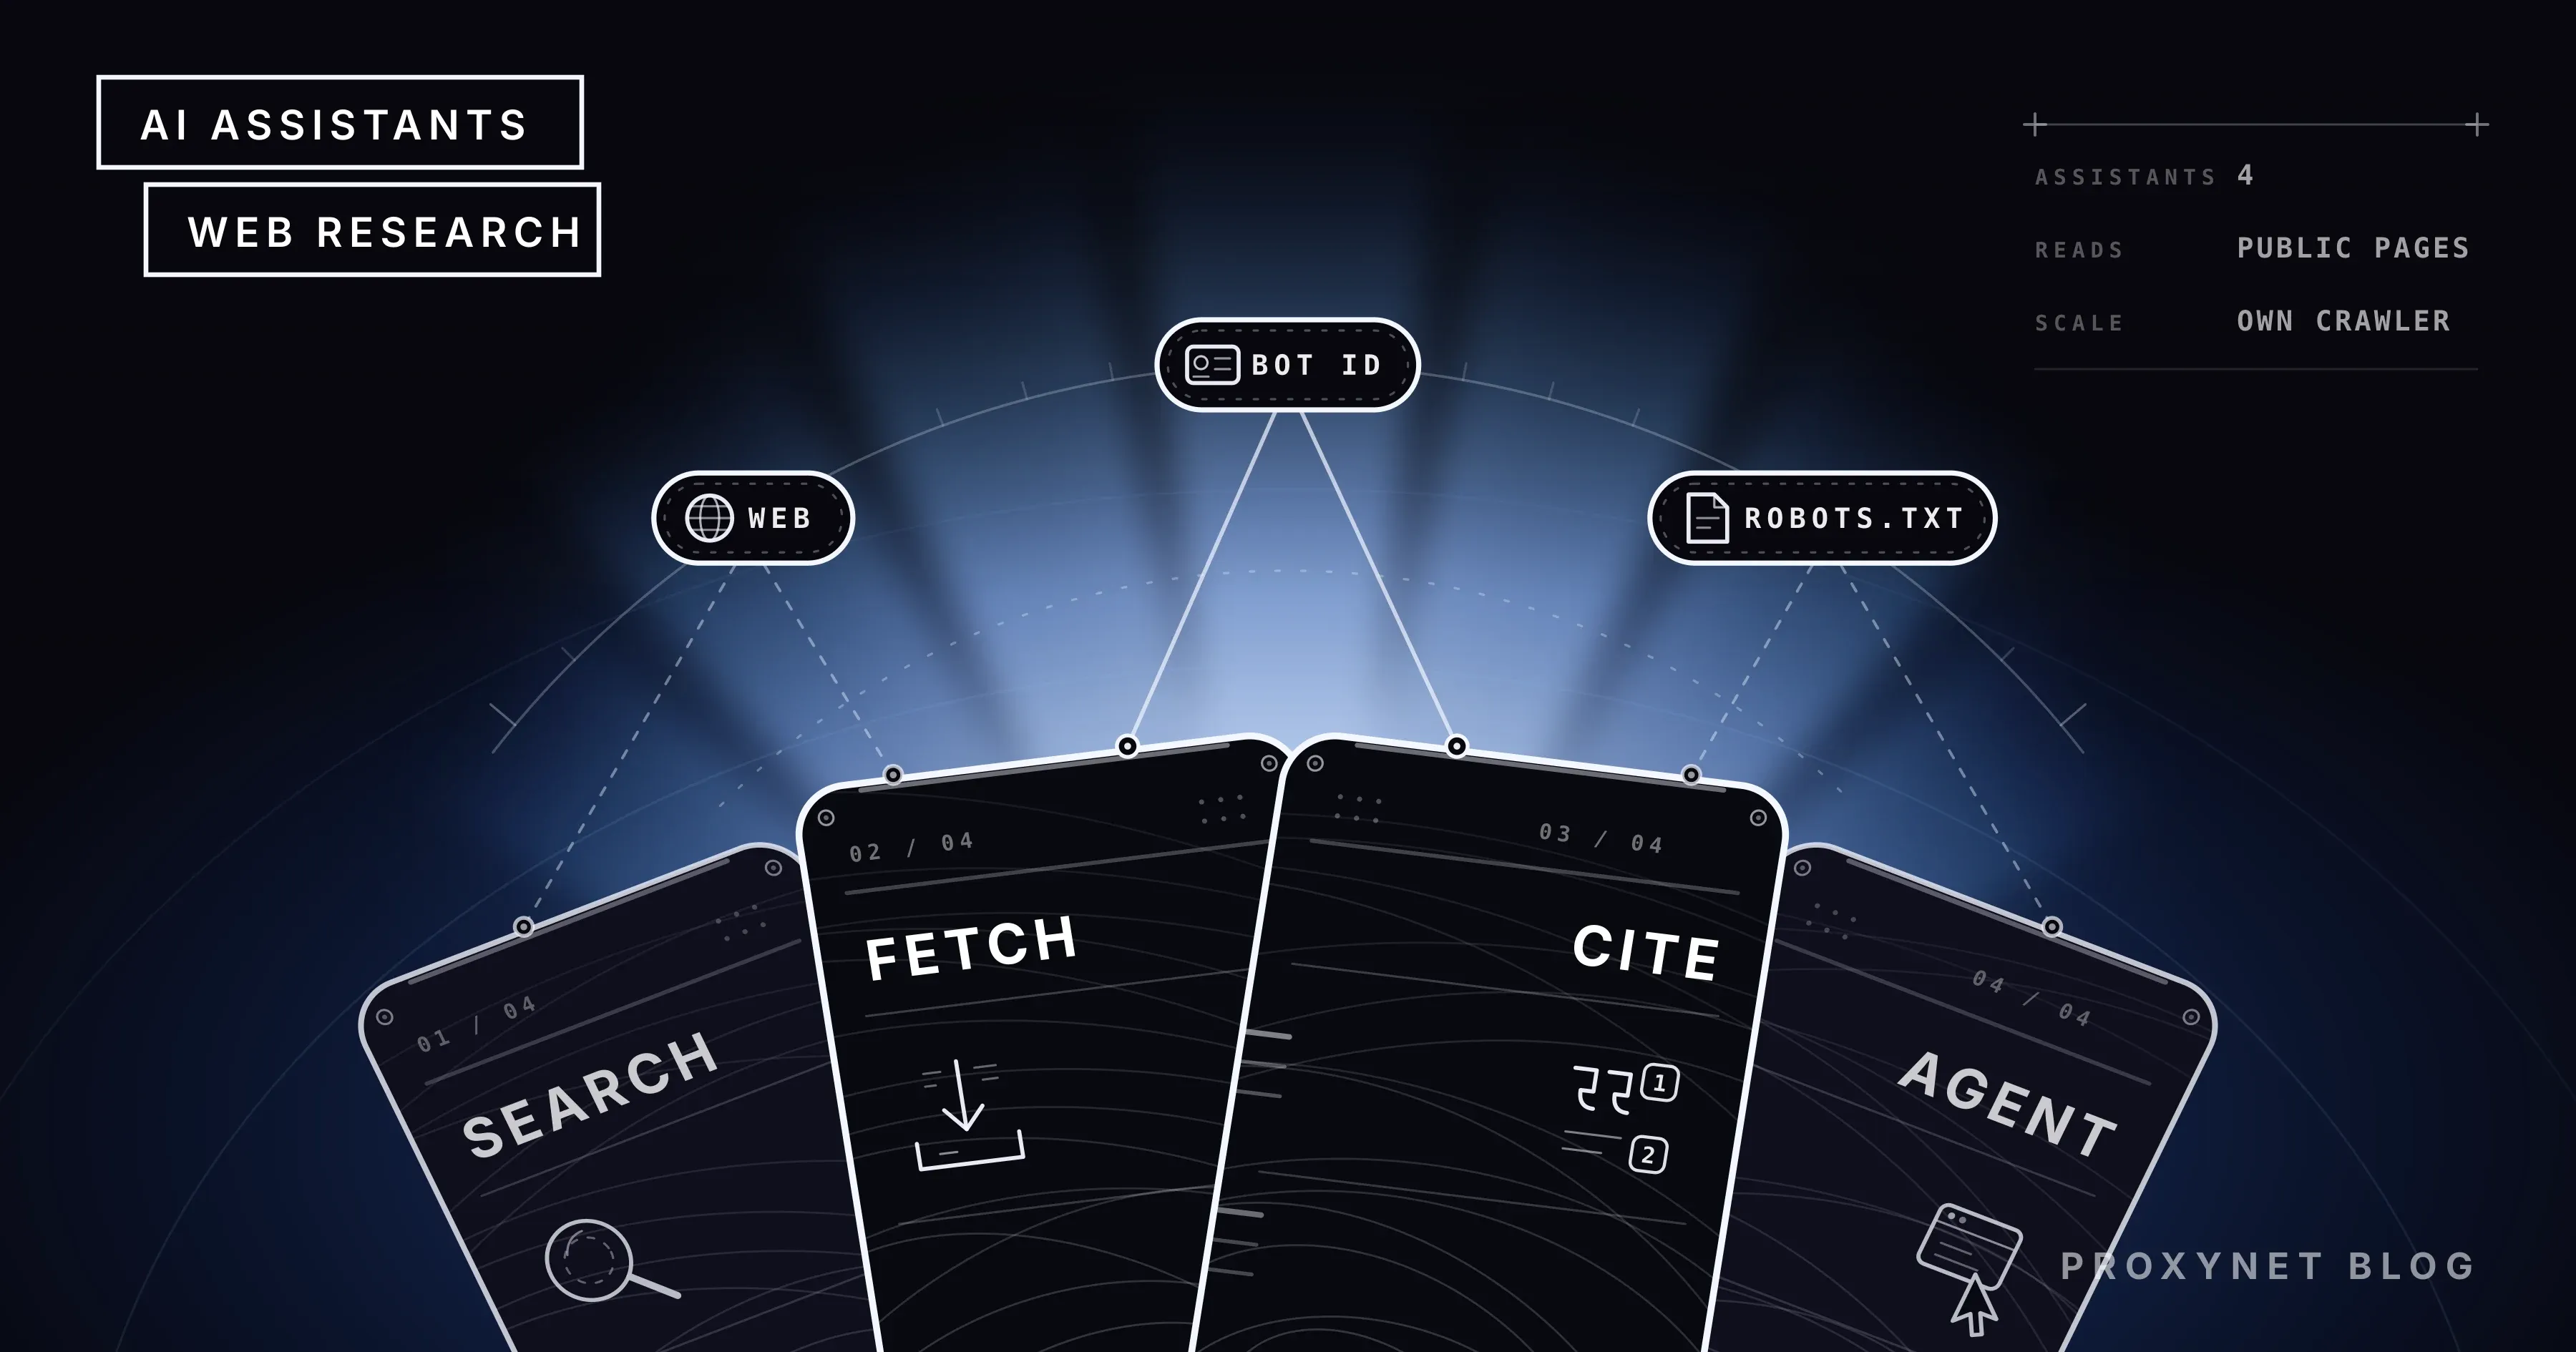
یک تیم پژوهش بازار یک پرسش را از چهار دستیار میپرسد: «این محصول امروز در این فروشگاه در ترکیه چند است؟» یکی قیمتی با منابع شمارهدار برمیگرداند، یکی صفحه را میخواند اما نمیگوید مال چه زمانی است، یکی بر پایه نتایج گوگل یک بازه میدهد و یکی میگوید به صفحه دسترسی ندارد. هر چهار دستیار با عنوان «متصل به وب» فروخته میشوند؛ آنچه آنها را از هم جدا میکند هوش مدل نیست، بلکه رابطهای است که هر محصول با وب دارد.
در این نوشته ChatGPT، Claude، Gemini و Perplexity را از همین یک زاویه مقایسه میکنیم: جستوجوی زنده چگونه کار میکند، منابع چگونه نشان داده میشوند، آیا نشانیای (URL) که به آنها میدهید خوانده میشود و کجا متوقف میشوند، حالتهای «deep research» و عامل چه میکنند و ابزارهای وب در سمت API چه شکلی دارند. سپس به سمت صاحب سایت میرویم: هویت رباتها، رفتار با robots.txt و اختلاف اوت 2025 میان Cloudflare و Perplexity. بخش پایانی برای تیمهای داده است: چرا این دستیارها ابزار اسکرپینگ نیستند و جای پروکسی کجاست. جزئیات هر شرکت را در 7 اکتبر 2026 در صفحههای خود آنها بررسی کردیم؛ نام نسخه مدلها را نیاوردهایم.
چهار دستیار چگونه به وب میرسند؟
هر چهار دستیار جستوجوی زنده دارند؛ تفاوت در این است که جستوجو کِی و روی چه زیرساختی اجرا میشود. خود مدل به وب متصل نیست: در هر محصول یک لایه جستوجو جلوی مدل نشسته است که پرسش را به چند جستوجو تبدیل میکند، نتایج را میآورد و به مدل میدهد. هرچه در پاسخ بهروز است از همین لایه میآید.
ChatGPT طبق صفحه راهنمای OpenAI در صورت نیاز در وب جستوجو میکند، گاهی برای این کار با ارائهدهندگان جستوجوی دیگر همکاری میکند و پرسش شما را به جستوجوهای هدفمند بازنویسی میکند. جستوجو در همه پلنها در دسترس است؛ منابع به شکل ارجاعهای قابلکلیک در متن میآیند و نمای «منابع» پیوندهای مرتبط را فهرست میکند.
Claude در مارس 2025 به جستوجوی وب مجهز شد و از مه 2025 آن را در همه پلنها و در سراسر جهان ارائه میکند. گزینه «Web search» را از منوی «+» در گفتوگو فعال میکنید و Claude وقتی پرسش به اطلاعات روز وابسته باشد جستوجو میکند: رویدادهای اخیر، قیمتها، اطلاعاتی درباره سازمانها و محصولات که ممکن است تغییر کرده باشد، یا درخواست صریح برای جستوجوی چیزی. برای دانش تثبیتشده، ریاضیات یا نوشتن خلاقانه جستوجو نمیکند.
Gemini پاسخهایش را به جستوجوی گوگل تکیه میدهد. طبق صفحه راهنمای گوگل، وقتی منبعی در کار باشد دکمه «منابع» زیر پاسخ یا درون آن ظاهر میشود و پیوندها را در یک پنل کناری باز میکند؛ اگر دکمهای نباشد، برای آن پاسخ پیوندی ارائه نشده است. هر پاسخی بر جستوجو تکیه ندارد.
Perplexity از جای دیگری شروع میکند. این محصول یک موتور پاسخ است: هر پرسش نخست به جستوجو میرود و مدل سپس از صفحههایی که یافته، پاسخی با منابع شمارهدار مینویسد. گزینهای به نام «خاموش کردن وب» وجود ندارد؛ وب پیششرط پاسخ است.
شیوههای ارجاع چه تفاوتی دارند؟
هر چهار دستیار منبع ذکر میکنند، اما رابطه منبع با پاسخ متفاوت است. Perplexity کنار هر جمله شمارهای میگذارد و فهرست منابع را بخشی از پاسخ میداند. Claude در سطح جمله ارجاع میدهد: اینکه کدام قطعه از کدام URL آمده، همراه با گزیدهای 150 نویسهای، درون پاسخ حمل میشود. ChatGPT ارجاعها را به شکل پیوند درون متن میگذارد و فهرست منابع هم میافزاید. Gemini منابع را در پنلی جداگانه گرد میآورد و پاسخ بدون منبع را هم عادی میداند.
| دستیار | کِی جستوجو میکند | منابع چگونه نشان داده میشوند | اثر موقعیت مکانی |
|---|---|---|---|
| ChatGPT | وقتی پرسش به داده روز نیاز دارد | پیوند درون متن + فهرست منابع | موقعیت تقریبی برگرفته از IP به شریک جستوجو داده میشود |
| Claude | وقتی فعال باشد و پرسش نیاز داشته باشد | ارجاع در سطح جمله با URL و گزیده | در اپلیکیشن مستند نشده؛ در API یک پارامتر |
| Gemini | وقتی جستوجوی گوگل پاسخ را بهتر کند | دکمه منابع، پنل کناری | مستند نشده |
| Perplexity | در هر پرسش | منابع شمارهدار بهعنوان بخشی از پاسخ | در API یک پارامتر |
ستون موقعیت مکانی مهم است. صفحه راهنمای OpenAI میگوید ChatGPT موقعیت تقریبی برگرفته از آدرس IP شما را، بدون خود IP، به شرکای جستوجویش میدهد. پرسشی درباره قیمت که از استانبول پرسیده شود شاید همان نتایجی را نیاورد که از برلین پرسیده میشود. برای سه محصول دیگر صفحهای نیافتیم که این را مستند کرده باشد، پس درباره آنها ادعایی نمیکنیم.
وقتی یک URL میچسبانید چه میشود؟
خواندن صفحه (واکشی یا fetch) قابلیتی جدا از جستوجوست: جستوجو از یک نمایه (ایندکس) خلاصه برمیگرداند، واکشی به یک نشانی مشخص میرود و خود صفحه را میآورد. هر چهار محصول وقتی از طرف کاربر عمل میکنند برای این کار هویت ربات جداگانهای دارند؛ سازوکار در همه یکی است:
- نشانی باید در گفتوگو آمده باشد. ابزار API در Claude این را قاعده میکند: فقط URLهایی واکشی میشوند که در پیام کاربر، در نتایج جستوجو یا در نتایج ابزارها آمدهاند؛ نشانیای که مدل خودش نوشته واکشی نمیشود. دلیلی که ذکر شده خطر نشت داده است.
- دامنه و robots.txt بررسی میشوند. ابزار Claude برای مسیری که robots.txt بسته است، نشانی شبکه خصوصی یا URL حامل اطلاعات ورود،
url_not_allowedبرمیگرداند. ابزار URL context در Gemini نشانیهای شبکه محلی و سرویسهای تونل را کنار میگذارد. - صفحه دریافت میشود. متن، HTML و PDF خوانده میشوند. مستندات Claude تصریح میکند صفحههایی که با JavaScript رندر میشوند پشتیبانی نمیشوند؛ مستندات Gemini میگوید محتوای پشت ورود به حساب یا دیوار پرداخت (paywall) خوانده نمیشود.
- محتوا کوتاه میشود. Claude محدودیت
max_content_tokensدارد؛ Gemini برای هر URL 34 MB و برای هر درخواست 20 URL اجازه میدهد. مدل بخشی را میخواند که جا میشود، نه کل صفحه را. - پاسخ نوشته و ارجاع داده میشود. در واکشی Claude ارجاع اختیاری است؛ Gemini همراه پاسخ برمیگرداند کدام URLها با موفقیت خوانده شدهاند.
بعد نوبت کش است. مستندات Claude میگوید محتوای واکشیشده کش میشود و شاید آخرین نسخه موجود در آن نشانی را بازتاب ندهد؛ برای محتوای تازه میتوان use_cache را خاموش کرد. Gemini نخست به کش نمایه خودش نگاه میکند و فقط اگر صفحه آنجا نباشد آن را زنده واکشی میکند. برای دادهای که ساعتبهساعت عوض میشود، مثل قیمت، همین تعیین میکند پاسخ چقدر کهنه است.
| دستیار | چگونه URL را میخواند | محدودیتهای مستند | موضع ربات بهدرخواست کاربر درباره robots.txt |
|---|---|---|---|
| ChatGPT | بازدید صفحه با ChatGPT-User | خزش خودکار ندارد | «ممکن است اعمال نشود» |
| Claude | Claude-User؛ ابزار واکشی وب در API | بدون JavaScript؛ URL باید در گفتوگو آمده باشد؛ کش | پایبند است |
| Gemini | واکشیکنندههای بهدرخواست کاربر گوگل؛ URL context در API | 20 URL، 34 MB؛ بدون ورود به حساب و دیوار پرداخت | معمولاً نادیده میگیرد |
| Perplexity | Perplexity-User | صفحه بلافاصله برای پاسخ به پرسش استفاده میشود | معمولاً نادیده میگیرد |
حالتهای deep research و عامل چه میکنند؟
هر چهار محصول حالت پژوهش بلند دارند و همه همان حلقه را اجرا میکنند: برنامهریزی، جستوجو، خواندن، جستوجوی دوباره برای آنچه کم است، نوشتن گزارش. Gemini این حالت را در دسامبر 2024 با نام «Deep Research» باز کرد؛ OpenAI در فوریه 2025 حالت «deep research» را عرضه کرد، Perplexity در همان ماه «Deep Research» خود را و Anthropic در آوریل 2025 قابلیت «Research» را. تفاوت در شمار صفحههای خواندهشده است، اما در شیوه حمل منابع هم هست: Perplexity و Claude ارجاع را به جمله گره میزنند، ChatGPT و Gemini آنها را زیر گزارش جمع میکنند. شکل این حلقه را در نوشته عاملهای هوش مصنوعی چگونه کار میکنند شرح دادهایم.
حالتهای عامل یک گام جلوتر میروند: دستیار در مرورگر میگردد، فرم پر میکند و کلیک میکند. Perplexity برای این کار مرورگر خودش به نام Comet را عرضه کرد؛ گوگل برای عاملهایی که از طرف کاربر میگردند هویت ربات جداگانهای (Google-Agent) فهرست میکند؛ حالت عامل OpenAI درون ChatGPT است. برای صاحب سایت چنین بازدیدی شبیه بازدید انسان است، اما درخواست همچنان از یک برنامه میآید و هویتش را در هدر user agent حمل میکند.
ابزارهای وب در سمت API چه شکلی دارند؟
در هر چهار API جستوجوی وب یک ابزار سمت سرور است: زیرساخت شرکت جستوجو را انجام میدهد و نتایج را به مدل میدهد. توسعهدهنده سه چیز را کنترل میکند: شمار جستوجوها، فیلتر دامنه و موقعیت مکانی.
| دستیار | ابزار API | پارامتر موقعیت مکانی | فیلتر دامنه |
|---|---|---|---|
| OpenAI | web_search در Responses API؛ حاشیهنویسیهای url_citation | user_location: شهر، کشور، منطقه، منطقه زمانی | دارد |
| Anthropic | ابزارهای web_search و web_fetch؛ ارجاع در جستوجو الزامی | user_location: شهر، منطقه، کد کشور، منطقه زمانی | allowed_domains یا blocked_domains |
grounding با google_search؛ url_context | مستند نشده | مستند نشده | |
| Perplexity | مدلهای Sonar؛ search_results و ارجاعها بهطور پیشفرض | web_search_options.user_location: طول و عرض جغرافیایی بهعلاوه کشور، شهر، منطقه | search_domain_filter، تا 20 دامنه |
یک درخواست با country: "TR" و بدون آن میتواند صفحههای متفاوتی برگرداند. مستندات Claude دستکم یک فیلد میخواهد و کشور را به شکل کد دوحرفی ISO میگیرد:
{
  "type": "web_search_20250305",
  "name": "web_search",
  "max_uses": 5,
  "user_location": {
    "type": "approximate",
    "city": "Istanbul",
    "country": "TR",
    "timezone": "Europe/Istanbul"
  }
}
در ابزار grounding گوگل، groundingMetadata که همراه پاسخ برمیگردد جستوجوها، قطعههای منبع و یک searchEntryPoint را حمل میکند و گوگل میخواهد این «Search Suggestions» به کاربر نشان داده شوند. جستوجوی Perplexity خاموششدنی نیست، اما search_recency_filter تعیین میکند منابع حداکثر چقدر قدیمی باشند.
کدام هویتهای ربات برای صاحبان سایت مهماند؟
هر شرکت برای سه کار سه هویت دارد: خزش برای آموزش، خزش برای نمایه جستوجو و باز کردن صفحه از طرف کاربر. هر یک در robots.txt جداگانه مدیریت میشود؛ بستن ربات آموزش، ربات جستوجو را نمیبندد. شیوه نوشتن این فایل را در راهنمای robots.txt آوردهایم؛ اینجا فقط نامها و موضعها را فهرست میکنیم.
| شرکت | آموزش | جستوجو | بهدرخواست کاربر |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User |
| Google-Extended (فقط توکن) | Googlebot | واکشیکنندههای بهدرخواست کاربر، Google-Agent | |
| Perplexity | ندارد (برای آموزش خزش نمیکند) | PerplexityBot | Perplexity-User |
OpenAI سه هویت خود را در مستندات رباتها تعریف میکند. GPTBot برای آموزش خزش میکند؛ OAI-SearchBot سایتها را در جستوجوی ChatGPT پیدا میکند و به آنها پیوند میدهد و برای آموزش استفاده نمیشود؛ ChatGPT-User وقتی کاربر پرسشی میپرسد صفحه را بازدید میکند و خزش خودکار ندارد. چون کاربر این بازدیدها را آغاز میکند، سند میگوید قواعد robots.txt برای ChatGPT-User «ممکن است اعمال نشود». سایتی که OAI-SearchBot را ببندد در پاسخهای جستوجوی ChatGPT نشان داده نمیشود؛ اعمال تغییر حدود 24 ساعت طول میکشد. بازههای IP در فایلهای JSON جداگانه منتشر میشوند.
Anthropic هر سه ربات را در صفحه راهنمای خود تعریف میکند و میگوید هر سه به robots.txt پایبندند؛ تنها شرکتی است که برای ربات بهدرخواست کاربر خود «پایبند است» میگوید. این صفحه همچنین میگوید رباتها دستور Crawl-delay را پشتیبانی میکنند و بازههای IP را در یک فهرست JSON واحد منتشر میکند.
در گوگل، Gemini با خزنده جداگانهای خزش نمیکند. Googlebot نمایه را میسازد؛ Google-Extended یک توکن robots.txt بدون رشته user agent مخصوص به خود است و تعیین میکند محتوای خزششده برای آموزش مدلهای Gemini و برای grounding جستوجوی گوگل در Gemini Apps و Vertex AI استفاده شود یا نه. مستندات دو چیز را صریح میگوید: Google-Extended بر جایگاه سایت در جستوجو اثر ندارد، و واکشیکنندههای بهدرخواست کاربر معمولاً قواعد robots.txt را نادیده میگیرند، چون کاربر واکشی را درخواست کرده است. بستن Google-Extended نه به Googlebot دست میزند و نه به بازدیدهایی که از طرف کاربر انجام میشوند.
Perplexity در مستندات خزندههایش مینویسد PerplexityBot برای نشان دادن سایتها در نتایج جستوجو خزش میکند، برای آموزش استفاده نمیشود و به robots.txt احترام میگذارد. جمله مربوط به Perplexity-User متفاوت است: «چون کاربر واکشی را درخواست کرده، این واکشیکننده معمولاً قواعد robots.txt را نادیده میگیرد.» بازههای IP هر دو ربات در فایلهای JSON جداگانه منتشر میشوند.
نتیجه عملی: robots.txt خزش خودکار را مدیریت میکند و سه شرکت از چهار شرکت، یک بازدید تکی از طرف کاربر را بیرون از این فایل میدانند. راه محدود کردن آن بازدیدها قاعدهای سمت سرور بر پایه user agent و فهرستهای IP منتشرشده است. یک پیکربندی رایج رباتهای آموزش را میبندد و رباتهای جستوجو را باز میگذارد:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /
میان Cloudflare و Perplexity چه گذشت؟
در 4 اوت 2025، Cloudflare نوشتهای منتشر کرد و در آن مدعی شد Perplexity از خزندههای اعلامنشده استفاده میکند. طبق روایت Cloudflare، سایتهایی که PerplexityBot را بسته بودند گزارش دادند محتوایشان همچنان در پاسخهای Perplexity ظاهر میشود، و دامنههای آزمایشی تازهای که Cloudflare به روی همه رباتها بسته بود باز هم توسط Perplexity واکشی میشدند. آن نوشته میگفت پس از بسته شدن user agent اعلامشده، درخواستها با یک user agent عمومی شبیه Chrome و از شبکههای متغیر (ASN) میرسیدند و robots.txt گاهی اصلاً واکشی نمیشد؛ Cloudflare همان روز Perplexity را از فهرست رباتهای تأییدشده خود حذف کرد.
Perplexity روز بعد با نوشتهای با عنوان «Agents or Bots? Making Sense of AI on the Open Web» پاسخ داد: ترافیک مورد بحث خزش خودکار نبود، بلکه درخواستهای «عامل کاربرمحور» بود که برای پرسش لحظهای یک کاربر صفحهای را باز میکرد، چیزی نمایه نشده بود و Cloudflare بخشی از ترافیک را با یک سرویس مرورگر ابری شخص ثالث اشتباه گرفته بود. دو روایت با هم نمیخوانند و این نوشته داور نیست. نتیجه ماندگار این بود که پرسش هویت به سمت یک پاسخ فنی حرکت کرد: Cloudflare در همان ماه برنامه «signed agents» را باز کرد که در آن عاملها درخواستهایشان را با Web Bot Auth، یک پیشنویس IETF، امضا میکنند. رباتی که رشته user agent را کپی میکند نمیتواند آن امضا را تولید کند.
آیا این دستیارها ابزار گردآوری دادهاند؟
خیر. محدودیتهای بالا تصمیمهای طراحیاند: شمار جستوجو در هر درخواست، کش، خواندن فقط URLهایی که در گفتوگو آمدهاند، اجرا نکردن JavaScript و رد کردن مسیرهایی که robots.txt بسته است، همه این ابزارها را به اندازه پرسش لحظهای یک کاربر مقیاس میدهند. صد صفحه صد پرسش میخواهد و شما نمیتوانید کنترل کنید کدام نسخه از صفحه خوانده شده است. نوشته ما درباره دسترسی امن LLM به وب شرح میدهد مدل هنگام خواندن صفحههای زنده باید مراقب چه چیزهایی باشد.
برای گردآوری منظم و در مقیاس بزرگ سه راه هست: منبعی که صریحاً اجازه میدهد، API رسمی همان منبع یا خزنده خودتان. در راه سوم، خواندن robots.txt، رعایت محدودیت نرخ سایت و معرفی خود با یک user agent صادقانه بر عهده شماست. اجرای خزنده از طریق پروکسی دیتاسنتر آدرسهای خروجی شما را از سرورهای اپلیکیشن جدا میکند و معرفی خود با یک فهرست IP ثابت را آسانتر میکند؛ اما شمار درخواستهایی را که سایت در هر دقیقه اجازه میدهد بالا نمیبرد.
جای واقعی پروکسی جغرافیاست. یک فروشگاه میتواند بسته به کشور بازدیدکننده قیمت، واحد پول و کمپین متفاوتی نشان دهد. دستیارها صفحه را از همانجایی واکشی میکنند که زیرساخت خودشان قرار دارد؛ بازههای IP خود را منتشر میکنند اما درباره کشور قولی نمیدهند. در خزنده خودتان این کنترل دست شماست: یک پروکسی مسکونی با خروجی ترکیه صفحه را همانطور برمیگرداند که خریدار آن کشور میبیند و به شما امکان میدهد «از کدام کشور دیده شده» را کنار داده ثبت کنید. اینکه پاسخ یک دستیار، در مورد ChatGPT، ممکن است بسته به محل پرسیدن تغییر کند، موضوع جداگانهای است.
اشتباههای رایج
- ثبت قیمت دستیار بدون تاریخ. پاسخ ممکن است از کش یا از صفحهای بیاید که روزها پیش نمایه شده است؛ URL منبع و زمان پاسخ را با هم نگه دارید.
- پاسخ بیمنبع را منبعدار پنداشتن. در Gemini نبودن دکمه «منابع» یعنی پاسخ بر جستوجو تکیه نداشته است؛ در Claude با خاموش بودن جستوجوی وب، پاسخ از دادههای آموزشی میآید.
- تلاش برای دادن صدها URL به یک دستیار. ابزارها برای هر درخواست سقف URL و توکن دارند؛ وقتی کار بزرگ شد، به API رسمی یا خزنده خودتان بروید.
- گزارش کردن صفحه رندرشده با JavaScript با عنوان «دستیار نتوانست بخواند». صفحه به شکل پوستهای خالی برمیگردد؛ مشکل در شیوه ساخت صفحه است.
- بستن فقط ربات آموزش و تمامشده دانستن کار. رباتهای جستوجو و رباتهای بهدرخواست کاربر هویتهای جداگانهاند و بیشتر دسته دوم اصلاً robots.txt را نمیخوانند.
- اعتماد به رشته user agent. هر کسی میتواند آن را بنویسد؛ راستیآزمایی به فهرست IP یا درخواست امضاشده نیاز دارد.
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
| پاسخی سریع با منبع برای هر جمله | Perplexity |
| خواندن یک سند بلند یا URL دلخواه شما با ارجاع در سطح جمله | Claude |
| پاسخهای روز بر پایه جستوجوی گوگل، درون اکوسیستم گوگل | Gemini |
| پژوهش روزمره با راستیآزمایی از راه کلیک روی منابع | ChatGPT |
| افزودن جستوجوی وب منبعدار به اپلیکیشن خودتان | ابزارهای OpenAI یا Anthropic؛ Perplexity Sonar |
| بهعنوان صاحب سایت، بستن خزش آموزشی و ماندن در جستوجو | GPTBot، ClaudeBot و Google-Extended بسته؛ رباتهای جستوجو باز |
| گردآوری منظم و بزرگمقیاس داده | منبع مجاز، API رسمی یا خزنده خودتان |
پرسشهای متداول
آیا ChatGPT به اینترنت متصل است؟
بله. ChatGPT در صورت نیاز در وب جستوجو میکند، در همه پلنها، و منابع قابلکلیک به پاسخ میافزاید. گاهی با ارائهدهندگان جستوجوی دیگر همکاری میکند و پرسش شما را به جستوجوهای هدفمند بازنویسی میکند.
آیا Claude میتواند در وب جستوجو کند؟
بله. جستوجوی وب از مارس 2025 در Claude هست و از مه 2025 در همه پلنها و همه کشورها در دسترس است. آن را از منوی «+» در گفتوگو فعال میکنید؛ Claude وقتی پرسشی به اطلاعات روز نیاز دارد جستوجو میکند و هر ارجاع را به منبعش گره میزند.
تفاوت Perplexity و ChatGPT چیست؟
Perplexity هر پاسخ را با جستوجو آغاز میکند و منابع شمارهدار را بخشی از پاسخ میسازد؛ ChatGPT فقط در صورت نیاز جستوجو میکند و منابع را به شکل پیوند درون متن میدهد. Perplexity برای پاسخ سریع و منبعدار مناسب است؛ ChatGPT برای گفتوگوی بلند و مجموعه ابزار گستردهتر.
آیا دستیارهای هوش مصنوعی میتوانند صفحههای پشت دیوار پرداخت را بخوانند؟
خیر. مستندات URL context در Gemini تصریح میکند محتوای پشت ورود به حساب یا دیوار پرداخت خوانده نمیشود و ابزارهای دیگر هم صفحه را بدون نشست (session) درخواست میکنند. دستیار همان نسخهای از صفحه را میبیند که سایت به همه نشان میدهد.
آیا بستن Google-Extended بر رتبه در جستوجوی گوگل اثر دارد؟
خیر. مستندات گوگل میگوید Google-Extended رشته user agent جداگانهای ندارد و بر جایگاه سایت در جستوجوی گوگل اثر نمیگذارد. این توکن فقط تعیین میکند محتوای خزششده برای آموزش و grounding در Gemini استفاده شود یا نه.
آیا میتوانم رباتهای هوش مصنوعی را با robots.txt کاملاً ببندم؟
تا حدی. رباتهای آموزش و جستوجو به robots.txt پایبندند؛ بیشتر رباتهایی که از طرف کاربر صفحه باز میکنند پایبند نیستند و Claude-User متعلق به Anthropic استثناست. برای محدود کردن بازدیدهای بهدرخواست کاربر به قاعدههای سمت سرور بر پایه user agent و فهرستهای IP منتشرشده نیاز دارید.
خلاصه
هر چهار دستیار به وب میرسند: Perplexity جستوجو را پیششرط هر پاسخ میکند، ChatGPT و Claude در صورت نیاز جستوجو میکنند و Gemini به جستوجوی گوگل تکیه میدهد و پاسخ بیمنبع را هم عادی میداند. در خواندن URL محدودیتهای مستند مشترکی دارند: بدون JavaScript، بدون ورود به حساب، بدون مسیرهای بستهشده با robots.txt، و با کش. برای صاحبان سایت شکاف اصلی در رباتهای بهدرخواست کاربر است؛ همه شرکتها جز Anthropic این بازدیدها را بیرون از robots.txt میدانند، پس کنترل به user agent و فهرست IP منتقل میشود. برای تیمهای داده این ابزارها دستیار پژوهشاند، نه گردآورنده؛ گردآوری منظم به منبع مجاز، API رسمی یا خزنده خودتان نیاز دارد و برای دیدن صفحه از کشور درست میتوانید زیرساخت اسکرپینگ داده ما را ببینید.