هر دوشنبه، صاحب یک کتابفروشی اینترنتی کوچک قیمت 150 عنوان از کتابهایش را در سه فروشگاه دیگر بررسی میکند. این کار بهصورت دستی یعنی 450 بار باز کردن صفحه و بیشتر وقت یک صبح، و تا چهارشنبه بعضی از عددها دیگر کهنه شدهاند. یک برنامه کوتاه میتواند همان صفحهها را باز کند، قیمت کنار هر عنوان را بخواند و صفحهگسترده را خودش پر کند. به چنین برنامهای اسکرپر وب (web scraper) میگویند و به کاری که انجام میدهد وب اسکرپینگ (web scraping).
این نوشته یک قیمت واقعی را از اولین درخواست تا جدول نهایی دنبال میکند. در طول مسیر، اسکرپینگ را با خزش وب و API مقایسه میکند، ابزارها را بر اساس مهارتی که لازم دارند دستهبندی میکند، به قانونی بودن آن میپردازد، توضیح میدهد چرا سایتها اسکرپرها را مسدود میکنند و پروکسی کجا به کار میآید و در پایان یک نمونه کوتاه پایتون را نشان میدهد که روی یک سایت تمرینی اجرا کردهایم.
وب اسکرپینگ چیست؟
وب اسکرپینگ یعنی به کار بردن نرمافزار برای خواندن صفحههای وب و کپی کردن اطلاعات مشخصی از آنها در قالبی ساختاریافته. کسی که به صفحه یک محصول نگاه میکند یک تصویر، یک عنوان و یک قیمت میبیند. اسکرپر متن پشت صفحه، یعنی کد HTML، را میبیند و فقط بخشهایی را برمیدارد که به آن گفته شده پیدا کند: نام محصولات، قیمتها، تاریخها، خانههای جدول، پیوندها.
اسکرپینگ داده (data scraping) اصطلاح گستردهتری است و بیرون کشیدن داده از فایلها، PDFها یا صفحهنمایش نرمافزارهای قدیمی را هم در بر میگیرد؛ وب اسکرپینگ بخشی از آن است که روی وبسایتها کار میکند. استخراج داده (data extraction) مرحلهای درون اسکرپینگ است که در آن فیلدها جدا میشوند. اسکرپر ابزار هک هم نیست. همان صفحههایی را میخواند که هر بازدیدکنندهای میتواند باز کند، فقط سریعتر، و همین سرعت دلیل آن است که اسکرپینگ قاعدههایی دارد.
پیش از نوشتن هر کدی، تصمیم بگیرید به کدام فیلدها نیاز دارید. سپس اسکرپر برای هر محصول یا مقاله یک ردیف پر میکند. جمع کردن «هر چیزی که در صفحه هست، محض احتیاط» پاکسازی داده را سختتر میکند و این احتمال را بالا میبرد که اطلاعات شخصیای وارد داده شود که نباید ذخیره کنید.
وب اسکرپینگ چگونه کار میکند؟
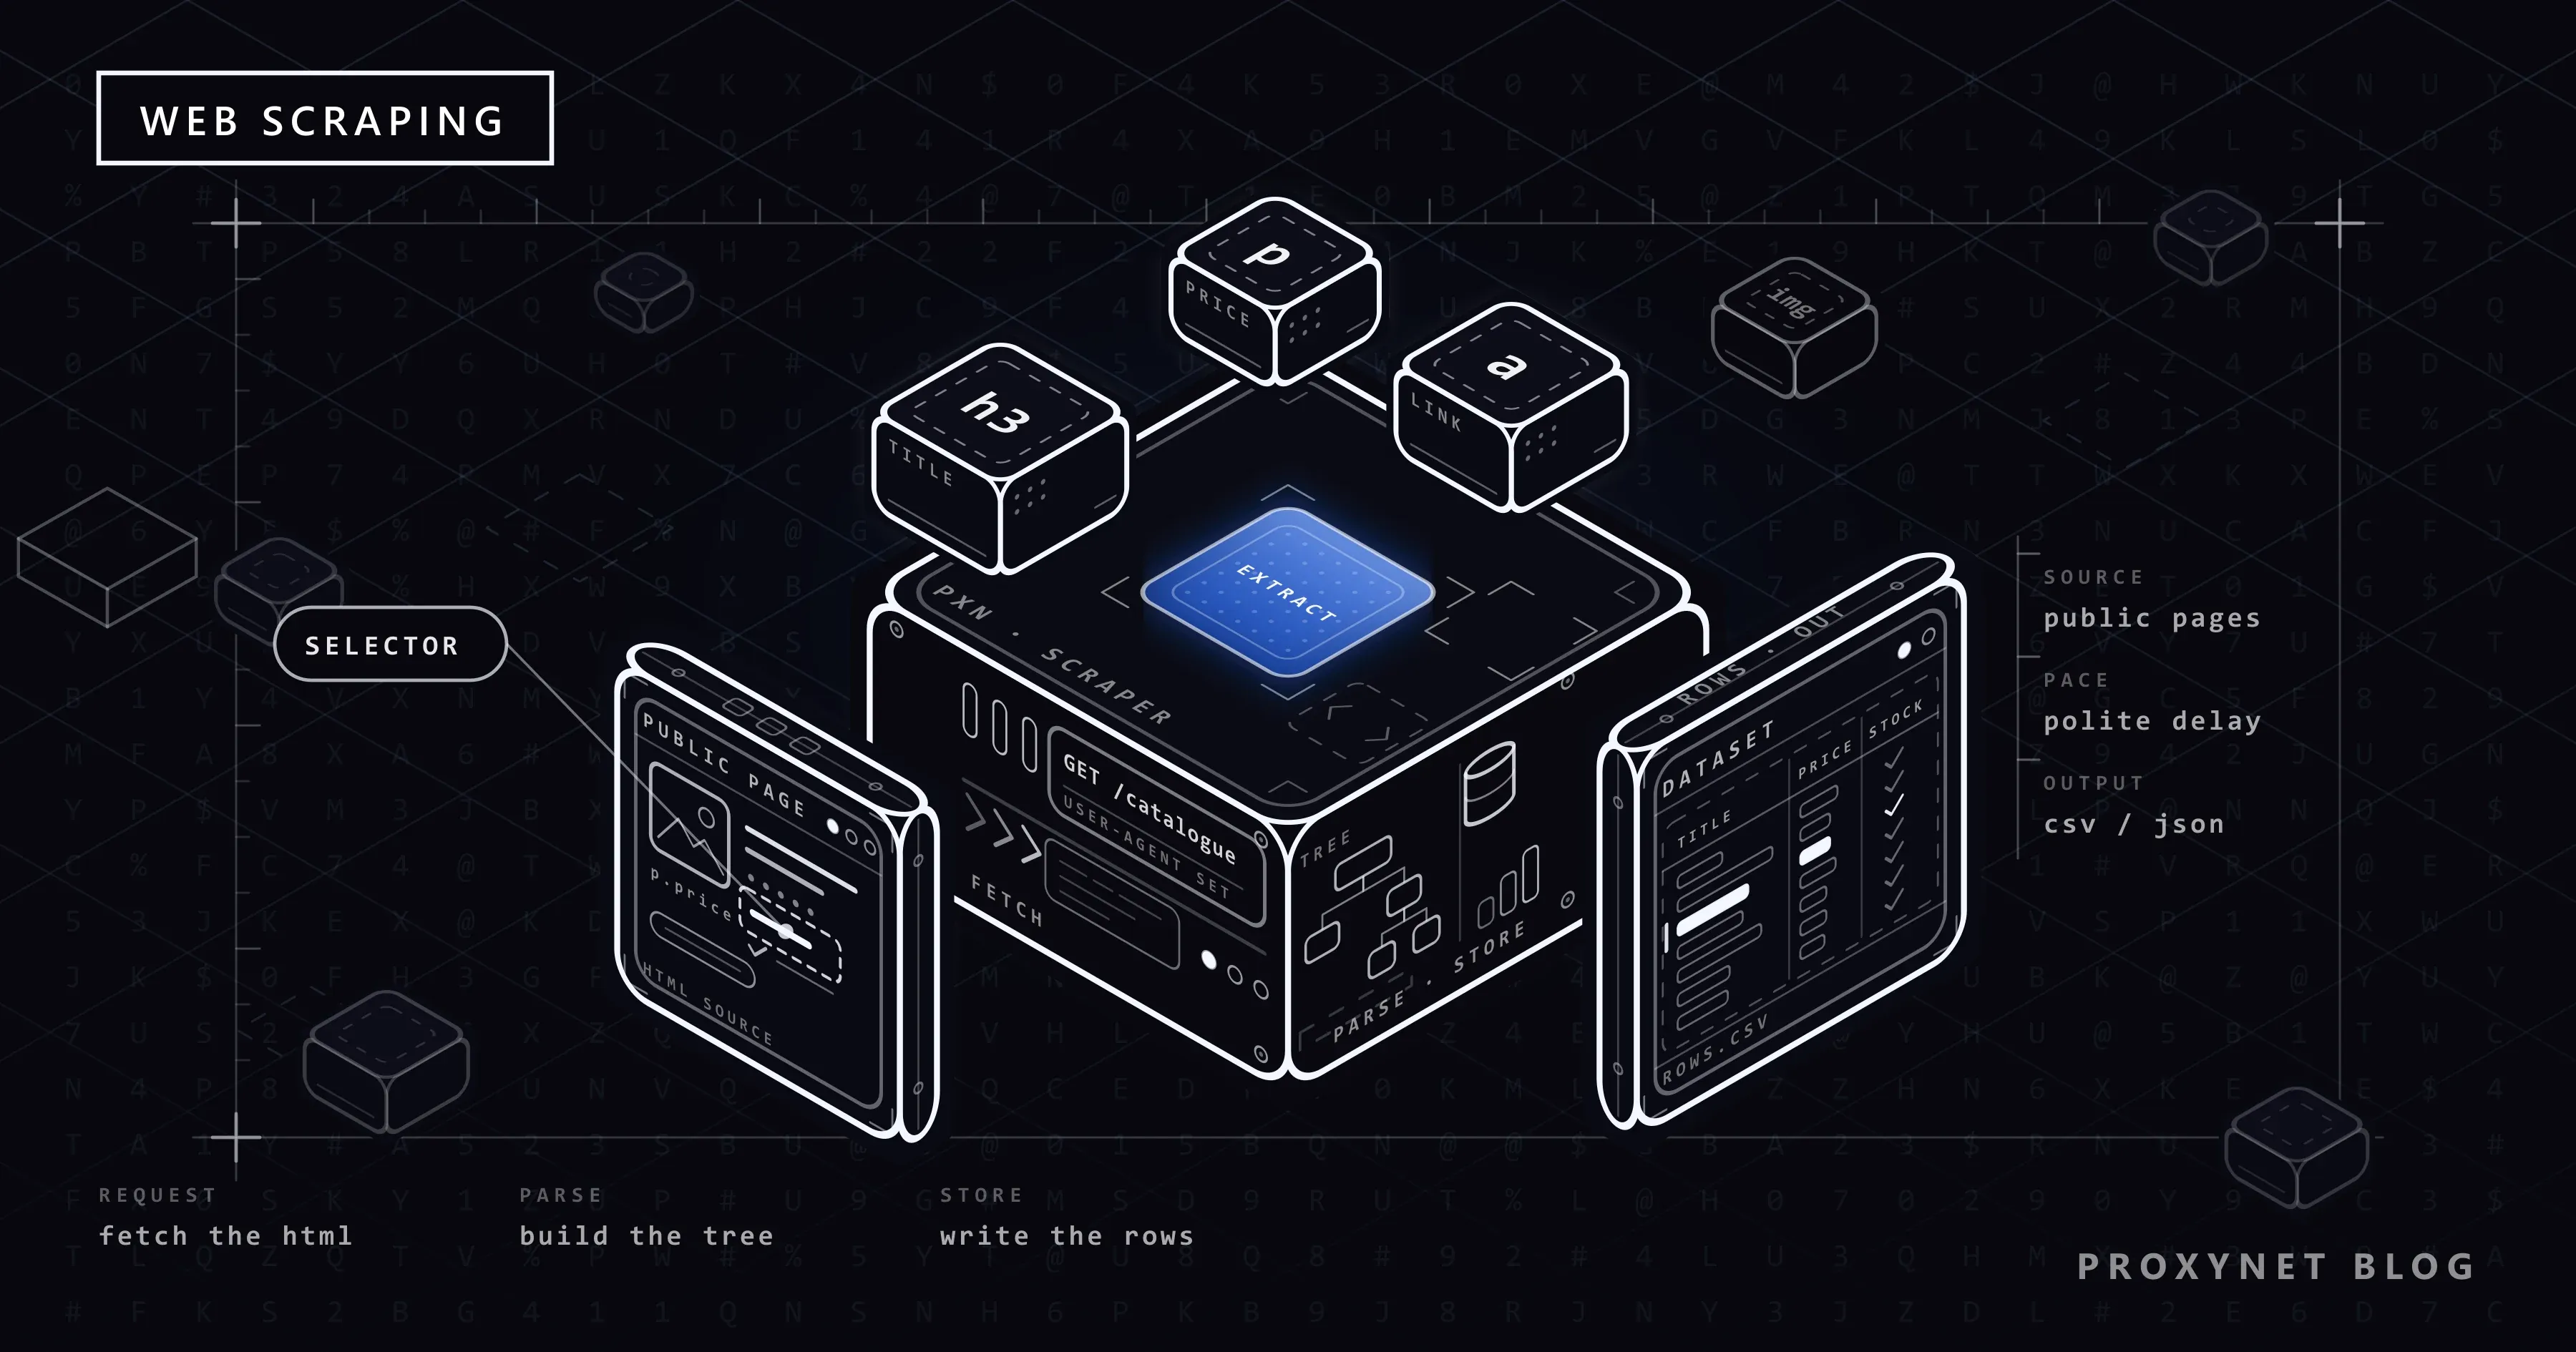
هر اسکرپری، از یک افزونه مرورگر تا سیستمی که میلیونها صفحه را بازدید میکند، همین چرخه را اجرا میکند. ما یک قیمت واقعی را در این چرخه دنبال میکنیم: اولین کتاب در صفحه دسته Travel سایت books.toscrape.com، سایتی که خودش را «یک وبسایت نمایشی برای اهداف وب اسکرپینگ» معرفی میکند و قیمتهایش تصادفی است.
- صفحهها را انتخاب کنید. اسکرپر با فهرستی از آدرسها شروع میکند که یا خودتان نوشتهاید یا یک خزنده با دنبال کردن پیوندها ساخته است. فهرست ما یک مدخل دارد: صفحه دسته Travel.
- قاعدهها را بررسی کنید. دنبال API رسمی یا پیوند دانلود بگردید، شرایط استفاده را بخوانید و فایل robots.txt سایت را دریافت کنید. در سایت تمرینی این آدرس خطای 404 برمیگرداند؛ این سایت برای اسکرپ شدن ساخته شده است.
- درخواست بفرستید. برنامه با یک درخواست HTTP، همان پیامی که مرورگر میفرستد، صفحه را از سرور میخواهد. اسکرپر خوشرفتار یک هدر User-Agent اضافه میکند که میگوید چه برنامهای است.
- HTML را دریافت کنید. سرور با یک کد وضعیت (200 یعنی صفحه تحویل داده شد) و HTML پاسخ میدهد. قیمت ما به این شکل میرسد:
<p class="price_color">£45.17</p>؛ متنی که در تگها پیچیده شده و هنوز عدد نیست. - HTML را تجزیه کنید. تجزیهگر (parser) متن را به درختی از عنصرهای تودرتو تبدیل میکند که برنامه میتواند در آن جستوجو کند. این مرحله را در نوشته تجزیه داده توضیح دادهایم.
- فیلدها را استخراج کنید. یک انتخابگر CSS دقیقاً به عنصر مورد نظر اشاره میکند: درون هر کارت محصول، پاراگرافی که کلاس
price_colorدارد. نتیجه یک رکورد کوچک است: «It's Only the Himalayas»،£45.17و «In stock». - پاکسازی و ذخیره کنید. فاصلههای اضافه حذف میشوند، اگر بخواهید با قیمت محاسبه کنید نماد ارز جدا میشود و رکورد به یک ردیف در فایل یا پایگاه داده تبدیل میشود؛ قالبها در ذخیره دادههای اسکرپینگ در CSV، JSON و SQLite مقایسه شدهاند.
- طبق زمانبندی تکرار کنید. اسکرپر به صفحه بعد میرود یا فردا دوباره اجرا میشود. تغییر قیمت با مقایسه ردیف امروز و ردیف دیروز آشکار میشود.
گامهای 3 تا 7 برای هر صفحه خیلی کمتر از یک ثانیه طول میکشند. کار دقیق و حساس در گامهای 1، 2 و 8 است.
مقایسه وب اسکرپینگ، خزش وب و API
| وب اسکرپینگ | خزش وب | API رسمی | |
|---|---|---|---|
| چه میکند | فیلدها را از صفحههای شناختهشده بیرون میکشد | با دنبال کردن پیوندها صفحه پیدا میکند | دادهای را ارائه میدهد که سایت از قبل ساختاریافته کرده است |
| چه به دست میآورید | ردیفها: عنوان، قیمت، تاریخ | فهرستی از آدرس صفحهها | JSON یا CSV در قالبی مستند |
| قالب را چه کسی تعیین میکند | شما، با انتخابگرها | هیچکس؛ فهرستی از URLهاست | خود سایت |
| چه زمانی از کار میافتد | وقتی طراحی صفحه تغییر کند | وقتی پیوندهای سایت تغییر کنند | بهندرت؛ نسخههای تازه از قبل اعلام میشوند |
| چه چیزی بر آن حاکم است | robots.txt، شرایط استفاده، قانون | robots.txt و نرخ خزش | کلید API و شرایط استفاده از API |
در عمل، اسکرپینگ و خزش با هم کار میکنند: خزنده صفحههای محصول را پیدا میکند و اسکرپر هر کدام را میخواند. این دو را با کد Scrapy در وب اسکرپینگ و خزش وب مقایسه کردهایم و صفحه خزنده وب ما پیکربندی پروکسی برای خزشهای بزرگ را پوشش میدهد. وقتی سایتی API با فیلدهای مورد نیاز شما ارائه میدهد، استفاده از آن تقریباً همیشه راه بهتری است، چون با عوض شدن نام یک کلاس به دست طراح از کار نمیافتد؛ تفاوت وب اسکرپینگ و API این تصمیم را قدم به قدم بررسی میکند.
ابزارهای وب اسکرپینگ: کدام نوع برای چه کسی مناسب است؟
انواع ابزار بیشتر در این با هم فرق دارند که چه مقدار از این چرخه را برای شما انجام میدهند و چه مقدار کنترل را در دست شما میگذارند.
| نوع ابزار | مهارت لازم | مناسب برای | کجا کم میآورد |
|---|---|---|---|
| افزونه مرورگر | هیچ | چند صد ردیف از یک سایت، یک بار | وقتی چیدمان صفحه تغییر کند، بیصدا از کار میافتد |
| ابزار بدون کدنویسی دسکتاپ یا ابری | کم | کارهای زمانبندیشده بدون برنامهنویسی | داده شما از سرور یک شخص ثالث عبور میکند؛ پلنهای رایگان محدودند |
| کتابخانههای پایتون یا Node.js | متوسط | کارهای منظم، هزاران صفحه، قالب دلخواه خودتان | کد را خودتان مینویسید و نگه میدارید |
| مرورگر headless | متوسط تا زیاد | صفحههایی که محتوایشان را با JavaScript پر میکنند | کند است و حافظه زیادی مصرف میکند |
| اسکرپر هوش مصنوعی | کم تا متوسط | چیدمانهایی که مدام تغییر میکنند | هزینه بهازای هر صفحه؛ یک مقدار نادرست میتواند درست به نظر برسد |
| API اسکرپینگ میزبانیشده | کم تا متوسط | یک URL میدهید و HTML یا JSON میگیرید، بدون سروری که نگه دارید | هزینه ماهانه؛ قاعدههای سایت همچنان شامل حال شماست |
مرورگر headless یک مرورگر واقعی بدون پنجره است که JavaScript صفحه را برای کد شما اجرا میکند؛ اینکه چه زمانی به آن نیاز دارید در صفحههای ایستا و پویا در وب اسکرپینگ آمده است. اسکرپر هوش مصنوعی مرحله «پیدا کردن فیلد» را به یک مدل زبانی میسپارد؛ مزایا و معایبش در نوشته اسکرپر وب هوش مصنوعی آمده است. اگر کد نمینویسید، از راهنمای استخراج داده از وبسایت شروع کنید؛ اگر کد مینویسید، آموزش BeautifulSoup از نمونه پایین همین صفحه جلوتر میرود.
آیا وب اسکرپینگ قانونی است؟
جمعآوری داده عمومی و غیرشخصی با سرعتی معقول، در بیشتر نظامهای حقوقی بهخودیخود ممنوع نیست. آنچه پاسخ را تغییر میدهد این است که چه چیزی را و چگونه جمع میکنید: داده شخصی، حتی وقتی آشکارا در صفحه دیده میشود، تابع قوانینی مانند GDPR اتحادیه اروپاست، متنها و پایگاههای دادهای که حق نشر دارند حمایت خاص خود را دارند و شرایط استفاده میتواند جمعآوری خودکار را ممنوع کند. اسکرپ کردن صفحههای پشت ورود به حساب یا عبور از یک مانع فنی، موقعیت شما را بسیار ضعیفتر میکند. قاعدههای هر کشور در آیا اسکرپینگ وب قانونی است؟ آمده است؛ این نوشته مشاوره حقوقی نیست.
چرا وبسایتها اسکرپرها را مسدود میکنند؟
یک انسان یک صفحه را در یک دقیقه میخواند؛ یک اسکریپت بیدقت میتواند در همان یک دقیقه صد صفحه درخواست کند و سرعت سایت را برای همه پایین بیاورد. سه سازوکار تعیین میکنند که یک اسکرپر همچنان پاسخ بگیرد یا نه.
- محدودیت نرخ. سرور درخواستها را بهازای هر آدرس یا حساب در یک بازه زمانی میشمارد. پس از گذشتن از حد، با
429 Too Many Requestsپاسخ میدهد که در RFC 6585 تعریف شده است و میتواند هدرRetry-Afterهم داشته باشد که میگوید چقدر صبر کنید. این RFC تعریف نمیکند سرور چگونه بشمارد، پس هر سایت آستانه خودش را تعیین میکند؛ نوشته خطای 429 Too Many Requests را ببینید. - اعتبار IP. آدرسها سابقه دارند. بازههای IP دیتاسنتر، آدرسهایی که در ارسال هرزنامه دیده شدهاند و آدرسهایی که در هر ساعت هزاران درخواست میفرستند، کمتر از یک اتصال خانگی مورد اعتماد قرار میگیرند.
- امتیاز بات. سرویسهای محافظت در برابر بات، نرخ درخواست، هدرها، handshake اتصال TLS و اجرا شدن یا نشدن JavaScript را در یک امتیاز ترکیب میکنند؛ اگر امتیاز از یک آستانه پایینتر باشد، بازدیدکننده با یک چالش یا مسدودسازی روبهرو میشود. این لایهها در تشخیص بات چگونه کار میکند؟ توضیح داده شدهاند.
پروکسی کجا به کار میآید؟
سرور پروکسی درخواستهای شما را منتقل میکند و سایت به جای آدرس IP شما، آدرس IP پروکسی را میبیند. این موضوع در دو موقعیت مشروع اهمیت دارد. اولی موقعیت جغرافیایی است: فروشگاهی را که در آلمان یک قیمت و در ترکیه قیمت دیگری نشان میدهد فقط میتوان از هر کشور جداگانه بررسی کرد و پروکسی مسکونی (رزیدنتال) با هدفگیری جغرافیایی به شما امکان میدهد کشور و شهر را انتخاب کنید. دومی حجم است: بار یک کار بزرگ نباید روی یک آدرس جمع شود و پروکسی چرخشی به هر درخواست، یا به هر نشست چنددقیقهای، IP متفاوتی از یک استخر میدهد. صفحه استخراج داده ما نوع پروکسی را با نوع کار تطبیق میدهد.
پروکسی راهی برای گذشتن از محدودیت نرخ یا مسدودسازی نیست. اگر سایتی با 429 پاسخ داد یا از شما خواست متوقف شوید، سرعت را کم کنید، به API بروید یا اجازه بگیرید؛ عوض کردن IP برای حفظ همان سرعت دقیقاً همان کاری است که محدودیت برای جلوگیری از آن وجود دارد. فهرست عیبیابی در وب اسکرپینگ بدون مسدود شدن آمده است.
چکلیست وب اسکرپینگ مسئولانه
- اول API. پیش از تجزیه یک صفحه، دنبال API رسمی، فایل دانلودی یا فید بگردید.
- از robots.txt پیروی کنید. RFC 9309 این فایل را در مسیر سطح بالای سایت، یعنی
/robots.txt، قرار میدهد و میگوید قاعدههایش «نوعی مجوز دسترسی نیستند». این فایل یک درخواست است، نه قفل: هیچچیز اسکرپر را از نادیده گرفتن آن باز نمیدارد و به همین دلیل پیروی از آن بر عهده خود شماست. نحوه خواندنش در راهنمای robots.txt آمده است. - شرایط استفاده را بخوانید. سایتی که جمعآوری خودکار را ممنوع کرده، هدف اسکرپینگ نیست.
- فقط صفحههای عمومی، هرگز صفحههای پشت ورود به حساب شخص دیگر.
- داده شخصی را کنار بگذارید. برای وقتی که چنین دادهای ناخواسته وارد شد، مدیریت دادههای شخصی (PII) در مجموعهدادههای اسکرپشده را ببینید.
- سرعتی آهسته و یکنواخت نگه دارید: برای یک سایت کوچک چند ثانیه فاصله میان درخواستها و توقف کامل در برابر
429یا503. - بگویید چه کسی هستید، با یک User-Agent صادقانه، نه هویت جعلی مرورگر.
یک نمونه کوتاه وب اسکرپینگ با پایتون
پایتون نقطه شروع رایجی است، چون دو کتابخانه بخشهای دشوار کار را انجام میدهند. Requests درخواست HTTP را میفرستد. Beautiful Soup، به تعبیر مستندات خودش، «یک کتابخانه پایتون برای بیرون کشیدن داده از فایلهای HTML و XML» است؛ خودش چیزی دانلود نمیکند.
pip install requests beautifulsoup4اسکریپت دسته Travel سایت تمرینی را میخواند، عنوان، قیمت و وضعیت موجودی همه کتابها را برمیدارد و آنها را در یک فایل CSV مینویسد. کامنتهای شمارهدار درون کد با گامهای 3 تا 7 بالا مطابقت دارند.
import csv
import os

import requests
from bs4 import BeautifulSoup

URL = "https://books.toscrape.com/catalogue/category/books/travel_2/index.html"

# Optional: PROXY_URL=http://user:pass@pr.proxynet.io:8000
proxy = os.environ.get("PROXY_URL")
proxies = {"http": proxy, "https": proxy} if proxy else None

# 1. Request: download the page
response = requests.get(
    URL,
    headers={"User-Agent": "scraping-intro/1.0 (contact: you@example.com)"},
    proxies=proxies,
    timeout=20,
)
response.raise_for_status()
response.encoding = "utf-8"

# 2. Parse: turn the HTML text into a tree you can search
soup = BeautifulSoup(response.text, "html.parser")

# 3. Extract: the same three fields from every product card
rows = []
for card in soup.select("article.product_pod"):
    rows.append({
        "title": card.h3.a["title"],
        "price": card.select_one("p.price_color").get_text(strip=True),
        "stock": card.select_one("p.availability").get_text(strip=True),
    })

# 4. Store: write the rows to a CSV file
with open("travel_books.csv", "w", newline="", encoding="utf-8-sig") as f:
    writer = csv.DictWriter(f, fieldnames=["title", "price", "stock"])
    writer.writeheader()
    writer.writerows(rows)

print(len(rows), "books saved to travel_books.csv")
for row in rows[:3]:
    print(row["price"], "|", row["stock"], "|", row["title"])
این اسکریپت را با پایتون 3.13، Requests 2.34 و Beautiful Soup 4.15 اجرا کردیم و این خروجی را چاپ کرد:
11 books saved to travel_books.csv
£45.17 | In stock | It's Only the Himalayas
£49.43 | In stock | Full Moon over Noah’s Ark: An Odyssey to Mount Ararat and Beyond
£48.87 | In stock | See America: A Celebration of Our National Parks & Treasured Sites
سه خط دلیل مشخصی دارند. بدون timeout=20، همانطور که مستندات Requests هشدار میدهد، Requests بیپایان منتظر سروری میماند که پاسخ نمیدهد و اسکریپت گیر میکند. سایت تمرینی هدر Content-Type: text/html را بدون مجموعه نویسه (charset) میفرستد، پس Requests کدگذاری ISO-8859-1 را فرض میکند؛ وقتی خط response.encoding = "utf-8" را حذف کردیم، همه قیمتها به شکل £45.17 درآمدند. و raise_for_status() با پاسخ 4xx یا 5xx اجرا را متوقف میکند تا یک صفحه خطا هرگز بهعنوان داده ذخیره نشود.
برای عبور از پروکسی، پیش از اجرا PROXY_URL را برابر http://user:pass@pr.proxynet.io:8000 قرار دهید؛ چیز دیگری عوض نمیشود. این را با یک پروکسی آزمایشی محلی آزمودیم: با اطلاعات ورود درست همان 11 ردیف برگشت و با رمز عبور نادرست یک ProxyError حاوی 407 Proxy Authentication Required رخ داد. برای صفحهبندی، تلاش دوباره و استخر چرخشی، با وب اسکرپینگ در Python با پروکسی چرخشی ادامه دهید.
وب اسکرپینگ چه کاربردهایی دارد؟
- پایش قیمت و موجودی: دنبال کردن قیمتها و موجودی عمومی رقبا. پیکربندی آن در صفحه پایش قیمت ما آمده است.
- تحقیقات بازار: تعداد محصولات، بازه قیمتها و ترکیب برندها در فروشگاههای مختلف نشان میدهد بازار چگونه حرکت میکند. صفحه تحقیقات بازار ما را ببینید.
- داده سئو: رتبههای سایت خودتان از API رسمی Search Console به دست میآید و داده SERP دارای مجوز جاهای خالی را پر میکند. سیاستهای اسپم گوگل اسکرپ کردن نتایج برای بررسی رتبه بدون اجازه صریح را تخلف میداند؛ راه رسمی در خودکارسازی ردیابی رتبه در سئو آمده است.
- پژوهش و علم داده: فهرستها و آمارهای عمومی که در طول زمان جمع شدهاند به مجموعهدادهای برای تحلیل تبدیل میشوند؛ این موضوع نوشته دادهکاوی است.
- ابزارهای هوش مصنوعی و RAG: در تولید تقویتشده با بازیابی (RAG، مخفف retrieval-augmented generation)، مدل هوش مصنوعی پیش از پاسخ دادن سندهای بهروز را جستوجو میکند و اغلب اسکرپرها این سندها را دریافت میکنند. برای محدودیتها دسترسی امن LLM به وب را ببینید.
- ممیزی سایت خودتان: توضیحات متای جاافتاده، قیمتهای نادرست و پیوندهای شکسته در هزاران صفحه. نوشته کدهای وضعیت HTTP در وب اسکرپینگ به خواندن پاسخها کمک میکند.
اشتباههای رایج
- اسکرپ کردن وقتی API وجود دارد. در این حالت کار با هر بازطراحی سایت از کار میافتد.
- نداشتن timeout. یک سرور ساکت میتواند اسکریپت را تمام شب معطل نگه دارد.
- نادیده گرفتن کدگذاری. دیدن
£به جای£، یا حروف فارسی و حروف نشانهدار بههمریخته، یعنی مجموعه نویسه اشتباه حدس زده شده است. - داده دانستن نتیجه خالی. انتخابگری که دیگر با صفحه جور درنمیآید معمولاً یک ستون خالی میدهد، نه خطا. در هر اجرا تعداد ردیفها را بررسی کنید.
- استفاده از پروکسی برای گذشتن از یک محدودیت.
429از شما میخواهد آهستهتر بروید؛ چرخاندن IP برای حفظ همان سرعت فقط مشکل را بزرگتر میکند. - شروع با مرورگر headless. اگر داده از قبل در HTML هست، مرورگر واقعی فقط زمان و حافظه بیشتری مصرف میکند.
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
| سایت API دارد و فیلدهای مورد نیاز شما را ارائه میدهد | به جای اسکرپینگ از API استفاده کنید |
| یک جدول از یک صفحه، یک بار | وارد کردن داده در صفحهگسترده یا یک افزونه مرورگر |
| همان صفحهها هر روز | یک اسکریپت پایتون با تأخیر میان درخواستها، timeout و بررسی تعداد ردیفها |
| محتوا فقط پس از اجرای JavaScript ظاهر میشود | اول منبع JSON خود صفحه، بعد مرورگر headless |
| قیمتها از کشوری به کشور دیگر فرق میکند | پروکسی مسکونی با هدفگیری همان کشور |
| هزاران صفحه با سرعتی مؤدبانه | یک خزنده با پروکسی چرخشی برای پخش کردن بار |
سایت با 429 پاسخ میدهد | سرعت را کم کنید و Retry-After را رعایت کنید |
| داده شخصی یا حساب کاربری شخص دیگر | اسکرپ نکنید؛ از صاحب سایت بپرسید |
پرسشهای متداول
وب اسکرپینگ در علم داده چه کاربردی دارد؟
برای مجموعهدادههایی که به شکل آماده وجود ندارند: قیمتها در فروشگاههای مختلف در طول زمان، آگهیهای شغلی به تفکیک شهر، نظرهای کاربران برای تحلیل متن. ارزش کار معمولاً از تکرار جمعآوری در طول چند هفته میآید، پس یک زمانبندی پایدار از سرعت مهمتر است.
آیا میتوان بدون کدنویسی وب اسکرپینگ کرد؟
بله. وارد کردن داده در صفحهگسترده، افزونههای مرورگر و ابزارهای بدون کدنویسی از پس کارهای یکباره و چیدمانهای ساده برمیآیند. با حجم زیاد، تکرار روزانه و صفحههایی که مدام تغییر میکنند، یک اسکریپت کوتاه با بررسی خطا زحمت کمتری دارد.
چرا برای وب اسکرپینگ اینقدر از پایتون استفاده میشود؟
چون قطعهها آمادهاند: Requests برای دانلود، Beautiful Soup برای تجزیه، Scrapy برای خزشهای بزرگ و Playwright برای صفحههایی که به مرورگر نیاز دارند. Node.js جایگزین رایجی است؛ این دو را در اسکرپینگ وب: JavaScript یا Python؟ مقایسه کردهایم.
آیا یک وبسایت میفهمد که دارد اسکرپ میشود؟
اغلب بله. نرخ درخواست، User-Agent، اجرا نشدن JavaScript و اعتبار IP همگی نشانههای خودکار بودن هستند. اسکرپری که خودش را معرفی میکند و سرعت پایینی دارد معمولاً تحمل میشود؛ اسکرپری که خودش را مرورگر جا میزند و در هر دقیقه صدها درخواست میفرستد معمولاً مسدود میشود.
آیا وب اسکرپینگ روی همه وبسایتها کار میکند؟
نه. صفحههای پشت ورود به حساب، متنی که درون تصویر کشیده شده و دادهای که فقط در یک اپلیکیشن موبایل وجود دارد از دسترس یک اسکرپر ساده بیروناند و بسیاری از آنها باید همینطور بمانند. صفحههایی که محتوا را با JavaScript بارگذاری میکنند قابل خواندناند، اما به مرورگر headless یا منبع داده خود صفحه نیاز دارند.
آیا برای وب اسکرپینگ به پروکسی نیاز دارید؟
برای یک کار کوچک و آهسته از یک کشور، نه. وقتی به پروکسی نیاز دارید که محتوا از کشوری به کشور دیگر تغییر کند، یک کار بزرگ باید بارش را روی آدرسهای زیادی پخش کند، یا نشستی با حساب خودتان باید همان IP را نگه دارد. پروکسی محدودیت نرخ یا شرایط استفاده یک سایت را از بین نمیبرد.
خلاصه
وب اسکرپینگ نسخه خودکار خواندن یک صفحه و کپی کردن آنچه لازم دارید در یک جدول است: صفحه را درخواست کنید، HTML را تجزیه کنید، فیلدها را استخراج کنید، ردیفها را ذخیره کنید و طبق زمانبندی تکرار کنید. خزش صفحهها را پیدا میکند، اسکرپینگ آنها را میخواند و اگر API رسمی وجود داشته باشد، هر دو را غیرضروری میکند. سادهترین ابزاری را انتخاب کنید که کار را انجام میدهد، اول robots.txt و شرایط استفاده را بررسی کنید، داده شخصی را کنار بگذارید و سرعت را پایین نگه دارید. وقتی کاری به نتیجههای مخصوص یک کشور نیاز دارد یا باید بارش را روی آدرسهای زیادی پخش کند، نوع پروکسی مناسب را در میان خدمات پروکسی ما پیدا میکنید.