


































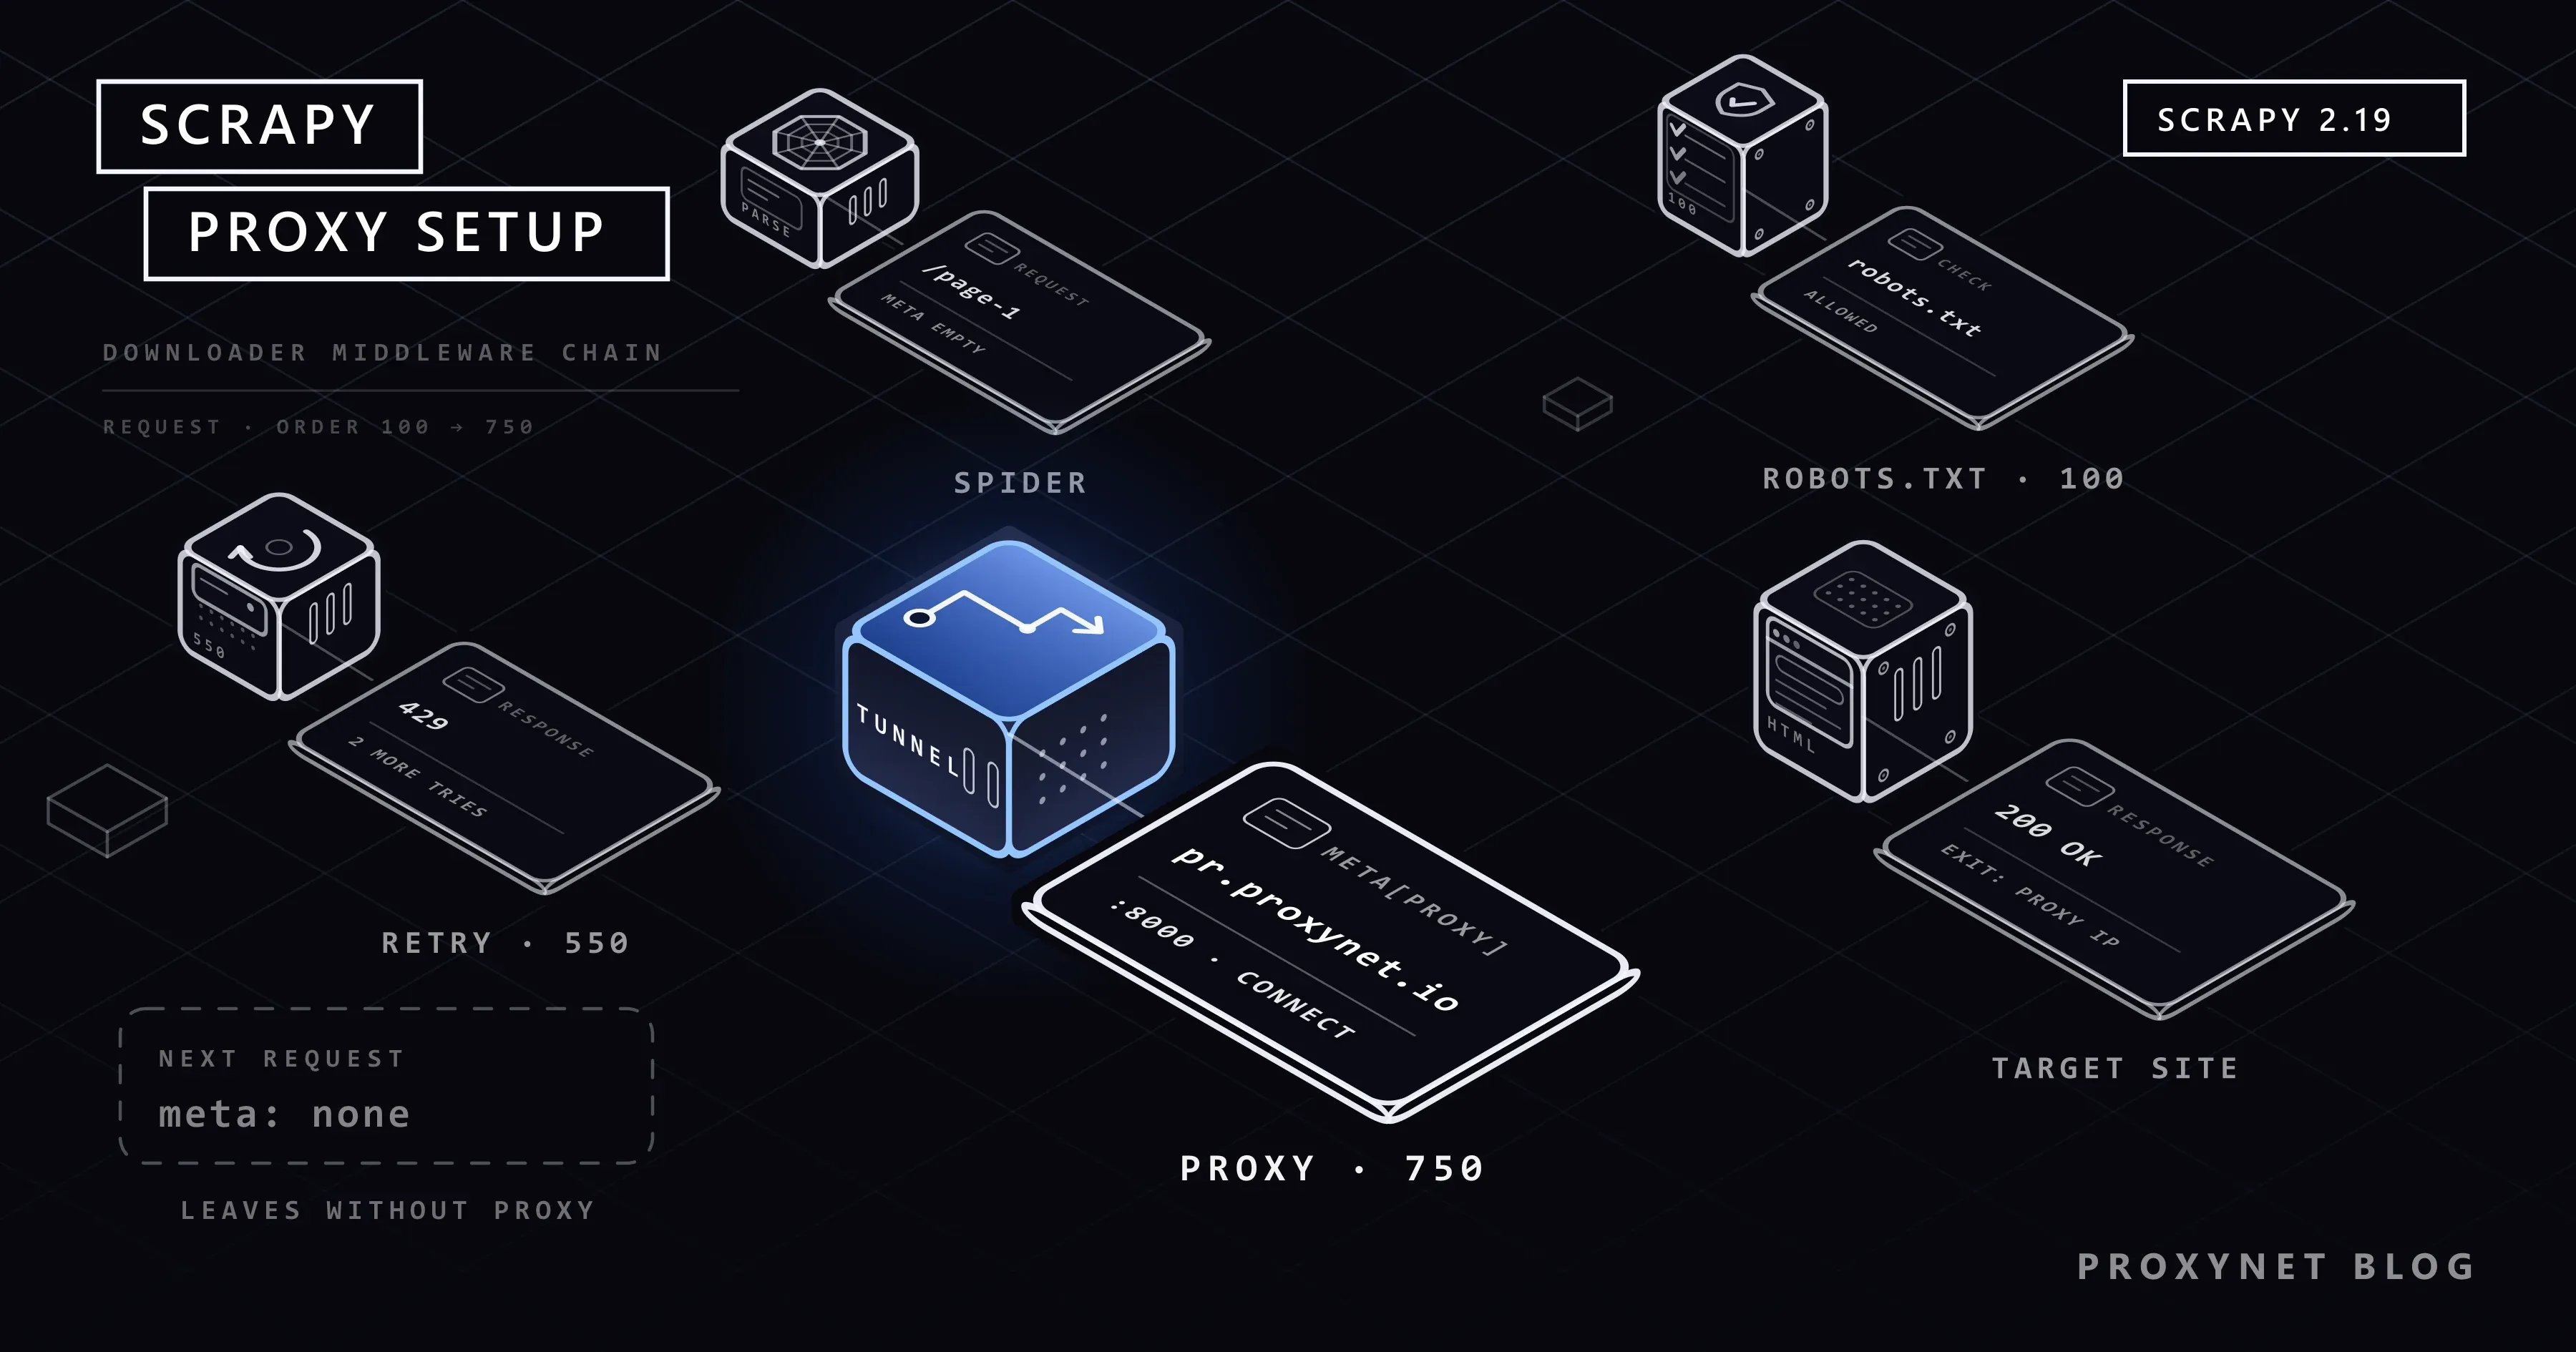
اسکریپتی که با Requests و BeautifulSoup نوشتهاید روی صد صفحه بدون مشکل کار میکند. وقتی به ده هزار صفحه میرسید خود کار عوض میشود: باید مدیریت کنید که کدام آدرس خزش شده است، کدام خطا داده و دوباره امتحان میشود، همزمان چند درخواست به یک سایت میرود و داده کجا نوشته میشود. Scrapy یک چارچوب Python است که همه این کارها را آماده در اختیار میگذارد. تنظیم پروکسی هم درون همین ساختار قرار دارد، در یکی از لایههایی که هر درخواست از آن میگذرد.
در این نوشته ابتدا کوتاه نشان میدهیم Scrapy چیست و چطور نصب میشود. سپس به موضوع اصلی میرسیم: سه راه تعریف پروکسی، احراز هویت، تفاوت گیتوی چرخشی با یک نقطه اتصال و فهرست پروکسی خودتان، تنظیم سرعت با DOWNLOAD_DELAY و AutoThrottle و رفتار Scrapy در برابر پاسخهای 429 و 503. همه نمونهها را با Scrapy 2.19 و Python 3.13 روی سایتهای تمرینی toscrape.com و یک پروکسی آزمایشی محلی اجرا کردهایم.
Scrapy چیست و چه کاربردی دارد؟
Scrapy یک چارچوب Python است که برای خزش وبسایتها و استخراج داده ساختیافته از صفحهها نوشته شده است. تفاوتش با یک کتابخانه این است: Requests ابزاری برای فرستادن یک درخواست به شما میدهد و حلقه را خودتان میسازید. در Scrapy حلقه خود چارچوب است. شما فقط کلاسی مینویسید که میگوید از کدام آدرس شروع شود و از صفحه دریافتی چه چیزی برداشته شود؛ به این کلاس spider (اسپایدر) میگویند.
هر چیزی بیرون از اسپایدر آماده است: زمانبندی که درخواستها را در صف میگذارد، فیلتر تکرار که یک آدرس را دو بار درخواست نمیکند، دانلودر ناهمگام، تلاش مجدد، بررسی robots.txt، محدود کردن سرعت و خروجی JSON یا CSV. برای انتخابگرها CSS و XPath در کنار هم به کار میروند؛ تفاوت این دو را در انتخابگر CSS یا XPath توضیح دادهایم. نقشه کلی ابزارهای Python و JavaScript هم در اسکرپینگ وب: JavaScript یا Python؟ آمده است.
Scrapy چطور نصب میشود؟
Scrapy را نه روی Python سیستم، بلکه در یک محیط مجازی مخصوص پروژه نصب کنید. دستورها در Windows اینطور است:
python -m venv venv
venv\Scripts\activate
pip install scrapy
scrapy startproject kitaplik
cd kitaplik
scrapy genspider kitaplar books.toscrape.com
در macOS و Linux خط دوم source venv/bin/activate میشود. دستور startproject اسکلتی شامل settings.py، middlewares.py و پوشه spiders/ میسازد. فایل settings.py در قالب فعلی سه تنظیم را آماده دارد: ROBOTSTXT_OBEY = True، CONCURRENT_REQUESTS_PER_DOMAIN = 1 و DOWNLOAD_DELAY = 1. یعنی پروژه تازه بهطور پیشفرض از robots.txt پیروی میکند و تقریباً در هر ثانیه یک درخواست به یک سایت میفرستد. این خطها را پاک نکنید و تنظیمات خود را روی همینها بسازید.
فایلی را که genspider ساخته مانند زیر پر کنید. اسپایدر کارتهای کتاب را میخواند و پیوند «صفحه بعد» را دنبال میکند:
import scrapy


class KitaplarSpider(scrapy.Spider):
    name = "kitaplar"
    allowed_domains = ["books.toscrape.com"]
    start_urls = ["https://books.toscrape.com/"]

    def parse(self, response):
        for kart in response.css("article.product_pod"):
            yield {
                "baslik": kart.css("h3 a::attr(title)").get(),
                "fiyat": kart.css("p.price_color::text").get(),
                "adres": response.urljoin(kart.css("h3 a::attr(href)").get()),
            }

        sonraki = response.css("li.next a::attr(href)").get()
        if sonraki:
            yield response.follow(sonraki, callback=self.parse)
دستور scrapy crawl kitaplar -O kitaplar.json اسپایدر را اجرا میکند و نتیجه را در فایل مینویسد. در آزمایش ما از دو صفحه اول 40 رکورد آمد. برای اینکه نویسههای غیرلاتین و نماد واحدهای پول در فایل خراب نشوند، خط FEED_EXPORT_ENCODING = "utf-8" قالب را نگه دارید.
Scrapy یک درخواست را چطور پردازش میکند؟
برای فهمیدن اینکه تنظیم پروکسی کجا نوشته میشود باید مسیر درخواست را بشناسید:
- اسپایدر یک شیء
Requestمیسازد (ازstart_urlsیاresponse.follow). - موتور درخواست را به زمانبند میدهد؛ فیلتر تکرار آدرسی را که پیشتر درخواست شده کنار میگذارد.
- درخواستی که نوبتش رسیده از زنجیره میانافزارهای دانلودر (downloader middleware) میگذرد. هر میانافزار یک شماره ترتیب دارد و درخواست از شماره کوچک به بزرگ پیش میرود: بررسی robots.txt شماره 100، تلاش مجدد 550 و
HttpProxyMiddlewareشماره 750 است. - دانلودر درخواست را به شبکه میفرستد. اگر درخواست
meta["proxy"]داشته باشد، اتصال بهجای مقصد به پروکسی باز میشود؛ در آدرسهای HTTPS یک تونلCONNECTاز راه پروکسی ساخته میشود. - پاسخ از همان زنجیره به ترتیب وارونه برمیگردد و به تابع بازفراخوان اسپایدر (
parse) میرسد. - رکوردهایی که تابع تولید میکند به item pipeline و درخواستهای تازه دوباره به زمانبند میروند.
نتیجه این است: پروکسی به گام سوم تعلق دارد، نه به کد تجزیه اسپایدر. فیلد meta["proxy"] را هر کسی پر کند، کار را HttpProxyMiddleware انجام میدهد. این میانافزار بهطور پیشفرض فعال است و بخش HttpProxyMiddleware در مستندات Scrapy رفتار آن را تعریف میکند.
در Scrapy پروکسی چطور تعریف میشود؟
سه راه وجود دارد و هر سه در پایان همان فیلد meta["proxy"] را پر میکنند.
| روش | کجا نوشته میشود | دامنه | چه زمانی مناسب است |
|---|---|---|---|
meta["proxy"] | در اسپایدر، درون هر Request | فقط همان درخواست | فرستادن چند درخواست از یک خروجی دیگر |
| متغیر محیطی | در پوسته، http_proxy / https_proxy | همه درخواستها، از جمله robots.txt | آزمایش سریع، اجرا بدون تغییر کد |
| میانافزار دانلودر | middlewares.py + settings.py | همه درخواستها، از جمله robots.txt | راهاندازی دائمی پروژه، چرخش |
برای هر درخواست: فیلد meta
import scrapy

PROXY = "http://user:pass@pr.proxynet.io:8000"


class KitaplarMetaSpider(scrapy.Spider):
    name = "kitaplar_meta"
    allowed_domains = ["books.toscrape.com"]

    async def start(self):
        yield scrapy.Request("https://books.toscrape.com/", meta={"proxy": PROXY})

    def parse(self, response):
        for kart in response.css("article.product_pod"):
            yield {"baslik": kart.css("h3 a::attr(title)").get()}

        sonraki = response.css("li.next a::attr(href)").get()
        if sonraki:
            # meta is not passed on to the new request automatically, carry it by hand
            yield response.follow(sonraki, callback=self.parse, meta={"proxy": PROXY})
این روش دو پیامد دارد که از چشم میافتد و هر دو را در آزمایش دیدیم. نخست، meta خودبهخود به درخواست بعدی منتقل نمیشود. در آزمایشی که meta را به فراخوانی response.follow اضافه نکردیم، صفحه اول از پروکسی و صفحه دوم مستقیم از آدرس IP خودمان رفت. دوم، درخواست robots.txt را شما ننوشتهاید و Scrapy خودش آن را میفرستد؛ پس meta ندارد و آن هم بدون پروکسی خارج میشود. اگر میخواهید همه ترافیک از یک خروجی برود، یکی از دو راه زیر را به کار ببرید.
متغیر محیطی
HttpProxyMiddleware مانند کتابخانه استاندارد Python متغیرهای http_proxy، https_proxy و no_proxy را میخواند. بدون هیچ تغییری در کد:
export https_proxy="http://user:pass@pr.proxynet.io:8000"
export http_proxy="$https_proxy"
scrapy crawl kitaplar
اگر درخواستی meta["proxy"] هم داشته باشد، آن مقدار بر متغیر محیطی مقدم است و فهرست no_proxy را نادیده میگیرد. اینکه متغیرها در Windows، macOS و Linux چطور تعریف میشوند و تفاوت حروف بزرگ و کوچک چیست، در استفاده از پروکسی در wget آمده است و اینجا تکرارش نمیکنیم.
برای کل پروژه: یک میانافزار کوچک
در راهاندازی دائمی، بهجای نوشتن آدرس درون کد، میانافزاری چندخطی که آدرس را از محیط میخواند کافی است:
# kitaplik/middlewares.py
from scrapy.exceptions import NotConfigured


class TekProxyMiddleware:
    """Applies the single proxy address from the settings to every request."""

    def __init__(self, adres):
        self.adres = adres

    @classmethod
    def from_crawler(cls, crawler):
        adres = crawler.settings.get("PROXY_ADRESI")
        if not adres:
            raise NotConfigured
        return cls(adres)

    def process_request(self, request):
        request.meta.setdefault("proxy", self.adres)
return None# kitaplik/settings.py
import os
PROXY_ADRESI = os.environ.get("PROXY_ADRESI")
DOWNLOADER_MIDDLEWARES = {
"kitaplik.middlewares.TekProxyMiddleware": 610,
}به کمک setdefault مقدار meta["proxy"] که دستی در یک درخواست نوشتهاید حفظ میشود. اگر PROXY_ADRESI تعریف نشده باشد، میانافزار خودش را غیرفعال میکند و اسپایدر بدون پروکسی کار میکند. شماره ترتیب باید کوچکتر از 750 باشد؛ به این ترتیب آدرس را اول شما مینویسید و اطلاعات ورود را پس از آن HttpProxyMiddleware جدا میکند. در نمونههایی که برای نسخههای قدیمی نوشته شدهاند امضا را به شکل process_request(self, request, spider) میبینید؛ در مستندات فعلی پارامتر spider وجود ندارد و نمونه به همین شکل در Scrapy 2.19 کار میکند.
احراز هویت چطور کار میکند؟
HttpProxyMiddleware بخش user:pass را از آدرس جدا میکند، با Base64 کدگذاری میکند و به شکل سرآیند Proxy-Authorization: Basic … به درخواست میافزاید. در meta["proxy"] آدرس بدون اطلاعات ورود باقی میماند و رمز عبورتان را در لاگ نمیبینید. اگر در رمز عبور @، : یا / هست، آن را با کدگذاری درصدی بنویسید (%40 بهجای @)؛ میانافزار مقدار را پیش از فرستادن رمزگشایی میکند.
در آزمایشی که با رمز عبور نادرست انجام دادیم Scrapy این خط را نوشت:
TunnelError: Could not open CONNECT tunnel with proxy 127.0.0.1:8120 [{'status': 407, 'reason': b'Proxy Authentication Required'}]در آدرسهای HTTPS کد 407 نه به شکل پاسخ، بلکه به شکل استثنا میرسد، چون تونل ساخته نشده است. نکتهای که باید به آن توجه کرد: میانافزار تلاش مجدد این استثنا را خطای موقت به حساب میآورد و همان درخواست را دو بار دیگر امتحان میکند. رمز عبور نادرست با تکرار درست نمیشود؛ اگر در لاگ TunnelError و 407 میبینید، خزش را متوقف کنید و اطلاعات ورود را اصلاح کنید. اگر بهجای نام کاربری و رمز عبور از لیست سفید IP استفاده میکنید، آدرس بدون اطلاعات ورود و به شکل http://pr.proxynet.io:8000 نوشته میشود. تفاوت این دو روش در احراز هویت پروکسی: نام کاربری و رمز یا لیست سفید IP آمده است.
آیا چرخش به میانافزار نیاز دارد؟
پاسخ به نوع پروکسی شما بستگی دارد.
اگر از گیتوی چرخشی استفاده میکنید، نیاز ندارد. در سرویس پروکسی چرخشی به یک نقطه اتصال وصل میشوید و IP خروجی را گیتوی عوض میکند. در سمت Scrapy همان TekProxyMiddleware بالا یا یک متغیر محیطی کافی است؛ نگهداشتن فهرست، انتخاب آدرس بعدی و کنار گذاشتن آدرس خراب کار شما نیست. در خزشهایی که با پروکسی مسکونی انجام میشود راهاندازی معمول همین است. شیوه کار حالتهای چرخش را در نوشته چرخش IP توضیح دادهایم.
اگر فهرستی از آدرسهای ثابت دارید (برای نمونه چند آدرس پروکسی دیتاسنتر یا پروکسی ISP)، توزیع را یک میانافزار انجام میدهد. نمونه زیر آدرسها را بهنوبت به کار میبرد، آدرسی را که پشت سر هم خطا میدهد مدتی کنار میگذارد و شمارشها را در آمار Scrapy مینویسد:
# kitaplik/middlewares.py
import time
from urllib.parse import urlsplit

from scrapy.exceptions import IgnoreRequest, NotConfigured


def anahtar(proxy_adresi):
    parca = urlsplit(proxy_adresi)
    return f"{parca.hostname}:{parca.port}"


class ProxyHavuzuMiddleware:
    """Assigns the next proxy in the list to each request and rests one that keeps failing."""

    def __init__(self, adresler, hata_siniri, dinlenme, stats):
        self.adresler = adresler
        self.hata_siniri = hata_siniri
        self.dinlenme = dinlenme
        self.stats = stats
        self.sira = 0
        self.hatalar = {anahtar(a): 0 for a in adresler}
        self.kapali = {}  # key -> the moment it reopens

    @classmethod
    def from_crawler(cls, crawler):
        adresler = crawler.settings.getlist("PROXY_LISTESI")
        if not adresler:
            raise NotConfigured
        return cls(
            adresler,
            crawler.settings.getint("PROXY_HATA_SINIRI", 3),
            crawler.settings.getfloat("PROXY_DINLENME", 60.0),
            crawler.stats,
        )

    def sec(self):
        simdi = time.monotonic()
        for _ in self.adresler:
            adres = self.adresler[self.sira % len(self.adresler)]
            self.sira += 1
            if self.kapali.get(anahtar(adres), 0) <= simdi:
                return adres
        return None

    def process_request(self, request):
        adres = self.sec()
        if adres is None:
            self.stats.inc_value("proxy_havuzu/hepsi_dinleniyor")
            raise IgnoreRequest("Every proxy in the list is resting")
        request.meta["proxy"] = adres
        request.meta["proxy_anahtari"] = anahtar(adres)
        return None

    def process_response(self, request, response):
        kim = request.meta.get("proxy_anahtari")
        if kim:
            self.hatalar[kim] = 0
            self.stats.inc_value(f"proxy_havuzu/yanit/{kim}")
        return response

    def process_exception(self, request, exception):
        kim = request.meta.get("proxy_anahtari")
        if not kim:
            return None
        self.hatalar[kim] += 1
        self.stats.inc_value(f"proxy_havuzu/hata/{kim}")
        if self.hatalar[kim] >= self.hata_siniri:
            self.kapali[kim] = time.monotonic() + self.dinlenme
            self.hatalar[kim] = 0
return None# kitaplik/settings.py
PROXY_LISTESI = [
"http://user:pass@203.0.113.10:8000",
"http://user:pass@203.0.113.11:8000",
"http://user:pass@203.0.113.12:8000",
]
DOWNLOADER_MIDDLEWARES = {
"kitaplik.middlewares.ProxyHavuzuMiddleware": 610,
}نمونه را با سه پروکسی محلی آزمودیم که دو تا روشن و یکی خاموش بود. هر صد رکورد کامل رسید؛ درخواستها به نسبت 6 و 5 میان دو آدرس سالم پخش شد، آدرس خاموش پس از سه خطای اتصال از مدار خارج شد و Scrapy درخواستهای ناموفق را از آدرسهای دیگر دوباره امتحان کرد.
شماره ترتیب در اینجا دلبخواهی نیست. در نخستین آزمایش میانافزار را روی 350 گذاشتیم و شمارنده خطا هیچوقت کار نکرد: استثناها زنجیره را به ترتیب وارونه طی میکنند و وقتی میانافزار تلاش مجدد در شماره 550 استثنا را میگیرد و درخواست تازهای برمیگرداند، میانافزارهای با شماره کوچکتر باخبر نمیشوند. مقداری میان 550 و 750 (در نمونه 610) هر دو شرط را برآورده میکند: خطا را پیش از تلاش مجدد شما میبینید و اطلاعات ورود را پس از شما HttpProxyMiddleware پردازش میکند. راه انجام همین کار بهصورت دستی با Requests در چرخاندن پروکسی در Python آمده است.
DOWNLOAD_DELAY و AutoThrottle چطور تنظیم میشوند؟
پروکسی جای خروج درخواست را عوض میکند؛ باری را که روی سرور مقصد میافتد عوض نمیکند. تنظیمهایی که بار را تعیین میکنند اینها هستند:
# kitaplik/settings.py
USER_AGENT = "kitaplik-bot/1.0 (+https://ornek.com/bot)"
ROBOTSTXT_OBEY = True

CONCURRENT_REQUESTS = 8
CONCURRENT_REQUESTS_PER_DOMAIN = 2
DOWNLOAD_DELAY = 1
DOWNLOAD_TIMEOUT = 30

AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 2
AUTOTHROTTLE_MAX_DELAY = 30
AUTOTHROTTLE_TARGET_CONCURRENCY = 1.0
AUTOTHROTTLE_DEBUG = False

RETRY_ENABLED = True
RETRY_TIMES = 2
RETRY_HTTP_CODES = [429, 500, 502, 503, 504, 408]CONCURRENT_REQUESTS_PER_DOMAINتعداد درخواستهایی است که میتوانند همزمان به یک دامنه باز باشند. پیشفرض چارچوب 8 است و قالب پروژه آن را به 1 میرساند. اینکه همروندی چیست در همروندی و موازیسازی توضیح داده شده است.DOWNLOAD_DELAYفاصله انتظار میان دو درخواست به یک دامنه است (بر حسب ثانیه). Scrapy بهطور پیشفرض نوسانی تصادفی به این مقدار میافزاید و درخواستها مثل ساعت با فاصله برابر نمیروند.- AutoThrottle انتظار را با زمان پاسخ سرور تنظیم میکند. بر پایه الگوریتم مستندات، انتظار هدف برابر است با تأخیر پاسخ تقسیم بر
AUTOTHROTTLE_TARGET_CONCURRENCYو انتظار تازه میانگین انتظار پیشین و این هدف است. پاسخهای غیر از200نمیتوانند انتظار را کم کنند. انتظار هیچگاه ازDOWNLOAD_DELAYپایینتر و ازAUTOTHROTTLE_MAX_DELAYبالاتر نمیرود. DOWNLOAD_TIMEOUTبهطور پیشفرض 180 ثانیه است. هنگام کار از راه پروکسی آن را کوتاه کنید تا اتصالی که پاسخ نمیدهد سه دقیقه معلق نماند.
با AUTOTHROTTLE_DEBUG = True برای هر پاسخ یک خط میبینید. در آزمایش ما انتظار از 2000 میلیثانیه شروع شد، با پاسخ 145 میلیثانیهای سرور به 1072 میلیثانیه و سپس به 1000 میلیثانیه رسید که کف تعیینشده با DOWNLOAD_DELAY است و همانجا ماند:
slot: books.toscrape.com | conc: 1 | delay: 2000 ms (+0)   | latency: 446 ms
slot: books.toscrape.com | conc: 1 | delay: 1072 ms (-927) | latency: 145 ms
slot: books.toscrape.com | conc: 1 | delay: 1000 ms (-72)  | latency: 144 ms
وقتی ROBOTSTXT_OBEY روشن است، Scrapy برای هر دامنه ابتدا فایل /robots.txt را دانلود میکند و آدرسهای غیرمجاز را بدون درخواست کنار میگذارد. شیوه خواندن این فایل در فایل robots.txt چیست و چگونه آن را بخوانیم؟ و چارچوب حقوقی خزش در آیا اسکرپینگ وب قانونی است؟ آمده است. نوشتن نشانیای در USER_AGENT که بتوان از راه آن با شما تماس گرفت باعث میشود مدیر سایت هنگام دیدن مشکل بهجای مسدود کردن، به شما پیام بدهد.
Scrapy در برابر پاسخهای 429 و 503 چه میکند؟
میانافزار تلاش مجدد بهطور پیشفرض کدهای 500، 502، 503، 504، 522، 524، 408 و 429 و نیز خطاهای اتصال را دوباره امتحان میکند؛ RETRY_TIMES = 2 یعنی همراه با درخواست نخست در مجموع سه تلاش. درخواستی که دوباره امتحان میشود با اولویت پایینتر به صف برمیگردد.
دو محدودیت را باید بدانید. تلاش مجدد Scrapy سرآیند Retry-After را نمیخواند و میان تلاشها انتظار نمایی اعمال نمیکند؛ فاصله را همچنان DOWNLOAD_DELAY و AutoThrottle تعیین میکنند. چون AutoThrottle در پاسخهای غیر از 200 انتظار را کم نمیکند، در موج 429 سرعت خودبهخود بالا نمیرود، اما ممکن است بهطور خودکار به اندازه کافی هم پایین نیاید. اگر سهم 429 در لاگ رو به افزایش است، واکنش درست پایین آوردن CONCURRENT_REQUESTS_PER_DOMAIN و بزرگ کردن DOWNLOAD_DELAY است. تلاش برای گذشتن از سقف درخواست با IP بیشتر مشکل را حل نمیکند و بار روی سایت را بیشتر میکند. معنای کدها و انتظار درست با Retry-After در کدهای وضعیت HTTP در وب اسکرپینگ و منطق سقف درخواست در سمت سایت در نوشته 429 Too Many Requests آمده است.
آیا در Scrapy میتوان از پروکسی SOCKS5 استفاده کرد؟
با دانلودر پیشفرض نه. در آزمایشی که آدرس socks5:// را در meta["proxy"] نوشتیم، درخواست بدون دریافت هیچ پاسخی تا پایان مهلت زمانی منتظر ماند. اما دانلودر دوم Scrapy که بر پایه httpx است، یعنی HttpxDownloadHandler، از نسخه 2.17 از SOCKS5 پشتیبانی میکند. برای راهاندازی دستور pip install "scrapy[httpx]" را اجرا کنید و این را به تنظیمات بیفزایید:
DOWNLOAD_HANDLERS = {
    "http": "scrapy.core.downloader.handlers._httpx.HttpxDownloadHandler",
    "https": "scrapy.core.downloader.handlers._httpx.HttpxDownloadHandler",
}
با این تنظیم آدرس socks5://user:pass@… در آزمایش ما همراه با احراز هویت کار کرد. مستندات Scrapy این دانلودر را آزمایشی علامت زده و هنوز آن را برای محیط عملیاتی توصیه نمیکند؛ همچنین یادآوری میکند که برای هر آدرس پروکسی یک مخزن اتصال جدا باز میکند. اگر ناچار نیستید، با پروکسی HTTP بمانید. تفاوت پروتکلها در تفاوت پروکسی SOCKS و HTTP آمده است.
با صفحههایی که با JavaScript بارگذاری میشوند چه باید کرد؟
Scrapy کد HTML صفحه را دانلود میکند و JavaScript اجرا نمیکند. اگر داده بعداً در مرورگر بارگذاری میشود، اول به نقطه اتصال JSON که صفحه در پسزمینه فراخوانی میکند نگاه کنید؛ بیشتر وقتها میتوان همان آدرس را مستقیم با Scrapy درخواست کرد. اگر این کار شدنی نیست، افزونه scrapy-playwright درخواستهای انتخابی شما را در یک مرورگر واقعی باز میکند. توجه کنید: در این افزونه پروکسی نه با meta["proxy"]، بلکه با گزینههای راهاندازی مرورگر یا زمینه (context) داده میشود. جزئیات در نوشته Playwright با پروکسی و راه تشخیص نوع صفحهها در صفحههای ایستا و پویا آمده است.
Scrapy، BeautifulSoup یا Selenium؟
این سه، بخشهای متفاوت یک کارند و برای همین مقایسه بیشتر وقتها نادرست چیده میشود.
| Scrapy | Requests + BeautifulSoup | Selenium | |
|---|---|---|---|
| چیست | چارچوب خزش | کلاینت HTTP + تجزیهگر HTML | خودکارسازی مرورگر |
| صف درخواست و همروندی | آماده | خودتان مینویسید | خودتان مینویسید |
| تلاش مجدد، محدودیت سرعت، robots.txt | با تنظیم روشن میشود | خودتان مینویسید | خودتان مینویسید |
| اجرای JavaScript | ندارد (با افزونه) | ندارد | دارد |
| تعریف پروکسی | meta["proxy"] یا میانافزار | پارامتر proxies= | گزینه راهاندازی مرورگر |
| دشواری آموختن | متوسط | کم | متوسط |
| کار مناسب | خزش چندصفحهای و تکرارشونده | یکباره، چند صفحه | ورود، کلیک، محتوای پویا |
BeautifulSoup فقط یک تجزیهگر است و درون Scrapy هم میتوان از آن استفاده کرد. Selenium برای هر صفحه یک مرورگر کامل باز میکند و به همین دلیل روی همان سختافزار صفحههای بسیار کمتری پردازش میکند؛ تنها در گامهایی که واقعاً به مرورگر نیاز دارند منطقی است. راهاندازی پروکسی در Selenium در Selenium با پروکسی و مقایسه دو ابزار مرورگر در نوشته Playwright و Selenium آمده است.
کاربردها
- پایش قیمت و موجودی: همان فهرست محصول هر روز خزش میشود؛ ساختار Scrapy که با اجرای زمانبندیشده سازگار است به این کار میخورد. طرح کلی در صفحه پایش قیمت و یک نمونه اجراشدنی در نوشته پایش قیمت رقبا در فروشگاههای اینترنتی آمده است.
- خزش درونسایتی و ساخت نمایه: کلاس
CrawlSpiderکه با دنبال کردن پیوندها همه صفحهها را میپیماید، نقطه شروع آمادهای برای کارهای خزنده وب است. - گردآوری کاتالوگ از چند سایت: برای هر سایت یک اسپایدر جدا، با pipeline مشترک و تنظیم پروکسی مشترک. معماری کلی در صفحه استخراج داده آمده است.
- فهرستهای صفحهبندیشده: الگوهای پیوند «بعدی»، شماره صفحه و مکاننما (cursor) در نوشته صفحهبندی در وب اسکرپینگ آمده است.
خطاهای رایج
- نوشتن پروکسی فقط در درخواست اول.
metaبه درخواستهای بعدی منتقل نمیشود؛ خزش از صفحه دوم به بعد از آدرس IP خودتان ادامه مییابد و در لاگ متوجه آن نمیشوید. - انتخاب تصادفی شماره ترتیب میانافزار. با شماره بزرگتر از 750 اطلاعات ورود جدا نمیشود و درخواست با خطای
invalid hostnameشکست میخورد؛ با شماره کوچکتر از 550 خطاهای اتصال را نمیبینید. - پاک کردن خطهای
ROBOTSTXT_OBEY،DOWNLOAD_DELAYو همروندی از قالب. پیشفرضهای خام چارچوب (robots.txt خاموش، بدون انتظار، 8 درخواست برای هر دامنه) آنقدر سریعاند که به یک سایت کوچک فشار میآورند. - ادامه دادن خزش هنگام دریافت
407. هر درخواست سه بار امتحان میشود و هیچکدام موفق نمیشود؛ اول اطلاعات ورود را اصلاح کنید. - گذاشتن میانافزار چرخش روی گیتوی چرخشی. گیتوی این کار را انجام میدهد؛ لایه دوم فقط اشکالزدایی را دشوار میکند.
- رها کردن
DOWNLOAD_TIMEOUTروی پیشفرض. یک اتصال بیپاسخ یک جایگاه را سه دقیقه مشغول نگه میدارد. - نوشتن رمز عبور در
settings.pyو فرستادن آن به مخزن کد. آدرس را از متغیر محیطی بخوانید.
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
| کار یکباره با چند صفحه | Requests + BeautifulSoup کافی است و Scrapy لازم نیست |
| هزاران صفحه با تکرار منظم | پروژه Scrapy با حفظ تنظیمات قالب |
| عبور همه ترافیک از پروکسی | TekProxyMiddleware یا متغیر محیطی https_proxy |
| رفتن فقط برخی درخواستها از خروجی دیگر | meta["proxy"] در همان درخواستها |
| پخش بار روی تعداد زیادی IP | گیتوی چرخشی، یک آدرس، بدون میانافزار |
| فهرست ثابتی از پروکسی دارید | ProxyHavuzuMiddleware با شماره ترتیب میان 550 و 750 |
| همان IP در طول نشست | پروکسی با نشست ثابت و یک آدرس |
429 در لاگ رو به افزایش است | همروندی را کم کنید، DOWNLOAD_DELAY را بزرگ کنید، AutoThrottle را روشن کنید |
| SOCKS5 الزامی است | HttpxDownloadHandler (آزمایشی) |
| داده با JavaScript میآید | اول نقطه اتصال JSON، در غیر این صورت scrapy-playwright |
پرسشهای متداول
اسپایدر در Scrapy چیست؟
اسپایدر یک کلاس Python است که از scrapy.Spider مشتق میشود و دو چیز را تعریف میکند: خزش از کدام آدرسها شروع شود و از پاسخ دریافتی کدام داده و کدام پیوندهای تازه استخراج شود. صف، دانلود و مدیریت خطا کار چارچوب است، نه اسپایدر.
آیا برای استفاده از Scrapy باید Python بلد بود؟
بله. اسپایدر یک کلاس Python است و با انتخابگرها، حلقهها و دیکشنریها کار میکنید. کسی که Python پایه میداند میتواند نخستین اسپایدر خود را بنویسد؛ برای بخش میانافزار و pipeline باید با ساختار کلاس آشنا باشید.
از کجا بفهمم پروکسی واقعاً استفاده میشود؟
با Scrapy به سرویسی که آدرس IP شما را به شکل JSON برمیگرداند درخواست بفرستید و آدرس درون پاسخ را با IP خودتان مقایسه کنید. نوشتن مقدار response.meta.get("proxy") در لاگ درون parse هم نشان میدهد کدام درخواست از کدام پروکسی رفته است. روشهای کلی در آیا پروکسی کار میکند؟ چگونه پروکسی را آزمایش کنیم آمده است.
Scrapy سریعتر است یا Selenium؟
روی همان سختافزار Scrapy بهروشنی صفحههای بیشتری پردازش میکند، چون مرورگر باز نمیکند و درخواستها را ناهمگام میفرستد. سرعت فقط وقتی معنا دارد که صفحه به JavaScript نیاز نداشته باشد؛ اگر داده در مرورگر ساخته میشود، Scrapy بهتنهایی آن داده را نمیبیند.
آیا با روشن بودن AutoThrottle دیگر DOWNLOAD_DELAY لازم نیست؟
لازم است، چون کف را همین مقدار تعیین میکند. AutoThrottle هیچگاه انتظار را از DOWNLOAD_DELAY پایینتر نمیبرد. در سروری که سریع پاسخ میدهد انتظار تا این کف پایین میآید و همانجا میماند؛ برای همین تکیه بر AutoThrottle با DOWNLOAD_DELAY = 0 یعنی فرستادن درخواست تقریباً بدون انتظار به سرورهای سریع.
آیا استفاده از IP متفاوت در هر درخواست جلوی مسدود شدن را میگیرد؟
بهتنهایی نه. سایتها سرعت را فقط بر پایه IP نمیشمارند، بلکه نشست، کوکی و رفتار را هم در نظر میگیرند. چرخش بار را روی خروجیهای زیاد پخش میکند و در کنار پیروی از robots.txt، همروندی پایین و یک User-Agent صادق معنا پیدا میکند. روشهای مشروع را در وب اسکرپینگ بدون مسدود شدن گرد آوردهایم.
خلاصه
در Scrapy پروکسی همان فیلد meta["proxy"] درخواست است و میتوانید آن را از سه راه پر کنید: دستی برای هر درخواست، با متغیر محیطی یا با یک میانافزار دانلودر. برای اینکه همه ترافیک، از جمله robots.txt، از یک خروجی برود یکی از دو راه آخر لازم است. اگر از گیتوی چرخشی استفاده میکنید یک آدرس کافی است؛ اگر فهرست ثابتی دارید، میانافزاری با شماره میان 550 و 750 توزیع و شمارش خطا را بر عهده میگیرد. سرعت را نه پروکسی، بلکه DOWNLOAD_DELAY، همروندی برای هر دامنه و AutoThrottle تعیین میکنند؛ تنظیمهای محتاطانه قالب را نگه دارید. انواع پروکسی مناسب کارهای خزش خود را میتوانید در سرویسهای پروکسی ما پیدا کنید.


