صبح دوشنبه گزارش فروش را باز میکنید: سفارش سه محصول پرفروش شما در آخر هفته نصف شده است. علت را بعدازظهر پیدا میکنید، وقتی دستی به صفحه رقیب سر میزنید. او جمعهشب قیمت را پایین آورده و شما دو روز گرانتر ماندهاید. رصد قیمت رقبا همین مشکل را حل میکند: از تغییر، بهواسطه خود تغییر باخبر میشوید، نه بهواسطه فروشی که از دست رفته است.
در این نوشته کار را از ابتدا تا انتها میچینیم. نخست مقایسه میکنیم داده از کجا میتواند بیاید (API فروشنده، ابزار آماده، اسکریپت خودتان)؛ سپس به تطبیق محصول، اینکه کدام قیمت ثبت شود و شیوه محاسبه فاصله خواندن میپردازیم. برای توسعهدهندگان نمونهای آزموده در پایتون آمده که قیمت را از صفحه میخواند، تاریخچه را در SQLite نگه میدهد و با گذشتن از آستانه هشدار میدهد. در پایان مرزهای کار آمده است: شرایط استفاده سایت، robots.txt و حقوق رقابت.
رصد قیمت رقبا از چه گامهایی تشکیل میشود؟
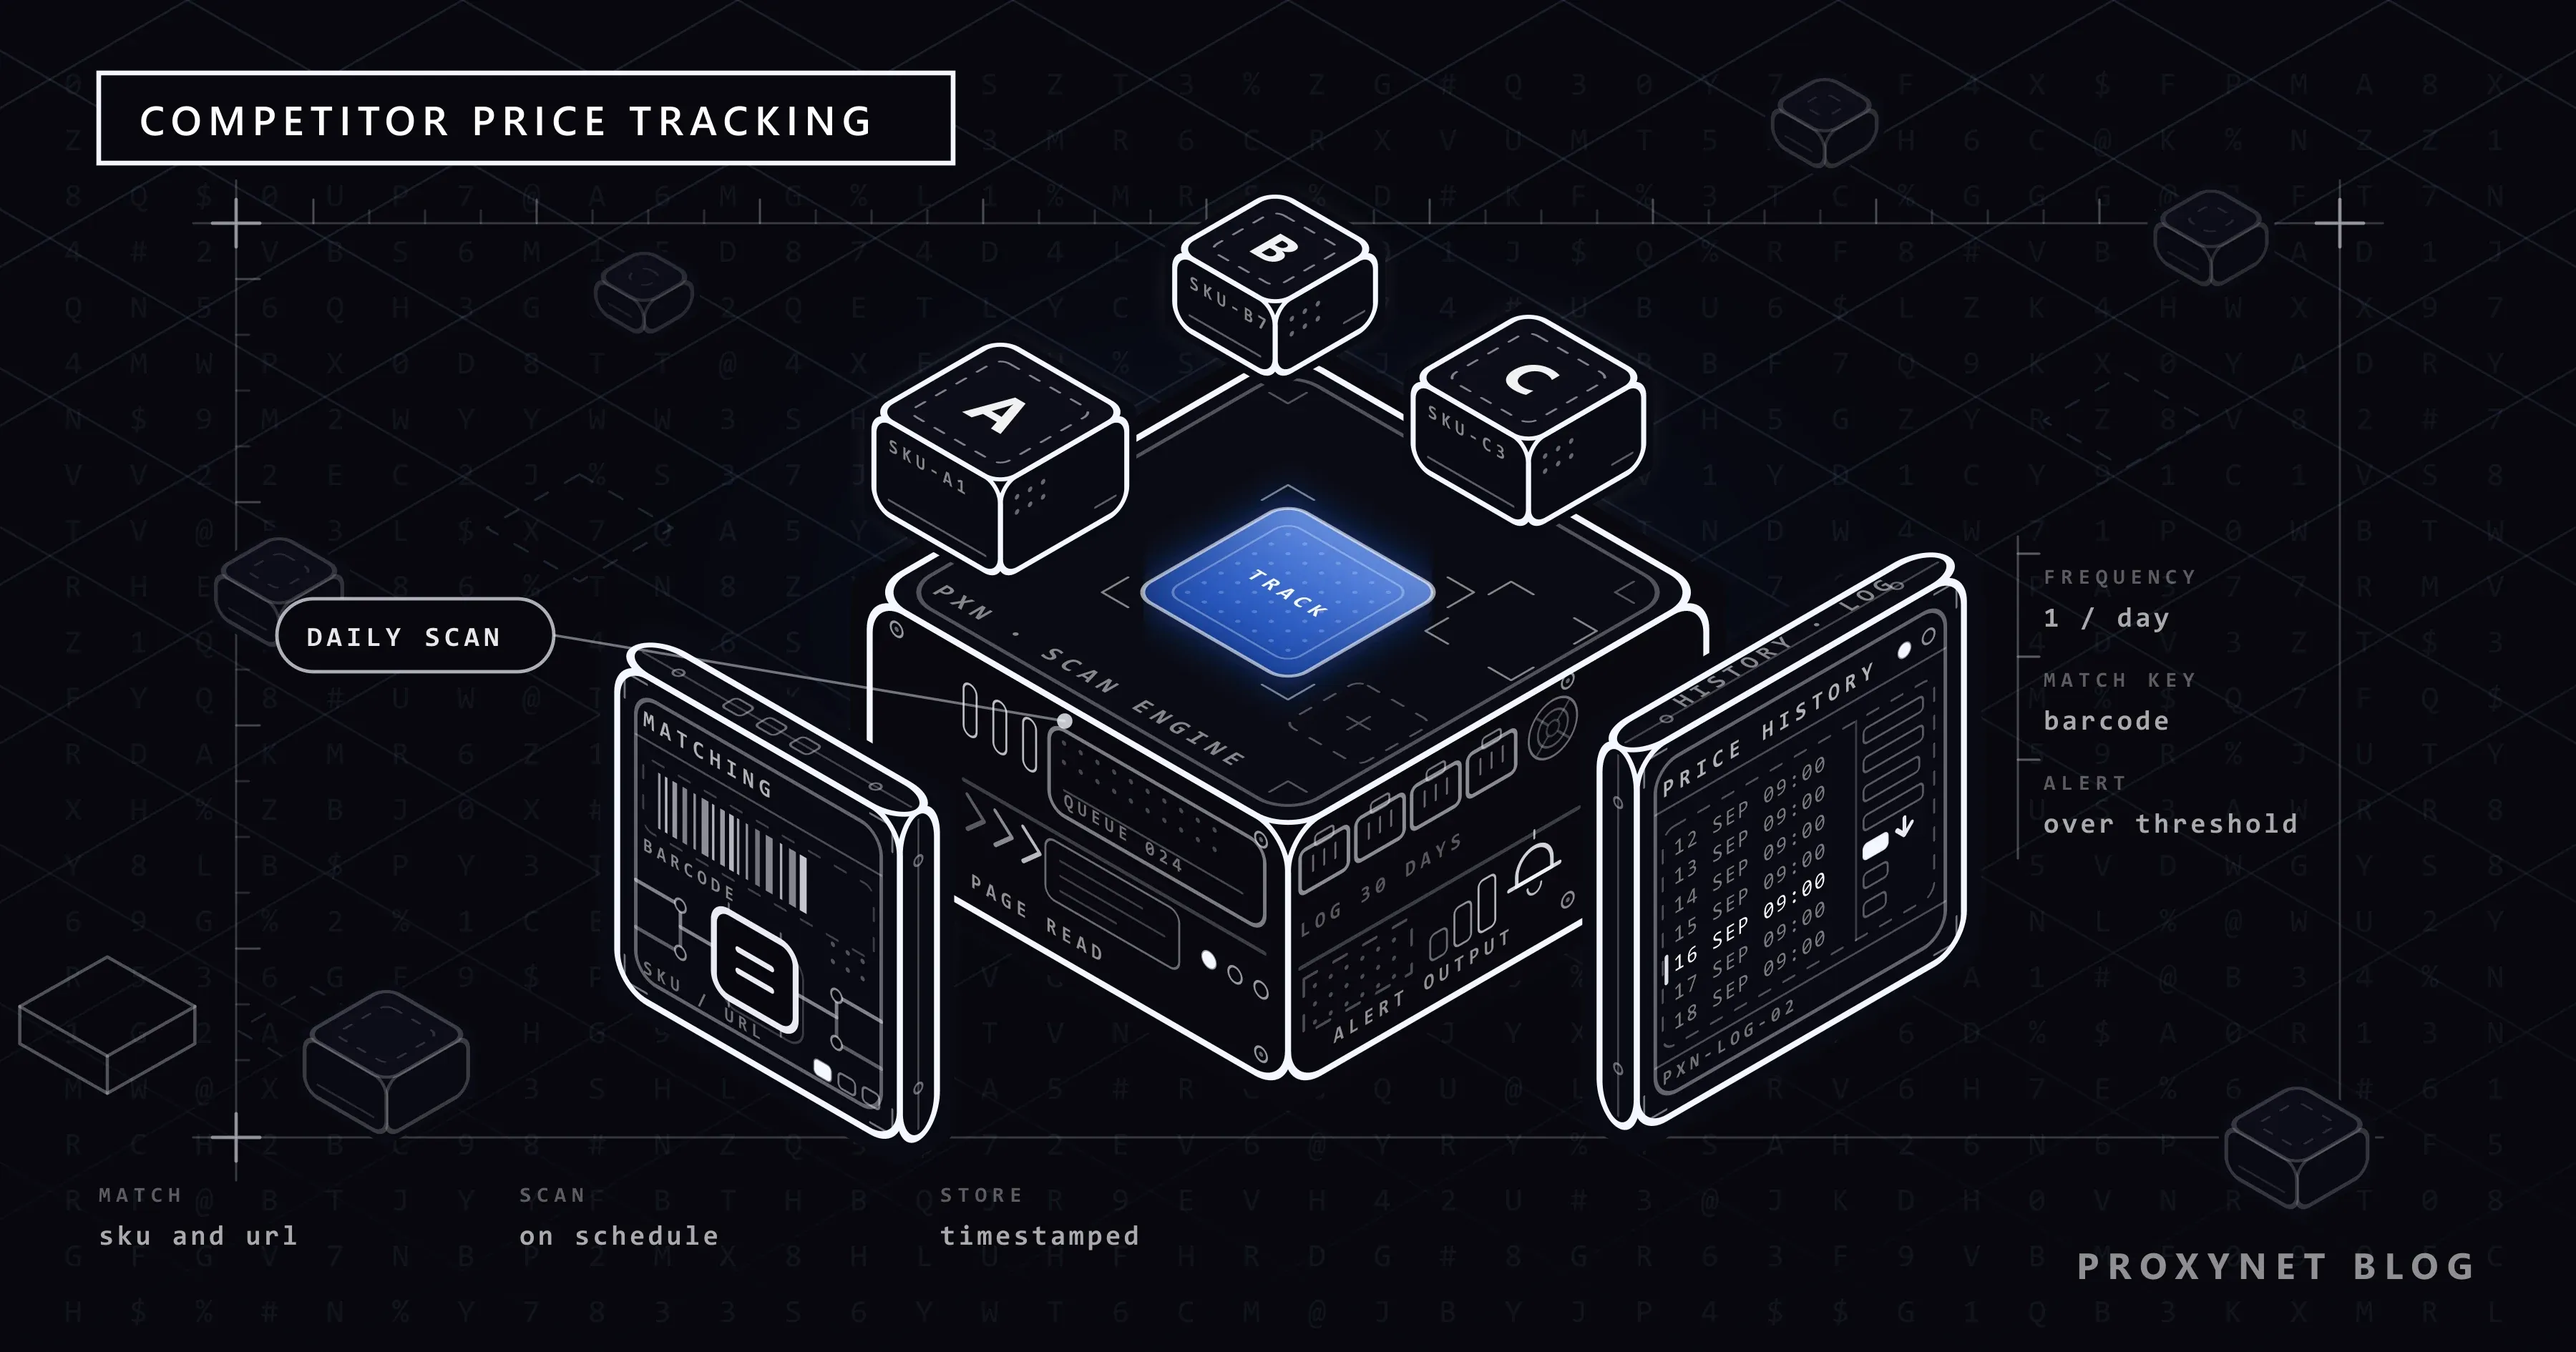
رصد قیمت یعنی خواندن و ثبت منظم اطلاعات قیمت و موجودی در صفحههای محصول رقبا. جزئیات تعریف و بخش زیرساخت در صفحه راهکار رصد قیمت آمده است؛ اینجا به شیوه راهاندازی کار میپردازیم. ابزار شما هر چه باشد، جریان کار یکی است:
- دامنه را انتخاب کنید. نه کل کاتالوگ، بلکه محصولاتی را دنبال کنید که بار درآمد را میکشند و به قیمت حساساند.
- محصولات را تطبیق دهید. کنار هر کد کالای خودتان (SKU) نشانی همان محصول نزد رقیب را بنویسید.
- صفحهها را در فاصلههای منظم بخوانید. قیمت، واحد پول، وضعیت موجودی و در صورت وجود نام فروشنده برداشته میشود.
- هر خواندن را با تاریخش نگه دهید. جدولی که فقط آخرین قیمت را دارد نمیتواند به پرسش «چه زمانی تغییر کرد» پاسخ دهد.
- تغییر را با آستانه بسنجید و خبر دهید. اگر برای هر نوسان ناچیز ایمیل بیاید، پس از سه روز کسی هشدارها را نمیخواند.
- تصمیم را به انسان بسپارید. هشدار یک پیشنهاد است. اینکه چه کسی و با چه قاعدهای قیمت را تغییر دهد، تصمیم کسبوکاری جداگانهای است.
داده از کجا میآید: API فروشنده، ابزار آماده یا اسکریپت خودتان؟
نخست مسیر رسمی را ببینید. مارکتپلیسها برای فروشندگان خود API فراهم میکنند تا داده محصول، موجودی و قیمت خودشان را مدیریت کنند. برای نمونه Selling Partner API آمازون فهرست کالا، قیمتگذاری، سفارش و موجودی را پوشش میدهد. این APIها برای فروشگاه خود شما ساخته شدهاند و آنچه درباره رقبا میگویند محدود است. Product Pricing API آمازون برای محصولات موجود در کاتالوگ آمازون داده قیمت رقابتی، مانند پیشنهاد برجسته (Featured Offer)، برمیگرداند. درباره فروشگاه اینترنتی خود رقیب، مارکتپلیس دیگر یا محصولی که شما عرضه نمیکنید چیزی نشان نمیدهد. با این حال ستون چپ مقایسه، یعنی قیمت فعلی خود شما، باید از همینجا خوانده شود، نه از جدولی که دستی نگهداری میشود.
گزینههای سمت رقیب کنار هم چنیناند:
| روش | چه میدهد | زحمت | چه زمانی مناسب است |
|---|---|---|---|
| API فروشنده | داده قیمت، موجودی و سفارش خودتان؛ در برخی مارکتپلیسها قیمت پیشنهاد برجسته برای محصولی که میفروشید | یک بار یکپارچهسازی | همیشه، برای سمت خودتان در مقایسه |
| بررسی دستی و جدول | قیمت لحظهای تعداد کمی محصول | کار انسانی که هر روز تکرار میشود | 20 تا 30 محصول، نگاه هفتگی |
| ابزار آماده رصد قیمت | تطبیق، خزش و صفحه گزارش | اشتراک ماهانه، راهاندازی اندک | تیم نرمافزار ندارید و مارکتپلیسهای رایج کافیاند |
| اسکریپت خودتان | هر سایت، هر فیلد و هر فاصلهای که بخواهید | توسعه و نگهداری | سایتهای خاص، جریان داده به انبار داده خودتان، قواعد هشدار انعطافپذیر |
| جریان کار در ابزار اتوماسیون | همان اسکریپت، بدون کد | متوسط | فهرست کوچک، اتصالهای آماده به جدول و اعلان |
نمونهای از سطر آخر را در نوشته وب اسکرپینگ با n8n ساختهایم. راههای گرفتن جدول از یک صفحه بدون نوشتن کد را هم گامبهگام در استخراج داده از وبسایت توضیح دادهایم.
تطبیق محصول چگونه انجام میشود؟
محصولی که اشتباه تطبیق داده شده از محصولی که اصلاً رصد نمیشود زیانبارتر است: هشداری که قیمت مدل 64 GB را با مدل 128 GB مقایسه کند شما را به تخفیفی بیدلیل میکشاند. ترتیب اطمینان در تطبیق چنین است:
- بارکد (GTIN یا EAN). اگر در دو صفحه بارکد یکسان باشد، محصول یکی است. در داده ساختیافته در فیلد
gtin13یاgtinو گاهی در جدول مشخصات محصول دیده میشود. - شماره قطعه سازنده (MPN) و برند. در کالاهای الکترونیکی و قطعات یدکی بیشتر از بارکد به چشم میخورد.
- مقایسه عنوان و مشخصات. اگر بارکد نبود، برند، مدل، ظرفیت، رنگ و تعداد جداگانه مقایسه میشوند.
در محصولات دارای گونه (اندازه، رنگ، ظرفیت) هر گونه یک سطر جداست و در بیشتر سایتها نشانی یا پارامتر نشانی جداگانه دارد. در بستههای چندتایی (سهتایی، ششتایی) پیش از تبدیل قیمت به قیمت واحد مقایسه نکنید. در مارکتپلیسها یک صفحه محصول میتواند چند فروشنده داشته باشد؛ «رقیب» خود صفحه نیست، بلکه فروشندهای مشخص در آن صفحه است.
برای جدول تطبیق ستونهای sku، competitor، url، match type و last checked کافی است. سطرهایی را که دستی تطبیق دادهاید هر چند وقت یک بار دوباره مرور کنید: رقیب ممکن است محصول را بردارد و مدل تازه را در همان نشانی بگذارد.
کدام قیمت را باید ثبت کنید؟
در یک صفحه محصول فقط یک قیمت وجود ندارد. اگر از آغاز روشن نکنید چه چیزی را ثبت میکنید، جدول تاریخچه شما سیب و گلابی را کنار هم میچیند.
- قیمت فهرست و قیمت با تخفیف. این دو را در ستونهای جدا نگه دهید. آنچه مشتری میپردازد قیمت با تخفیف است.
- قیمتی که در سبد خرید یا با کوپن پایین میآید. ممکن است در صفحه محصول دیده نشود. اگر در صفحه در دسترس عموم نوشته نشده، آن را بیرون از دامنه رصد بگذارید؛ گشتوگذار خودکار با حساب واردشده موضوع این نوشته نیست.
- هزینه ارسال. آستانه ارسال رایگان در محصولات ارزان تفاوت واقعی را تعیین میکند.
- واحد پول. برای رقبای خارجی واحد پول را همراه قیمت ثبت کنید و تبدیل را به مرحله گزارش بسپارید.
- وضعیت موجودی. قیمت رقیبی که کالا ندارد شما را به چیزی ملزم نمیکند.
فاصله خواندن چگونه تعیین میشود؟
فاصله را کنجکاوی تعیین نمیکند، دو پرسش تعیین میکند: قیمت در این دسته با چه سرعتی تغییر میکند و شما با چه سرعتی میتوانید واکنش نشان دهید؟ برای تیمی که هفتهای یک بار قیمتها را بهروز میکند، خواندن ساعتی برای سرور رقیب بار و برای شما دادهای میسازد که کسی نمیخواند.
| دسته محصول | شروع معقول | دلیل |
|---|---|---|
| پرفروشها در دوره کمپین | چند بار در روز | قیمت ممکن است در طول روز تغییر کند و زمان واکنش کوتاه است |
| محصولات اصلی با فروش منظم | روزی یک بار | بیشتر تصمیمهای قیمت روزانه گرفته میشوند |
| دنباله بلند، محصولات کمگردش | هفتهای یک بار | تغییر کم است و نیاز به واکنش اندک |
| محصولاتی که رقیب موجود ندارد | روزی یک بار، فقط برای موجودی | بازگشت موجودی به اندازه قیمت اطلاعات ارزشمندی است |
تعداد درخواست را با یک ضرب ساده حساب کنید: تعداد محصول × تعداد خواندن در روز. خواندن 500 محصول چهار بار در روز میشود 2000 درخواست. اگر میان درخواستها دو ثانیه صبر کنید، یک دور حدود 17 دقیقه طول میکشد و این برای یک سایت آهنگی آرام است. وقتی همین حساب را برای 50000 محصول و خواندن ساعتی انجام دهید، صف، محدودیت نرخ و پخش کردن بار میان چند IP وارد ماجرا میشوند. راههای رعایت محدودیت نرخ را در وب اسکرپینگ بدون مسدود شدن و معنای «آهستهتر» گفتن سرور را در نوشته 429 Too Many Requests آوردهایم.
قیمت در کجای صفحه قرار دارد؟
به سمت توسعهدهنده میرویم. خواندن قیمت از همان جایی که روی صفحه میبینید، یعنی از متن درون یک کلاس CSS، شکنندهترین راه است: طراحی عوض میشود، نام کلاس عوض میشود و اسکریپت بیصدا از کار میافتد. بیشتر فروشگاهها همین اطلاعات را یک بار دیگر و به شکل ساختیافته برای موتورهای جستوجو در صفحه میگذارند. این داده درون تگ <script type="application/ld+json"> قرار دارد و فیلدهای price، priceCurrency و availability از نوع Offer در schema.org را دارد. مستند گوگل درباره داده ساختیافته فهرست فروشندگان فیلدهای price و priceCurrency را الزامی میداند؛ فروشگاهی که میخواهد با قیمتش در جستوجو دیده شود این داده را بهروز نگه میدهد.
از همین رو ترتیب خواندن باید چنین باشد:
- اگر صفحه داده JSON-LD از نوع
Productدارد، قیمت را از همانجا بردارید. - اگر ندارد، بر پایه ساختار HTML خود صفحه یک انتخابگر بنویسید.
- اگر قیمت اصلاً در HTML نیست، صفحه داده را با JavaScript بار میکند. این حالت و شکلهای دیگر خواندن JSON جاسازیشده را در صفحههای ایستا و پویا توضیح دادهایم؛ برای نوشتن انتخابگر به CSS Selector و XPath نگاه کنید.
نمونه اجراشده با پایتون: تاریخچه قیمت و هشدار آستانه
نمونه را نه روی یک فروشگاه واقعی، بلکه روی books.toscrape.com اجرا میکنیم. این سایت کتابفروشی خیالیای است که برای تمرین اسکرپینگ منتشر شده و بنا بر یادداشت صفحه اصلیاش، قیمتها تصادفی تعیین شدهاند. صفحههای آن JSON-LD ندارند. در فروشگاههای واقعی با هر دو حالت روبهرو میشوید؛ برای همین اسکریپت نخست JSON-LD را امتحان میکند و اگر نیافت، سراغ جدول اطلاعات محصول سایت میرود.
آنچه لازم است: Python 3 و دو بسته (pip install requests beautifulsoup4). SQLite با ماژول sqlite3 در کتابخانه استاندارد پایتون همراه است؛ سرور پایگاه داده جداگانهای نصب نمیکنید.
import json
import re
import sqlite3
import time
from datetime import datetime, timezone
from decimal import Decimal

import requests
from bs4 import BeautifulSoup

DB = "prices.db"
THRESHOLD_PCT = Decimal("5")   # a change larger than this raises an alert
DELAY = 2.0                    # pause between two requests to the same site (seconds)
PROXY = None                   # example: "http://user:pass@pr.proxynet.io:8000"
USER_AGENT = "ExamplePriceBot/1.0 (+https://example.com/about-the-bot)"

# Your own SKU -> the competitor's page for the same product
PRODUCTS = {
    "BK-001": "https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html",
    "BK-002": "https://books.toscrape.com/catalogue/tipping-the-velvet_999/index.html",
    "BK-003": "https://books.toscrape.com/catalogue/soumission_998/index.html",
}

CURRENCIES = {"£": "GBP", "€": "EUR", "$": "USD", "₺": "TRY", "TL": "TRY"}


def parse_price(text):
    """Turns a string such as '£51.77' or '1.299,90' into a Decimal."""
    number = re.sub(r"[^\d.,]", "", text)
    if re.fullmatch(r"\d{1,3}(\.\d{3})+", number):
        number = number.replace(".", "")                     # 1.299 -> 1299 (no decimals)
    elif number.rfind(",") > number.rfind("."):
        number = number.replace(".", "").replace(",", ".")   # 1.299,90 -> 1299.90
    else:
        number = number.replace(",", "")                     # 1,299.90 -> 1299.90
    return Decimal(number)


def read_jsonld(soup):
    """Reads the price from schema.org Product data if the page has it."""
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except json.JSONDecodeError:
            continue
        candidates = data if isinstance(data, list) else data.get("@graph", [data])
        for candidate in candidates:
            kind = candidate.get("@type")
            if "Product" not in (kind if isinstance(kind, list) else [kind]):
                continue
            offer = candidate.get("offers") or {}
            if isinstance(offer, list):
                offer = offer[0]
            price = offer.get("price") or offer.get("lowPrice")
            if price is None:
                continue
            return {
                "price": Decimal(str(price)),
                "currency": offer.get("priceCurrency"),
                "in_stock": str(offer.get("availability", "")).endswith("InStock"),
                "source": "json-ld",
            }
    return None


def read_html(soup):
    """No JSON-LD: fall back to the page's own markup, here the books.toscrape.com product table."""
    table = {
        row.th.get_text(strip=True): row.td.get_text(strip=True)
        for row in soup.select("table.table-striped tr")
    }
    raw = table.get("Price (incl. tax)") or soup.select_one("p.price_color").get_text()
    symbol = next((s for s in CURRENCIES if s in raw), None)
    return {
        "price": parse_price(raw),
        "currency": CURRENCIES.get(symbol),
        "in_stock": table.get("Availability", "").startswith("In stock"),
        "source": "html",
    }


def fetch_product(session, url):
    response = session.get(url, timeout=20)
    response.raise_for_status()
    response.encoding = "utf-8"   # the server sends no charset; keeps the £ sign intact
    soup = BeautifulSoup(response.text, "html.parser")
    if soup.select_one("h1") is None:
        raise ValueError("got 200 but this is not a product page")
    return read_jsonld(soup) or read_html(soup)


def database():
    db = sqlite3.connect(DB)
    db.execute(
        """CREATE TABLE IF NOT EXISTS prices (
               sku TEXT NOT NULL,
               url TEXT NOT NULL,
               price_cents INTEGER NOT NULL,
               currency TEXT,
               in_stock INTEGER NOT NULL,
               source TEXT,
               checked_at TEXT NOT NULL
           )"""
    )
    db.execute("CREATE INDEX IF NOT EXISTS idx_sku_checked ON prices (sku, checked_at)")
    return db


def previous_row(db, sku):
    return db.execute(
        "SELECT price_cents, in_stock FROM prices WHERE sku = ? ORDER BY checked_at DESC LIMIT 1",
        (sku,),
    ).fetchone()


def alert(message):
    print("ALERT:", message)   # hook up e-mail or a chat webhook here


def main():
    db = database()
    session = requests.Session()
    session.headers["User-Agent"] = USER_AGENT
    if PROXY:
        session.proxies = {"http": PROXY, "https": PROXY}

    for sku, url in PRODUCTS.items():
        try:
            product = fetch_product(session, url)
        except (requests.RequestException, ValueError, AttributeError) as error:
            print(f"{sku}: could not be read ({error})")
            time.sleep(DELAY)
            continue

        cents = int(product["price"] * 100)
        previous = previous_row(db, sku)
        if previous:
            old_cents, old_stock = previous
            change = Decimal(cents - old_cents) * 100 / Decimal(old_cents)
            if abs(change) >= THRESHOLD_PCT:
                alert(f"{sku}: {old_cents / 100:.2f} -> {cents / 100:.2f} "
                      f"{product['currency']} ({change:+.1f}%)")
            if bool(old_stock) != product["in_stock"]:
                alert(f"{sku}: stock status changed, now {'in stock' if product['in_stock'] else 'out of stock'}")

        db.execute(
            "INSERT INTO prices VALUES (?, ?, ?, ?, ?, ?, ?)",
            (sku, url, cents, product["currency"], int(product["in_stock"]), product["source"],
             datetime.now(timezone.utc).isoformat(timespec="seconds")),
        )
        db.commit()
        print(f"{sku}: {product['price']} {product['currency']} "
              f"stock={'yes' if product['in_stock'] else 'no'} ({product['source']})")
        time.sleep(DELAY)

    db.close()


if __name__ == "__main__":
    main()
در اجرای نخست سه سطر نوشته میشود و چون رکورد قدیمیتری برای مقایسه نیست، هشداری نمیآید:
BK-001: 51.77 GBP stock=yes (html)
BK-002: 53.74 GBP stock=yes (html)
BK-003: 50.10 GBP stock=yes (html)قیمتهای سایت تمرینی تغییر نمیکنند؛ برای دیدن هشدار، آخرین رکورد پایگاه داده را دستی تغییر دادیم: قیمت BK-001 را 45.00 گذاشتیم و BK-002 را ناموجود علامت زدیم. خروجی اجرای دوم:
ALERT: BK-001: 45.00 -> 51.77 GBP (+15.0%)
BK-001: 51.77 GBP stock=yes (html)
ALERT: BK-002: stock status changed, now in stock
BK-002: 53.74 GBP stock=yes (html)
BK-003: 50.10 GBP stock=yes (html)
چهار انتخاب در این کد آگاهانه است:
- قیمت به شکل عدد صحیح بر حسب سنت ذخیره میشود. اعداد ممیز شناور (
float) در حساب پول خطای گرد کردن انباشته میکنند. تجزیه باDecimalو تبدیل به سنت، محاسبه درصد را دقیق نگه میدهد. - هر خواندن یک سطر تازه است. حتی اگر قیمت تغییر نکرده باشد سطر نوشته میشود؛ به این ترتیب «آن روز نگاه کردیم و همان بود» از «آن روز نتوانستیم نگاه کنیم» جدا میشود.
- محصولی که خوانده نشود رد میشود و دور متوقف نمیشود. خطا روی صفحه نوشته میشود و اسکریپت سراغ محصول بعدی میرود. اینکه با کدام کد وضعیت دوباره تلاش شود و با کدام متوقف شوید را میتوانید با کد تلاش دوباره در نوشته کدهای وضعیت HTTP در وب اسکرپینگ ترکیب کنید.
- User-Agent میگوید ربات کیست. شیوه انتخاب مقدار آن در نوشته User-Agent چیست؟ آمده است.
وقتی سطر PROXY را پر کردیم، همین اسکریپت را از طریق یک پروکسی آزمایشی محلی با احراز هویت هم اجرا کردیم. نتیجه تغییر نکرد؛ با گذرواژه نادرست برای هر محصول ProxyError (407) آمد و دور باز هم کامل شد.
فهرست محصولات چگونه به دست میآید: صفحههای دسته و صفحهبندی
برای گردآوری همه نشانیهای محصول در یک دسته از سایت رقیب باید صفحههای دسته را بپیمایید و فهرست تقریباً همیشه به چند صفحه تقسیم شده است. استوارترین روش ساختن شماره صفحه از پیش خود نیست، بلکه دنبال کردن پیوند «بعدی» در خود صفحه است:
import time
from urllib.parse import urljoin

import requests
from bs4 import BeautifulSoup


def product_urls(session, start, max_pages=3, delay=2.0):
    """Walks category pages by following the 'next' link and collects product URLs."""
    url, found = start, []
    for _ in range(max_pages):
        response = session.get(url, timeout=20)
        response.raise_for_status()
        soup = BeautifulSoup(response.text, "html.parser")
        found += [urljoin(url, a["href"]) for a in soup.select("article.product_pod h3 a")]
        next_link = soup.select_one("li.next a")
        if next_link is None:
            break
        url = urljoin(url, next_link["href"])
        time.sleep(delay)
    return found


session = requests.Session()
session.headers["User-Agent"] = "ExamplePriceBot/1.0 (+https://example.com/about-the-bot)"
urls = product_urls(session, "https://books.toscrape.com/catalogue/category/books/mystery_3/index.html")
print(len(urls), "products found")
در دسته «Mystery» سایت تمرینی، این تابع دو صفحه را پیمود و 32 نشانی محصول برگرداند. سقف صفحه (max_pages) نمیگذارد یک پیوند «بعدی» معیوب اسکریپت را در حلقه بیپایان بیندازد. پیمایش بیپایان، دکمه «بارگذاری بیشتر»، APIهای مبتنی بر مکاننما و صف URL که خزش نیمهکاره را از همانجا ادامه میدهد، موضوع نوشته صفحهبندی در وب اسکرپینگ است. اگر میخواهید همین کار را با یک چارچوب آماده بسازید، Scrapy و شیوه استفاده از آن با پروکسی را ببینید.
تاریخچه چگونه پرسوجو میشود و اسکریپت چگونه زمانبندی میشود؟
کمترین و بیشترین قیمت 30 روز گذشته یک پرسوجوی ساده است:
SELECT sku,
       MIN(price_cents) / 100.0 AS lowest,
       MAX(price_cents) / 100.0 AS highest,
       COUNT(*)                 AS readings
FROM prices
WHERE checked_at >= date('now', '-30 days')
GROUP BY sku
ORDER BY sku;
این جدول نشان میدهد تخفیف چند روز طول کشیده و آیا قیمتی که با نام «تخفیف» اعلام شده همان قیمت عادی ماه پیش بوده است یا نه.
برای زمانبندی، در لینوکس یک سطر cron (0 */6 * * * python3 /opt/prices/price_tracker.py، هر شش ساعت) و در ویندوز Task Scheduler کار را انجام میدهد. برای دورها ساعتهای شب را برگزینید؛ سایت رقیب هم مانند سایت شما در طول روز به مشتری خدمت میدهد.
چرا کشوری که از آن نگاه میکنید اهمیت دارد؟
قیمت و موجودیای که یک فروشگاه نشان میدهد میتواند بسته به کشور بازدیدکننده تغییر کند: واحد پول، مالیات، منطقه تحویل، کمپین منطقهای. اگر اسکریپت شما روی سرور ابری در کشور دیگری اجرا میشود، شاید صفحهای را ثبت میکنید که به آن مکان نشان داده میشود، نه صفحهای که مشتری شما میبیند.
راهحل این است که درخواست از همان کشور مشتری شما فرستاده شود. با پروکسی مسکونی میتوانید کشور خروج را انتخاب کنید؛ فهرست کشورهای در دسترس در صفحه موقعیتهای پروکسی آمده است. اینکه مکان IP چگونه تعیین میشود و چرا گاهی نادرست درمیآید را در دقت مکانیابی از روی IP توضیح دادهایم. نقش دوم پروکسی در این کار پخش کردن بار میان چند نشانی است، وقتی تعداد زیادی محصول خوانده میشود. منطق چرخش در نوشته چرخش IP آمده است. انتخاب میان پروکسی چرخشی و نشست ثابت را بخش پرسشهای صفحه رصد قیمت ما پاسخ میدهد.
پروکسی مجوز نیست. محدودیت نرخ سایت و قواعد robots.txt مستقل از اینکه درخواست از کدام IP بیرون میآید معتبرند.
اعلان موجودی هم با همین جریان ساخته میشود؟
بله. اسکریپت بالا وضعیت موجودی را هم ثبت میکند و با تغییر آن هشدار میدهد. تمام شدن موجودی رقیب میگوید در آن روزها نیازی به تخفیف ندارید؛ بازگشت موجودی او زمان بازنگری قیمت است.
مرز اینجاست: گرفتن اعلان با خرید خودکار یکی نیست. جمع کردن کالای محدود با ربات در همان لحظه موجود شدن و فروش دوباره آن به زیان خریداران دیگر است و بیشتر فروشگاهها آن را در شرایط خود ممنوع کردهاند. جریان این نوشته اطلاعات گردآوری میکند و به سبد خرید دست نمیزند. اینکه چرا عاملهایی که گام خرید را خودکار میکنند مسدود میشوند را در چرا عاملهای خرید هوش مصنوعی مسدود میشوند بررسی کردهایم.
مرزها: شرایط سایت، robots.txt و حقوق رقابت
نگاه کردن به قیمت پشت ویترین رقیب به اندازه خود تجارت قدمت دارد. آنچه رصد خودکار را مشروع نگه میدهد روش است:
- فقط صفحههای محصولِ در دسترس عموم. بخشهایی که ورود میخواهند، داده شخصی در نظرهای مشتریان و اتوماسیون حساب بیرون از دامنهاند.
- robots.txt و شرایط سایت. پیش از خزش هر دو را بخوانید. شرایط استفاده مارکتپلیسها ممکن است بندهایی داشته باشد که دسترسی خودکار را محدود میکند؛ اگر چنین بندی هست، API رسمی، همکاری داده یا درخواست اجازه را بررسی کنید. شیوه خواندن این فایل در فایل robots.txt چیست؟ و چارچوب حقوقی در آیا وب اسکرپینگ قانونی است؟ آمده است.
- سرعت پایین و کش. میان درخواستها صبر کنید و یک صفحه را بیش از آنچه آهنگ تصمیمگیری شما لازم دارد درخواست نکنید.
- اگر صفحه محافظت آمد، بایستید. صفحه تأیید خرابی نیست، پاسخی است که سایت داده است. شیوه کار این سامانهها را در تشخیص ربات چگونه کار میکند؟ توضیح دادهایم.
حقوق رقابت هم هست. دنبال کردن قیمت علنی رقیب و تعیین قیمت خودتان بهتنهایی، رفتار تجاری عادی است. توافق با رقبا بر سر قیمت یا هماهنگ عمل کردن با تبادل دوطرفه اطلاعات قیمت چیز دیگری است. در اتحادیه اروپا ماده 101 معاهده کارکرد اتحادیه اروپا توافقها و رویههای هماهنگی را که رقابت را محدود میکنند ممنوع میکند و نخستین نمونهاش تثبیت قیمت خرید یا فروش است. در Türkiye ماده 4 قانون شماره 4054 درباره حمایت از رقابت همین خط را میکشد و بیشتر نظامهای حقوقی قاعدهای همارز دارند. اگر قواعد قیمتگذاری خودکار میچینید، این مرز را با یک حقوقدان در میان بگذارید.
کاربردها
- فروشندگان مارکتپلیس: قیمت و موجودی فروشندگان دیگری که همان محصول را میفروشند. یادداشتهای زیرساختی ویژه هر پلتفرم در صفحههای Amazon Proxy، Walmart Proxy و Alibaba Proxy آمده است.
- برندهایی که از سایت خودشان میفروشند: پایش اینکه نمایندگان مجاز قیمت توصیهشده را رعایت میکنند یا نه. چیدمان کلی در صفحه راهکار تجارت الکترونیک آمده است.
- تیمهای داده: به کار بردن تاریخچه قیمت بهعنوان ورودی پیشبینی تقاضا و تحلیل کمپین. مقیاسپذیر کردن سمت گردآوری در صفحه راهکار استخراج داده آمده است.
خطاهای رایج
- نگه داشتن فقط آخرین قیمت. بدون تاریخچه نمیبینید تخفیف چه زمانی شروع شد، چند روز طول کشید و آیا تکرار میشود.
- یک بار تطبیق دادن و فراموش کردن. رقیب محصول را نو میکند، نشانی همان میماند و شما مدل قدیمی را با مدل تازه مقایسه میکنید.
- پاسخ
200را قیمت پنداشتن. صفحه تأیید یا صفحه «محصول یافت نشد» هم میتواند200برگرداند. بررسیای مانند آزمونh1در اسکریپت ضروری است؛ اگر فیلد قیمت خالی بود سطر ننویسید. - اشتباه گرفتن ویرگول و نقطه.
1.299,90و1,299.90یک عددند. تابع تجزیه را با نمونههای واقعی سایت مقصد بیازمایید. - همسطح شدن خودکار و بیحد با قیمت رقیب. اگر دو قاعده خودکار روبهروی هم کار کنند، قیمت به کف میرسد. کف قیمت را خودتان و بر پایه هزینهتان بگذارید.
راهنمای انتخاب
| نیاز | پیشنهاد |
|---|---|
| بهروز نگه داشتن قیمت و موجودی خودتان | API فروشنده مارکتپلیس |
| 20 تا 30 محصول، نگاه هفتگی | بررسی دستی و جدول |
| صدها محصول، بدون تیم نرمافزار | ابزار آماده رصد قیمت یا جریان اتوماسیون |
| سایتهای خاص، انبار داده خودتان، هشدار انعطافپذیر | اسکریپت پایتون خودتان و SQLite |
| دهها هزار محصول، خواندن ساعتی | خزنده صفدار (Scrapy)، پایگاه داده سروری، پخش بار میان چند IP |
| قیمت بسته به کشور تغییر میکند | IP که از کشور مشتری شما بیرون میآید |
| سایت صفحه تأیید نشان میدهد | بایستید؛ سرعت، شرایط و گزینه API رسمی را بازبینی کنید |
پرسشهای متداول
رصد قیمت رقبا قانونی است؟
نگاه کردن به قیمت در یک صفحه محصولِ در دسترس عموم و یادداشت کردن آن فعالیت تجاری عادی است. مشکل در روش پیش میآید: دسترسی به داده پشت صفحه ورود، نادیده گرفتن شرایط سایت یا robots.txt و خزش با سرعتی که سرور را خسته کند. همچنین به کار بردن اطلاعات گردآوریشده برای توافق قیمت با رقبا خلاف حقوق رقابت است.
رصد قیمت با Excel شدنی است؟
برای تعداد کمی محصول، بله. جدولی که دستی پر میشود یا قابلیت دریافت داده از وب در Excel برای شروع کافی است. مرز آن در تاریخچه و هشدار پیدا میشود: جدول وضعیت فعلی را نشان میدهد و از تغییر خبر نمیدهد. وقتی تعداد محصول از چند ده گذشت، پایگاه داده کوچکی مانند SQLite زحمت کمتری دارد.
API فروشنده آمازون قیمت رقبا را میدهد؟
تا حدی. APIهای فروشنده پیش از هر چیز برای مدیریت داده محصول، موجودی، قیمت و سفارش فروشگاه خود شما هستند. Product Pricing API آمازون برای محصولات کاتالوگ آمازون داده قیمت رقابتی مانند پیشنهاد برجسته را برمیگرداند؛ برای تاریخچه قیمت رقیب، موجودی او یا قیمتش در سایتهای دیگر نقطه پایانی ندارد. اینکه هر مارکتپلیس چه ارائه میکند را در مستند یکپارچهسازی بهروز آن بررسی کنید. کار اصلی این APIها خواندن قیمت فعلی خودتان و بازنویسی تصمیم قیمت در فروشگاهتان است.
روزی چند بار باید بخوانم؟
به همان اندازه که تصمیم قیمت میگیرید. برای بیشتر کاتالوگها روزی یک بار کافی است؛ پرفروشهای دوره کمپین به چند دور در روز میرسند و محصولات کمگردش به هفتهای یک بار پایین میآیند.
برای رصد قیمت پروکسی لازم است؟
برای فهرست کوچک و فاصله زیاد، نه. در دو حالت لازم میشود: وقتی قیمت بسته به کشور تغییر میکند و اسکریپت شما در کشوری غیر از کشور مشتری اجرا میشود، یا وقتی تعداد محصول آنقدر زیاد است که بیرون آمدن همه درخواستها از یک نشانی مشکلساز میشود. اینکه کدام نوع IP برای کدام کار مناسب است را در صفحه راهکار رصد قیمت مقایسه کردهایم.
اگر صفحه JSON-LD نداشت قیمت را از کجا بخوانم؟
نخست در سورس صفحه ببینید قیمت در HTML ساده هست یا نه؛ اگر هست، انتخابگری مانند نمونه بنویسید و در صورت امکان بهجای نام کلاس به ساختاری ماندگارتر مانند جدول اطلاعات محصول تکیه کنید. اگر قیمت اصلاً در سورس نیست، صفحه داده را بعداً بار میکند. در این حالت یافتن درخواستی که داده از آن میآید در زبانه شبکه مرورگر، راهحلی سبکتر از اجرای مرورگر headless است.
خلاصه
رصد قیمت رقبا نرمافزار نیست، یک جریان کار است: فهرست محصولی که درست تطبیق داده شده، فاصله خواندنی متناسب با آهنگ تصمیمهای شما، جدول تاریخچه تاریخدار و هشدارهایی کم اما معنادار. داده سمت خودتان را از API فروشنده بگیرید و در سمت رقیب به صفحههای در دسترس عموم، robots.txt و سرعت پایین پایبند بمانید. یک اسکریپت پایتون حدود 150 سطری و یک پایگاه داده SQLite تکفایلی برای بیشتر کاتالوگها این کار را انجام میدهد. وقتی مقیاس بزرگ شد و لازم بود قیمت را از کشور مشتری خود ببینید، گزینههای زیرساخت را در صفحه راهکار رصد قیمت مییابید.