اسکریپت Python شما هر صبح صفحههای محصول چند ده فروشگاه را جمعآوری میکند. روی همه کار میکند جز یکی. آن فروشگاه با 403 و یک صفحه کوتاه HTML پاسخ میدهد که JavaScript و کوکی میخواهد. اجرای دوباره اسکریپت هم همان صفحه را برمیگرداند. فروشگاه پشت Cloudflare است و Cloudflare پیش از آنکه سرور خود فروشگاه درخواست شما را ببیند به آن پاسخ داده است.
هر اسکرپری که با سایتهای پشت Cloudflare کار میکند دیر یا زود چنین پاسخی میگیرد. این راهنما نشان میدهد این پاسخ را چگونه بخوانید، کدام راههای مجاز شما را به داده میرسانند و پروکسی چه چیزی را میتواند تغییر دهد و چه چیزی را نه. در پایان یک اسکرپر Python آزمودهشده میآوریم که هر پاسخ Cloudflare را دستهبندی میکند و وقتی سایت دسترسی نمیدهد متوقف میشود، بیآنکه برای دور زدن هیچ چالشی (challenge) تلاش کند.
اصطلاح اسکرپر Cloudflare یعنی چه؟
اسکرپر Cloudflare ابزار خاصی نیست؛ به هر اسکرپری گفته میشود که سایت مقصدش ترافیک خود را از Cloudflare عبور میدهد. (برخی بستههای Python همین نام را برای ابزارهای حل چالش به کار میبرند؛ پایینتر توضیح میدهیم چرا سراغ آنها نمیرویم.) در چنین سایتی DNS آدرسهای Cloudflare را برمیگرداند، پس درخواست شما نخست به سروری از Cloudflare میرسد. Cloudflare همانجا تنظیمات امنیتی صاحب سایت را اعمال میکند و فقط درخواستهایی را که از این تنظیمات بگذرند به سرور مبدأ (سرور خود سایت) میفرستد. این ساختار ریورس پروکسی است و برای سایت کار میکند، در حالی که فوروارد پروکسیای که در اسکرپر خود تنظیم میکنید برای شما کار میکند (فوروارد پروکسی و ریورس پروکسی).
Cloudflare چگونه تشخیص میدهد که درخواستی از ربات است؟
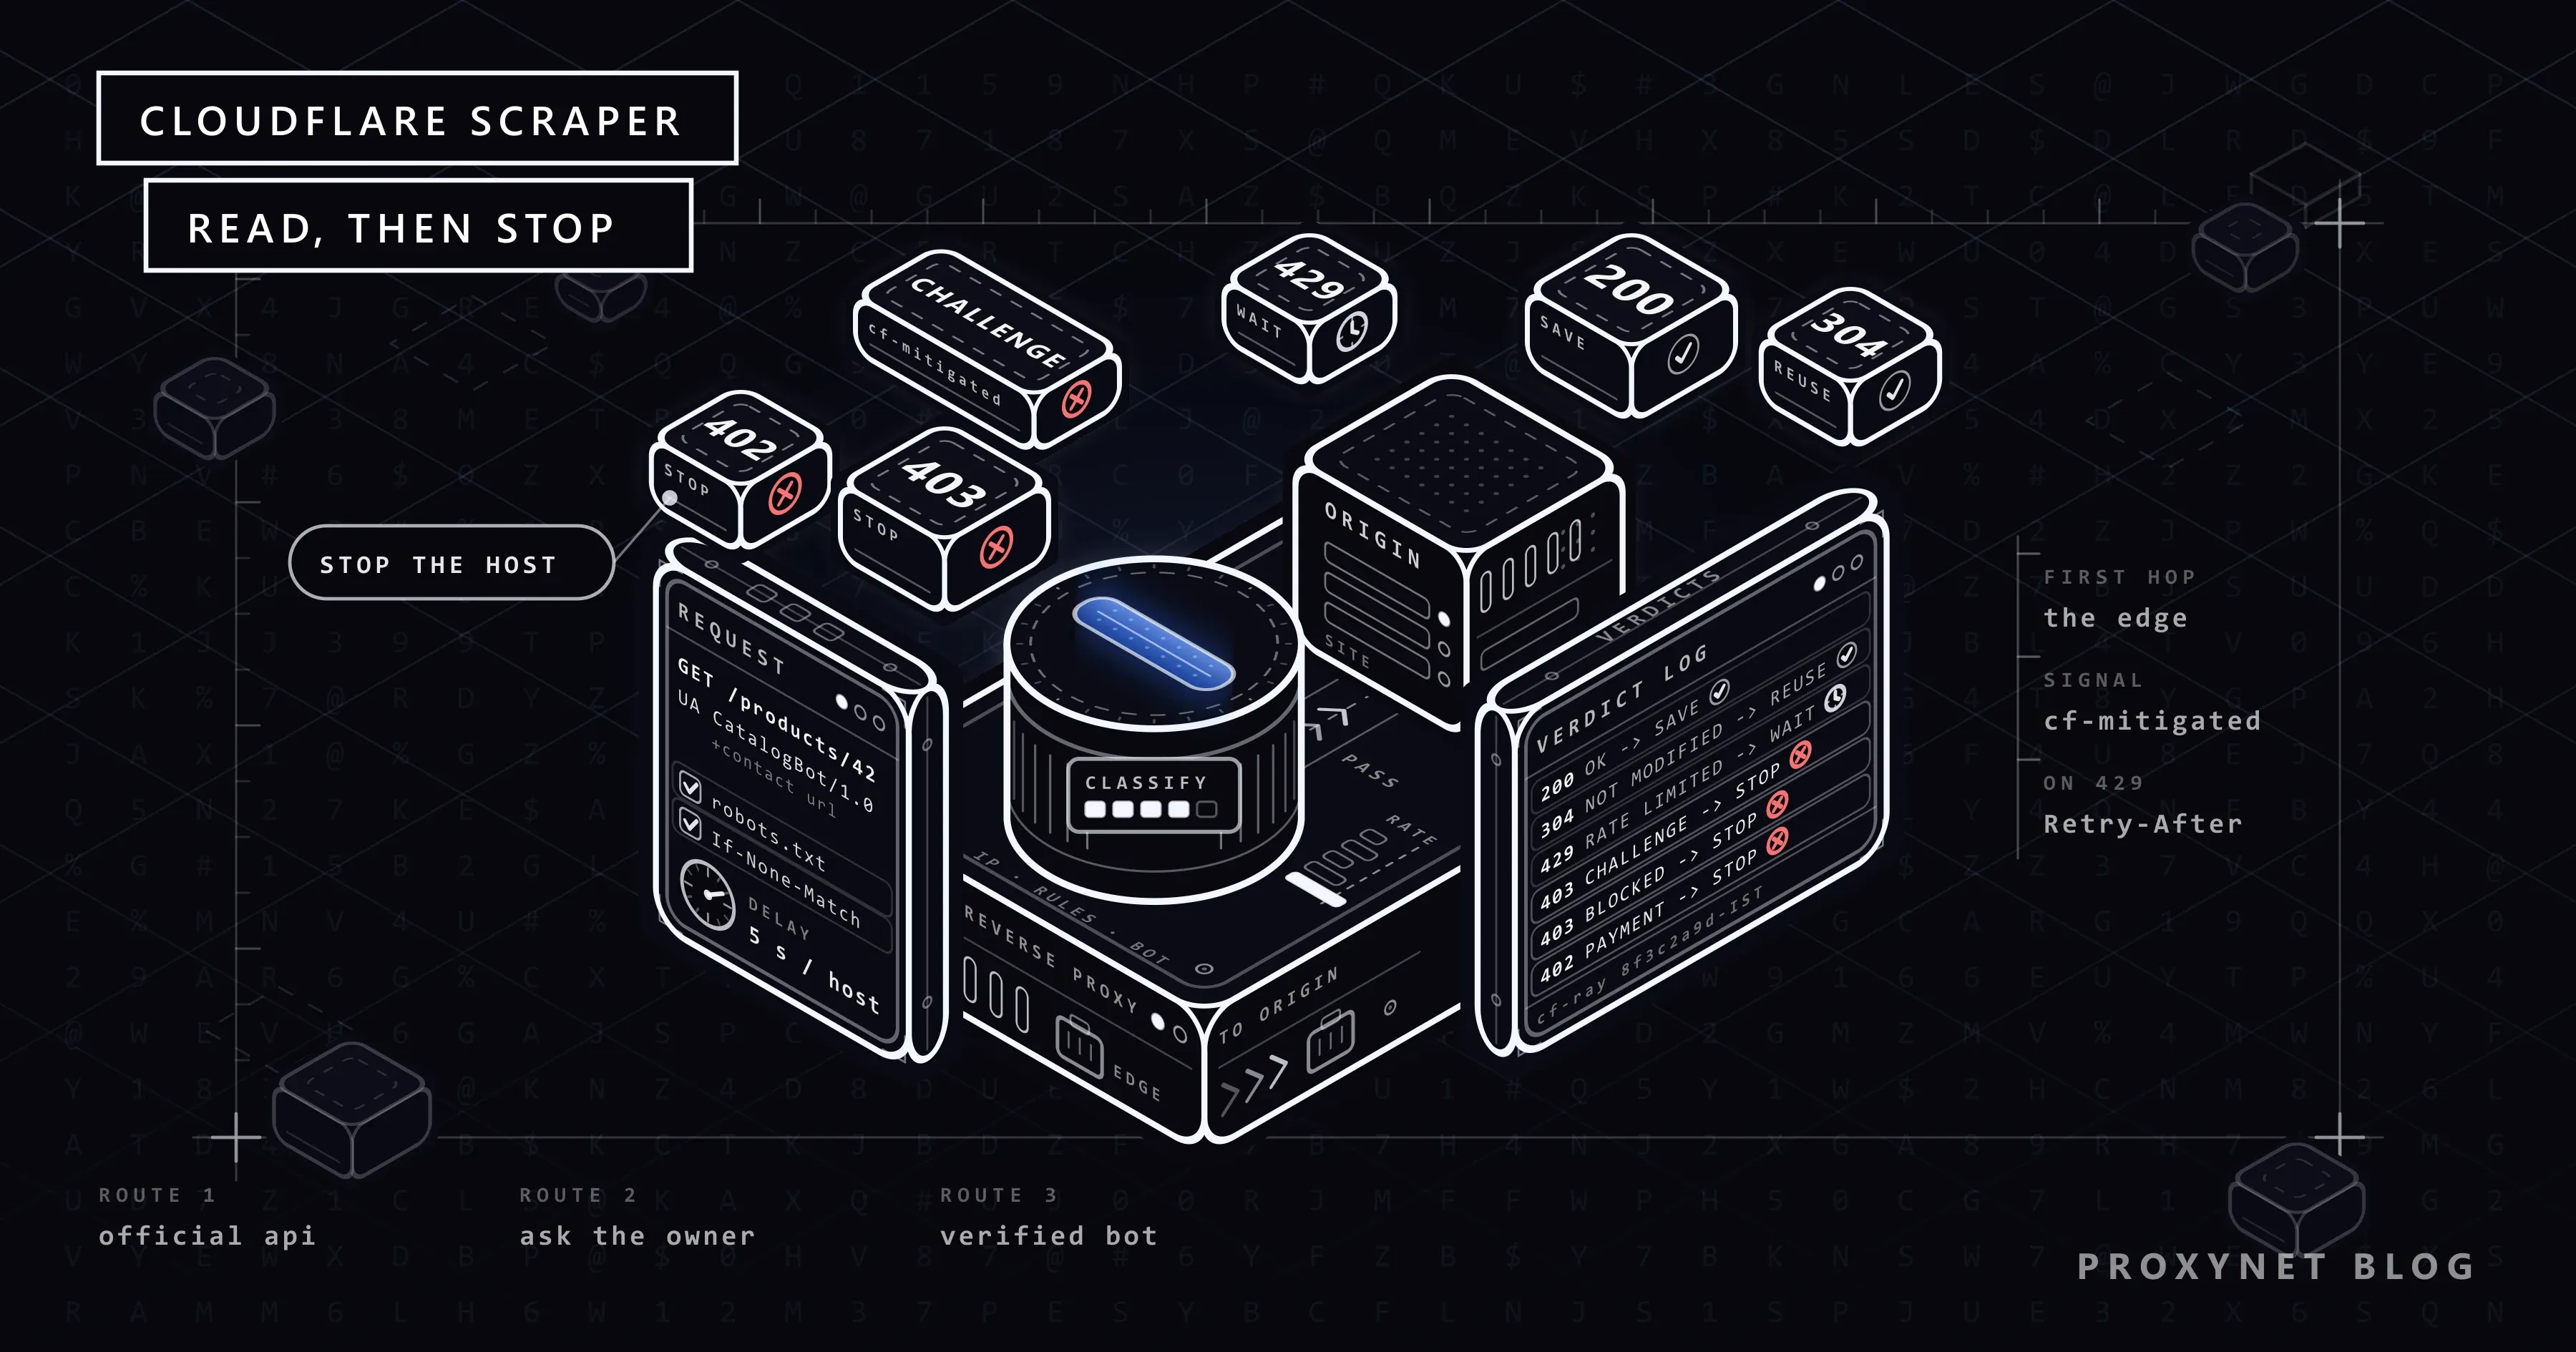
Cloudflare تنظیمات صاحب سایت را یکی پس از دیگری اجرا میکند و نخستین تنظیمی که درخواست را مسدود کند یا با چالش روبهرو کند، بررسی را تمام میکند. ترتیب کار، بهصورت سادهشده:
- بررسی IP و هدرها. قاعدههای IP Access آدرس IP، شبکه آن (ASN) یا کشورش را میسنجند. Browser Integrity Check که بهطور پیشفرض روشن است، درخواستی را که
User-Agentندارد یاUser-Agentغیراستاندارد دارد با چالش روبهرو میکند. - قاعدههای سفارشی (custom rules). قاعدههایی که صاحب سایت خودش نوشته میتوانند مسیر، کشور،
User-Agent، امتیاز ربات (bot score) و موارد دیگر را بسنجند. - قاعدههای محدودیت نرخ (rate limiting). در بیشتر پلنها درخواستها بهازای هر IP شمرده میشوند. Advanced Rate Limiting در پلن Enterprise میتواند درخواستها را بهازای کوکی، هدر یا ASN هم بشمارد و اگر Bot Management هم فعال باشد، بهازای اثر انگشت TLS (JA3/JA4).
- قاعدههای مدیریتشده و محصولات مدیریت ربات. الگوهای شناختهشده حمله بررسی میشوند و سپس، بسته به پلن، Bot Fight Mode، Super Bot Fight Mode یا Bot Management وارد عمل میشود.
- پاسخ. درخواست یا به مبدأ میرسد، یا صفحه خطا میگیرد، یا با چالشی روبهرو میشود که در مرورگر بررسیهایی اجرا میکند و اگر مرورگر از آنها بگذرد، کوکی
cf_clearanceرا در مرورگر ذخیره میکند.
سیگنالهای پشت هر گام را در نوشته تشخیص ربات و لایه نشست را در نوشته Cloudflare Precursor توضیح دادهایم.
اسکرپر شما با کدام مسدودی Cloudflare روبهرو شده است؟
یک 403 از سایتی پشت Cloudflare ممکن است از یک چالش بیاید، از یک قاعده فایروال، از ممنوع بودن شبکه شما یا از اینکه خود مبدأ درخواست را رد کرده است. به ترتیب هدرها، کد وضعیت، بدنه پاسخ و در آخر بررسی محتوای خودتان را ببینید. هدرهای cf-ray و server: cloudflare بهتنهایی چیزی نمیگویند، چون هر پاسخی که از Cloudflare میگذرد آنها را دارد.
| آنچه میبینید | کد وضعیت | نشانه | معنا | گام بعدی |
|---|---|---|---|---|
| صفحه کوتاهی که JavaScript میخواهد | اغلب 403 | cf-mitigated: challenge | صفحه چالش | متوقف شوید؛ برای حل آن تلاش نکنید |
| صفحه عادی با یک فرم Turnstile | 200 | عنصر cf-turnstile | Turnstile از آن فرم محافظت میکند | فرم را نفرستید |
| «Sorry, you have been blocked» | بهطور پیشفرض 403 | صفحه Cloudflare با Ray ID و بدون کد 1xxx | قاعده WAF که صاحب سایت گذاشته است | متوقف شوید؛ Ray ID را برای صاحب سایت بفرستید |
| Error 1020، «Access denied» | 403 | کد 1xxx از Cloudflare | قاعده فایروال قدیمی (legacy) | متوقف شوید؛ Ray ID را برای صاحب سایت بفرستید |
| Error 1010 | 403 | همان | Browser Integrity Check شما را مسدود کرده است | با صاحب سایت تماس بگیرید |
| Error 1005، 1006 تا 1008، 1106 یا 1009 | 403 | همان | شبکه (ASN)، IP یا کشور شما ممنوع شده است | متوقف شوید؛ شبکه را عوض نکنید |
| Error 1015 | بهطور پیشفرض 429، یا یک 4xx که صاحب سایت انتخاب کند | 1015 در بدنه، یا خود 429 | محدودیت نرخ، بسته به پلن از 10 ثانیه تا یک روز | صبر کنید، از Retry-After پیروی کنید و سرعت را کم کنید |
| اعلان پرداخت | 402 | هدر crawler-price | پرداخت بهازای خزش (pay per crawl) برای خزندههای هوش مصنوعی | متوقف شوید، مگر اینکه در این برنامه شرکت کرده باشید |
| صفحه خطای ساده | 403 | بدون کد خطای Cloudflare و بدون Ray ID | سرور مبدأ درخواست را رد کرده است | متوقف شوید؛ با صاحب سایت تماس بگیرید |
| صفحهای که داده شما در آن نیست | 200 | بررسی محتوای شما ناموفق است | صفحهای که با JavaScript ساخته میشود یا صفحه تله | ذخیرهاش نکنید؛ صفحههای ایستا و پویا و تلههای هانیپات را ببینید |
| خطای سرور | 5xx، از جمله 520 تا 526 | کد وضعیت | مشکل در مبدأ است، نه مسدودی | با فاصلهای که هر بار بیشتر میشود چند بار دوباره تلاش کنید |
چهار نکته اینجا مهم است:
- به هدر اعتماد کنید، نه به متن. Cloudflare هدر
cf-mitigated: challengeرا راه تشخیص پاسخ صفحه چالش معرفی میکند: همه انواع چالش این هدر را میگذارند وchallengeتنها مقدار آن است. متن چالش با زبان مرورگر تغییر میکند و/cdn-cgi/challenge-platform/در صفحههای عادی هم دیده میشود. همین صفحه از نگاه بازدیدکننده در نوشته تأیید Cloudflare آمده است. - کدهای خطا دو شکل دارند. Cloudflare یا یک صفحه HTML با نشان خودش («Error 1020») میفرستد یا بدنه متنی کوتاهی مانند
error code: 1003. وقتی یک آدرس IP از Cloudflare را مستقیم درخواست کردیم، حتی باUser-Agentمرورگر، شکل کوتاه را گرفتیم. - هر کد
1xxxمسدودی نیست. برای نمونه Error 1016 خطای DNS مبدأ در سمت سایت است. - مسدودیها هدر
cf-mitigatedندارند. فقط بدنه پاسخ مسدودی Cloudflare را از403خود مبدأ جدا میکند: یک کد خطا، یا صفحه Cloudflare با Ray ID. کدها یکییکی در خطای Sorry, You Have Been Blocked و محدودیتهای نرخ در نوشته Error 1015 آمدهاند.
چرا Cloudflare جلوی Python Requests را میگیرد ولی مرورگر عبور میکند؟
Chrome پس از مکثی کوتاه صفحه را باز میکند، اما Python Requests با صفحه چالش روبهرو میشود. تفاوت در سه چیز است.
JavaScript اجرا نمیشود. Cloudflare میگوید بازدیدکننده برای گذشتن از هر نوع چالشی به JavaScript و کوکی نیاز دارد. Requests، httpx و curl صفحه HTML را دانلود میکنند اما اسکریپتهای آن را هرگز اجرا نمیکنند.
کوکی مجوز عبور در کار نیست. مرورگری که از چالش بگذرد کوکی cf_clearance را نگه میدارد و با هر درخواست بعدی میفرستد. یک کلاینت ساده HTTP هرگز چنین کوکیای نمیگیرد.
هویت کلاینت با ادعایش جور نیست. کتابخانههای Python اتصال TLS را به شکلی متفاوت از Chrome باز میکنند، پس درخواستی که در User-Agent خود «Chrome» نوشته اما دستدادن TLS آن همان دستدادن Python است بهآسانی شناخته میشود (اثر انگشت TLS و JA3). نام واقعی ربات هم میتواند Browser Integrity Check را فعال کند، چون این بررسی درخواستهایی را که User-Agent غیراستاندارد دارند با چالش روبهرو میکند؛ فقط صاحب سایت میتواند برای آن استثنا بگذارد.
برخی ابزارها اسکریپت را جای مرورگر جا میزنند: افزونههای stealth، کتابخانههای جعل TLS، درایورهای دستکاریشده و سرویسهای حل چالش. ما به آنها نمیپردازیم. این ابزارها کلاینت شما را نادرست معرفی میکنند، معمولاً شرایط استفاده سایت را زیر پا میگذارند و هر بار که روش تشخیص تغییر کند از کار میافتند.
راههای مجاز برای رسیدن به داده در سایتی که پشت Cloudflare است کداماند؟
راهها را به همان ترتیبی میآوریم که خودمان امتحانشان میکنیم.
1. API رسمی، خوراک داده یا نقشه سایت
بسیاری از سایتها داده را برای ماشینها منتشر میکنند: یک API، یک خوراک RSS یا خوراک محصول، یا نقشه سایتی (sitemap) که در robots.txt معرفی شده است. API به شما کلید، محدودیت مستند و قالبی پایدار میدهد و با تغییر HTML هیچ چیز خراب نمیشود. پیش از نوشتن اسکرپر، فوتر سایت، صفحههای توسعهدهندگان و سطرهای Sitemap: در robots.txt را بررسی کنید.
2. از صاحب سایت اجازه بخواهید
فقط صاحب سایت میتواند چالش یا مسدودی را بردارد؛ کارکنان Cloudflare نمیتوانند. پیام کوتاهی بنویسید و در آن نام ربات، یک نشانی تماس، مسیرهایی که لازم دارید، اینکه هر چند وقت یک بار سر میزنید و آدرس IP خودتان را بیاورید. صاحب سایت سپس میتواند با یک قاعده IP Access به IP شما اجازه دهد. درخواستهایی که با این قاعده مجاز شوند از قاعدههای سفارشی، محدودیت نرخ و قاعدههای مدیریتشده معاف میشوند و Bot Fight Mode هم روی آنها عمل نمیکند. در پلنهای پولی یک قاعده Skip هم میتواند شما را از Super Bot Fight Mode معاف کند؛ این قاعده هم معمولاً روی یک IP ثابت یا توکنی در هدر که بر سر آن توافق کردهاید تنظیم میشود. برای آدرس ثابت، IP ثابت برای API را ببینید یا از پروکسی ISP استفاده کنید.
3. به برنامه رباتهای تأییدشده Cloudflare بپیوندید
برای خزندهای که به عموم خدمت میدهد، برنامه رباتهای تأییدشده Cloudflare راه رسمی است. ربات تأییدشده هویت خود را با یکی از این روشها ثابت میکند: امضای Web Bot Auth، فهرست IP منتشرشده همراه با User-Agent ثابت، یا DNS معکوس (reverse DNS). ربات باید از robots.txt پیروی کند و با نرخ معقولی درخواست بفرستد. درخواست عضویت از راه فرمی در پنل Cloudflare فرستاده میشود؛ نامهای کلی مانند python-requests برای تأیید بر اساس IP پذیرفته نمیشوند. از 1 ژوئیه 2026 عاملهای امضاشدهای هم که از طرف کاربران کار میکنند در این برنامه جا دارند و سئو، پایش و اسکرپینگ قیمت از جمله دستههای آناند.
در روش Web Bot Auth، ربات هر درخواست را با کلید خصوصی خود و بر پایه RFC 9421 HTTP Message Signatures امضا میکند و کلید عمومی را روی دامنه خودش منتشر میکند؛ این سند از فوریه 2024 استاندارد است. کارگروه IETF قواعد مربوط به رباتها را در 1 سپتامبر 2026 بهعنوان پیشنویس پذیرفت: draft-ietf-webbotauth-httpsig-protocol. روند کامل را در نوشته چرا عاملهای خرید هوش مصنوعی مسدود میشوند توضیح دادهایم. تأیید ثابت میکند شما چه کسی هستید، اما اینکه رباتهای تأییدشده اجازه ورود داشته باشند یا نه همچنان تصمیم صاحب سایت است.
4. برای خزندههای هوش مصنوعی: تنظیمات پیشفرض و پرداخت بهازای خزش
از ژوئیه 2025 دامنههای تازه در Cloudflare بهطور پیشفرض خزندههای هوش مصنوعی را مسدود میکنند. از 15 سپتامبر 2026 دامنههای تازه رباتهای Training و Agent را در صفحههای دارای تبلیغ هم مسدود میکنند، در حالی که رباتهای Search همچنان مجازند. برخی سایتها سطرهای Content-Signal مانند ai-train=no را به robots.txt میافزایند؛ urllib.robotparser آنها را نادیده میگیرد (خودمان بررسی کردیم)، پس این سطرها را خودتان بخوانید. پرداخت بهازای خزش (Pay per crawl) در ژوئیه 2025 بهصورت بتای خصوصی آغاز شد و در سپتامبر 2026 مستندات Cloudflare هنوز آن را بتای بسته مینامد. خزندهای که هدرهای پرداخت را نفرستد پاسخ 402 همراه با هدر crawler-price میگیرد.
5. مرورگر واقعی، فقط جایی که لازم است
اگر صفحه دادههایش را با JavaScript میسازد و سایت خودکارسازی را مجاز میداند، Playwright صفحه رندرشده را به شما میدهد (Playwright با پروکسی). اول زبانه Network مرورگر را ببینید: داده بیشتر وقتها از یک درخواست JSON میآید که یک کلاینت ساده هم میتواند آن را فراخوانی کند. Cloudflare اعلام کرده است که چارچوبهای خودکارسازی مانند Playwright برای حل چالشهایش پشتیبانی نمیشوند؛ پس اگر چالشی ظاهر شد، متوقف شوید و به راه 2 برگردید.
پروکسی کجا کمک میکند و کجا نه؟
پروکسی فقط آدرس IP و شبکه درخواست شما را تغییر میدهد. دستدادن TLS را عوض نمیکند، JavaScript اجرا نمیکند و cf_clearance را با خود نمیبرد. چرخاندن IP در هر درخواست، یک کلاینت را به شکل بازدیدکنندگان ناشناس فراوانی درمیآورد که هیچ سابقهای ندارند (چرخش IP چگونه کار میکند).
پروکسی در سه حالت ابزار درستی است:
- محتوای یک کشور مشخص. پروکسی مسکونی در همان کشور صفحهای را نشان میدهد که بازدیدکنندگان محلی میبینند.
- IP ثابتی که صاحب سایت به آن اجازه داده است. پروکسی ISP آن آدرس را ثابت نگه میدارد.
- سایتهای زیاد، هر کدام با نرخی مؤدبانه. پروکسی چرخشی میتواند به هر سایت IP خروجی متفاوتی بدهد و پروکسی با نشست ثابت برای هر سایت یک IP خروجی را ثابت نگه میدارد. هرگز با چرخش IP به یک سایت بیش از آنچه برای یک IP مجاز است درخواست نفرستید.
گذشتن از ممنوعیت جزو این حالتها نیست: عوض کردن شبکه پس از Error 1005 یا 1006 دقیقاً همان کاری است که این قاعدهها برای جلوگیری از آن نوشته شدهاند.
اسکرپر Python برای Cloudflare که میداند چه زمانی باید متوقف شود
این اسکریپت برای کارهایی است که اجازه اجرایشان را دارید، مانند کاتالوگهای عمومی در سایتهایی که خزش را مجاز میدانند، یا سایتی که صاحبش IP شما را در فهرست مجاز گذاشته است. اسکریپت بیآنکه برای گذشتن از هیچ بررسیای تلاش کند:
- یک
User-Agentشفاف با نام ربات و یک URL برای تماس میفرستد؛ robots.txtرا برای هر میزبان یک بار و با همان دستهبندیکننده میخواند و اگر آنجا به چالش یا مسدودی بخورد، خزش آن میزبان را متوقف میکند (این قاعده محتاطانه خود ماست، چون RFC 9309 پاسخ4xxرا به معنای «بدون قاعده» میگیرد)؛- وقتی
robots.txtدریافت نمیشود، خطای واقعی را ثبت میکند، برای نمونه407به خاطر گذرواژه نادرست پروکسی، تا یک خطای پیکربندی شبیه جواب رد سایت به نظر نرسد؛ - میان دو درخواست به یک میزبان
MIN_DELAYثانیه صبر میکند، یا اگرCrawl-delayبیشتر باشد به همان اندازه (فقط ثانیههای کامل:urllib.robotparserمقدار1.5را نادیده میگیرد)؛ - هدرهای
If-None-MatchوIf-Modified-Sinceرا میفرستد تا صفحهای که تغییر نکرده فقط به اندازه یک304هزینه داشته باشد؛ - در پاسخ
429یا5xxازRetry-Afterدر هر دو شکلی که RFC 9110 مجاز میداند پیروی میکند و اگر این هدر نباشد زمان انتظار را هر بار دو برابر میکند؛ انتظار هرگز ازMAX_WAITبیشتر نمیشود و پس ازMAX_RETRIESبار تلاش دوباره، آن میزبان رها میشود (کدهای وضعیت HTTP در وب اسکرپینگ)؛ - در برابر چالش، مسدودی یا
402نشانی صفحه و مقدارcf-rayرا ثبت میکند و آن میزبان را کنار میگذارد.
اسکریپت از Requests همگام (pip install requests) استفاده میکند، چون هدف این است که در هر لحظه فقط یک درخواست مؤدبانه به هر میزبان برود (مقایسه HTTPX، Requests و AIOHTTP).
"""A small scraper for sites behind Cloudflare that reads each answer and stops when told no."""
import email.utils
import logging
import math
import re
import time
from datetime import datetime, timezone
from enum import Enum
from urllib.parse import urlsplit
from urllib.robotparser import RobotFileParser

import requests

BOT_NAME = "NorthwindCatalogBot"
USER_AGENT = f"{BOT_NAME}/1.0 (+https://example.com/bot)"
PROXY = "http://user:pass@pr.proxynet.io:8000"  # a fixed exit IP the owner allowlisted, or None
EXPECT = 'data-sku="'  # a marker every real product page contains
MIN_DELAY = 5.0        # seconds between two requests to the same host
MAX_WAIT = 300         # never sleep longer than this before one retry
MAX_RETRIES = 3        # retries after a 429 or 5xx before we give up on the host
BLOCK_CODES = {"1005", "1006", "1007", "1008", "1009", "1010", "1020", "1106"}

log = logging.getLogger(BOT_NAME)


class Verdict(Enum):
    OK = "ok"
    NOT_MODIFIED = "not_modified"
    CHALLENGE = "challenge"
    BLOCKED = "blocked"
    RATE_LIMITED = "rate_limited"
    PAYMENT_REQUIRED = "payment_required"
    SUSPICIOUS_200 = "suspicious_200"
    SERVER_ERROR = "server_error"
    OTHER = "other"


STOP = {Verdict.CHALLENGE, Verdict.BLOCKED, Verdict.PAYMENT_REQUIRED}
RETRY = {Verdict.RATE_LIMITED, Verdict.SERVER_ERROR}


class StopHost(Exception):
    """The site said no. We leave this host alone for the rest of the run."""


def page_text(resp):
    """The start of the body with the HTML tags removed."""
    return re.sub(r"<[^>]+>", " ", resp.text[:20000])


def cloudflare_code(resp):
    """The 1xxx code of a Cloudflare error response, or None.

    Cloudflare sends it as a branded HTML page ("Error 1020") or as a short
    text body ("error code: 1020") together with a "Server: cloudflare" header.
    """
    text = page_text(resp)
    from_cloudflare = resp.headers.get("Server", "").lower() == "cloudflare"
    short_form = from_cloudflare and text.lstrip().lower().startswith("error code:")
    if not short_form and "cloudflare" not in text.lower():
        return None
    match = re.search(r"(?i)\berror(?:\s+code)?:?\s+(1\d{3})\b", text)
    return match.group(1) if match else None


def classify(resp, expect=EXPECT):
    if resp.headers.get("cf-mitigated") == "challenge":
        return Verdict.CHALLENGE, "Cloudflare challenge page"
    status = resp.status_code
    if status == 304:
        return Verdict.NOT_MODIFIED, "unchanged since the last visit"
    if status == 402:
        return Verdict.PAYMENT_REQUIRED, "402 with crawler-price" if "crawler-price" in resp.headers else "402"
    code = cloudflare_code(resp) if status >= 400 else None
    if status == 429 or code == "1015":
        return Verdict.RATE_LIMITED, f"HTTP {status}, error {code}" if code else f"HTTP {status}"
    if code in BLOCK_CODES or status == 403:
        text = page_text(resp).lower()
        if code:
            why = f"Cloudflare error {code}"
        elif "cloudflare" in text and "ray id" in text:
            why = "Cloudflare block page without a code"  # a WAF rule
        else:
            why = "403 from the origin server"
        return Verdict.BLOCKED, why
    if status >= 500:
        return Verdict.SERVER_ERROR, f"HTTP {status}"
    if status == 200 and expect and expect not in resp.text:
        why = "Turnstile form, no data" if "cf-turnstile" in resp.text else "expected content missing"
        return Verdict.SUSPICIOUS_200, why
    if status == 200:
        return Verdict.OK, "expected content found" if expect else "HTTP 200"
    return Verdict.OTHER, f"HTTP {status}"


def wait_seconds(resp, attempt):
    """Retry-After in either RFC 9110 form, else a doubling backoff. Whole seconds, capped."""
    value = resp.headers.get("Retry-After", "").strip()
    wait = 30 * 2**attempt
    if value.isdigit():
        wait = int(value)
    elif value:
        try:
            when = email.utils.parsedate_to_datetime(value)
            if when.tzinfo is None:
                when = when.replace(tzinfo=timezone.utc)
            wait = (when - datetime.now(timezone.utc)).total_seconds()
        except (TypeError, ValueError):
            pass
    return min(max(math.ceil(wait), 1), MAX_WAIT)


class PoliteFetcher:
    def __init__(self, proxy=PROXY):
        self.session = requests.Session()
        self.session.headers["User-Agent"] = USER_AGENT
        if proxy:
            self.session.proxies = {"http": proxy, "https": proxy}
        self.robots, self.delay, self.last, self.cache = {}, {}, {}, {}

    def get(self, url, headers=None, expect=EXPECT):
        host = urlsplit(url).netloc
        for attempt in range(MAX_RETRIES + 1):
            pause = self.delay.get(host, MIN_DELAY) - (time.monotonic() - self.last.get(host, -1e9))
            if pause > 0:
                time.sleep(pause)
            resp = self.session.get(url, headers=headers, timeout=20)
            self.last[host] = time.monotonic()
            if resp.status_code == 407:
                raise requests.exceptions.ProxyError("the proxy rejected the credentials (407)")
            verdict, why = classify(resp, expect)
            if verdict in STOP:
                ray = resp.headers.get("cf-ray", "none")
                log.error("STOP %s: %s, %s (cf-ray %s)", url, verdict.value, why, ray)
                raise StopHost(host)
            if verdict not in RETRY:
                return resp, verdict, why
            if attempt < MAX_RETRIES:
                wait = wait_seconds(resp, attempt)
                log.warning("%s %s: %s, waiting at least %d s", verdict.value, url, why, wait)
                time.sleep(wait)
        log.error("STOP %s: still %s after %d retries", url, verdict.value, MAX_RETRIES)
        raise StopHost(host)

    def allowed(self, url):
        parts = urlsplit(url)
        host = parts.netloc
        if host not in self.robots:
            try:
                resp, _, _ = self.get(f"{parts.scheme}://{host}/robots.txt", expect=None)
            except requests.RequestException as exc:
                log.error("STOP %s: robots.txt unreachable (%s)", host, exc)
                raise StopHost(host) from exc
            parser = RobotFileParser()
            parser.parse(resp.text.splitlines() if resp.status_code == 200 else [])
            self.robots[host] = parser
            # urllib.robotparser reads whole seconds only: "Crawl-delay: 1.5" is ignored
            self.delay[host] = max(MIN_DELAY, parser.crawl_delay(BOT_NAME) or 0)
        return self.robots[host].can_fetch(BOT_NAME, url)

    def fetch(self, url):
        """Page HTML, or None when the page should be skipped."""
        if not self.allowed(url):
            log.info("skip %s: disallowed by robots.txt", url)
            return None
        validators, body = self.cache.get(url, ({}, None))
        resp, verdict, why = self.get(url, headers=validators)
        log.log(logging.INFO if verdict in (Verdict.OK, Verdict.NOT_MODIFIED) else logging.WARNING,
                "%s %s: %s", verdict.value, url, why)
        if verdict is Verdict.NOT_MODIFIED:
            return body
        if verdict is not Verdict.OK:
            return None
        saved = {}
        if "ETag" in resp.headers:
            saved["If-None-Match"] = resp.headers["ETag"]
        if "Last-Modified" in resp.headers:
            saved["If-Modified-Since"] = resp.headers["Last-Modified"]
        self.cache[url] = (saved, resp.text)
        return resp.text


def crawl(urls, proxy=PROXY):
    fetcher, stopped, pages = PoliteFetcher(proxy), set(), {}
    for url in urls:
        host = urlsplit(url).netloc
        if host in stopped:
            log.info("skip %s: host stopped earlier", url)
            continue
        try:
            html = fetcher.fetch(url)
        except StopHost:
            stopped.add(host)
            continue
        except requests.RequestException as exc:
            log.warning("network error %s: %s", url, exc)
            continue
        if html is not None:
            pages[url] = html
    return pages


if __name__ == "__main__":
    logging.basicConfig(level=logging.INFO, format="%(levelname)-7s %(message)s")
    found = crawl([
        "https://www.example.com/products/1001",
        "https://www.example.com/products/1002",
    ])
    print(f"{len(found)} pages saved")
تابع classify() نخست cf-mitigated را بررسی میکند، سپس 402 و 429 را، و بعد در هر دو شکل دنبال کد 1xxx میگردد. 403 بدون کد وقتی صفحه مسدودی Cloudflare شمرده میشود که بدنه نام Cloudflare را بیاورد و Ray ID نشان دهد. برای 200 نتیجه فقط وقتی ok است که نشانگر EXPECT در صفحه باشد؛ پس نشانگری انتخاب کنید که در صفحه چالش، صفحه خالیای که محتوایش را JavaScript میسازد یا صفحه تله پیدا نشود، مانند ویژگی HTML که شناسه محصول را نگه میدارد.
خروجی چه شکلی دارد؟
اسکریپت را با Python 3.13 و Requests 2.34.2 از راه یک پروکسی HTTP محلی روی هشت سایت آزمایشی محلی اجرا کردیم؛ هر سایت یکی از انواع پاسخ را برمیگرداند. برای این اجرا دو نشانی نمونه در __main__ را با صفحههایی از همین سایتها عوض کردیم. سایتهای آزمایشی فقط نشانههای مستند را بازسازی میکنند و Ray IDها را هم خود همین سایتها ساختهاند.
INFO    ok http://127.0.0.1:28150/products/1001: expected content found
INFO    not_modified http://127.0.0.1:28150/products/1001: unchanged since the last visit
INFO    skip http://127.0.0.1:28150/cart: disallowed by robots.txt
WARNING rate_limited http://127.0.0.1:28150/products/1002: HTTP 429, waiting at least 2 s
INFO    ok http://127.0.0.1:28150/products/1002: expected content found
WARNING rate_limited http://127.0.0.1:28150/products/1003: HTTP 429, waiting at least 3 s
INFO    ok http://127.0.0.1:28150/products/1003: expected content found
WARNING suspicious_200 http://127.0.0.1:28150/products/1004: expected content missing
WARNING suspicious_200 http://127.0.0.1:28150/products/1005: Turnstile form, no data
ERROR   STOP http://127.0.0.1:28151/products/1: challenge, Cloudflare challenge page (cf-ray 8f3c2a9d1b7e28151-IST)
INFO    skip http://127.0.0.1:28151/products/2: host stopped earlier
ERROR   STOP http://127.0.0.1:28152/products/1: blocked, Cloudflare error 1020 (cf-ray 8f3c2a9d1b7e28152-IST)
ERROR   STOP http://127.0.0.1:28153/products/1: blocked, Cloudflare block page without a code (cf-ray 8f3c2a9d1b7e28153-IST)
ERROR   STOP http://127.0.0.1:28154/products/1: blocked, Cloudflare error 1006 (cf-ray 8f3c2a9d1b7e28154-IST)
ERROR   STOP http://127.0.0.1:28155/products/1: payment_required, 402 with crawler-price (cf-ray 8f3c2a9d1b7e28155-IST)
ERROR   STOP http://127.0.0.1:28156/robots.txt: challenge, Cloudflare challenge page (cf-ray 8f3c2a9d1b7e28156-IST)
INFO    skip http://127.0.0.1:28156/products/2: host stopped earlier
WARNING rate_limited http://127.0.0.1:28157/products/1: HTTP 429, waiting at least 1 s
WARNING rate_limited http://127.0.0.1:28157/products/1: HTTP 429, waiting at least 1 s
WARNING rate_limited http://127.0.0.1:28157/products/1: HTTP 429, waiting at least 1 s
ERROR   STOP http://127.0.0.1:28157/products/1: still rate_limited after 3 retries
3 pages saved
صفحه نخست ok است، با اینکه اسکریپتی را از /cdn-cgi/challenge-platform/ بارگذاری میکند. در بازدید دوم سرور با 304 پاسخ میدهد و robots.txt اسکریپت را از /cart دور نگه میدارد. هر دو پاسخ 429 هدر Retry-After داشتند، یک بار به ثانیه و یک بار به شکل تاریخ. در لاگ عبارت «at least» (دستکم) آمده است، چون فاصلهای که برای هر میزبان رعایت میشود میتواند فاصله واقعی میان دو درخواست را بیشتر کند. دو صفحه 200 ذخیره نشدند، شش میزبان بعدی در نخستین صفحه یا در robots.txt متوقف شدند و آخرین میزبان پس از سه تلاش دوباره کنار گذاشته شد.
این اسکریپت یک کاستی دارد: صاحب سایت میتواند برای محدودیت نرخ کد وضعیت و بدنه دلخواهی تعیین کند که 1015 در آن نباشد. در این حالت اسکریپت blocked یا other ثبت میکند، پس هر دو نتیجه را زیر نظر داشته باشید.
کاربردها
- رصد قیمت: درخواستهای شرطی بررسی روزانه را کمهزینه نگه میدارند و
suspicious_200تغییر قالب صفحه را نشان میدهد (رصد قیمت). - تحقیقات بازار: دادههای تنوع محصول و موجودی از فروشگاههای فراوان، که هر کدام با نرخ خودش بازدید میشود (تحقیقات بازار).
- بررسیهای سئو: ببینید تنظیمات Cloudflare خودتان خزندههایی را که میخواهید به سایت دسترسی داشته باشند با چالش روبهرو میکند یا نه (پروکسی سئو).
- حفاظت از برند: جستوجو در مارکتپلیسها برای یافتن آگهیهای تقلبی، با اسکریپتی که با دیدن هر چالشی متوقف میشود (حفاظت از برند).
- خزندههای عمومی: نمایه یا آرشیوی که پیش از نخستین خزش برای وضعیت ربات تأییدشده درخواست میدهد (خزنده وب).
- گردآوری عمومی داده: داده تمیز، همراه با گزارشی از صفحههایی که اسکریپت به آنها نرسید (استخراج داده).
اشتباهات رایج
- تکرار درخواست در یک حلقه پس از گرفتن
403. پاسخ همان میماند و خود این رگبار درخواستها شبیه رفتار ربات است. - تلاش دوباره سریع پس از Error 1015 یا نادیده گرفتن
Retry-After. Cloudflare هشدار میدهد که تلاشهای پیاپی در زمانی کوتاه میتوانند مسدودی را طولانیتر کنند (429 Too Many Requests). - چرخاندن IP در هر درخواست به یک سایت. فرستادن درخواست با همان سرعت از آدرسهای تازه یعنی نادیده گرفتن سقفی که صاحب سایت گذاشته است؛ محدودیتهایی هم که بهازای کوکی یا اثر انگشت شمرده میشوند صفر نمیشوند (وب اسکرپینگ بدون مسدود شدن).
- جعل Googlebot. Google به صاحبان سایت میگوید Googlebot را با جستوجوی DNS معکوس و مستقیم یا با بازههای IP منتشرشدهاش تأیید کنند و رشته Googlebot که از IP دیگری بیاید از هیچکدام از این دو آزمون نمیگذرد.
- اعتماد به هر
200. صفحههای خالیای که محتوایشان را JavaScript میسازد، فرمهای Turnstile و صفحههای تله همگی200برمیگردانند. AI Labyrinth در Cloudflare خزندههایی را که پیوندهای پنهانش را دنبال میکنند، بیآنکه مسدودشان کند، به هزارتویی از صفحهها میکشاند. - کپی کردن
cf_clearanceدر اسکریپت. این کوکی به دستگاهی که برایش صادر شده وابسته است. - اسکرپینگ صفحههای پشت ورود به حسابی که متعلق به شما نیست. حساب و داده خودتان یک موضوع است (نشست و کوکی در Python)؛ صفحههایی که سایت به روی شما باز نکرده موضوعی دیگر.
- پول دادن به سرویس حل کپچا. چالشهای Cloudflare معمای تصویری نیستند؛ بررسیها درون مرورگر اجرا میشوند و سرویس حلکننده تصمیم صاحب سایت را دور میزند.
راهنمای انتخاب
| وضعیت شما | چه کنید |
|---|---|
| سایت API یا خوراک داده دارد | از آن استفاده کنید، حتی اگر اسکرپ کردن HTML سادهتر به نظر برسد |
| از یک سایت چند صفحه لازم دارید | به صاحب سایت بنویسید: نام ربات، مسیرها، نرخ |
| صاحب سایت پذیرفته است که به شما اجازه دهد | همه ترافیک را از یک IP ثابت بفرستید |
| یک خزنده عمومی اجرا میکنید | برای وضعیت ربات تأییدشده درخواست بدهید |
| خزنده یا عامل هوش مصنوعی میسازید | سطرهای Content-Signal را بخوانید؛ 402 را قیمت بدانید |
| داده با JavaScript ساخته میشود | درخواست JSON را پیدا کنید؛ Playwright را فقط جایی به کار ببرید که مجاز است |
| قیمتهای یک کشور را لازم دارید | از پروکسی همان کشور با همان نرخ استفاده کنید |
اسکریپت شما هر روز 429 میگیرد | نرخ را پایین بیاورید؛ IP اضافه نکنید |
| اسکریپت شما به صفحه چالش یا مسدودی میرسد | خزش آن میزبان را متوقف کنید؛ یکی از راههای بالا را انتخاب کنید |
| سایت Cloudflare خودتان را پایش میکنید | با یک قاعده IP Access به IP ابزار پایش اجازه دهید |
پرسشهای متداول
آیا Python Requests میتواند سایتی را که پشت Cloudflare است اسکرپ کند؟
بله، به شرطی که تنظیمات صاحب سایت درخواست را عبور دهد. اگر سایت با چالش پاسخ دهد، Requests نمیتواند از آن بگذرد، چون هر چالش Cloudflare به JavaScript و کوکی نیاز دارد. در این حالت از API سایت استفاده کنید، از صاحب سایت دسترسی بخواهید یا متوقف شوید.
آیا اسکرپ کردن سایتی که Cloudflare از آن محافظت میکند قانونی است؟
این متن مشاوره حقوقی نیست. پاسخ به کشور، شرایط استفاده سایت، شخصی بودن یا نبودن داده و شیوه استفاده شما از آن بستگی دارد. چالش نشانه روشنی از خواست صاحب سایت است؛ دور زدن آن این نشانه را نادیده میگیرد و معمولاً شرایط استفاده سایت را زیر پا میگذارد. وضعیت کشورهای مختلف را در نوشته قانونی بودن اسکرپینگ وب آوردهایم.
کوکی cf_clearance چیست؟
cf_clearance کوکیای است که مرورگر پس از گذشتن از چالش Cloudflare دریافت میکند تا درخواستهای بعدی بدون چالش تازه به مبدأ برسند. عمر آن به تنظیم Challenge Passage صاحب سایت بستگی دارد (بهطور پیشفرض 30 دقیقه) و به بازدیدکننده و دستگاه وابسته است. اگر نشست مشکوک به نظر برسد، Precursor میتواند آن را زودتر باطل کند.
آیا با پروکسی مسکونی میتوان از Cloudflare گذشت؟
نه، و کار پروکسی هم این نیست. پروکسی آدرس IP و شبکه شما را تغییر میدهد، اما چالش همچنان JavaScript لازم دارد، دستدادن TLS شما همان میماند و ممنوعیتی که روی کلاینت شما گذاشته شده همچنان اعمال میشود. از پروکسی مسکونی برای دیدن صفحه به همان شکلی استفاده کنید که بازدیدکنندگان یک کشور آن را میبینند، با نرخی که سایت میپذیرد.
خزنده من چگونه در Cloudflare تأیید میشود؟
برای خزنده نام اختصاصی بگذارید و یکی از روشهای اثبات هویت در راه 3 را به کار ببرید: امضای Web Bot Auth، یا فهرست منتشرشدهای از آدرسهای IP که فقط همین خزنده از آنها استفاده میکند. خزنده را طوری بسازید که از robots.txt و crawl-delay پیروی کند، سپس از راه فرم رباتهای تأییدشده در پنل Cloudflare درخواست بدهید.
چرا اسکرپر من روی لپتاپ کار میکند اما روی سرور نه؟
لپتاپ شما از خط اینترنت خانه یا محل کار استفاده میکند و سرور از شبکه یک شرکت میزبانی. صاحبان سایت میتوانند کل یک شبکه را با ASN آن ممنوع کنند (Error 1005) و اعتبار آدرس هم در امتیاز ربات اثر دارد؛ به همین دلیل همان اسکریپت ممکن است از یکی عبور کند و روی دیگری با چالش روبهرو شود. از صاحب سایت بخواهید به IP ثابت سرور اجازه دهد، یا از API رسمی استفاده کنید.
خلاصه
اسکرپر Cloudflare وقتی مسدود میشود که تنظیمات صاحب سایت درخواست را پیش از رسیدن به مبدأ متوقف کند. پیش از تغییر هر چیزی پاسخ را بخوانید. هدر cf-mitigated: challenge یعنی چالش، بیشتر کدهای خطای Cloudflare و صفحه مسدودی قاعدههای صاحب سایتاند، 429 یا Error 1015 محدودیت نرخ است، 402 قیمت است و 200 فقط وقتی حساب میشود که محتوای شما در آن باشد. سپس راهی را انتخاب کنید که ماندگار باشد: API رسمی، اجازه صاحب سایت برای یک IP ثابت، وضعیت ربات تأییدشده، یا مرورگر واقعی فقط جایی که رندر لازم است. برای کارهایی که کشور یا آدرس ثابت در آنها مهم است، گزینهها را در صفحه خدمات پروکسی ما مقایسه کنید.