میخواهید فهرست قیمت یک تأمینکننده، نام و قیمت دویست محصول یک کتابفروشی اینترنتی یا جدولی را که یک سازمان هر هفته بهروز میکند به فایل خودتان بیاورید. نخستین فکر، کپی و چسباندن است. برای ده سطر جواب میدهد، برای هزار سطر یک بعدازظهر کامل وقت میگیرد. هر کس «استخراج داده از وبسایت» را جستوجو میکند دنبال یک چیز است: راهی که این کار را با دست انجام ندهد.
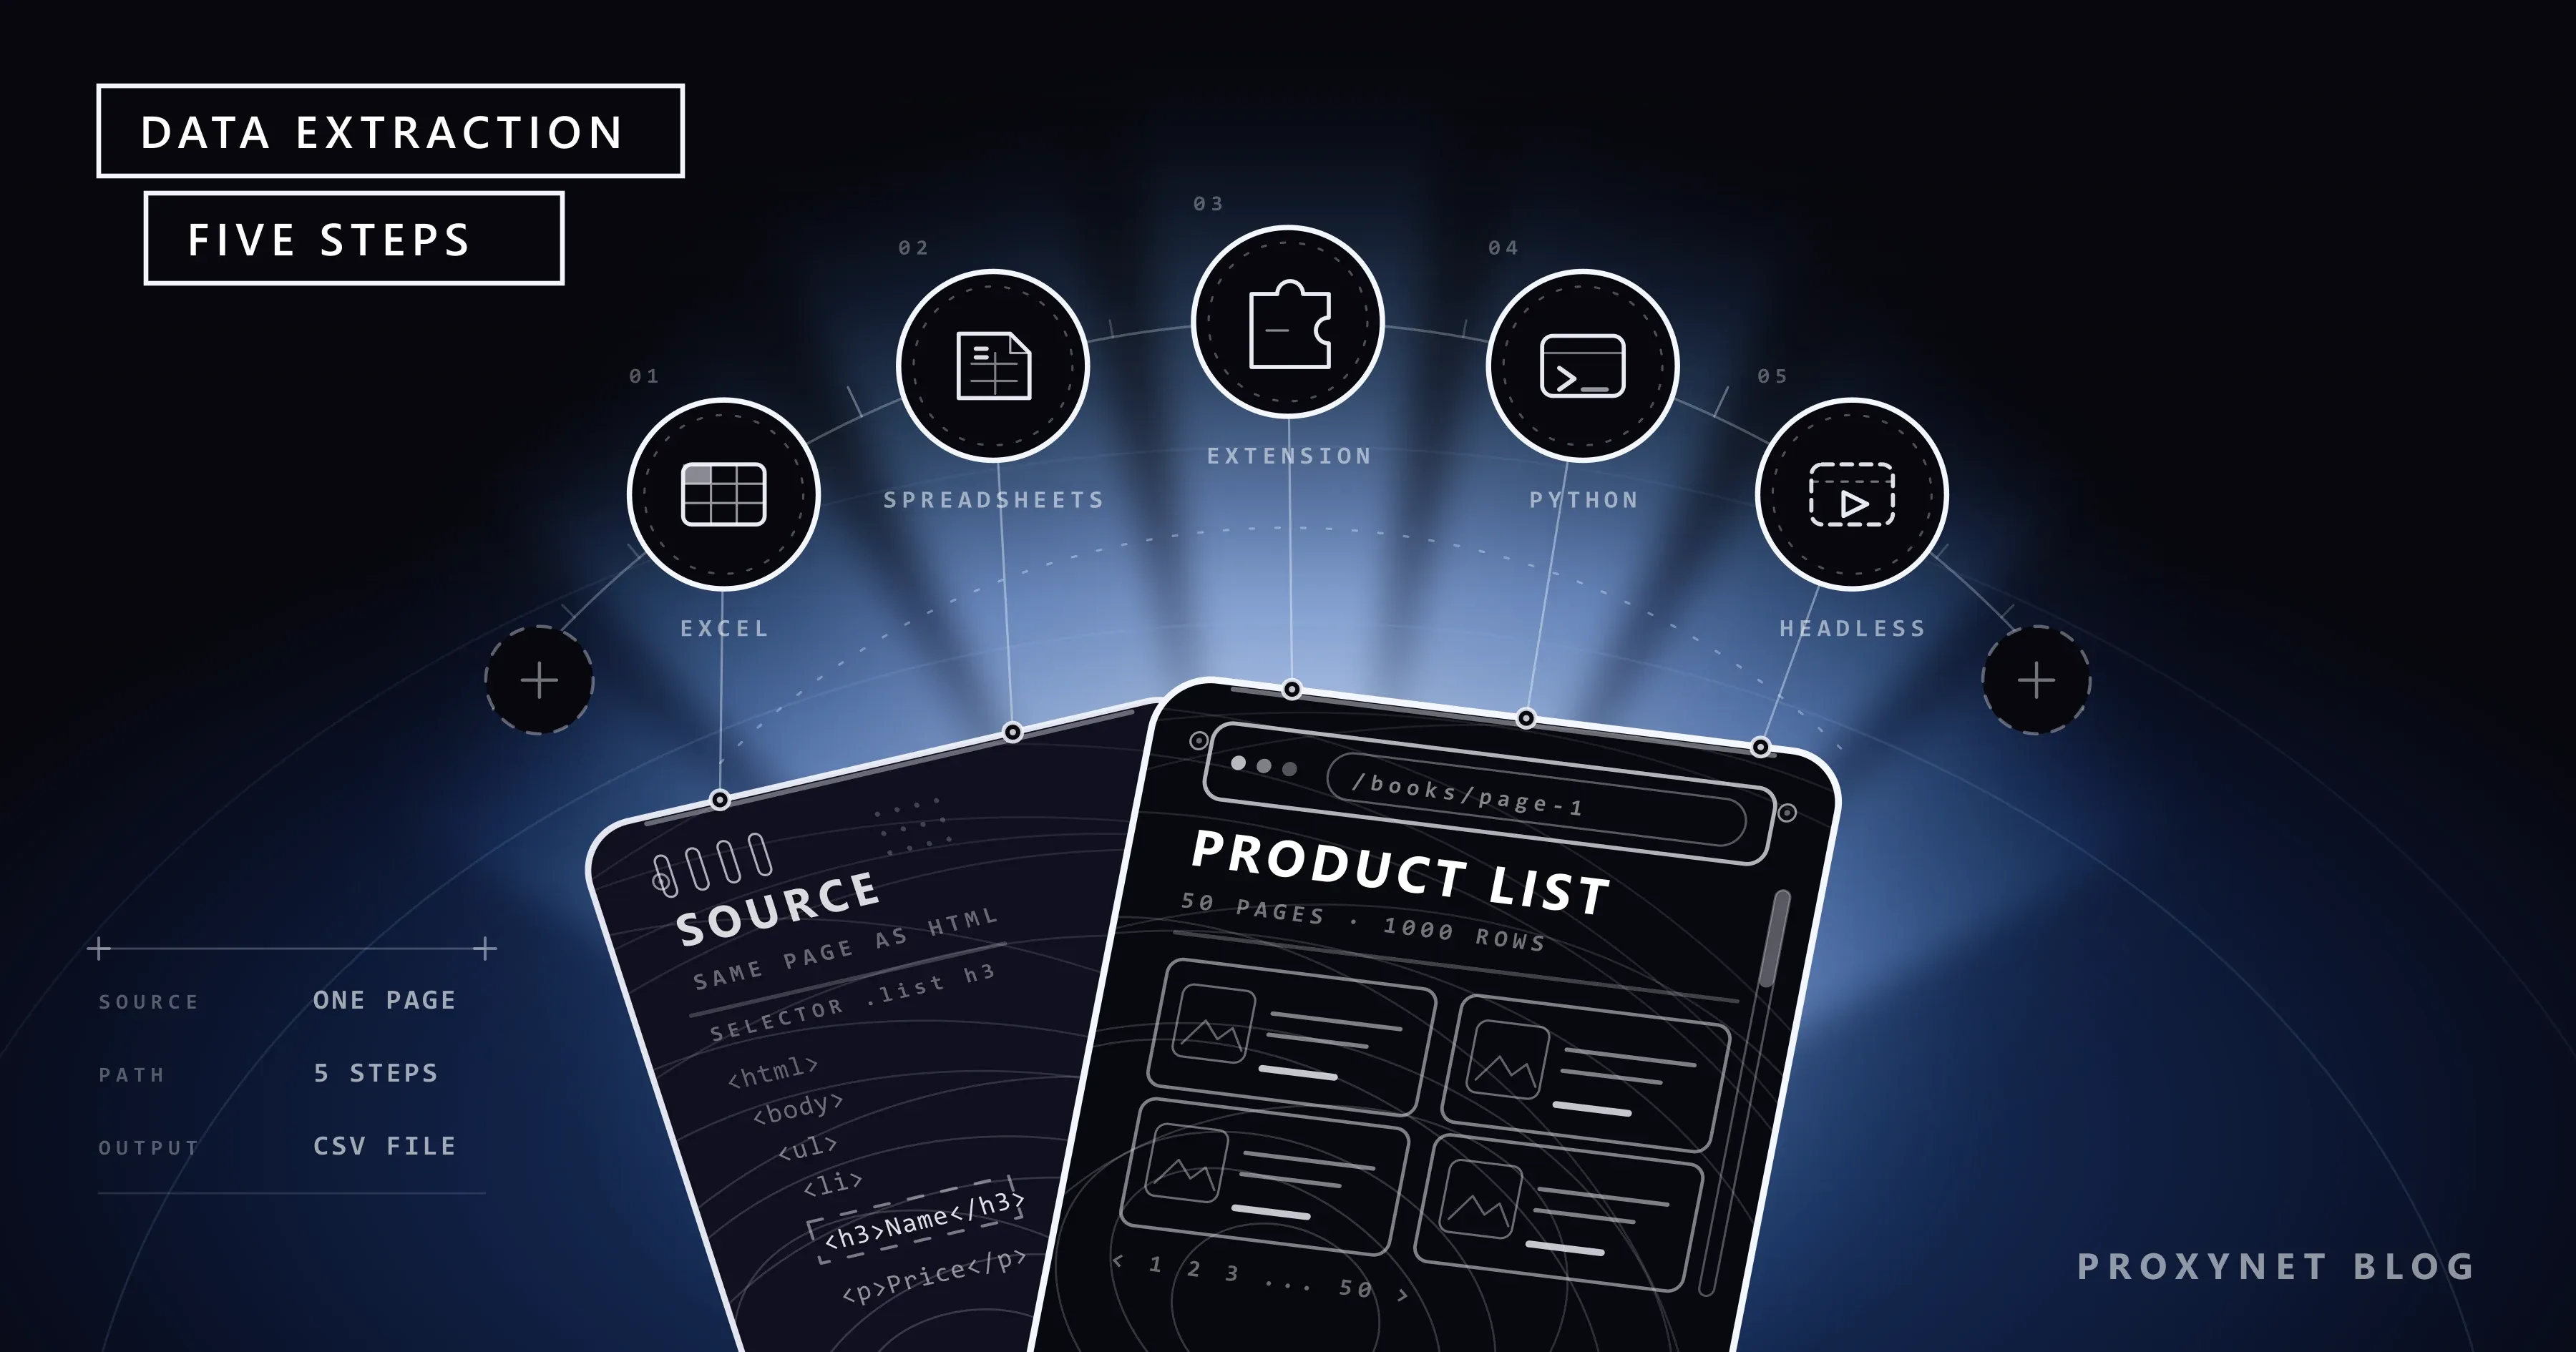
یک راه واحد وجود ندارد، چون روش درست به این بستگی دارد که چند صفحه لازم دارید، صفحه چگونه ساخته شده و کار را هر چند وقت یک بار تکرار میکنید. در این نوشته روشها را مانند پلههای یک نردبان میچینیم: قابلیت From Web در Excel، فرمولهای Google Sheets، افزونههای مرورگر و ابزارهای بدون کد، پایتون با Requests و BeautifulSoup و در بالاترین پله مرورگر headless. در هر پله میگوییم برای چه کاری کافی است، کجا گیر میکند و پروکسی در کدام پله وارد ماجرا میشود. نمونههای پایتون این نوشته را روی یک سایت تمرینی اجرا کردهایم.
استخراج داده از وبسایت یعنی چه؟
استخراج داده از وبسایت یعنی تبدیل اطلاعاتی که برای چشم انسان چیده شده (نام محصول، قیمت، تاریخ، نشانی) به فایلی از سطرها و ستونها. نام فنی این کار وب اسکرپینگ است؛ در ادامه نوشته کوتاه میگوییم «اسکرپینگ» یا «استخراج داده». جزئیات تعریف و اینکه در هر نوع کار کدام پروکسی به کار میرود در صفحه راهحل استخراج داده آمده است. موضوع این نوشته تعریف نیست، انتخاب روش است.
سه مفهومی را که اغلب با هم اشتباه گرفته میشوند از آغاز جدا کنیم:
- خزش (crawling): یافتن اینکه در یک سایت چه صفحههایی هست، یعنی تهیه فهرست آدرسها. کار موتورهای جستوجو همین است. جزئیات در صفحه خزنده وب آمده است.
- استخراج (scraping): بیرون کشیدن فیلدهای مشخص از صفحهای که آدرسش معلوم است. خزش آدرسها را میدهد، استخراج اطلاعات درون آن آدرسها را.
- API: درگاه رسمیای که سایت داده را از پیش بهصورت ساختیافته (بیشتر JSON) عرضه میکند. اگر API هست، نیازی به تجزیه صفحه نیست.
پیش از استخراج: آیا API یا دکمه دانلود وجود دارد؟
ارزانترین استخراج داده همان است که هرگز انجام نمیشود. پیش از انتخاب روش به این سه جا نگاه کنید:
- API رسمی. بازارگاههای اینترنتی به فروشندگانشان و نهادهای عمومی به پژوهشگران API میدهند. برای نمونه بانک مرکزی اروپا نرخهای مرجع یورو و دیگر سریهایش را در ECB Data Portal هم با رابط کاربری و هم با وبسرویس منتشر میکند. برای جدول نرخ ارز، بهجای تجزیه یک سایت خبری به خود منبع بروید.
- دکمه دانلود. شمار صفحههایی که زیر جدولشان پیوند «خروجی Excel» یا «دانلود CSV» دارند بیشتر از آن است که گمان میرود. درگاههای داده مراکز آمار اینگونه کار میکنند.
- درخواست داده خود صفحه. برخی صفحهها محتوا را در پسزمینه از یک آدرس JSON میگیرند. راه یافتن این آدرس را گام به گام در صفحههای ایستا و پویا نشان دادهایم.
اگر هیچکدام نبود نوبت استخراج میرسد، اما با چهار قاعده. فقط داده عمومی که ورود به حساب نمیخواهد گردآوری میشود. فایل robots.txt و شرایط استفاده سایت خوانده میشود؛ سایتهای آگهی، نتایج زنده ورزشی و شبکههای اجتماعی که در شرایطشان گردآوری خودکار را آشکارا ممنوع کردهاند هدف روشهای این نوشته نیستند. نام، شماره تلفن و ایمیل داده شخصیاند و قوانینی مانند GDPR از آنها حفاظت میکنند؛ استدلال «در صفحه جلوی چشم بود» چیزی را عوض نمیکند. چارچوب حقوقی را در آیا اسکرپینگ وب قانونی است؟ گرد آوردهایم. قاعده آخر سرعت است: سایت نباید به خاطر شما کند شود.
به همین دلیل همه نمونههای این نوشته روی books.toscrape.com اجرا میشوند که برای تمرین اسکرپینگ ساخته شده است. سایت خودش را «سایت نمایشی برای اهداف وب اسکرپینگ» معرفی میکند؛ قیمتها و امتیازها تصادفی تعیین شدهاند.
یک درخواست چگونه به داده تبدیل میشود؟
چه Excel به کار ببرید چه پایتون بنویسید، در پسزمینه همان شش گام اجرا میشود. تفاوت روشها در این است که چند تا از این گامها را بهجای شما انجام میدهند.
- درخواست فرستاده میشود. ابزار مانند مرورگر یک درخواست HTTP به آدرس صفحه میفرستد.
- پاسخ میرسد. سرور یک کد وضعیت و HTML صفحه را برمیگرداند. معنای کدهای غیر از
200در نوشته کدهای وضعیت HTTP آمده است. - HTML تجزیه میشود. متن ساده به درختی از تگهای تودرتو تبدیل میشود.
- فیلدها انتخاب میشوند. قاعدهای مانند «عنوان و قیمت درون هر کارت محصول» نوشته میشود. زبان این قاعده انتخابگر CSS یا XPath است؛ تفاوتشان را در انتخابگر CSS یا XPath مقایسه کردهایم.
- سطرها ذخیره میشوند. فیلدهای انتخابشده در یک جدول، فایل CSV یا پایگاه داده نوشته میشوند.
- به صفحه بعد میرود. اگر فهرست در چند صفحه پخش باشد، گامهای 1 تا 5 برای هر صفحه تکرار میشود.
Excel و Google Sheets همه این گامها را با یک کلیک انجام میدهند، اما در گام چهارم گزینههایشان محدود است. ابزارهای بدون کد میگذارند آن گام را با موس توصیف کنید. در پایتون هر شش گام در دست شماست.
روشهای استخراج داده در کنار هم
| پله | روش | کد لازم است؟ | چه زمانی کافی است؟ | کجا گیر میکند؟ |
|---|---|---|---|---|
| 1 | Excel، مسیر Data > From Web | نه | صفحه جدول HTML دارد و داده در Excel پردازش میشود | صفحههای با چیدمان کارتی، ورود با فرم، فهرستهای چندصفحهای |
| 2 | Google Sheets، فرمولهای IMPORTHTML و IMPORTXML | فرمول | یک صفحه که باید در جدولی مشترک بهروز بماند | محتوایی که با جاوااسکریپت پر میشود، صفحه نیازمند ورود، شمار زیاد فرمول |
| 3 | افزونه مرورگر یا ابزار بدون کد | نه | چیدمان کارتی، چند صد سطر، کار یکباره | تکرار منظم، حجم بزرگ، دستورالعملی که با تغییر طراحی سایت خراب میشود |
| 4 | پایتون، Requests و BeautifulSoup | بله | دهها یا هزاران صفحه، اجرای زمانبندیشده، قالب دلخواه | محتوایی که بعداً با جاوااسکریپت پر میشود |
| 5 | مرورگر headless (Playwright) | بله | محتوا فقط در مرورگر ساخته میشود | سرعت و منابع: برای هر صفحه یک مرورگر واقعی اجرا میشود |
نردبان را از پایین به بالا بروید. اگر پله پایینتر کارتان را راه میاندازد، رفتن به پله بالاتر فقط بار نگهداری میآورد.
پله 1: گرفتن داده از وبسایت با Excel
Excel برای این کار قابلیتی درونی دارد و بیشتر کاربران از آن بیخبرند. Excel رابط فارسی رسمی ندارد، پس نام منوها را به انگلیسی میآوریم. گامهای صفحه پشتیبانی مایکروسافت چنین است: در زبانه Data و بخش Get & Transform دکمه From Web را میزنید، آدرس صفحه را میچسبانید و OK را انتخاب میکنید. Excel جدولهای صفحه را مییابد و در پنل Navigator فهرست میکند. وقتی جدول دلخواه را برگزینید و Load را بزنید، داده به کاربرگ میآید. اتصال در فایل میماند؛ هفته بعد همان گامها را تکرار نمیکنید، فقط کوئری را تازه میکنید. زبانه Web View در Navigator خود صفحه را نشان میدهد و جدولهای شناساییشده را پررنگ میکند.
جاهایی که گیر میکند هم روشن است. این قابلیت با جدولهایی راحتتر کار میکند که در HTML واقعاً با تگ <table> ساخته شده باشند. در صفحه اصلی سایت تمرینی ما حتی یک تگ جدول نیست و کتابها بهصورت کارت چیده شدهاند؛ در چنین صفحههایی ممکن است Navigator جدولی را که میخواهید پیشنهاد ندهد و فقط دکمه Add table using examples بماند که با نوشتن مقدارهای نمونه ستونها را توصیف میکنید. بر پایه مستندات کانکتور در Microsoft Learn نوعهای احراز هویت پشتیبانیشده اینها هستند: ناشناس، Windows، پایه (نام کاربری و گذرواژه)، کلید Web API و حساب سازمانی. پر کردن فرم ورود و باز کردن نشست در این فهرست نیست. پیمودن صفحه به صفحه یک فهرست پنجاهصفحهای هم در Excel شدنی است اما عملی نیست؛ در آن نقطه باید به پله چهارم رفت.
پله 2: فرمولهای IMPORTHTML و IMPORTXML در Google Sheets
Google Sheets همین کار را با فرمول انجام میدهد. IMPORTHTML جدول یا فهرست یک صفحه را و IMPORTXML هر عنصری را که با XPath توصیف کنید در سلولها میریزد. صفحه راهنمای این دو تابع به فارسی ترجمه نشده است. در جدولی با تنظیم منطقهای ایالات متحده، آرگومانها با ویرگول انگلیسی جدا میشوند:
=IMPORTHTML("https://en.wikipedia.org/wiki/Demographics_of_India", "table", 4)
=IMPORTXML("https://books.toscrape.com/", "//article[@class='product_pod']/h3/a/@title")
فرمول نخست نمونه مستندات خود گوگل است: چهارمین جدول صفحه را میآورد و شمارش از 1 آغاز میشود. آرگومان دوم فقط "table" یا "list" میپذیرد. اگر تنظیم منطقهای جدول شما جداکننده اعشار را ویرگول بداند، آرگومانها بهجای آن با نقطهویرگول جدا میشوند و وقتی فرمول خطای تجزیه میدهد نخستین جایی که باید ببینید همینجاست. عبارت XPath فرمول دوم را روی HTML سایت تمرینی آزمودهایم؛ عنوان بیست کتاب صفحه اصلی را برمیگرداند. به همین دلیل در صفحهای با چیدمان کارتی، توصیف عنصر با XPath بهجای گشتن دنبال جدول جواب میدهد.
این پله سه محدودیت دارد. فرمول روی سرورهای گوگل اجرا میشود و درخواست را رایانه شما نمیفرستد. پس صفحهای را که در آن وارد حساب شدهاید، پنلی در شبکه شرکتتان یا نشست مرورگرتان را نمیبیند. فرمول HTML خام صفحه را میخواند؛ اگر محتوا بعداً با جاوااسکریپت پر شود، در سلول نتیجه خالی یا خطا میآید. محدودیت سوم مقیاس است: زمان تازهسازی فرمولها را شما تعیین نمیکنید و گذاشتن صدها فرمول درونریزی در یک فایل جدول را سنگین میکند. برای جدولی تکصفحهای که یک تیم با هم نگاهش میکند مناسب است، نه برای کاتالوگی با هزار محصول.
پله 3: برنامههای استخراج داده و افزونههای مرورگر
ابزارهایی که با جستوجوی «برنامه استخراج داده» یا «وب اسکرپینگ بدون کدنویسی» پیدا میشوند سه دستهاند:
- افزونههای مرورگر. در صفحه باز روی یک کارت محصول و سپس روی عنوان و قیمت کلیک میکنید؛ افزونه همه کارتهای دارای همان الگو را مییابد و بهصورت فایل CSV یا Excel دانلود میکند. چون درخواست از مرورگر خودتان بیرون میرود، افزونه صفحه را همانگونه میبیند که شما میبینید.
- ابزارهای بدون کد دسکتاپی و ابری. به همان منطق توصیف با کلیک، صفحهبندی، زمانبندی و اجرا در ابر را میافزایند. بیشترشان لایه رایگان دارند؛ حد آن را در صفحه قیمت خود ابزار بررسی کنید.
- ابزارهای گردش کار. استخراج داده را حلقهای از یک زنجیره میکنند: صفحه را بگیر، فیلد را جدا کن، در جدول بنویس، اگر تغییری بود اعلان بفرست. نمونهای از این دسته را در نوشته وب اسکرپینگ با n8n ساختهایم.
در کارهای یکباره چند صد سطری این ابزارها زودتر از پایتون نتیجه میدهند. جایی که گیر میکنند در کار پیوسته پیدا میشود. دستورالعمل بر پایه طراحی همان روز صفحه ضبط میشود؛ وقتی سایت نام یک کلاس را عوض کند، ابزار بیصدا ستون خالی میسازد و فهمیدنش با شماست. در ابزارهای ابری، داده گردآوریشده و اطلاعات حسابی که شاید وارد کرده باشید از سرور شرکت سومی میگذرد؛ هنگام انتخاب ابزار این را در نظر بگیرید.
پله 4: استخراج داده از سایت با پایتون
رایجترین زوج در پایتون کتابخانههای Requests و BeautifulSoup هستند. Requests صفحه را دانلود میکند، BeautifulSoup هم HTML را تجزیه میکند و میگذارد فیلدها را با انتخابگر CSS برگزینید. نصب یک خط است:
pip install requests beautifulsoup4اسکریپت زیر سه صفحه نخست سایت تمرینی را میپیماید، عنوان، قیمت، وضعیت موجودی و آدرس هر کتاب را گرد میآورد و نتیجه را در فایل CSV مینویسد که Excel مستقیم بازش میکند. وقتی آن را با Python 3.13 اجرا کردیم، فایل 60 کتاب را بدون مشکل ساخت.
import csv
import os
import time
from urllib.parse import urljoin

import requests
from bs4 import BeautifulSoup

START_URL = "https://books.toscrape.com/"
MAX_PAGES = 3          # three pages are enough for practice
DELAY = 2              # seconds between two requests

# If you need a proxy: PROXY_URL=http://user:pass@pr.proxynet.io:8000
proxy = os.environ.get("PROXY_URL")

session = requests.Session()
session.headers["User-Agent"] = "book-price-test/1.0 (contact: you@example.com)"
if proxy:
    session.proxies = {"http": proxy, "https": proxy}

rows = []
url = START_URL
for page in range(MAX_PAGES):
    response = session.get(url, timeout=20)
    response.raise_for_status()
    response.encoding = "utf-8"
    soup = BeautifulSoup(response.text, "html.parser")

    for card in soup.select("article.product_pod"):
        rows.append({
            "title": card.select_one("h3 a")["title"],
            "price": card.select_one("p.price_color").get_text(strip=True),
            "stock": card.select_one("p.instock").get_text(strip=True),
            "url": urljoin(url, card.select_one("h3 a")["href"]),
        })

    next_link = soup.select_one("li.next a")
    if next_link is None:
        break
    url = urljoin(url, next_link["href"])
    time.sleep(DELAY)

if not rows:
    raise SystemExit("No products found: the selectors may have changed or the page may be filled in by JavaScript.")

# utf-8-sig: Excel shows non-ASCII characters correctly when it opens the file
with open("books.csv", "w", newline="", encoding="utf-8-sig") as f:
    writer = csv.DictWriter(f, fieldnames=rows[0].keys())
    writer.writeheader()
    writer.writerows(rows)

print(f"{len(rows)} rows written to books.csv")
در این اسکریپت چهار تصمیم هست که ابزارهای بدون کد به شما واگذار نمیکنند. خط User-Agent میگوید شما که هستید و چگونه میتوان با شما تماس گرفت؛ بهجای هویت جعلی مرورگر، نام صادقانه یک ربات را به کار ببرید. DELAY میان دو درخواست مکث میگذارد. raise_for_status() با دیدن کد خطا اسکریپت را نگه میدارد تا محتوای صفحه مسدودشده بهعنوان داده در فایلتان نوشته نشود. بررسی if not rows در پایان هم چاره مشکل ستون خالی بیصدایی است که در پله سوم گفتیم: اگر انتخابگر چیزی نگیرد، اسکریپت این را با صدای بلند میگوید.
از اینجا به بعد مسیر بر پایه بزرگی کار شاخه میشود. برای صف خزشی که بتواند پنجاه صفحه را از همانجا که مانده ادامه دهد نوشته پیمایش فهرستهای صفحهبندیشده، برای صفحههایی که ورود با حساب خودتان میخواهند مدیریت نشست و کوکی در پایتون و برای کارهای منظم چند صد صفحهای نوشته Scrapy را ببینید. اگر تیم شما پایتون نمینویسد، همین منطق را میتوانید با PHP، با C# یا با جاوااسکریپت بسازید؛ روش به زبان وابسته نیست.
در بخش ذخیرهسازی، برای کار یکباره CSV کافی است. اگر کار تکرار میشود، فایلی که بازنویسی میشود تاریخچه تغییر را از میان میبرد؛ ساختاری که به هر سطر تاریخ میافزاید و در SQLite مینویسد در نوشته پایش قیمت رقبا و تحلیل داده گردآوریشده در دادهکاوی آمده است.
پله 5: مرورگر headless وقتی صفحه با جاوااسکریپت پر میشود
سازندگان همان سایت صفحه تمرینی دیگری هم دارند که با جاوااسکریپت پر میشود. وقتی این صفحه را با Requests دانلود کردیم و در آن دنبال کادرهای نقلقول گشتیم، نتیجه صفر بود: کادرها در HTML نیستند و پس از اجرای اسکریپت در مرورگر ساخته میشوند. پله دوم و چهارم درست همینجا گیر میکنند.
مرورگر headless مرورگری واقعی است که پنجره ندارد. صفحه را باز میکند، جاوااسکریپت را اجرا میکند و شما داده را از صفحه ساختهشده میخوانید. با Playwright همان صفحه اینگونه خوانده میشود (پس از pip install playwright و playwright install chromium):
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch()
    page = browser.new_page()
    page.goto("https://quotes.toscrape.com/js/")
    page.wait_for_selector("div.quote")          # wait until the element appears
    for quote in page.locator("div.quote").all():
        text = quote.locator("span.text").inner_text()
        author = quote.locator("small.author").inner_text()
        print(author, "-", text[:60])
    browser.close()
بهای این پله منابع است: برای هر صفحه یک زبانه مرورگر باز میشود و تصویرها و اسکریپتها دانلود میشوند. به همین دلیل مرورگر headless آخرین پله است. در بیشتر صفحههای پویا، یافتن آدرس JSON که داده از آن میآید راه ارزانتری است؛ تصمیم میان این دو و راهبردهای انتظار را در صفحههای ایستا و پویا و تعریف پروکسی برای مرورگر را در نوشته Playwright و پروکسی مییابید.
پروکسی در کدام پله وارد میشود؟
در سه پله نخست پروکسی بیشتر بیرون از بحث است. فرمول Google Sheets از سرور گوگل بیرون میرود و نمیتوانید چیزی در میانه بگذارید. Excel و افزونه مرورگر اتصال خود رایانه شما را به کار میبرند؛ برای کاری چندصفحهای به چیز دیگری هم نیاز نیست.
پروکسی در پله چهارم و پنجم و در سه وضعیت مشخص مطرح میشود:
- محتوا بر پایه کشور تغییر میکند. اگر فروشگاهی به بازدیدکننده آلمان یک قیمت و به بازدیدکننده Türkiye قیمت دیگری نشان دهد، داده درست را فقط اتصالی میبیند که از همان کشور بیرون میرود. پروکسی مسکونی با هدفگیری مکانی برای همین کار است؛ صورتحسابش بر پایه GB است و قیمت پایه کنونی $ 1.50 است.
- کار بزرگ شده است. گرفتن هزاران صفحه در زمانی معقول و بدون خسته کردن سایت مقصد یعنی درخواستها نباید روی یک آدرس انباشته شوند. پروکسی چرخشی بار را میان مخزنی از آدرسها پخش میکند. سازوکارش را در نوشته چرخش IP توضیح دادهایم.
- نشست لازم است. اگر با حساب خودتان وارد میشوید و چند صفحه را میگردید، باید در طول نشست روی همان IP بمانید؛ برای این کار پروکسی با نشست ثابت به کار میرود.
آنچه پروکسی انجام نمیدهد را هم باید گفت. محدودیت نرخ شیوه یک سایت برای گفتن «همینقدر بس است» است و مانعی نیست که با عوض کردن IP از آن بگذرید، نشانهای است که باید رعایتش کنید؛ معنای پاسخ 429 را در نوشته 429 Too Many Requests باز کردهایم. فهرست تشخیص دلیلهای مسدود شدن در وب اسکرپینگ بدون مسدود شدن آمده است.
برای به کار بردن پروکسی در اسکریپت لازم نیست کد را عوض کنید. وقتی به متغیر PROXY_URL آدرسی به شکل http://user:pass@pr.proxynet.io:8000 بدهید، همه درخواستها از آن میگذرند. نمونه را با یک پروکسی آزمایشی محلی آزمودیم: با اطلاعات ورود درست صفحهها آمدند و با گذرواژه نادرست، Requests یک ProxyError دارای 407 Proxy Authentication Required پرتاب کرد. Requests متغیر محیطی HTTPS_PROXY را هم خودش میخواند؛ جزئیات این متغیرها در استفاده از پروکسی در wget آمده است.
کاربردها
- پایش قیمت و موجودی: گردآوری منظم قیمتهای عمومی صفحههای رقبا برای دنبال کردن جایگاه محصولات خودتان در بازار. ساختار راهحل در صفحه پایش قیمت آمده است.
- تحقیقات بازار: شاخصهای کلی مانند شمار محصولات یک دسته، بازه قیمت و توزیع برندها. جزئیات در صفحه تحقیقات بازار آمده است.
- بازبینی کاتالوگ و محتوا: گشتن دنبال توضیح ناقص، پیوند شکسته یا قیمت نادرست در هزاران صفحه سایت خودتان. در سایت خودتان مسئله اجازه وجود ندارد و برای نخستین آزمایشها هم امنترین هدف همانجاست.
اشتباهات رایج
- تجزیه صفحه بدون نگاه کردن به API. کلنجار رفتن با HTML در حالی که منبع رسمی هست، کاری میسازد که با هر تغییر طراحی خراب میشود.
- آغاز نردبان از بالاترین پله. راه انداختن مرورگر headless برای یک جدول HTML ساده کار را کند و نگهداریاش را دشوار میکند.
- نتیجه خالی را داده پنداشتن. وقتی انتخابگر چیزی نمیگیرد، بیشتر ابزارها خطا نمیدهند و ستون خالی میدهند. در هر اجرا شمار سطرها را بررسی کنید.
- نوشتن حلقه بدون مکث. اسکریپتی که در ثانیه دهها درخواست میفرستد نخست
429و سپس مسدودی ماندگار میگیرد و میتواند یک سایت کوچک را واقعاً کند کند. - گردآوری داده شخصی به این بهانه که «جلوی چشم است». نام نویسندگان نظرها و شماره تلفن آگهیدهندگان داده شخصی است. به اطلاعات قیمت و محصول بسنده کنید.
راهنمای انتخاب
| نیاز | روش |
|---|---|
| سایت API یا دکمه «دانلود CSV» دارد | از همان استفاده کنید، استخراج نکنید |
| جدولی مرتب در یک صفحه، داده در Excel پردازش میشود | Excel، مسیر Data > From Web |
| چند صد سطر در چیدمان کارتی، یکباره | افزونه مرورگر یا IMPORTXML |
| دهها صفحه، اجرای زمانبندیشده، قالب فایل دلخواه | پایتون، Requests و BeautifulSoup |
| صدها یا هزاران صفحه، خزش منظم | Scrapy و پروکسی چرخشی که بار را پخش میکند |
| محتوا فقط در مرورگر ساخته میشود و آدرس JSON پیدا نمیشود | مرورگر headless (Playwright) |
| داده بر پایه کشور تغییر میکند | پایتون یا Playwright با پروکسی مسکونی دارای هدفگیری مکانی |
| داده پشت صفحه ورود است و حساب مال شما نیست | استخراج نکنید؛ از صاحب سایت اجازه یا API بخواهید |
پرسشهای متداول
آیا بدون کدنویسی میتوان از وبسایت داده استخراج کرد؟
بله. اگر صفحه جدول HTML دارد، قابلیت From Web در Excel و فرمول IMPORTHTML در Google Sheets و در صفحههای با چیدمان کارتی، افزونههای مرورگر و ابزارهای بدون کد این کار را انجام میدهند. وقتی صدها صفحه، تکرار هرروزه و بررسی خطا لازم شود، کد نوشتن زحمت کمتری دارد.
آیا برنامه رایگان برای استخراج داده وجود دارد؟
اگر Excel یا یک حساب گوگل دارید، دو پله نخست هزینه اضافهای ندارد. پایتون و کتابخانههای نامبرده در این نوشته متنبازند. بیشتر ابزارهای بدون کد لایه رایگان دارند؛ حد آن را در صفحه خود ابزار بررسی کنید. از پیوندهای «دانلود برنامه» با منبع نامعلوم دور بمانید و افزونه را از فروشگاه رسمی مرورگرتان نصب کنید.
آیا استخراج داده از وبسایت قانونی است؟
گردآوری داده عمومی و غیرشخصی با سرعتی معقول در بیشتر نظامهای حقوقی بهتنهایی ممنوع نیست؛ اما شرایط استفاده سایت، حق نشر و در دادههای شخصی قوانینی مانند GDPR نتیجه را تغییر میدهند. این نوشته مشاوره حقوقی نیست. چارچوب را در آیا اسکرپینگ وب قانونی است؟ توضیح دادهایم؛ در پروژه تجاری با یک حقوقدان مشورت کنید.
چرا Excel داده صفحه را نمیبیند؟
رایجترین دلیل این است که داده بهجای جدول HTML بهصورت کارت یا فهرست ساخته شده است؛ ممکن است Navigator جدولی را که میخواهید پیشنهاد ندهد. دلیل دوم این است که صفحه ورود به حساب میخواهد و دلیل سوم اینکه محتوا بعداً با جاوااسکریپت بارگذاری میشود. در حالت نخست IMPORTXML یا افزونه مرورگر و در حالتهای دیگر پلههای پایتون راهحل هستند.
آیا برای استخراج داده باید پایتون آموخت؟
نه. روش به زبان وابسته نیست: درخواست بفرست، HTML را تجزیه کن، فیلد را برگزین، ذخیره کن. با هر زبانی که تیمتان میداند آغاز کنید. مقایسه دو زبان پرکاربرد در اسکرپینگ وب: JavaScript یا Python؟ آمده است.
هنگام استخراج داده چه زمانی پروکسی لازم است؟
در کاری کمسرعت با چند صد صفحه و از یک کشور لازم نیست. وقتی محتوا بر پایه کشور تغییر میکند، وقتی کار به هزاران صفحه رسیده و باید بار پخش شود یا وقتی باید IP در نشستی که وارد حساب شدهاید ثابت بماند، لازم است. پروکسی ابزار نادیده گرفتن محدودیت نرخی که سایت گذاشته نیست.
خلاصه
استخراج داده از وبسایت پنج پله دارد و پله درست، پایینترین پلهای است که کارتان را راه میاندازد. نخست دنبال API یا دکمه دانلود بگردید. برای جدول مرتب Excel یا Google Sheets، برای کارهای یکباره در چیدمان کارتی افزونه و ابزارهای بدون کد، برای کارهای تکرارشونده و رو به رشد پایتون و فقط برای محتوایی که در مرورگر ساخته میشود مرورگر headless به کار میرود. در هر پلهای که هستید فقط داده عمومی را با سرعت کم و با رعایت قواعد سایت گردآوری کنید. وقتی کار آنقدر بزرگ شد که به هدفگیری کشور یا پخش بار نیاز داشت، نوعهای مناسب پروکسی را در خدمات پروکسی ما مییابید.