


































O script que você escreveu com Requests e BeautifulSoup roda sem problemas em cem páginas. Quando chega a dez mil, o trabalho muda: você precisa controlar qual endereço já foi rastreado, qual deu erro e será tentado de novo, quantas requisições vão ao mesmo site ao mesmo tempo e onde os dados serão gravados. O Scrapy é um framework Python que traz tudo isso pronto. A configuração de proxy também fica dentro dessa estrutura, em uma das camadas por onde toda requisição passa.
Neste artigo mostramos primeiro, de forma breve, o que é o Scrapy e como instalá-lo. Depois vamos ao assunto principal: as três formas de definir um proxy, a autenticação, a diferença entre um gateway rotativo com um único endpoint e a sua própria lista de proxies, o controle de velocidade com DOWNLOAD_DELAY e AutoThrottle, e o comportamento do Scrapy diante das respostas 429 e 503. Executamos todos os exemplos com Scrapy 2.19 e Python 3.13, nos sites de prática do toscrape.com e em um proxy de teste local.
O que é Scrapy e para que serve?
O Scrapy é um framework Python escrito para rastrear sites e extrair dados estruturados das páginas. A diferença em relação a uma biblioteca é esta: o Requests entrega uma ferramenta para enviar uma requisição, e o laço é você quem monta. No Scrapy, o laço é o próprio framework. Você só escreve uma classe que diz de qual endereço começar e o que retirar da página recebida; essa classe se chama spider.
Tudo o que fica fora do spider já vem pronto: um agendador que coloca as requisições na fila, um filtro de duplicatas que não pede o mesmo endereço duas vezes, um downloader assíncrono, novas tentativas, verificação do robots.txt, limite de velocidade e exportação para JSON ou CSV. Nos seletores, CSS e XPath são usados lado a lado; explicamos a diferença em Seletor CSS ou XPath. O mapa geral das ferramentas em Python e JavaScript está em Extração de dados: JavaScript ou Python?.
Como instalar o Scrapy?
Instale o Scrapy em um ambiente virtual próprio do projeto, e não no Python do sistema. No Windows, os comandos são:
python -m venv venv
venv\Scripts\activate
pip install scrapy
scrapy startproject kitaplik
cd kitaplik
scrapy genspider kitaplar books.toscrape.com
No macOS e no Linux, a segunda linha passa a ser source venv/bin/activate. O comando startproject gera um esqueleto com settings.py, middlewares.py e a pasta spiders/. O arquivo settings.py do modelo atual já traz três configurações: ROBOTSTXT_OBEY = True, CONCURRENT_REQUESTS_PER_DOMAIN = 1 e DOWNLOAD_DELAY = 1. Ou seja, um projeto novo respeita o robots.txt por padrão e envia cerca de uma requisição por segundo ao mesmo site. Não apague essas linhas; construa as suas configurações sobre elas.
Preencha o arquivo criado pelo genspider como abaixo. O spider lê os cartões dos livros e segue o link de "próxima página":
import scrapy


class KitaplarSpider(scrapy.Spider):
    name = "kitaplar"
    allowed_domains = ["books.toscrape.com"]
    start_urls = ["https://books.toscrape.com/"]

    def parse(self, response):
        for kart in response.css("article.product_pod"):
            yield {
                "baslik": kart.css("h3 a::attr(title)").get(),
                "fiyat": kart.css("p.price_color::text").get(),
                "adres": response.urljoin(kart.css("h3 a::attr(href)").get()),
            }

        sonraki = response.css("li.next a::attr(href)").get()
        if sonraki:
            yield response.follow(sonraki, callback=self.parse)
O comando scrapy crawl kitaplar -O kitaplar.json executa o spider e grava o resultado em um arquivo. No nosso teste vieram 40 registros das duas primeiras páginas. Mantenha a linha FEED_EXPORT_ENCODING = "utf-8" do modelo para que caracteres acentuados e símbolos de moeda não saiam corrompidos no arquivo.
Como o Scrapy processa uma requisição?
Para entender onde a configuração de proxy deve ficar, é preciso conhecer o caminho que a requisição percorre:
- O spider gera um objeto
Request(a partir destart_urlsou deresponse.follow). - O motor entrega a requisição ao agendador; o filtro de duplicatas descarta endereços já pedidos.
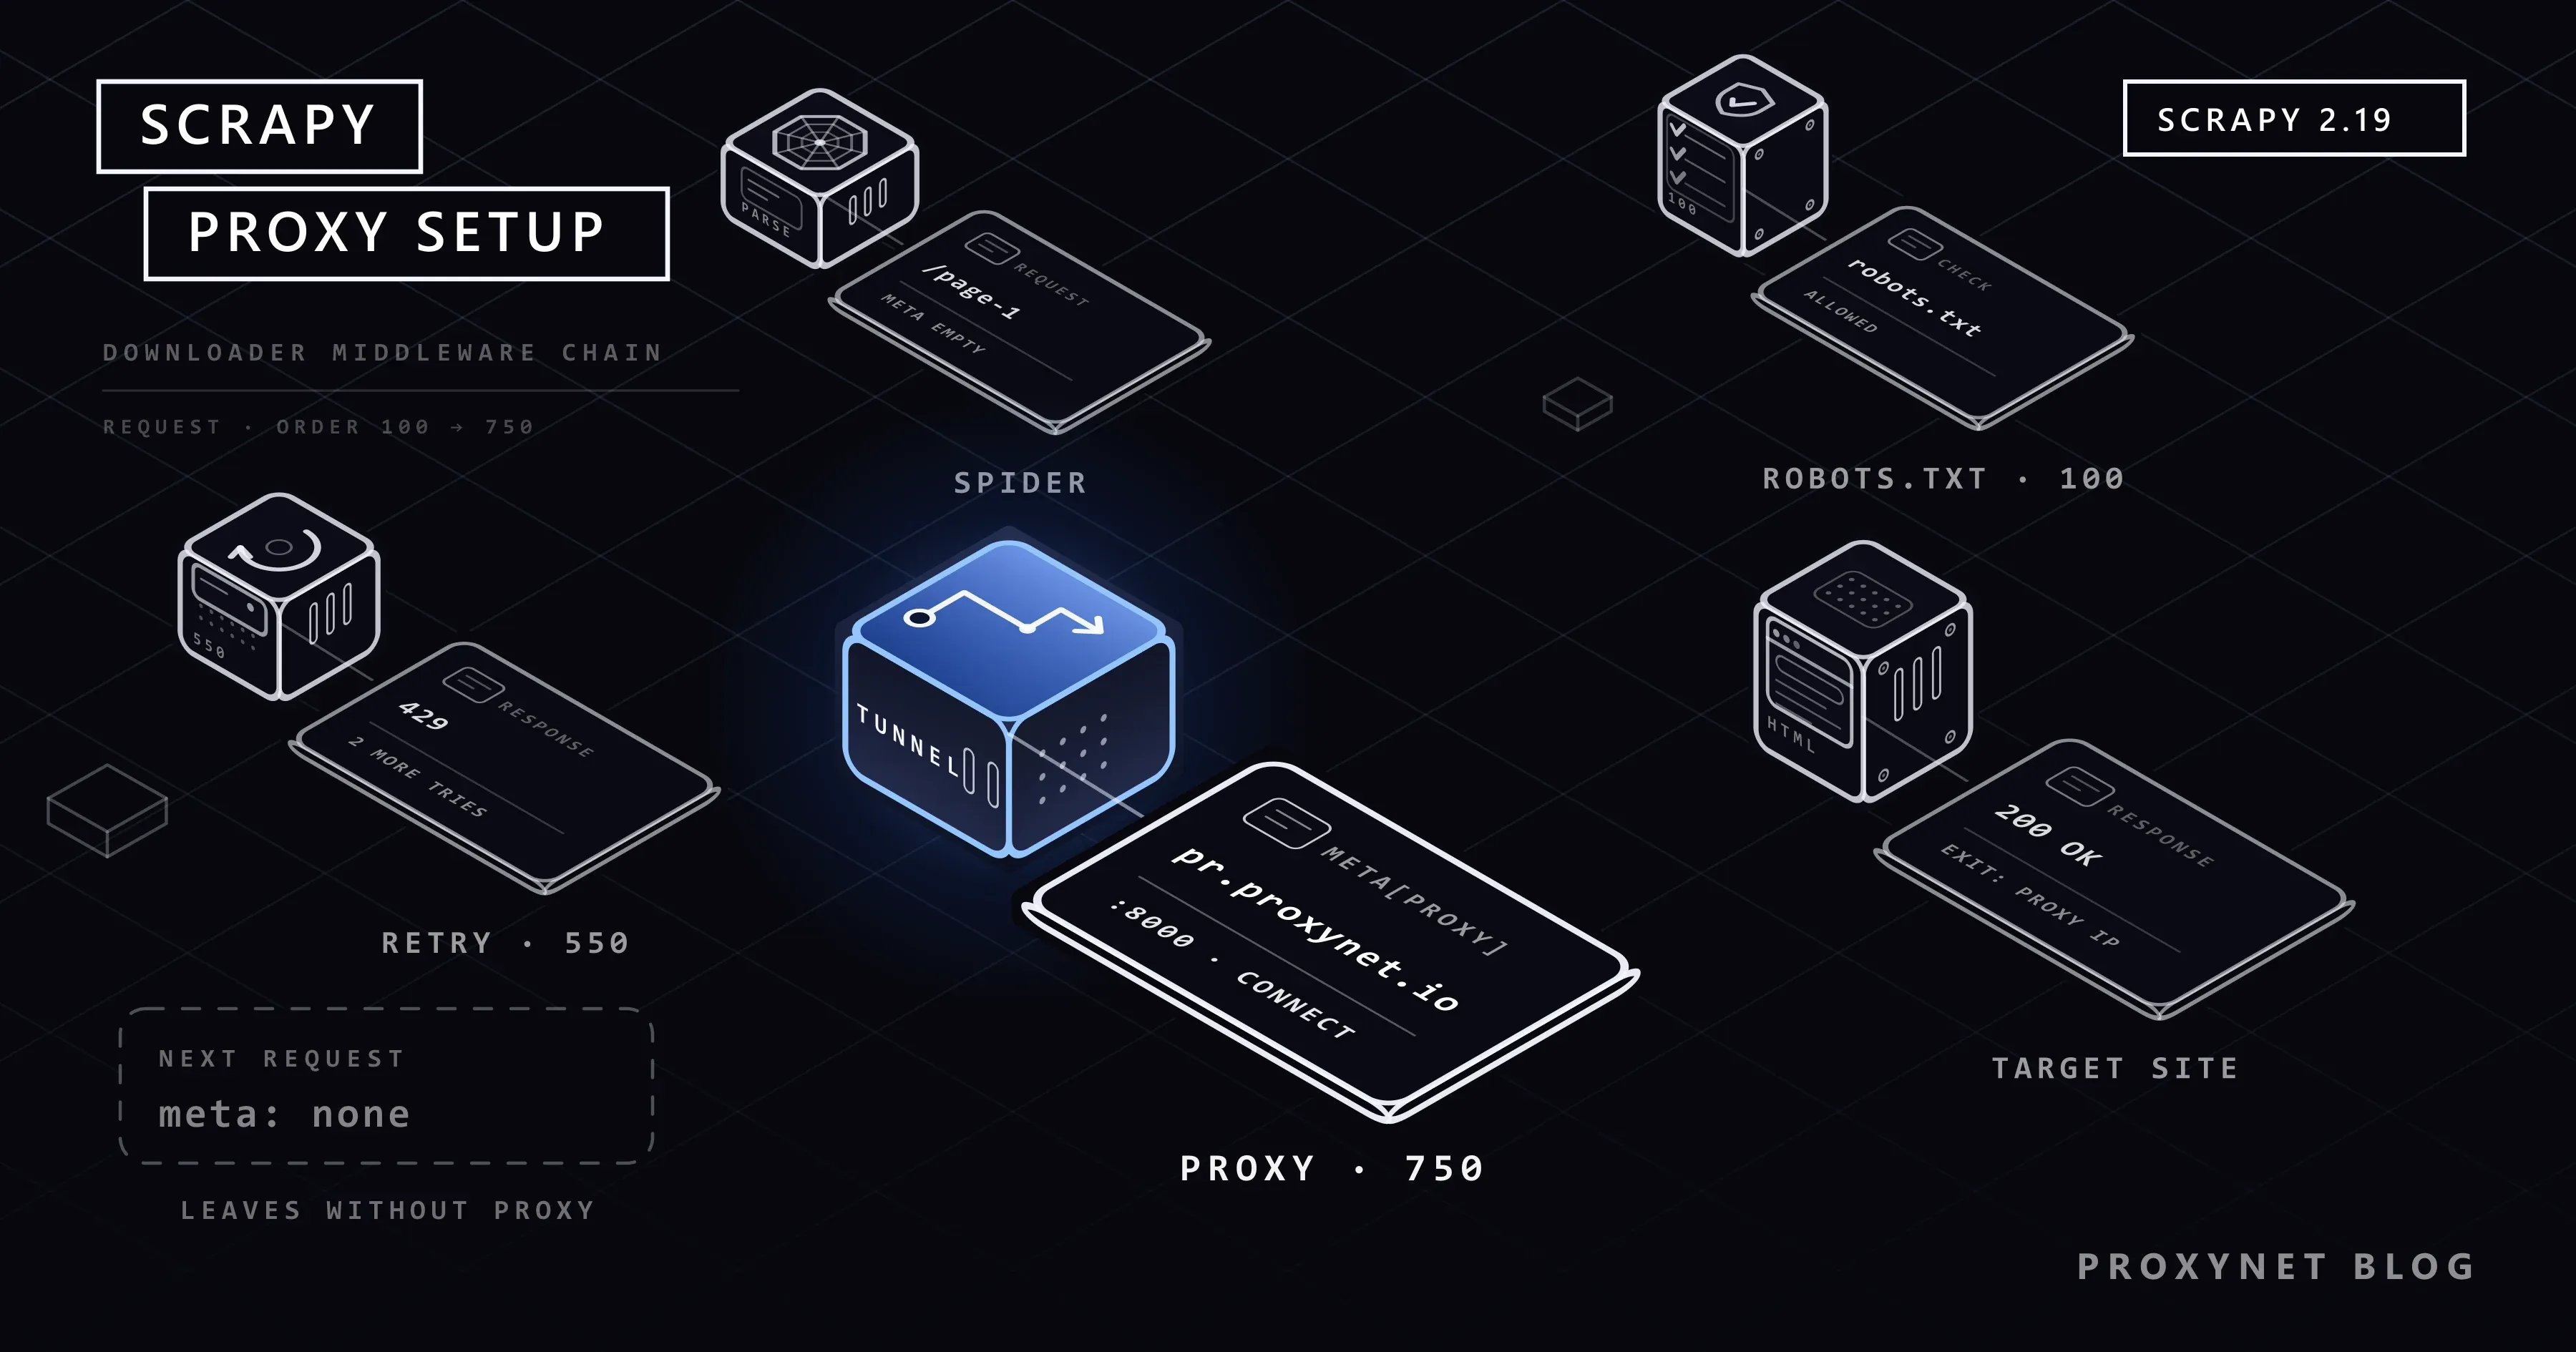
- Quando chega a sua vez, a requisição atravessa a cadeia de downloader middleware. Cada middleware tem um número de ordem, e a requisição avança do número menor para o maior: a verificação do robots.txt é 100, a nova tentativa é 550,
HttpProxyMiddlewareé 750. - O downloader envia a requisição à rede. Se ela tem
meta["proxy"], a conexão é aberta com o proxy, e não com o destino; em endereços HTTPS, um túnelCONNECTé estabelecido por meio do proxy. - A resposta volta pela mesma cadeia em ordem inversa e chega à função de callback do spider (
parse). - Os registros gerados pela função vão para o item pipeline, e as novas requisições voltam ao agendador.
A conclusão: o proxy pertence ao terceiro passo, não ao código de análise do spider. Seja quem for que preencha meta["proxy"], quem faz o trabalho é HttpProxyMiddleware. Esse middleware vem ativado por padrão; a seção HttpProxyMiddleware da documentação do Scrapy define o seu comportamento.
Como definir um proxy no Scrapy?
Há três formas, e as três acabam preenchendo o mesmo campo meta["proxy"].
| Método | Onde se escreve | Alcance | Quando convém |
|---|---|---|---|
meta["proxy"] | No spider, dentro de cada Request | Só aquela requisição | Enviar algumas requisições por outra saída |
| Variável de ambiente | No shell, http_proxy / https_proxy | Todas as requisições, inclusive robots.txt | Teste rápido, execução sem mexer no código |
| Downloader middleware | middlewares.py + settings.py | Todas as requisições, inclusive robots.txt | Configuração permanente do projeto, rotação |
Por requisição: o campo meta
import scrapy

PROXY = "http://user:pass@pr.proxynet.io:8000"


class KitaplarMetaSpider(scrapy.Spider):
    name = "kitaplar_meta"
    allowed_domains = ["books.toscrape.com"]

    async def start(self):
        yield scrapy.Request("https://books.toscrape.com/", meta={"proxy": PROXY})

    def parse(self, response):
        for kart in response.css("article.product_pod"):
            yield {"baslik": kart.css("h3 a::attr(title)").get()}

        sonraki = response.css("li.next a::attr(href)").get()
        if sonraki:
            # meta não passa sozinha para a nova requisição, é levada à mão
            yield response.follow(sonraki, callback=self.parse, meta={"proxy": PROXY})
Esse método tem duas consequências que passam despercebidas, e vimos as duas nos testes. A primeira: meta não é transmitida sozinha para a requisição seguinte. No teste em que não incluímos meta na chamada response.follow, a primeira página saiu pelo proxy e a segunda saiu direto do nosso próprio endereço IP. A segunda: a requisição de robots.txt do Scrapy não é uma requisição escrita por você, então não carrega meta e também sai sem proxy. Se você quer que todo o tráfego use a mesma saída, recorra a uma das duas formas a seguir.
Variável de ambiente
HttpProxyMiddleware lê, assim como a biblioteca padrão do Python, as variáveis http_proxy, https_proxy e no_proxy. Sem mudar nada no código:
export https_proxy="http://user:pass@pr.proxynet.io:8000"
export http_proxy="$https_proxy"
scrapy crawl kitaplar
Se uma requisição também tiver meta["proxy"], esse valor prevalece sobre a variável de ambiente e ignora a lista no_proxy. Como as variáveis são definidas no Windows, no macOS e no Linux, e a diferença entre maiúsculas e minúsculas, está explicado em Uso de proxy com o wget; não repetimos aqui.
Para o projeto inteiro: um middleware pequeno
Em uma configuração permanente, basta um middleware de poucas linhas que leia o endereço do ambiente em vez de embuti-lo no código:
# kitaplik/middlewares.py
from scrapy.exceptions import NotConfigured


class TekProxyMiddleware:
    """Aplica a todas as requisições o único endereço de proxy das configurações."""

    def __init__(self, adres):
        self.adres = adres

    @classmethod
    def from_crawler(cls, crawler):
        adres = crawler.settings.get("PROXY_ADRESI")
        if not adres:
            raise NotConfigured
        return cls(adres)

    def process_request(self, request):
        request.meta.setdefault("proxy", self.adres)
return None# kitaplik/settings.py
import os
PROXY_ADRESI = os.environ.get("PROXY_ADRESI")
DOWNLOADER_MIDDLEWARES = {
"kitaplik.middlewares.TekProxyMiddleware": 610,
}Graças ao setdefault, o meta["proxy"] que você escreveu à mão em uma requisição é preservado. Se PROXY_ADRESI não estiver definida, o middleware se desativa e o spider roda sem proxy. O número de ordem precisa ser menor que 750; assim você escreve o endereço primeiro e as credenciais são separadas depois por HttpProxyMiddleware. Em exemplos escritos para versões antigas, você verá a assinatura como process_request(self, request, spider); na documentação atual o parâmetro spider não existe, e o exemplo funciona desse jeito no Scrapy 2.19.
Como funciona a autenticação?
HttpProxyMiddleware separa a parte user:pass do endereço, codifica em Base64 e adiciona à requisição como cabeçalho Proxy-Authorization: Basic …. Em meta["proxy"] fica o endereço sem credenciais; você não verá a sua senha no log. Se a senha contiver @, : ou /, escreva com codificação percentual (%40 no lugar de @); o middleware decodifica o valor antes de enviar.
No teste com uma senha errada, o Scrapy escreveu esta linha:
TunnelError: Could not open CONNECT tunnel with proxy 127.0.0.1:8120 [{'status': 407, 'reason': b'Proxy Authentication Required'}]Em endereços HTTPS, o 407 não chega como resposta, e sim como exceção, porque o túnel não pôde ser aberto. Um ponto de atenção: o middleware de novas tentativas trata essa exceção como falha temporária e tenta a mesma requisição mais duas vezes. Senha errada não se corrige com repetição; se você vir TunnelError e 407 no log, pare o rastreamento e corrija as credenciais. Se, em vez de usuário e senha, você usa whitelist de IP, o endereço é escrito sem credenciais, na forma http://pr.proxynet.io:8000. A diferença entre os dois métodos está em Autenticação de proxy: user:pass ou whitelist de IP.
A rotação precisa de um middleware?
A resposta depende do tipo de proxy que você tem.
Com um gateway rotativo, não. Em um serviço de proxy rotativo você se conecta a um único endpoint e é o gateway que troca o IP de saída. Do lado do Scrapy, basta o TekProxyMiddleware acima ou uma única variável de ambiente; manter uma lista, escolher o próximo endereço e separar os que falham não é tarefa sua. Essa é a configuração típica nos rastreamentos feitos com Proxies residenciais. Como funcionam os modos de rotação está no nosso artigo sobre rotação de IP.
Se você tem uma lista de endereços fixos (por exemplo, alguns endereços de Proxies de datacenter ou de Proxies ISP), quem faz a distribuição é um middleware. O exemplo abaixo usa os endereços em sequência, deixa descansar por um tempo aquele que falha várias vezes seguidas e grava as contagens nas estatísticas do Scrapy:
# kitaplik/middlewares.py
import time
from urllib.parse import urlsplit

from scrapy.exceptions import IgnoreRequest, NotConfigured


def anahtar(proxy_adresi):
    parca = urlsplit(proxy_adresi)
    return f"{parca.hostname}:{parca.port}"


class ProxyHavuzuMiddleware:
    """Atribui a cada requisição o próximo proxy da lista e deixa descansar o que falha em sequência."""

    def __init__(self, adresler, hata_siniri, dinlenme, stats):
        self.adresler = adresler
        self.hata_siniri = hata_siniri
        self.dinlenme = dinlenme
        self.stats = stats
        self.sira = 0
        self.hatalar = {anahtar(a): 0 for a in adresler}
        self.kapali = {}  # chave -> momento em que volta a abrir

    @classmethod
    def from_crawler(cls, crawler):
        adresler = crawler.settings.getlist("PROXY_LISTESI")
        if not adresler:
            raise NotConfigured
        return cls(
            adresler,
            crawler.settings.getint("PROXY_HATA_SINIRI", 3),
            crawler.settings.getfloat("PROXY_DINLENME", 60.0),
            crawler.stats,
        )

    def sec(self):
        simdi = time.monotonic()
        for _ in self.adresler:
            adres = self.adresler[self.sira % len(self.adresler)]
            self.sira += 1
            if self.kapali.get(anahtar(adres), 0) <= simdi:
                return adres
        return None

    def process_request(self, request):
        adres = self.sec()
        if adres is None:
            self.stats.inc_value("proxy_havuzu/hepsi_dinleniyor")
            raise IgnoreRequest("Todos os proxies da lista estão descansando")
        request.meta["proxy"] = adres
        request.meta["proxy_anahtari"] = anahtar(adres)
        return None

    def process_response(self, request, response):
        kim = request.meta.get("proxy_anahtari")
        if kim:
            self.hatalar[kim] = 0
            self.stats.inc_value(f"proxy_havuzu/yanit/{kim}")
        return response

    def process_exception(self, request, exception):
        kim = request.meta.get("proxy_anahtari")
        if not kim:
            return None
        self.hatalar[kim] += 1
        self.stats.inc_value(f"proxy_havuzu/hata/{kim}")
        if self.hatalar[kim] >= self.hata_siniri:
            self.kapali[kim] = time.monotonic() + self.dinlenme
            self.hatalar[kim] = 0
return None# kitaplik/settings.py
PROXY_LISTESI = [
"http://user:pass@203.0.113.10:8000",
"http://user:pass@203.0.113.11:8000",
"http://user:pass@203.0.113.12:8000",
]
DOWNLOADER_MIDDLEWARES = {
"kitaplik.middlewares.ProxyHavuzuMiddleware": 610,
}Testamos o exemplo com três proxies locais, dois em funcionamento e um desligado. Os cem registros chegaram completos; as requisições se dividiram em 6 e 5 entre os dois endereços que funcionavam, o endereço desligado saiu de circulação depois de três erros de conexão, e o Scrapy tentou de novo as requisições com falha pelos outros endereços.
Aqui o número de ordem não é arbitrário. Na primeira tentativa colocamos o middleware em 350 e o contador de erros nunca funcionou: as exceções percorrem a cadeia em ordem inversa, e quando o middleware de novas tentativas, em 550, captura a exceção e devolve uma nova requisição, os middlewares de número menor não ficam sabendo. Um valor entre 550 e 750 (610 no exemplo) atende às duas condições: você vê o erro antes da nova tentativa, e as credenciais são processadas por HttpProxyMiddleware depois de você. Como fazer o mesmo à mão com o Requests está em Como rotacionar proxies em Python.
Como ajustar DOWNLOAD_DELAY e AutoThrottle?
O proxy muda por onde a requisição sai; não muda a carga que o servidor de destino recebe. As configurações que definem essa carga são estas:
# kitaplik/settings.py
USER_AGENT = "kitaplik-bot/1.0 (+https://ornek.com/bot)"
ROBOTSTXT_OBEY = True

CONCURRENT_REQUESTS = 8
CONCURRENT_REQUESTS_PER_DOMAIN = 2
DOWNLOAD_DELAY = 1
DOWNLOAD_TIMEOUT = 30

AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 2
AUTOTHROTTLE_MAX_DELAY = 30
AUTOTHROTTLE_TARGET_CONCURRENCY = 1.0
AUTOTHROTTLE_DEBUG = False

RETRY_ENABLED = True
RETRY_TIMES = 2
RETRY_HTTP_CODES = [429, 500, 502, 503, 504, 408]CONCURRENT_REQUESTS_PER_DOMAINé o número de requisições que podem estar abertas ao mesmo tempo para o mesmo domínio. O padrão do framework é 8, e o modelo de projeto reduz para 1. O que é concorrência está explicado em Concorrência e paralelismo.DOWNLOAD_DELAYé a espera, em segundos, entre duas requisições ao mesmo domínio. Por padrão, o Scrapy acrescenta uma variação aleatória a esse valor; as requisições não saem em intervalos exatos como um relógio.- AutoThrottle ajusta a espera de acordo com o tempo de resposta do servidor. Segundo o algoritmo da documentação, a espera alvo é a latência da resposta dividida por
AUTOTHROTTLE_TARGET_CONCURRENCY, e a nova espera é a média entre a espera anterior e esse alvo. Respostas diferentes de200não podem reduzir a espera. A espera nunca fica abaixo deDOWNLOAD_DELAYnem acima deAUTOTHROTTLE_MAX_DELAY. DOWNLOAD_TIMEOUTvale 180 segundos por padrão. Ao trabalhar por meio de um proxy, reduza esse valor para que uma conexão que não responde não fique pendurada por três minutos.
Com AUTOTHROTTLE_DEBUG = True, você vê uma linha por resposta. No nosso teste, a espera começou em 2.000 ms, caiu para 1.072 ms quando o servidor respondeu em 145 ms, depois para 1.000 ms, o piso definido por DOWNLOAD_DELAY, e ficou ali:
slot: books.toscrape.com | conc: 1 | delay: 2000 ms (+0)   | latency: 446 ms
slot: books.toscrape.com | conc: 1 | delay: 1072 ms (-927) | latency: 145 ms
slot: books.toscrape.com | conc: 1 | delay: 1000 ms (-72)  | latency: 144 ms
Com ROBOTSTXT_OBEY ativado, o Scrapy baixa primeiro o arquivo /robots.txt de cada domínio e descarta os endereços não permitidos sem pedi-los. Como ler o arquivo está em O que é robots.txt e como ler o arquivo?, e o enquadramento jurídico do rastreamento em Web scraping é legal?. Colocar em USER_AGENT um endereço pelo qual você possa ser contatado permite que o administrador do site escreva para você ao notar um problema, em vez de bloquear o seu acesso.
O que o Scrapy faz diante das respostas 429 e 503?
Por padrão, o middleware de novas tentativas repete os códigos 500, 502, 503, 504, 522, 524, 408 e 429, além dos erros de conexão; RETRY_TIMES = 2 significa três tentativas no total, contando a primeira requisição. A requisição repetida volta para a fila com prioridade menor.
Vale conhecer dois limites. A nova tentativa do Scrapy não lê o cabeçalho Retry-After e não aplica espera exponencial entre as tentativas; o intervalo continua sendo definido por DOWNLOAD_DELAY e AutoThrottle. Como o AutoThrottle não reduz a espera em respostas diferentes de 200, a velocidade não sobe sozinha durante uma onda de 429, mas também pode não cair o suficiente de forma automática. Se a proporção de 429 está crescendo no log, a reação correta é reduzir CONCURRENT_REQUESTS_PER_DOMAIN e aumentar DOWNLOAD_DELAY. Tentar ultrapassar um limite de velocidade com mais IPs não resolve o problema: aumenta a carga sobre o site. O significado dos códigos e a espera correta com Retry-After estão em Códigos de status HTTP no web scraping, e a lógica do limite de velocidade do lado do site no nosso artigo sobre 429 Too Many Requests.
Dá para usar proxy SOCKS5 no Scrapy?
Com o downloader padrão, não. No teste em que escrevemos um endereço socks5:// em meta["proxy"], a requisição esperou até o tempo limite sem receber resposta alguma. Já o segundo downloader do Scrapy, baseado em httpx, HttpxDownloadHandler, oferece suporte a SOCKS5 desde a versão 2.17. Para configurar, execute pip install "scrapy[httpx]" e acrescente isto às configurações:
DOWNLOAD_HANDLERS = {
    "http": "scrapy.core.downloader.handlers._httpx.HttpxDownloadHandler",
    "https": "scrapy.core.downloader.handlers._httpx.HttpxDownloadHandler",
}
Com essa configuração, um endereço socks5://user:pass@… funcionou no nosso teste, inclusive com autenticação. A documentação do Scrapy marca esse downloader como experimental e ainda não o recomenda para produção; também observa que ele abre um pool de conexões separado para cada endereço de proxy. Se não for obrigatório, fique com um proxy HTTP. As diferenças entre os protocolos estão em Diferença entre SOCKS e HTTP proxy.
O que fazer com páginas carregadas por JavaScript?
O Scrapy baixa o HTML da página; não executa JavaScript. Se os dados são carregados depois no navegador, olhe primeiro o endpoint JSON que a página chama em segundo plano; na maioria das vezes esse endereço pode ser pedido diretamente com o Scrapy. Se isso não for possível, o plugin scrapy-playwright abre em um navegador real as requisições que você escolher. Atenção: nesse plugin o proxy não é informado por meta["proxy"], e sim pelas opções de inicialização do navegador ou do contexto (context). Os detalhes estão no nosso artigo sobre Playwright com proxy, e a forma de distinguir os tipos de página em Páginas estáticas e dinâmicas.
Scrapy, BeautifulSoup ou Selenium?
Os três são partes diferentes do mesmo trabalho; por isso a comparação costuma ser montada do jeito errado.
| Scrapy | Requests + BeautifulSoup | Selenium | |
|---|---|---|---|
| O que é | Framework de rastreamento | Cliente HTTP + analisador de HTML | Automação de navegador |
| Fila de requisições e concorrência | Prontas | Você escreve | Você escreve |
| Novas tentativas, limite de velocidade, robots.txt | Ativados por configuração | Você escreve | Você escreve |
| Execução de JavaScript | Não (com plugin) | Não | Sim |
| Definição do proxy | meta["proxy"] ou middleware | Parâmetro proxies= | Opção de inicialização do navegador |
| Curva de aprendizado | Média | Baixa | Média |
| Trabalho adequado | Muitas páginas, rastreamento recorrente | Pontual, poucas páginas | Login, cliques, conteúdo dinâmico |
O BeautifulSoup é apenas um analisador e também pode ser usado dentro do Scrapy. O Selenium abre um navegador completo para cada página e, por isso, processa muito menos páginas no mesmo hardware; faz sentido só nas etapas que realmente precisam de um navegador. A configuração de proxy no Selenium está em Selenium com proxy, e a comparação das duas ferramentas de navegador no nosso artigo sobre Playwright e Selenium.
Casos de uso
- Acompanhamento de preços e estoque: A mesma lista de produtos é rastreada todos os dias; a estrutura do Scrapy, própria para execuções agendadas, se encaixa nesse trabalho. O desenho está na nossa página de monitoramento de preços, e um exemplo que funciona no nosso artigo sobre o acompanhamento de preços de concorrentes no e-commerce.
- Rastreamento interno de um site e criação de índice: A classe
CrawlSpider, que percorre todas as páginas seguindo os links, é um ponto de partida pronto para trabalhos de web crawler. - Coleta de catálogos de vários sites: Um spider por site, um pipeline comum e uma configuração de proxy comum. A arquitetura geral está na nossa página de extração de dados.
- Listas paginadas: Os padrões de link "próxima", número de página e cursor estão no nosso artigo sobre paginação no web scraping.
Erros comuns
- Escrever o proxy só na primeira requisição.
metanão passa para as requisições seguintes; da segunda página em diante o rastreamento continua a partir do seu próprio endereço IP, e você não percebe isso no log. - Escolher ao acaso o número de ordem do middleware. Com um número maior que 750, as credenciais não são separadas e a requisição falha com o erro
invalid hostname; com um número menor que 550, você não vê os erros de conexão. - Apagar do modelo as linhas de
ROBOTSTXT_OBEY,DOWNLOAD_DELAYe concorrência. Os padrões crus do framework (robots.txt desligado, sem espera, 8 requisições por domínio) são rápidos o bastante para sobrecarregar um site pequeno. - Continuar o rastreamento recebendo
407. Cada requisição é tentada três vezes e nenhuma dá certo; corrija primeiro as credenciais. - Montar um middleware de rotação por cima de um gateway rotativo. O gateway já faz esse trabalho; uma segunda camada só dificulta a depuração.
- Deixar
DOWNLOAD_TIMEOUTno padrão. Uma única conexão que não responde ocupa um slot por três minutos. - Escrever a senha no
settings.pye enviar para o repositório. Leia o endereço de uma variável de ambiente.
Guia de decisão
| Necessidade | Recomendação |
|---|---|
| Trabalho pontual de poucas páginas | Requests + BeautifulSoup bastam, o Scrapy não é obrigatório |
| Milhares de páginas, repetição regular | Projeto Scrapy, mantendo as configurações do modelo |
| Todo o tráfego passando pelo proxy | TekProxyMiddleware ou a variável de ambiente https_proxy |
| Só algumas requisições por outra saída | meta["proxy"] nessas requisições |
| Distribuir a carga entre muitos IPs | Gateway rotativo, um único endereço, sem middleware |
| Você tem uma lista fixa de proxies | ProxyHavuzuMiddleware, número de ordem entre 550 e 750 |
| O mesmo IP durante toda a sessão | Proxies de sessão fixa e um único endereço |
Os 429 estão aumentando no log | Reduza a concorrência, aumente DOWNLOAD_DELAY, ative o AutoThrottle |
| SOCKS5 é obrigatório | HttpxDownloadHandler (experimental) |
| Os dados chegam por JavaScript | Primeiro o endpoint JSON; se não der, scrapy-playwright |
Perguntas frequentes
O que é um spider do Scrapy?
Um spider é uma classe Python derivada de scrapy.Spider que define duas coisas: de quais endereços o rastreamento começa, e quais dados e quais novos links são extraídos da resposta recebida. A fila, o download e o tratamento de erros são tarefa do framework, não do spider.
É preciso saber Python para usar o Scrapy?
Sim. Um spider é uma classe Python, e você vai usar seletores, laços e dicionários. Quem sabe o básico de Python consegue escrever o primeiro spider; para a parte de middleware e pipeline, convém ter familiaridade com classes.
Como sei que o proxy está mesmo sendo usado?
Envie com o Scrapy uma requisição a um serviço que devolva o seu endereço IP em JSON e compare o endereço da resposta com o seu próprio IP. Gravar no log o valor de response.meta.get("proxy") dentro de parse também mostra qual requisição saiu por qual proxy. Os métodos gerais estão em Seu proxy está funcionando? Como testar um proxy.
O que é mais rápido, Scrapy ou Selenium?
No mesmo hardware, o Scrapy processa bem mais páginas, porque não abre navegador e envia as requisições de forma assíncrona. A velocidade só importa se a página não precisa de JavaScript; se os dados são gerados no navegador, o Scrapy sozinho não consegue vê-los.
Com o AutoThrottle ativado, DOWNLOAD_DELAY fica desnecessário?
Não, é esse valor que define o piso. O AutoThrottle nunca leva a espera abaixo de DOWNLOAD_DELAY. Em um servidor que responde rápido, a espera cai até esse piso e fica ali; por isso, confiar no AutoThrottle com DOWNLOAD_DELAY = 0 equivale a enviar requisições quase sem espera a servidores rápidos.
Usar um IP diferente em cada requisição evita bloqueios?
Sozinho, não. Os sites medem a velocidade não só por IP, mas também por sessão, cookie e comportamento. A rotação distribui a carga entre muitas saídas; ela ganha sentido junto com o respeito ao robots.txt, a concorrência baixa e um User-Agent honesto. Reunimos os métodos legítimos em Como fazer web scraping sem ser bloqueado.
Em resumo
No Scrapy, o proxy é o campo meta["proxy"] da requisição, e você pode preenchê-lo de três formas: à mão em cada requisição, com uma variável de ambiente ou com um downloader middleware. Para que todo o tráfego, inclusive o robots.txt, saia pela mesma saída, é preciso uma das duas últimas. Com um gateway rotativo, um único endereço basta; se você tem uma lista fixa, um middleware numerado entre 550 e 750 assume a distribuição e a contagem de erros. Quem define a velocidade não é o proxy, e sim DOWNLOAD_DELAY, a concorrência por domínio e o AutoThrottle; mantenha as configurações cautelosas que o modelo traz. Você encontra os tipos de proxy adequados aos seus rastreamentos entre nossos serviços de proxy.


